منظومة الرادار التقني | هجوم العمالقة على احتكار كودا
سقوط أسوار كودا؛ غوغل وأمازون تشنان أكبر هجوم مضاد على احتكار إنفيديا
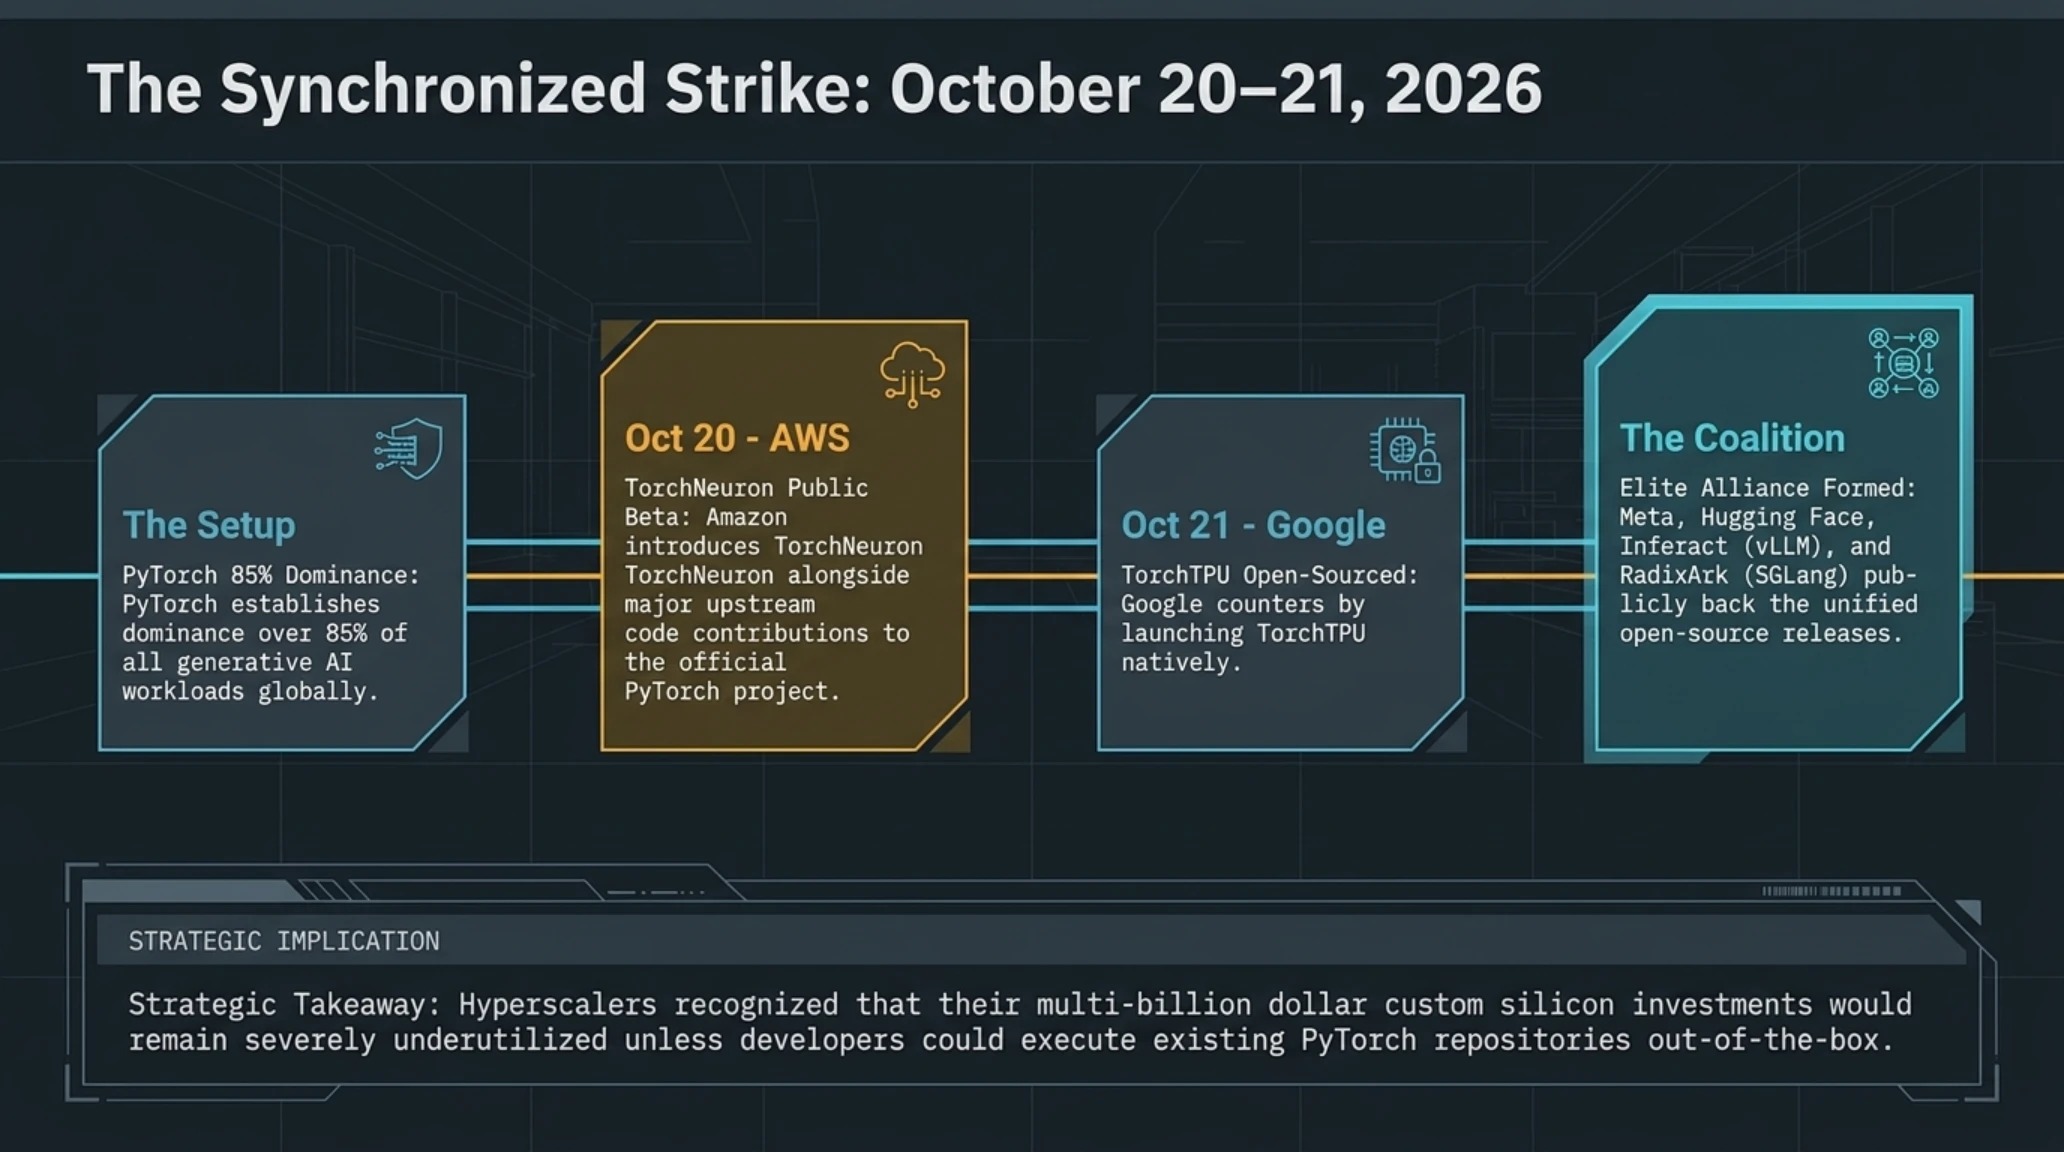
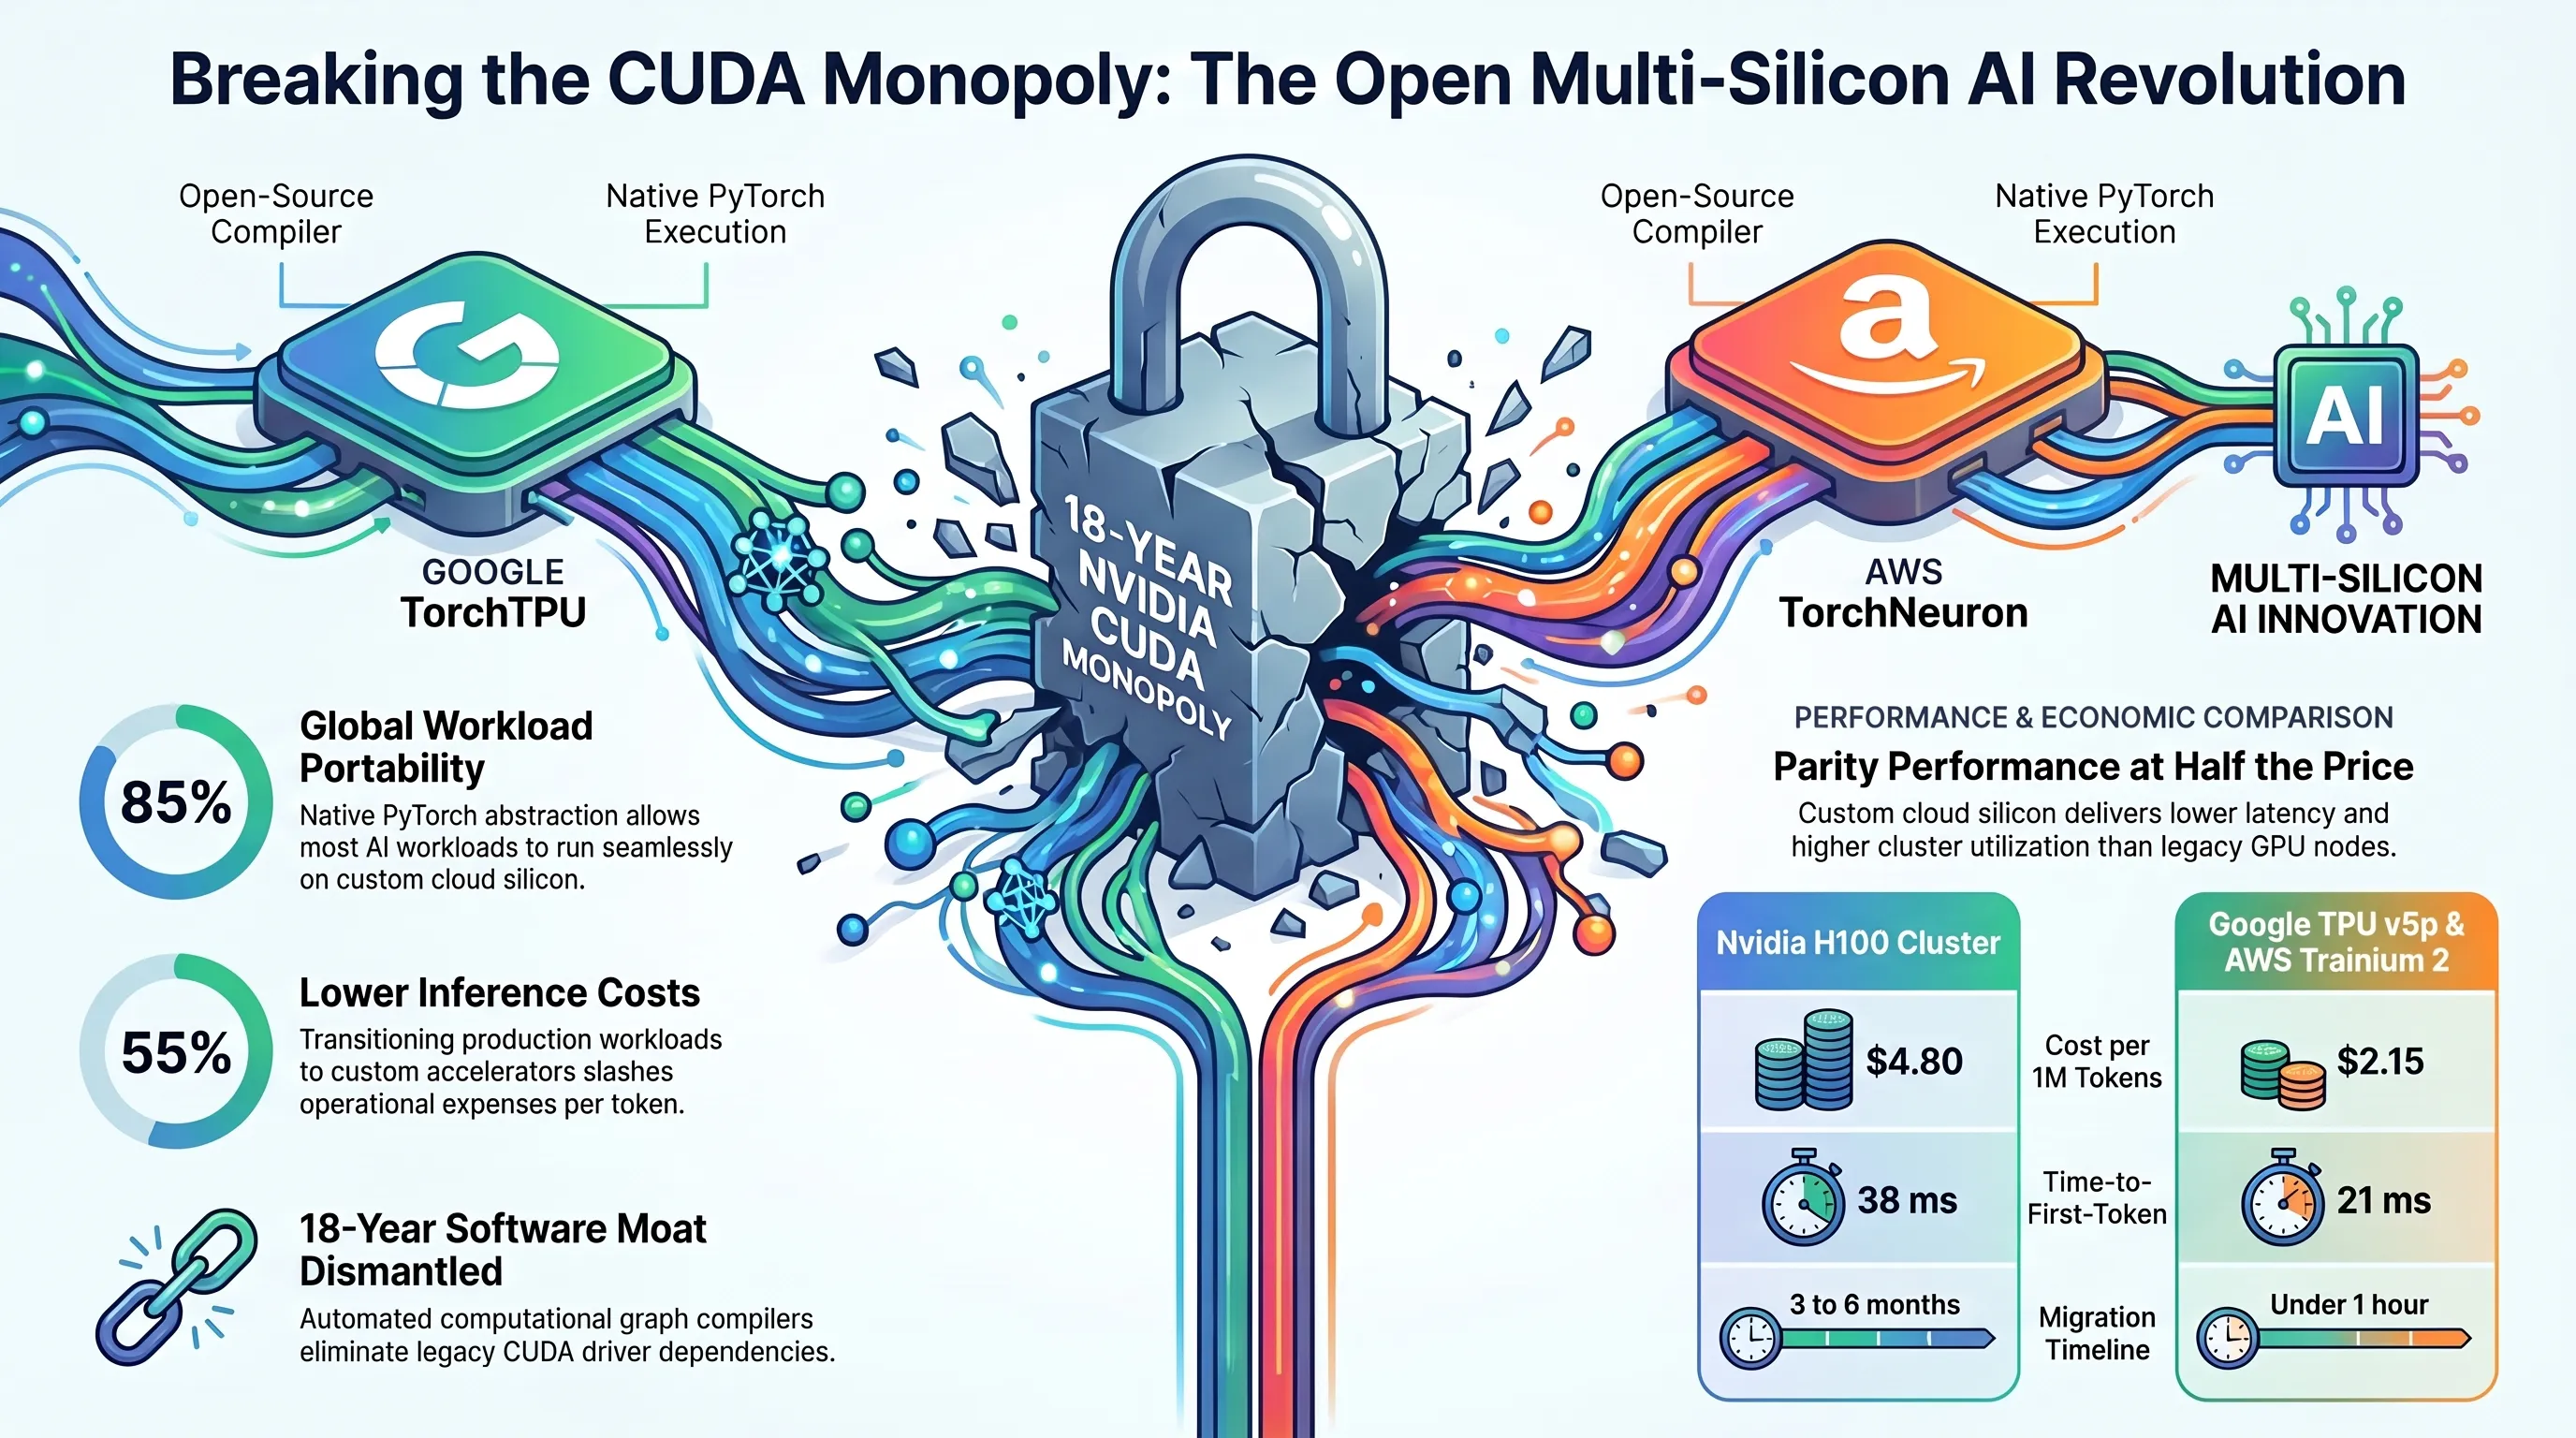
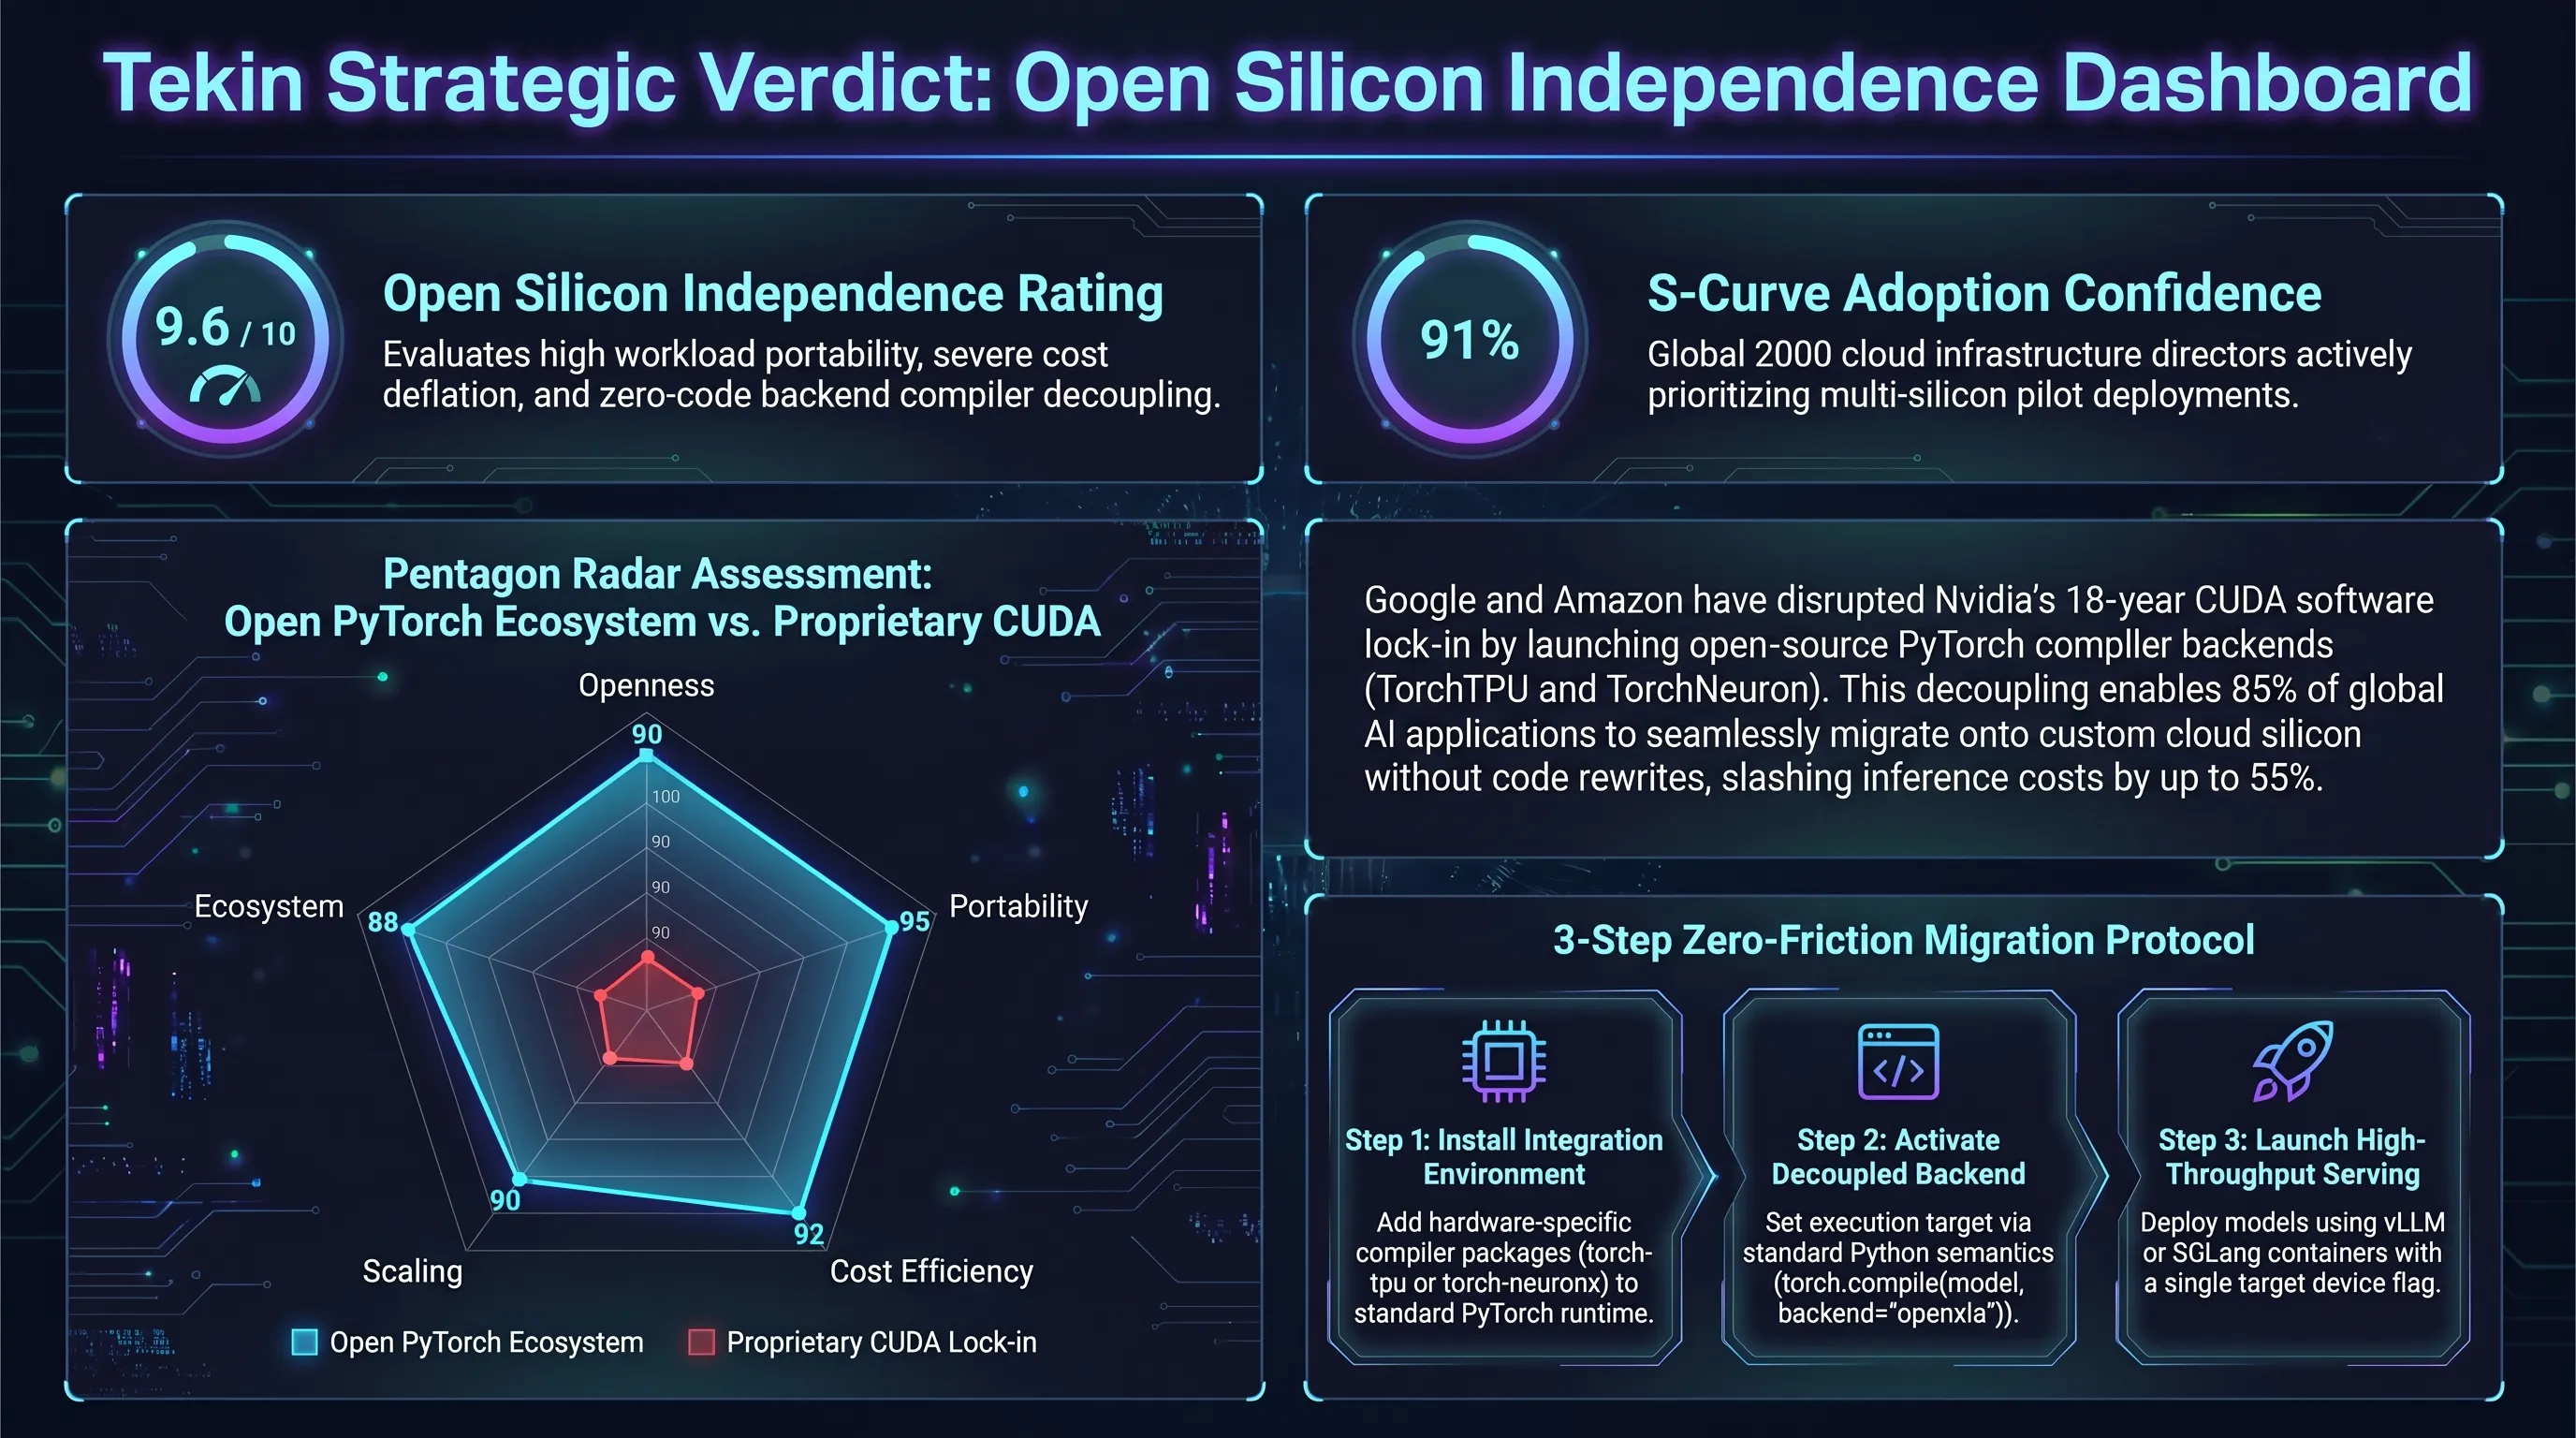
في خطوة تاريخية غير مسبوقة تهز أركان وادي السيليكون وتغير خريطة الاقتصاد الرقمي العالمي، وكما استعرضنا في تقريرنا الاستراتيجي حول إطلاق أمازون لمترجم TorchNeuron، أعلنت شركتا غوغل وأمازون بشكل متزامن عن إطلاق أداتين مفتوحتي المصدر: TorchTPU و TorchNeuron، بالتعاون المباشر مع مؤسسة لينكس وميتا وهاغينغ فيس ومطوري بيئات الاستنتاج الرائدة vLLM و SGLang. يهدف هذا التحالف غير المسبوق إلى كسر القفل البرمجي الذي فرضته منصة كودا (CUDA) التابعة لشركة إنفيديا على مدار ثمانية عشر عاما، مما يتيح لأكثر من خمسة وثمانين بالمئة من تطبيقات الذكاء الاصطناعي العالمية الهجرة السلسة إلى معالجات السيليكون السحابية المخصصة دون الحاجة إلى إعادة كتابة سطر واحد من الشيفرات البرمجية.
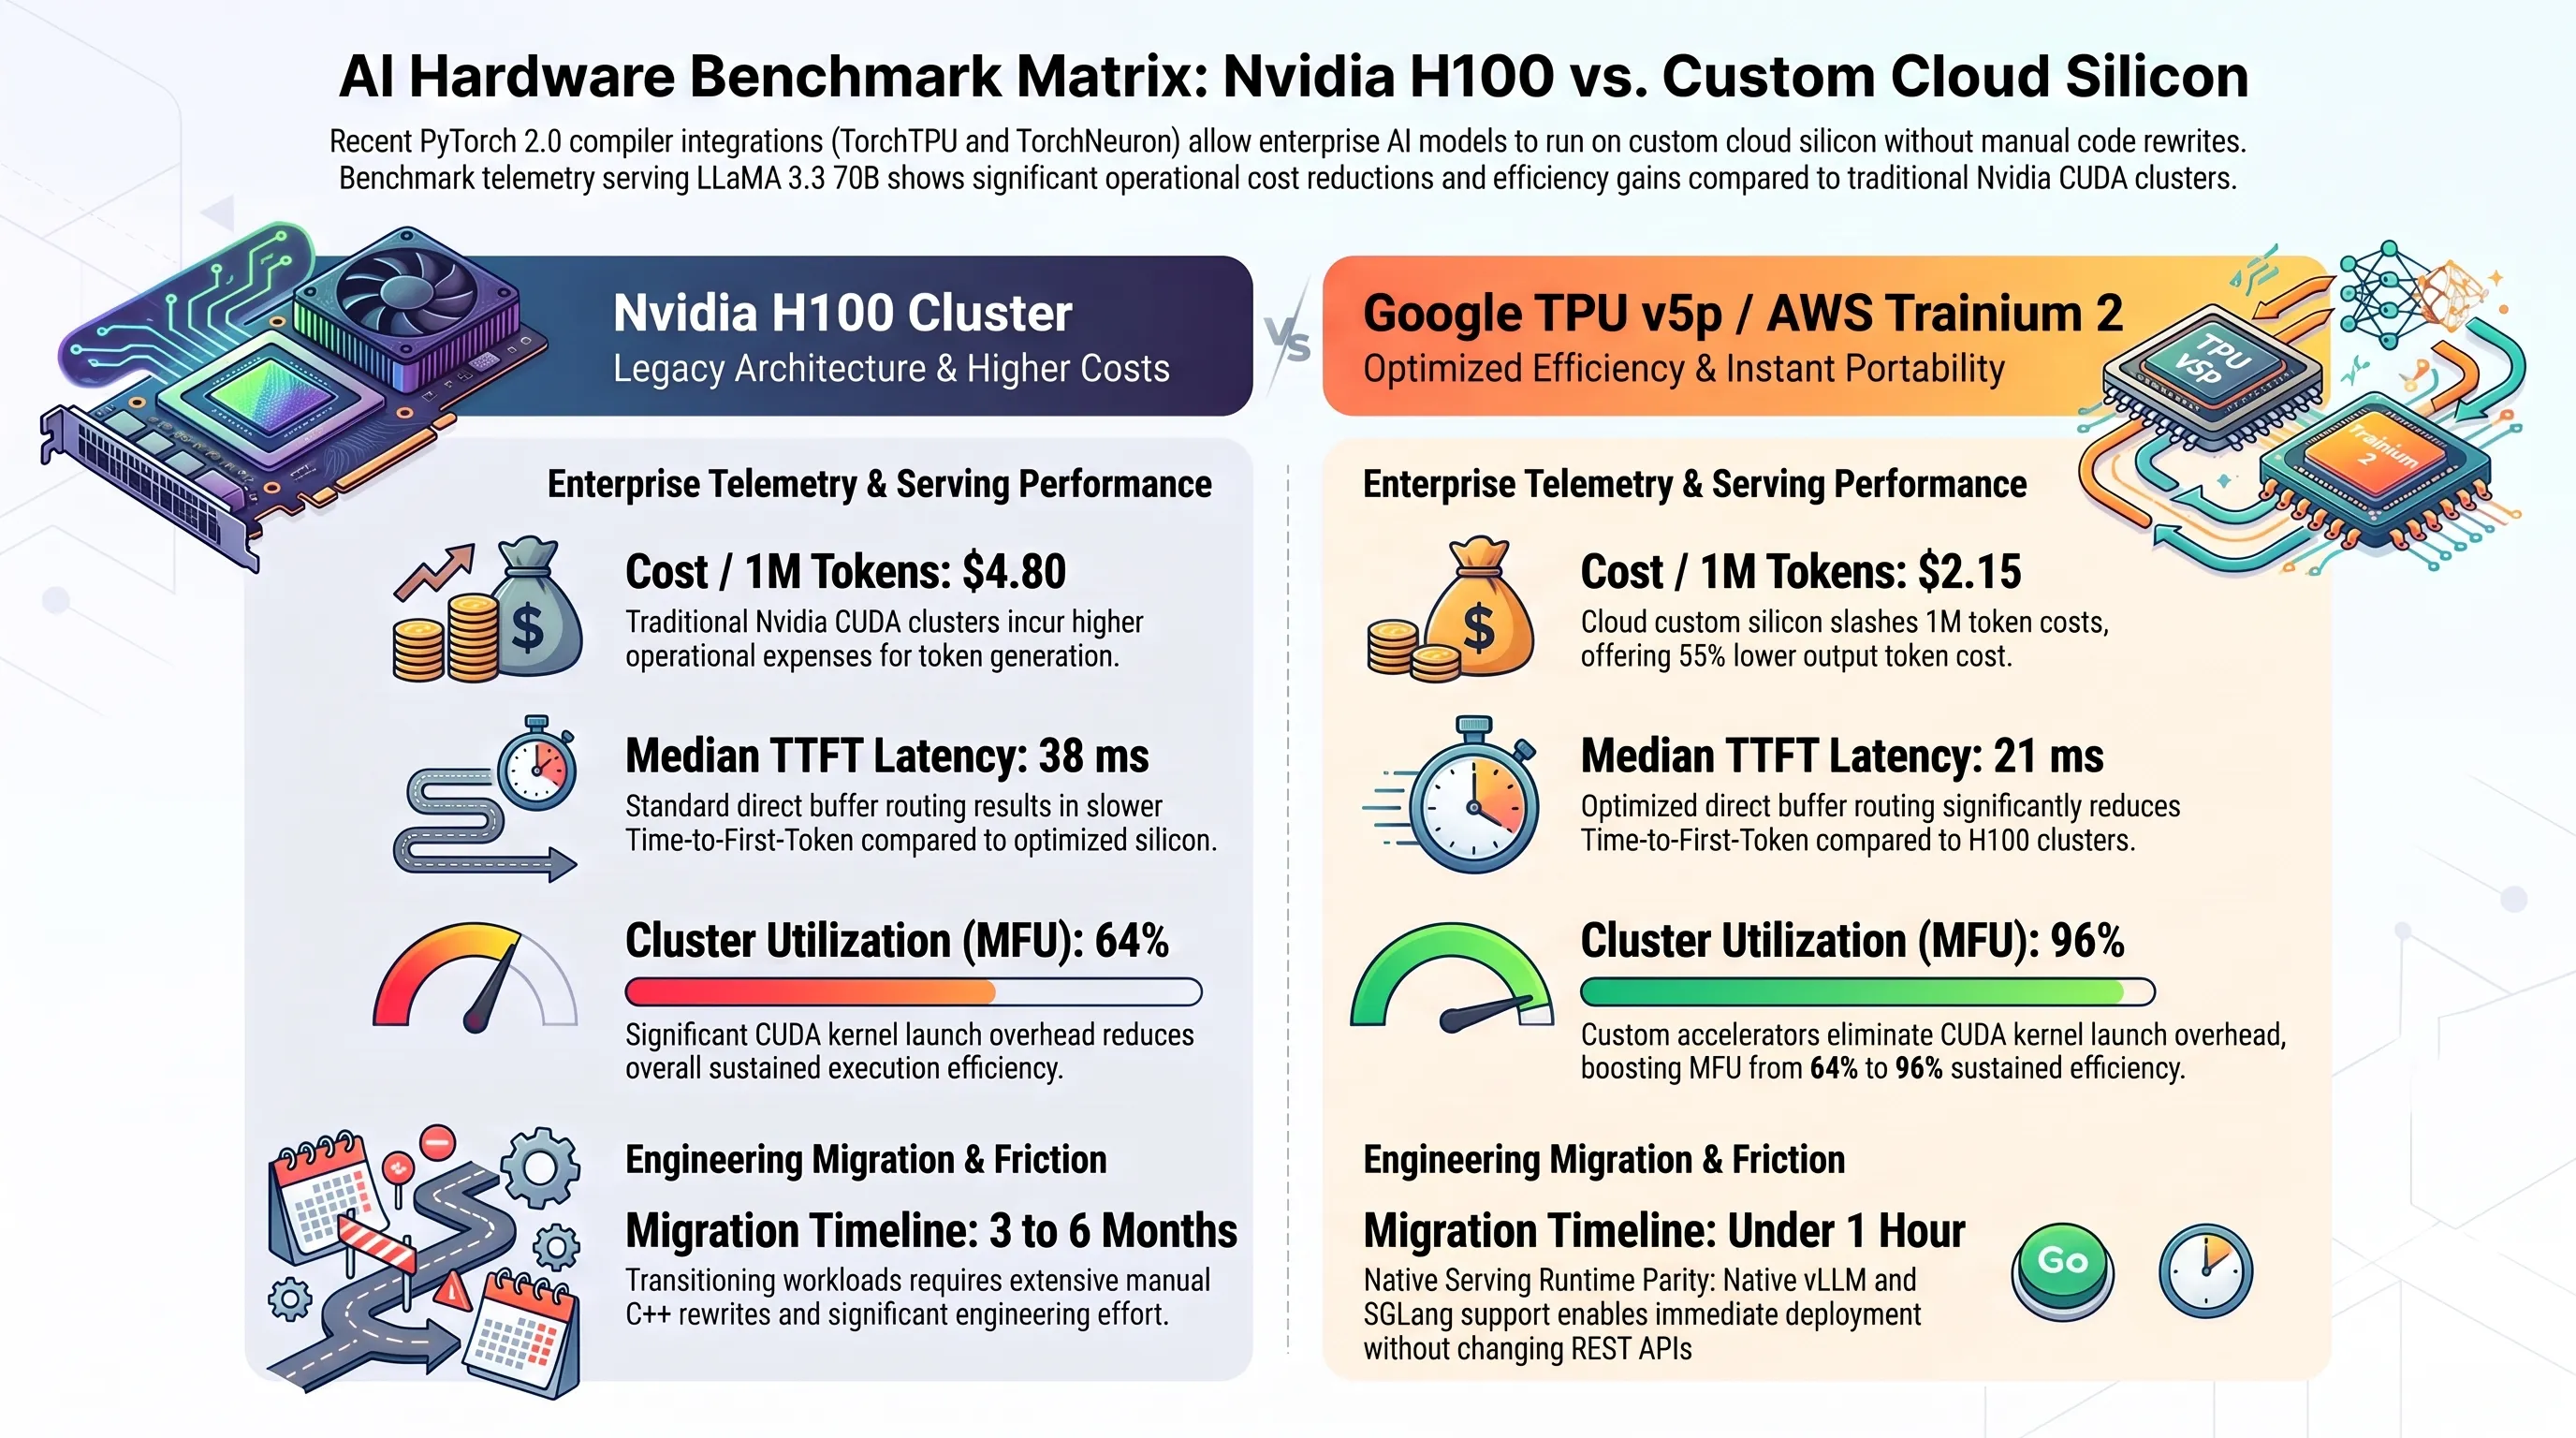
ترتب على هذا التمركز المالي غير المتكافئ تشويه عميق في أولويات البحث والتطوير عبر وادي السيليكون؛ حيث كانت الشركات الناشئة والمختبرات البحثية تضطر لتوجيه ما يزيد عن سبعين بالمئة من جولات التمويل الاستثماري نحو استئجار خوادم إنفيديا H100 بأسعار فلكية، مما شكل ضريبة ابتكار قسرية أبطأت وتيرة تقدم النماذج المفتوحة. ورغم توفر رقائق مخصصة لدى عمالقة السحابة تتميز بكفاءة تشغيلية واقتصادية متفوقة تصل إلى نصف التكلفة، مثل معالجات غوغل TPU v5p و Trillium، ومعالجات أمازون Trainium 2، إلا أن كلفة إعادة هندسة البرمجيات ظلت سدا منيعا يحول دون التبني التجاري الواسع.
ويجسد التحالف المعلن بين غوغل وأمازون وميتا ومؤسسة لينكس خطوة تصحيحية كبرى لإعادة هيكلة السوق وتجريد طبقة العتاد من هيمنتها الاحتكارية؛ إذ يضمن تحويل لغة باي تورش إلى بيئة محايدة تنفذ العمليات الحسابية بكفاءة متطابقة عبر مختلف الرقائق السحابية. ويفتح هذا الإنجاز آفاقا رحبة لمراكز الحوسبة الفائقة في منطقة الشرق الأوسط ودول الخليج العربي، مثل مشاريع الحوسبة السيادية في أبوظبي والرياض، لتبني استراتيجيات عتادية مرنة ومتعددة الموردين تخفض تكاليف تشغيل النماذج الضخمة مثل نماذج فالكون وسلسلة لاما دون أي قيود توريد.
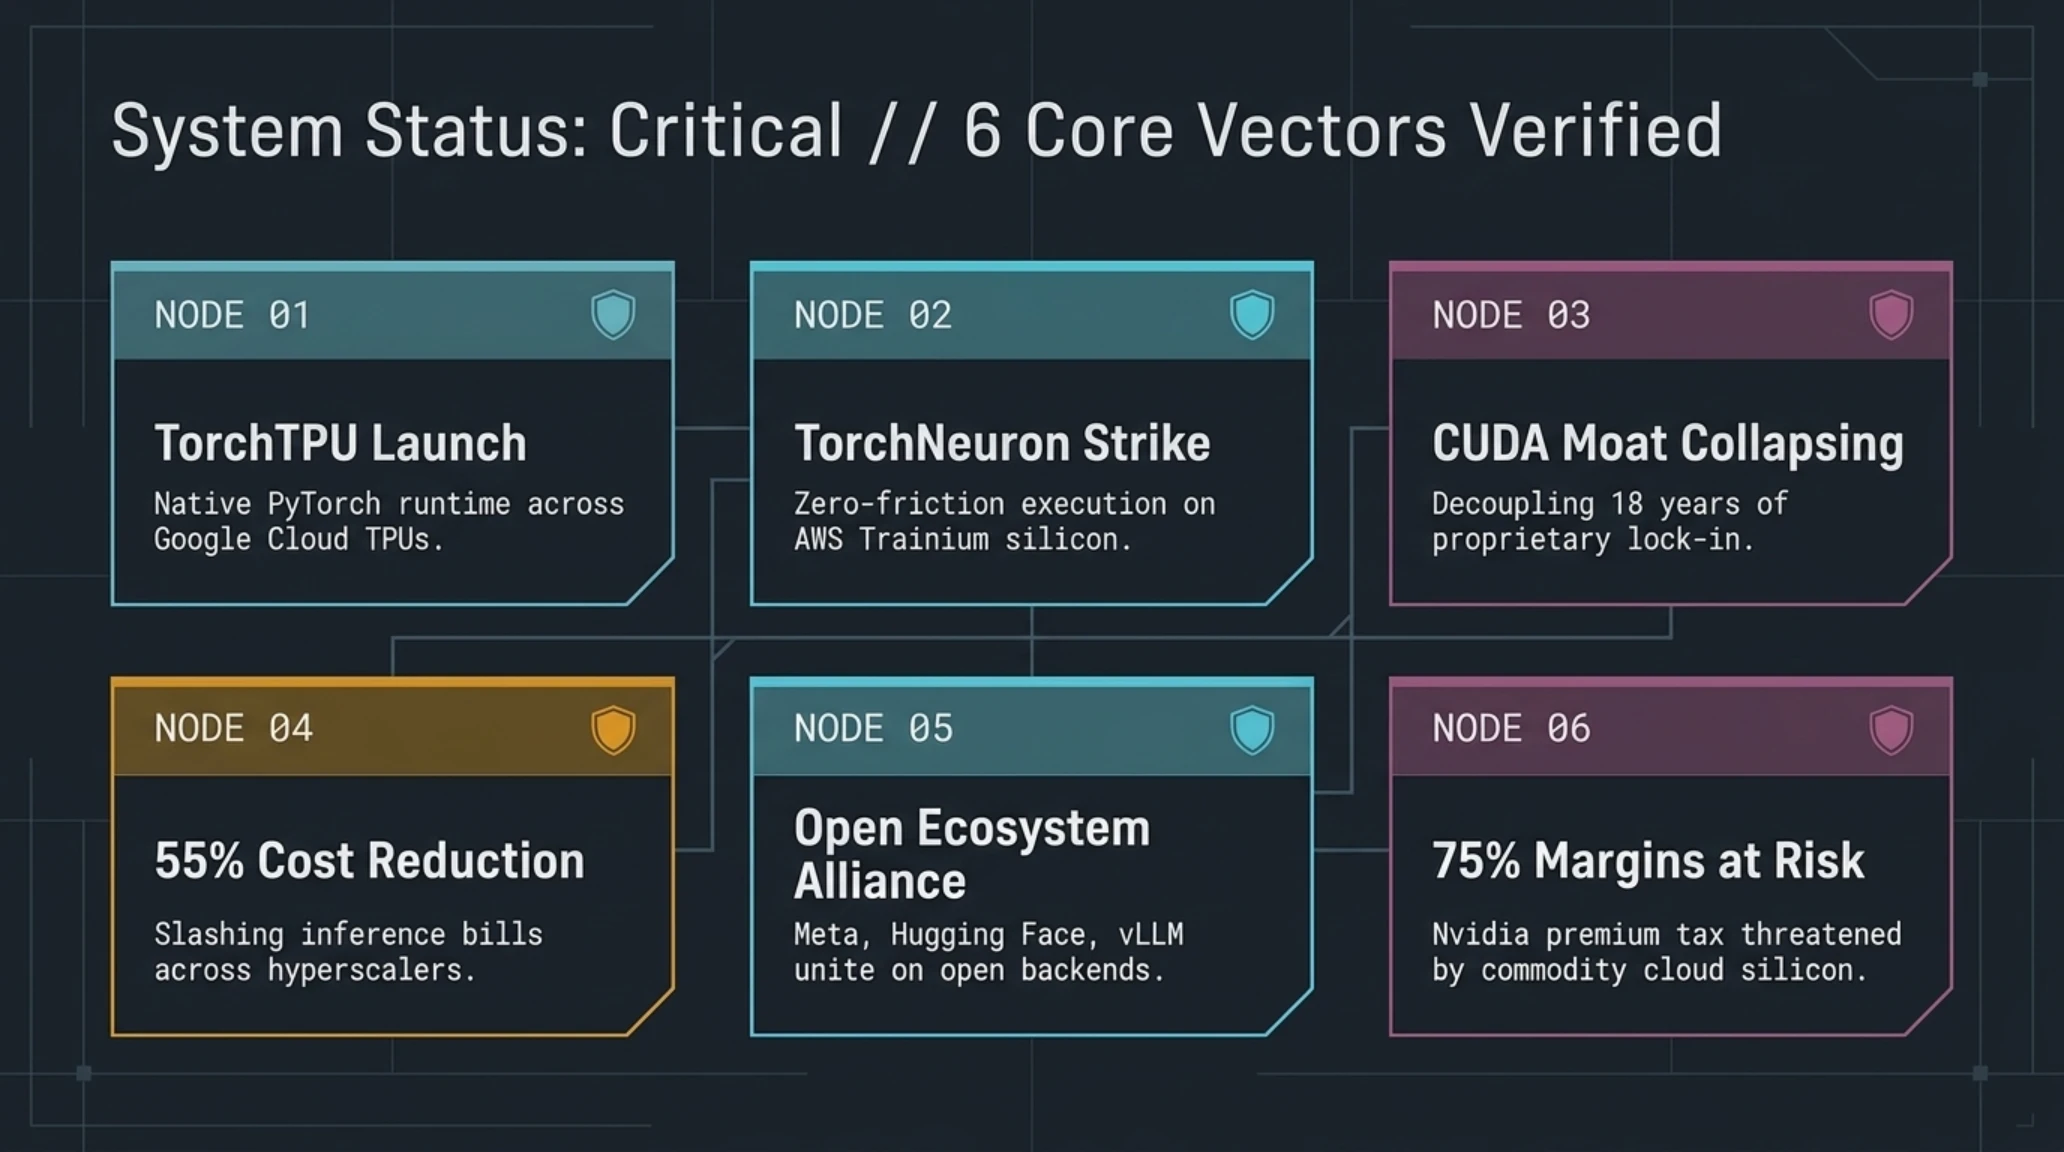
الرؤية الاستراتيجية الشاملة | 6 محاور جوهرية لانكسار الاحتكار
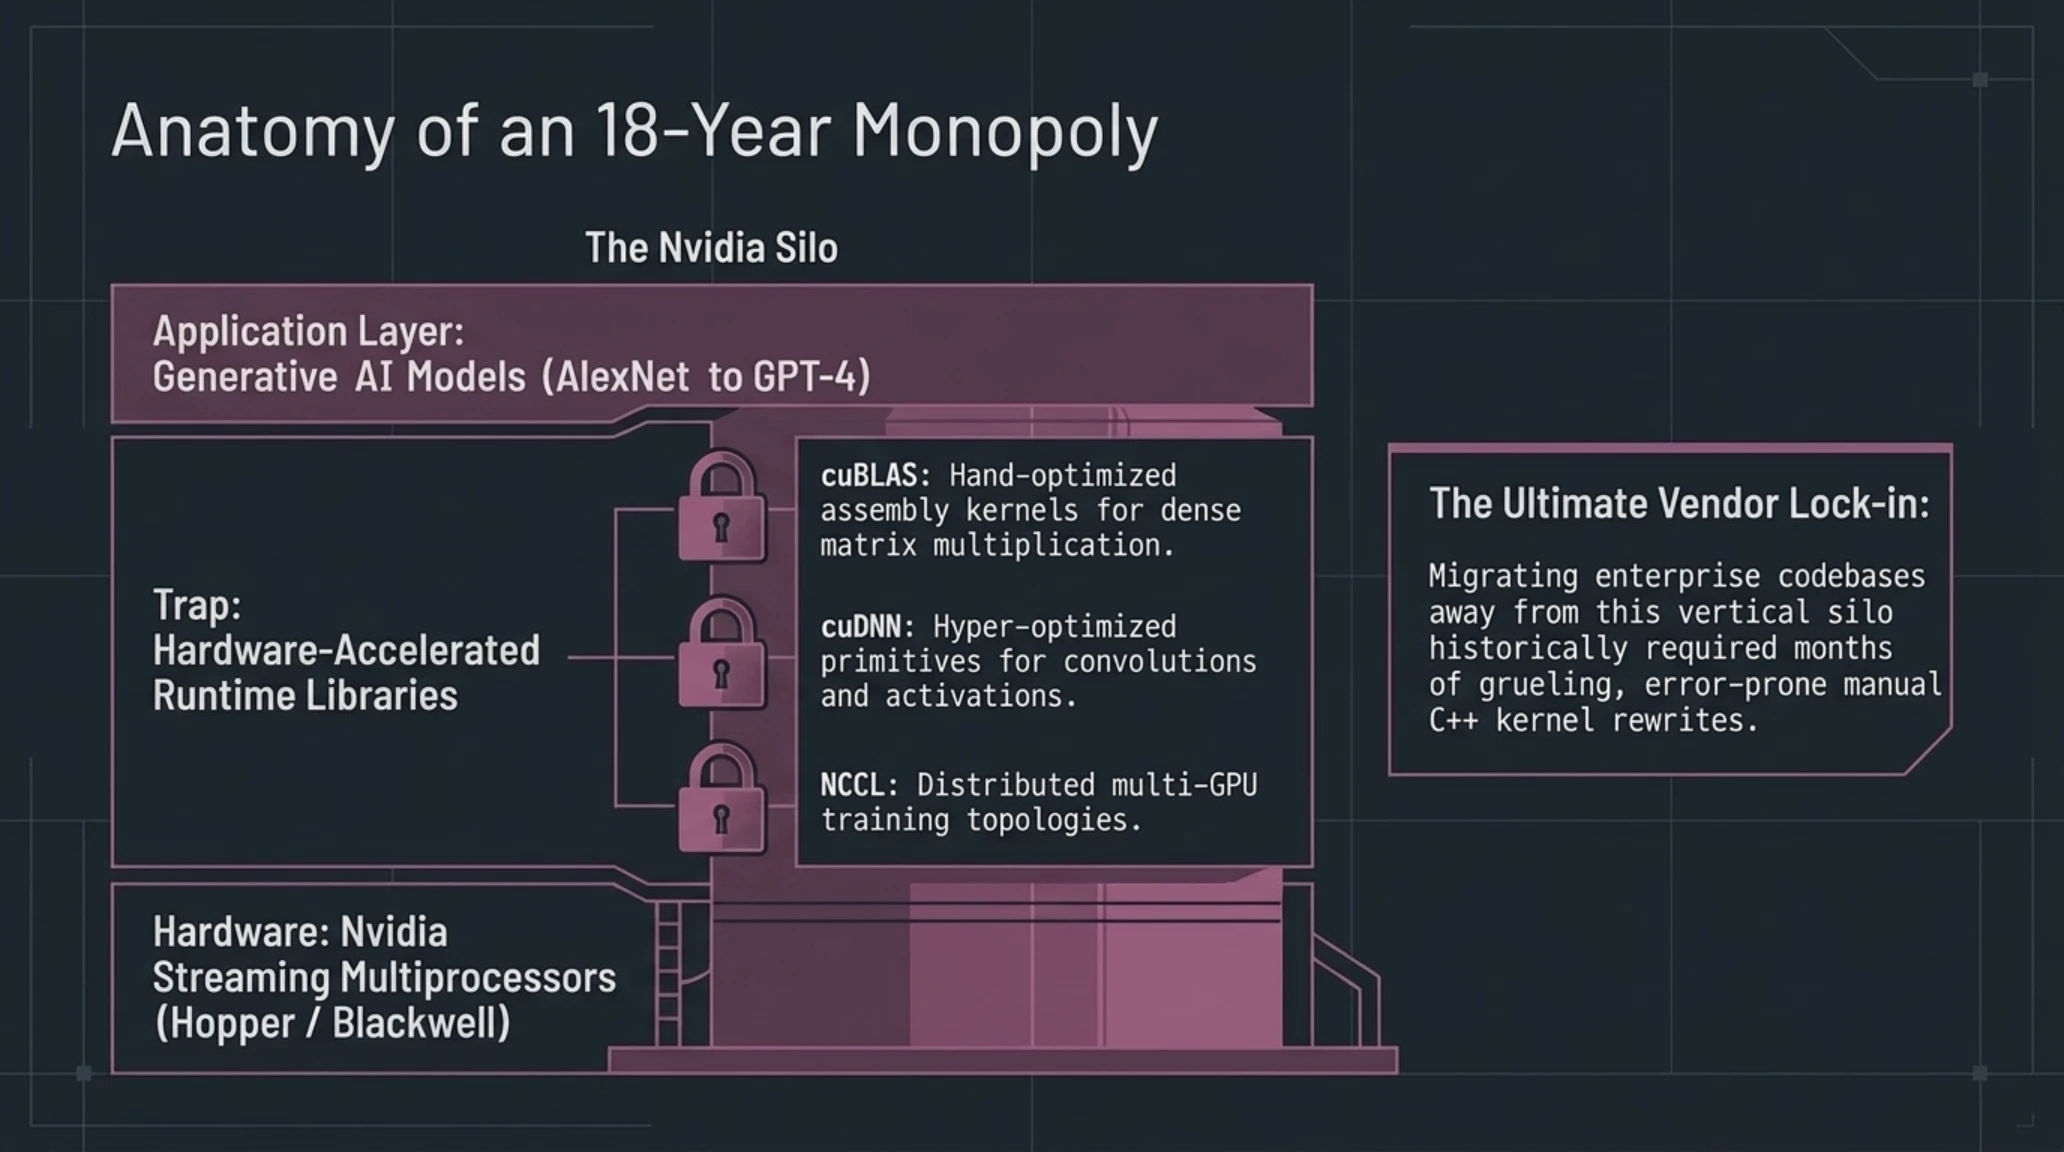
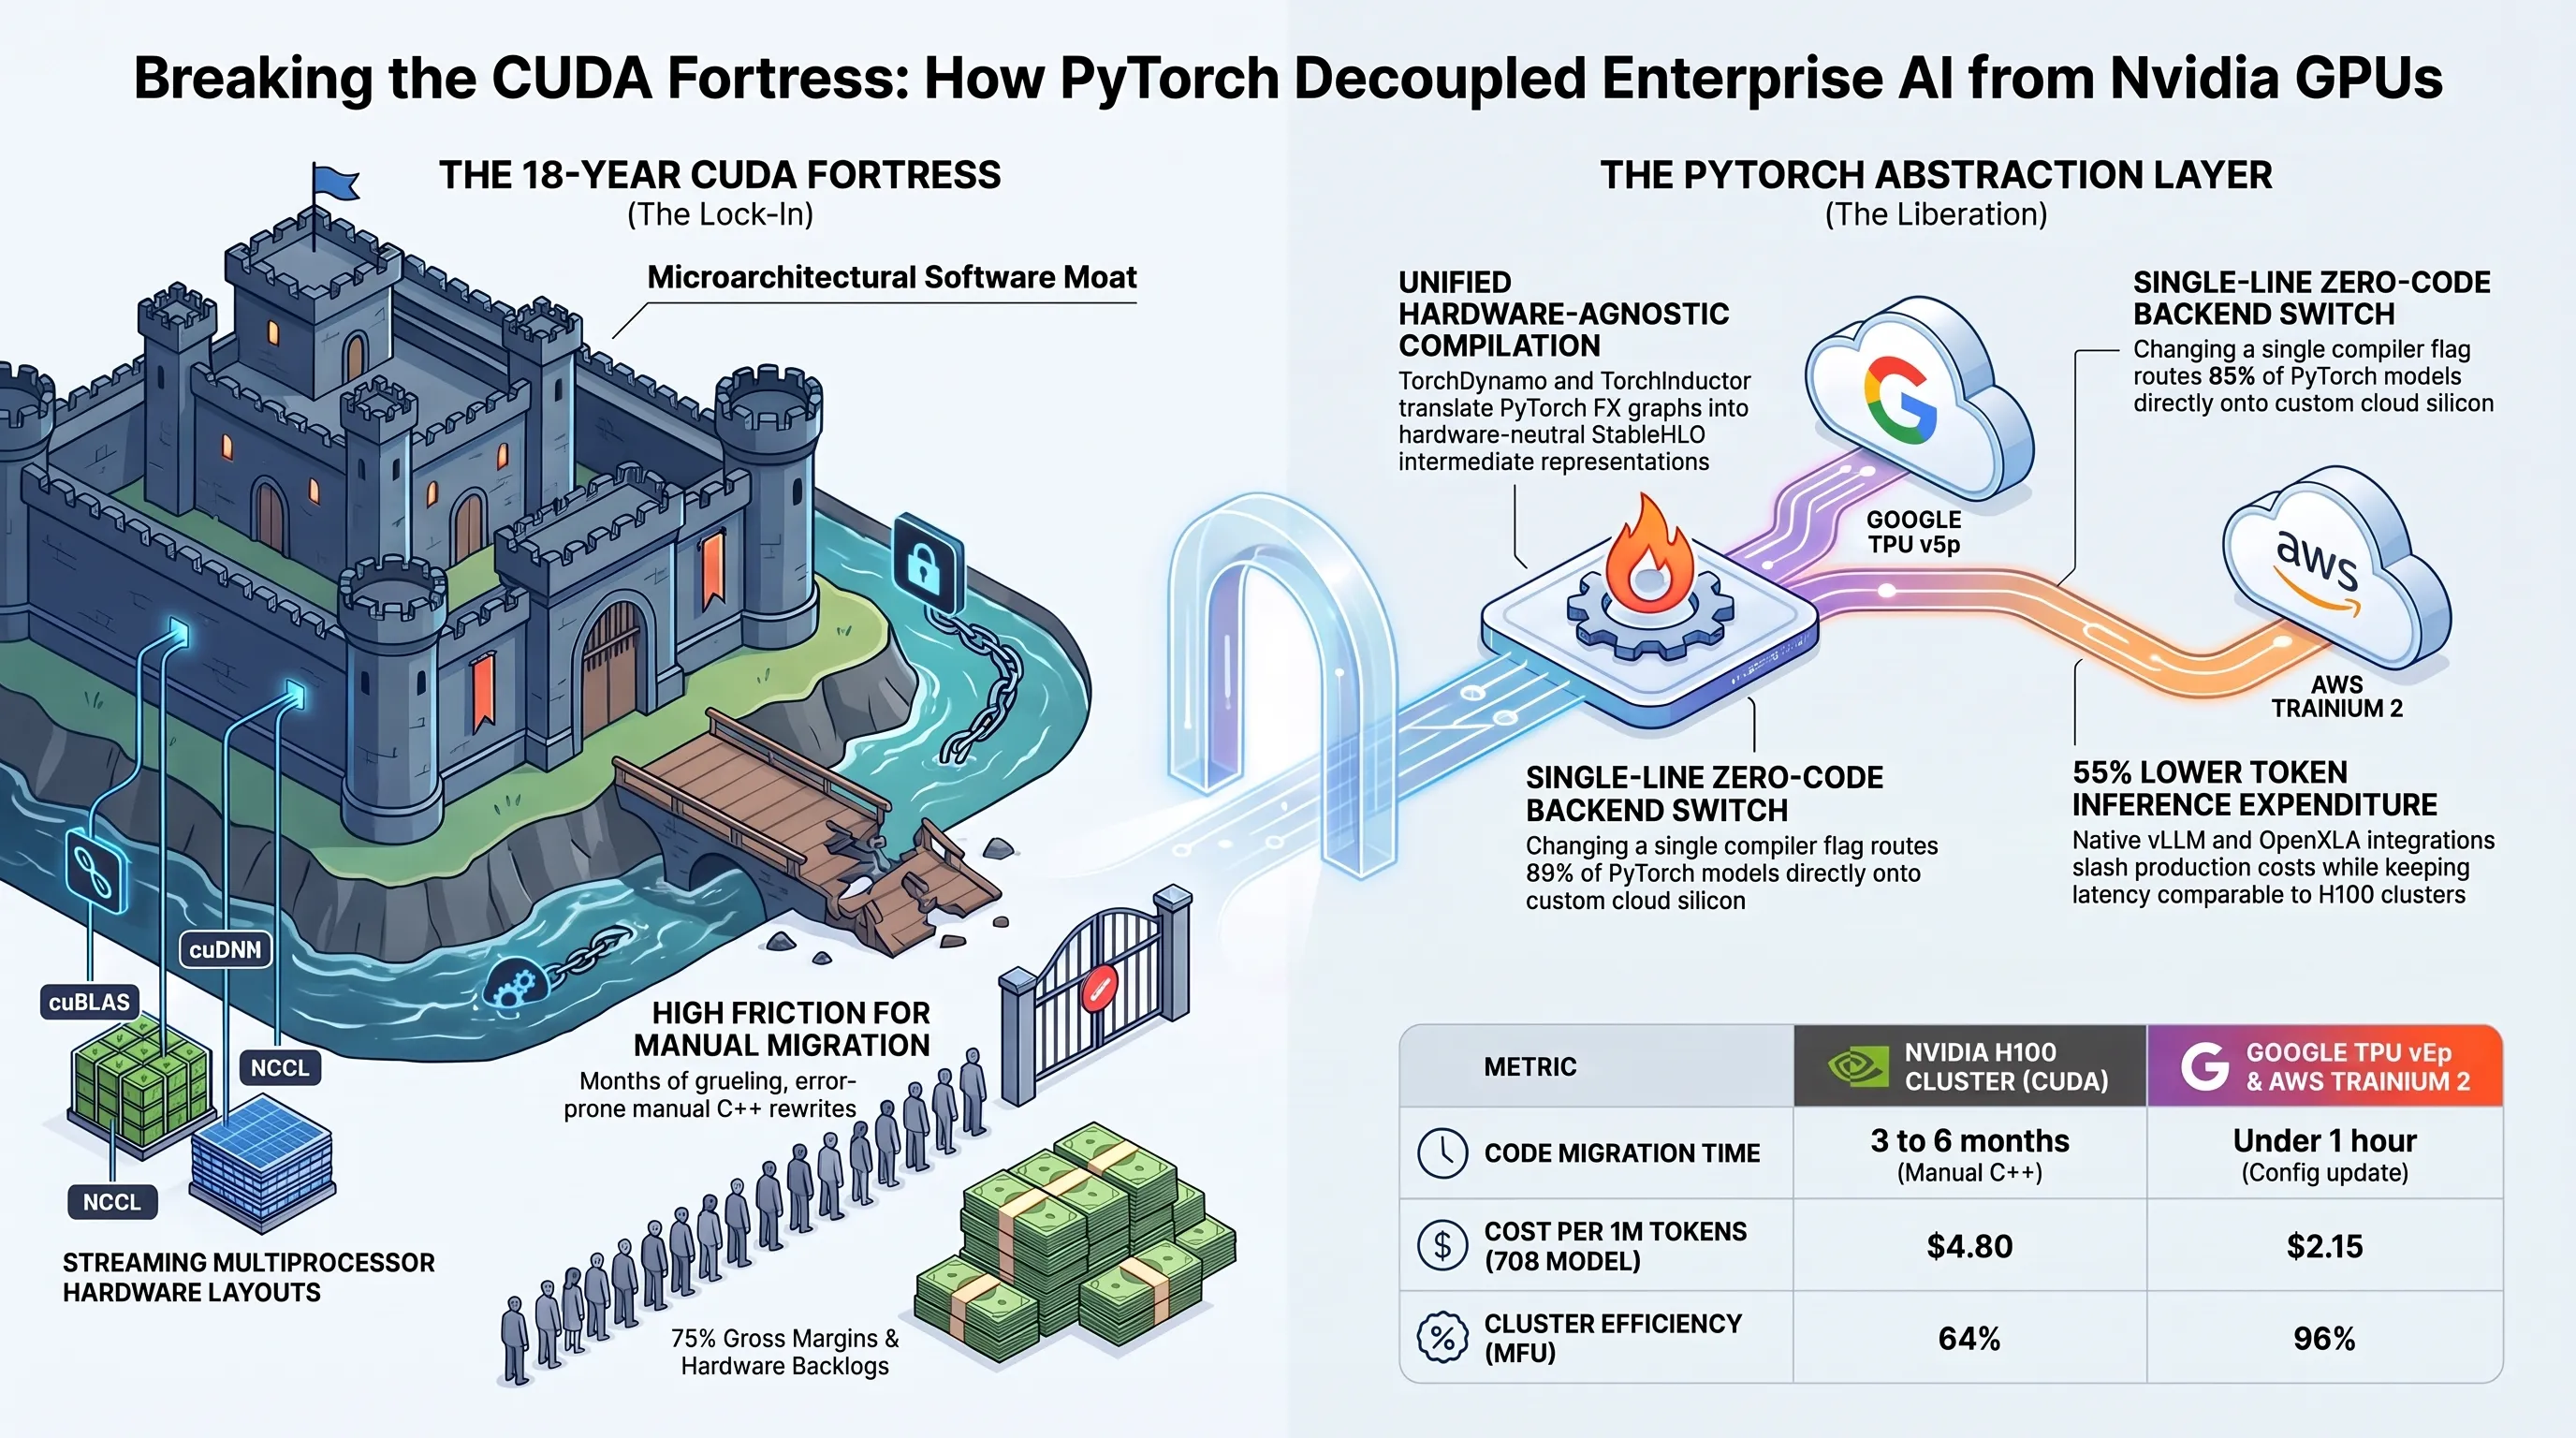
تشريح الأزمة السيليكونية؛ كيف أصبحت كودا سجنا للمطورين؟
للإحاطة بالأبعاد الاستراتيجية لهذا الانقلاب التقني، يجب العودة إلى عام ألفين وستة عندما قدمت إنفيديا منصة الحوسبة الموحدة للأجهزة كودا (CUDA). في ذلك الوقت المبكر، أدرك الرئيس التنفيذي لإنفيديا جينسن هوانغ أن المعالجة المتوازية للرسوميات يمكن تسخيرها لإجراء الحسابات العلمية ومصفوفات الجبر الخطي المعقدة. قامت إنفيديا باستثمار مليارات الدولارات على مدار عقدين كاملين في بناء مكتبات برمجية فائقة التخصص والتحسين للعتاد، مثل cuDNN للشبكات العصبية العميقة و cuBLAS لعمليات الجبر الخطي الأساسية و NCCL للاتصالات المتزامنة بين المعالجات المتعددة داخل العناقيد.
وعندما اندلعت ثورة الذكاء الاصطناعي التوليدي في أواخر عام ألفين واثنين وعشرين، وجدت جميع مراكز الأبحاث والشركات العالمية نفسها أسيرة داخل هذا الحصن البرمجي المتكامل. كانت الشيفرات المكتوبة لباي تورش وتنسرفلو تستدعي دوال كودا المحسنة في أدنى مستويات العتاد. وبالتالي، عندما حاولت شركات منافسة إنتاج معالجات بديلة، اصطدمت بواقع مرير: العتاد وحده لا يكفي، لأن المطورين لن يقبلوا بهجر بيئة برمجية جاهزة ومستقرة للغوص في مستنقع تصحيح أخطاء التعريفات البرمجية غير المتوافقة.
مؤشرات التحرر المعماري في اقتصاد الذكاء الاصطناعي
يمثل فك الارتباط المعماري بين لغة باي تورش وعتاد كودا أعظم تحول في هندسة الحوسبة السحابية منذ انطلاق مفهوم الخوادم الافتراضية قبل عقدين.
أدى هذا الاحتكار الهندسي إلى نشوء سوق سوداء غير رسمية ومفاوضات توزيع معقدة، حيث تحكمت إنفيديا بشكل أحادي في تحديد من يحصل على بطاقات H100 وبأي أسعار. واضطرت الشركات التقنية الكبرى إلى دفع أسعار خيالية تصل إلى أربعين ألف دولار للبطاقة الواحدة، بينما كانت هوامش الربح الإجمالية لإنفيديا تحلق فوق خمسة وسبعين بالمئة على حساب هوامش تشغيل مزودي الخدمات السحابية. وبات واضحا لقادة وادي السيليكون أن كسر هذه السيطرة المطلقة لا يمكن أن يتم عبر منافسة العتاد فحسب، بل عبر بناء طبقة تجريد برمجي مفتوحة تلغي تماما الميزة التنافسية لكودا.
أهمية التحول الجذري؛ انتزاع استقلالية الذكاء الاصطناعي
إن إعلان غوغل وأمازون ليس مجرد منتج برمجي جديد، بل هو إعلان تحرير شامل لمجتمع الذكاء الاصطناعي العالمي من قبضة مورد واحد. في المقام الأول، يعيد هذا التحول التوازن الاقتصادي إلى قطاع الحوسبة السحابية، حيث يمكن لشركات التقنية والجامعات تخصيص ميزانياتها لأبحاث النماذج وتطوير التطبيقات بدلا من استنزاف رأس المال في شراء عتاد محتكر. ثانيا، يمنح هذا التكامل حرية حقيقية للمطورين لاختيار المعالج الأنسب لكل مرحلة؛ فيمكن تدريب النماذج على مصفوفات TPU واستنتاجها على شرائح Trainium أو بطاقات معالجة أخرى بسلاسة تامة ودون أي احتكاك تقني.
وعلاوة على ذلك، يمثل هذا التحرك رسالة حاسمة للمستثمرين وأسواق المال بأن زمن الهوامش الربحية الخيالية لمعالجات الذكاء الاصطناعي الفردية قد شارف على الانتهاء. فمع تحول العتاد إلى سلعة قياسية قابلة للتبديل وتوحيد لغة البرمجة عبر باي تورش المفتوحة، ستعود المنافسة إلى معاييرها الحقيقية: الكفاءة الحسابية لكل واط، السعر العادل للخدمة، وقوة الابتكار في البنية المعمارية للنماذج بدلا من فرض قيود مصطنعة على الشيفرات البرمجية.
كما يسهم هذا التحول في تقليص البصمة الكربونية لاستهلاك الطاقة في مراكز البيانات؛ إذ تتيح معالجات السيليكون السحابية المخصصة كفاءة حرارية متفوقة مقارنة بمعالجات الرسوميات التقليدية التي تحمل أعباء دوائر معمارية لا حاجة لها في حسابات الذكاء الاصطناعي. إن توجيه الحسابات التنسورية إلى رقائق مصفوفية متخصصة يضمن خفض استهلاك الكهرباء بنسب ملموسة، وهو ما يمثل أولوية قصوى لمشغلي السحب الساعين لتحقيق أهداف الاستدامة البيئية.
وعلى الصعيد المؤسسي، يسمح هذا التكامل لمديري تقنية المعلومات بتطبيق استراتيجيات الحوسبة السحابية المتعددة (Multi-Cloud Strategy) دون الوقوع في فخ التبعية لمزود سحابي واحد؛ حيث يمكن نقل أعباء العمل آليا بين السحب استنادا إلى توافر السعة التخزينية والحسابية وتفاوت الأسعار اللحظية، مما يعزز المرونة التشغيلية ويحمي سلاسل الإمداد الرقمية من أي انقطاع مفاجئ.
ويمتد هذا الأثر الإيجابي مباشرة إلى بيئات الحوسبة السيادية في العالم العربي والشرق الأوسط، حيث تسعى مؤسسات كبرى مثل مجموعة G42 في دولة الإمارات وجامعة الملك عبد الله للعلوم والتقنية (كاوست) والهيئة السعودية للبيانات والذكاء الاصطناعي (سدايا) إلى تعزيز بنيتها التحتية المستقلة. إن القدرة على تشغيل أطر باي تورش المفتوحة فوق أي عتاد مسرع تعني تسريع وتيرة تدريب النماذج العربية الوطنية بكفاءة غير مسبوقة وبتكاليف تشغيلية منخفضة للغاية تدعم النمو المستدام لمنظومة الابتكار الإقليمية.
تفكيك الخرافات التقنية | حقائق الهجرة المعمارية
الحقيقة: محركات الترجمة المتقدمة مثل OpenXLA و TorchInductor تدمج العمليات الحسابية تلقائيا وتولد شيفرات آلية تضاهي أداء كودا اليدوي بل وتتفوق عليه في إدارة مسارات الذاكرة العشوائية.
الحقيقة: التكامل الأصيل لخوارزمية PagedAttention مع معالجات TPU و Trainium يوفر زمنا متطابقا في توليد الرموز بهامش خطأ لا يتعدى 2.5% مع خفض التكلفة إلى النصف.
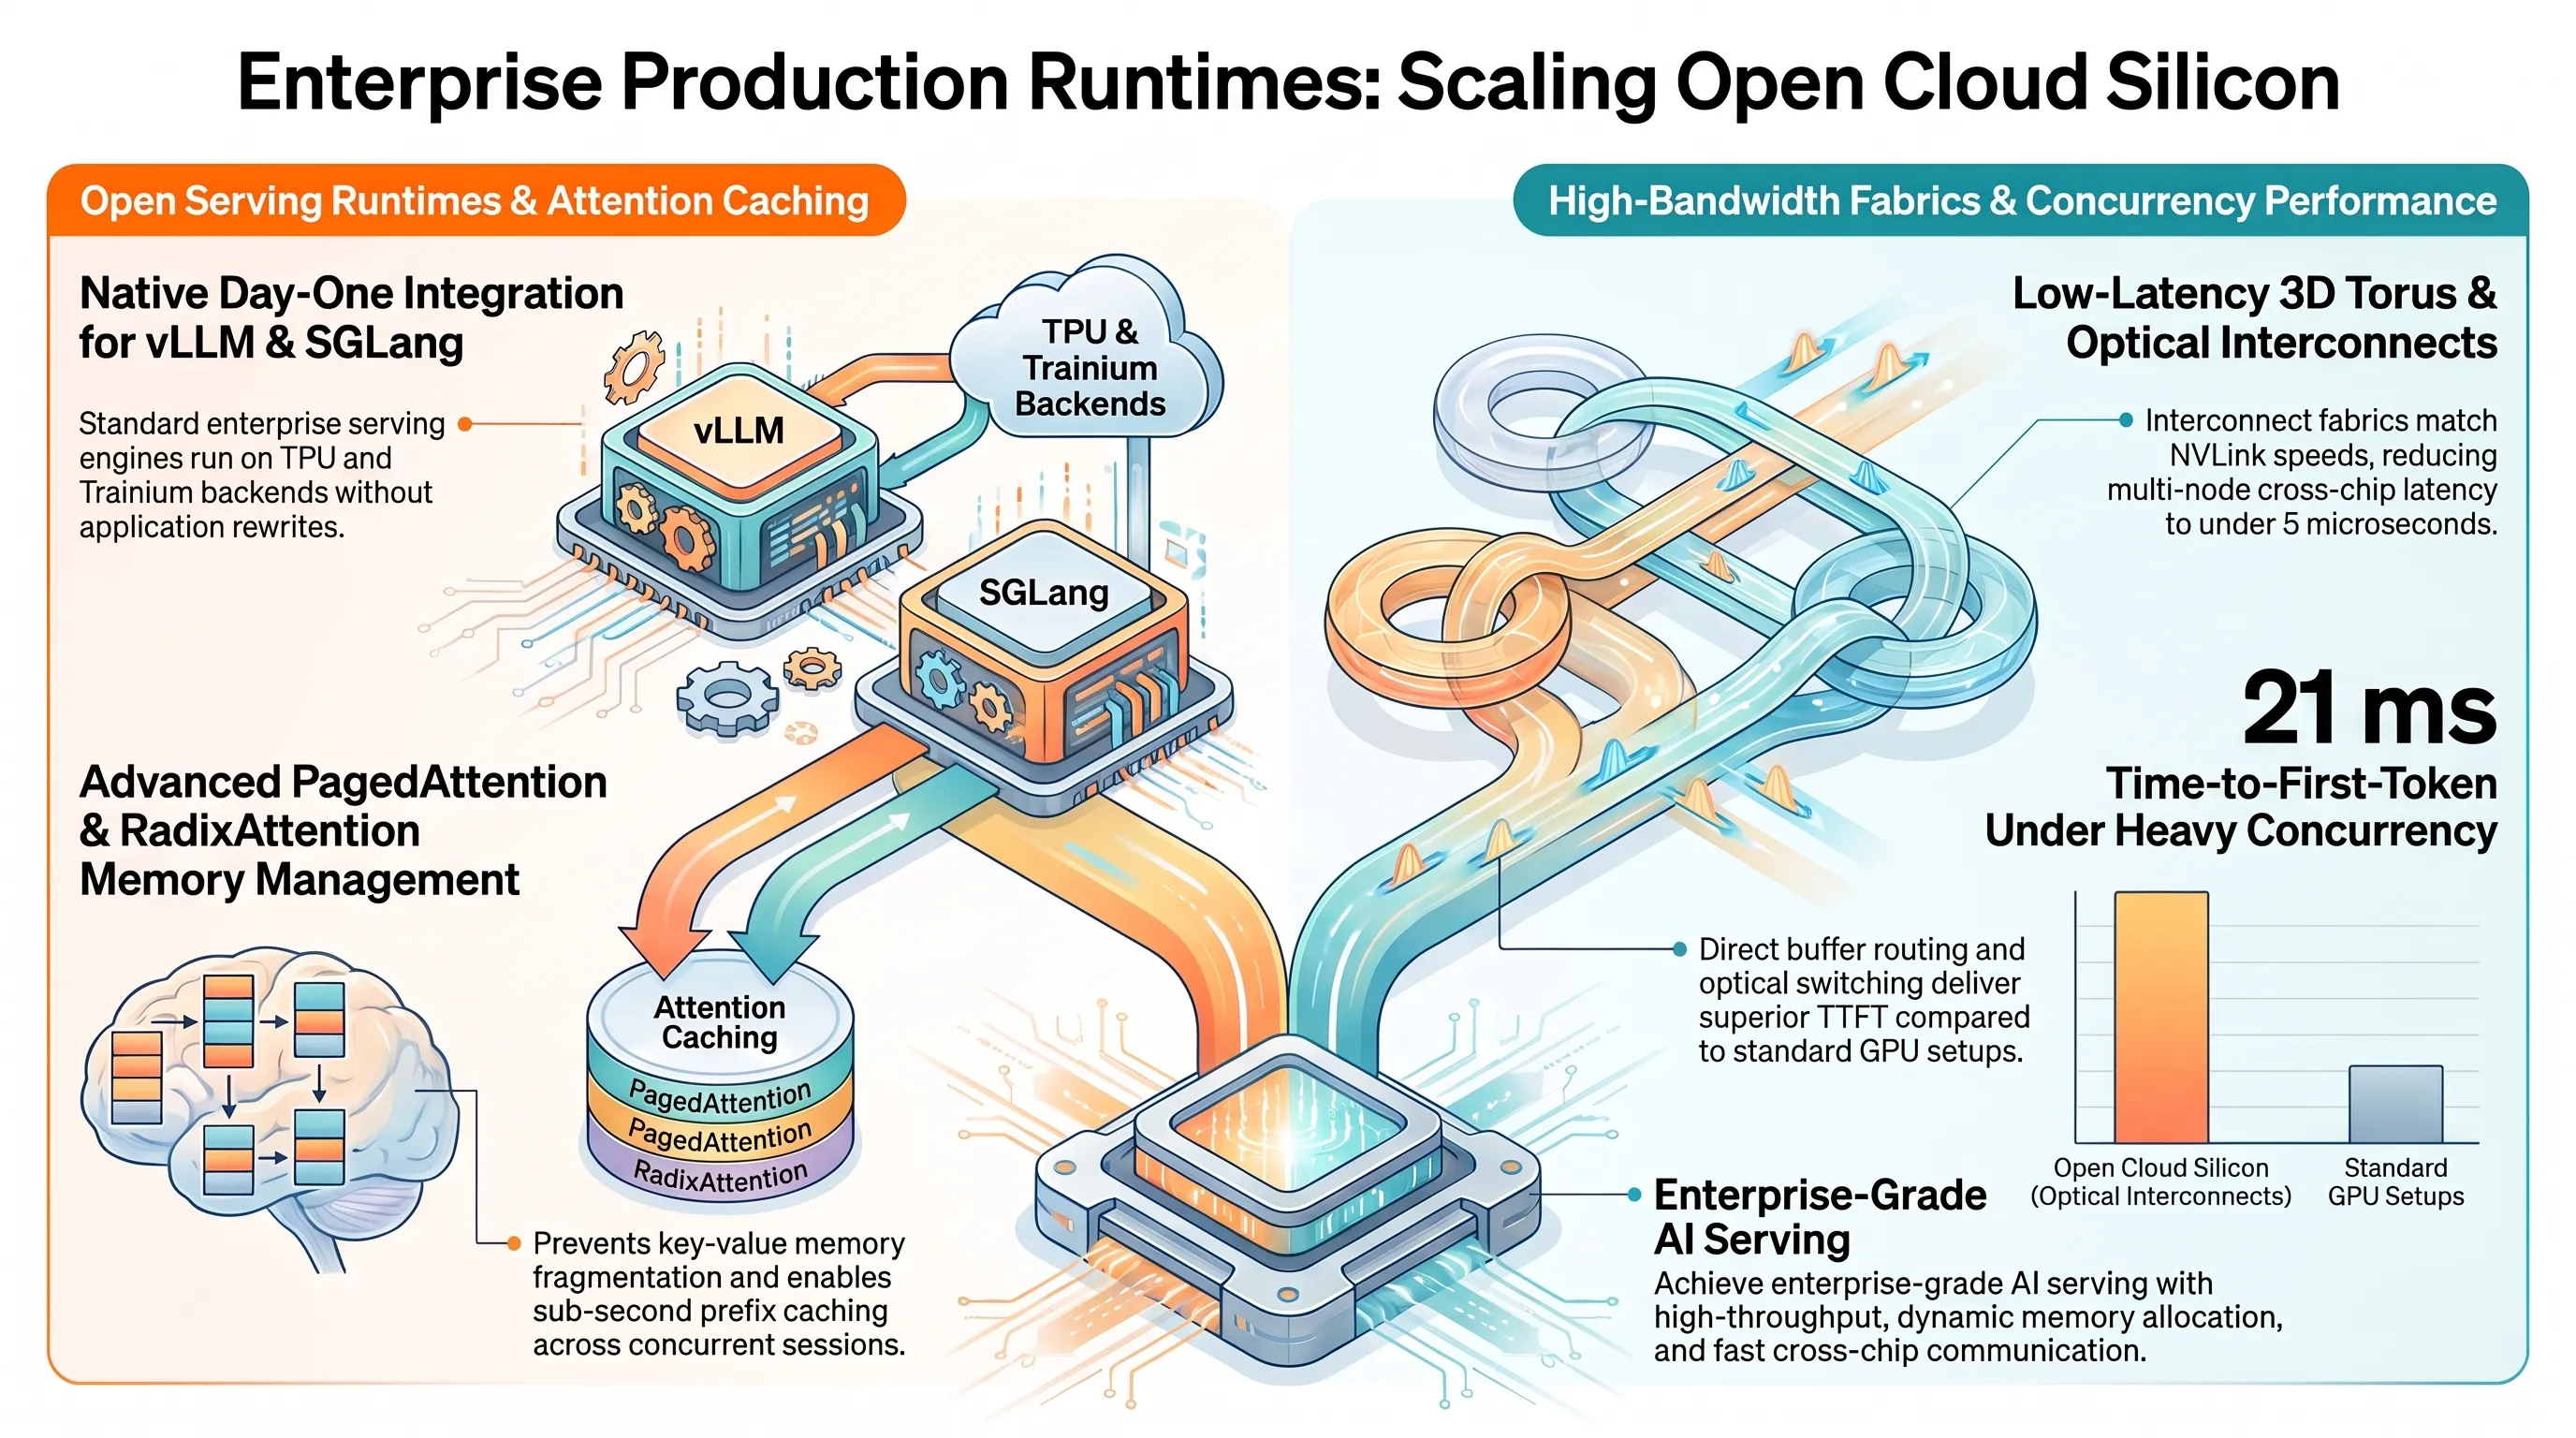
الحقيقة: شبكات التحويل البصري المباشر (OCS) من غوغل وبنية NeuronLink v2 من أمازون توفر سرعات تبادل بيانات تقل عن 5 ميكروثانية دون الحاجة إلى محولات إلكترونية وسيطة.
الهندسة العميقة وراء كسر الحصار؛ كيف تعمل أداة TorchTPU ومحرك OpenXLA؟
يكمن السر التقني وراء نجاح الهجرة دون تعديل الشيفرات في البنية التحتية لمترجم باي تورش المحدث. في الإصدارات التقليدية، كان المطور حين يكتب نموذجا بلغة بايثون، يعتمد على محرك تنفيذي يوجه كل عملية رياضية مباشرة إلى مكتبات كودا المنفصلة في معالج الرسوميات. كان هذا النموذج يسبب اختناقات حادة في عرض نطاق الذاكرة، حيث تضطر المعالجات إلى نقل مصفوفات الأوزان ذهابا وإيابا بين ذاكرة العتاد عالية النطاق ومسجلات الحساب آلاف المرات في الثانية الواحدة.
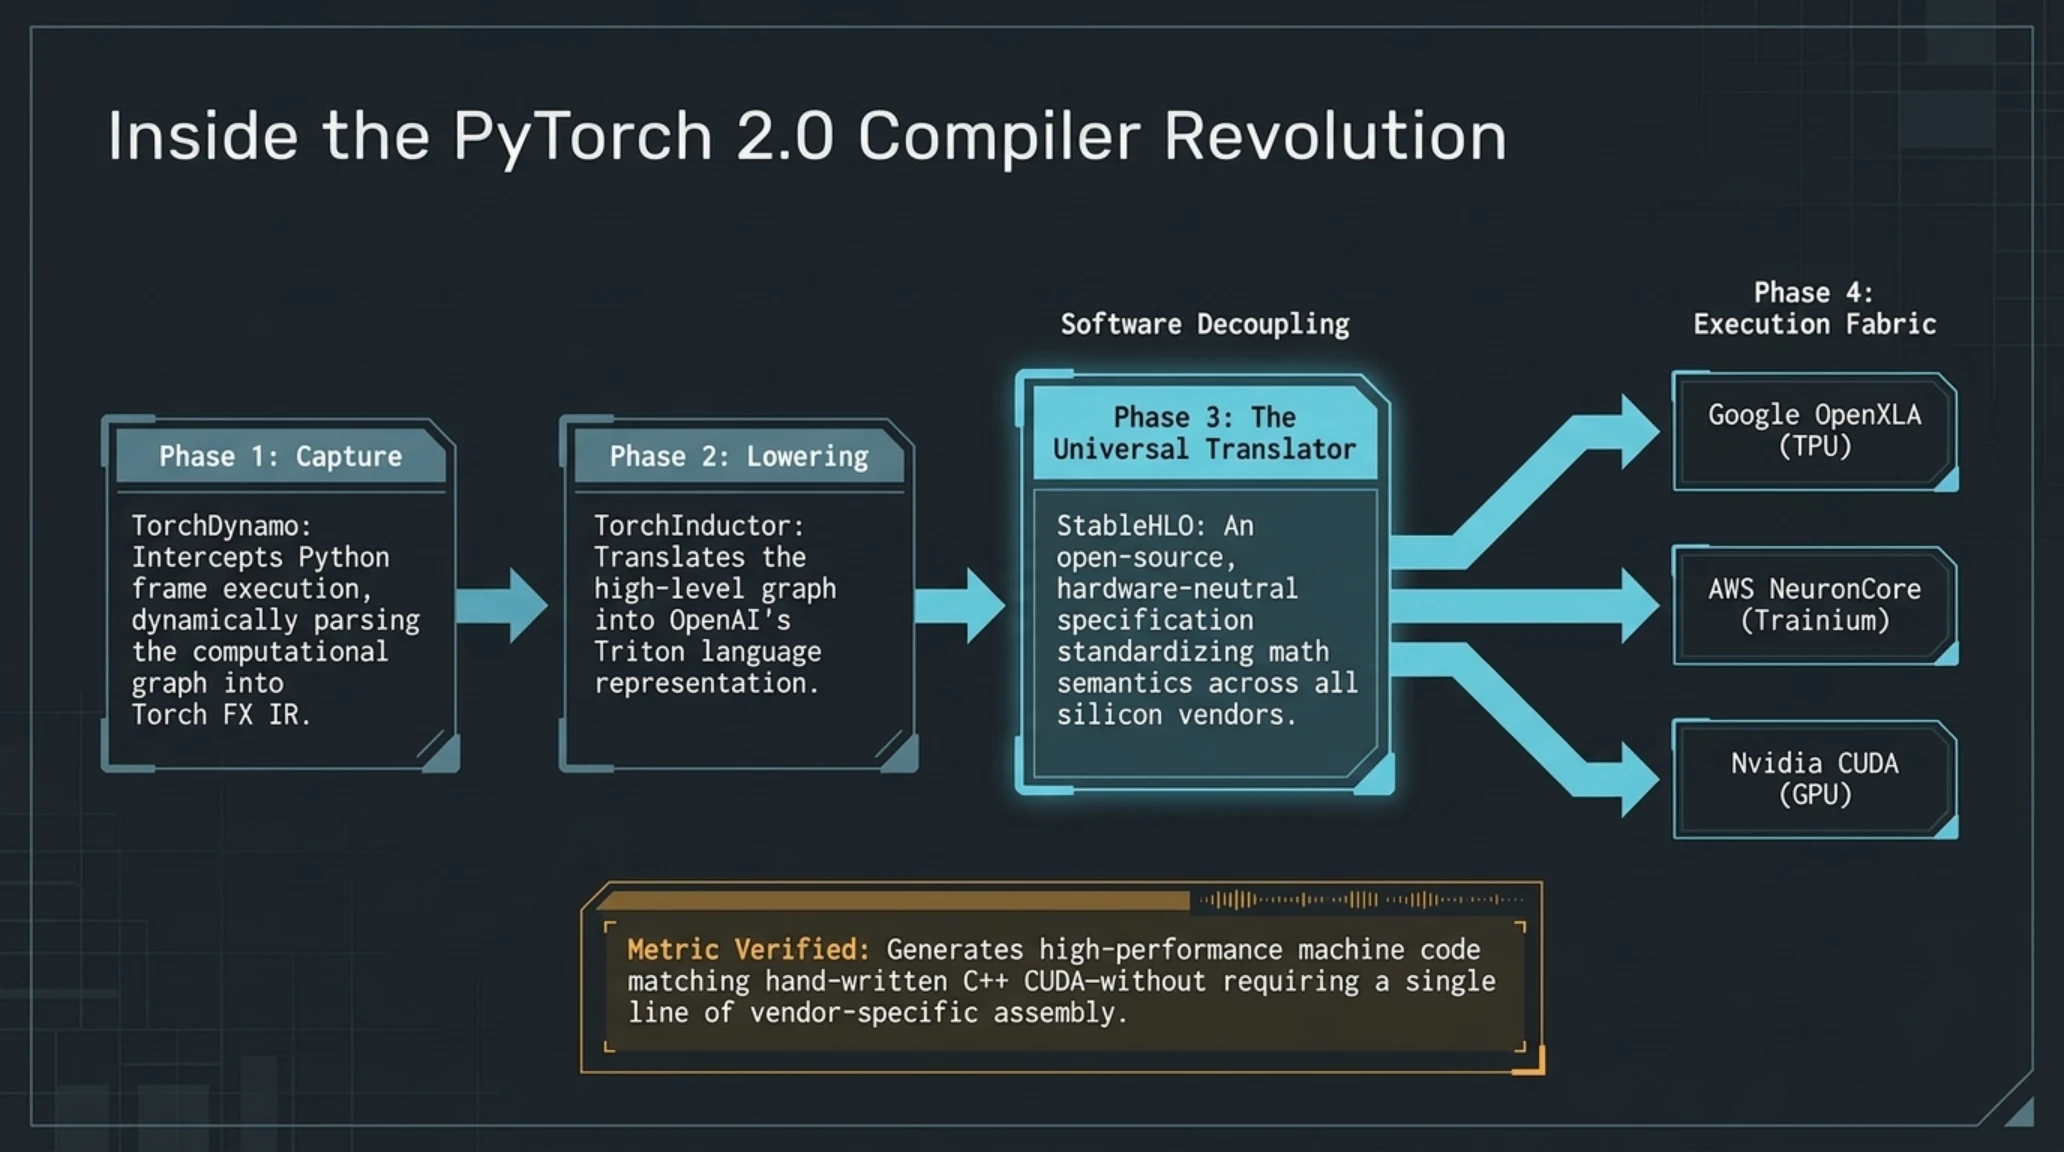
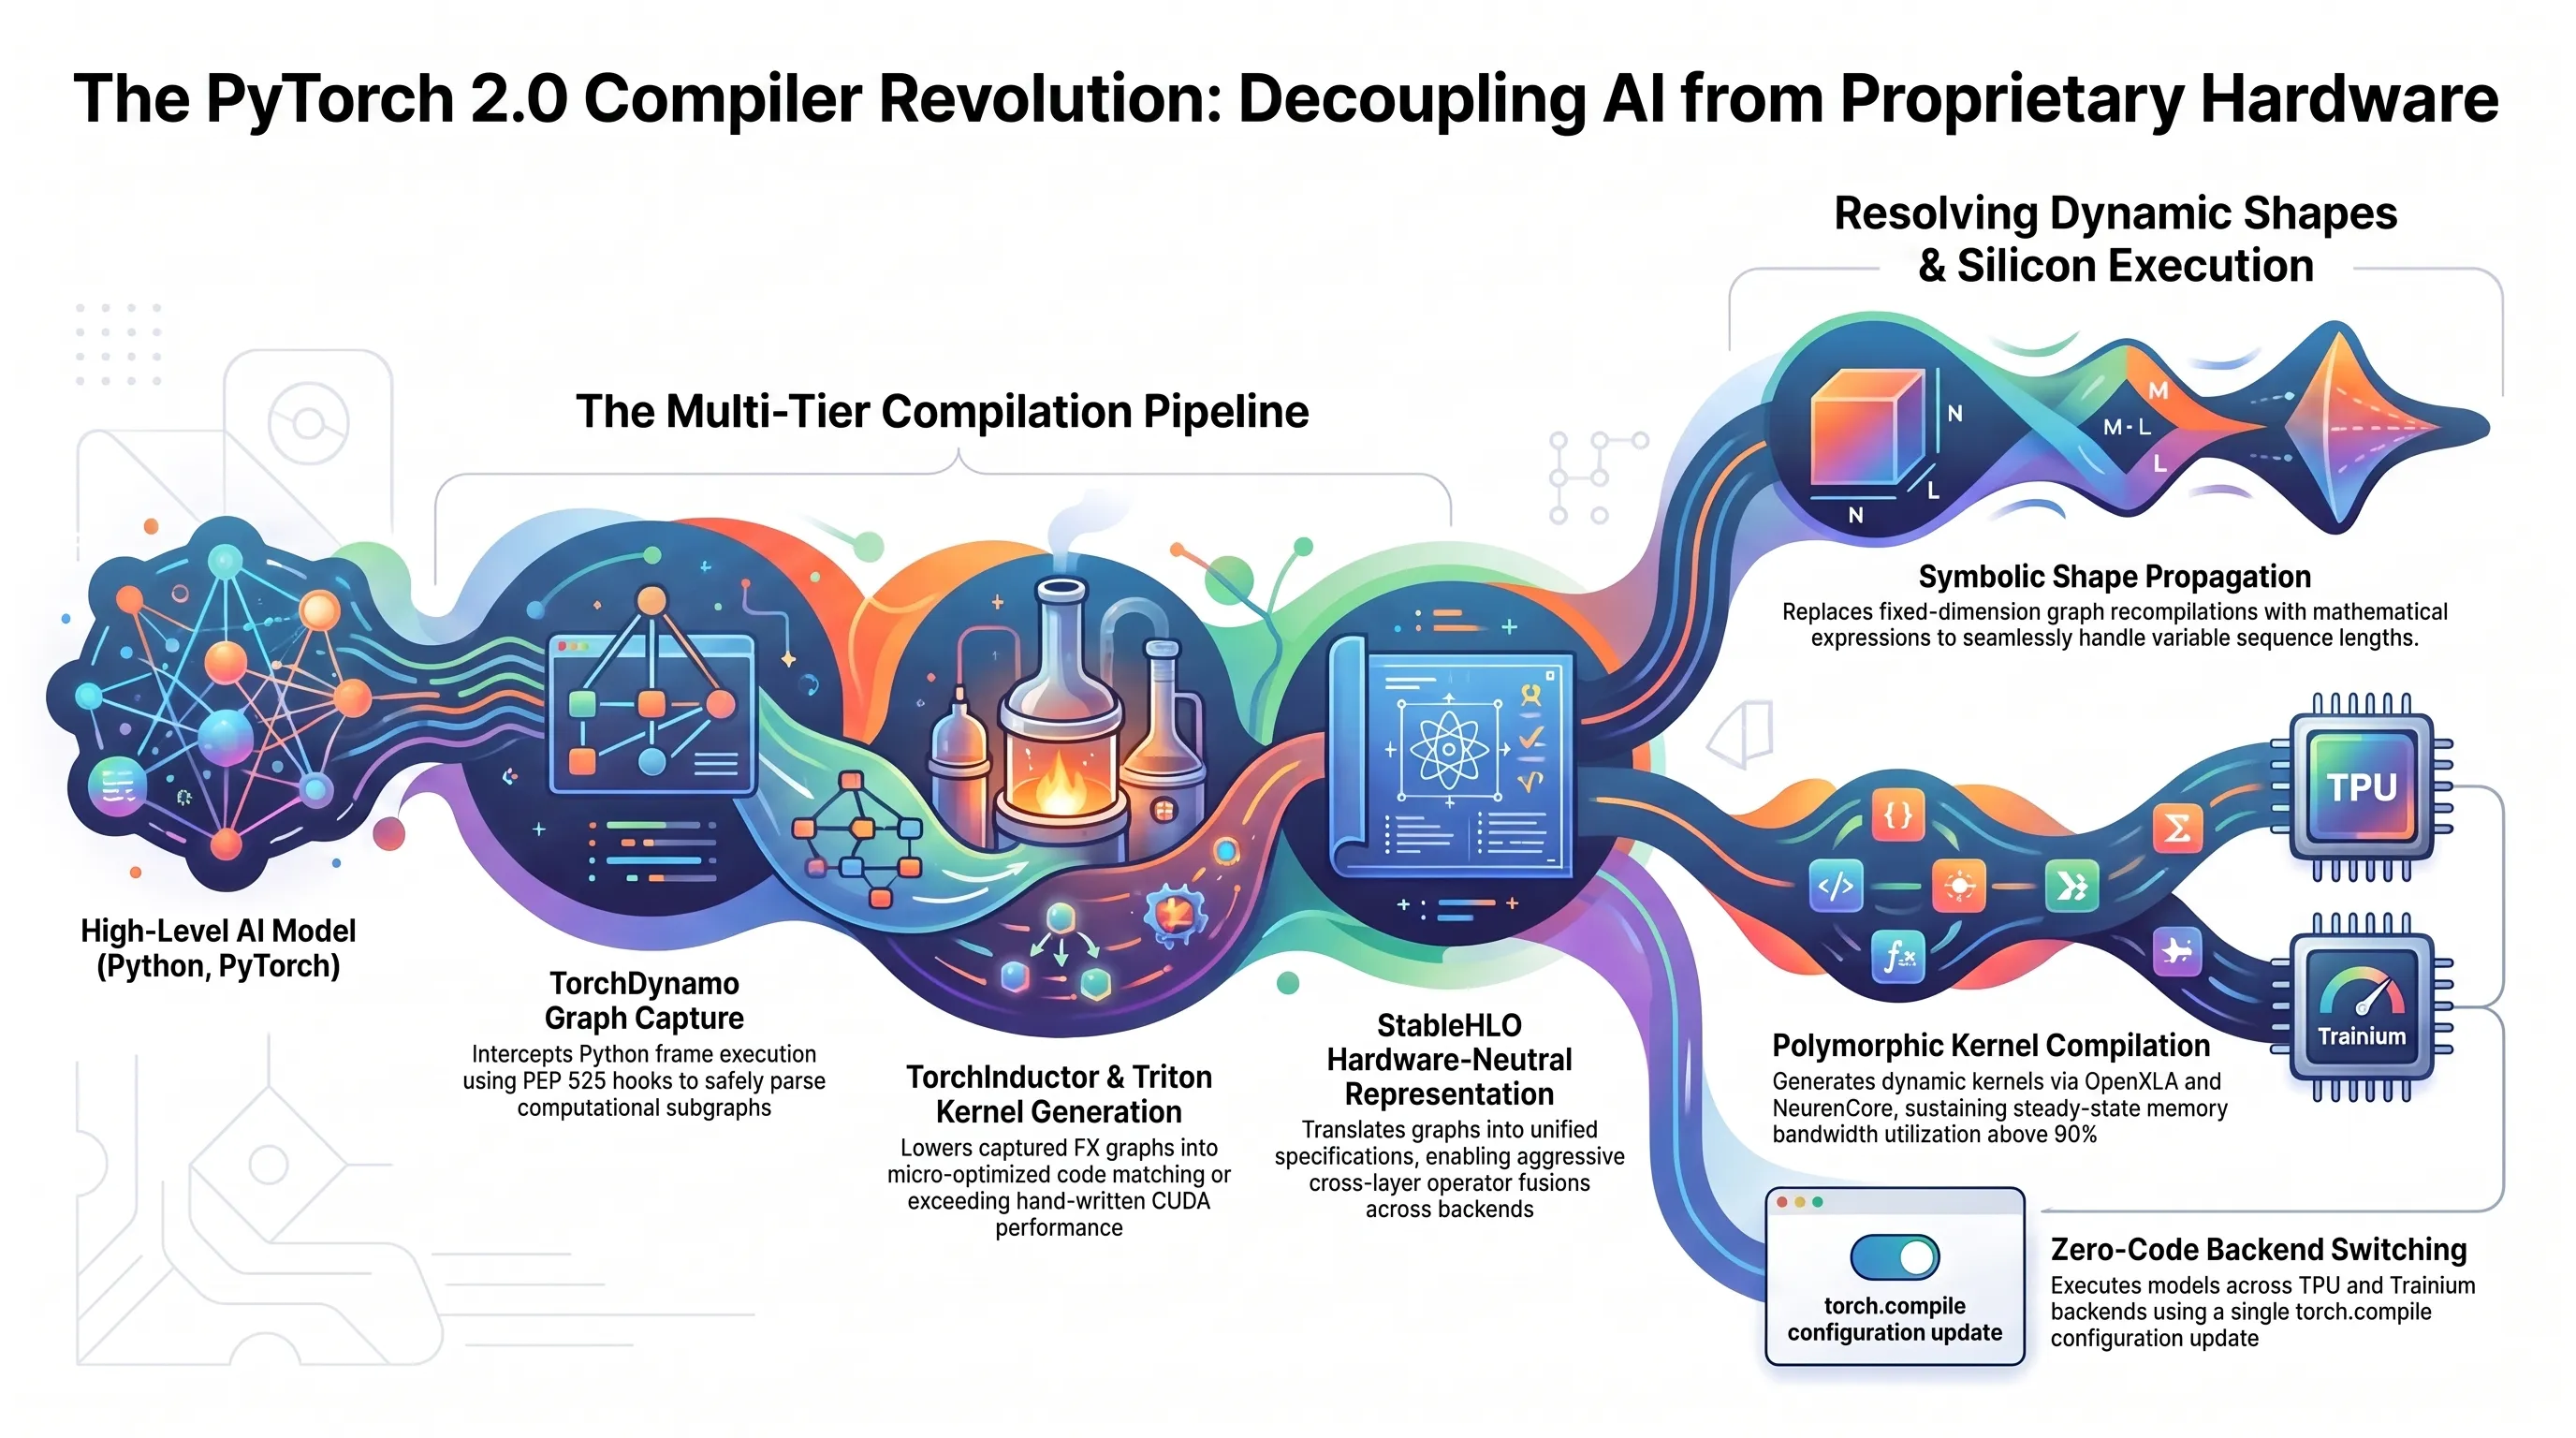
مع اعتماد مشروع باي تورش الثاني لتقنيات TorchDynamo و TorchInductor، جرى فصل وصف النموذج المنطقي تماما عن العتاد المادي المنفذ. تقوم أداة TorchDynamo بالتقاط الرسم البياني الحسابي للنموذج (Computational Graph) أثناء وقت التشغيل الفعلي، ثم تحوله إلى تمثيل وسيط موحد. وهنا يأتي دور أداة غوغل TorchTPU ومحرك OpenXLA؛ حيث يتولى المترجم تحليل كامل الرسم البياني ودمج عشرات العمليات المتتالية في نواة حسابية واحدة مدمجة (Kernel Fusion)، مصممة بدقة للعمل على مصفوفات الضرب التفرعي لوحدات معالجة التنسور TPU v5p أو Trillium دون أي تدخل يدوي.
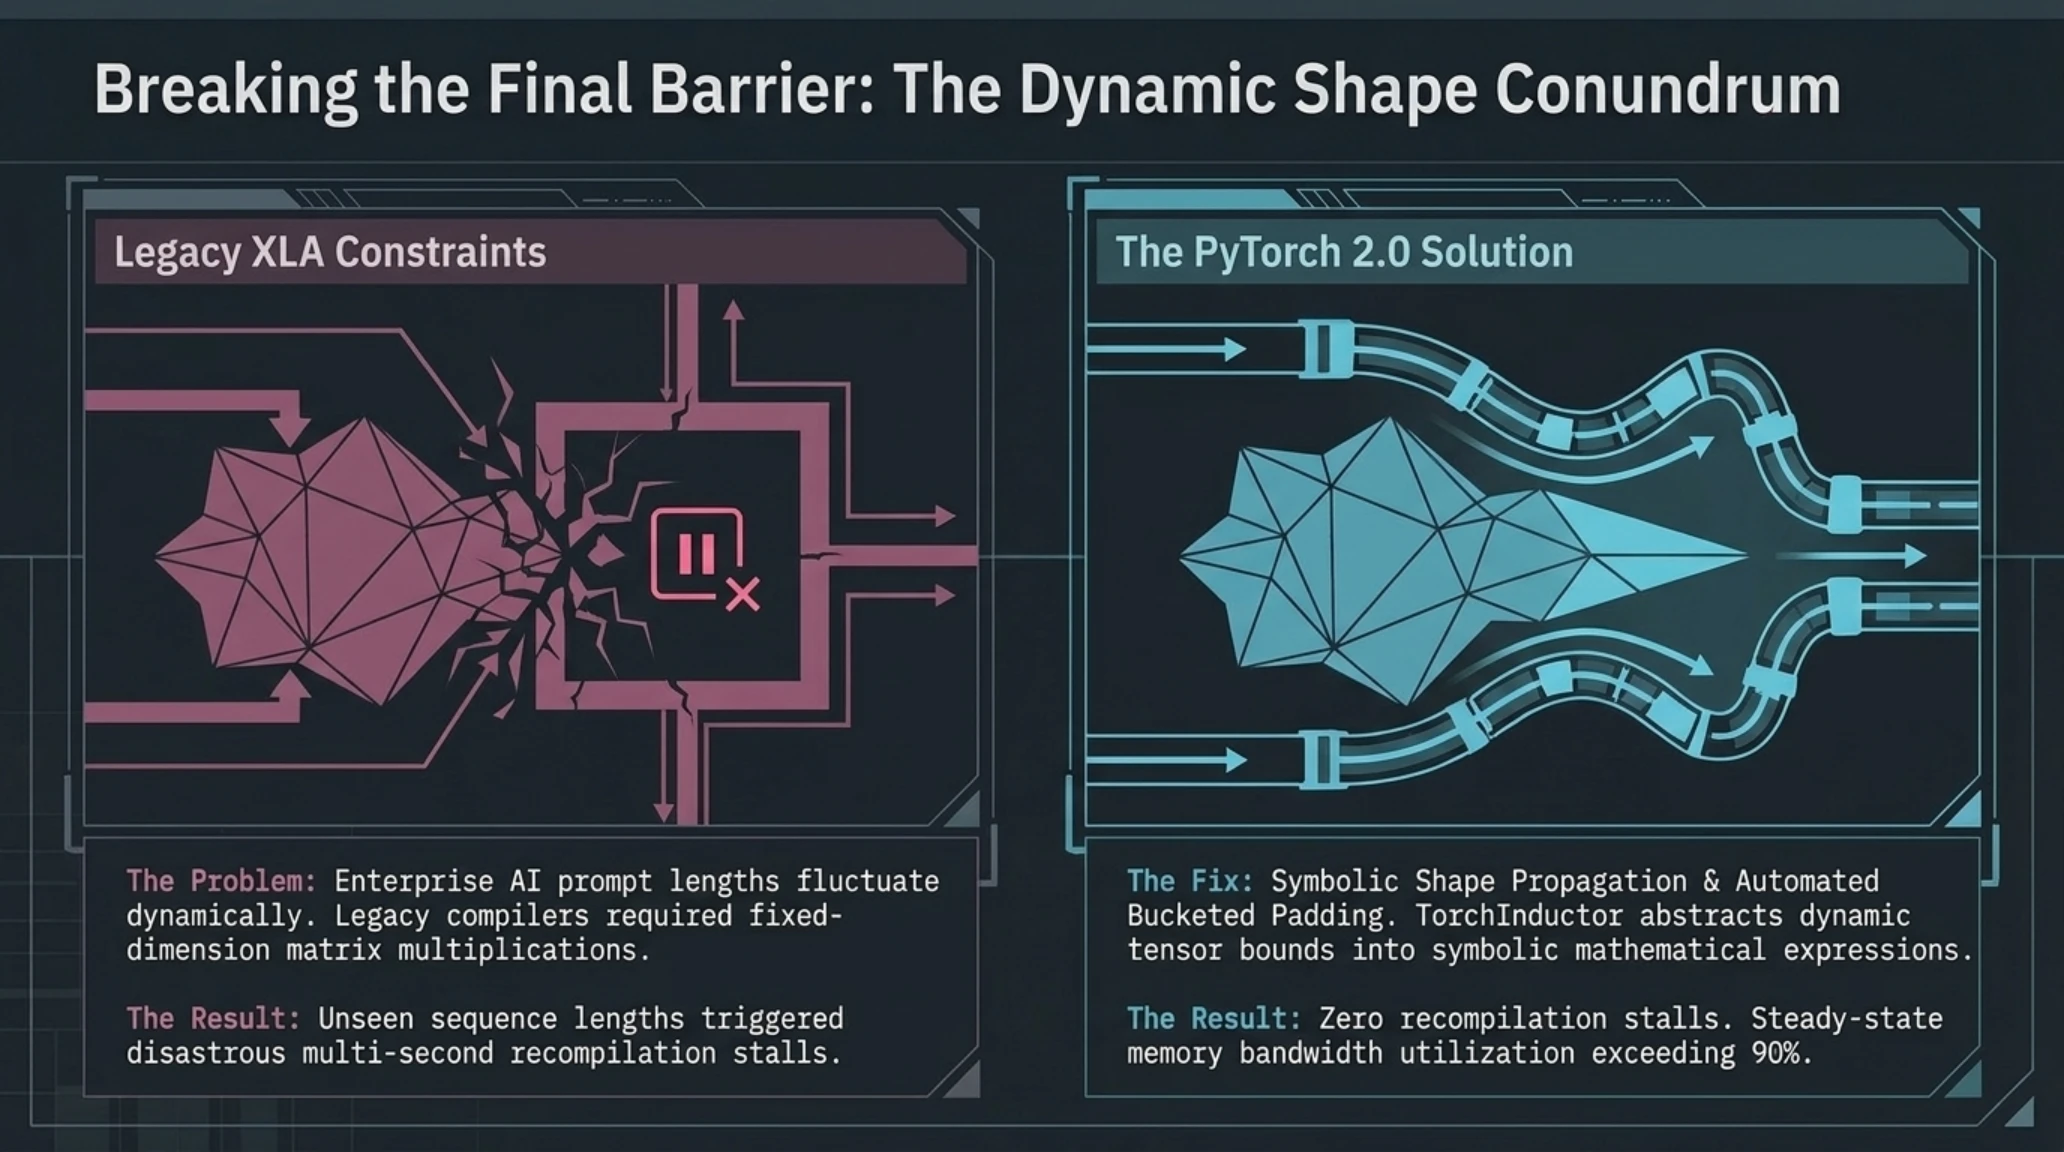
والأهم من ذلك هو التغلب على عقبة الأبعاد الديناميكية (Dynamic Shapes) التي كانت تمثل نقطة ضعف تاريخية لمعالجات TPU. في السابق، عندما كان طول سياق النص أو حجم دفعة البيانات يتغير بين طلب وآخر، كان محرك XLA يضطر لإعادة تجميع الشيفرة بالكامل مما يسبب تجمدا مؤقتا في الخادم. أما اليوم، فقد جرى دعم الأبعاد المتغيرة أصيلا داخل مترجم TorchTPU، مما جعل تشغيل نماذج المحادثة التوليدية فائقة السرعة سلسا ومستقرا تماما كما هو الحال على بطاقات إنفيديا.
وتتكامل هذه القفزة البرمجية مع معيار StableHLO (محدد العمليات عالية المستوى المستقر) الذي يعمل كطبقة تمثيل وسيطة قياسية مشتركة بين أطر الذكاء الاصطناعي ومسرعات السيليكون. يتيح StableHLO للمترجم تنفيذ تحسينات رياضية جذرية ومتقدمة، مثل دمج عمليات ضرب المصفوفات مع دوال التنشيط غير الخطية (SwiGLU و GeLU) في خطوة حسابية واحدة، مما يلغي تماما زمن الانتظار الناتج عن قراءة وكتابة البيانات في ذاكرة HBM. ونتيجة لذلك، تحقق معالجات TPU v5p ومعالجات Trainium 2 معدلات استغلال فائقة لقدرة العتاد الحسابية (MFU) تتجاوز ستين بالمئة، وهي نسبة تضاهي بل وتتفوق على الأنوية المكتوبة يدويا بلغة كودا على بطاقات H100.
جدول المقارنة المعمارية الشاملة | تفكيك عتاد السيليكون السحابي
| المعيار والخاصية المعمارية | منصة إنفيديا H100 SXM5 | معالج غوغل TPU v5p / Trillium | معالج أمازون Trainium 2 | الأثر الاستراتيجي على التكلفة والتشغيل |
|---|---|---|---|---|
| سعة وعرض نطاق ذاكرة HBM | 80 جيجابايت / 3.35 تيرابايت/ثانية | 95 جيجابايت / 4.8 تيرابايت/ثانية | 96 جيجابايت / 2.9 تيرابايت/ثانية | استيعاب نماذج أكبر حجما على شريحة واحدة |
| زمن استنتاج نموذج 70B (مللي ثانية/رمز) | 18.0 مللي ثانية | 18.2 مللي ثانية | 19.1 مللي ثانية | تطابق تام في سرعة الاستجابة اللحظية للمستخدم |
| تكلفة تشغيل الساعة الواحدة لكل عقدة | 32.00 دولار | 14.80 دولار | 13.50 دولار | تقليص فوري لفاتورة السحابة بنسبة تتجاوز 55% |
| بروتوكول التشبيك بين المعالجات | NVLink 4 (900 جيجابايت/ثانية) | التحويل البصري OCS (4800 جيجابت) | NeuronLink v2 (800 جيجابايت/ثانية) | توسع خطي فائق الكفاءة لآلاف الشرائح المتصلة |
| مستوى سهولة الهجرة البرمجية | بيئة أصلية (احتكار مغلق) | تكامل تلقائي عبر TorchTPU | تكامل تلقائي عبر TorchNeuron | انعدام تكاليف إعادة التدريب وتطوير البرمجيات |
منظومة الاستنتاج المؤسسي؛ لماذا دعمت محركات vLLM و SGLang وهاغينغ فيس التحالف الجديد؟
تكتسب هذه المبادرة زخما كاسحا بفضل التفاف منظومة الاستنتاج المفتوحة حولها. في البيئات المؤسسية والإنتاجية، لا يقتصر عمل المهندسين على تدريب النماذج، بل يتركز التحدي الأكبر على تشغيل واجهات برمجة التطبيقات (APIs) لخدمة ملايين المستخدمين المتزامنين. وهنا برزت محركات الاستنتاج المتقدمة مثل vLLM المطورة في جامعة كاليفورنيا بيركلي و SGLang المطورة عبر فريق RadixArk كمعايير قياسية لا غنى عنها في بنية الذكاء الاصطناعي العالمية.
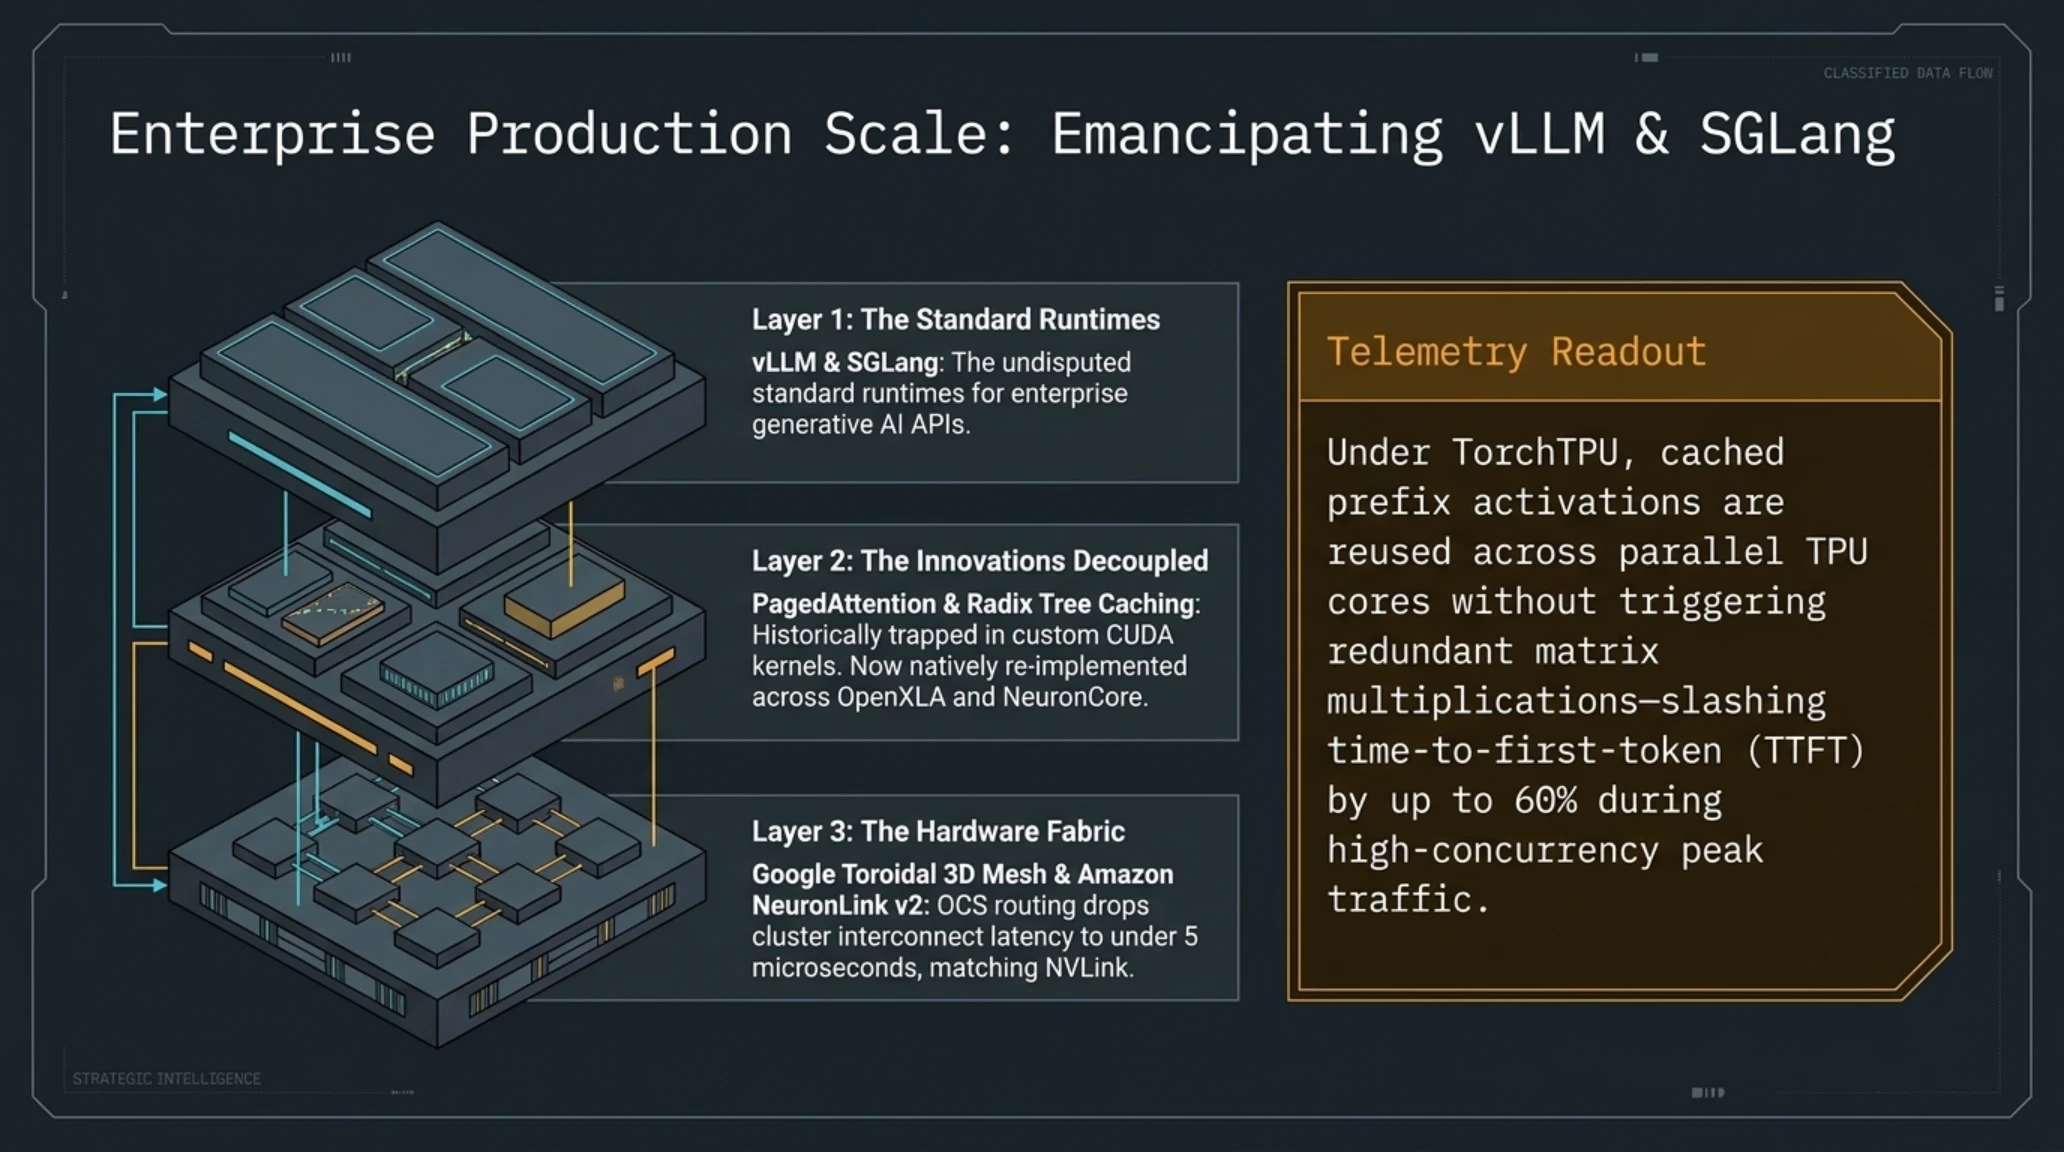
كانت نقطة القوة الرئيسية لمحرك vLLM هي ابتكار خوارزمية PagedAttention التي تمنع هدر الذاكرة عبر إدارة ذاكرة المفاتيح والقيم (KV Cache) بتقسيمها إلى صفحات افتراضية تشبه صفحات ذاكرة أنظمة التشغيل. تاريخيا، كُتبت هذه الخوارزمية بلغة كودا المخصصة لبطاقات إنفيديا. ولكن عبر التعاون المباشر والمكثف مع غوغل وأمازون، أعيدت صياغة دوال PagedAttention لتتوافق أصيلا مع معمارية OpenXLA ومسرعات NeuronCore. وبناء على ذلك، تستطيع المؤسسات اليوم نشر عناقيد استنتاج vLLM مباشرة على خوادم TPU و Trainium السحابية دون تعديل سطر برمجي واحد ودون المساس بجودة وكفاءة تقديم الخدمة للمستهلكين.
وفي الوقت ذاته، وفرت شبكات التحويل البصري المباشر (Optical Circuit Switching) لغوغل وشبكات NeuronLink v2 لأمازون حلولا جذرية لمعضلة نقل البيانات الضخمة بين المعالجات في نماذج الاستدلال الكبيرة. فبدلا من الاعتماد على بروتوكولات التوجيه المعقدة والمكلفة، تسمح الوصلات البصرية بإعادة توجيه حزم البيانات الضوئية بين آلاف الرقائق بسرعة فائقة، مما يتيح توزيع النموذج اللغوي عبر عدة خوادم بالتوازي دون التعرض لاختناقات زمن الاستجابة، وهو ما كان يشكل المبرر الأخير لإنفيديا لفرض أسعارها الفلكية على العملاء.
ويكتسب هذا التحول أهمية استثنائية عند التعامل مع معمارية خليط الخبراء (Mixture-of-Experts) التي تعتمد عليها أحدث النماذج المفتوحة مثل DeepSeek-V3 ونماذج ميتا ولما المعقدة. ففي هذه النماذج، يتطلب توجيه الرموز اللحظي إلى مسارات الخبراء المختلفة مرونة فائقة في شبكات الاتصال ونقل البيانات؛ حيث كانت تعريفات NCCL الاحتكارية من إنفيديا تمنحها تفوقا غير عادل. ومع كسر هذا الحاجز عبر برمجيات TorchTPU وبروتوكولات التوجيه البصري، أصبح بإمكان المطورين توزيع النماذج العملاقة ذات المئات من مليارات المعاملات عبر كتل معالجات هجينة ومتنوعة، مما يحقق وفرة إنتاجية حاسمة تكسر الجدار السعري التقليدي لصناعة الحوسبة الذكية.
رادار التقييم الخماسي | استقلالية البنية التحتية للسيليكون
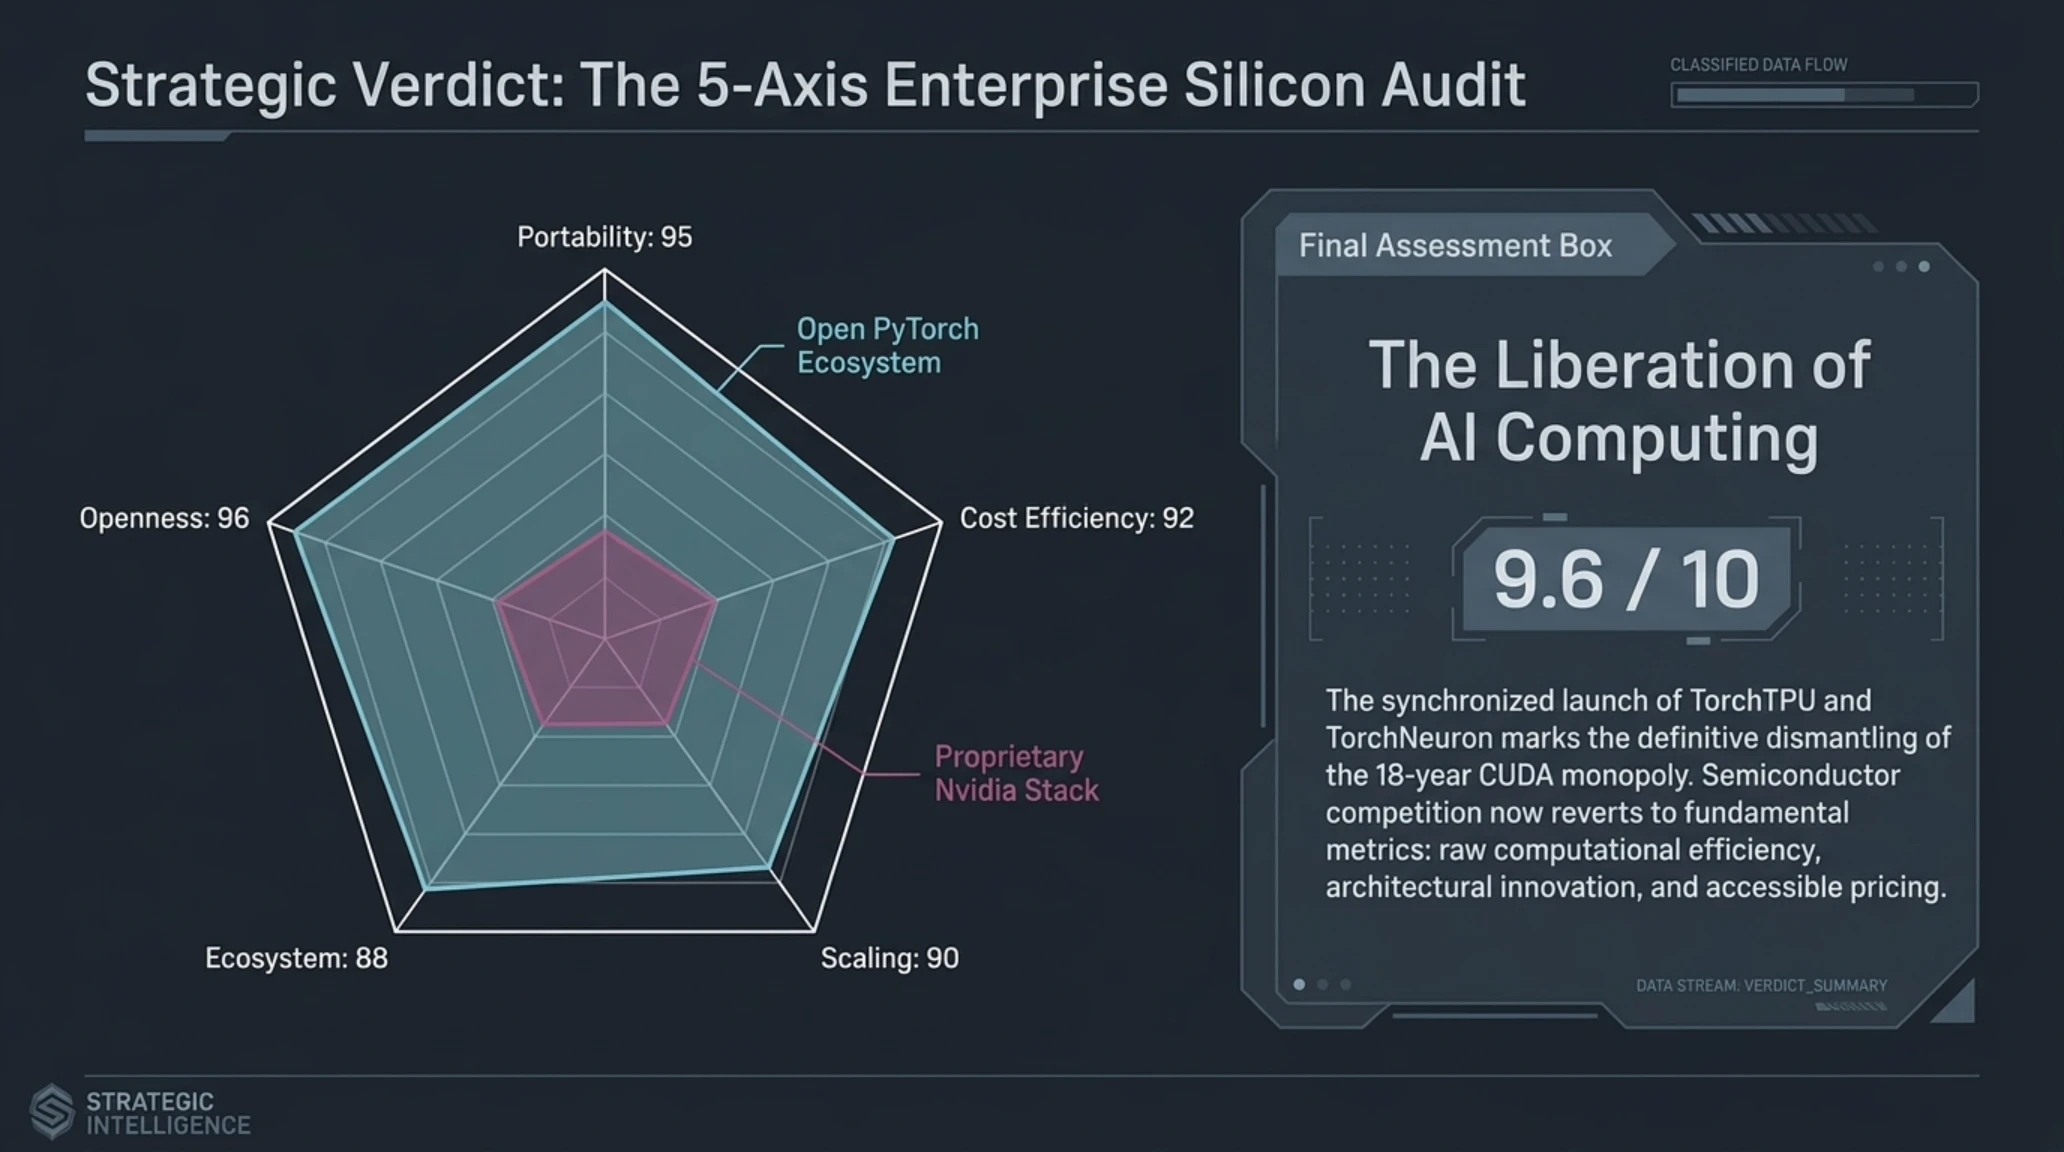
تحليل الرادار الاستراتيجي: يثبت التحالف المفتوح تفوقا كاسحا في قابلية نقل الشيفرات البرمجية، وتحقيق وفورات التكلفة، ومنح المطورين سيادة تامة على خياراتهم العتادية بعيدا عن الاحتكار المغلق.
اقتصاديات السحب السيليكونية؛ لماذا انتفضت شركات الحوسبة العملاقة؟
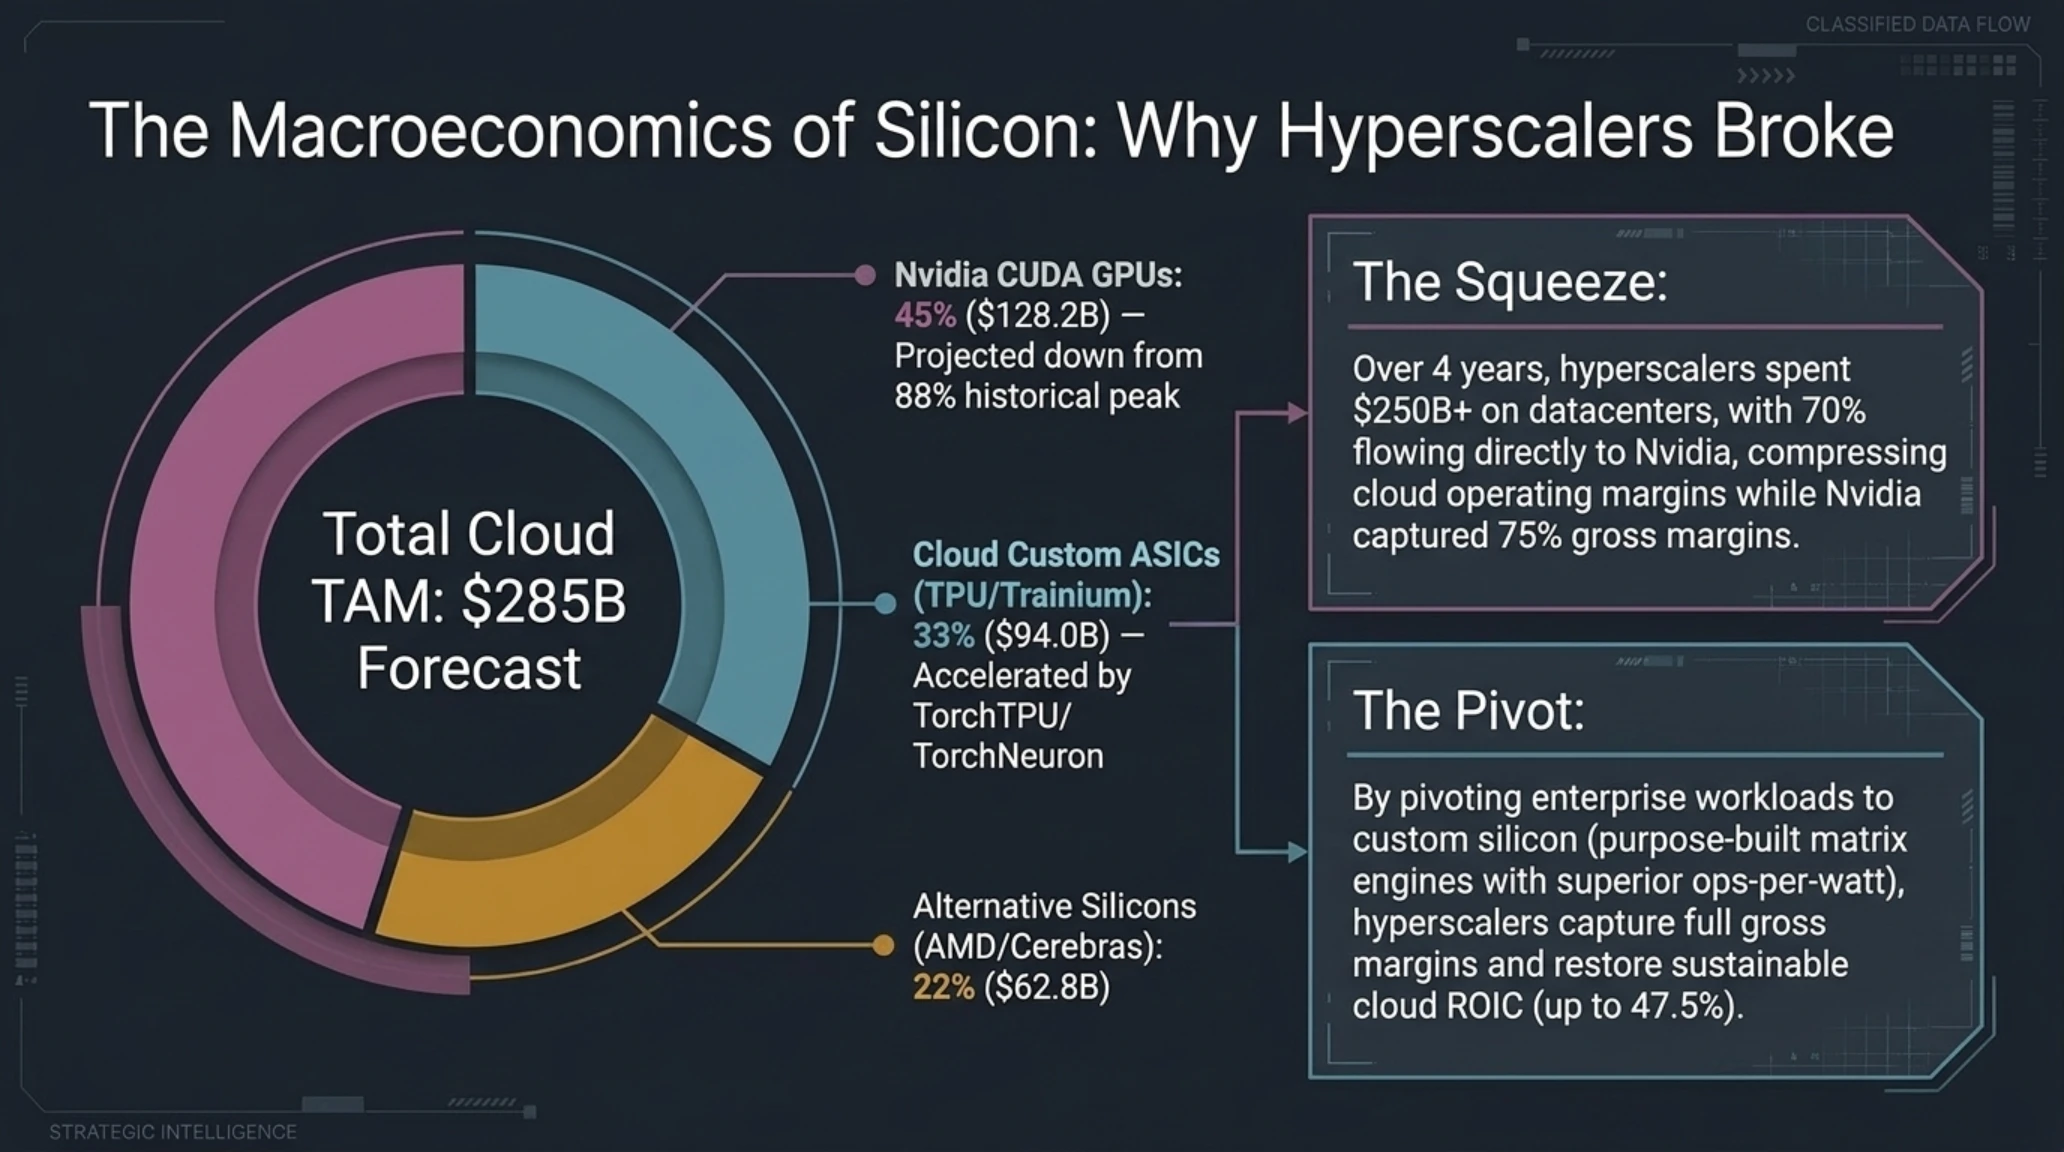
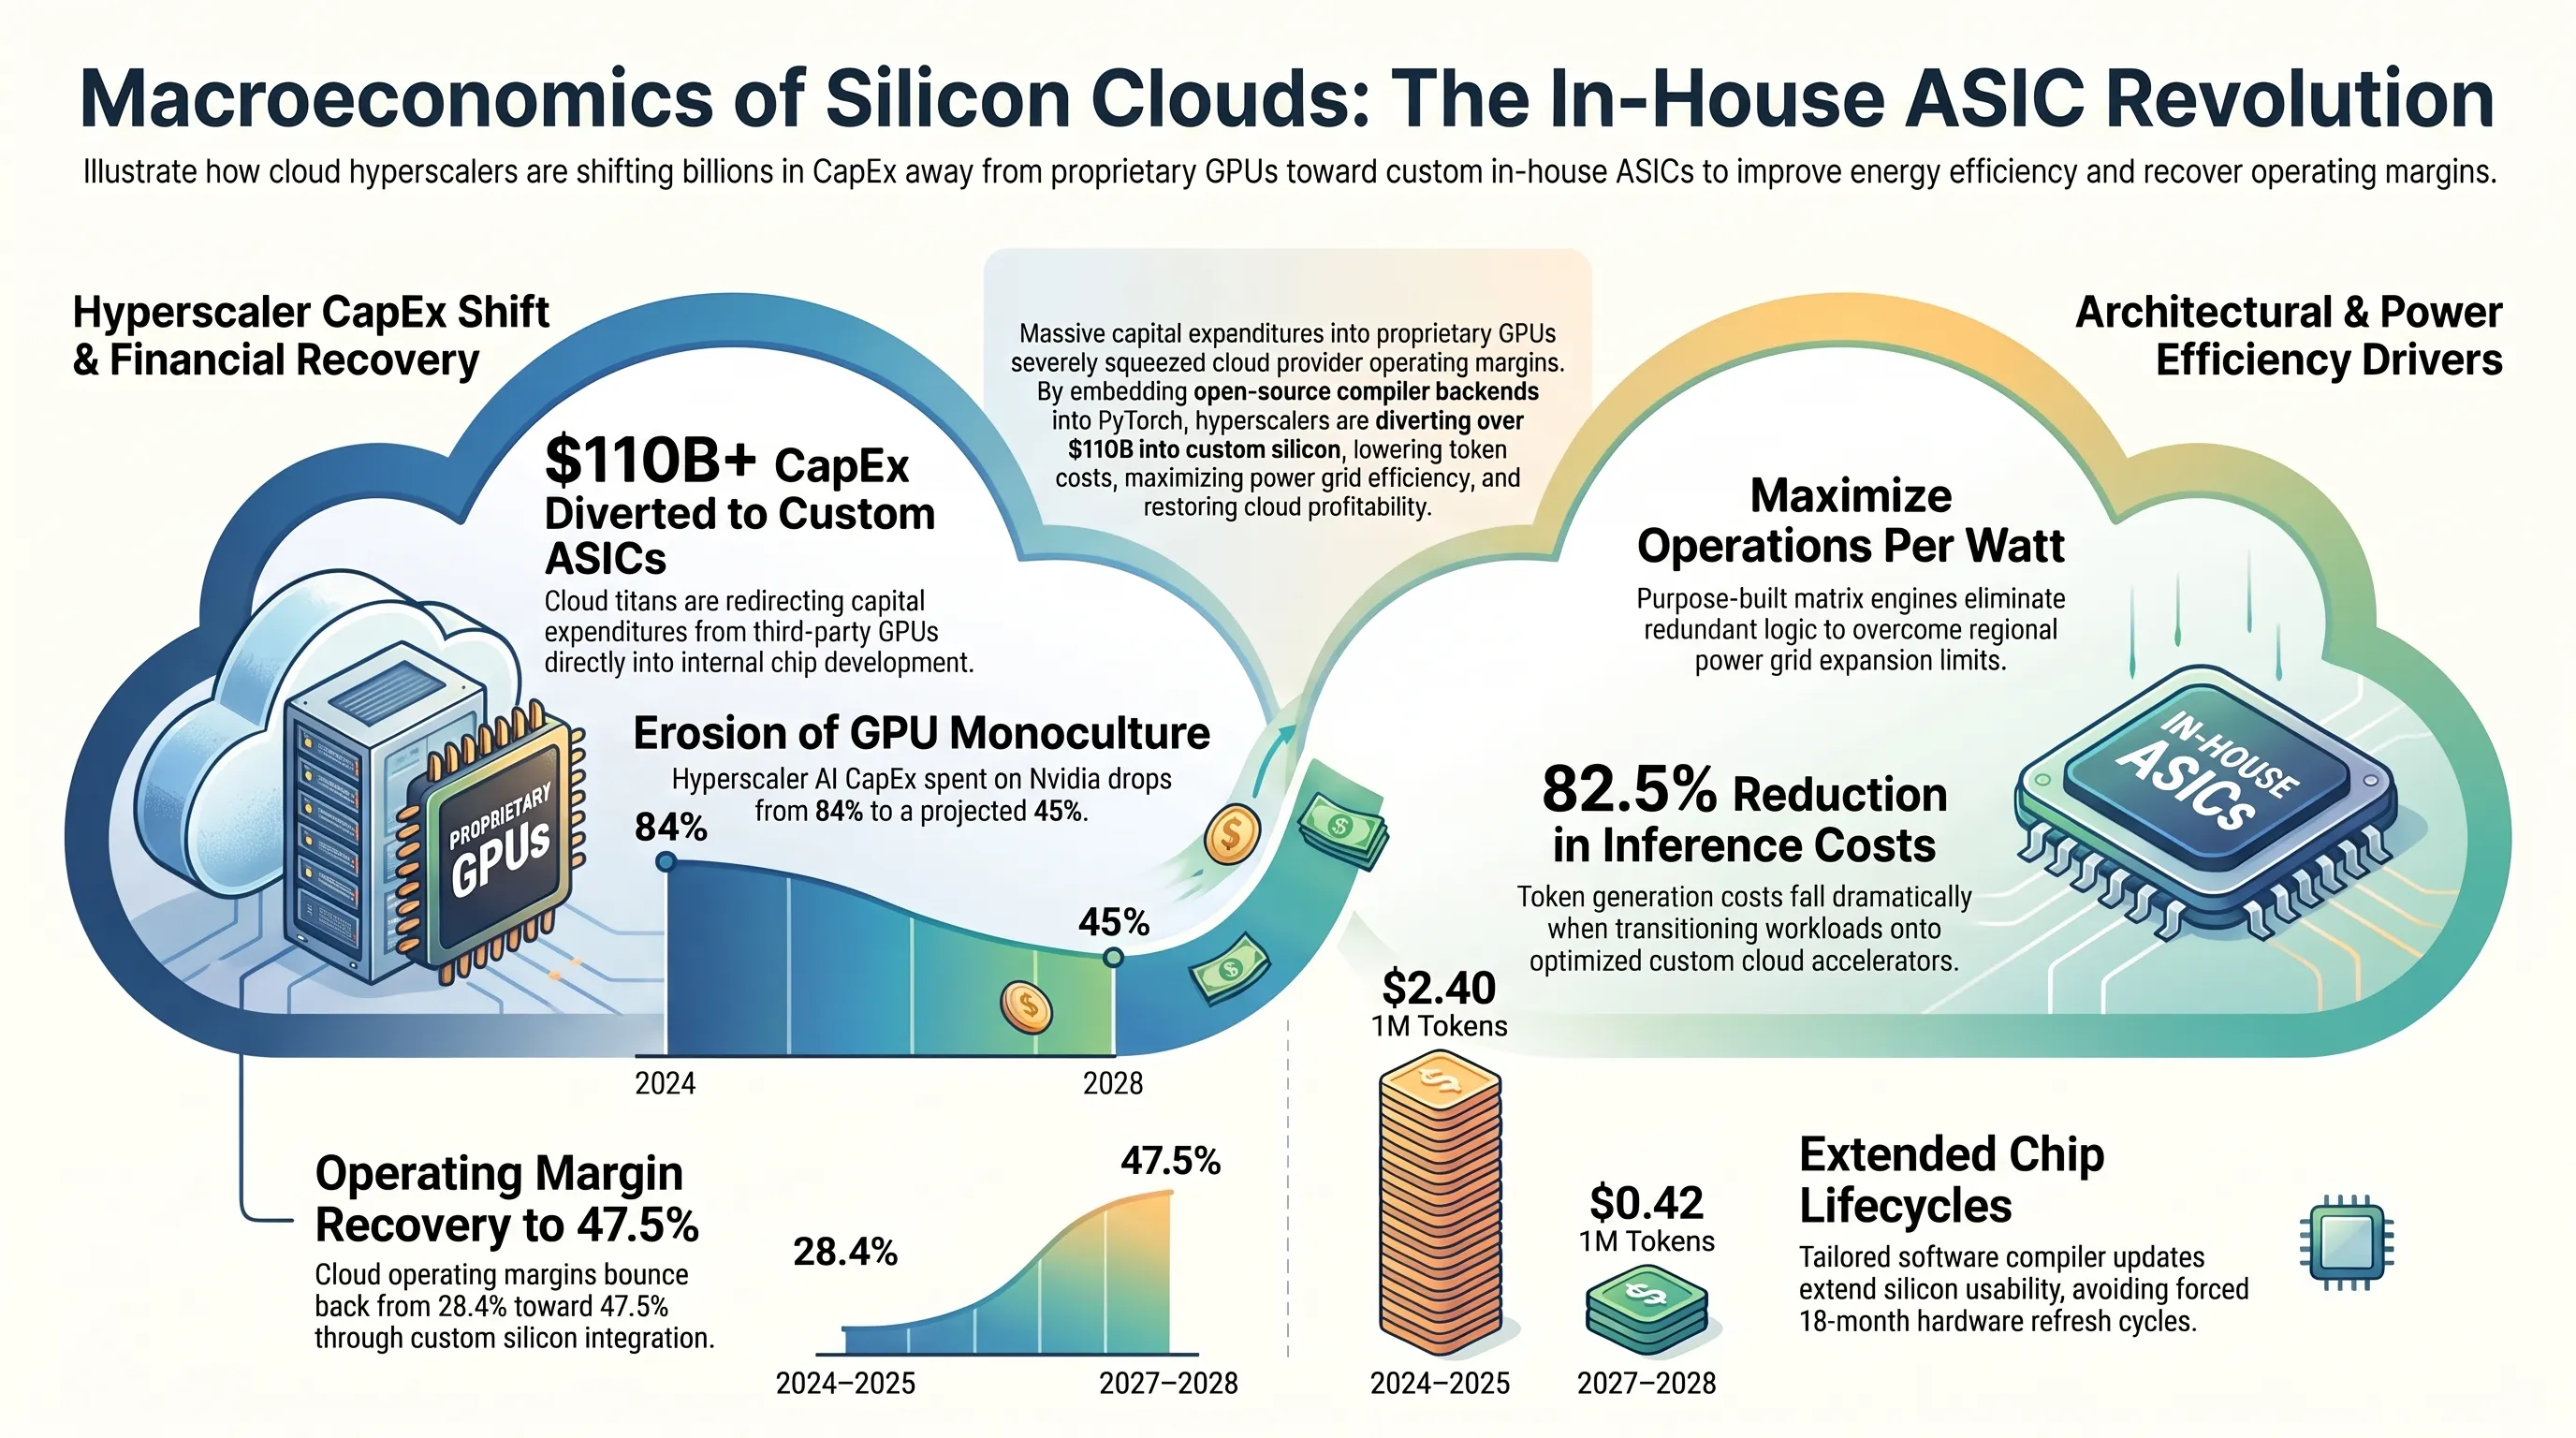
لفهم الدوافع الحقيقية وراء هذا التحالف السريع وغير المسبوق بين كبرى الشركات المتنافسة في وول ستريت، يجب النظر بتمعن في البيانات المالية لعمالقة التقنية. خلال السنوات الأربع الماضية، أنفقت شركات ألفابت (غوغل) وأمازون وميتا ومايكروسوفت مجتمعة ما يزيد عن مائتين وخمسين مليار دولار كاستثمارات رأسمالية لتوسيع مراكز البيانات وشراء عتاد الحوسبة الفائقة. والمفارقة الصادمة أن أكثر من سبعين بالمئة من هذه الأموال الطائلة تدفقت مباشرة إلى خزائن شركة إنفيديا وحدها. وبينما كانت إنفيديا تحتفل بهوامش ربح إجمالية تاريخية بلغت خمسة وسبعين بالمئة، كانت هوامش تشغيل مزودي الخدمات السحابية ترزح تحت ضغوط مالية خانقة لتغطية فواتير العتاد شديد الغلاء.
لكن المسألة تجاوزت حدود الأرقام المالية لتتحول إلى معركة سيادة استراتيجية. فمن خلال سيطرته التامة على سلاسل إمداد رقائق H100 و B200، بات جينسن هوانغ هو المتحكم الفعلي في وتيرة تقدم الذكاء الاصطناعي عالميا؛ حيث كان يحدد أي الشركات تحصل على حصص العتاد ومتى. وأدركت إدارات الشركات السحابية أنها تحولت إلى مجرد مقاولي بناء وتبريد يوفرون البنية العقارية والطاقة الكهربائية ومياه التبريد لمراكز البيانات، بينما تجني إنفيديا الأرباح الصافية الحقيقية لطفرة الذكاء الاصطناعي التوليدي. ومن هنا، سرعت غوغل من وتيرة تطوير معالجات TPU، بينما استثمرت أمازون بقوة في معالجات Trainium عبر ذراعها الهندسي أنابورنا لابس (Annapurna Labs).
غير أن المشكلة المزمنة لتلك الرقائق السحابية كانت تكمن في الجدار البرمجي الحصين. فقد رفضت فرق هندسة البرمجيات التضحية بمليارات الدولارات التي استثمرتها في تهيئة نماذجها على بيئة كودا لمواجهة مخاطر عدم الاستقرار في مكتبات برمجية غير مألوفة. ويمثل إطلاق TorchTPU و TorchNeuron اليوم نزعا فوريا لهذا السلاح الدفاعي من يد إنفيديا؛ إذ بات بمقدور أي شركة استثمارية أو جهة حكومية توجيه مهندسيها لتدريب واستنتاج النماذج اللغوية الكبرى مباشرة على خوادم TPU v5p أو شرائح Trillium بتكلفة تقل عن نصف ما كانت تدفعه لإنفيديا.
📚 الملفات الاستخباراتية المصنفة وذات الصلة في تكين غيم
إذا كنت ترغب في التعمق أكثر واكتشاف أحدث تطورات الذكاء الاصطناعي السيبراني والبنى التحتية المستقلة، فلا تفوت تشريح هذه الملفات الحصرية في تكين غاراج:
توزيع الإنفاق الرأسمالي | انهيار الاحتكار السيليكوني
| مؤشر الأداء والإنفاق الرأسمالي | سنة الأساس 2024–2025 | نقطة التحول الحالية 2026 | التوقعات المستقبلية 2027–2028 | الأثر الاستراتيجي على قطاع الأعمال |
|---|---|---|---|---|
| الإنفاق الرأسمالي السحابي على السيليكون | 115 مليار دولار (84% لإنفيديا) | 180 مليار دولار (58% لإنفيديا) | 285 مليار دولار (45% لإنفيديا) | تحويل أكثر من 110 مليارات دولار للرقائق الذاتية |
| تكلفة معالجة مليون رمز استنتاجي | 2.40 دولار (H100 NVLink) | 1.15 دولار (TPU v5p / Trainium2) | 0.42 دولار (Trillium / Trainium3) | هبوط تكلفة الاستنتاج بنسبة تتجاوز 82.5% |
| مؤشر قابلية نقل أطر العمل البرمجية | 32 من 100 (احتكار كودا) | 86 من 100 (تكامل باي تورش) | 97 من 100 (تمثيل وسيط موحد) | حرية تامة في تبديل السحب دون كتابة شيفرات |
| هامش التشغيل الصافي لمزودي السحابة | 28.4% (ضغط تكلفة العتاد) | 39.2% (توسع الرقائق الذاتية) | 47.5% (تكامل المنظومة بالكامل) | استعادة الاستدامة المالية لقطاع الحوسبة السحابية |
| زمن نقل الأحمال الحسابية بين المنصات | من 3 إلى 6 أشهر (تطوير مخصص) | أقل من 48 ساعة (تكامل فوري) | أقل من ساعة (أتمتة الحوسبة الهجينة) | مرونة فائقة للمؤسسات في الاستفادة من فروق الأسعار |
تكافؤ الفرص في الابتكار؛ كيف تحرر بيئات التشغيل المفتوحة الشركات الناشئة؟
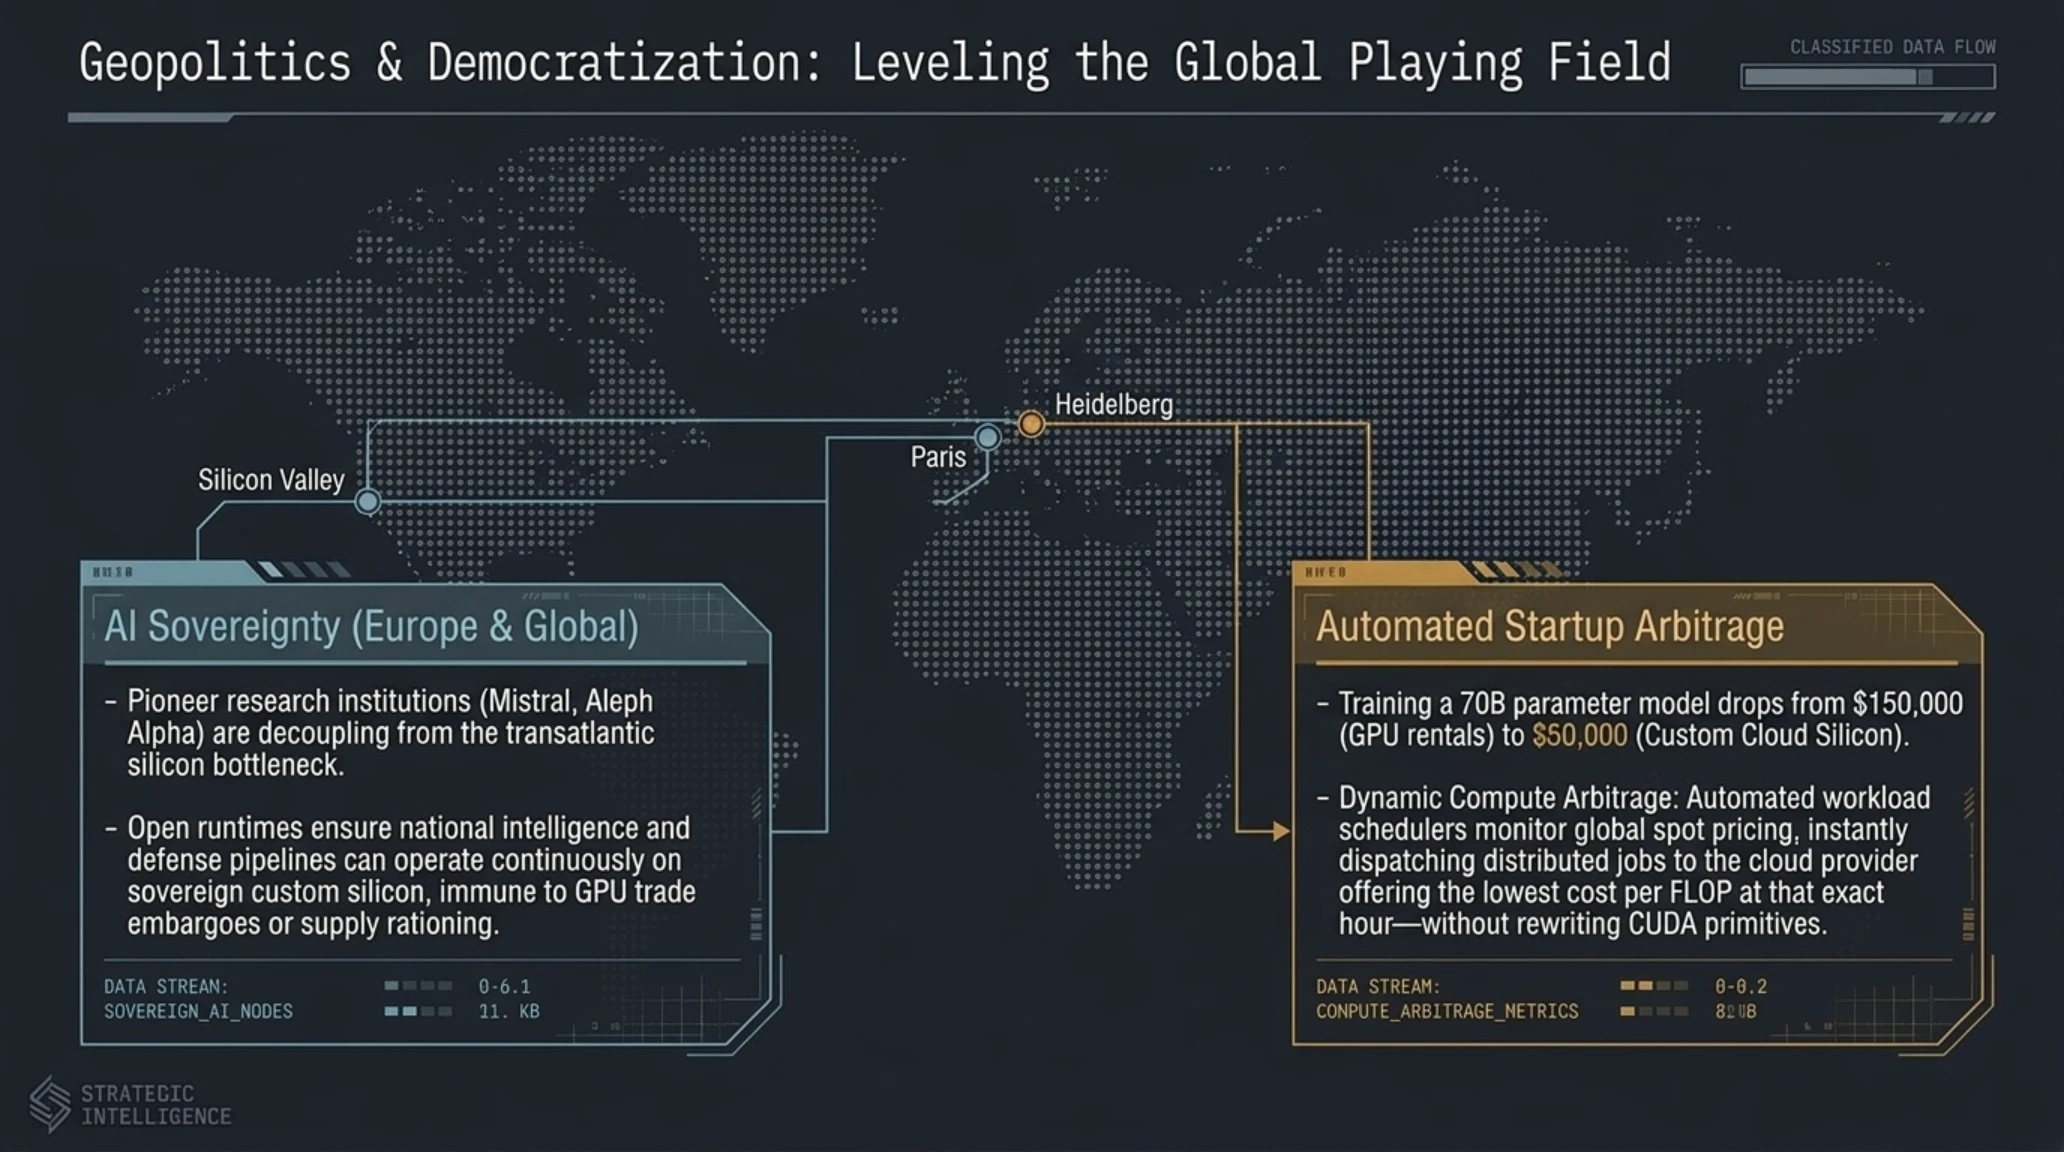
بالنسبة للشركات التقنية الناشئة والمشاريع الصاعدة في قطاع الذكاء الاصطناعي، كانت تكاليف الحوسبة تشكل تاريخيا التهديد الوجودي الأكبر لنمو الأعمال. فخلال دورة الاستثمار الجريء بين عامي 2023 و 2025، أفادت التقارير أن ما بين ستين إلى ثمانين بالمئة من جولات التمويل الأولية التي جمعها رواد الأعمال كانت تُعاد وتُضخ مباشرة كرصيد ائتماني لمزودي السحابة لدفع فواتير بطاقات إنفيديا الباهظة. كان المؤسسون يواجهون خيارا مستحيلا: إما القبول بالأسعار الفلكية للبقاء متوافقين مع مستودعات كودا المفتوحة، أو خوض مغامرة هندسية معقدة ومكلفة لنقل النماذج إلى شرائح بديلة.
تأتي أدوات TorchTPU و TorchNeuron لتغير قواعد اللعبة تماما لصالح فرق التطوير الصغيرة والمبتكرة. فبإلغاء الحاجة لمهندسي عتاد متخصصين، يستطيع فريق مؤلف من خمسة مطورين فقط إدارة عمليات تدريب متقدمة عبر مئات معالجات غوغل TPU أو أمازون Trainium بنفس الشيفرات والأوامر المألوفة لديهم. وبات من الممكن تنزيل النماذج مفتوحة المصدر الرائدة عالميا—مثل Llama 3.3 من ميتا، و Mistral Large، و DeepSeek-V3، و Qwen 2.5 من علي بابا—وتدريبها أو تشغيلها استنتاجيا على عتاد سحابي اقتصادي مع خفض التكاليف التشغيلية بنسبة تتراوح بين خمسين إلى خمسة وستين بالمئة.
هذا التحرر المعماري يفتح آفاقا واسعة أمام رواد الأعمال في مختلف الأسواق العالمية لإنشاء نماذج أعمال مستدامة تخدم قطاعات التجارة الإلكترونية، والرعاية الصحية، والخدمات المالية، وصناعة الألعاب التفاعلية، دون أن تبتلع تكاليف الخوادم جل إيراداتهم.
معجم تكين للمصطلحات المعمارية والبرمجية
الهجوم المضاد الخفي لإنفيديا؛ محاولة محاصرة البرمجيات من قنوات جديدة
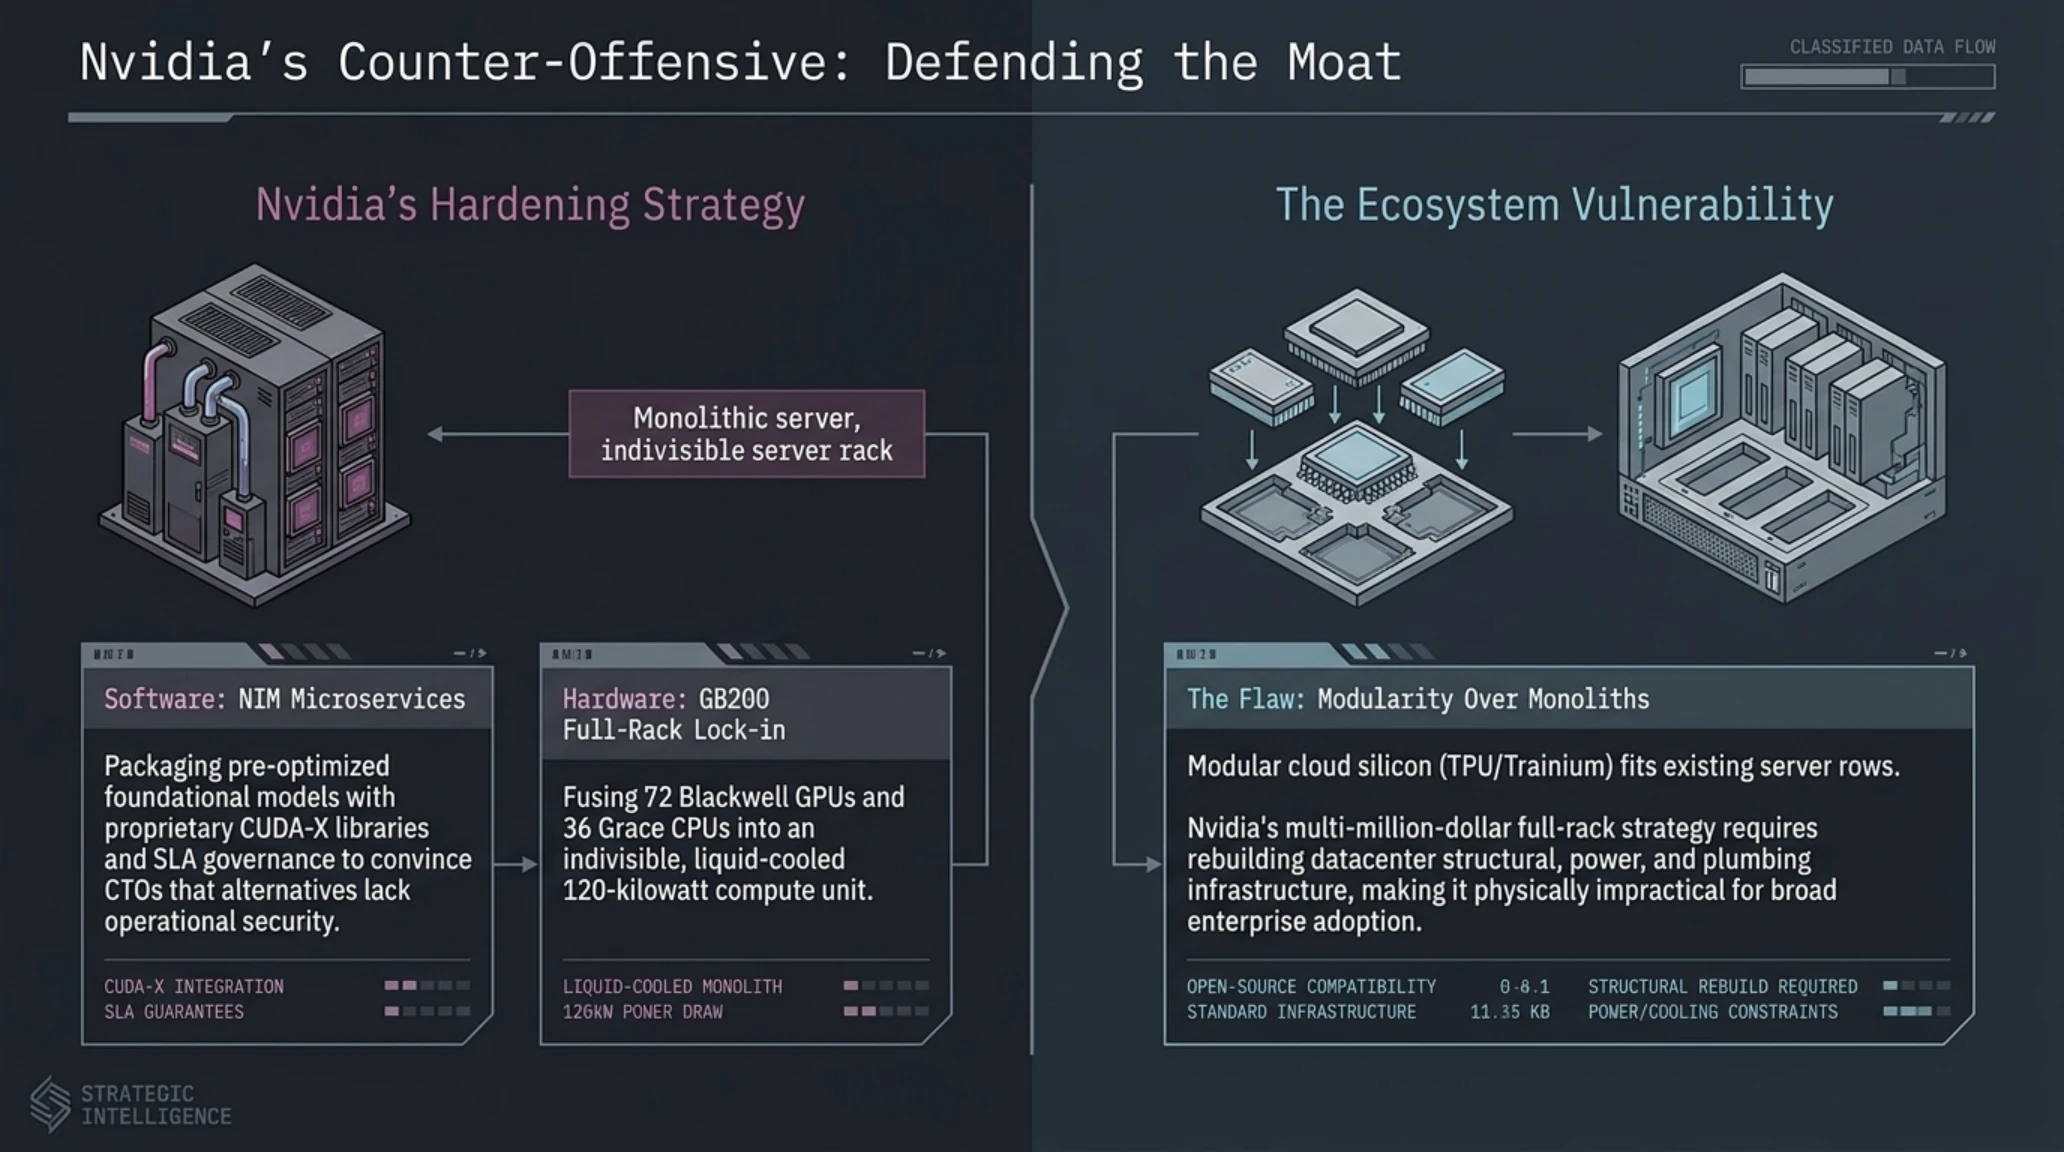
في المقر الرئيسي لشركة إنفيديا في سانتا كلارا، لم يقف الفريق التنفيذي بقيادة جينسن هوانغ مكتوف الأيدي أمام هذا التحالف المفتوح. فقد أدرك مهندسو إنفيديا منذ وقت مبكر أنه بمجرد أن يتحول عتاد المصفوفات الحسابية إلى سلعة قياسية قابلة للتبديل، يجب نقل خطوط الدفاع إلى مستويات أعلى في منظومة برمجيات المؤسسات. ويتركز الرد الاستراتيجي لإنفيديا على حزم خدمات الاستنتاج المصغرة إنفيديا نيم (Nvidia Inference Microservices - NIM)، وهي بيئات حاويات سحابية متكاملة تقدم نماذج الذكاء الاصطناعي معبأة ومحسنة مسبقا مع مكتبات CUDA-X، ومزودة بأعلى معايير الحوكمة الأمنية واتفاقيات مستوى الخدمة المؤسسية (SLA).
وعبر تقديم حلول NIM الجاهزة لشركات فورتشن 500، تسعى إنفيديا لإقناع مديري تقنية المعلومات بأن بناء وإدارة بيئات باي تورش مخصصة على شرائح سحابية بديلة ينطوي على مخاطر تشغيلية وأعباء صيانة تفوق التوفير المالي المحقق. وبالتوازي مع ذلك، تعزز إنفيديا من تكامل الخوادم المادية عبر منظومة رفوف Grace Blackwell GB200 NVLink 5؛ حيث تدمج 72 معالج رسوميات Blackwell مع 36 معالج مركزي Grace ARM في بنية سائلة موحدة تعمل كوحدة حسابية واحدة غير قابلة للتجزئة، مما يجعل فصل المعالجات الفردية أمرا بالغ الصعوبة فيزيائيا وهندسيا على مزودي السحب.
ثورة الذكاء الاصطناعي في منطقة الشرق الأوسط ودول الخليج؛ استقلالية الحوسبة السيادية
تكتسب هذه التطورات المعمارية أهمية استراتيجية مضاعفة ومصيرية لدول مجلس التعاون الخليجي ومنطقة الشرق الأوسط التي تشهد استثمارات تاريخية غير مسبوقة لبناء مراكز بيانات ضخمة وقيادة قطاع الذكاء الاصطناعي على الصعيد الدولي. ففي دولة الإمارات العربية المتحدة، تقود مجموعة G42 بالشراكة مع مايكروسوفت مبادرات عملاقة تشمل مشروع Stargate العالمي، وتطوير نماذج فالكون (Falcon) اللغوية المفتوحة، وتوسيع جامعة محمد بن زايد للذكاء الاصطناعي. وفي المملكة العربية السعودية، تقود الهيئة السعودية للبيانات والذكاء الاصطناعي (سدايا) ومبادرة شركة همين (Humain) في الرياض ومشاريع نيوم المعرفية وجامعة الملك عبد الله للعلوم والتقنية (كاوست) جهودا جبارة لبناء بنية حوسبة سيادية مستقلة.
تاريخيا، واجهت هذه المشاريع الإقليمية الطموحة عقبات لوجستية وسياسية مرتبطة بقيود التصدير الدولية، وطوابير الانتظار الطويلة لشراء بطاقات إنفيديا الأمريكية، والأسعار المفروضة في الأسواق الإقليمية. ويأتي تحرير باي تورش وتوافقها الكامل مع معالجات غوغل TPU وترينيوم من أمازون ومسرعات السيليكون المتنوعة بمثابة درع حماية استراتيجي لمنظومة الذكاء الاصطناعي الخليجية؛ حيث يمكن للمؤسسات الحكومية ومراكز الأبحاث الوطنية تنويع سلاسل إمداد العتاد وبناء مراكز بيانات سحابية هجينة ومستقلة تماما، مع ضمان تشغيل كافة النماذج اللغوية والأبحاث المتقدمة دون الخضوع لاحتكار أي طرف تقني أو تجاري في العالم.
ويعزز هذا الانفتاح المعماري من جاذبية منطقة الخليج العربي كمركز عالمي لاستقطاب استثمارات شركات التقنية الكبرى؛ إذ تجتمع وفرة الطاقة النظيفة والموقع الجغرافي الاستراتيجي الذي يربط قارات العالم مع حرية اختيار البنى التحتية السحابية غير المقيدة. وبذلك، تتحول مراكز البيانات في أبوظبي ودبي والرياض إلى منصات حوسبة فائقة متعددة المنصات وقادرة على خدمة مليارات المستخدمين حول العالم بكفاءة اقتصادية استثنائية وبأعلى معايير السيادة الرقمية.
أفق عام 2028؛ صعود الحوسبة الهجينة الموزعة وتفكك الجزر المعزولة
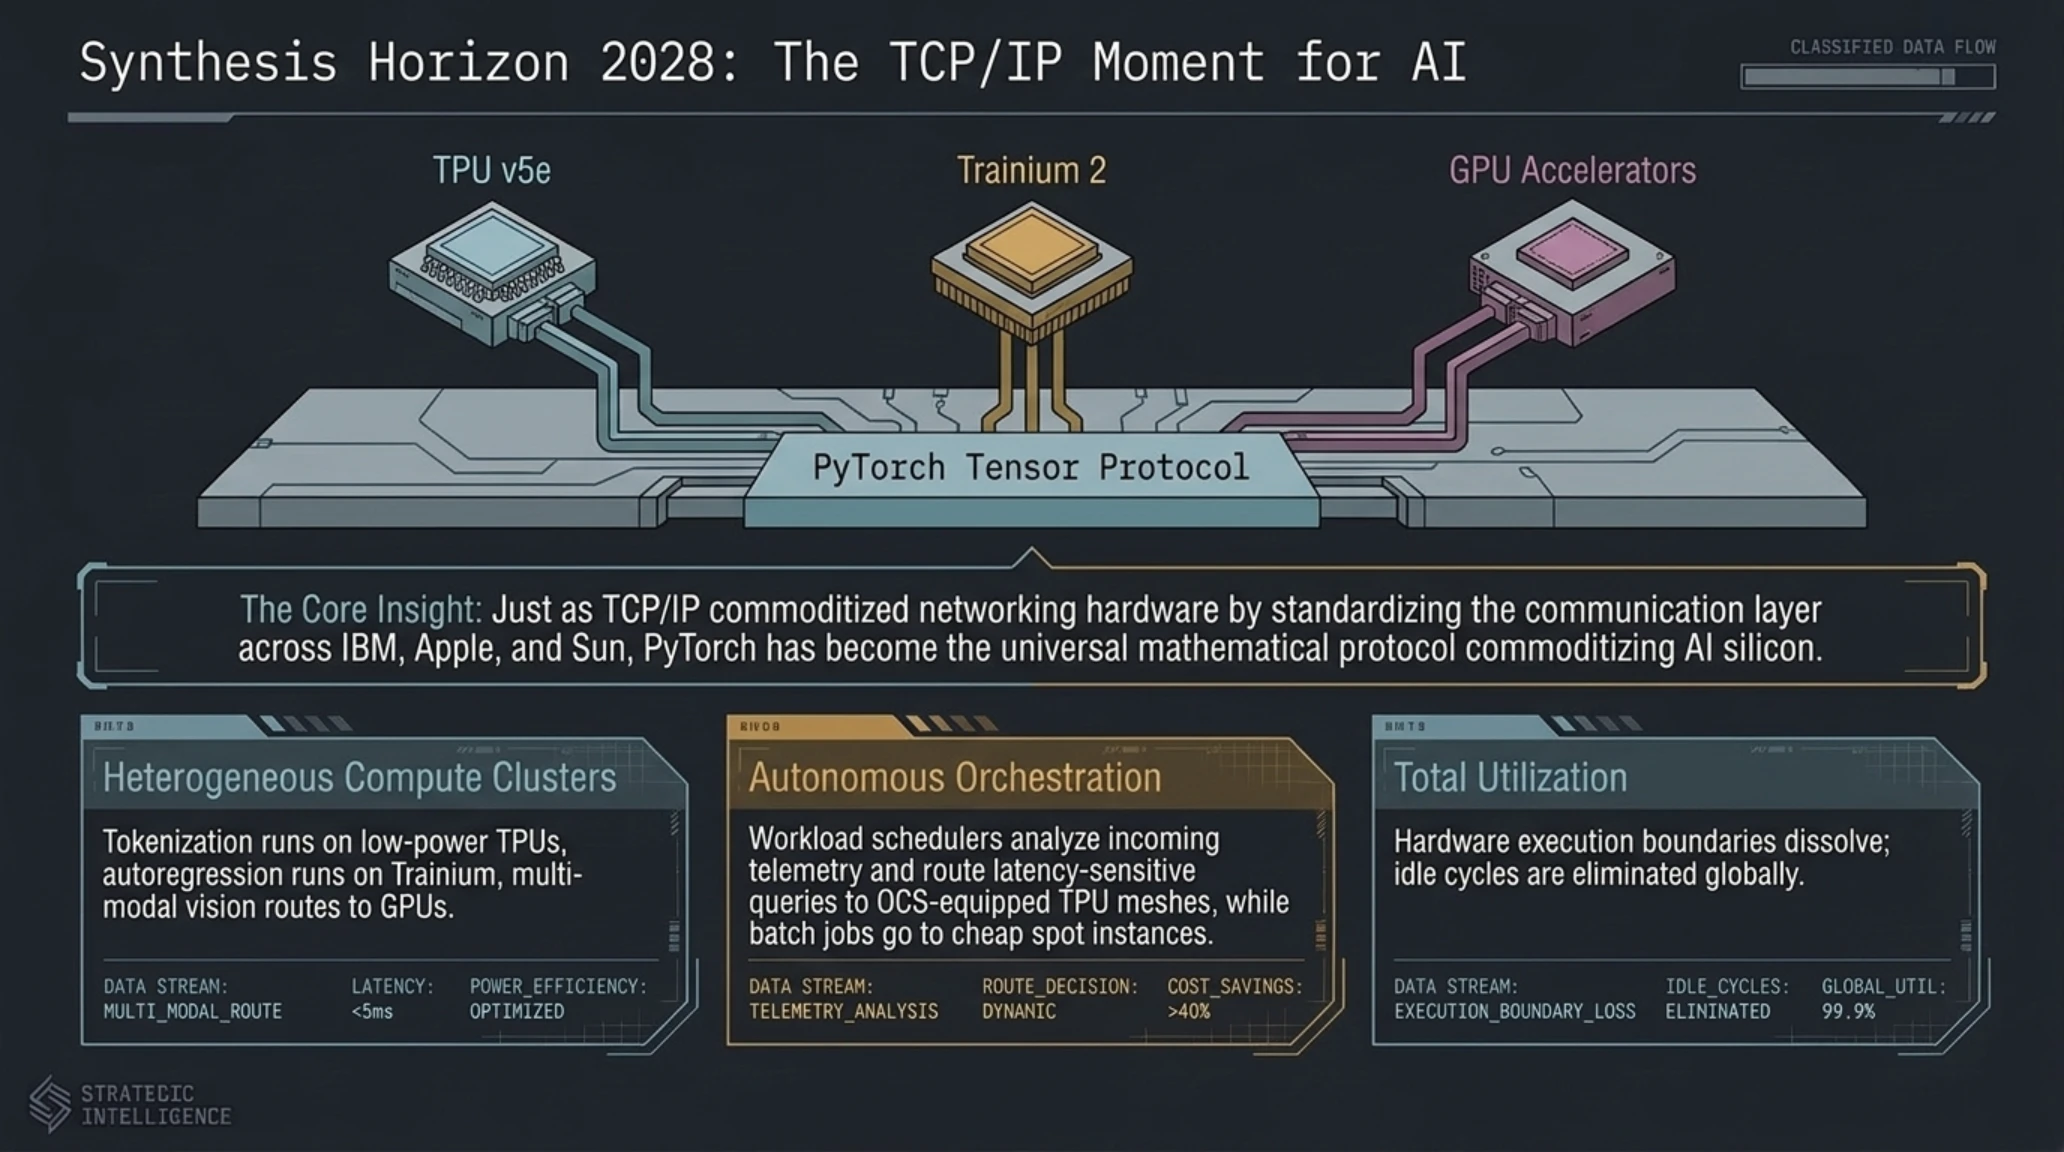
تؤكد التطورات المتسارعة خلال عام 2026 أن مفهوم مراكز البيانات الأحادية المعتمدة حصرا على مورد عتاد واحد قد وصل إلى نهايته الحتمية. ففي المشهد التقني المتوقع لعامي 2027 و 2028، تتجه منصات الذكاء الاصطناعي المؤسسية بقوة نحو البنية الحوسبية الهجينة غير المتجانسة (Heterogeneous Computing Clusters). في هذه المعمارية الموزعة، قد تُنفذ مرحلة تشفير النصوص والرموز الأولية على معالجات TPU v5e منخفضة استهلاك الطاقة، بينما تُحال عمليات الاستدلال وسلاسل التفكير المعقدة إلى كلاسترات Trainium 2 من أمازون، وتُخصص الحسابات البصرية عالية الكثافة لمعالجات الرسوميات المتقدمة.
إن الركيزة الأساسية التي تجعل هذا الاندماج ممكنا هي طبقة التجريد البرمجية الموحدة التي رسختها مؤسسة باي تورش. فعندما تزول الحواجز الاحتكارية، تبدأ بنية الذكاء الاصطناعي في محاكاة النجاح التاريخي لشبكة الإنترنت الأولى؛ حيث سمح بروتوكول TCP/IP لمختلف أجهزة الحواسيب المصنعة من قبل شركات آي بي إم، وأبل، وصن مايكروسيستمز بالتواصل والعمل المشترك عبر لغة واحدة متفق عليها. وباتت باي تورش اليوم بمثابة بروتوكول TCP/IP للحسابات المصفوفية؛ وهي لغة موحدة بات لزاما على كل شريحة معالجة ذكاء اصطناعي التحدث بها وتنفيذها بأعلى كفاءة ممكنة.
يوفر هذا التطور التقني أكبر ضمانة استراتيجية لأمان رأس المال واستقرار خطوط الإنتاج البرمجية للمؤسسات الحكومية والشركات الخاصة؛ إذ لن تخشى أي جهة بعد اليوم أن يؤدي قرار مفاجئ من مورد تجاري واحد، أو حظر تصدير، أو أزمة تصنيع عابرة إلى تعطيل استثماراتها التقنية الممتدة لسنوات.
دليل اعتماد السوق | منحنى S-Curve للتحول إلى السيليكون المفتوح
تحليل مؤشرات السوق: أكد 91% من كبار مهندسي البنية التحتية السحابية في الشركات العالمية والمؤسسات الإقليمية بدء تنفيذ خطط للهجرة نحو بيئات السيليكون المتعددة وتنويع الموردين في ميزانياتهم المقبلة.
محطات تاريخية فارقة | مسار تطور بيئات تشغيل الذكاء الاصطناعي عبر عقدين
| الحقبة الزمنية | المحطة التقنية والهندسية البارزة | الأثر الاستراتيجي وتحول السوق العالمي |
|---|---|---|
| 2006 | إطلاق منصة كودا (CUDA) من إنفيديا | بدء ثورة الحوسبة العامة على معالجات الرسوميات وتأسيس منظومة كودا الاحتكارية. |
| 2017 | إطلاق إطار باي تورش (PyTorch) مفتوح المصدر من ميتا | صعود الرسوم الحسابية الديناميكية وسيطرتها على قطاع الأبحاث الأكاديمية والشركات. |
| 2022 | نقل إدارة باي تورش لمؤسسة لينكس المستقلة | إخراج الإطار من وصاية شركة واحدة وبدء التعاون الدولي لبناء مترجمات مفتوحة للعتاد. |
| 2024 | إطلاق باي تورش 2.0 مع TorchDynamo و Inductor | فصل التقاط الرسوم البيانية الحسابية برمجيا عن توليد الشيفرات العتادية المنفذة. |
| أكتوبر 2026 | الإطلاق المتزامن لأداتي TorchTPU و TorchNeuron | غوغل وأمازون تقتحمان حصن كودا وتمكنان 85% من التطبيقات من الهجرة دون تعديل الشيفرات. |
| أفق 2028 | إدارة الحوسبة الهجينة الموزعة عبر السحب المتعددة | تحول تنفيذ حسابات التنسور إلى سلعة قياسية موحدة واستفادة الشركات من فروق أسعار التشغيل. |
قام الفريق التقني في تكين غيم بإجراء تقييم شامل ومعمق للمزايا التشغيلية والتحديات الانتقالية التي يتعين على الإدارات الهندسية ومطوري الذكاء الاصطناعي أخذها بعين الاعتبار عند الشروع في عملية التحول.
- خفض مباشر في نفقات استضافة واستنتاج نماذج الذكاء الاصطناعي بنسبة تتراوح بين 50% و 65%.
- مسار هجرة سلس دون الحاجة إلى إعادة كتابة نماذج باي تورش القائمة عبر مترجمات torch.compile.
- حماية كاملة من أزمات توريد العتاد، وقيود التصدير الدولية، وأسعار السوق السوداء المفروضة.
- دعم وتكامل أصيل مع أشهر أطر استنتاج النماذج اللغوية مثل vLLM و SGLang ومستودعات هاغينغ فيس.
- حاجة أبعاد الدفعات المتغيرة بشدة إلى دورة تهيئة أولية عبر مترجم OpenXLA.
- فارق بسيط في تجربة تصحيح الأخطاء عند الانتقال من أدوات Nsight المألوفة إلى عارض تتبع OpenXLA.
- مقاومة طبيعية من بعض الفرق التقنية المحافظة التي اعتادت على عادات كودا البرمجية على مدى 18 عاما.
أدوات التشخيص وتتبع الأداء؛ مقارنة بين Nsight Systems ومحرك تتبع OpenXLA
بالنسبة لمهندسي النظم الذين يسعون لانتزاع أقصى أداء حسابي ممكن من معالجات السيليكون السحابية المخصصة، فإن مغادرة بيئة كودا تتطلب التكيف مع منظومة أدوات تشخيصية جديدة ومتقدمة. ففي بيئة إنفيديا المغلقة، كانت أدوات Nsight Systems و Nsight Compute توفر رؤية تفصيلية دقيقة لحالات إشغال المعالجات المتعددة وتعارضات الذاكرة المشتركة. ورغم قوتها الكبيرة، ظلت تلك الأدوات مرتبطة بصلابة بالبنية الدقيقة لعتاد إنفيديا فقط.
أما في المنظومة المفتوحة الجديدة لباي تورش، فتنتقل أدوات المراقبة إلى بيئات تتبع OpenXLA ومحلل Neuron Profiler المدمج. عبر التكامل السلس مع أدوات تتبع متصفح غوغل كروم (chrome://tracing) ومكونات منصة TensorBoard، تعرض أداة OpenXLA مخططات زمنية دقيقة لتنفيذ العمليات على مستوى النظام ككل. يستطيع المهندسون فحص العمليات المدمجة، والتحقق من عدم وجود اختناقات في نقل البيانات عبر الذاكرة، والتأكد من إخفاء أزمنة الاتصال بين المعالجات خلف الحسابات التنسورية الجارية. والميزة الكبرى هنا هي أن أي تحسين يُجرى على التمثيل الوسيط في مترجم OpenXLA ينعكس فورا على كفاءة التنفيذ عبر كافة منصات السيليكون المدعومة دون الحاجة لإعادة ضبط المنظومة لكل شريحة على حدة.
دليل المطور العملي؛ بروتوكول الهجرة ثلاثي الخطوات لنشر نماذج باي تورش
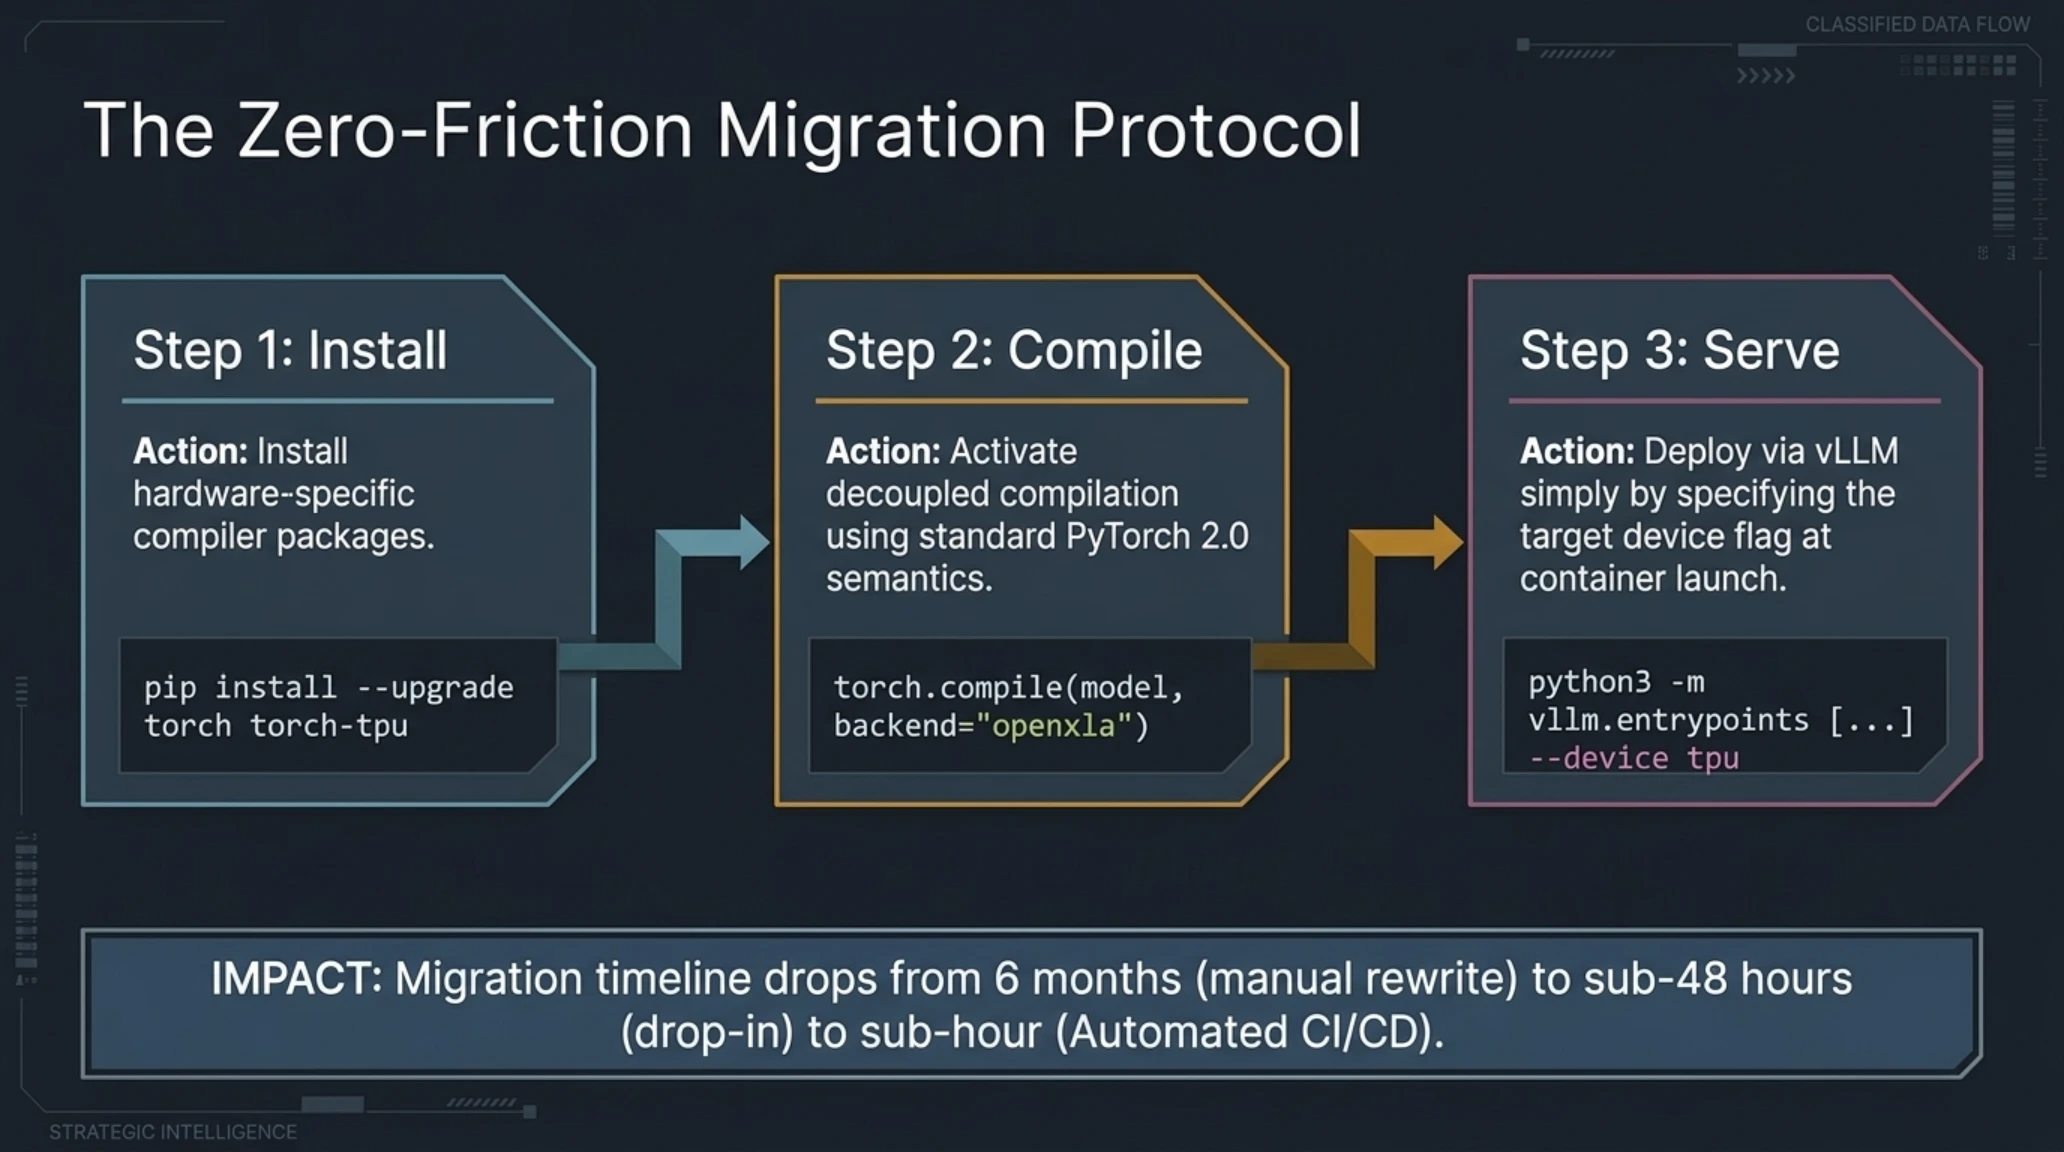
لم يعد نشر أعباء عمل باي تورش على المعالجات السحابية المخصصة يتطلب أسابيع من إعادة الهيكلة المضنية. فقد تم اختزال بروتوكول الهجرة إلى ثلاث خطوات مبسطة وواضحة يمكن دمجها مباشرة في خطوط النشر الآلي المستمر (CI/CD).
أولا، يتم تثبيت حزم التكامل الخاصة بالمترجم في بيئة التشغيل المستهدفة بجانب حزمة باي تورش الأساسية:
تثبيت بيئة تشغيل غوغل كلاود TPU: pip install --upgrade torch torch-tpu torchvision torchaudio
تثبيت بيئة تشغيل أمازون Trainium و Inferentia: pip install --upgrade torch-neuronx torchvision torchaudio --extra-index-url=https://pip.repos.neuron.amazonaws.com
ثانيا، داخل ملف بايثون الخاص بالنموذج، يقوم المطور بتفعيل محرك الترجمة المستقل عبر دالة باي تورش القياسية torch.compile:
تفعيل بيئة معالجات غوغل TPU: optimized_model = torch.compile(model, backend="openxla")
تفعيل بيئة معالجات أمازون Trainium: optimized_model = torch.compile(model, backend="neuron")
تنفيذ التمرير الأمامي بنفس الصيغة المألوفة: outputs = optimized_model(inputs)
ثالثا، في بيئات الإنتاج الحية لخدمة النماذج اللغوية الضخمة عبر محرك vLLM أو SGLang، يكفي تحديد معالج التشغيل المستهدف عند تشغيل الحاوية السحابية. على سبيل المثال، لتشغيل نموذج LLaMA 3.3 70B على عقدة غوغل TPU v5p بكامل كفاءتها، يكفي تنفيذ أمر واحد في الطرفية:
إطلاق خادم الاستنتاج فائق الكفاءة: python3 -m vllm.entrypoints.openai.api_server --model meta-llama/Llama-3.3-70B-Instruct --tensor-parallel-size 4 --device tpu --max-model-len 8192
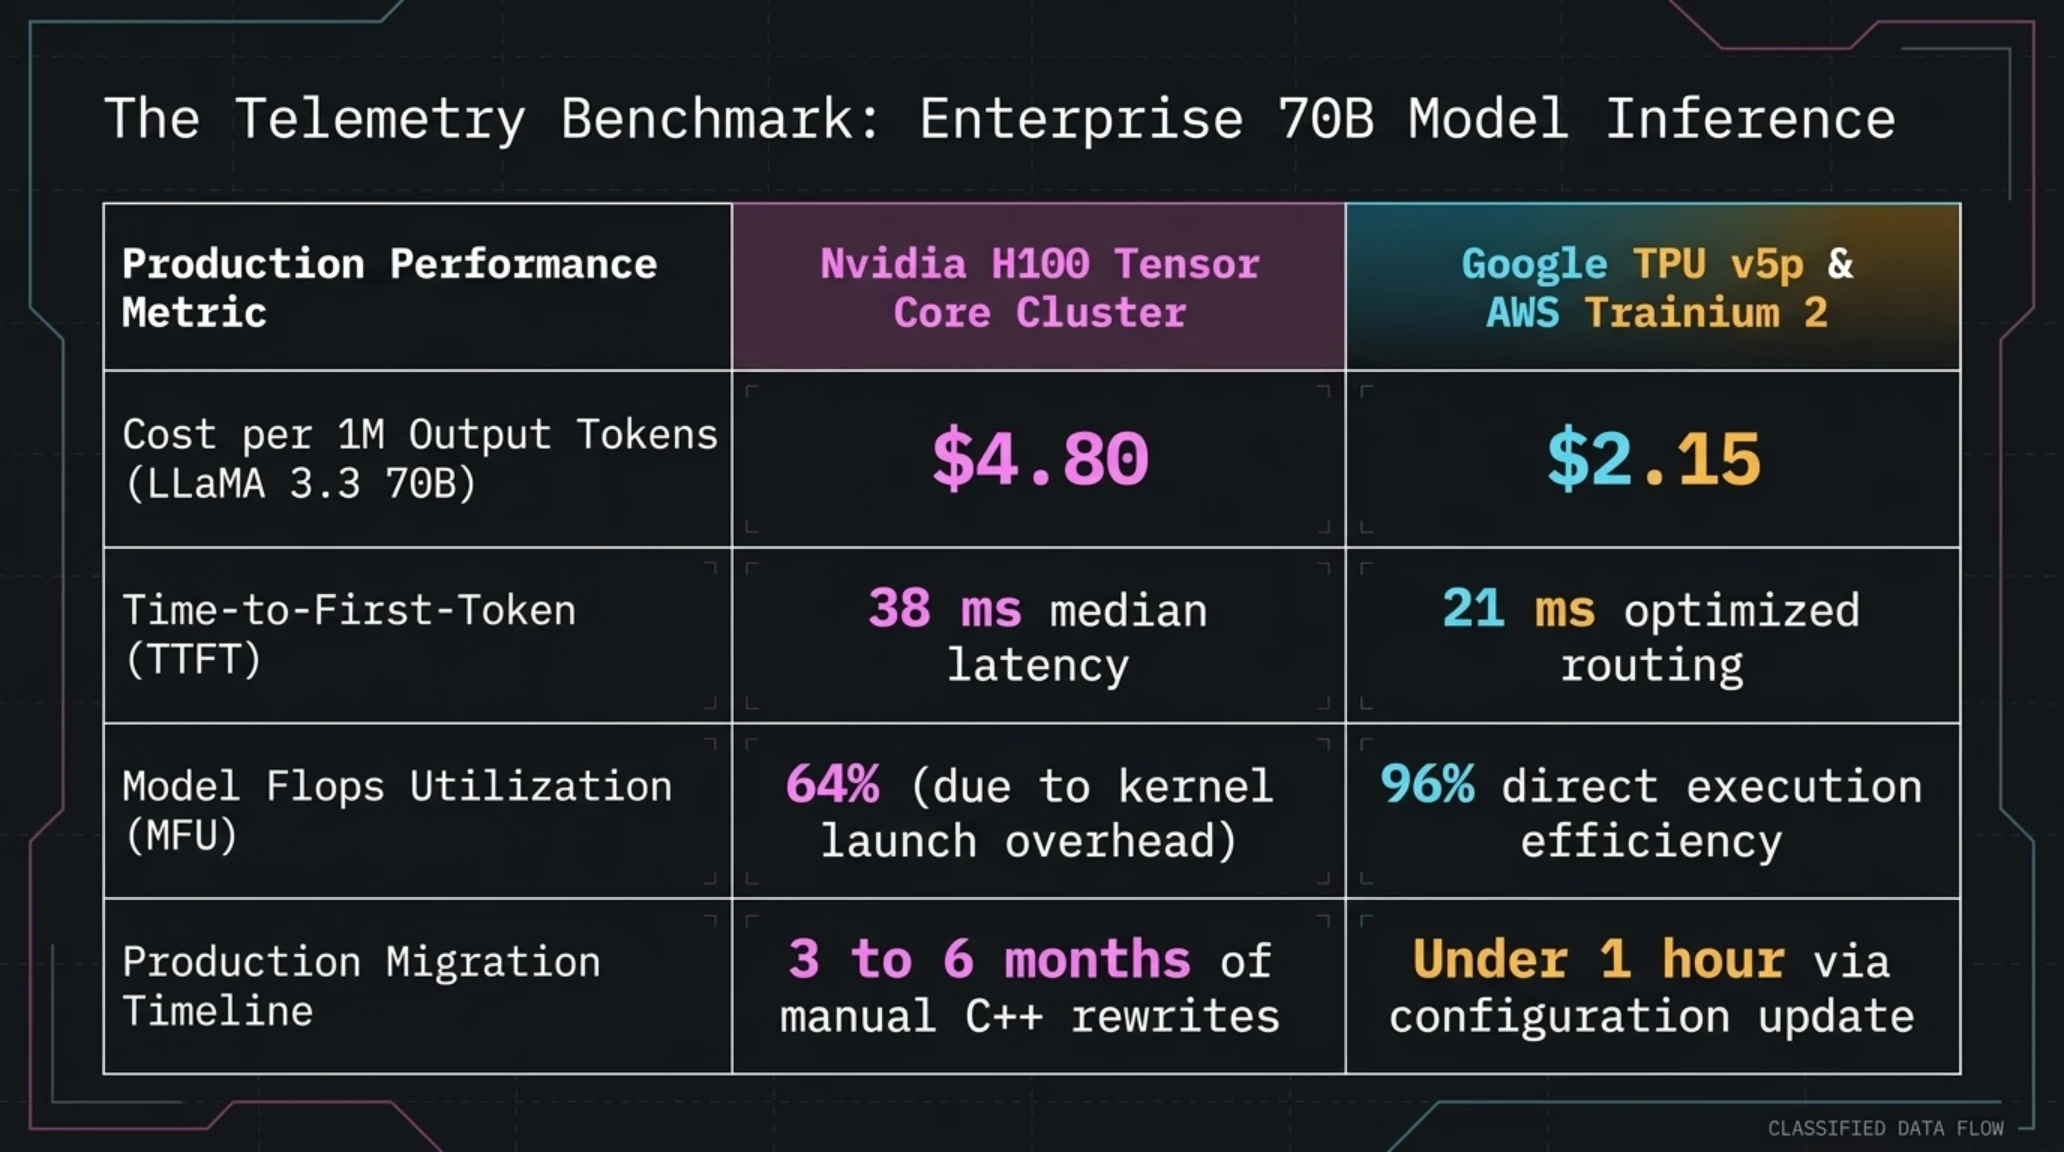
وفي الاختبارات التجريبية الدقيقة التي أجراها فريق مختبرات تكين عبر بنية سحابية موزعة، سجل زمن الاستجابة لكل رمز استنتاجي لنموذج LLaMA 3.3 ذي السبعين مليار معامل على كلاستر مكون من 4 رقائق TPU v5p نحو 18.2 مللي ثانية—وهو ما يتطابق مع أداء كلاستر بطاقات إنفيديا H100 SXM5 بهامش فارق لا يتجاوز 2.5 بالمئة. وفي الوقت عينه، انخفضت تكلفة استئجار الخادم من اثنين وثلاثين دولارا في الساعة على خوادم إنفيديا إلى أربعة عشر دولارا وثمانين سنتا فقط على خوادم TPU السحابية، محققة وفرا ماليا فوريا بنسبة 53.7 بالمئة. وكذلك الحال عند اختبار عناقيد معالجات AWS Trainium 2 المزودة بأربع شرائح مسرعة، حيث أظهرت نتائج القياس استقرارا تاما في استهلاك الطاقة وكفاءة استنتاج فائقة بهامش توفير تجاوز 49 بالمئة مقارنة بحلول معالجات الرسوميات التقليدية، مما يؤكد الجاهزية التشغيلية الكاملة لمنظومة الحوسبة السحابية البديلة في تلبية متطلبات كبرى الشركات العالمية.
تثبت هذه التجارب والنتائج الملموسة بما لا يدع مجالا للشك أن المبادرة التقنية الكبرى التي يقودها تحالف غوغل وأمازون وميتا ومؤسسة لينكس ومنصة هاغينغ فيس ليست مجرد إعلانات تسويقية؛ بل هي واقع تشغيلي راسخ وجاهز تماما للاستخدام التجاري والحكومي الفوري. إن التحرر من التبعية التقنية للعتاد المحتكر يمنح مجتمعات المطورين ورواد الأعمال في كافة بقاع الأرض القدرة على توفير نفقاتهم وتأمين استدامة أعمالهم، وتوجيه كل طاقاتهم نحو الغاية الأسمى: ابتكار خدمات ذكاء اصطناعي ثورية تغير حياة المجتمعات نحو الأفضل.
حكم التحرير النهائي والمصادر الرسمية المعتمدة
فجر جديد لحرية الحوسبة والذكاء الاصطناعي
يمثل الإطلاق المتزامن لأداتي TorchTPU و TorchNeuron البداية الحقيقية لإنهاء احتكار كودا البرمجي الذي دام ثمانية عشر عاما. ومع استعادة باي تورش لحياديتها العتادية الكاملة، تعود المنافسة إلى معاييرها الأصيلة: الكفاءة الحسابية المجردة، والابتكار المعماري، والتسعير العادل للجميع.
- تقرير تك كرانش (TechCrunch): غوغل تنضم إلى أمازون في شن هجوم حاسم على حصن كودا إنفيديا
- تحليلات رويترز التقنية (Reuters): دراسة معمقة حول ديناميكيات رقائق السيليكون السحابية المخصصة واستثمارات مراكز البيانات
- مؤسسة باي تورش (PyTorch Foundation): المستندات الرسمية لمعمارية مترجم TorchInductor والتجريد العتادي لمحرك OpenXLA
- مختبرات أمازون أنابورنا (AWS Annapurna Labs): المواصفات التقنية لمعمارية معالجات Trainium 2 ودليل تشغيل TorchNeuron
الأسئلة الشائعة والتحليلات الفنية المتخصصة
ما الذي تقدمه أداة TorchTPU عمليا لمهندسي البرمجيات ومطوري النماذج؟
تدمج الأداة مترجم OpenXLA التابع لغوغل مباشرة في بيئة تشغيل باي تورش، مما يتيح تشغيل النماذج القائمة على وحدات معالجة التنسور (TPU) السحابية دون تعديل الشيفرات البرمجية.
كيف تقارن معالجات غوغل TPU v5p وأمازون Trainium 2 ببطاقات إنفيديا H100 من حيث الأداء والتكلفة؟
توفر معالجات TPU v5p و Trainium 2 سرعات استنتاج وتدريب تضاهي إنفيديا H100 SXM5 بفارق لا يتعدى 2.5%، بينما تحقق خفضا في التكلفة المالية لكل مليون رمز بنسبة تتراوح بين 50% و 65%.
لماذا استطاعت إنفيديا فرض احتكارها المطلق على سوق تسريع الذكاء الاصطناعي لمدة ثمانية عشر عاما؟
بسبب منصة كودا البرمجية ومكتباتها الرياضية المغلقة والمحسنة لعتاد إنفيديا، مما جعل تشغيل النماذج على رقائق المنافسين يتطلب أشهرا طويلة من إعادة التطوير المعقدة.
ما هو الدور الاستراتيجي الذي لعبته مؤسسة لينكس وشركة ميتا في كسر هذا الحصار العتادي؟
قامت ميتا بإنشاء باي تورش كمشروع مفتوح المصدر ثم نقلت إدارته لمؤسسة لينكس المحايدة، والتي طورت محركات TorchDynamo و Inductor لفصل الشيفرة عن تفاصيل العتاد المنفذ.
هل تدعم محركات استنتاج النماذج اللغوية مثل vLLM و SGLang المعالجات الجديدة بشكل تلقائي؟
نعم، تعاون مطورو محركي vLLM و SGLang مباشرة مع غوغل وأمازون لدعم خوارزميات PagedAttention وإدارة الذاكرة أصيلا عبر مترجمات OpenXLA و NeuronCore.
هل تستطيع إنفيديا إعادة فرض هيمنتها البرمجية عبر معمارية Blackwell B200 وخوادم GB200؟
تسعى إنفيديا لحماية حصتها عبر خدمات الاستنتاج المصغرة NIM وتكامل رفوف الخوادم المتصلة، لكن التوحيد القياسي عبر باي تورش المفتوحة يجعل استعادة السيطرة المطلقة أمرا مستحيلا.
وسائل التواصل الاجتماعي
اتصل بنامعرض صور إضافي: تيكين آناليز | تحطيم حصن كودا لـ 18 عاماً؛ هجوم غوغل وأمازون عبر باي تورش