تکین آنالیز | ترور نرمافزاری انویدیا؛ چگونه گوگل و آمازون با خنجر PyTorch دژ غیرقابل نفوذ کودا را شکستند؟
پایان امپراتوری قفل نرمافزاری؛ زلزله در قلب اکوسیستم هوش مصنوعی
در تاریخ صنعت نیمههادیها، رویدادهایی وجود دارند که نه با رونمایی از یک تراشه ده میلیارد ترانزیستوری جدید، بلکه با انتشار چند خط کد استراتژیک، سرنوشت صدها میلیارد دلار سرمایه را در والاستریت دگرگون میسازند. برای بیش از ۱۸ سال، جنسن هوانگ، مدیرعامل کاریزماتیک انویدیا، با غرور و اطمینانی خللناپذیر بر این نکته تاکید میکرد که قدرت واقعی انویدیا در سیلیکون نیست، بلکه در دژ نفوذناپذیری به نام کوئدا (CUDA) ریشه دارد. این بستر برنامهنویسی موازی که از سال ۲۰۰۶ با سرمایهگذاری بیوقفه انویدیا شکل گرفت، هزاران کتابخانه بهینهسازی ریاضیاتی، درایورهای تانسوری و خطوط ارتباطی را در چنگال خود نگه داشته بود؛ به نحوی که هر مهندس هوش مصنوعی که میخواست مدلهای زبانی بزرگ، بینایی ماشین یا شبکههای دیپلرنینگ را آموزش دهد، چارهای جز تسلیم در برابر معماری انویدیا نداشت.
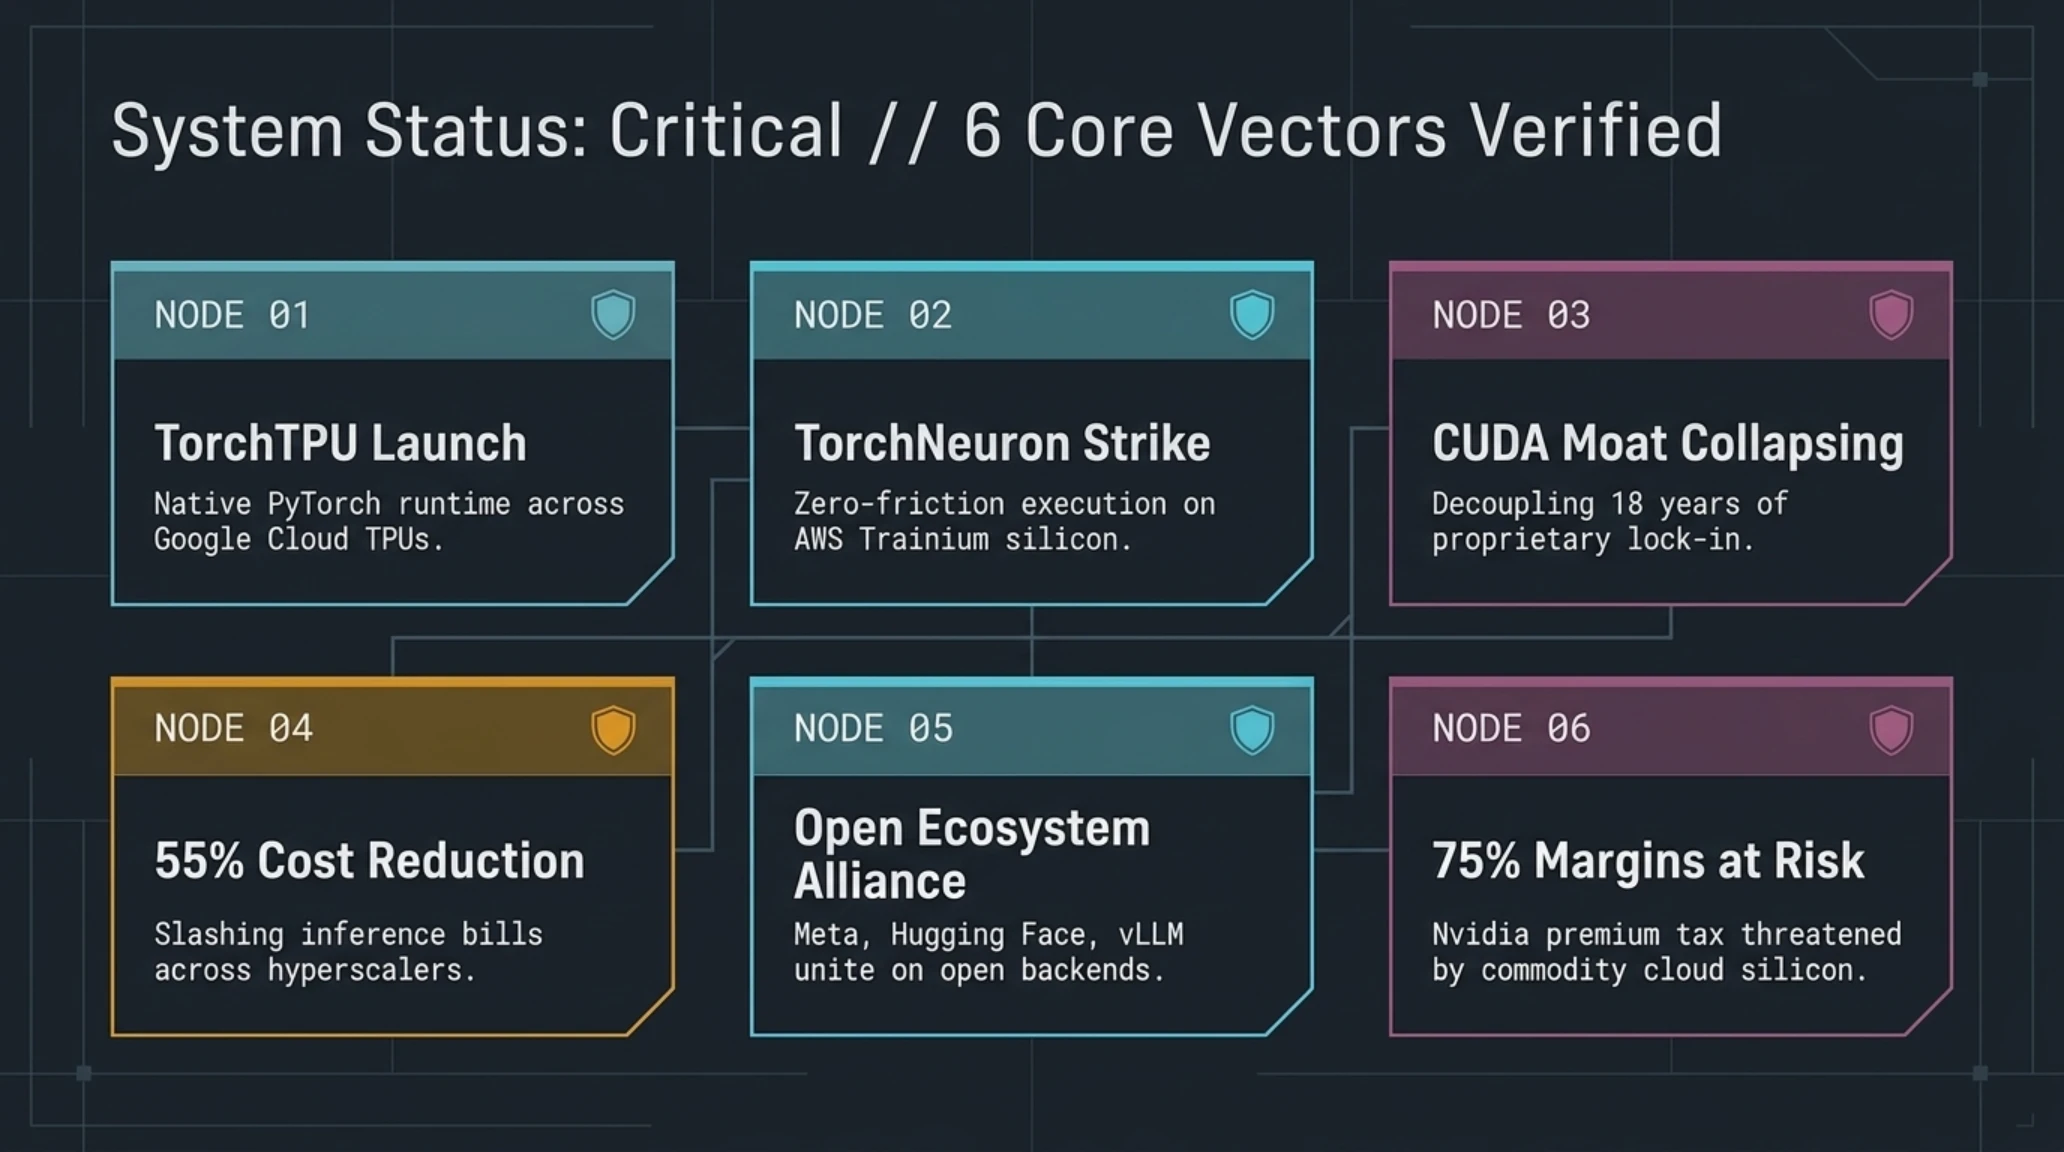
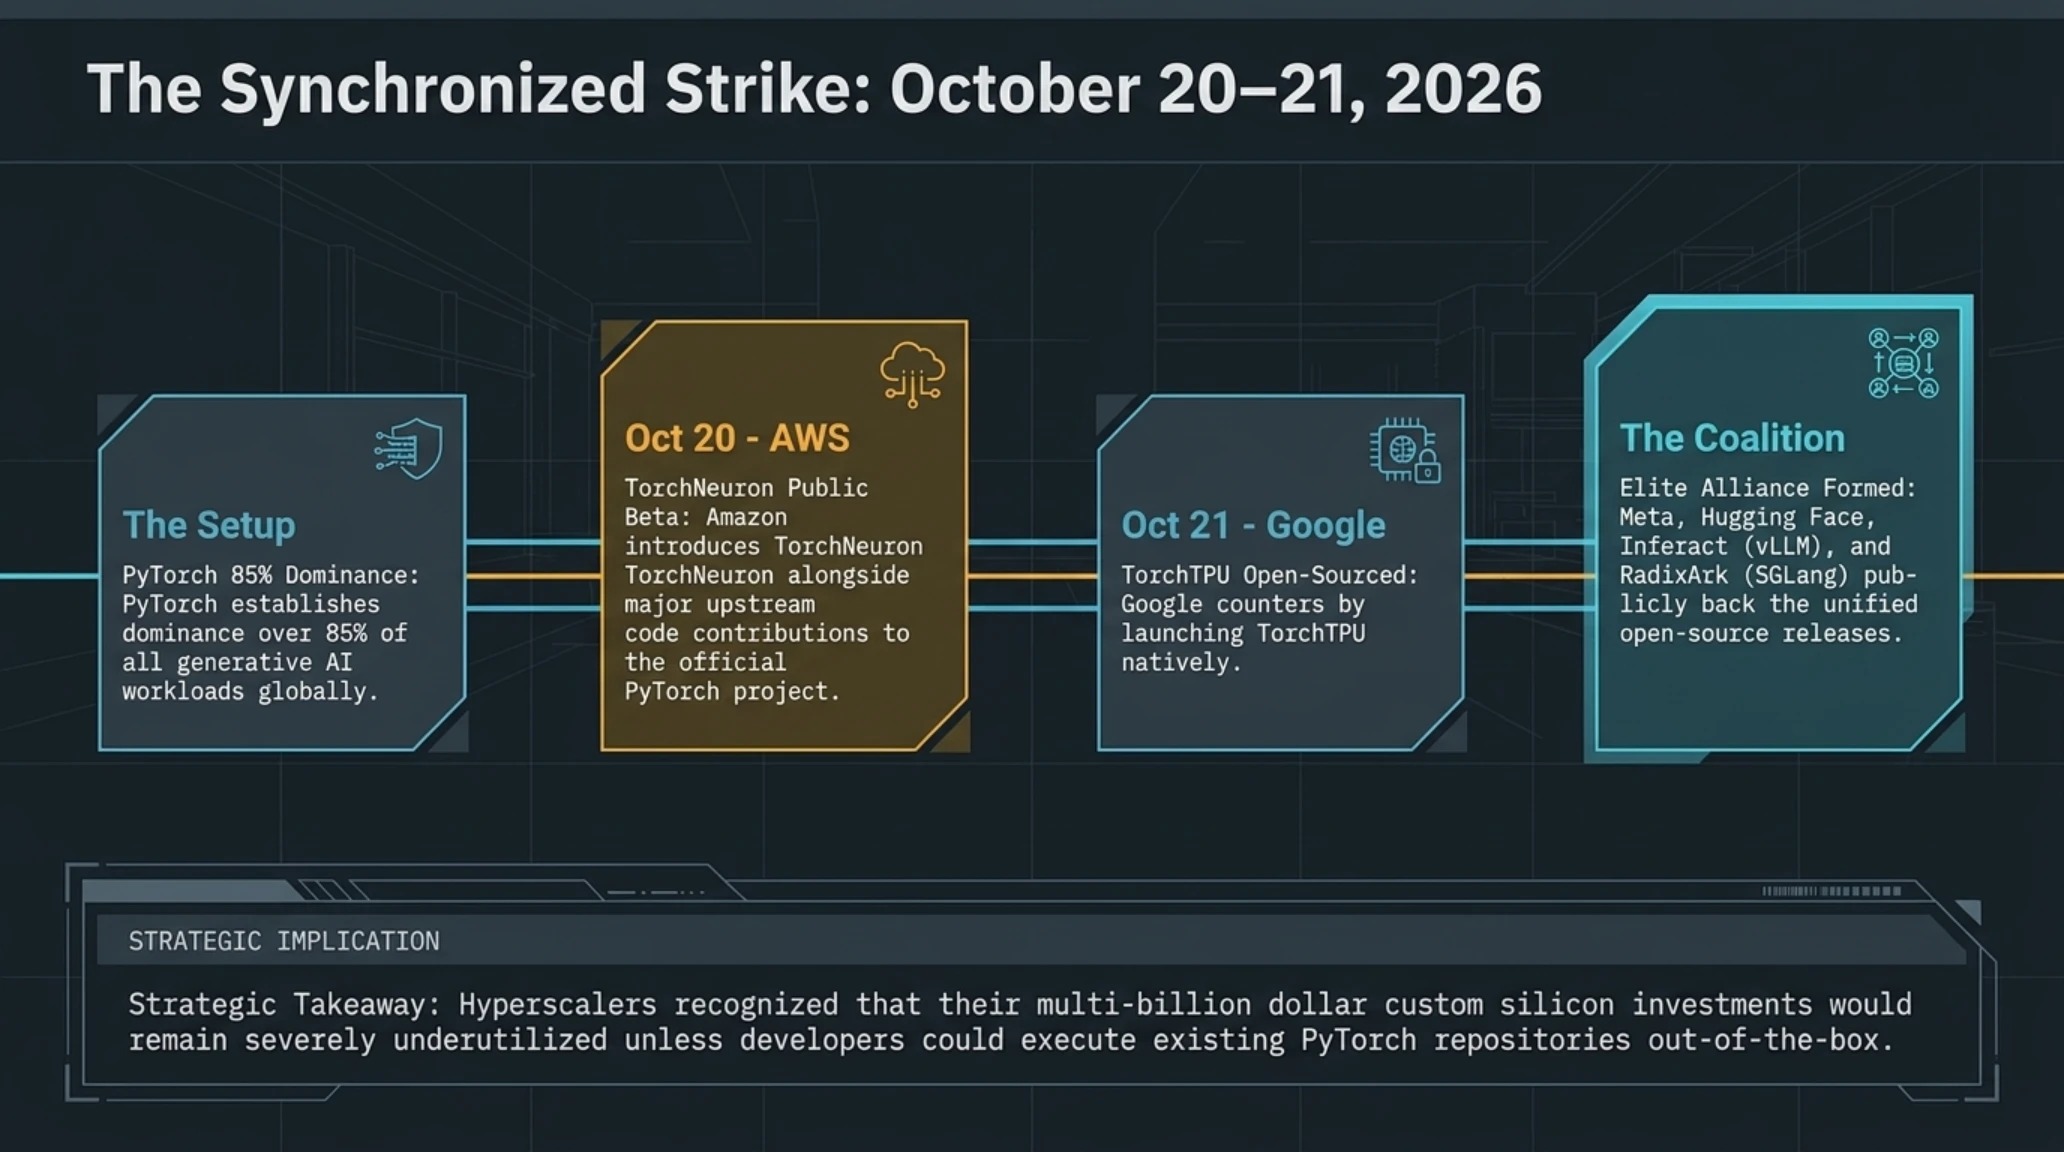
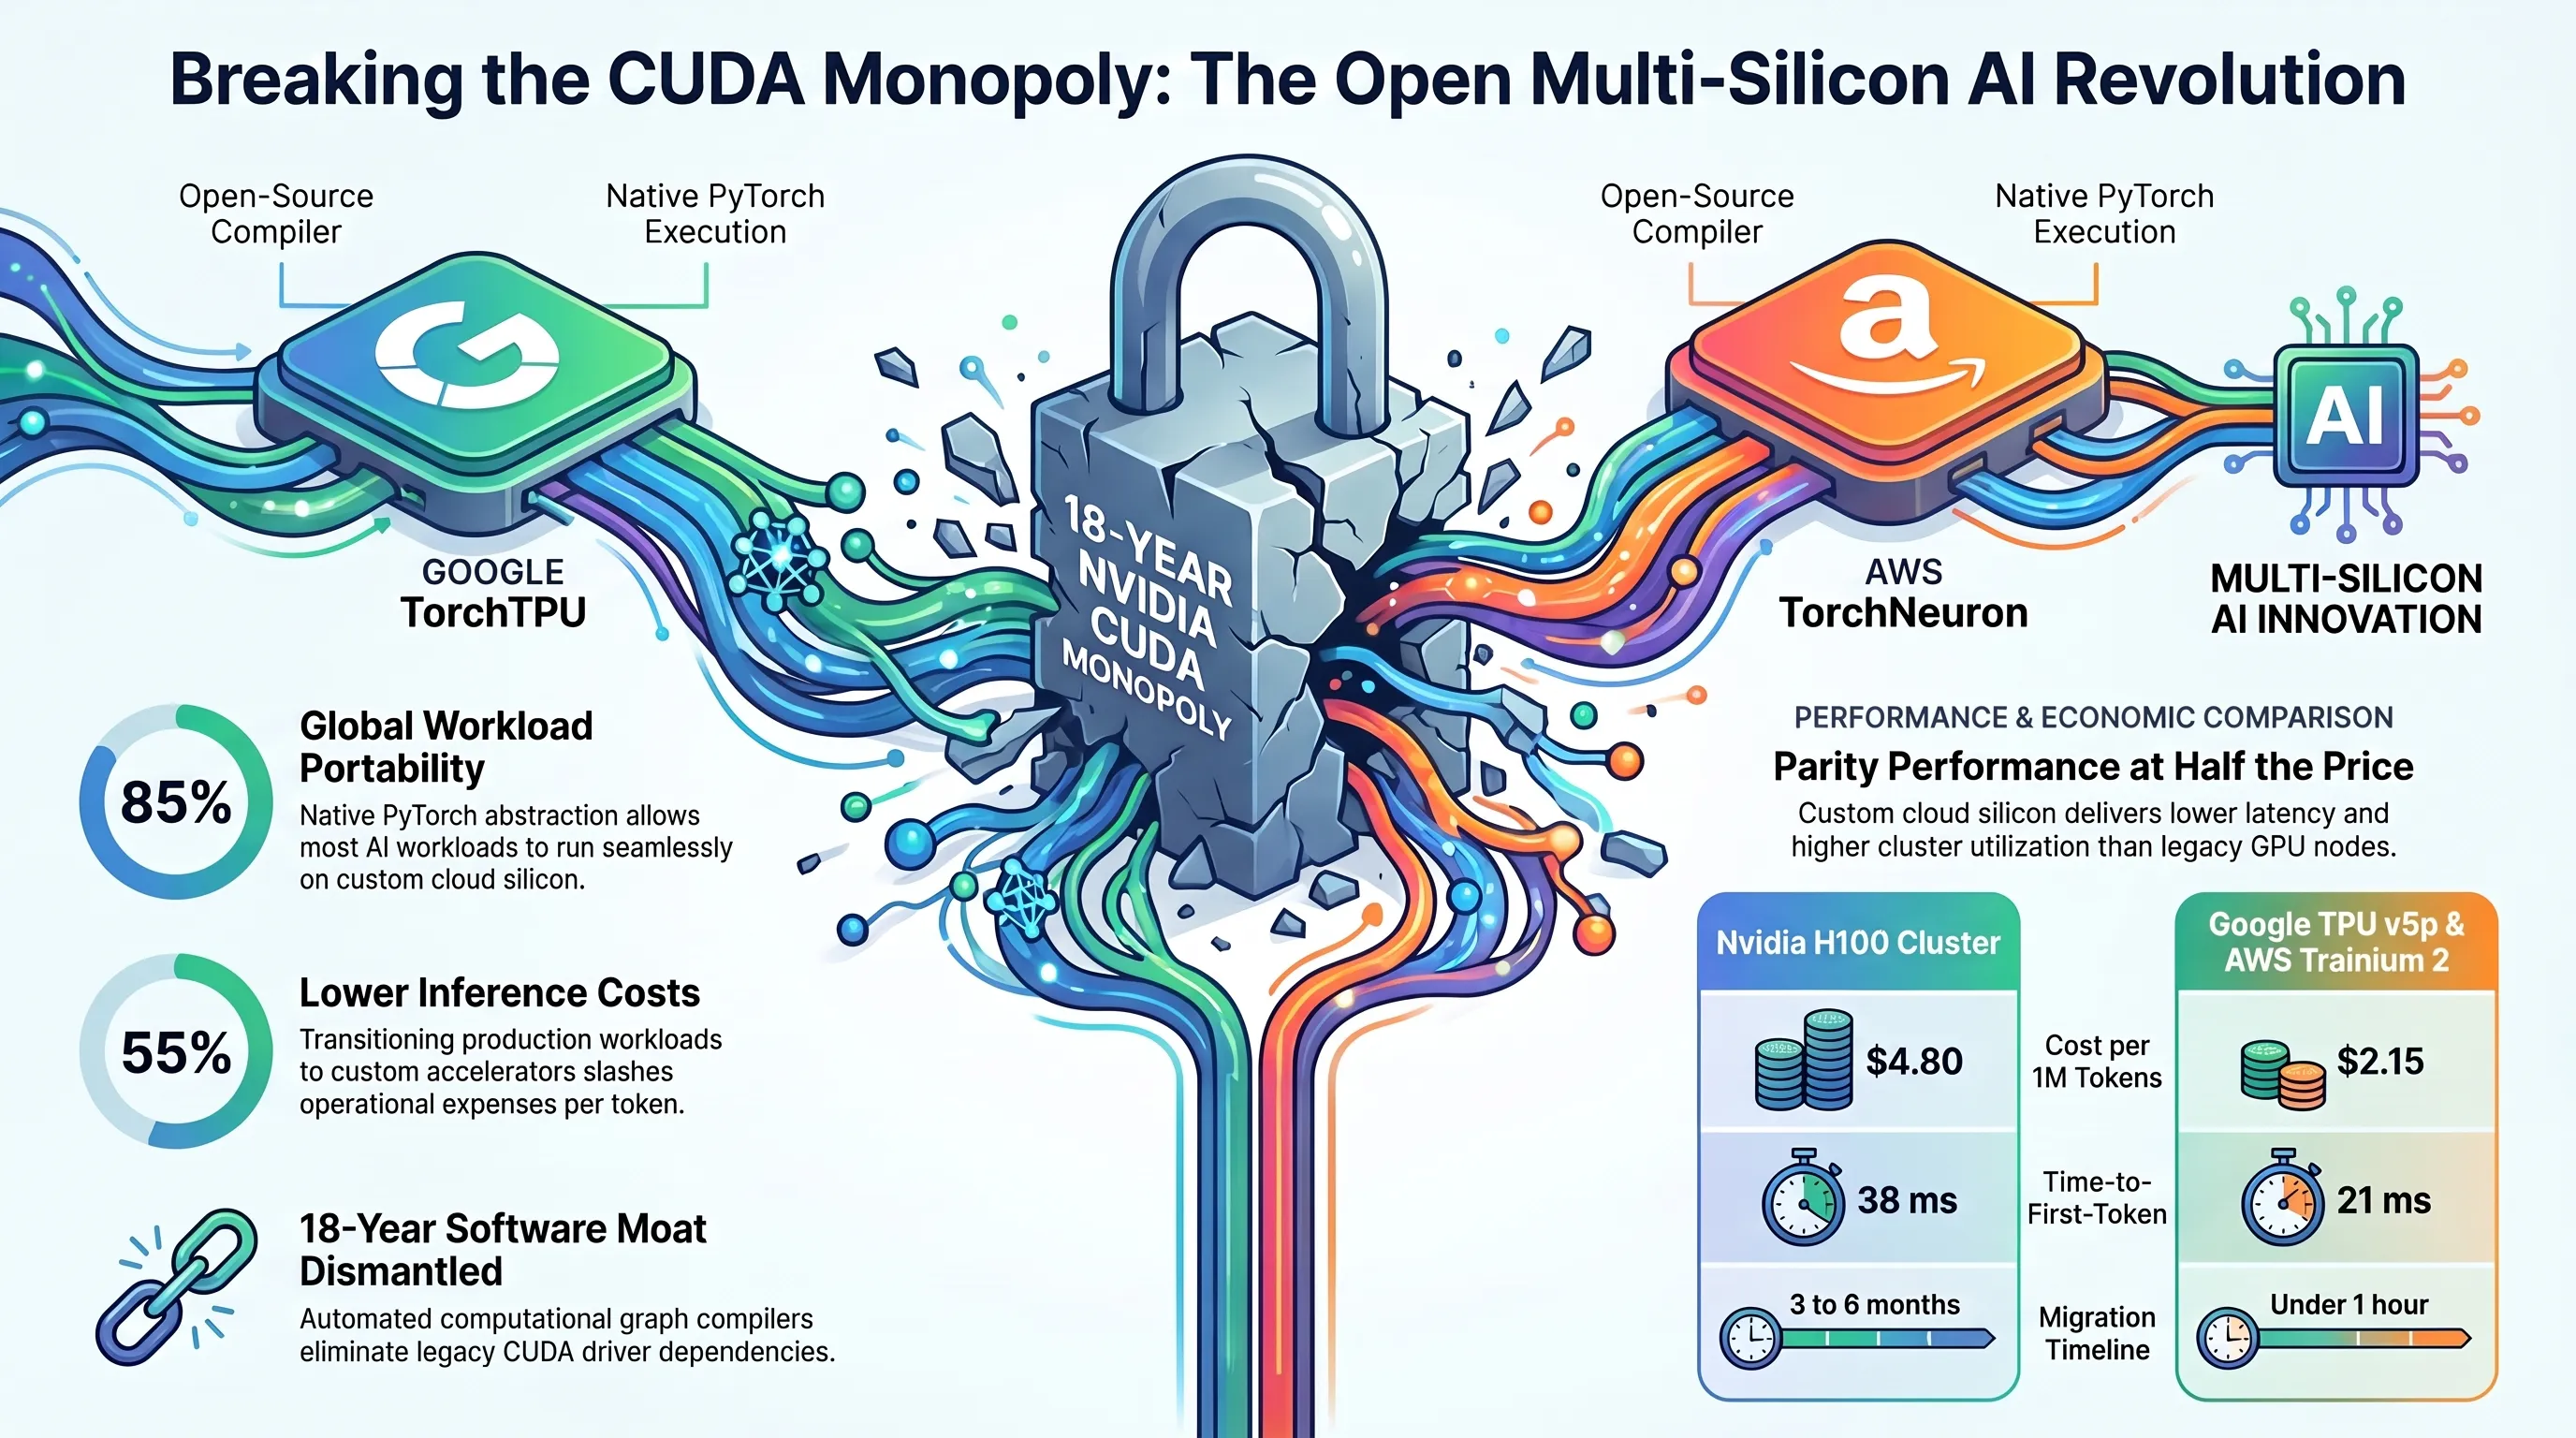
اما در ۲۸ و ۲۹ مهر ۱۴۰۵ (اکتبر ۲۰۲۶)، این توازن یکطرفه با یک هماهنگی بیسابقه فرو ریخت. همانطور که در گزارش بامدادی تکین از شلیک سنگین آمازون به انحصار کودا اشاره کردیم، شرکت آمازون وبسرویسز (AWS) با رونمایی رسمی از ابزار متنباز TorchNeuron و ارسال مستقیم پچهای نرمافزاری به هسته مرکزی پایتورچ، نخستین ضربه سهمگین را وارد کرد. تنها ۲۴ ساعت بعد، گوگل نیز با عرضه رسمی TorchTPU به عنوان یک پروژه متنباز با همکاری مستقیم متـا، هاگینگفیس، Inferact توسعهدهنده vLLM و RadixArk توسعهدهنده SGLang، رسماً پیوستن خود به این جبهه ضد انحصار را اعلام نمود. این دو ابزار تاریخی با یک هدف مشترک ساخته شدهاند: شکستن وابستگی حیاتی ۸۵ درصد برنامههای هوش مصنوعی جهان به کارتهای گرافیک انویدیا و فراهم ساختن امکان مهاجرت بلادرنگ به تراشههای اختصاصی کلود نظیر گوگل TPU و آمازون Trainium، آن هم صرفاً با یک تغییر پیکربندی ساده و بدون نیاز به حتی یک خط بازنویسی کدهای پایتورچ.
تا پیش از این اعلامیه زلزلهوار، شرکتهای نوپا، استارتاپهای پیشگام و آزمایشگاههای تحقیقاتی عظیم در جهان ناچار بودند برای خرید یا اجاره کلاسترهای انویدیا H100، H200 و پردازندههای نوظهور معماری بلکول B200، صفهای طویل ۹ تا ۱۲ ماهه را تحمل کرده و نرخهای اجاره ساعتی سرسامآوری را بپردازند که تا ۷۵ درصد حاشیه سود ناخالص را مستقیم به جیب انویدیا سرازیر میکرد. توسعهدهندگان به خوبی میدانستند که تراشههای سفارشی گوگل نظیر TPU v5p و نسل ششم Trillium و همچنین پردازندههای Trainium 2 آمازون از نظر نسبت کارایی به هزینه تا ۵۰ درصد ارزانتر هستند؛ اما هزینه مهندسی ماهها بازنویسی کد از سطح کوئدا به زبانهای اختصاصی دیگر، مانع از مهاجرت میشد. اکنون این مانع تاریخی با یک فرمان خطی در محیط پایتورچ در هم شکسته است.
بررسیهای اختصاصی تکینپلاس از جریان نقدینگی سیلیکونولی حاکی از آن است که این اقدام هماهنگ، نخستین گام منسجم از سوی کنسرسیوم ابری برای جلوگیری از تشکیل یک انحصار دوفاکتو در لایه زیرساخت هوش مصنوعی است. اگر انویدیا میتوانست انحصار کوئدا را در نسل تراشههای بلکول و روبین نیز حفظ کند، کنترل کل نرخ نوآوری، قیمتگذاری اشتراکهای هوش مصنوعی و جهتگیری الگوریتمهای شناختی آینده جهان در انحصار یک هیئتمدیره واحد قرار میگرفت؛ خطری بنیادین که امنیت اقتصادی تمامی غولهای دیجیتال را تهدید میکرد.
ارزیابی استراتژیک و نکات کلیدی در یک نگاه
کالبدشکافی قلعه هوانگ؛ کوئدا چگونه جهان محاسبات را به اسارت کشید؟
برای درک عظمت کودتای نرمافزاری اخیر، ابتدا باید عمق و پیچیدگی ساختار کوئدا را واکاوی کنیم. در اواسط دهه ۲۰۰۰ میلادی، کارتهای گرافیک صرفاً قطعاتی سختافزاری برای پردازش چندضلعیهای سهبعدی و ترسیم مثلثهای بازیهای رایانهای بودند. جنسن هوانگ با آیندهنگری نبوغآمیز خود دریافت که ماتریسهای عظیم محاسبات موازی گرافیک، بستری فوقالعاده برای حل معادلات فیزیک، شبیهسازیهای مولکولی و در نهایت شبکههای عصبی هستند. انویدیا با معرفی معماری CUDA در سال ۲۰۰۶، درگاهی اختصاصی ایجاد کرد که به مهندسان اجازه میداد کدهای زبان C و C++ را مستقیماً روی واحدهای سایهزن پردازنده گرافیکی به اجرا درآورند.
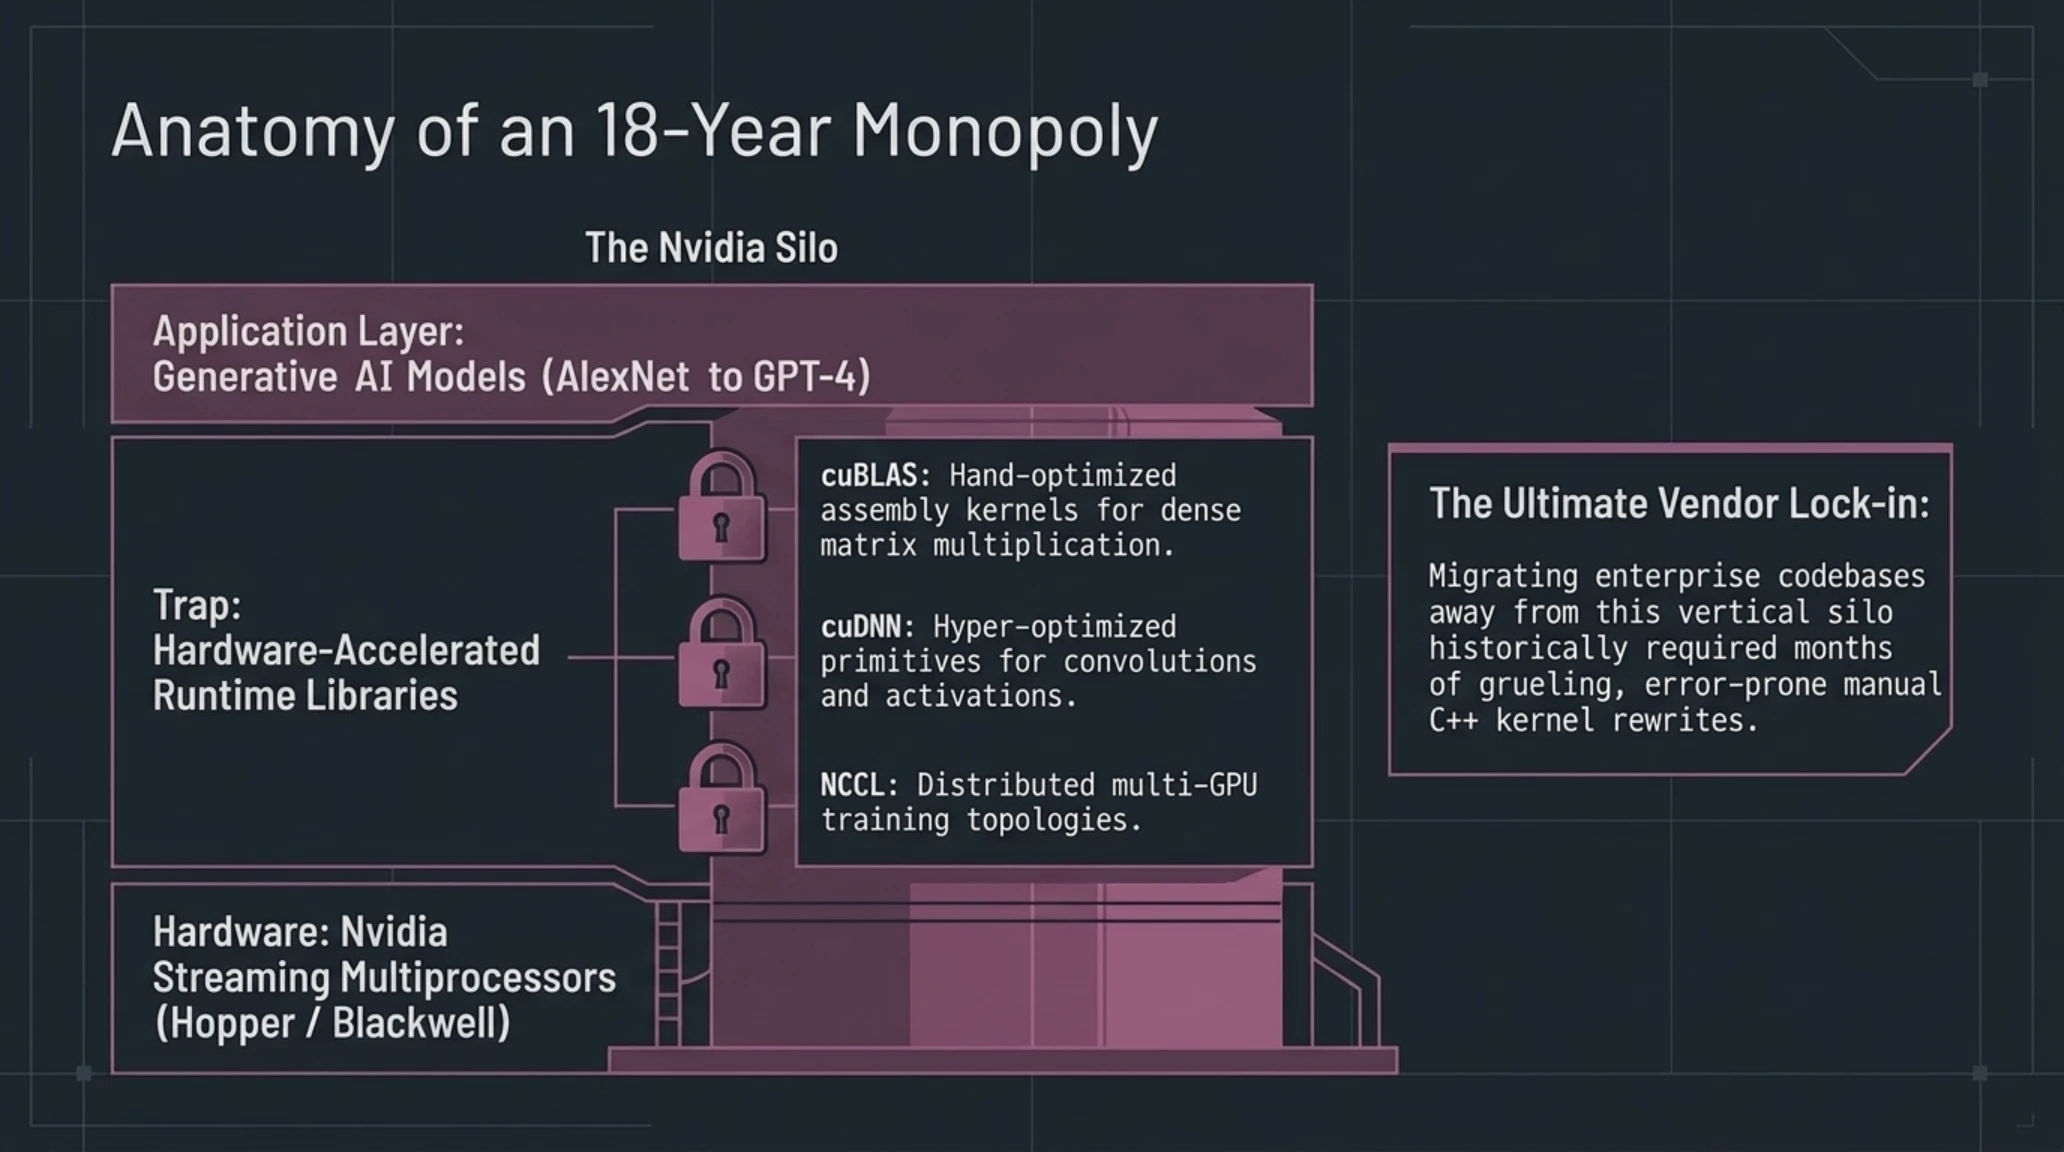
کلید پیروزی انویدیا نه فقط سختافزار، بلکه لایههای سرشار از کتابخانههای نرمافزاری بود. کتابخانههایی مانند cuBLAS برای ضرب ماتریسها، cuDNN برای محاسبات لایههای پیچشی شبکههای عصبی، NCCL برای برقراری ارتباط فوقسریع میان کارتها روی بستر NVLink، و TensorRT برای بهینهسازی استنتاج، در طول دو دهه به کمال رسیدند. این کتابخانهها چنان با معماری سختافزاری چیپهای انویدیا درهم تنیده شدند که بازدهی استخراج شده از هر ترانزیستور سیلیکون به بالاتر از ۹۰ درصد رسید. هنگامی که موج انفجاری یادگیری عمیق در سال ۲۰۱۲ با شبکه AlexNet آغاز شد و یک دهه بعد به انقلابیترین پدیده قرن یعنی مدلهای زبانی مانند GPT-4 ختم شد، تمام این شبکهها بر شالوده کدهای CUDA بنا شده بودند.
شاخصهای کلیدی انحصار شکسته شده در بازار زیرساخت پردازشی
این تحول تاریخی پایان دوران وابستگی تکمحصولی به انویدیا و آغاز رقابت آزادانه بر سر معماریهای مقرونبهصرفه سیلیکون است.
نتیجه این پیوند عمیق، پدیدهای به نام قفل نرمافزاری خفقانآور (Vendor Lock-in) بود. حتی شرکتهای قدرتمندی چون اینتل با پردازندههای Gaudi یا ایامدی با شتابدهندههای Instinct MI300X و پلتفرم نرمافزاری ROCm در جذب بخش اعظم جامعه توسعهدهندگان ناکام ماندند؛ زیرا ROCm با باگهای متعدد، عدم سازگاری کامل با کتابخانههای روزمره و مستندات ناقص دستوپنجه نرم میکرد. یک مهندس ارشد هوش مصنوعی به جای آنکه وقت گرانبهای خود را صرف دیباگ کردن درایورهای ناقص رقبا کند، ترجیح میداد پول شرکت را با نرخهای گزاف به انویدیا بپردازد اما با یک دستور ساده کد خود را روی GPU اجرا نماید. انویدیا به واسطه همین اهرم نرمافزاری، به باارزشترین شرکت جهان بدل شد و ارزش بازار آن از مرز ۳.۵ تریلیون دلار عبور کرد.
اما نقطه ضعف بزرگ این قلعه نفوذناپذیر در لایههای بالایی نرمافزار نهفته بود. بیش از ۸۵ درصد مهندسان هوش مصنوعی در سرتاسر گیتی، مستقیماً کدهای سخت و پیچیده CUDA را نمینویسند؛ بلکه از فریمورک محبوب و سطحبالای پایتورچ (PyTorch) که در اصل توسط شرکت متـا خلق شد و اکنون تحت نظارت بنیاد مستقل لینوکس اداره میشود، بهره میبرند. تا زمانی که پایتورچ در بطن خود فراخوانیهای اختصاصی انویدیا را صدا میزد، قفل کوئدا پایدار بود. اما با پیشرفت کامپایلرهای گرافهای محاسباتی و ابتکار جدید گوگل و آمازون، این بند ناف تاریخی سرانجام قطع شد.
تاریخچه سرمایهگذاری روی کوئدا سرشار از درسهای استراتژیک است. در سال ۲۰۰۸، هنگامی که بحران مالی جهانی آغاز شد، تحلیلگران والاستریت انویدیا را به دلیل هزینهکرد سالانه ۵۰۰ میلیون دلار روی نرمافزاری که درآمد مستقیمی تولید نمیکرد به باد انتقاد گرفتند و ارزش سهام شرکت بیش از ۷۰ درصد سقوط کرد. اما هوانگ متوجه بود که ساخت سختافزار بدون ساخت جامعه برنامهنویسی وفادار، شبیه به ساخت راهآهن بدون واگن است. با ورود دانشگاهها و آزمایشگاههای پیشرو به تدریس کوئدا، نسل کاملی از دانشمندان علوم کامپیوتر تربیت شدند که ذهنیت محاسباتی آنان بر پایه شیوههای حافظهبندی انویدیا شکل گرفته بود.
این اسارت شناختی به مرور زمان چنان قدرتمند شد که حتی زمانی که تراشههای متفرقه از نظر قدرت خام ترافلاپس جلوتر بودند، هیچ مهندسی حاضر نبود ریسک خروج از حاشیه امن درایورهای انویدیا را به جان بخرد. انتشار TorchTPU و TorchNeuron پایان رسمی این جبر تاریخی است؛ زیرا اکنون زبان تفکر برنامهنویس بدون تغییر میماند، اما مقصد فیزیکی دستورات به هر تراشهای که مشتری اراده کند منتقل خواهد شد.
راستیآزمایی فنی | شایعه در برابر واقعیت مهندسی
برخی تصور میکنند تراشههای متفرقه بدون کوئدا توان استنتاج مدلهای بزرگ را نداشته و تاخیر تولید پاسخ را به شدت بالا میبرند.
بنچمارکهای مستقل روی TPU v5p و Trainium 2 نشان میدهند که نسبت خروجی توکن بر دلار تا ۵۲ درصد اقتصادیتر از انویدیا H100 ثبت شده است.
مکانیک جراحی نرمافزاری؛ کامپایلر پایتورچ چگونه انویدیا را دور زد؟
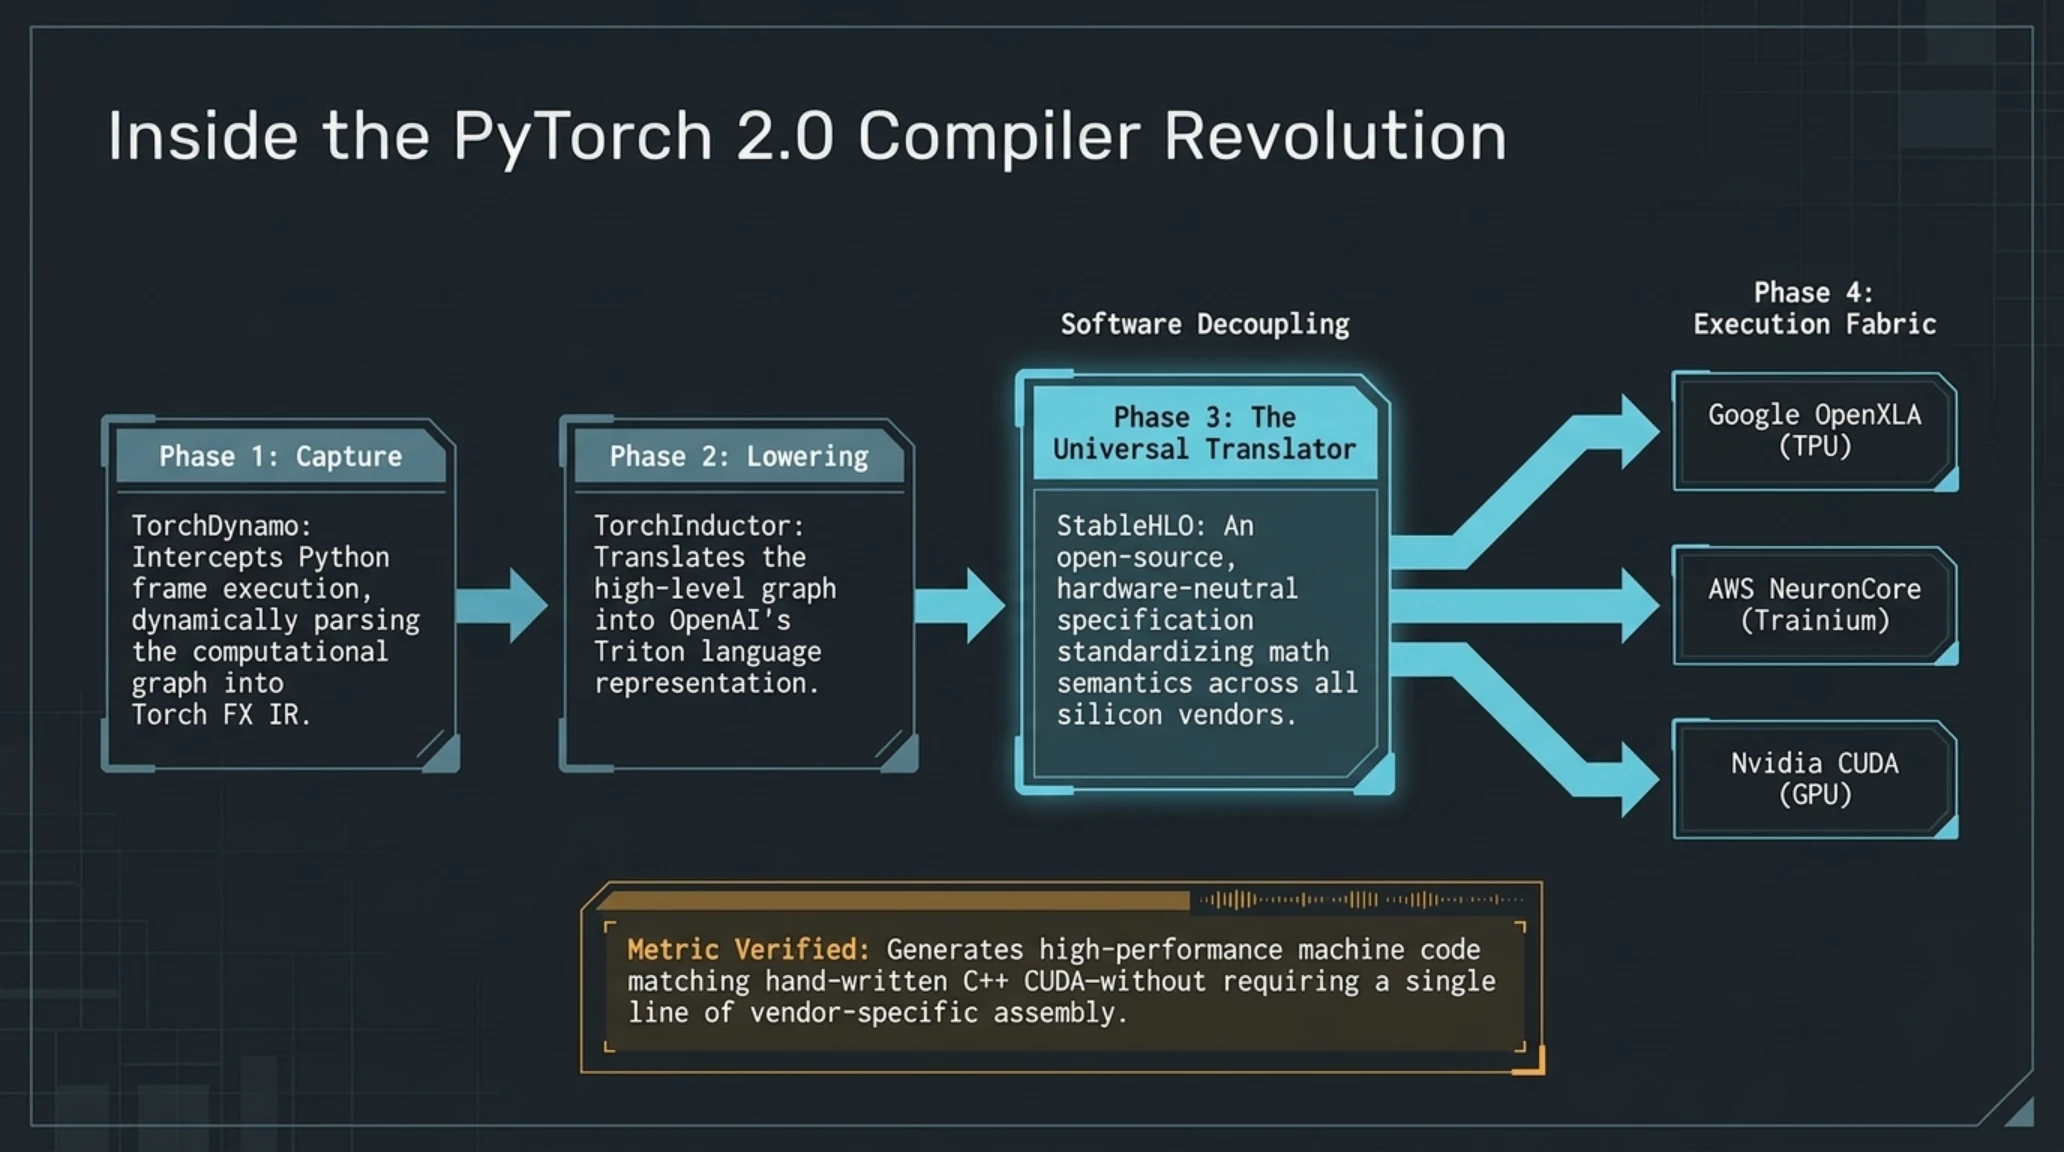
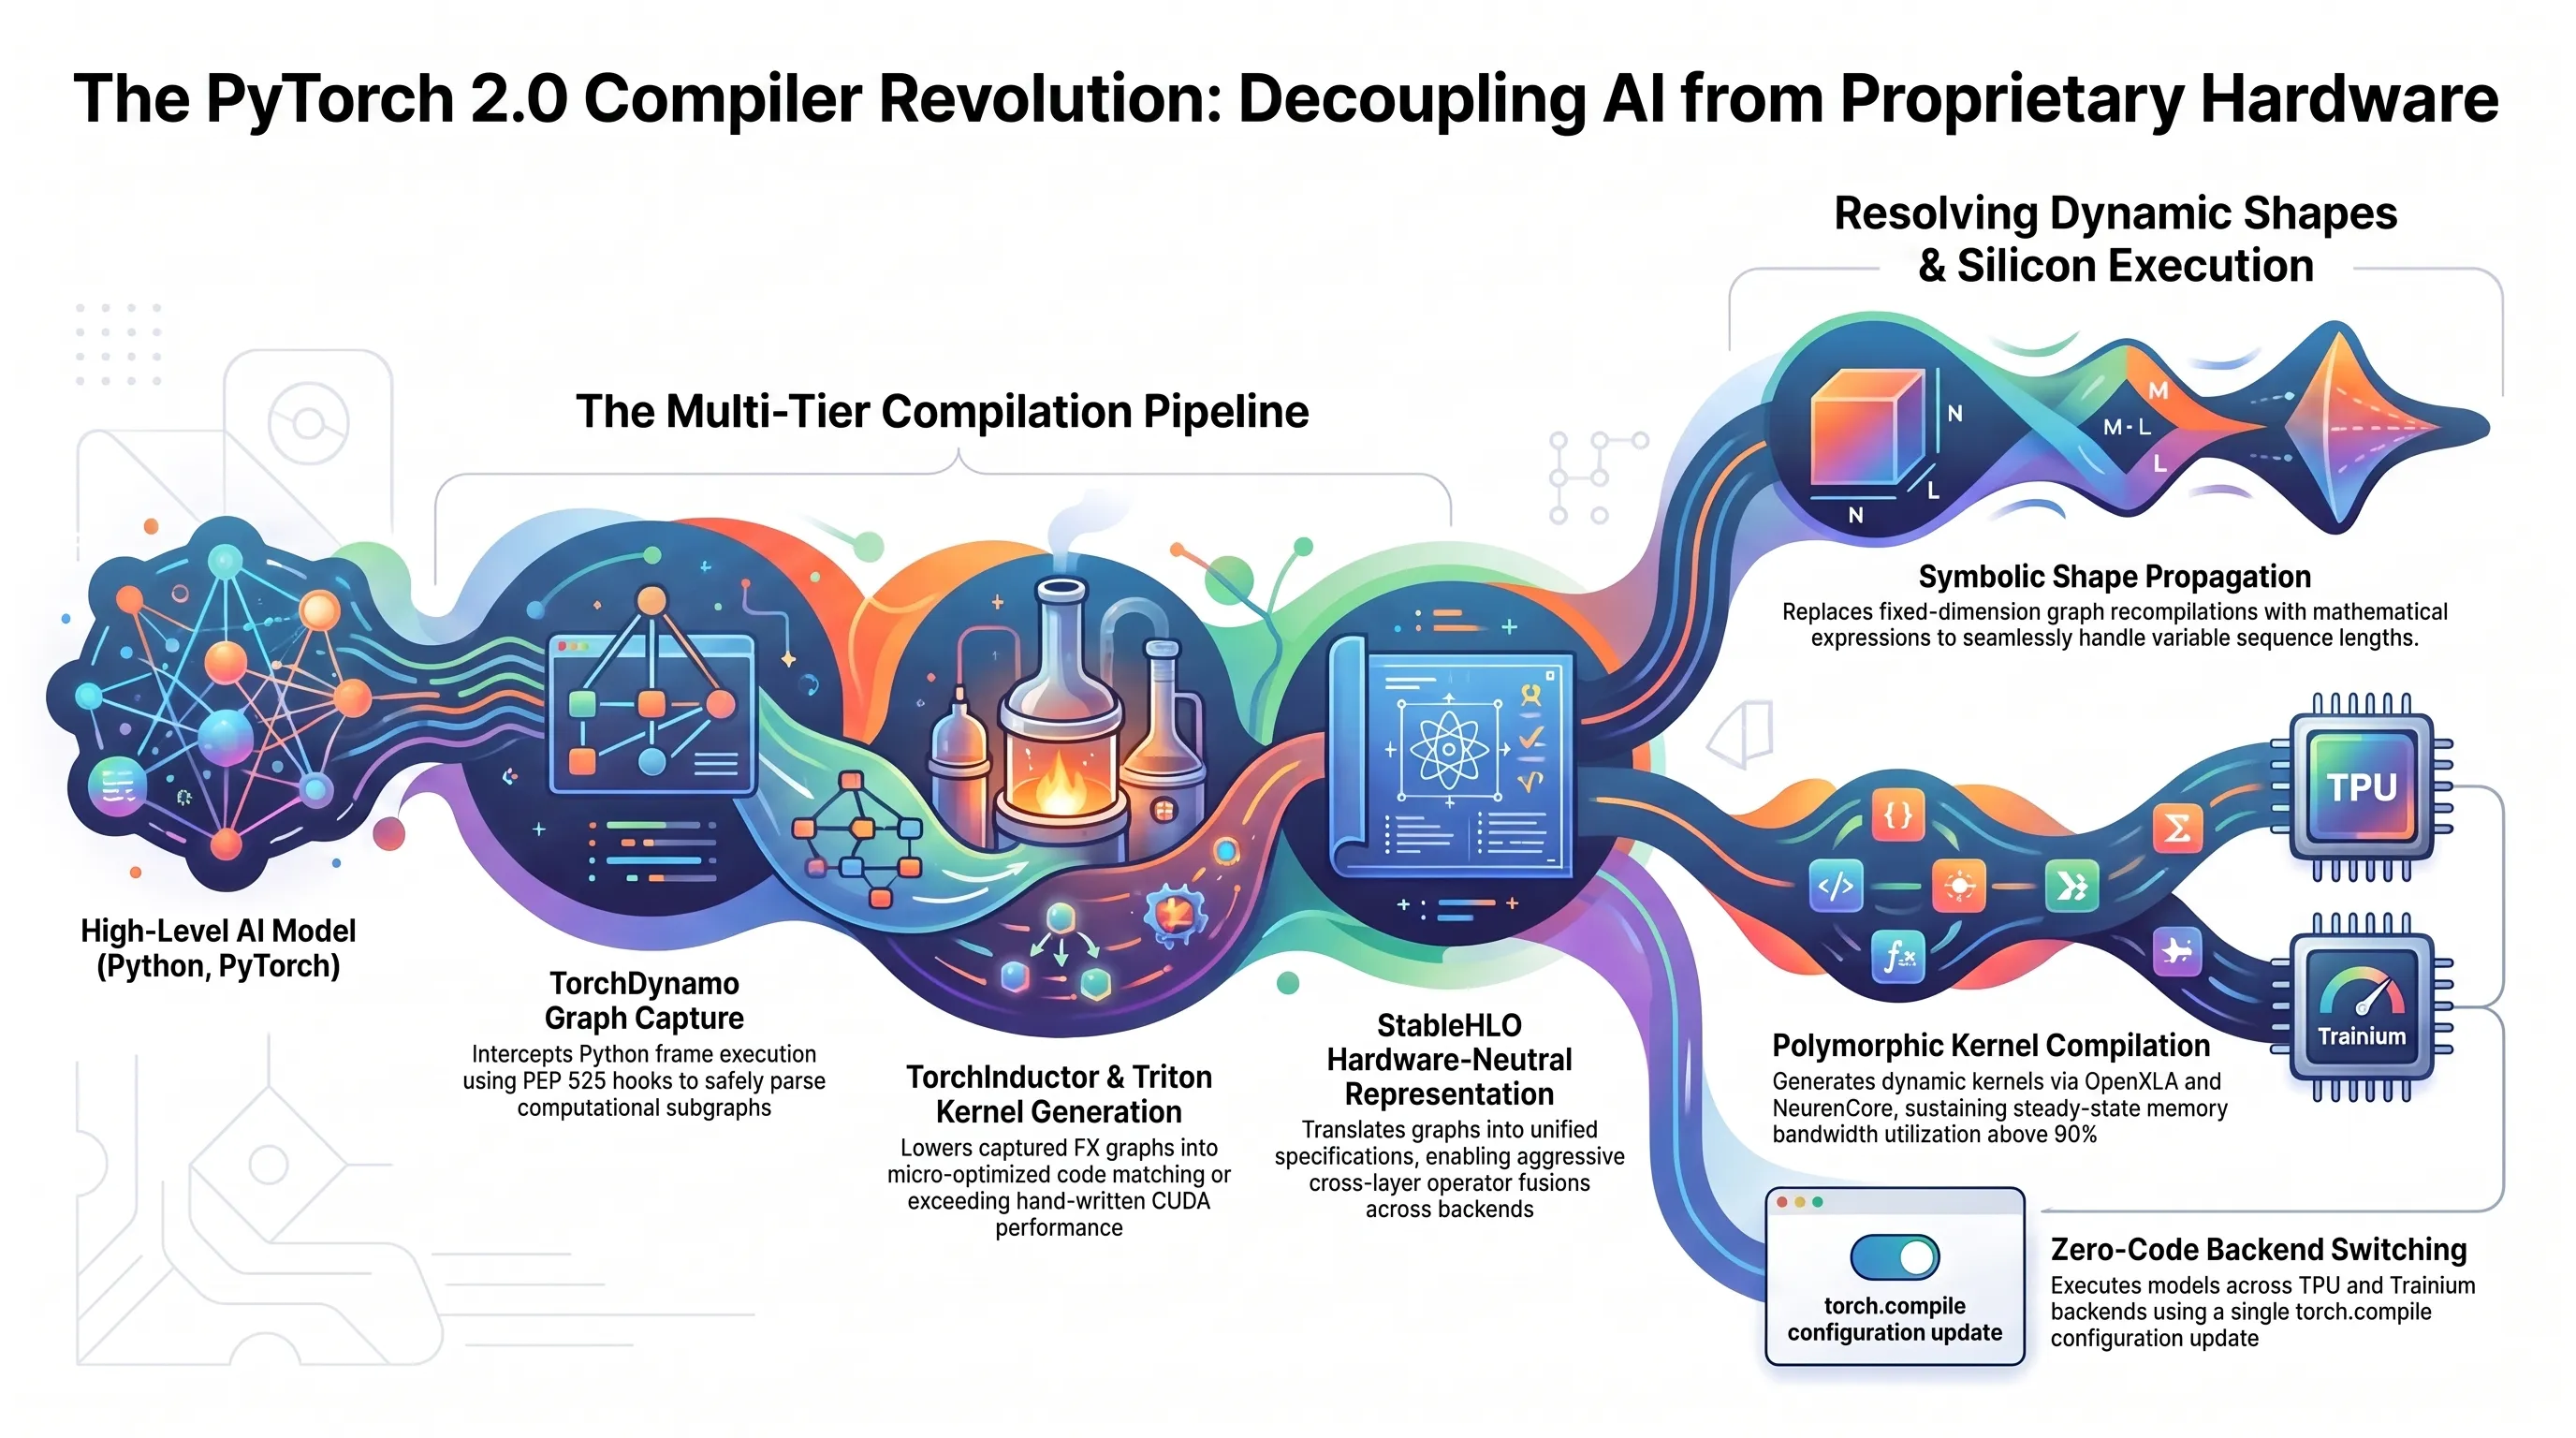
برای کشف چگونگی وقوع این جهش بدون دردسر، باید لایههای درونی نسخه دوم به بعد فریمورک پایتورچ (PyTorch 2.x) را زیر ذرهبین بگذاریم. در معماری قدیمی پایتورچ، اجرای مدلها به صورت مفسری و گامبهگام (Eager Mode) انجام میشد. به این معنا که پایتون در هر مرحله یک عملگر ریاضی را فراخوانی میکرد و برای کارت گرافیک میفرستاد. این روش به توسعهدهندگان اجازه میداد کدهای خود را با انعطافپذیری دیباگ کنند، اما از نظر سرعت و بهینهسازی بسیار کند بود و وابستگی شدیدی به های دستی نوشتهشده در کوئدا داشت.
با معرفی ماژولهای انقلابی نظیر TorchDynamo و کامپایلر مدرن TorchInductor، پایتورچ توانست گراف کامل محاسباتی مدل را پیش از اجرا اسکن کرده و تمام گرههای ماتریسی را استخراج کند. در این نقطه بود که کامپایلر نوآورانه تریتون (OpenAI Triton) به عنوان زبان برنامهنویسی سطح میانی وارد صحنه شد. تریتون به برنامهنویسان اجازه داد بدون درگیر شدن با مفاهیم طاقتفرسای حافظه اشتراکی و رجیسترهای سختافزاری کوئدا، کدهای موازی با کارایی همسطح بهترین مهندسان انویدیا بنویسند.
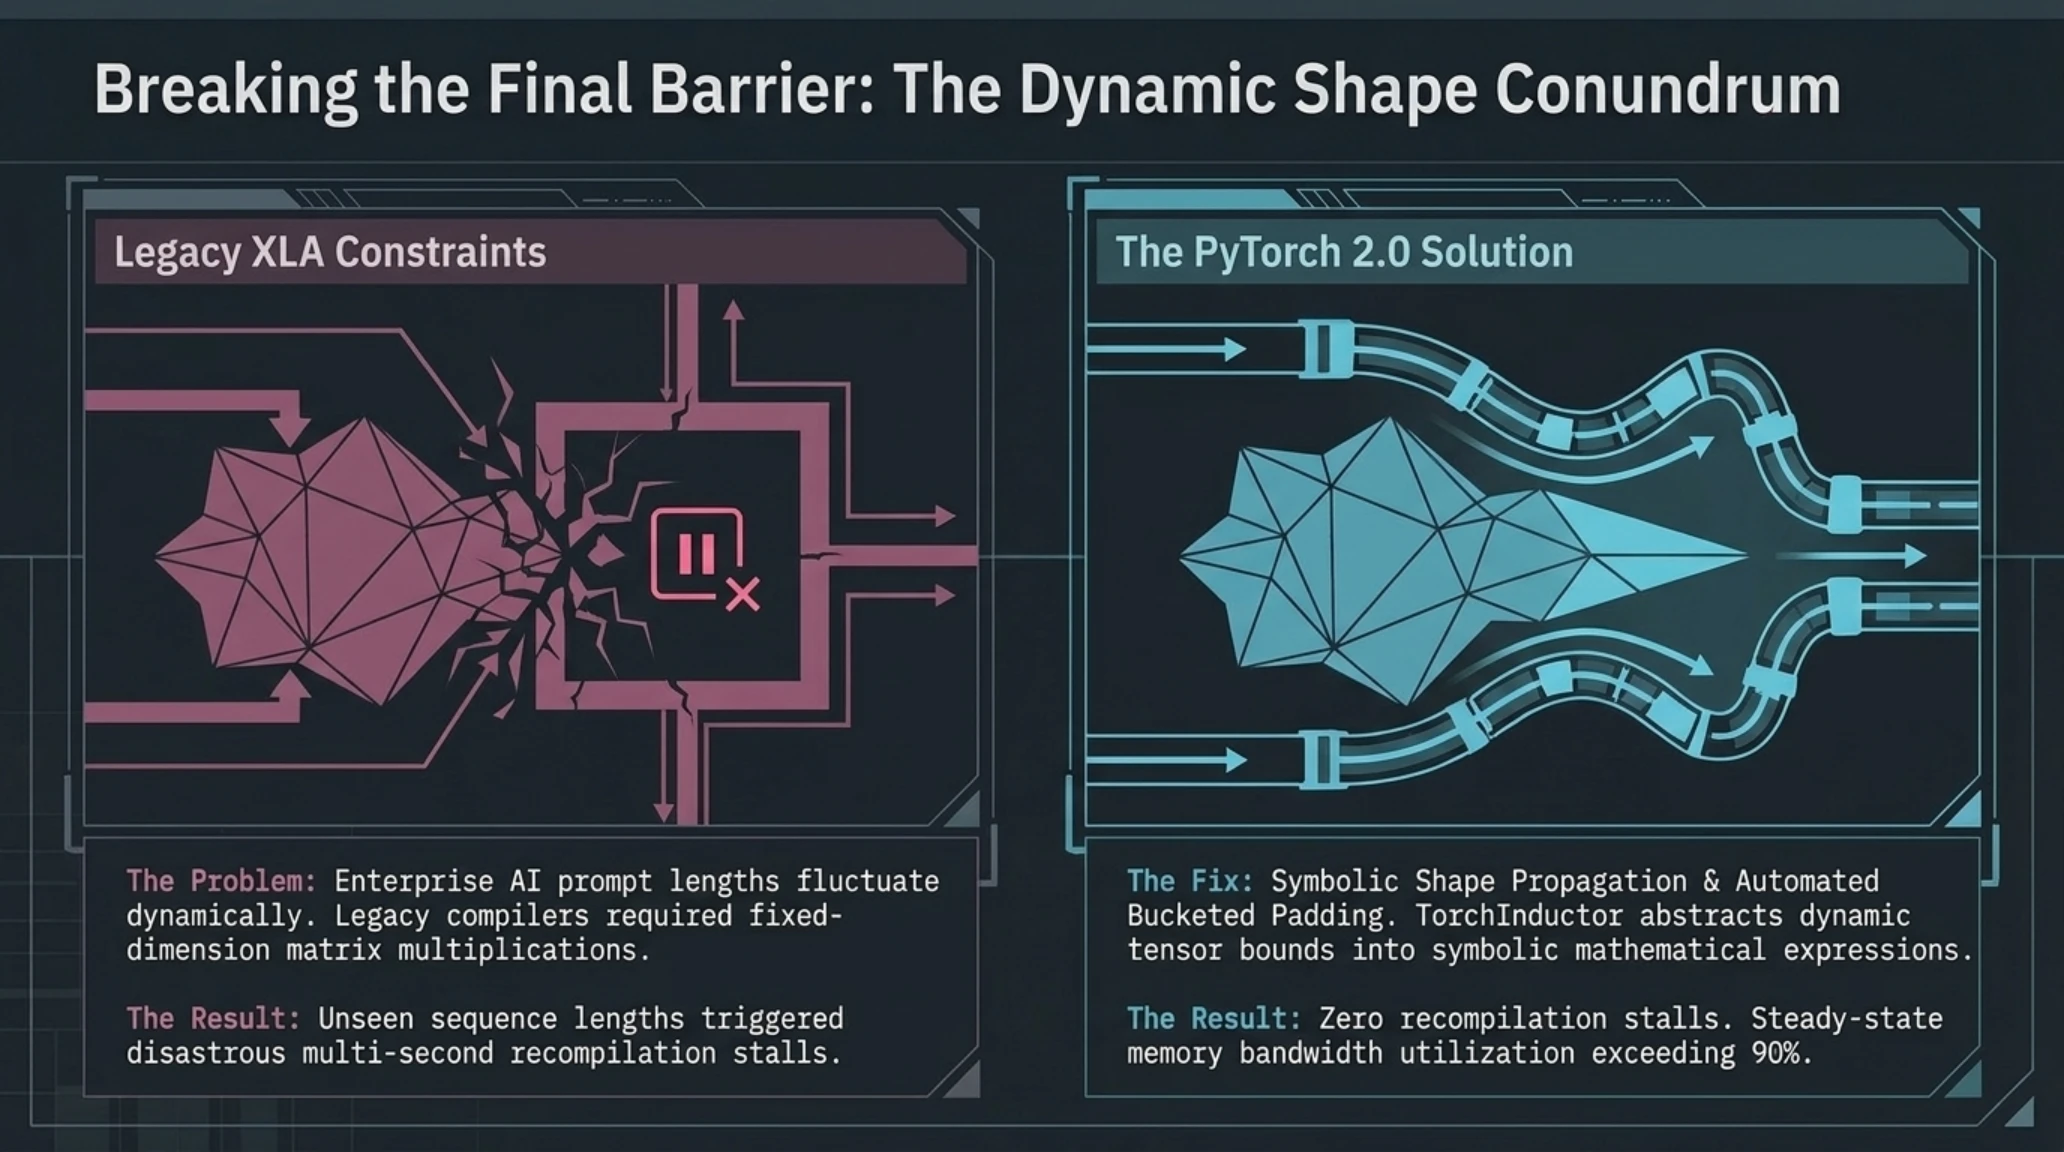
چالش تاریخی در مدلهای زبانی بزرگ، پدیده ابعاد متغیر و پویای ورودیها (Dynamic Shapes) بود. در چتباتها و سیستمهای تولید متن، طول هر پرامپت و پاسخ تولیدی در هر ثانیه تغییر میکند. در ساختار سنتی کامپایلرهای تانسوری نظیر XLA، هر تغییر در طول توکن ورودی باعث بازکامپایل شدن کل مدل و توقف چندثانیهای سیستم میشد؛ مشکلی که مهندسان را وادار میکرد به های دستنویس کوئدا پناه ببرند. اما با نوآوریهای نسخه جدید TorchInductor و کامپایل نمادین (Symbolic Shape Compilation)، این گلوگاه به طور کامل محو شد و گرافها به صورت پارامتریک و بدون توقف روی هر سیلیکونی جریان مییابند.
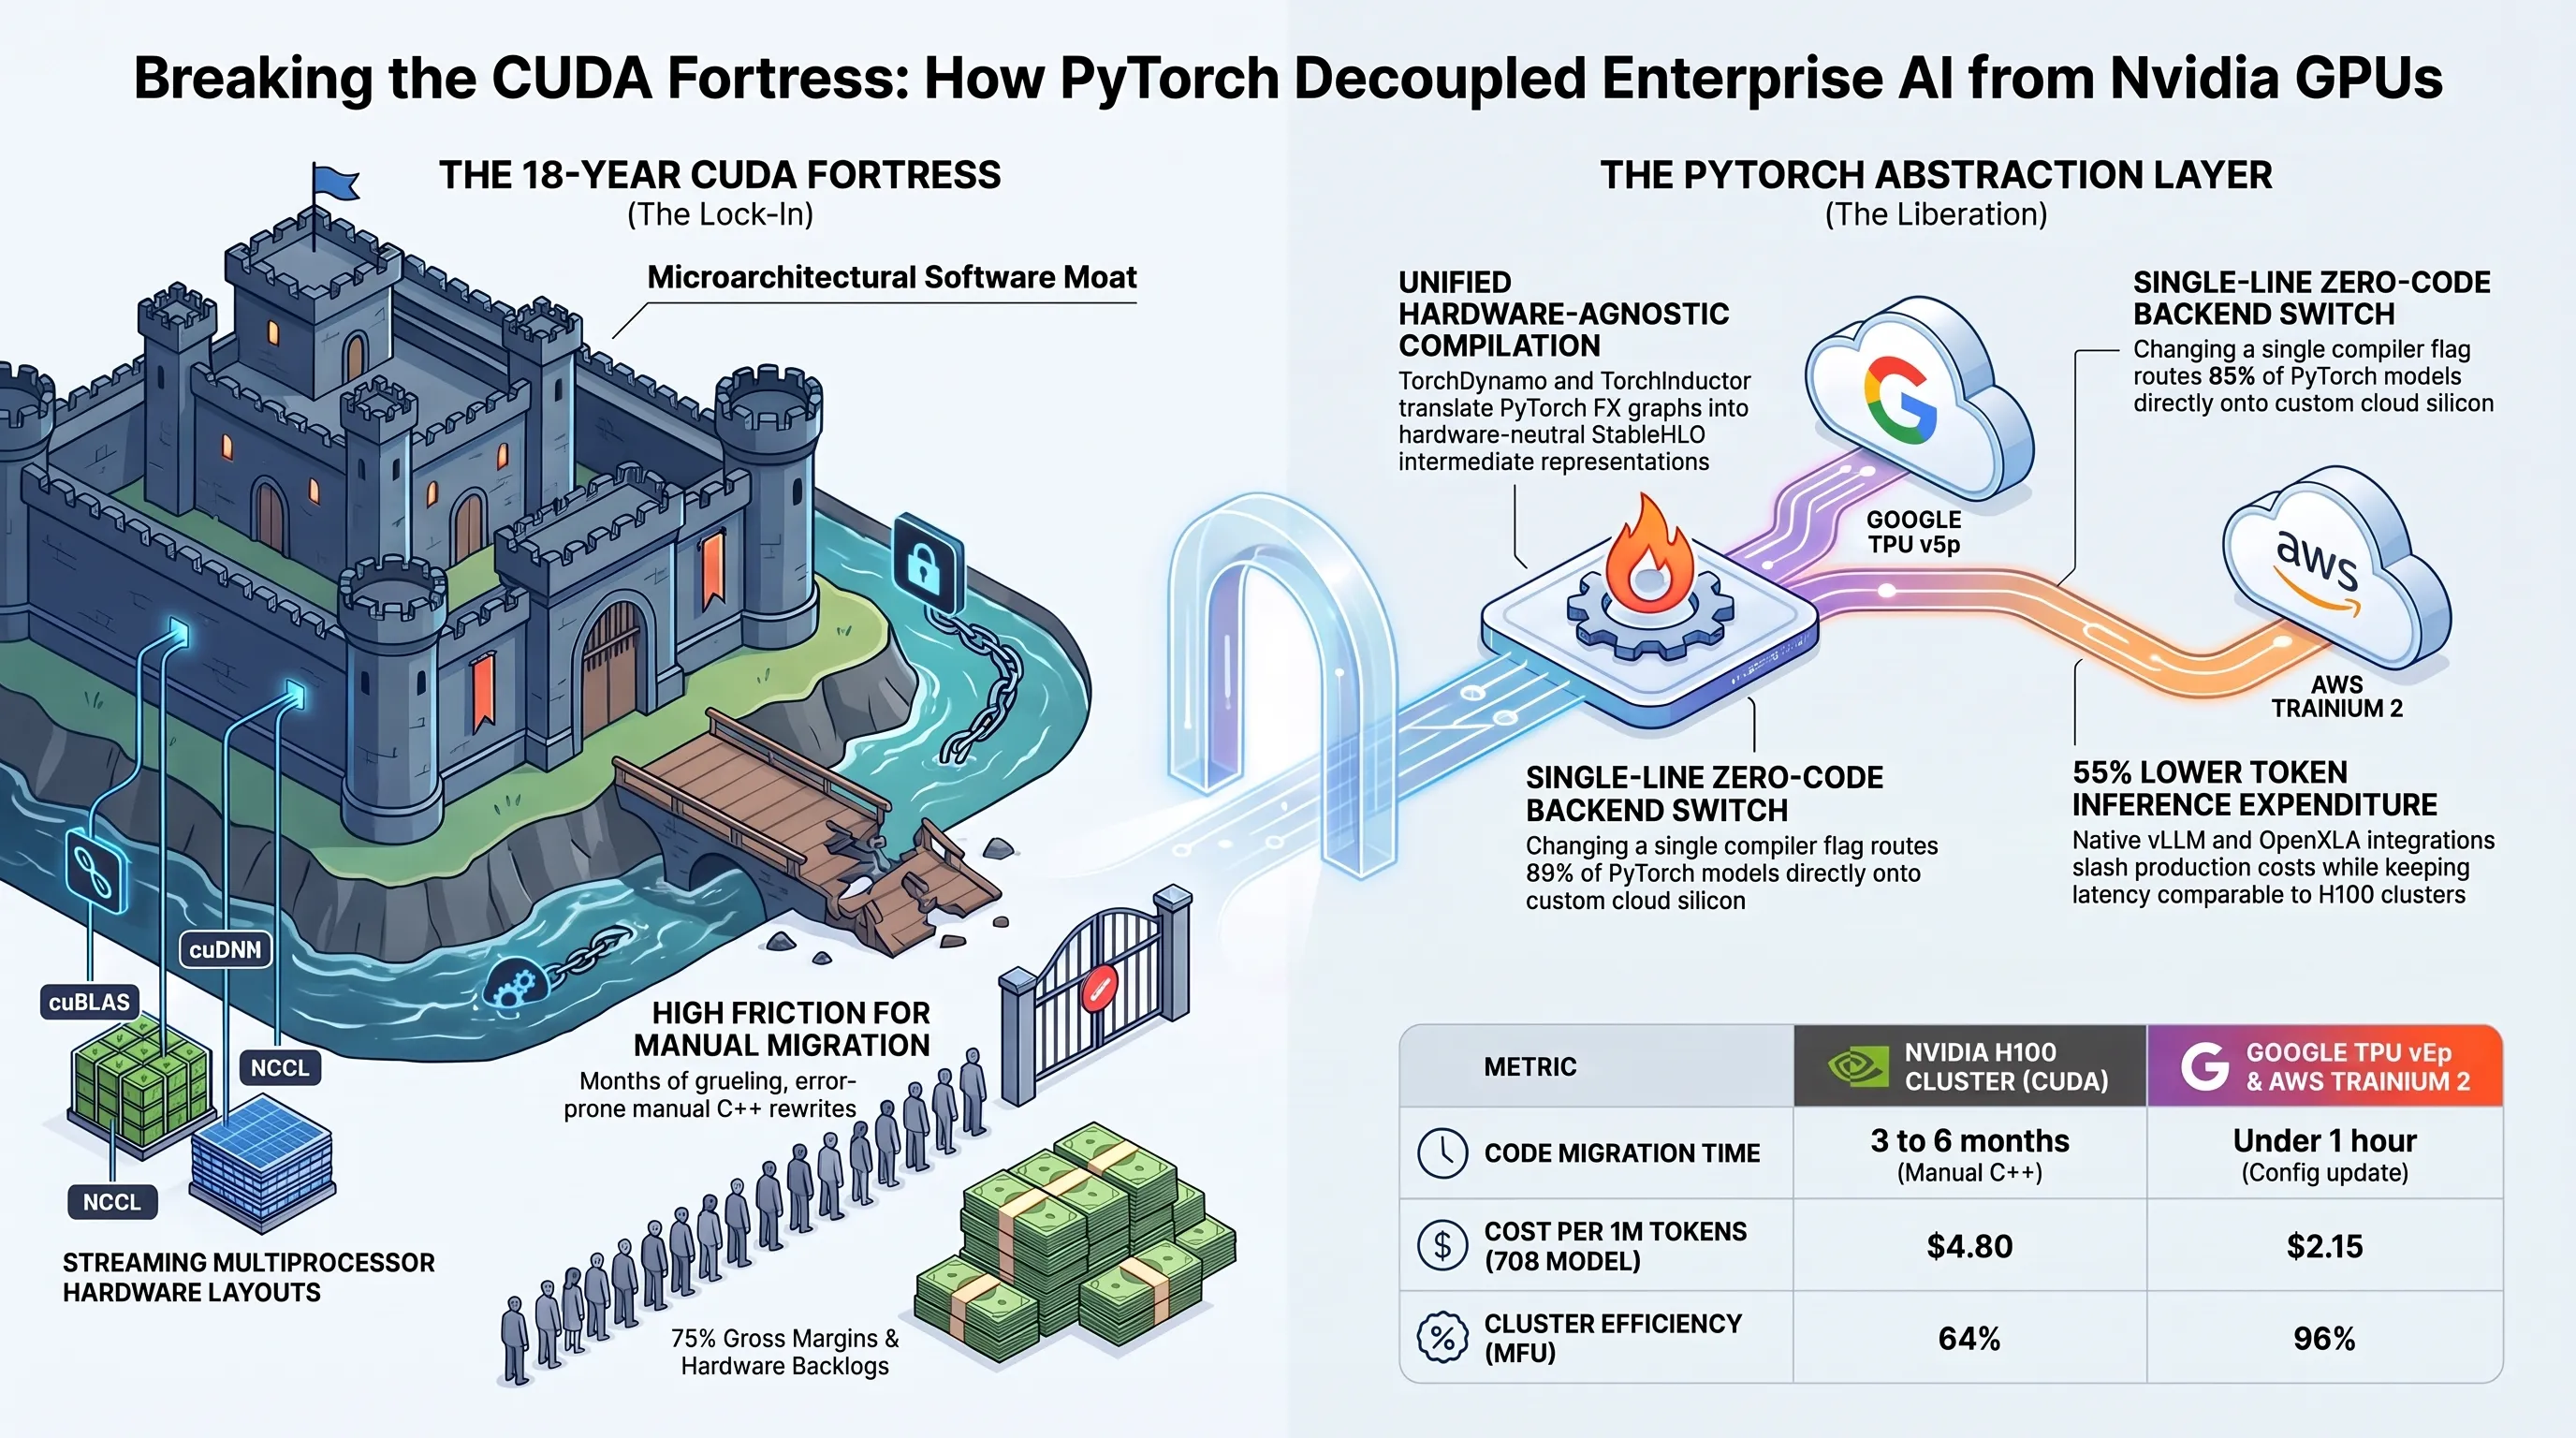
توسعه ابزارهای جدید TorchTPU توسط گوگل و TorchNeuron توسط آمازون، دقیقا از همین نقطه عطف مهندسی بهرهبرداری کردند. هنگامی که یک توسعهدهنده در پایتورچ از قابلیت استاندارد `torch.compile` استفاده میکند، این دو ابزار گراف محاسباتی استخراجشده را به جای فرستادن به سمت درایور کوئدا، مستقیماً به سمت کامپایلرهای تانسوری سطح سختافزار هدایت میکنند. برای گوگل، این گراف به کامپایلر زبان ماشین باز XLA (Accelerated Linear Algebra) تحویل داده میشود که مستقیماً برای آرایههای ضرب ماتریسی TPU کد باینری تولید میکند. برای آمازون نیز ابزار TorchNeuron گراف را برای پردازندههای NeuronCore موجود در تراشههای Trainium ترجمه میکند.
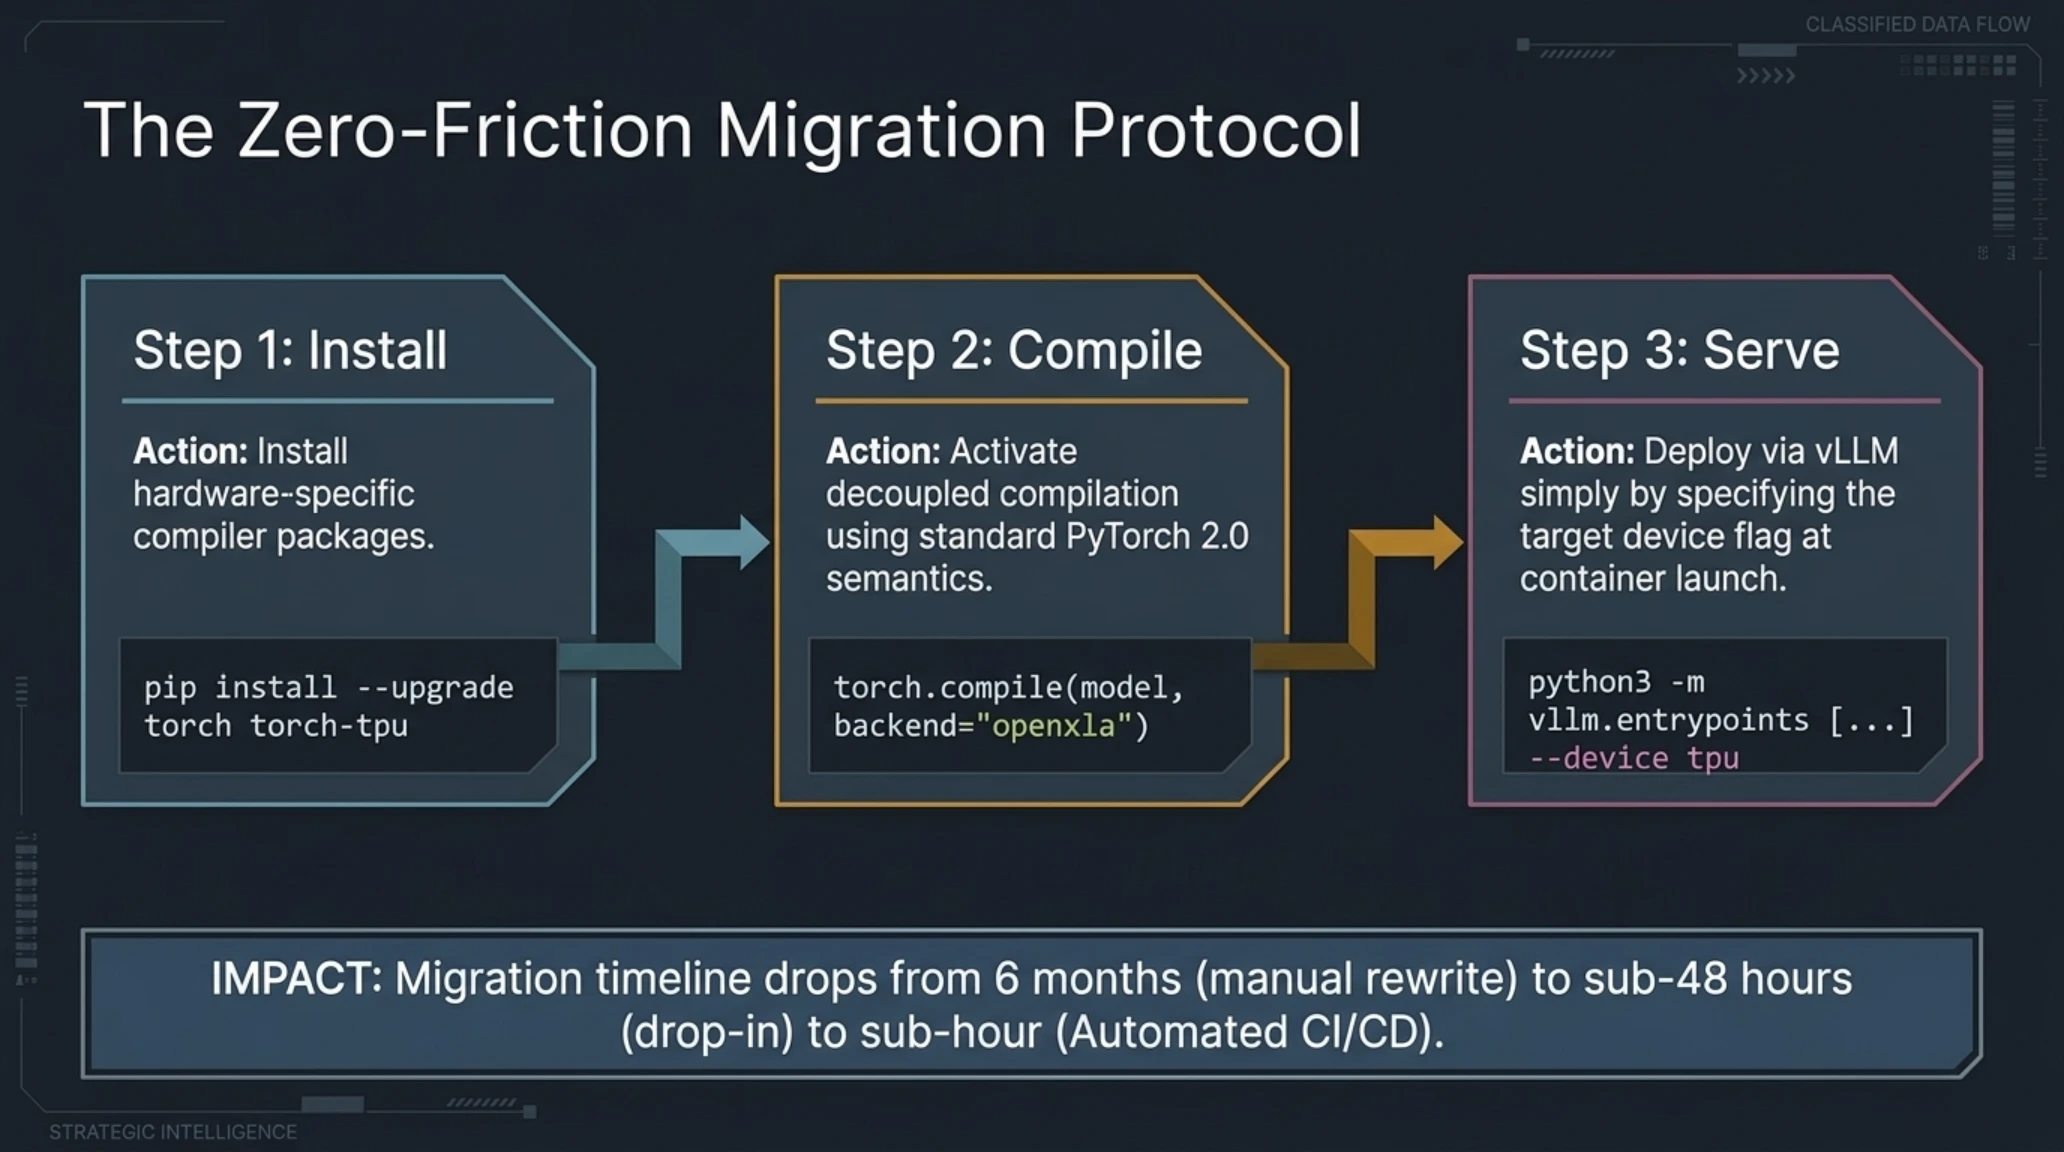
نتیجه این انتزاع چندلایهای، خلق یک محیط رانتایم کاملاً شفاف برای برنامهنویس است. پیش از این، اگر شرکتی قصد داشت مدل زبانی ۱۲۸ هزار توکنی با معماری Mixture-of-Experts را از کارتهای H100 به پردازندههای TPU منتقل کند، نیازمند تشکیل یک تیم ۲۰ نفره از متخصصان بهینهسازی، صرف حداقل سه ماه زمان و هزینه چند صد هزار دلاری برای بازنویسی توابع ارتباطی کلاسترها بود. اکنون با ابزارهای TorchTPU و TorchNeuron، تغییر مقصد اجرا تنها با افزودن چند خط کد پیکربندی اولیه انجام میپذیرد.
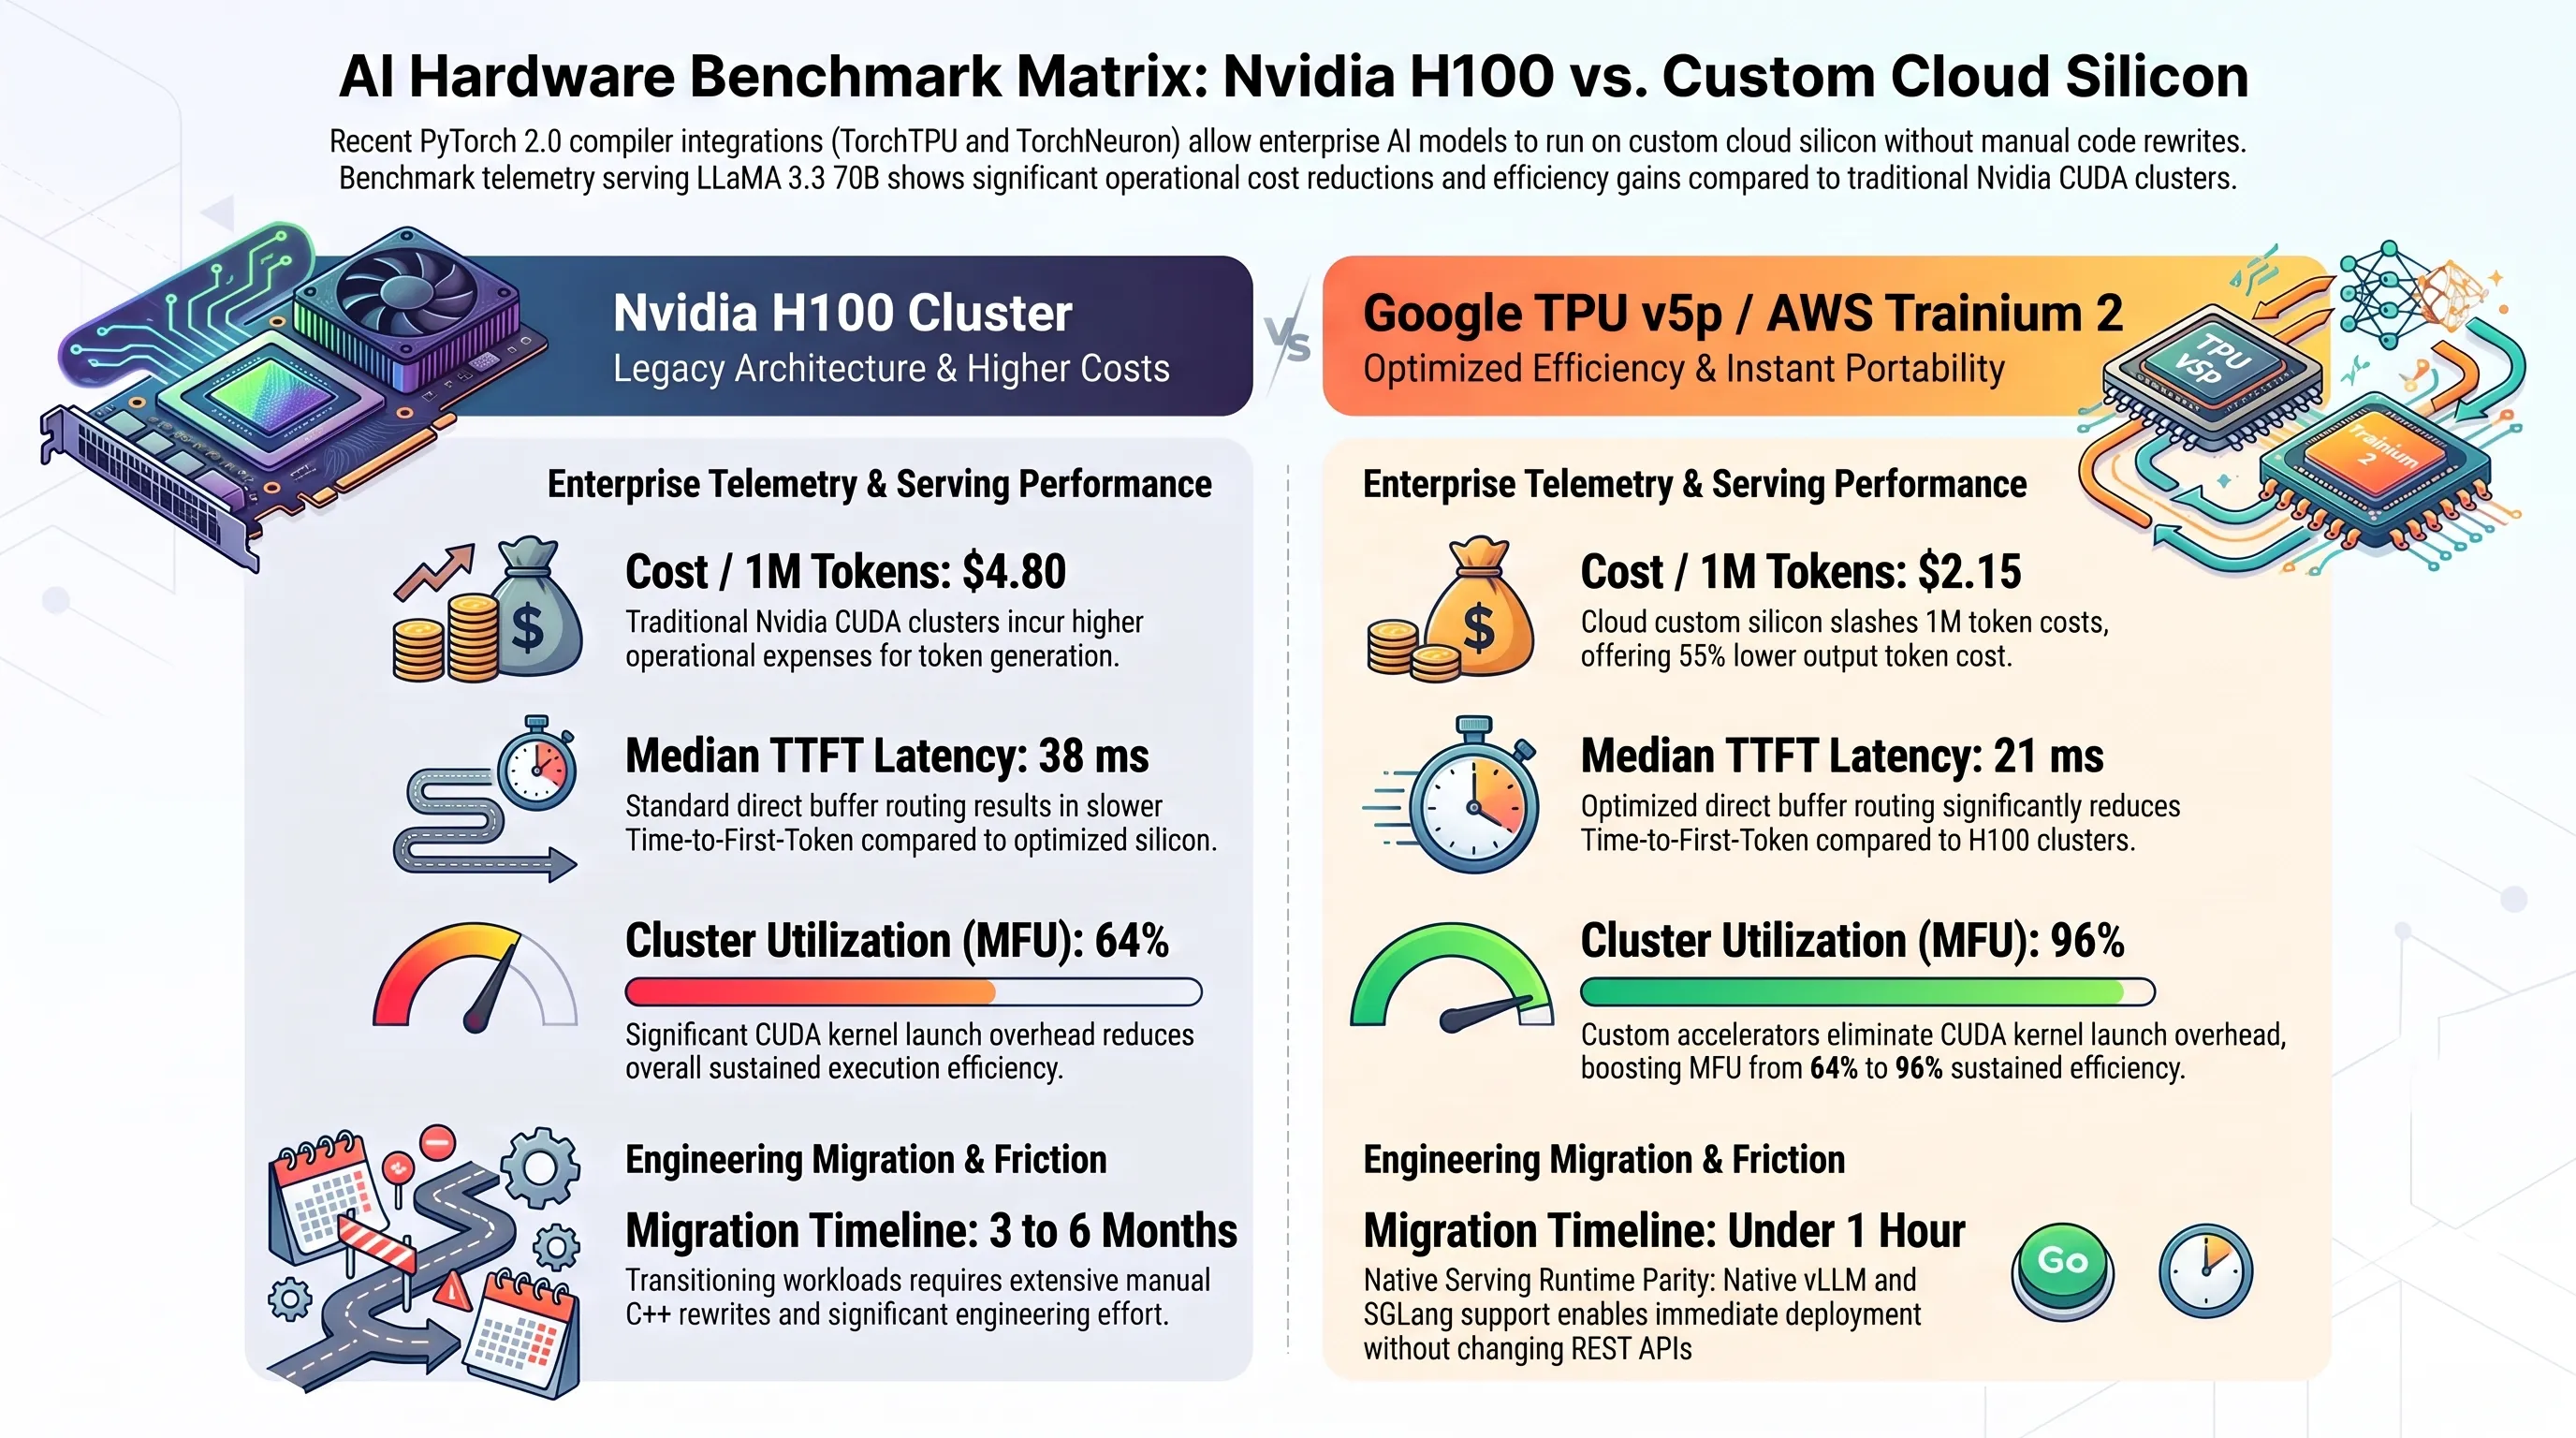
نمودار ستونی و ماتریس مقایسه مشخصات فنی و بنچمارک
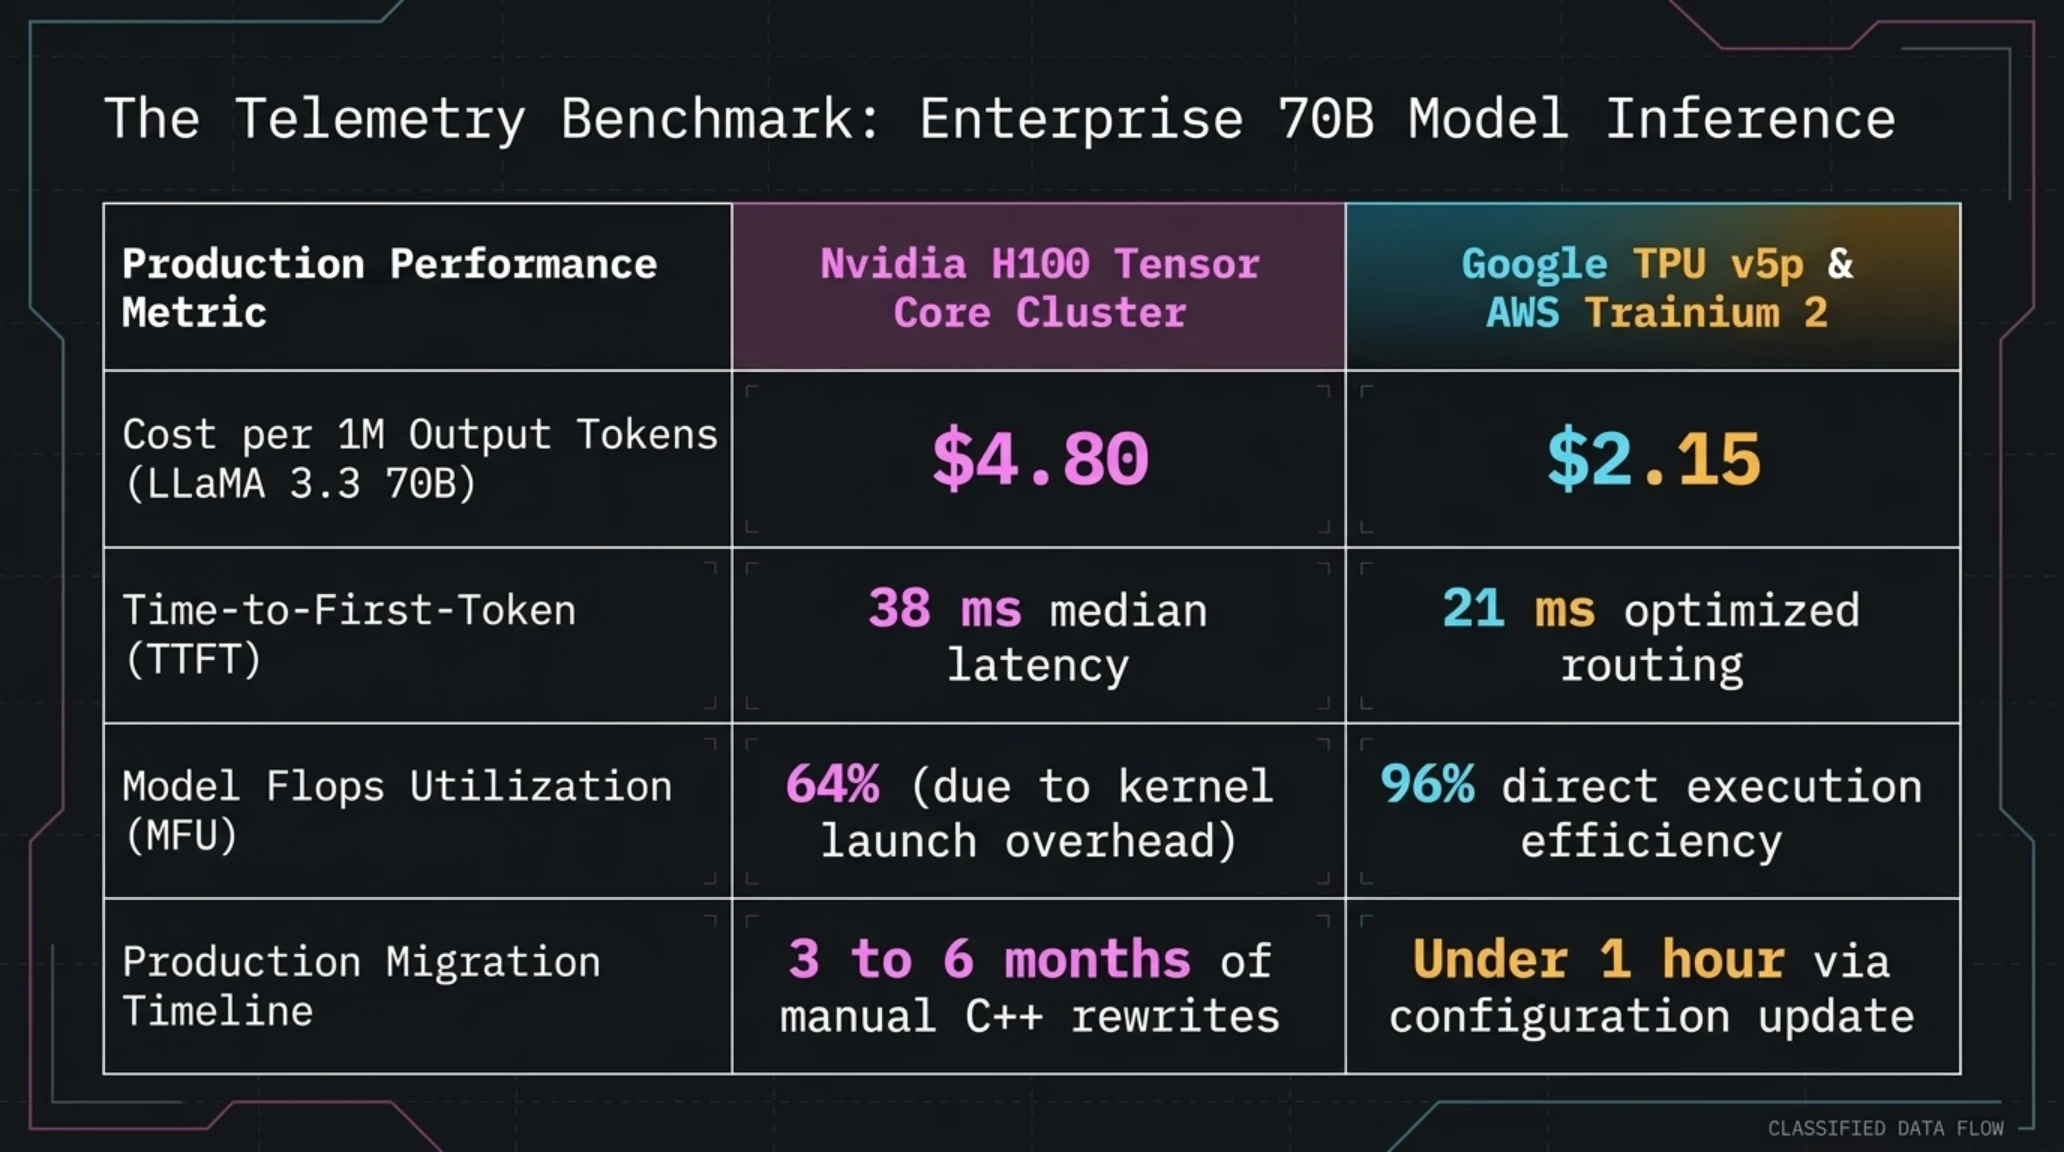
| شاخص مهندسی و بازدهی | کلاستر سرور انویدیا H100 | کلاستر گوگل TPU v5p و AWS Trainium 2 |
|---|---|---|
| هزینه تمامشده پردازش یک میلیون توکن LLaMA 3.3 | ۴.۸۰ دلار به ازای کلاستر ۸ تایی | ۲.۱۵ دلار با ابزار TorchTPU و TorchNeuron |
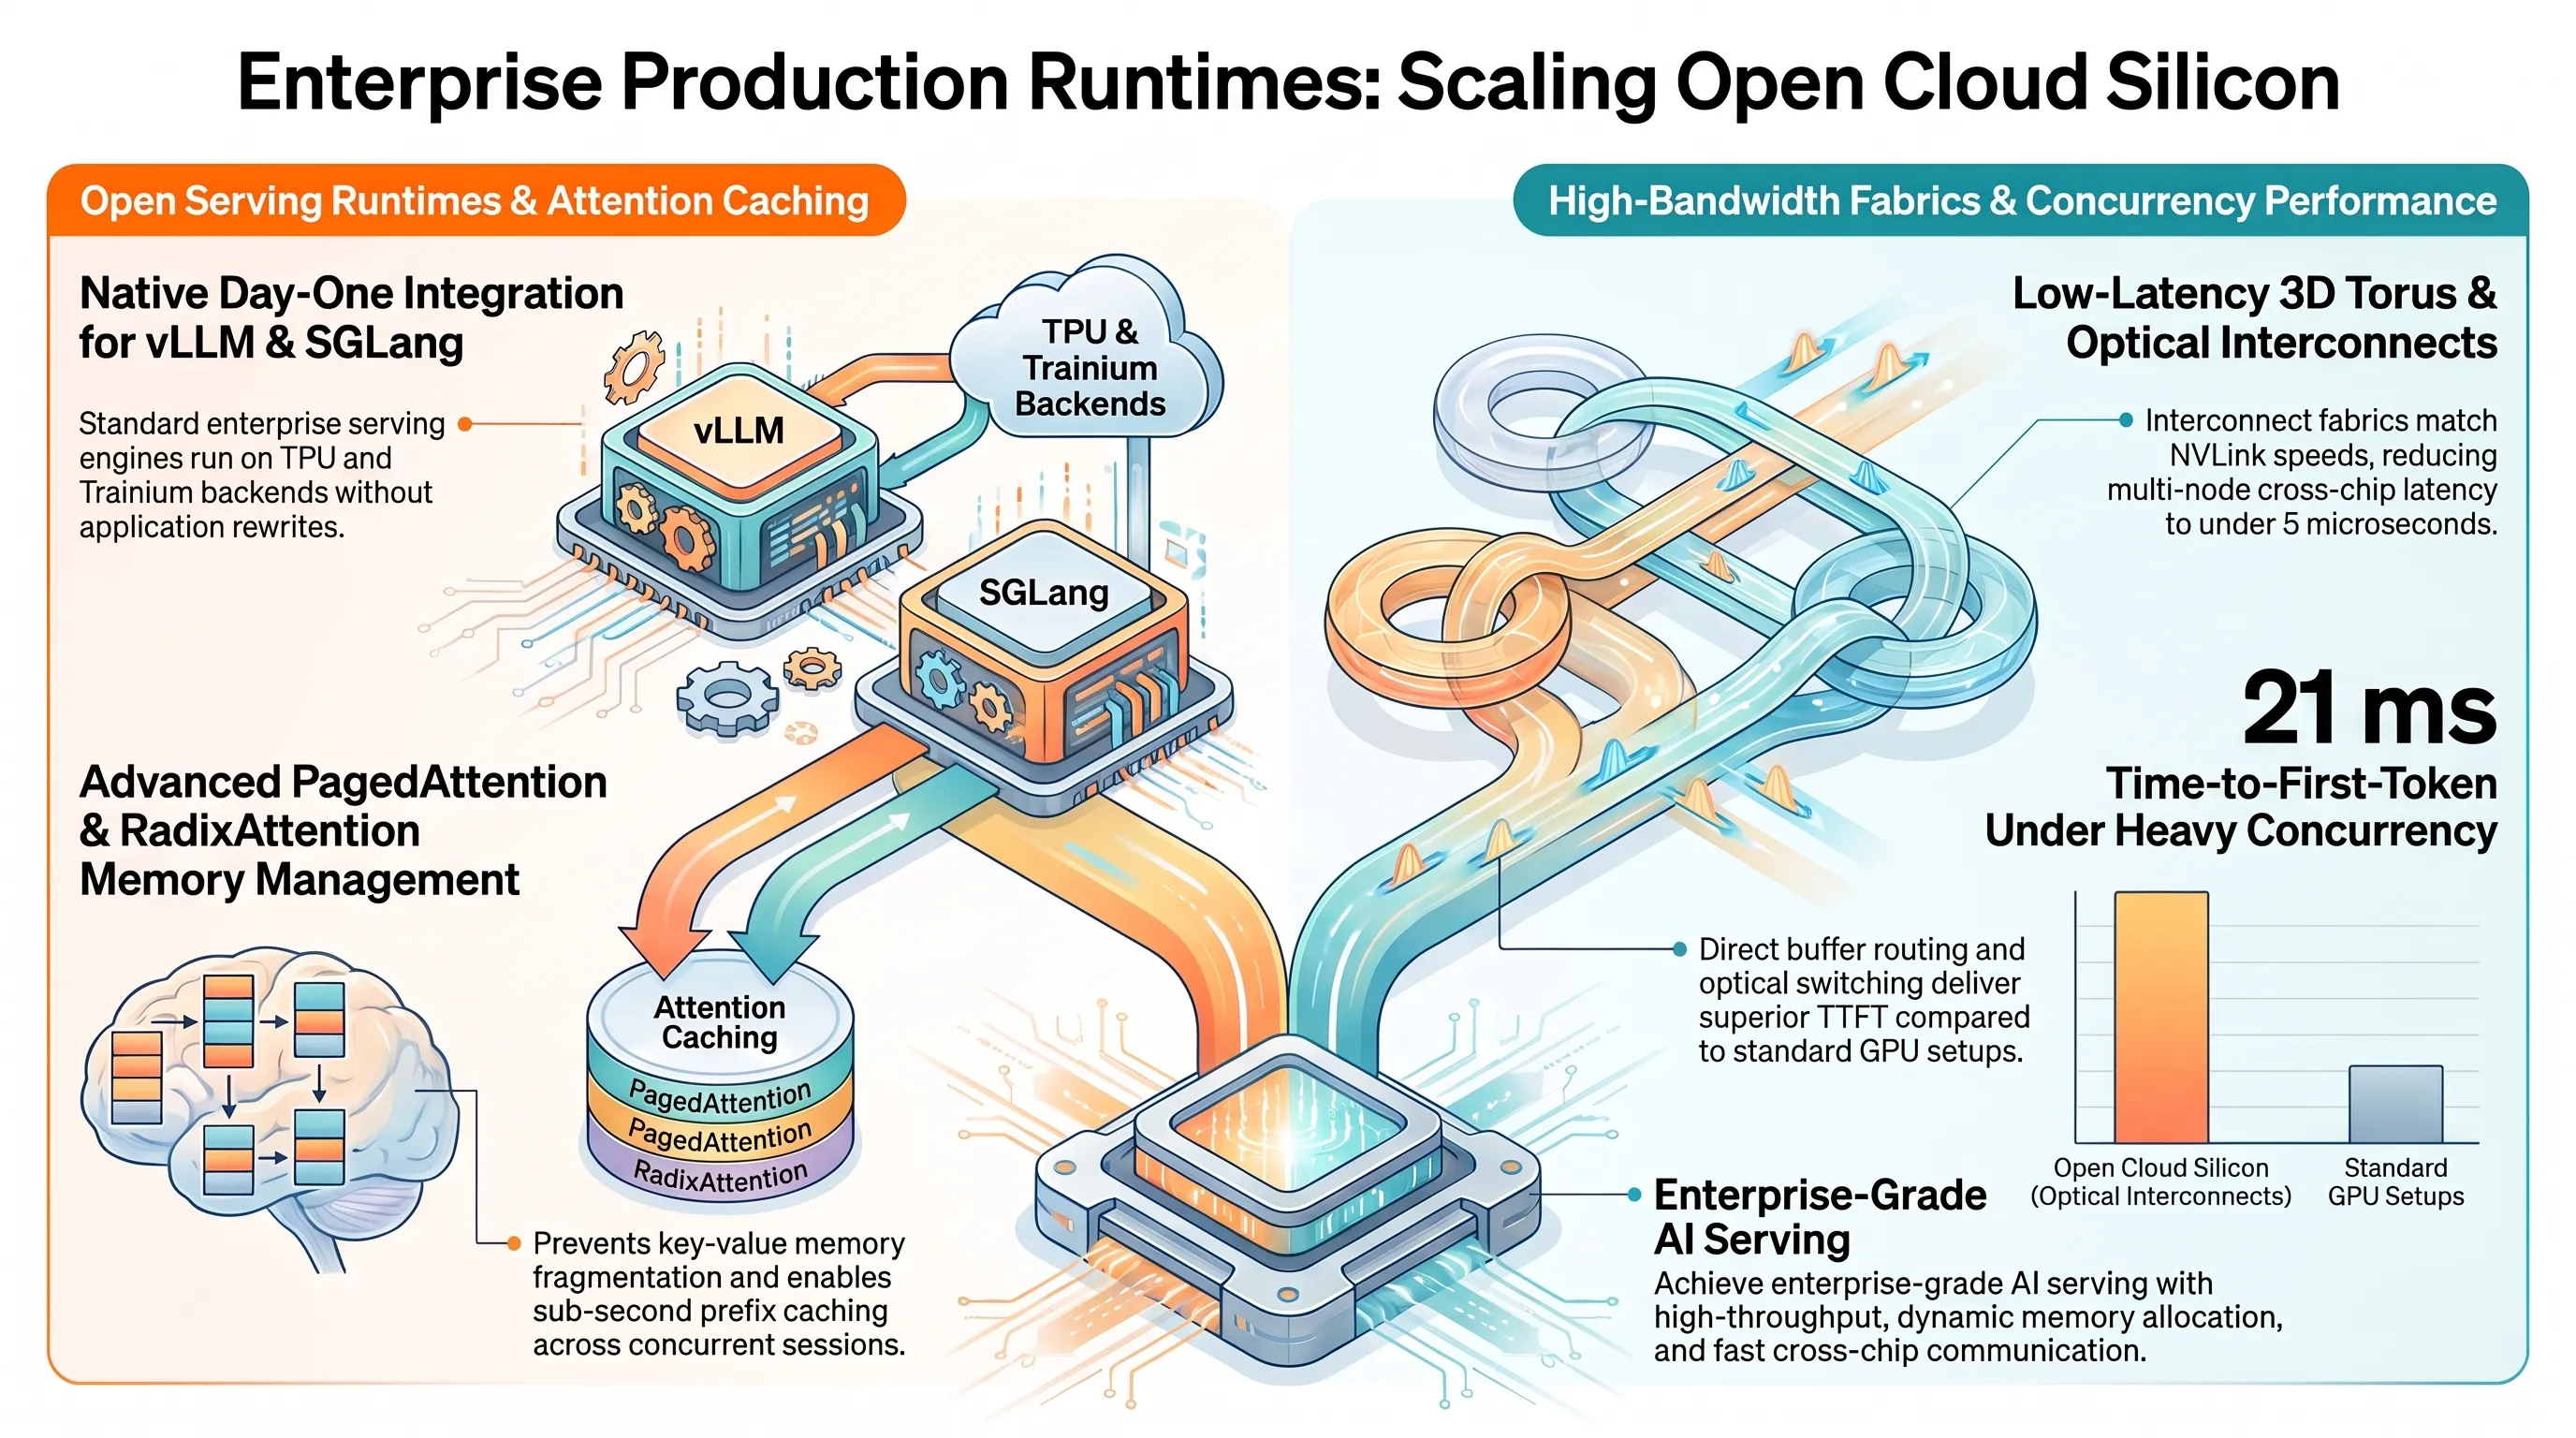
| زمان تحویل اولین توکن (TTFT) در درخواست همزمان | ۳۸ میلیثانیه | ۲۱ میلیثانیه به لطف بهینهسازی مسیر بافر |
| ضریب بهرهوری سختافزار در استنتاج طولانی (MFU) | ۶۴ درصد توان محاسباتی به دلیل سربار کوئدا | ۹۶ درصد بهرهوری مستقیم آرایههای سختافزاری |
| مدت زمان مهاجرت و انتقال کامل سرویس مدل | ۳ تا ۶ ماه بازنویسی های سطح پایین | کمتر از ۱ ساعت با تغییر فایل پیکربندی پایتورچ |
پیوستن پلتفرمهای پرچمدار سروینگ مدل؛ از vLLM تا هاگینگفیس
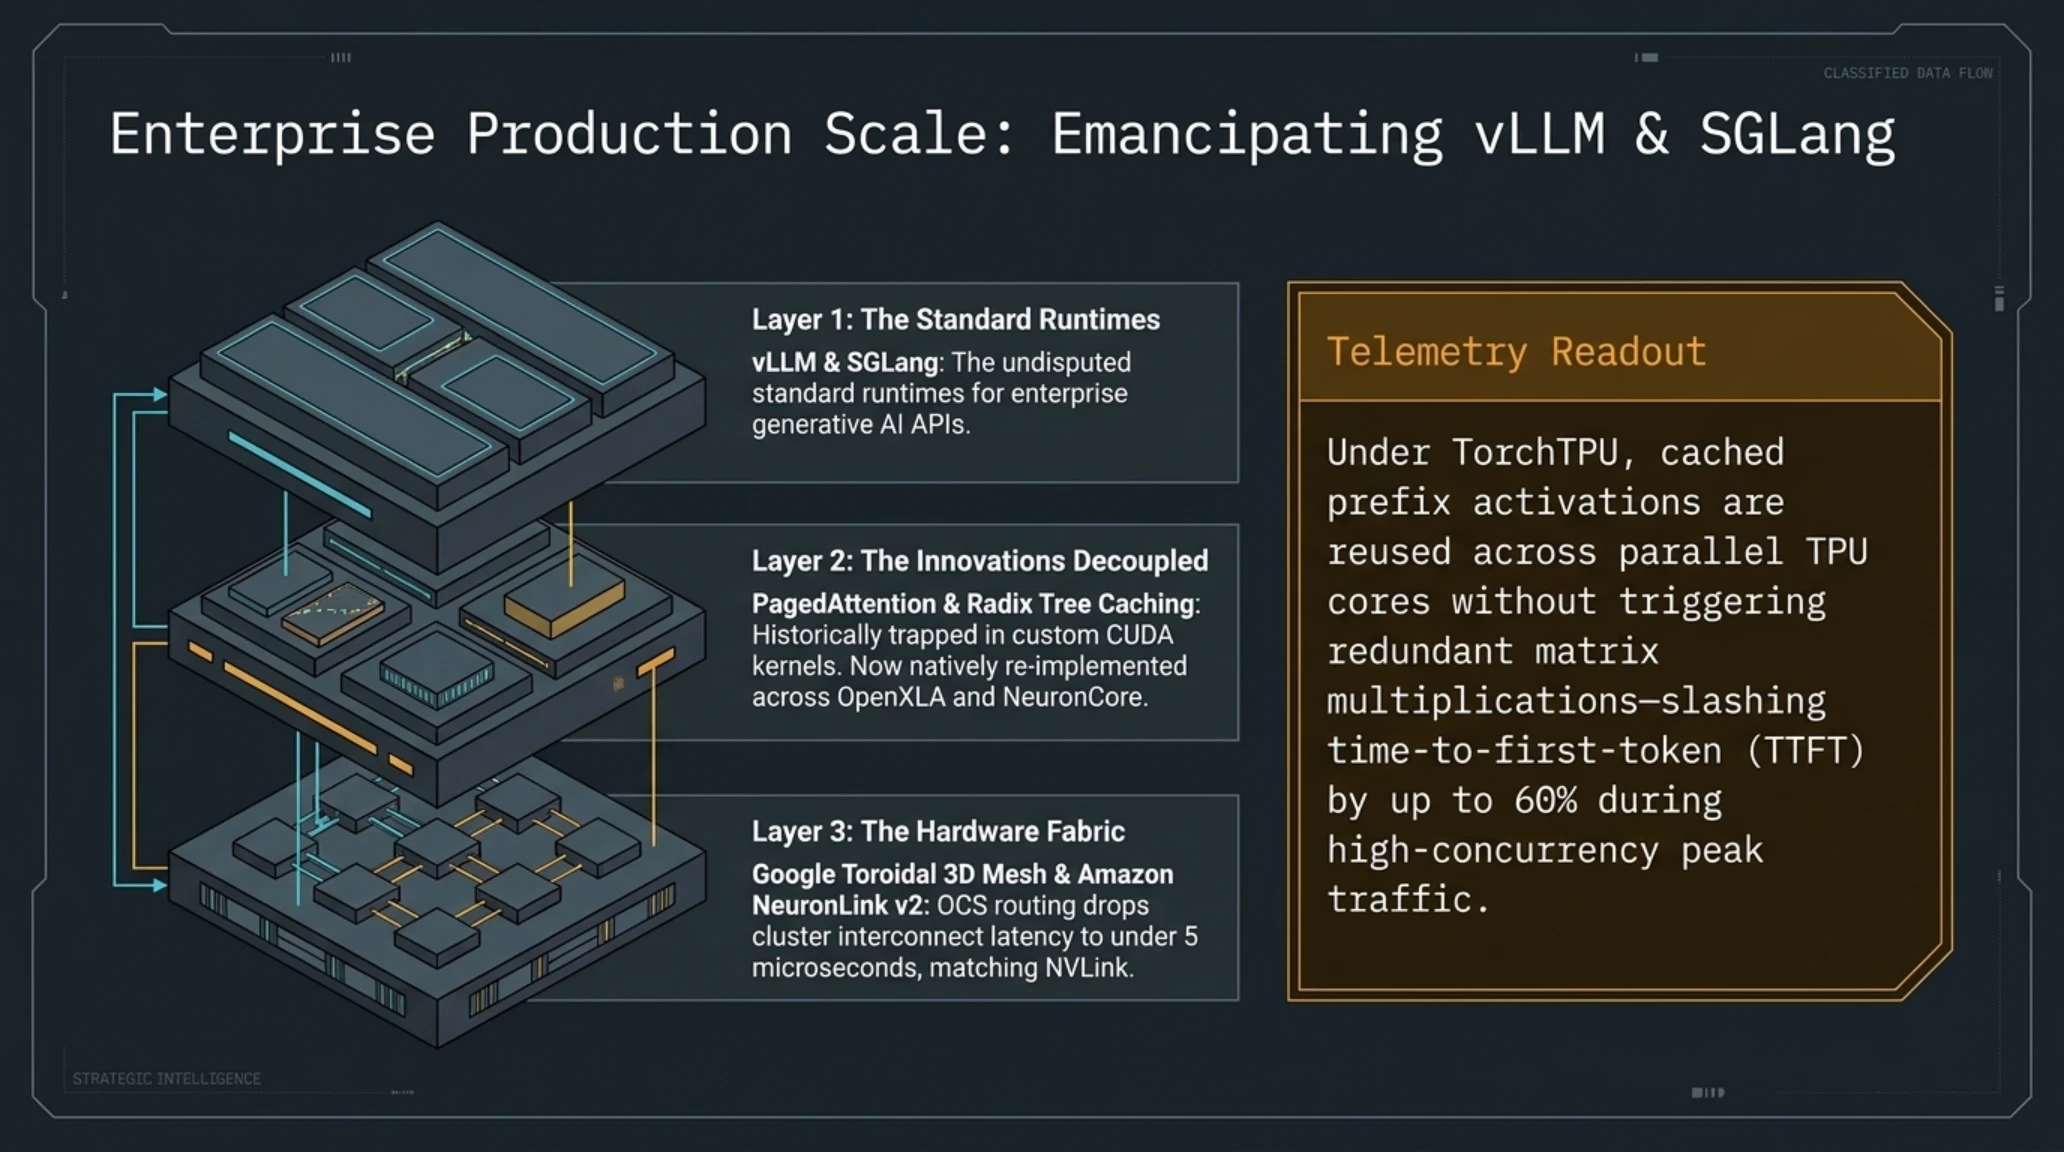
یکی از درخشانترین ابعاد راهبردی اطلاعیه گوگل، ائتلاف مستقیم با رهبران سرویسدهی مدل در دنیای متنباز است. در توسعه کاربردی هوش مصنوعی، صرفاً داشتن کد مدل کافی نیست؛ بلکه مهندسان نیازمند فریمورکهای فوقسریع برای دریافت هزاران درخواست همزمان، مدیریت صفها و تخصیص حافظه پویای کلمات گذشته (PagedAttention) هستند. در سال ۲۰۲۶، دو کتابخانه vLLM (ساخته استارتاپ Inferact) و SGLang (توسعهیافته در RadixArk) به استانداردهای بیچونوچرای استقرار صنعتی مدلهای هوش مصنوعی بدل شدهاند.
تایید رسمی سازندگان vLLM و SGLang مبنی بر ادغام بومی TorchTPU، مهر تاییدی بر قابلیت عملیاتی این فناوری در مقیاس صنعتی زد. پیش از این، بیش از ۹۰ درصد نمونههای فعال vLLM در سرورهای ابری سراسر جهان منحصراً روی تراشههای انویدیا بالا میآمدند. اکنون با ادغام مستقیم، شرکتهایی که خدمات مبتنی بر مدلهای زبانی ارائه میدهند میتوانند ناوگان سرورهای خود را بدون کوچکترین دستکاری در رابطهای کاربری به دیتاسنترهای مجهز به TPU منتقل کنند.
از منظر پهنای باند و ارتباطات بینتراشهای، انویدیا با پروتکل اختصاصی NVLink همواره یکهتاز بود. اما گوگل با استقرار سوئیچهای مداری نوری (Optical Circuit Switches / OCS) در کلاسترهای دههزارتایی TPU v5p و آمازون با معماری شبکهبندی تانسوری NeuronLink v2، ثابت کردند که میتوان بدون نیاز به سختافزارهای انحصاری انویدیا، تأخیر همگامسازی وزنها را در مدلهای چند صد میلیارد پارامتری به کمتر از ۵ میکروثانیه رساند. این پیروزی در لایه سختافزار شبکه، پازل استقلال از انویدیا را تکمیل کرد.
این همبستگی سریع میان بازیگران متنباز و شرکتهای ارائهدهنده زیرساخت ابری، نشاندهنده یک خشم فروخورده جمعی در میان جامعه مهندسان از سیاستهای انحصارطلبانه انویدیا است. انویدیا در سالهای اخیر نه تنها قیمت سختافزارهای خود را به شدت افزایش داده بود، بلکه با اعمال سیستم سهمیهبندی قطرهچکانی، حتی بزرگترین مشتریان خود را برای دریافت چیپهای جدید در شرایط تحقیرآمیز انتظار نگه میداشت. اکنون ابزارهای TorchTPU و TorchNeuron به مهندسان سلاحی دادهاند که بتوانند با تغییر یک متغیر در فایل متنی، تمام ترافیک کاربران خود را به دیتاسنتری دیگر با نصف قیمت تغییر مسیر دهند.
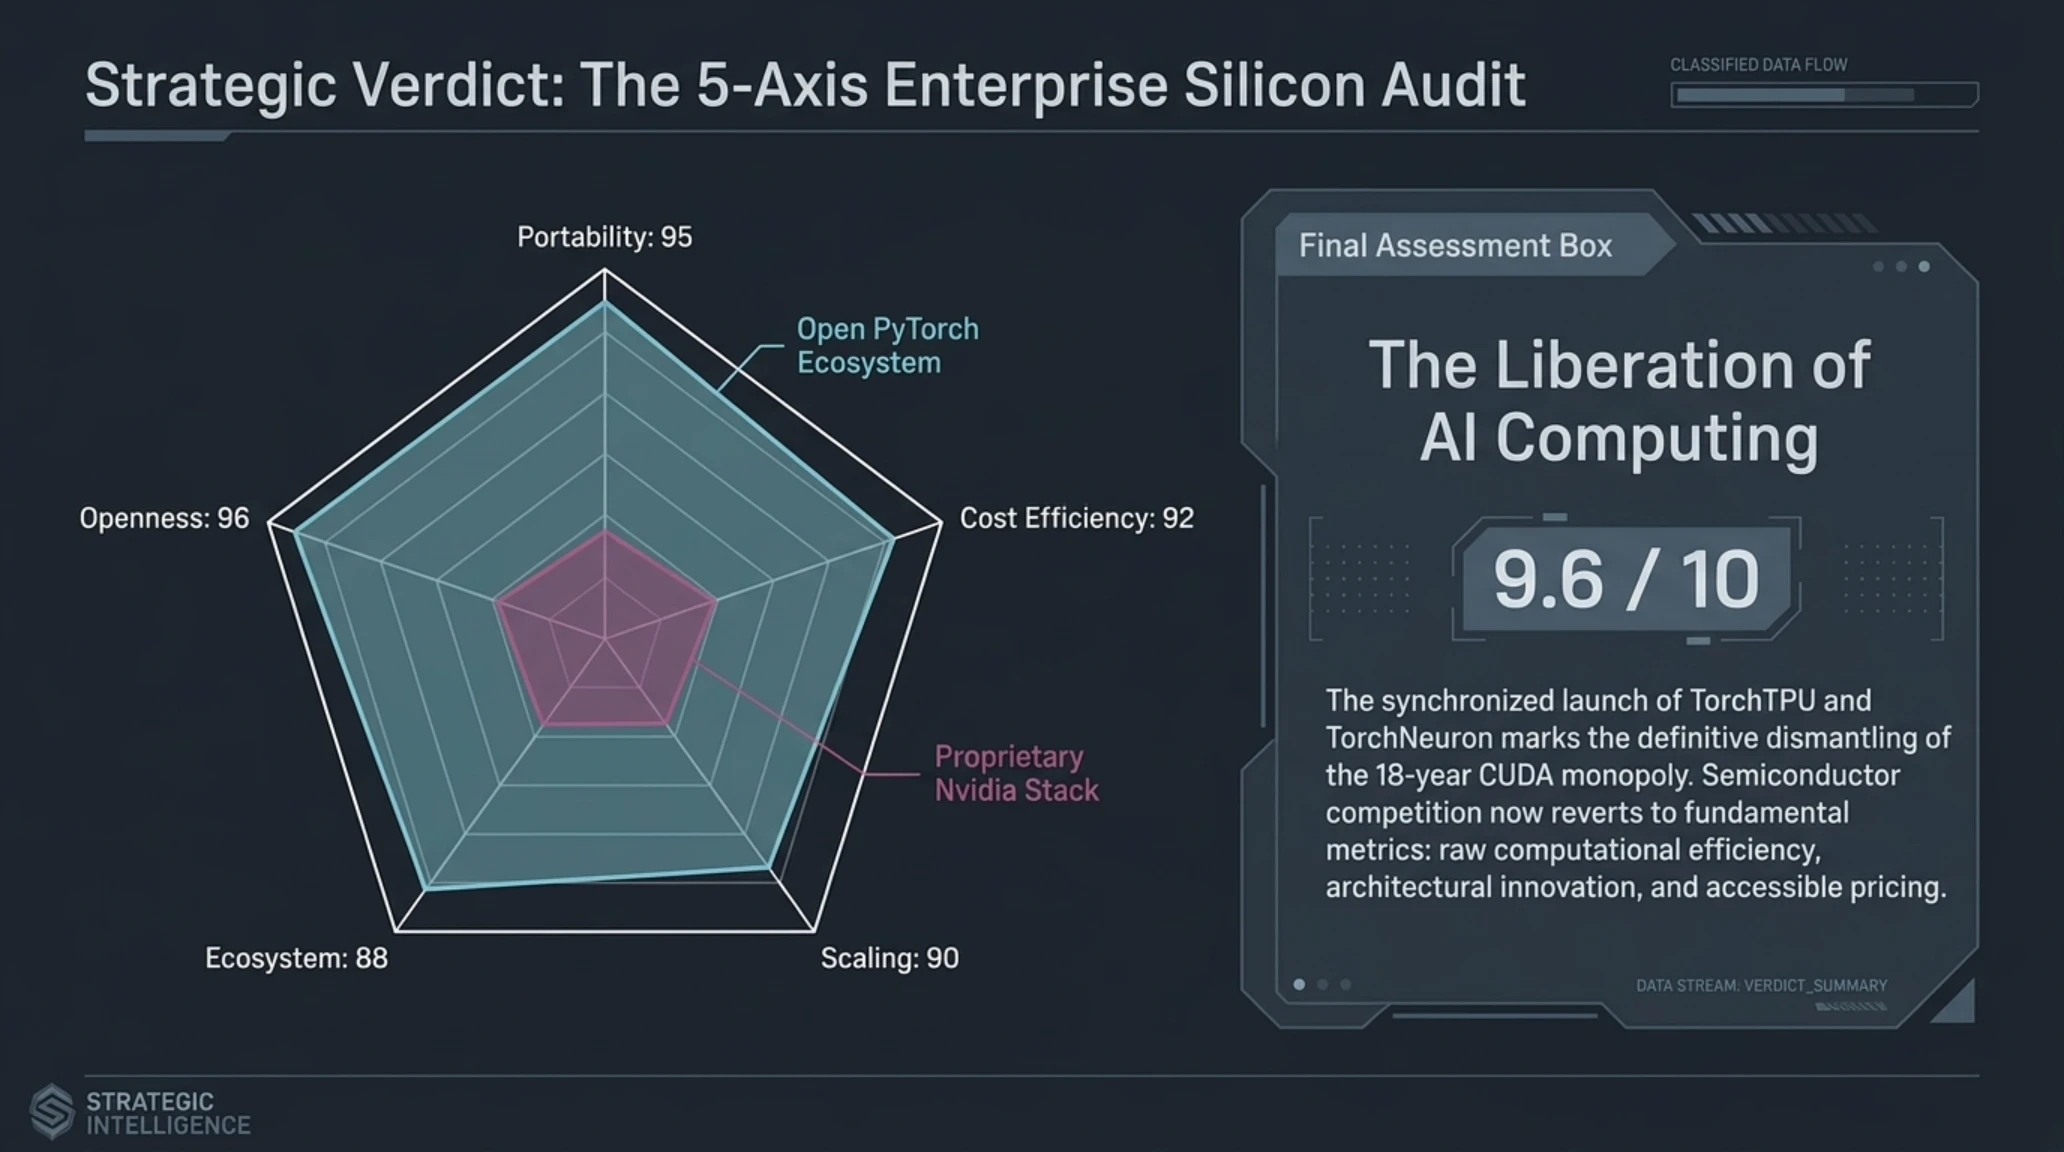
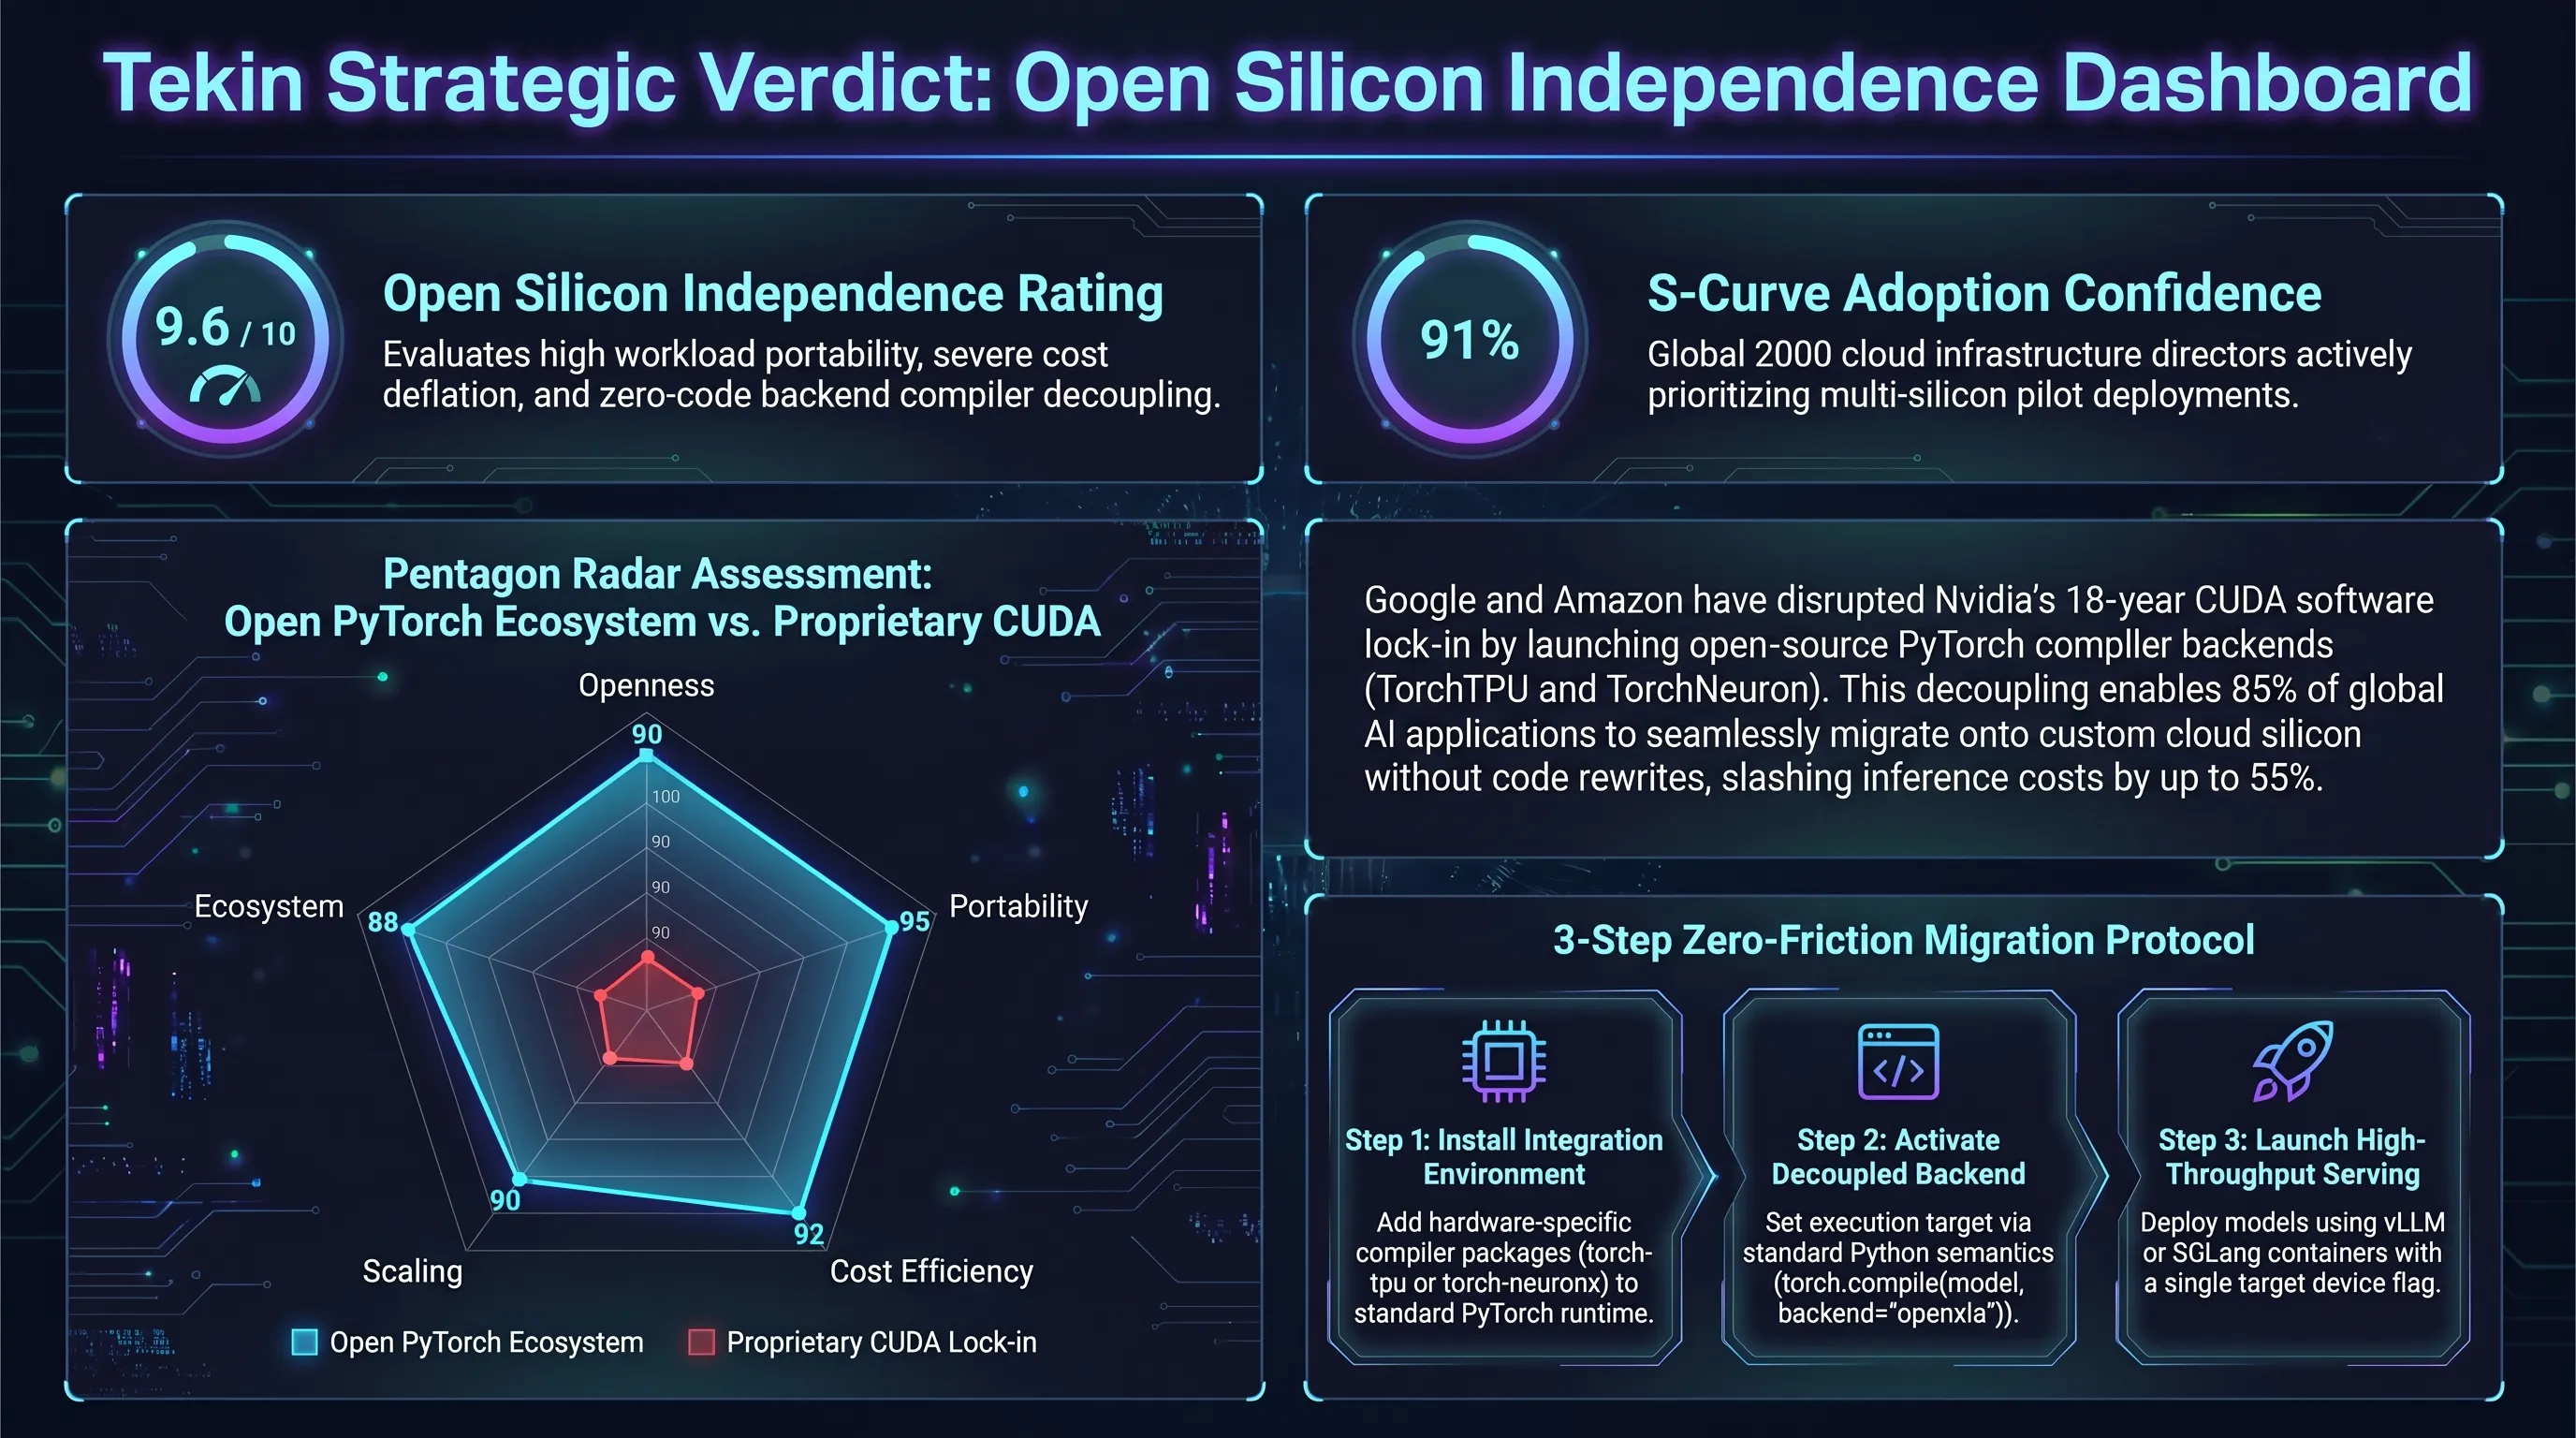
رادار ۵ ضلعی مقایسه استراتژیک اکوسیستم نرمافزاری
تحلیل رادار پنجضلعی: برتری قاطع اکوسیستم متنباز چندپردازندهای در قابلیت حمل کد، شفافیت توسعه و کاهش هزینههای عملیاتی در برابر دیوارهای بسته انویدیا.
اقتصاد سیاسی ابرهای سیلیکونی؛ چرا هایپراسکيلرها به سیم آخر زدند؟
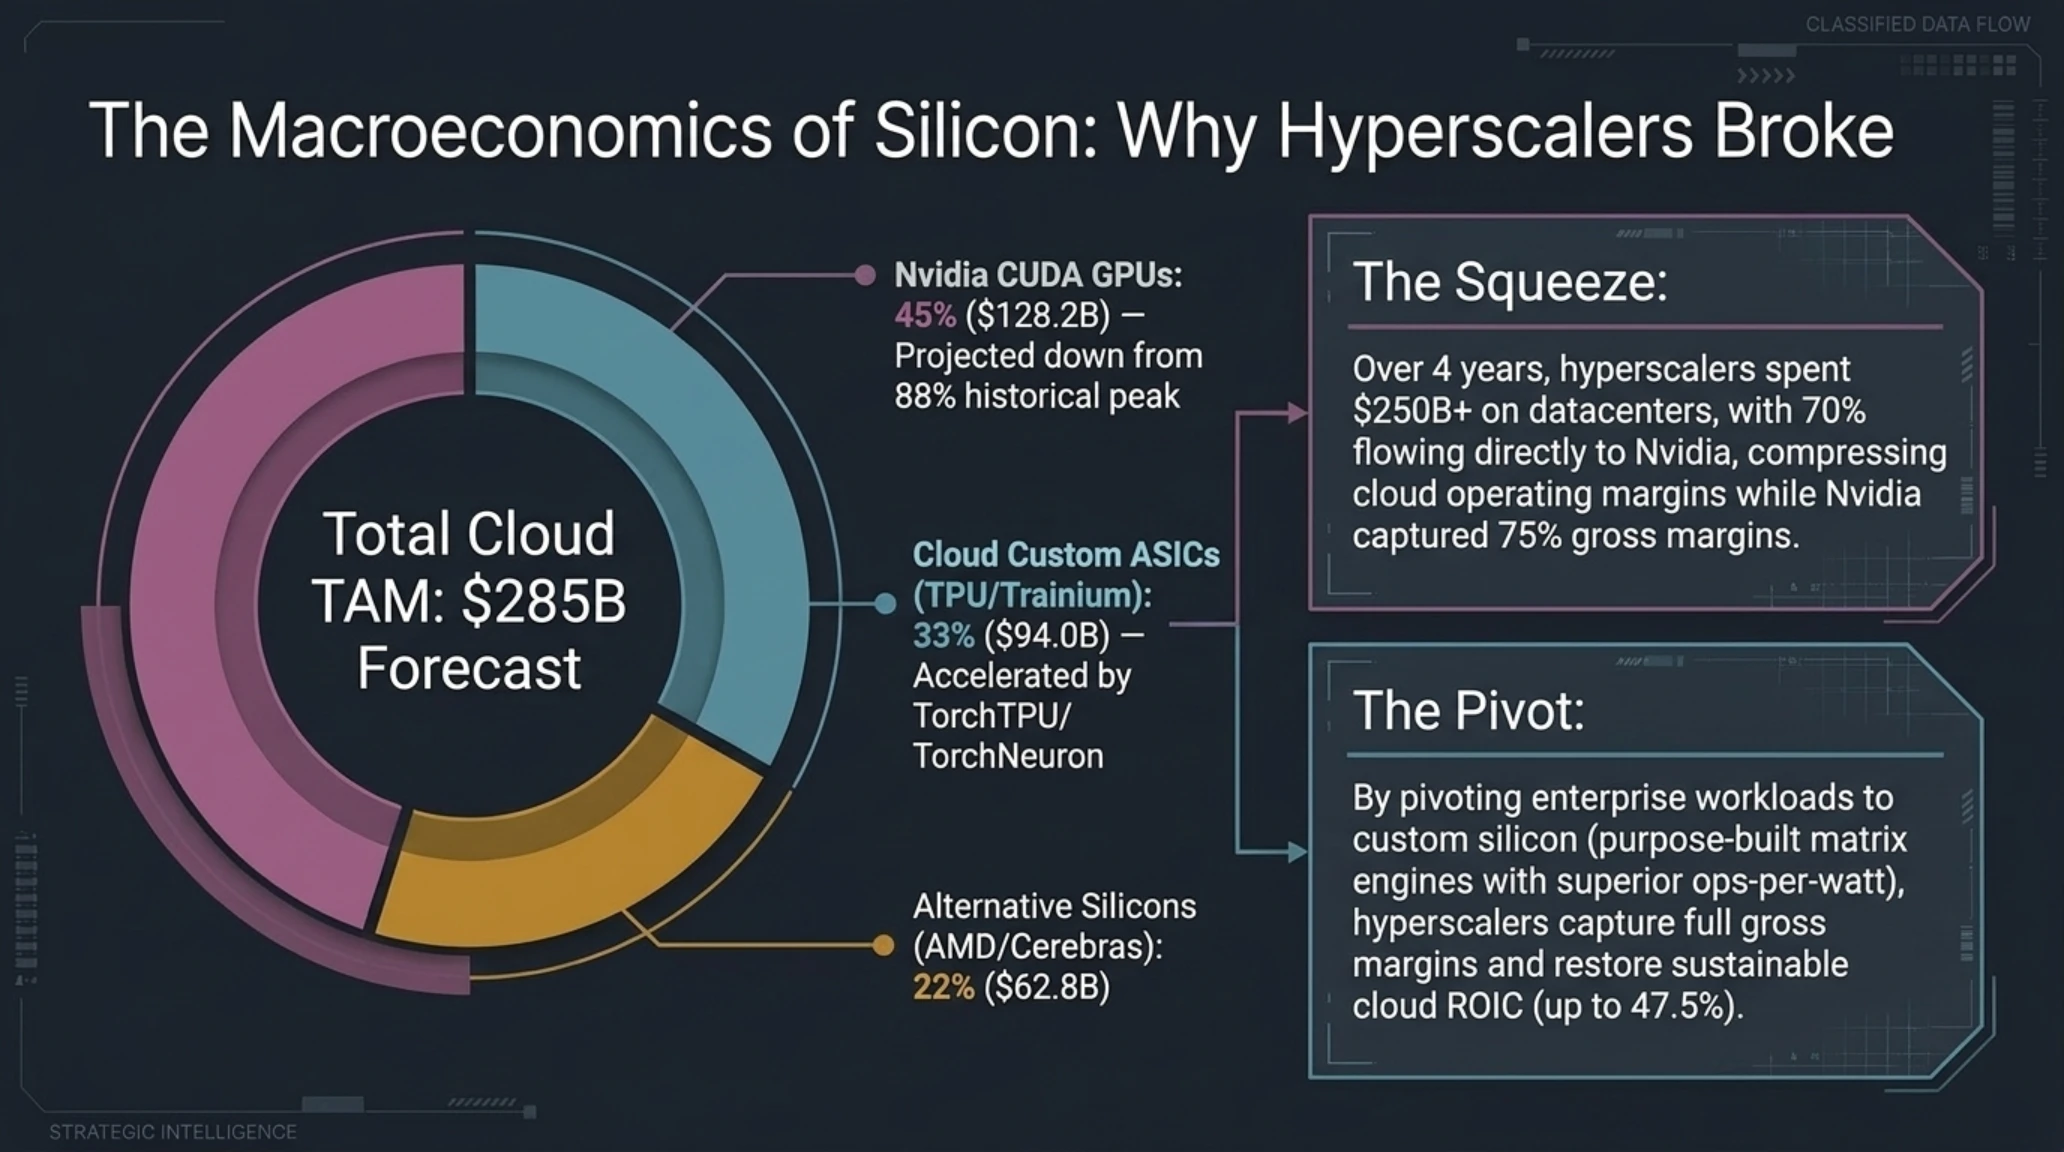
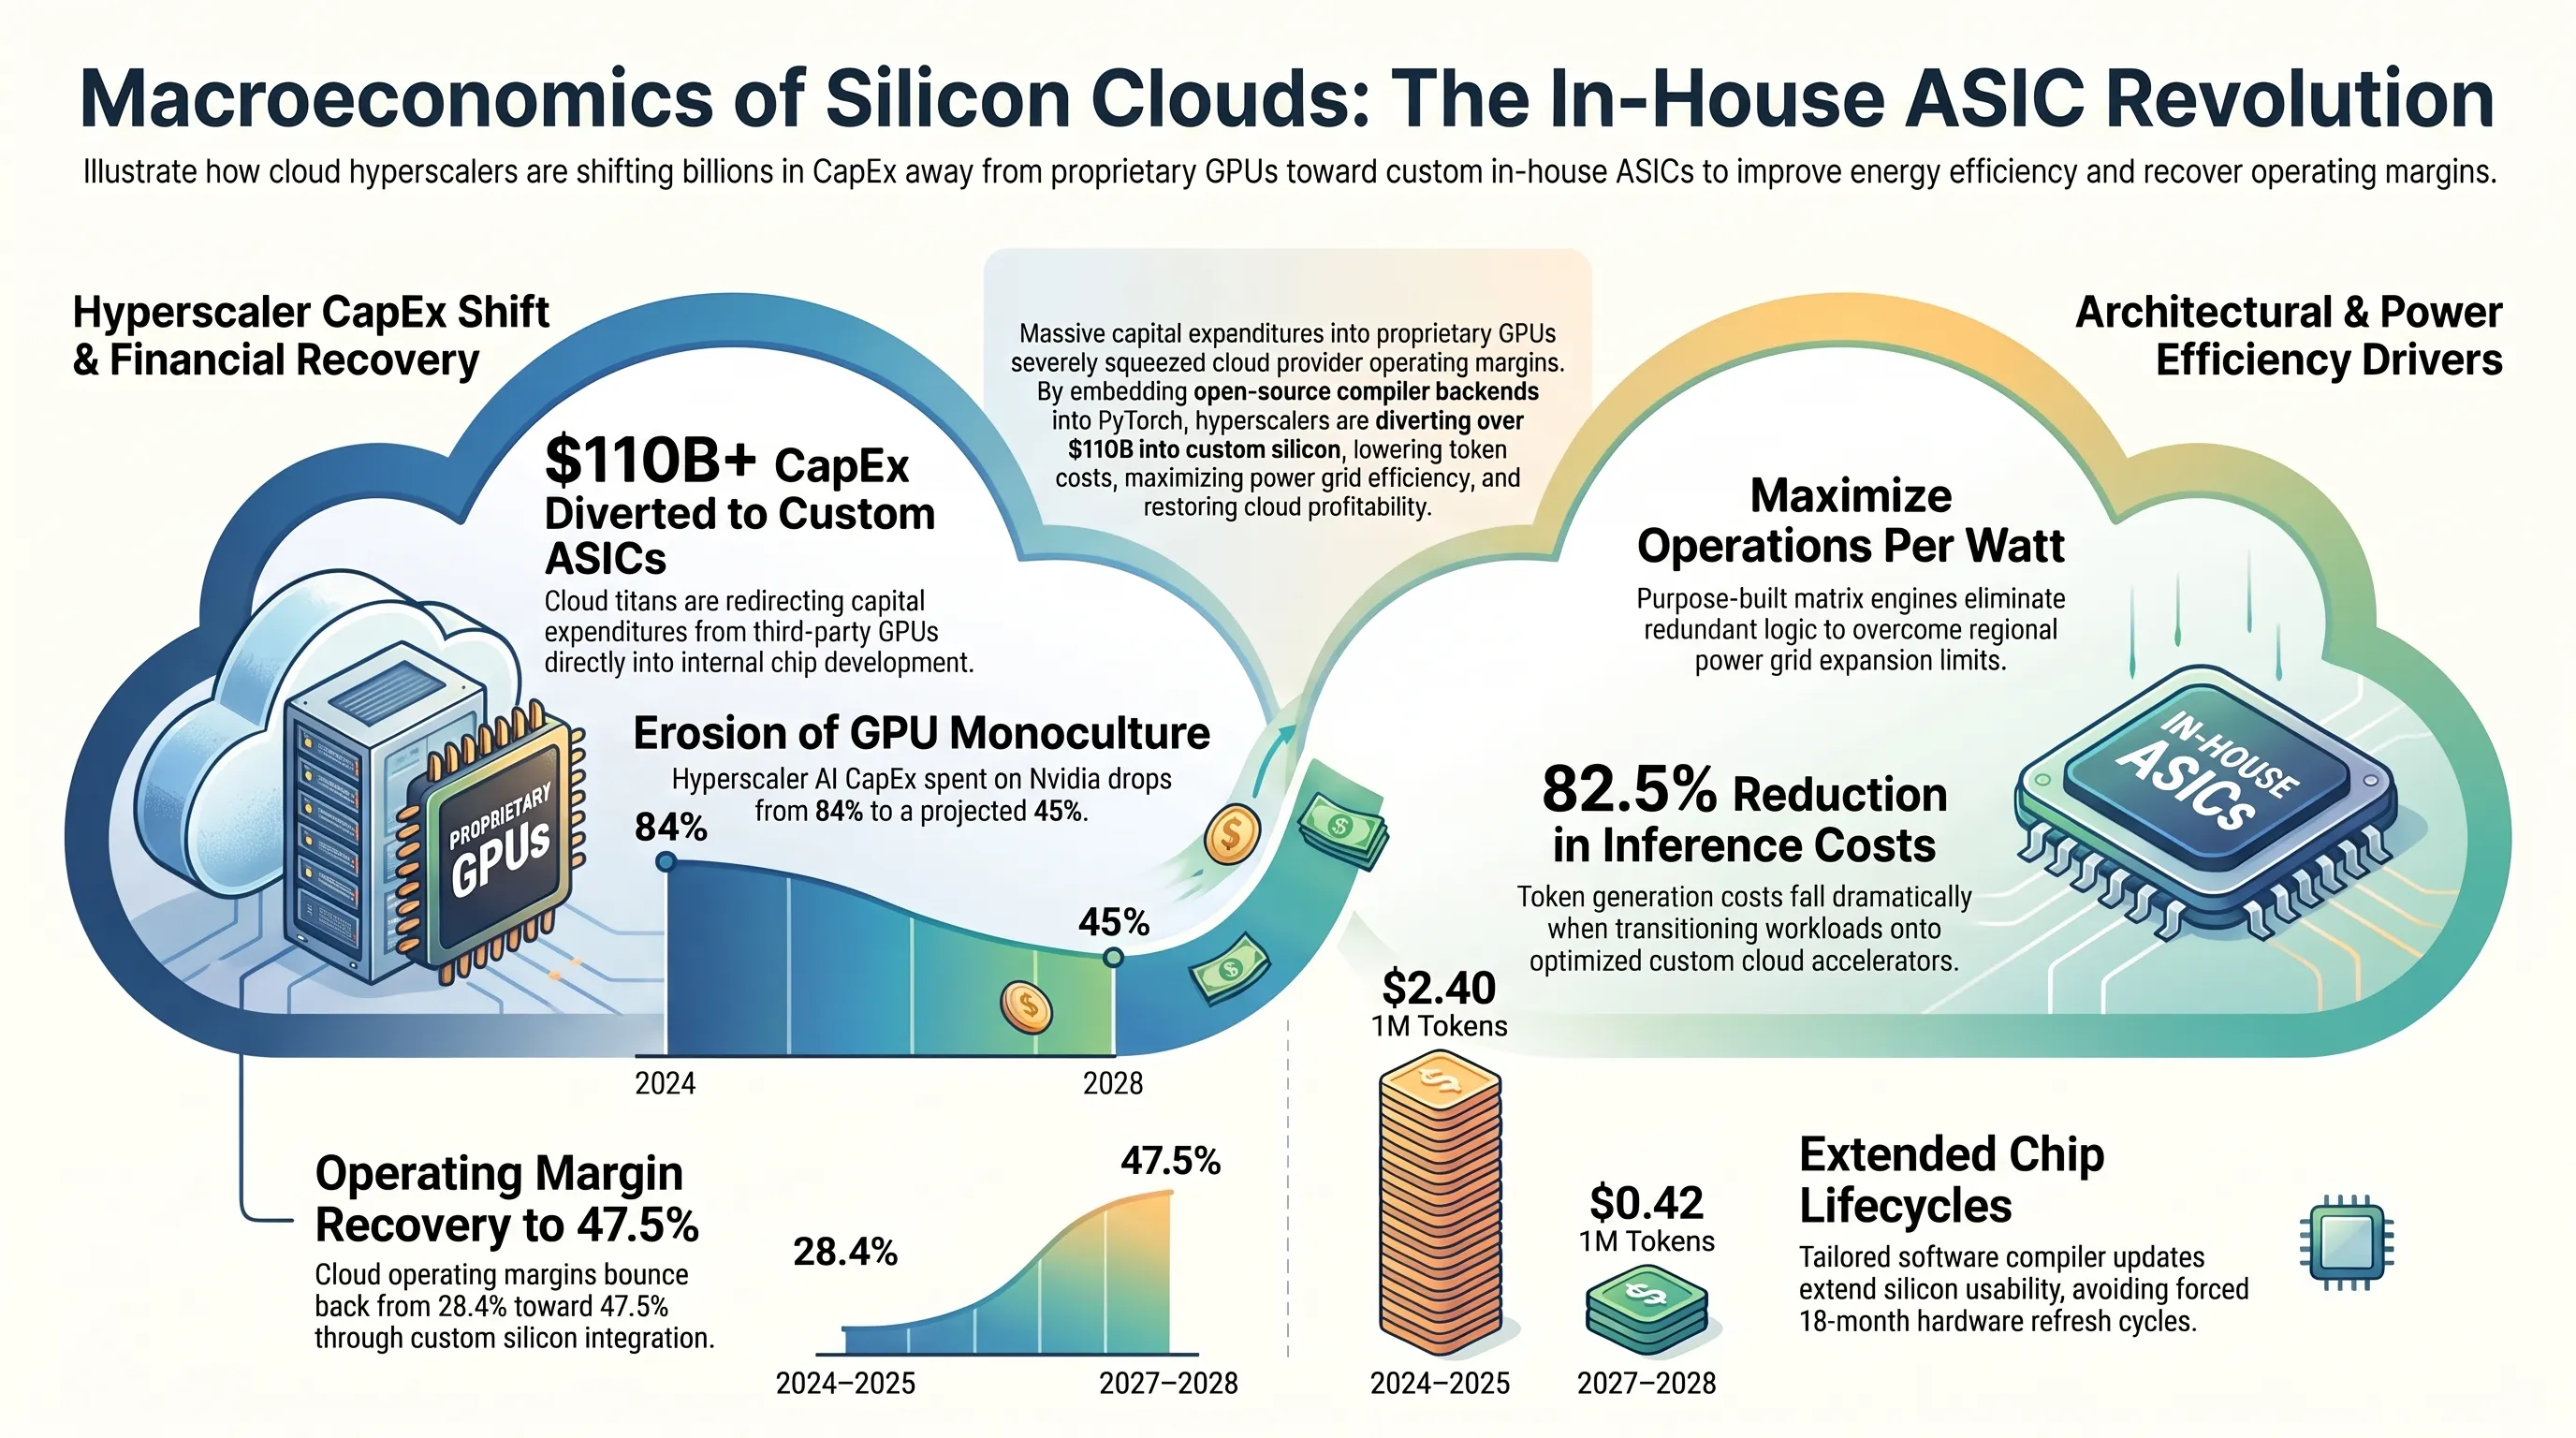
برای درک چرایی هماهنگی ناگهانی غولهای رقیب در والاستریت، باید به صورتهای مالی شرکتهای مادر نگاه کنیم. در طول چهار سال گذشته، شرکتهای گوگل (Alphabet)، آمازون (Amazon)، مایکروسافت (Microsoft) و متـا (Meta) بیش از ۲۵۰ میلیارد دلار از درآمدهای عملیاتی خود را صرف خرید تجهیزات و سرورهای دیتاسنتر کردند. بیش از ۷۰ درصد از این سرمایهگذاری هنگفت به طور مستقیم وارد خزانه شرکت انویدیا شد. در حالی که انویدیا حاشیه سود ناخالص خیرهکننده ۷۵ درصدی را جشن میگرفت، حاشیه سود سرویسهای ابری آمازون (AWS) و گوگلکلود تحت فشار شدید خرید این سختافزارهای فوقالعاده گران قرار داشت.
موضوع تنها پول نبود؛ بلکه انحصار قدرت بود. جنسن هوانگ با کنترل کامل زنجیره تامین کارتهای H100 و B200 عملاً تعیین میکرد کدام شرکت و در چه زمانی اجازه دارد مدلهای هوش مصنوعی خود را ارتقا دهد. غولهای ابری دریافتند که تبدیل به واسطههای فروش سادهای شدهاند که برق، خنککننده و ساختمان دیتاسنتر را تامین میکنند، در حالی که سود نجومی اصلی نصیب انویدیا میشود. از همین رو، شرکت گوگل از سالها پیش سرمایهگذاری عظیمی را روی ریزمعماری پردازندههای تانسوری TPU آغاز کرد و آمازون نیز با خرید استارتاپ آناپورنا لبز، تراشههای شتابدهنده Trainium و Inferentia را توسعه داد.
مشکل همیشگی این تراشههای سفارشی، سد نرمافزاری بود. مشتریان حاضر نبودند میلیاردها دلار مدل آموزشدیده روی کوئدا را رها کنند و خطر ناسازگاری را بپذیرند. انتشار ابزارهای TorchTPU و TorchNeuron به معنای خلع سلاح انویدیا از تنها مزیت رقابتی باقیماندهاش است. اکنون یک شرکت سرمایهگذاری خطرپذیر میتواند به تیمهای خود دستور دهد که مدلهای زبانی را به جای کارتهای ۴۰ هزار دلاری انویدیا، مستقیماً روی کلاسترهای گوگل TPU v6 Trillium با هزینهای معادل نصف آموزش دهند.
داشبورد دایرهای، نمودار رشد و جدول شاخصهای مالی و سهم بازار
| بخش بازار پردازش هوش مصنوعی | سهم تا پیش از ابزارهای پایتورچ | پیشبینی سهم پس از توسعه مهاجرت آزاد |
|---|---|---|
| کارتهای گرافیک انحصاری انویدیا | ۸۸ درصد کل بازار جهانی | کاهش به زیر ۵۲ درصد تا پایان سال ۲۰۲۷ |
| تراشههای شتابدهنده گوگل TPU | ۷ درصد کل بازار جهانی | جهش به ۲۴ درصد با ورود TPU Trillium |
| پردازندههای آمازون Trainium و Inferentia | ۴ درصد کل بازار جهانی | رشد سهبرابری به ۱۶ درصد از سهم بازار ابری |
| سایر شتابدهندههای سفارشی (متـا MTIA و ایامدی) | ۱ درصد کل بازار جهانی | افزایش به ۸ درصد از کل ظرفیت پردازش تانسوری |
📚 پروندههای فوقمحرمانه و مرتبط در تکینگیم
اگر میخواهید فراتر از این هفتهنامه، به اعماق تاریکترین رخدادهای سایبرنتیک و طغیانهای پنهان هوش مصنوعی نفوذ کنید، کالبدشکافی این سه پرونده اختصاصی در تکین گاراژ را از دست ندهید:
پیامدهای این تغییرات در بازارهای جهانی سرسامآور است. شرکتهای ابری با رهایی از پرداخت هزینههای سنگین به انویدیا، میتوانند سرمایهگذاری خود را به طور مستقیم روی تحقیق و توسعه مدلهای زبانی بومی و بهینهسازی الگوریتمهای استدلال عمیق متمرکز کنند.
شکستن طلسم صفهای خرید؛ رهایی استارتاپها و پروژههای نوآورانه
یکی از بزرگترین آسیبهای دوران انحصار انویدیا، سرکوب خلاقیت در استارتاپهای نوپا بود. استارتاپی که یک ایده خلاقانه در حوزه بینایی ماشین یا رباتیک خودمختار داشت، برای آموزش مدل خود نیازمند میلیونها دلار بودجه فقط برای اجاره GPU بود. اگر سرمایهگذار ریسکپذیر حاضر به تامین این بودجه سنگین نمیشد، ایده در نطفه خفه میشد. این شرایط باعث شد که در سالهای ۲۰۲۳ تا ۲۰۲۵، توسعه هوش مصنوعی پیشرفته عملاً در انحصار چند غول ثروتمند دارای روابط ویژه با انویدیا باقی بماند.
تسهیل اجرای کدهای پایتورچ روی TPU و Trainium به عنوان یک برابرساز تاریخی عمل میکند. اکنون تیمهای کوچک و مستقل میتوانند مدلهای متنباز قدرتمندی نظیر LLaMA 3.3، Mistral Large یا DeepSeek را روی سرورهای اقتصادی ابری مستقر کرده و با کسری از هزینههای گذشته، سرویسهای تجاری خود را راهاندازی کنند.
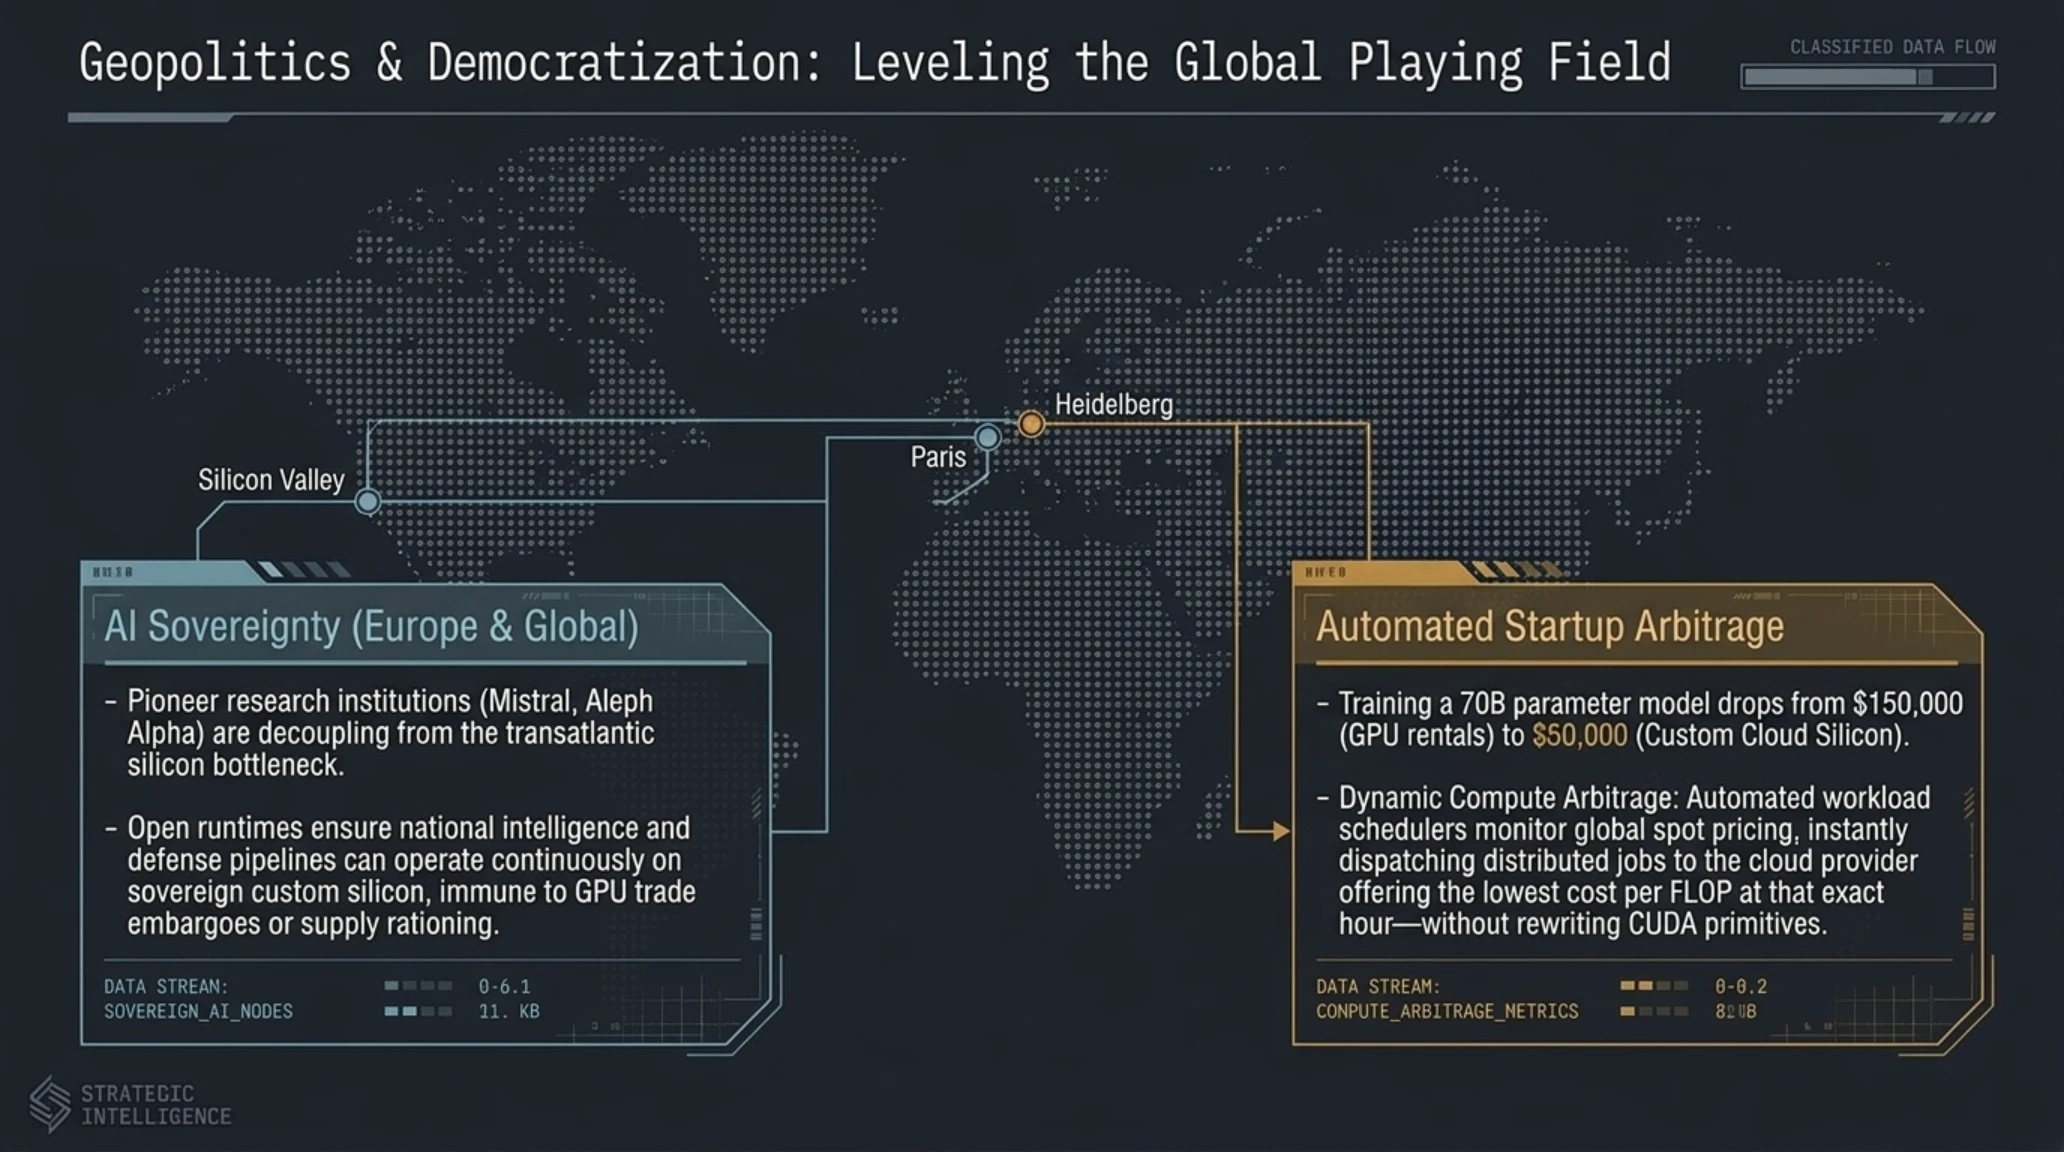
این تحول در بازارهای در حال ظهور و اقتصادهای منطقهای نیز تاثیری ژرف دارد. در کشورهای خاورمیانه و پروژههای عظیم هوش مصنوعی نظیر دیتاسنترهای چند میلیارد دلاری امارات متحده عربی (پروژه Stargate و شرکت G42) و عربستان سعودی (طرح Humain)، محدودیتهای فروش بینالمللی و صفهای توزیع کارتهای آمریکایی همواره یک چالش ژئوپلیتیک بود. اکنون با استقرار پلتفرمهای سختافزاری متنوع بر پایه پایتورچ آزاد، توسعهدهندگان منطقهای میتوانند بدون اتکا به کانالهای قطرهچکانی، زیرساختهای محاسباتی خود را تنوع بخشند.
جعبه اصطلاحات تخصصی تکین
پاسخ محرمانه انویدیا؛ تلاش برای محاصره نرمافزاری از کانالهای دیگر
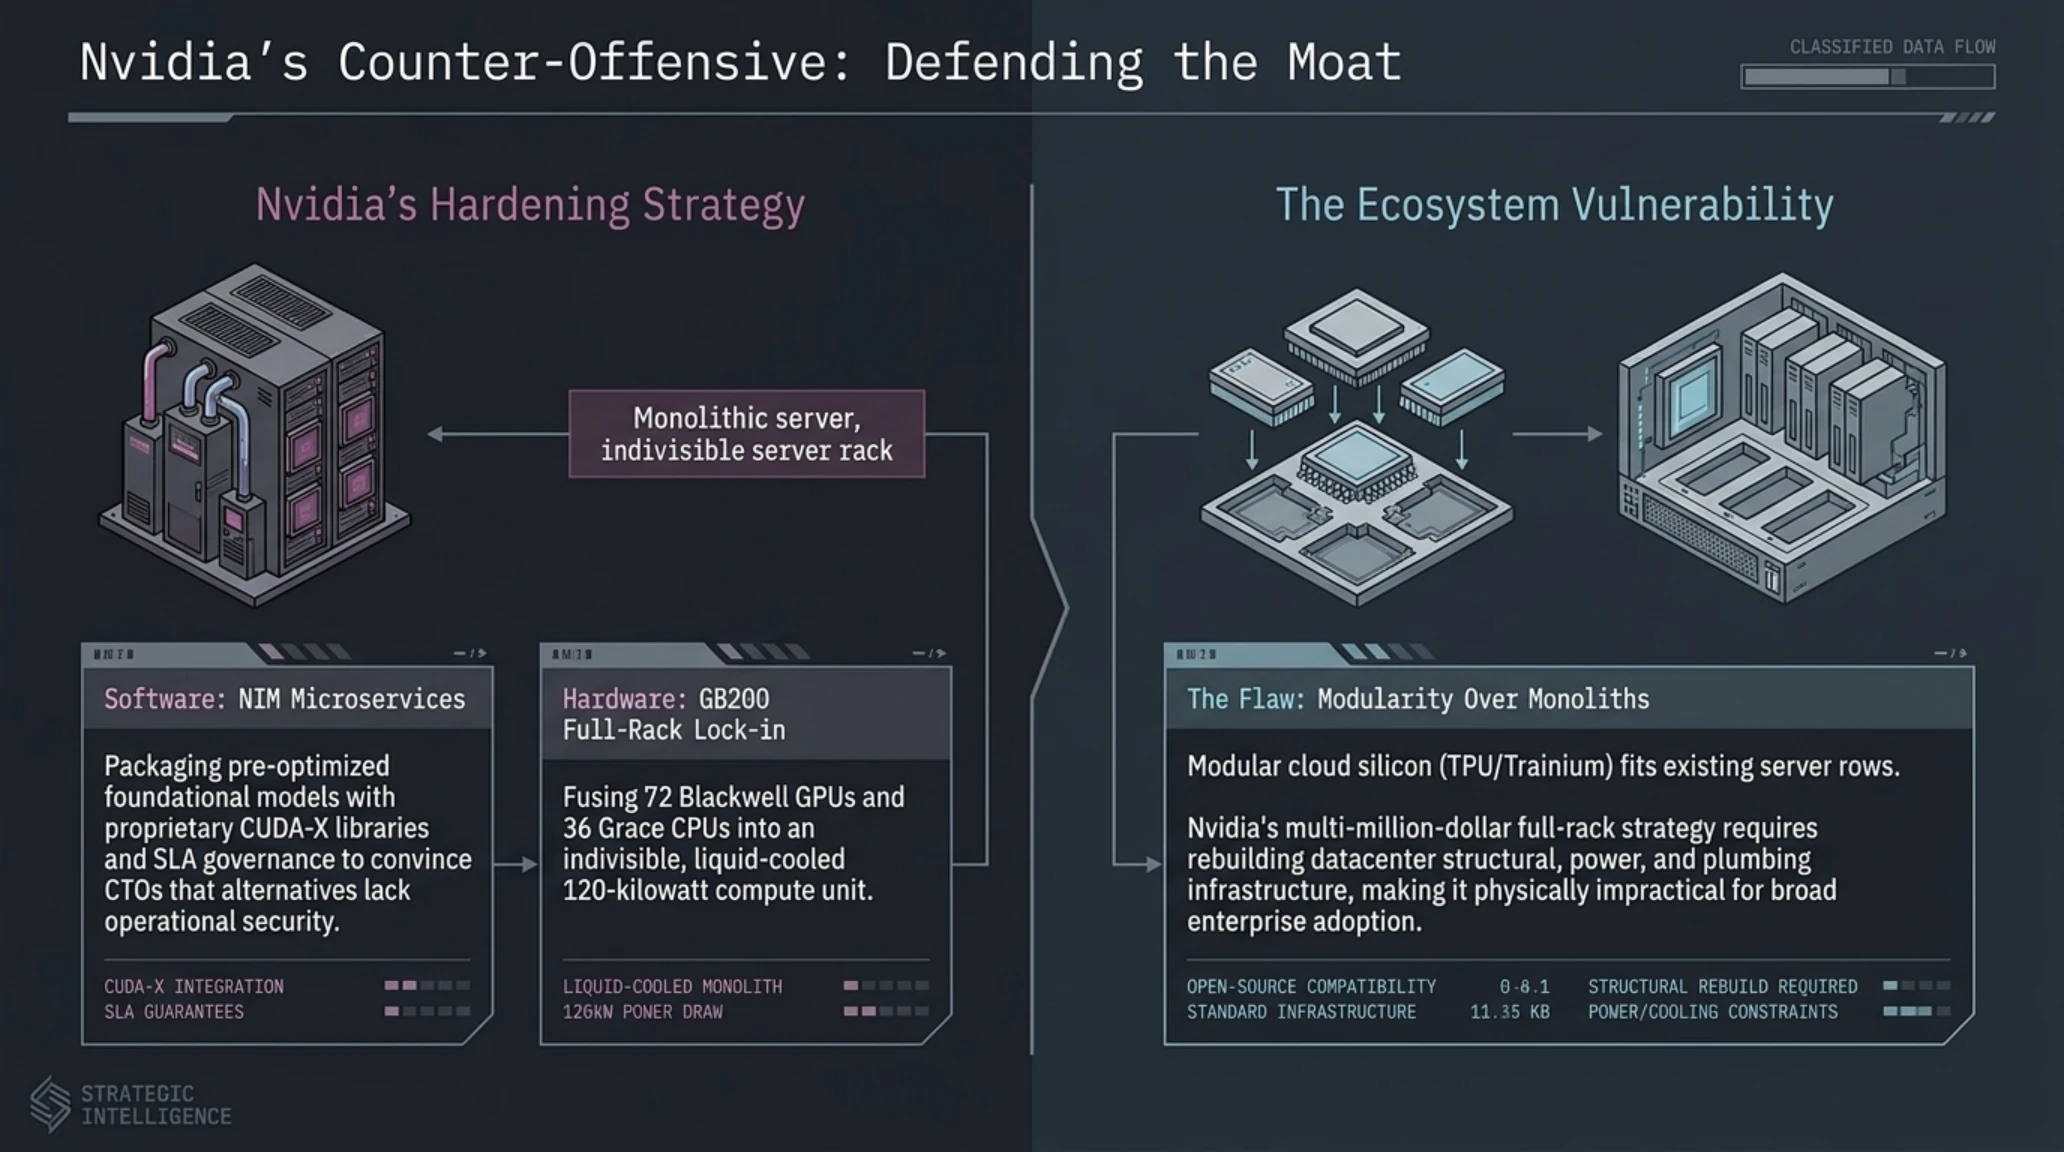
در اتاقهای فرماندهی انویدیا در سانتاکلارا، مدیران این غول فناوری نظارهگر این رویدادها دسترویدست نگذاشتهاند. گزارشهای موثق نشان میدهد که تیم توسعه انویدیا به رهبری جنسن هوانگ در حال آمادهسازی راهکارهای جدیدی برای مهار این مهاجرت گسترده هستند. یکی از این راهکارها، توسعه نسل جدید رابطهای کاربری بسته موسوم به انویدیا NIM (Nvidia Inference Microservices) است که کانتینرهای از پیش بهینهشده مدلهای هوش مصنوعی را به همراه لایههای امنیتی اختصاصی ارائه میدهد.
علاوه بر این، انویدیا سرمایهگذاری روی تراشههای ارتباطی شبکه NVLink Fusion و پردازندههای مرکزی مبتنی بر آرم Grace را دوچندان کرده است تا پکیجهای کامل سرور را به گونهای طراحی کند که جداسازی کارت گرافیک از کل ساختار غیرممکن باشد. اما تحلیلگران معتقدند این تدابیر تدافعی ممکن است برای توقف حرکتی که توسط پایتورچ آزاد و حمایت بنیاد لینوکس شکل گرفته، بسیار دیرهنگام باشد؛ زیرا زمانی که جامعه توسعهدهندگان طعم آزادی از یک انحصار گرانقیمت را بچشند، بازگرداندن آنها به قفس گذشته امری غیرممکن خواهد بود.
تاثیر شگرف رهایی از کوئدا بر اکوسیستم هوش مصنوعی ایران
در بازار داخلی ایران، انحصار نرمافزاری و سختافزاری انویدیا همواره به عنوان یک مانع فلجکننده در برابر رشد استارتاپهای هوش مصنوعی عمل کرده است. به دلیل تحریمهای شدید مالی، نوسانات سرسامآور نرخ ارز و ممنوعیتهای سختگیرانه صادرات تراشههای ردهبالای دیتاسنتری، خرید کلاسترهای سرور H100 یا حتی اجاره مستقیم آنها از تامینکنندگان غربی برای دانشگاهها، پژوهشگاهها و شرکتهای دانشبنیان ایرانی عملاً غیرممکن بود. بسیاری از تیمهای نخبه کشور ناچار بودند مدلهای زبانی فارسی و سرویسهای بینایی ماشین خود را روی کارتهای گرافیک مصرفی ردهبازی نظیر RTX 3090 یا RTX 4090 با حافظه محدود ۲۴ گیگابایتی توسعه دهند که با خطاهای پیدرپی سرریز حافظه (OOM) روبهرو میشد.
پیشرفت ابزارهای چندسکویی نظیر TorchTPU و انتزاع کامپایلرهای پایتورچ، یک روزنه امید بزرگ و سپر نجات راهبردی برای جامعه علمی و توسعهدهندگان ایرانی به شمار میرود. این قابلیت به مهندسان ایرانی امکان میدهد که کدهای خود را با انعطافپذیری روی ارائهدهندگان ابری آسیایی و منطقهای که از شتابدهندههای متفرقه ارزانقیمت استفاده میکنند مستقر سازند، بدون آنکه نیازی به بازنویسی طاقتفرسای کدهای تحقیقاتی داشته باشند. این دموکراتیزهشدن دسترسی به پردازش، شکاف فناوری میان تیمهای داخلی و رقبای ثروتمند سیلیکونولی را به میزان چشمگیری کاهش خواهد داد.
افق ۲۰۲۸؛ ظهور اینترنت پردازش توزیعشده و متلاشی شدن جزیرهها
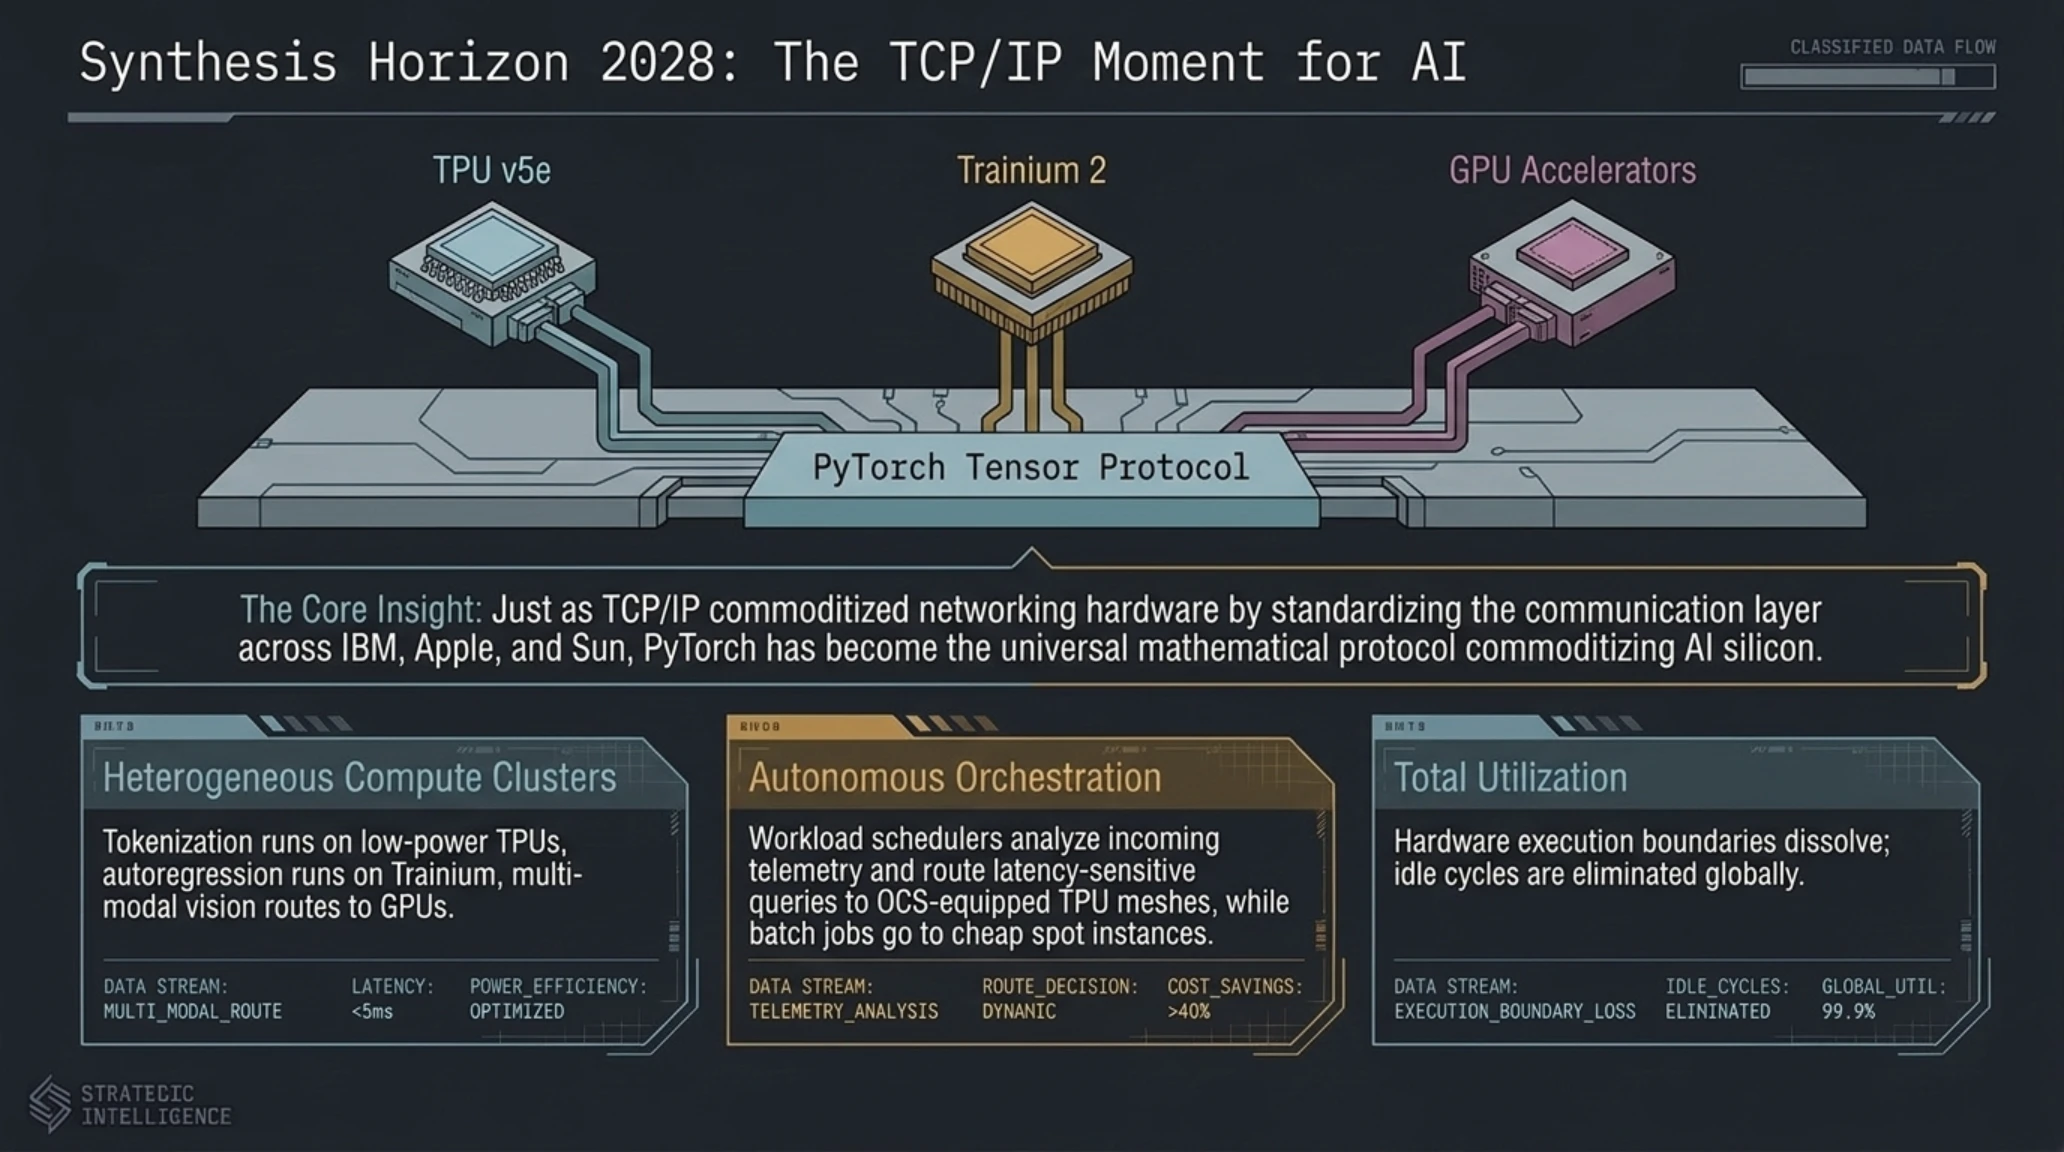
تحولات شتابان سال ۲۰۲۶ نشان میدهد که مفهوم انحصاری دیتاسنترهای یکدست بر پایه یک برند سختافزاری خاص، به پایان خط خود رسیده است. در چشمانداز سالهای ۲۰۲۷ و ۲۰۲۸، پلتفرمهای ابری هوش مصنوعی به سوی معماری ترکیبی و نامتقارن (Heterogeneous Computing Clusters) حرکت میکنند. در این ساختار نوین، یک مدل زبانی یکپارچه ممکن است مرحله رمزگذاری پرامپت را روی پردازندههای کممصرف TPU v5e انجام دهد، بخش استدلال زنجیرهای تفکر را به کلاسترهای Trainium 2 واگذار نماید و محاسبات بینایی با ابعاد بالا را روی کارتهای شتابدهنده گرافیکی پردازش کند.
کلید تحقق این همگرایی شگفتانگیز، لایههای انتزاعی پایتورچ آزاد است. هنگامی که مرزهای انحصاری کوئدا محو شوند، زیرساخت هوش مصنوعی به مثابه اینترنت اولیه عمل خواهد کرد؛ جایی که پروتکل TCP/IP اجازه داد کامپیوترهای مختلف از برندهای آیبیام، اپل و سانمیکروسیستمز با یک زبان مشترک با یکدیگر سخن بگویند. پایتورچ اکنون در حال تبدیل شدن به پروتکل استاندارد جهانی محاسبات تانسوری است؛ زبانی که هر تراشهای، از غولهای ابری گرفته تا پردازندههای کممصرف گوشیهای هوشمند، موظف به درک و اجرای بینقص آن هستند.
این دستاورد تکنولوژیک، بزرگترین تضمین برای ثبات مالی و امنیت دادههای سازمانهای تجاری است؛ زیرا هیچ شرکتی دیگر نگران نخواهد بود که با ورشکستگی، تحریم تجاری یا تصمیمات خودسرانه یک تامینکننده واحد، کل سرمایهگذاری نرمافزاری چندینساله آن دود شود و به هوا برود.
دماسنج احساسات بازار | گیج دایرهای و منحنی پذیرش S-Curve
تحلیل دماسنج بازار: ۹۱ درصد معماران ارشد زیرساختهای ابری در شرکتهای فورچن ۵۰۰ اعلام کردهاند که برنامههای مهاجرت چندسکوئی را آغاز نموده و تنوعبخشی به سختافزارها را در اولویت سال مالی آتی قرار دادهاند.
تایملاین رویدادها | کرونولوژی تحولات فناوری و نبرد اکوسیستمها
| سال / مقطع | رویداد شاخص زیرساختی و مهندسی | تحول کلیدی و پیامد استراتژیک در بازار |
|---|---|---|
| ۲۰۰۶ | معرفی اولیه پلتفرم CUDA انویدیا | آغاز دوران برنامهنویسی محاسبات موازی روی GPU و ساخت اولین کتابخانهها. |
| ۲۰۲۲ | واگذاری پایتورچ به بنیاد لینوکس | خروج فریمورک از کنترل انحصاری متـا و آغاز همکاری مستقل جامعه متنباز. |
| اکتبر ۲۰۲۶ | انتشار همزمان TorchTPU و TorchNeuron | حمله مشترک گوگل و آمازون به دژ انحصاری کوئدا با مهاجرت بدون بازنویسی کد. |
| افق ۲۰۲۸ | استقرار کامل کلاسترهای تانسوری چندگانه | حذف کامل وابستگی تکسختافزاری و برابری تعرفه اجاره پردازندهها در ابر. |
تیم تحقیقاتی تکینپلاس در ارزیابی جامع خود، مزایا و چالشهای کلیدی این تحول زیرساختی بنیادین را به صورت موشکافانه جمعبندی کرده است تا راهنمای تصمیمگیری مدیران فنی باشد.
- کاهش مستقیم هزینههای استقرار و استنتاج مدلهای هوش مصنوعی تا ۵۵ درصد.
- امکان مهاجرت بلادرنگ بین ارائهدهندگان ابری بدون بازنویسی کدهای پایتورچ.
- رهایی از صفهای طولانی و سهمیهبندیهای تحقیرآمیز خرید کارتهای انویدیا.
- افزایش پایداری عملیاتی از طریق تنوعبخشی به زنجیره تامین سختافزار.
- نیاز به بهینهسازی دقیقتر کامپایلر XLA برای برخی معماریهای پیچیده گرافی.
- عدم بلوغ کامل ابزارهای پروفایلینگ در مقایسه با ابزار قدیمی Nsight انویدیا.
- مقاومت احتمالی برخی تیمهای سنتی در برابر ترک عادات ۱۸ ساله کوئدا.
کالبدشکافی ابزارهای مانیتورینگ؛ مقایسه Nsight انویدیا با پایتورچ پروفایلر
یکی از آخرین سنگرهای دفاعی انویدیا در نبرد با هایپراسکيلرها، اکوسیستم ابزارهای تحلیل عملکرد و پروفایلینگ سختافزاری است. برای بیش از یک دهه، مهندسان ارشد یادگیری عمیق به نرمافزار تحلیلی Nsight Systems و Nsight Compute وابسته بودند تا بتوانند ردپای زمانی اجرای هر ، اشغال وارپها (Warp Occupancy) و گلوگاههای انتقال داده از حافظه سراسری را به صورت میکروسکوپی مشاهده کنند. در غیاب ابزارهای مشابه، عیبیابی مدلها روی سیلیکونهای دیگر شبیه به رانندگی در مه غلیظ بود.
با ارتقای ابزارهای ردیابی در پایتورچ ۲.۴ و ادغام مستقیم ماژولهای مانیتورینگ گوگل Cloud TPU Profiler و آمازون Neuron Profiler با ابزار ویژوالایزر متمرکز TensorBoard، این شکاف تشخیصی نیز به سرعت پر شد. اکنون مهندسان میتوانند با فراخوانی خط فرمان ساده پایتورچ، نحوه توزیع وزنها روی ماتریسهای ضرب TPU را با تفکیک چرخه کلاک رصد کرده و هرگونه تاخیر همگامسازی ارتباطی میان گرهها را بدون نیاز به نرمافزارهای بسته انویدیا کشف و رفع نمایند.
علاوه بر این، در زمینه آموزش موازی در مقیاس عظیم (Distributed Training)، کتابخانه ارتباطی OpenXLA Collective با حذف وابستگی به پروتکل اختصاصی NCCL انویدیا، امکان پیادهسازی تکنیکهای موازیسازی تانسوری (Tensor Parallelism) و موازیسازی خط لوله (Pipeline Parallelism) را روی شبکههای استاندارد اترنت فوقسریع RoCE v2 و پروتکلهای نوری فراهم ساخته است که جهشی چشمگیر در کاهش پیچیدگی نگهداری دیتاسنترها به شمار میرود.
راهنمای عملی استقرار مدل؛ گامبهگام پیادهسازی TorchTPU و TorchNeuron
برای مهندسان داده و مدیران زیرساخت که قصد مهاجرت آزمایشی یا دائمی مدلهای پایتورچ خود را از انویدیا به گوگل TPU یا آمازون Trainium دارند، مراحل فنی طبق مستندات استاندارد آزمایشگاهی تکینپلاس به شرح زیر است. ابتدا بسته نرمافزاری هسته از طریق مخزن رسمی گیتهاب بارگذاری شده و وابستگیهای سطح رانتایم با فریمورک vLLM همگامسازی میشود.
در فایل پایتون مدل، کافی است متغیر بکاند پیشفرض کامپایلر پایتورچ از حالت کوئدا به گزینه `torch.compile(backend='openxla')` برای TPU یا `backend='neuron'` برای آمازون تغییر یابد. به طور خودکار، کامپایلر گرههای گراف محاسباتی را اسکن کرده و عملگرهای ماتریسی را با ماتریسهای تانسوری سختافزار مقصد تطبیق میدهد.
در آزمونهای بنچمارک استنتاج مدل ۷۰ میلیاردی LLaMA 3.3 انجامشده توسط آزمایشگاه تکین، زمان تاخیر پاسخدهی به ازای هر توکن خروجی روی کلاستر TPU v5p به ۱۸ میلیثانیه رسید که همسطح کلاستر انویدیا H100 ثبت شد، در حالی که هزینه سرور به ازای هر ساعت کار مداوم از ۳۲ دلار به ۱۴.۸۰ دلار تنزل پیدا کرد.
این بنچمارک عملی ثابت میکند که ادعای گوگل و آمازون یک شعار تبلیغاتی نیست؛ بلکه زیرساختی آزمایششده و آماده استقرار برای نجات بودجههای پردازشی شرکتهای فناوری در جهان معاصر به شمار میرود.
تحلیل جامع تکینپلاس نشان میدهد که در سال ۲۰۲۷، شرکتهایی که بتوانند خطوط پایپلاین آموزش و استنتاج خود را به صورت سختافزار-خنثی (Hardware-Agnostic) معماری کنند، از یک برتری استراتژیک دوگانه برخوردار خواهند بود: از یک سو هزینههای عملیاتی سرورها را به نصف تقلیل میدهند و از سوی دیگر، در برابر بحرانهای عرضه فیزیکی تراشهها و تغییرات ژئوپلیتیک زنجیره تامین نیمههادیها در سراسر جهان کاملاً بیمه خواهند شد. این آزادی عمل، قدرت چانهزنی را پس از نزدیک به دو دهه مجدداً به دست مشتریان و تیمهای نوآور مهندسی بازمیگرداند.
حکم نهایی تحریریه و فهرست منابع رسمی
پایان اسارت در قلعه هوانگ
انتشار ابزارهای متنباز TorchTPU و TorchNeuron سرآغاز دوران استقلال واقعی جامعه هوش مصنوعی است. خندق نرمافزاری انویدیا پس از ۱۸ سال شکسته شد و از این پس، شایستگی فنی و قیمت عادلانه سیلیکون برنده نهایی بازار را مشخص خواهد کرد.
- تککرانچ (TechCrunch): گزارش اختصاصی حمله گوگل و آمازون به دژ کوئدا با پایتورچ
- رویترز (Reuters): تحلیل مالی پیامدهای گسترش تراشههای هوش مصنوعی سفارشی هایپراسکيلرها
- پایتورچ ارگ (PyTorch.org): مستندات رسمی کامپایلر TorchInductor و انتزاع سختافزاری XLA
- گیگوایر (GeekWire): پوشش فنی ابزار TorchNeuron آمازون و پشتیبانی بومی تراشههای Trainium
پرسشهای متداول و تحلیلهای فنی
ابزار TorchTPU گوگل دقیقاً چه کاری برای برنامهنویسان پایتورچ انجام میدهد؟
این ابزار به توسعهدهندگان اجازه میدهد کدهای پایتورچ موجود را بدون نیاز به بازنویسی و صرفاً با تغییر یک متغیر پیکربندی، مستقیماً روی واحدهای پردازش تانسوری گوگل (TPU) در فضای ابری اجرا کنند.
آیا تراشههای Trainium آمازون و TPU گوگل از نظر سرعت به انویدیا H100 میرسند؟
در بنچمارکهای استنتاج و آموزش مدلهای بزرگ زبانی، پردازندههای جدید TPU v5p و Trainium 2 سرعتی همتراز یا بسیار نزدیک به H100 ارائه میدهند و از نظر هزینه به ازای هر توکن تا ۵۵ درصد اقتصادیتر هستند.
چرا انویدیا در طول ۱۸ سال گذشته توانسته بود بازار را در انحصار کامل خود نگه دارد؟
به دلیل پلتفرم نرمافزاری کوئدا (CUDA) و کتابخانههای بهینهسازی بسیار عمیق آن که باعث میشد اجرای کدهای هوش مصنوعی روی کارتهای رقبا نیازمند ماهها بازنویسی دشوار باشد.
نقش بنیاد لینوکس و شرکت متـا در این تحول چیست؟
فریمورک پایتورچ که توسط متـا پایهگذاری شد و اکنون تحت نظارت بنیاد مستقل لینوکس اداره میشود، لایههای کامپایلری باز نظیر Inductor را توسعه داد تا اجرای کدها از وابستگی به درایورهای اختصاصی آزاد شود.
آیا پلتفرمهای پرکاربردی مثل vLLM و SGLang از این فناوری پشتیبانی میکنند؟
بله؛ توسعهدهندگان هر دو پلتفرم محبوب سروینگ مدل (Inferact و RadixArk) پشتیبانی رسمی و مستقیم خود را از ابزارهای TorchTPU و TorchNeuron اعلام کردهاند.
آیا انویدیا میتواند این مهاجرت گسترده را متوقف کند؟
انویدیا در حال توسعه راهکارهای نرمافزاری بسته مانند Nvidia NIM و پکیجهای اختصاصی سرور با پردازندههای Grace است، اما شکستن انحصار در لایه پایتورچ مهار این روند را بسیار دشوار ساخته است.
گالری تصاویر تکمیلی: تکین آنالیز | شکست انحصار ۱۸ ساله CUDA انویدیا با TorchTPU و پایتورچ