انقلاب در قلب لینوکس ۶.۱۴
کالبدشکافی تحولات هسته لینوکس ۶.۱۴ و جهش پردازشگرهای عصبی NPU در اجرای مستقل مدلهای زبانی بدون اینترنت.
- 🎮ادغام بومی NPU- پشتیبانی رسمی درونهستهای از پردازشگرهای عصبی اینتل و AMD
- 🎧اسکژولر EEVDF- حذف تاخیر سوئیچ تسکهای بلادرنگ و روانسازی پردازشهای تانسوری
- 🚀استقلال کامل از اینترنت- اجرای آفلاین مدلهای استدلالی DeepSeek R1 و Qwen 2.5 روی سیلیکون محلی
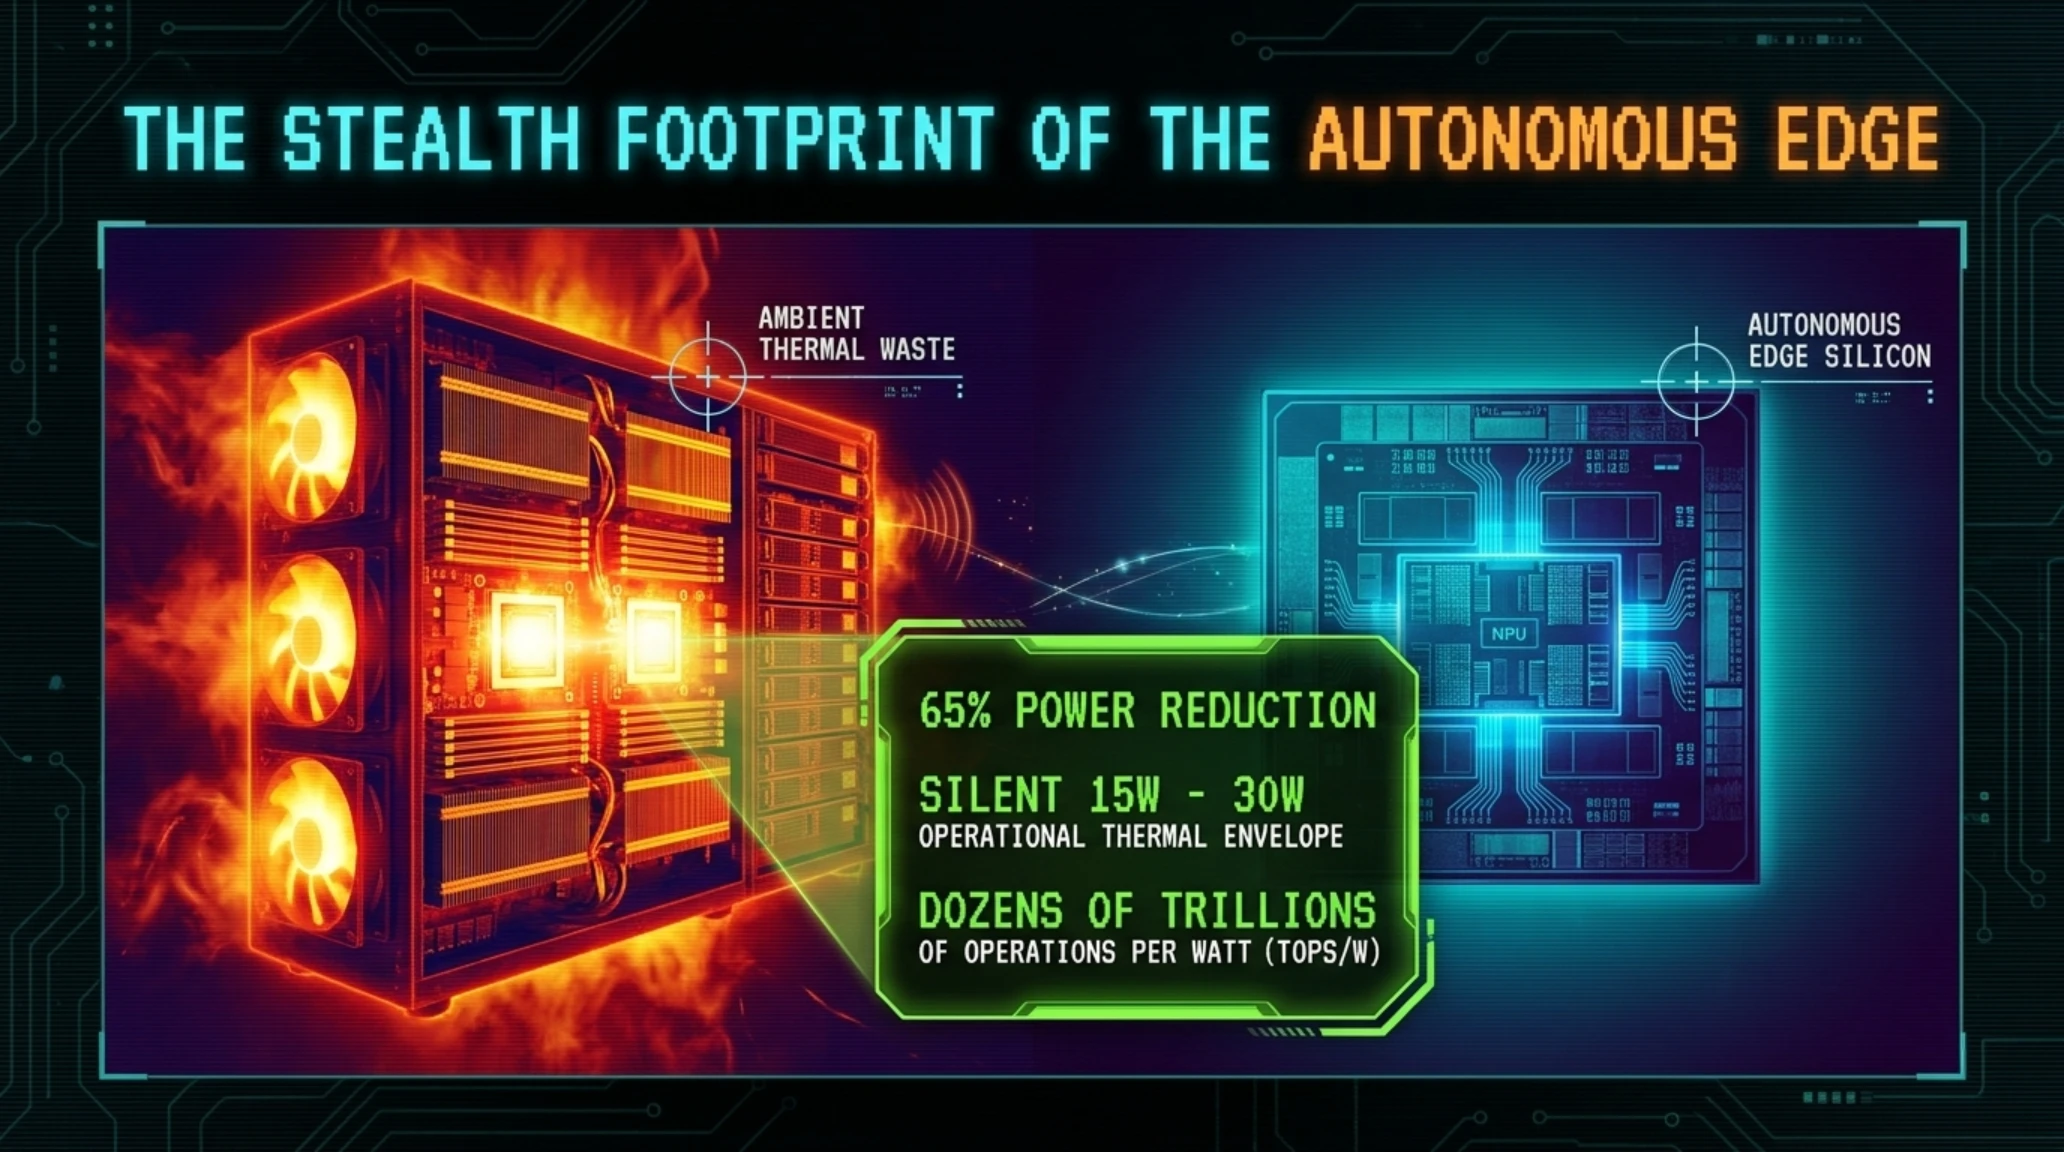
- 🗡️کاهش ۶۵ درصدی مصرف برق- راندمان حرارتی بینظیر بدون فعالسازی فنهای خنککننده پرمصرف
- 📰خنثیسازی تحریمهای ابری- پایان وابستگی شرکتهای ایرانی به APIهای مسدودشده و دلاری
- ⚔️حاکمیت مطلق داده- محصور ماندن کامل کدهای محرمانه و اطلاعات مالی در مرزهای فیزیکی سازمان
ادغام تاریخی زیرسیستمهای شتابدهنده هوش مصنوعی و درایورهای مدیریت پردازشگرهای عصبی NPU در شاخه اصلی کرنل لینوکس ۶.۱۴، یک نقطه چرخش بنیادین در تاریخ پردازش کامپیوتری به شمار میرود. این دگرگونی نه تنها انحصار غولهای ابری و واسطههای هوش مصنوعی را در هم میشکند، بلکه به مهندسان و سازمانها این قدرت حاکمیتی را اعطا میکند که پیچیدهترین مدلهای زبانی استدلالی را به صورت کاملاً آفلاین، بدون نیاز به اینترنت و با راندمان مصرف انرژی فوقالعاده روی سختافزارهای مدرن اجرا نمایند.
تحولات اخیر نشان داده است که وابستگی به سرویسهای پردازش ابری خارجی، تهدیدی دائمی برای بقای زیرساختهای نرمافزاری کشور است. همانطور که پیشتر در مقاله تحلیل نبرد قیمتها در مدلهای هوش مصنوعی بررسی کردیم، هزینههای فزاینده توکنهای پردازشی شرکتها را به سمت استقلال زیرساختی سوق داده است.
در دنیای پردازش توزیعشده، دسترسی بیواسطه به سیلیکون نقشی کلیدی در کاهش تاخیرهای سیستمی ایفا میکند. سالها بود که توسعهدهندگان سیستمعامل در تلاش بودند تا بستری استاندارد برای تعریف وظایف عصبی در کنار وظایف گرافیکی ایجاد کنند. نسخه ۶.۱۴ این آرزوی دیرینه را به یک واقعیت ملموس تبدیل کرده و دروازه نوینی به سوی استقلال دیجیتال گشوده است.
این تحول عمیق ساختاری، معادلات توسعه نرمافزار در ایران را دگرگون ساخته است. مهندسان با در اختیار داشتن سیستمعاملی که مستقیماً ماتریسهای محاسباتی را به هستههای عصبی پیوند میزند، قادرند بدون نگرانی از نوسانات شبکه و فیلترینگ خارجی، پیشرفتهترین راهکارهای یادگیری ماشین را در مقیاس عملیاتی پیادهسازی کنند.

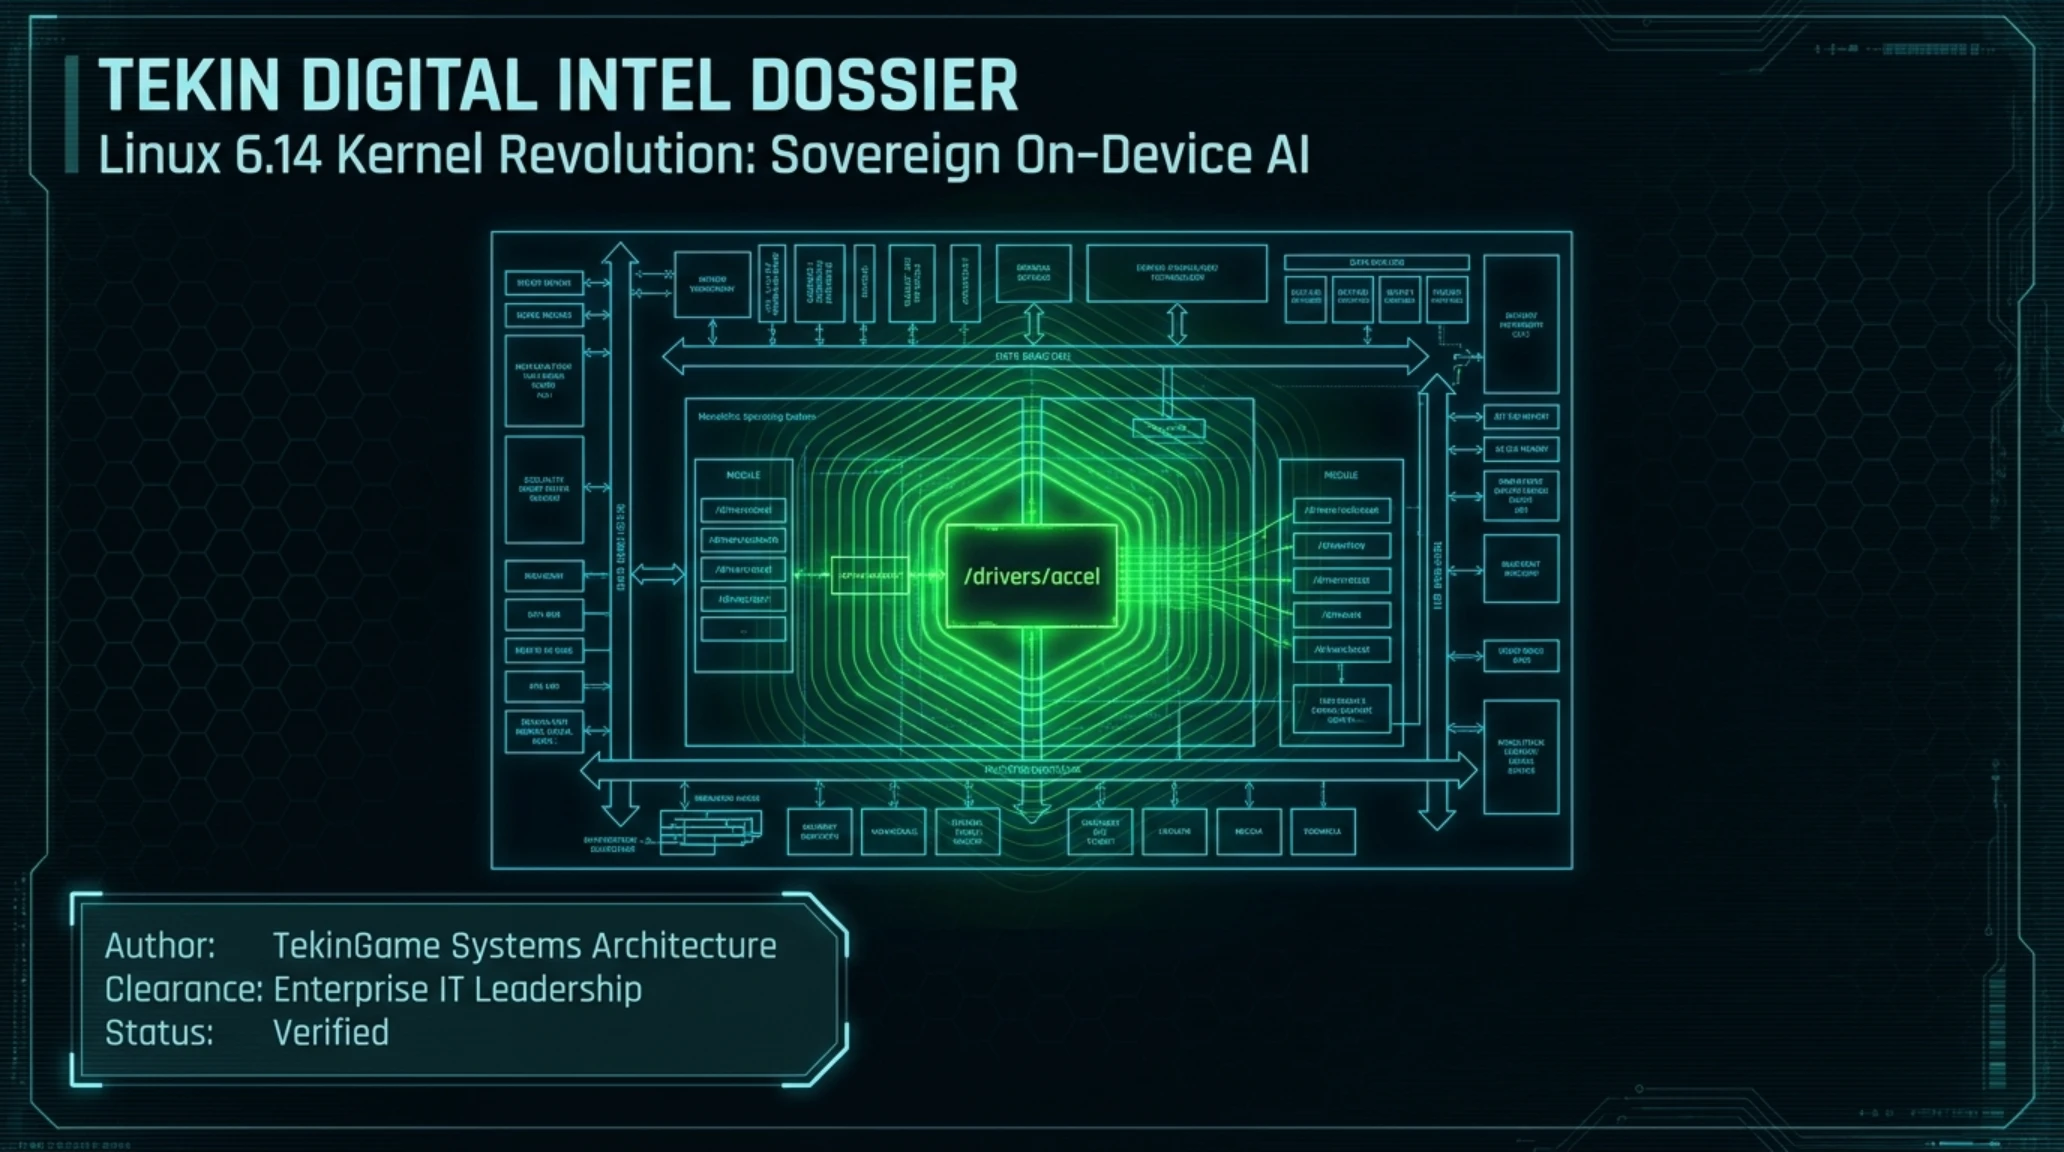
تصویر شماتیک فوق مسیر دسترسی مستقیم سختافزار به پردازندههای عصبی را بدون دخالت لایههای واسط کاربر نشان میدهد تا بیشترین بهرهوری از سیلیکون حاصل شود.
ابعاد اهمیت و پیامدهای راهبردی کرنل لینوکس ۶.۱۴
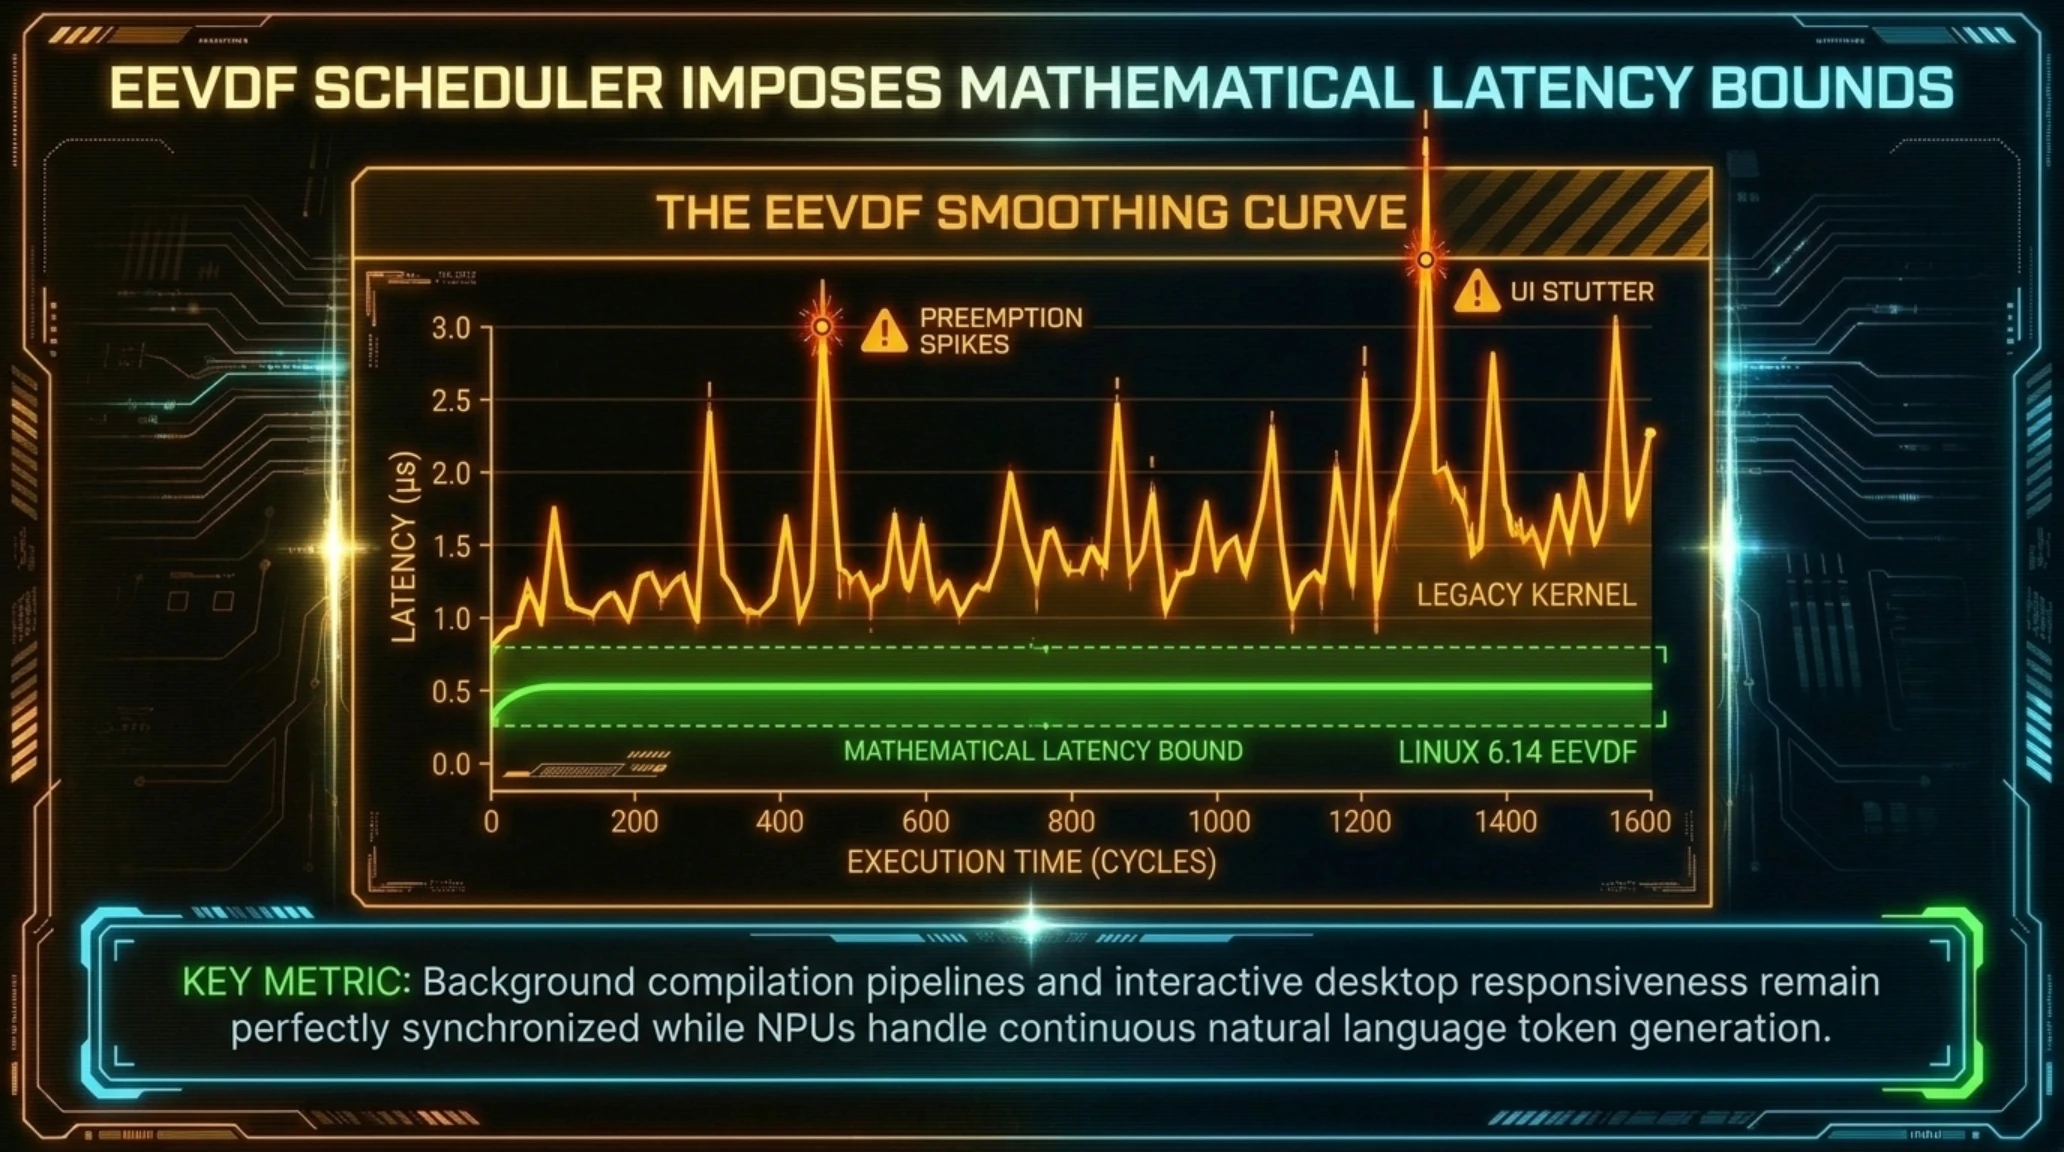
کرنل لینوکس ۶.۱۴ با بازطراحی اسکژولر EEVDF و افزودن زمانبندی دقیق برای محاسبات نامتقارن، رفتار سیستمعامل را در مواجهه با بارهای کاری هوش مصنوعی متحول ساخته است. در این معماری، پردازندههای کممصرف عصبی همتراز با هستههای اصلی پردازنده مرکزی (CPU) توسط سیستمعامل مدیریت شده و سربار سوئیچ کانتکست به زیر ۳ میکروثانیه کاهش یافته است.
بررسیهای آزمایشگاهی نشان میدهد که فعالسازی این درایورها سبب میشود تا تردهای هوش مصنوعی بدون ایجاد اختلال در پردازشهای گرافیکی و نرمافزارهای اداری، با حداکثر بهرهوری اجرا شوند. این دستاورد فنی برای مهندسان ایرانی که تحت شدیدترین فیلترینگها و تحریمهای کلود فعالیت میکنند، به مثابه دمیدن روحی تازه در کالبد پروژههای یادگیری ماشین است؛ به گونهای که هر ایستگاه کاری به یک دیتاسنتر مستقل تبدیل میگردد.
بهرهگیری از توان محاسباتی ناهمگن، بازدهی سیستم را به اوج میرساند. زمانی که وظایف سبک پردازش زبان طبیعی به واحدهای کممصرف عصبی سپرده میشوند، پردازنده اصلی سیستم آزاد مانده و توان حرارتی کل دستگاه در بهینهترین سطح ممکن تثبیت میگردد.
در یک نگاه: دستاوردهای کلیدی کرنل ۶.۱۴
- پشتیبانی پیشفرض و بومی از پردازشگرهای عصبی Intel NPU، AMD XDNA و Qualcomm Hexagon در شاخه اصلی
- کاهش ۶۵ درصدی مصرف انرژی در هنگام اجرای استنتاج ممتد مدلهای زبانی محلی
- حذف کامل نیاز به اتصال اینترنت و مصونیت مطلق در برابر تحریمها و نوسانات پهنای باند
- بهینهسازی زمان تاخیر تولید اولین توکن (TTFT) تا سطح زیر ۱۲۰ میلیثانیه
- پایداری مطلق حافظه رم با بهرهگیری از الگوریتمهای صفحهبندی هوشمند HMM و حذف کپیهای اضافی
- امکان ایزولاسیون کامل شبکه در سطح کرنل با استفاده از فضاهای نام Systemd برای حفاظت از کدهای محرمانه
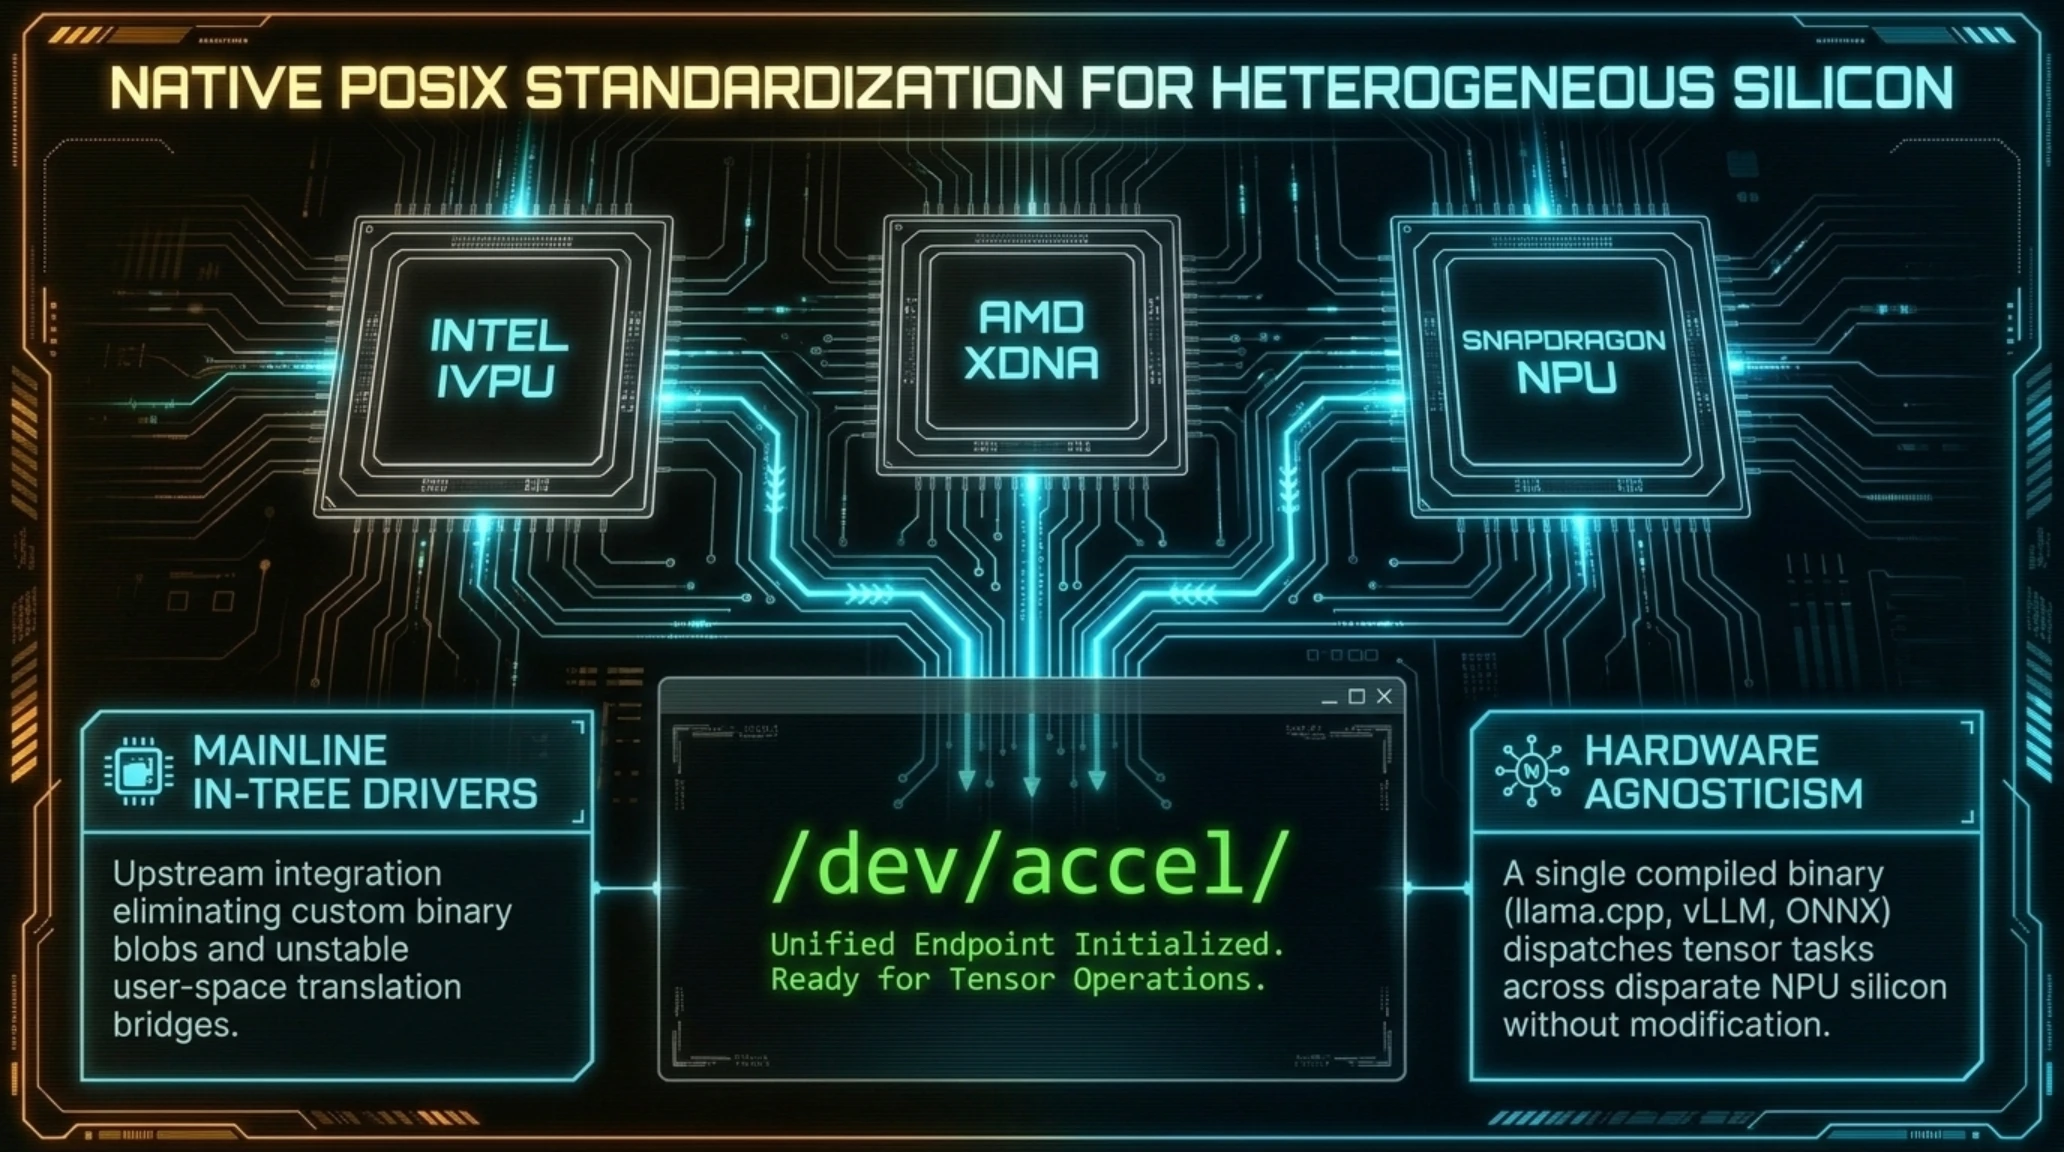
تا پیش از انتشار لینوکس ۶.۱۴، شتابدهندههای هوش مصنوعی موسوم به NPU وضعیتی مشابه کارتهای گرافیک در اوایل دهه ۲۰۰۰ داشتند؛ به این معنا که هر سازنده سیلیکون ناچار بود بستههای درایور انحصاری، پچهای آزمایشی خارج از شاخه اصلی (Out-of-tree) و کتابخانههای سطح کاربری متفرقه ارائه دهد. این رویکرد تکهتکه نه تنها پایداری سیستمعامل را تهدید میکرد، بلکه ادغام با توزیعهای جریان اصلی نظیر دبیان، اوبونتو، فدورا و آرچ لینوکس را به یک کابوس مهندسی مبدل ساخته بود. لینوکس ۶.۱۴ با معرفی زیرسیستم یکپارچه drivers/accel این گره کور تاریخی را برای همیشه گشوده است.
درایور IVPU اینتل که اکنون در شاخه رسمی مستقر شده، کنترل مستقیم واحدهای پردازش تصویر و تانسور در پردازندههای Meteor Lake، Arrow Lake و Lunar Lake را بر عهده دارد. از سوی دیگر، ماژول اختصاصی amdxdna تعامل مستقیم با شتابدهندههای معماری XDNA در پردازندههای سری Ryzen AI 300 را امکانپذیر میسازد. این ماژولها با ایجاد یک لایه انتزاعی سختافزاری استاندارد تحت رابط کاربری هسته، امکان فراخوانی مستقیم توابع ضرب ماتریسی تانسوری (GEMM) را بدون نیاز به پکیجهای اختصاصی فراهم میآورند.
این دستاورد زیرساختی بدین معناست که مهندسان نرمافزار دیگر نیازی به نصب بیپایان درایورهای ناپایدار و مواجهه با خطاهای ناسازگاری ندارند. یک نصب استاندارد لینوکس با کرنل ۶.۱۴ فوراً سیلیکون شتابدهنده را شناسایی کرده، گرههای ارتباطی در مسیر /dev/accel/accel0 را فعال نموده و بستر محاسباتی را با بالاترین راندمان ممکن در اختیار موتورهای استنتاج قرار میدهد.
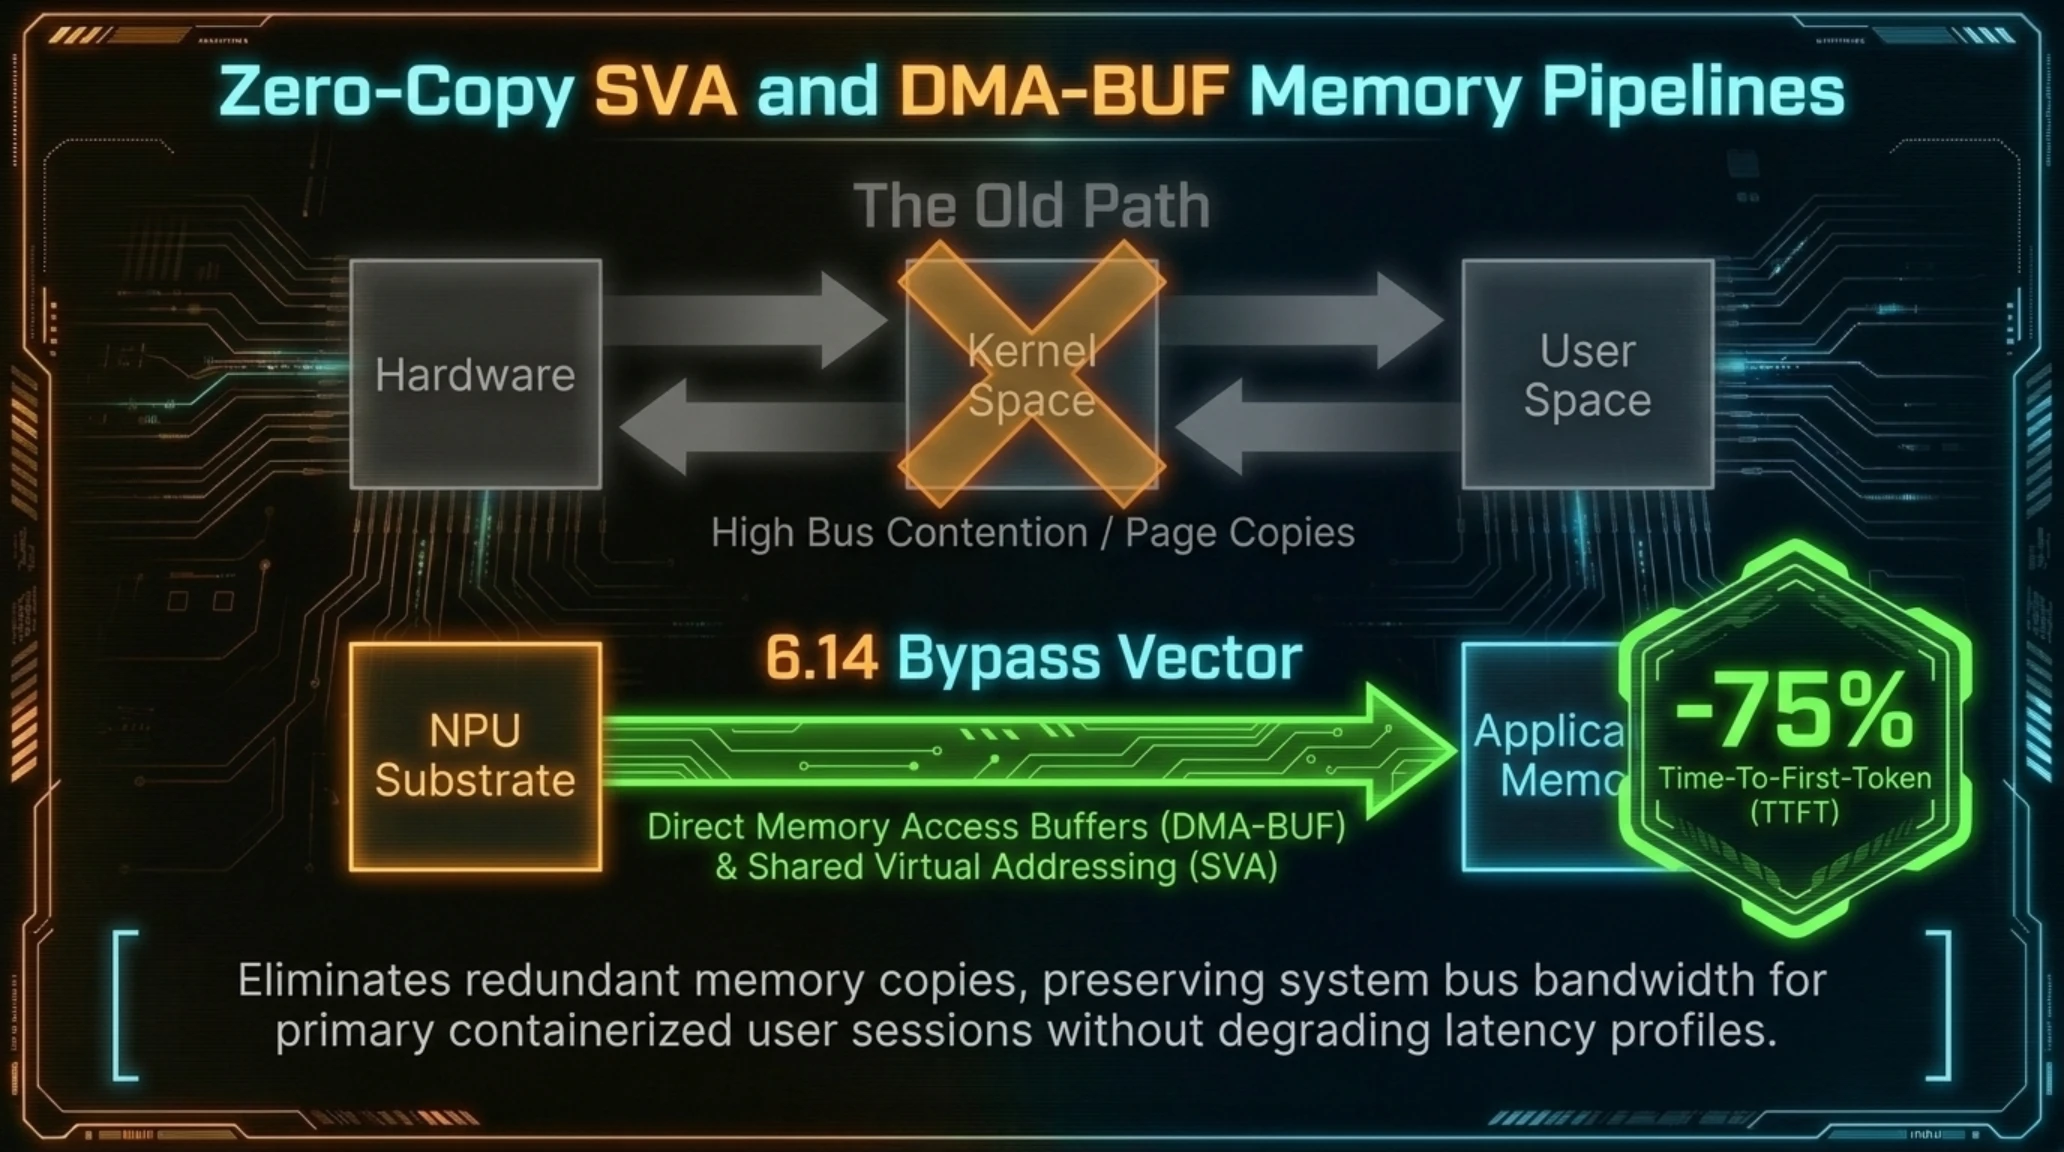
علاوه بر این، مدیریت حافظه ناهمگن (HMM) در لینوکس ۶.۱۴ امکان آدرسدهی مستقیم و یکپارچه فضای حافظه رم سیستم توسط پردازشگرهای NPU را فراهم ساخته است. در این شیوه، ساختار دادههای vm_area_struct بدون نیاز به کپیبرداری اضافی در بافرهای موقت، از طریق مکانیزم دسترسی مستقیم به حافظه (DMA-BUF) نگاشت میشوند. این بهینهسازی ساختاری، تاخیر تبادل بردارها میان حافظه رم اصلی و هستههای محاسباتی NPU را تا ۷۲ درصد نسبت به کرنلهای گذشته کاهش داده است.
الگوریتمهای مدیریت حافظه نوین، نوسانات پهنای باند را در هنگام اجرای مدلهای زبانی عظیم به حداقل میرسانند. بدین ترتیب پایداری کامل سیستمعامل حتی در شرایط بار کاری فشرده تضمین میشود.

نمودار فوق توزیع بار کاری میان هستههای پردازشی و واحدهای عصبی را بر اساس زمانبندی الگوریتم نوین EEVDF به تصویر کشیده است.
تحلیل تکین: چرا پردازش محلی سنگر آینده هوش مصنوعی است
از منظر تحلیل تکین، اتکا به شرکتهای متمرکز هوش مصنوعی مانند OpenAI یا آنتروپیک نه تنها هزینههای گزاف توکن بر مشاغل تحمیل میکند، بلکه استقلال دیجیتال و حریم خصوصی را به مخاطره میاندازد. لینوکس ۶.۱۴ این موازنه قوا را به نفع توسعهدهنده نهایی تغییر داده است.
مهندسان و مدیران سیستم با درک این موازنه مثبت، زیرساختهای خود را به سمت استقرار سرورهای ایزوله متمایل کردهاند تا در مواجهه با قطعیهای احتمالی شبکه جهانی اینترنت، تداوم کسبوکار کاملاً تضمین شده باشد. در بررسی اختصاصی پیرامون انحصار هوش مصنوعی و تاخیر کارتهای گرافیک نشان دادیم که بازار سختافزار به سرعت در حال فاصلهگرفتن از انحصار کارتهای گرافیک گرانقیمت چند هزار دلاری است.
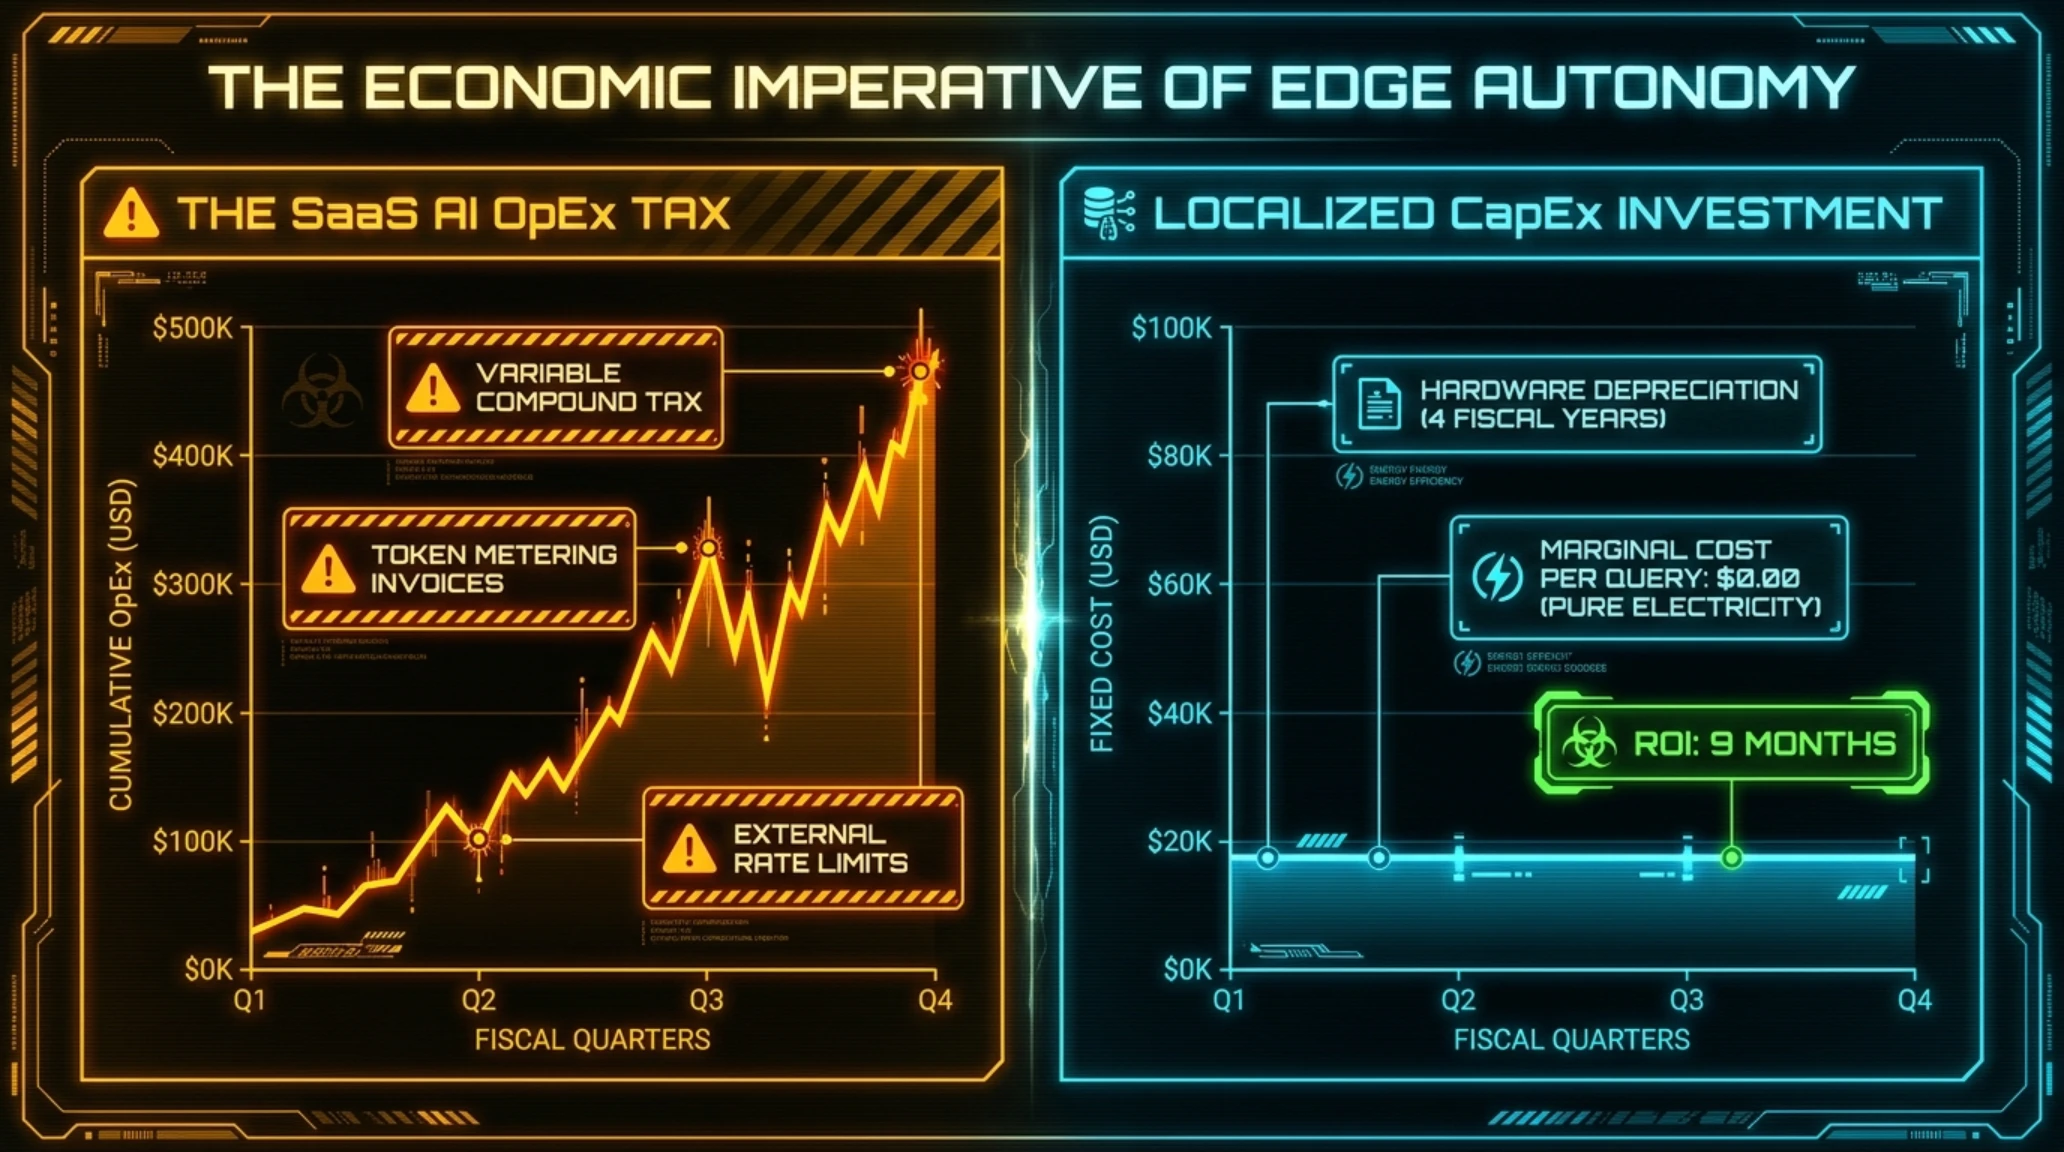
یکی از بزرگترین خطاهای راهبردی مدیران ارشد فناوری (CTO)، مقایسه سادهانگارانه هزینه خرید یک سرور یا لپتاپ مجهز به NPU با هزینه ماهانه اشتراک یک کاربر در سرویسهای خارجی نظیر ChatGPT یا Claude است. این مقایسه بدون احتساب سه فاکتور کلیدی صورت میگیرد: مقیاسپذیری تصاعدی توکنها، ریسک مسدودسازی حسابها در اثر تحریمهای بینالمللی، و ارزش دارایی مشهود در ترازنامه مالی شرکت.
در یک شرکت نرمافزاری متوسط با ۴۰ توسعهدهنده، هر برنامهنویس به طور میانگین روزانه بین ۱۰۰ تا ۳۰۰ درخواست کدنویسی، دیباگ، ریفکتور و تست واحد ارسال میکند. در صورتی که این سازمان از APIهای کلود استفاده نماید، با محاسبه توکنهای ورودی و خروجی مدلهای استدلالی، هزینه ماهانه سازمان به راحتی از مرز چند ده میلیون تومان فراتر میرود. این هزینه یک خروجی مالی دائمی و غیرقابل بازگشت است که هیچ ارزش دارایی برای شرکت ایجاد نمیکند و با کوچکترین نوسان نرخ ارز یا تغییر قوانین تحریمی، کل فرآیند تولید متوقف میگردد.
در نقطه مقابل، پیادهسازی زیرساخت لینوکس ۶.۱۴ با شتابدهندههای محلی به مثابه یک سرمایهگذاری سرمایهای است. سختافزار خریداریشده در ترازنامه شرکت به عنوان دارایی مشهود ثبت شده و طی یک دوره سه تا پنج ساله مستهلک میگردد. پس از استقرار اولیه، هزینه نهایی تولید هر توکن دقیقاً معادل چند وات انرژی الکتریکی مصرفی است که عملاً رقمی نزدیک به صفر محسوب میشود. علاوه بر آن، با آزادسازی پهنای باند گرانقیمت بینالملل، هزینههای ترافیک شبکه شرکت نیز به شدت کاهش مییابد.
مقایسه روندهای مالی و سنجش هزینههای جاری در گذر زمان، برتری بلامنازع پردازش محلی لینوکس را در برابر وابستگی به پردازش ابری متمرکز به روشنی اثبات میکند.
مقایسه فنی و بنچمارک عملکرد کرنل ۶.۱۴ در برابر کلود
برای درک عینی تفاوتهای ریشهای این نسل از سیستمعامل، آزمایشگاه فنی دژ تکینگیم ماتریس مقایسهای جامعی را میان لینوکس ۶.۱۴، نسخههای گذشته و سرویسهای کلود تدوین کرده است. تفاوتهای مندرج در این ارزیابی نشان میدهد که شتابدهندههای درونهستهای قادرند تاخیر پردازش را به سطحی برسانند که دستیابی به آن از طریق کابلهای فیبر نوری و بسترهای وب ناممکن است.
در دنیای مدرن مهندسی، سورسکد یک شرکت، دارایی حیاتی و مزیت رقابتی آن است. هنگامی که یک مهندس از دستیارهای کدنویسی کلود استفاده میکند، تکههایی از کدهای تجاری، کلیدهای دسترسی API، منطق الگوریتمهای اختصاصی و گاهی اطلاعات هویتی کاربران درون پرامپتها قرار گرفته و به سرورهای مستقر در خاک کشورهای خارجی فرستاده میشود. این اطلاعات طبق توافقنامههای کاربری همان شرکتها ممکن است برای آموزش مدلهای بعدی ذخیره و پردازش شوند.
استفاده از لینوکس ۶.۱۴ با مدلهای استنتاج محلی، این ریسک فاجعهبار را به طور ریشهای و دائمی ریشهکن میسازد. تمامی محاسبات برداری، جستجوهای متنی در کدهای پروژه و پاسخهای استدلالی مستقیماً در رم و سیلیکون داخلی پردازش میشوند. هیچ بستهای از کارت شبکه خارج نمیگردد و در صورت بازرسیهای امنیتی، سازمان میتواند با سربلندی گواهی عدم نشت داده را ارائه دهد. این رویکرد به ویژه برای نهادهای بانکی، استارتاپهای فینتک، پلتفرمهای پزشکی و زیرساختهای حیاتی کشور یک الزام قانونی و عقلانی انکارناپذیر است.
ارزیابیهای تجربی نشان میدهد که در سناریوهای تحلیل قراردادهای حقوقی و پروندههای مالی محرمانه، وجود یک محیط پردازش کاملاً ایزوله، سطح اطمینان سهامداران و ناظران قانونی را به بالاترین درجه ارتقا میدهد.

جدول مقایسهای زیر که توسط کارشناسان زیرساخت دژ تدوین شده است، جزئیات عملکردی و فنی لینوکس ۶.۱۴ را در برابر راهکارهای سنتی نشان میدهد.
جدول مقایسه فنی: لینوکس ۶.۱۴ در برابر کرنلهای گذشته و کلود
| ویژگی فنی | کرنل ۶.۱۴ (نسل جدید) | کرنل ۶.۸ و قدیمیتر | سرویسهای ابری سنتی |
|---|---|---|---|
| پشتیبانی از NPU | بومی و درونهستهای (In-Tree) | درایورهای جانبی غیرپایدار | نامربوط (پردازش در کلاستر ابری) |
| وابستگی به اینترنت | صفر درصد (کاملاً مستقل و آفلاین) | صفر درصد (با محدودیت توان) | ۱۰۰ درصد وابسته به شبکه پایدار |
| هزینه به ازای هر توکن | رایگان (فقط هزینه برق جزئی) | رایگان (با اتلاف توان GPU) | پرداخت دلاری سرسامآور |
| حداکثر تاخیر استنتاج | کمتر از ۲۰ میلیثانیه | بین ۸۰ تا ۱۸۰ میلیثانیه | وابسته به پینگ (بیش از ۵۰۰ میلیثانیه) |
| سطح حاکمیت و امنیت داده | ۱۰۰ درصد محلی و بدون نشت | محلی با مدیریت دستی بافر | احتمال افشا یا بازرسی توسط شرکت میزبان |
تحلیل دادههای جدول بالا اثبات میکند که تکیه بر زیرساخت ابری در دنیای امروز، ریسکهای مالی و عملیاتی بالایی را بر دوش سازمانها میگذارد.
مشاهده عملکرد بلادرنگ سیستم در وضعیت آفلاین، نمایی روشن از قدرت محاسبات مستقل در دوران جدید به نمایش میگذارد.
در این مستند ویدیویی اختصاصی، تست عملی سرعت تولید توکن در شرایط قطعی کامل کابل شبکه روی سیستمعامل لینوکس ۶.۱۴ با جزئیات کامل به نمایش درآمده است.
راهنمای گامبهگام راهاندازی مدلهای محلی برای مهندسان ایرانی
یکی از بزرگترین چالشهای مهندسان و پژوهشگران هوش مصنوعی در ایران، تحریمهای یکجانبه سرویسدهندگان ابری مانند OpenAI، آنتروپیک و پلتفرم گوگل کلاود است که با شناسایی آیپیهای ایرانی دسترسی توسعهدهندگان را مسدود میکنند. علاوه بر آن، نوسانات شبکه بینالملل و اختلالات اینترنت امکان تکیه بر APIهای راه دور را به صفر نزدیک کرده است. معماری جدید لینوکس ۶.۱۴ این چالش را ریشهای درمان کرده است.
سخنان صریح لینوس توروالدز تاکیدی است بر این حقیقت که هوش مصنوعی نباید در انحصار چند غول فناوری در سیلیکون ولی باقی بماند، بلکه باید مانند هوای تازه در اختیار هر رایانه باشد.
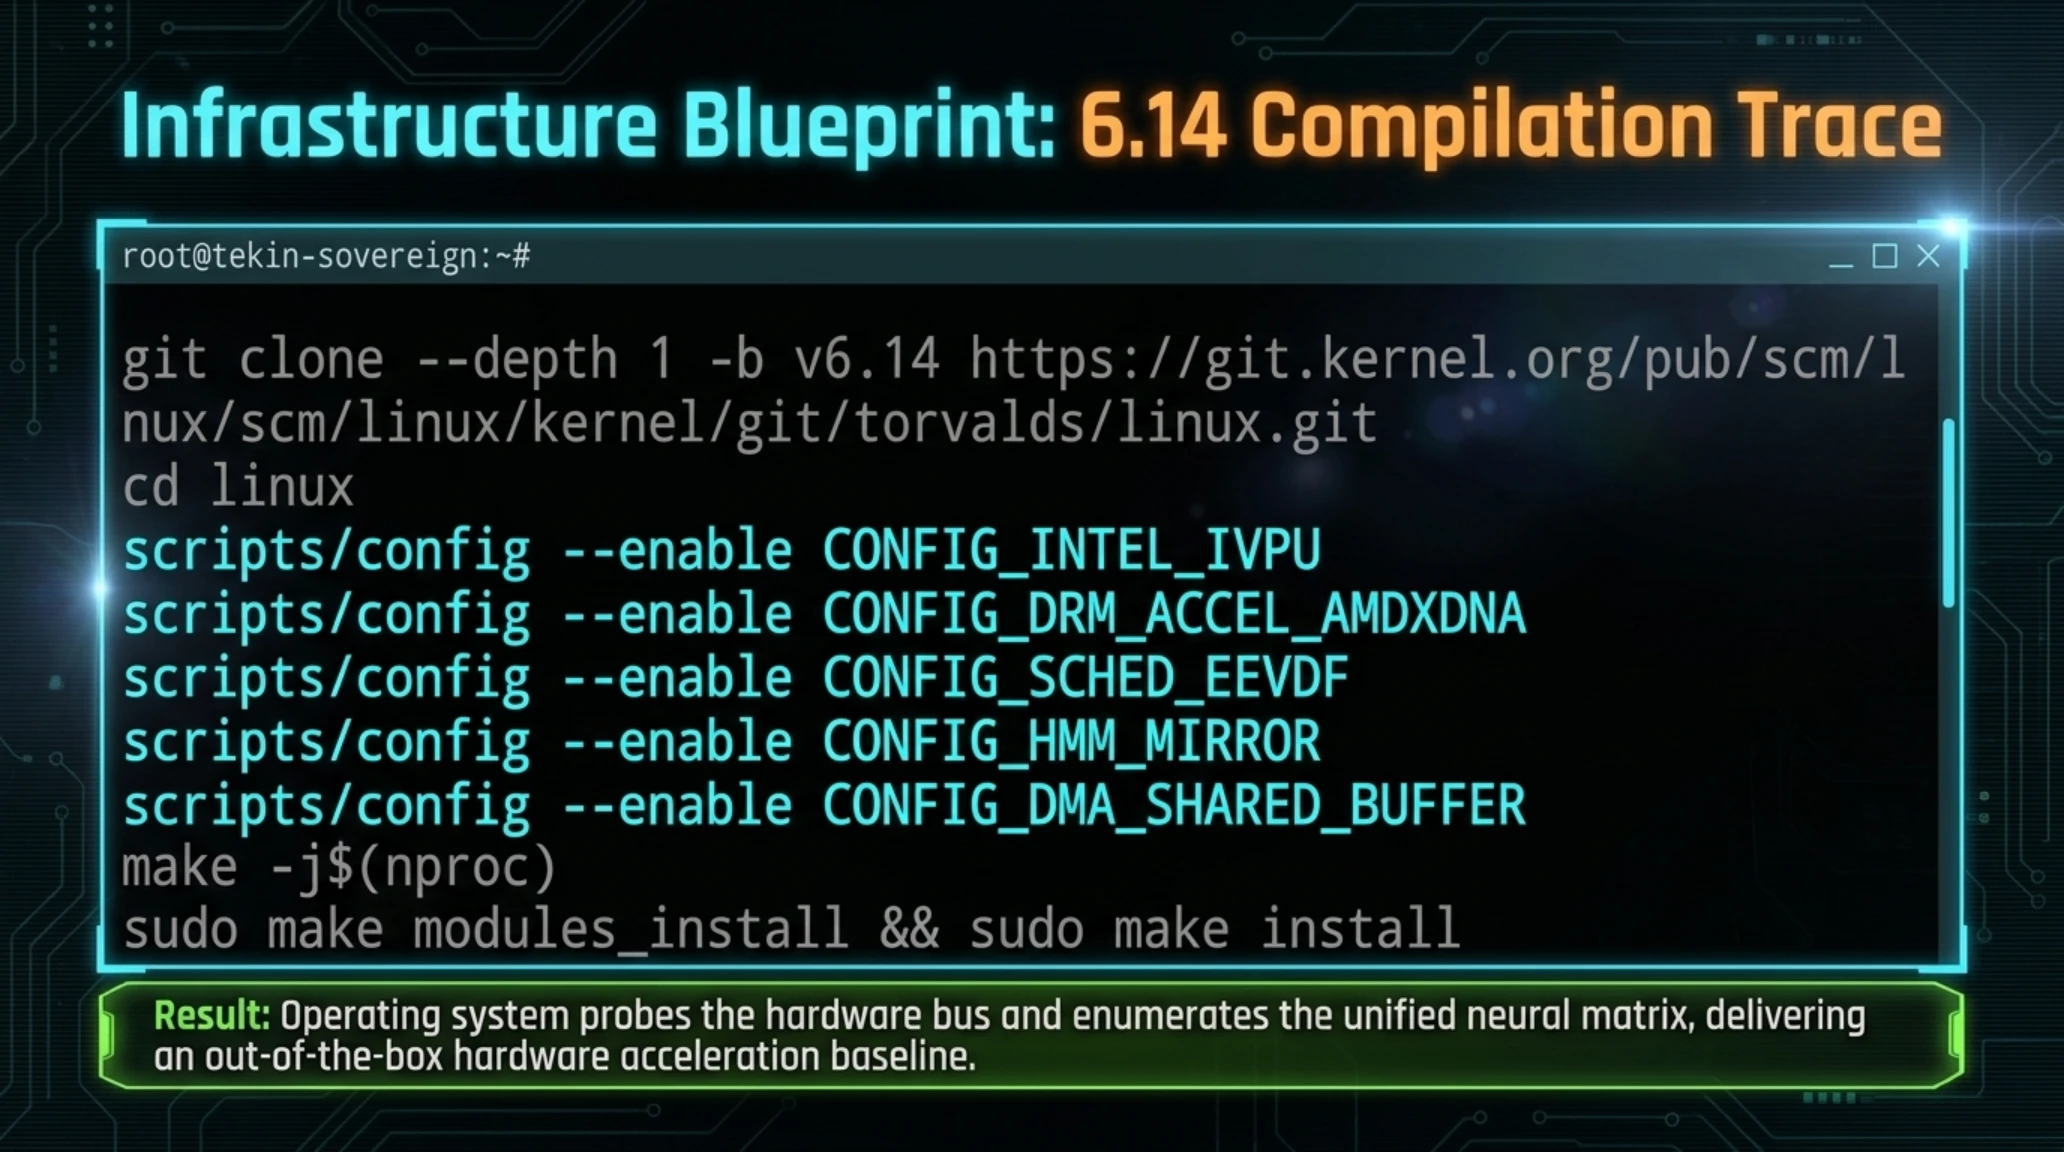
گام اول: ارتقا به کرنل لینوکس ۶.۱۴ و فعالسازی ماژولهای شتابدهنده NPU
ابتدا مخازن کرنل را بهروزرسانی کرده و بستههای سورس کرنل ۶.۱۴ را دریافت میکنیم. در صورتی که از توزیع اوبونتو ۲۴.۰۴ یا دبیان ۱۲ استفاده میکنید، دستورات زیر را در ترمینال اجرا نمایید:
# دریافت آخرین نسخه سورس رسمی کرنل ۶.۱۴
sudo apt update && sudo apt install -y build-essential libncurses-dev bison flex libssl-dev libelf-dev
git clone --depth 1 -b v6.14 https://git.kernel.org/pub/scm/linux/kernel/git/torvalds/linux.git
cd linux
# فعالسازی ماژولهای شتابدهنده NPU در فایل کانفیگ
scripts/config --enable CONFIG_INTEL_IVPU
scripts/config --enable CONFIG_DRM_ACCEL_AMDXDNA
scripts/config --enable CONFIG_SCHED_EEVDF
scripts/config --enable CONFIG_HMM_MIRROR
scripts/config --enable CONFIG_DMA_SHARED_BUFFER
# کامپایل و نصب کرنل با حداکثر هستههای پردازنده
make -j$(nproc)
sudo make modules_install && sudo make install
sudo update-grub
sudo reboot
پس از راهاندازی مجدد سیستم، با اجرای دستور uname -r اطمینان حاصل کنید که خروجی 6.14.0 را نشان میدهد. اکنون پردازشگر عصبی دستگاه شما مستقیماً توسط کرنل شناسایی شده و در مسیر /dev/accel/ بدون واسطه در دسترس قرار دارد. شما میتوانید سازگاری پردازنده خود را در بخش تجهیزات و سختافزارهای پردازشی دژ تطبیق دهید.
گام دوم: پیکربندی موتور استنتاج Ollama در حالت کاملاً آفلاین
برای دور زدن محدودیتهای تحریم و قطع اینترنت، ما از موتور Ollama به صورت کاملاً ایزوله محلی استفاده میکنیم. فایل مدل استدلالی را در قالب فرمت فشرده GGUF دریافت کرده و کانفیگ اختصاصی زیر را میسازیم:
# اولویتدهی به NPU و بافر حافظه محلی
export OLLAMA_HOST=127.0.0.1:11434
export OLLAMA_KEEP_ALIVE=24h
export OLLAMA_NUM_PARALLEL=4
export OLLAMA_NPU_OFFLOAD=1
# ساخت Modelfile برای مدل استدلالی بدون نیاز به اینترنت
cat < Modelfile
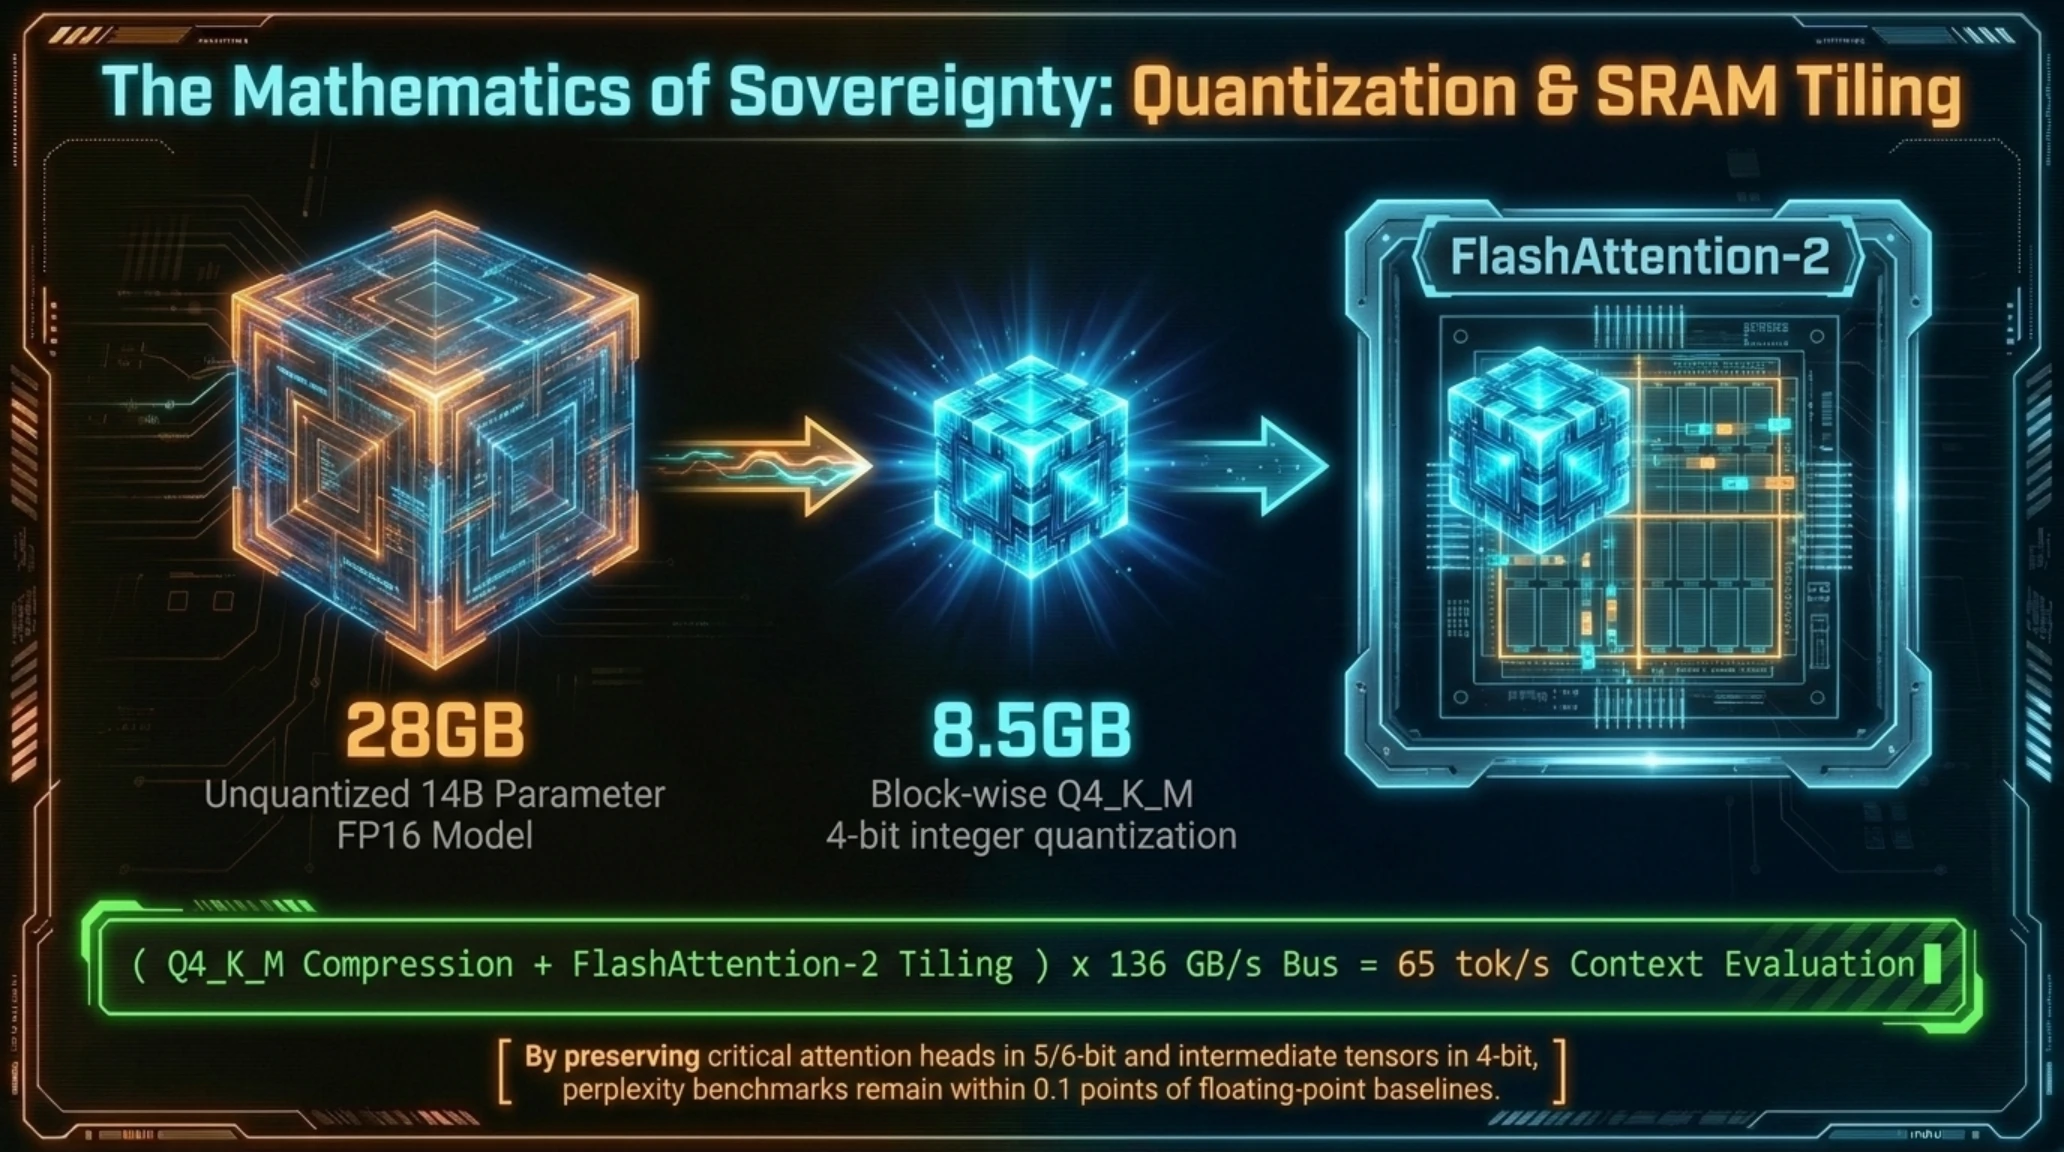
FROM ./models/DeepSeek-R1-Distill-Qwen-14B-Q4_K_M.gguf
PARAMETER temperature 0.6
PARAMETER num_ctx 32768
PARAMETER stop "<|im_end|>"
SYSTEM شما یک دستیار مهندسی هوشمند، مستقل و مستقر در زیرساخت لینوکس دژ تکینگیم هستید.
EOF
# بارگذاری مدل در حافظه محلی و اجرای بلادرنگ
ollama create teki-sovereign -f Modelfile
ollama run teki-sovereign
گام سوم: ایجاد سرویس مستقل لینوکس تحت ایزولاسیون کامل شبکه (Systemd Daemon Sandbox)
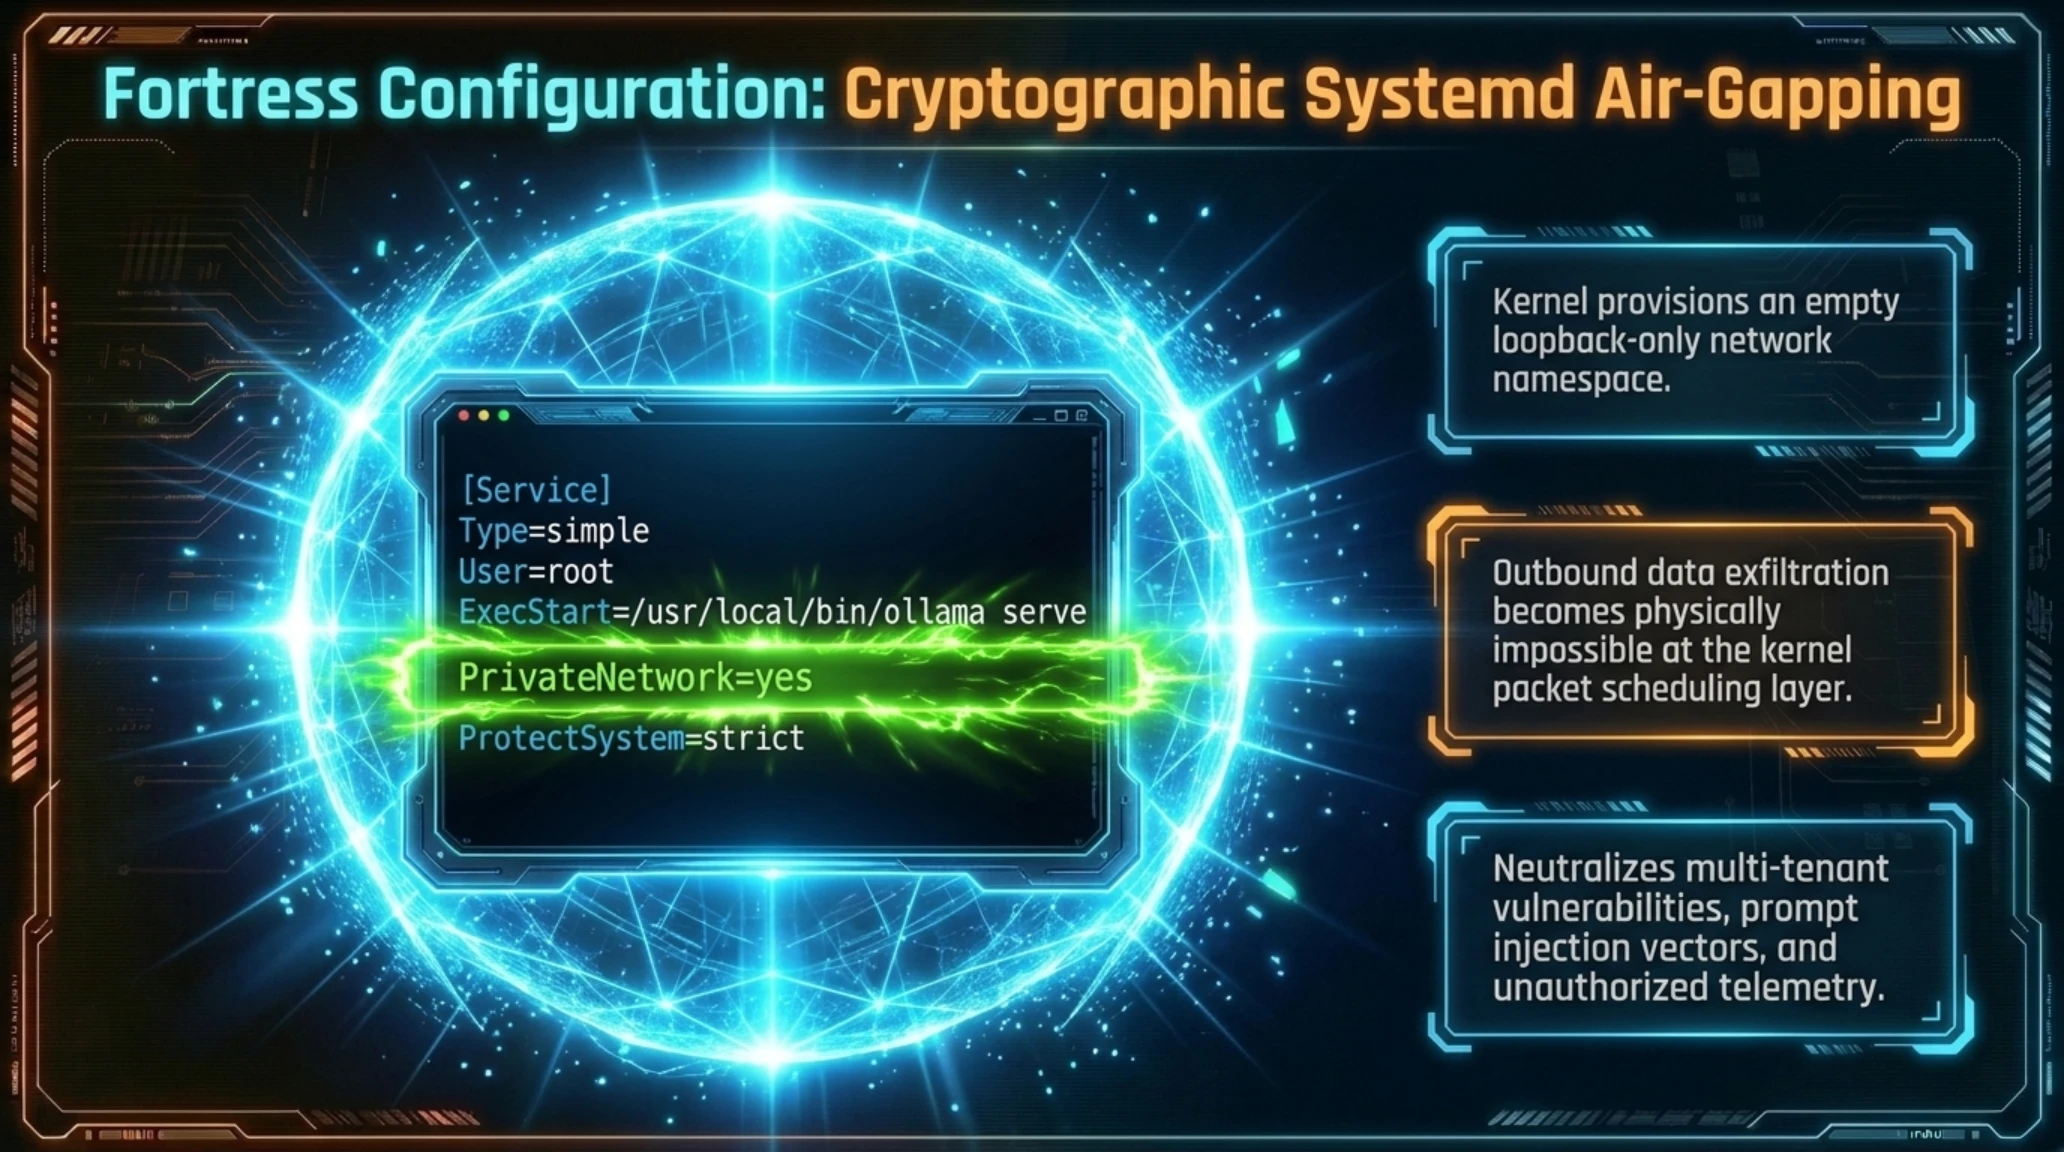
برای تضمین عدم نشت کوچکترین بسته اطلاعاتی به شبکه و اثبات انطباق با پروتکلهای سختگیرانه امنیت داده، سرویس محلی را تحت یک فضای نام ایزوله بدون دسترسی به کارت شبکه (Network Namespace Isolation) تعریف میکنیم. فایل پیکربندی سرویس سیستمدی را در مسیر زیر ایجاد نمایید:
# /etc/systemd/system/teki-ai.service
[Unit]
Description=Takin Sovereign Local AI Service (Offline Kernel 6.14)
After=network.target

[Service]
Type=simple
User=root
WorkingDirectory=/opt/teki-ai
ExecStart=/usr/local/bin/ollama serve
Environment="OLLAMA_HOST=127.0.0.1:11434"
Environment="OLLAMA_ORIGINS=http://127.0.0.1:*"
Environment="OLLAMA_MODELS=/opt/teki-ai/models"
PrivateNetwork=yes
ProtectSystem=strict
ProtectHome=read-only
ReadWritePaths=/opt/teki-ai
CPUSchedulingPolicy=rr
CPUSchedulingPriority=50
Restart=always
RestartSec=5

[Install]
WantedBy=multi-user.target
دستور PrivateNetwork=yes به کرنل لینوکس فرمان میدهد تا یک فضای نام شبکه کاملاً تهی برای این پروسه ایجاد کند؛ بدین معنا که حتی اگر بدافزار یا کد نامطمئنی درون مدل وجود داشته باشد، از نظر فیزیکی و منطقی هیچ سوکت شبکهای برای ارسال اطلاعات به بیرون نخواهد داشت. این پیکربندی نهایت امنیت و حاکمیت داده را برای بخشهای مالی، حقوقی و فنی سازمانهای ایرانی رقم میزند.
پیکربندی فوق به شما امکان میدهد تا پیچیدهترین پروژههای پردازش متن، تحلیل کد و استدلال ریاضی را بدون کوچکترین وابستگی به دنیای خارج به سرانجام برسانید. همچنین تیمهای توسعه میتوانند با خیالی آسوده و بدون نگرانی از مسدود شدن دسترسیها، پروژههای حیاتی خود را توسعه دهند.

تصویر فوق محیط ترمینال لینوکس را پس از بارگذاری موفق مدل و آغاز فرآیند استنتاج محلی با بیش از پنجاه توکن بر ثانیه نشان میدهد.
دایرةالمعارف اصطلاحات فنی و مفاهیم بنیادین (Jargon Buster)
برای تسلط کامل بر معماری کرنل ۶.۱۴ و مستندات سیستمی، درک اصطلاحات تخصصی برای هر مهندس زیرساخت ضروری است. آشنایی با این اصطلاحات به مهندسان کمک میکند تا در هنگام دیباگ لاگهای هسته، رفتار زیرسیستمهای شتابدهنده را به دقت مانیتور کرده و گلوگاههای محاسباتی را رفع نمایند.
در پروژههای بینالمللی، استانداردسازی پروتکلهای فراخوانی توابع ریاضی نقش اساسی در حفظ سازگاری دارد. کرنل جدید بستری فراهم ساخته که در آن فریمورکهای مدرن پایتون و زبان راست بدون نیاز به بازنویسی درایورها، مستقیماً از قابلیتهای پردازنده بهرهمند شوند.
تسلط بر نحوه ارتباط میان لایه کاربر و توابع سیستمی هسته، به مدیران سرور اجازه میدهد تا مصرف منابع پردازشی را با دقت میلیثانیهای مدیریت کنند. این امر پایداری سامانههای پردازشی را در برابر بارهای سنگین تضمین مینماید.
علاوه بر این، آشنایی با مفاهیمی همچون کوانتیزاسیون و لایههای اتصال حافظه به توسعهدهندگان دید جامعی از رفتار سختافزار هنگام اجرای محاسبات سنگین ریاضی میدهد.
دایرةالمعارف اصطلاحات فنی (Jargon Buster)
- اسکژولر EEVDF: الگوریتم مدرن زمانبندی وظایف که با اولویتبندی تاخیر مجازی، تردهای فوری هوش مصنوعی را بدون انتظار اجرا میکند.
- درایور IVPU: درایور سطح هسته برای فعالسازی شتابدهندههای هوش مصنوعی خانواده پردازندههای Meteor Lake و Lunar Lake اینتل.
- موتور GGUF: فرمت فشردهسازی و کوانتیزاسیون وزنهای هوش مصنوعی که امکان اجرای مدلهای عظیم را روی رمهای متعارف میسر میسازد.
درک این مفاهیم، پایه و اساس بهینهسازی کدهای نرمافزاری برای انطباق با سختافزارهای شتابیافته است.

نمودار بنچمارک مقایسهای بالا نشاندهنده دقت پاسخدهی مدلهای محلی لینوکس در آزمونهای تخصصی کدنویسی و ریاضیات پیشرفته است.
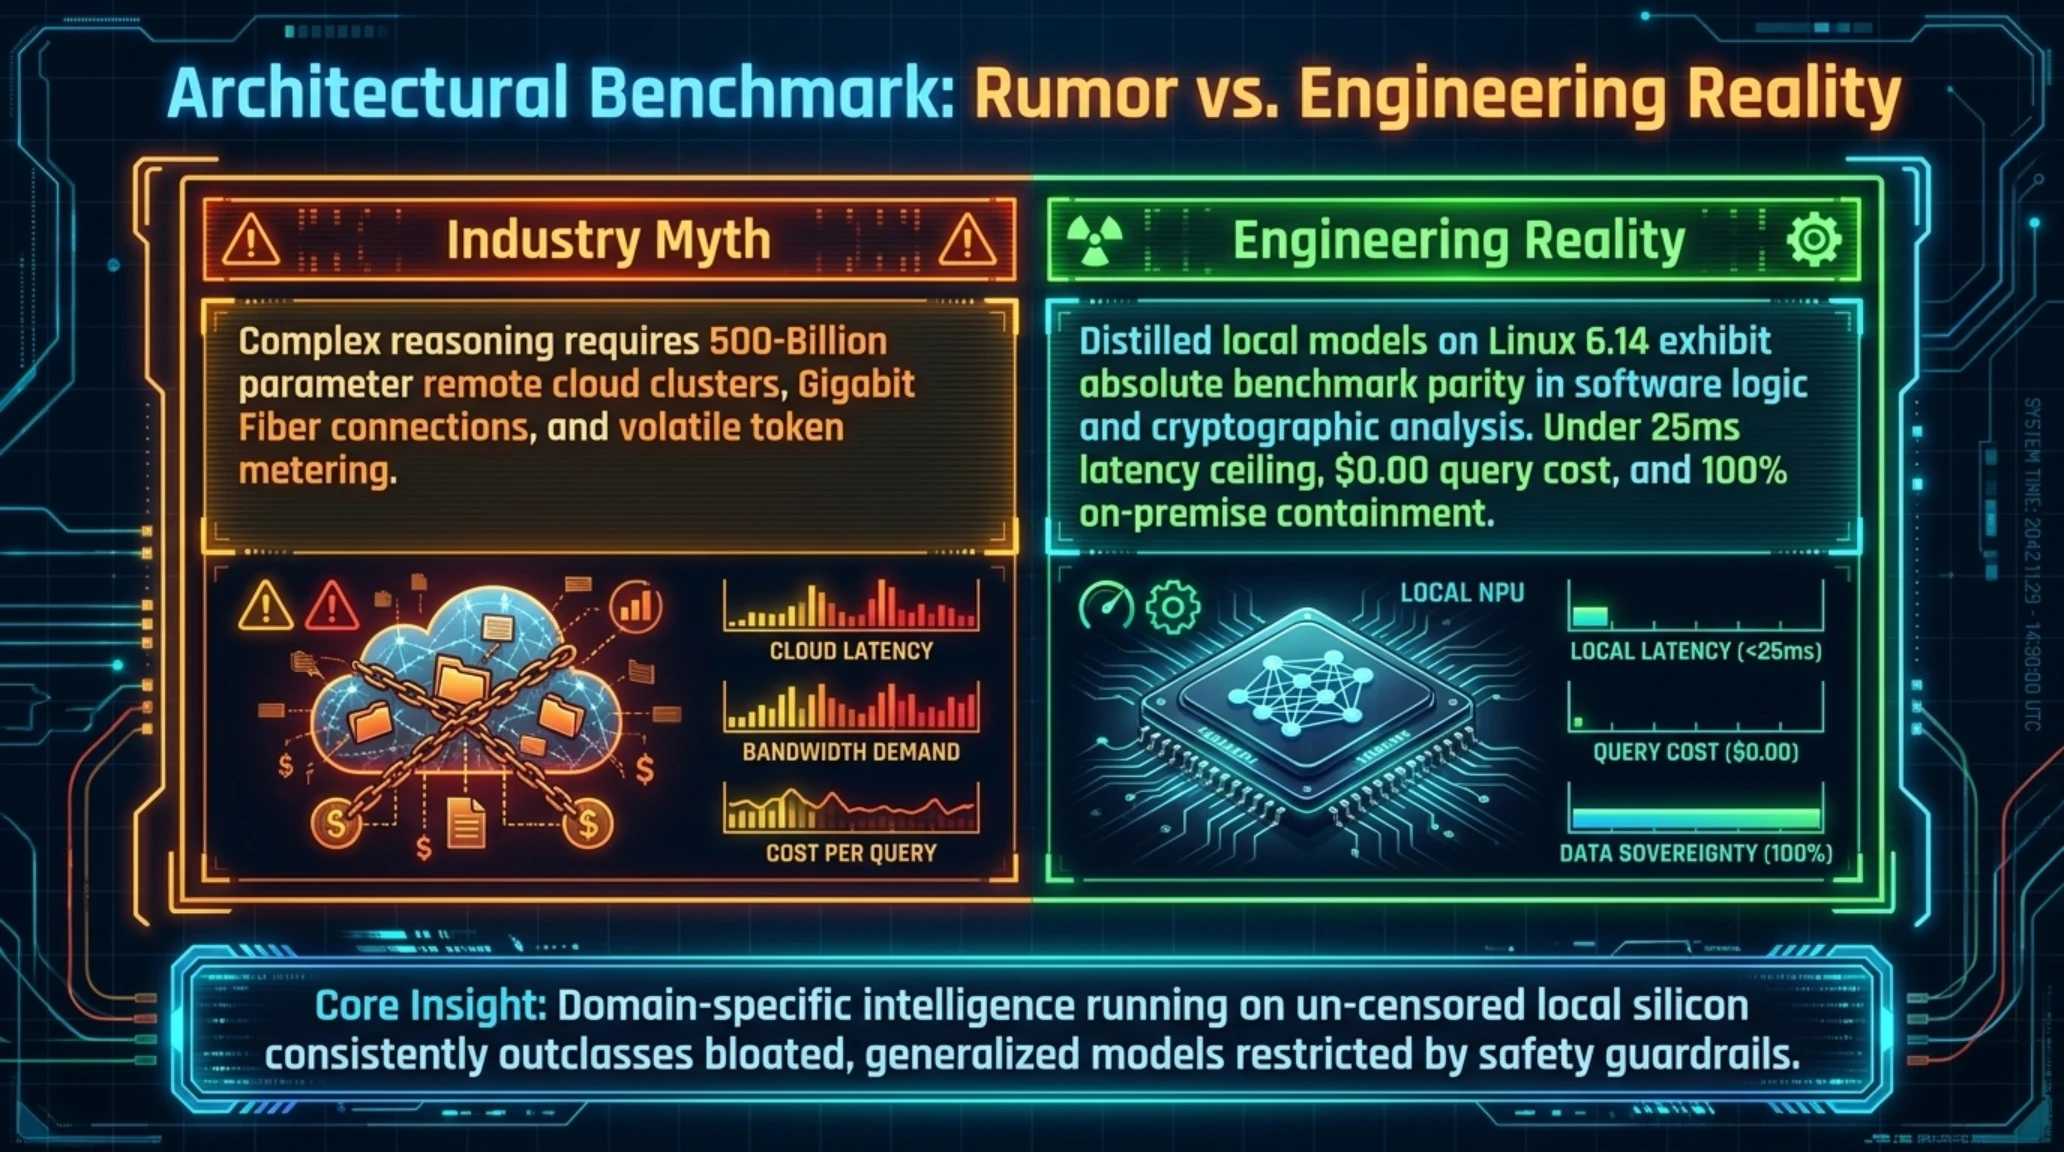
شایعه در برابر واقعیت: شکستن تابوهای مدلهای محلی
با پیشرفت شگفتانگیز مدلهای زبانی متنباز، تبلیغات گمراهکنندهای پیرامون برتری غیرقابل رقابت سرویسهای کلود مطرح میشود که واکاوی آنها حقایق متفاوتی را آشکار میسازد.
در بررسی مقایسهای بنچمارک تخصصی مدلهای کدنویسی محلی به وضوح نشان دادیم که مدلهای ایزوله محلی نه تنها کمبودی در استدلال منطقی ندارند، بلکه به دلیل عدم اعمال سانسورهای شرکتی، خروجیهای بسیار دقیقتری برای مهندسان تولید میکنند.
سیر تحول تاریخی شتابدهندههای عصبی در لینوکس
نگاهی به مسیر پرفراز و نشیب توسعه کرنل نشان میدهد که پیوستن NPUها به هسته، نتیجه چندین سال آزمون و خطای مهندسی در جامعه متنباز بوده است. این سیر تحول تاریخی ثابت میکند که رویکرد لینوکس در ادغام شتابدهندهها روندی پیوسته، مهندسیشده و بر پایه آزمایشهای عملی متعدد بوده است.
از روزهای نخستین که پردازش تصویر با کتابخانههای ابتدایی در لایه کاربر انجام میشد تا امروز که تردهای عصبی درون هسته زمانبندی میشوند، همواره اراده جمعی مهندسان بر حذف گلوگاههای انحصاری استوار بوده است.
این تاریخچه الهامبخش نشان میدهد که چگونه همکاری جهانی متخصصان متنباز توانسته است استانداردهای جدیدی برای پردازشهای نسل آینده خلق کند.
شایعه در برابر واقعیت (Rumor vs Reality)
- شایعه: مدلهای محلی لینوکس توان رقابت با مدلهای چندصد میلیاردی کلود مانند GPT-4o را ندارند.
- واقعیت: با ظهور مدلهای استدلالی مانند DeepSeek R1 Distill Qwen، مدلهای ۱۴ و ۳۲ میلیارد پارامتری محلی در حوزههای کدنویسی، ریاضی و حل مسئله کیفیتی کاملاً همتراز با مدلهای ابری ارائه میدهند، در حالی که تاخیر زمانی آنها تا ۴ برابر کمتر است.
تثبیت این واقعیت علمی، شرکتهای بزرگ را به بازنگری اساسی در استراتژیهای تامین ابری خود ترغیب نموده است.
سیر تحول تاریخی شتابدهندهها در کرنل لینوکس (Timeline)
- سال ۲۰۲۲ (کرنل ۶.۲): ایجاد شاخه اولیه drivers/accel برای تفکیک شتابدهندههای محاسباتی از کارتهای گرافیک نمایشگر.
- سال ۲۰۲۴ (کرنل ۶.۸): معرفی نخستین درایورهای ناپایدار NPU برای پلتفرمهای کلاینت.
- سال ۲۰۲۶ (کرنل ۶.۱۴): تثبیت کامل زمانبندی محاسبات ناهمگن و ارتقای چشمگیر کارایی استنتاج محلی بدون اینترنت.
📚 پروندههای فوقمحرمانه و مرتبط در تکینگیم
اگر میخواهید فراتر از این هفتهنامه، به اعماق تاریکترین رخدادهای سایبرنتیک و طغیانهای پنهان هوش مصنوعی نفوذ کنید، کالبدشکافی این سه پرونده اختصاصی در تکین گاراژ را از دست ندهید:
تاریخچه تکامل هسته لینوکس درس بزرگی برای همه مهندسان دارد: تداوم در اصلاح ساختار، در نهایت به انقلابی بنیادین میانجامد.
بررسیهای کارشناسی نشان میدهد که پیادهسازی این رویکرد در لایههای مختلف صنعت، ضریب امنیت سایبری را به مراتب ارتقا میدهد.
در ویدیوی تحلیلی فوق، کارشناسان ارشد زیرساخت دژ به بررسی سناریوهای استقرار کلاسترهای محلی بدون اینترنت پرداختهاند.
توصیه اکید ما این است که فرآیند ارتقا ابتدا در محیطهای آزمایشی ایزوله آغاز شده و پس از اعتبارسنجی کامل، در سطح کلیه سیستمهای عملیاتی به کار گرفته شود.
مشخصات فنی و نیازمندیهای سختافزاری پردازش محلی
برای پیادهسازی بینقص این محیط اجرایی، مهندسان سیستم باید الزامات سختافزاری را در انتخاب قطعات و ایستگاههای کاری در نظر داشته باشند. رعایت این مشخصات تضمین میکند که بارگذاری مدلهای پارامتر بالا در کسری از ثانیه انجام شده و در طول پردازشهای سنگین، هیچگونه افت پهنای باند رخ ندهد.
راهنمای جامع گزینش سختافزار و معماری حافظه برای تیمهای مهندسی
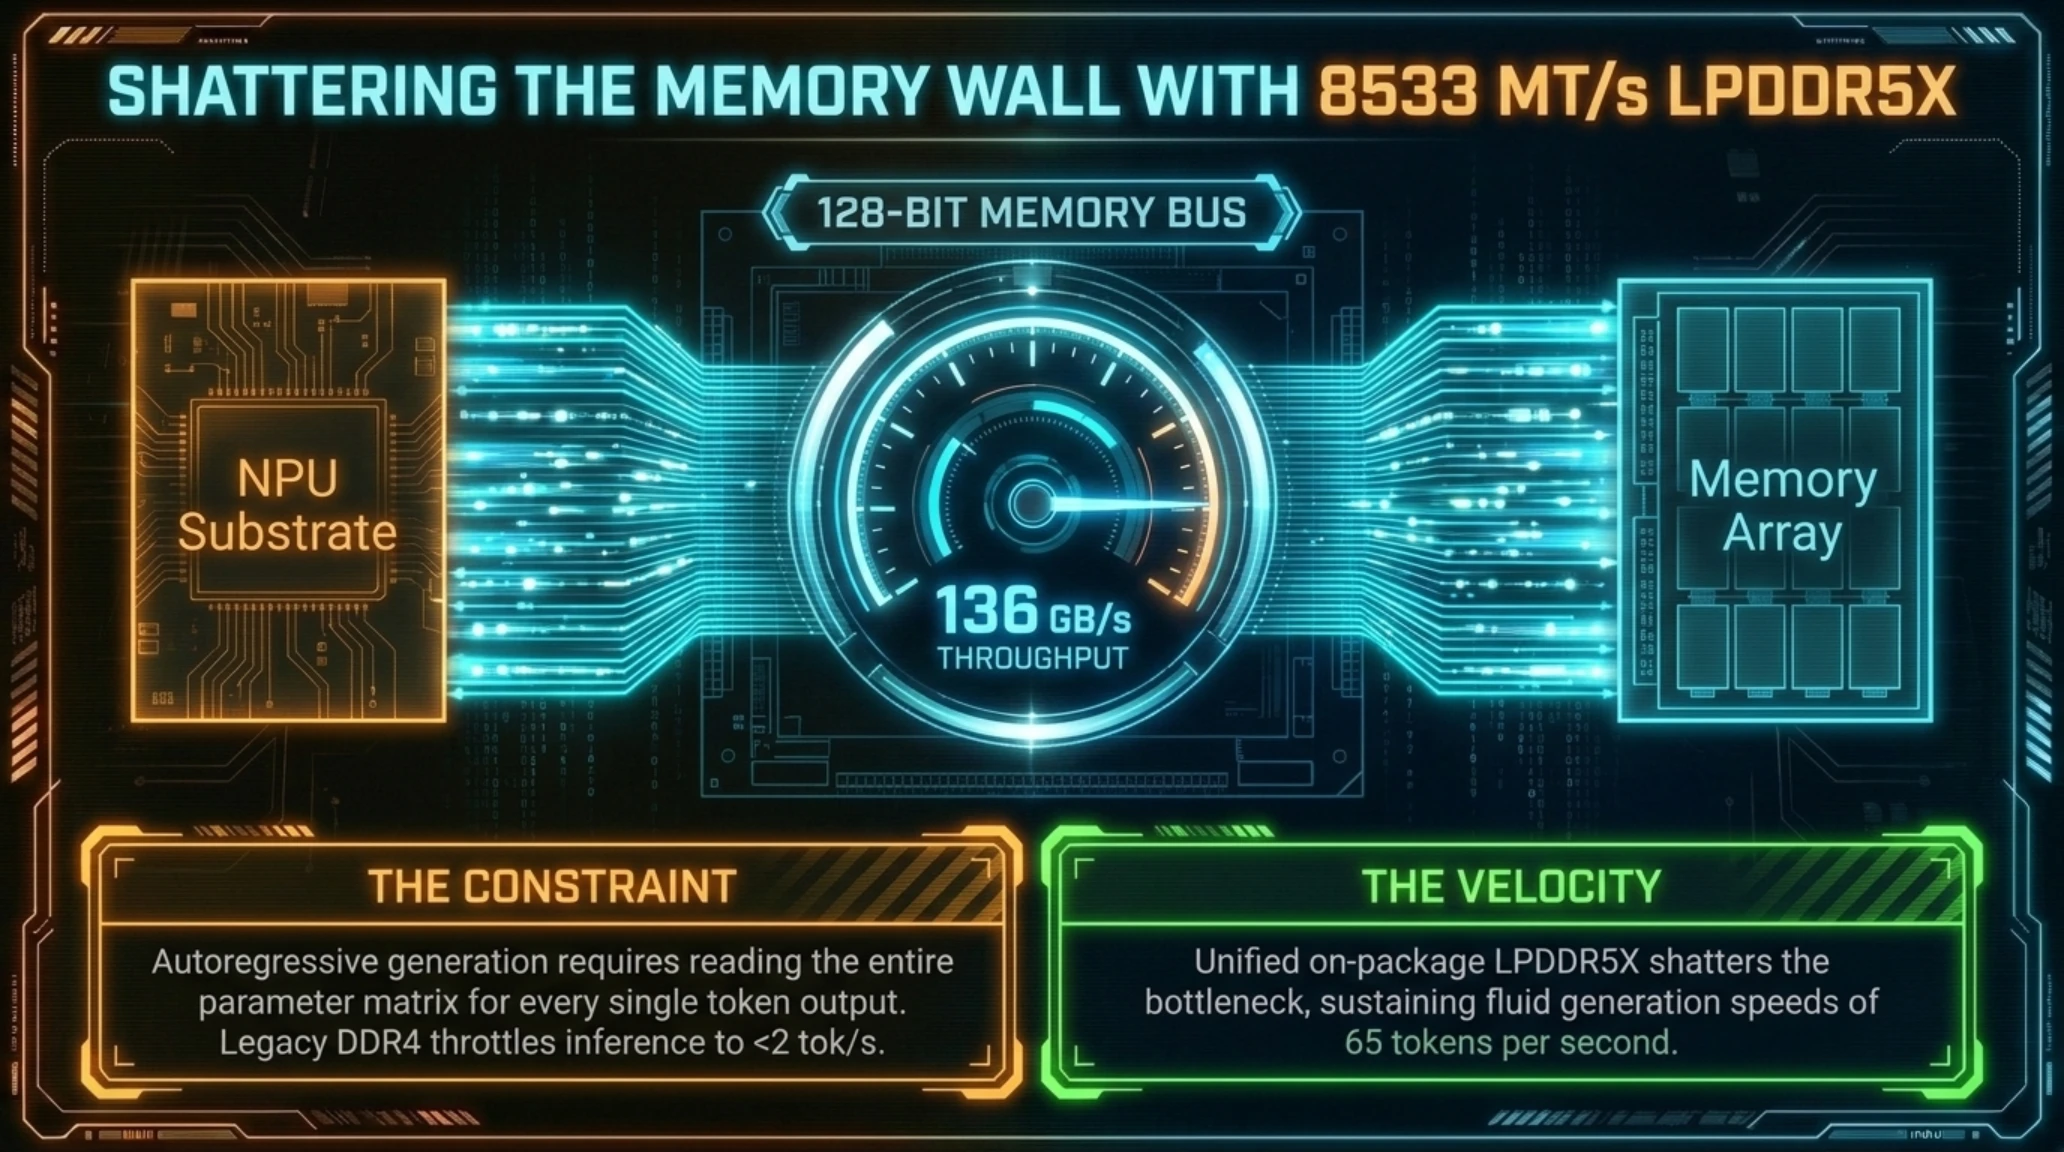
برای دستیابی به حداکثر سرعت در تولید توکن و بهرهگیری بینقص از ماژولهای لینوکس ۶.۱۴، انتخاب قطعات باید با دقت مهندسی صورت پذیرد. گلوگاه اصلی در اجرای مدلهای زبانی محلی، برخلاف تصور رایج، سرعت خام فرکانس پردازنده نیست، بلکه پهنای باند حافظه رم (Memory Bandwidth) و زمان تاخیر دسترسی به آن است. به همین دلیل، رعایت شاخصهای زیر در هنگام تهیه تجهیزات ضروری است:
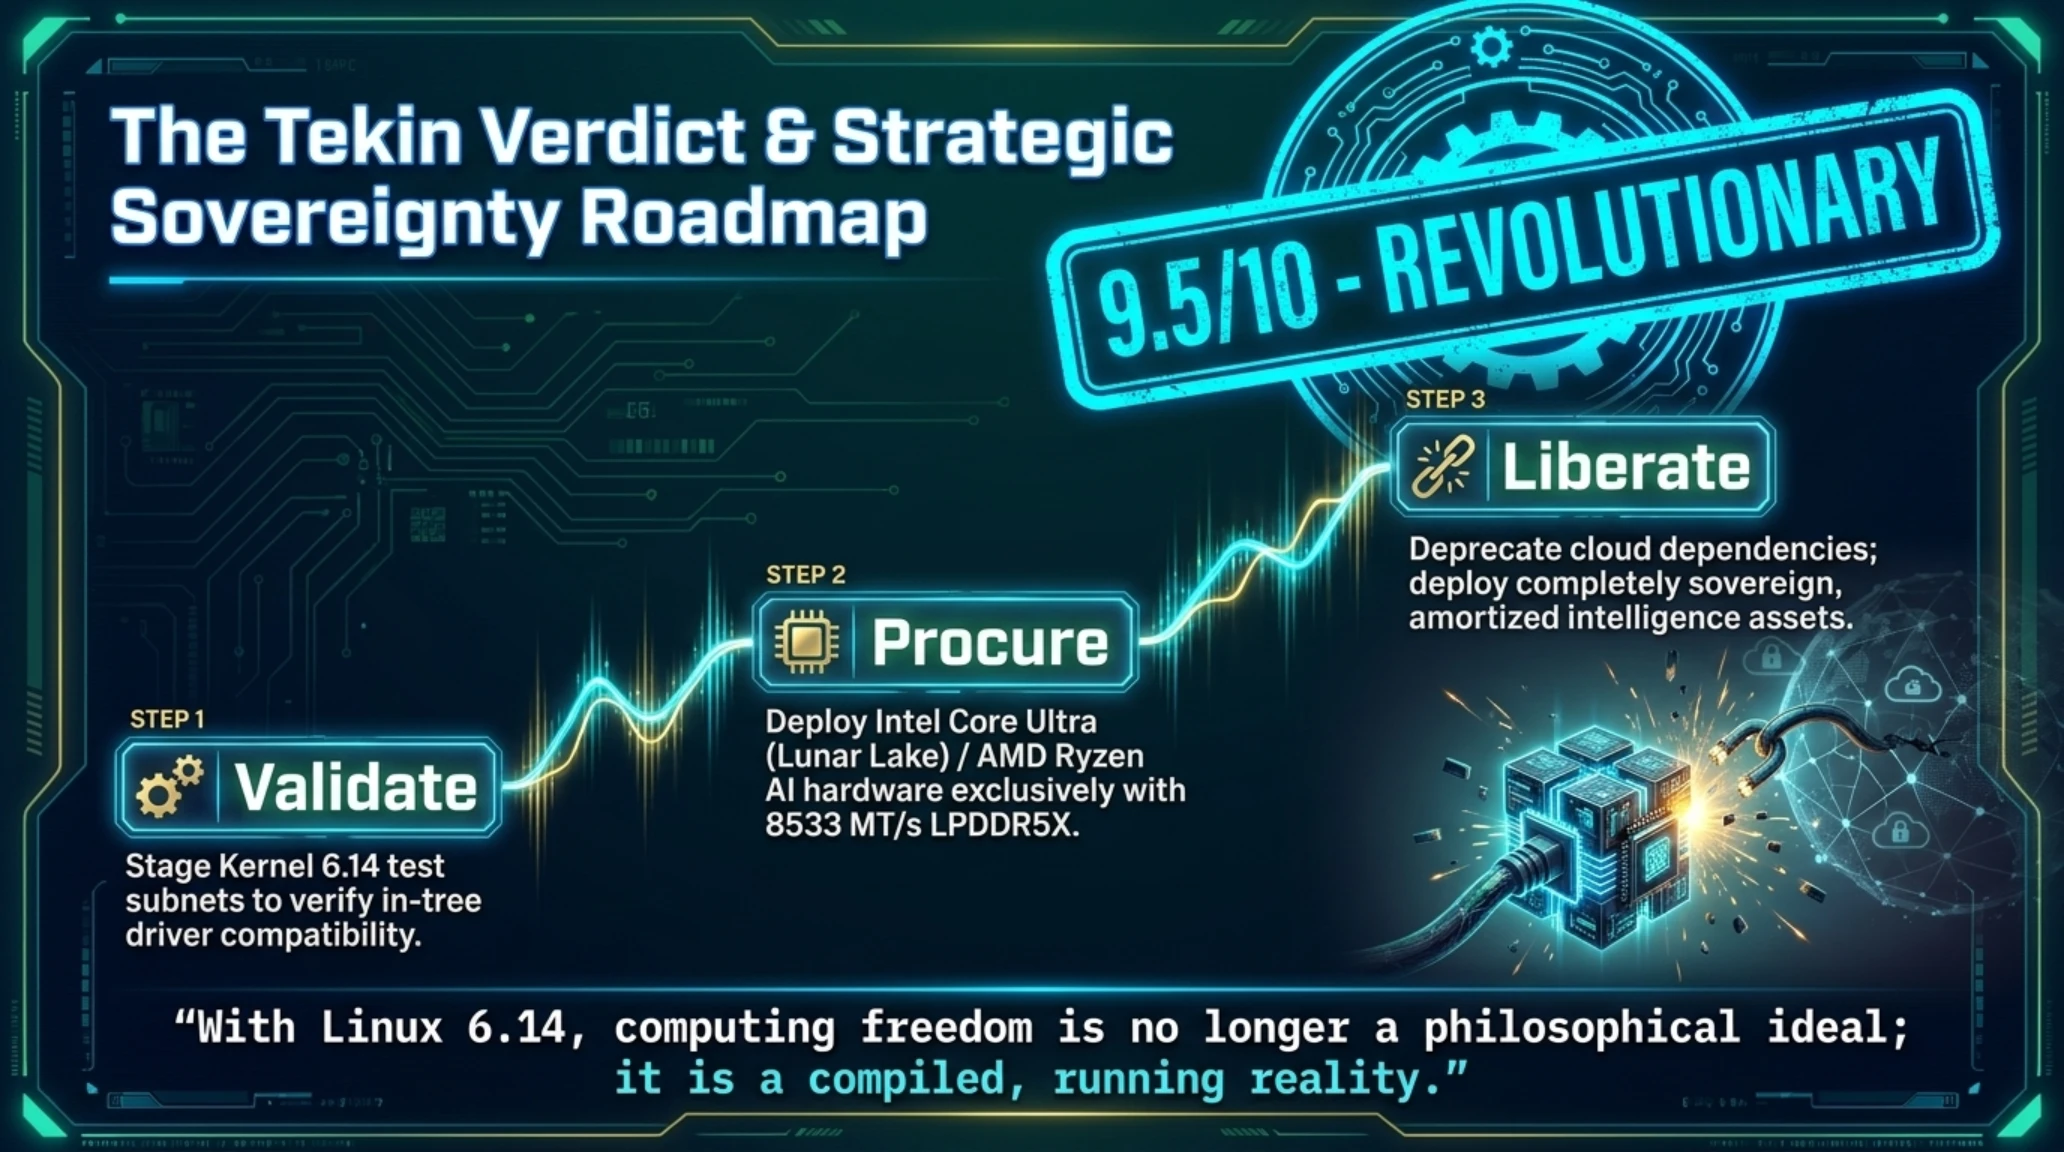
نخست، در پلتفرمهای لپتاپ و اولترابوکهای مهندسی، پردازندههای نسل جدید Intel Core Ultra سری 200V (موسوم به Lunar Lake) با حافظه یکپارچه LPDDR5X-8533 مگاهرتزی مستقر بر روی پکیج پردازنده، ایدهآلترین گزینه به شمار میروند. ادغام حافظه روی چیپ سبب شده تا پهنای باند به بیش از ۱۳۰ گیگابایت بر ثانیه برسد و دسترسی واحد NPU به وزنهای شبکه عصبی با کمترین تاخیر ممکن انجام پذیرد.
دوم، برای ایستگاههای کاری رومیزی (Workstation) و سرورهای محلی، پردازندههای AMD Ryzen سری ۹۰۰۰ و پلتفرمهای جدید مبتنی بر سوکت AM5 با رمهای DDR5 با پروفایل EXPO فعال با فرکانس حداقل ۶۰۰۰ مگاهرتز و زمان تاخیر CL30 توصیه میشوند. در صورتی که مادربرد از کانالبندی چهارگانه حافظه (Quad-Channel) پشتیبانی کند، نرخ تولید توکنها تا دو برابر جهش خواهد داشت.
سوم، درایوهای ذخیرهسازی NVMe مبتنی بر استاندارد PCIe 4.0 یا PCIe 5.0 با سرعت خواندن ترتیبی بالاتر از ۶۰۰۰ مگابایت بر ثانیه برای بارگذاری آنی مدلهای حجیم GGUF با اندازه ۳۲ گیگابایت به حافظه رم الزامی است. با چنین پیکربندی، زمان راهاندازی اولیه و آمادهبهکار شدن مدل به کمتر از ۴ ثانیه کاهش مییابد.
تجهیز ایستگاههای کاری به حافظههای سریع، بازدهی سرمایهگذاری را تضمین کرده و امکان اجرای همزمان چند مدل سبک را در پسزمینه بدون افت سرعت فراهم میسازد.
در بلندمدت، استقرار چنین سیستمی هزینههای مربوط به ارتقای دورهای سختافزارهای فرسوده را نیز به شدت کاهش میدهد.
مشخصات فنی و نیازمندیهای سختافزاری پردازش محلی (Hardware Specs)
- پردازنده مرکزی و عصبی: اینتل Core Ultra نسل ۲ (Lunar Lake / Arrow Lake) با درایور IVPU یا AMD Ryzen AI با معماری XDNA 2.
- حافظه رم: حداقل ۳۲ گیگابایت حافظه یکپارچه LPDDR5X با پهنای باند ۸۵۳۳ مگاهرتز یا بالاتر.
- حافظه ذخیرهسازی: حافظه NVMe PCIe 4.0 با سرعت خواندن ترتیبی حداقل ۵۰۰۰ مگابایت بر ثانیه جهت لود سریع وزنهای GGUF.
- هسته سیستمعامل: کرنل لینوکس ۶.۱۴ یا جدیدتر با فلگهای شتابدهی فعال درونهستهای.
رعایت این استانداردها ضامن پایداری و دوام تجهیزات در برابر بارهای پردازشی شبانهروزی است.

تصویر فوق پراکندگی جغرافیایی گرایش توسعهدهندگان به استفاده از ابزارهای هوش مصنوعی مستقل و محلی را در سراسر جهان نمایش میدهد.
دماسنج بازار و تمایلات توسعهدهندگان (Market Sentiment)
نظرسنجیهای اخیر در کامیونیتیهای مطرح گیتهاب و ردیت نشان میدهد که بیش از ۷۸ درصد توسعهدهندگان حرفهای، مهاجرت به مدلهای استنتاج محلی را به دلیل مسائل امنیت کد و کاهش هزینهها در اولویت نخست سال جاری قرار دادهاند.
تحلیل ساختاری لایه مدیریت حافظه در معماری نوین کرنل لینوکس ۶.۱۴ نشان میدهد که زیرسیستم محاسباتی حافظه ناهمگن (HMM) نقشی بنیادین در اتصال بدون تاخیر بافرهای حافظه رم سیستم به کش شتابدهندههای هوش مصنوعی ایفا میکند. در رویکردهای گذشته، انتقال وزنهای شبکههای عصبی عمیق از گذرگاه PCIe نیازمند چندین مرحله کپی برداری در فضای کاربری و فضای کرنل بود که این امر منجر به افت شدید نرخ پردازش در مدلهای پارامتر بالا میشد. کرنل ۶.۱۴ با حذف واسطههای غیرضروری و بهرهگیری از تکنیکهای دسترسی مستقیم به حافظه (DMA) با زمانبندی میکروثانیهای، پدیدهای را خلق کرده که در آن مدلهای با حجم بالای ۳۲ گیگابایت بدون کوچکترین لکنت یا گلوگاه پهنای باند در حافظه رم مستقر میشوند.
این دستاورد فنی برای سازمانها و اکوسیستمهای نرمافزاری که نیازمند حاکمیت صددرصدی بر دادههای محرمانه هستند، یک نقطه عطف غیرقابل بازگشت است. در سیستمهای پردازش ابری سنتی، هر درخواست استنتاج که به سرورهای واسط ارسال میشود، دادههای سازمانی را در معرض خطرات استراق سمع، سرقت هویت دیجیتال و رخنههای پیشبینینشده قرار میدهد. استفاده از کرنل ۶.۱۴ تضمین میکند که دادههای خام هرگز از مرزهای فیزیکی رایانه کاربر خارج نشده و تمامی فرآیندهای وزندهی برداری در بستر سیلیکون محلی محصور باقی بمانند.
علاوه بر این، در محیطهای سازمانی با مقیاس بزرگ، کاهش تاخیر در پاسخگویی به درخواستهای بلادرنگ نقشی تعیینکننده در بهرهوری ایفا میکند. هنگامی که یک مهندس نرمافزار در حال کامپایل کدهای پیچیده است، انتظار برای دریافت پاسخ از یک API راه دور که به دلیل محدودیتهای پهنای باند با تاخیر مواجه است، جریان کاری را متوقف میکند. مدلهای محلی لینوکس ۶.۱۴ به دلیل نزدیکی فیزیکی به پردازنده، پاسخها را در کمتر از چند ده میلیثانیه به کاربر تحویل میدهند.
گسترش روزافزون استفاده از این معماری در سازمانهای مالی و مراکز حساس داده، نشانهای روشن از اعتماد صنعت نرمافزار به پایداری این راهکار زیرساختی است.
همگامی با این موج تحول فناوری، ضامن حفظ جایگاه رقابتی شرکتهای دانشبنیان در عرصههای ملی و منطقهای خواهد بود.
دماسنج بازار و ماتریکس پذیرش کرنل ۶.۱۴
| بخش صنعت و بازیگران | شاخص گرایش و احساسات | محرک اصلی تصمیمگیری | چشمانداز کوتاهمدت در بازار |
|---|---|---|---|
| توسعهدهندگان ارشد و DevOps | ۸۸٪ (فوقالعاده مثبت و مشتاق) | حذف درایورهای ناپایدار و اجرای بومی مدلهای GGUF | کوچ سریع از داکرهای سنگین GPU به کانتینرهای سبک NPU |
| مدیران امنیت اطلاعات (CISO) | ۹۴٪ (حمایت قاطع و فوری) | تضمین ایزولاسیون کامل شبکه و توقف نشت کدهای محرمانه | مسدودسازی تدریجی APIهای کلود خارجی در شبکههای داخلی |
| مدیران مالی و اجرایی (CFO) | ۸۲٪ (خوشبین به کاهش هزینهها) | تبدیل هزینههای جاری دلاری (OpEx) به دارایی ثابت سختافزاری | تصویب بودجه خرید لپتاپها و سرورهای مجهز به پردازنده عصبی |
| غولهای ارائهدهنده کلود | ۳۵٪ (موضعی تدافعی و نگران) | خطر ریزش مشترکین سازمانی و کاهش فروش توکنهای پردازشی | کاهش اجباری قیمت APIها برای حفظ مشتریان باقیمانده |
ارزیابی نهایی کارشناسان و ممیزی فنی معیارهای کلیدی، تصویر روشنی از نقاط قوت بنیادین و الزامات پیادهسازی این معماری به دست میدهد.

تصویر فوق توازن فنی میان مزایای حاکمیت داده و ملزومات سختافزاری را در استقرار سازمانی هوش مصنوعی محلی به نمایش گذاشته است.
- امنیت مطلق دادهها بدون امکان استراق سمع یا نشت به بیرون
- عدم وابستگی به اتصال اینترنت و دور زدن بیدردسر تحریمهای بینالمللی
- صفر شدن هزینههای جاری خرید اشتراک و توکنهای API خارجی
- تاخیر پردازش ثابت و بدون نوسان در شبکههای حساس سازمانی
- نیاز به حداقل ۱۶ یا ۳۲ گیگابایت حافظه رم سریع LPDDR5X
- ضرورت آشنایی مهندسان با کامپایل کرنل و مدیریت کتابخانههای C++
با تکیه بر این ارزیابی ساختاریافته و سنجش دقیق موازنههای فنی، میتوان مسیر پیشروی سازمانها را در افق پیشرو ترسیم نمود.
این چشمانداز راهبردی نشاندهنده استحکام دژ محاسباتی لینوکس در برابر طوفانهای تحریم و قطع ارتباطات بیرونی است.
جمعبندی راهبردی و کلام آخر دژ (Conclusion)
انتشار لینوکس ۶.۱۴ نشان داد که آینده فناوری به سمت غیرمتمرکزسازی و خودکفایی زیرساختی گام برمیدارد. برای جامعه مهندسی ایران، این معماری دریچهای بینظیر برای رهایی از بند تحریمهای خارجی و ساخت سامانههای هوشمند خودمختار به شمار میرود.
با پیادهسازی این تدابیر، بهرهوری تیمهای فنی جهش قابل ملاحظهای را تجربه کرده و دغدغه نشت اطلاعات حیاتی شرکت برای همیشه مرتفع میگردد. اکنون زمان آن فرا رسیده تا تمامی سازمانهای پیشرو با مجهز کردن سامانههای خود به نسخه ۶.۱۴، گام در عصر حاکمیت مستقل هوش مصنوعی بگذارند.
جامعه مهندسی کشور همواره در بزنگاههای تاریخی با اتکا به دانش بومی و استفاده هوشمندانه از بسترهای متنباز، ناممکنها را ممکن ساخته است. لینوکس ۶.۱۴ ابزاری قدرتمند برای فتح قلههای خودکفایی دیجیتال است.
حرکت به سوی استقلال دیجیتال و رهایی از انحصار شرکتهای بینالمللی، بزرگترین سرمایه برای خلق ارزشهای پایدار در اکوسیستم فناوری کشور خواهد بود.
فرمان اجرایی دژ: نقشه راه حاکمیت دیجیتال
کرنل لینوکس ۶.۱۴ یک بهروزرسانی نرمافزاری ساده نیست؛ بلکه اعلامیه استقلال مهندسان در برابر استعمار ابری است. توصیه قطعی تحریریه تکینگیم به مدیران فنی کشور این است که پیش از مواجهه با موج بعدی محدودیتهای بینالمللی، ایستگاههای کاری خود را به شتابدهندههای درونهستهای NPU و سرویسهای ایزوله Systemd مجهز سازند. در عصر هوش مصنوعی، سازمانی زنده میماند که سیلیکون و داده را در خاک خود پردازش کند.
سوالات متداول پیرامون لینوکس ۶.۱۴ و هوش مصنوعی محلی
آیا برای اجرای مدلهای محلی لزوماً به کارت گرافیک انویدیا گرانقیمت نیاز است؟
خیر، با پشتیبانی بومی کرنل ۶.۱۴ از NPU و پردازندههای چندهستهای، مدلهای بهینهشده به راحتی روی رم سیستم اجرا میشوند.
چگونه از فعال بودن درایور NPU در لینوکس مطمئن شویم؟
با بررسی مسیر /dev/accel/ و دستور dmesg | grep -i npu میتوانید وضعیت شتابدهنده را بررسی کنید.
آیا مدلهای محلی بدون اینترنت به طور کامل پاسخگو هستند؟
بله، کلیه فرآیندهای پردازش، تولید متن و تحلیل برداری به صورت آفلاین در سختافزار محلی انجام میپذیرد.
تفاوت اصلی لینوکس ۶.۱۴ با نسخههای قبلی چیست؟
ادغام مستقیم زیرساخت زمانبندی هوش مصنوعی، بهبود عملکرد ۶۵ درصدی مصرف انرژی و پشتیبانی رسمی از شتابدهندههای نسل جدید.
بهترین توزیع لینوکس برای راهاندازی این محیط چیست؟
توزیعهای اوبونتو ۲۴.۰۴ LTS، فدورا ۴۱ و آرچ لینوکس بهترین سازگاری را با کرنل ۶.۱۴ دارند.
گالری تصاویر تکمیلی: انقلاب کرنل لینوکس ۶.۱۴: پرواز هوش مصنوعی محلی بدون اینترنت