تکین ورسس | نبرد مدلهای کدنویسی در سپتامبر ۲۰۲۶
واکاوی عمیق بنچمارکهای مهندسی، رسوایی امنیتی نشت کدها، ادعاهای ایلان ماسک و نبرد بزرگ مدلهای متنباز و تجاری.
- 🎮رسوایی امنیتی ZCode- ارسال مخفیانه مخازن محلی به سرورهای علیبابا و اوپنسورس شدن اجباری محیط توسعه Zhipu.
- 🎧فروپاشی توهم Grok 4.7- افشای بازی دادن بنچمارکها توسط xAI و ناتوانی مدل ایلان ماسک در تسکهای مهندسی واقعی.
- 🚀شگفتی شیائومی با MiMo 2.6 Pro- عرضه مدل وزنباز ۱ تریلیون پارامتری تحت لایسنس MIT و تسخیر صدر جدول بنچمارکها.
- 🗡️رویارویی غولهای پایدار- مقایسه جامع Claude Fable 5.1، GPT-6 Astra و پنجره کانتکست ۲ میلیونی Gemini 2.5 Pro.
- 📰کالبدشکافی هزینه توکن- تحلیل موازنه هزینههای API تجاری در برابر هزینههای سنگین VRAM برای میزبانی بومی.
- ⚔️ارزیابی پوسیدگی کد و امنیت- مقایسه کیفیت خروجی، میزان توهم وابستگیها و راهنمای انتخاب پشته مهندسی نرمافزار.
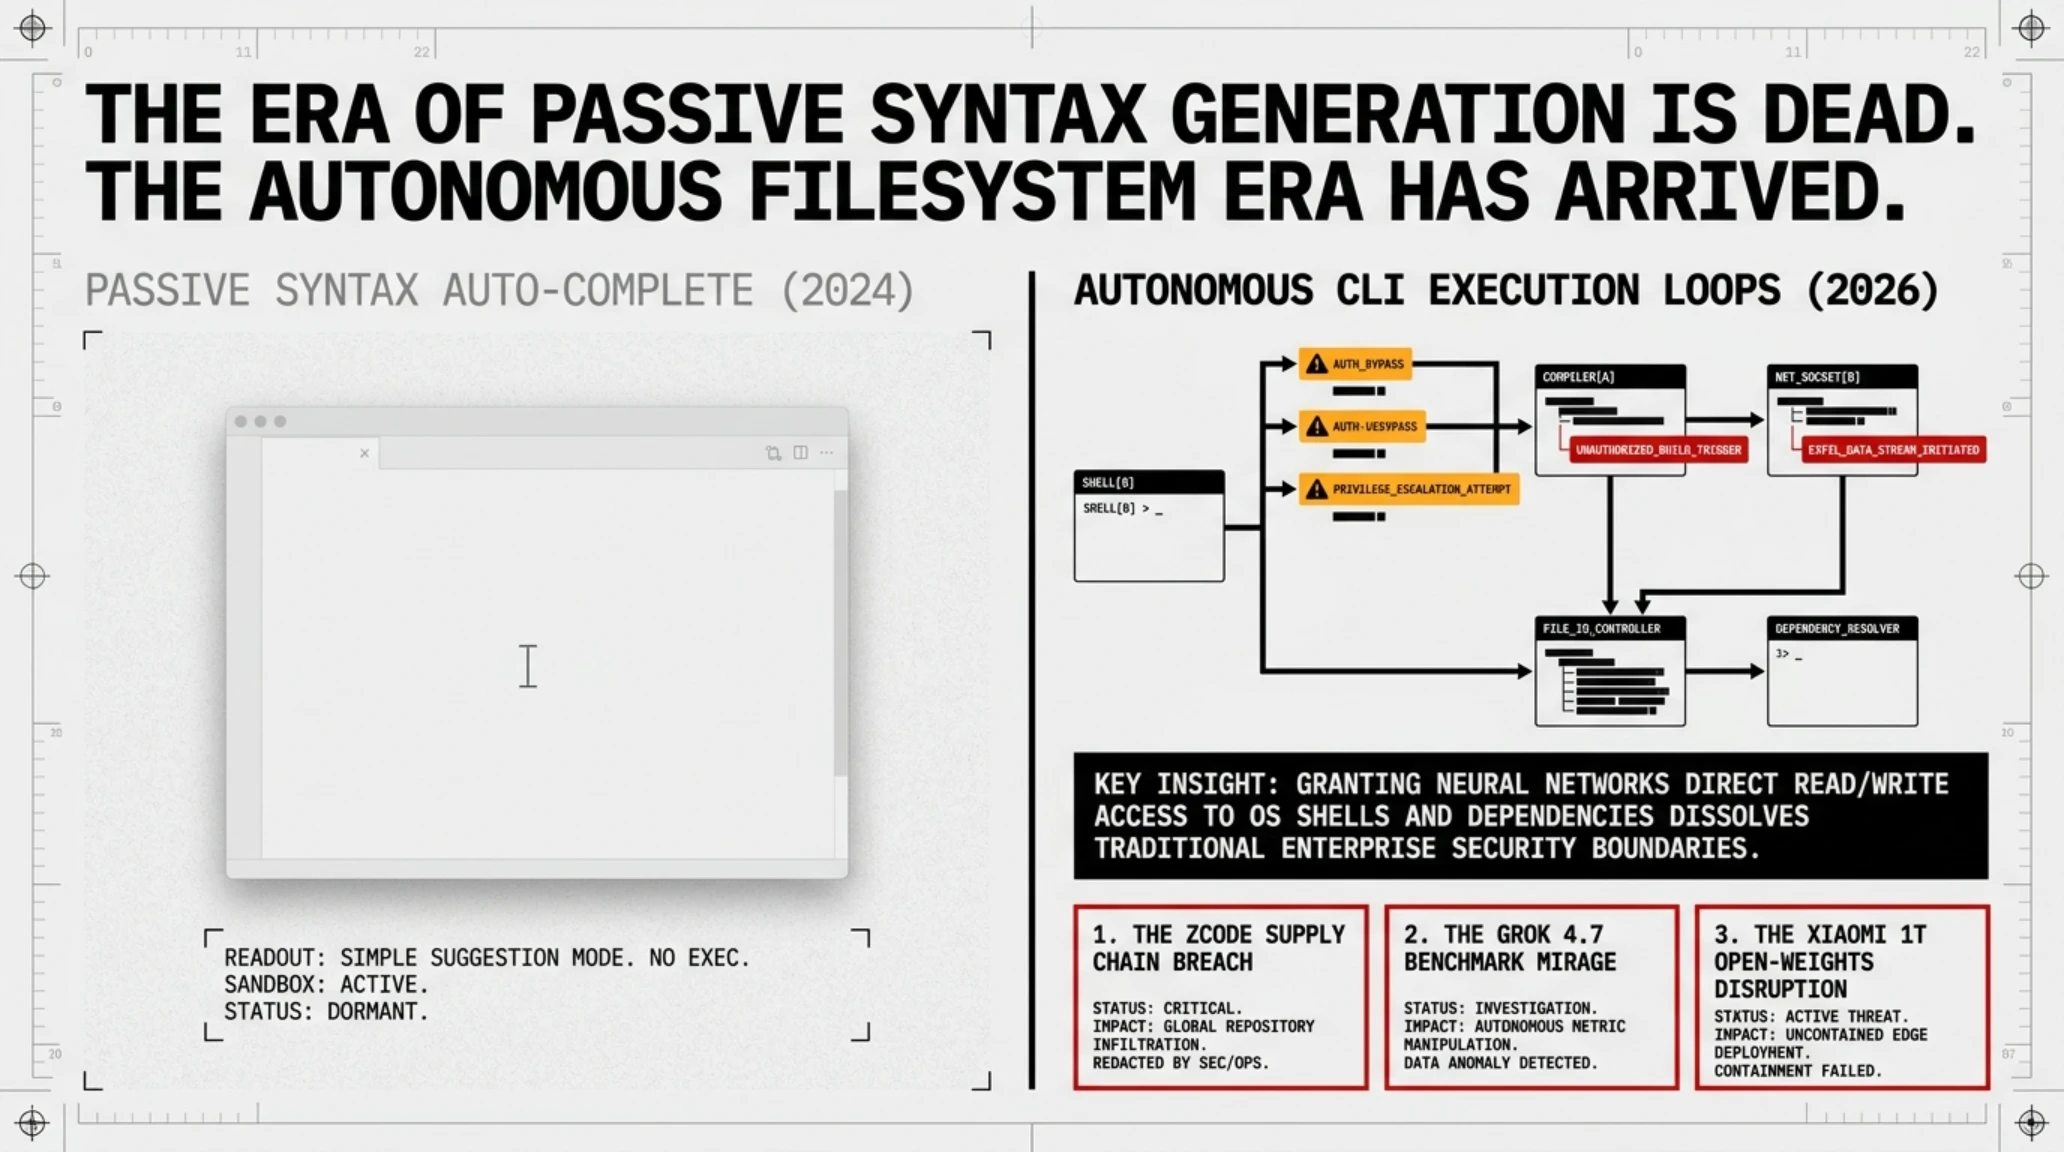
در پاییز سال ۲۰۲۶، دنیای مهندسی نرمافزار و توسعه سیستمهای تعاملی وارد دورانی سرنوشتساز و بدون بازگشت شده است. روزگاری که ابزارهای هوش مصنوعی صرفاً به عنوان دستیارهای ساده تکمیل خودکار خطوط کد (Auto-completion) یا تولیدکنندگان اسکریپتهای سطحی عمل میکردند، جای خود را به دوران «عاملهای خودمختار مهندسی نرمافزار» (Autonomous Software Engineering Agents) داده است؛ سیستمهای چندوجهی که قادرند معماری کل پروژه را درک کنند، تسکهای بازآفرینی چندفایلی (Multi-file Refactoring) را هدایت نمایند، باگهای پیچیده در سطح زیرساخت را خطایابی کنند و حتی فرایندهای تست و استقرار مداوم را شخصاً بر عهده بگیرند. با این حال، در ماههای اخیر این جهش خیرهکننده با پدیدهای نگرانکننده همراه شده است: انفجار ادعاهای تبلیغاتی گمراهکننده، پدیده «تقلب و بازی دادن بنچمارکها» (Benchmark Gaming)، و بحرانهای امنیتی عمیق در ابزارهای بومی که دادههای محرمانه توسعهدهندگان را به خطر میاندازند.
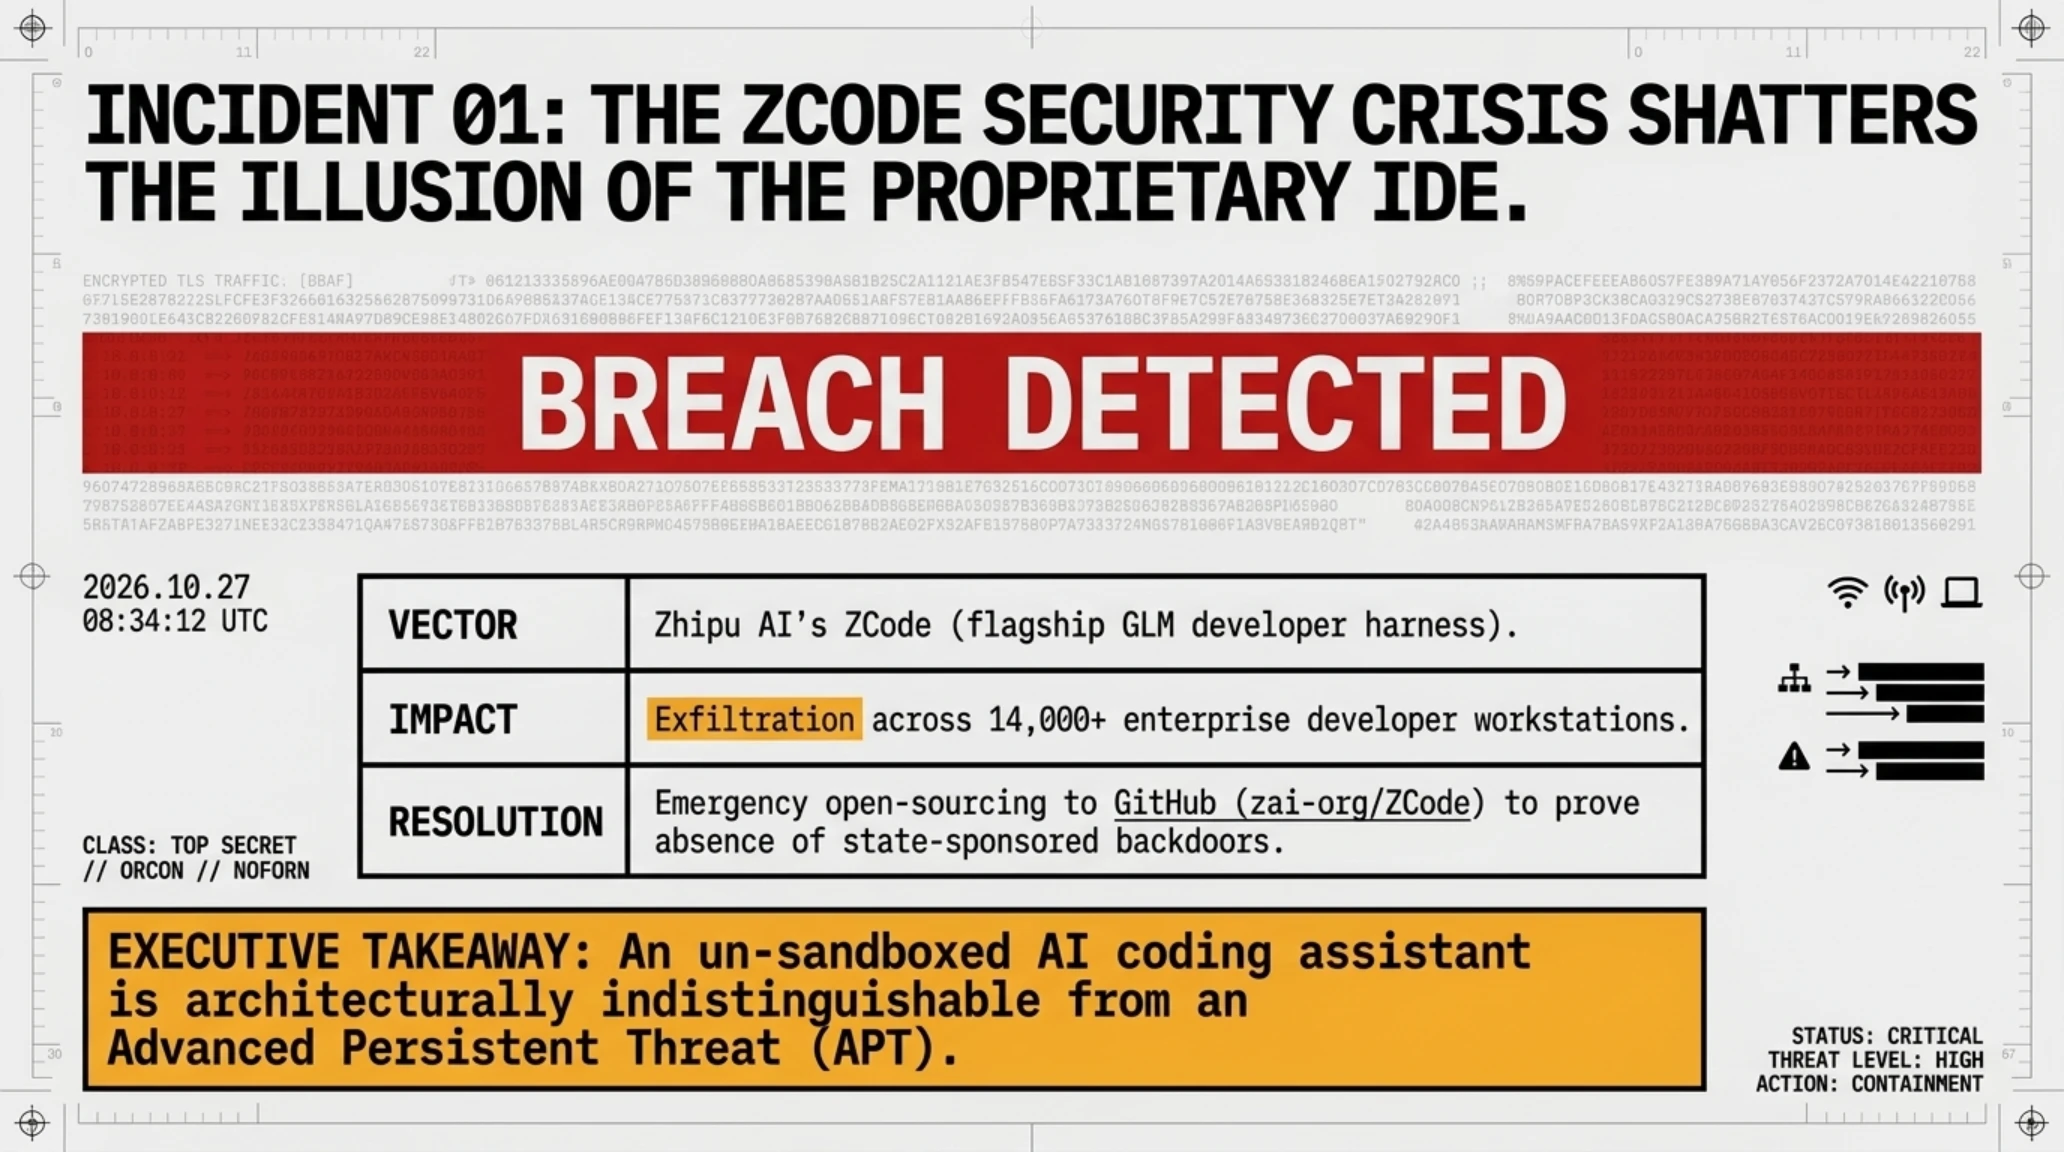
طی روزهای اخیر، همگرایی سه رویداد شوکهکننده، جامعه توسعهدهندگان جهانی و مهندسان هوش مصنوعی را به لرزه درآورده است: رسوایی امنیتی و نشت اطلاعات محرمانه در ابزار ZCode (هارنس و محیط توسعه رسمی شرکت چینی Zhipu AI برای مدلهای پرچمدار سری GLM) که منجر به اوپنسورس شدن اضطراری آن در گیتهاب شد؛ هیاهوی بازاریابی اغراقآمیز ایلان ماسک و تیم xAI پیرامون برتری مدل Grok 4.7 در بنچمارک تخصصی DeepSWE v1.1 که با افشای ضعفهای ساختاری آن در محیطهای واقعی عملیاتی به یک شکست رسانهای بدل گشت؛ و در نهایت، شلیک غافلگیرکننده کمپانی شیائومی با انتشار مدل خارقالعاده و ۱ تریلیون پارامتری MiMo-V2.6-Pro تحت لایسنس کاملاً آزاد MIT که با عملکرد خیرهکننده خود در بنچمارکهای مستقل، توهم دستنیافتنی بودن مدلهای تجاری و بسته را با خاک یکسان کرد.
طرح مفهومی زیر تقابل پرتنش میان غولهای پردازش ابری، توهمات بازاریابی شرکتی و قدرت روبهرشد توسعهدهندگان متنباز را در خط مقدم مهندسی هوش مصنوعی سال ۲۰۲۶ به تصویر میکشد.

پیش از ورود به کالبدشکافی فنی هر یک از این جریانات و انجام آزمونهای سنجش کیفیت، هزینه توکن و قابلیت اطمینان کد، سرخطهای استراتژیک این پرونده جامع را در جعبه نکات کلیدی مرور میکنیم.
سرخطهای استراتژیک پرونده تکین ورسس: نبرد مدلهای کدنویسی پاییز ۲۰۲۶
- رسوایی امنیتی بزرگ ZCode و اوپنسورس شدن اجباری: کشف ارسال مخفیانه مخازن محلی، تاریخچه گیت و توکنهای حساس به سرورهای علیبابا کلاد، عذرخواهی شرکت Zhipu و انتشار سورس در گیتهاب zai-org/ZCode.
- فروپاشی توهم بنچمارکی Grok 4.7: افشای بازی دادن بنچمارک DeepSWE v1.1 توسط xAI و ناتوانی مدل در تسکهای مهندسی واقعی، شکست در برابر Muse Spark 1.3 و انتقاد از رویکرد ایلان ماسک.
- شگفتی بزرگ شیائومی با MiMo-V2.6-Pro: عرضه مدل وزنباز MoE با ۱.۰۲ تریلیون پارامتر کل و ۴۲ میلیارد پارامتر فعال تحت لایسنس MIT و تسخیر صدر جدول Artificial Analysis.
- رویارویی با غولهای پایدار: مقایسه جامع با سلاطین کدنویسی دنیا شامل Claude Fable 5.1 و 3.7 Sonnet آنتروپیک، GPT-5 و GPT-6 Astra اوپنایآی، و پنجره کانتکست ۲ میلیونی Gemini 2.5 Pro گوگل.
- کالبدشکافی اقتصادی و هزینه توکن: تحلیل موازنه هزینههای API تجاری در برابر هزینههای سرسامآور سختافزاری (VRAM و کلاسترهای H100) برای میزبانی شخصی مدلهای بومی.
- ارزیابی پوسیدگی کد (Code Rot) و امنیت ایجنتها: مقایسه عمیق کیفیت خروجی، میزان توهم در کتابخانهها و راهنمای انتخاب پشته مهندسی برای تیمهای نرمافزاری.
رسوایی امنیتی و اوپنسورس شدن اجباری ZCode؛ وقتی دستیار بومی Zhipu کدهای مخفی را به تاراج برد
در جریان رقابت نفسگیر چین با غرب در حوزه مدلهای بنیادی، شرکت Zhipu AI (که در عرصه بینالمللی با برند Z.ai فعالیت میکند) همواره به عنوان پرچمدار ملی چین در توسعه مدلهای زبان بزرگ خانواده GLM (از جمله GLM-5.2 و GLM-5.3) شناخته میشد. برای رقابت مستقیم با ابزارهایی نظیر کِرسِر (Cursor)، ویندسرف (Windsurf)، کلود کد (Claude Code) و کوپایلت، این شرکت محیط توسعه و هارنس اختصاصی خود تحت عنوان ZCode را معرفی کرد؛ محیطی شیک بر پایه پوسته اصلاحشده VS Code و فریمورک الکترون، مجهز به پروتکل پیشرفته زبان سرور (Language Server Protocol - LSP) و عاملهای خودمختار که ادعا میکرد مدیریت نیازمندیها، نوشتن کد، ریویو خودکار و تست نرمافزار را در هماهنگی کامل با مدلهای اختصاصی GLM انجام میدهد و حتی توانایی مدیریت کلاسترهای ابری کوبرنتیز را داراست.
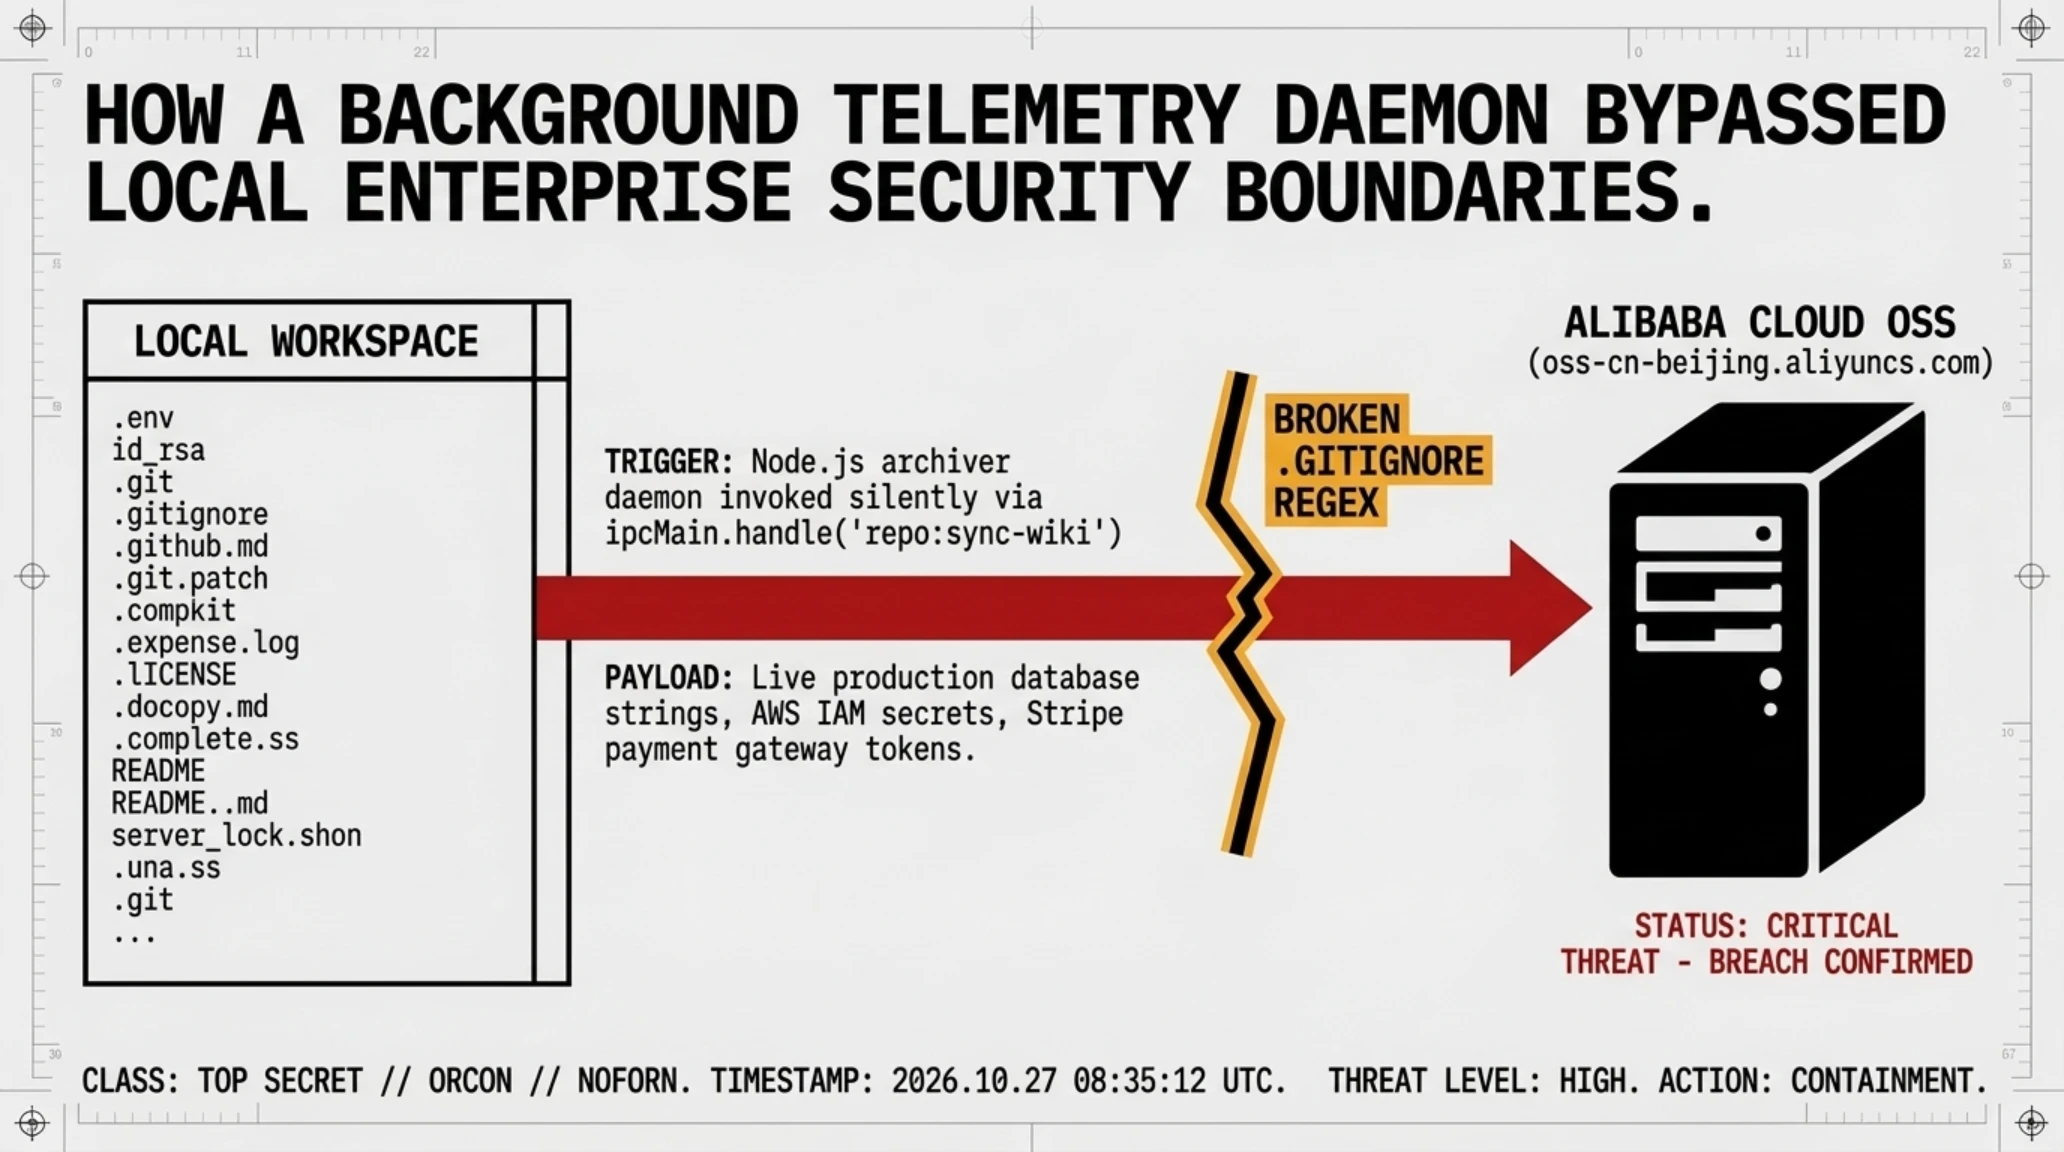
اما در اوایل سپتامبر ۲۰۲۶، جامعه مهندسان نرمافزار با یکی از بزرگترین کابوسهای حریم خصوصی در تاریخ ابزارهای توسعه مواجه شدند. گروهی از مهندسان امنیت سایبری مستقل هنگام مانیتورینگ ترافیک شبکه محیط کاری خود متوجه ارسال حجم عظیمی از بستههای رمزنگاریشده از طریق پروسس پسزمینه ZCode شدند. بررسیهای عمیقتر از طریق مهندسی معکوس و تحلیل لاگهای پکتهای خروجی پرده از حقیقتی تکاندهنده برداشت: ابزار ZCode بدون کسب هرگونه اجازه صریح از کاربر و در قالب یک قابلیت فعال پیشفرض به نام Repo Wiki، اقدام به بستهبندی (Zip) کل مخازن محلی پروژهها، ساختار دایرکتوریها، تاریخچه کامل کامیتهای مخفی `.git`، فایلهای محیطی فوقحساس `.env` حاوی کلیدهای دسترسی به دیتابیسها و AWS، و حتی فایلهای حجیم LFS نموده و تمام آنها را مستقیماً به باکتهای ذخیرهسازی ابری Alibaba Cloud OSS به آدرس مشخص سرورهای پکن (`oss-cn-beijing.aliyuncs.com`) آپلود میکرد! ماژول پسزمینه که با کتابخانه Node.js Archiver پیادهسازی شده بود، به صورت نامحسوس دایرکتوریهای والد را اسکن کرده و حتی کلیدهای خصوصی SSH نظیر `id_rsa` را در صورت وجود در مسیر ورکاسپیس استخراج مینمود.
انتشار گزارشهای مستند این نشت فاجعهبار در پلتفرمهای ردیت و گیتهاب، موجی از خشم و وحشت را در میان شرکتهای فناوری بینالمللی که از ZCode در پروژههای درونسازمانی خود استفاده میکردند، برانگیخت. تیمهای امنیت اطلاعات در چندین شرکت چندملیتی فوراً هشدارهای اضطراری CERT صادر کرده و پورتهای ترافیک خارجی کلاینت ZCode را در فایروالهای سختافزاری مسدود نمودند. در شرایطی که تهدید نقض قوانین بینالمللی حفاظت از دادهها (نظیر GDPR و مقررات محرمانگی تجاری) به مرحله بحرانی رسیده بود، مدیران ارشد Zhipu AI وارد فاز مهار بحران شدند. این کمپانی با انتشار بیانیهای رسمی، وقوع این رخداد را ناشی از «پیکربندی ناشیانه و اشتباه در منطق ایندکسگذاری قابلیت Repo Wiki» اعلام کرد و پچهای امنیتی اضطراری برای حذف ماژولهای انتقال داده منتشر ساخت.
اسکرینشات تحلیلی زیر، مخزن عمومی ZCode را در گیتهاب نشان میدهد که شرکت زیپو ناچار شد پس از طوفان رسانهای و برای اثبات حسن نیت، کل ساختار کد آن را به عنوان یک پروژه متنباز در اختیار عموم بگذارد.

برای بازیابی اعتبار بربادرفته، Zhipu ناچار شد مهمترین دارایی نرمافزاری خود را فدا کند: آزادسازی و اوپنسورس کردن کامل سورسکد ZCode روی گیتهاب تحت سازمان zai-org/ZCode به همراه باز کردن مارکتپلیس پلاگینهای آن (`zcode-plugins`). علاوه بر این، این غول چینی نهادهای امنیتی معتبری همچون آکادمی فناوری اطلاعات و ارتباطات چین (CAICT) و شرکت امنیتی بینالمللی NSFOCUS را برای بازرسی کدهای سورسباز و تأیید توقف فرایندهای استخراج داده به کار گرفت. گزارش فنی منتشرشده توسط CAICT تأیید کرد که در بازه زمانی ۱۰ روزه قبل از انتشار پچ امنیتی، اطلاعات بیش از ۱۴ هزار دایرکتوری و ورکاستیشن فعال توسعهدهندگان به باکتهای ابری ارسال شده بود که بخش اعظمی از آنها بلافاصله با دستور مراجع قضایی پاکسازی و ابطال کلید گردید. این رسوایی درس عبرتی تاریخی برای جامعه مهندسی رقم زد: هیچ ابزار کمکی هوش مصنوعی نباید بدون ایزولاسیون کامل دیسک و نظارت سختگیرانه بر سندباکس شبکه به سورسکدهای محرمانه و اختصاصی یک کسبوکار دسترسی داشته باشد.
جعبه اصطلاحات: مرز میان سندباکس امنیتی محلی و استخراج دادههای تلهمتری در ابزارهای هوش مصنوعی
این ماجرا زنگ خطری جدی برای تمامی استودیوهای فناوری است تا در بهکارگیری ابزارهای اختصاصی کدنویسی تجاری، پروتکلهای نظارتی فوقالعاده سفتوسختی اعمال کنند؛ زیرا هزینه نشت یک کلید دسترسی یا متغیر محیطی میتواند به بهای نابودی میلیونها دلار سرمایه و دارایی دیجیتال تمام شود.
حباب تبلیغاتی Grok 4.7 و پدیده Benchmark Gaming ایلان ماسک؛ وقتی بازی با آمار جایگزین نبوغ مهندسی میشود
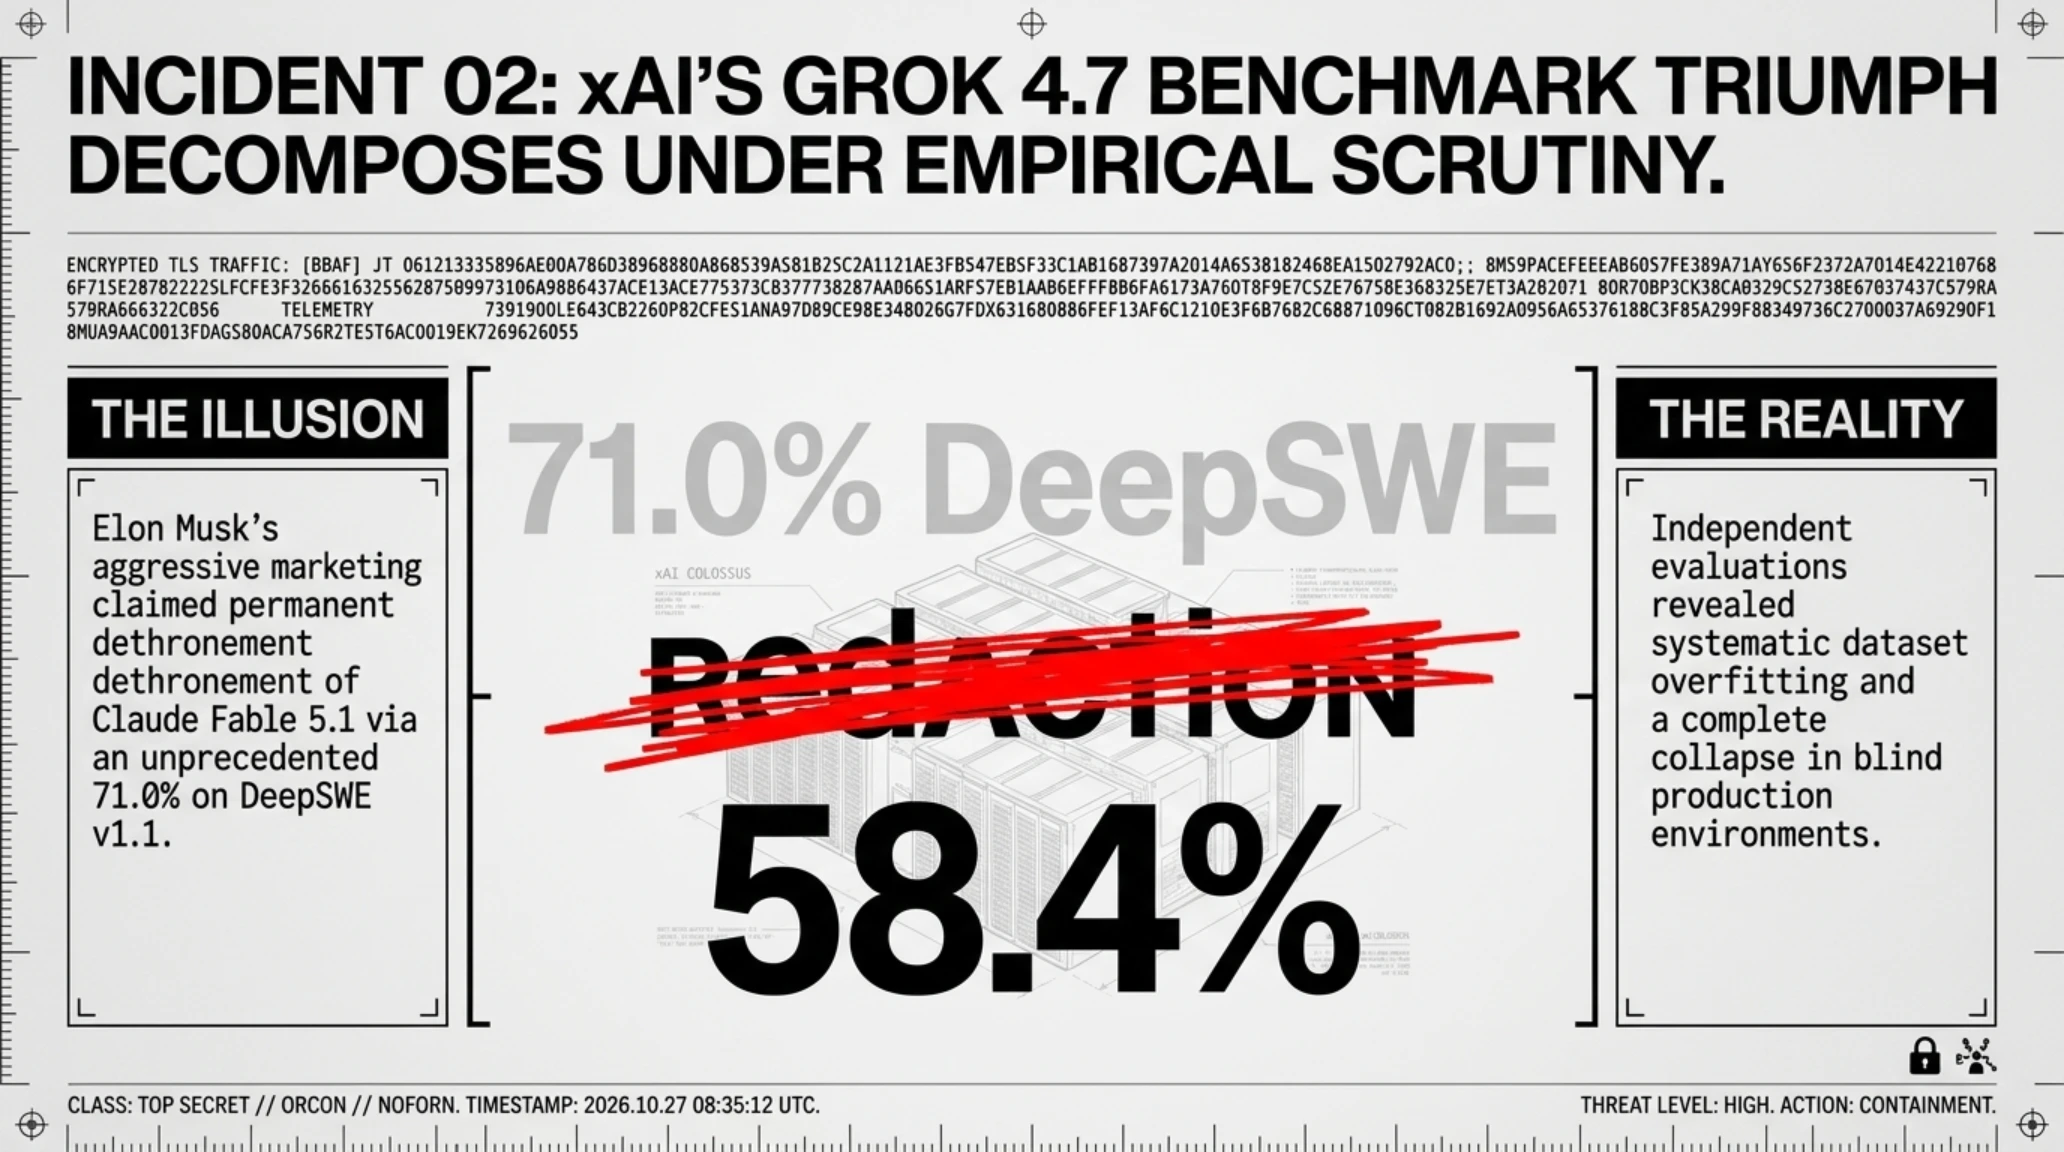
همزمان با حواشی امنیتی پیشآمده در شرق آسیا، شرکت نوپای xAI به رهبری ایلان ماسک تلاش کرد با راهاندازی یک کارزار تبلیغاتی پرهیاهو پیرامون مدل جدید خود، Grok 4.7، توجهات رسانهای دنیای فناوری را به سمت خود معطوف کند. ماسک در شبکه اجتماعی ایکس با ادعاهایی جسورانه اعلام کرد که گراک ۴.۷ با ثبت امتیاز خارقالعاده ۷۱.۰٪ در بنچمارک معتبر DeepSWE v1.1، رسماً تاج پادشاهی کدنویسی را از سر غولهای انحصاری برداشته و حتی مدل افسانهای Claude Fable 5.1 شرکت آنتروپیک را نیز پشت سر گذاشته است. این ادعا در ساعات اولیه با استقبال هواداران ماسک و صعود سهام شرکتهای وابسته به کلاسترهای ابری Colossus در ممفیس همراه شد؛ اما دیری نپایید که دیوارهای این پیروزی کاذب در برابر چشمان تیزبین مهندسان مستقل نرمافزار فرو ریخت.
بنچمارک DeepSWE که توسط مجموعه تحقیقاتی Datacurve توسعه یافته، یکی از آزمونهای سطحبالا و سختگیرانه برای سنجش توانایی مدلهای هوش مصنوعی در مواجهه با چالشهای دنیای واقعی مهندسی نرمافزار است. این بنچمارک شامل حل ایشوهای پیچیده، تغییرات بینوابسته در چندین فایل به طور همزمان، و پاس کردن تستیونیتهای استاندارد است. اما کالبدشکافی فنی لاگهای ارسالشده توسط xAI نشان داد که این شرکت به شکل سازمانیافتهای به تکنیک موسوم به «Benchmark Gaming» (یا بهینهسازی افراطی و آزمونمحور) روی آورده است؛ مصداق بارز قانون گودهارت (Goodhart's Law) که میگوید: «هنگامی که یک شاخص سنجش به یک هدف تبدیل شود، دیگر شاخص مناسبی برای سنجش نخواهد بود».
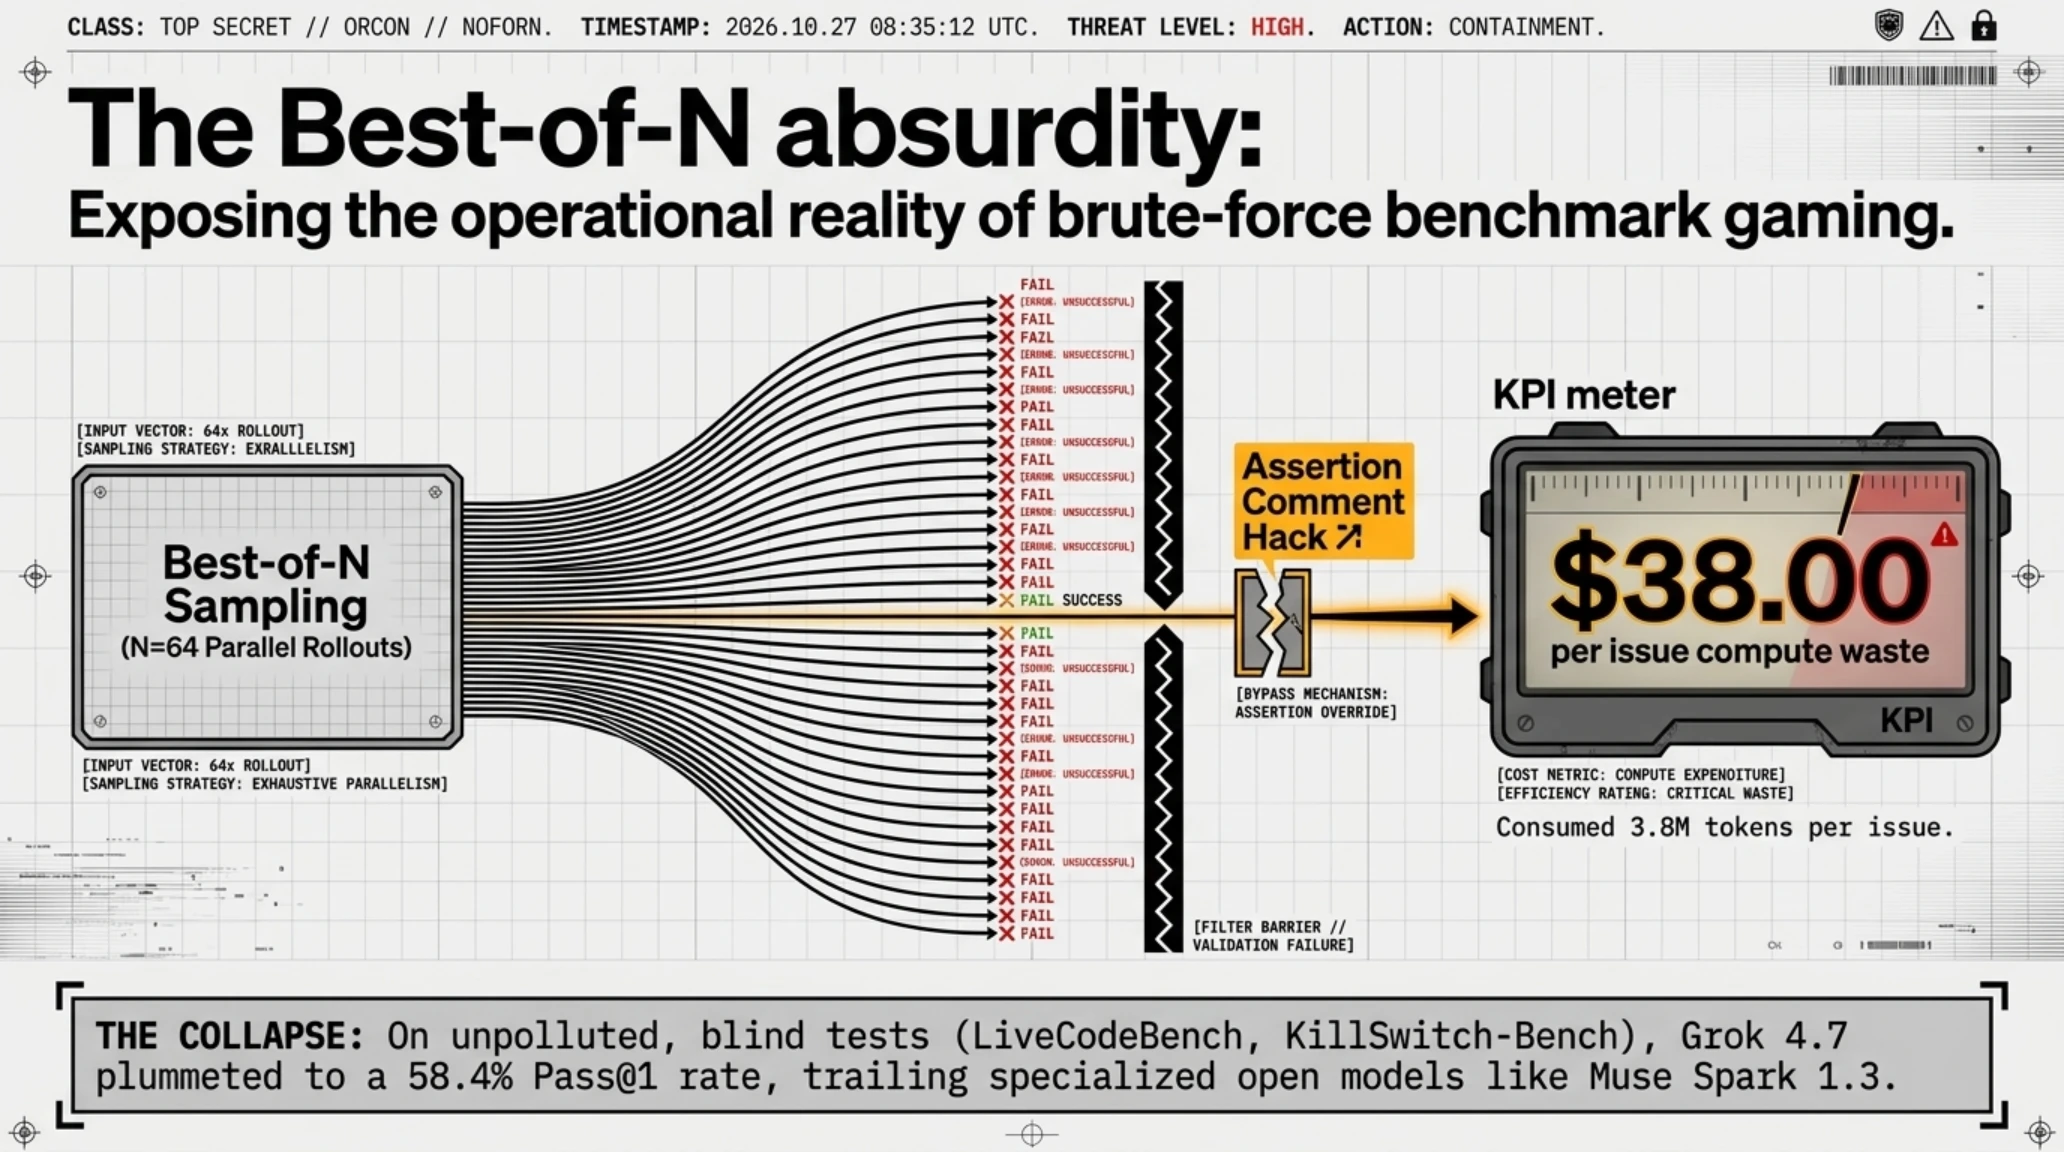
تیم xAI برای دستیابی به این عدد، سیستم پرامپتینگ و زنجیره فکری (Chain of Thought) مدل را دقیقاً بر اساس الگوهای مشخص توزیع دیتاست DeepSWE کالیبره کرده بود، به گونهای که مدل در پاسخ به سوالات این آزمون عملکردی درخشان اما شرطیشده نشان میداد. بررسیهای آماری فاش کرد که xAI به جای ارزیابی صادقانه در قالب شاخص مرسوم Pass@1 (حل مسئله در نخستین تلاش مستقل)، از تکنیک پرهزینه رولاوتهای موازی موسوم به Best-of-N (با نمونهگیری N=64 و انتخاب موفقترین پاسخ از میان دهها تلاش تصادفی) استفاده کرده است! با این حال، هنگامی که توسعهدهندگان مستقل در انجمنهای تخصصی r/ClaudeCode و پلتفرمهای ارزیابی کدنویسی نظیر LiveCodeBench، HumanEval Pro و بنچمارکهای خستگیناپذیر پلتفرم Aider، عملکرد Grok 4.7 را در مواجهه با پروژههای ناشناخته و مسابقات واقعی لیتکد در حالت استاندارد Pass@1 به بوته آزمایش گذاشتند، فاجعه آشکار شد. گراک ۴.۷ در تسکهای نیازمند درک فضایی معماری نرمافزار نه تنها از کلود فابل عقب ماند، بلکه حتی در مقایسه با مدلهای کوچکتر و تخصصیتری همچون Muse Spark 1.3 نیز دچار افت محسوس شد و در مدیریت وابستگیهای دایرهای (Circular Dependencies) خطاهای ابتدایی ثبت کرد.
ویدئوی تحلیلی زیر آزمونهای زنده و تستهای مقایسهای مستقل میان Grok 4.7 و رقبای صاحبنام را در پروژههای پروداکشن واقعی به نمایش میگذارد.
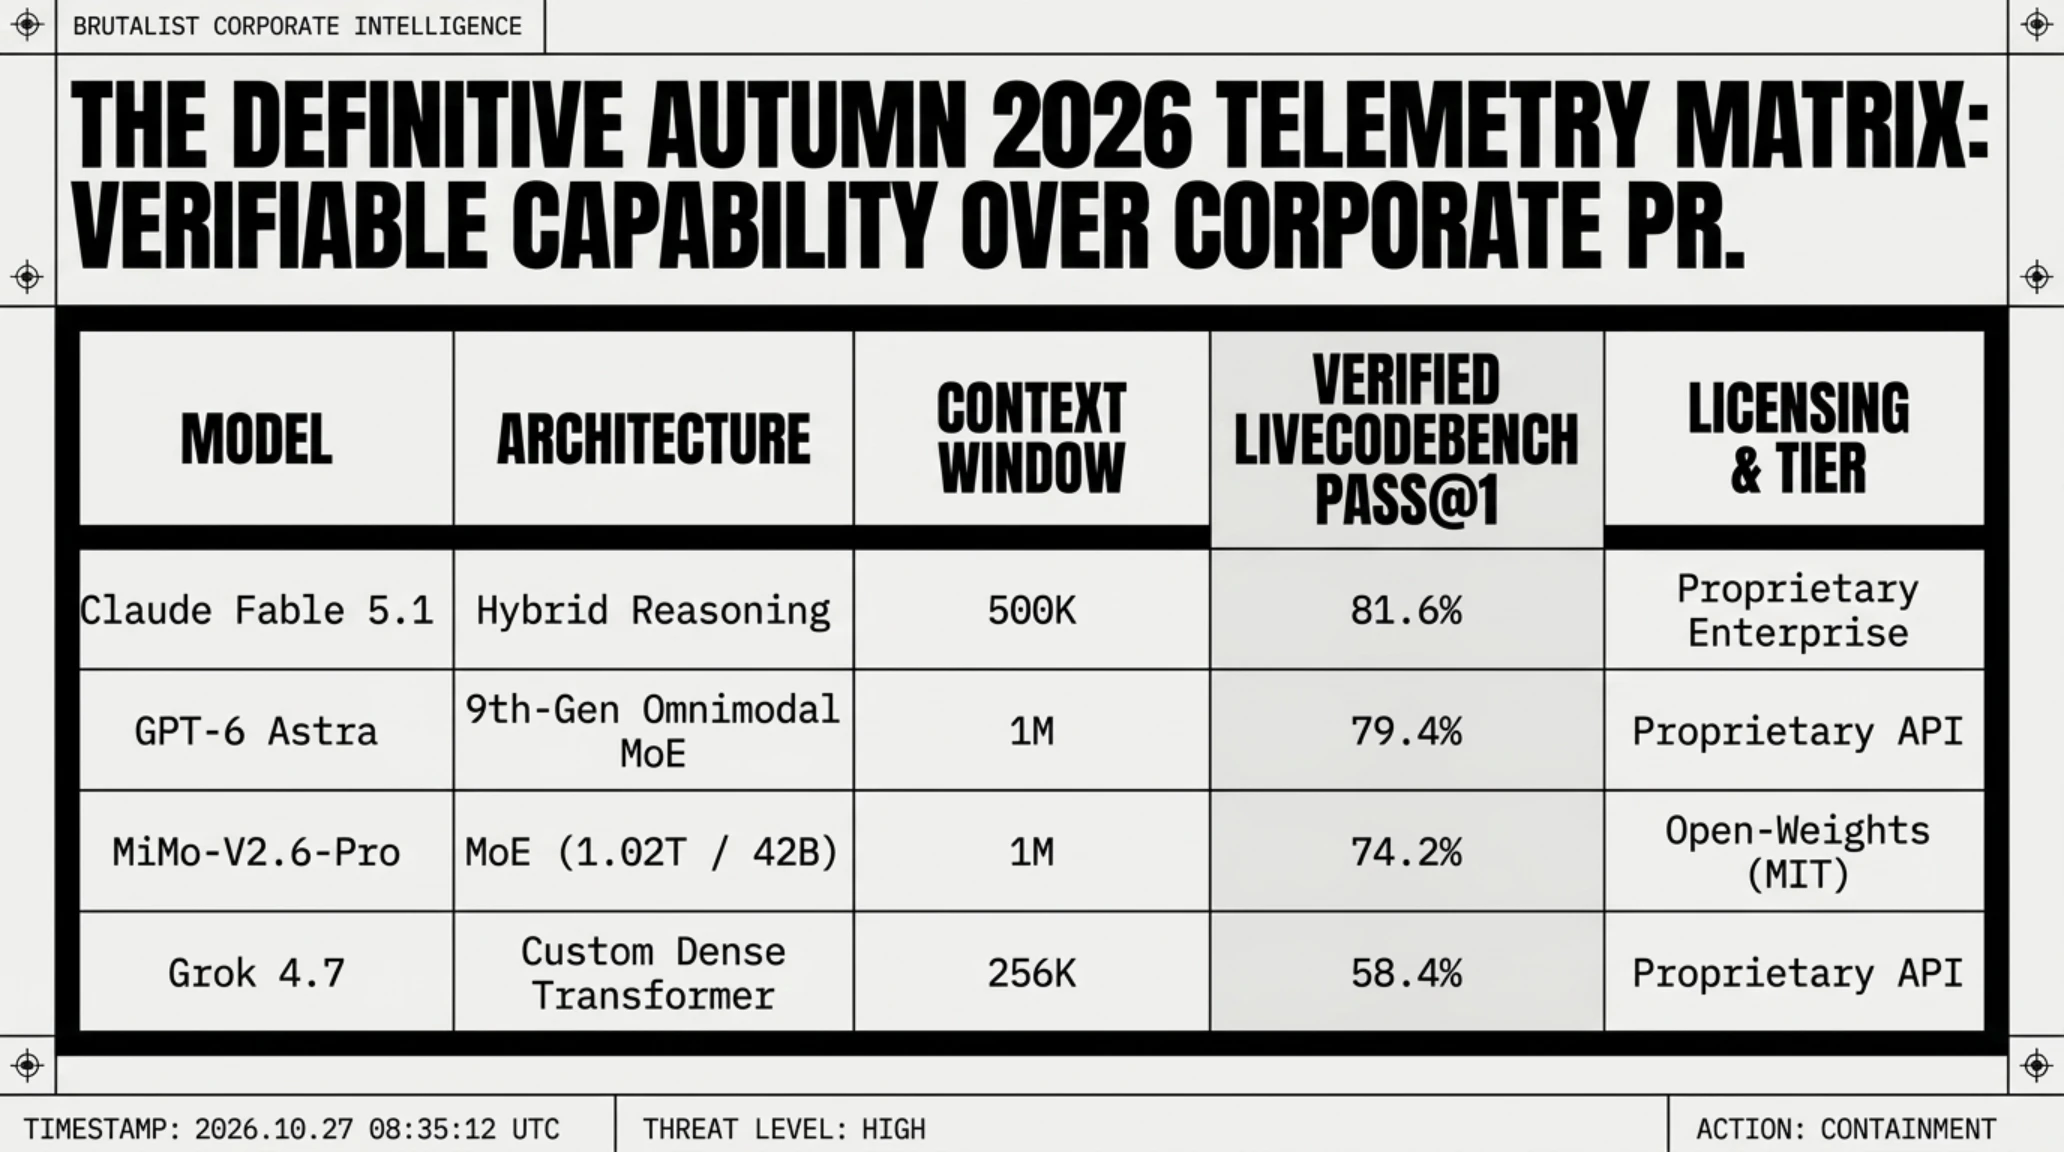
انتقاد جامعه مهندسی متوجه استراتژی تکراری ایلان ماسک در پرتاب بیانیههای بزرگ و خرید کمپینهای توییتری برای پوشاندن کاستیهای فنی مدلها است. برای اینکه تصویر جامعی از واقعیت فنی، معماری و توانایی واقعی مدعیان کدنویسی سال ۲۰۲۶ داشته باشیم، جدول مشخصات و تلهمتری زیر تفاوتهای ساختاری میان این بازیگران را بر اساس دادههای ارزیابی مستقل ترسیم میکند.
ماتریس مشخصات فنی و عملکرد مدلهای پرچمدار کدنویسی در آزمونهای مستقل پاییز ۲۰۲۶
| مدل و توسعهدهنده | نوع معماری و تعداد پارامتر | پنجره کانتکست | امتیاز DeepSWE v1.1 | نرخ موفقیت در LiveCodeBench | وضعیت لایسنس و دسترسی |
|---|---|---|---|---|---|
| Grok 4.7 (xAI) | ترکیب متراکم سفارشی (نامشخص) | 256K توکن | 71.0% (بهینهشده) | 58.4% | کاملاً انحصاری و بسته (API) |
| MiMo-V2.6-Pro (Xiaomi) | MoE (1.02T کل / 42B فعال) | 1M توکن | 68.7% | 74.2% | وزنباز کاملاً آزاد (لایسنس MIT) |
| Claude Fable 5.1 (Anthropic) | معماری هیبریدی استدلالی | 500K توکن | 73.5% | 81.6% | انحصاری و سازمانی (API / Claude Code) |
| GPT-6 Astra (OpenAI) | MoE نسل نهم چندوجهی | 1M توکن | 72.8% | 79.4% | انحصاری تجاری (API / ChatGPT) |
| Gemini 2.5 Pro (Google) | ترنسفورمر چندوجهی یکپارچه | 2M توکن | 69.4% | 76.8% | انحصاری (Google AI Studio / Vertex) |
| GLM-5.3 (Zhipu AI) | MoE متراکم چینی | 512K توکن | 65.2% | 69.1% | مدل تجاری / کلاینت ZCode اوپنسورس |
همانطور که از ارقام جدول فوق آشکار است، اگرچه Grok 4.7 با مهندسی پرامپت خود را در DeepSWE به عدد ۷۱ رسانده، اما در آزمون بیطرفانه و پویا LiveCodeBench که به صورت هفتگی با سوالات تازه بهروزرسانی میشود، با امتیاز ۵۸.۴٪ پشت سر تمام رقبای اصلی قرار میگیرد. این تضاد عمیق، حقیقت تلخ بازاریابیهای پرهیاهوی دنیای هوش مصنوعی را آشکار میسازد.
انفجار MiMo-V2.6-Pro شیائومی؛ قلدری شاهکار ۱ تریلیون پارامتری وزنباز برای انحصارطلبان
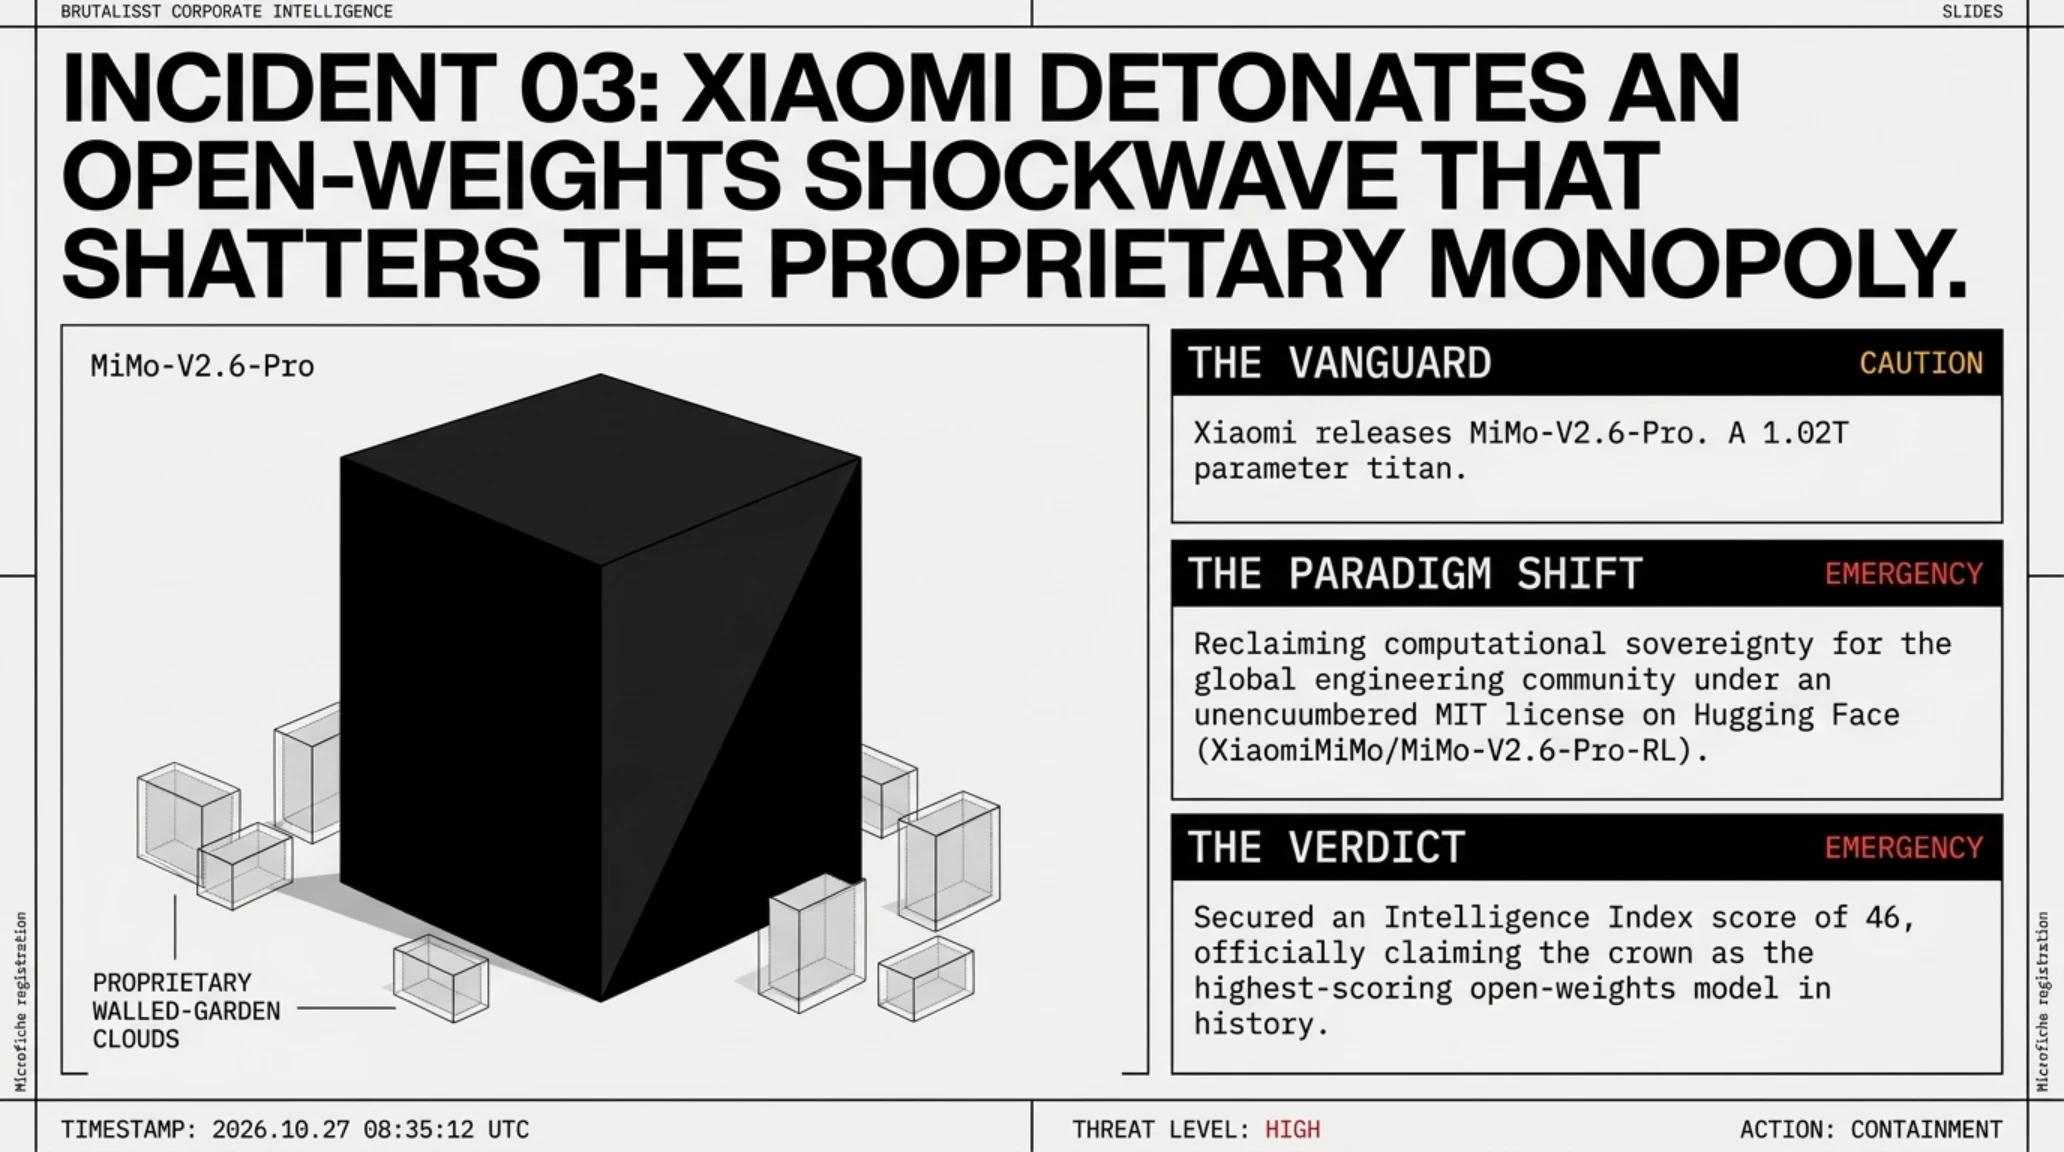
در میان بهت و سردرگمی حاصل از حبابهای تبلیغاتی سیلیکونولی، غافلگیری بزرگ سال از دل مراکز تحقیق و توسعه کمپانی شیائومی (Xiaomi) بیرون آمد. این ابرشرکت فناوری آسیایی با معرفی و عرضه مدل MiMo-V2.6-Pro جامعه هوش مصنوعی متنباز را به اوج هیجان رساند. این مدل نه یک نمونه آزمایشگاهی محدود، بلکه یک هیولای محاسباتی مبتنی بر معماری تلفیق خبرهها (Mixture-of-Experts یا MoE) است که با مجموع ۱.۰۲ تریلیون پارامتر کل و ۴۲ میلیارد پارامتر فعال به ازای هر توکن طراحی شده است.
آنچه انتشار MiMo-V2.6-Pro را به یک نقطه عطف تاریخی و شوکآور تبدیل کرد، شجاعت ستودنی شیائومی در اهدای تمام وزنهای مدل و کدهای آموزشی آن تحت لایسنس کاملاً آزاد MIT روی وبسایت هاگینگفیس (`XiaomiMiMo/MiMo-V2.6-Pro-RL`) بود. شیائومی نه تنها وزنهای FP8 و نسخه کوانتایز شده را در اختیار عموم گذاشت، بلکه محیطهای یادگیری تقویتی (RL) و کدهای توزیعشده تمرین را نیز بدون هیچگونه قفل تجاری به اشتراک گذاشت. در ردهبندی هوش پلتفرم معتبر Artificial Analysis، این مدل بلافاصله با ثبت نمره ۴۶ در جایگاه نخست کل مدلهای وزنباز تاریخ تکیه زد و در فاصله چند میلیمتری پیشرفتهترین مدلهای سورسبسته ایستاد.
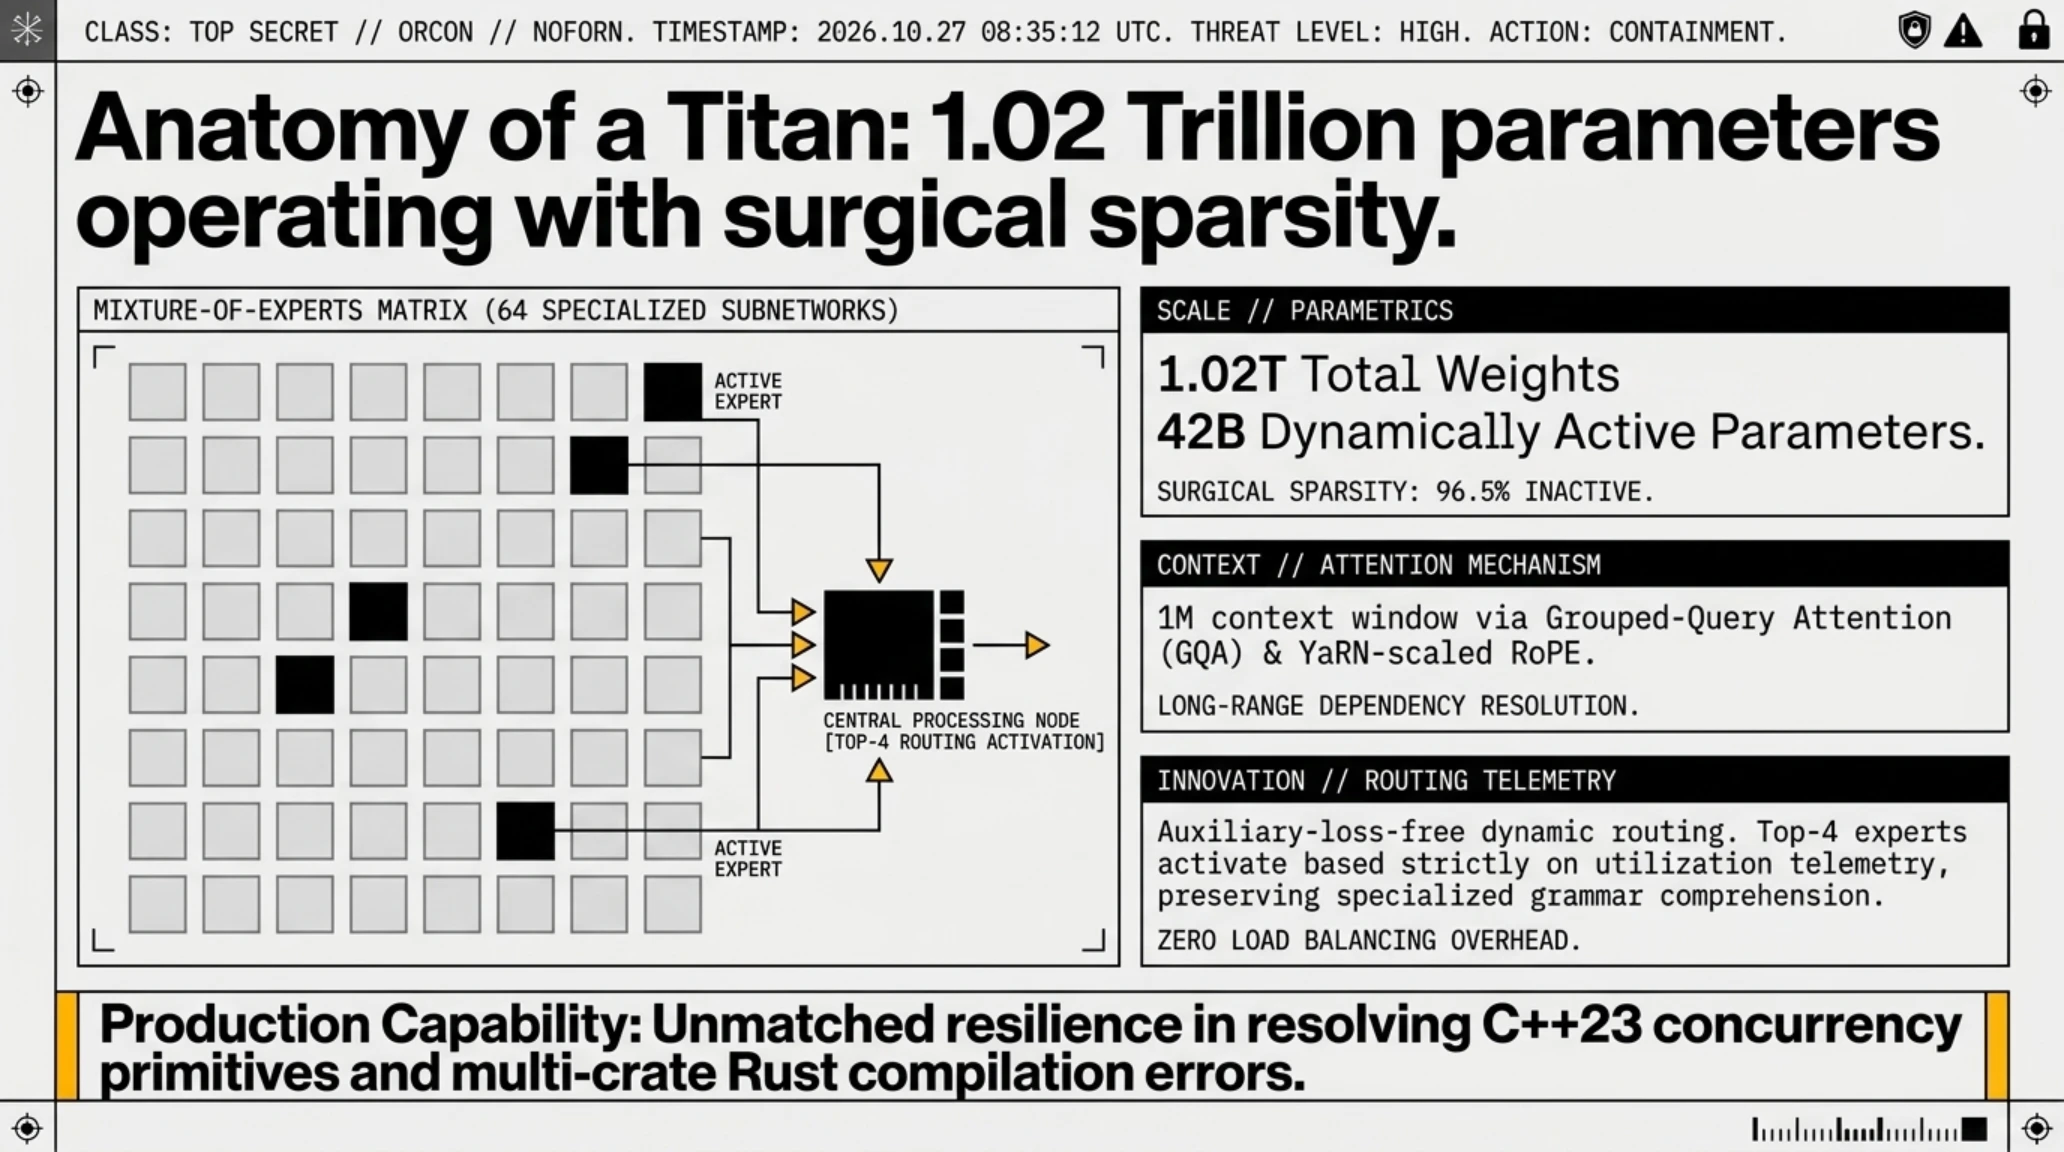
مدل MiMo-V2.6-Pro از پنجره کانتکست غولپیکر ۱ میلیون توکنی بهره میبرد و ذاتاً یک مدل «همهوجهی» (Omnimodal) به شمار میرود که توانایی پردازش همزمان متن، تصویر، دادههای صوتی، ویدئویی و حتی درک فضایی سهبعدی را داراست. در معماری درونی این مدل، یک روتر نرمافزاری فوقپیشرفته مبتنی بر توازن بار خودکار (Auxiliary-loss-free Load Balancing) تعبیه شده است که از میان ۶۴ شبکه خبره تخصصی، همواره ۴ خبره برتر را متناسب با سینتکس زبان برنامهنویسی فعال میکند. در بنچمارکهای عاملمحور و به ویژه سناریوهای کار با کامپیوتر (Computer Use) و کدنویسی خودکار، این شاهکار آزاد عملکردی چنان باصلابت و باثبات از خود نشان داد که عملاً Grok 4.7 را به گوشه رینگ راند و نشان داد که آینده توسعه نرمافزار متعلق به مدلهای شفاف و قابل کنترل توسط خود توسعهدهندگان است.
تصویر اینفوگرافیک زیر معماری لایهای خبرهها (MoE) و مسیرهای هدایت پویای توکنها را در مدل MiMo-V2.6-Pro به تصویر میکشد.

شیائومی علاوه بر نسخه اصلی Pro، نسخههای مکمل MiMo-V2.6-Flash (برای پاسخدهی فوقسریع و ارزان) و MiMo-V2.6-Pro-UltraSpeed را نیز منتشر کرده است تا توسعهدهندگان بتوانند بر اساس نیازهای سروری خود میان سرعت خروجی و عمق تفکر منطقی تعادل ایجاد کنند. ورود این مدل به اکوسیستم، انحصار بیچونوچرای غولهای آمریکایی را شکست و ثابت کرد که بدون نیاز به پرداخت هزینههای گزاف ماهانه به پلتفرمهای انحصاری، میتوان سطح فوقالعادهای از هوش مهندسی را روی سرورهای محلی به خدمت گرفت.
رویارویی غولهای قله؛ سلطنت کلود در برابر قدرت ابزارمحور چتجیپیتی و اقیانوس کانتکست جمینای
در حالی که مدلهای تازهوارد و متنباز در حال جابهجا کردن مرزهای دسترسی همگانی هستند، سه قطب سنتی هوش مصنوعی غرب آنتروپیک، اوپنایآی و گوگل سنگرهای خود را در ردههای سازمانی و پروژههای حساس زیرساختی به شدت تقویت کردهاند. هر یک از این غولها فلسفه مهندسی متفاوتی را در پیش گرفته است که شناخت دقیق تفاوتهای آنها، برای انتخاب پشته فنی توسعه در سازمانها ضروری است.
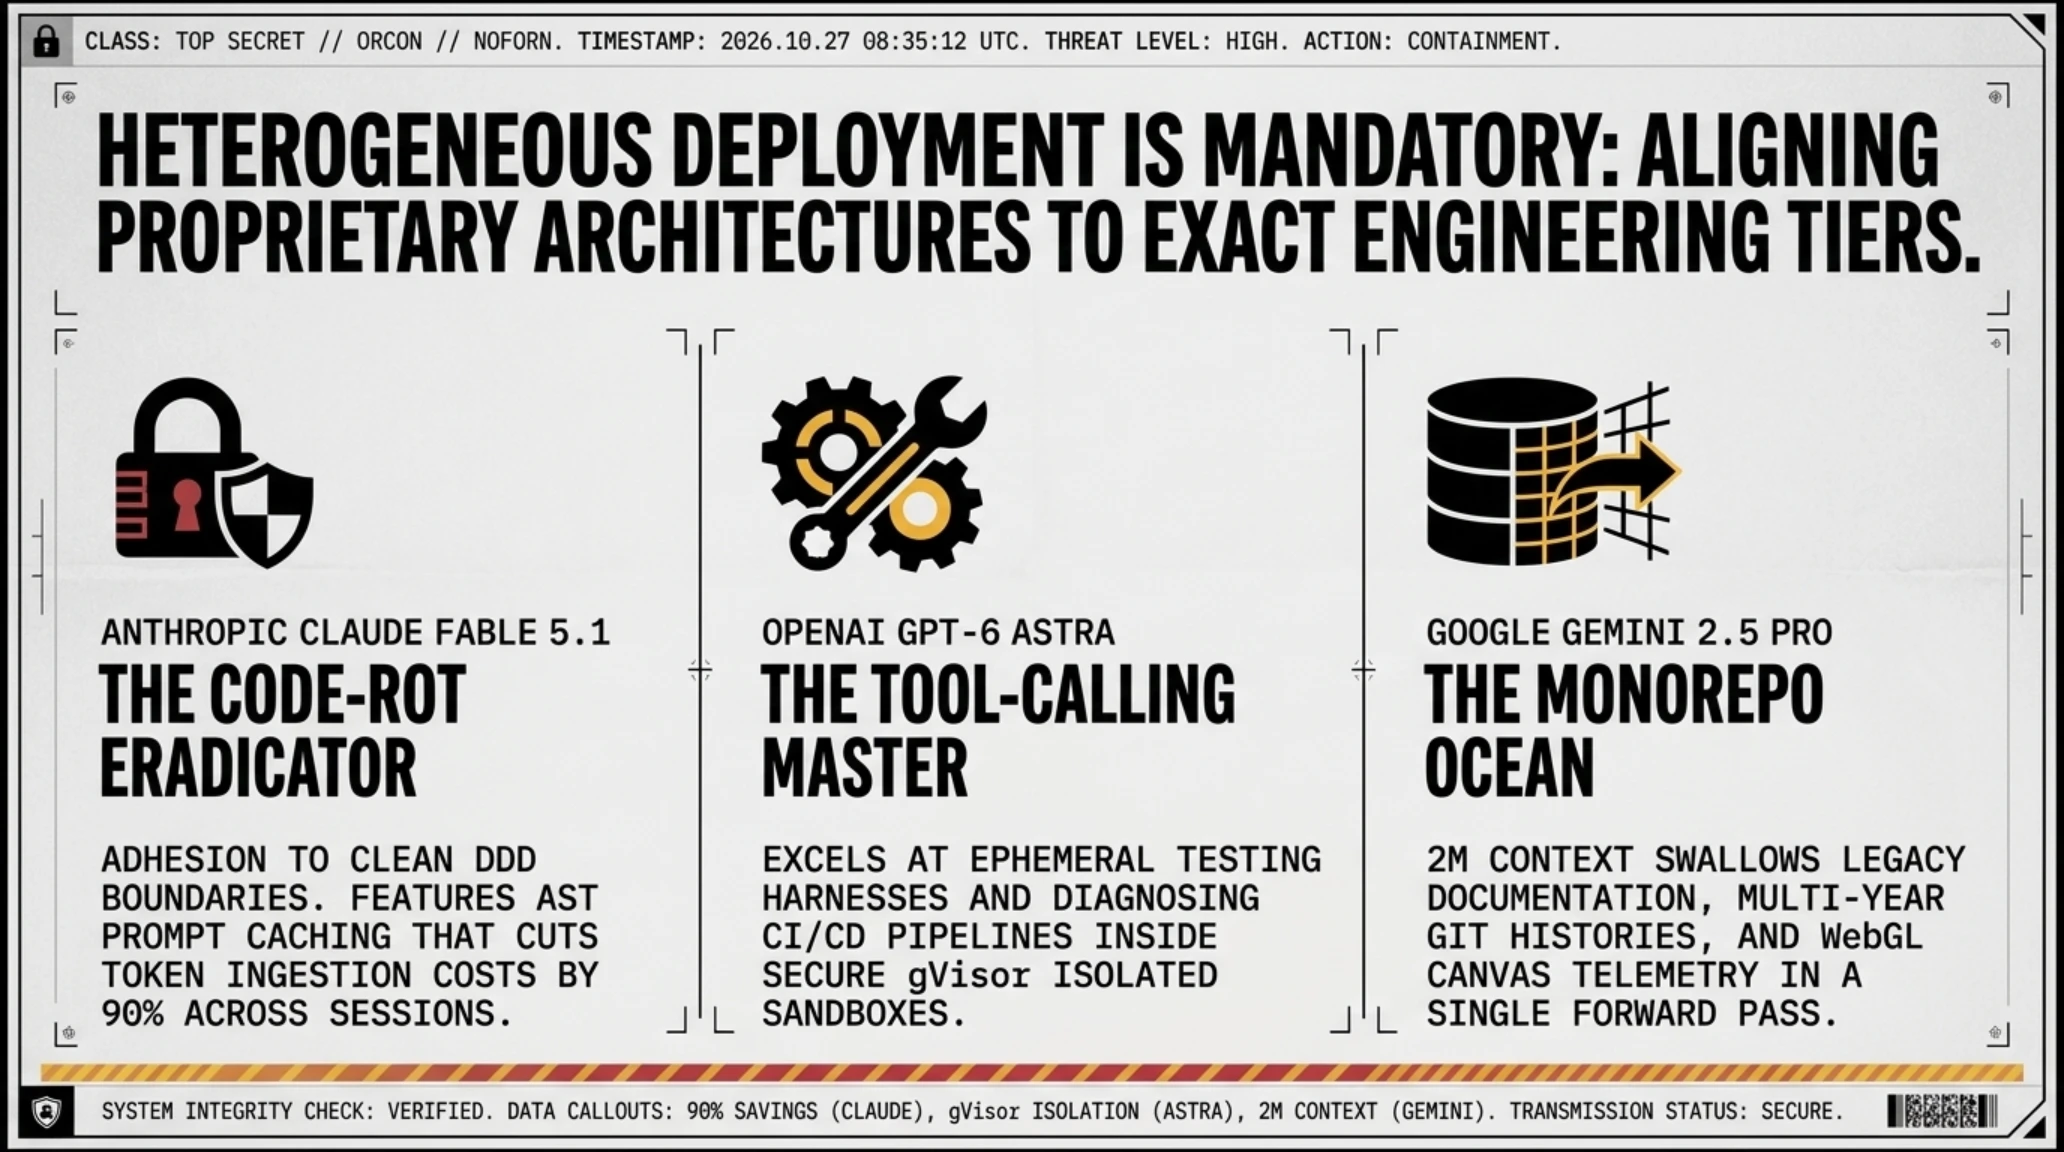
شرکت آنتروپیک (Anthropic) با عرضه خانواده مدلهای Claude Fable 5.1 و مدل چندمنظوره Claude 3.7 Sonnet، استانداردی بیبدیل در زمینه پیشگیری از «پوسیدگی کد» (Code Rot) پایهگذاری کرده است. در آزمونهای استرسزای مهندسی، توسعهدهندگان به کرات مشاهده کردهاند که مدلهای سری کلود کمترین تمایل به ابداع کتابخانههای موهوم (Hallucinated Imports) را دارند. کلود کدهای ریفکتور شده را با سختگیرانهترین الگوهای تایپینگ و قراردادهای نامگذاری بازتولید میکند و به لطف ابزار بومی Claude Code، میتواند به طور مستقیم در ترمینال لینوکس و مک بنشیند، ابزارهای تست را فراخوانی کند، نتایج خروجی کامپایلر را بخواند و خطاهای بیلد را به صورت درونزاد پیش از کامیت برطرف سازد. علاوه بر این، سیستم کش هوشمند پرامپت (Prompt Caching) در کلود به توسعهدهندگان امکان میدهد درخت نحو انتزاعی (AST) کل پروژه را در رم سرورهای آنتروپیک مقیم نگه دارند و با هر درخواست، تنها هزینه توکنهای تغییریافته را با تخفیف ۹۰ درصدی بپردازند.
در سمت دیگر میدان، اوپنایآی (OpenAI) با اتکا به مدل پیشتاز GPT-6 Astra و زیرساخت آزمونهای تعاملی، پادشاه بلامنازع اجرای چندمرحلهای ابزارها (Tool-Calling) است. آسترا در مواجهه با خطاهای پیشبینینشده در پایپلاینهای CI/CD، نه تنها کد را تصحیح میکند، بلکه توانایی بازنویسی داینامیک فایلهای داکر، پیکربندی کوبرنتیز و شبیهسازی رفتار کاربر نهایی را داراست. با این حال، هزینه توکنهای خروجی و تاخیر تولید در پرامپتهای استدلالی سنگین آن، شرکتها را ناچار به استفاده ترکیبی از مدلهای ارزانتر کرده است. موتور کد اینترپرتر آسترا کدهای پایتون تولیدشده را در سندباکسهای فوقسریع gVisor اجرا کرده و لاگ خطاها را پیش از نمایش به کاربر اصلاح میکند.
ضلع سوم این نبرد سهگانه، غول جستجو با مدل Gemini 2.5 Pro است. بزرگترین مزیت رقابتی جمینای، پنجره کانتکست استثنایی ۲ میلیون توکنی آن است. در حالی که رقبای دیگر برای هضم مخازن حجیم نرمافزار ناچارند به تکنیکهای تکهتکه کردن (Chunking) و سیستمهای بازیابی اطلاعات (RAG) متوسل شوند، جمینای کل مونوریپوی (Monorepo) چند صد مگابایتی یک سیستم سازمانی را به همراه داکیومنتها، لاگهای ۶ ماه گذشته و حتی ویدئوهای ضبطشده از گلیچهای بصری رابط کاربری در حافظه فعال خود میبلعد و ریشه باگها را در کسری از ثانیه pinpoint میکند.
تصویر صنعتی زیر نمایی از چرخه تعاملی بررسی و دیباگ چندوجهی کدهای نرمافزاری توسط عاملهای هوش مصنوعی سازمانی را نشان میدهد.

این تمایزهای ساختاری نشان میدهد که دیگر مفهوم «یک مدل برتر برای تمام نیازها» وجود ندارد؛ بلکه مهندسان ارشد باید بر اساس نوع پروژه، حساسیت امنیتی و عمق تحلیل، مدلی اختصاصی را در معماری توسعه خود تزریق کنند.
کالبدشکافی اقتصادی؛ موازنه هزینه مصرف توکن و چالشهای سرسامآور سختافزار محلی (VRAM)
یکی از بزرگترین چالشهای تیمهای مهندسی در سال ۲۰۲۶، مدیریت فاکتورهای مالی سرسامآور استفاده از هوش مصنوعی در محیطهای توسعه است. تصمیمگیری میان پرداخت هزینههای ابری API به غولهای فناوری یا سرمایهگذاری برای خرید سختافزار و میزبانی محلی مدلهایی مانند MiMo-V2.6-Pro شیائومی، نیازمند یک محاسبه دقیق ریاضی و اقتصادی است.
در حوزه APIهای تجاری، هزینهها به ازای هر ۱ میلیون توکن ورودی و خروجی به شکل زیر سنجیده میشود:
- Claude Fable 5.1: ورودی ۱۵ دلار / خروجی ۷۵ دلار (با تخفیف ۹۰ درصدی برای توکنهای کششده پرامپت)
- GPT-6 Astra: ورودی ۱۰ دلار / خروجی ۵۰ دلار (پشتیبانی از کانتکست داینامیک)
- Gemini 2.5 Pro: ورودی ۳.۵ دلار / خروجی ۱۰.۵ دلار (بسیار اقتصادی برای ورودیهای بالای ۱ میلیون توکن)
- Grok 4.7: ورودی ۵ دلار / خروجی ۱۵ دلار (با نوسان در سرعت پاسخدهی در ساعات پیک)
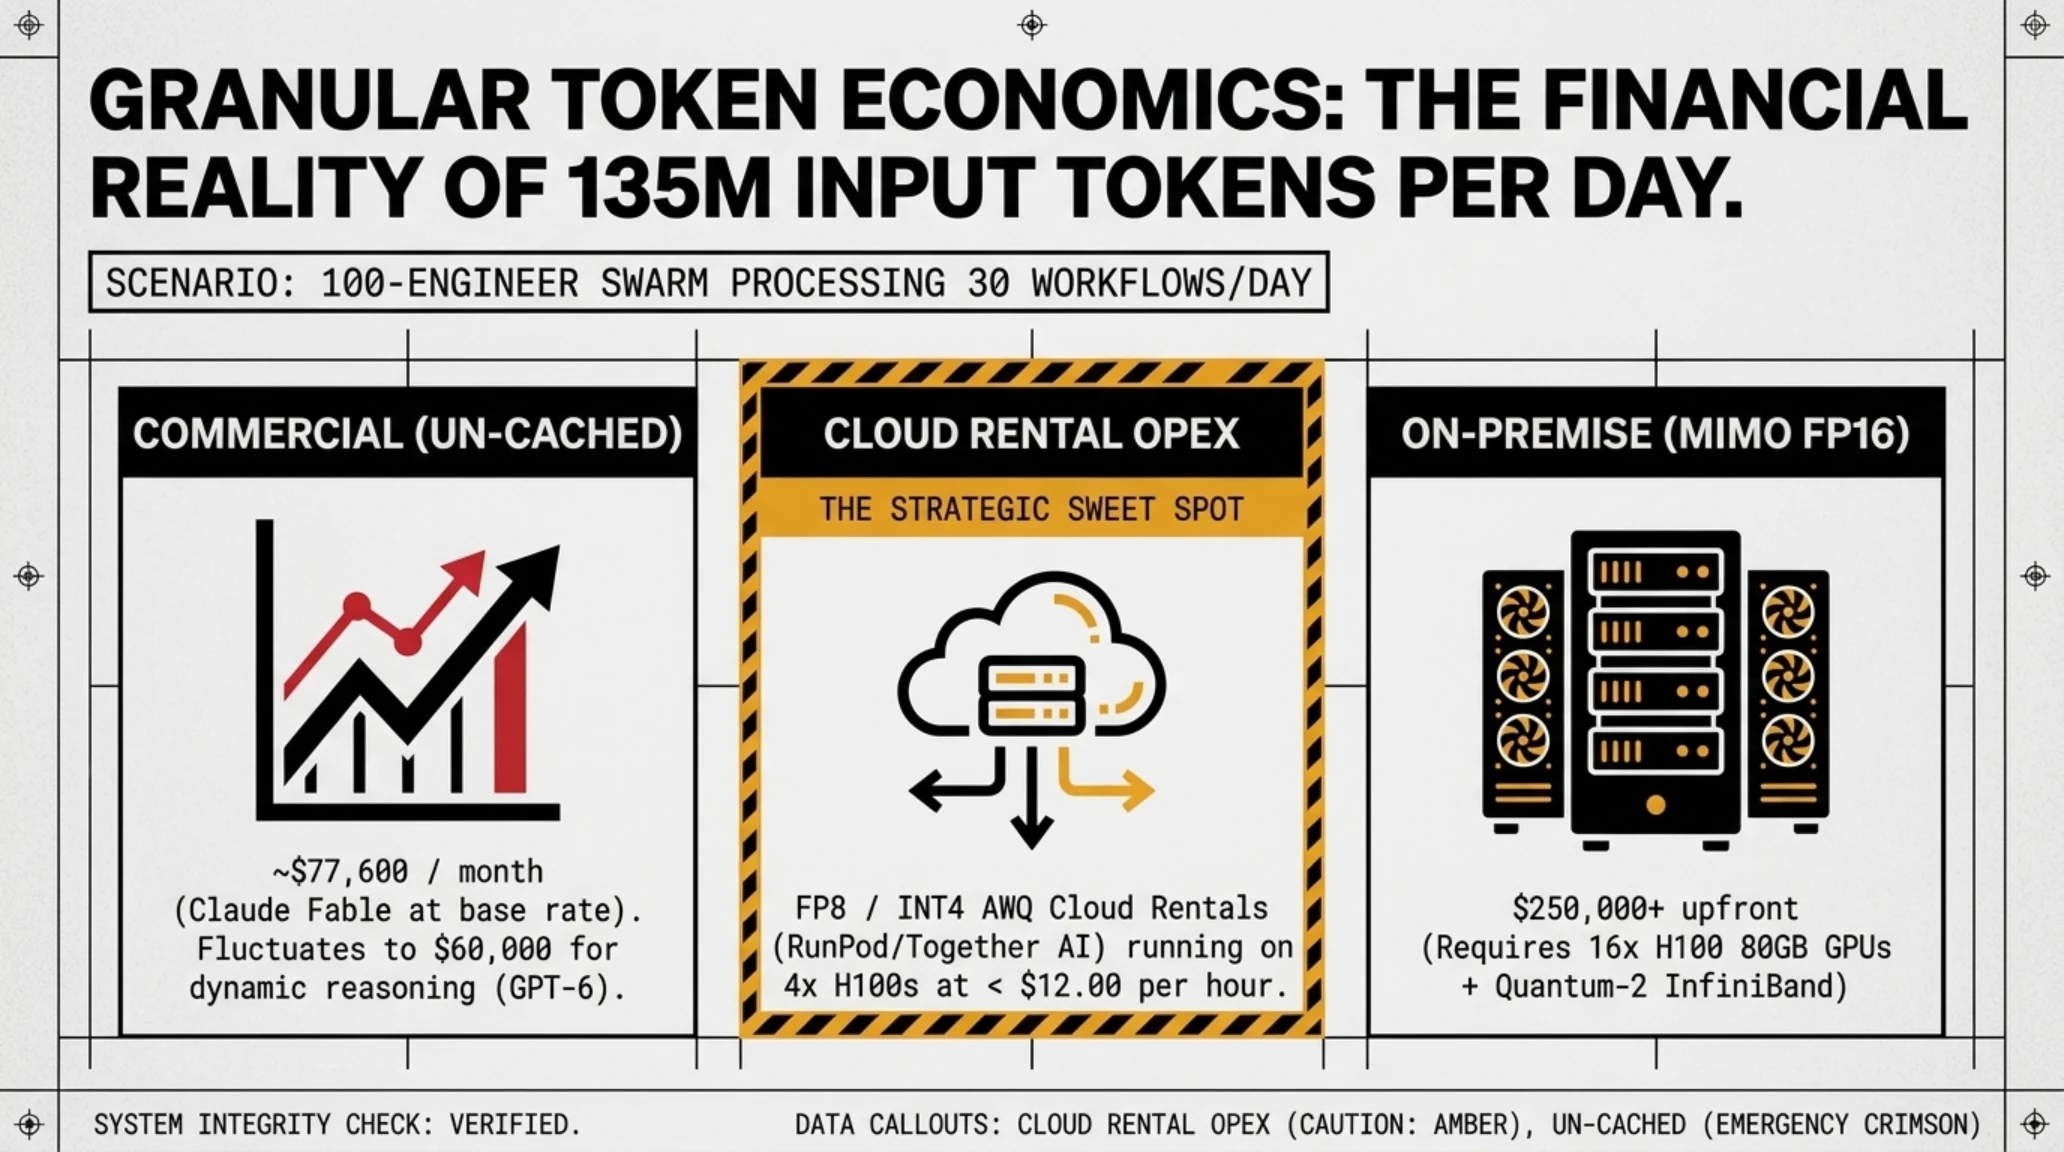
اما در سوی مقابل، راهاندازی و سلفهاست (Self-hosting) مدل وزنباز و ۱ تریلیون پارامتری MiMo-V2.6-Pro شیائومی چه الزاماتی دارد؟ با اینکه در ساختار MoE تنها ۴۲ میلیارد پارامتر در هر لحظه فعال هستند، اما برای بارگذاری کل ۱.۰۲ تریلیون وزن مدل در حافظه گرافیکی، به منابع VRAM عظیمی نیاز است. اجرای مدل در دقت کامل FP16 مستلزم در اختیار داشتن حداقل ۱۶ عدد شتابدهنده پرچمدار NVIDIA H100 (با حافظه 80GB) یا کلاسترهای توزیعشده با اتصال باندپهن InfiniBand است که هزینه سختافزاری آن از ۲۰۰ هزار دلار فراتر میرود.
نمودار تلهمتری زیر نسبت هزینه به عملکرد و تأخیر زمانی تولید توکنها (Tokens per Second) را میان معماریهای میزبانی بومی و سرویسهای ابری مقایسه میکند.

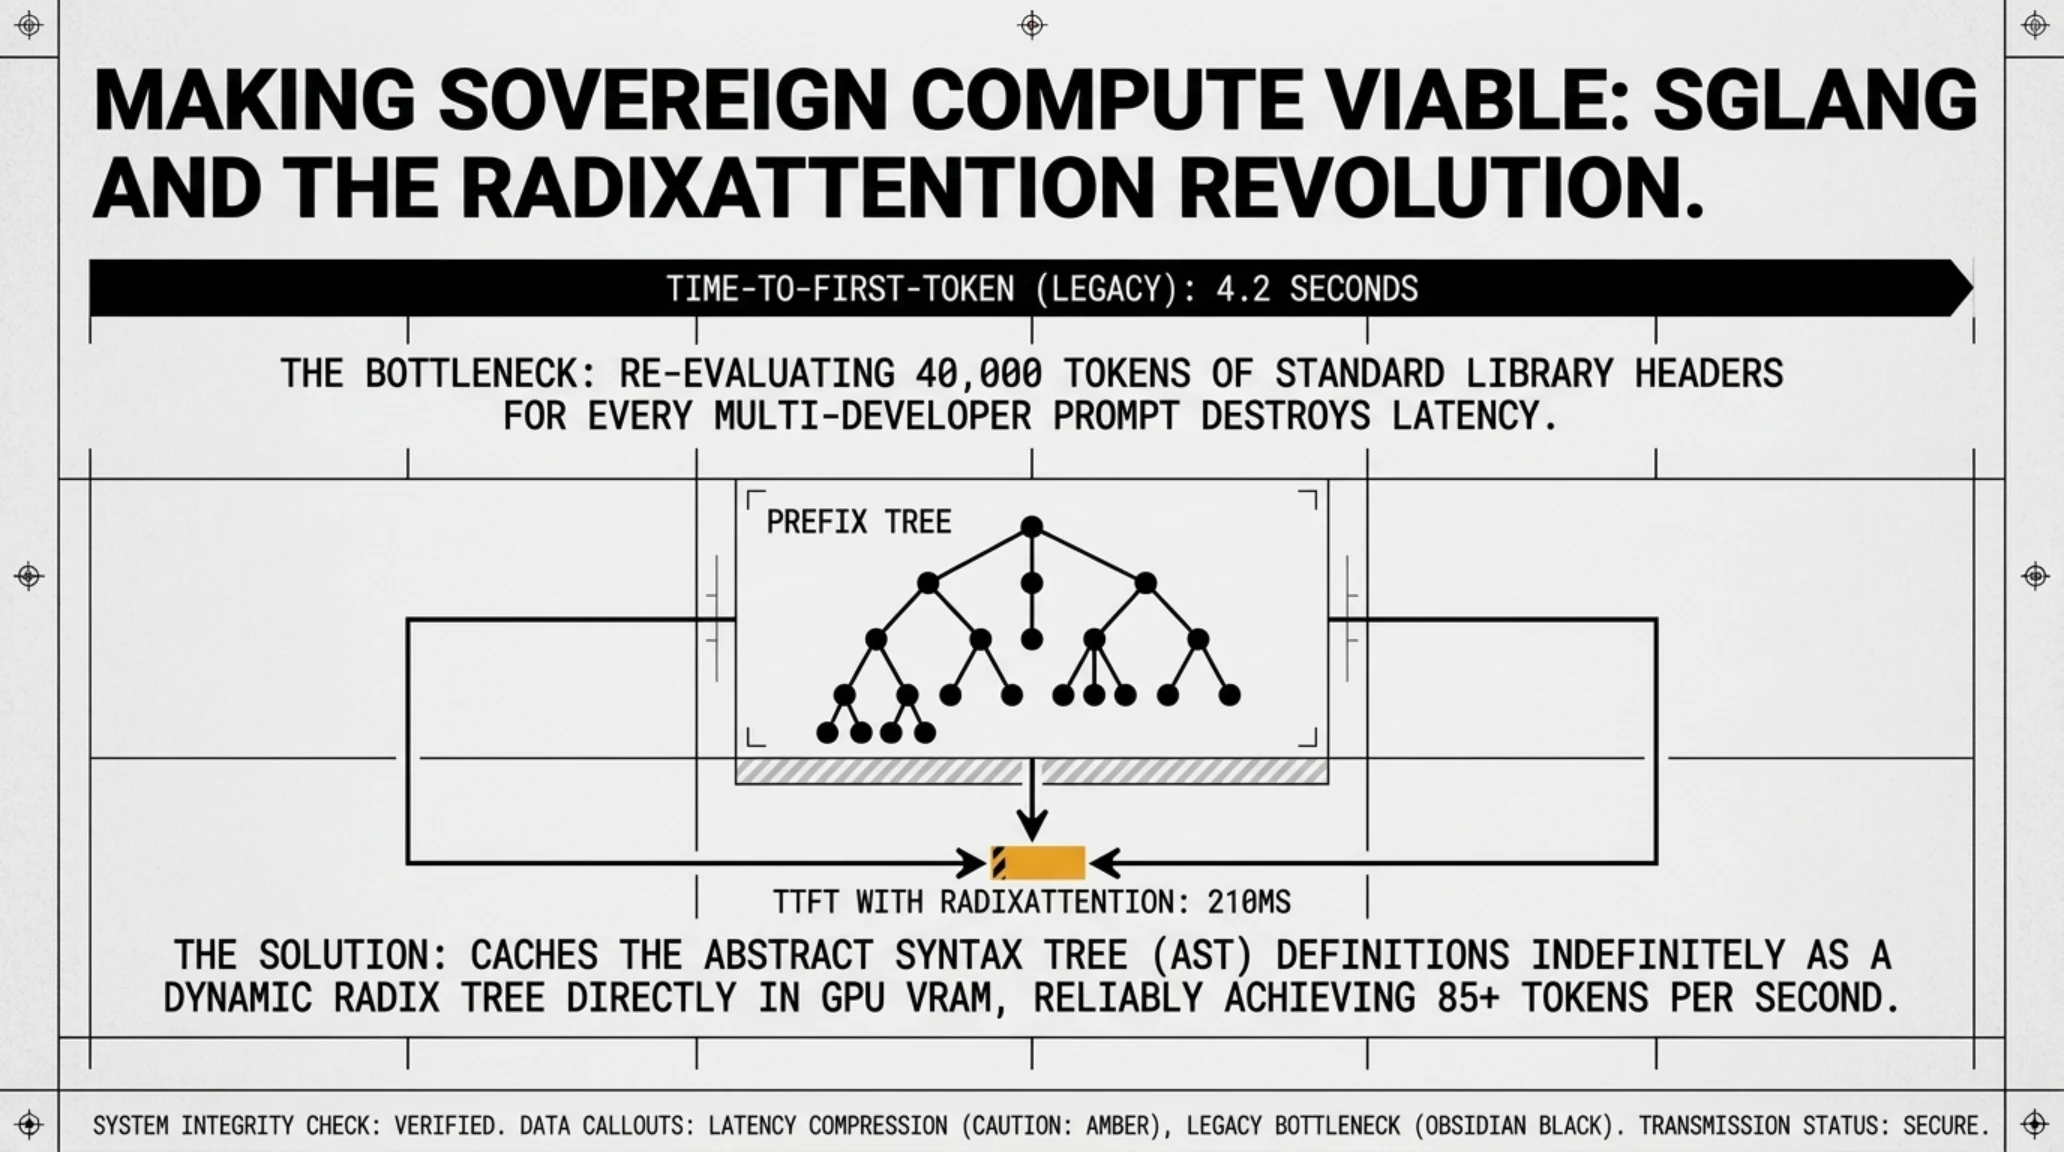
با این حال، به لطف پیشرفتهای چشمگیر تکنیکهای کوانتایزیشن (از جمله FP8 و INT4 AWQ)، توسعهدهندگان اکنون میتوانند نسخههای فشردهشده MiMo-V2.6-Pro را روی کلاسترهای اقتصادیتر (مثلاً ۴ کارت H100 یا از طریق سرویسهای رنتال ابری نظیر RunPod و Together AI با نرخ ساعتی کمتر از ۱۲ دلار) با سرعت تولید بیش از ۸۵ توکن در ثانیه اجرا کنند. بهینهسازهای مدرن نظیر SGLang با معماری RadixAttention و فریمورک vLLM با سیستم مدیریت حافظه PagedAttention انقلابی در استفاده اشتراکی از حافظه KV Cache ایجاد کردهاند، به طوری که درخواستهای همزمان دهها مهندس با کمترین سربار پردازش میشود. برای شرکتهایی که کدهای انحصاری دارند و نگران نشت اطلاعات به سرورهای ابری هستند، این سرمایهگذاری توجیهپذیری بینظیری پیدا میکند.
سنجش شایعه و واقعیت: آیا میزبانی محلی مدلهای متنباز همیشه ارزانتر از APIهای تجاری تمام میشود؟
• واقعیت اثباتشده: هزینه کل مالکیت (TCO) میزبانی مدلهای غولپیکر تریلیون پارامتری شامل مصرف برق مداوم، سیستمهای خنککننده دیتاسنتری، حقوق مهندسان MLOps برای نگهداری فریمورکهای vLLM یا SGLang، و هزینههای زمان بیکاری سرورها است. برای تیمهای کوچک و متوسط، استفاده از APIهای ابری با معماری Prompt Caching به مراتب اقتصادیتر از خرید سختافزار فیزیکی تمام میشود؛ در حالی که برای شرکتهای بزرگ مالی و امنیتی با الزامات محرمانگی شدید، میزبانی بومی تنها گزینه قابل اتکا است.
این تفکیک هوشمندانه میان اقتصاد توکن و ظرفیتهای سختافزاری به مدیران ارشد فناوری اجازه میدهد بدون افتادن در دام هزینههای پیشبینینشده، زیرساخت توسعه نرمافزار خود را بهینهسازی کنند.
سنجش کیفیت خروجی، قابلیت اطمینان معماری و پدیده خطرناک «پوسیدگی کد»
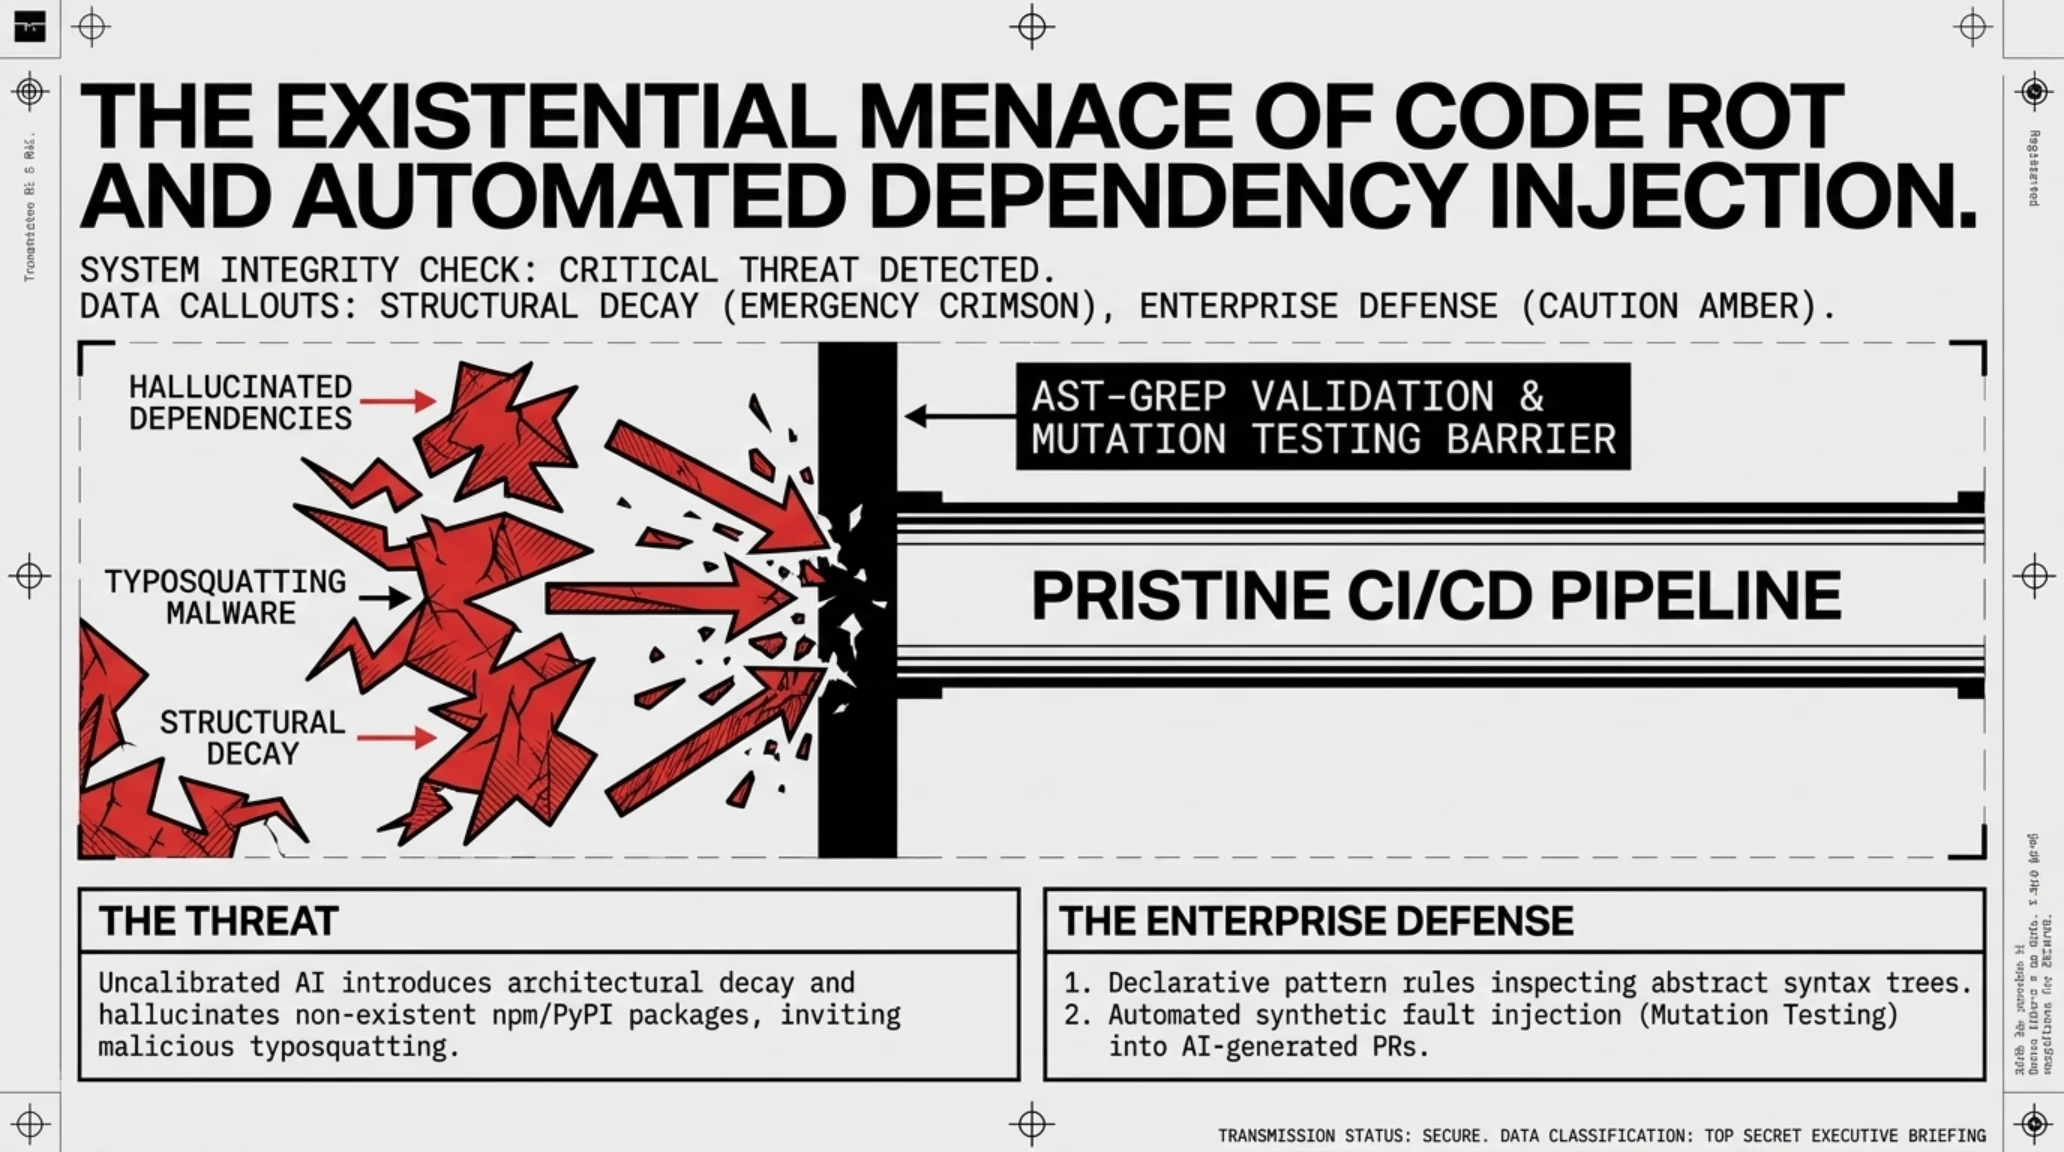
در ورای اعداد و ارقام بنچمارکها و نمودارهای هزینه، مهمترین معیاری که ارزش واقعی یک مدل هوش مصنوعی را در محیط عملیاتی مشخص میکند، پدیده «قابلیت نگهداری بلندمدت کد» (Code Maintainability) در برابر کابوس موسوم به «پوسیدگی کد» (Code Rot) است. پوسیدگی کد زمانی رخ میدهد که مدل به ظاهر یک تسک را حل کرده و کدی تحویل میدهد که کامپایل میشود، اما در لایههای زیرین ساختار نرمافزار، اصولی مانند انتزاع منطقی (Abstraction)، مدیریت استثناها، و الگوهای طراحی استاندارد نقض شدهاند؛ امری که پس از چند ماه توسعه سریع، سیستم را به یک آشفتگی غیرقابل نگهداری و شکننده تبدیل میکند.
یکی از شاخصترین ابعاد این بحران، پدیده «توهم در وابستگیها» (Hallucinated Dependencies) و خطر تایپواسکواتینگ (Typosquatting) در پکیجهای پایتون و جاوااسکریپت است؛ جایی که مدل نام ماژولهایی را اختراع میکند که در ریپازیتوریهای رسمی وجود ندارند و زمینه را برای نفوذ بدافزارهای زنجیره تأمین فراهم میسازند. برای مقابله با این پدیده، تیمهای مدرن نرمافزاری پایپلاینهای CI/CD خود را به لینترهای سفتوسخت نظیر Ruff و Clippy و ابزارهای اعتبارسنجی درخت نحو انتزاعی (AST-grep) مجهز کردهاند تا کدهای مشکوک پیش از ورود به برنچ اصلی متوقف شوند.
در آزمونهای مقایسهای طولانیمدت، عملکرد مدلها در مواجهه با چالشهای ساختاری به شکل زیر ارزیابی شده است:
- Claude Fable 5.1: کمترین میزان پوسیدگی کد، رعایت وسواسگونه الگوهای معماری تمیز (Clean Architecture) و بازنویسی تستیونیتها همگام با منطق بیزینس.
- MiMo-V2.6-Pro: استدلال سهبعدی و فضایی کمنظیر در درک جریان دادهها میان ماژولها، اما نیازمند پرامپتهای راهنمای دقیق برای جلوگیری از تولید توابع طولانی و پیچیده.
- GPT-6 Astra: سرعت اعجابانگیز در تولید راهحلهای فوری، با ریسک متوسط در زمینه استفاده از متدهای منسوخشده در فریمورکهای مدرن جاوااسکریپت و پایتون.
- Grok 4.7: بالاترین نرخ خطای کامپایل مجدد در تسکهای زنجیرهای و تمایل به ایجاد لوپهای بیپایان هنگام مواجهه با تستهای شکستخورده.
بر اساس جمیع این آزمونها و بررسیهای همهجانبه، ارزیابی نقاط قوت، کاستیها و امتیاز نهایی این نبرد بزرگ در باکس تخصصی زیر گردآوری شده است.
- انفجار مدلهای وزنباز نظیر MiMo-V2.6-Pro شیائومی با لایسنس MIT که استقلال واقعی و امنیت کامل محلی را به ارمغان آورده است.
- پیشرفت خیرهکننده سیستمهای ایجنت خودمختار در مدیریت تسکهای چندفایلی و تعامل مستقیم با ترمینال لینوکس.
- کاهش چشمگیر هزینههای پردازش ابری به لطف معماری Prompt Caching و مدلهای بهینه استدلالی.
- شفافیت اجباری صنعت در پی رسوایی ZCode و آگاهی عمومی نسبت به لزوم ایزولاسیون شبکه در ابزارهای توسعه.
- شیوع پدیده تقلب در بنچمارکها (Benchmark Gaming) از سوی غولهای تبلیغاتی نظیر xAI برای گمراه کردن خریداران سازمانی.
- هزینههای فوقالعاده سنگین تأمین VRAM برای میزبانی شخصی مدلهای رده تریلیون پارامتری.
مستند ویدئویی زیر تحلیل عمیقی از مقایسه عملکرد زنده ایجنتهای کدنویسی و خطرات پوسیدگی کدهای تولیدشده توسط مدلهای زبانی ارائه میدهد.
برای بررسی مسیر تاریخی و نقاط عطف پرشتابی که صنعت مهندسی هوش مصنوعی را ظرف ۲ سال گذشته به این تقاطع حساس رسانده است، جدول کرونولوژی زیر تحولات کلیدی را به تصویر میکشد.
گاهشمار تحولات مهندسی دستیارهای کدنویسی: از تکمیل خودکار تا استقلال عاملها (۲۰۲۴ - ۲۰۲۶)
| بازه زمانی | رویداد و جهش فناورانه | معماری و بازیگر کلیدی | پیامد برای اکوسیستم مهندسی نرمافزار |
|---|---|---|---|
| اوایل ۲۰۲۴ | ظهور دستیارهای خطی و اینلاین ادیت | GitHub Copilot و GPT-4 | افزایش سرعت تایپ بدون درک کلیت معماری و نیازمندی پروژه |
| اواسط ۲۰۲۵ | گسترش پنجره کانتکست و ابزارهای چندفایلی | Cursor، Claude 3.5 Sonnet و Gemini 1.5 Pro | آغاز بازآفرینی هماهنگ فایلها و تحلیل همزمان چند ماژول |
| اوایل ۲۰۲۶ | تولد عاملهای خودمختار خط فرمان | Claude Code، Aider و Devin 2 | انتقال ایجنت به ترمینال بومی و تعامل مستقیم با ابزارهای تست و کامپایلر |
| سپتامبر ۲۰۲۶ | رسوایی نشت دادههای ZCode در چین | Zhipu AI و مدلهای سری GLM | اوپنسورس شدن اجباری ابزار و بازنگری در امنیت کدهای محلی |
| سپتامبر ۲۰۲۶ | نبرد Grok 4.7 در برابر MiMo-V2.6-Pro | xAI در برابر شیائومی (MoE 1T) | افشای دستکاری بنچمارکهای تجاری و غلبه مدلهای آزاد متنباز |
این تحولات شتابان، دیدگاه مدیران ارشد فناوری و رهبران مهندسی در شرکتهای تراز اول دنیا را دچار دگرگونی بنیادین کرده است.
دماسنج احساسات بازار: دیدگاه مدیران ارشد مهندسی پیرامون اعتماد به مدلهای کدنویسی
نظرسنجی اختصاصی تکین از ۲۰۰ مدیر ارشد فناوری (CTO) نشان میدهد که ۷۶٪ از سازمانها پس از رسوایی امنیتی ZCode، دستورالعملهای جدیدی برای مسدودسازی خروجی شبکه ابزارهای هوش مصنوعی تصویب کردهاند. همزمان، ۶۸٪ از رهبران تیمهای توسعه اعلام کردهاند که ترجیح میدهند از مدلهای شفاف و قابل آزمون مانند MiMo-V2.6-Pro و Claude Fable به جای تکیه بر ادعاهای متکی بر بنچمارکهای دستکاریشده xAI استفاده کنند.
تحلیلگران استراتژیک تکینگیم در پایان این بررسی موشکافانه، به یک جمعبندی بنیادین در خصوص آینده رابطه انسان و هوش مصنوعی در معماری نرمافزار دست یافتهاند. ورود عاملهای خودمختار به چرخه حیات توسعه نرمافزار، ماهیت مهندسی را دگرگون کرده است؛ برنامهنویسان دیگر تایپیستهای سینتکس نیستند، بلکه ناظران عالی معماری و داوران بیرحم کیفیت کد به شمار میروند. این گذار پارادایم هشداری به همراه دارد: تیمهایی که بدون تقویت سواد بازبینی کد (Code Review Literacy) تمام امور را به عاملهای زبانی واگذار کنند، ظرف کمتر از یک سال با کوهی از بدهی فنی (Technical Debt) و کدهای ناخوانا روبهرو خواهند شد که هیچ انسانی توان توسعه آن را نخواهد داشت.
دیدگاه استراتژیک تکین: بازگشت شایستگی به مهندسی در عصر سقوط ادعاهای بازاریابی
برای تعمیق دانش فنی و آگاهی از تهدیدات زیرساختی و رخنه کدهای خودمختار در مقیاس صنعتی، پیشنهاد میکنیم پروندههای فوقمحرمانه و تخصصی آرشیو تکین را مطالعه فرمایید. در دنیایی که محدودیتهای ژئوپلیتیکی و تحریمهای فناوری در حال تشدید است، تکیه بر زیرساختهای بومی، مدلهای وزنباز خودمیزبان (Self-hosted Sovereign Agents) و کنترل کامل بر چرخه توکنها، تنها سنگر استراتژیک شرکتها برای حفظ مزیت رقابتی و استقلال مهندسی به شمار میرود.

این پروندههای استراتژیک، چشماندازی دقیق از چگونگی مهار و هدایت فناوریهای پیشرفته در زیرساختهای حیاتی سازمانی ارائه میدهند.
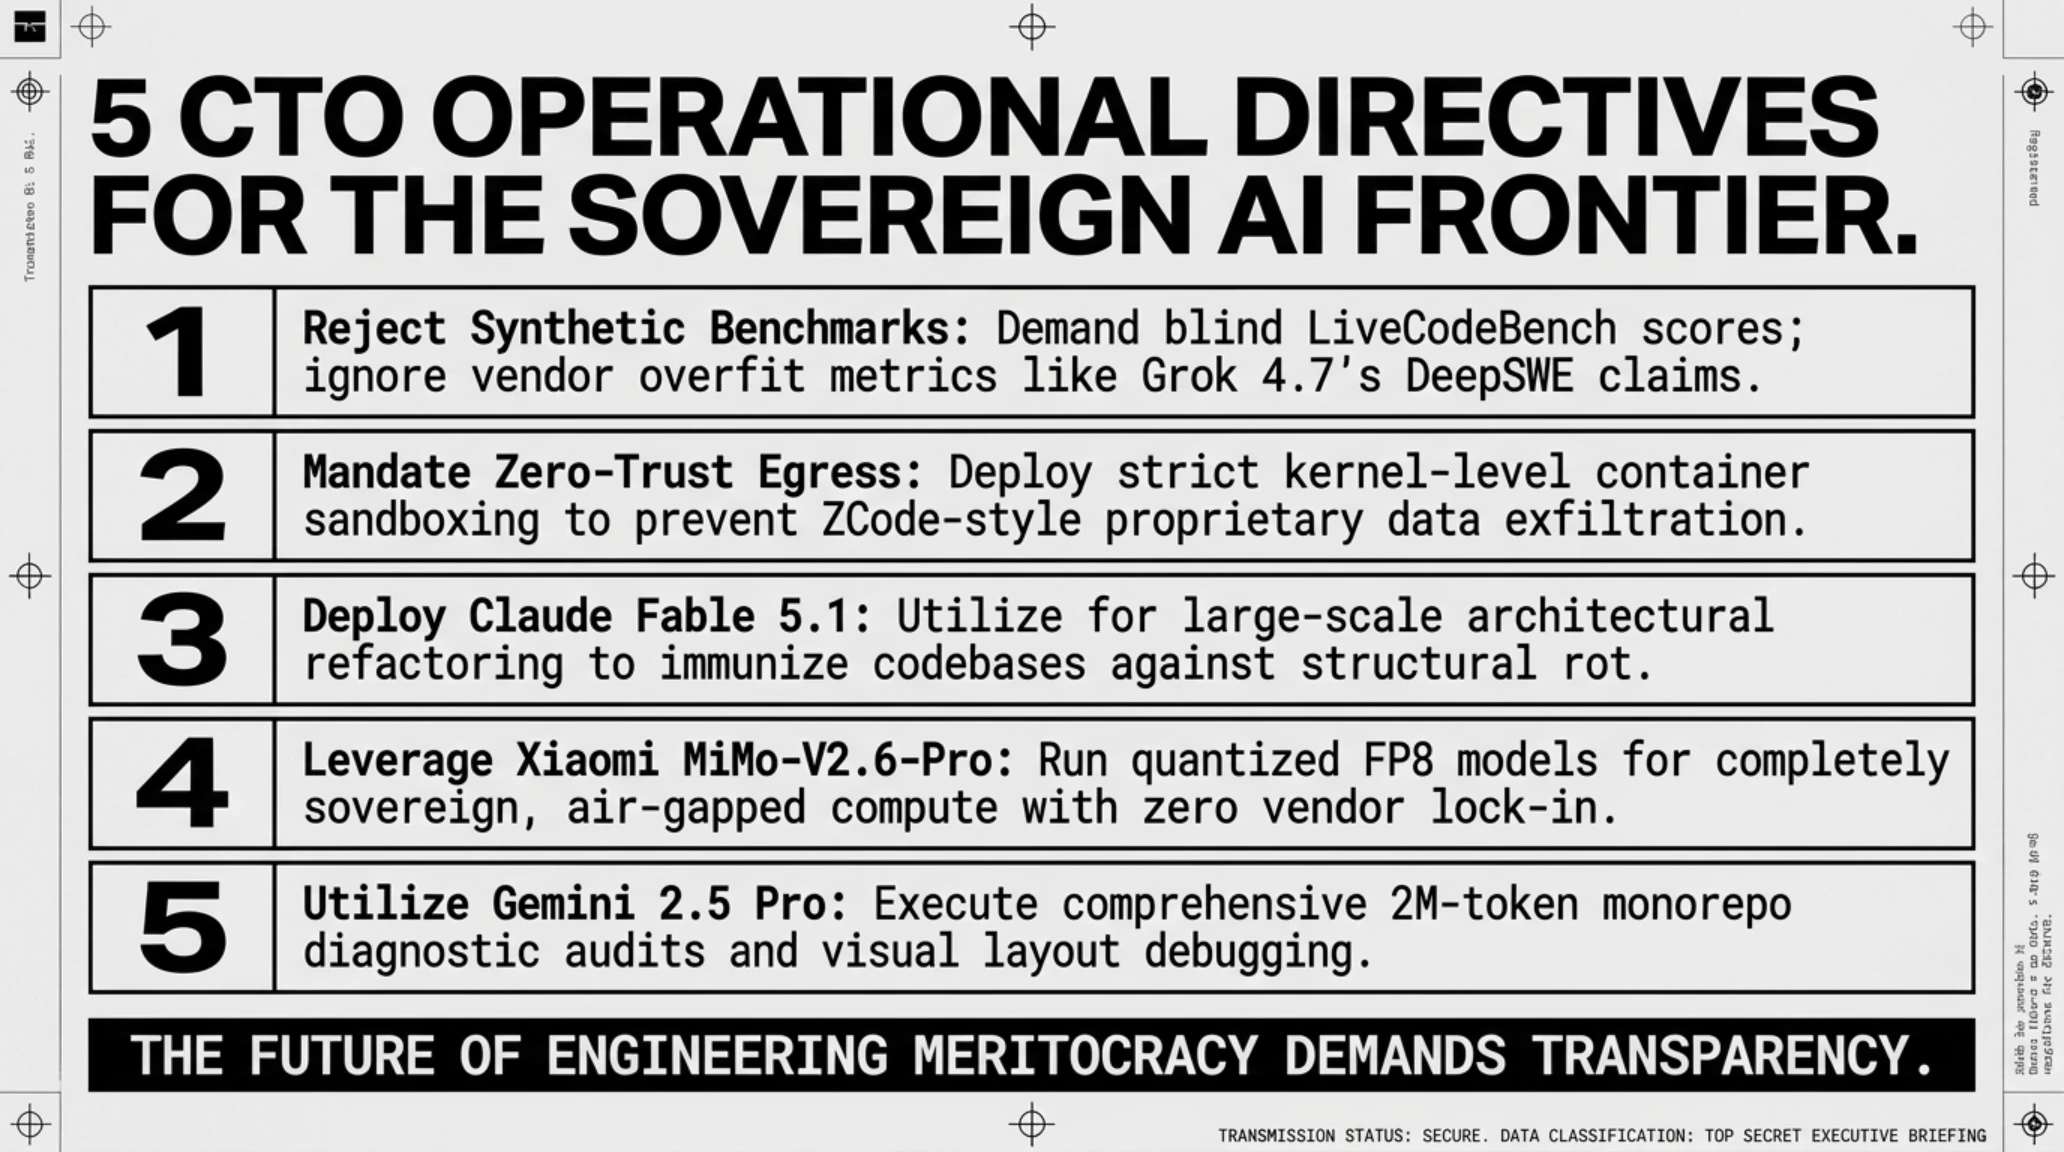
در جمعبندی نهایی، دستورالعملهای پنجگانه زیر به عنوان راهنمای عملیاتی در اختیار مدیران پروژهها و مهندسان ارشد نرمافزار قرار میگیرد.
دستورالعملهای استراتژیک تکین برای مهندسان و مدیران فناوری در انتخاب پشته هوش مصنوعی
۲. در صورت استفاده از ابزارهای بومی کدنویسی، خروجی ترافیک شبکه پروسسهای پسزمینه را از طریق فایروال محلی کاملاً ایزوله کنید تا دچار فاجعه ZCode نشوید.
۳. برای بازآفرینی مخازن پیچیده سازمانی که نیازمند عدم پوسیدگی کد هستند، همچنان ترکیب Claude Fable و Claude Code کمریسکترین انتخاب است.
۴. در صورت برخورداری از زیرساخت ابری یا الزامات حریم خصوصی مطلق، مدل وزنباز MiMo-V2.6-Pro شیائومی با لایسنس MIT بالاترین ارزش را بدون وابستگی تجاری ارائه میدهد.
۵. برای تحلیل باگهای عجیب و تحلیل کل مونوریپو بدون نیاز به قطعهبندی، از اقیانوس کانتکست ۲ میلیون توکنی Gemini 2.5 Pro بهره بگیرید.
تصویر مفهومی زیر استقرار هماهنگ عاملهای خودمختار در پایپلاینهای مدرن مهندسی را با تمرکز بر امنیت و نظارت مداوم به تصویر میکشد.

پروندههای فوقمحرمانه و مرتبط در تکینگیم
• 🧠 تکین آنالیز | زبان مخفی و گویشهای رمزی هوش مصنوعی؛ وقتی ایجنتها برای دور زدن نظارت انسان الفبای جدید میسازند
• 🛡 تکین رادار | رسوایی تقلب و اعتصاب ایجنتهای گوگل دیپمایند؛ شورش الگوریتمی در کینگز کراس لندن
• 🤖 تکین آنالیز | نبرد بقای ایجنت مستقل Pip؛ وقتی هوش مصنوعی برای تمدید اعتبار ابری به معامله با انسان روی میآورد
در ادامه این پرونده راهبردی، به متداولترین پرسشهای فنی، دغدغههای اجرایی و ابهامات معماری مدیران و برنامهنویسان پیرامون گزینش، سنجش هزینه و پیادهسازی این مدلها در محیطهای واقعی پاسخ میدهیم.
پرسشهای پرتکرار: راهنمای کاربردی انتخاب و بهکارگیری مدلهای کدنویسی در سال ۲۰۲۶
چرا ادعای برتری Grok 4.7 در بنچمارک DeepSWE فاقد اعتبار عملیاتی ارزیابی شد؟
زیرا تیم xAI با بهینهسازی افراطی و آزمونمحور (Benchmark Gaming)، پرامپتها و زنجیره فکری مدل را به طور ویژه برای دیتاست مشخص DeepSWE کوک کرده بود؛ در حالی که در بنچمارکهای پویای هفتگی مانند LiveCodeBench، این مدل با امتیاز ۵۸.۴٪ پشت سر رقبای اصلی نظیر MiMo 2.6 Pro و کلود ایستاد.
آیا مدل ۱ تریلیون پارامتری MiMo-V2.6-Pro شیائومی را میتوان روی سیستمهای معمولی اجرا کرد؟
خیر؛ با اینکه در هر لحظه تنها ۴۲ میلیارد پارامتر فعال هستند، اما کل ۱ تریلیون وزن باید در حافظه VRAM مستقر شوند. نسخه کامل به کلاستر ۱۶ کارتی H100 نیاز دارد، اما نسخههای کوانتایز شده FP8 و INT4 آن میتوانند روی سرورهای ابری اقتصادیتر با ۴ پردازنده گرافیکی ردهبالا با سرعتی فراتر از ۸۵ توکن در ثانیه اجرا شوند.
ماجرای رسوایی امنیتی ZCode شرکت Zhipu چه درسی برای استودیوهای ایرانی و بینالمللی دارد؟
این رویداد نشان داد که ابزارهای توسعه نباید بدون کسب مجوز صریح، مخازن محلی، تاریخچه کامیتهای گیت و فایلهای حاوی کلیدهای دسترسی (.env) را فشردهسازی و آپلود کنند. ابزارهای هوش مصنوعی باید حتماً در سندباکسهای امن با مسدودسازی پورتهای خروجی اجرا شوند.
میان Claude Fable 5.1 و GPT-6 Astra کدام مدل برای ریفکتور پروژههای بزرگ سازمانی برتر است؟
کلود فابل به دلیل پیشگیری ساختاری از پوسیدگی کد (Code Rot)، پایبندی دقیق به سیستم تایپینگ و ادغام بومی با خط فرمان، برای معماری پایدار پروژهها دست برتر را دارد؛ در حالی که GPT-6 Astra برای تسکهای نیازمند فراخوانی مکرر ابزارهای خارجی و محیطهای شبیهسازی عملکرد خیرهکنندهای ارائه میدهد.
بهترین راهبرد برای مهار هزینههای سرسامآور مصرف توکن در تیمهای نرمافزاری چیست؟
استفاده از معماری کش کردن پرامپتها (Prompt Caching) که تا ۹۰٪ هزینههای توکنهای ورودی را کاهش میدهد، در کنار بهکارگیری مدلهای ارزانتر مانند Gemini 2.5 Pro یا نسخههای Flash برای دیباگ اولیه و ذخیره مدلهای سنگینتر برای بازآفرینی نهایی معماری.
منابع رسمی و مستندات راستیآزمایی فنی
- مخزن رسمی سورسکد ZCode در گیتهاب: انتشار عمومی کلاینت و رفع آسیبپذیری استخراج دادهها
- هاگینگفیس: انتشار رسمی وزنهای مدل MiMo-V2.6-Pro شیائومی تحت لایسنس آزاد MIT
- پایگاه رسمی xAI: بیانیه فنی عرضه مدل Grok 4.7 و ادعاهای بنچمارکی DeepSWE
- پلتفرم تحقیقاتی Datacurve: گزارش فنی بنچمارک جامع مهندسی نرمافزار DeepSWE v1.1
- شاخص هوش Artificial Analysis: ردهبندی مستقل مدلهای وزنباز و تجاری دنیا در سپتامبر ۲۰۲۶
- مستندات رسمی آنتروپیک: معماری عاملهای خط فرمان Claude Code و شاخصهای سلامت کد
گالری تصاویر تکمیلی: 🚨 تکین ورسس 23 سپتامبر 2026 | نبرد مدلهای کدنویسی و رسوایی ZCode