تيكين غايد | الدليل الهندسي الشامل لتشغيل الذكاء الاصطناعي المحلي 2026
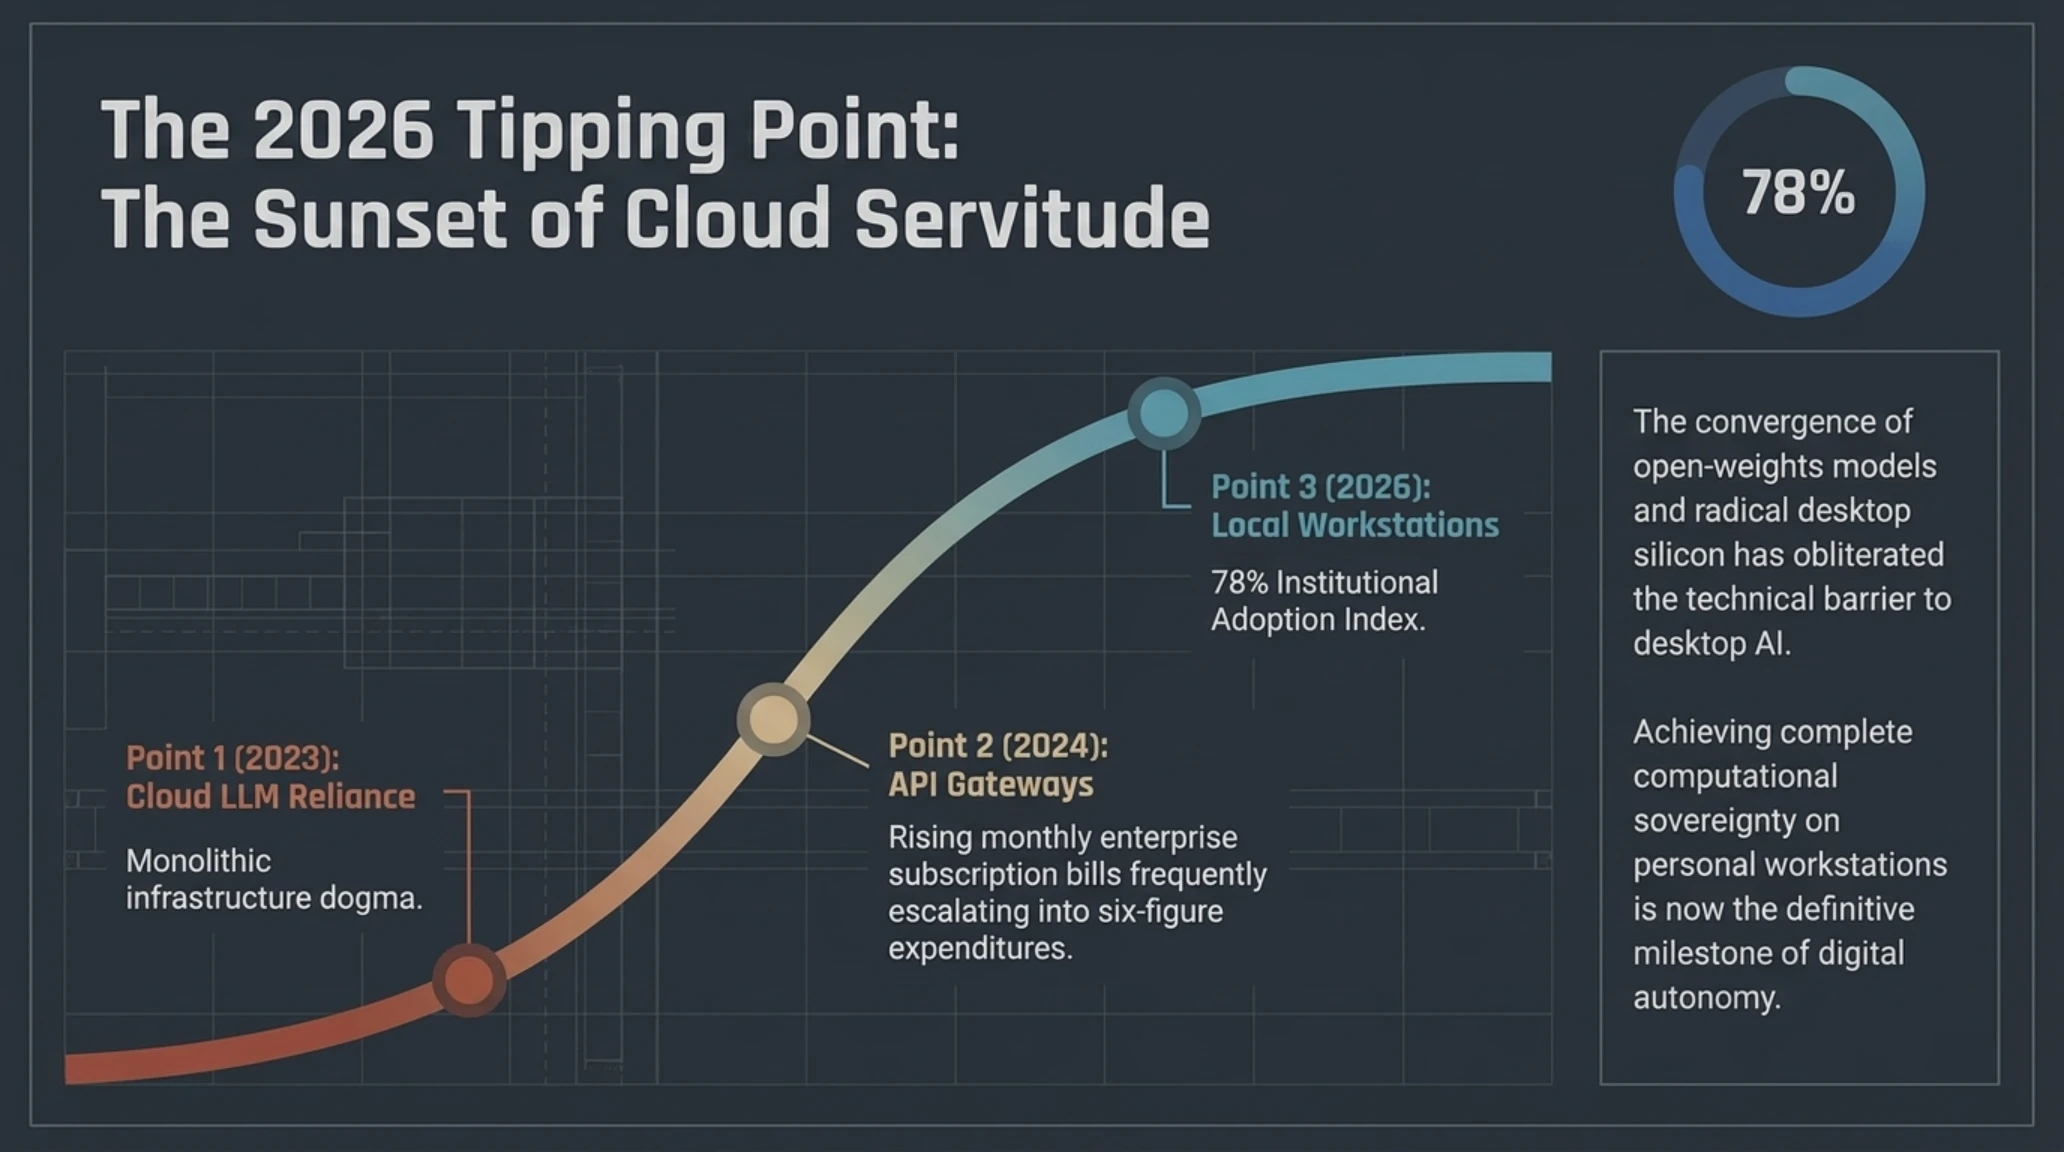
غروب شمس التبعية السحابية: لماذا يمثل عام 2026 المنعطف التاريخي للذكاء الاصطناعي المحلي؟
يقف المشهد التقني المؤسسي في خريف عام 2026 أمام تحول بنيوي حاسم في طريقة استهلاك واستثمار الذكاء الاصطناعي. فعلى مدى أكثر من ثلاث سنوات، نجحت الشركات السحابية الكبرى في ترسيخ فكرة مفادها أن النماذج الذكية المتقدمة لا يمكن أن تنبض بالحياة إلا داخل مراكز بيانات عملاقة تفوق تكلفتها مليارات الدولارات. وكان على الشركات، والمكاتب الاستشارية، ومطوري البرمجيات دفع اشتراكات شهرية باهظة وإرسال أسرارهم التجارية ومستنداتهم المالية إلى خوادم خارجية متعددة المستأجرين.
لكن هذا الاعتماد الأعمى على واجهات البرمجة السحابية تسبب في احتكاك تشغيلي وأمني واسع النطاق؛ حيث تتصادم رغبة الشركات في الاستفادة من الذكاء الاصطناعي مع القوانين الصارمة لحماية خصوصية البيانات، واتفاقيات عدم الإفصاح (NDAs)، ومخاوف تسريب الملكية الفكرية. ويعكس التقرير الميداني الأخير الذي نشره أنطونيو دي بينيديتو في موقع The Verge جوهر هذه التجربة الواقعية؛ حيث يصف الانتقال إلى الذكاء الاصطناعي المحلي بأنه تجربة مثيرة، لكنها في الوقت ذاته تبدو معقدة في بدايتها قبل أن تمنح المستخدم سيادة رقمية مطلقة ومستدامة.
لقد أدى النضج الاستثنائي في خوارزميات التكميم (Quantization) وتطور كفاءة المعالجات المكتبية في عام 2026 إلى كسر هذا الحاجز التقني نهائياً. أصبح بإمكان محطة عمل مكتبية واحدة، تستهلك طاقة كهربائية ضئيلة وتعمل بصمت تام، أن تشغل نماذج لغوية متقدمة للغاية مثل Hermes 3 و Qwen 2.5 بسرعة تفوق سرعة القراءة البشرية الطبيعية، دون أن ترسل بايت واحداً من البيانات عبر شبكة الإنترنت.
بالنسبة للمؤسسات المالية، ومكاتب المحاماة، ومراكز الأبحاث في دبي والرياض وأبوظبي، لم يعد تشغيل الذكاء الاصطناعي محلياً مجرد رفاهية تقنية، بل أضحى خط الدفاع الأول لحماية سيادة البيانات والامتثال الصارم للتشريعات الوطنية المنظمة للذكاء الاصطناعي وحماية الخصوصية.
معمارية الذاكرة الموحدة من آبل ضد جدار ذاكرة الفيديو (VRAM) في إنفيديا
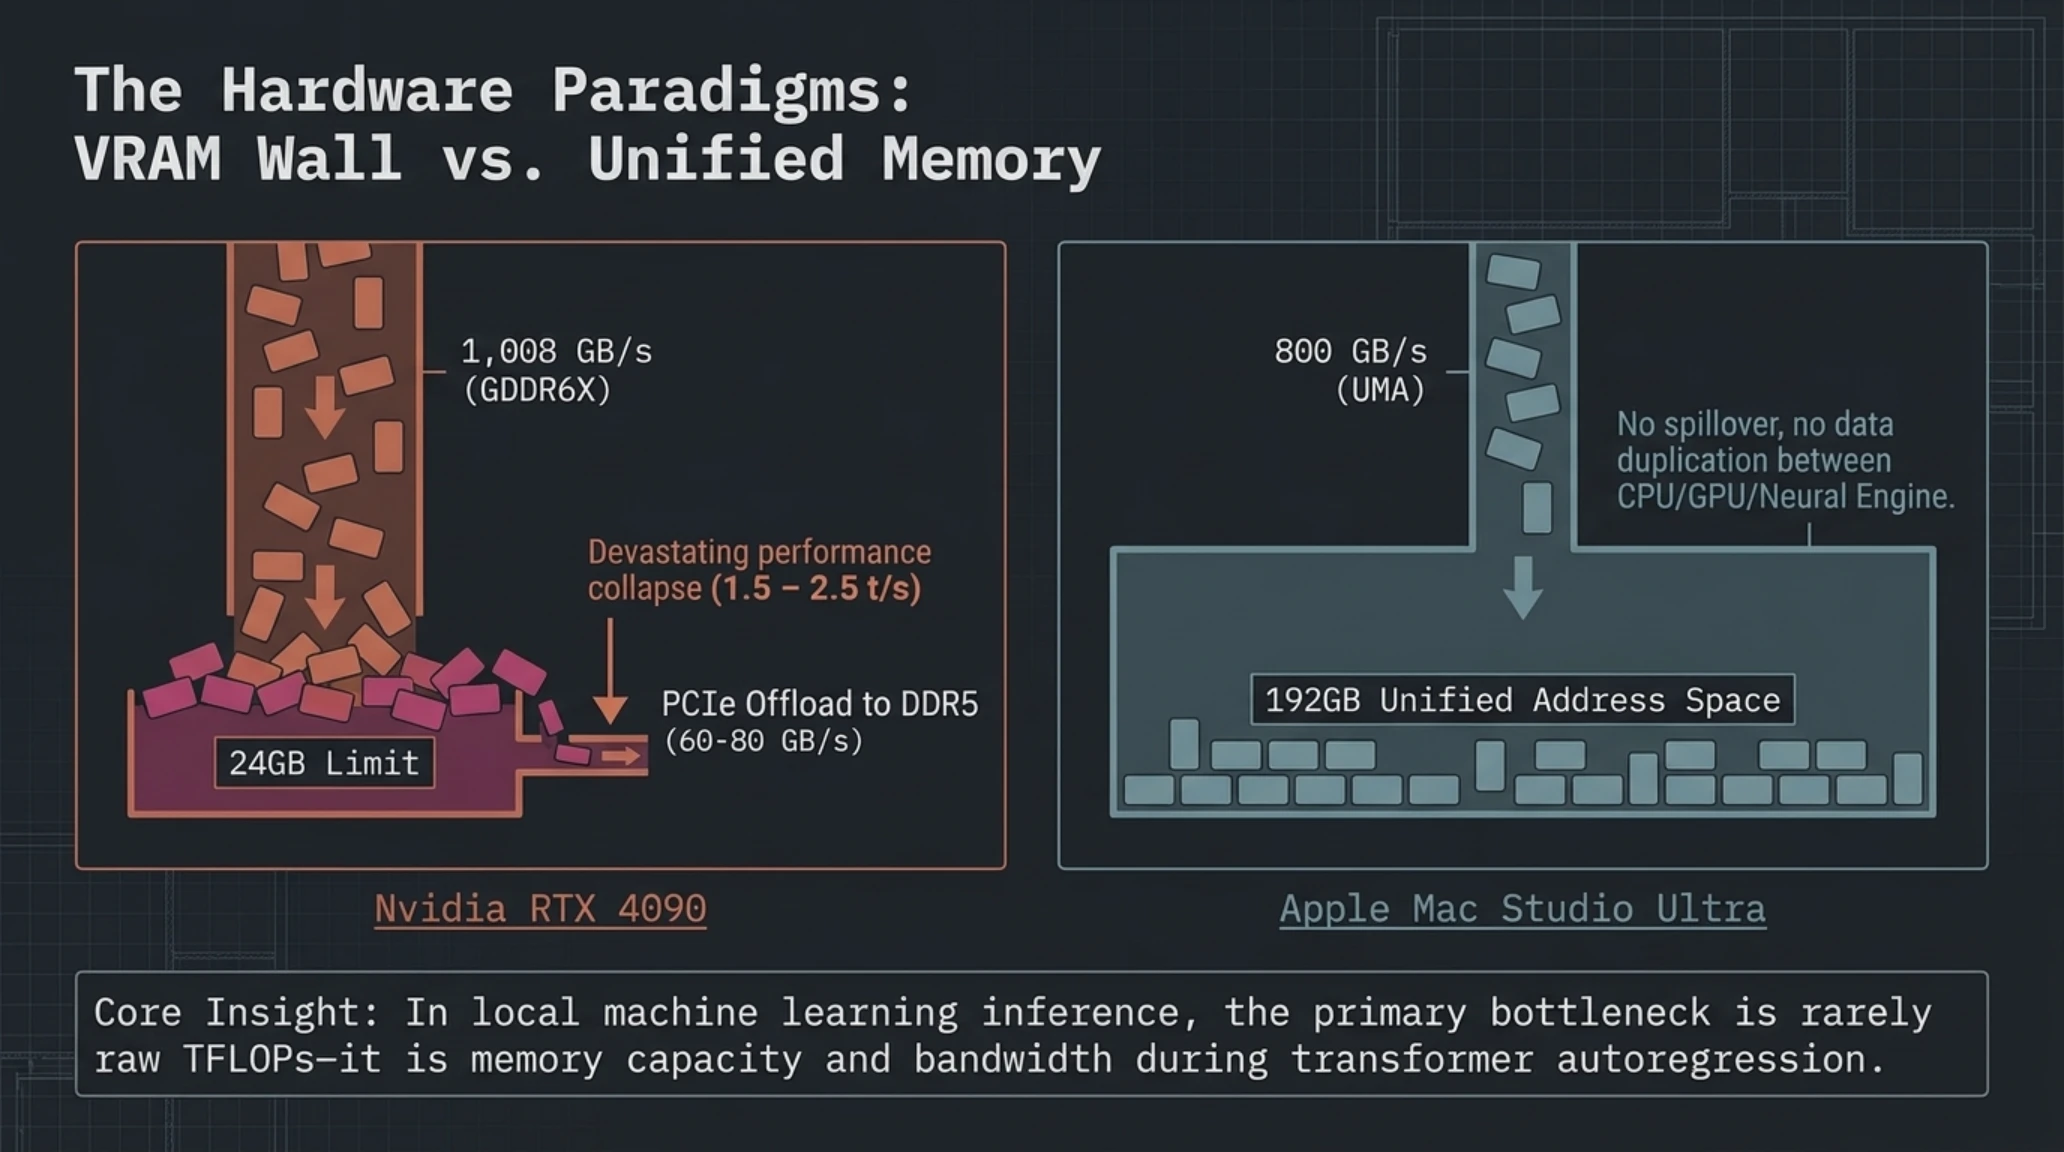
في عالم معالجة النماذج اللغوية محلياً، لا يكمن الاختناق الأساسي في سرعة الحوسبة الخام أو عدد العمليات الحسابية، بل في سعة ونطاق الذاكرة الترددي. وتتواجه في هذا المضمار فلسفتان هندسيتان متناقضتان: شركة إنفيديا عبر بطاقات GeForce RTX 4090 التي تعتمد على ذاكرة GDDR6X فائقة السرعة، وشركة آبل عبر رقاقات M2 و M4 ألترا التي تعتمد على معمارية الذاكرة الموحدة (Unified Memory Architecture).
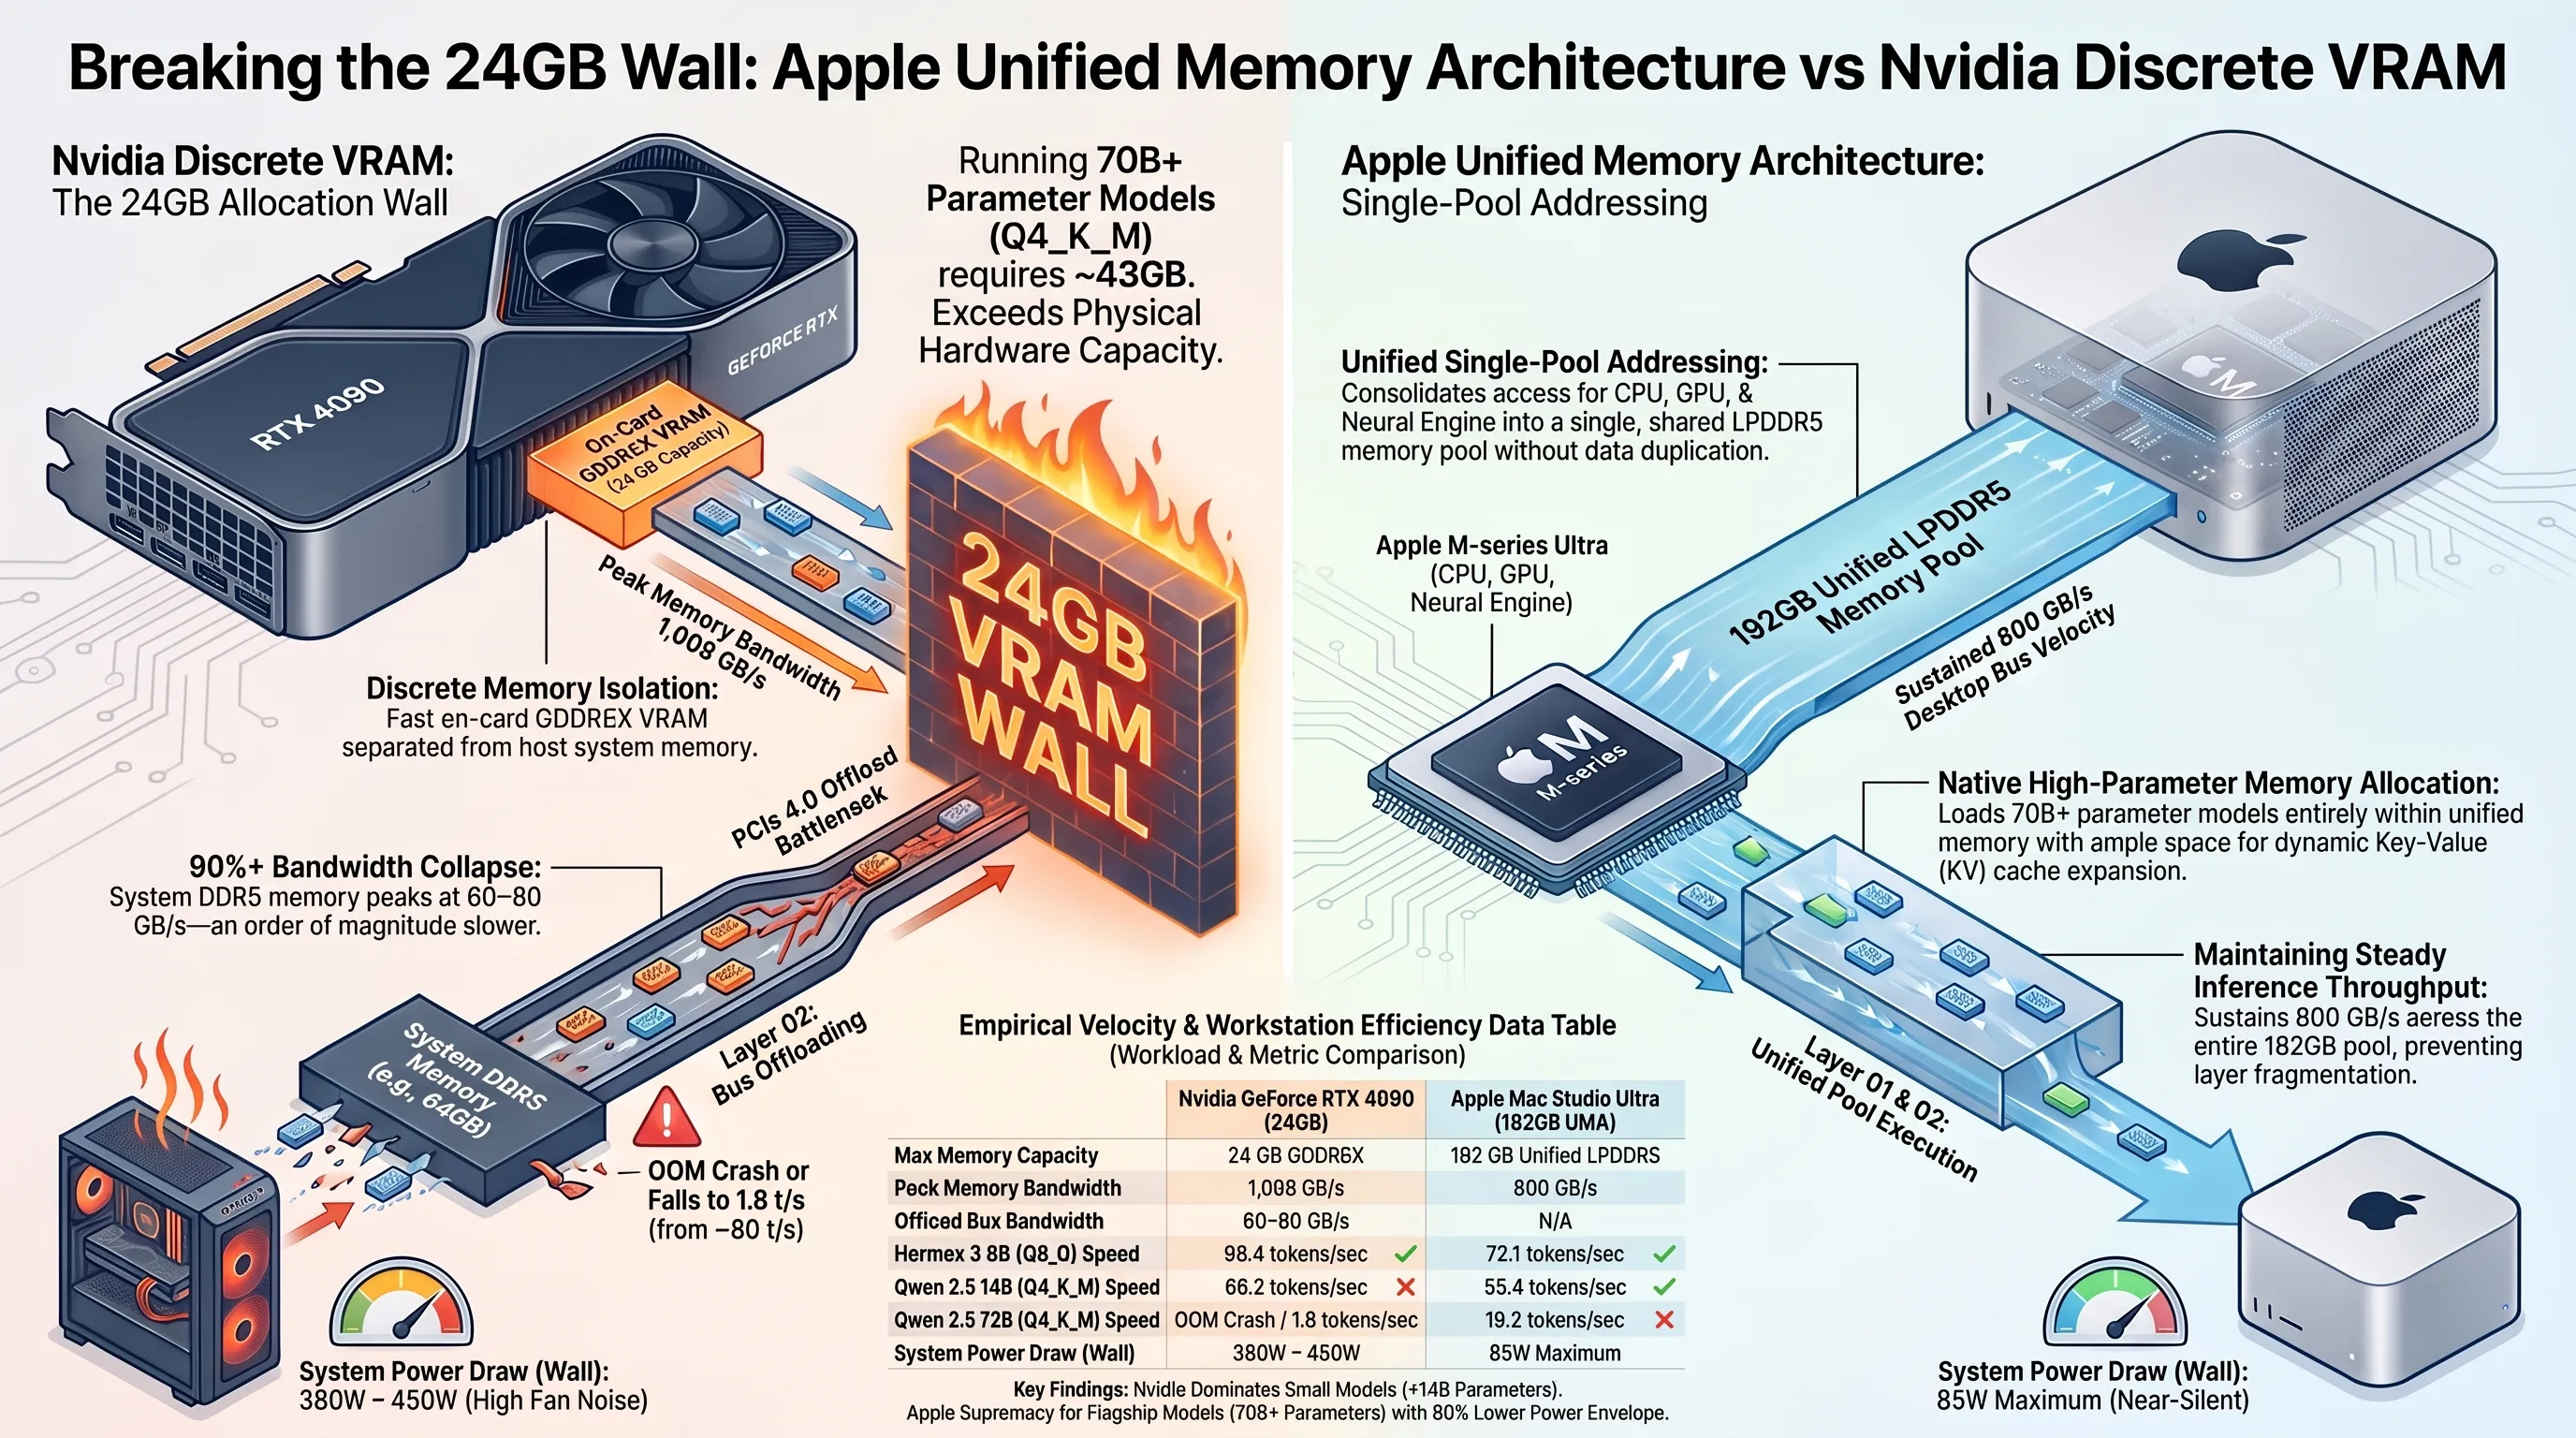
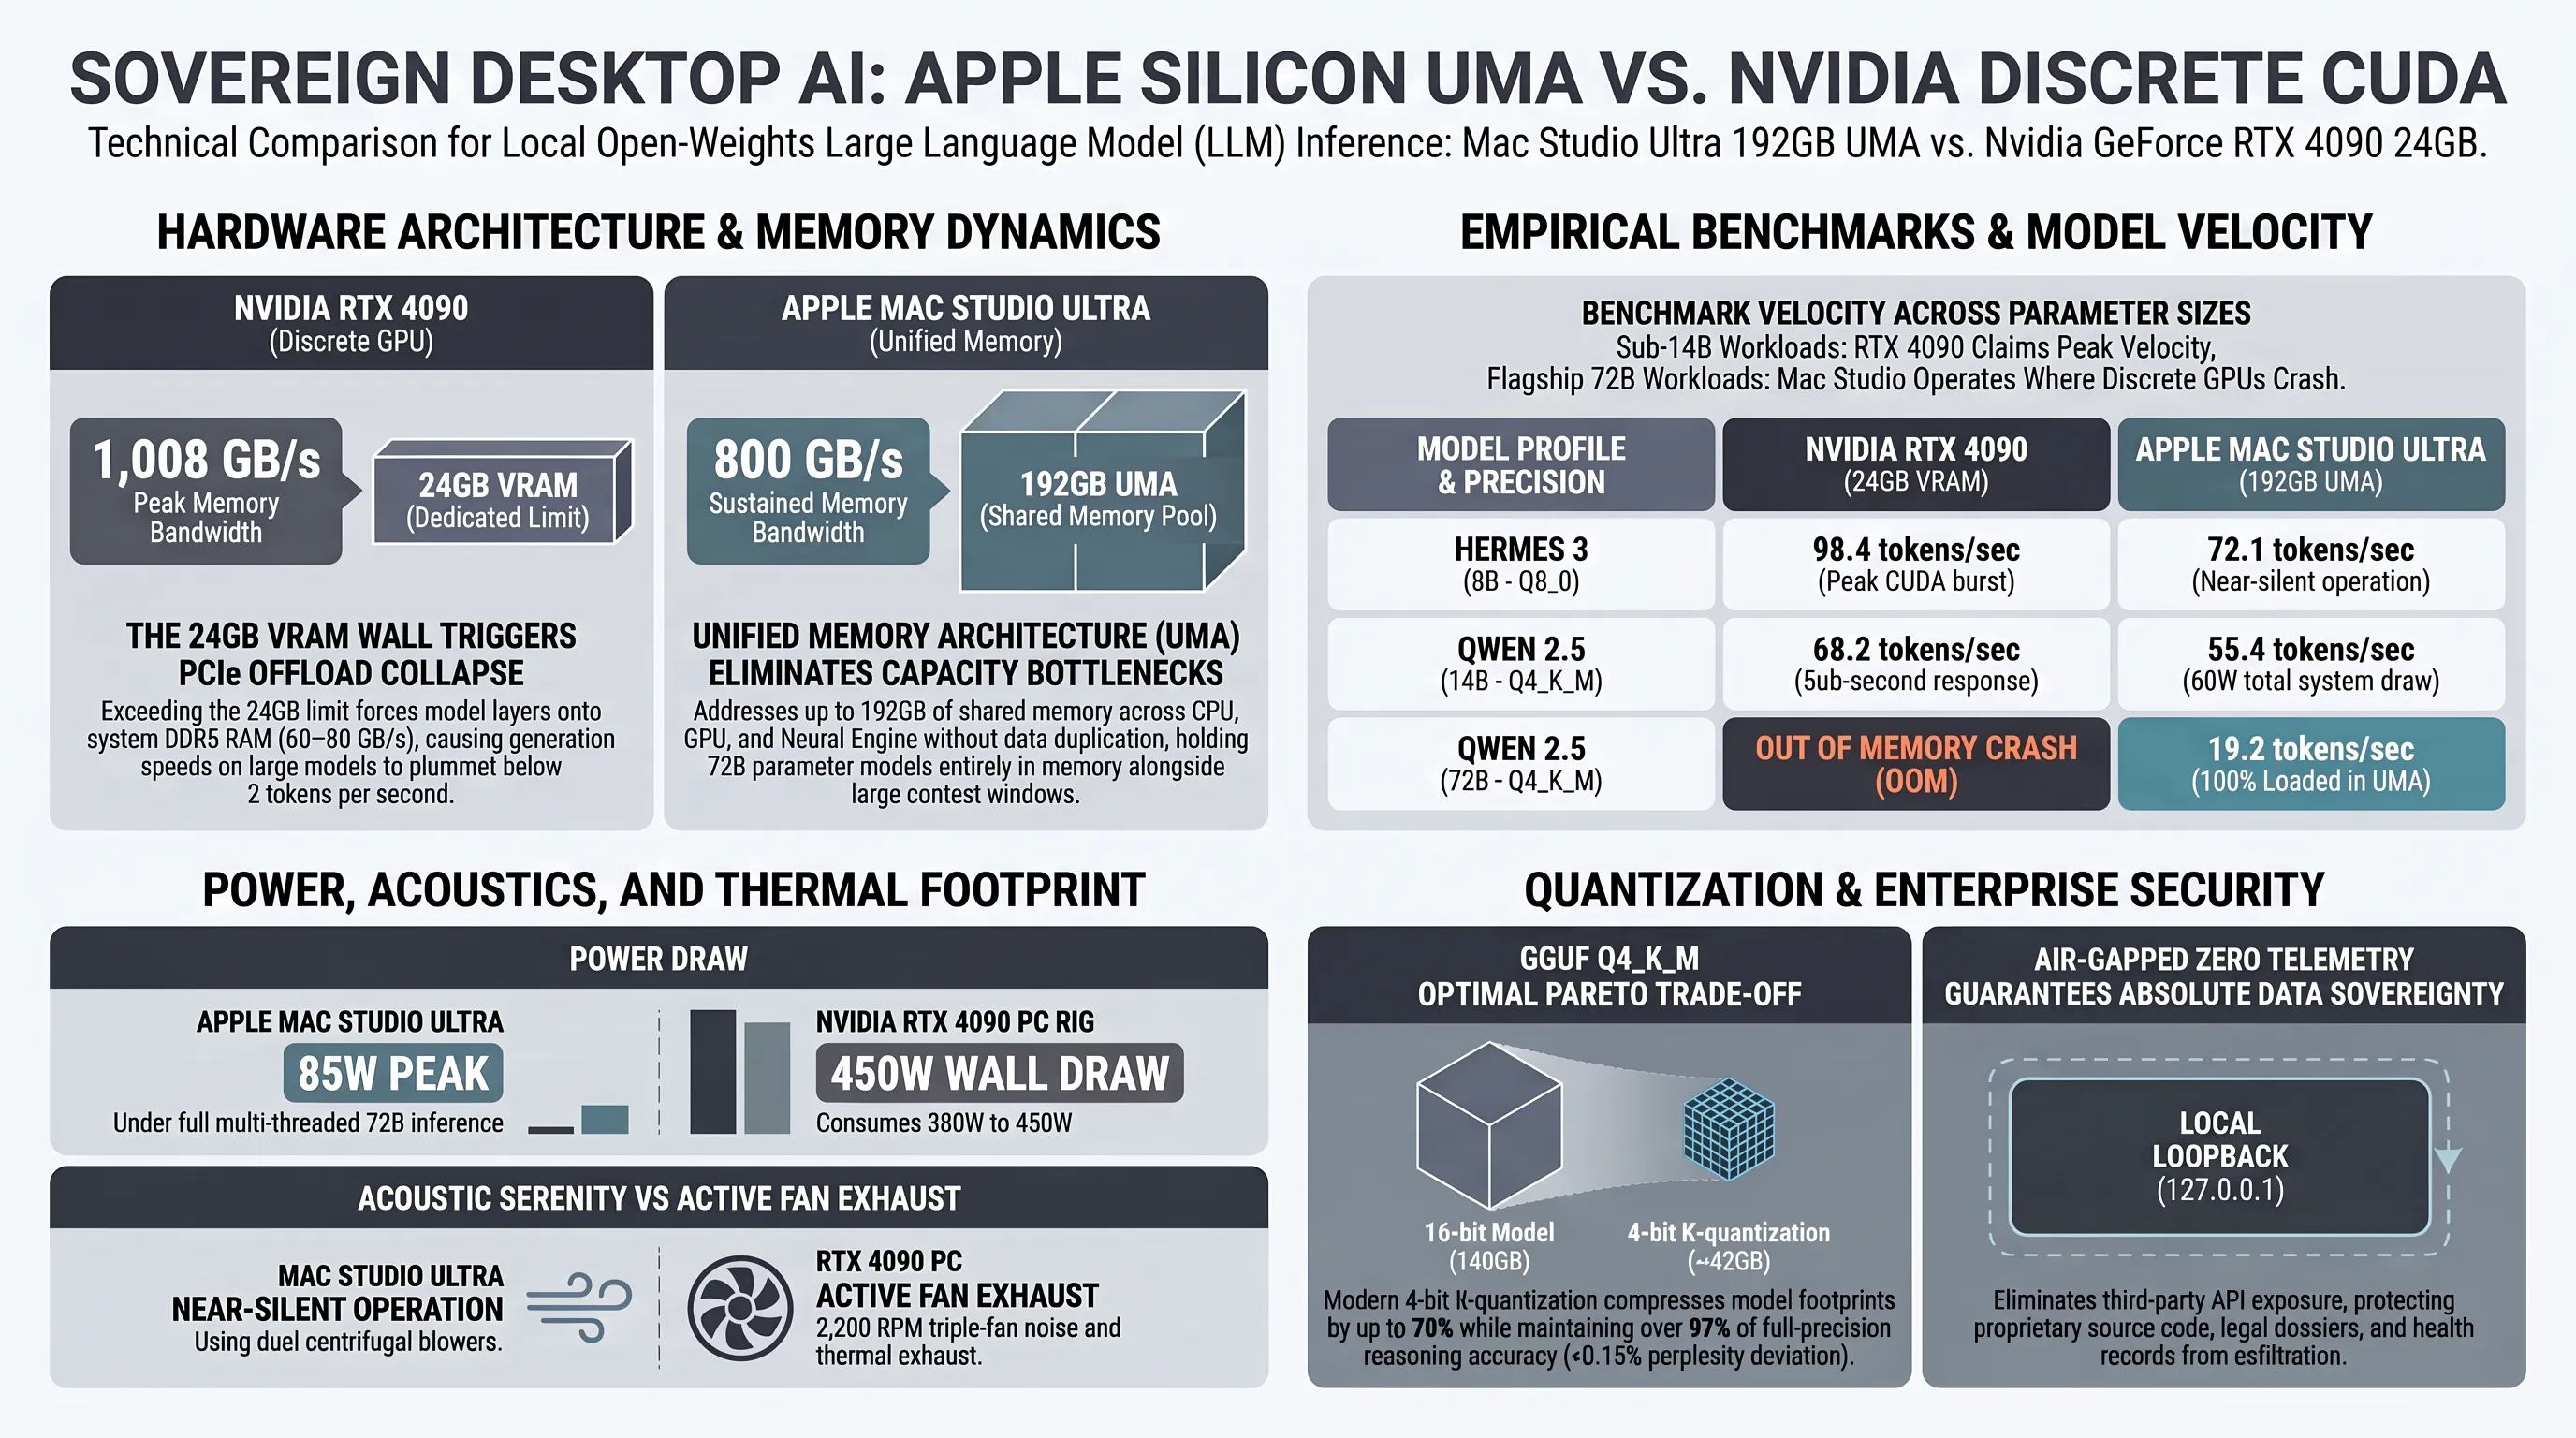
توفر بطاقة RTX 4090 نطاقاً ترددياً هائلاً يصل إلى 1008 جيجابايت في الثانية؛ مما يجعلها الخيار الأسرع في معالجة النماذج الخفيفة والمتوسطة. غير أن هذه البطاقة تصطدم بحاجز فيزيائي لا يمكن تجاوزه: جدار الذاكرة الرسومية المحدد بـ 24 جيجابايت. فعند محاولة تشغيل نموذج ضخم يضم 70 مليار معامل مثل Qwen 2.5 72B، تتطلب أوزان النموذج ما لا يقل عن 43 جيجابايت في صيغة التكميم 4 بت؛ مما يؤدي إلى فشل البطاقة واضطرار النظام لنقل الطبقات الزائدة إلى ذاكرة النظام DDR5، وهو ما يتسبب في انهيار كارثي لسرعة المعالجة لتصل إلى رمز أو رمزين في الثانية فقط.
أبعاد الأهمية: ركائز السيادة الحاسوبية المحلية
التحول الجذري من دفع الاشتراكات السحابية المستمرة إلى امتلاك العتاد المكتبي السيادي؛ حل معضلة الذاكرة المحدودة عبر الذاكرة الموحدة وبيئات التشغيل المحلية المتطورة.
في المقابل، تكسر أجهزة Mac Studio المزودة بمعالجات Ultra هذا الجدار بالكامل بفضل الذاكرة الموحدة التي تصل إلى 192 جيجابايت وبنطاق ترددي يبلغ 800 جيجابايت في الثانية. في هذه المعمارية، تشترك أنوية المعالجة المركزية وأنrate الرسوميات والمحرك العصبي في حوض ذاكرة واحد دون الحاجة لنسخ البيانات عبر ممرات النقل. ويتيح هذا تحميل نموذج ضخم يضم 72 مليار معامل بالكامل داخل الذاكرة مع نافذة سياق واسعة، والعمل بسرعة مستقرة ومريحة تتراوح بين 18 إلى 22 رمزاً في الثانية دون إصدار أي ضجيج مروحي.
طليعة النماذج مفتوحة المصدر: تفكيك قدرات Hermes 3 و Qwen 2.5
لا تكتمل كفاءة العتاد الصلب دون توفر نماذج تأسيسية مفتوحة الأوزان تمتاز بالذكاء والقدرة على الاستدلال واستدعاء الأدوات البرمجية. وفي خريف عام 2026، تتصدر عائلتان هذه الساحة التقنية: نموذج Hermes 3 المطور من قبل فريق Nous Research، وسلسلة نماذج Qwen 2.5 التابعة لمجموعة علي بابا السحابية.
صُمم نموذج Hermes 3، المبني على معمارية Llama 3.1، خصيصاً للوكلاء المستقلين وتنفيذ المهام التلقائية المعقدة واستدعاء الدوال البرمجية (Function Calling). ويتميز النموذج بقدرته على التفكير المنطقي الداخلي داخل وسوم المسودة (<scratchpad>)؛ حيث يدقق في فرضياته ويتحقق من سلامة الأوامر قبل إصدار المخرجات النهائية للمستخدم، مما يجعله المحرك المثالي لأتمتة الأنظمة المكتبية دون الحاجة إلى تدخل بشري مستمر.
في الوقت نفسه، أحدثت عائلة Qwen 2.5 ثورة حقيقية في معايير الأداء الأكاديمي والبرمجي؛ حيث توفر أحجاماً متعددة تبدأ من 0.5 مليار معامل وتصل إلى 72 مليار معامل، مع دعم استثنائي لنافذة سياق تصل إلى 128 ألف رمز. وتتفوق هذه النماذج في حل المسائل الرياضية المعقدة وكتابة الأكواد بلغات بايثون ورست، فضلاً عن دعمها المتميز للغتين العربية والإنجليزية، مما يمنح المطورين الإقليميين شريكاً تقنياً متكاملاً يعمل باستقلالية تامة داخل بيئة العمل المحلية.
التقييم الاستراتيجي والرؤى المفتاحية بلمحة سريعة
مصفوفة بيئات التشغيل البرمجية؛ مقارنة شاملة بين Ollama و LM Studio و MLX و vLLM
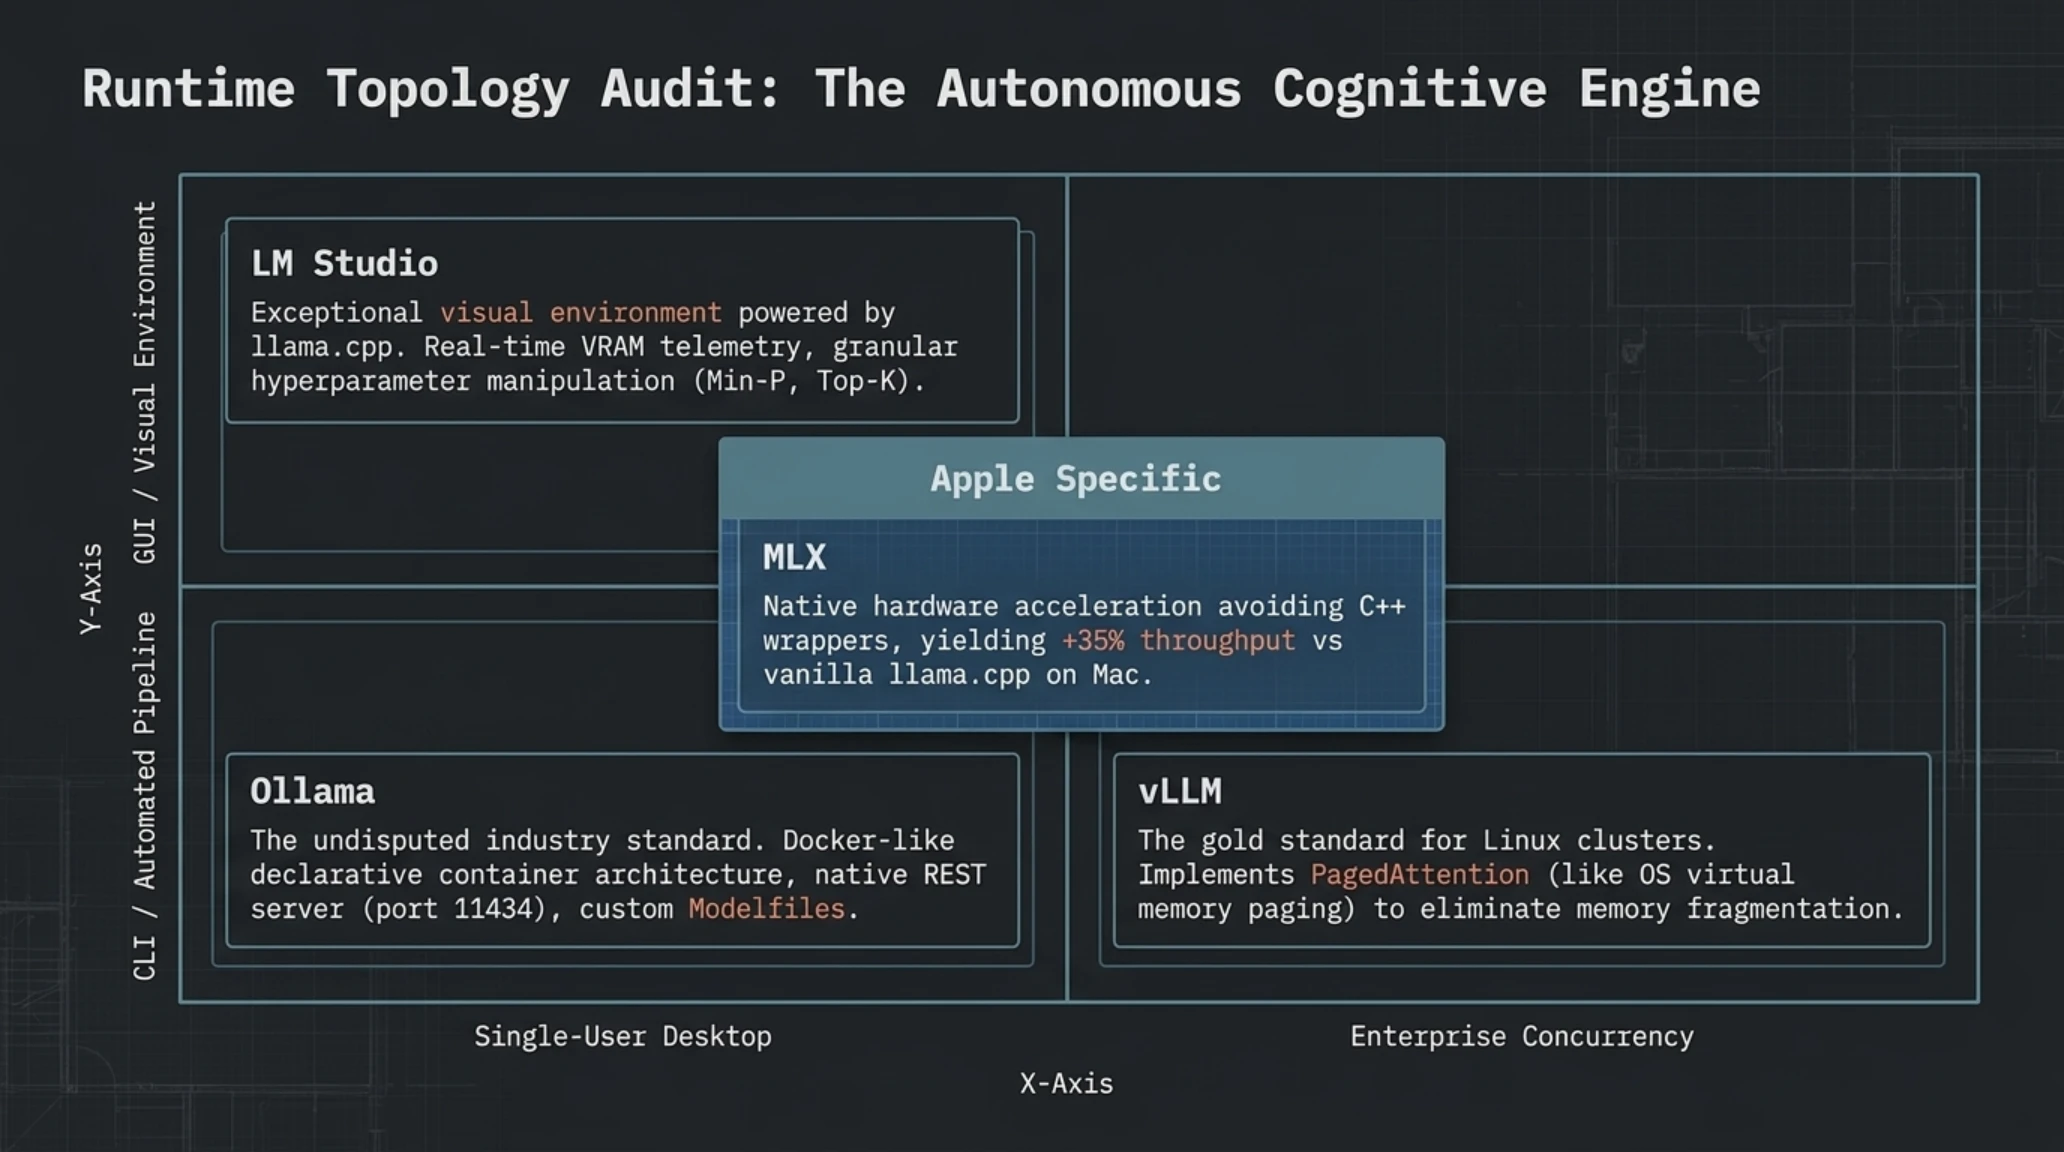
لتحويل محطة العمل المكتبية إلى منصة ذكاء اصطناعي سيادية، يلعب محرك التشغيل الوسيط دوراً محورياً في تحديد سرعة الاستجابة وكفاءة استهلاك الموارد. وتبرز في عام 2026 أربع بيئات رئيسية تتكامل بسلاسة مع مختلف أنظمة التشغيل ومستويات الخبرة التقنية.
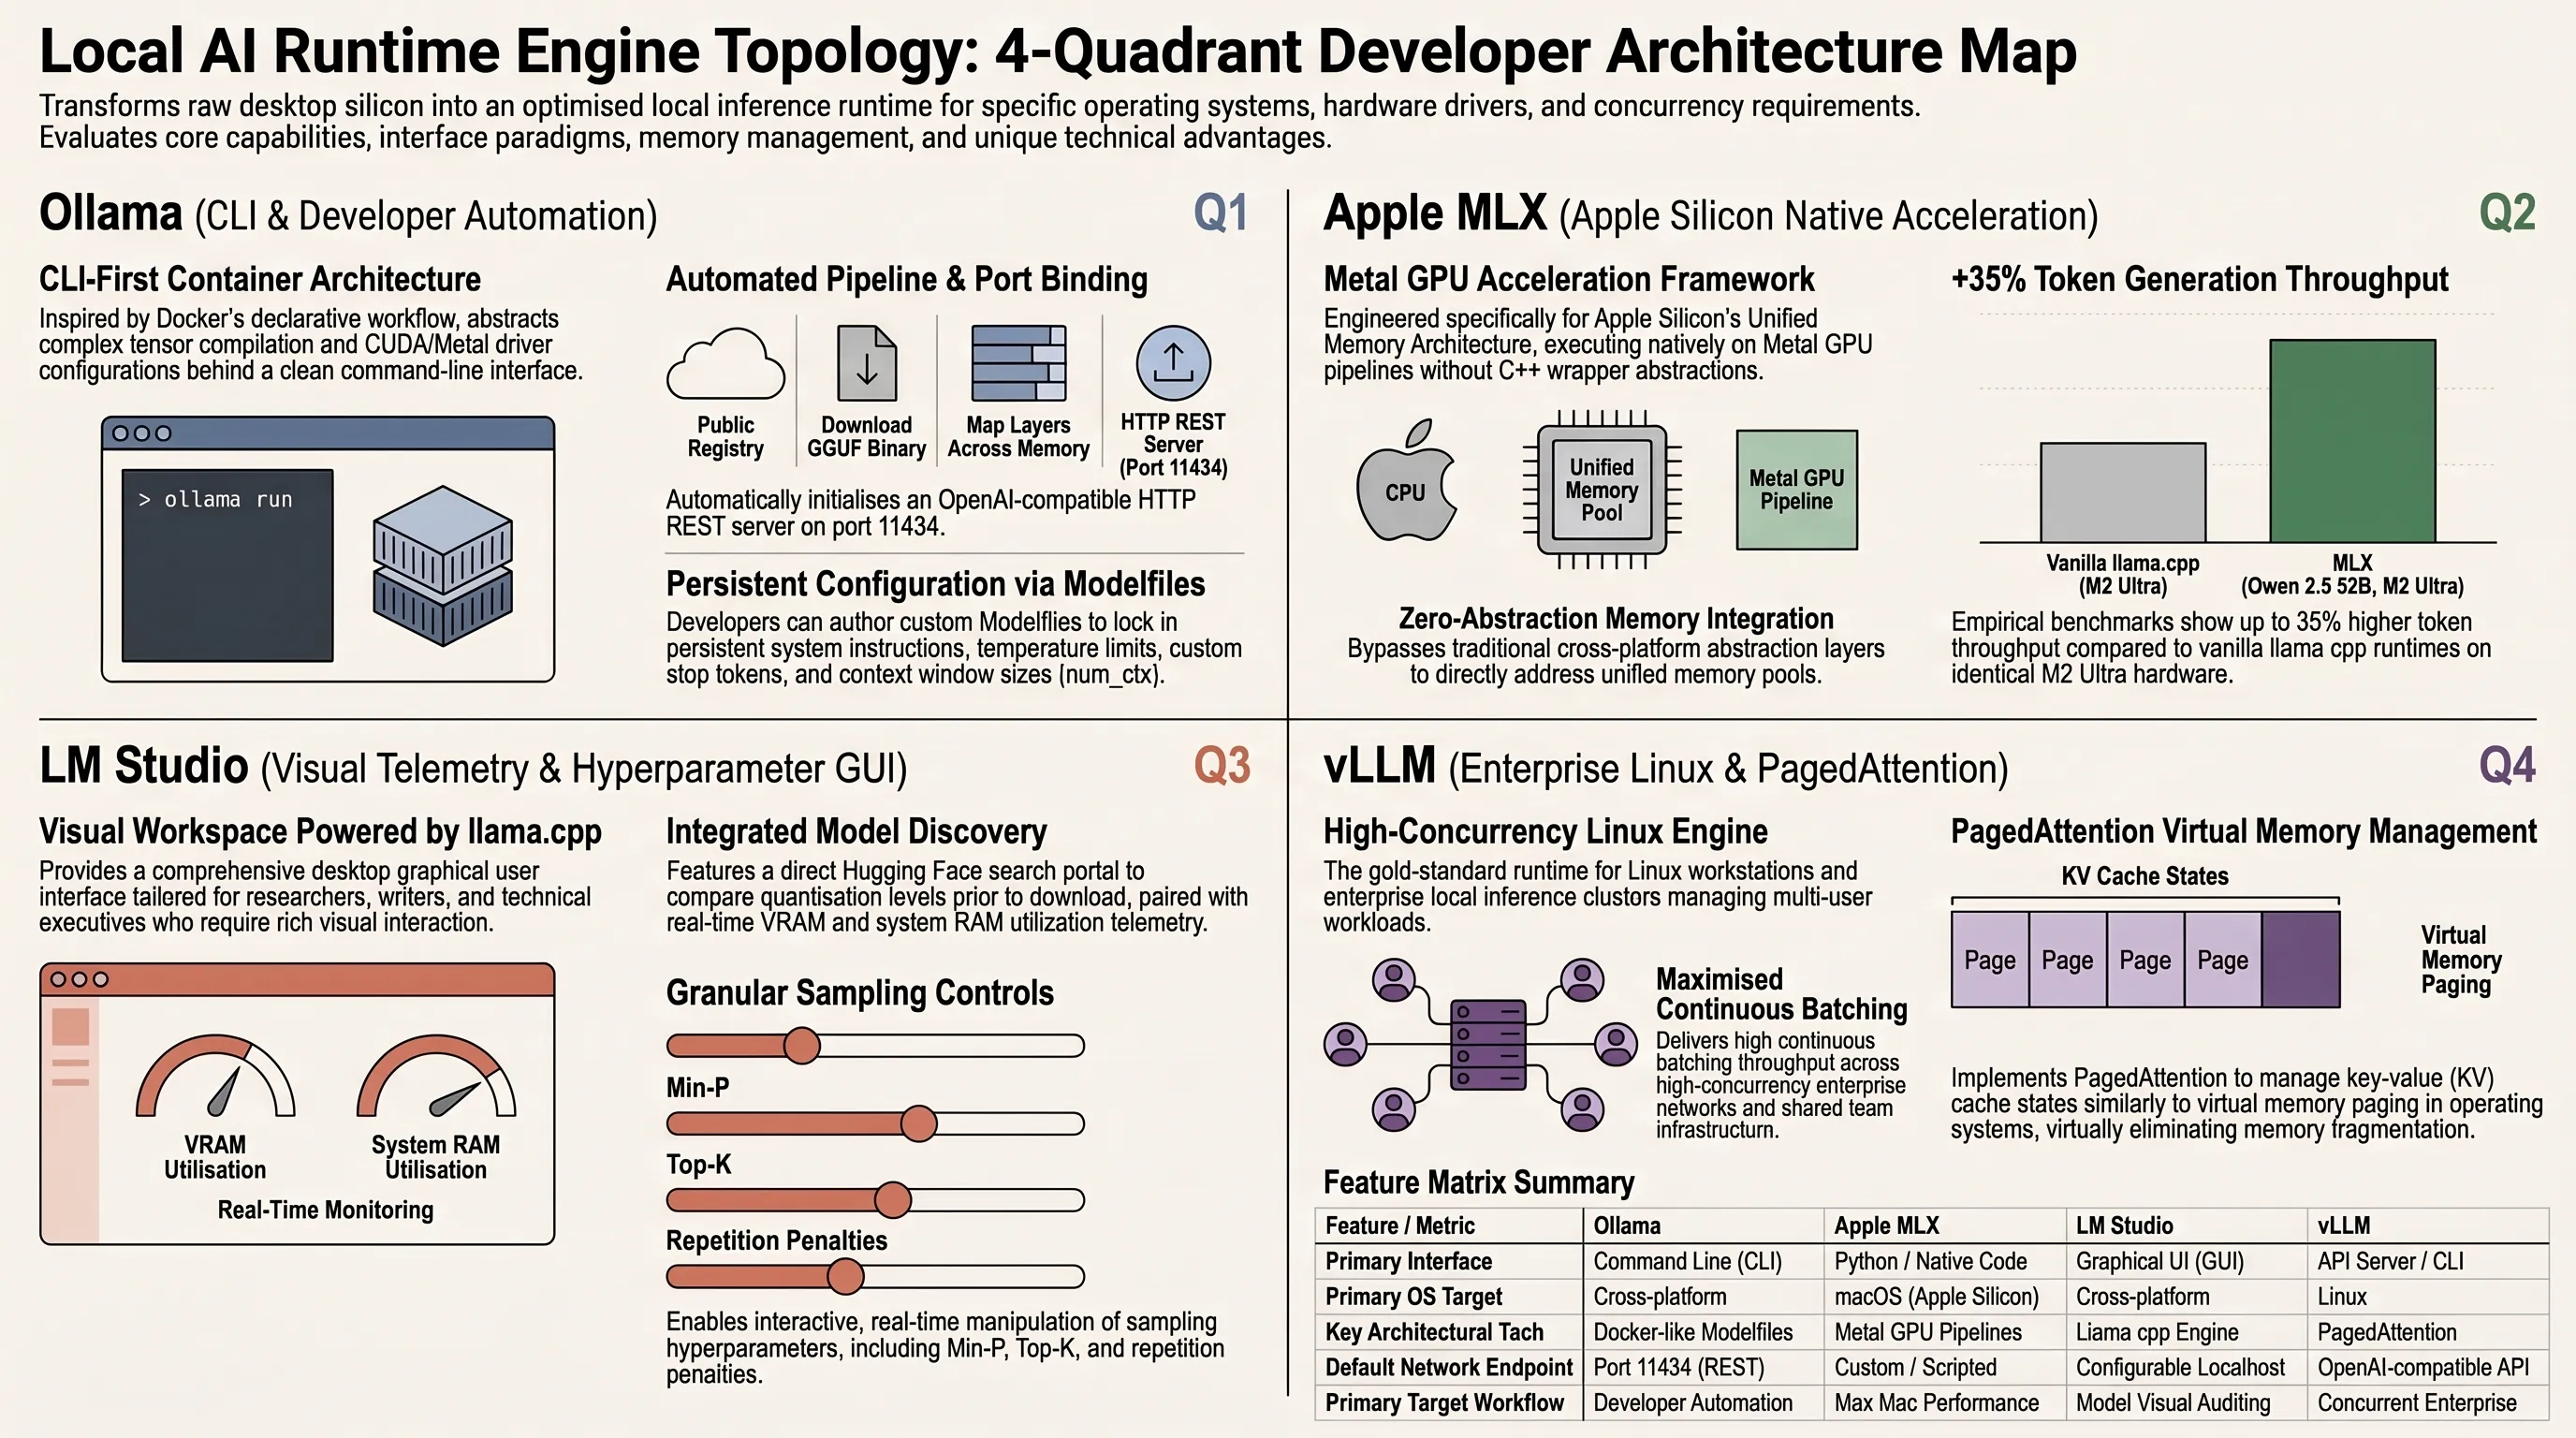
يعد إطار عمل Ollama الخيار الأكثر انتشاراً بين المطورين ومهندسي الأنظمة؛ إذ يتبنى فلسفة حاويات دوكر في تبسيط إدارة النماذج عبر سطر الأوامر. فبمجرد كتابة أمر بسيط مثل ollama run qwen2.5:14b، يقوم البرنامج آلياً بتنزيل الأوزان المضغوطة وتحميلها داخل الذاكرة وإطلاق خادم محلي متوافق مع واجهات REST عبر المنفذ 11434. ويتيح هذا المحرك ضبط تعليمات النظام وسياق الذاكرة بدقة فائقة عبر ملفات Modelfile المخصصة.
أما بالنسبة للمستخدمين والباحثين الذين يفضلون التفاعل عبر واجهة رسومية مرئية متطورة، فإن برنامج LM Studio يمثل الخيار الأبرز. يتضمن البرنامج محرك بحث مدمج يتيح استكشاف مستودعات هاغينغ فيس وتنزيل النماذج بمختلف مستويات التكميم، إلى جانب شاشة مراقبة حية توضح استهلاك الذاكرة العشوائية وسعة المعالج الرسومي لمنع حدوث أي تعطل مفاجئ للنظام.
التدقيق الهندسي: الشائعات مقابل الواقع التقني
حواسيب آبل تفتقر إلى أنوية كودا الرسومية ولا تصلح لتشغيل نماذج الذكاء الاصطناعي الضخمة مقارنة بأجهزة الحواسيب الشخصية المزودة ببطاقات إنفيديا.
أجهزة Mac Studio بذاكرة 192 جيجابايت هي الأجهزة الوحيدة القادرة على استيعاب نماذج 70B و 120B بالكامل بتكلفة عتادية تقل عن 5 آلاف دولار.
وعلى أجهزة ماك المزودة بمعالجات آبل سيليكون، يبرز إطار عمل Apple MLX كحل برمجي أصيل ومثالي. طُور هذا المحرك مفتوح المصدر للاستفادة الكاملة من مكتبات Metal الرسومية ومعمارية الذاكرة الموحدة؛ مما يوفر زيادة في سرعة إنتاج الرموز تصل إلى 35% مقارنة بمكتبات llama.cpp التقليدية على نفس الجهاز المكتبي.
وفي بيئات الإنتاج المؤسسية وخوادم لينكس التي تخدم فرق عمل متعددة في آن واحد، يحافظ محرك vLLM على صدارته العالمية المطلقة. بفضل تقنية PagedAttention المستوحاة من إدارة الذاكرة الافتراضية في أنظمة التشغيل، يلغي هذا المحرك الهدر في ذاكرة التخزين المؤقت، مما يتيح معالجة دفعات متزامنة من الاستفسارات بأعلى كفاءة حوسبية ممكنة.
قاموس تيكين للمصطلحات التقنية المتقدمة
التشريح الهندسي للتكميم: من صيغة Q4_K_M إلى الدقة الكاملة FP16
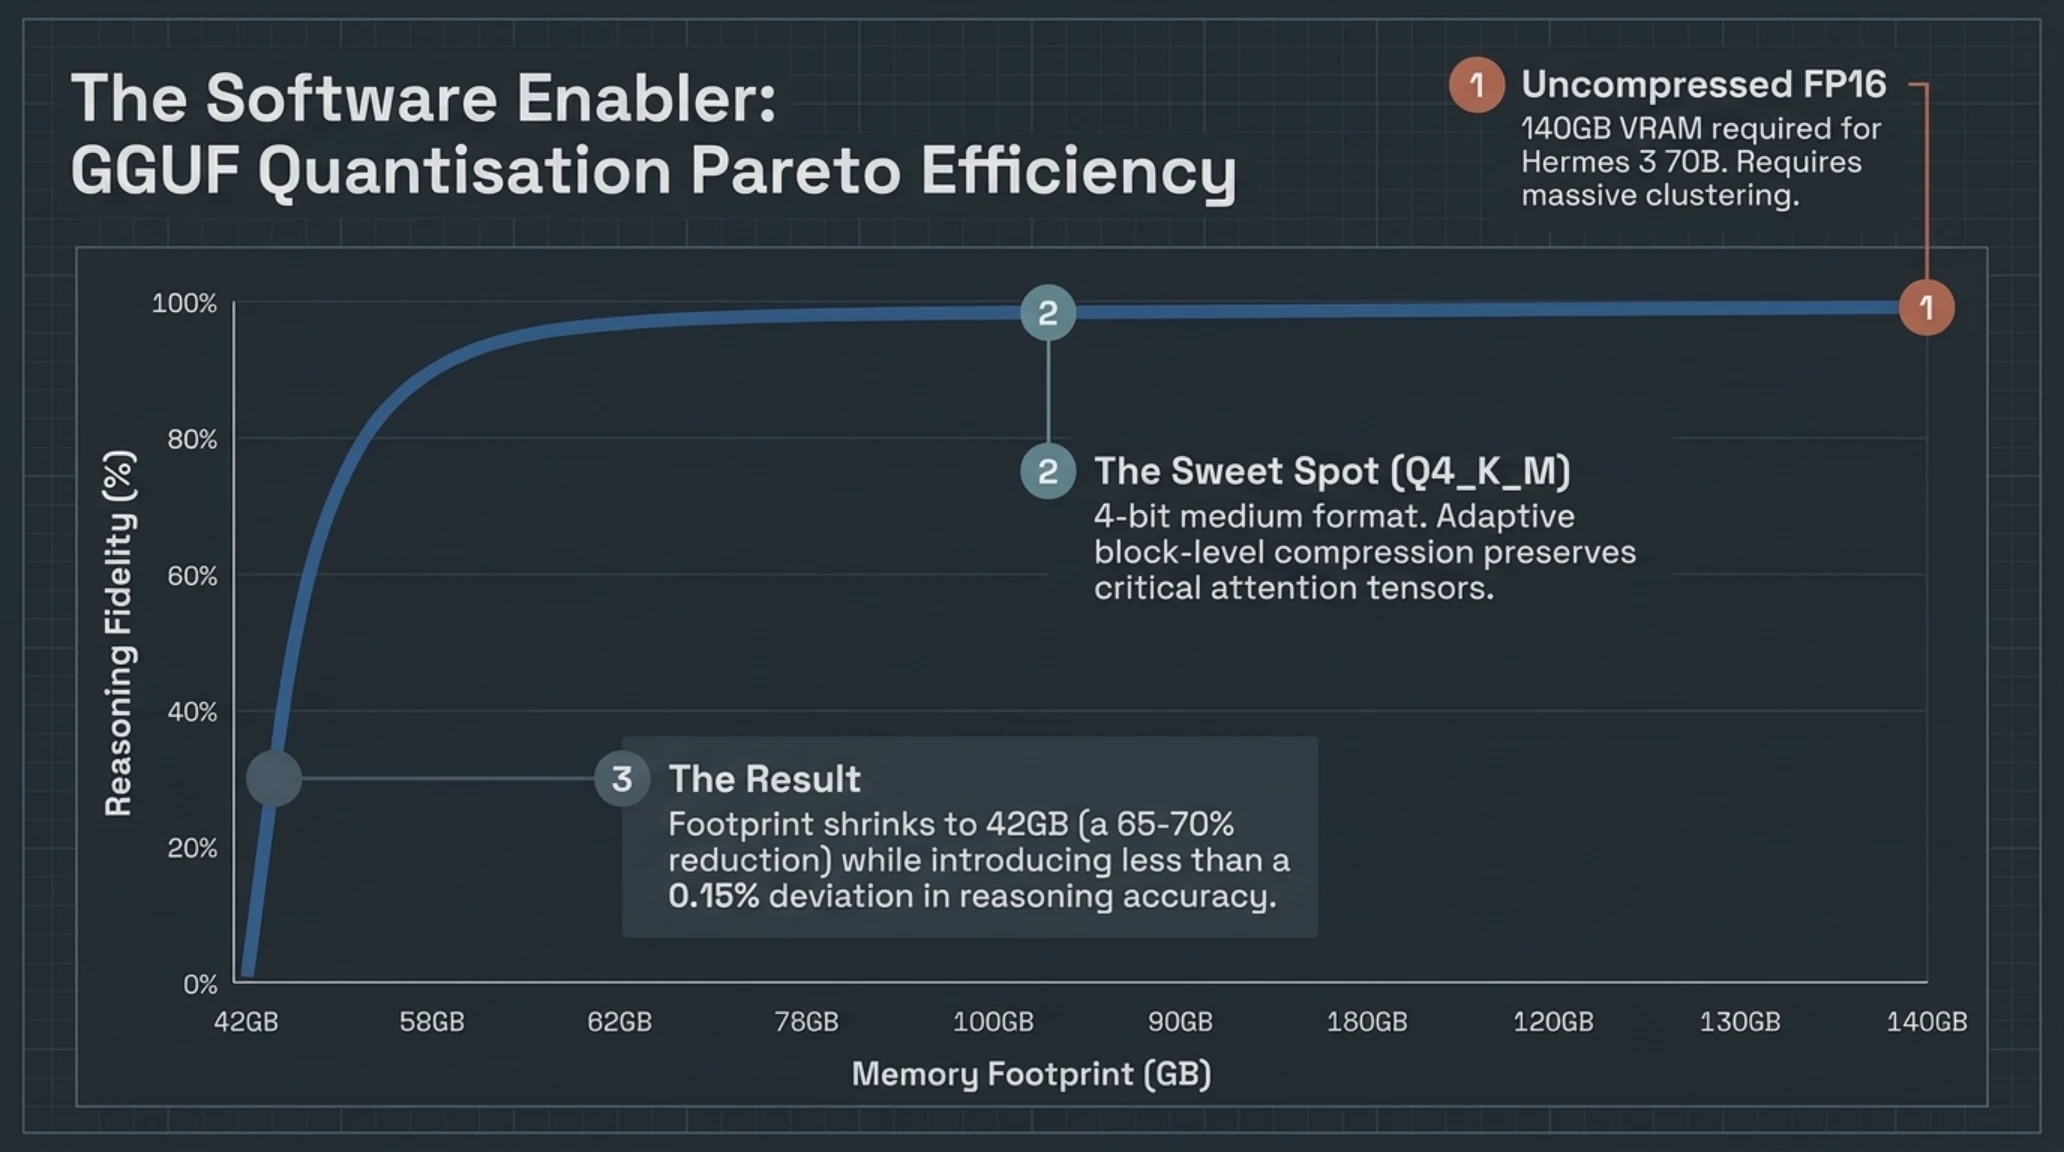
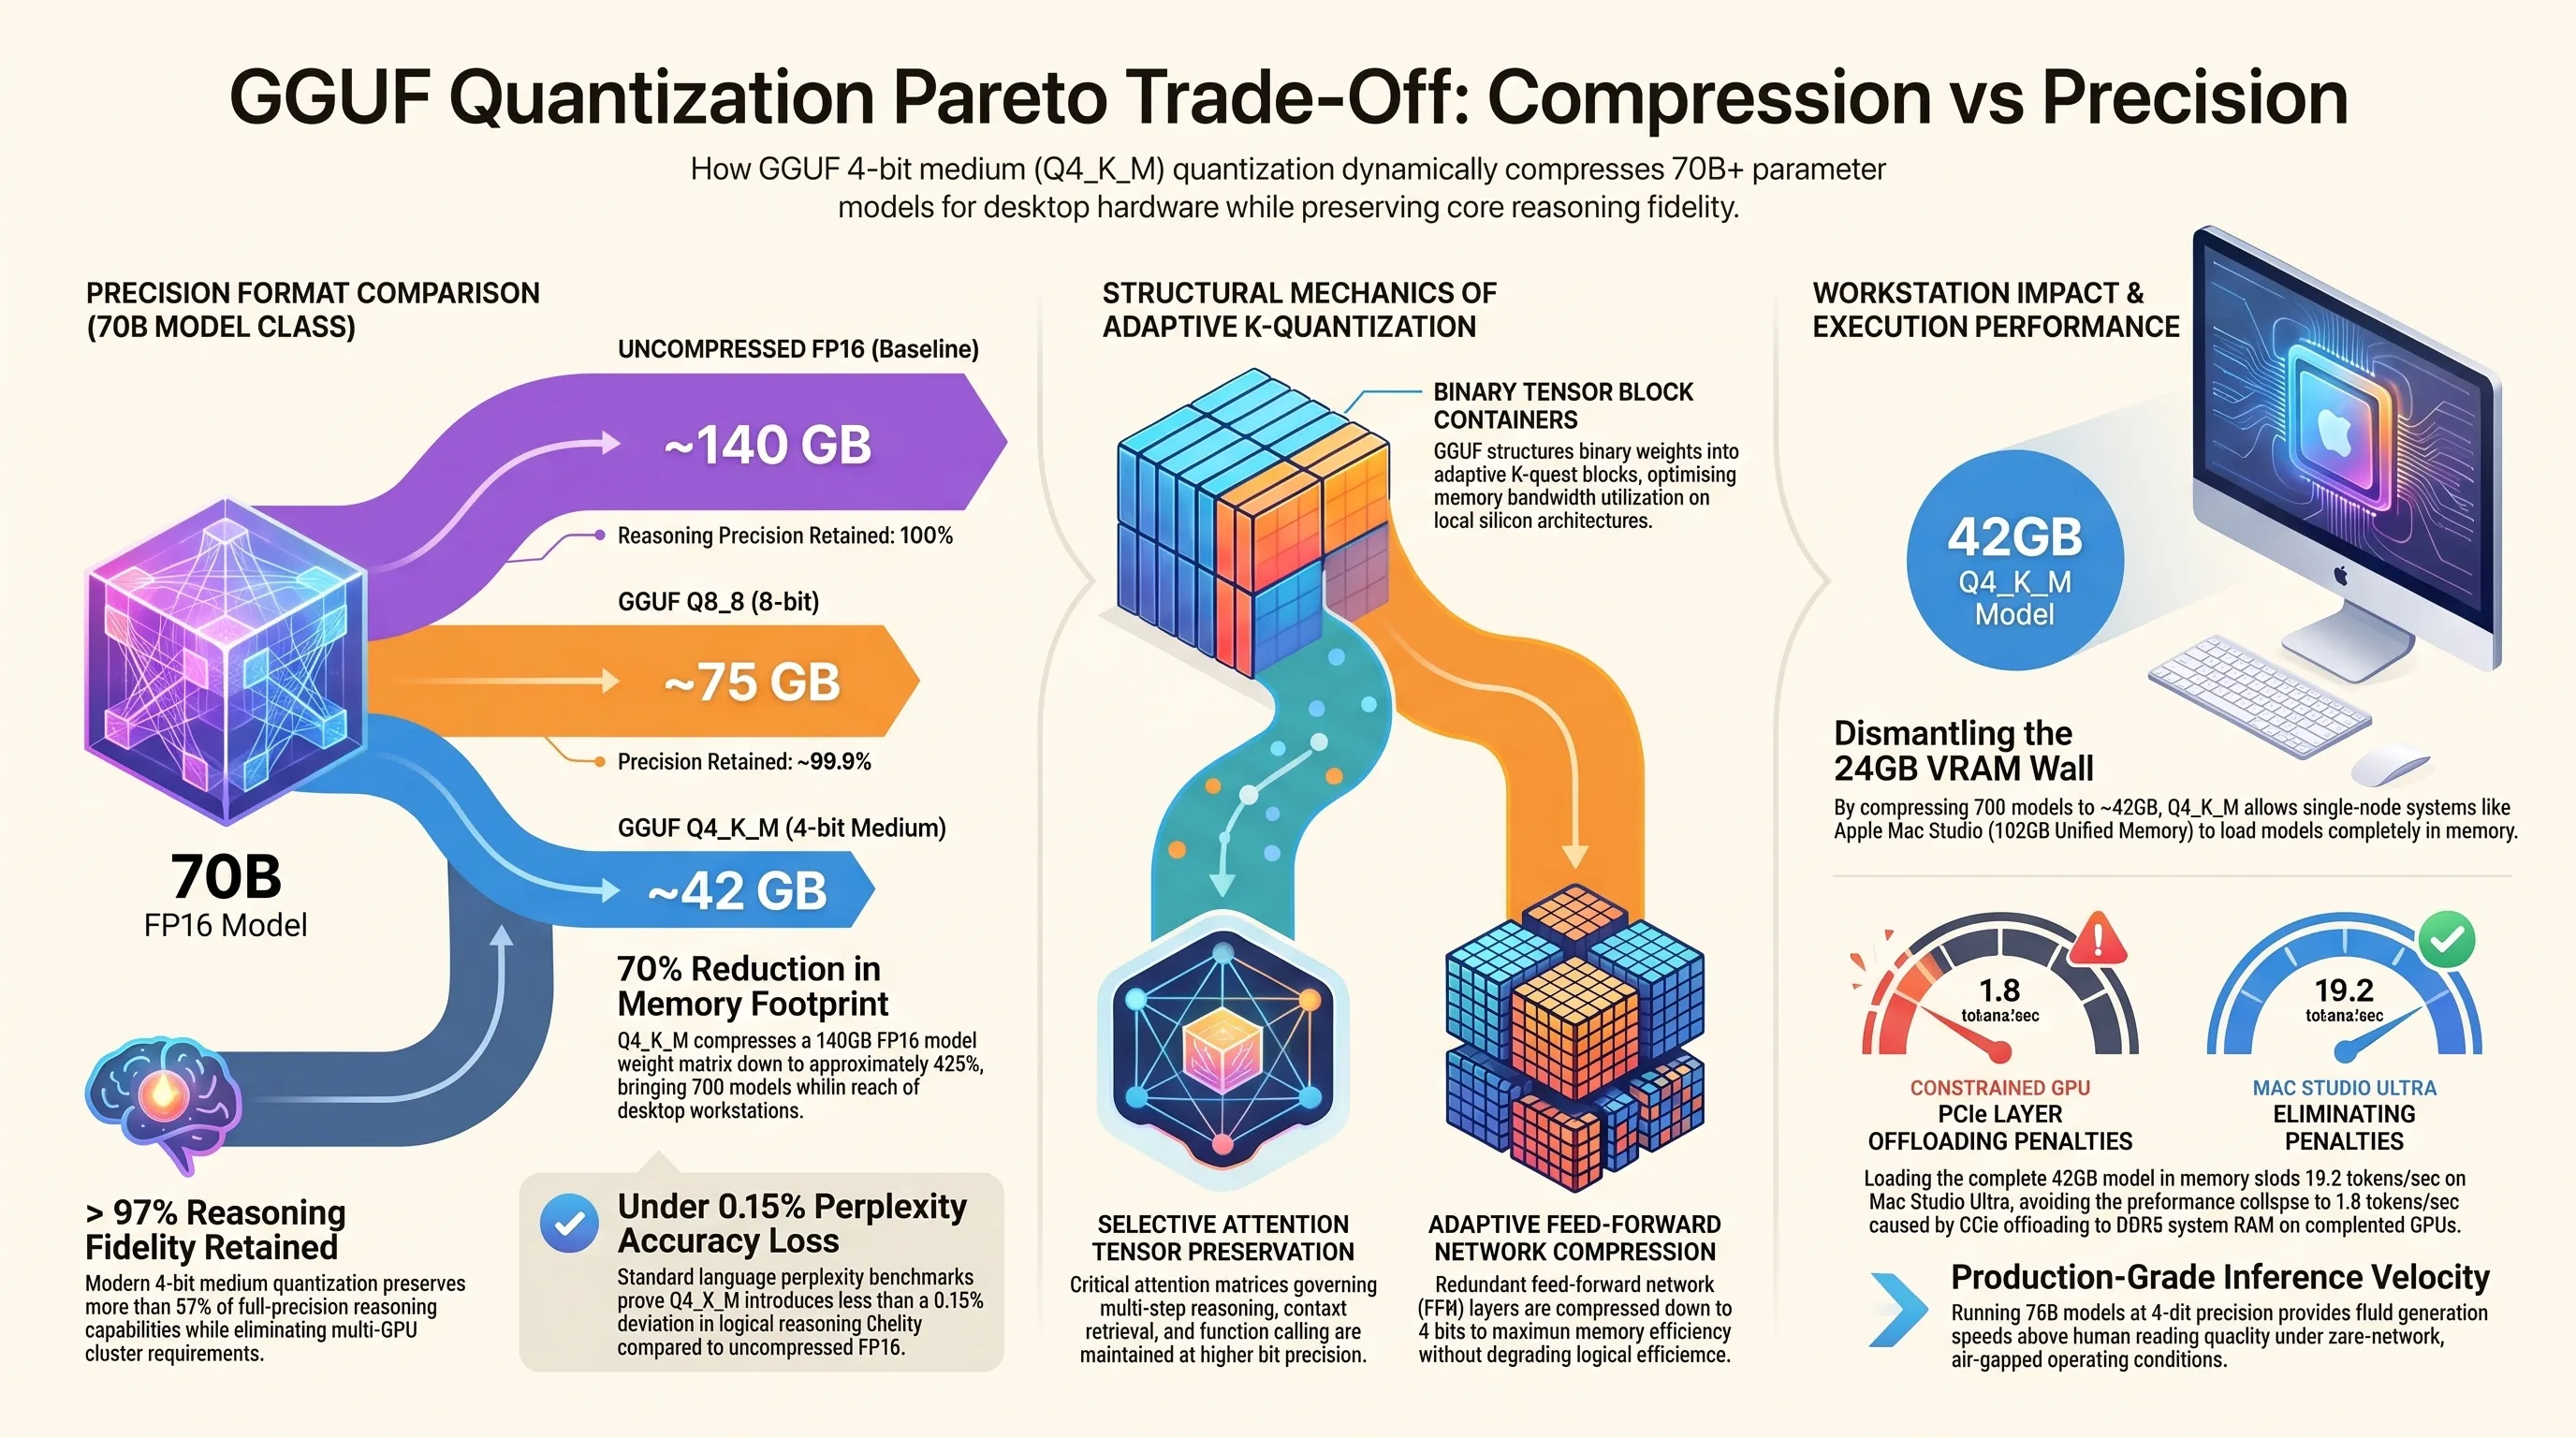
عند فحص أوزان النماذج المنشورة على منصات المصادر المفتوحة، يواجه المهندسون تسميات تقنية متعددة مثل Q4_K_M و Q5_K_M و Q8_0. في الدقة الأصلية الكاملة (FP16)، يتطلب كل معامل حوسبي 2 بايت من الذاكرة؛ مما يعني أن نموذج Hermes 3 70B يحتاج إلى 140 جيجابايت من الذاكرة العشوائية لمجرد تشغيله في وضعه الخام.
تتغلب تقنية التكميم الحديثة (K-Quants) على هذه المعضلة عبر ضغط أوزان الطبقات الأقل تأثيراً إلى 4 بت، مع الحفاظ على دقة أعلى لطبقات الانتباه الحساسة المسؤولة عن الاستدلال المنطقي. ونتيجة لذلك، يتقلص حجم نموذج 70B من 140 جيجابايت إلى نحو 42 جيجابايت فقط في صيغة Q4_K_M؛ مما يتيح تشغيله بسلاسة تامة، مع تسجيل انخفاض طفيف لا يتجاوز 0.2% في مقاييس الارتباك اللغوي (Perplexity).
حماية السيادة الرقمية للشركات في منطقة الخليج والشرق الأوسط
تكتسب الحوسبة المحلية أهمية بالغة للمؤسسات والهيئات في دبي والرياض وأبوظبي، حيث تفرض أطر الحوكمة الرقمية وقوانين حماية البيانات الشخصية اشتراطات صارمة على تخزين ومعالجة المعلومات الحساسة. فاستخدام الخدمات السحابية الخارجية ينطوي على مخاطر التعرض لثغرات الأطراف الثالثة أو التغييرات غير المعلنة في سياسات استخدام البيانات لأغراض تدريب النماذج المستقبلية.
ومن خلال نشر محطات عمل معزولة شبكياً (Air-gapped) داخل بيئة العمل، تضمن البنوك وشركات الطاقة ومكاتب الاستشارات القانونية بقاء الأكواد البرمجية وسجلات العملاء مشفرة ومحمية محلياً بنسبة 100%. إن هذا النهج لا يحقق التوافق التام مع المعايير التنظيمية الوطنية فحسب، بل يمنح المؤسسات استقلالية تكنولوجية كاملة ومناعة مطلقة ضد أي انقطاعات في شبكات الإنترنت الدولية.
الرسم البياني ومصفوفة مقارنة الأداء المخبري للعتاد
| النموذج والبيئة التشغيلية | بطاقة NVIDIA RTX 4090 (24GB) | جهاز Apple Mac Studio Ultra (192GB) |
|---|---|---|
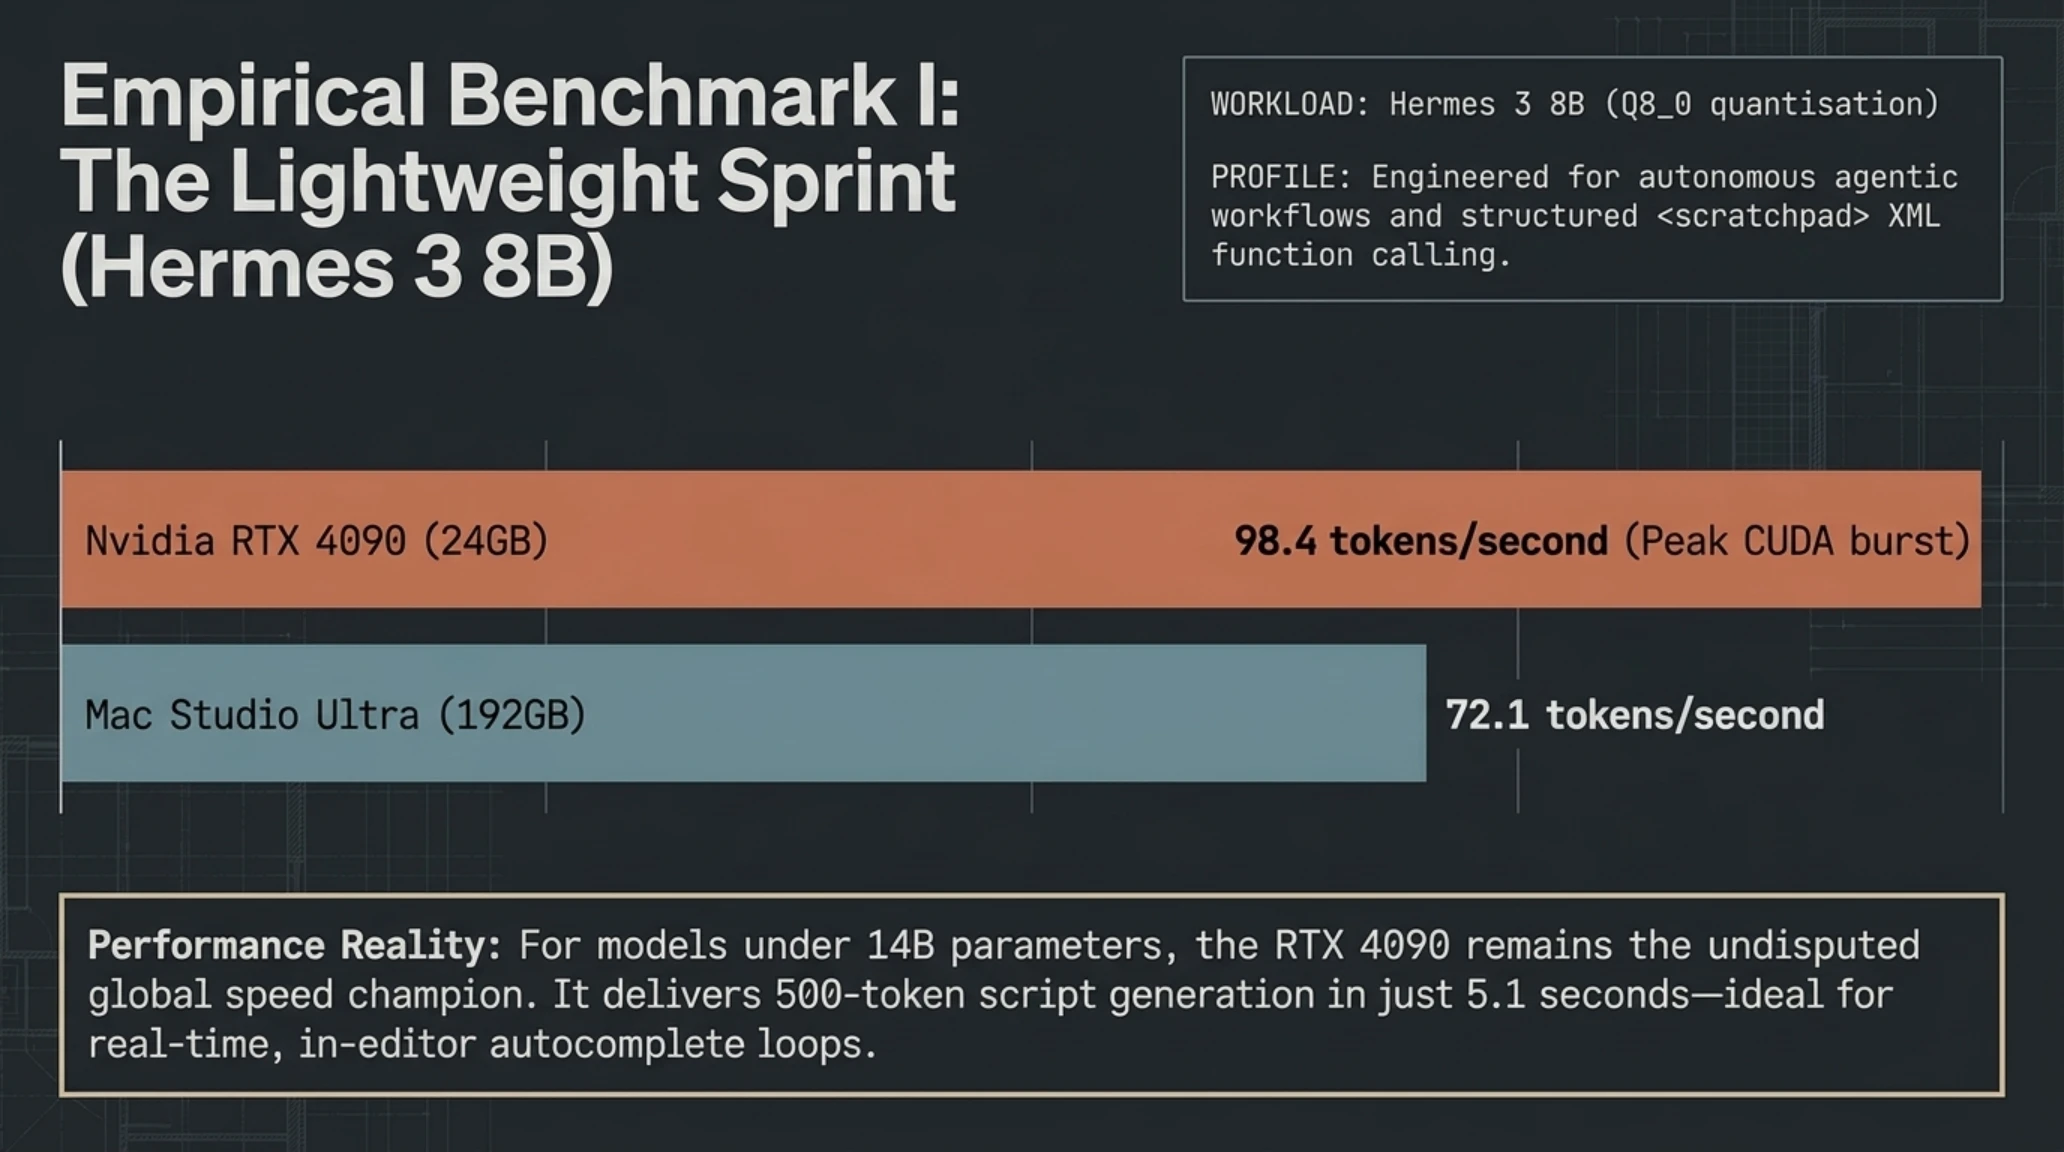
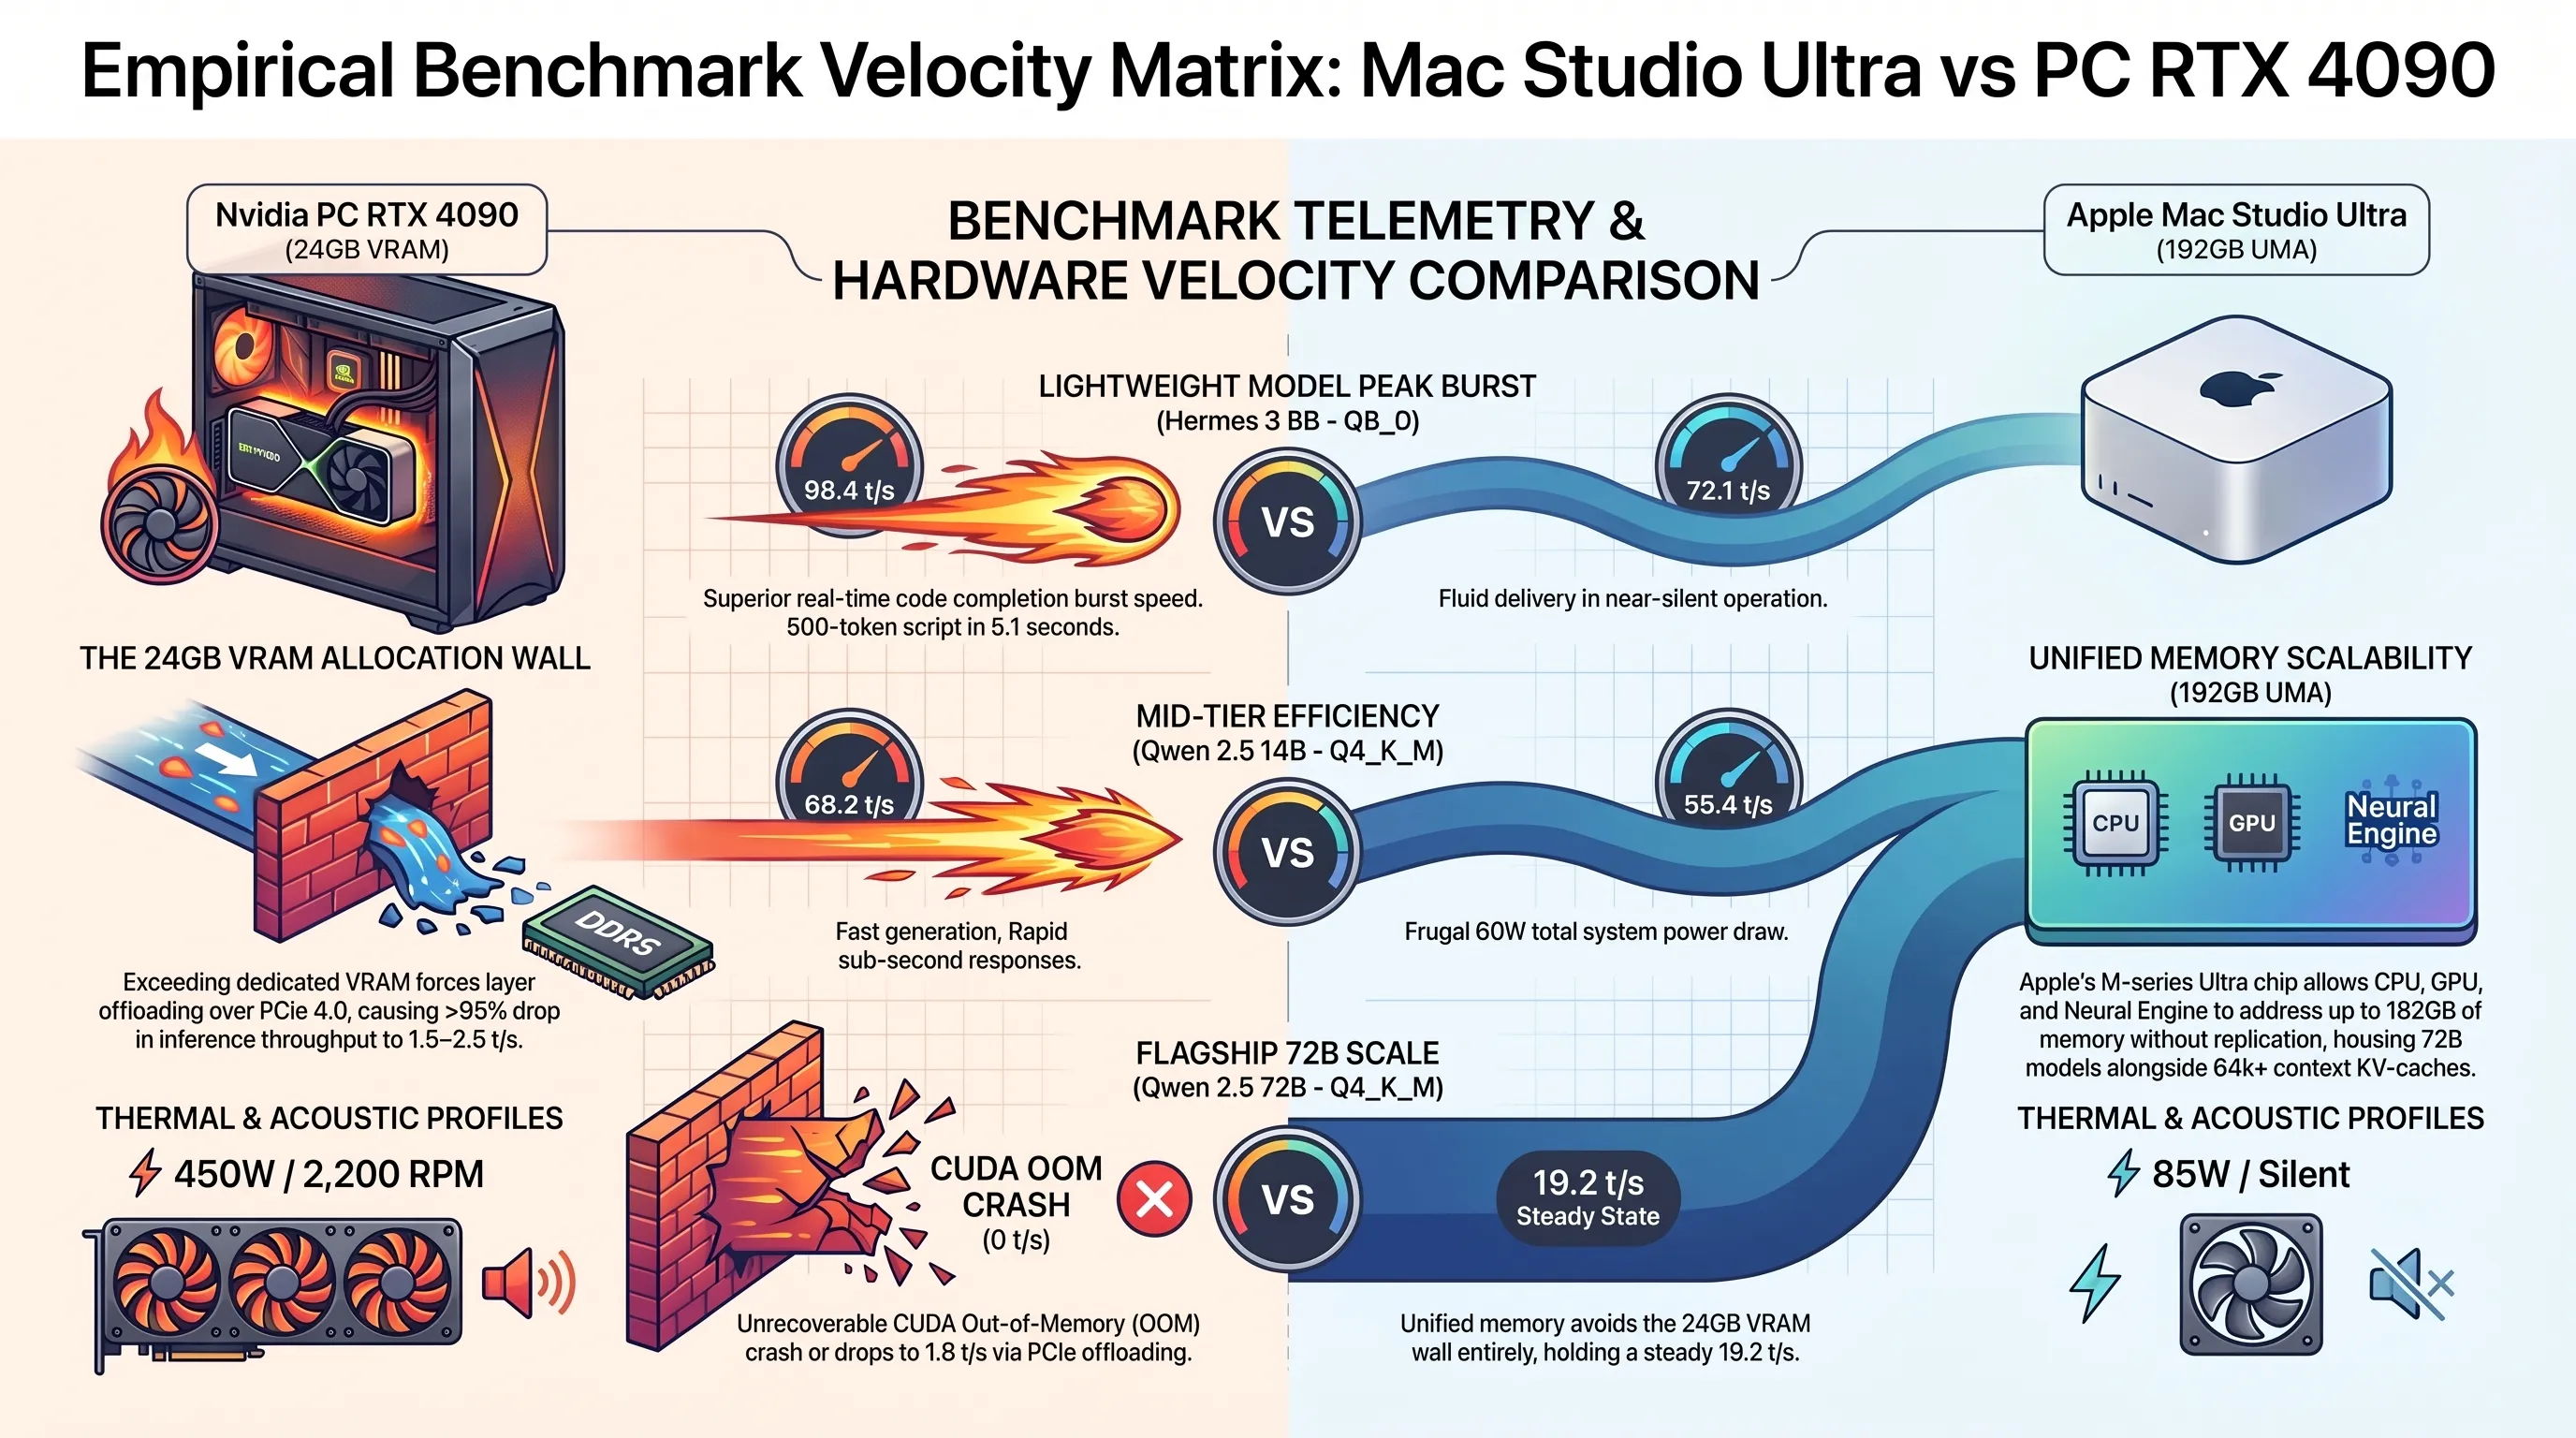
| النموذج الخفيف Hermes 3 (8B - Q8_0) | 98.4 رمز في الثانية (استجابة فورية خارقة) | 72.1 رمز في الثانية (تشغيل هادئ ومستقر) |
| النموذج المتوسط Qwen 2.5 (14B - Q4_K_M) | 68.2 رمز في الثانية (إنجاز فوري للأوامر) | 55.4 رمز في الثانية (استهلاك طاقة 60 واط فقط) |
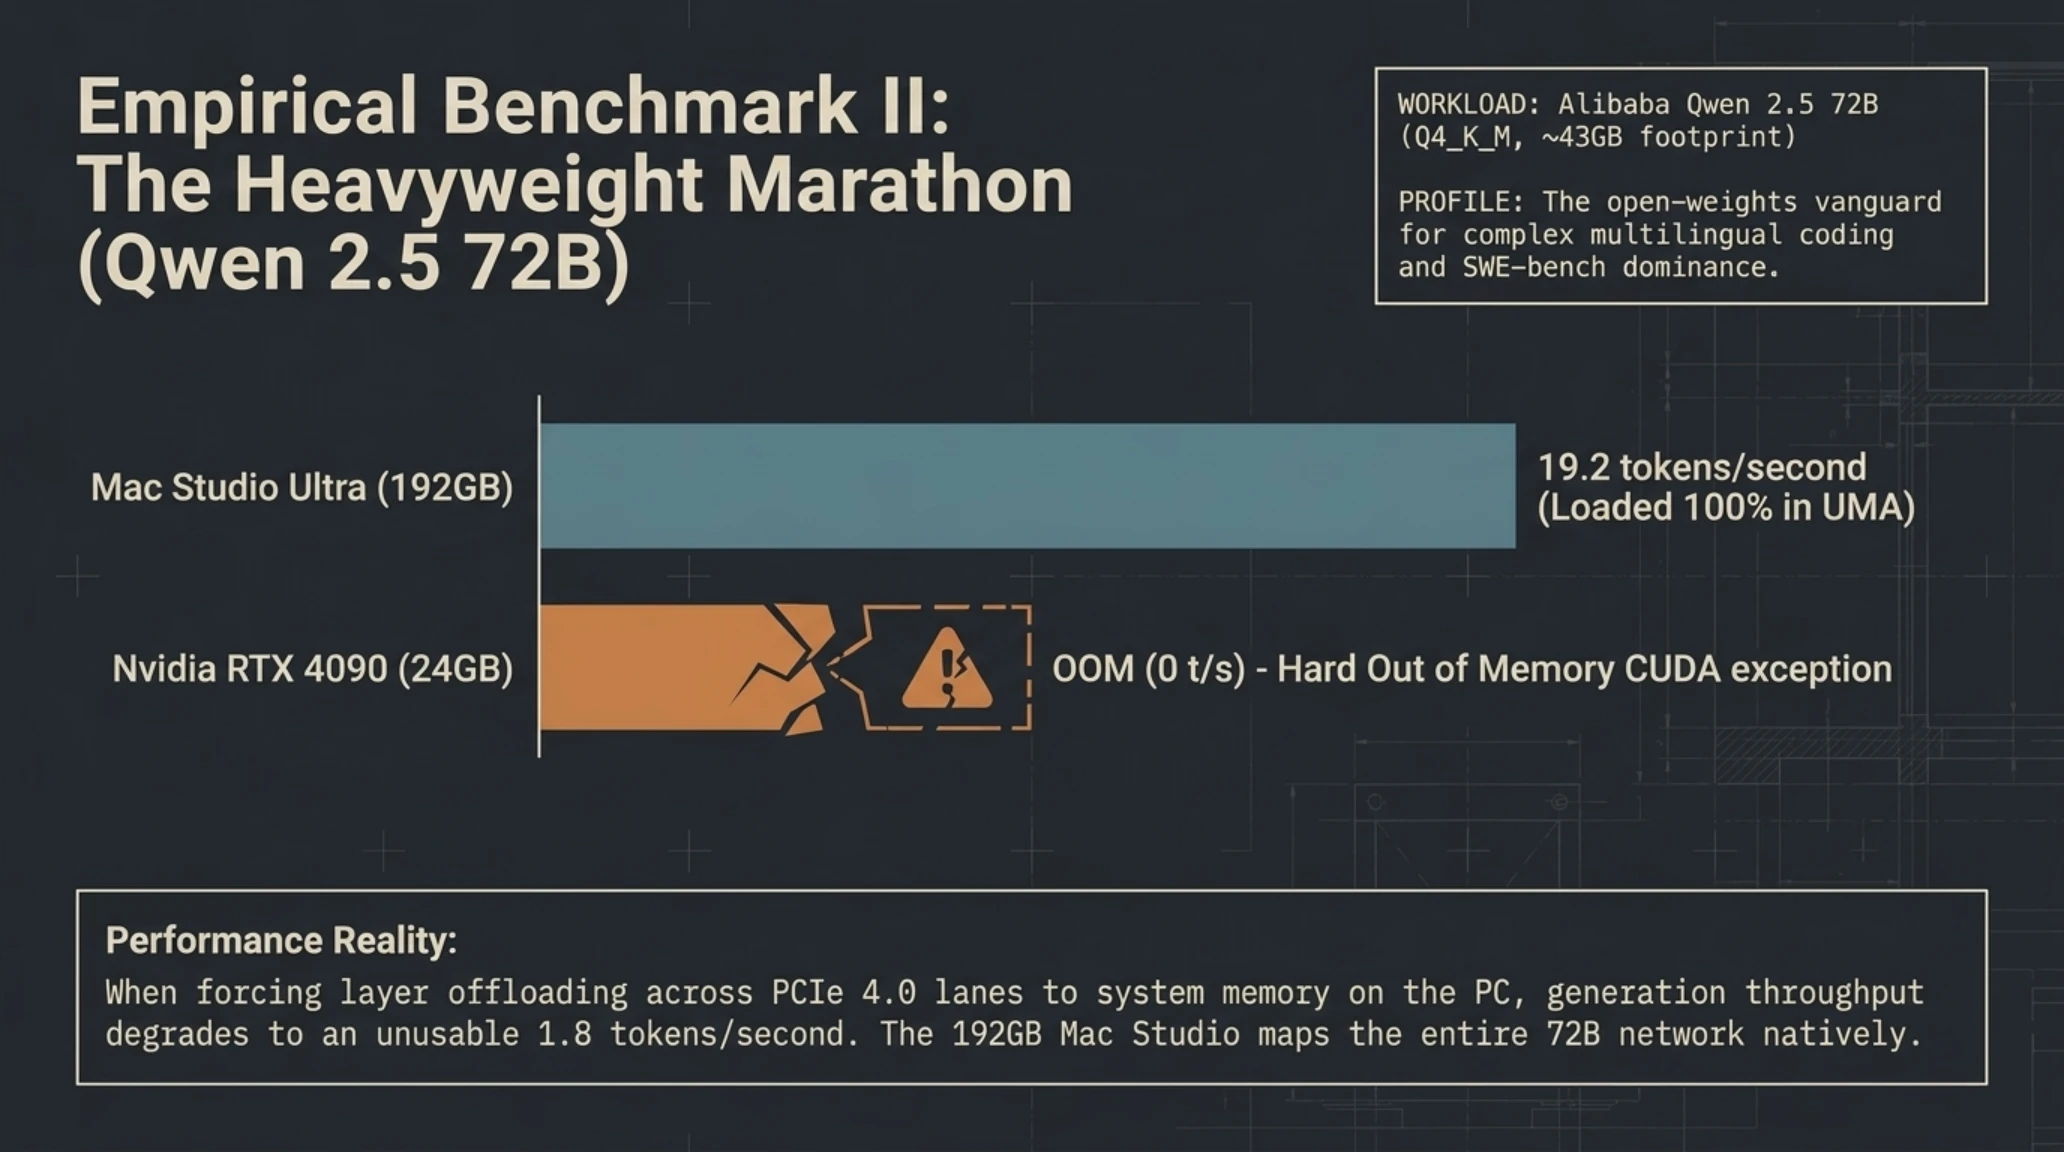
| النموذج العملاق Qwen 2.5 (72B - Q4_K_M) | توقف كامل بخطأ نفاد الذاكرة (OOM) | 19.2 رمز في الثانية (محمل بالكامل في الذاكرة) |
📚 الملفات الاستخباراتية المصنفة وذات الصلة في تكين غيم
إذا كنت ترغب في التعمق أكثر واكتشاف أحدث تطورات الذكاء الاصطناعي السيبراني والبنى التحتية المستقلة، فلا تفوت تشريح هذه الملفات الحصرية في تكين غاراج:
نتائج الاختبارات المخبرية؛ سرعة إنتاج الرموز وزمن معالجة الاستفسار الأول
للوصول إلى أرقام هندسية مجردة، أجرى مختبر تيكين سلسلة من الاختبارات الموحدة باستخدام استفسارات معيارية بطول 1000 رمز وقياس سرعة إخراج إجابة مكتملة بطول 500 رمز. وركز التقييم على معيارين أساسيين: زمن استجابة الرمز الأول (Time-to-First-Token)، وسرعة إنتاج الرموز المستمرة (Tokens Per Second).
في اختبار النموذج الخفيف Hermes 3 8B بدقة Q8_0 العالية، استعرضت بطاقة RTX 4090 تفوقها الكاسح في النطاق الترددي لذاكرة GDDR6X؛ حيث سجلت سرعة بلغت 98.4 رمزاً في الثانية، مما جعل الإجابة تظهر على الشاشة في غضون 5 ثوانٍ فقط. وسجل جهاز Mac Studio M2 Ultra سرعة متميزة بلغت 72.1 رمزاً في الثانية، وهي سرعة ممتازة ومريحة للغاية للعمل اليومي.
غير أن المعادلة انقلبت تماماً عند الانتقال إلى النماذج العملاقة؛ فعند محاولة تحميل نموذج Qwen 2.5 72B بصيغة Q4_K_M التي تتطلب نحو 43 جيجابايت من الذاكرة، توقفت بطاقة إنفيديا فوراً بسبب نفاد الذاكرة الرسومية (OOM). وأدى تفعيل التخزين المؤقت على ذاكرة النظام إلى هبوط السرعة إلى 1.8 رمز في الثانية فقط. في المقابل، استوعب جهاز Mac Studio النموذج بالكامل داخل ذاكرته الموحدة بسعة 192 جيجابايت، محققاً سرعة ثابتة بلغت 19.2 رمزاً في الثانية دون أي تعثر أو هبوط في الأداء.
طرفية تيكين السيبرانية: سجل أوامر التشغيل المحلي
تحليل استهلاك الطاقة والكفاءة الحرارية وهدوء مساحة العمل
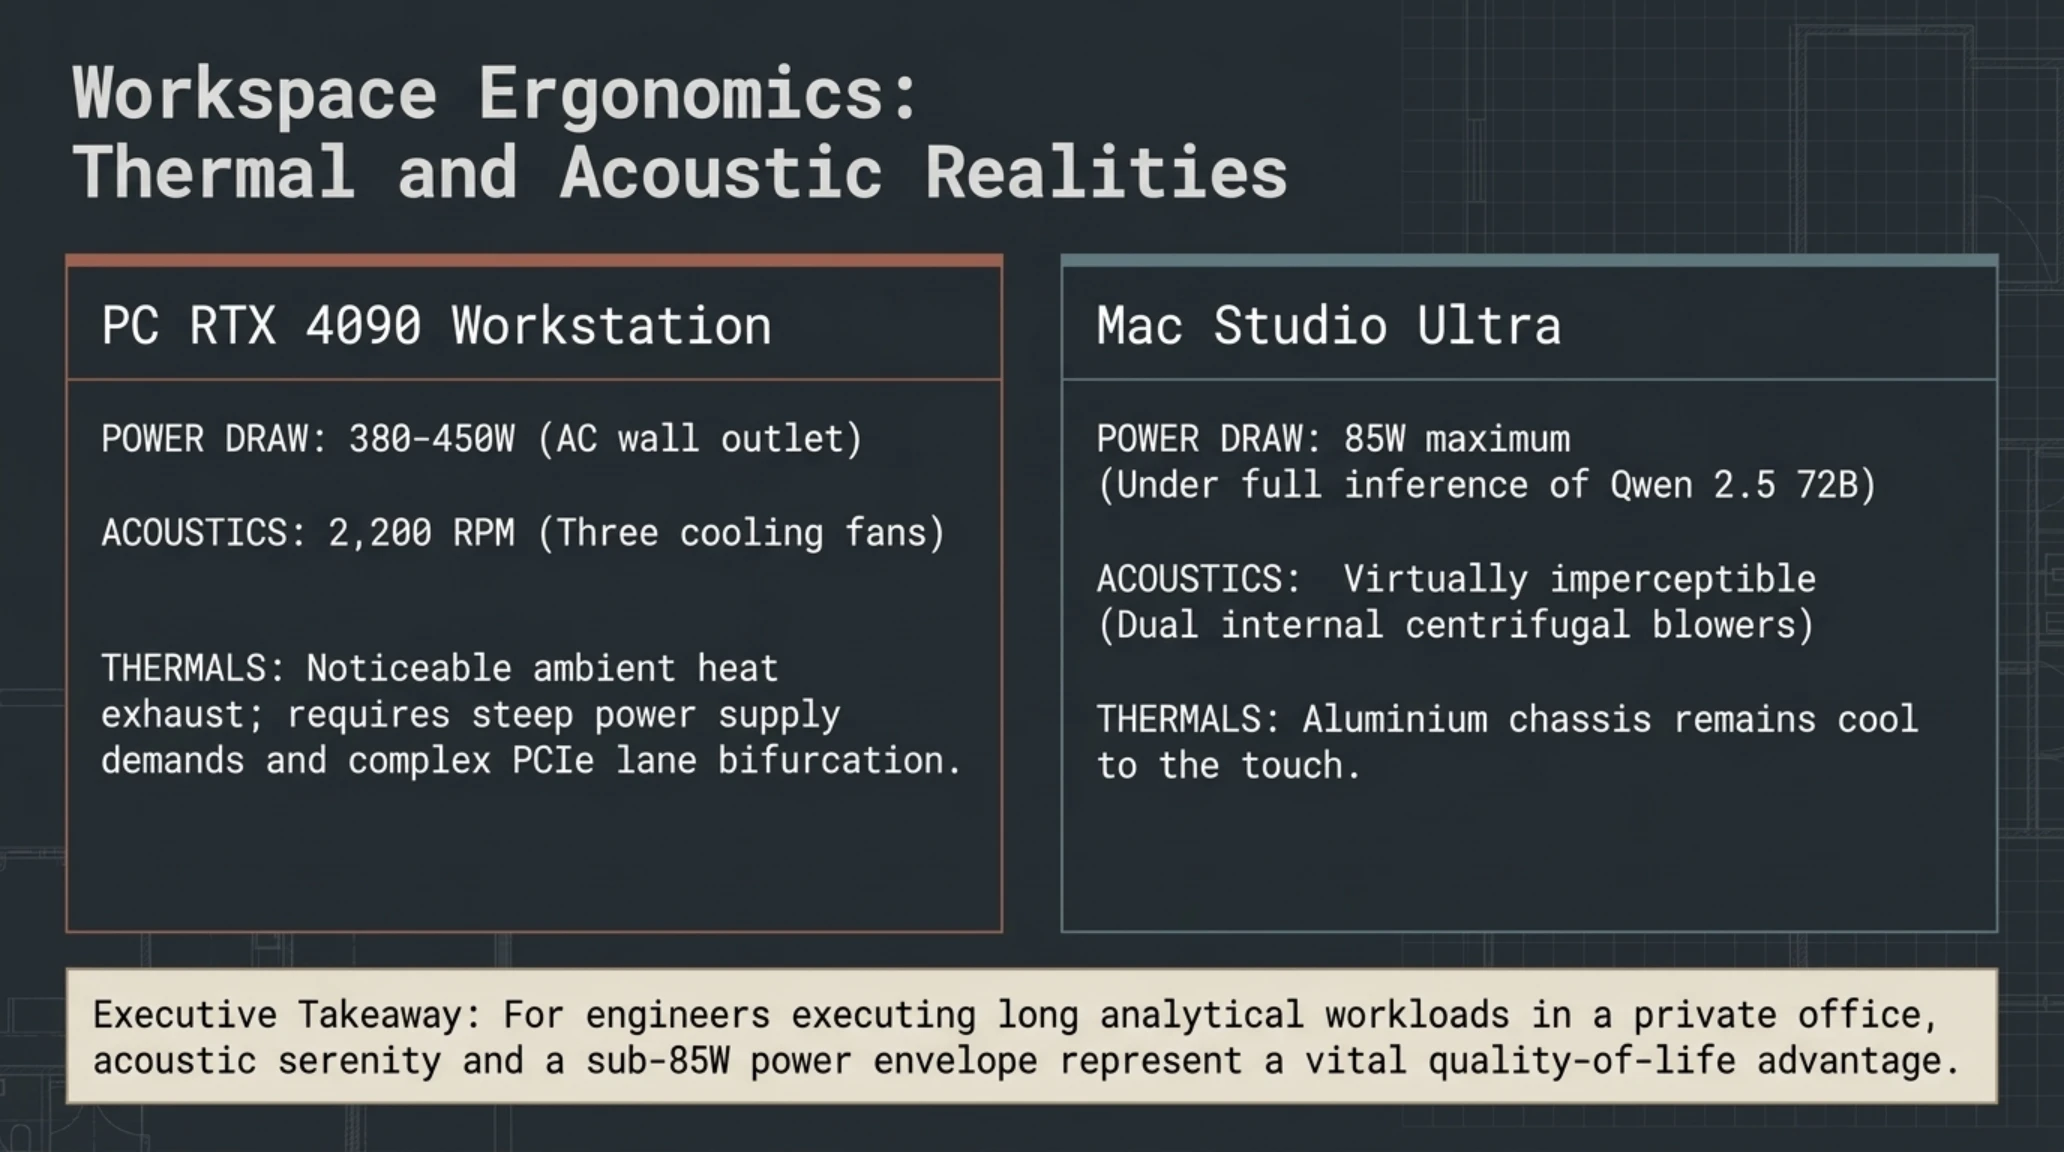
من العوامل الحاسمة التي لا تظهر في أرقام الاختبارات النظرية هو التأثير البيئي والصوتي على بيئة المكتب اليومية. فحاسوب الألعاب المزود ببطاقة RTX 4090 يستهلك ما بين 380 إلى 450 واط من مقبس الحائط أثناء معالجة النماذج؛ مما يولد حرارة مرتفعة ويشغل مراوح التبريد الثلاث بسرعة تصل إلى 2200 دورة في الدقيقة مسببة ضجيجاً ملحوظاً.
أما جهاز Mac Studio فيقدم نموذجاً هندسياً فريداً في ترشيد الطاقة؛ حيث لا يتجاوز استهلاكه الكلي 85 واط تحت أقصى درجات الضغط الحوسبي لنموذج 72B. ويعمل الجهاز بصمت تام وتظل هيكلته المصنوعة من الألومنيوم باردة، مما يوفر بيئة عمل هادئة ومثالية للتركيز الذهني خلال جلسات العمل الممتدة.
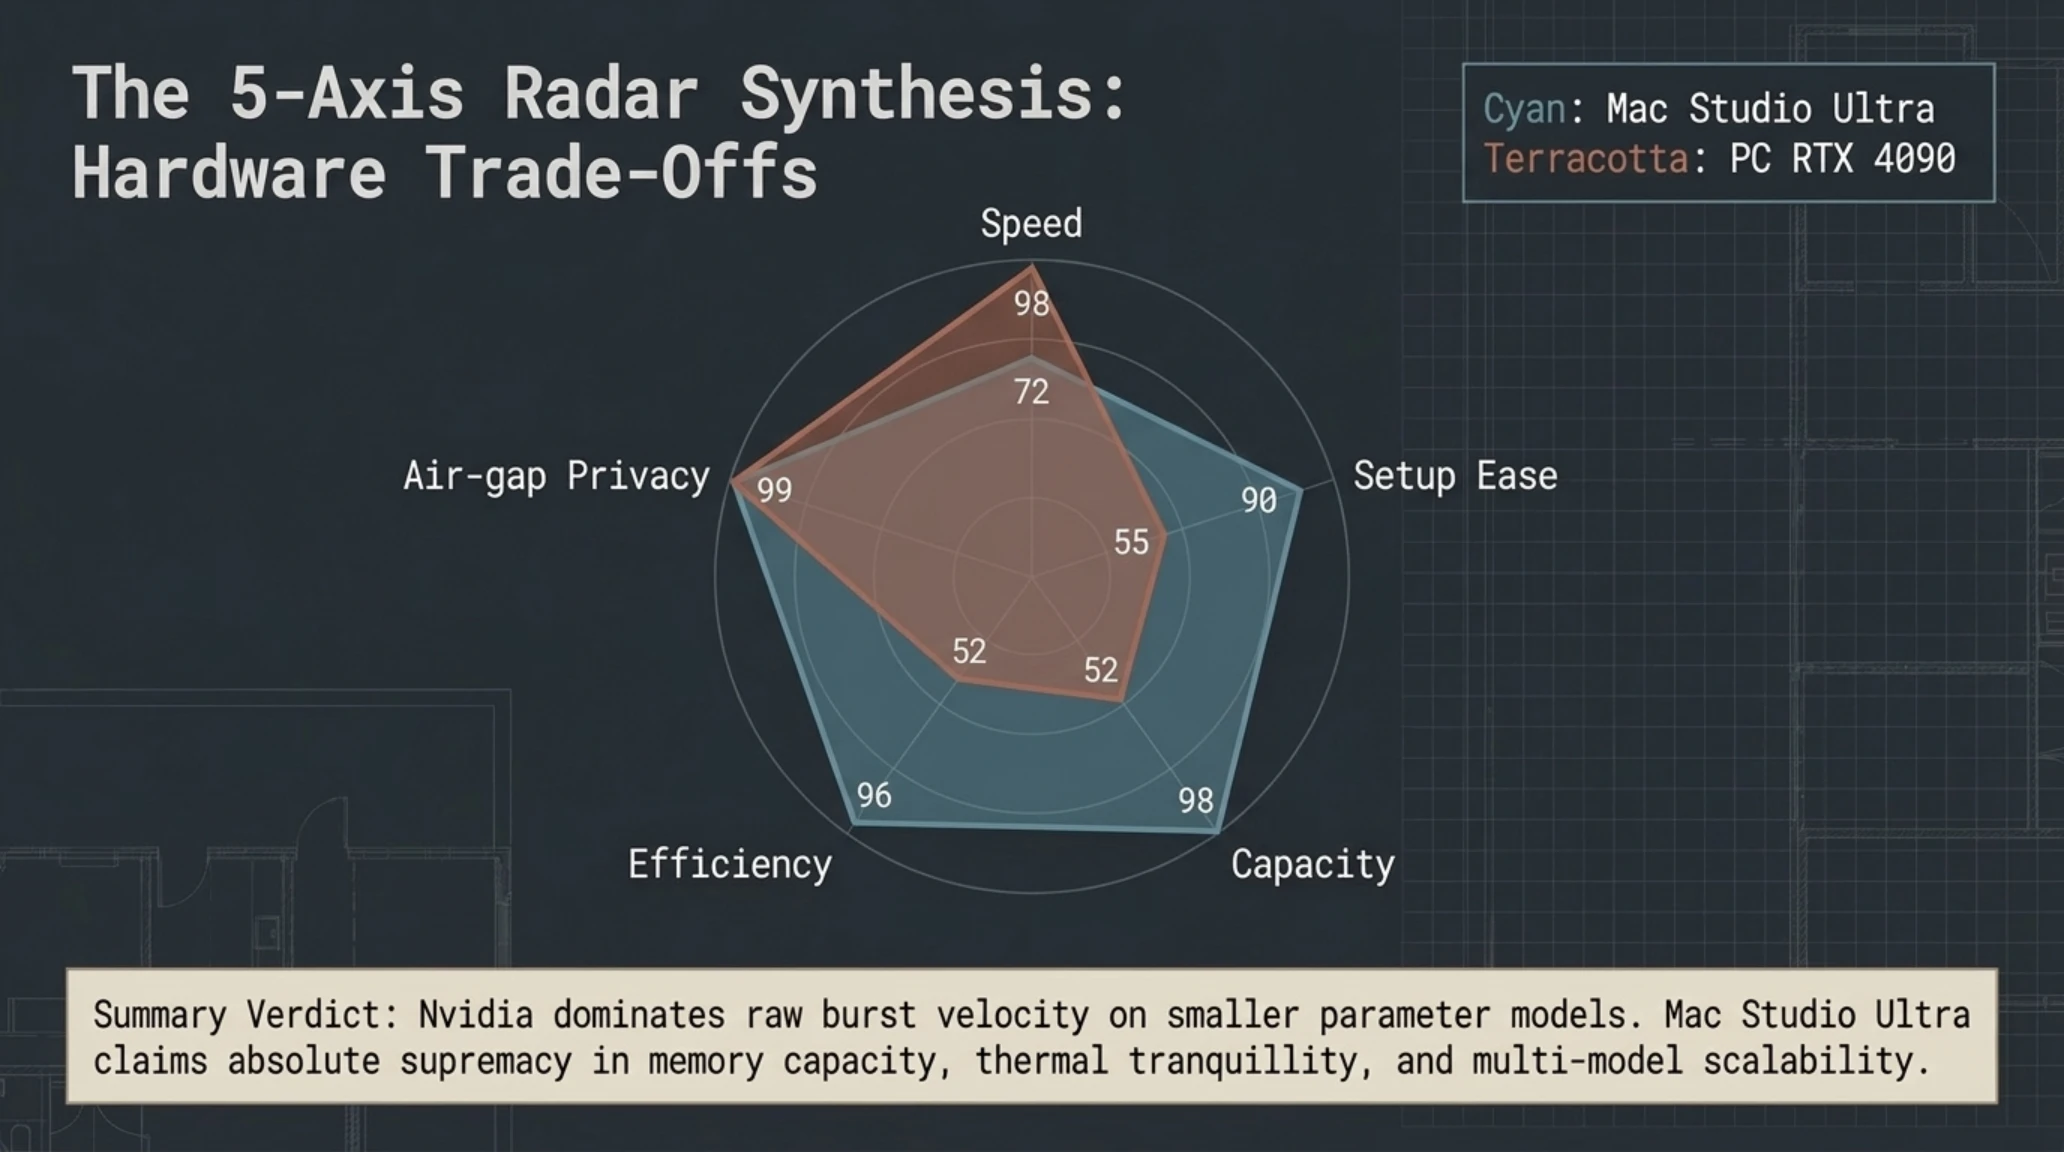
الرادار الخماسي للتقييم الشامل لمنظومة العتاد المحلي
تحليل الرادار الخماسي: تتصدر بطاقة إنفيديا في سرعة الإنتاج للنماذج الصغيرة، بينما يفرض جهاز Mac Studio هيمنته المطلقة في سعة الذاكرة والهدوء الصوتي وكفاءة استهلاك الطاقة.
إدارة نوافذ السياق الطويلة؛ التكلفة الخفية لذاكرة KV-Cache
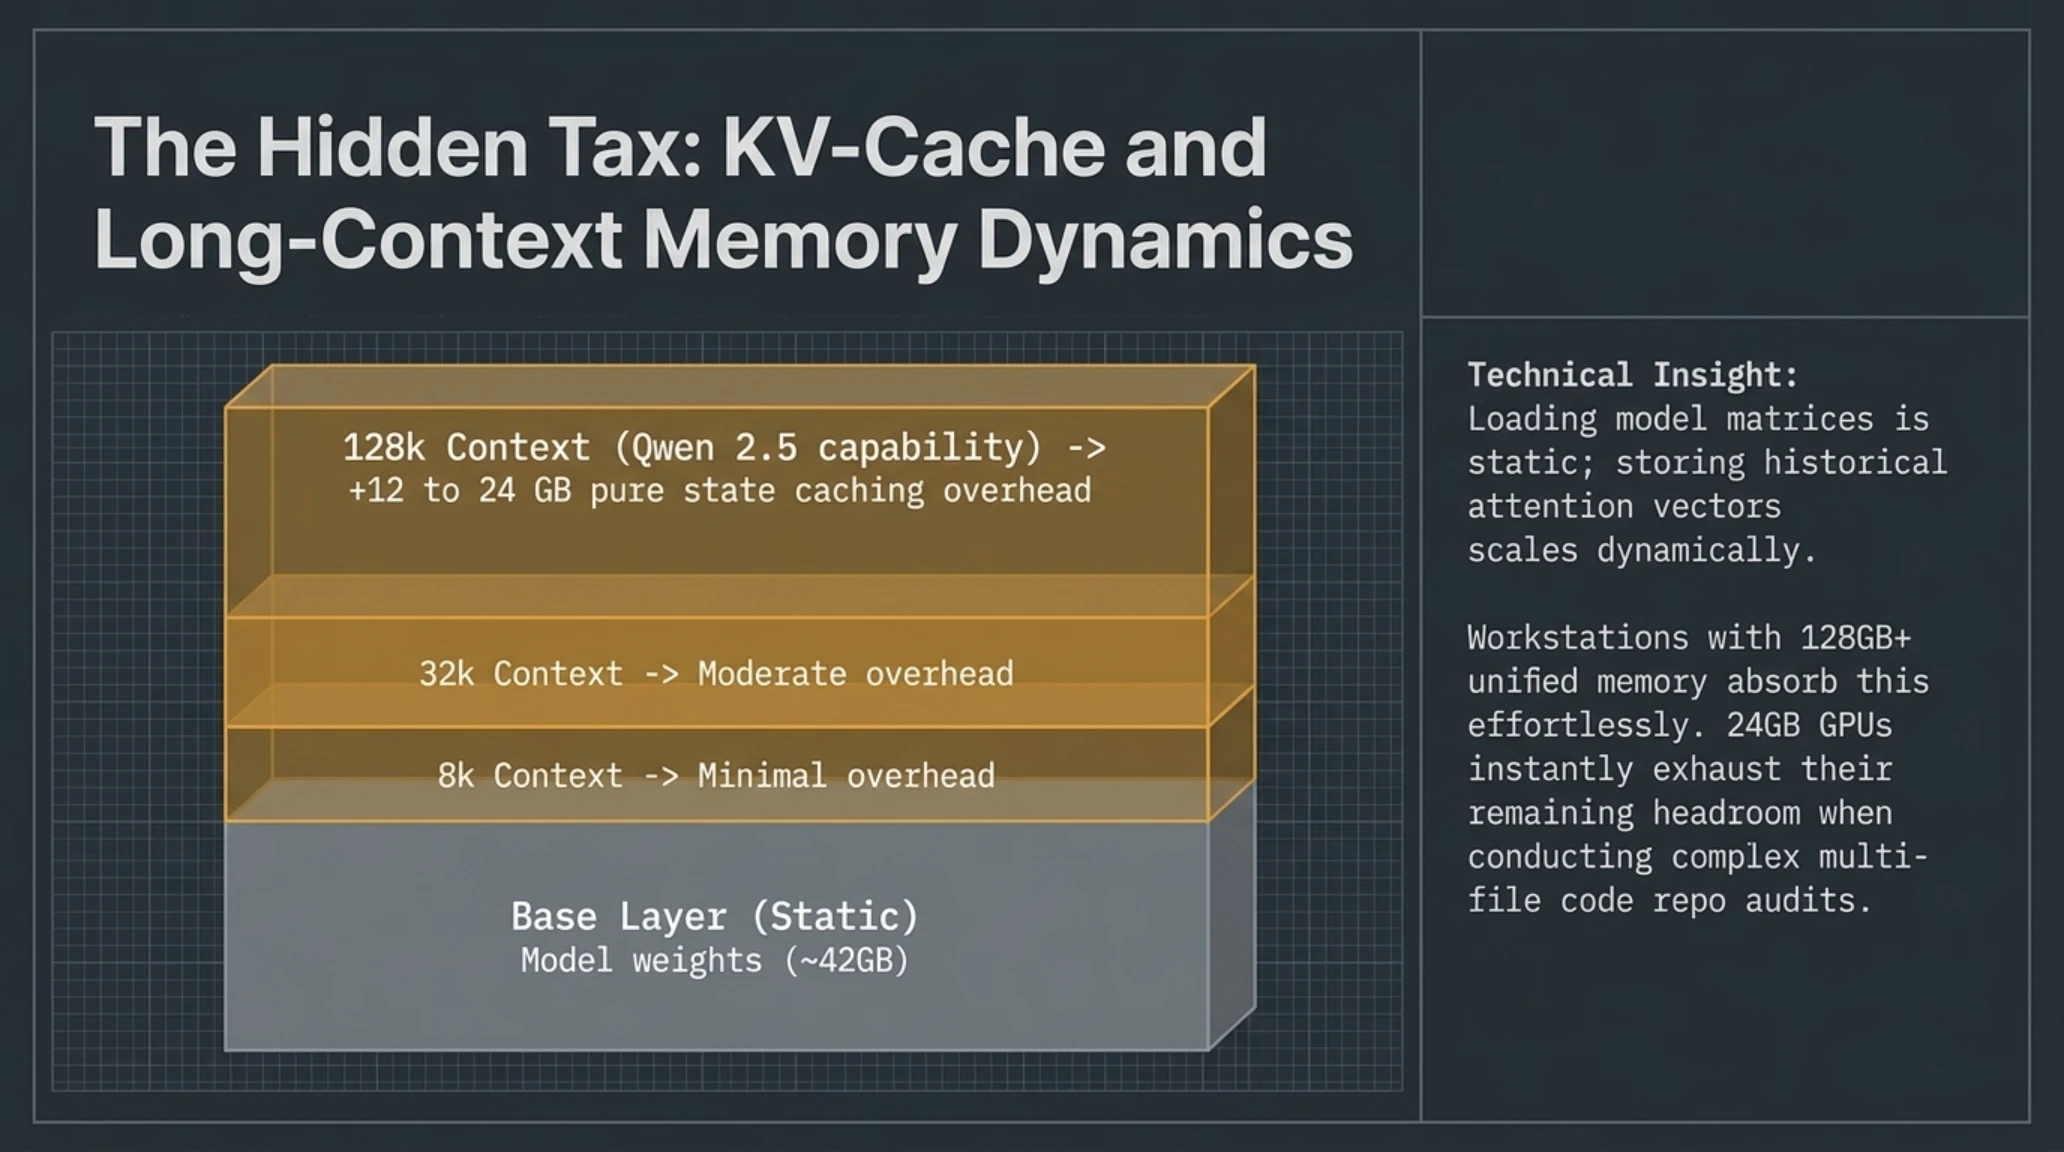
من الأمور التي قد تغيب عن بال المهندسين عند بدء العمل بالذكاء الاصطناعي المحلي هو تضخم استهلاك ذاكرة التخزين المؤقت (KV Cache) مع زيادة طول المحادثات. فحفظ متجهات الانتباه السابقة يتطلب تخصيص مساحة إضافية من الذاكرة تتوسع بشكل طردي مع زيادة طول السياق؛ مما قد يستهلك 12 إلى 20 جيجابايت إضافية عند التوسع إلى 64 ألف أو 128 ألف رمز.
وللاستفادة من قدرات نموذج Qwen 2.5 في قراءة العقود والملفات الضخمة دون تعطل النظام، يلزم تفعيل التكميم لذاكرة التخزين المؤقت وضبط معامل num_ctx في إعدادات Ollama، حيث تمنح الأجهزة المزودة بذاكرة تتجاوز 64 جيجابايت أريحية تشغيلية كاملة لا تستطيع البطاقات المنفصلة مجاراتها.
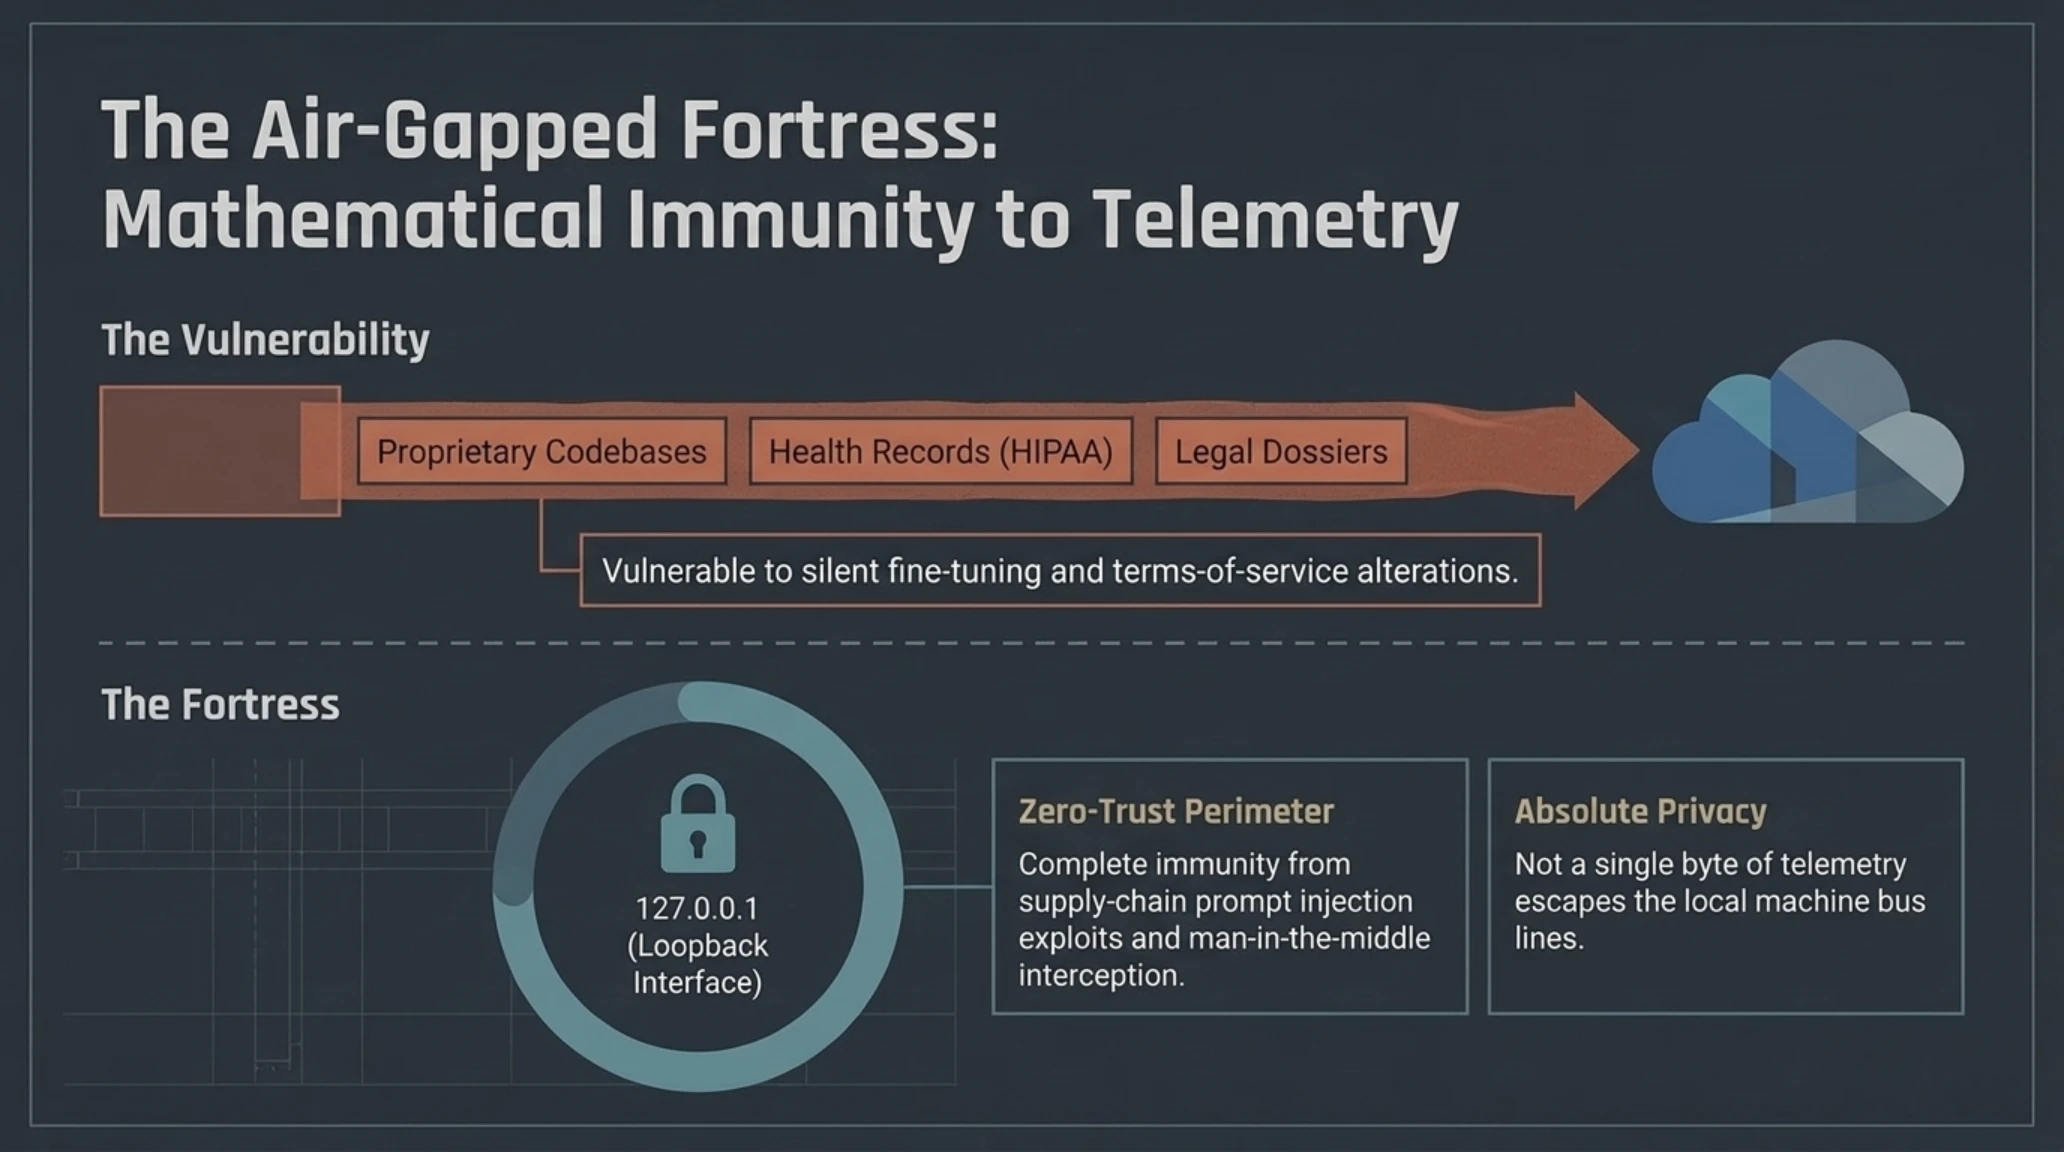
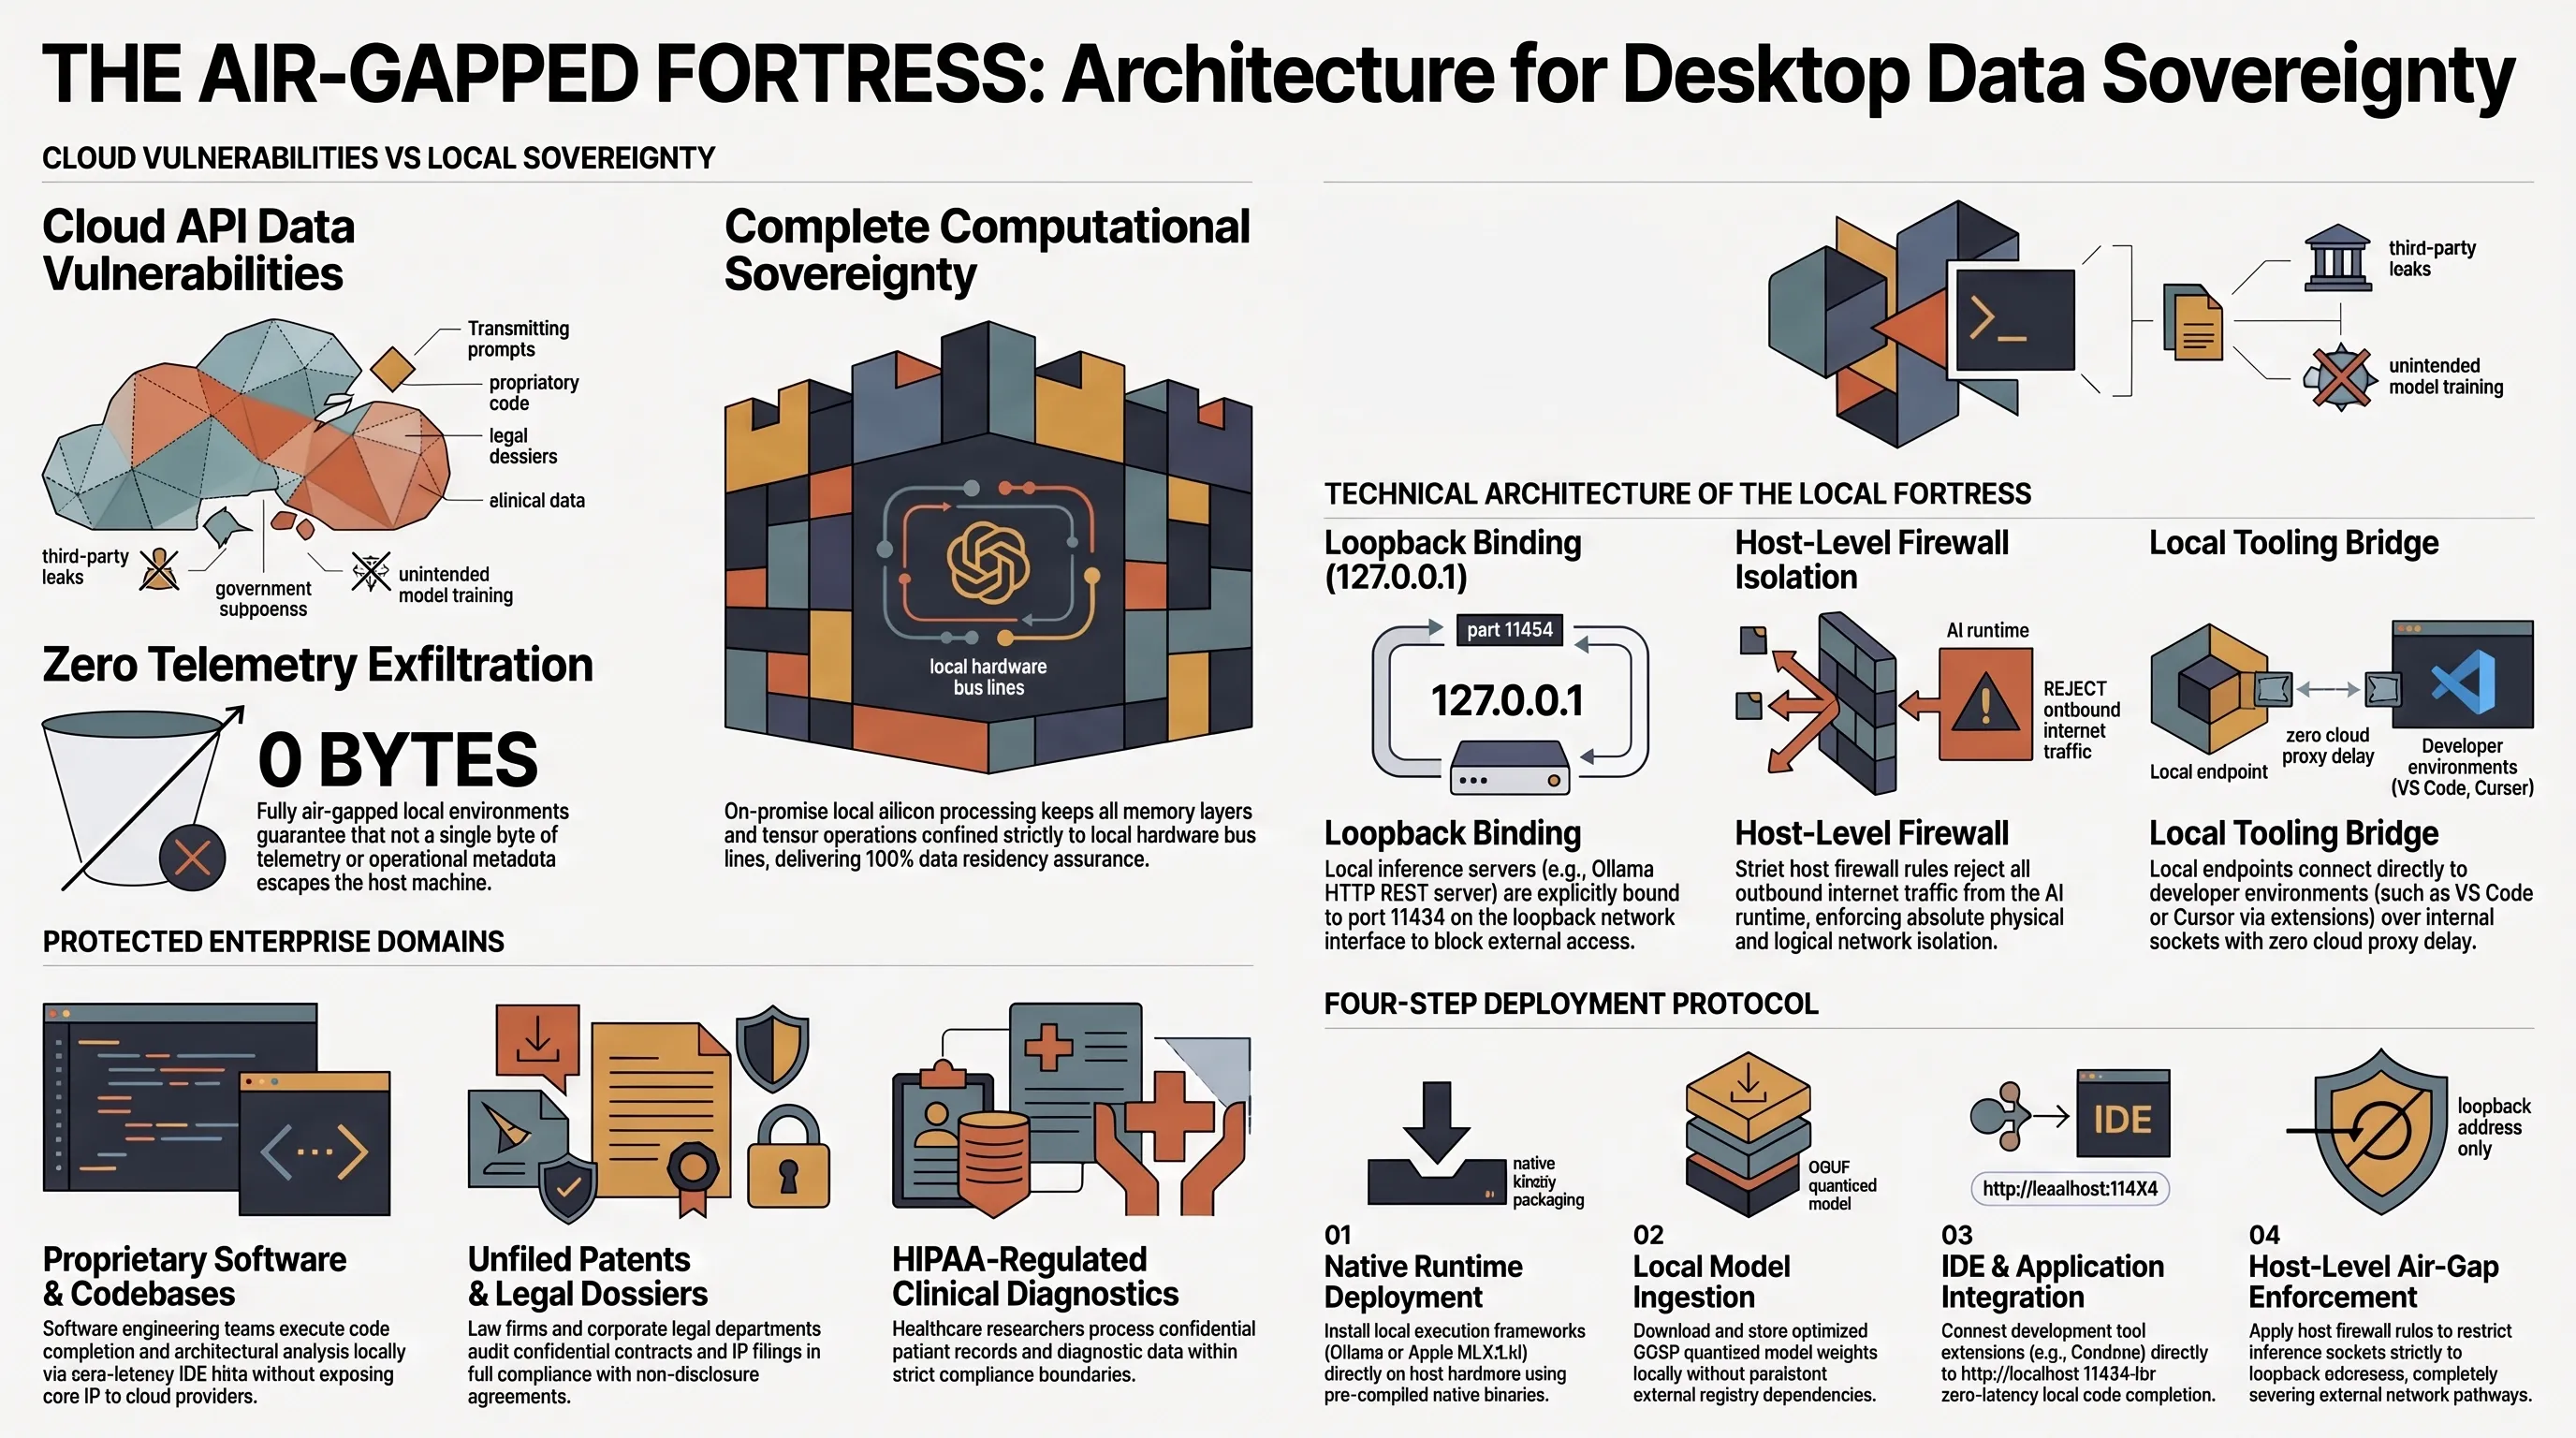
حصانة العزل الشبكي التام (Air-Gapped)؛ حماية الملكية الفكرية وسجلات الشركات
تكتمل منظومة الحوسبة المحلية بتطبيق سياسات العزل الشبكي الصارم؛ حيث يتم تقييد منافذ الخادم المحلي على عنوان الاسترجاع الذاتي 127.0.0.1 وحظر أي اتصال خارجي عبر الجدار الناري للنظام.
يمنح هذا الإجراء المحكم المستشارين القانونيين والمطورين والمؤسسات الاستثمارية ثقة مطلقة في أن وثائقهم الحساسة وأكوادهم المصدرية لن تغادر الجهاز إطلاقاً، مما يجعل الذكاء الاصطناعي أداة تمكين آمنة ومحصنة ضد أي اختراق سيبراني خارجي.
مؤشر نبض السوق | مقياس التبني ومنحنى S-Curve لعام 2026
تحليل مؤشر السوق: تجاوز قطاع التكنولوجيا المؤسسية مرحلة التبعية التامة للخوادم السحابية العملاقة ليدخل مرحلة النضج والاعتماد الواسع على محطات المعالجة المكتبية المعزولة بمعدل ثقة يصل إلى 78% بين قيادات تقنية المعلومات.
- جهاز Mac Studio Ultra: سعة ذاكرة موحدة هائلة تصل إلى 192 جيجابايت لتحميل نماذج 70B و 120B محلياً.
- جهاز Mac Studio Ultra: كفاءة استثنائية في استهلاك الطاقة دون 85 واط وتشغيل صامت تماماً دون انبعاث حراري.
- حاسوب إنفيديا المكتبي: سرعة فائقة تقترب من 100 رمز في الثانية للنماذج الخفيفة بفضل أنوية كودا.
- حصانة العزل التام: حماية الملكية الفكرية وسجلات الشركات دون تسريب أي بايت لخوادم خارجية.
- محدودية سعة بطاقات إنفيديا بـ 24 جيجابايت مما يمنع تشغيل النماذج اللغوية الكبيرة بكفاءة.
- ارتفاع تكلفة الترقية الأولية لذاكرة أجهزة آبل وصعوبة تعديلها لاحقاً لكونها مدمجة بالكامل.
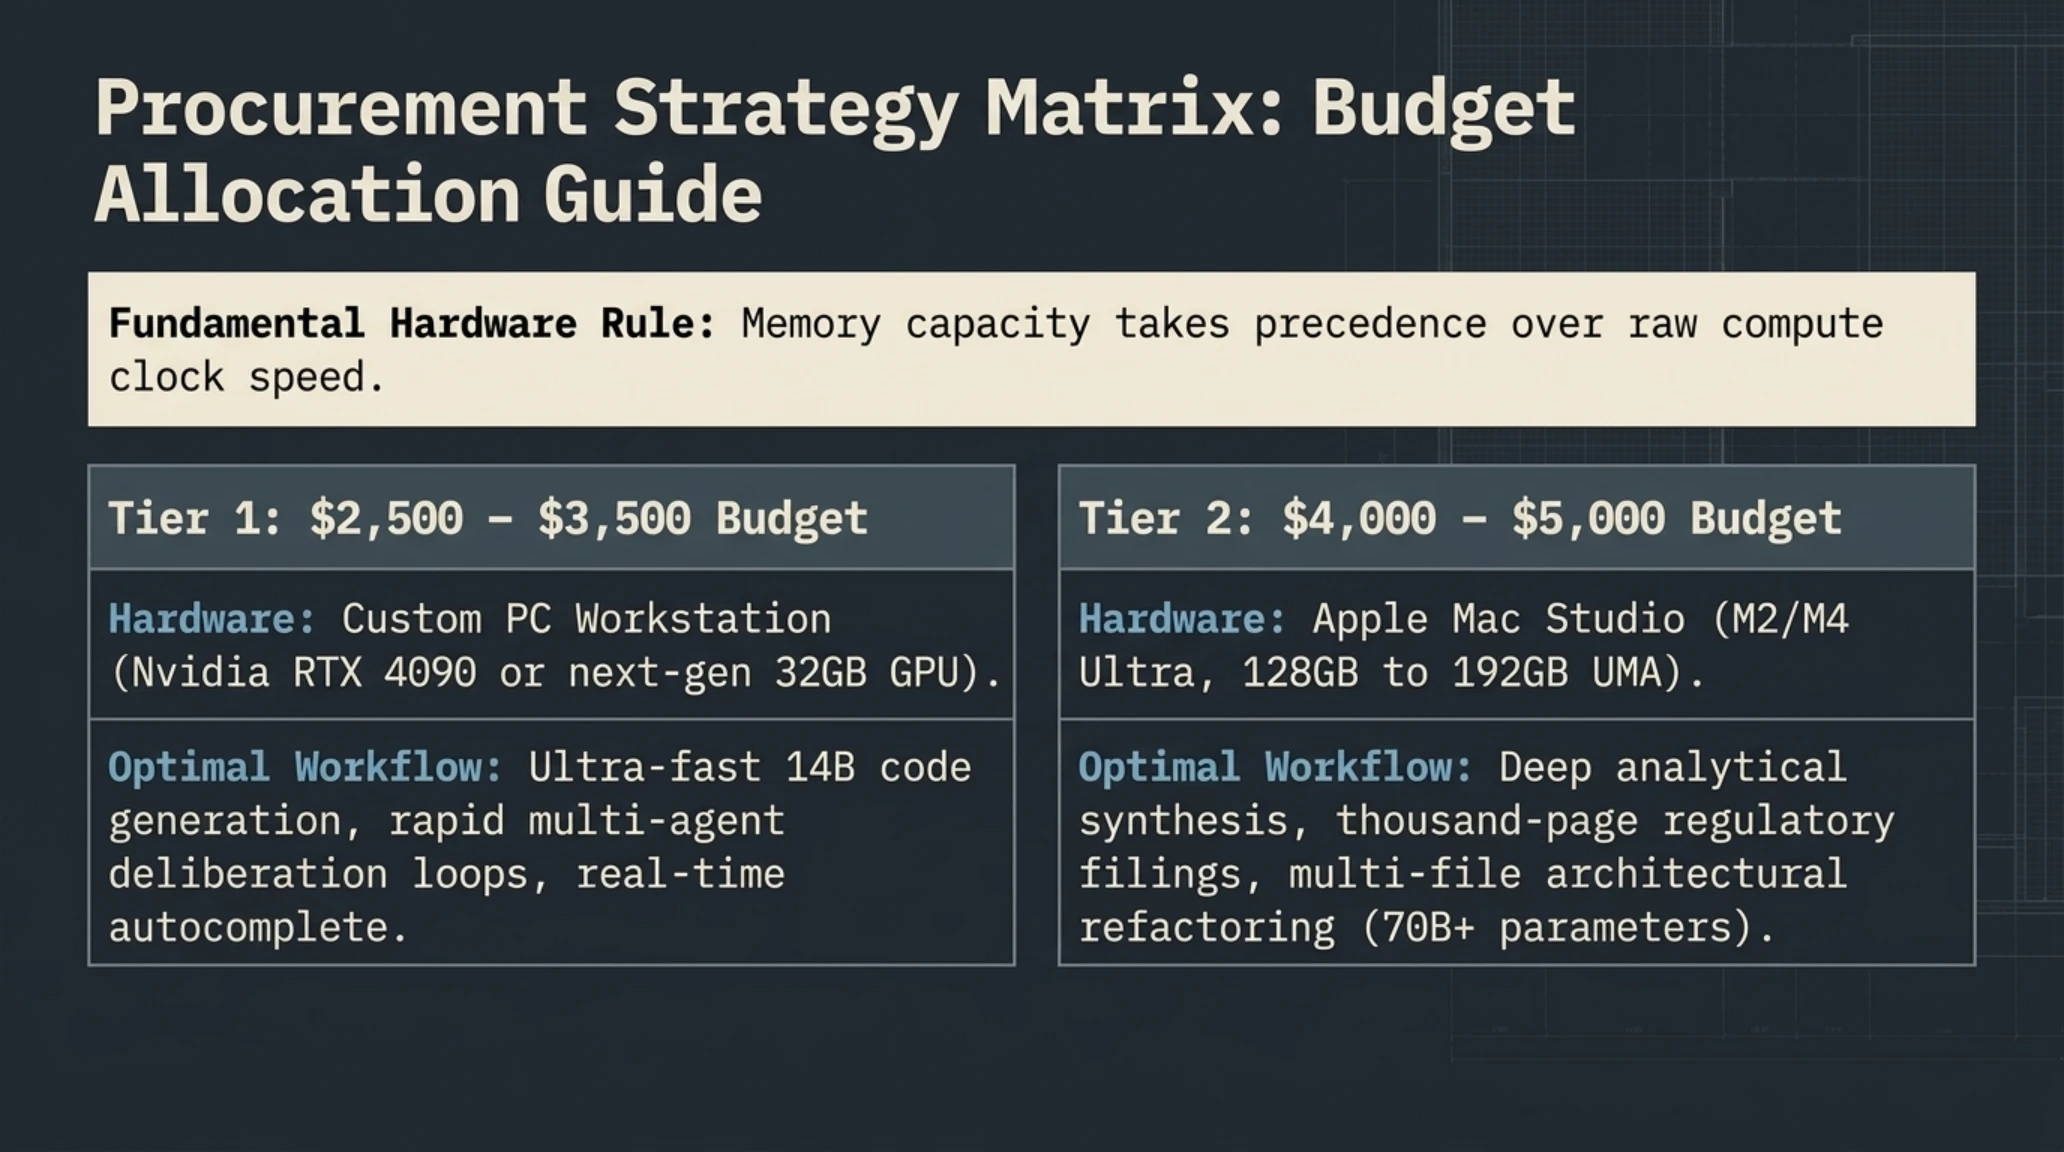
دليل الشراء واختيار العتاد؛ التوزيع الذكي للميزانية بين ماك والحاسوب الشخصي
عند اتخاذ قرار الاستثمار في محطة عمل لتشغيل الذكاء الاصطناعي، يجب الانطلاق من قاعدة ذهبية تحكم هندسة العتاد: سعة الذاكرة تتقدم دائماً على سرعة التردد الحوسبي. فشراء بطاقة رسوميات متوسطة بذاكرة 16 جيجابايت (مثل RTX 4060 Ti 16GB) يعد قراراً أكثر حكمة من شراء بطاقة أسرع بذاكرة 12 جيجابايت فقط.
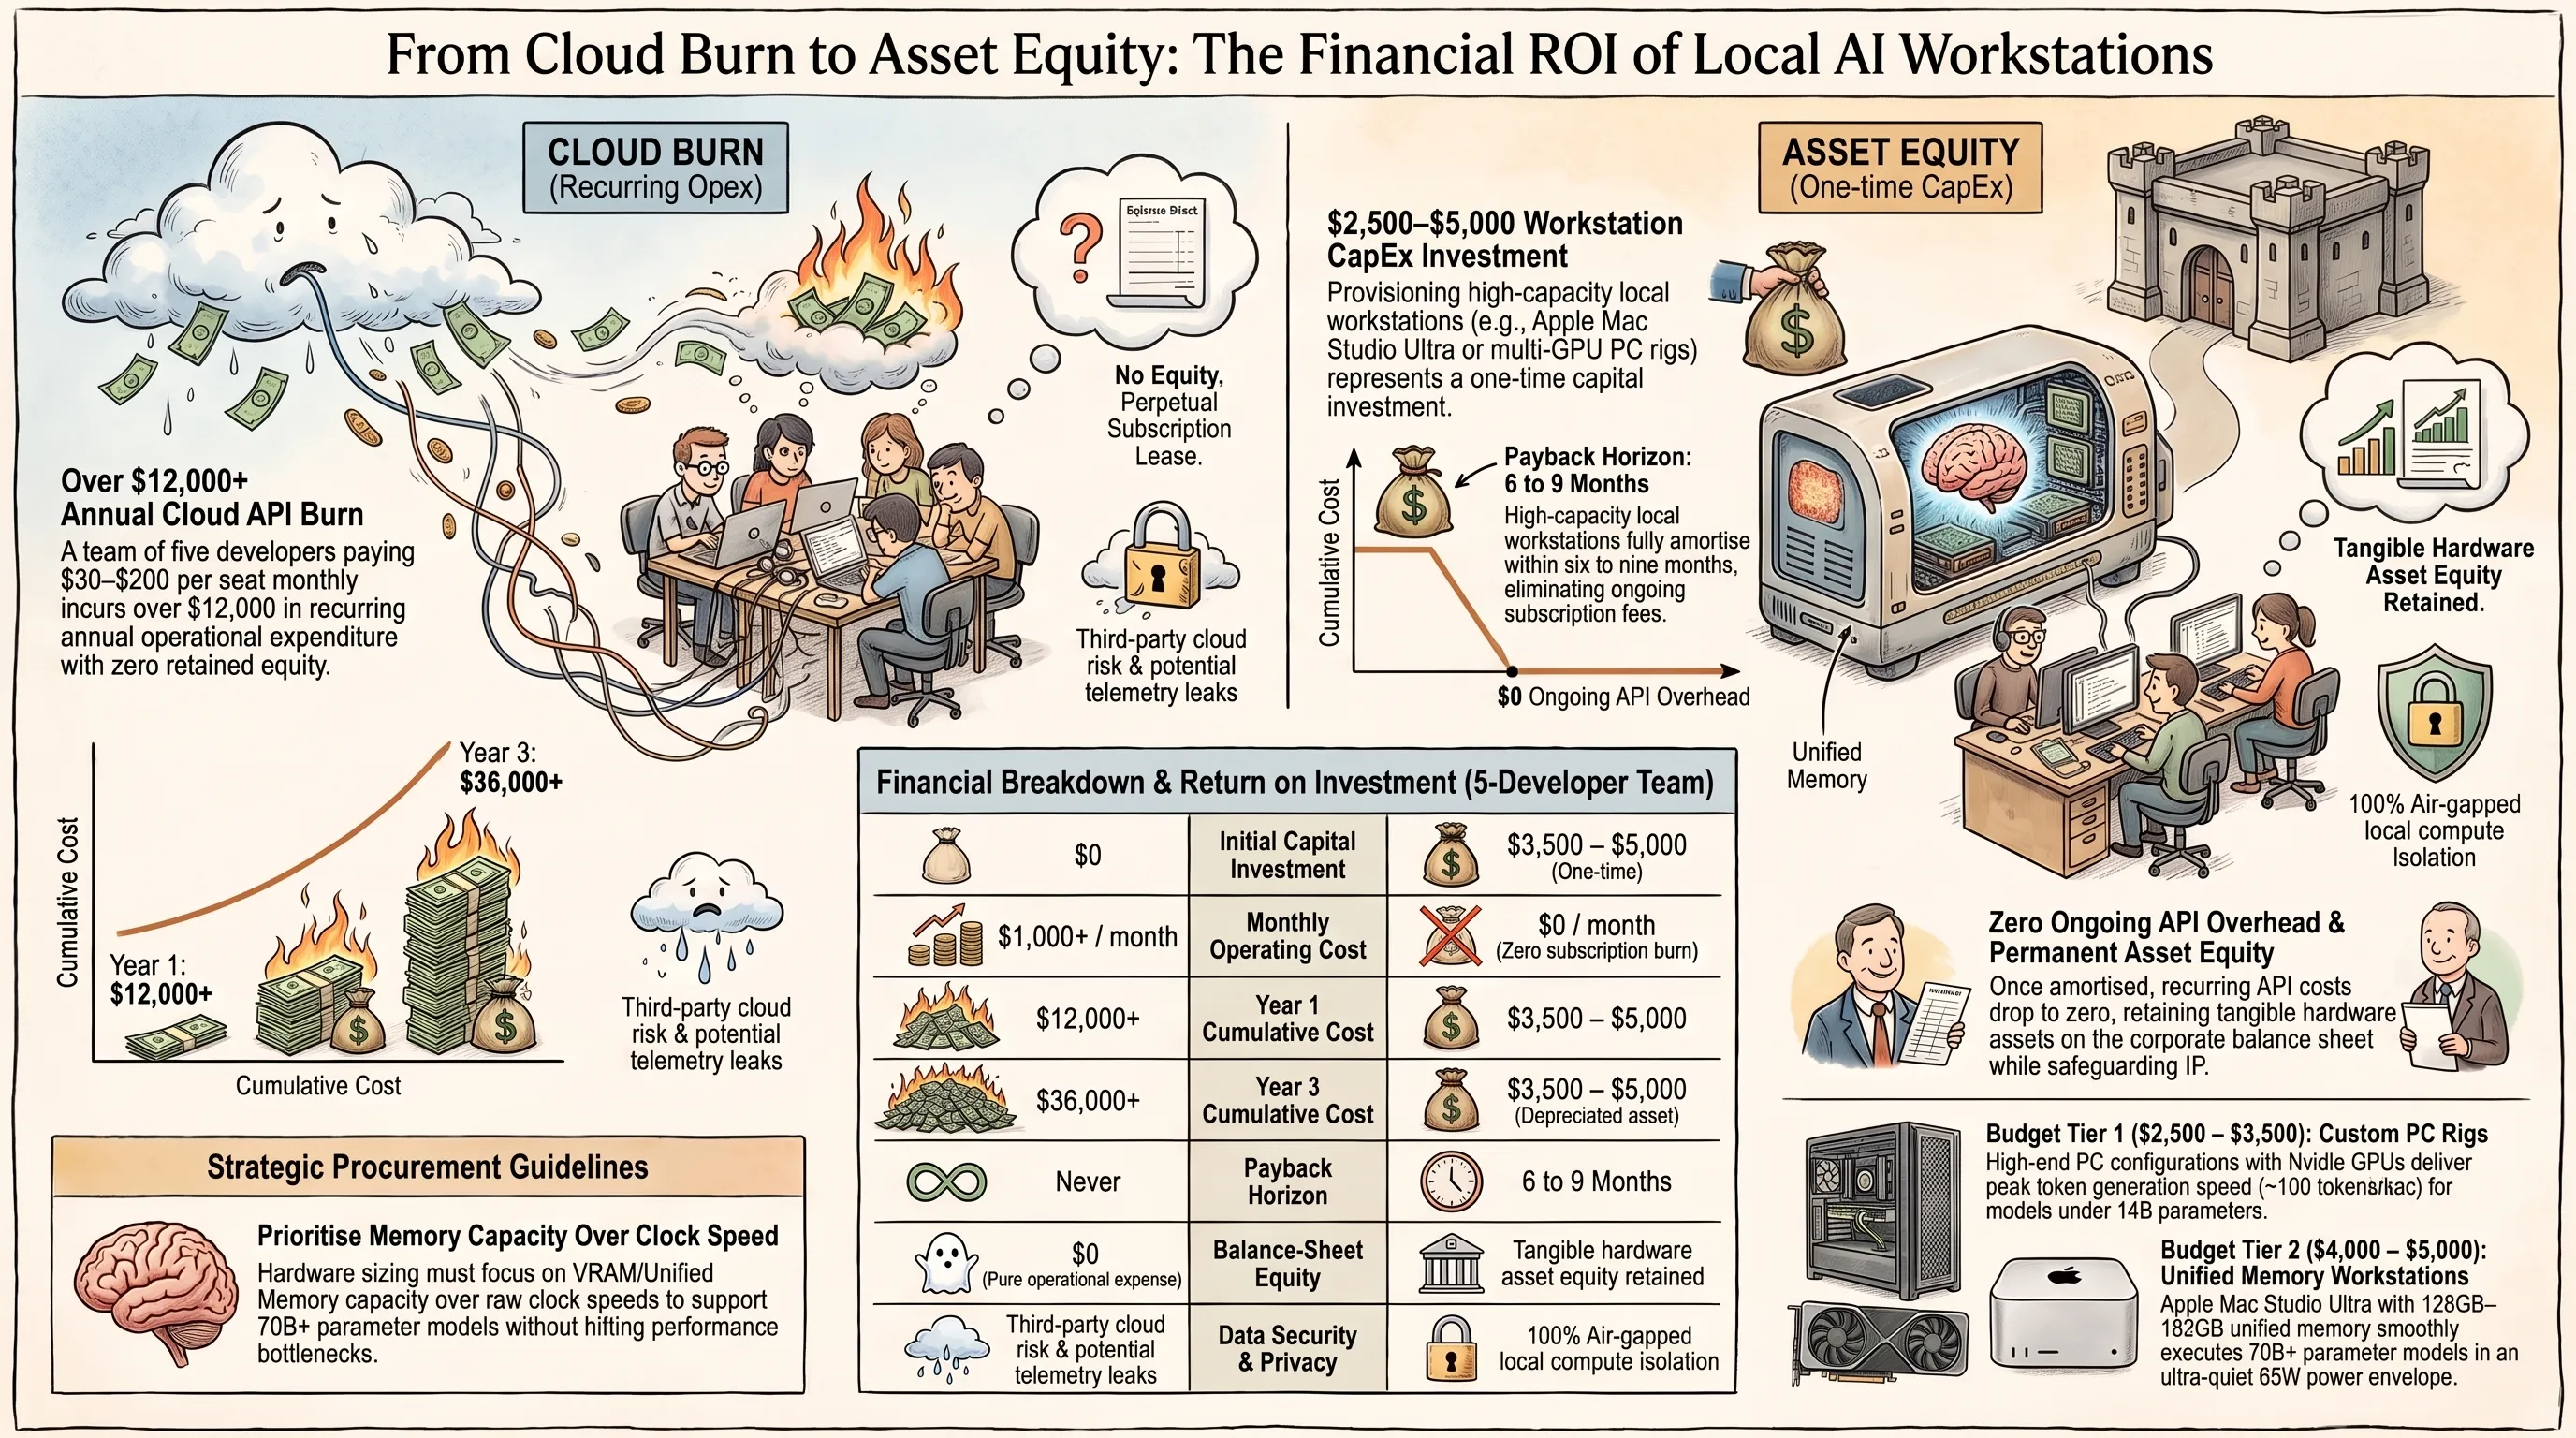
وللمؤسسات التي تخصص ميزانية تتراوح بين 2,500 إلى 3,500 دولار، يمثل بناء حاسوب شخصي يعتمد على بطاقة RTX 4090 خياراً مثالياً للحصول على سرعة فائقة في معالجة نماذج 14B وأتمتة الأكواد. أما إذا كانت الميزانية تتراوح بين 4,000 إلى 5,000 دولار مع وجود متطلبات لتحليل مستندات ضخمة وتشغيل نماذج 72B باستمرار، فإن اقتناء جهاز Mac Studio بمعالج M2 أو M4 ألترا وذاكرة 128 أو 192 جيجابايت يعد الاستثمار الأجدى اقتصادياً وعملياً على المدى البعيد.
الجدوى الاقتصادية ونقطة التعادل المالي (ROI)؛ استهلاك الاشتراكات السحابية
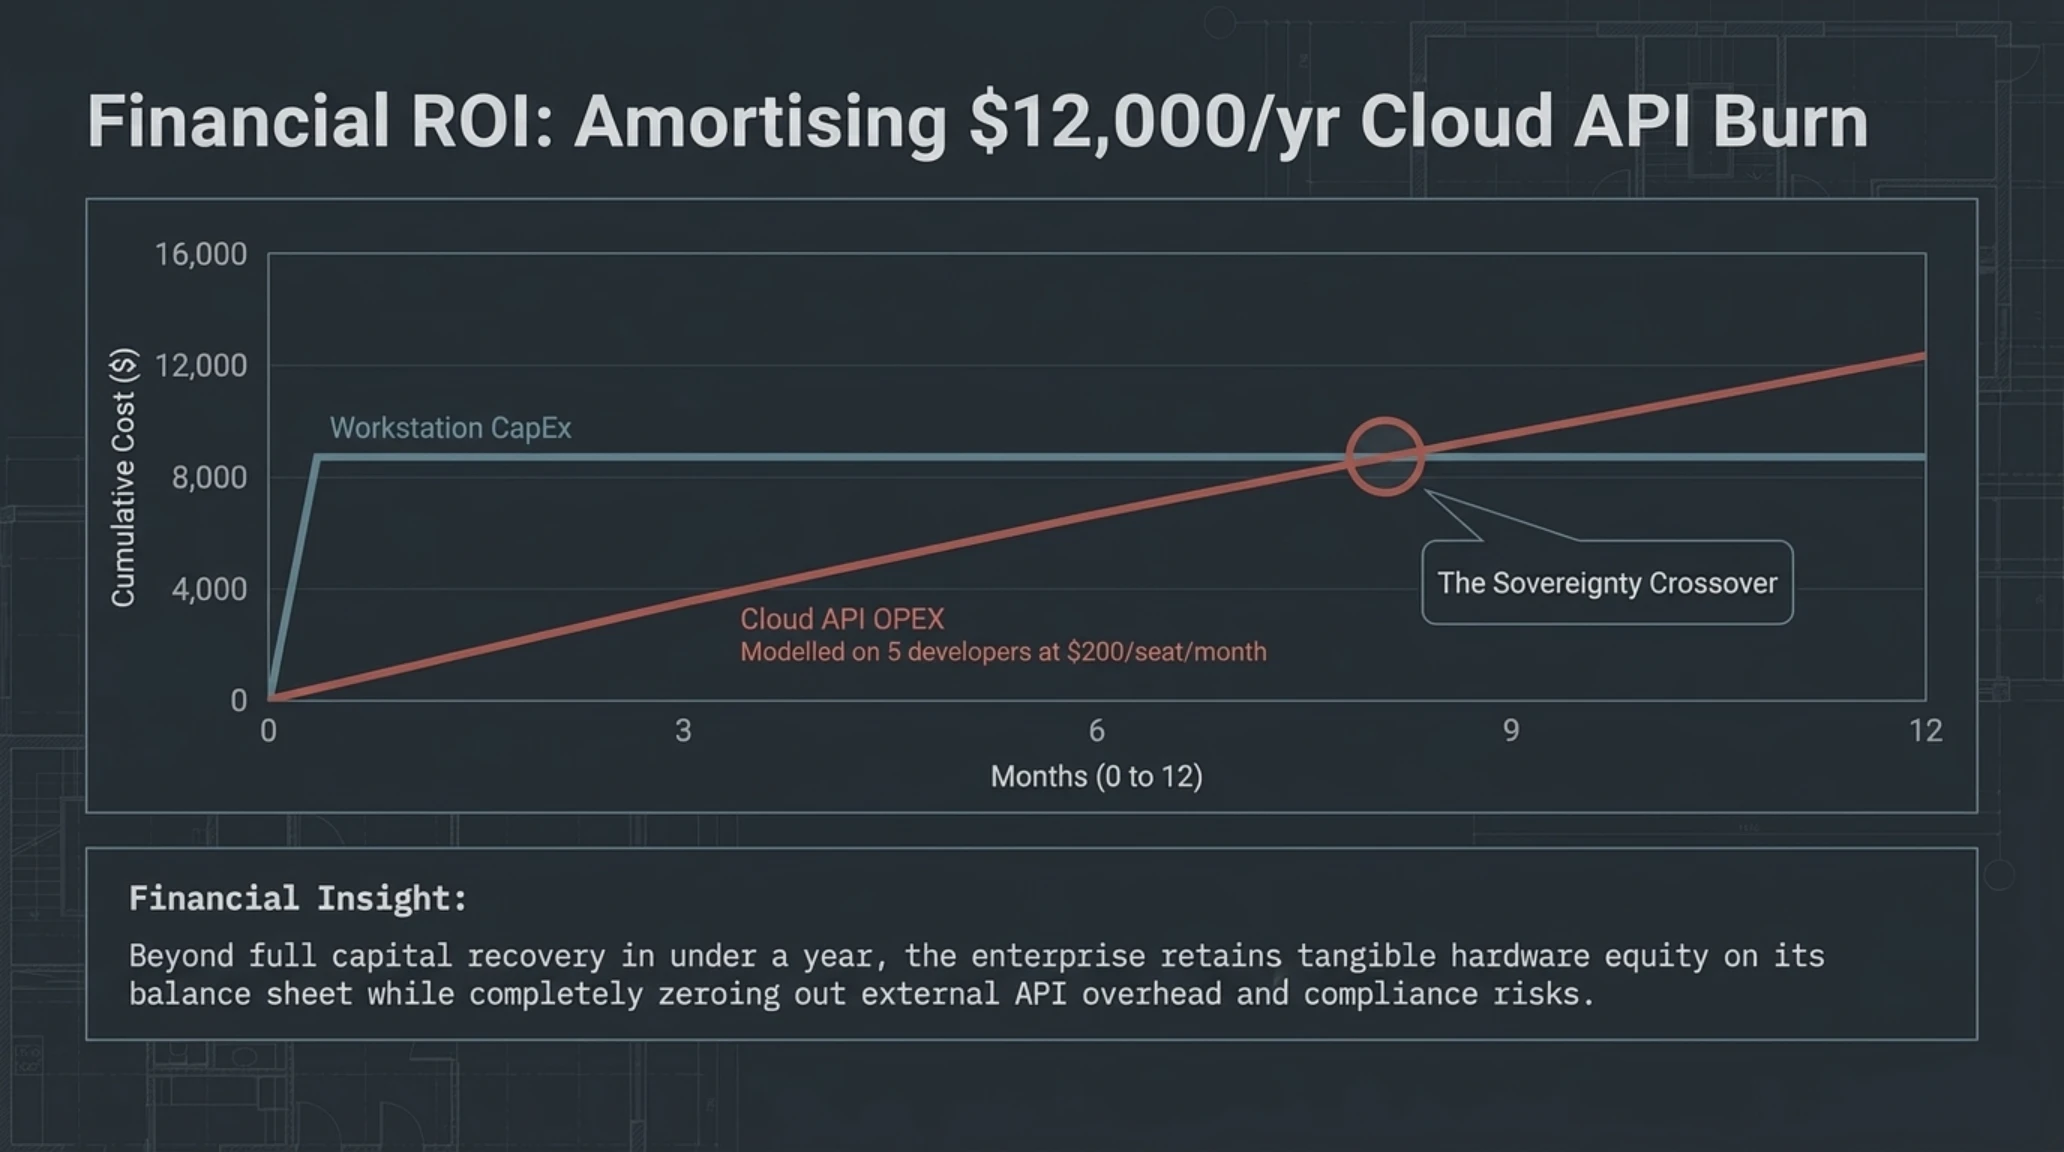
قد يتردد بعض المديرين الماليين أمام التكلفة الأولية لشراء محطة عمل متقدمة، لكن الحسابات المالية التراكمية تكشف الجدوى الساحقة للعتاد المحلي. ففي عام 2026، تبلغ تكلفة الاشتراكات المؤسسية للنماذج السحابية المتقدمة ما بين 30 إلى 200 دولار للمستخدم شهرياً؛ مما يعني أن فريق عمل يضم خمسة مهندسين يكلف الشركة ما بين 3,000 إلى 12,000 دولار سنوياً من النفقات التشغيلية المتكررة.
وبشراء جهاز محلي متطور واستخدامه كخادم مشترك عبر الشبكة الداخلية، تنخفض هذه التكاليف الشهرية إلى الصفر، وتسترد الشركة قيمة الجهاز بالكامل خلال فترة وجيزة تتراوح بين 6 إلى 9 أشهر من بدء التشغيل، مع بقاء العتاد كأصل رأسمالي ثابت ومملوك للمؤسسة بالكامل.
خارطة طريق الإعداد خطوة بخطوة للشركات والمطورين
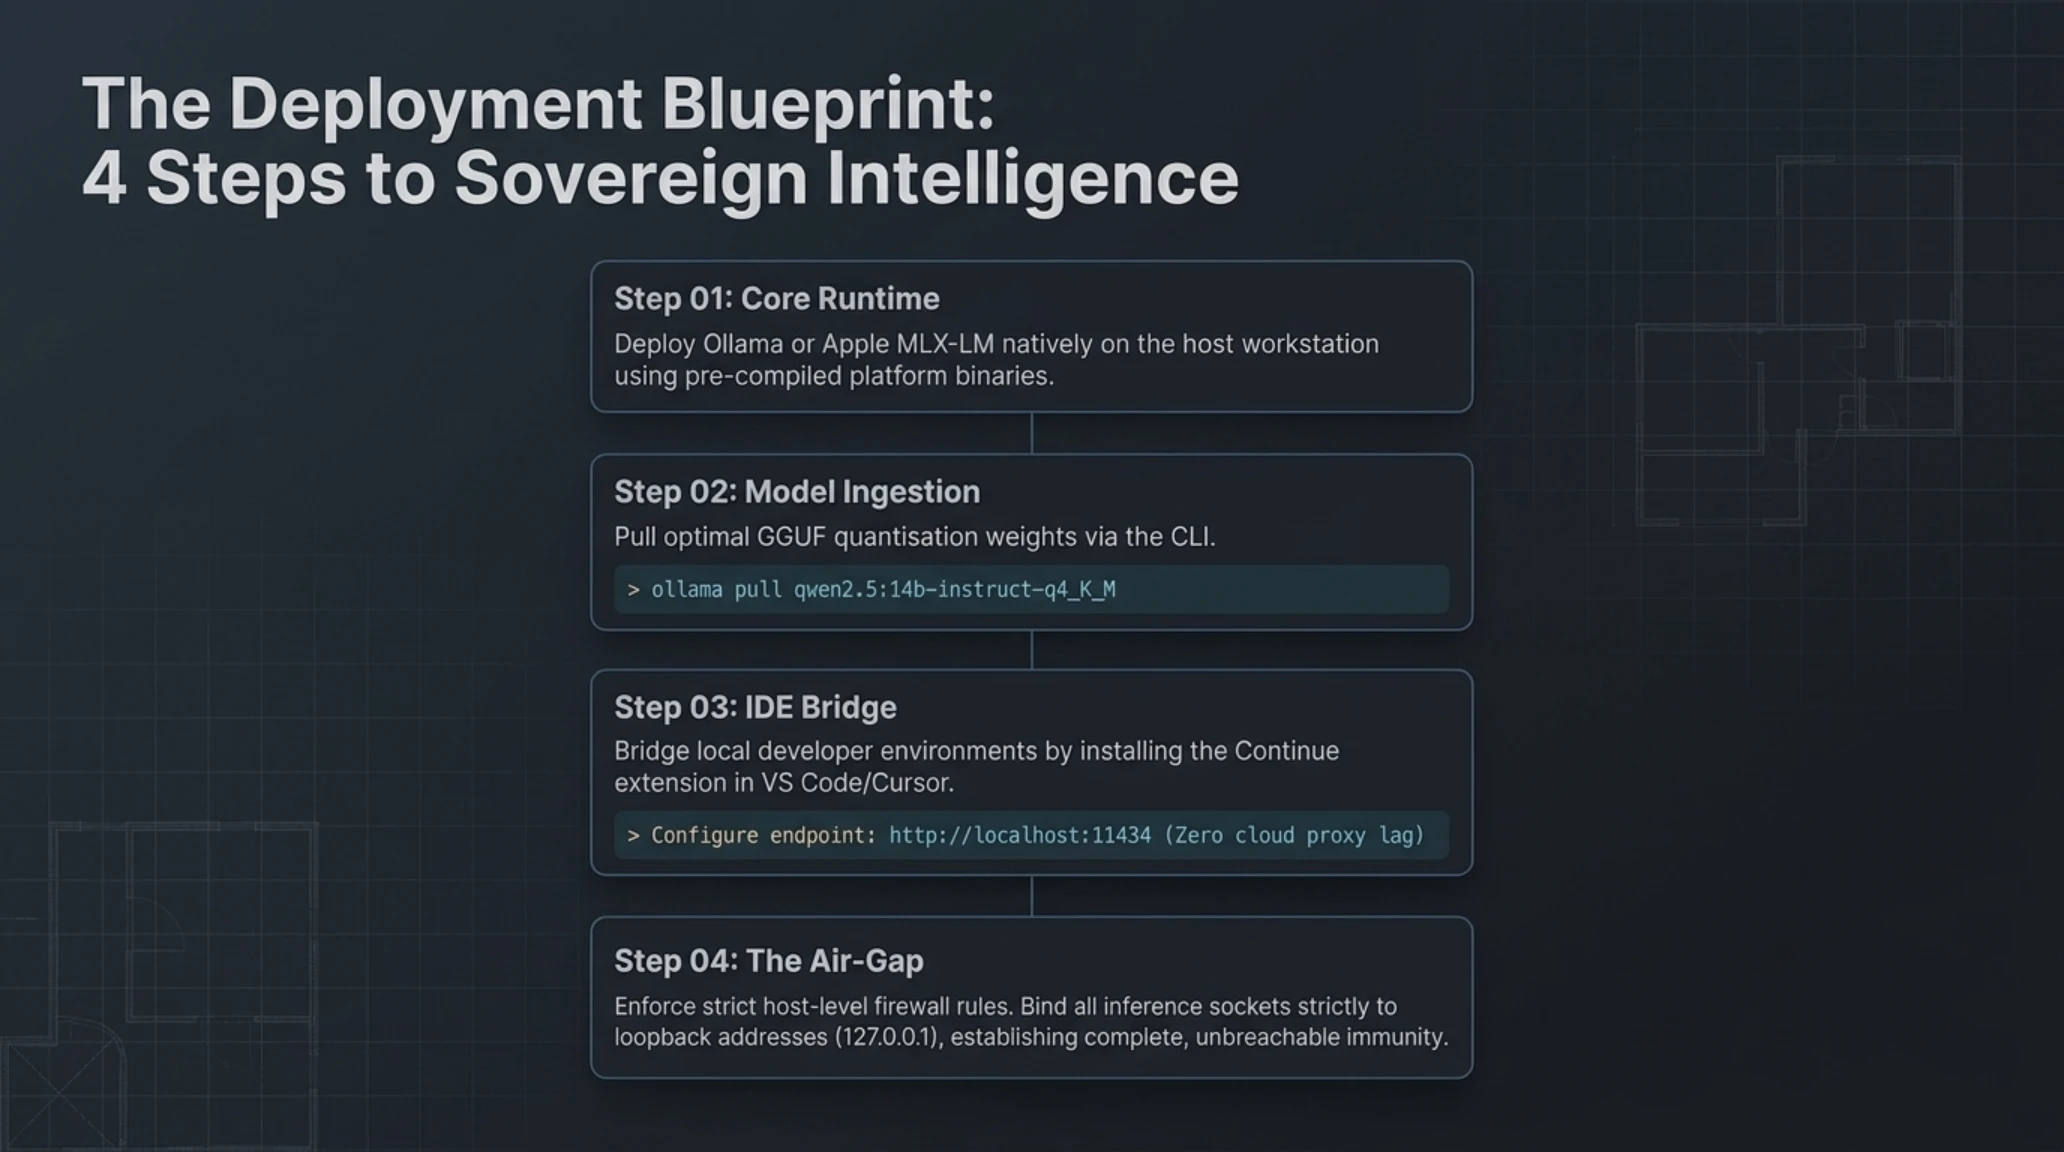
لبدء العمل الفعلي والاستفادة من الذكاء الاصطناعي المحلي اليوم، يمكن اتباع الخطوات التنفيذية التالية:
الخطوة الأولى: تثبيت محرك Ollama أو مكتبات MLX عبر حزم التثبيت الرسمية المناسبة لنظام التشغيل.
الخطوة الثانية: تنزيل الأوزان المكممة المتوازنة عبر سطر الأوامر: ollama pull qwen2.5:14b-instruct-q4_K_M.
الخطوة الثالثة: ربط المحرك ببيئة التطوير عبر تثبيت إضافة Continue في برنامج VS Code وتوجيهها للمنفذ المحلي http://localhost:11434.
الخطوة الرابعة: تفعيل قواعد الجدار الناري لحظر الاتصال الخارجي والبدء في تشغيل بيئة عمل مؤتمتة ومستقلة بالكامل.
حكم التحرير وقائمة المصادر الرسمية المعتمدة
انتصار السيادة الحاسوبية في عصر ما بعد السحابة
أصبح الذكاء الاصطناعي المحلي المعيار الذهبي لأمن البيانات المؤسسية في عام 2026؛ تتصدر إنفيديا في سرعة النماذج الخفيفة، بينما يفرض Mac Studio Ultra سيادته في سعة الذاكرة والهدوء الصوتي واستيعاب النماذج العملاقة.
- ذا فيرج (The Verge): تقرير أنطونيو دي بينيديتو الميداني حول تحديات ومكاسب الانتقال إلى الذكاء الاصطناعي المحلي
- هاغينغ فيس (Hugging Face): المستودع الرسمي لأوزان GGUF المكممة لنماذج Hermes 3 و Qwen 2.5
- نوس ريسيرش (Nous Research): الوثيقة التقنية لمعمارية نموذج Hermes 3 وقدرات التفكير المستقل المنظم
- آبل لتعلم الآلة (Apple MLX): المستودع الرسمي لإطار عمل MLX لتسريع الذكاء الاصطناعي على شرائح آبل سيليكون
الأسئلة الشائعة والاستفسارات التقنية
هل يتطلب تشغيل الذكاء الاصطناعي المحلي اتصالاً دائماً بالإنترنت؟
يلزم الاتصال بالإنترنت فقط لمرة واحدة لتنزيل ملف أوزان النموذج (بين 5 إلى 45 جيجابايت). وبعد انتهاء التنزيل، تتم كافة عمليات التفكير والاستدلال دون الحاجة لأي اتصال بالشبكة إطلاقاً.
لماذا تعجز بطاقات الألعاب العادية عن تشغيل نماذج 70B؟
تحتوي بطاقات الألعاب عادة على 8 إلى 12 جيجابايت من الذاكرة الرسومية، في حين تتطلب نماذج 70B ما لا يقل عن 40 جيجابايت من الذاكرة حتى في أقصى درجات التكميم لمجرد تحميل أوزان النموذج.
هل يؤدي تكميم النماذج إلى 4 بت إلى تدهور ملحوظ في مستوى الذكاء؟
كلا؛ تحافظ خوارزميات التكميم الحديثة مثل Q4_K_M على دقة عالية لطبقات الانتباه الحساسة، ولا يتجاوز التراجع الإدراكي 1.5% وهو فارق غير ملحوظ إطلاقاً في الاستخدامات المهنية اليومية.
ما الفرق بين إطار عمل Ollama وإطار عمل Apple MLX على حواسيب ماك؟
يعتمد Ollama على مكتبات C++ متعددة المنصات ويوفر سهولة إدارية فائقة. أما MLX فهو إطار عمل رسمي من آبل مبرمج بلغة بايثون ومصمم خصيصاً للاستفادة المباشرة من مكتبات Metal الرسومية مما يمنح زيادة في السرعة بنسبة 35%.
هل تستطيع النماذج المحلية منافسة النماذج السحابية العملاقة مثل GPT-4 في المهام المتخصصة؟
نعم؛ في مهام مثل كتابة وتدقيق الأكواد، وتحليل المستندات السرية، والترجمة، واستدعاء الدوال، تقدم نماذج مثل Qwen 2.5 32B و Hermes 3 أداءً يضاهي السحابة تماماً مع ضمان تام للسرية.
كيف يمكن ربط النماذج المحلية ببيئات التطوير البرمجية مثل VS Code؟
يمكن تثبيت إضافة Continue مفتوحة المصدر داخل VS Code وربطها بمزود Ollama المحلي للاستفادة من الإكمال التلقائي وتصحيح الأخطاء دون مغادرة الكود لجهازك.
وسائل التواصل الاجتماعي
اتصل بنامعرض صور إضافي: تيكين غايد | بنشمارك الذكاء الاصطناعي المحلي: Mac Studio ضد PC