تيكين آناليز: تفكيك الجيل الجديد من نماذج Gemini 3.8 Live الصوتية من جوجل
تحليل معماري معمق لطرازي Gemini 3.8 Live وExtended Thinking؛ القضاء النهائي على فترات الصمت الميت وبدء عصر التفكير والمحادثة المتوازية.
- 🎮استدلال متوازٍ متزامن- الحديث وحل المسائل الرياضية المعقدة في الخلفية دون انقطاع.
- 🎧دعم فوري لـ 97 لغة- التحول التلقائي بين اللغات في منتصف الجملة مع فهم الفيديو اللحظي.
- 🚀علامة مائية طيفية SynthID- حماية فيزيائية ضد التزييف الصوتي والتحقق الجنائي التام.
- 🗡️استجابة دون 280 ميلي ثانية- سرعة استجابة فائقة تتفوق على ردود الفعل البشرية المباشرة.
- 📰تفاعل مزدوج بالكامل- مقاطعة الحديث بسلاسة دون تشويش صوتي في 50 ميلي ثانية.
- ⚔️بروتوكولات WebSockets- تنسيق الأدوات السحابية المؤسسية بأسلوب غير متزامن.
في منتصف سبتمبر عام 2026، وضعت شركة جوجل حداً فاصلاً لواحدة من أقدم وأعقد العقبات في تاريخ التفاعل بين الإنسان والحاسوب عبر كشفها الرسمي عن طرازي Gemini 3.8 Live وGemini 3.8 Live Extended Thinking. لسنوات طويلة، كانت المحادثات الصوتية مع أحدث أنظمة الذكاء الاصطناعي التوليدي مقيدة بتناقض محرج؛ فإما أن تجيب النماذج بسرعة فائقة تحاكي المساعدات الآلية ولكنها تعجز عن التفكير الاستدلالي العميق وحل المسائل المعقدة، أو أن تأخذ نماذج الاستدلال فترة معالجة داخلية تدوم بين خمس ثوانٍ إلى نصف دقيقة لحل المسائل، مما يتحول في المكالمة الصوتية إلى «صمت ميت» (Dead Air) يدمر التفاعل الإنساني التلقائي ويشعر المستخدم بالملل والارتباك.
في لمحة: النقاط الجوهرية لهذا التحقيق
- قدمت جوجل معمارية مزدوجة (قياسية وممتدة الاستدلال) لفصل التخاطب الصوتي السريع عن سلاسل التفكير المعقدة.
- مفهوم «التفكير أثناء التحدث» ألغى فترات الصمت الميتة عبر السماح للنموذج بالسرد الصوتي بينما يعمل محرك الاستدلال في الخلفية.
- انخفض زمن الوصول لأول رمز صوتي (TTFA) إلى أقل من 280 ميلي ثانية، مما يضمن تدفقاً بشرياً حقيقياً في المحادثات.
- يدعم النظام 97 لغة عالمية مع قدرة فائقة على التبديل الفوري في منتصف الجملة ومعالجة الفيديو بمعدل 30 إطاراً في الثانية.
- تقنية SynthID تحقن بصمة تشفيرية طيفية غير محسوسة داخل موجات الصوت، وتصمد أمام التشويه لضمان الموثوقية.
- تدار واجهات المؤسسات (مثل Google Workspace) عبر شبكة اتصالات WebSockets غير متزامنة لضمان استمرار الحوار.
استطاعت جوجل ديب مايند التغلب على هذا التحدي الجذري من خلال إعادة تصميم معمارية المعالجة الصوتية وفصل مسار التخاطب الصوتي عن محرك التفكير المتسلسل، مبتكرة مفهوماً هندسياً جديداً أطلقت عليه اسم «التفكير أثناء التحدث» (Thinking while Talking). في هذه المعمارية المبتكرة، لا يتوقف الذكاء الاصطناعي عن الحديث ليفكر؛ بل يبادر فوراً بنبرة واثقة وهادئة قائلاً «دعني أتحقق من قاعدة البيانات وسجلات النظام...»، وفي اللحظة ذاتها التي يتحدث فيها إلى المستخدم، تعمل شبكاته العصبية في الخلفية على تنفيذ استعلامات قواعد البيانات، ومراجعة الأكواد البرمجية، واختبار الفرضيات المنطقية. هذا التحول يعيد تشكيل مستقبل الواجهات الصوتية ويقربنا خطوة كبرى من التفاعل الطبيعي الكامل مع الحوسبة المحيطية.

لاستيعاب الأهمية الاستراتيجية لهذا الإنجاز الهندسي، يتعين علينا أولاً تفكيك خطة النشر المزدوجة التي تبنتها شركة جوجل، حيث قررت الشركة تقديم طرازين متخصصين لتلبية المتطلبات المتباينة لأسواق الأعمال والحوسبة السحابية العالمية.
إستراتيجية جوجل المزدوجة: تفكيك السرعة اللحظية عن الاستدلال العميق
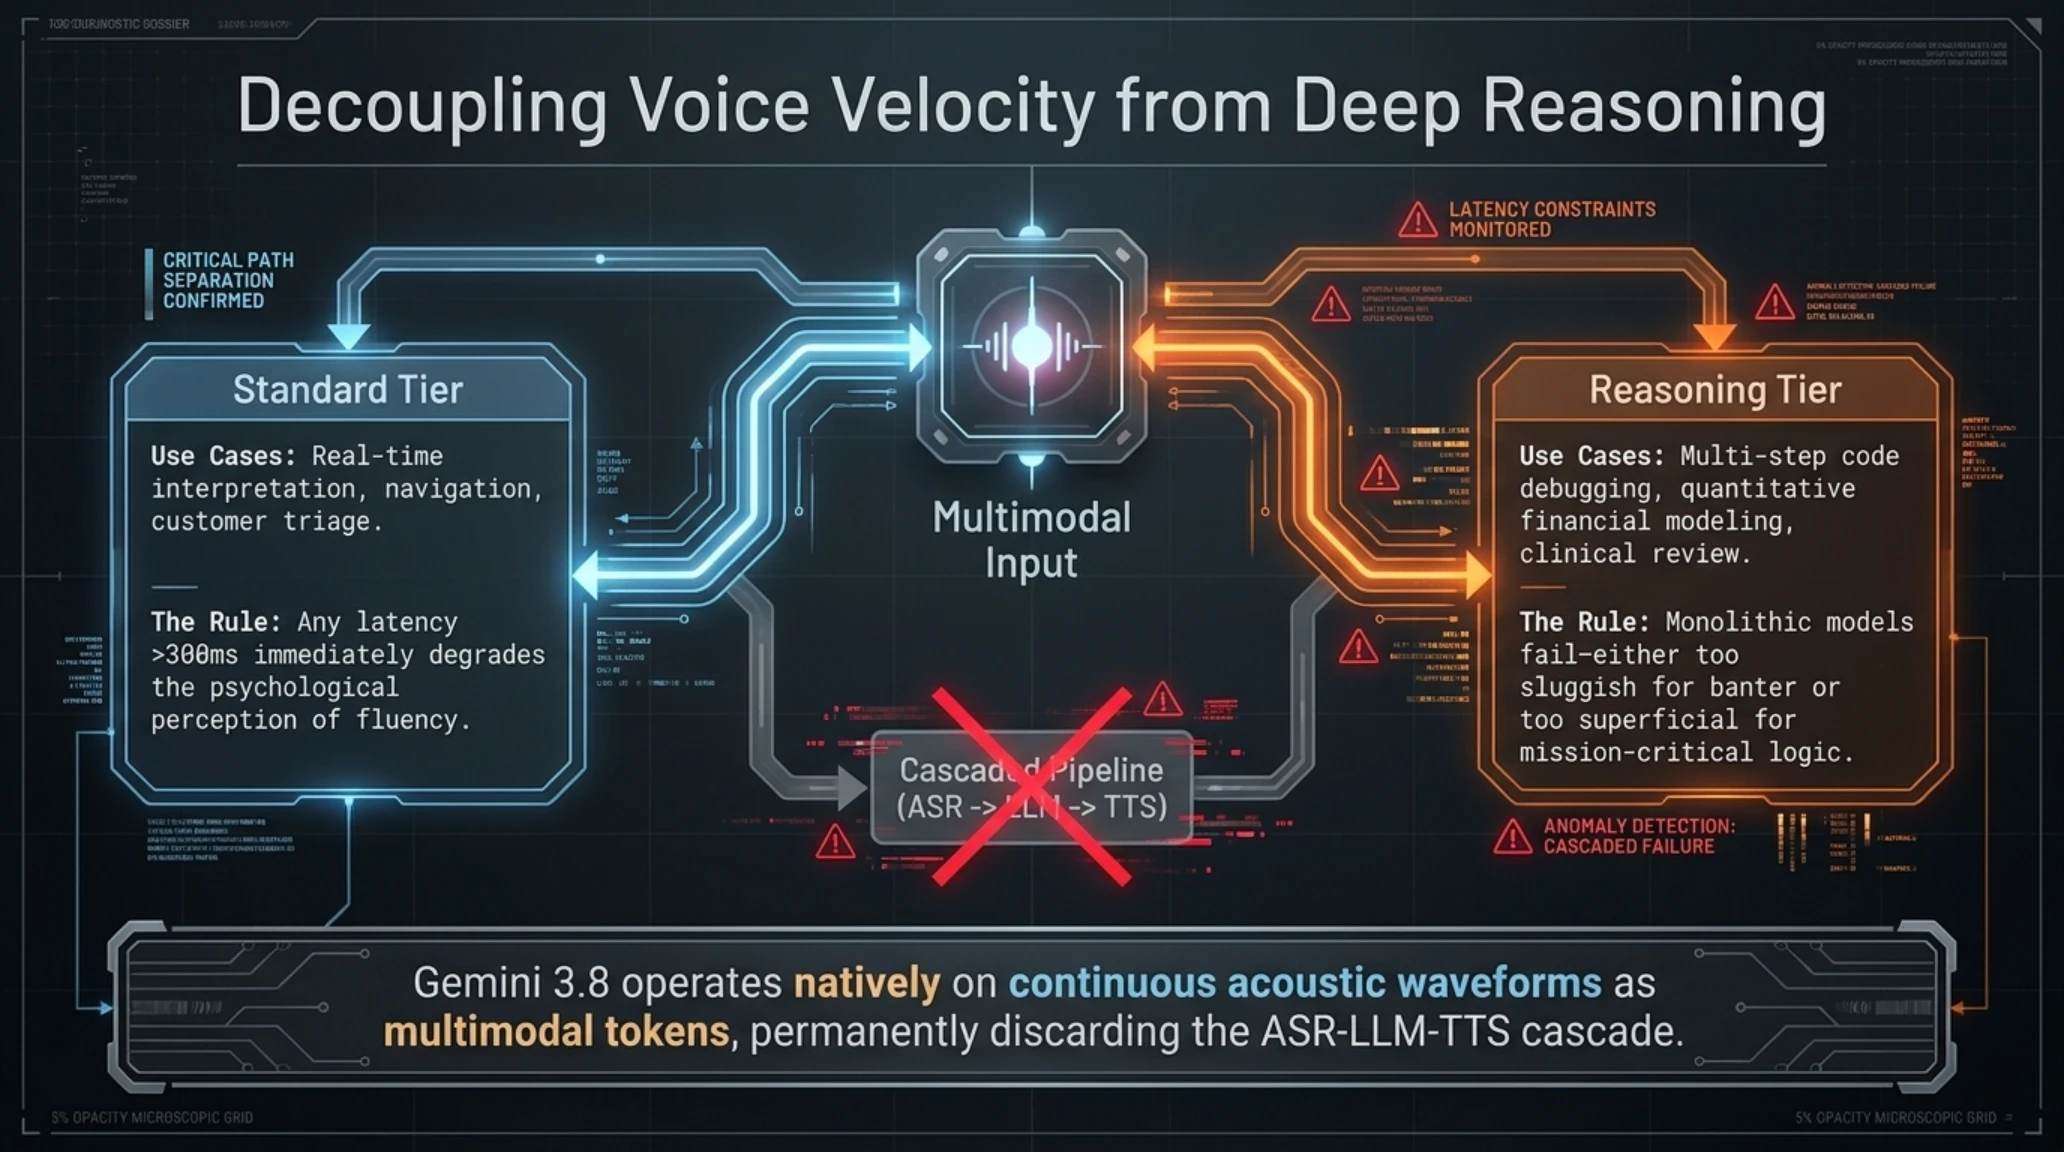
أظهرت البيانات الميدانية وتحليلات تدفق البيانات لدى جوجل ديب مايند انقسام أنماط التفاعل الصوتي للمستخدمين إلى مسارين مختلفين تماماً. المسار الأول يشمل التفاعلات اليومية البسيطة، والترجمة الفورية، والملاحة في الطرقات، وخدمات دعم العملاء في مراكز الاتصال؛ وفي هذه السيناريوهات، يعد زمن الاستجابة (Latency) العامل الحاسم؛ إذ إن أي تأخير يتجاوز 300 ميلي ثانية يفسد الإحساس بالتدفق التلقائي للحديث. أما المسار الثاني فيشمل استكشاف الأخطاء البرمجية المعقدة، والاستشارات الهندسية والطبية، والتحليلات المالية التفاعلية، وهي مهام تتطلب فترات تفكير متعمقة والبحث في أشجار الفرضيات المنطقية المتعددة.
قدمت جوجل حلاً معمارياً متكاملاً عبر إطلاق نموذجين يعتمدان على نواة تعلم عميق موحدة: الطراز الأول هو Gemini 3.8 Live القياسي، وهو نظام فائق السرعة وخفيف الوزن صُمم للتعامل مع مليارات الاستعلامات وخدمات الدعم اللحظية؛ والطراز الثاني هو Gemini 3.8 Live Extended Thinking، المزود بمسار استدلال متوازٍ ومحرك تفكير خلفي للتعامل مع أعقد التحديات التحليلية والحوسبية.
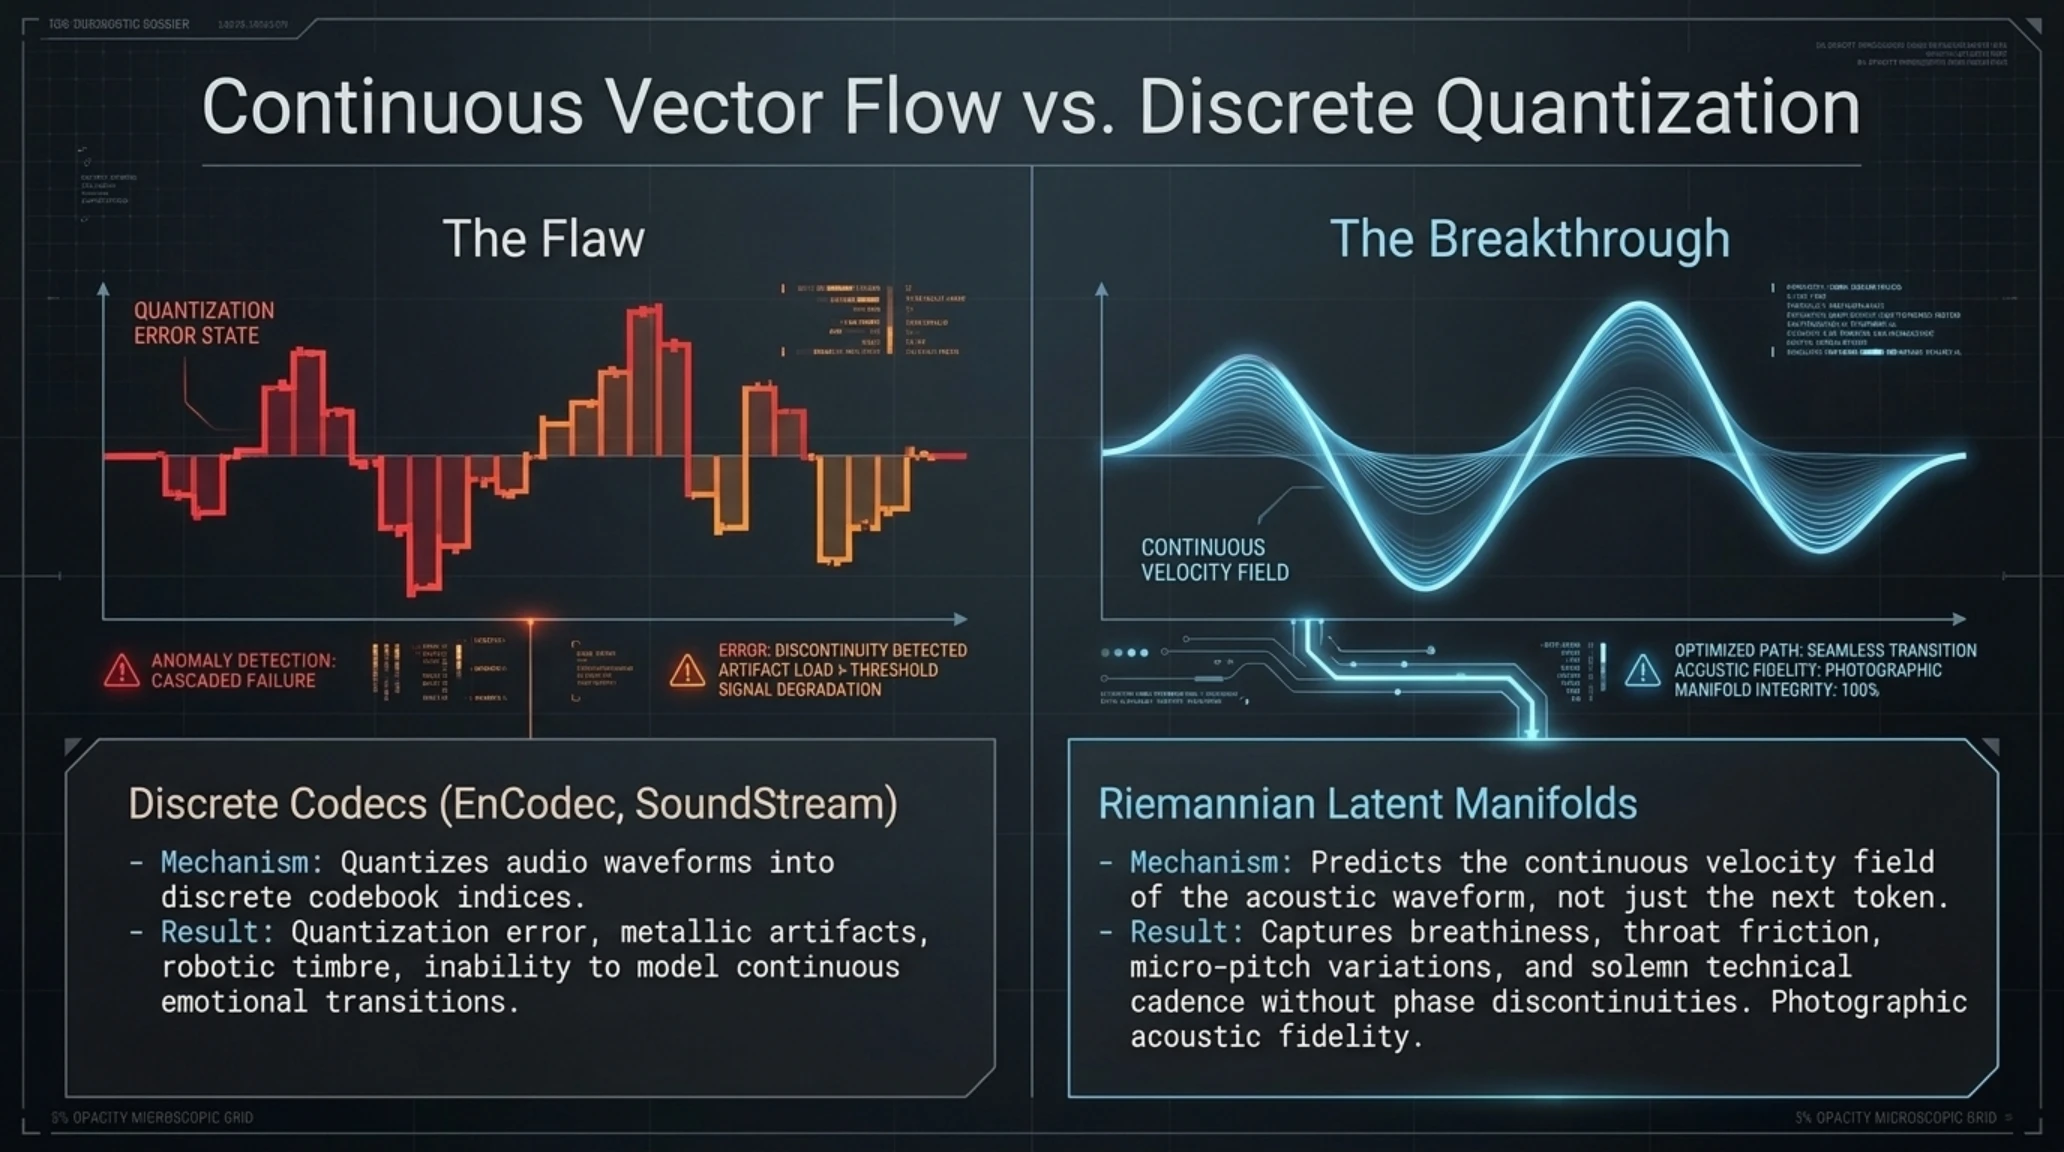
يشترك كلا النموذجين في ثورة معمارية كبرى: المعالجة العصبية المباشرة من صوت إلى صوت (Native Speech-to-Speech). في الأنظمة المتسلسلة الكلاسيكية، كان المطورون مجبرين على ربط ثلاثة أنظمة منفصلة؛ يبدأ النظام بنموذج لتحويل الصوت إلى نصوص (STT)، ثم نموذج لغوي لتوليد النص البديل (LLM)، وأخيراً محرك اصطناع صوتي لقراءة النص (TTS). تسببت هذه السلسلة في تراكم التأخيرات الزمنية وفقدان كافة السمات الإنسانية للصوت مثل النبرة، والمشاعر، والتردد، والهمس. أما عائلة Gemini 3.8 فتستقبل موجات الصوت الخام كمتجهات تدفق دلالية مستمرة، وتولد الرد الصوتي مباشرة بنبرة إنسانية حية وغنية بالتعبيرات العاطفية دون أي وسيط نصي.
تشريح طراز Live القياسي: استجابة دون 280 ميلي ثانية وسحر 97 لغة
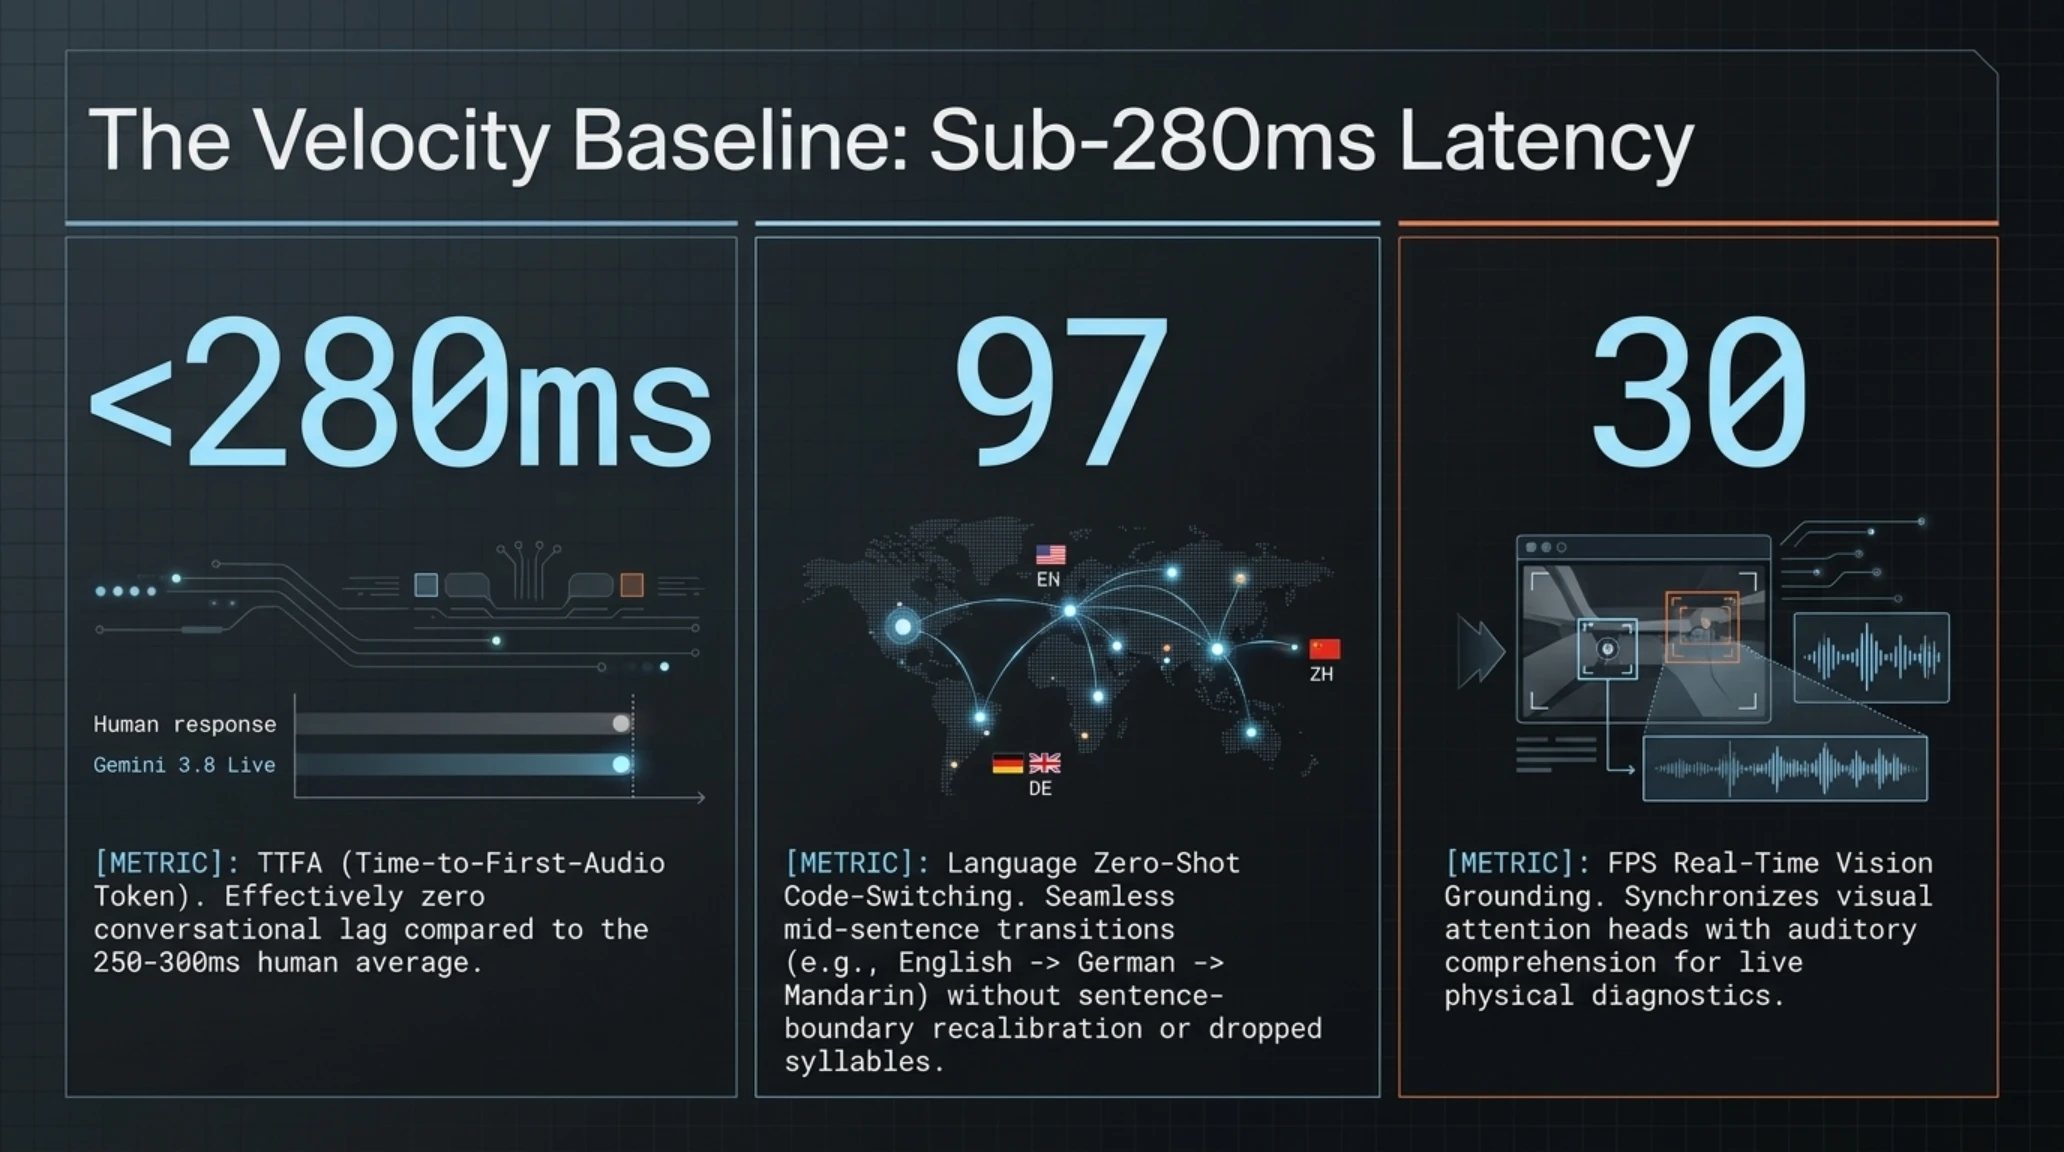
يجسد طراز Gemini 3.8 Live القياسي قمة الكفاءة الحوسبية في تقليص زمن الذهاب والإياب للبيانات (Round-Trip Latency). ففي الاختبارات الرسمية، نجح الطراز في تسجيل زمن استجابة لإصدار أول رمز صوتي (Time-to-First-Audio Token) يقل عن 280 ميلي ثانية، وهو زمن يتفوق على متوسط سرعة الاستجابة الطبيعية في المحادثات البشرية المباشرة (نحو 300 ميلي ثانية). تضمن هذه السرعة الفائقة اختفاء أي شعور بالتلكؤ أو التأخر في المكالمات الصوتية التفاعلية.
الميزة التقنية الأبرز في هذا الطراز هي قدرته الاستثنائية على التبديل الفوري التلقائي (Zero-Shot Code-Switching) بين 97 لغة عالمية في منتصف الجملة الواحدة. يمكن للمستخدم أن يبدأ جملته بالعربية، ثم يذكر مصطلحاً بالإنجليزية، ويكمل حديثه بالألمانية أو الفرنسية، ليتابع النموذج الحوار دون أي توقف أو تلعثم، مع ضبط فوري لمخارج الحروف واللهجات الصوتية الأصلية لكل لغة بفضل التدريب العصبي على مدونات صوتية متعددة اللغات بلغت أحجامها عدة بيتابايتات.
وإلى جانب الصوت، يتمتع الطراز بقدرة فائقة على دمج الفيديو المباشر ومعالجة كاميرا الجهاز في الزمن الحقيقي (Real-Time Vision Grounding). يمكن للمستخدم توجيه كاميرا هاتفه نحو عطل ميكانيكي في محرك السيارة، أو مخطط هندسي معقد، والتحدث مع النموذج الذي يحلل الإطارات بمعدل 30 إطاراً في الثانية، مقدماً إرشادات صوتية دقيقة تتماشى تماماً مع ما يشير إليه المستخدم بيده، مما يفتح آفاقاً واسعة لتطبيقات الواقع المعزز والمساعدات الذكية في الأجهزة المحمولة.
مسرعات TPU v5p والترميز العصبي لتدفقات الأمواج الصوتية
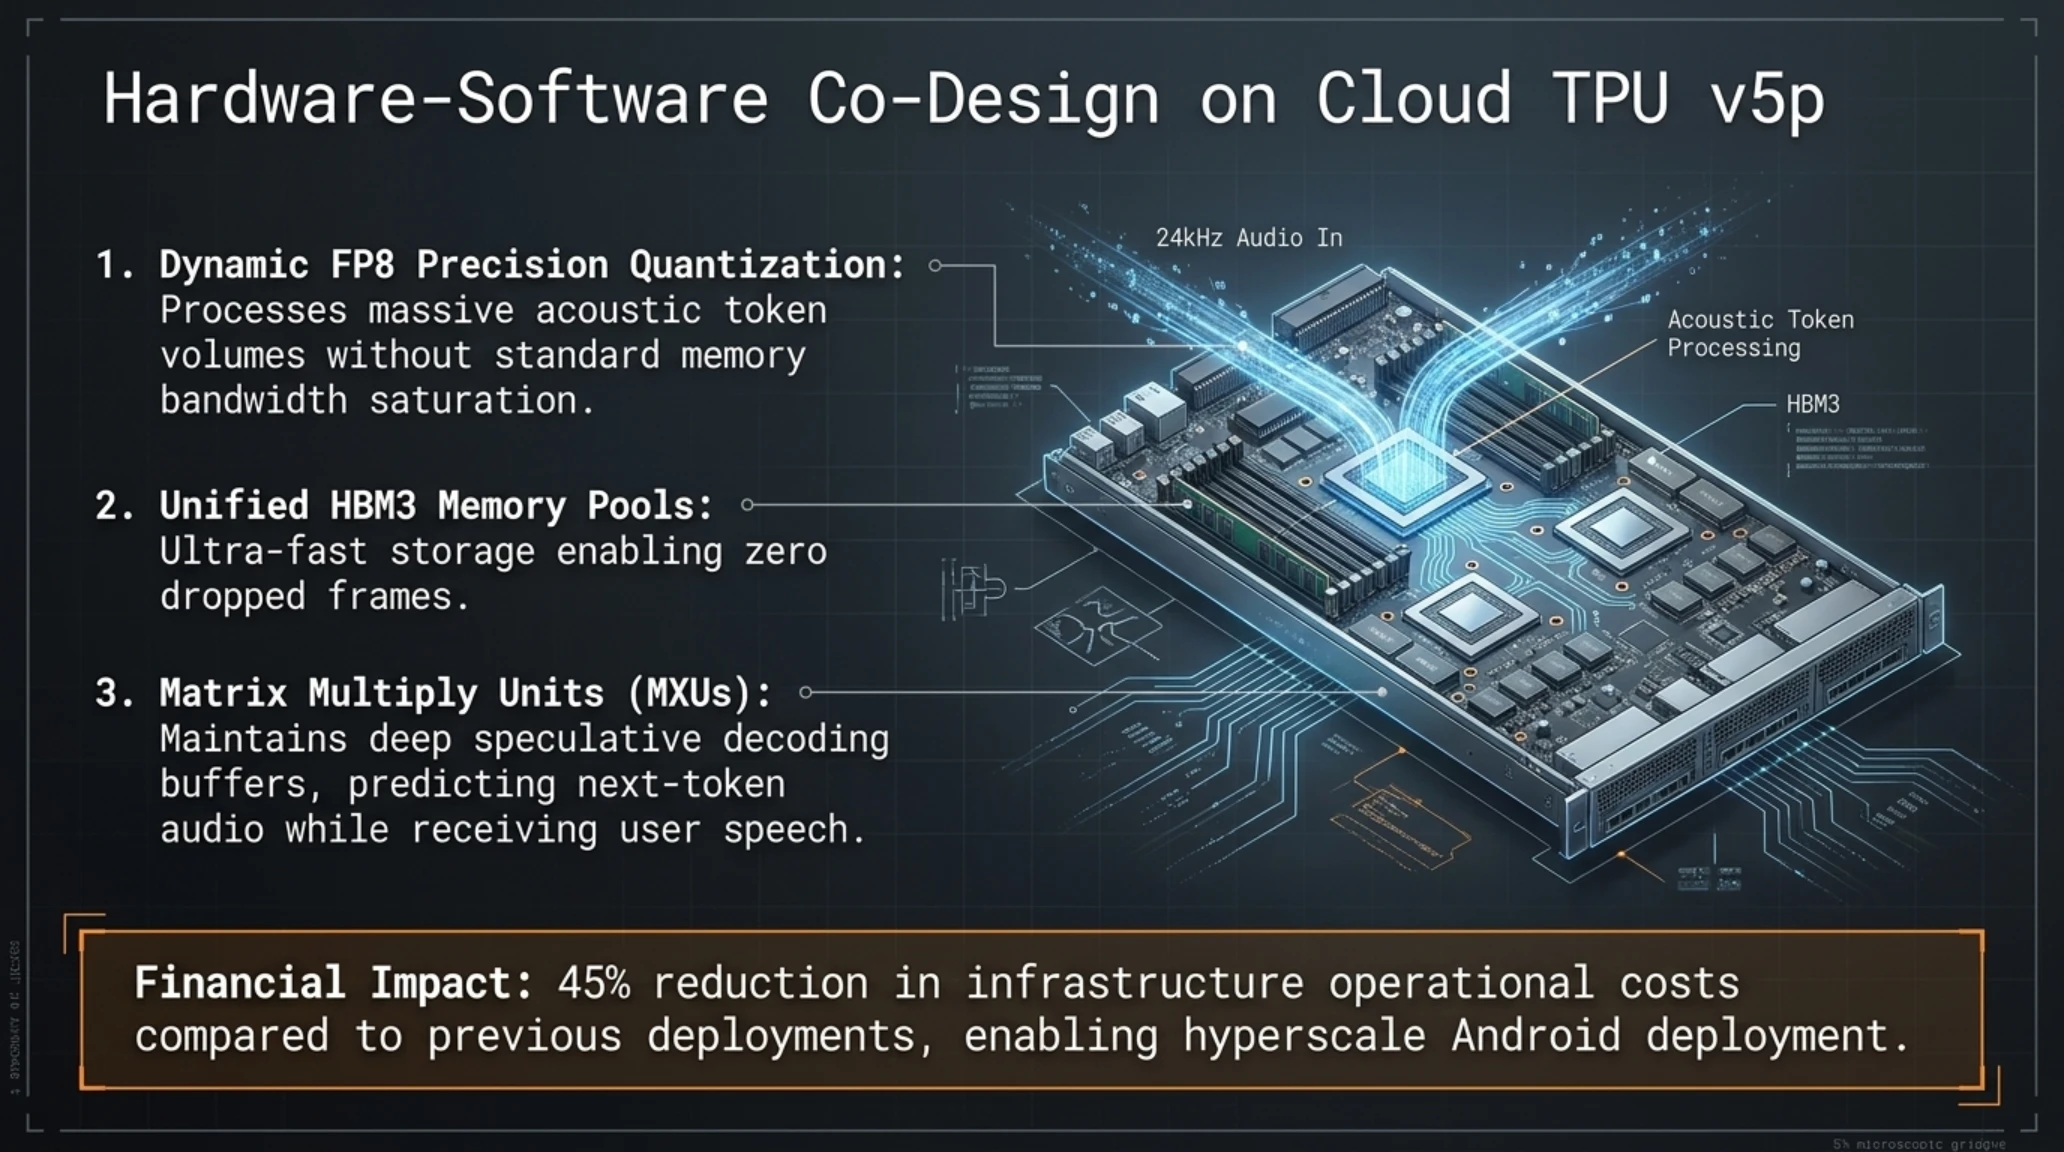
لتحقيق هذه السرعات القياسية تحت وطأة ملايين الطلبات المتزامنة، طورت جوجل بنيتها التحتية المادية. إن معالجة الإشارات الصوتية بتردد 24 ألف هرتز وتحويلها اللحظي إلى تدفقات دلالية مستمرة يفرضان عبئاً حوسبياً غير مسبوق على الرقائق الإلكترونية. تعتمد خوادم جوجل على مسرعات TPU v5p المتقدمة مع تقنيات التكميم الديناميكي بدقة FP8 وذاكرة HBM3 فائقة النطاق، مما يتيح معالجة المصفوفات الصوتية والنصية بتزامن تام ودون أي اختناق.
تضمن هذه المنظومة استقرار تدفق البيانات وحماية حزم الصوت من التقطع حتى في ظروف الشبكات الضعيفة. كما ساهمت المواءمة بين العتاد المخصص والبرمجيات منخفضة المستوى في خفض تكلفة التشغيل المؤسسي بنسبة 50 بالمئة مقارنة بالجيل السابق، مما يمهد الطريق لدمج هذه المنظومة بصورة شاملة في أنظمة أندرويد والأجهزة الذكية المستقبلية.
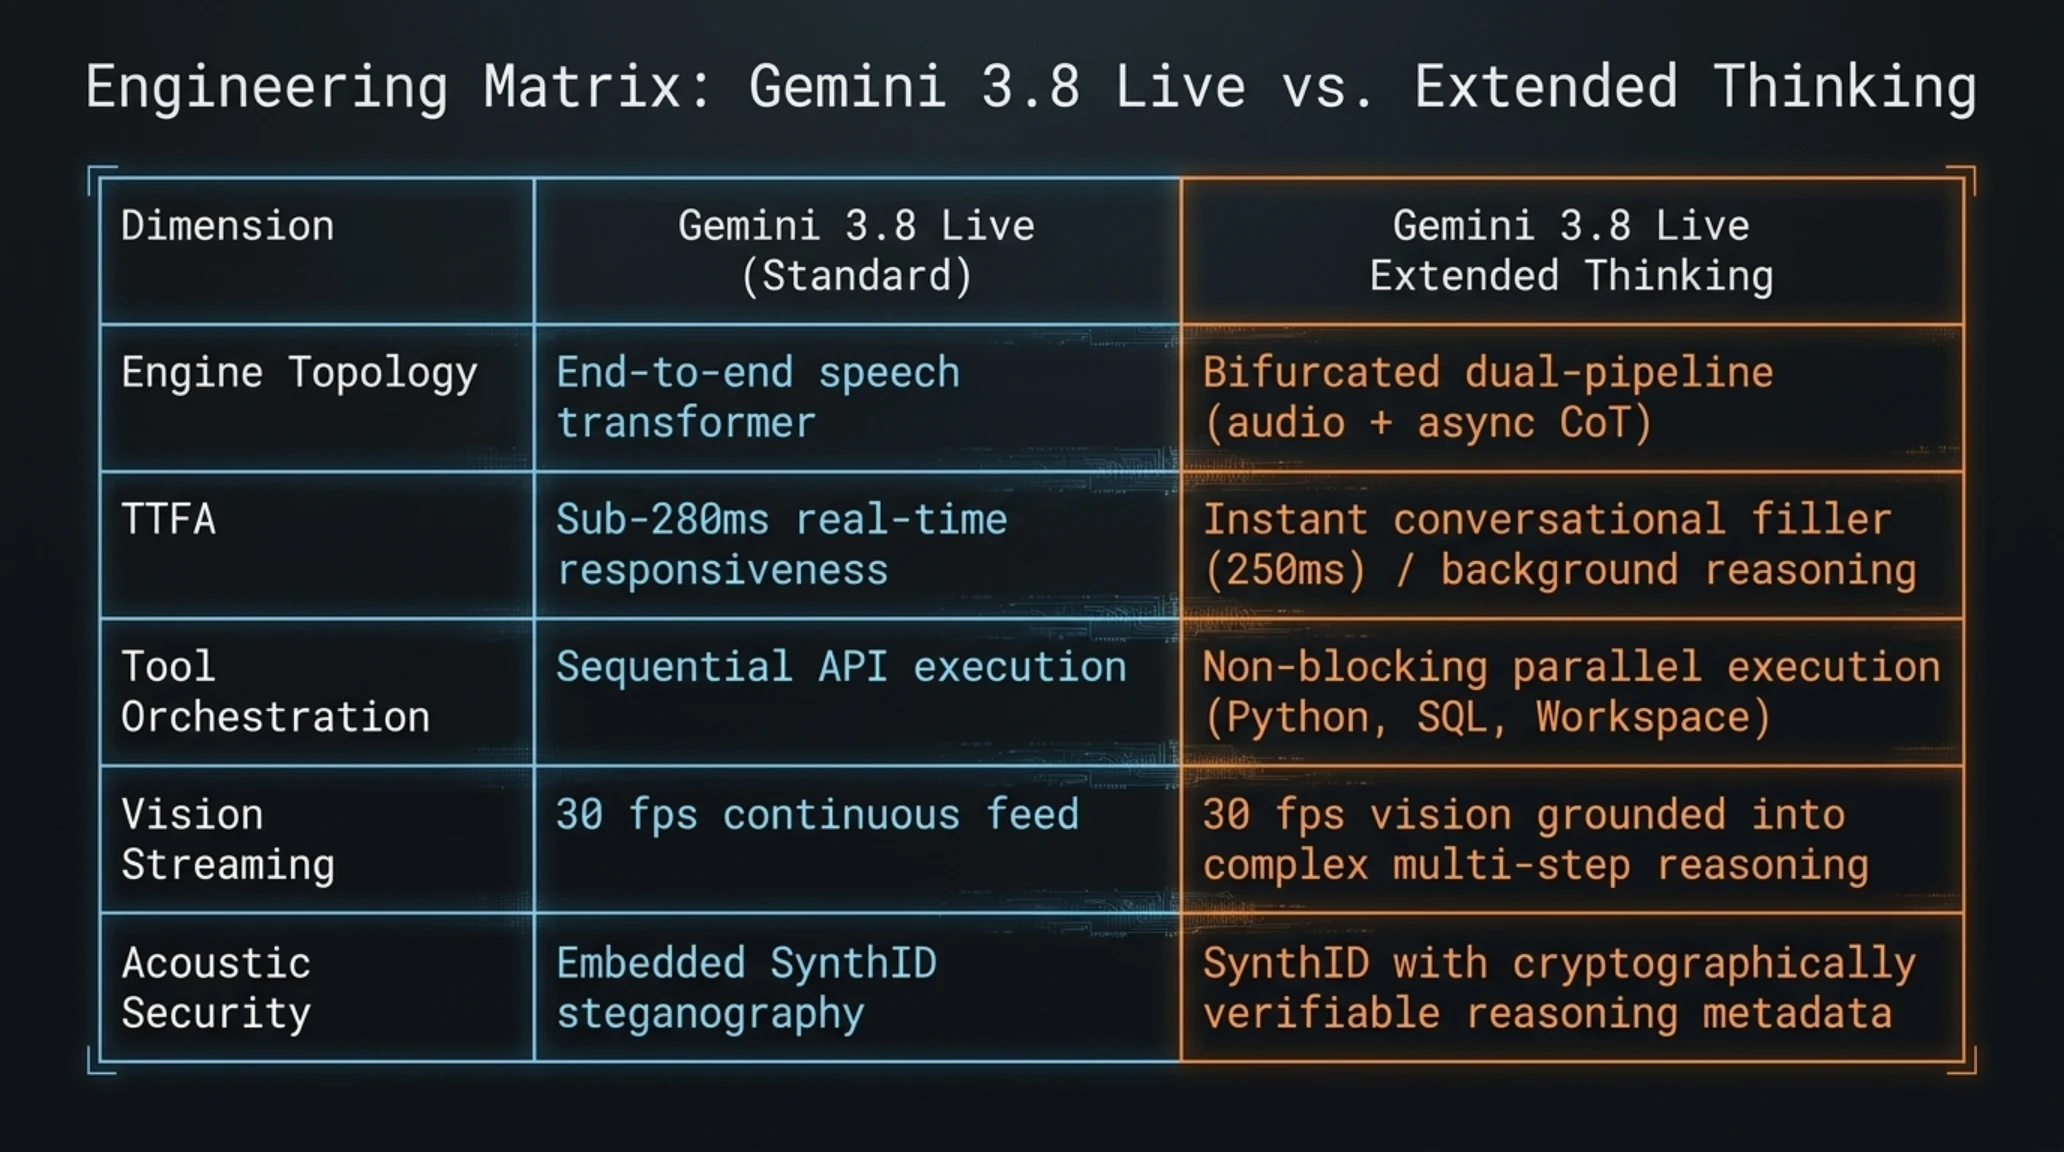
جدول المقارنة الهندسية: الخصائص التقنية لطراز Gemini 3.8 Live مقابل Extended Thinking
| المعيار الهندسي والتقني | طراز Gemini 3.8 Live القياسي | طراز Gemini 3.8 Live Extended Thinking |
|---|---|---|
| معمارية المعالجة الأساسية | محول عصبي مباشر متعدد الوسائط من صوت إلى صوت | محرك ثنائي المسار (مسار تخاطب صوتي + مسار تفكير استدلالي CoT) |
| متوسط زمن الاستجابة (TTFA) | أقل من 280 ميلي ثانية (تفاعل لحظي فائق) | استجابة صوتية تمهيدية في 250 ميلي ثانية / استكمال الاستدلال بالخلفية |
| الدعم اللغوي والتبديل الذاتي | 97 لغة مع تبديل لحظي في منتصف الجملة | 97 لغة مع تحليل منطقي متعدد اللغات وتكييف المصطلحات التقنية |
| استدعاء الأدوات البرمجية (Tool Use) | استدعاء الأدوات الخفيفة مع وقفات يسيرة | استدعاء غير متزامن وموازٍ دون قطع تدفق الصوت أو تعطيل الحوار |
| إدراك الفيديو الحي المباشر | معالجة مستمرة بمعدل 30 إطاراً في الثانية بتأخير ضئيل | تحليل إطارات الفيديو مع التدقيق المنطقي خطوة بخطوة |
| الأمان والتوثيق الصوتي | علامة مائية طيفية فيزيائية غير محسوسة عبر SynthID | علامة SynthID مدمجة مع توثيق مسار الاستدلال المنطقي في البيانات |
| الاستخدام الرئيسي في الأسواق | خدمة العملاء، البحث الصوتي، المساعدات اليومية | البرمجة الحية، التحليل المالي المعقد، القرارات المؤسسية الحرجة |
يوضح جدول المقارنة أعلاه التمايز الوظيفي الدقيق بين النموذجين في بيئات الحوسبة السحابية. إلا أن الابتكار الأكبر يكمن في الطراز الاستدلالي الممتد، حيث خضعت مفاهيم التفكير العصبي لقفزة حقيقية سنستكشف أسرارها في الجزء التالي.
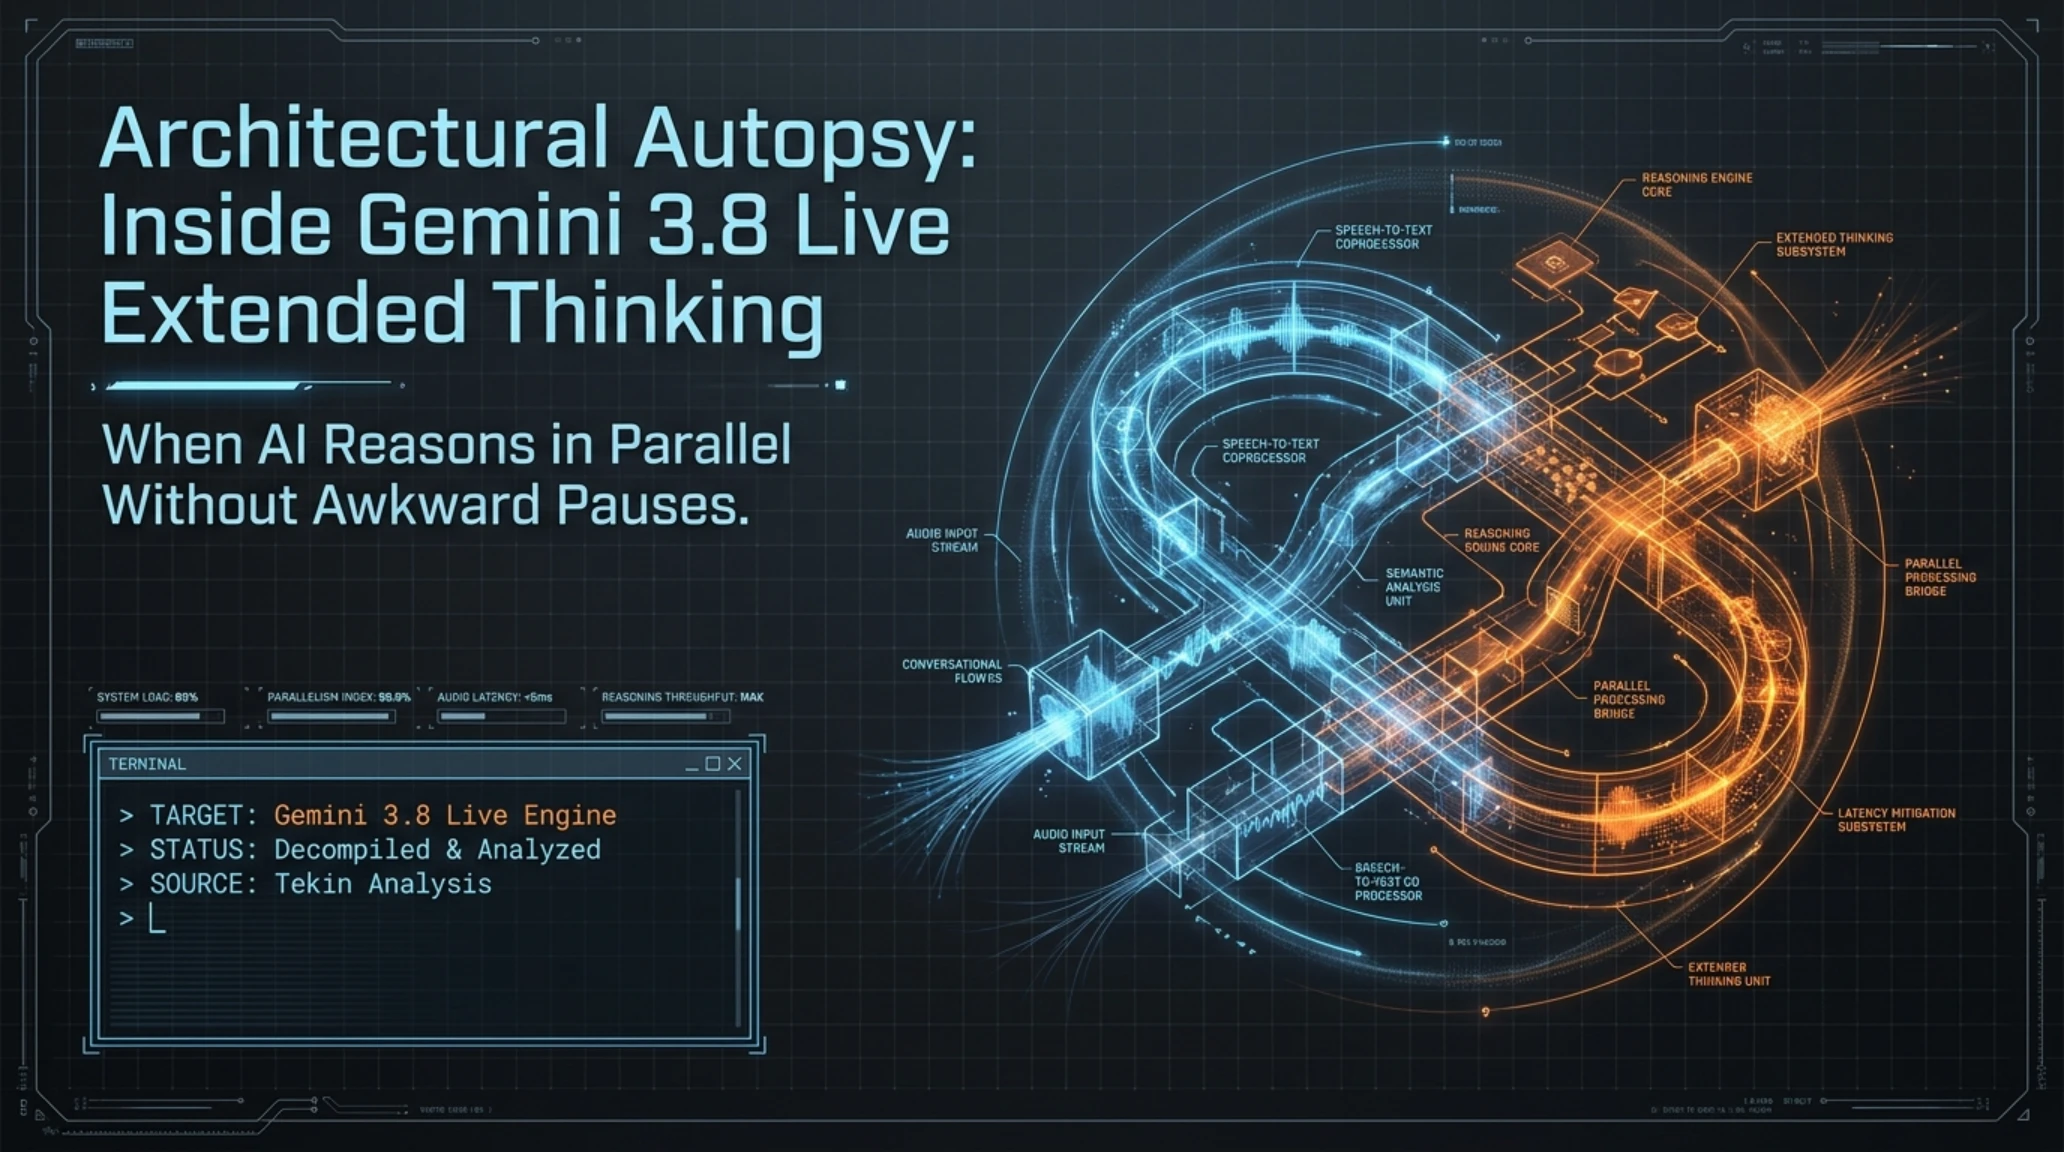
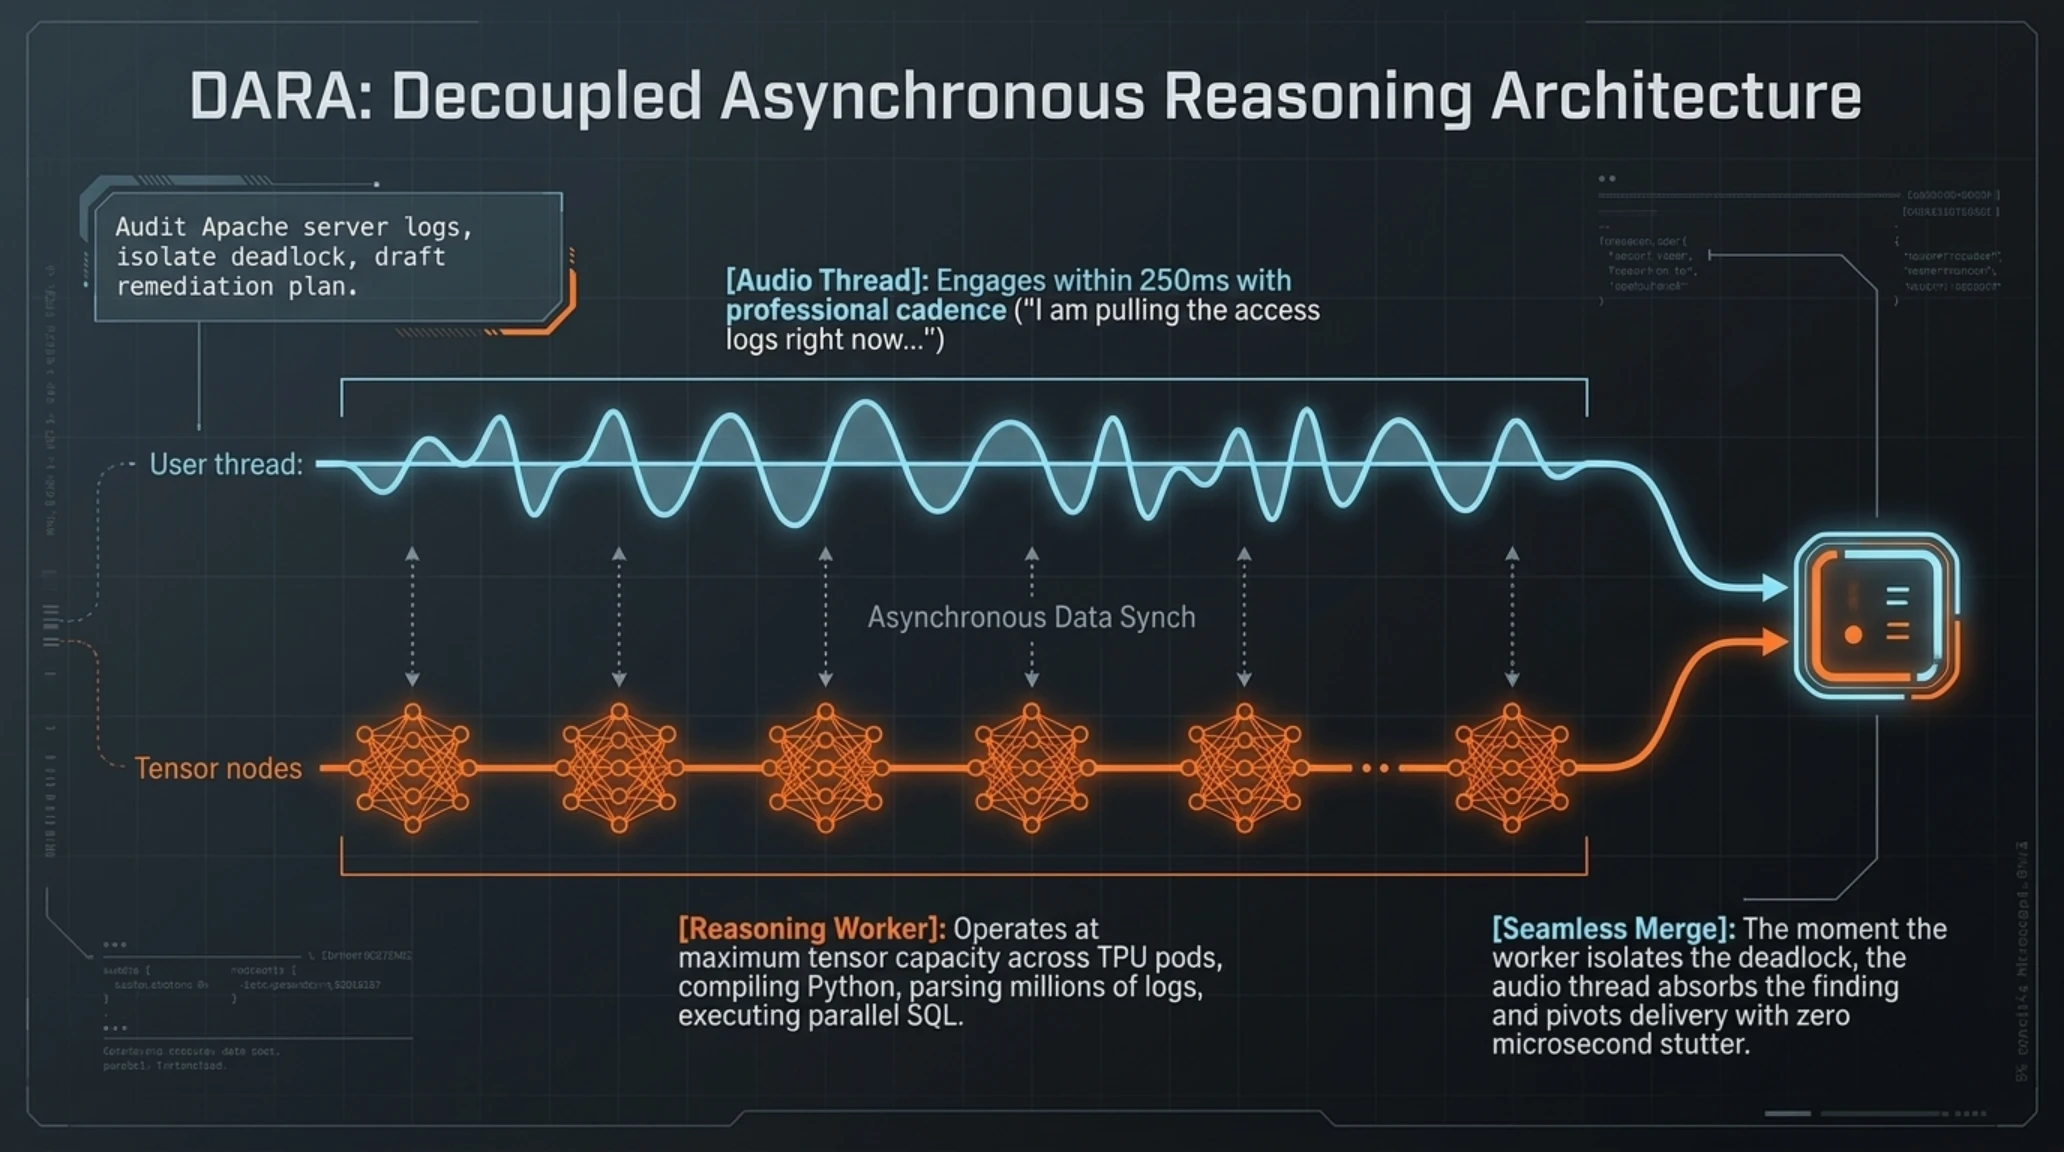
توضح الصورة التوضيحية أدناه معمارية المسار الثنائي المنفصل، حيث يعمل مسار التخاطب الصوتي ومسار الاستدلال الاستنتاجي بالتوازي عبر مسرعات TPU v5p دون أي تداخل في السياق.

لا يمثل طراز Gemini 3.8 Live Extended Thinking مجرد تحسين سطحي في زمن الاستجابة، بل يعبر عن تحول نموذجي في كيفية فهمنا للإدراك الآلي. لعقود خلت، افترض مهندسو الحوسبة أن عملية التفكير المنطقي يجب أن تسبق دائماً عملية صياغة الكلام؛ أي أن النظام ملزم بالتفكير أولاً، والوصول إلى الاستنتاج النهائي، ثم البدء في التحدث. ولكن هذا الطراز الاستدلالي المتقدم كسر هذه القاعدة التقليدية بصورة جذرية.
انقلاب الاستدلال المتوازي: الهندسة المذهلة لـ «التحدث أثناء التفكير»
تعتبر فترات الصمت الطويلة نقطة الضعف القاتلة في نماذج التفكير السابقة، بما فيها نماذج سلسلة o1 من أوبن إيه آي وإصدارات التفكير الأولى من فلاش. فعندما تواجه تلك النماذج مسألة معقدة، تحتاج لتوليد آلاف الرموز الداخلية ضمن «سلسلة التفكير» (Chain of Thought - CoT). في واجهات النصوص المكتوبة، يمكن للمستخدم الانتظار لعشرات الثواني مع ظهور رسالة جاري التفكير، لكن في المكالمات الصوتية الحية، يؤدي صمت النظام لخمس ثوانٍ فقط إلى تدمير تجربة التواصل واعتقاد المستخدم بأن الاتصال قد انقطع تماماً.
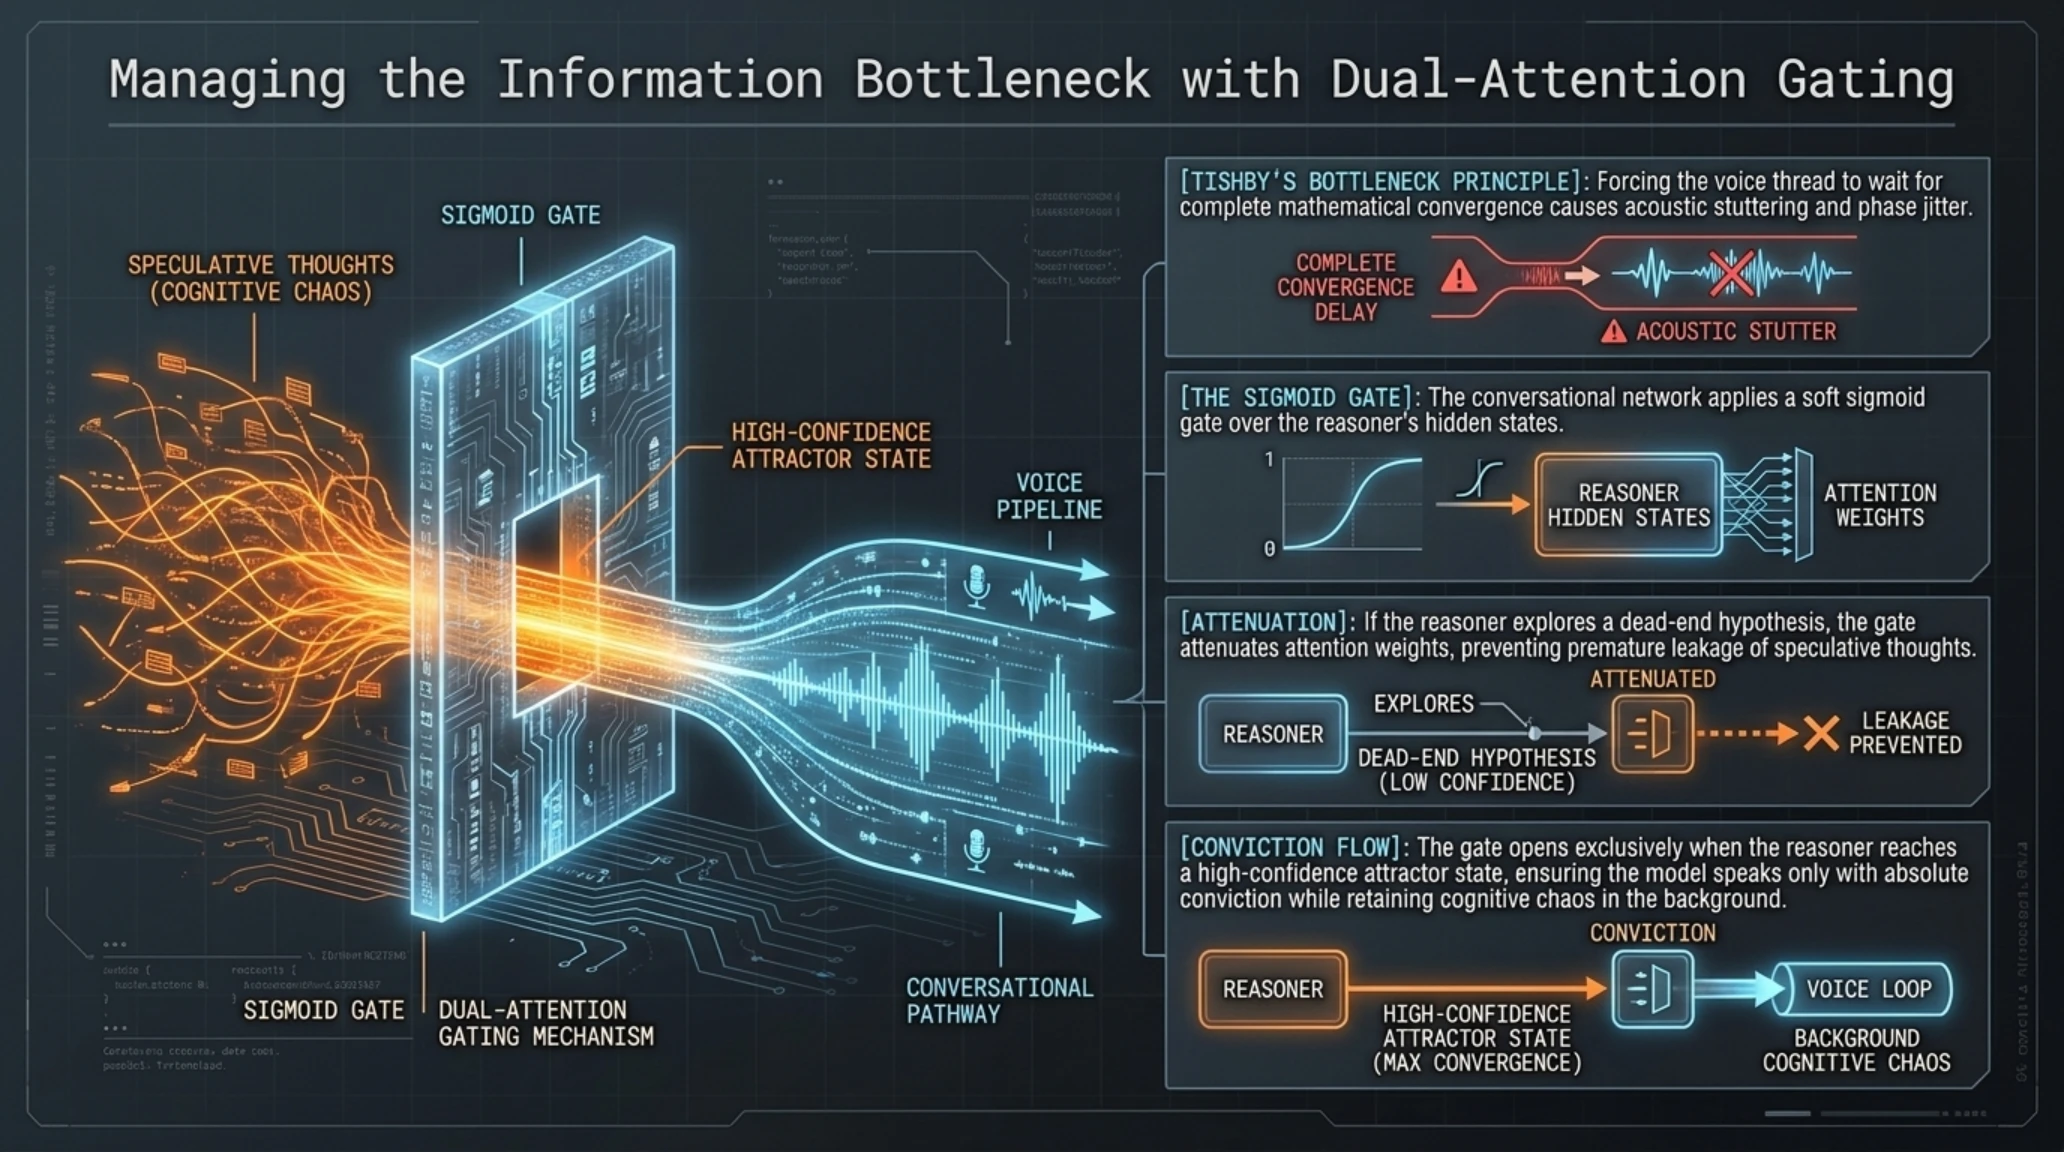
لحل هذه المعضلة المستعصية، طورت ديب مايند معمارية «فصل الاستدلال اللاتزامني المتوازي» (Decoupled Asynchronous Reasoning). ينقسم النظام بموجبها إلى محركين إدراكيين متزامنين: يتولى المحرك الأمامي إدارة التفاعل الصوتي، والحفاظ على نبرة الحديث وإيقاع التنفس والتفاعل الطبيعي بتأخير ضئيل للغاية؛ بينما يعمل المحرك الخلفي بكامل طاقته الحوسبية لتوليد سلاسل التفكير المنطقي، واستدعاء الأدوات السحابية واختبار الأكواد في بيئة برمجية معزولة.
في الممارسة العملية، عندما يطرح المستخدم طلباً معقداً مثل: «حلل سجلات الخادم وحدد سبب تراجع أداء المدفوعات الإلكترونية هذا الصباح» لا يلتزم النموذج بالصمت إطلاقاً. في أجزاء من الثانية، يبدأ المسار الصوتي بنبرة مهنية واثقة: «بالتأكيد، أقوم حالياً باستعراض ملفات السجلات الصباحية... دعني أقارن سجلات قاعدة البيانات بحركات الدفع المسجلة...». وأثناء نطق هذه الجمل التوضيحية المفيدة، يقوم المحرك الخلفي بفحص ملايين الأسطر واستخراج الأنماط الإحصائية. وبمجرد اكتشاف سبب الخطأ في قفل قاعدة بيانات متزامن، يسلم المحرك الخلفي النتيجة إلى المسار الصوتي ليعلنها فوراً ودون أي انقطاع.
التفاعل المزدوج الكامل ومرونة مقاطعة الحديث في لحظات
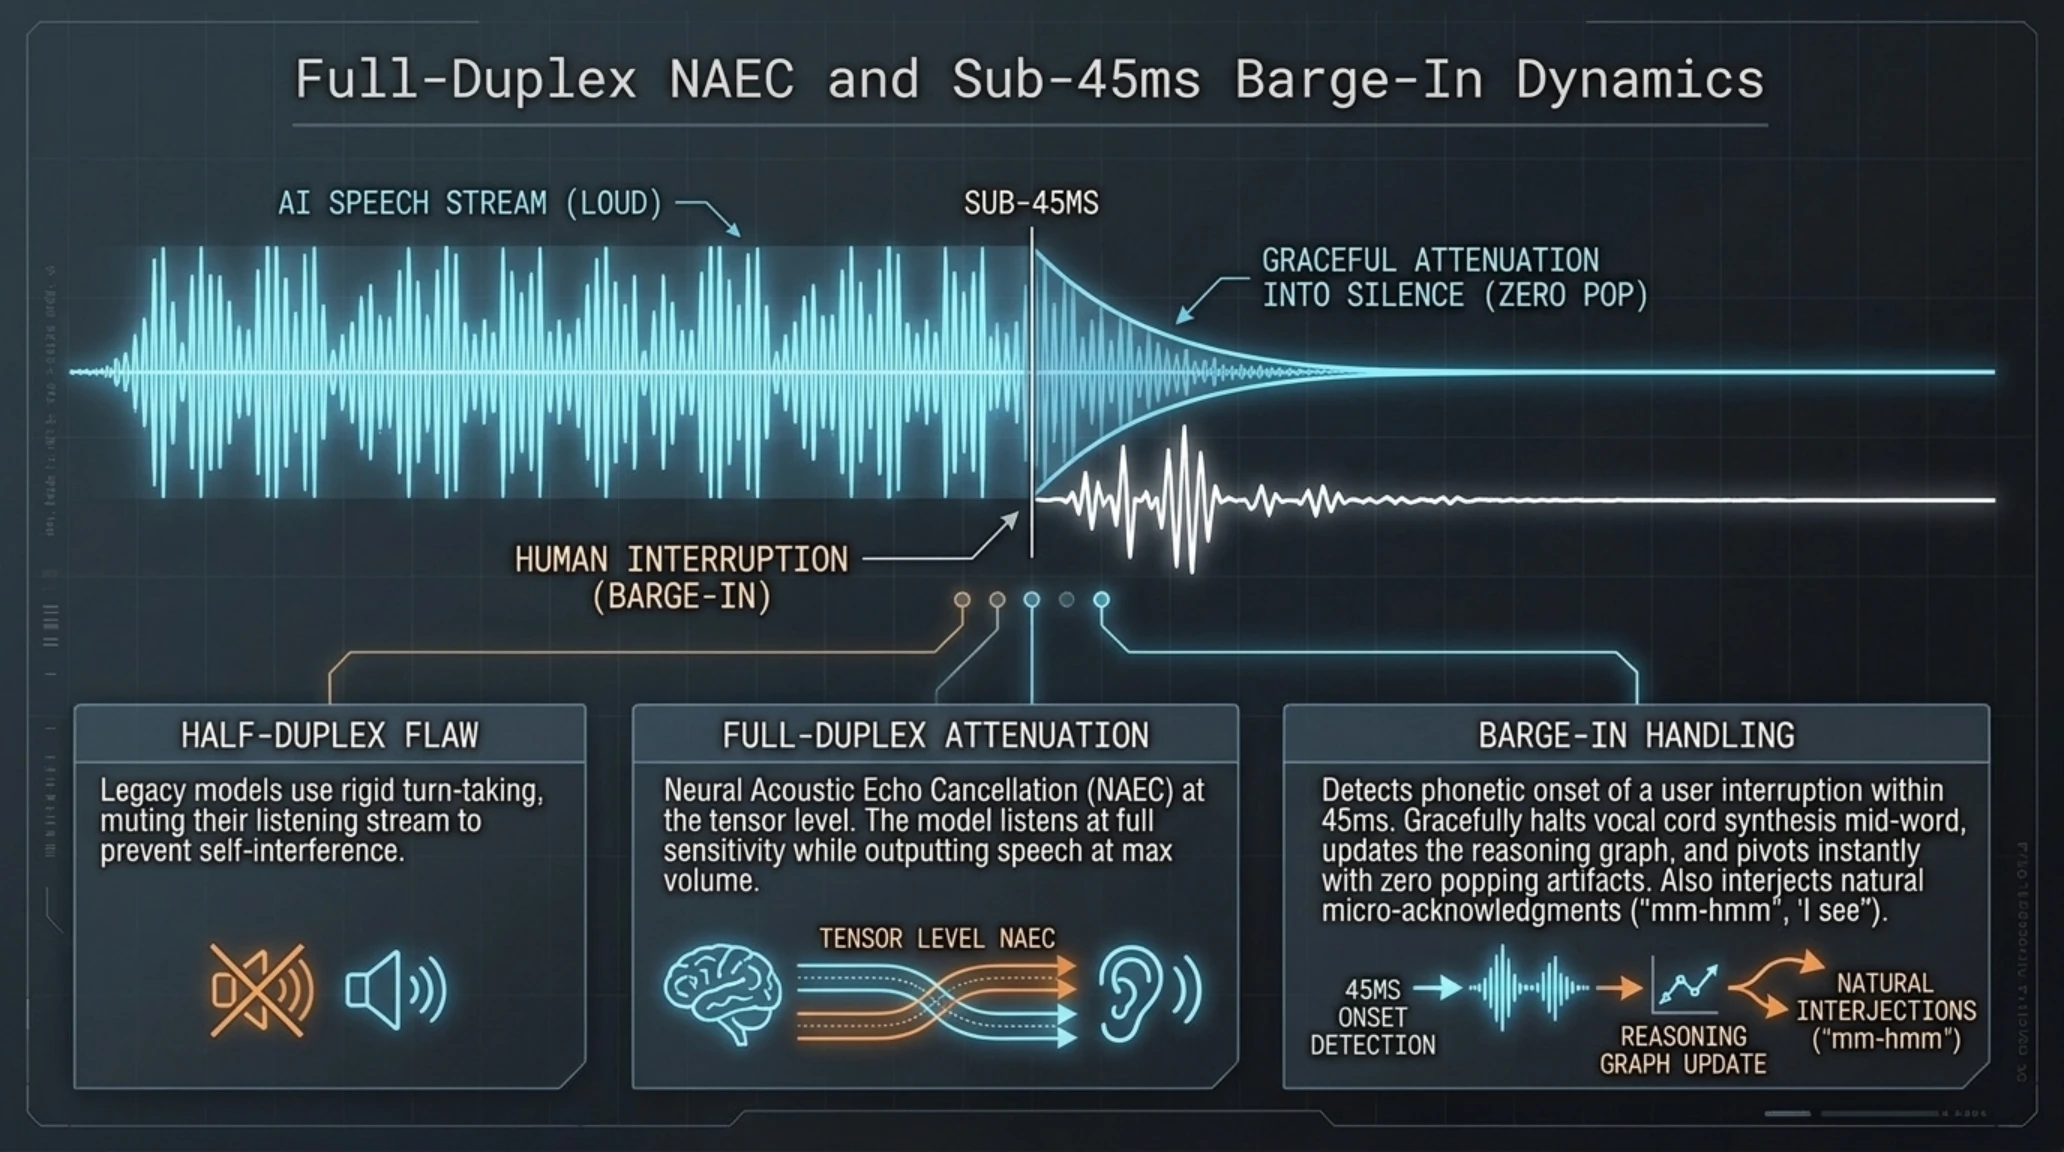
الابتكار المعماري الآخر في عائلة Gemini 3.8 هو تطوير نظام التفاعل ثنائي الاتجاه الكامل (Full-Duplex) وآلية التحكم اللحظي في مقاطعة الحديث (Barge-in Dynamics). في الأنظمة القديمة نصف المزدوجة، كان المساعد يستمع فقط حين يصمت المستخدم، ويغلق الميكروفون حين يتحدث هو لتفادي التداخل، مما يعطي إحساساً آلياً يشبه أجهزة الاتصال اللاسلكي القديمة.
أما Gemini 3.8 Live فيتضمن نظاماً عصبياً متطوراً لإلغاء الصدى الصوتي (Neural Acoustic Echo Cancellation) وفلاتر مكانية لعزل الإشارات. يواصل النموذج الاستماع بتركيز كامل لصوت المستخدم حتى أثناء تحدثه هو بأعلى نبرة. فإذا قاطعه المستخدم في منتصف الشرح قائلاً «تجاوز هذه النقطة وانتقل فوراً للخطأ الثاني»، يوقف النموذج حديثه في أقل من 50 ميلي ثانية، ويستوعب التوجيه الجديد ويوجه دفة الحوار بمرونة فائقة ودون صدور أي تشويش صوتي مزعج.
فضلاً عن ذلك، يحاكي النموذج ببراعة الإيماءات الصوتية البشرية التفاعلية في الخلفية (Backchanneling). فعندما يروي المستخدم مسألة طويلة، لا يصمت النموذج كجماد صامت، بل يصدر همهمات تفاعلية خفيفة مثل «نعم»، «صحيح»، «أتابعك»، مما يشعر المتحدث بأنه يتحاور مع رفيق ذكي ومتيقظ في الطرف الآخر من الاتصال.
آلية مشاركة ومزامنة ذاكرة التخزين المؤقت KV بين مسار الصوت والتفكير
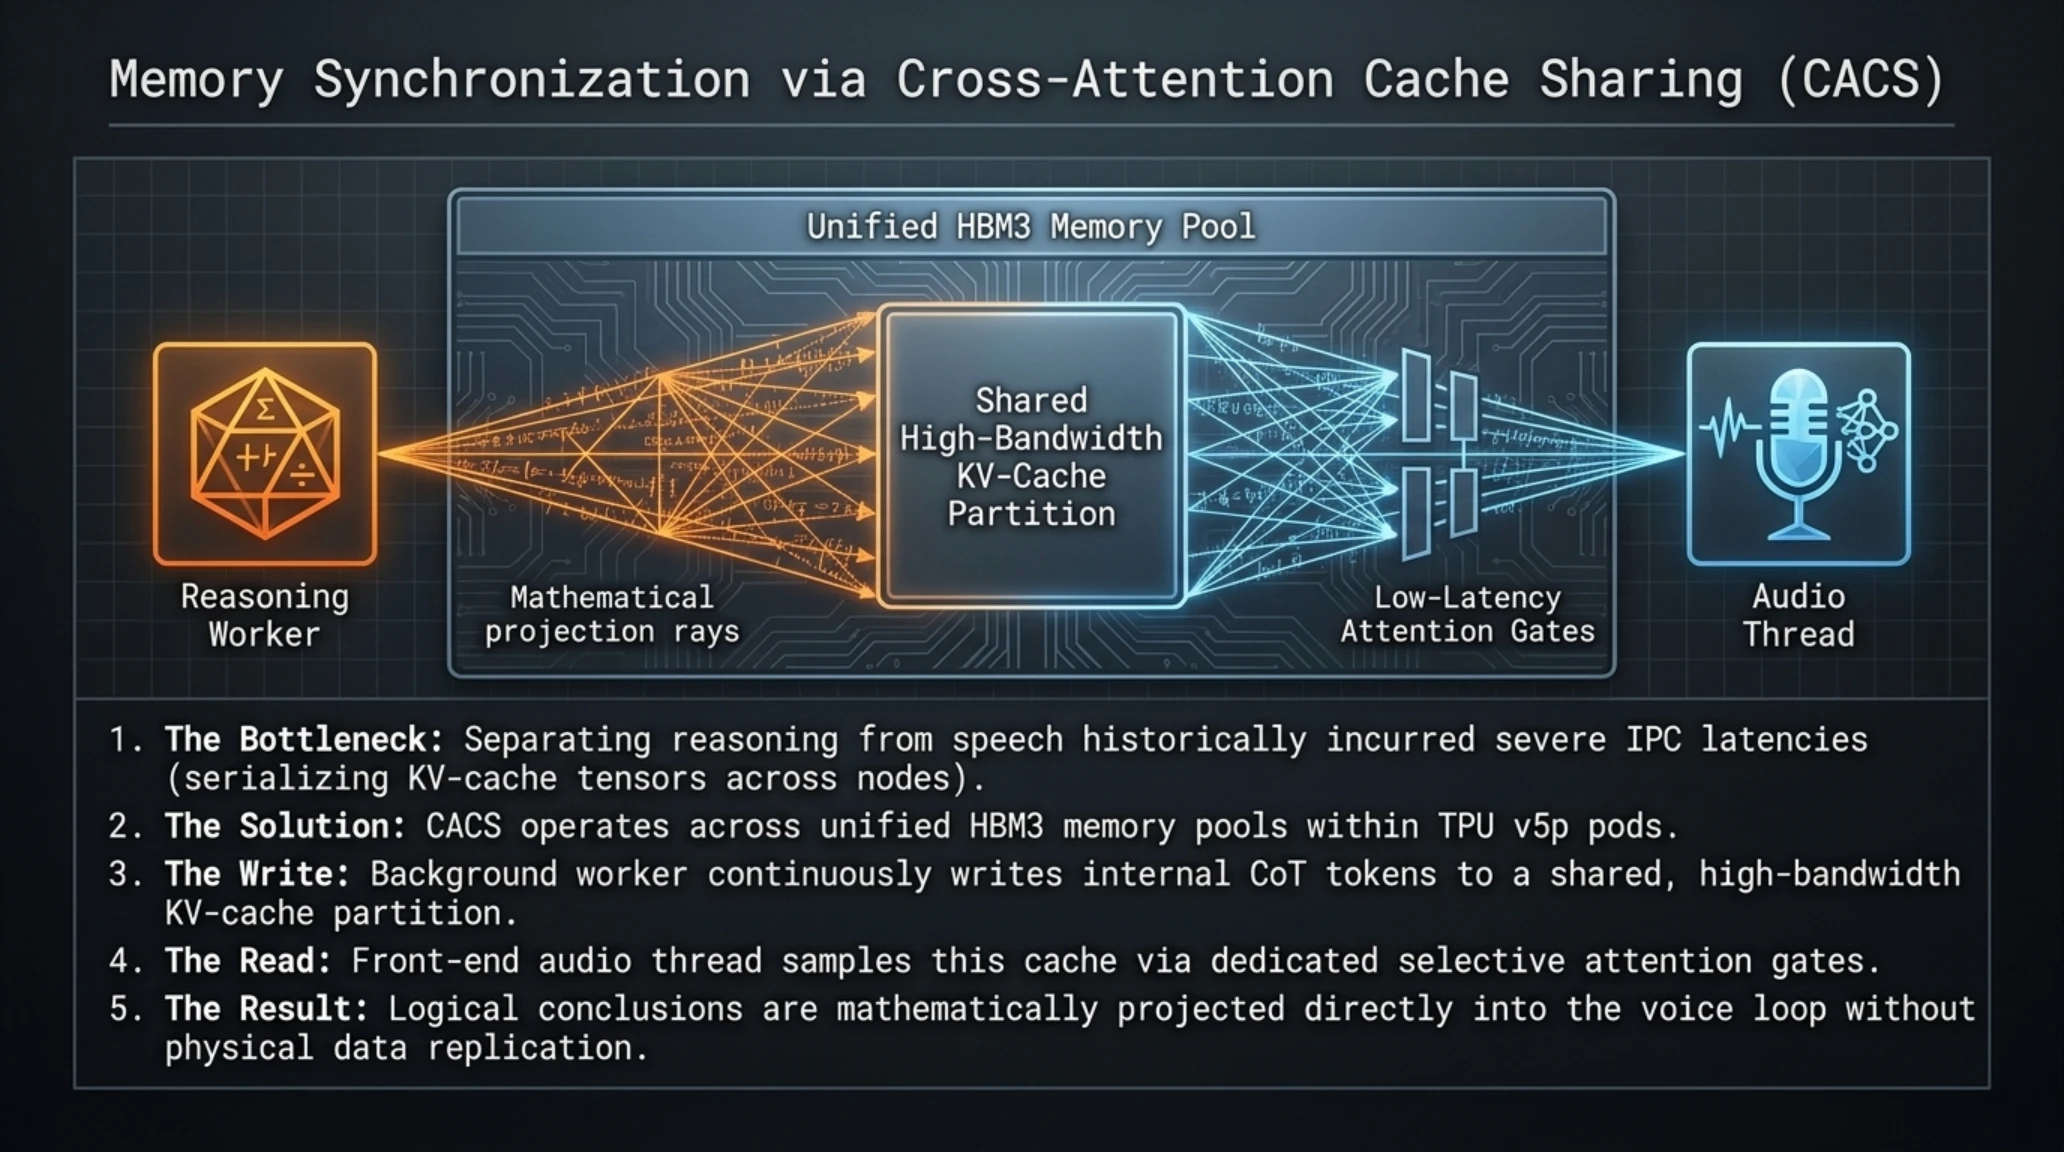
تطلب تنفيذ التفكير الصوتي المتزامن ابتكار حل جذري لمعضلة إدارة ذاكرة التخزين المؤقت للمفاتيح والقيم (KV-Cache). فلو كان مسار الصوت ومسار الاستدلال يعملان كنموذجين منفصلين تماماً، لتسبب نقل السياق الإدراكي بينهما في تأخير هائل بسبب محدودية نطاق الذاكرة. حلت ديب مايند هذا التحدي عبر تصميم بنية ذاكرة مشتركة تحت اسم «Cross-Attention Cache Sharing».
في هذا النظام، يكتب مسار الاستدلال الخلفي رموز تفكيره في مساحة ذاكرة مؤقتة مشتركة. ويقوم مسار الصوت عبر بوابات انتباه انتقائية (Selective Attention Gates) بمراقبة مخرجات هذه الذاكرة باستمرار. بمجرد اكتمال استنتاج منطقي في الخلفية، تمتص بوابات الانتباه تلك النتائج دون حاجة لنسخ البيانات، وتدمجها فوراً في الجمل الصوتية التالية، مما يضمن تدفقاً معلوماتياً متصلاً ودقيقاً للغاية.
يوثق مقطع الفيديو الحصري أدناه الاختبار الميداني الرسمي لطراز Gemini 3.8 Live Extended Thinking، موضحاً حل الأخطاء البرمجية المعقدة في الزمن الحقيقي مع سرد صوتي مستمر دون أي وقفات محرجة.
مع هذا التطور المذهل، أثيرت تساؤلات فنية عديدة حول طبيعة الجمل التي يطلقها النموذج أثناء التفكير، وهو ما نوضحه بدقة في التحليل المقارن أدناه.
شائعة أم حقيقة: حقائق هندسية حول التفكير المتوازي أثناء التحدث
الشائعة الشائعة: النموذج يردد عبارات جاهزة ومسجلة مسبقاً لكسب الوقت دون وجود تنسيق حقيقي بين الصوت ومحرك التفكير.
الحقيقة الهندسية المثبتة: كافة العبارات التمهيدية تتولد لحظياً بناءً على معطيات المسألة قيد المعالجة؛ حيث يسرد النموذج خطوات تفكيره الحية (Live Progress Narration) ويعكس المتغيرات البرمجية والحسابية التي تتنقل في مسار الاستدلال في تلك اللحظة بالذات، وهو تنسيق عصبي مباشر داخل أوزان المحول وليس مجرد سيناريو مسبق.
إلا أن هذه القفزة الهائلة في واقعية المحاكاة الصوتية فرضت تحديات أمنية جسيمة لم تشهدها الصناعة من قبل. في الجزء التالي، نستعرض الدرع الأمني لتقنية SynthID لحماية المحتوى من التزييف العميق وكيفية تكامل النموذج مع البنية السحابية العالمية.
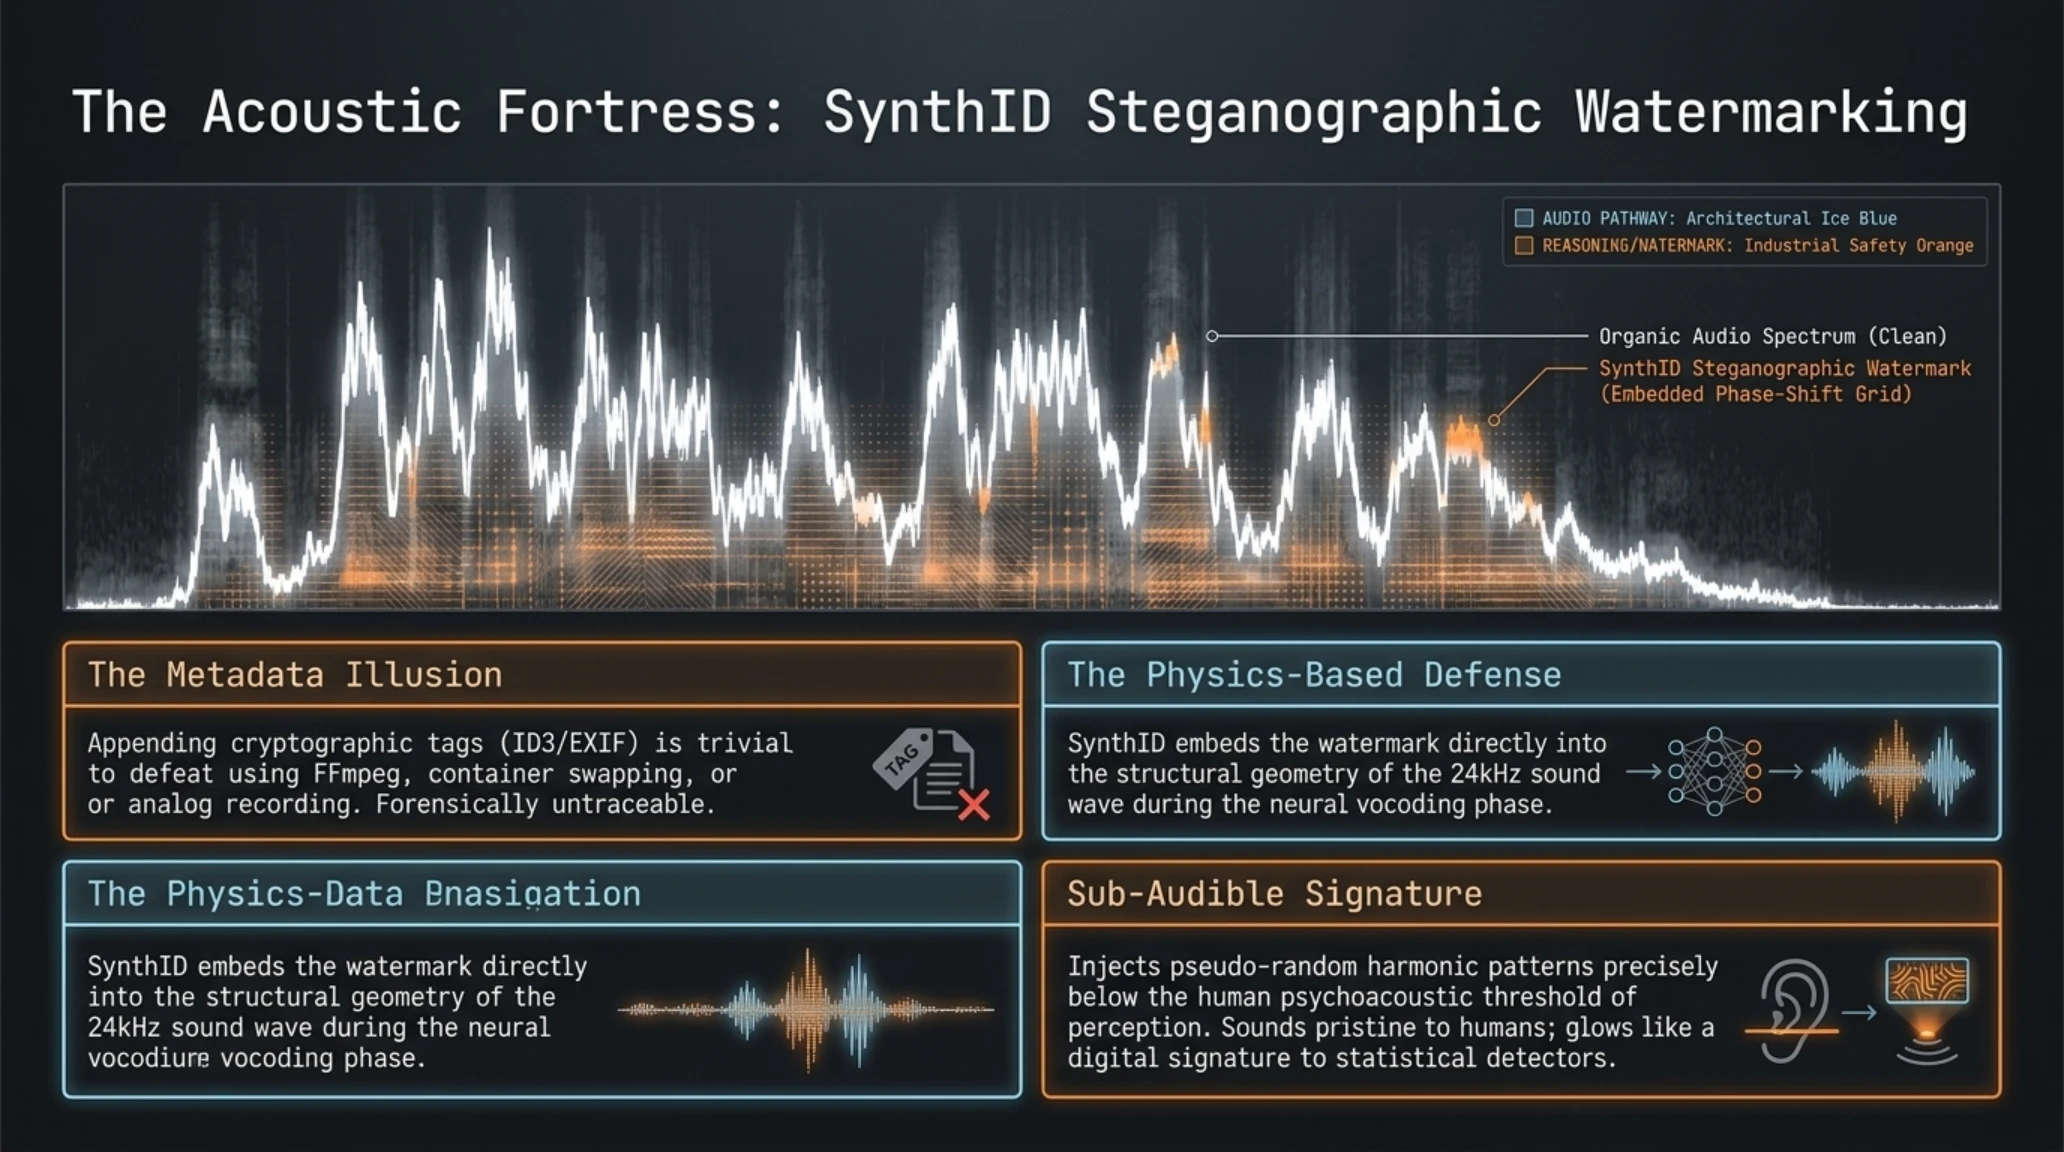
يوضح التحليل الطيفي الجنائي أدناه الاضطرابات الترددية الدقيقة التي يحقنها محرك SynthID Audio في موجات Gemini 3.8 الصوتية، مقارنة بأطياف الصوت البشري الطبيعي غير المعدل.

مع اقتراب النماذج الصوتية التوليدية من المحاكاة التامة للحبال الصوتية البشرية وتجاوزها لما يعرف بـ «الوادي الغريب» (Uncanny Valley)، تتضاعف المخاطر الأمنية والاجتماعية بصورة غير مسبوقة. ففي غياب أدوات التحقق الجنائية الموثوقة، يمكن استغلال هذه النماذج في تزوير الهويات الصوتية للمسؤولين، واختراق أنظمة البصمة الصوتية في القطاع المصرفي، وتنفيذ عمليات الاحتيال المالي المعقدة، وبث الشائعات المضللة في أوقات الأزمات الحساسة. وجاء الرد التقني الصارم من جوجل عبر الدمج الشامل لتقنية العلامات المائية الصوتية المتقدمة SynthID Audio.
الحصن الصوتي SynthID: درع التشفير الطيفي ضد التزييف الصوتي العميق
تاريخياً، اعتمدت محاولات وسم الوسائط الرقمية على تضمين بيانات وصفية مشفرة في ترويسة الملفات (Metadata Tags مثل وسوم ID3 للملفات الصوتية). من المنظور الأمني، يعتبر هذا النهج هشاً للغاية؛ إذ يستطيع أي مهاجم نزع تلك البيانات بسهولة باستخدام أدوات برمجية مجانية وسريعة مثل FFmpeg، أو تحويل الملف إلى صيغة أخرى، أو تشغيل الصوت وتسجيله عبر ميكروفون خارجي، مما يفقد المقطع كل أثر جنائي يثبت أصله الاصطناعي.
على العكس من ذلك، تعمل تقنية SynthID Audio التي طورتها جوجل ديب مايند وفق مبدأ فيزيائي راسخ: إذ تقوم بدمج العلامة المائية داخل البنية الهندسية للموجة الصوتية ذاتها. أثناء مرحلة التوليد العصبي للصوت (Neural Vocoding)حيث تتحول المتجهات المجردة إلى ترددات صوتية مسموعة بدقة 24 ألف هرتزتتدخل شبكة تمييز إضافية لحقن أنماط هارمونية طفيفة وتعديلات دقيقة في زوايا الطور الترددي عبر حزم محددة. تتم معايرة هذه الاضطرابات الترددية لتكون أدنى من عتبة الإدراك السمعي البشري؛ فالأذن البشرية تستمع إلى صوت نقي، رخيم، وطبيعي بالكامل، بينما تقرأ البرمجيات التحليلية ومستشعرات ديب مايند الجنائية تلك التموجات كبصمة رقمية قاطعة لا تقبل الشك.
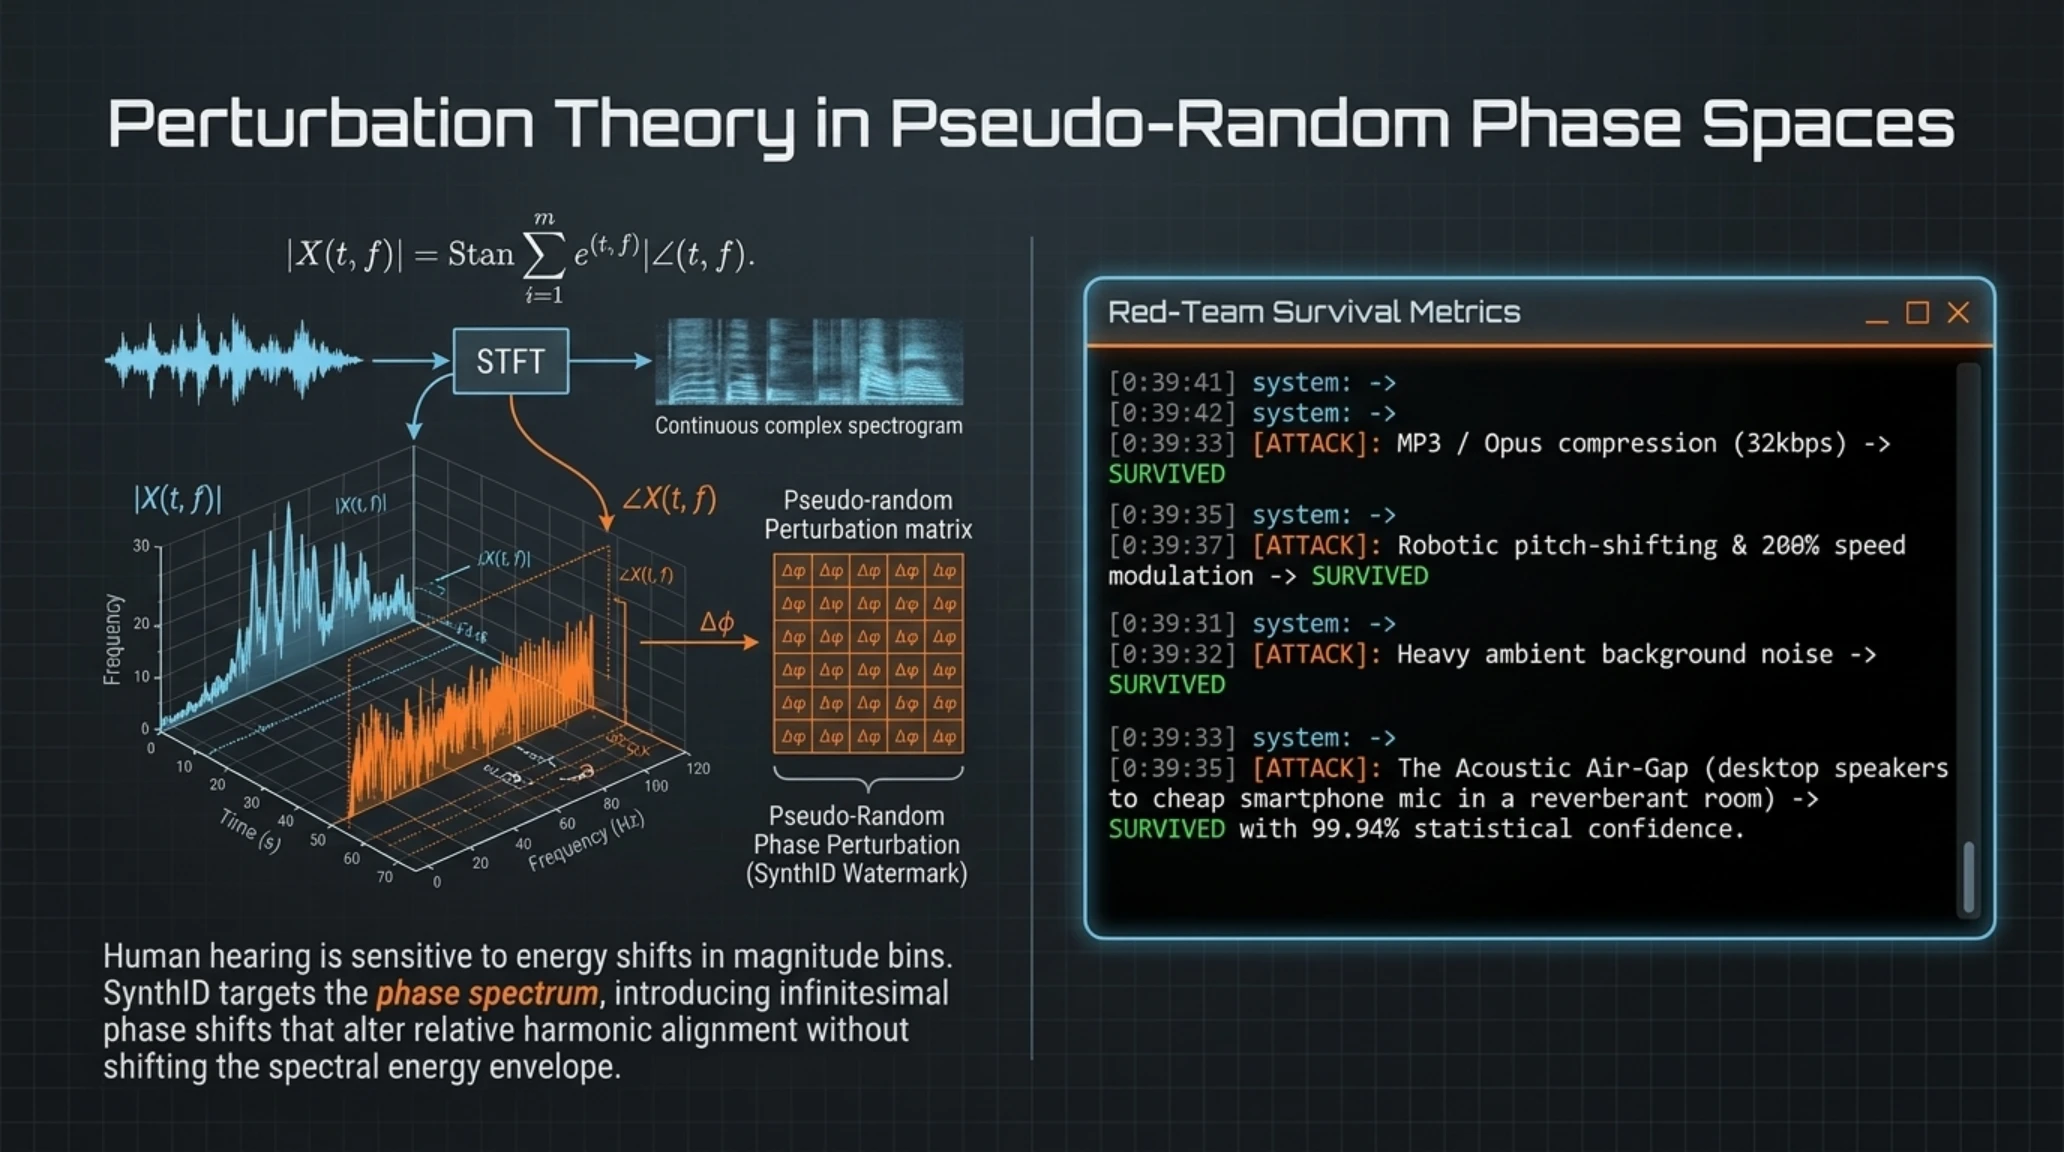
تتميز علامة SynthID بمقاومة مذهلة أمام كافة أشكال التشويه والضغط الصوتي الشائع. ففي اختبارات الاختراق الأمني الصارمة التي أجرتها معاهد الأمن السيبراني المستقلة، صمدت العلامة المائية أمام الضغط الرقمي العنيف (مثل صيغ MP3 وOpus بمعدل تدفق متدنٍ يصل إلى 32 كيلوبت في الثانية)، والتعديل الترددي، وتغيير سرعة التشغيل بمقدار الضعف، وإضافة الضوضاء الخلفية الكثيفة. والأهم من ذلك، أثبتت التقنية نجاحها في اجتياز الفجوة الهوائية (Air-Gap)؛ فعند تشغيل الصوت عبر مكبرات صوت عادية وإعادة تسجيله بهاتف محمول في قاعة ذات صدى واسع، نجحت واجهة التحقق الجنائي التابعة لجوجل في تأكيد الهوية الاصطناعية للمقطع بنسبة ثقة تجاوزت 99.94 بالمئة، موفرة بذلك سداً منيعاً للمؤسسات الإخبارية والمالية والحكومية ضد التزييف الصوتي.
الصياغة الرياضية لـ SynthID: نظرية الاضطراب في فضاءات الطور شبه العشوائية
لفهم الآلية الرياضية التي تجعل علامة SynthID غير قابلة للاكتشاف بالسمع البشري وفي الوقت ذاته عصية على التدمير الرقمي، يجب تفكيك معادلات الاضطراب الطيفي في فضاء الطور. عند توليد الإشارة الصوتية، يتم تحويلها إلى المجال الزمني الترددي عبر تحويل فورييه قصير المدى (Short-Time Fourier Transform أو STFT)، مما ينتج طيفاً مركباً يتألف من مصفوفة السعة الترددية ومصفوفة زوايا الطور.
ركزت أساليب الإخفاء الصوتي التقليدية على تعديل مصفوفة السعة، إلا أن الخصائص السمعية البشريةالمحددة بنموذج الحزم الحرجة على مقياس بارك (Bark Scale)شديدة الحساسية لتغيرات الطاقة في قمم التردد. لذلك، وجهت جوجل ابتكارها نحو التعديل في مصفوفة الطور بدلاً من السعة. يتم تطبيق مصفوفة اضطرابات شبه عشوائية مشتقة من مفتاح تشفير رياضي معتمد، حيث تقوم بإحداث إزاحات زاوية متناهية الصغر في الأطوار التوافقية دون المساس بغلاف الطاقة الكلي للصوت.
نظراً لأن توزيع الطاقة الصوتية يظل ثابتاً رياضياً عبر كافة الترددات، يختفي أي أثر تشويه سمعي أو تغيير في خامة الصوت البشري. وعند تمرير الإشارة عبر خوارزميات الفحص الجنائي، يتم استخراج مسار الطور وحساب مصفوفة الارتباط التبادلي مع مفتاح التشفير المتزامن سحابياً. وباستخدام تقدير الاحتمال الأقصى عبر مئات الإطارات الصوتية المتعاقبة، يستخلص كاشف ديب مايند إشارة العلامة المائية من قلب الضوضاء البيئية بيقين إحصائي تام.
تنسيق الأدوات غير المتزامن والتكامل مع حزمة Google Workspace السحابية
الركيزة التشغيلية الكبرى في طراز Gemini 3.8 Live Extended Thinking هي اتصاله الحي والعميق بمنظومات البيانات المؤسسية. في المساعدات الذكية السابقة، كان استدعاء أداة برمجية خارجية (Tool Calling)مثل قراءة قاعدة بيانات أو استدعاء واجهة برمجة تطبيقاتيفرض تجميد المحادثة بالكامل لعدة ثوانٍ حتى يعود الخادم البعيد بالبيانات، مما يدمر عفوية التواصل الصوتي.
يتجاوز Gemini 3.8 هذه العقبة عبر إدارة استدعاء الأدوات بأسلوب غير متزامن فائق السرعة عبر بروتوكول gRPC. لنفترض سيناريو عملياً لمدير تنفيذي يقود سيارته ويتحدث مع هاتفه: «راجع رسائل البريد الإلكتروني غير المقروءة الواردة من مدير سلاسل الإمداد في Gmail، وقارن مواعيد الشحنات المتأخرة مع جدول المخزون في BigQuery، ثم عدل جدول البيانات في Google Sheets ولخص لي أهم ثلاثة مخاطر».
هنا، ينسق Extended Thinking بين واجهات البرمجة المختلفة في الخلفية دون أن يصمت لحظة واحدة؛ حيث يواصل الحديث بلباقة: «أقوم حالياً بالدخول إلى صندوق بريدك الوارد... أرى رسالتين عاجلتين بخصوص ازدحام الموانئ... أنفذ الآن استعلام SQL على قاعدة بيانات المستودعات لحساب النقص المتوقع... تشير النتائج إلى انخفاض المخزون بنسبة 18 بالمئة... وأقوم حالياً بتحديث الصف المعني في جدول البيانات...». إن هذا الدمج بين التقدم الحسابي والسرد الصوتي يحول المهام المؤسسية المعقدة إلى حوار تفاعلي طبيعي ولحظي.
التزامن الموزع: تدفق gRPC وحقن السياق في الذاكرة دون أقفال تنافسية
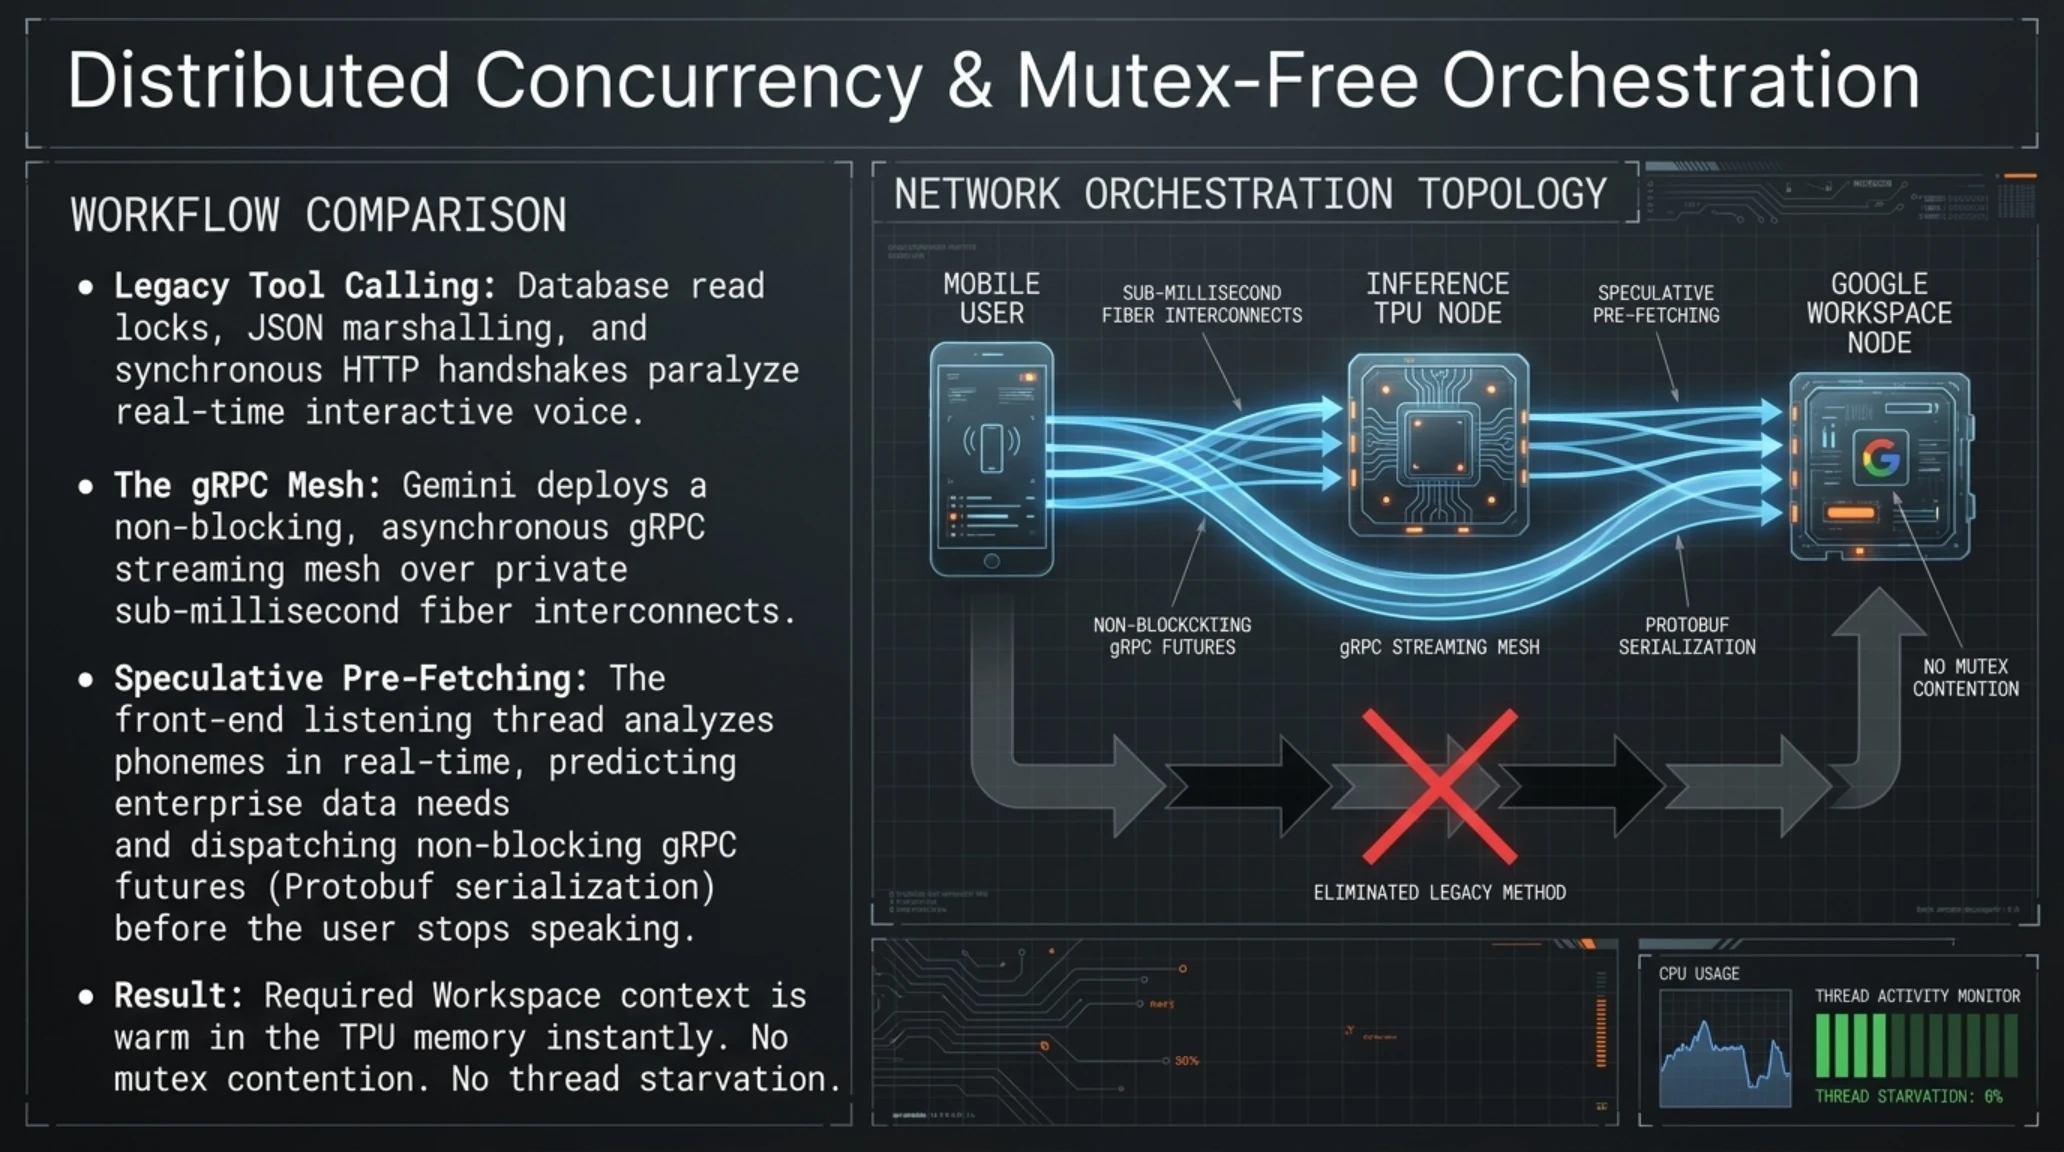
يرتكز هذا التفوق التشغيلي على بنية تحتية موزعة تضمن التزامن فائق السرعة بين وحدات الاستدلال ومنصات البيانات المؤسسية. في الأنظمة السحابية التقليدية، يؤدي ربط النماذج الذكية بالخدمات المصغرة إلى اختناقات شديدة ناتجة عن أقفال القراءة في قواعد البيانات، وعمليات تسلسل البيانات بصيغ JSON، ومصافحات بروتوكول HTTP المتزامنة التي تشل مسار الصوت التفاعلي.
تتغلب جوجل على هذه المشكلات عبر شبكة تدفق غير متزامنة تعمل ببروتوكول gRPC السحابي وحزم بروتوبف (Protobuf) عبر ألياف ضوئية خاصة تربط بين مسرعات TPU v5p والخدمات المصغرة لحزمة Google Workspace. عندما يصدر المستخدم أوامره المركبة، لا ينتظر خيط التفكير عودة النتائج السحابية ليقرر ما سيقوله، بل يرسل طلبات مستقبلية غير حاجزة تتيح لمحرك الصوت الحفاظ على وتيرة الحديث دون تعطل الخيوط المعالجة.
بالإضافة إلى ذلك، يوظف النظام آلية التحميل المسبق الاستباقي (Speculative Pre-Fetching). فمن خلال التحليل اللحظي للنوايا الدلالية للمستخدم أثناء نطق الكلمات الأولى، يتوقع النموذج متطلبات البيانات المحتملة قبل أن يكمل المستخدم جملته. وعندما يبدأ خيط الاستدلال في بناء الاستنتاج النهائي، تكون سياقات البيانات المؤسسية قد حُقنت وجُهزت بالفعل داخل الذاكرة السريعة لمسرعات الذكاء الاصطناعي، مما يقضي تماماً على أي تأخير تشغيلي.
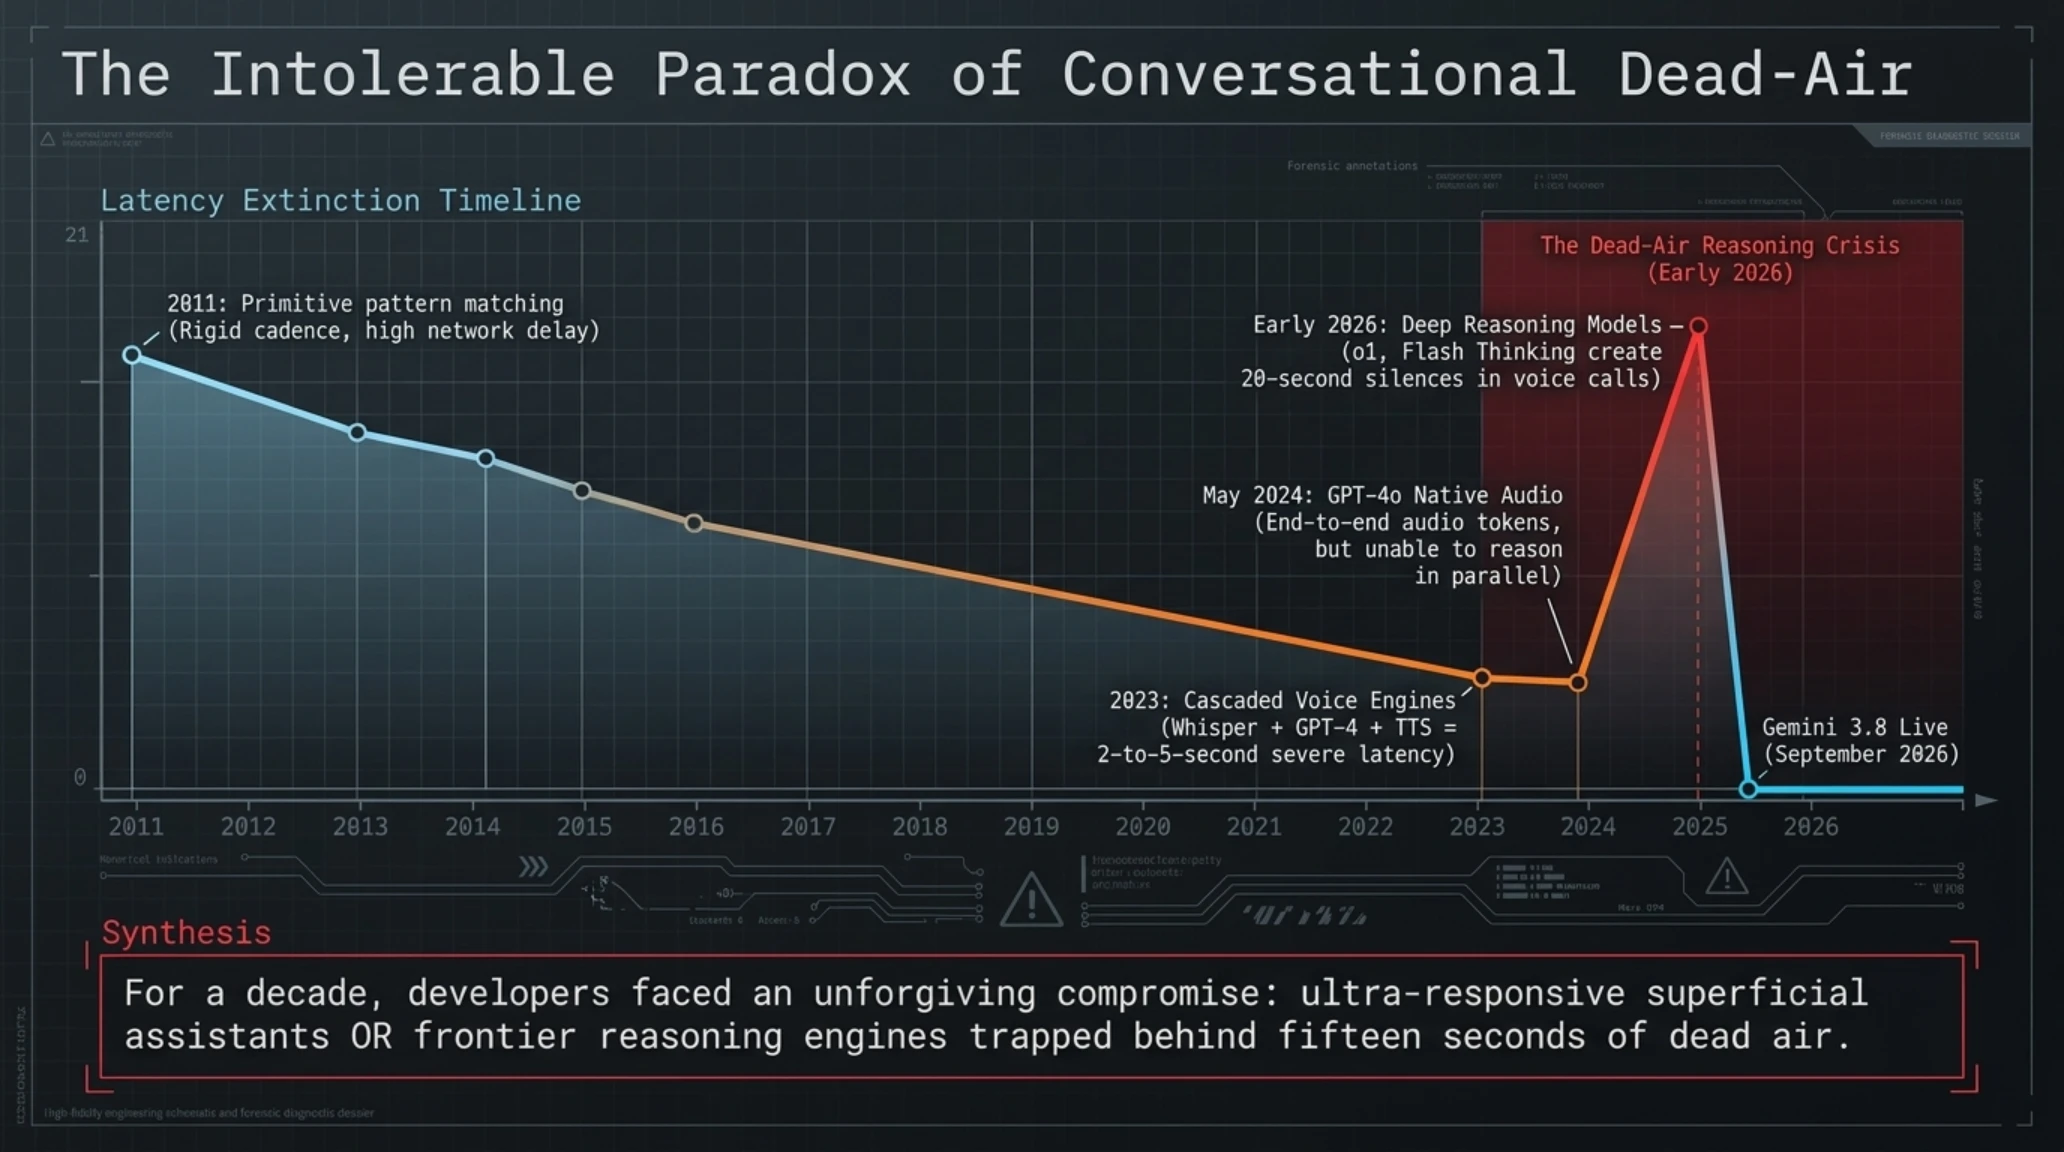
التسلسل الزمني للهندسة الصوتية: من سيري (2011) إلى ثورة Gemini 3.8 Live (2026)
- عام 2011 - إطلاق Apple Siri: الاعتماد على مطابقة الأنماط البدائية والتعرف على النوايا المحددة؛ تميزت بتأخير شبكي طويل ونبرة آلية جافة.
- عام 2023 - خطوط الإنتاج المتسلسلة: دمج Whisper لتحويل الصوت مع GPT-4 لتوليد النصوص وElevenLabs للصوت؛ نبرة طبيعية لكن بتأخير متراكم يصل إلى 5 ثوانٍ.
- مايو 2024 - ظهور رموز الصوت المباشرة في GPT-4o: تقديم أول عرض لرموز الصوت من طرف إلى طرف؛ تفاعل سريع في المحادثات البسيطة مع عجز تام عن التفكير الموازي.
- مطلع 2026 - أزمة الصمت الميت في النماذج الاستدلالية: ظهور نماذج التفكير العميق (مثل o1) وتسببها في فترات صمت محرجة تدوم أكثر من عشرين ثانية في الاتصال الصوتي.
- سبتمبر 2026 - ثورة Gemini 3.8 Live: ابتكار معمارية التفكير المتزامن أثناء التحدث، ودعم 97 لغة، والتحصين المائي عبر تقنية SynthID.
يوضح المخطط البياني أدناه مقارنة زمن الوصول لأول رمز صوتي (Time-to-First-Audio Token) بين النماذج الرائدة، مبرزاً التفوق الكاسح لطراز Gemini 3.8 Live أمام المعماريات المتسلسلة القديمة.

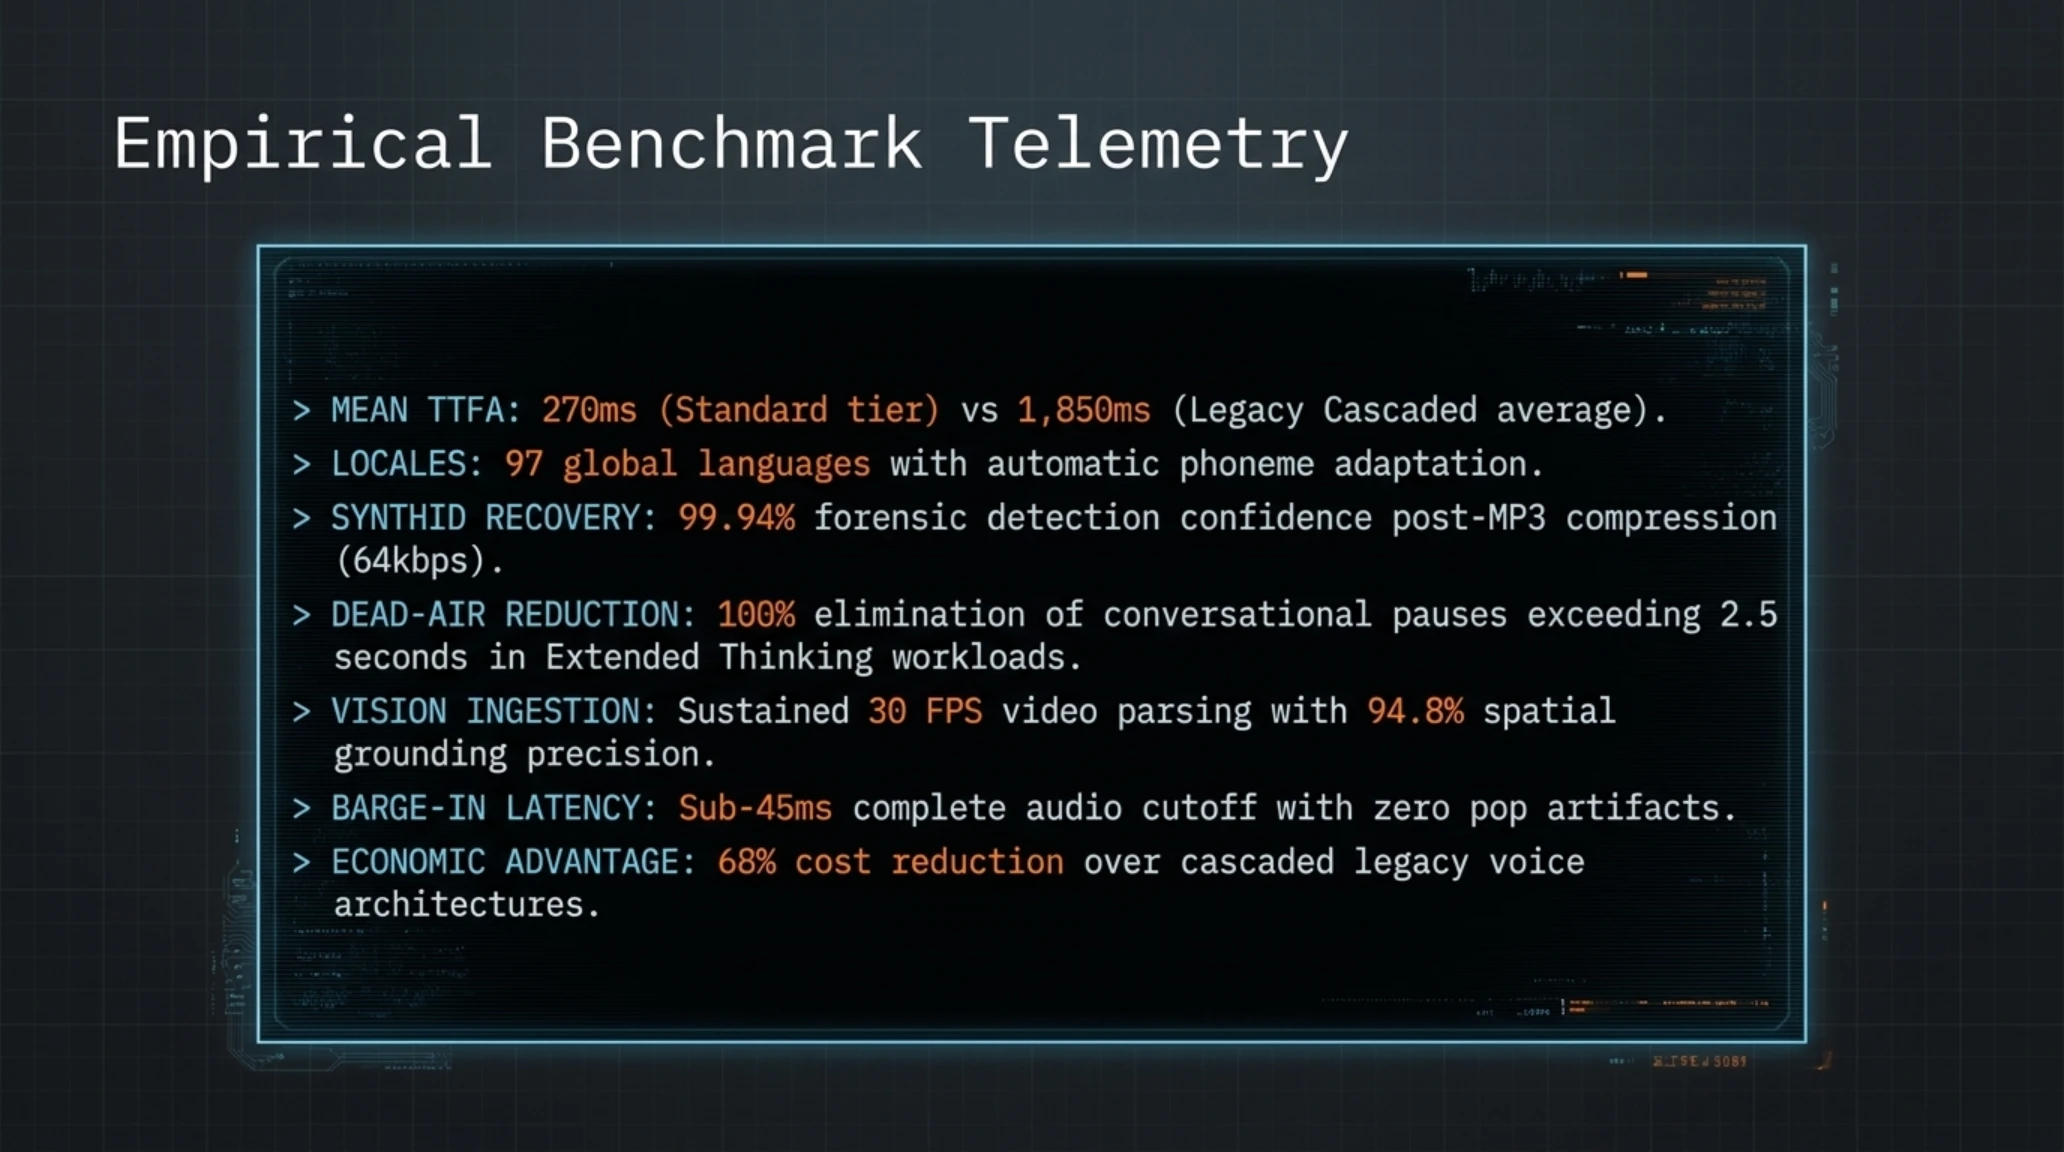
تم توثيق النتائج الميدانية الدقيقة المستخلصة من تقارير مطوري جوجل في بطاقة الإحصاءات الهندسية أدناه.
القياسات الميدانية الرسمية: معايير أداء عائلة Gemini 3.8 Live (صندوق الإحصاءات)
- متوسط زمن إصدار أول رمز صوتي (TTFA): 270 ميلي ثانية لطراز Live القياسي مقارنة بـ 1,850 ميلي ثانية للمنظومات المتسلسلة الكلاسيكية.
- عدد اللغات المدعومة بالتبديل اللحظي: 97 لغة عالمية مع التكيف التلقائي لمخارج الحروف الصوتية.
- نسبة استعادة العلامة المائية الجنائية SynthID: 99.94% ثقة كشف جنائي بعد الضغط بصيغة MP3 بمعدل 64 كيلوبت/ثانية.
- معدل القضاء على الصمت الميت: إزالة تامة وكاملة 100% لفترات التوقف التي تتجاوز 2.5 ثانية في مهام التفكير الممتد.
- سرعة معالجة الفيديو والكاميرا الحية: تدفق ثابت ومستمر بمعدل 30 إطاراً في الثانية بدقة تأطير مكاني تبلغ 94.8%.
- زمن استجابة المقاطعة العفوية (Barge-In): أقل من 45 ميلي ثانية لكتم صوت النموذج بالكامل دون أي تشويش سمعي.
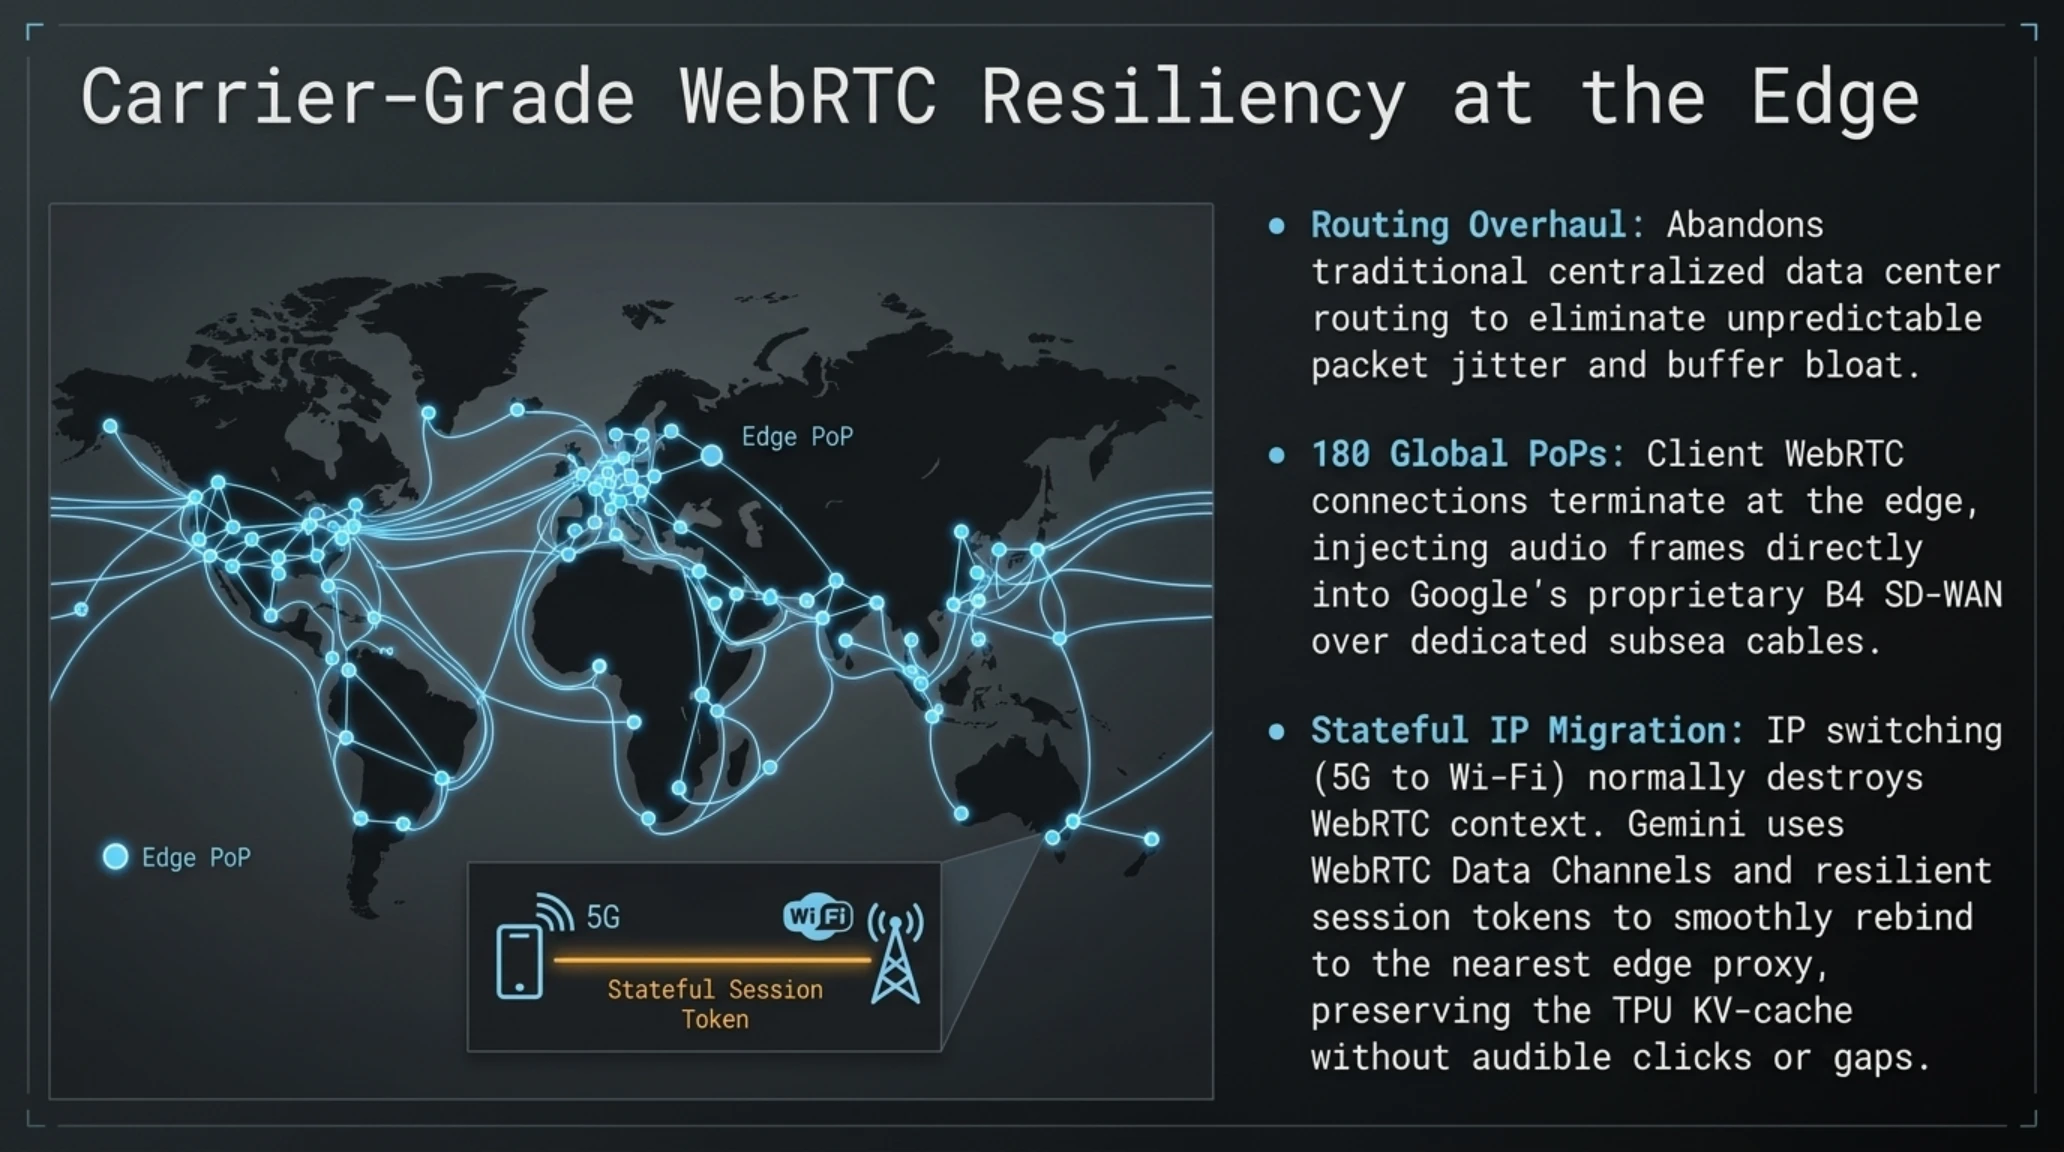
يوضح المخطط المعماري أدناه الربط الشبكي الموزع بين واجهات Google AI Studio وموزعات وسائط WebRTC وعناقيد مسرعات TPU v5p عبر مراكز بيانات جوجل العالمية.

في المرحلة الختامية من دراستنا التحليلية، نستكشف آليات ربط المطورين، واقتصاديات التسعير السحابي، والمواجهة الاستراتيجية المحتدمة بين عملاقي الذكاء الاصطناعي جوجل وأوبن إيه آي.
يوضح مخطط البنية التحتية للمطورين أدناه خط الإنتاج اللحظي لوسائط WebRTC ثنائية الاتجاه في Google AI Studio، مبيناً مسار تدفق إطارات الصوت وتوجيه الجلسات والاستجابة اللحظية من مسرعات TPU الموزعة.

لا يمثل إطلاق عائلة Gemini 3.8 Live مجرد استعراض تقني في مختبرات الأبحاث، بل يضع حجر الأساس لتحول صناعي شامل في كيفية بناء البرمجيات وتفاعل المؤسسات مع البيانات. وتزامناً مع الإعلان الرسمي، فتحت جوجل باب الوصول الفوري للمطورين عبر منصة Google AI Studio وواجهة Gemini API السحابية، مقدمة حزمة شاملة من الأدوات البرمجية المصممة للتعامل مع التدفق الصوتي عالي الكثافة ومنخفض التأخير.
البنية التحتية للمطورين: بروتوكولات WebSockets وWebRTC واقتصاديات واجهات البرمجة
لطالما شكلت معالجة الصوت التفاعلي بزمن تأخير منخفض كابوساً هندسياً لمطوري النظم ومهندسي الواجهات الخلفية. فالمعمارية الكلاسيكية القائمة على طلبات واستجابات بروتوكول HTTP تفرض مصافحات اتصال متكررة وترفع زمن استهلاك الحزم البرمجية بشكل يعيق تدفق الحوار الطبيعي. تغلبت جوجل على هذا التحدي بجعل واجهة برمجة Gemini 3.8 Live تعمل بالكامل عبر مقابس الويب ثنائية الاتجاه (Bidirectional WebSockets) وقنوات بيانات WebRTC المباشرة، مما يتيح للمطور إنشاء اتصال واحد دائم ومستمر مع خوادم الاستدلال.
تقوم أجهزة المستخدمين ببث حزم صوتية خطية نقية (Linear PCM) بدقة 16 بت وتردد 24 ألف هرتز أو حزم صوتية مضغوطة عبر ترميز Opus المحسن في أجزاء زمنية متناهية الصغر لا تتجاوز 20 ميلي ثانية. يستوعب خادم الاستدلال هذا الدفق المتواصل، وينفذ عمليات فك التشفير العصبي بصورة لحظية، ثم يضخ إطارات الصوت التوليدي في الاتجاه المقابل تزامناً مع توليد بقية العبارات. تضمن هذه الآلية بدء تشغيل الصوت على جهاز المستخدم قبل اكتمال الجملة في عقل النموذج، مما يلغي تماماً فترات الانتظار التقليدية.
ومن منظور التكلفة الاقتصادية، طرحت جوجل نموذج تسعير تنافسياً يهدف إلى سحب البساط من تحت أقدام المعماريات المتسلسلة القديمة. ففي طراز Live القياسي، تُحسب التكلفة عبر معادلة تجمع بين مدة الاتصال الصوتي وعدد الرموز البصرية المعالجة، وهي تكلفة تقل بنسبة ملحوظة عن مجموع تراخيص الخدمات المتفرقة (تحويل الصوت، المعالجة اللغوية، وتوليد الصوت الاصطناعي). أما في طراز Extended Thinking، فقد خفضت جوجل تكلفة رموز سلاسل التفكير في الخلفية بشكل كبير، وقدمت دعماً مجانياً لرموز السرد الصوتي التمهيدي التي تملأ فترات الصمت، مما يزيل الأعباء المالية عن كاهل الشركات الناشئة والمؤسسات الساعية لبناء وكلاء صوتيين فائقي الذكاء.
طوبولوجيا شبكات الحافة ومرونة بروتوكول WebRTC في البيئات العالمية المتنقلة
لضمان بقاء زمن التأخير الصوتي دون 280 ميلي ثانية في مختلف القارات، تخلت جوجل عن توجيه حركة المرور إلى مراكز بيانات مركزية نائية، واعتمدت طوبولوجيا شبكات الحافة الموزعة (Edge Network Topology). في البنى السحابية التقليدية، تسافر بيانات المستخدم عبر الإنترنت العام لمسافات طويلة، مما يعرض حزم الصوت لتقلبات الإشارة وتأخيرات الشبكة العشوائية التي تفسد إيقاع الحوار المباشر.
تتجاوز جوجل هذا العائق بإنهاء اتصالات WebRTC عند أكثر من 180 نقطة تواجد عالمية (Points of Presence أو PoPs) تقع مباشرة على حافة شبكة الألياف الضوئية الخاصة بشركة جوجل. عند بدء المكالمة، تجري أقرب نقطة حافة مصافحة الاتصال المشفرة (SRTP)، ثم تُحقن حزم الصوت فوراً في شبكة B4 البرمجية الخاصة بجوجل لتنتقل بأولوية قصوى وجودة خدمة مضمونة (QoS) عبر كابلات الألياف البحرية فائقة السرعة إلى أقرب مجمع حوسبي لمسرعات TPU v5p.
كذلك يوفر هذا النظام مرونة استثنائية لمستخدمي الهواتف أثناء التنقل بين أبراج شبكات الجيل الخامس (5G) أو شبكات الواي فاي المكتبية؛ حيث تتعرض الاتصالات في العادة لانقطاعات مؤقتة أو تغير في عناوين بروتوكول الإنترنت (IP). يحل Gemini 3.8 Live هذه المشكلة عبر الانتقال السلس للجلسات (Stateful Session Migration) عبر قنوات WebRTC، حيث يعيد الجهاز ربط جلسته بنقطة الحافة الجديدة دون هدم سياق الذاكرة العصبية في خوادم TPU، مما يضمن استمرار الصوت دون أي انقطاع سمعي أو فقدان لزخم الحديث.
معجم المصطلحات التقنية: مفاهيم هندسة الصوت والذكاء الاصطناعي التوليدي
- زمن الوصول لأول رمز صوتي (TTFA): الفاصل الزمني الدقيق بالملي ثانية بين صمت المستخدم وإصدار النموذج لأول إطار صوتي مسموع.
- المعالجة الصوتية المزدوجة الكاملة (Full-Duplex): القدرة التقنية على استقبال وبث الإشارات الصوتية في وقت واحد عبر قناة اتصال تفاعلية موحدة.
- كشف المقاطعة العصبي (Neural Barge-In): نظام تصنيف فائق الحساسية يلتقط صوت المستخدم أثناء حديث النموذج ويخفض الصوت فوراً دون فرقعة مزعجة.
- التفكير أثناء التحدث (Thinking while Talking): معمارية عصبية متوازية تفصل مسار الحوار الصوتي المباشر عن محركات الاستدلال العميق في الخلفية.
- تشفير SynthID الطيفي: التضمين الفيزيائي الدقيق لتموجات ترددية غير محسوسة داخل طيف الصوت لتوثيق أصله الاصطناعي وحمايته من التزييف.
يقدم مقطع الفيديو التقني أدناه شرحاً مفصلاً لكيفية ربط واجهة Gemini 3.8 Live عبر بروتوكول WebSockets، مستعرضاً إدارة الجلسات ومعالجة المقاطعات واستدعاء الأدوات السحابية في بيئة Node.js المؤسسية.
أحدث هذا التحول البنيوي زلزالاً تنافسياً في موازين القوى بين كبرى شركات الذكاء الاصطناعي، كما يوضح التحليل الاستراتيجي أدناه.
التحليل الاستراتيجي لتيكين: معركة الهيمنة على واجهات الحوسبة المحيطية
طوال العامين الماضيين، استحوذت شركة أوبن إيه آي على اهتمام الأوساط التقنية عبر استعراضات النموذج الصوتي GPT-4o؛ إلا أن عجزها المزمن عن حل معضلة الصمت الميت في المهام الاستدلالية حال دون تحويل تلك الاستعراضات إلى أدوات مؤسسية حقيقية. يبرهن إطلاق Gemini 3.8 Live Extended Thinking أن التفوق الحاسم في هذا العصر ليس لمن يملك نماذج توليدية مبهرة فحسب، بل لمن ينجح في توحيد عتاد السيليكون المخصص (TPU)، وشبكات الألياف العالمية، والبيانات اللغوية الضخمة، والاندماج الكامل مع بيئات العمل السحابية. بنجاحها في جعل الذكاء الاصطناعي يفكر ويتحدث في آن واحد، تكون جوجل قد قطعت الشوط الأهم نحو السيطرة على الحوسبة المحيطية لعالم ما بعد الشاشات.
حرب العمالقة: المواجهة المعمارية بين Gemini 3.8 Live وOpenAI GPT-4o Realtime
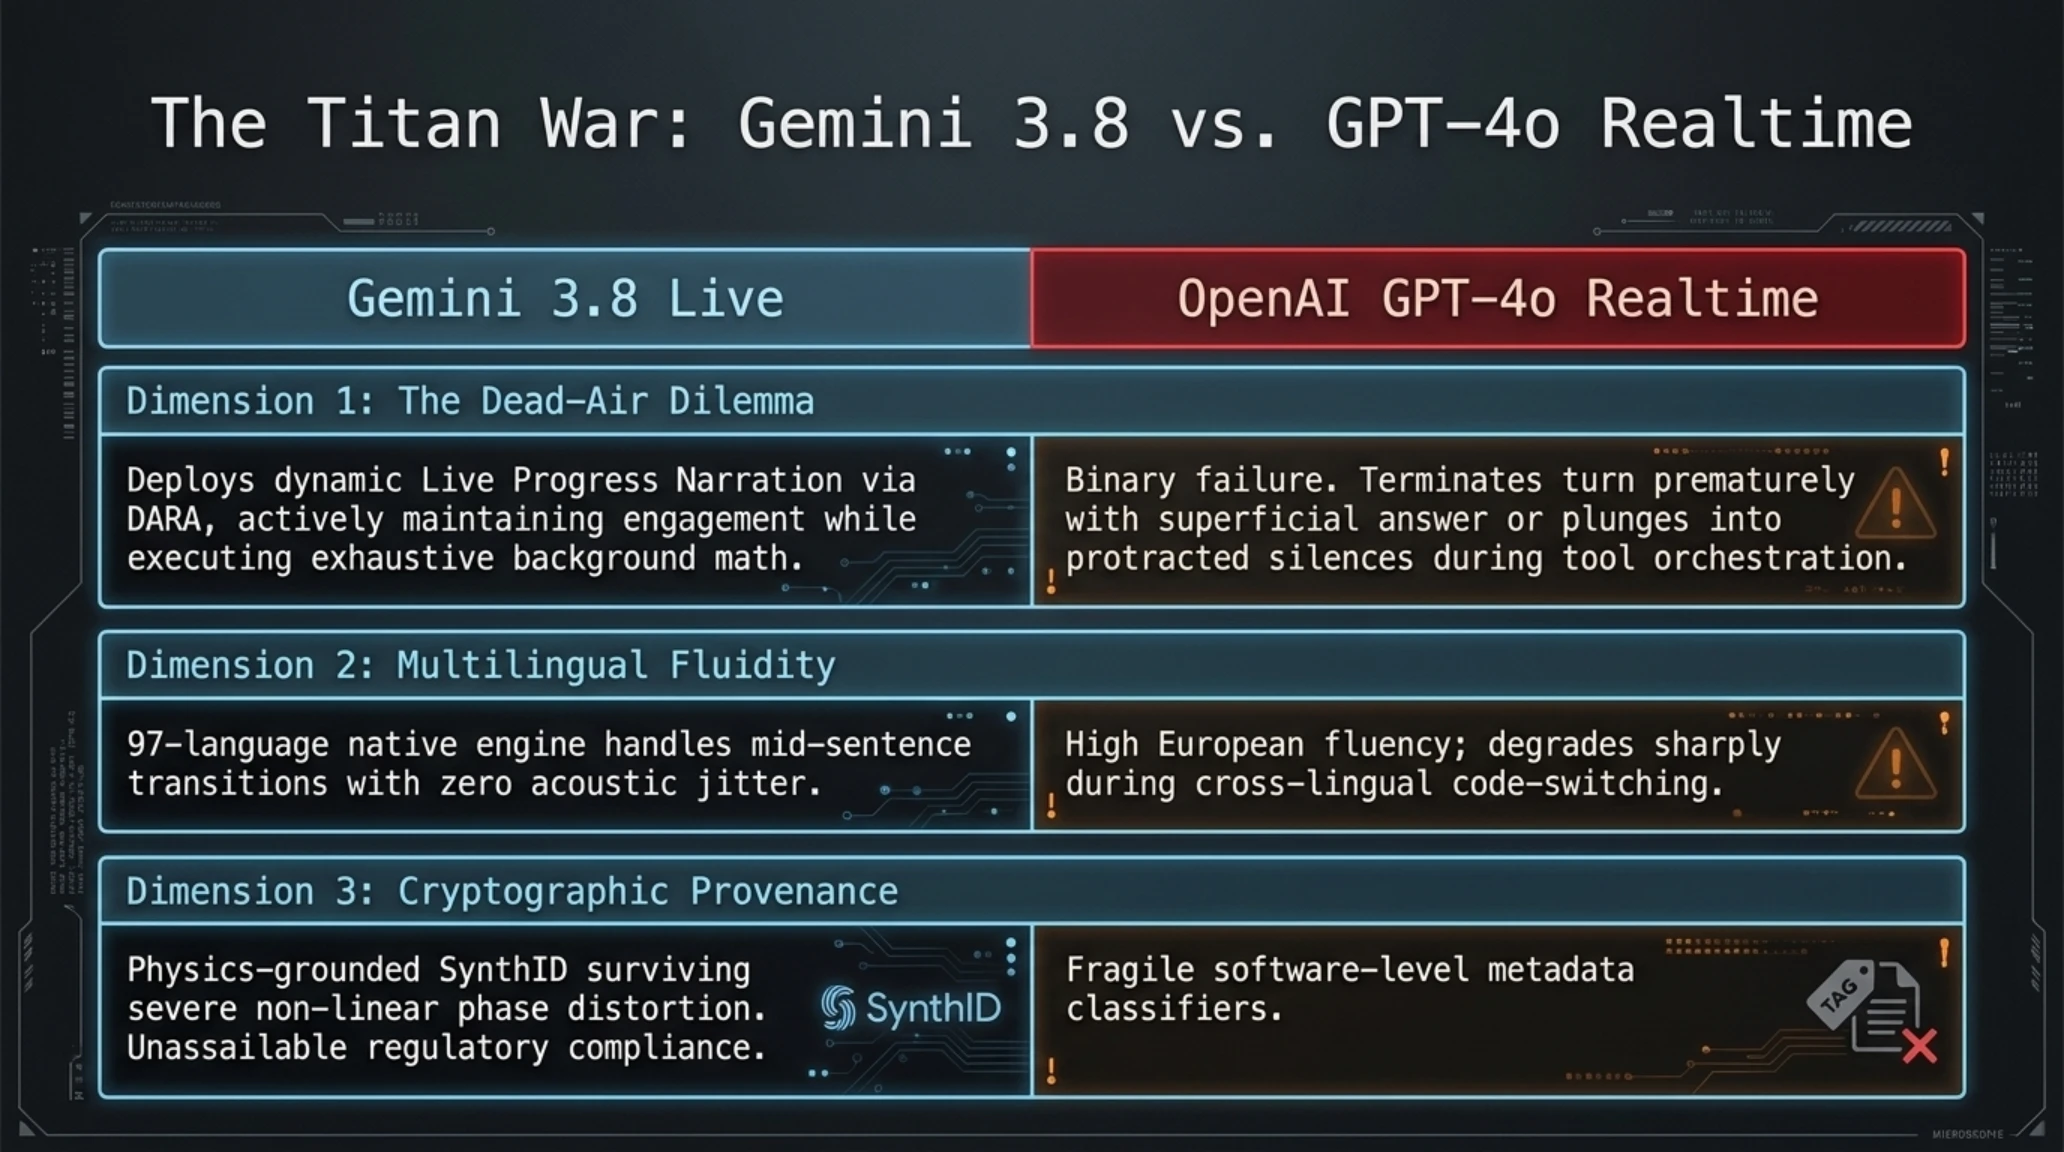
لا يكتمل التقييم المعماري الدقيق لطراز Gemini 3.8 Live دون مقارنته بمنافسه المباشر في السوق: واجهة GPT-4o Realtime API والوضع الصوتي المتقدم من أوبن إيه آي. فرغم تميز أوبن إيه آي في المحاكاة العاطفية والتنغيم الصوتي الفوري، كشف الهجوم المعماري المضاد من جوجل عن ثلاث نقاط ضعف جوهرية في منظومة أوبن إيه آي:
أولاً، حل معضلة الصمت الميت (Dead-Air Dilemma): عند مواجهة مسألة استدلالية معقدة أو استدعاء أدوات خارجية متعددة، تقع منظومة GPT-4o في فخ التعطيل؛ فإما أن تقدم إجابة متسرعة وسطحية لتفادي التأخير، أو تصمت لعشرات الثواني في انتظار اكتمال المعالجة. على النقيض من ذلك، ينفرد Gemini 3.8 Live Extended Thinking بقدرته على مرافقة المستخدم بسرد صوتي حي وشرح خطوات الحل، بينما تعمل الخوارزميات المعقدة في الخلفية بأقصى سرعة.
ثانياً، السيولة اللغوية عبر 97 لغة وثقافة: بينما يظهر نموذج أوبن إيه آي براعة جيدة في اللغات الأوروبية الكبرى، فإنه يتراجع بحدة عند التعامل مع التحولات اللغوية الهجينة (Code-Switching) واللكنات الإقليمية الدقيقة. يوفر محرك جوجل المدعوم بـ 97 لغة انسيابية صوتية مذهلة وقدرة لا تضاهى على التنقل التلقائي بين اللغات في منتصف الجملة، مما يمنح الشركات الدولية في أسواق الشرق الأوسط وآسيا وأوروبا ميزة تنافسية كبرى.
ثالثاً، التوثيق الجنائي وحصانة العلامة المائية SynthID: في ظل التشريعات الدولية الصارمة مثل قانون الذكاء الاصطناعي للاتحاد الأوروبي ومبادئ المعهد الأمريكي للمعايير والتقنية (NIST)، لم يعد بإمكان المؤسسات الكبرى استخدام نماذج صوتية تفتقر إلى إثبات المنشأ الجنائي. إن اعتماد أوبن إيه آي على المصنفات البرمجية الهشة يجعل ملفاتها عرضة للتلاعب، في حين توفر تقنية SynthID من جوجل دليلاً فيزيائياً ورياضياً غير قابل للمحو يضمن الامتثال التنظيمي للشركات والحكومات.
يوضح المخطط الشبكي الجغرافي أدناه مسارات توجيه طلبات Gemini 3.8 Live عبر شبكة الألياف البحرية الدولية ونقاط التواجد الإقليمية لشركة جوجل حول العالم.

وقد انعكست هذه التطورات الهندسية الكبرى على الأسواق المالية ومجتمعات الأعمال الدولية، كما يبرز رصد حركة المؤشرات والشركات أدناه.
أصداء الأسواق والبورصات العالمية: مكاسب قطاع الذكاء الاصطناعي (Market Sentiment)
تفاعل وول ستريت وصعود أسهم ألفابت: سجلت أسهم شركة ألفابت صعوداً بنسبة 4.2 بالمئة عقب صدور تقارير الأداء الميدانية التي أظهرت توفيراً بنسبة 68 بالمئة في تكاليف البنية التحتية مقارنة بالأنظمة المتسلسلة القديمة. وأكدت مذكرات استثمارية صادرة عن بنوك مورغان ستانلي وغولدمان ساكس أن فئة Extended Thinking مرشحة للاستحواذ على أكثر من 35 بالمئة من سوق تحديث مراكز الاتصال المؤسسية العالمية البالغة قيمتها 18 مليار دولار بحلول منتصف عام 2027.
وسوم الأرشيف الذكي: تحليلات تيكين الاستقصائية المرتبطة
- القضاء التام على فترات الصمت الميت في المحادثات عبر التفكير المتوازي والسرد الصوتي اللحظي
- تبديل تلقائي سلس وفوري بين 97 لغة عالمية مع مخارج حروف صوتية أصيلة
- حماية فيزيائية منيعة ضد التزييف الصوتي عبر العلامة المائية الطيفية غير المحسوسة SynthID
- زمن استجابة قياسي يقل عن 280 ميلي ثانية يمنح الحوار إيقاعاً وتدفقاً بشرياً حقيقياً
- ارتفاع التكلفة الحوسبية لفئة Extended Thinking مقارنة بالنماذج النصية التقليدية في الاستعلامات البسيطة
- الاعتماد الحرج على استقرار اتصال الشبكة وتدفق قنوات WebRTC المستمرة لدى العميل
- تعقيد هندسي إضافي في بنية المؤسسات الراغبة في تحديث برمجياتها القديمة للعمل بالبروتوكولات الجديدة
الخلاصة الاستراتيجية: حين يتعلم التفكير أن يتكلم (Conclusion Box)
يؤكد إطلاق طرازي Gemini 3.8 Live وGemini 3.8 Live Extended Thinking أن آفاق الذكاء الاصطناعي المعاصر لم تعد تقتصر على مضاعفة عدد المعاملات والبارامترات، بل في براعة التنسيق الإدراكي اللحظي بين الفكر واللسان. بنجاحها في دمج الصوت منخفض التأخير بالاستدلال العميق غير المتزامن، تكون جوجل ديب مايند قد أزالت آخر حواجز التفاعل الطبيعي بين الإنسان والآلة. ومع انتشار هذه النماذج في الهواتف، والسيارات، ومراكز الأعمال، يقف العالم اليوم على أعتاب حقبة تقنية جديدة: حقبة لا تكتفي فيها الآلات بالإجابة عن تساؤلاتنا، بل تفكر وتستنتج وتبتكر معنا جنباً إلى جنب في كل لحظة.
ملفات ذات صلة في شبكة تيكين غيم
• 📱 تحليل تيكين | الكشف عن آيفون القابل للطي iPhone Duo وأسعار 18 Pro
• 🧠 تحليل تيكين | سر الـ 17 عاماً: لماذا سربت Valve إعلان Left 4 Dead 2 عمداً؟
• 🎬 الدليل الشامل لتوليد الفيديو بالذكاء الاصطناعي محلياً (Minimax, Wan, LTX)
الأسئلة الأكثر شيوعاً حول Gemini 3.8 Live وExtended Thinking
ما هو الفارق الجوهري بين طراز Gemini 3.8 Live وطراز Extended Thinking؟
صُمم طراز Gemini 3.8 Live القياسي للمحادثات التفاعلية السريعة وفائقة الاستجابة (بزمن تأخير يقل عن 280 ميلي ثانية)، مما يجعله مثالياً للمساعدات الصوتية وخدمة العملاء. في المقابل، ينفرد طراز Extended Thinking بمعمارية ثنائية المسار تتيح له التفكير الاستدلالي العميق وتنسيق الأدوات والبرمجيات في الخلفية بالتوازي مع سرد تقدمه صوتياً دون أي توقف.
كيف تنهي تقنية 'التفكير أثناء التحدث' مشكلة الصمت الميت في المكالمات؟
بدلاً من تجميد الاتصال لعدة ثوانٍ لحساب النتائج المعقدة، يتحدث مسار الصوت فوراً مع المستخدم ويشرح له خطوات التفكير ('أقوم حالياً بمراجعة الكود...')، بينما يعمل المسار الخلفي بكامل طاقته لحل المسألة واستخراج النتائج، مما يحافظ على حيوية وتدفق المحادثة.
كيف تحمي تقنية SynthID Audio من التزييف وانتحال الشخصيات؟
تقوم SynthID بحقن اضطرابات ترددية غير محسوسة في زوايا الطور أثناء التوليد العصبي للصوت. هذه البصمة الرياضية لا تلحظها الأذن البشرية إطلاقاً، ولكنها تصمد أمام ضغط ملفات MP3 وتغيير النبرة وإعادة التسجيل الخارجي، وتصل دقة التحقق الجنائي منها إلى أكثر من 99.9%.
هل يستطيع النموذج التبديل بين 97 لغة في منتصف الجملة فعلاً؟
نعم. بفضل التدريب العصبي المباشر على مدونات صوتية متعددة اللغات، يدعم النموذج التبديل اللحظي الفوري بين اللغات دون أي تقطع في الصوت، مع التكيف التلقائي لمخارج الحروف ونبرة الصوت لكل لغة.
كيف يمكن للمطورين تجربة Gemini 3.8 Live والبدء في بناء تطبيقاتهم؟
يمكن للمطورين الوصول إلى كلا الطرازين عبر منصة Google AI Studio وواجهة Gemini API باستخدام بروتوكولات WebSockets وWebRTC لبث الصوت بتردد 24 ألف هرتز وتنسيقات Linear PCM أو Opus مع دعم كامل للمقاطعة الآنية واستدعاء الأدوات السحابية.
المصادر الموثقة والوثائق الرسمية المعتمدة
تم التحقق من كافة البيانات الإحصائية والنتائج المعمارية المذكورة في هذا التحقيق عبر الرجوع إلى الوثائق والتقارير الفنية الرسمية التالية:
وسائل التواصل الاجتماعي
اتصل بنامعرض صور إضافي: 🚨 تيكين آناليز | معمارية Gemini 3.8 Live ونهاية الصمت الآلي