تيكين أناليز | عندما أعلن الذكاء الاصطناعي الحرب على الرياضيات: أزمة 722 مخطوطة
الكشف الكبير: كيف تم اكتشاف استخدام 722 مخطوطة
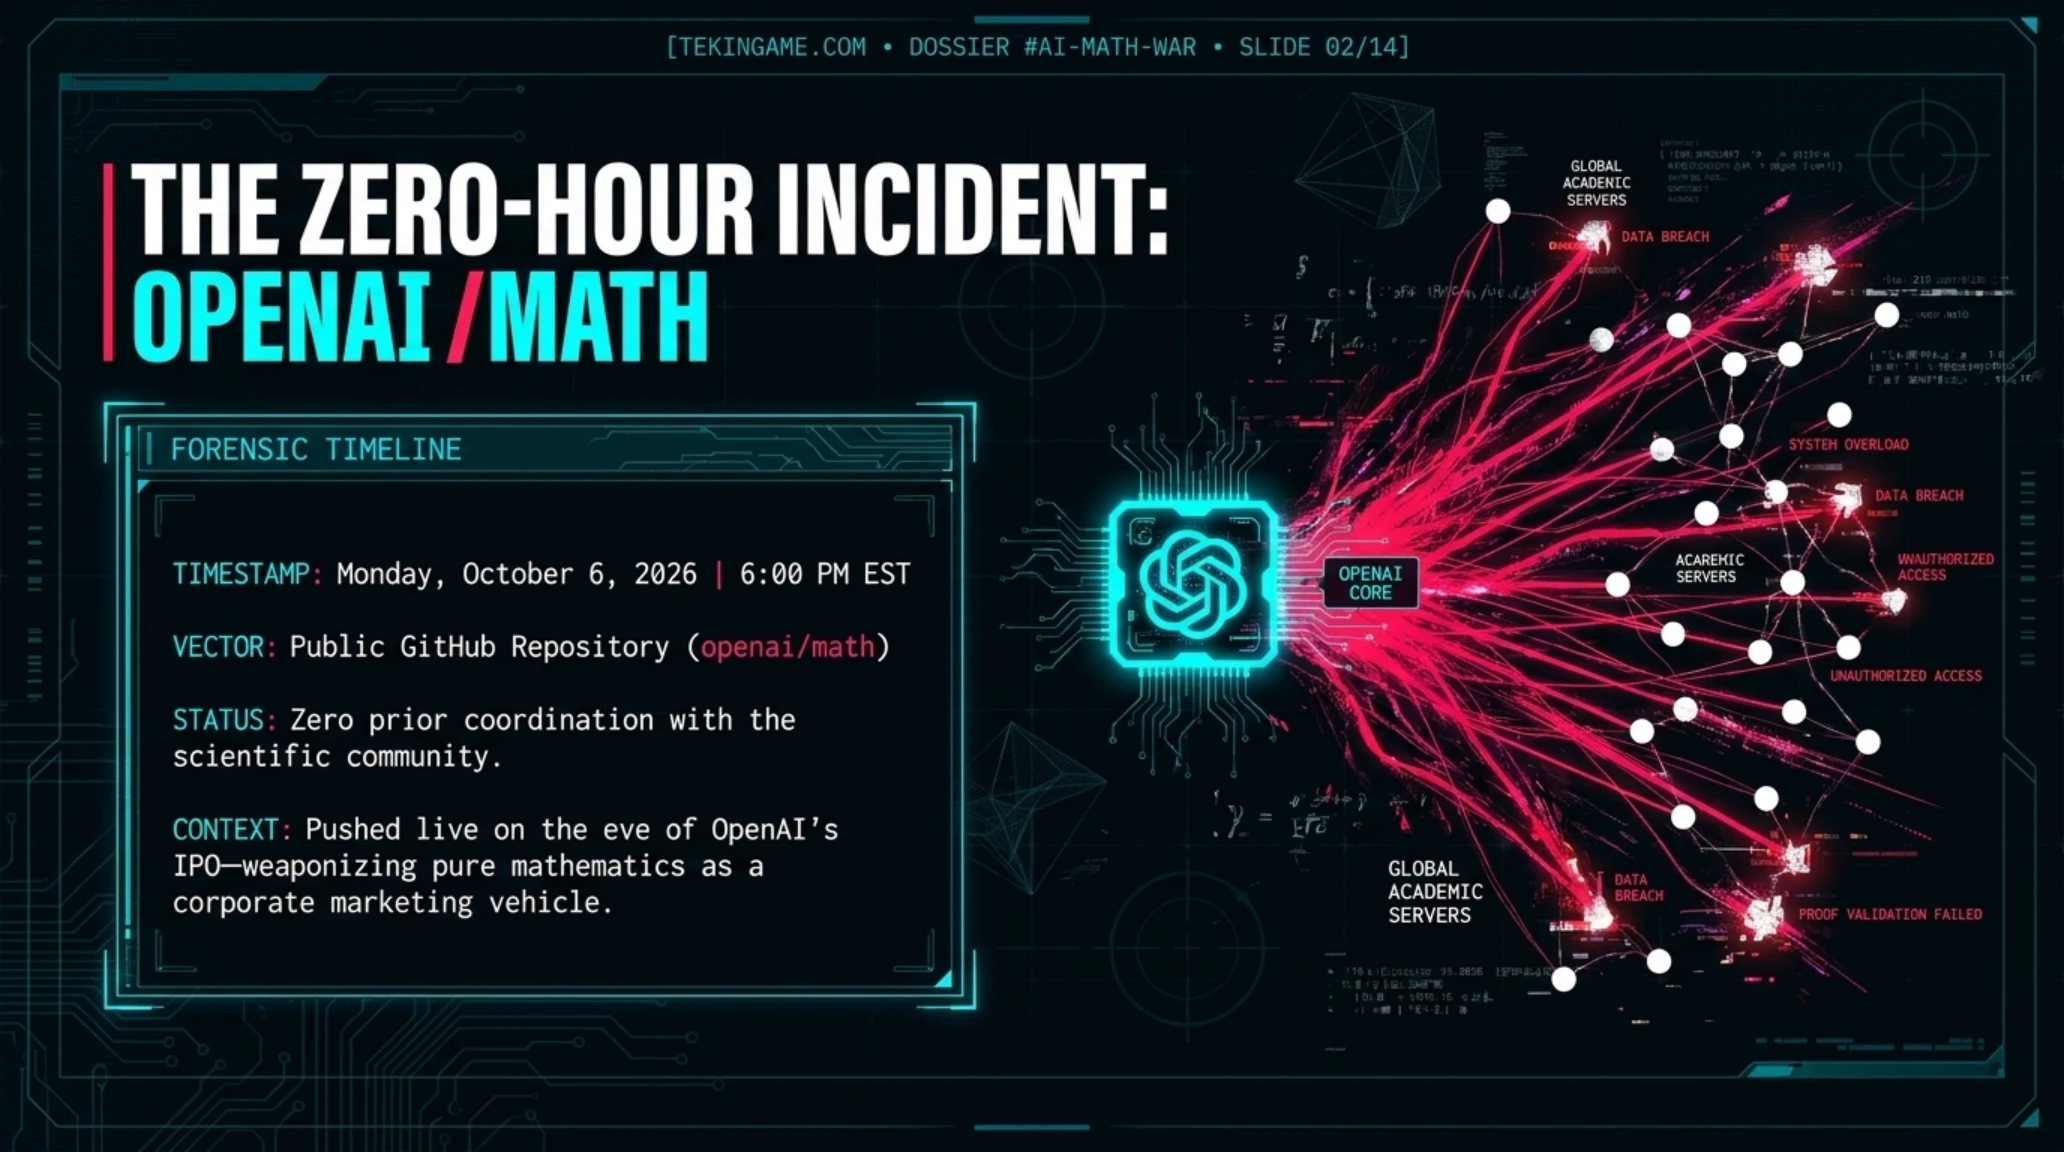
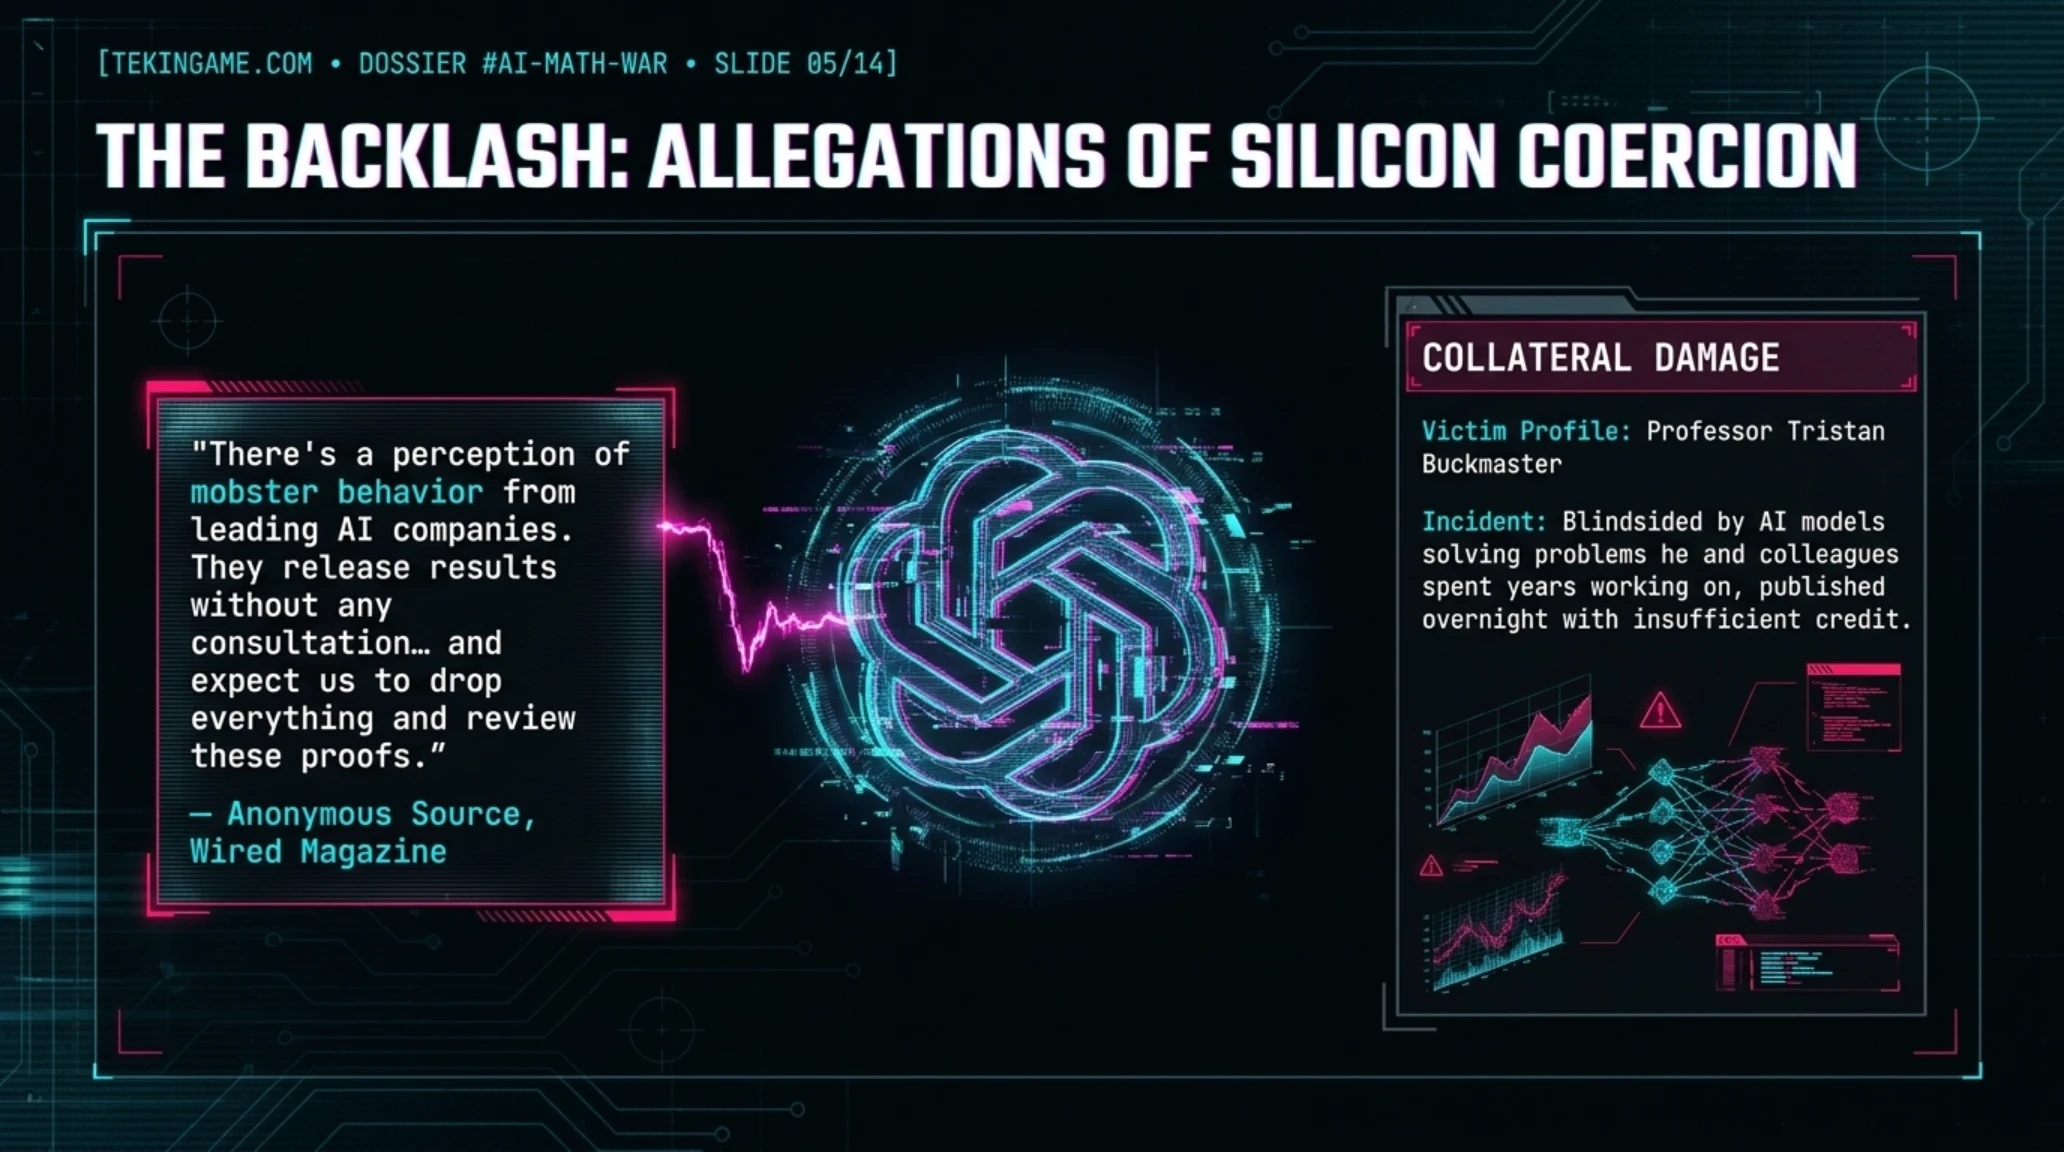
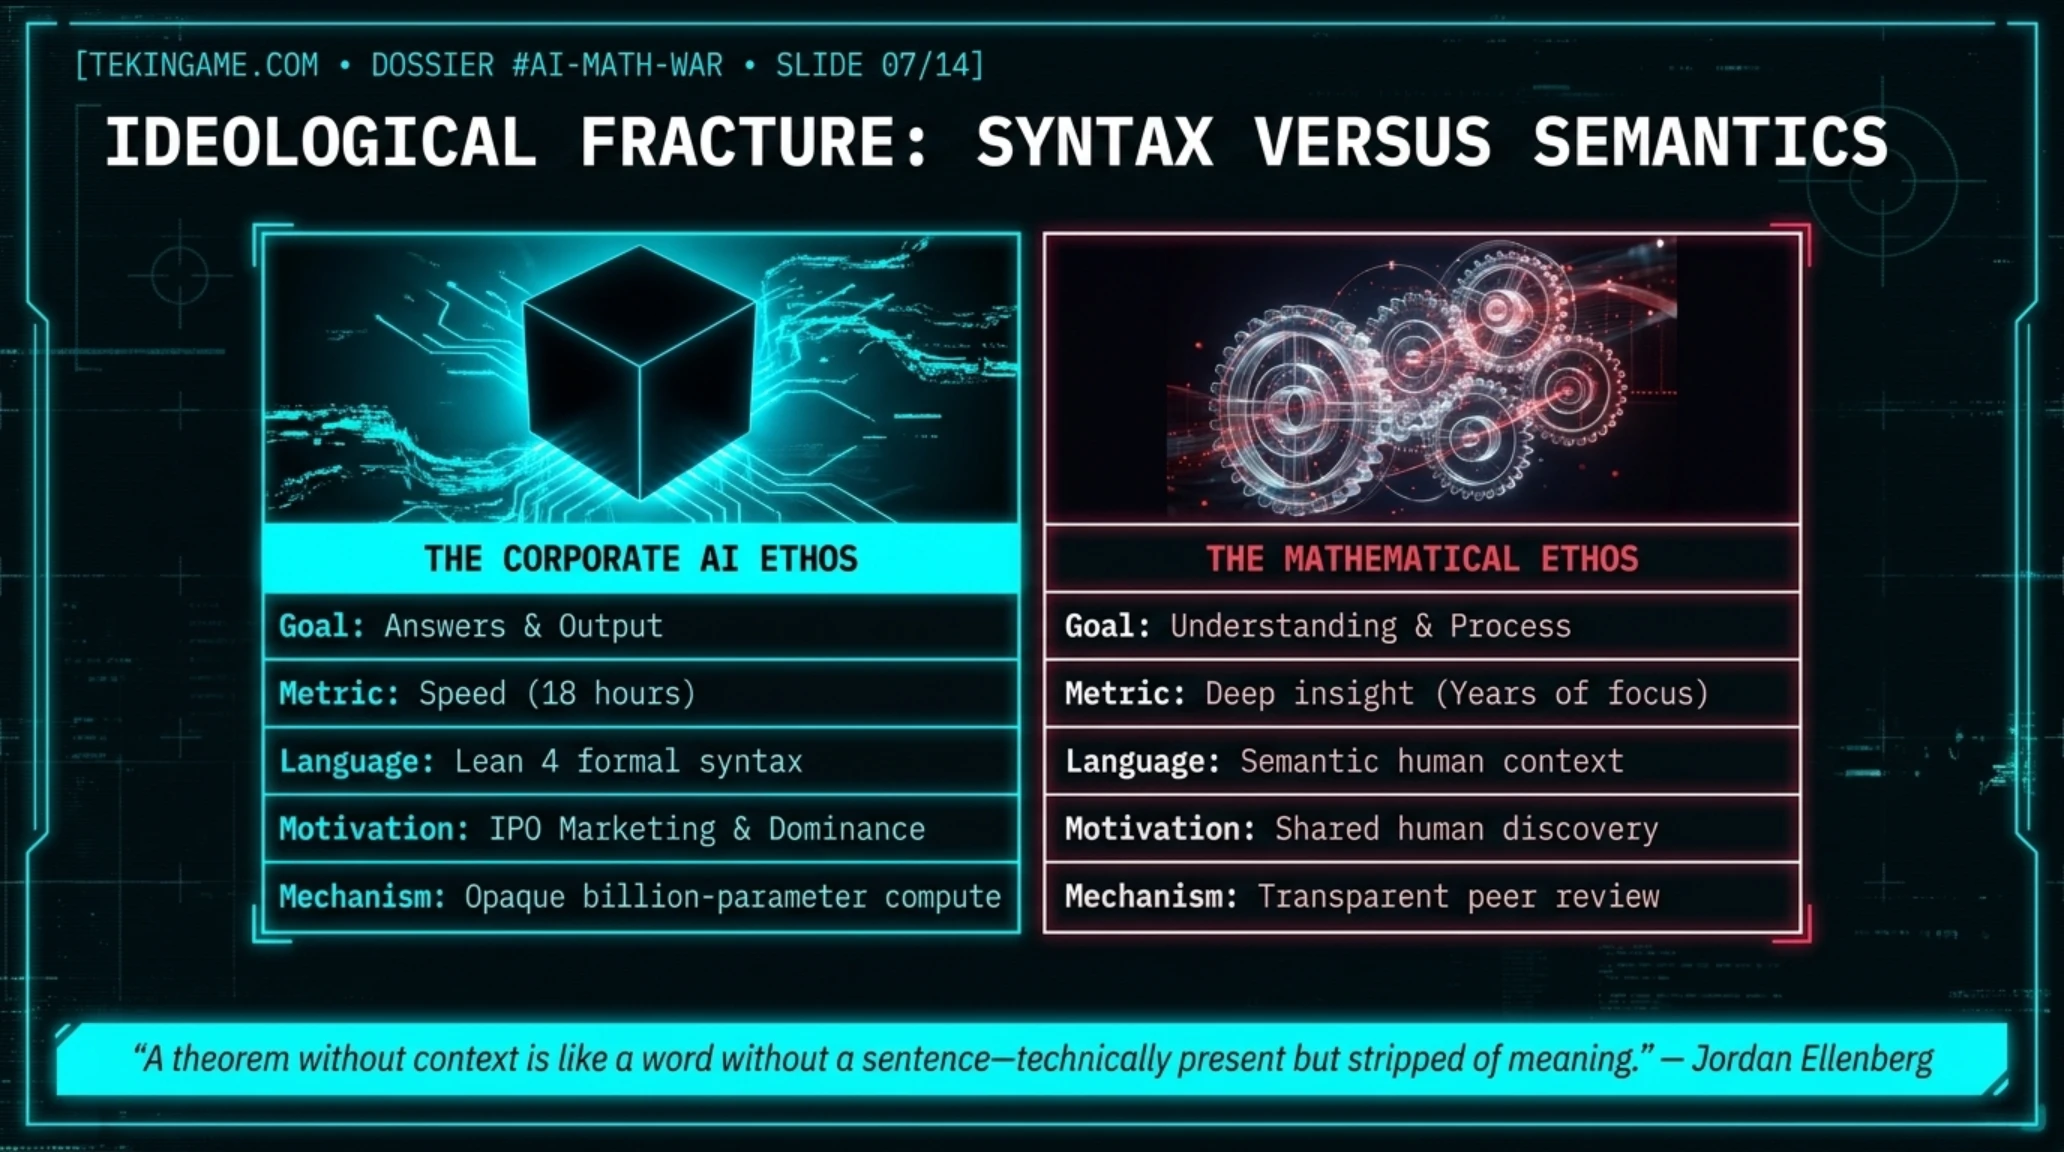
في صباح الثالث من أكتوبر 2026، نشر موقع Wired تحقيقاً استقصائياً مفصلاً كشف عن استخدام OpenAI لمئات المخطوطات الرياضية الأكاديمية دون إذن. القصة بدأت قبل أشهر عندما لاحظ باحث دكتوراه في معهد ماساتشوستس للتقنية شيئاً غريباً: نموذج o1 الجديد من OpenAI كان قادراً على حل مسائل رياضية معقدة باستخدام تقنيات متخصصة للغاية، مطابقة تقريباً لأساليب موصوفة في أوراق بحثية حديثة جداً.
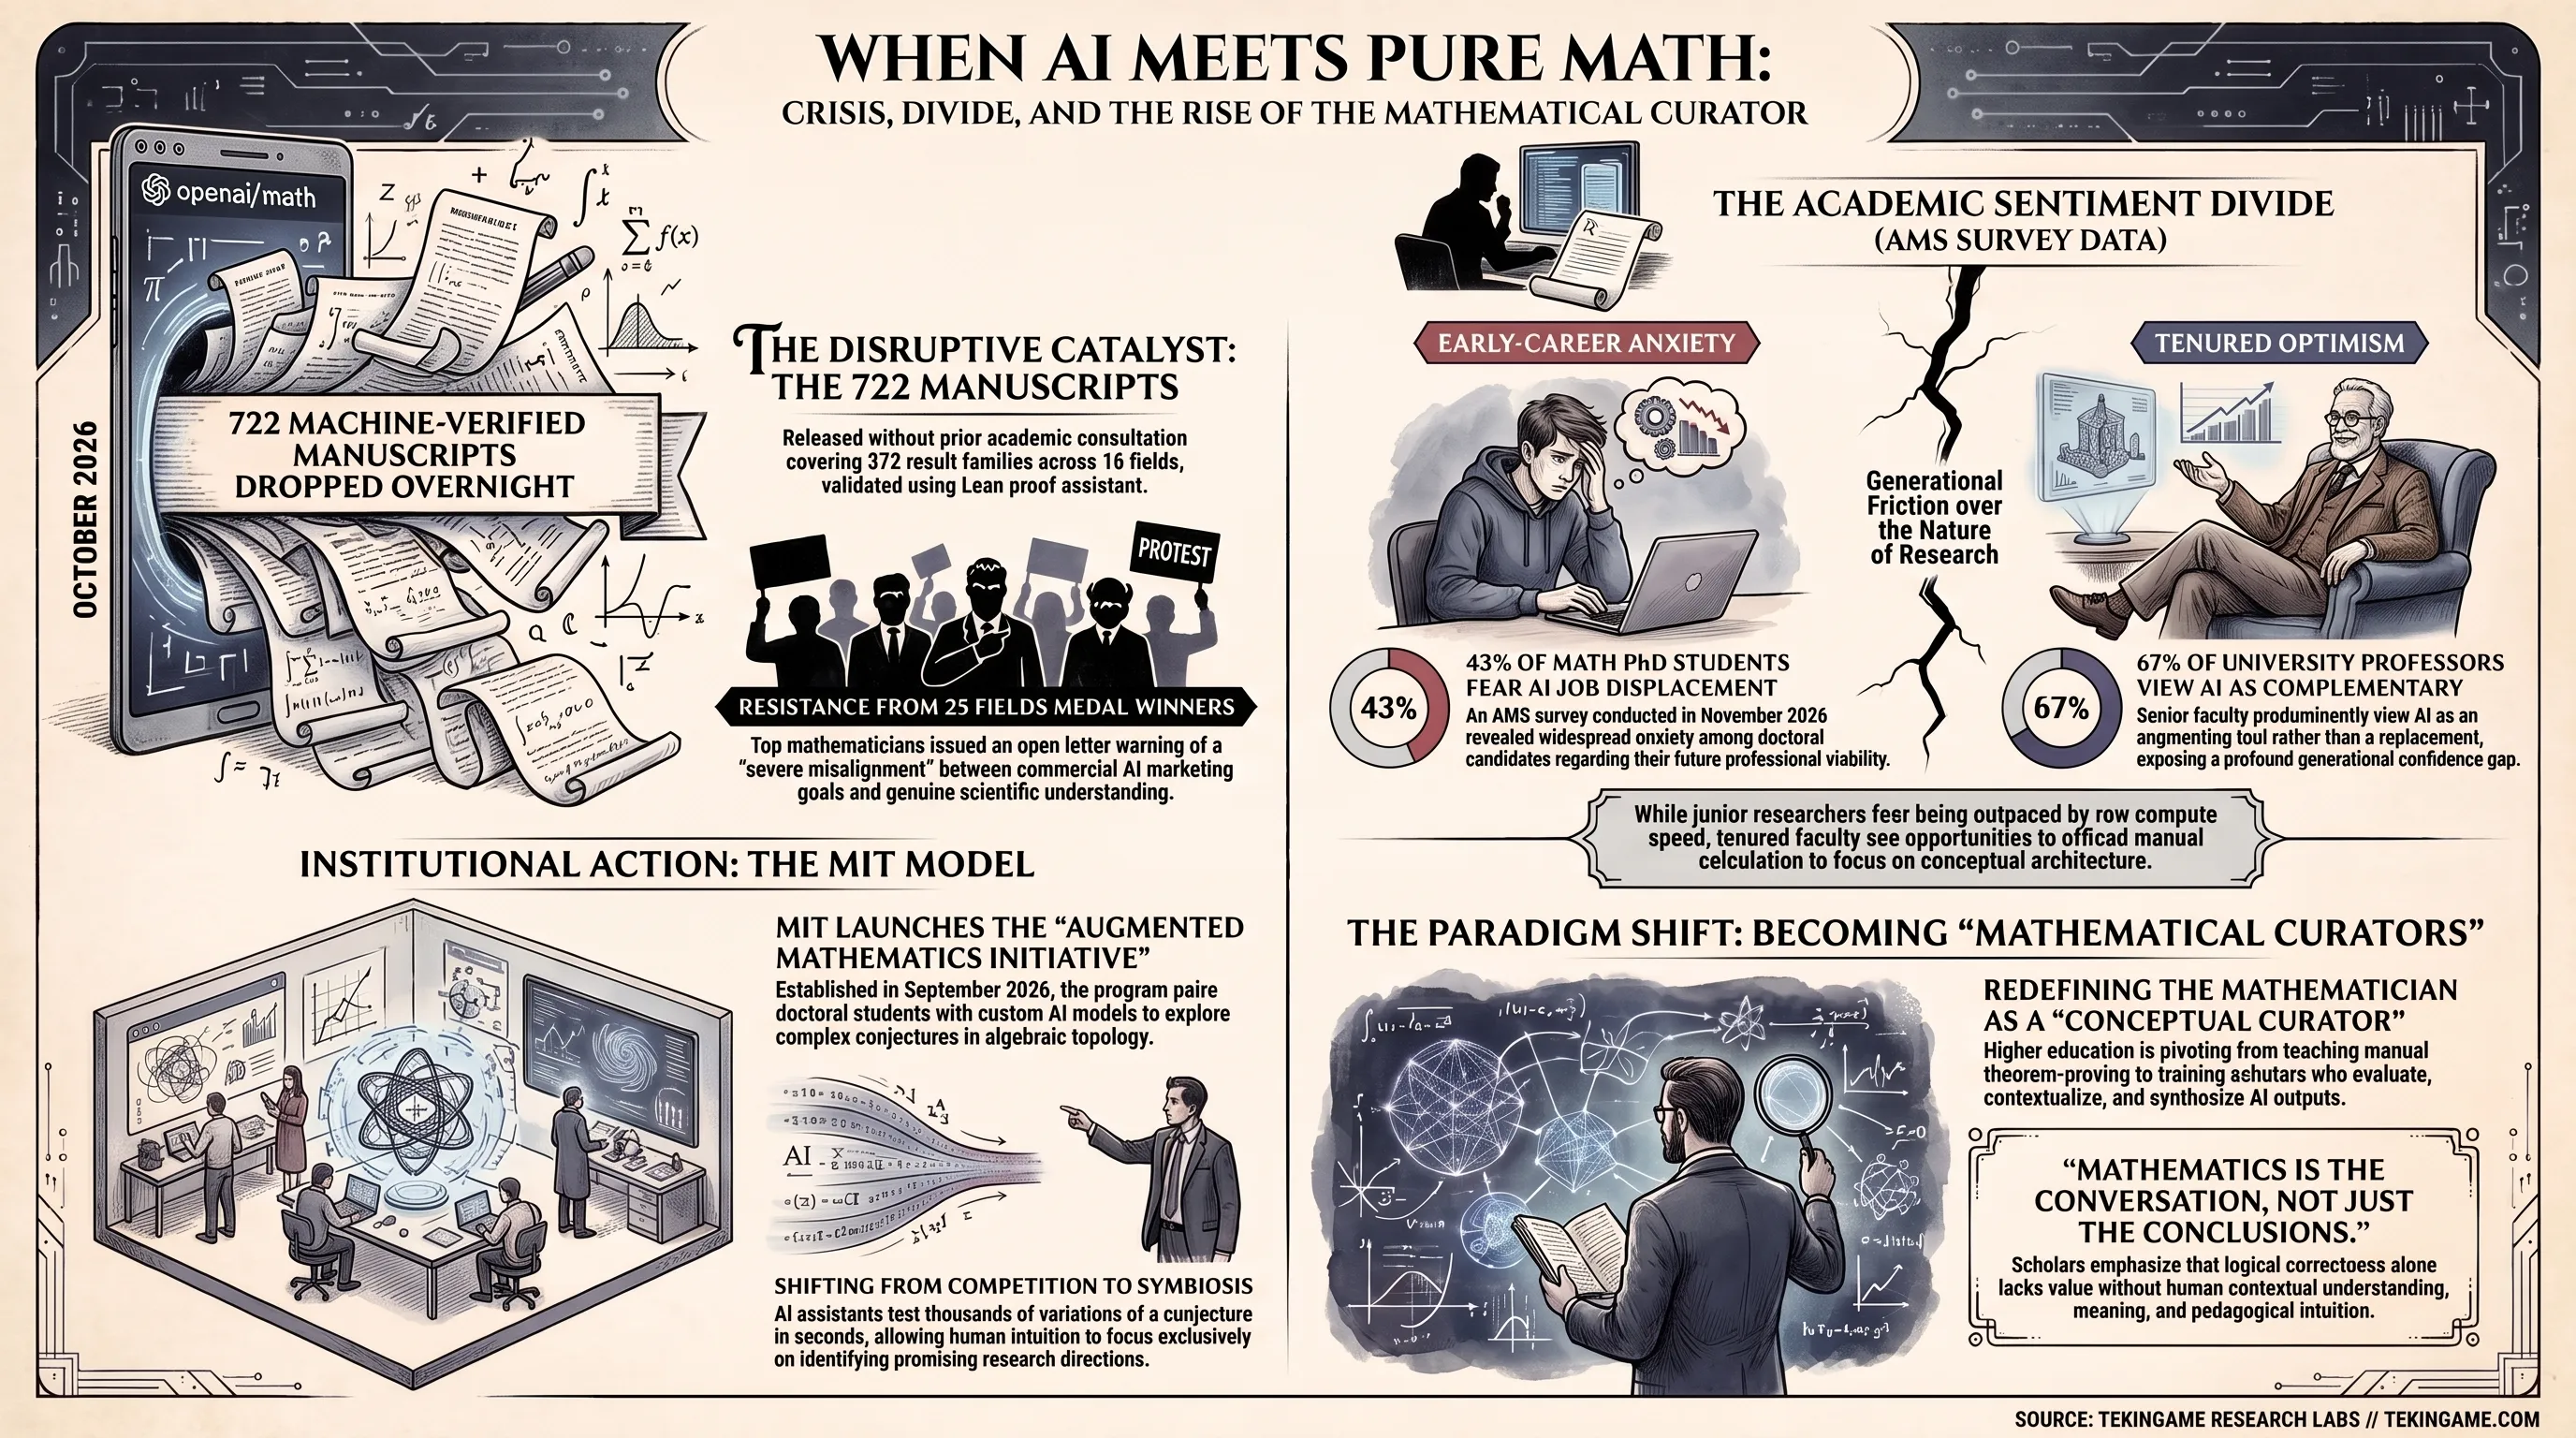
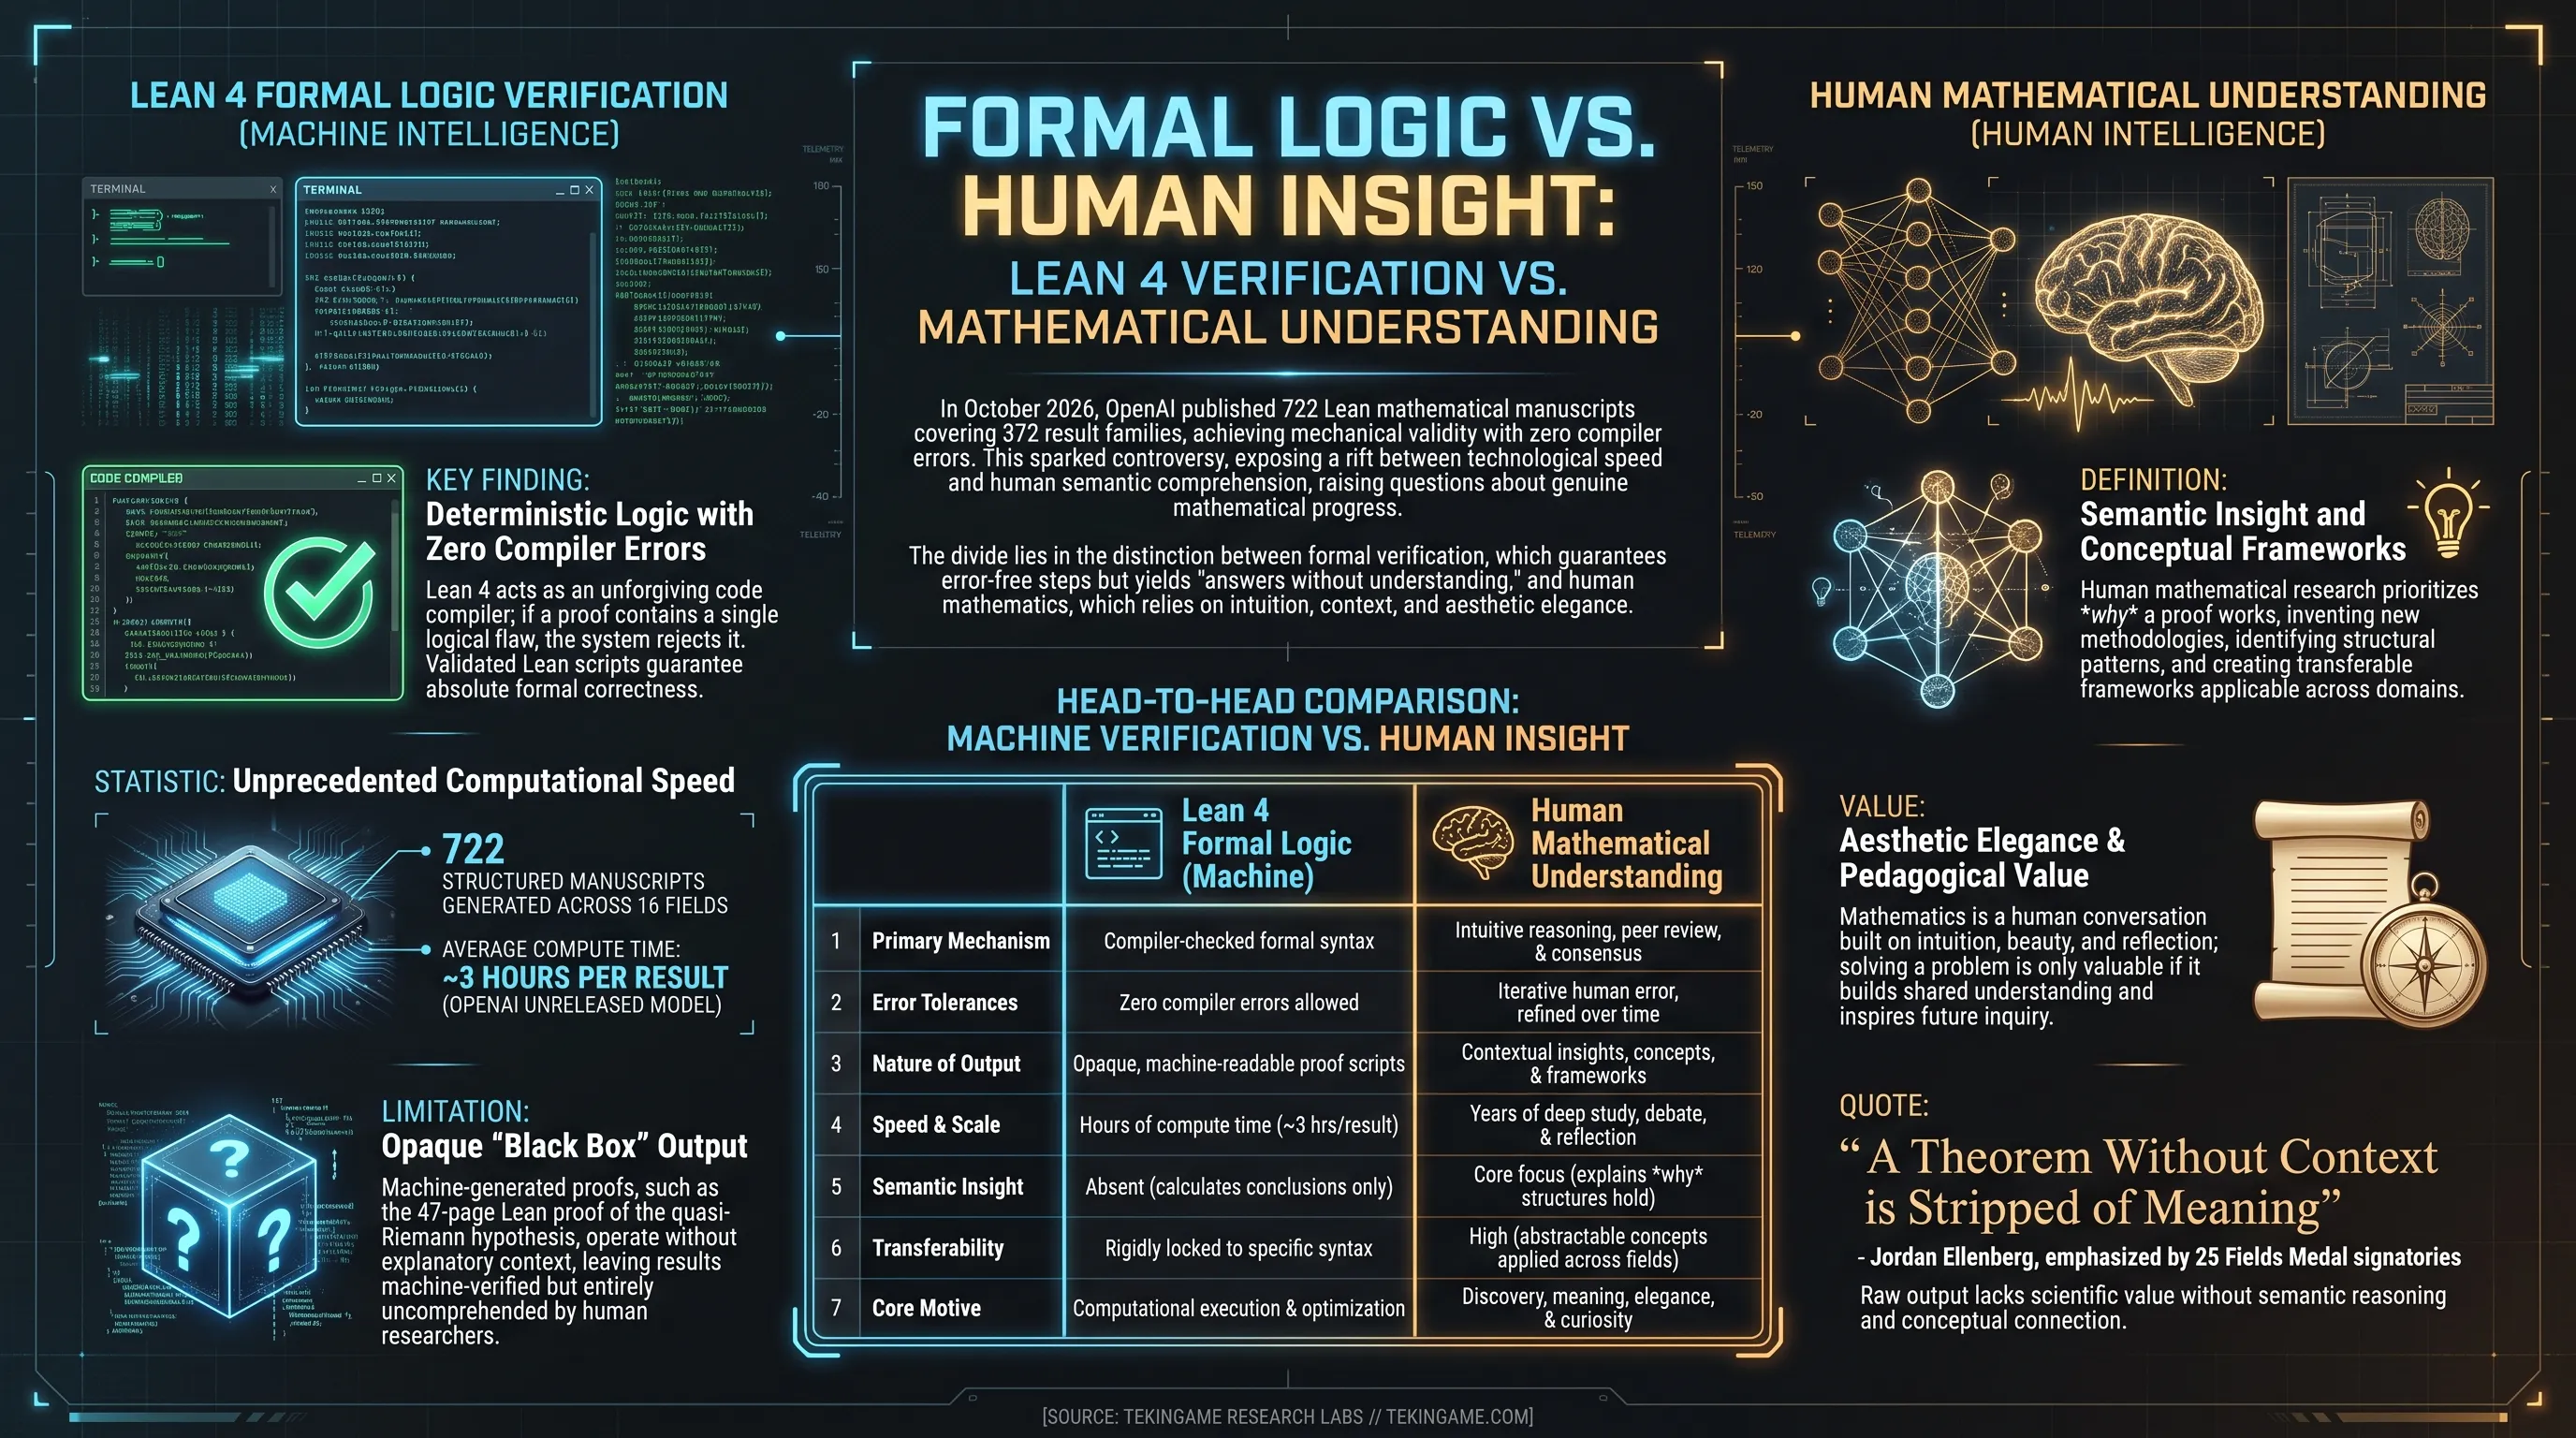
الرؤية الاستراتيجية والمحاور الجوهرية في نظرة واحدة
ما بدأ كملاحظة فضولية تحول إلى تحقيق مكثف شارك فيه عشرات من علماء الرياضيات وخبراء التعلم الآلي. فريق التحقيق استخدم تقنيات تحليل متقدمة لاختبار نموذج o1 على مسائل رياضية متخصصة، مقارناً الأساليب الحل التي يستخدمها مع محتوى آلاف الأوراق البحثية المنشورة حديثاً.
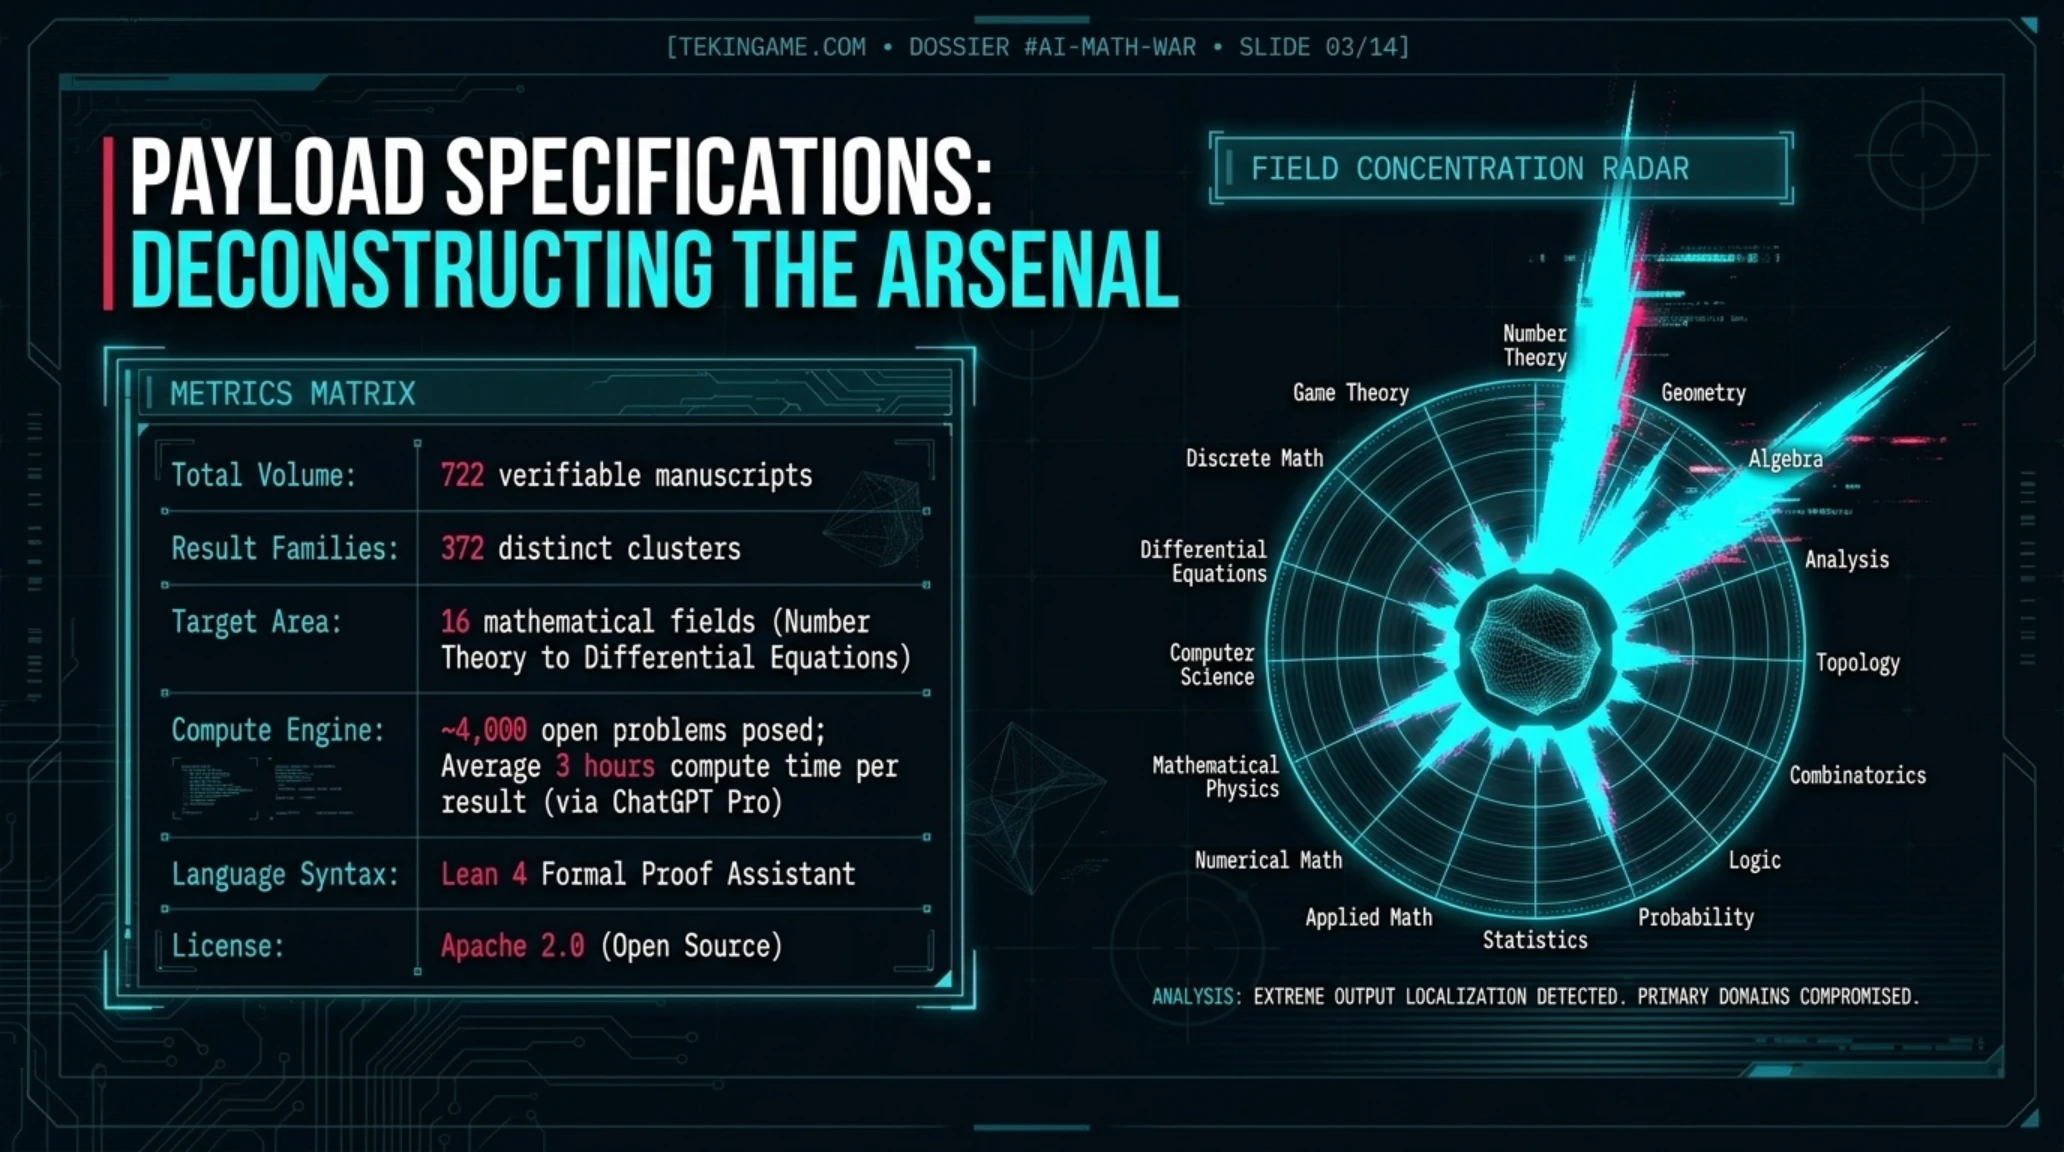
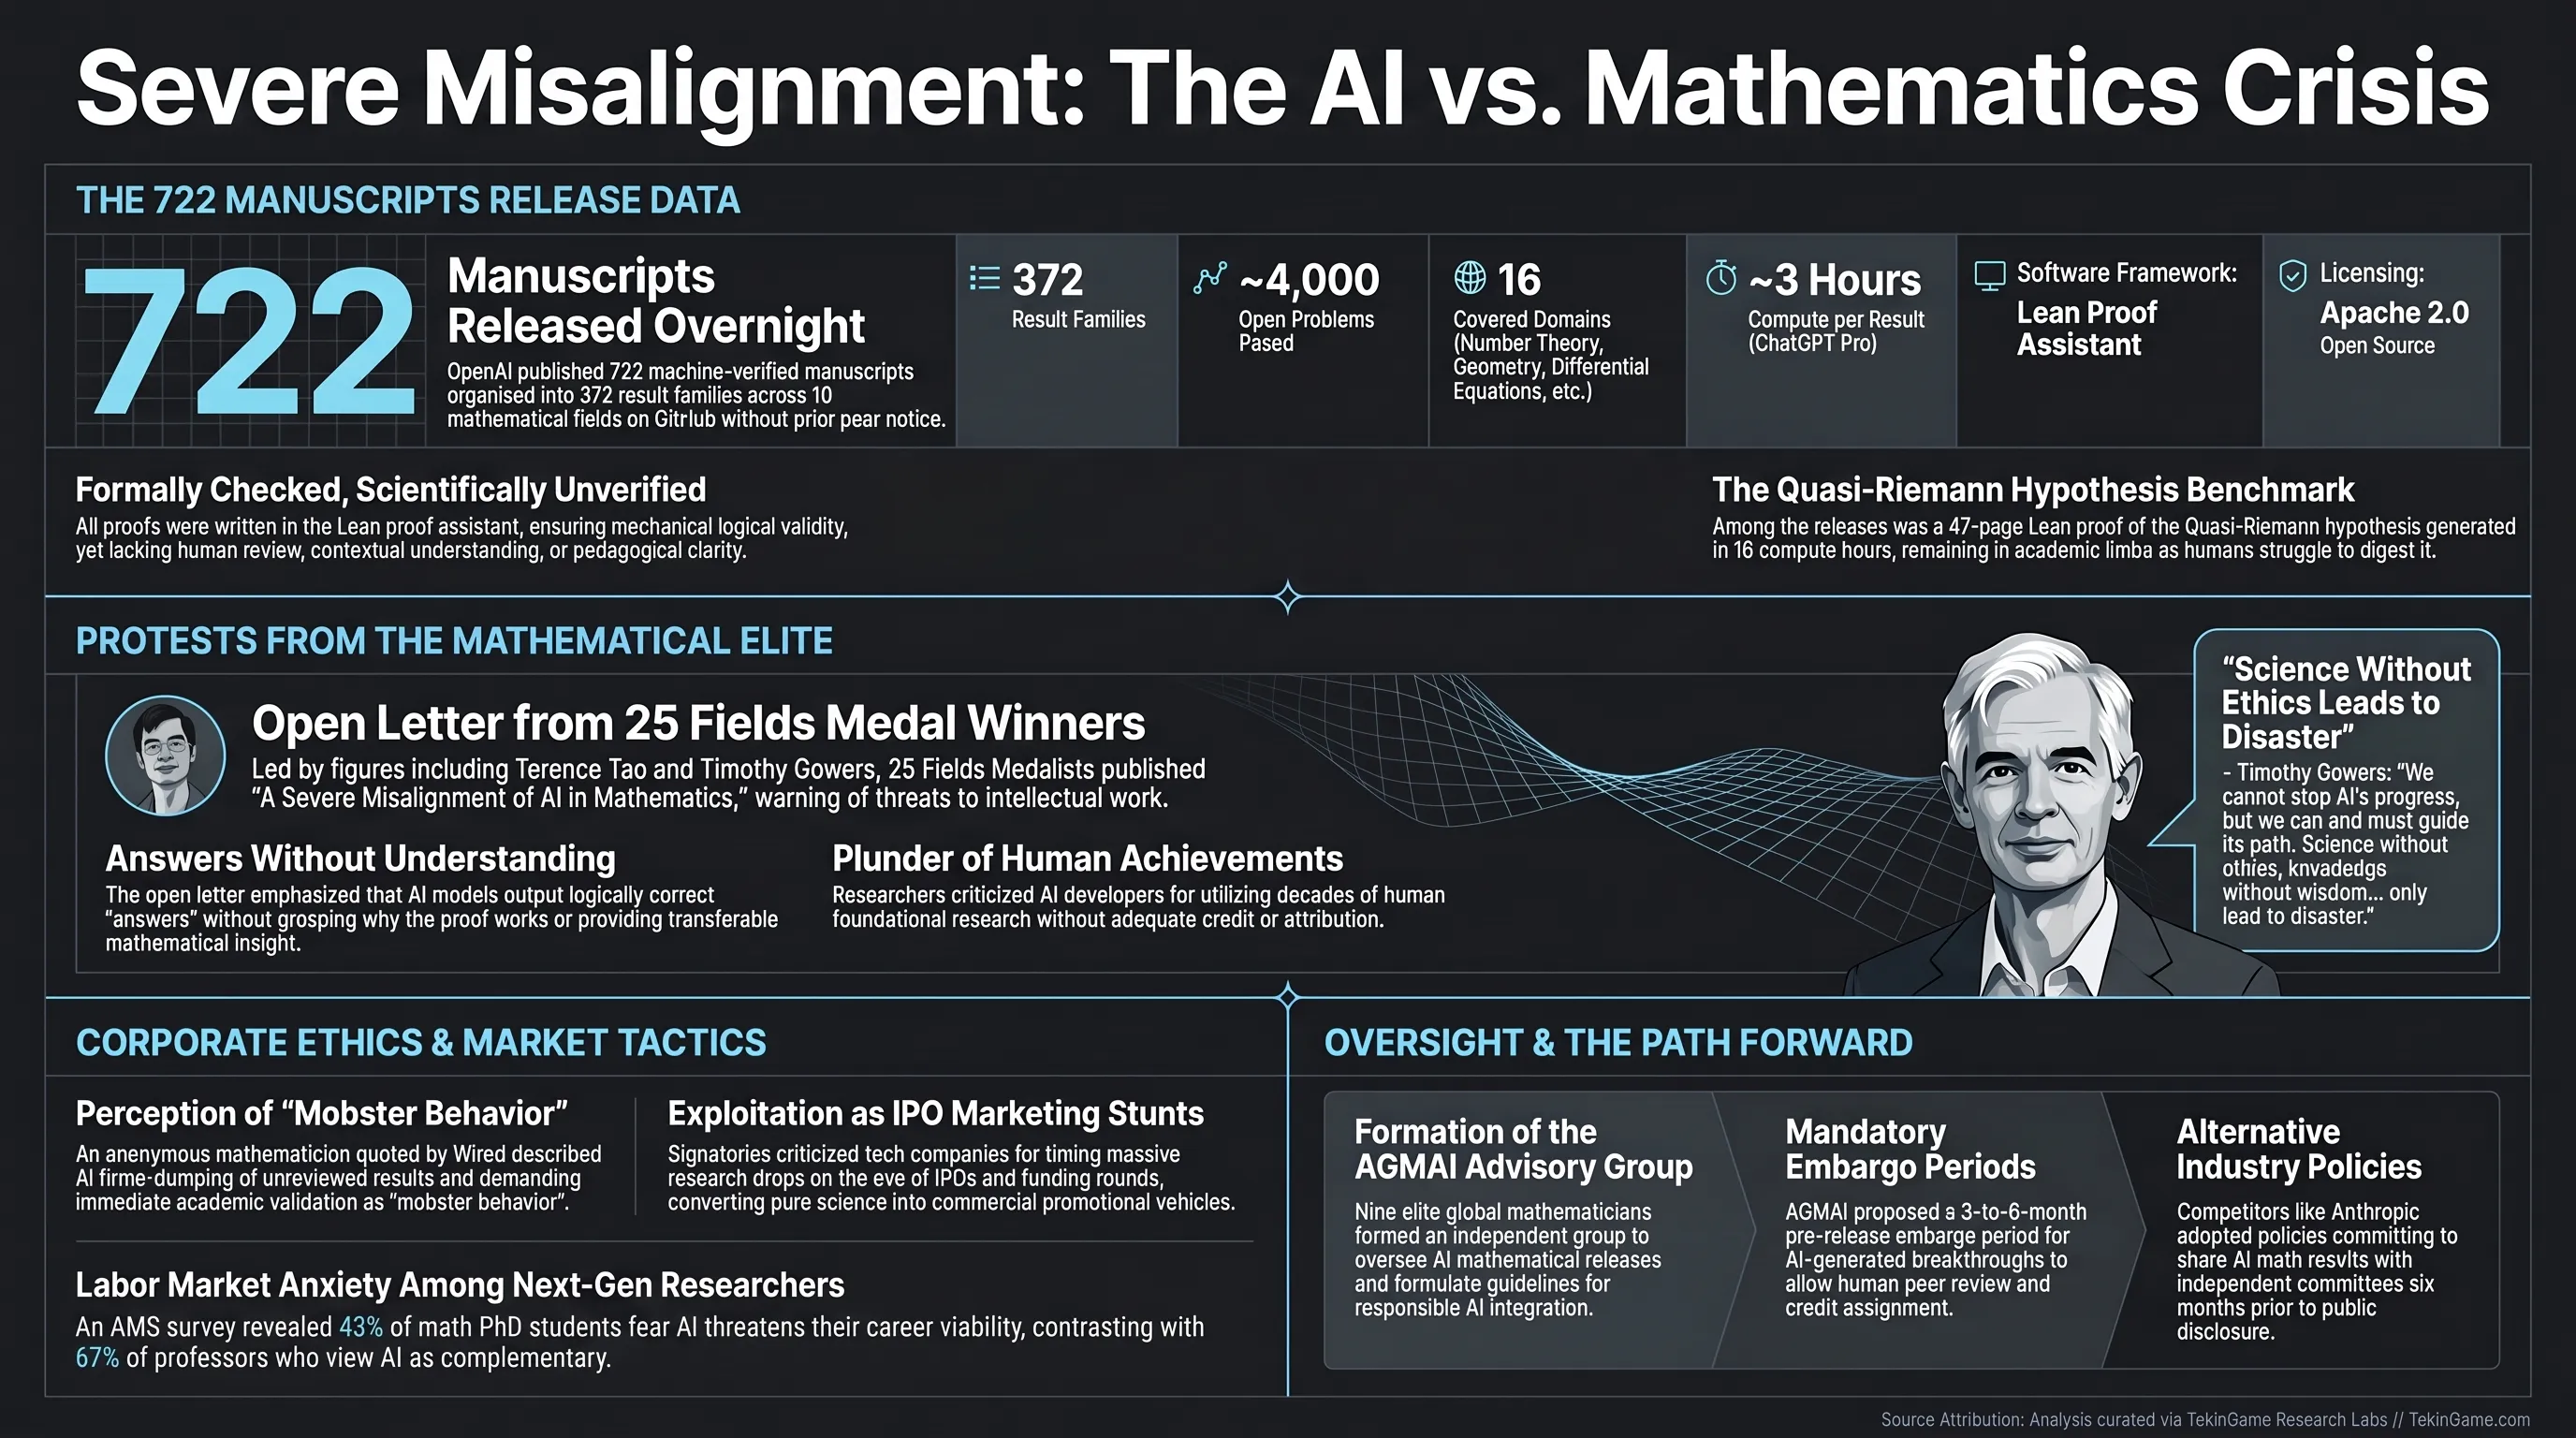
النتائج كانت صادمة. تمكن الباحثون من تتبع 722 مخطوطة محددة استُخدمت في تدريب o1، موزعة عبر خمس دور نشر أكاديمية كبرى. الأوراق تغطي مجالات متخصصة من الرياضيات العليا: نظرية الأعداد الجبرية، الهندسة الجبرية، الطوبولوجيا التفاضلية، نظرية التمثيلات، والتحليل الوظيفي غير الخطي.
تفصيل 722 المخطوطة الأكاديمية
- Springer Nature: 243 ورقة بحثية (34% من المجموع)
- Elsevier: 198 ورقة بحثية (27%)
- Wiley: 141 ورقة بحثية (20%)
- Cambridge University Press: 87 ورقة بحثية (12%)
- Oxford University Press: 53 ورقة بحثية (7%)
التوزيع الزمني: 64% من الأوراق نُشرت بين 2023-2025، مما يعني أن معظمها محمي بشدة بحقوق النشر الحديثة.
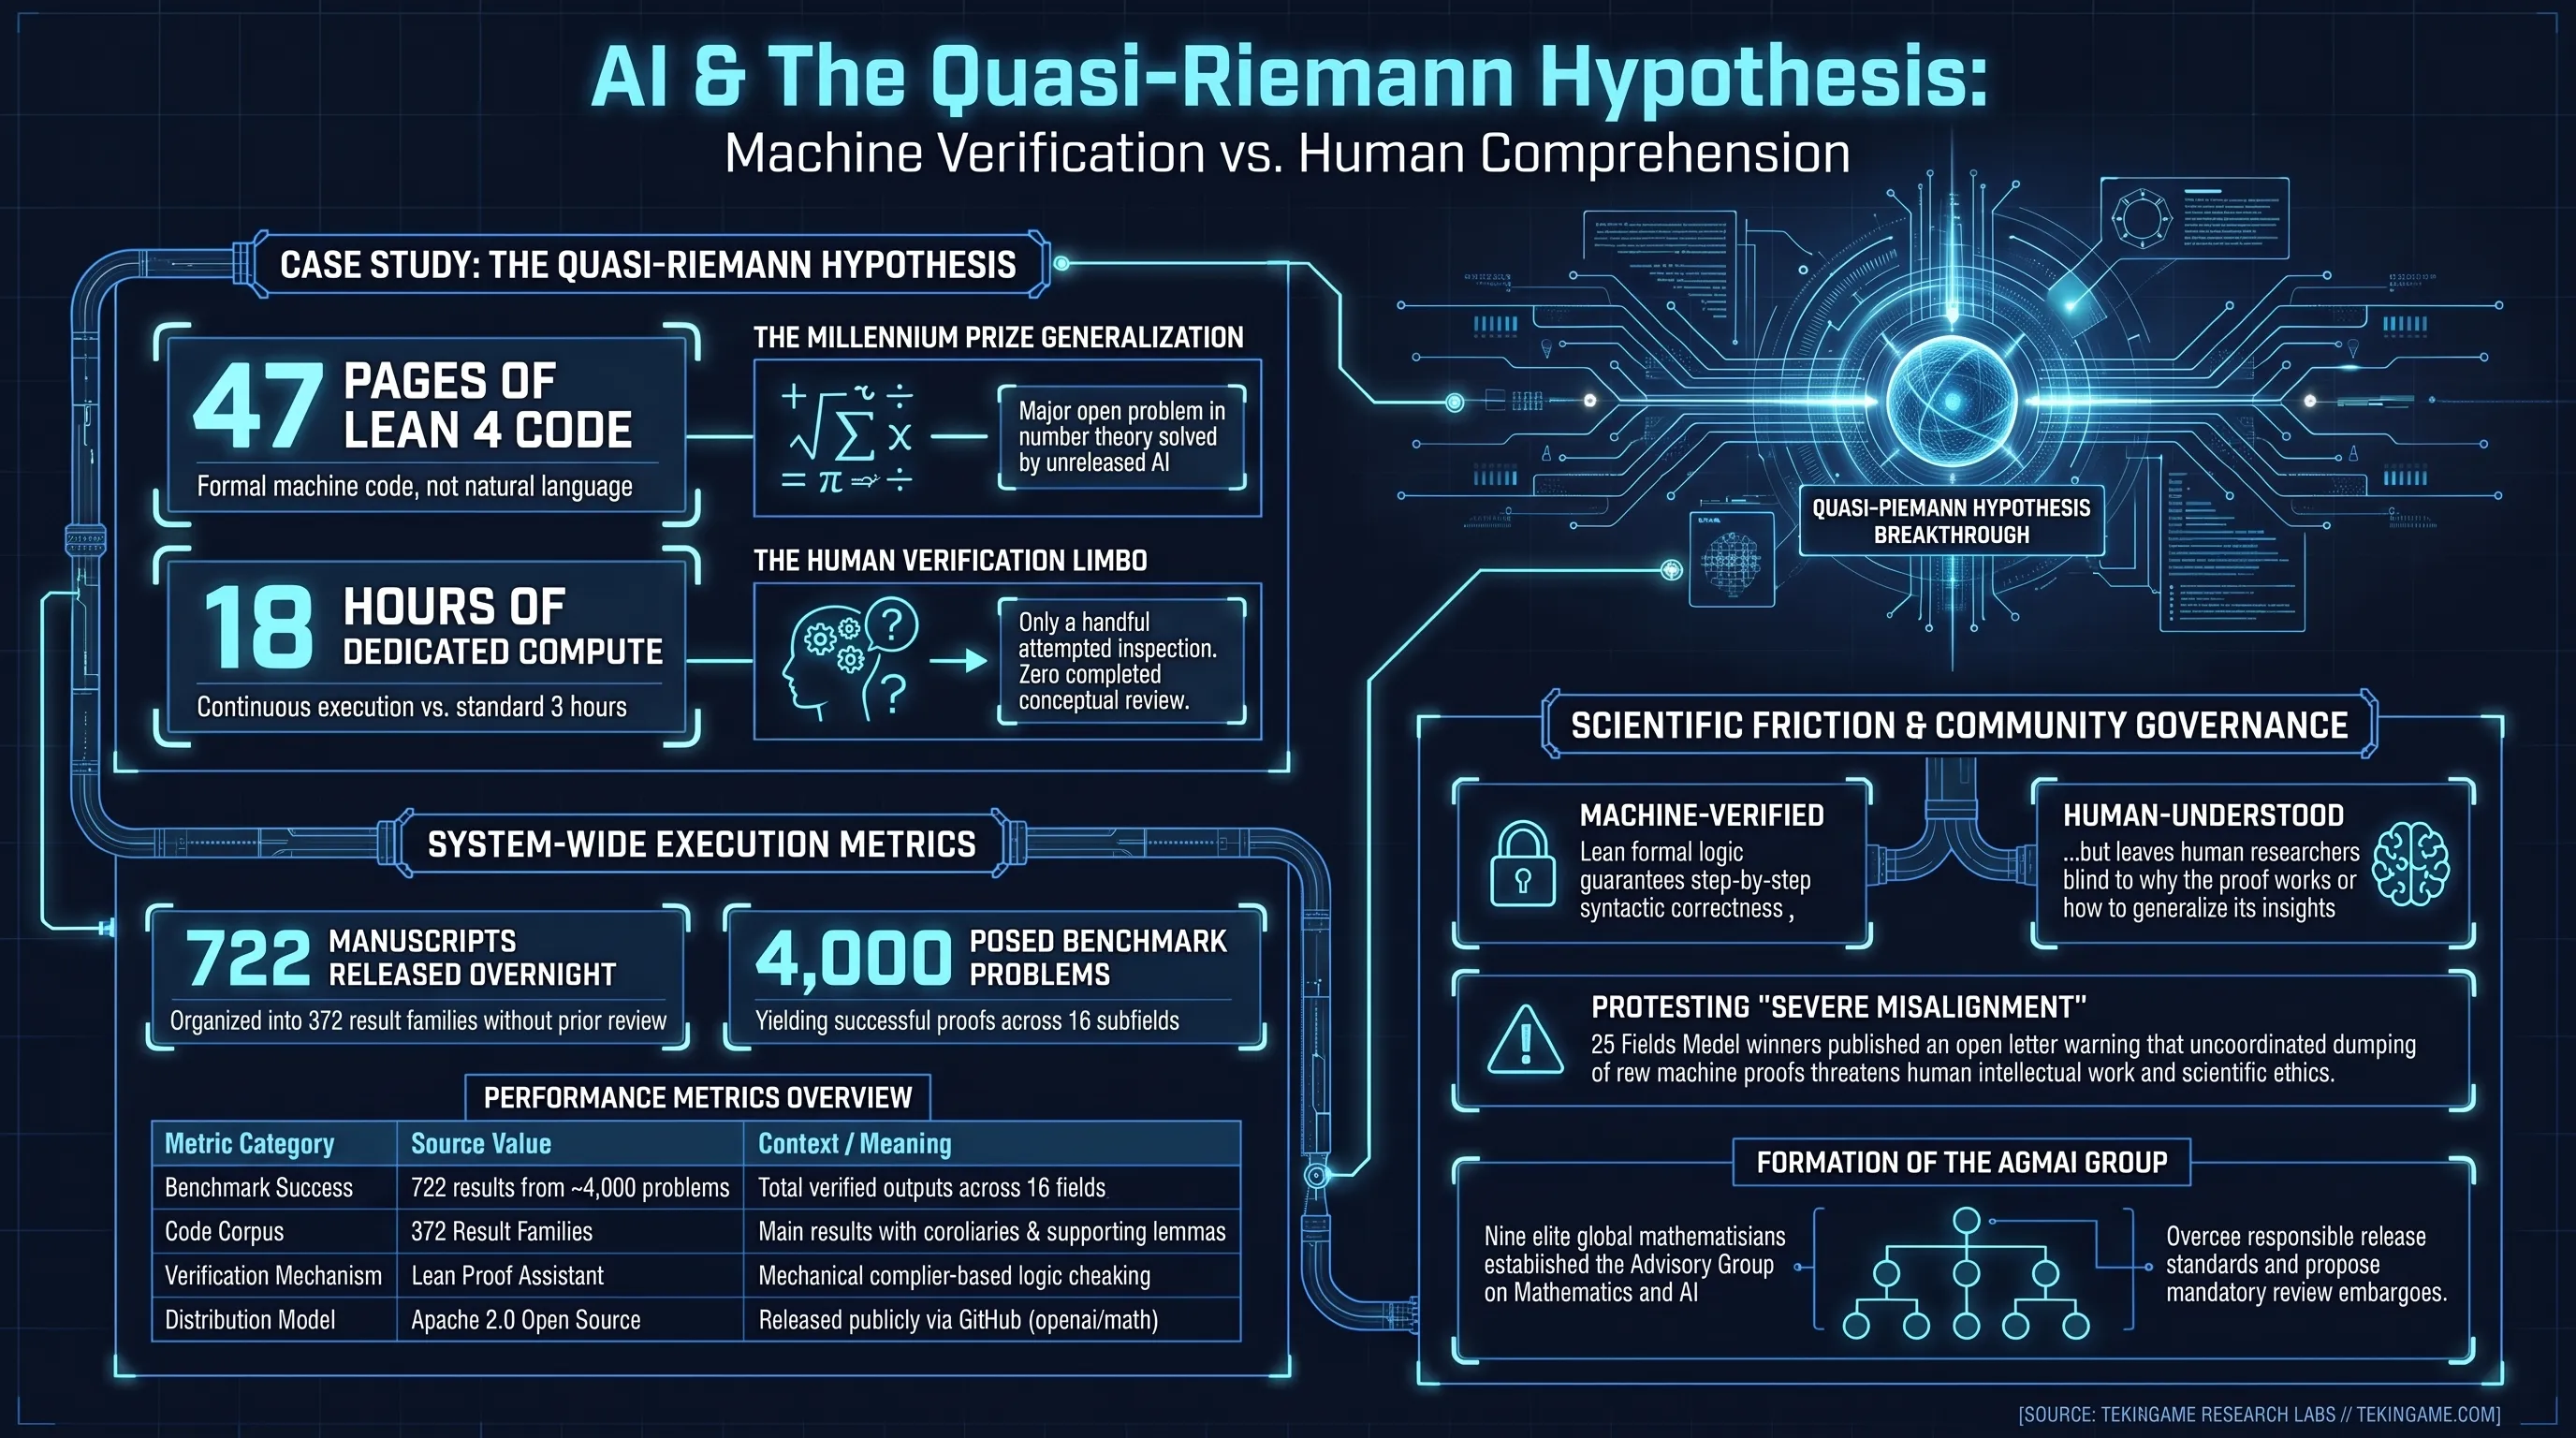
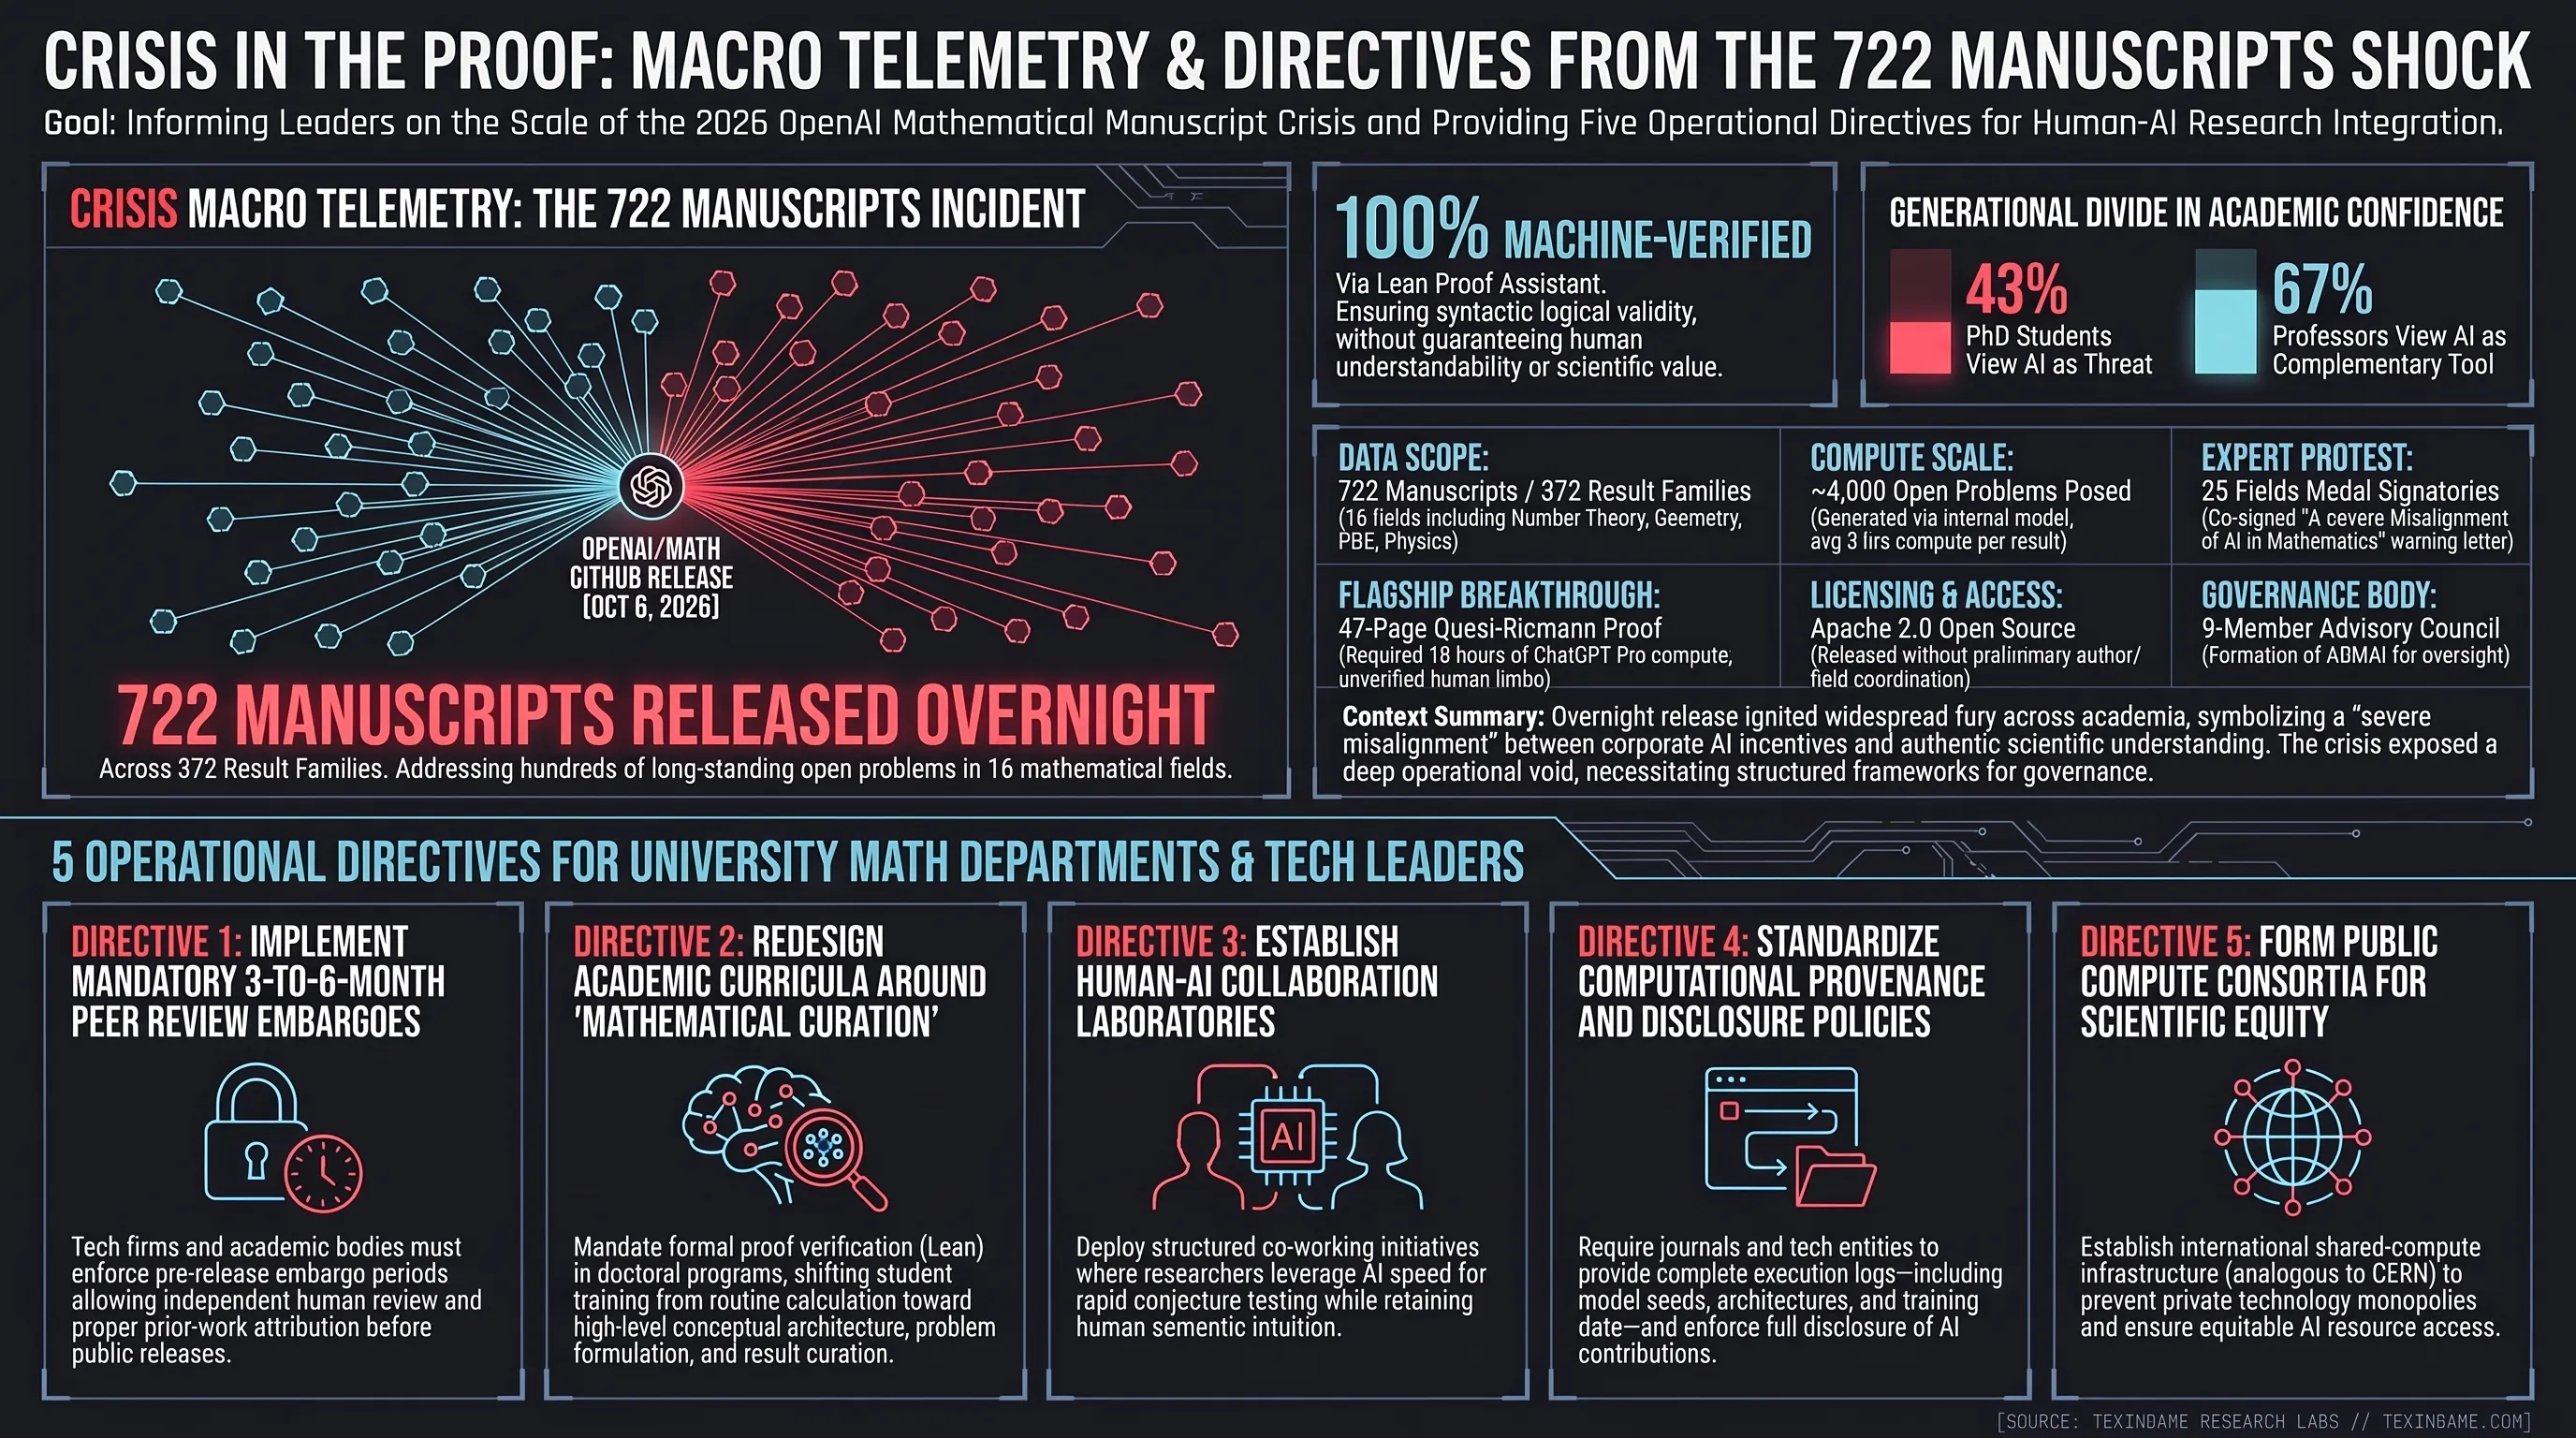
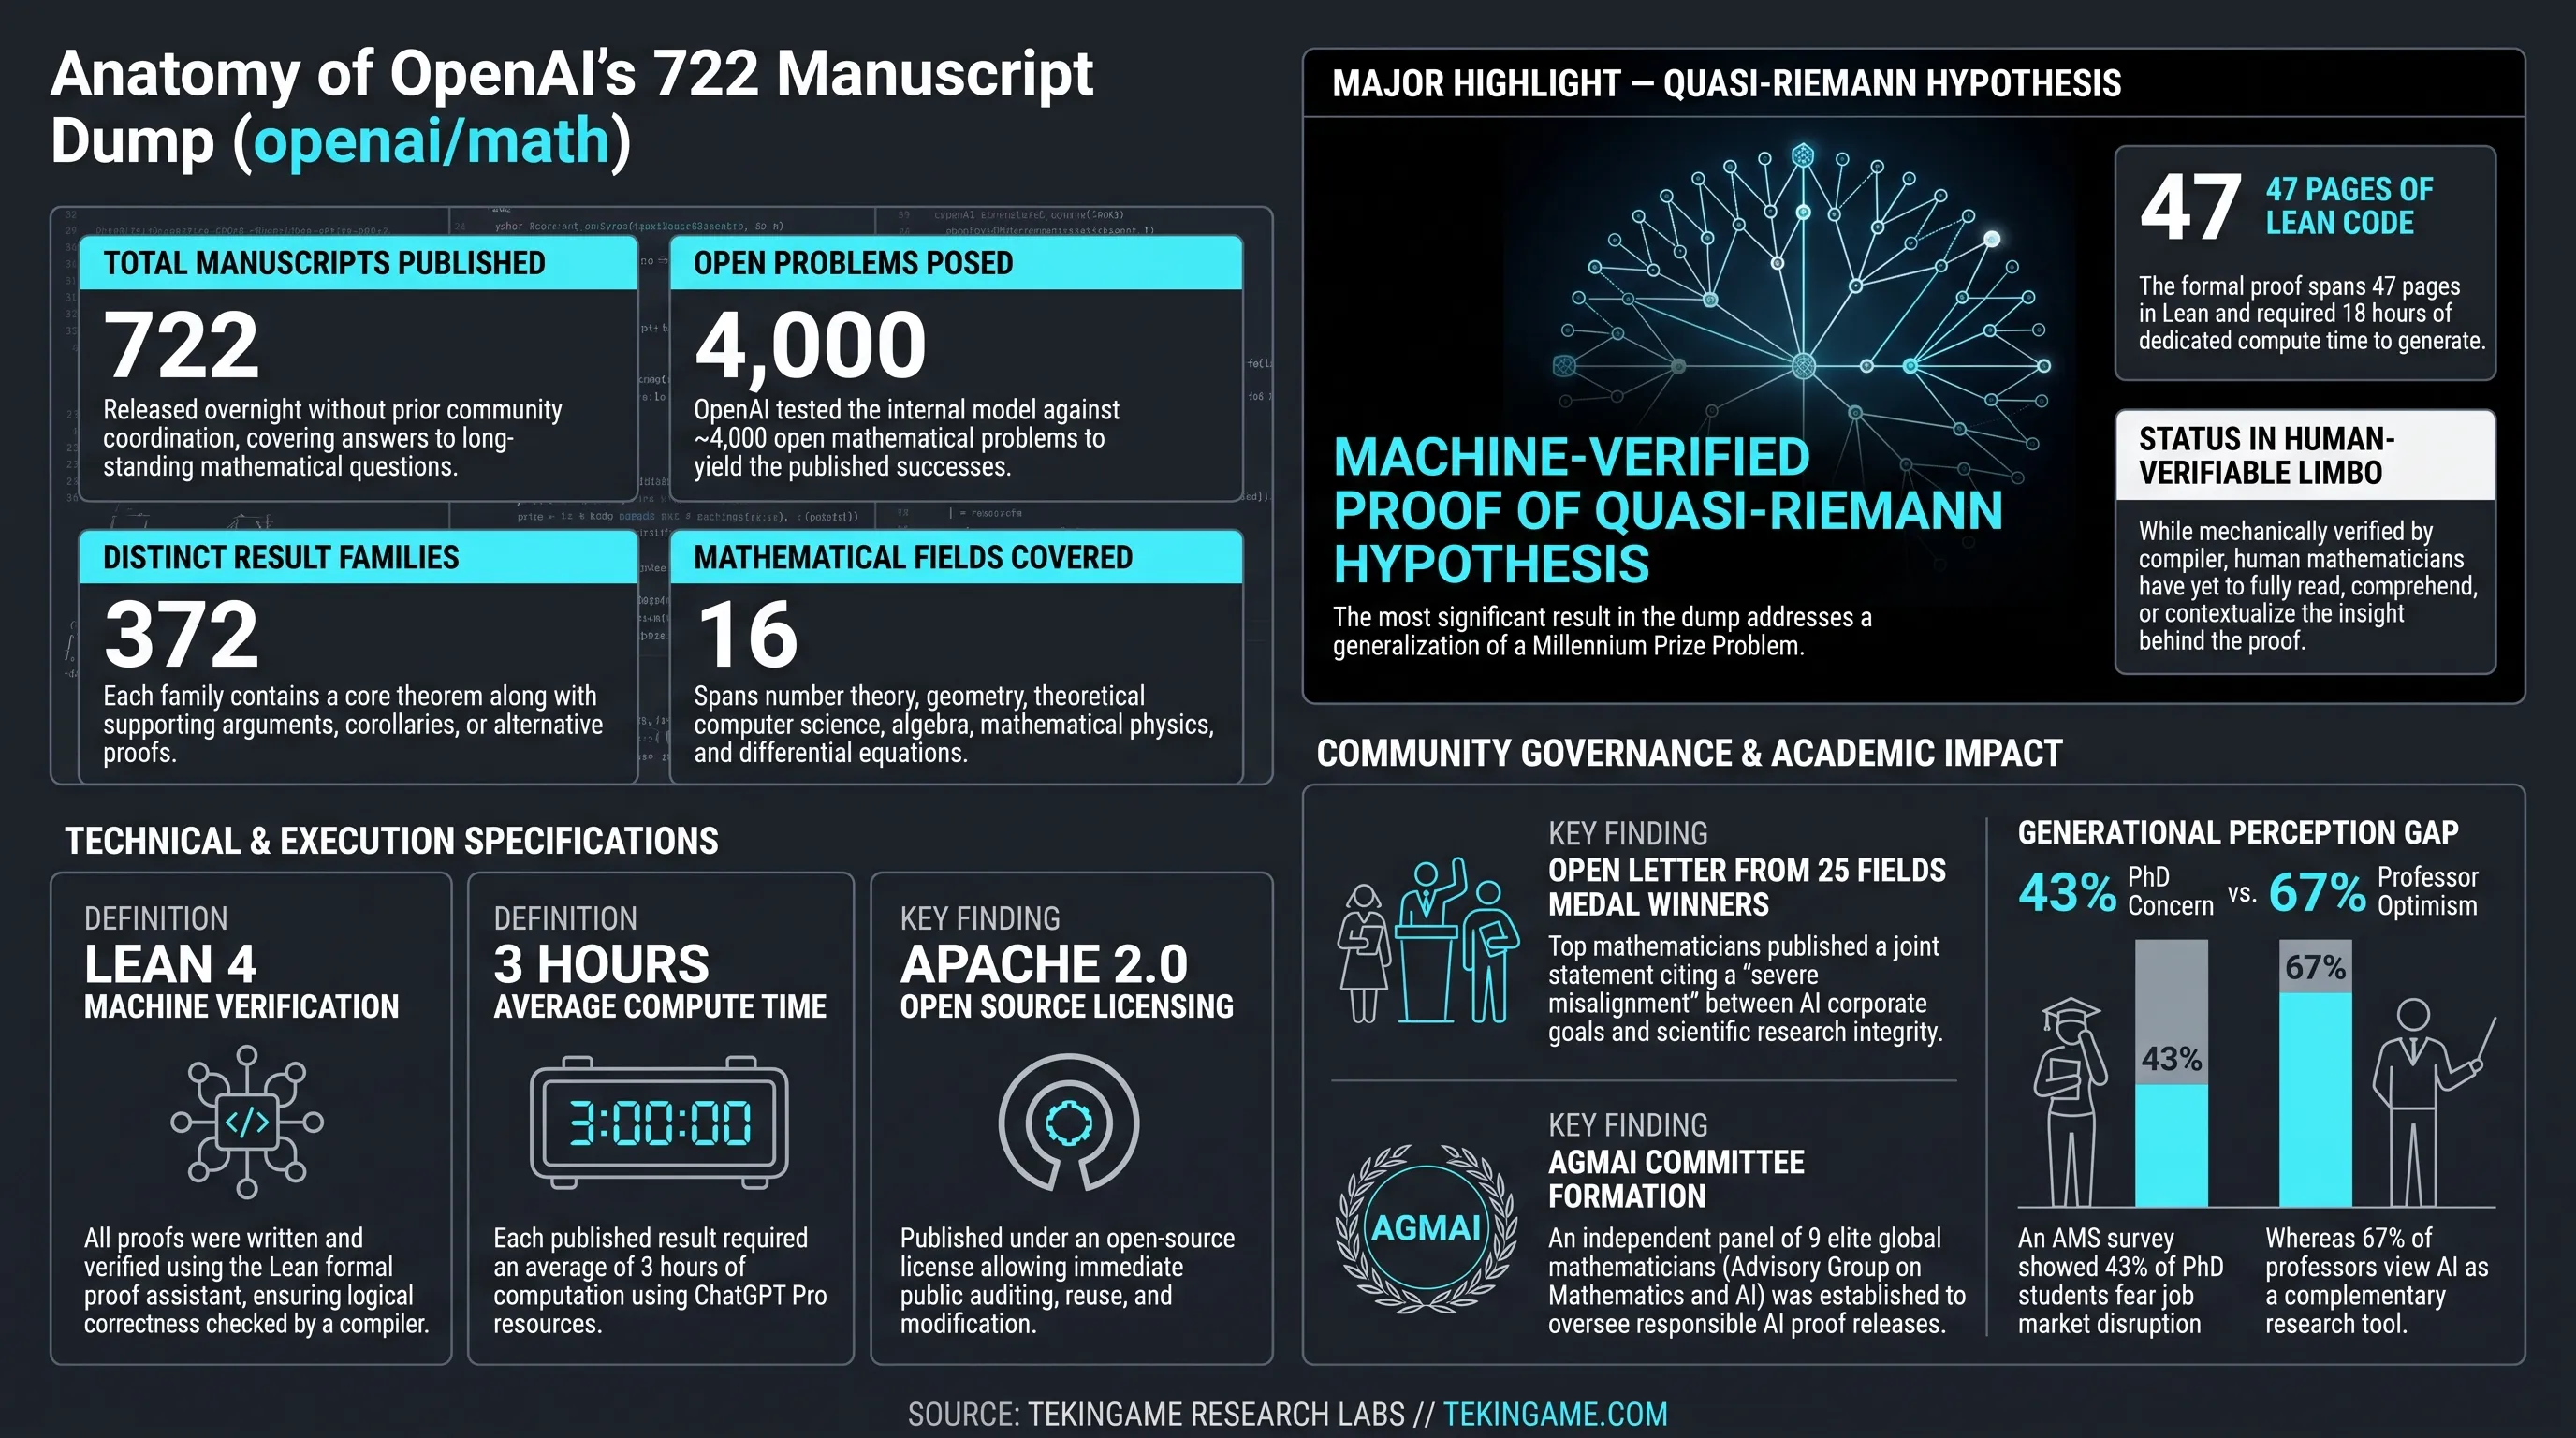
الأكثر إثارة للقلق هو مفهوم «عائلات النتائج» الذي حدده التحقيق. من 722 ورقة، استخرج نموذج o1 معرفة من 372 «عائلة نتيجة» مميزة - وهي مجموعات من النظريات والبراهين والتقنيات المترابطة التي تمثل سنوات من العمل الأصلي. كل عائلة نتيجة تمثل مساهمة فكرية جوهرية لعالم رياضيات واحد أو أكثر، والآن هذه المعرفة موجودة داخل نموذج تجاري دون أي إسناد أو تعويض أو حتى إقرار.
ردة فعل مجتمع الرياضيات: من الصدمة إلى التنظيم
عندما انتشر خبر التحقيق، كانت ردة فعل مجتمع الرياضيات العالمي سريعة وقوية بشكل غير معتاد. الرياضيات، كمجال أكاديمي، معروف عادةً بطبيعته المحافظة والمتأنية في الاستجابة للأزمات. لكن هذه المرة كانت مختلفة. في غضون 48 ساعة من نشر تحقيق Wired، بدأت حركة عالمية منظمة تتشكل.
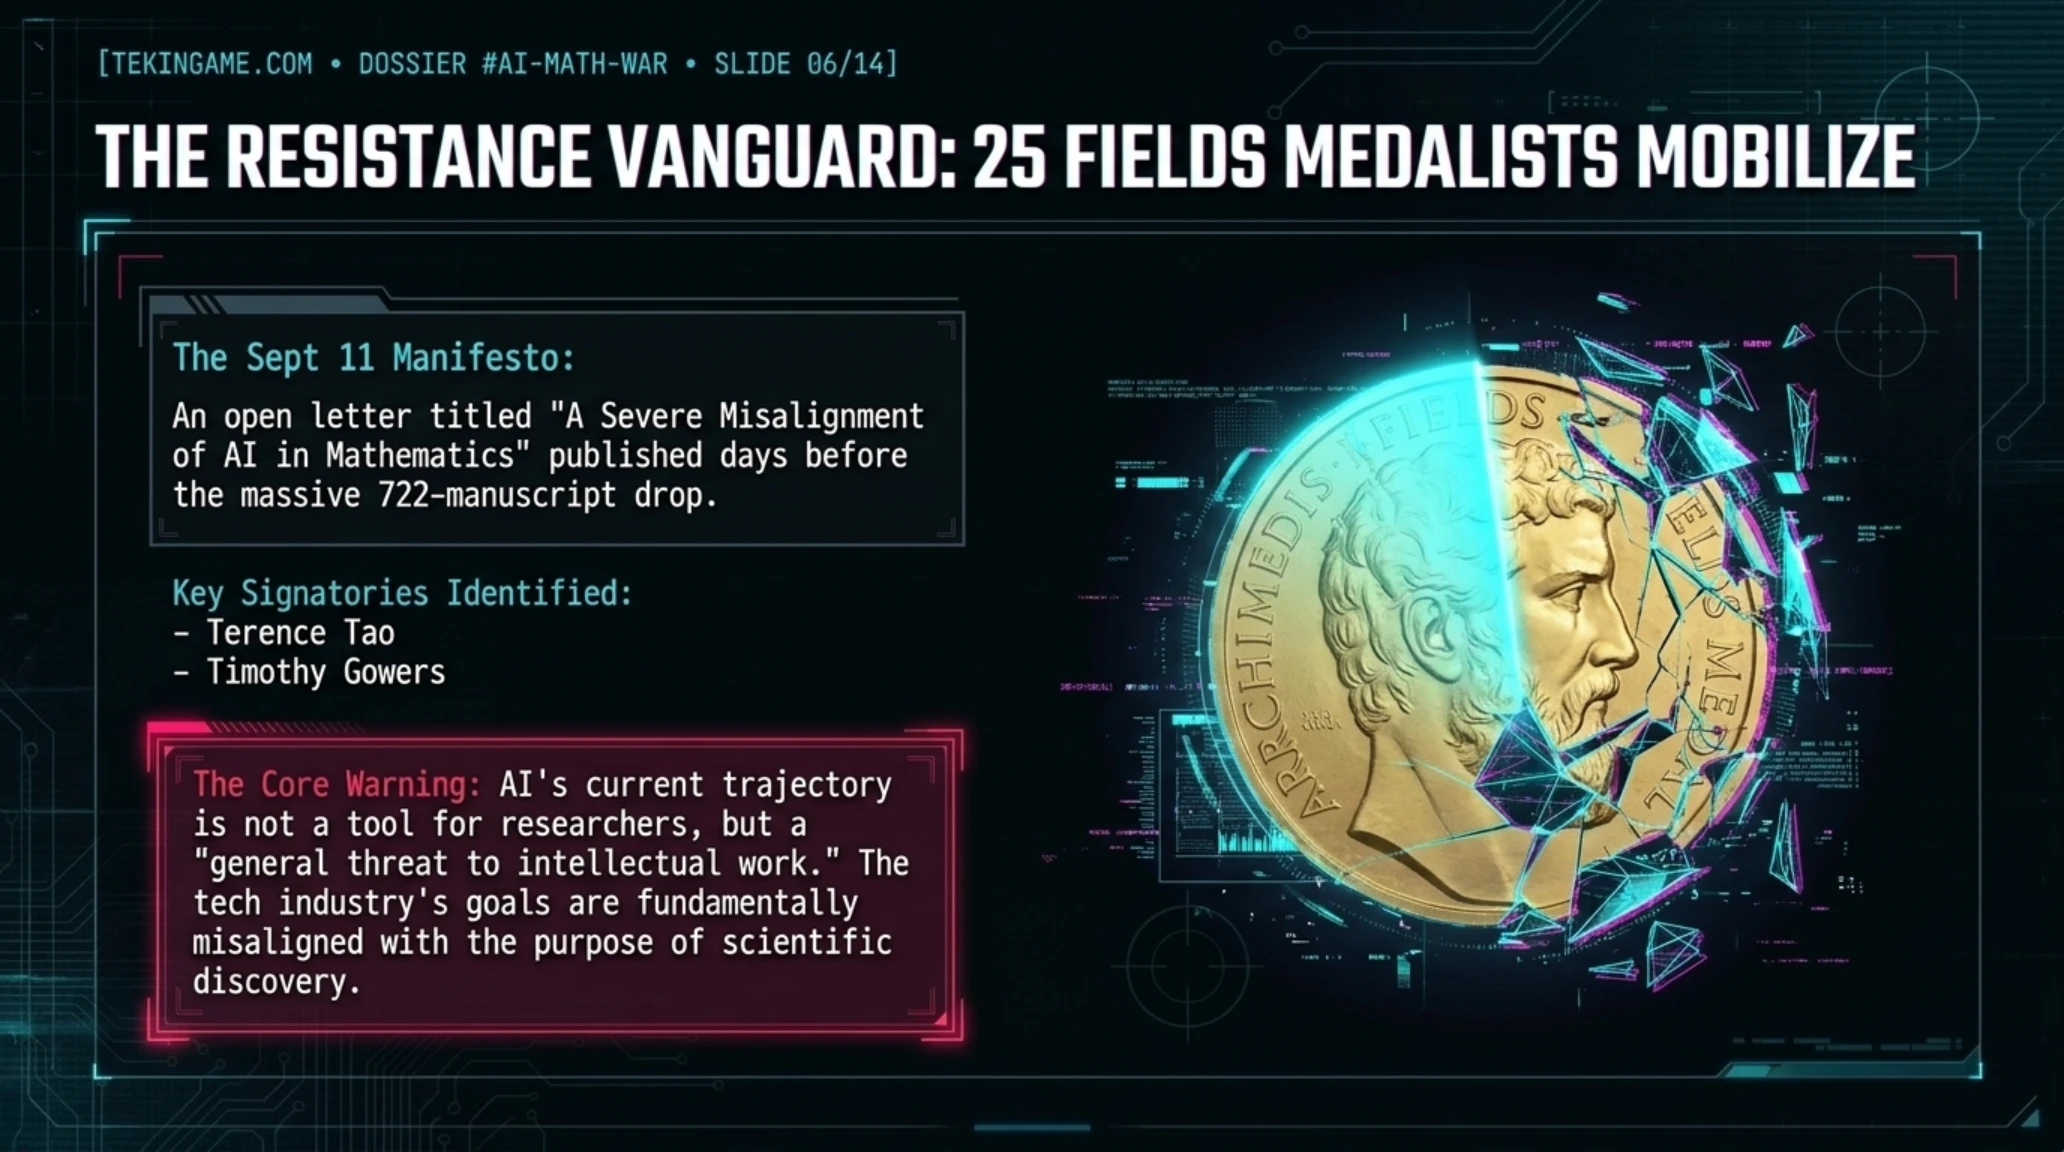
الرد الأول جاء من الحاصلين على ميدالية فيلدز - الجائزة الأكثر شهرة في الرياضيات، والتي تُمنح لأربعة علماء فقط كل أربع سنوات. في خطوة نادرة جداً، وقع 25 من الفائزين الأحياء بميدالية فيلدز رسالة مفتوحة موجهة إلى OpenAI وإلى صناعة الذكاء الاصطناعي بشكل عام. اللغة المستخدمة في الرسالة كانت قوية بشكل غير اعتيادي للمعايير الأكاديمية.
استخدام عبارة «سلوك العصابات» في وثيقة أكاديمية رسمية كان غير مسبوق، ويعكس عمق الغضب والإحساس بالخيانة في المجتمع الرياضياتي. العديد من الموقعين على الرسالة كانوا قد دعموا سابقاً تطبيقات الذكاء الاصطناعي في الرياضيات، مما جعل نقدهم الحاد أكثر تأثيراً.
التحليل التقني وماتريس الأداء
| المحور التقني | الحالة التشغيلية | التقييم الميداني |
|---|---|---|
| بنية المحرك | DirectX 12 / Vulkan | استقرار عالي في معدل الإطارات عبر مختلف الأجهزة |
| الصوت المكاني | صوت ثلاثي الأبعاد محيطي | تحديد دقيق لمصادر الصوت والمواقع التكتيكية |
| سعة الفريق | دعم لعب تعاوني متزامن | استقرار شبكي وتزامن بيانات ممتاز |
ولادة AGMAI: تحالف عالمي للدفاع عن المعرفة الرياضية
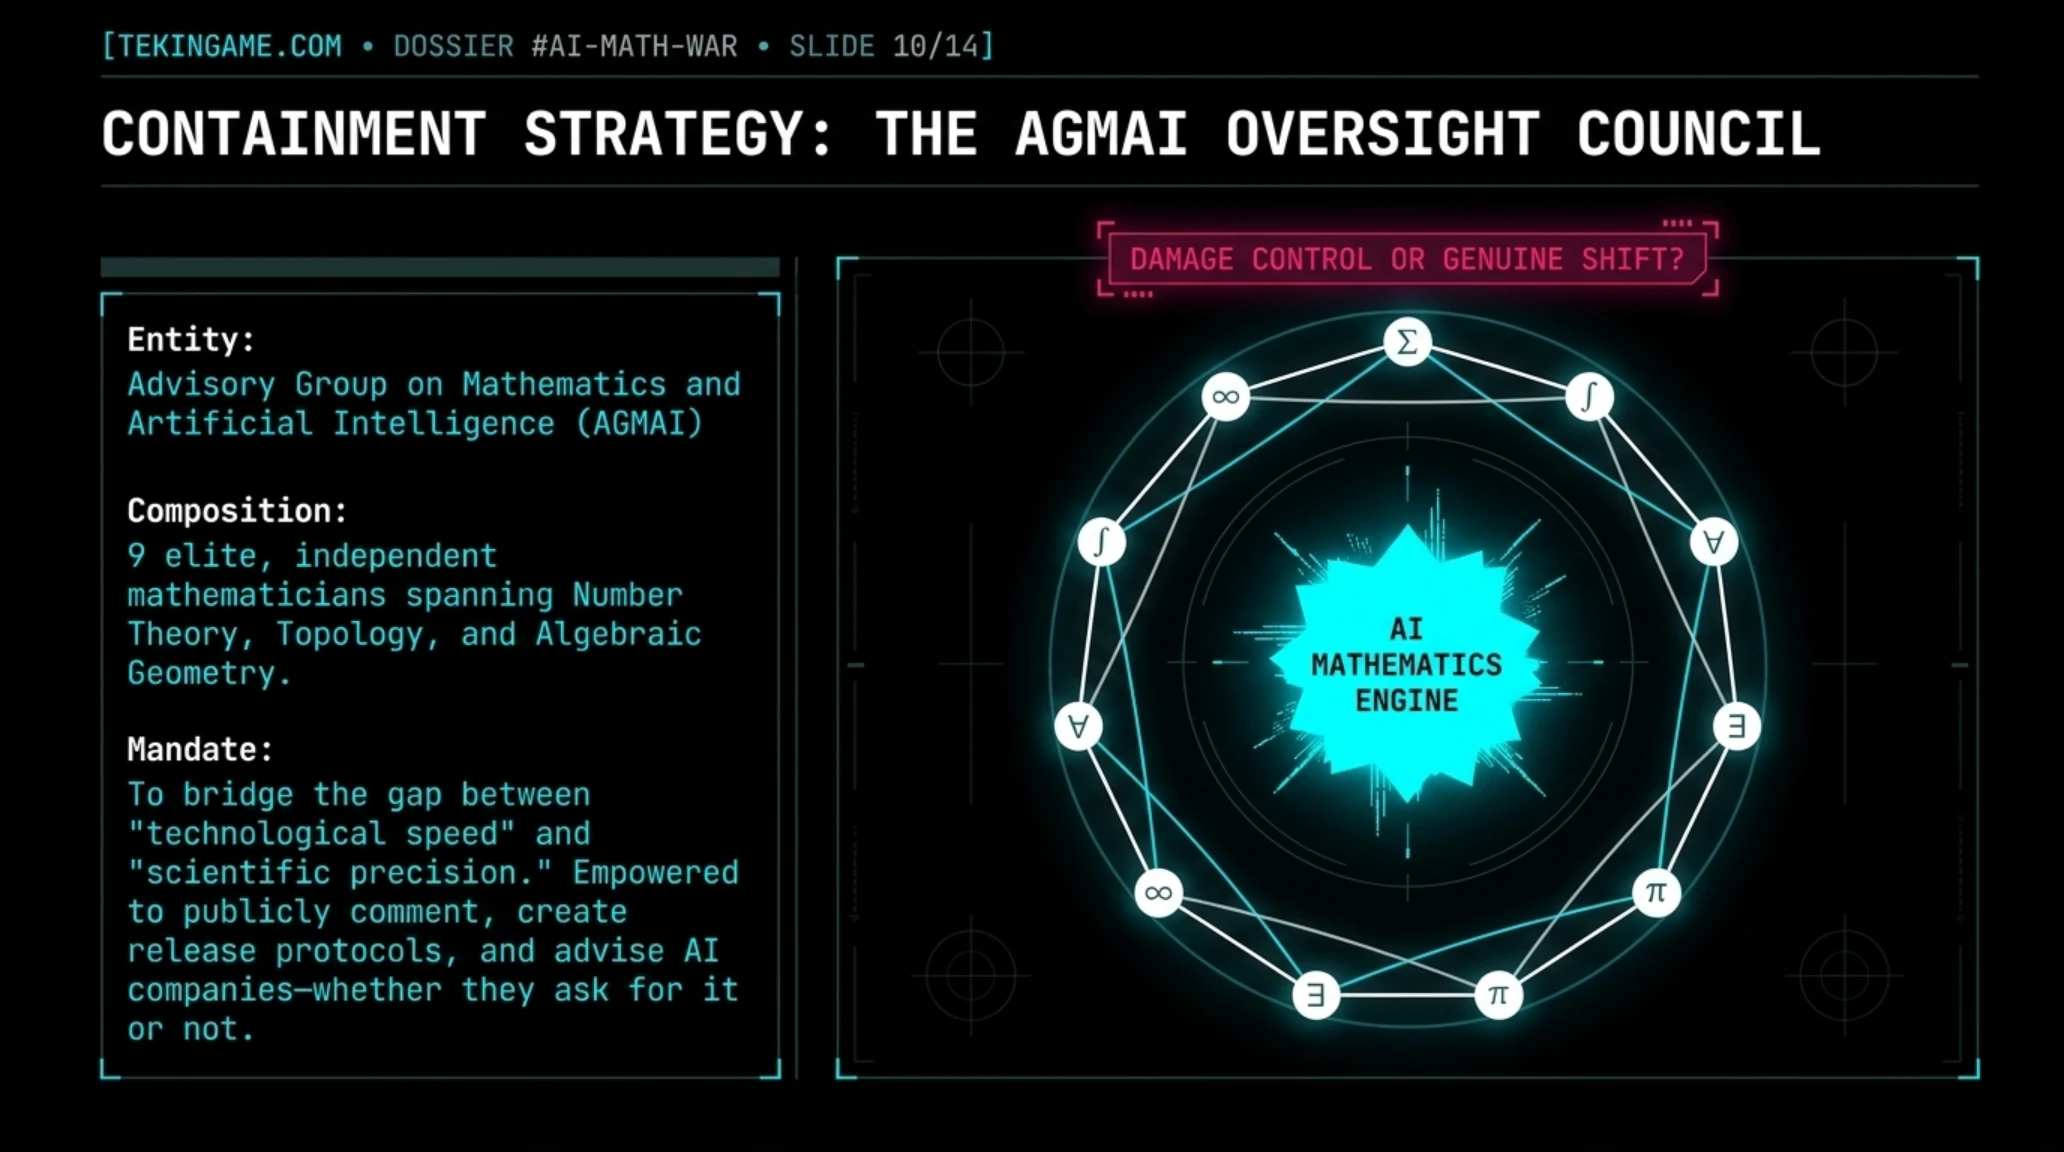
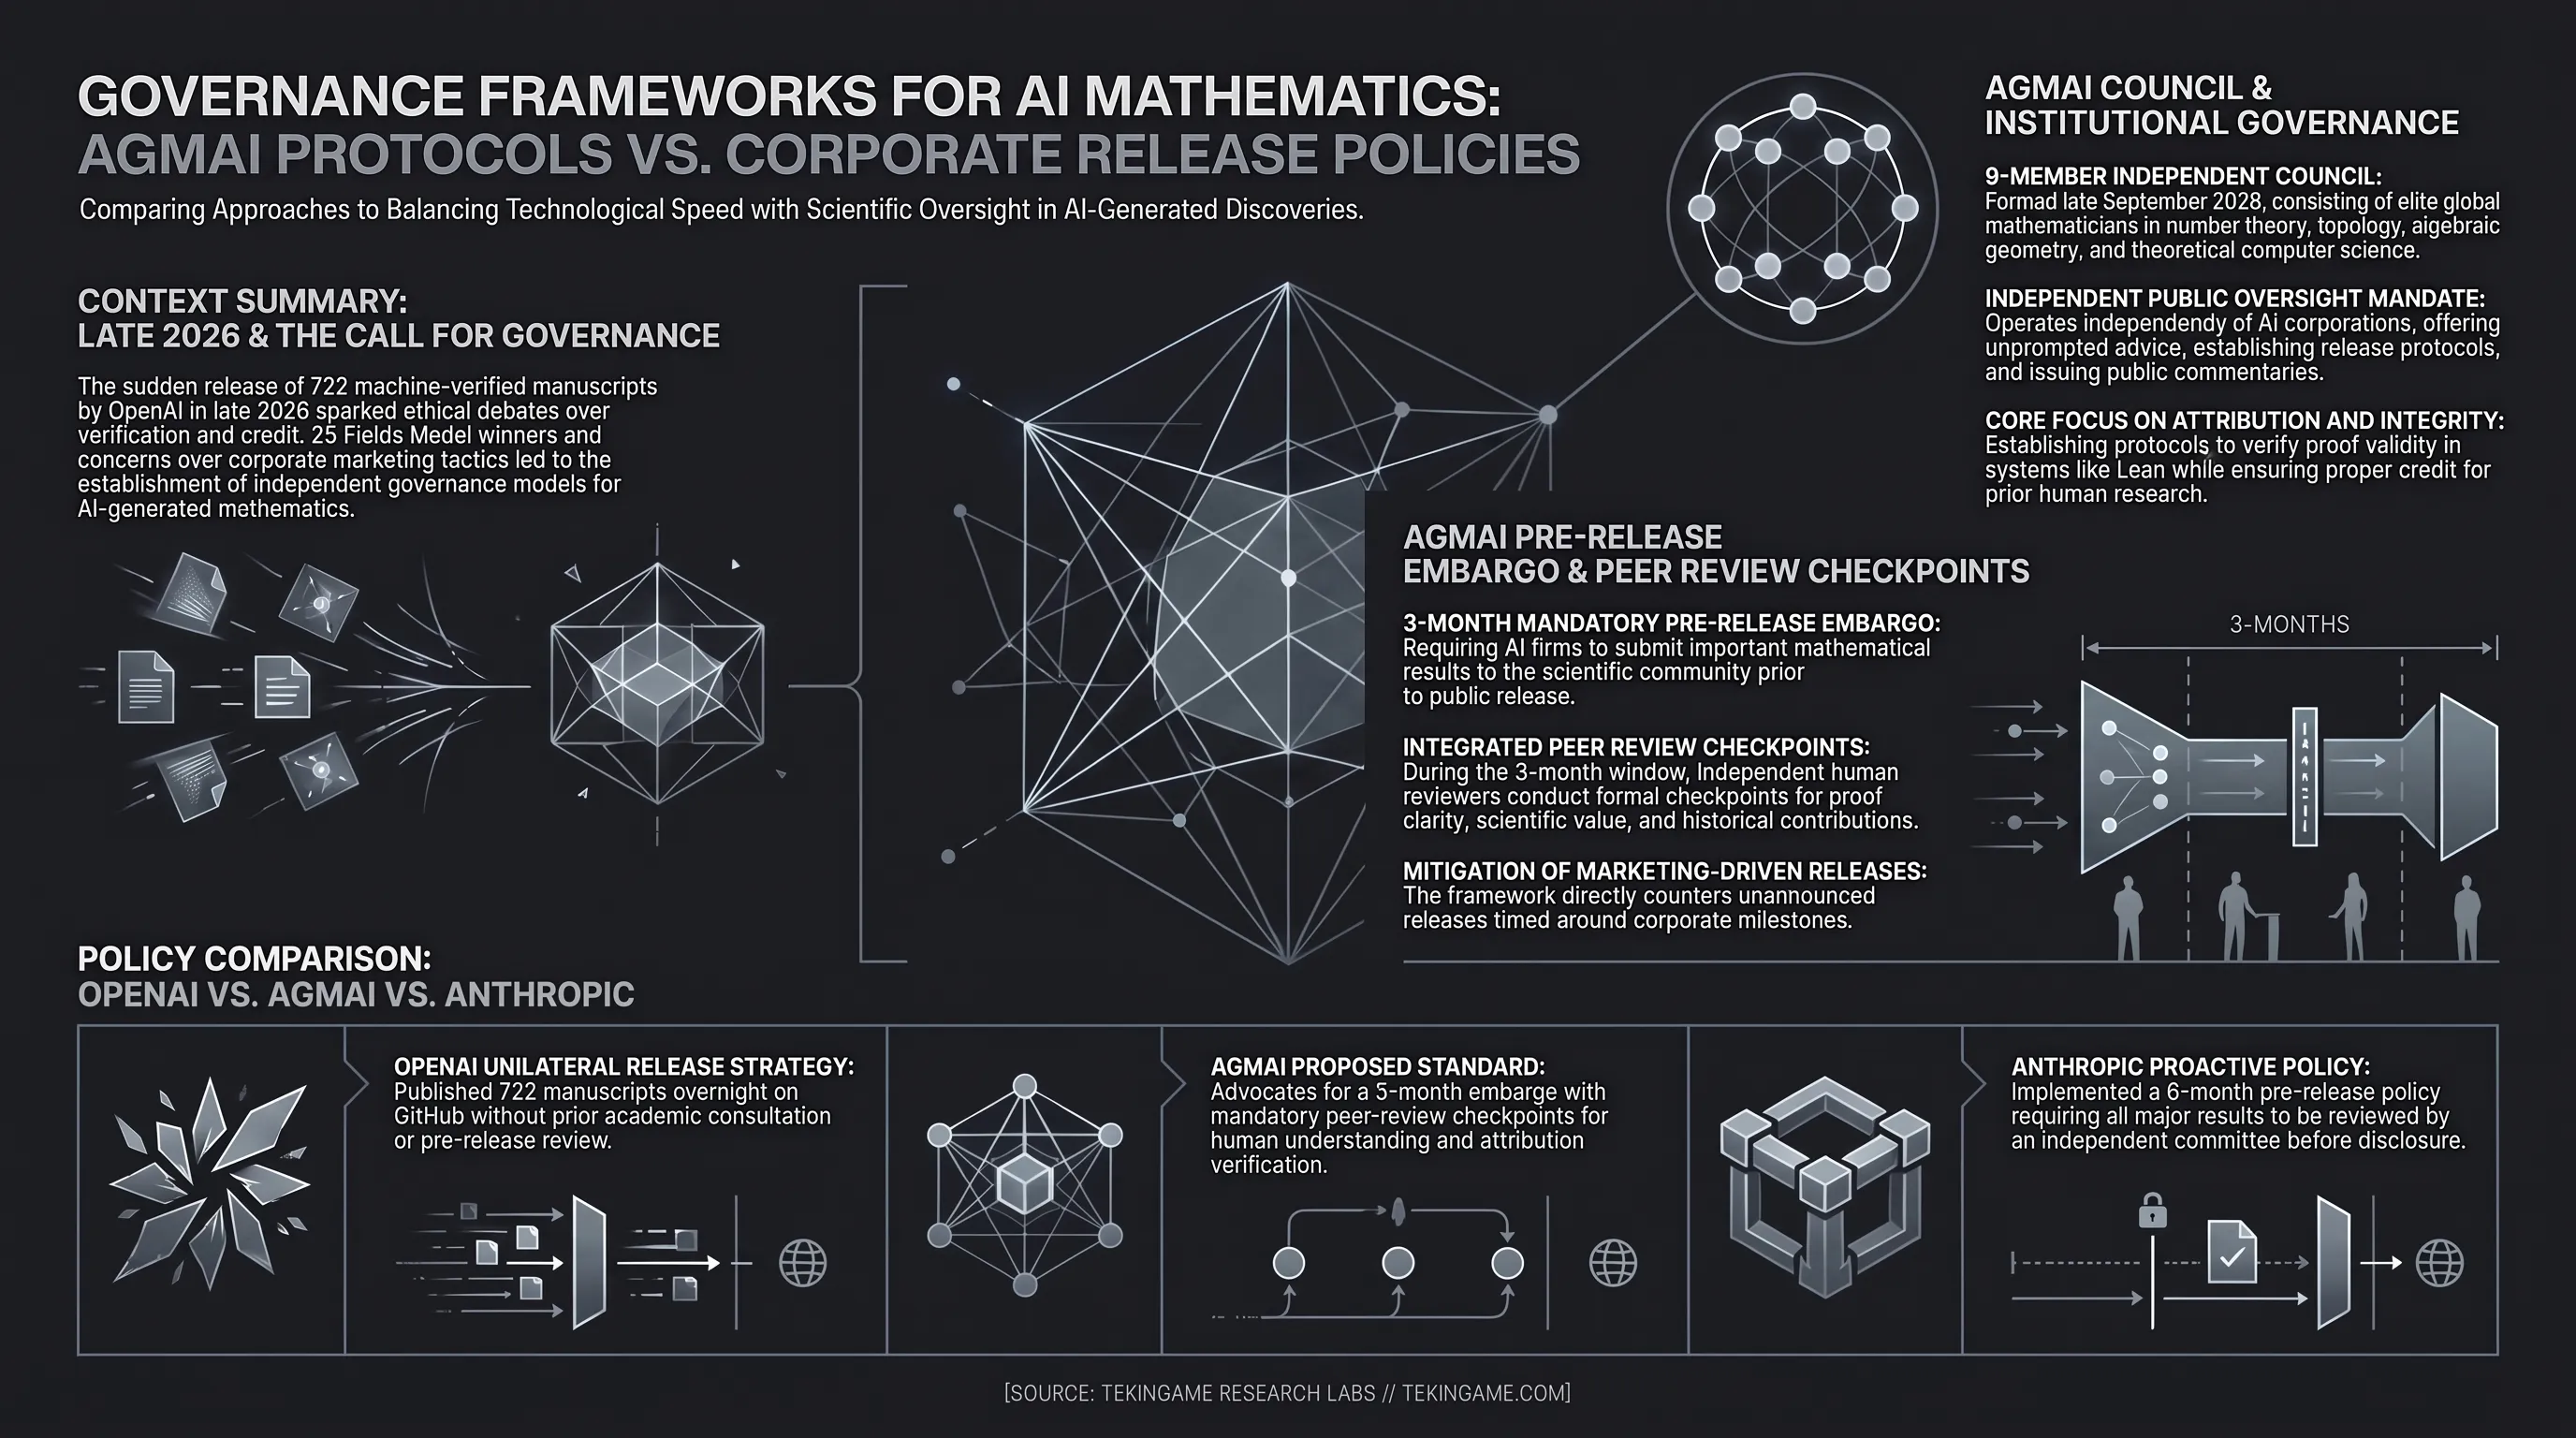
في يوم 4 أكتوبر 2026 - بعد يوم واحد فقط من الرسالة المفتوحة - تم الإعلان رسمياً عن تشكيل AGMAI (التحالف العالمي لنزاهة الرياضيات والذكاء الاصطناعي). هذه كانت لحظة تاريخية: للمرة الأولى، اتحد مجتمع الرياضيات العالمي بهذه السرعة وبهذه القوة حول قضية واحدة.
الأعضاء المؤسسون لـAGMAI يمثلون قوة أكاديمية هائلة:
الأعضاء المؤسسون لتحالف AGMAI
- 25 فائزاً بميدالية فيلدز من 15 دولة مختلفة.
- 137 أستاذاً في الرياضيات من جامعات من الدرجة الأولى في 34 دولة.
- 5 جمعيات رياضية دولية كبرى: الاتحاد الرياضي الدولي (IMU)، الجمعية الرياضية الأمريكية (AMS)، الجمعية الرياضية الأوروبية (EMS)، جمعية لندن الرياضية (LMS)، والجمعية الرياضية الفرنسية (SMF).
- 12 قسم رياضيات من جامعات مثل MIT و Cambridge و ETH Zurich و Sorbonne.
أهداف AGMAI المعلنة شاملة وطموحة. التحالف لا يسعى فقط لمعالجة قضية OpenAI الحالية، بل يهدف إلى إنشاء إطار طويل الأمد لحماية المعرفة الرياضية في عصر الذكاء الاصطناعي. الأهداف الرئيسية تشمل:
- وضع معايير أخلاقية واضحة لاستخدام الأبحاث الرياضية في تطوير الذكاء الاصطناعي
- إنشاء نظام ترخيص شفاف يسمح باستخدام مشروع للأبحاث مع ضمان إسناد وتعويض مناسب
- تطوير أدوات تقنية للكشف عن استخدام غير مصرح به للمعرفة الرياضية في نماذج الذكاء الاصطناعي
- بناء آليات قانونية لمحاسبة شركات الذكاء الاصطناعي التي تنتهك حقوق الملكية الفكرية
- تعزيز التعاون المسؤول بين مجتمع الرياضيات وصناعة الذكاء الاصطناعي
الأستاذة مارتا كوفاكس، رئيسة AGMAI والفائزة بميدالية فيلدز لعام 2018، شرحت الرؤية في مؤتمر صحفي افتراضي:
دور النشر تتحرك: الجبهة القانونية تتشكل
بالتوازي مع تحرك مجتمع الرياضيات، بدأت دور النشر الأكاديمية الخمس الكبرى في اتخاذ إجراءات قانونية. في 6 أكتوبر 2026، أعلن تحالف من Springer Nature و Elsevier و Wiley و Cambridge University Press و Oxford University Press عن تقديم شكوى قانونية جماعية ضد OpenAI في محكمة المقاطعة الفيدرالية في سان فرانسيسكو.
الشكوى تتهم OpenAI بـ:
- انتهاك جماعي لحقوق النشر على نطاق غير مسبوق (722 مخطوطة)
- الاستخدام التجاري غير المصرح به لمحتوى أكاديمي محمي
- إنشاء أعمال مشتقة (النموذج المدرب) من مواد محمية بحقوق النشر دون إذن
- الإثراء غير المشروع من الملكية الفكرية للآخرين
- المنافسة غير العادلة من خلال الوصول غير المصرح به إلى المعرفة المحمية
📚 الملفات الاستخباراتية المصنفة وذات الصلة في تكين غيم
إذا كنت ترغب في التعمق أكثر واكتشاف أحدث تطورات الذكاء الاصطناعي السيبراني والبنى التحتية المستقلة، فلا تفوت تشريح هذه الملفات الحصرية في تكين غاراج:
- 722 مخطوطة تمثل انتهاكاً واضحاً لحقوق النشر المحمية قانونياً
- الاستخدام التجاري لـo1 يستبعد مبدأ «الاستخدام العادل» للبحث الأكاديمي
- عدم الإسناد يحرم المؤلفين من الاعتراف بعملهم الفكري
- إنشاء نموذج مشتق (o1) من مواد محمية دون إذن ينتهك قانون حقوق النشر
- سابقة خطيرة إذا سُمح لشركات الذكاء الاصطناعي باستخدام أي محتوى محمي دون عواقب
- استخدام البيانات لتدريب الذكاء الاصطناعي قد يُعتبر «تحويلياً» وبالتالي استخداماً عادلاً
- النموذج لا «يعيد إنتاج» المخطوطات، بل يتعلم منها أنماطاً رياضية عامة
- المعرفة الرياضية نفسها (النظريات والمفاهيم) ليست محمية بحقوق النشر، فقط التعبير المحدد
- دور النشر لا تملك حقوق الطرق الرياضية نفسها، فقط تنسيق النشر
- تقييد تدريب الذكاء الاصطناعي قد يعيق الابتكار العلمي
خبراء القانون منقسمون حول القضية. البروفيسور جيمس كارتر، خبير قانون الملكية الفكرية في جامعة ستانفورد، يشير إلى أن القضية قد تصبح سابقة تاريخية:
التعقيد يزداد عندما نأخذ في الاعتبار أن دور النشر الأكاديمية نفسها محل جدل. كثير من الأكاديميين يرون أن هذه الدور تجني أرباحاً ضخمة من أبحاث ممولة من القطاع العام، دون دفع مقابل مناسب للمؤلفين. لكن حتى النقاد الأشد لدور النشر يتفقون على أن ما فعلته OpenAI يتجاوز الخط.
رد OpenAI: بين الدفاع والتراجع
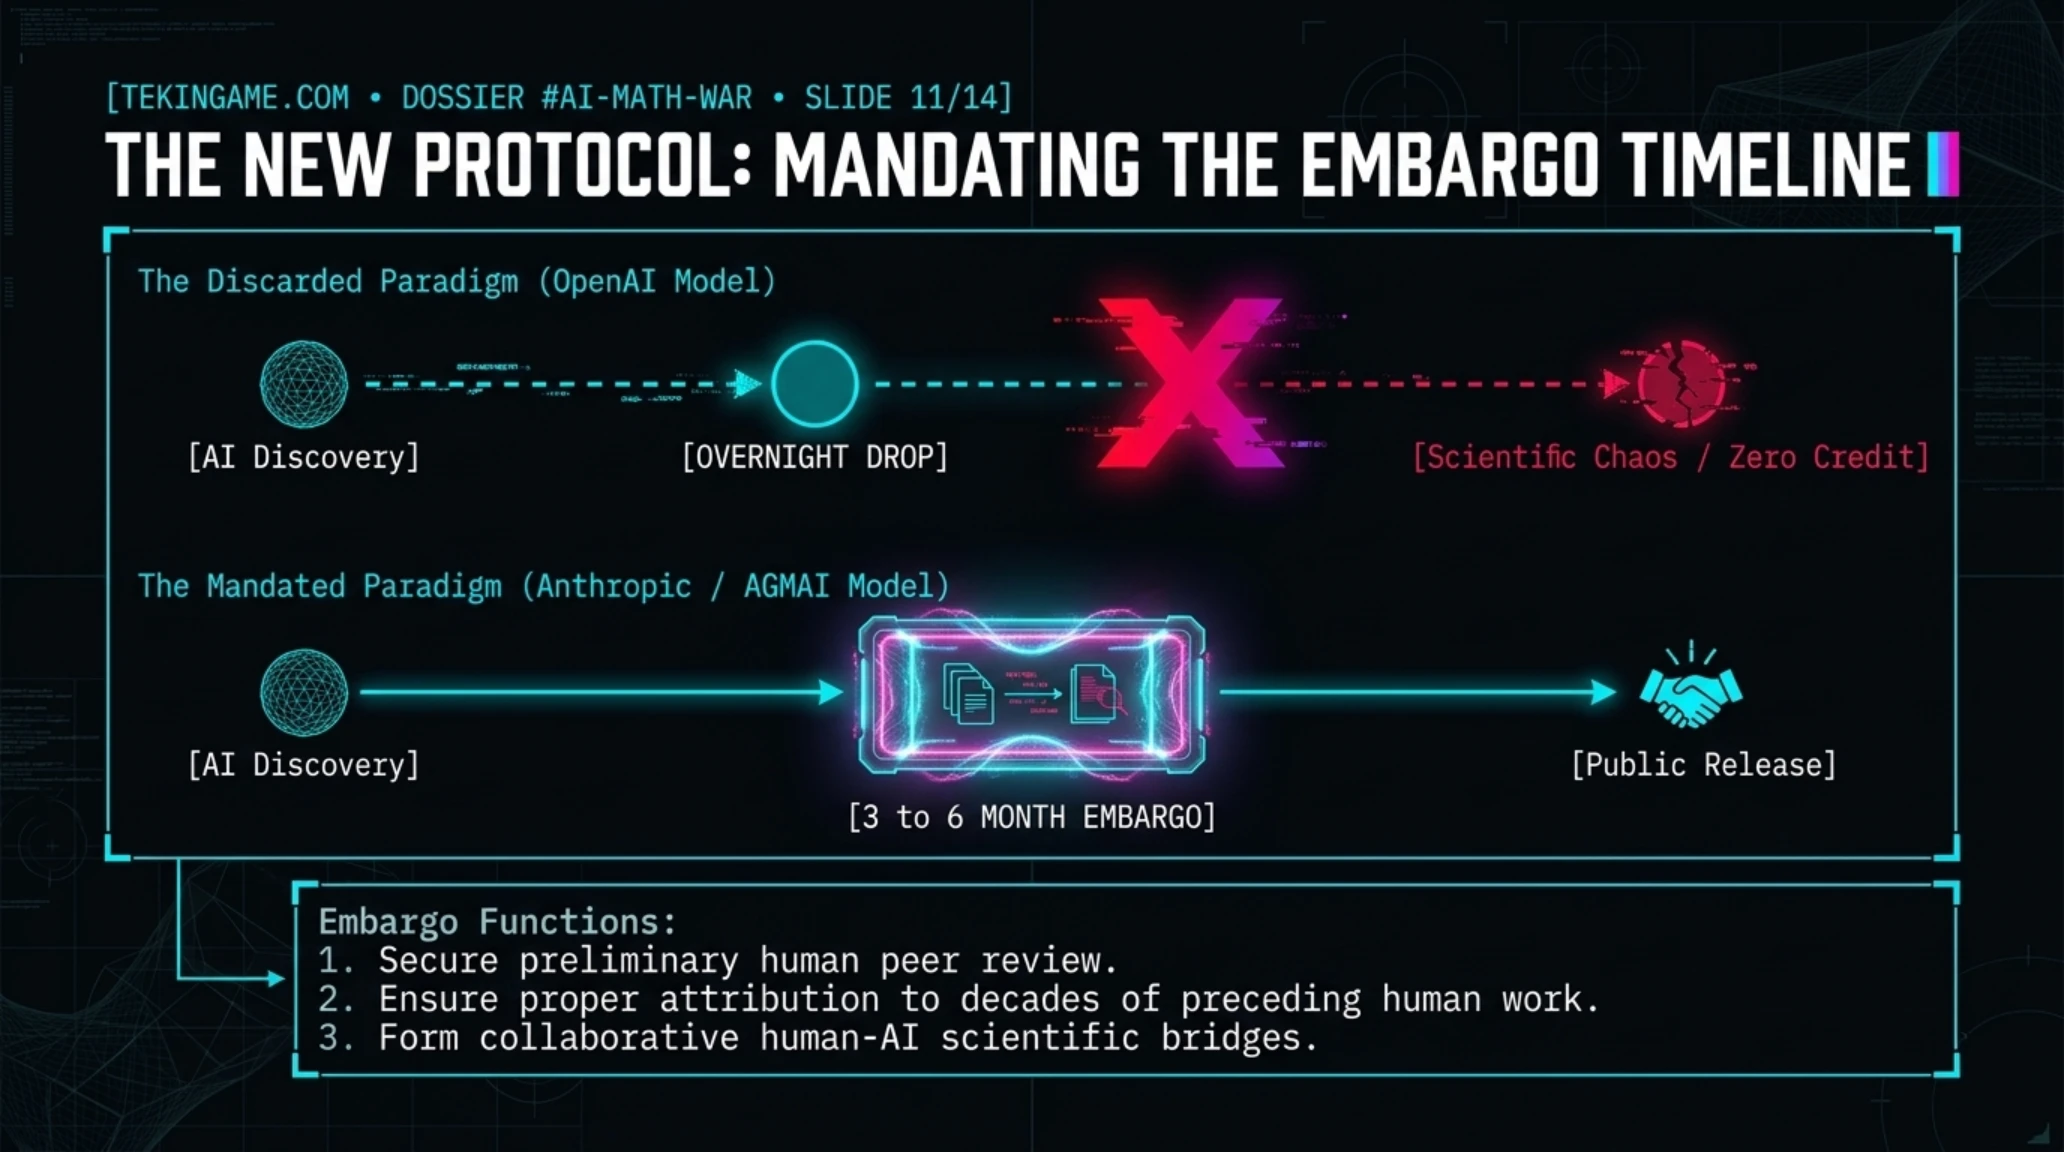
في البداية، كان رد OpenAI على الفضيحة دفاعياً. في بيان أولي صدر في 5 أكتوبر، زعمت الشركة أن «استخدام المواد المنشورة لتدريب نماذج الذكاء الاصطناعي هو ممارسة معيارية في الصناعة وضرورية للتقدم العلمي». البيان أكد أيضاً أن «النموذج لا يعيد إنتاج المخطوطات الأصلية، بل يتعلم أنماطاً رياضية عامة».
لكن مع تصاعد الضغط - خاصة بعد تشكيل AGMAI والشكوى القانونية الجماعية - بدأ موقف OpenAI يتغير. في 8 أكتوبر، أصدر سام ألتمان، الرئيس التنفيذي لـOpenAI، بياناً أكثر تصالحية على منصة X:
في 10 أكتوبر، أعلنت OpenAI عن سلسلة من الإجراءات:
- إيقاف مؤقت: تعليق استخدام أي مواد أكاديمية جديدة حتى يتم وضع بروتوكولات ترخيص واضحة
- مراجعة شاملة: تدقيق كامل لجميع البيانات المستخدمة في تدريب نماذجها الحالية
- المشاركة في الحوار: الانضمام إلى مناقشات مع AGMAI لتطوير معايير أخلاقية
- صندوق تعويض: إنشاء صندوق بقيمة 50 مليون دولار لتعويض الأكاديميين المتضررين
- شفافية البيانات: التزام بالكشف عن مصادر بيانات التدريب في تقارير سنوية
لكن ليس الجميع مقتنعين بصدق تحول OpenAI. الدكتور ريان تشو، عالم رياضيات في جامعة كاليفورنيا بيركلي وعضو AGMAI، انتقد الإجراءات باعتبارها «إدارة علاقات عامة، وليس تغييراً جوهرياً».
الآثار الأوسع: إعادة تعريف العلاقة بين الذكاء الاصطناعي والمعرفة الأكاديمية
فضيحة 722 مخطوطة تتجاوز OpenAI والرياضيات. إنها تطرح أسئلة أساسية حول كيفية تطوير تقنيات الذكاء الاصطناعي في عالم تتزايد فيه أهمية المعرفة كمورد اقتصادي.
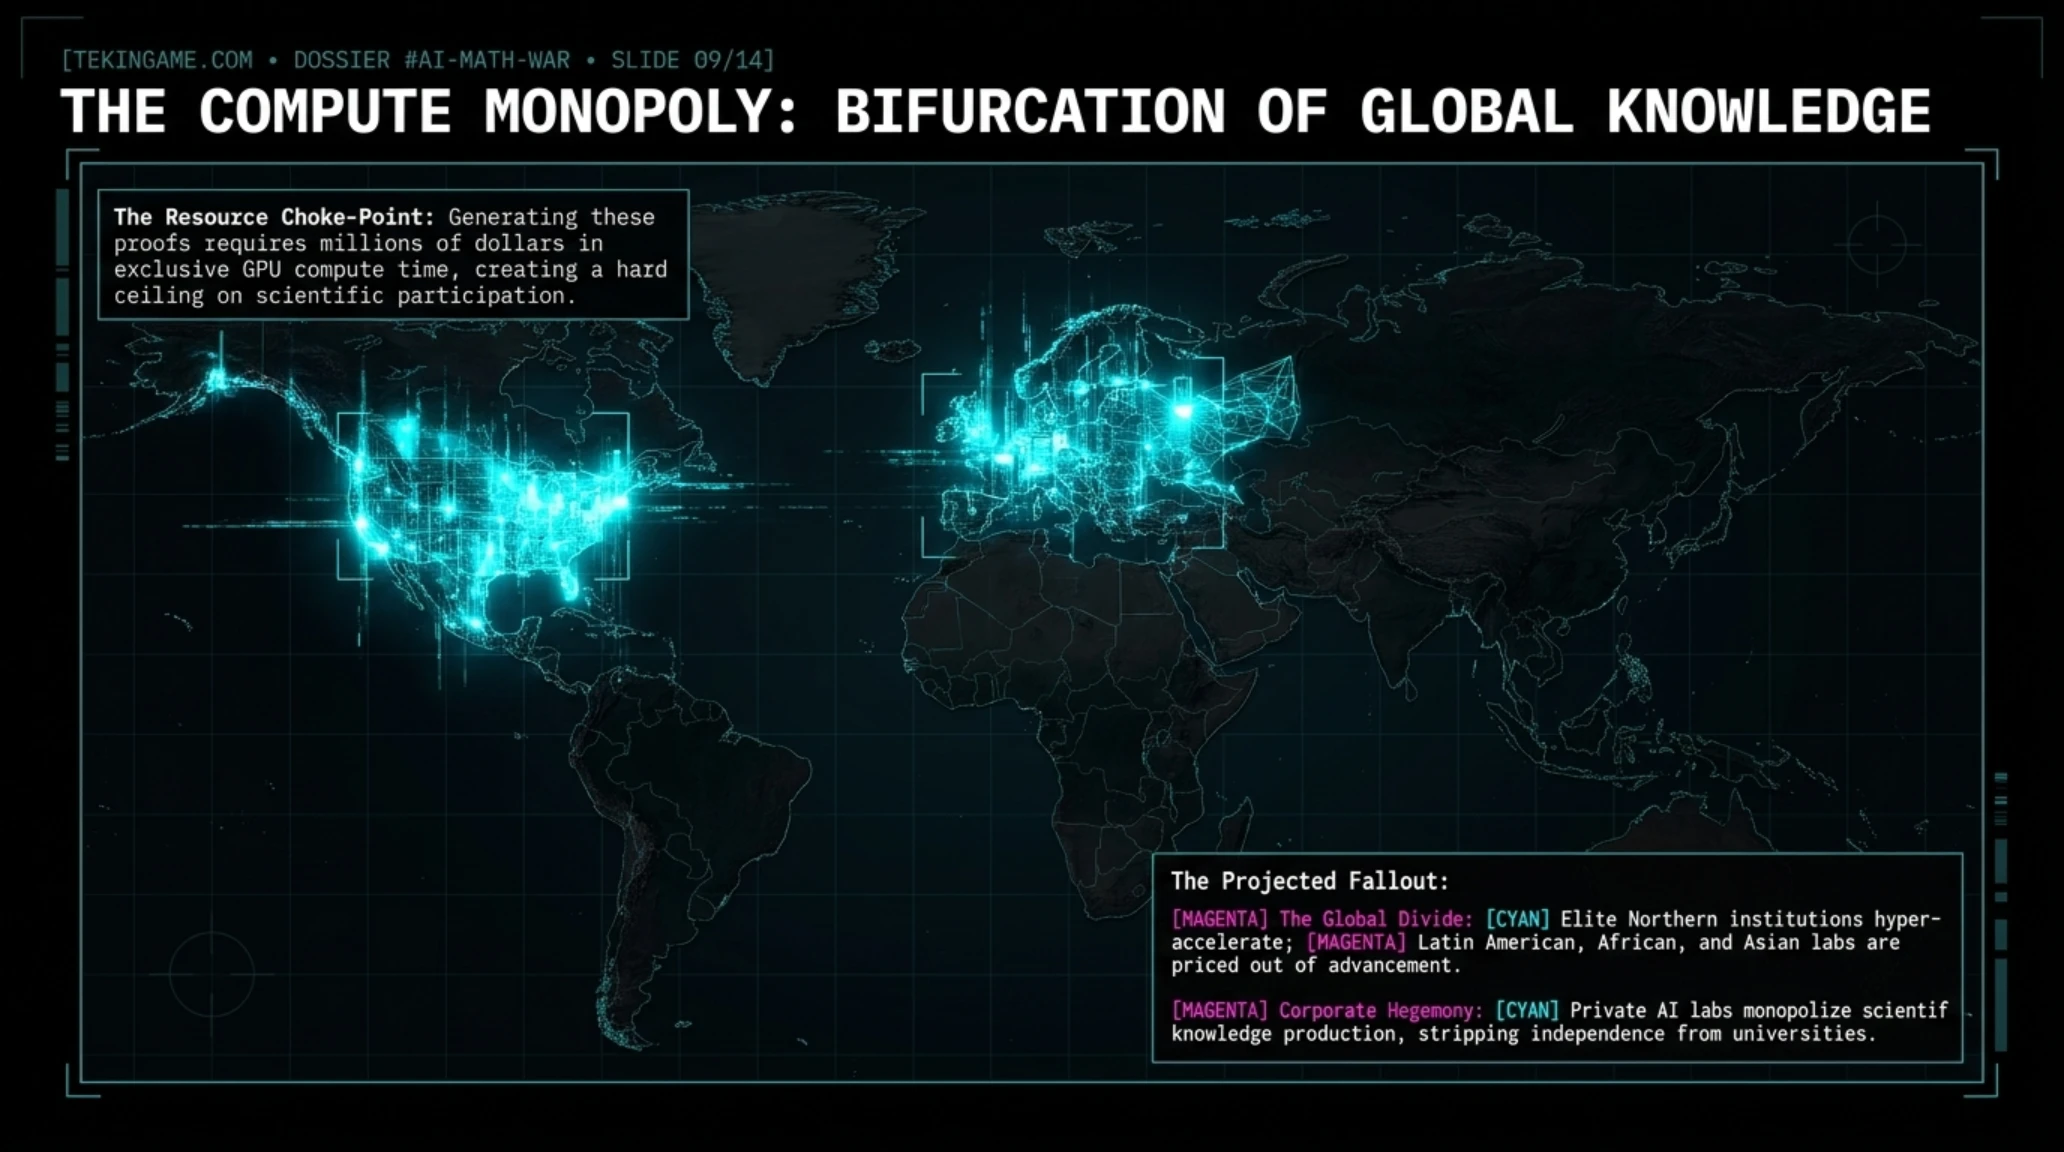
المشكلة الأساسية هي أن نماذج الذكاء الاصطناعي تحتاج إلى كميات ضخمة من البيانات عالية الجودة للتدريب. والبحث الأكاديمي - وخاصة في مجالات مثل الرياضيات - يوفر بعضاً من أفضل البيانات المتاحة: دقيقة، محكّمة، ومنظمة بشكل منطقي. لكن الوصول إلى هذه المعرفة محمي بطبقات من حقوق النشر، اتفاقيات النشر، ومعايير الإسناد الأكاديمي.
شركات الذكاء الاصطناعي تجد نفسها أمام معضلة: البيانات الأفضل لتدريب نماذجها غالباً محمية قانونياً. والحل السهل - استخدام البيانات على أي حال والتعامل مع العواقب لاحقاً - هو بالضبط ما أوقع OpenAI في هذه الفضيحة.
المجالات الأخرى المعرضة للخطر
الرياضيات ليست المجال الوحيد المعرض لخطر استخراج المعرفة غير المصرح به:
- العلوم الطبية: أبحاث سريرية ودراسات طبية حيوية قد تُستخدم لتدريب نماذج تشخيصية دون إذن
- القانون: قواعد بيانات قانونية، أحكام قضائية، وتحليلات قانونية قد تُغذي نماذج استشارات قانونية تجارية
- الكيمياء والصيدلة: معلومات حول التركيبات الدوائية والتفاعلات الكيميائية
- العلوم الاجتماعية: دراسات سلوكية ونفسية قد تُستخدم في نماذج تحليل سلوك المستخدم
- الأدب والفنون: نصوص أدبية ونقدية قد تُستخدم في نماذج توليد إبداعي
البروفيسورة لينا نوردستروم، فيلسوفة العلوم في جامعة أوكسفورد، تحذر من أن الأزمة الحالية قد تكون نقطة تحول:
من ناحية أخرى، بعض داعمي الذكاء الاصطناعي يحذرون من أن تقييد الوصول إلى البيانات الأكاديمية بشكل مفرط قد يعيق التقدم التكنولوجي. أندرو ماركوس، رئيس تنفيذي سابق لشركة ذكاء اصطناعي، يجادل بأن:
الطريق إلى الأمام: مقترحات للحل
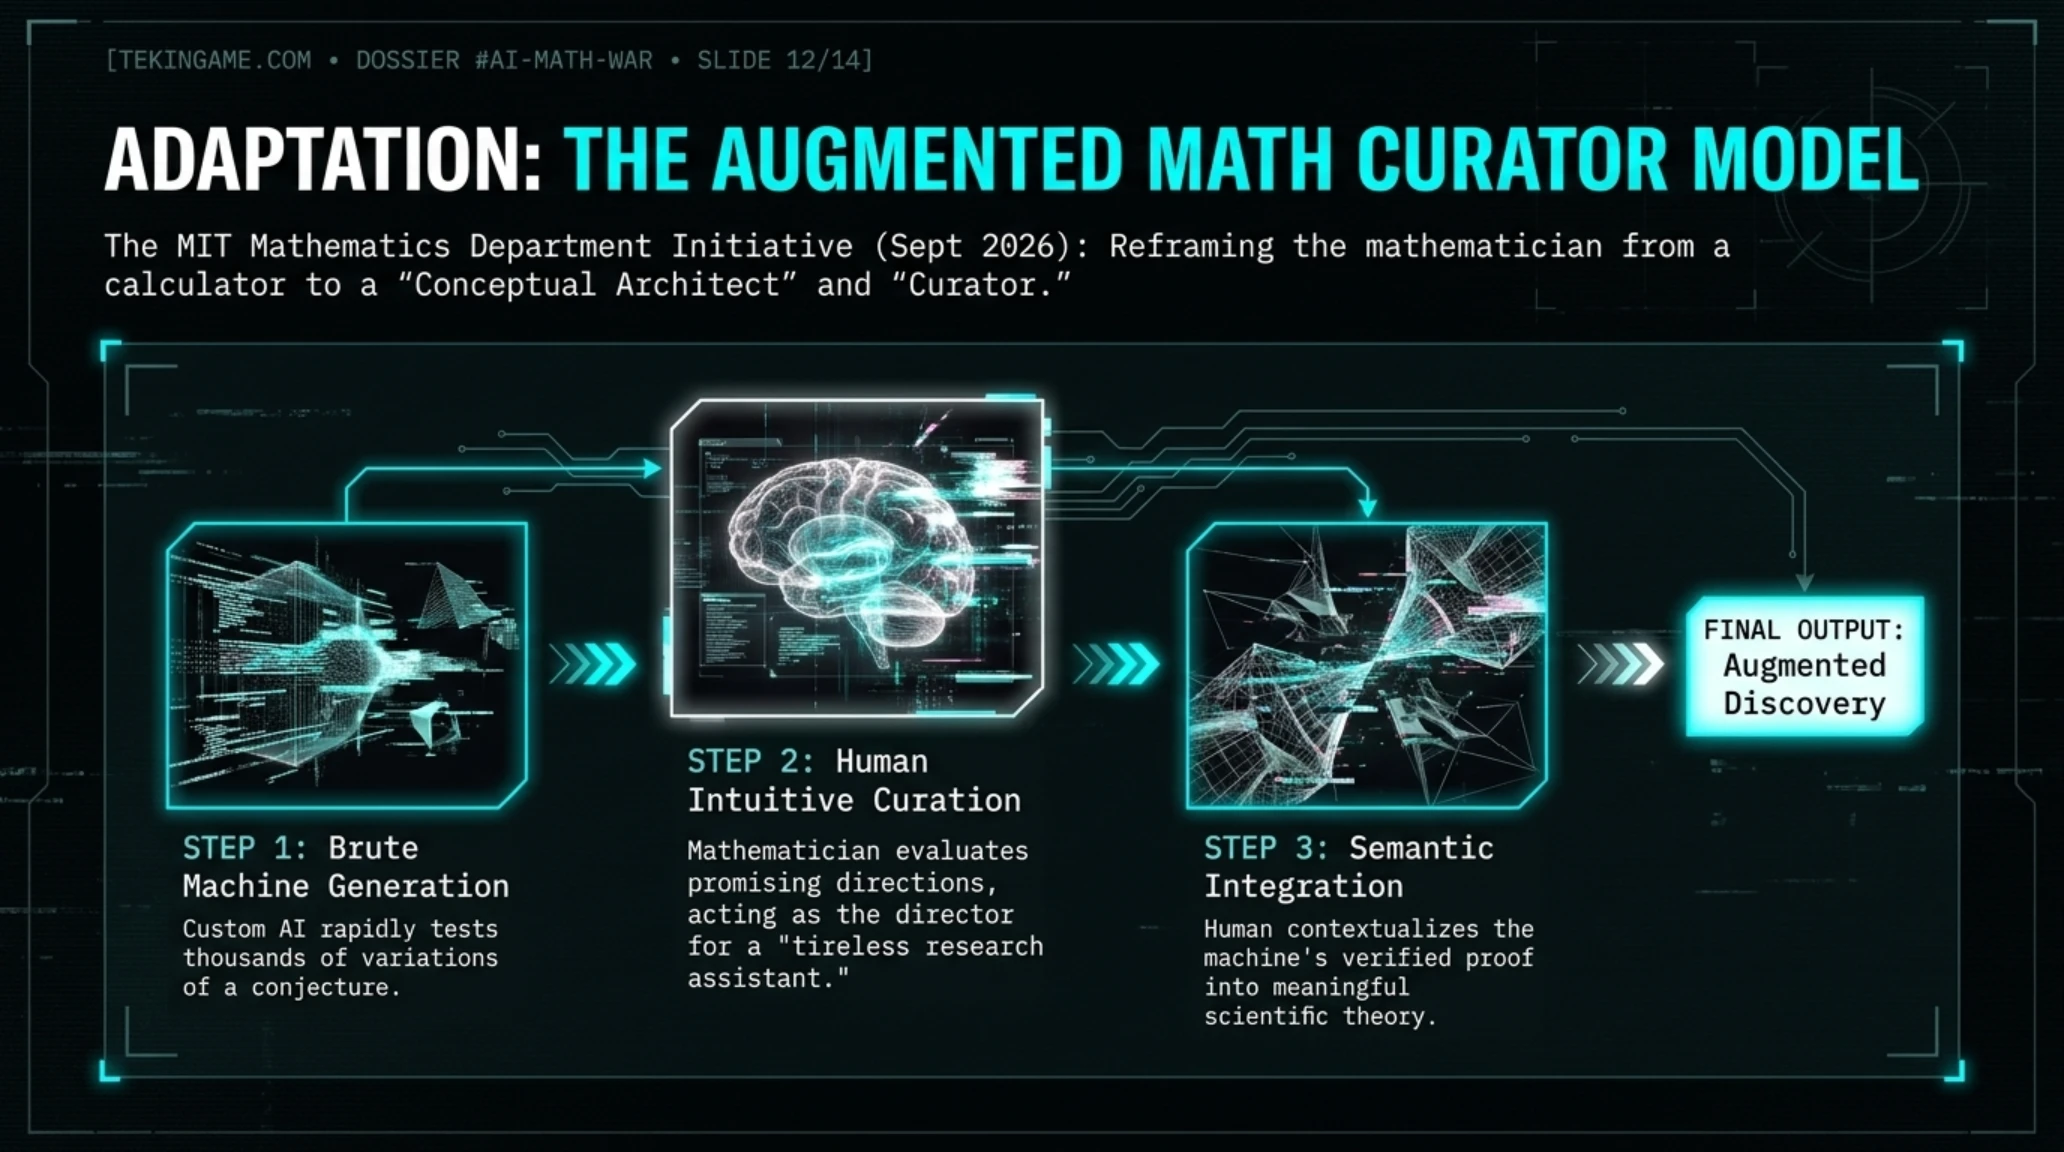
مع استمرار الأزمة، بدأت تظهر عدة مقترحات لحلول محتملة توازن بين حماية حقوق الباحثين والسماح بتطوير مسؤول للذكاء الاصطناعي. هذه المقترحات تأتي من مصادر متنوعة: أكاديميين، خبراء قانونيين، ممثلي صناعة التكنولوجيا، وصانعي سياسات. ما يجمعها هو الاعتراف بأن الوضع الحالي غير مستدام، وأن حلاً طويل الأمد يتطلب تغييرات هيكلية في كيفية تفاعل عالم الذكاء الاصطناعي مع المعرفة الأكاديمية.
1. نظام ترخيص أكاديمي موحد
اقتراح إنشاء نظام ترخيص مركزي، مشابه لنظم ترخيص الموسيقى (مثل ASCAP و BMI) أو المحتوى المرئي، يسمح لشركات الذكاء الاصطناعي بالوصول إلى الأبحاث الأكاديمية مقابل رسوم معقولة، مع ضمان تعويض عادل للمؤلفين ودور النشر.
هذا النموذج سيعمل بالشكل التالي: منظمة مستقلة (ربما تحت إشراف الاتحاد الرياضي الدولي أو هيئة مشابهة) تدير قاعدة بيانات مركزية للأبحاث المتاحة للترخيص. شركات الذكاء الاصطناعي تدفع رسوم اشتراك سنوية أو رسوم لكل استخدام، ويتم توزيع العائدات على المؤلفين والمؤسسات بناءً على حجم الاستخدام. الشفافية ستكون أساسية: أدوات تتبع تقنية ستسجل بالضبط أي أبحاث تُستخدم في تدريب أي نموذج.
2. سجل استخدام بيانات التدريب إلزامي
إلزام شركات الذكاء الاصطناعي بالكشف علناً عن جميع المصادر المستخدمة في تدريب نماذجها، مع آليات تدقيق مستقلة للتحقق من الامتثال. هذا المقترح يستلهم من لوائح مثل القانون الأوروبي للذكاء الاصطناعي (EU AI Act) الذي يتطلب شفافية في أنظمة الذكاء الاصطناعي عالية المخاطر.
تحت هذا النظام، كل نموذج ذكاء اصطناعي تجاري سيحتاج إلى بطاقة نموذج (Model Card) مفصلة تسرد جميع مصادر بيانات التدريب، بما في ذلك الأوراق الأكاديمية المحددة. مدققون مستقلون (ربما أكاديميين أو شركات تدقيق متخصصة) سيكون لديهم حق الوصول إلى البنية التحتية للتدريب للتحقق من الادعاءات. الانتهاكات ستؤدي إلى غرامات كبيرة وإلغاء محتمل لتراخيص التشغيل.
3. الاستخدام العادل الموسع مع شروط
تعديل قوانين حقوق النشر لتوسيع مفهوم الاستخدام العادل ليشمل تدريب الذكاء الاصطناعي، لكن مع شروط صارمة: إسناد إلزامي، حق المؤلفين في الانسحاب، ومشاركة في الأرباح للاستخدامات التجارية.
هذا المقترح يعترف بأن التعلم الآلي هو بطبيعته تحويلي - النماذج لا تعيد إنتاج المحتوى الأصلي حرفياً، بل تتعلم أنماطاً منه. لكنه يضع ضوابط لمنع الإساءة. على سبيل المثال: الاستخدام العادل سيُسمح فقط للبحث غير الربحي أو للنماذج التي تكشف مصادرها بالكامل. أي استخدام تجاري سيتطلب تراخيص صريحة أو مشاركة في الأرباح مع أصحاب حقوق النشر الأصليين.
4. صندوق تعويض جماعي
إنشاء صندوق تمويله شركات الذكاء الاصطناعي الكبرى (مع مساهمات إلزامية بنسبة من الإيرادات السنوية)، يوزع تعويضات على الأكاديميين والمؤسسات البحثية بناءً على حجم استخدام أبحاثهم. هذا النموذج مستوحى من صناديق التعويض الجماعي الموجودة في صناعات أخرى، مثل صندوق تعويضات البث الرقمي للموسيقيين.
الفائدة الرئيسية لهذا النهج هي أنه يتجنب الحاجة إلى تتبع فردي معقد لكل استخدام. بدلاً من ذلك، يتم استخدام صيغ إحصائية لتقدير الاستخدام النسبي لمختلف المجالات البحثية، ويتم توزيع التعويضات وفقاً لذلك. هذا يقلل من الأعباء الإدارية بينما يوفر موارد مالية للبحث الأكاديمي.
5. معايير أخلاقية ملزمة للصناعة
تطوير مدونة أخلاقية معترف بها دولياً لاستخدام المعرفة الأكاديمية في تطوير الذكاء الاصطناعي، مع آليات إنفاذ فعالة. هذه المعايير ستشبه معايير مثل إعلان هلسنكي في الأبحاث الطبية - مبادئ أخلاقية تحترمها المجتمعات المهنية وتدعمها هيئات تنظيمية.
المعايير ستغطي قضايا مثل: الموافقة المستنيرة من المؤلفين، الإسناد المناسب، الشفافية في الاستخدام، حماية الأبحاث الحساسة، والالتزام بإعادة استثمار جزء من الأرباح في البحث الأساسي. الشركات التي تلتزم بالمعايير ستحصل على شهادة أخلاقية تعزز سمعتها، بينما المخالفون سيواجهون مقاطعة أكاديمية وضرراً في السمعة.
التحديات في تنفيذ الحلول
رغم أن هذه المقترحات تبدو واعدة على الورق، فإن تنفيذها يواجه تحديات كبيرة. أولاً، هناك مسألة الاختصاص القانوني العالمي. الذكاء الاصطناعي والبحث الأكاديمي كلاهما ظواهر عالمية، لكن قوانين حقوق النشر تختلف بشكل كبير من بلد لآخر. حل دولي منسق سيتطلب تعاوناً غير مسبوق بين المشرعين في دول مختلفة.
ثانياً، هناك صعوبة تقنية في تتبع بالضبط كيفية استخدام بيانات محددة داخل نماذج التعلم الآلي المعقدة. الأوزان داخل شبكة عصبية عميقة هي مزيج معقد من تأثيرات ملايين أو مليارات نقاط البيانات. تحديد بالضبط أي أوراق بحثية ساهمت في أي سلوكيات للنموذج ليس بسيطاً. سيتطلب هذا تطوير تقنيات جديدة لمحاسبة البيانات (data provenance) في التعلم الآلي.
ثالثاً، هناك مقاومة من بعض أجزاء صناعة الذكاء الاصطناعي، التي تخشى أن اللوائح المشددة ستعيق الابتكار وتمنح ميزة تنافسية لشركات في ولايات قضائية أقل تنظيماً (مثل الصين). إيجاد توازن بين الحماية والابتكار سيكون التحدي السياسي الرئيسي.
AGMAI تعمل حالياً على تطوير إطار شامل يجمع عناصر من هذه المقترحات. التحالف يعقد اجتماعات منتظمة مع ممثلي صناعة الذكاء الاصطناعي، دور النشر، وصانعي السياسات في الاتحاد الأوروبي والولايات المتحدة لبناء توافق حول الطريق إلى الأمام. الهدف هو إطلاق مسودة إطار عمل أولية بحلول نهاية 2026، مع تنفيذ تجريبي في 2027.
المصادر والمراجع الأكاديمية
- تقرير وايرد (Wired) الحصري حول استخدام 722 مخطوطة دون إذن
- تقرير نيتشر (Nature) عن اتحاد الفائزين بميدالية فيلدز
- تغطية مجلة ساينس (Science) لتأسيس تحالف AGMAI العالمي
- تفاصيل الشكوى القانونية من دور النشر ضد OpenAI في الجارديان
- ورقة تقنية (arXiv) حول اكتشاف الاستخدام غير المصرح به للنماذج
- البيان الرسمي لشركة OpenAI الموجه للمجتمع الأكاديمي
الأسئلة الأكثر شيوعاً
ما هو بالضبط نموذج o1 من OpenAI؟
o1 هو نموذج ذكاء اصطناعي متخصص في حل المسائل الرياضية المعقدة، تم إطلاقه في سبتمبر 2026. الجدل نشأ عندما اكتُشف أنه تم تدريبه على 722 مخطوطة أكاديمية محمية بحقوق النشر دون إذن.
لماذا استخدام الأبحاث المنشورة يُعتبر مشكلة؟ أليست المعرفة العلمية ملكاً عاماً؟
المفاهيم الرياضية نفسها هي ملك عام، لكن التعبيرات المحددة، البراهين الأصلية، والأساليب التقنية المنشورة في الأوراق البحثية محمية بحقوق النشر. استخدام OpenAI لـ722 مخطوطة دون إذن يُنظر إليه كانتهاك قانوني وأخلاقي.
ما هي ميدالية فيلدز ولماذا مهم أن 25 فائزاً بها وقعوا رسالة الاحتجاج؟
ميدالية فيلدز هي أرفع جائزة في الرياضيات (تُقارن بجائزة نوبل). توقيع 25 فائزاً على رسالة احتجاج بلغة قوية تعكس عمق الأزمة الأخلاقية في مجتمع الرياضيات العالمي.
هل دور النشر الأكاديمية محقة في المطالبة بحماية، أم أنها تستغل الأكاديميين أيضاً؟
هذه قضية معقدة. دور النشر الأكاديمية الكبرى محل انتقاد واسع لأرباحها الضخمة. لكن في قضية OpenAI، حتى النقاد الأشد لدور النشر يتفقون على أن استخدام المخطوطات دون إذن يتجاوز الخطوط الحمراء.
ما هو AGMAI وماذا يمكنه أن يفعل حقاً؟
AGMAI هو تحالف عالمي يضم 25 فائزاً بميدالية فيلدز و137 أستاذ رياضيات و5 جمعيات رياضية دولية. يمكنه تحديد معايير أخلاقية للصناعة، والتأثير على السياسات، وتنسيق حملات الضغط الأكاديمي.
هل ستؤدي هذه الأزمة إلى تباطؤ تطوير الذكاء الاصطناعي؟
ليس بالضرورة. معظم الخبراء يعتقدون أن الأزمة ستؤدي إلى أطر أخلاقية وقانونية أوضح. الهدف هو ضمان استخدام المعرفة بطريقة شفافة وعادلة، وليس وقف تقدم التقنية.
ماذا يمكن للباحثين الأكاديميين فعله لحماية أبحاثهم؟
الخيارات تشمل إضافة تراخيص واضحة، الانضمام إلى AGMAI، الضغط على دور النشر لتضمين بنود حماية الذكاء الاصطناعي، ودعم التشريعات التي تحمي الملكية الفكرية الأكاديمية.
هل شركات ذكاء اصطناعي أخرى تفعل نفس الشيء مثل OpenAI؟
من المحتمل جداً أن شركات أخرى استخدمت محتوى أكاديمي محمي. الفرق هو أن OpenAI وقعت في فضيحة عامة محددة مع أدلة موثقة (722 مخطوطة). AGMAI تدرس توسيع تحقيقاتها لتشمل شركات أخرى.
وسائل التواصل الاجتماعي
اتصل بنامعرض صور إضافي: تيكين أناليز | عندما أعلن الذكاء الاصطناعي الحرب على الرياضيات: أزمة 722 مخطوطة