تكين للمقارنة | التدقيق الهندسي الشامل لنتائج بنشمارك أندرويد
الصدمة الكبرى في هندسة البرمجيات المحمولة: سقوط غوغل المدو في معقلها التاريخي
في قطاع التكنولوجيا المتقدمة، نادراً ما يشهد العالم صدمة هندسية تعادل رؤية عملاق تقني مهيمن يُمنى بهزيمة ساحقة داخل معقله البرمجي المحصن. في شهر أكتوبر 2026، عاش مجتمع مهندسي البرمجيات عبر العالم لحظة تاريخية فارقة بكل المقاييس. فقد كشف فريق هندسة نظام التشغيل أندرويد التابع لشركة غوغل عن التحديث الرسمي للوحة تصنيف بنشمارك Android Bench—وهو المعيار القياسي المتخصص المصمم خصيصاً لاختبار قدرات نماذج الذكاء الاصطناعي التوليدية على كتابة وتصحيح وبناء الشيفرات المصدرية لتطبيقات أندرويد المعقدة. ولكن ما كان يُفترض أن يكون استعراضاً مبهراً لسيادة نموذج الاستدلال الرائد Gemini 4 Argon التابع لمختبرات Google DeepMind، تحول بصورة مباغتة إلى هزيمة علنية مدوية هزت أركان عملاق البحث العالمي.
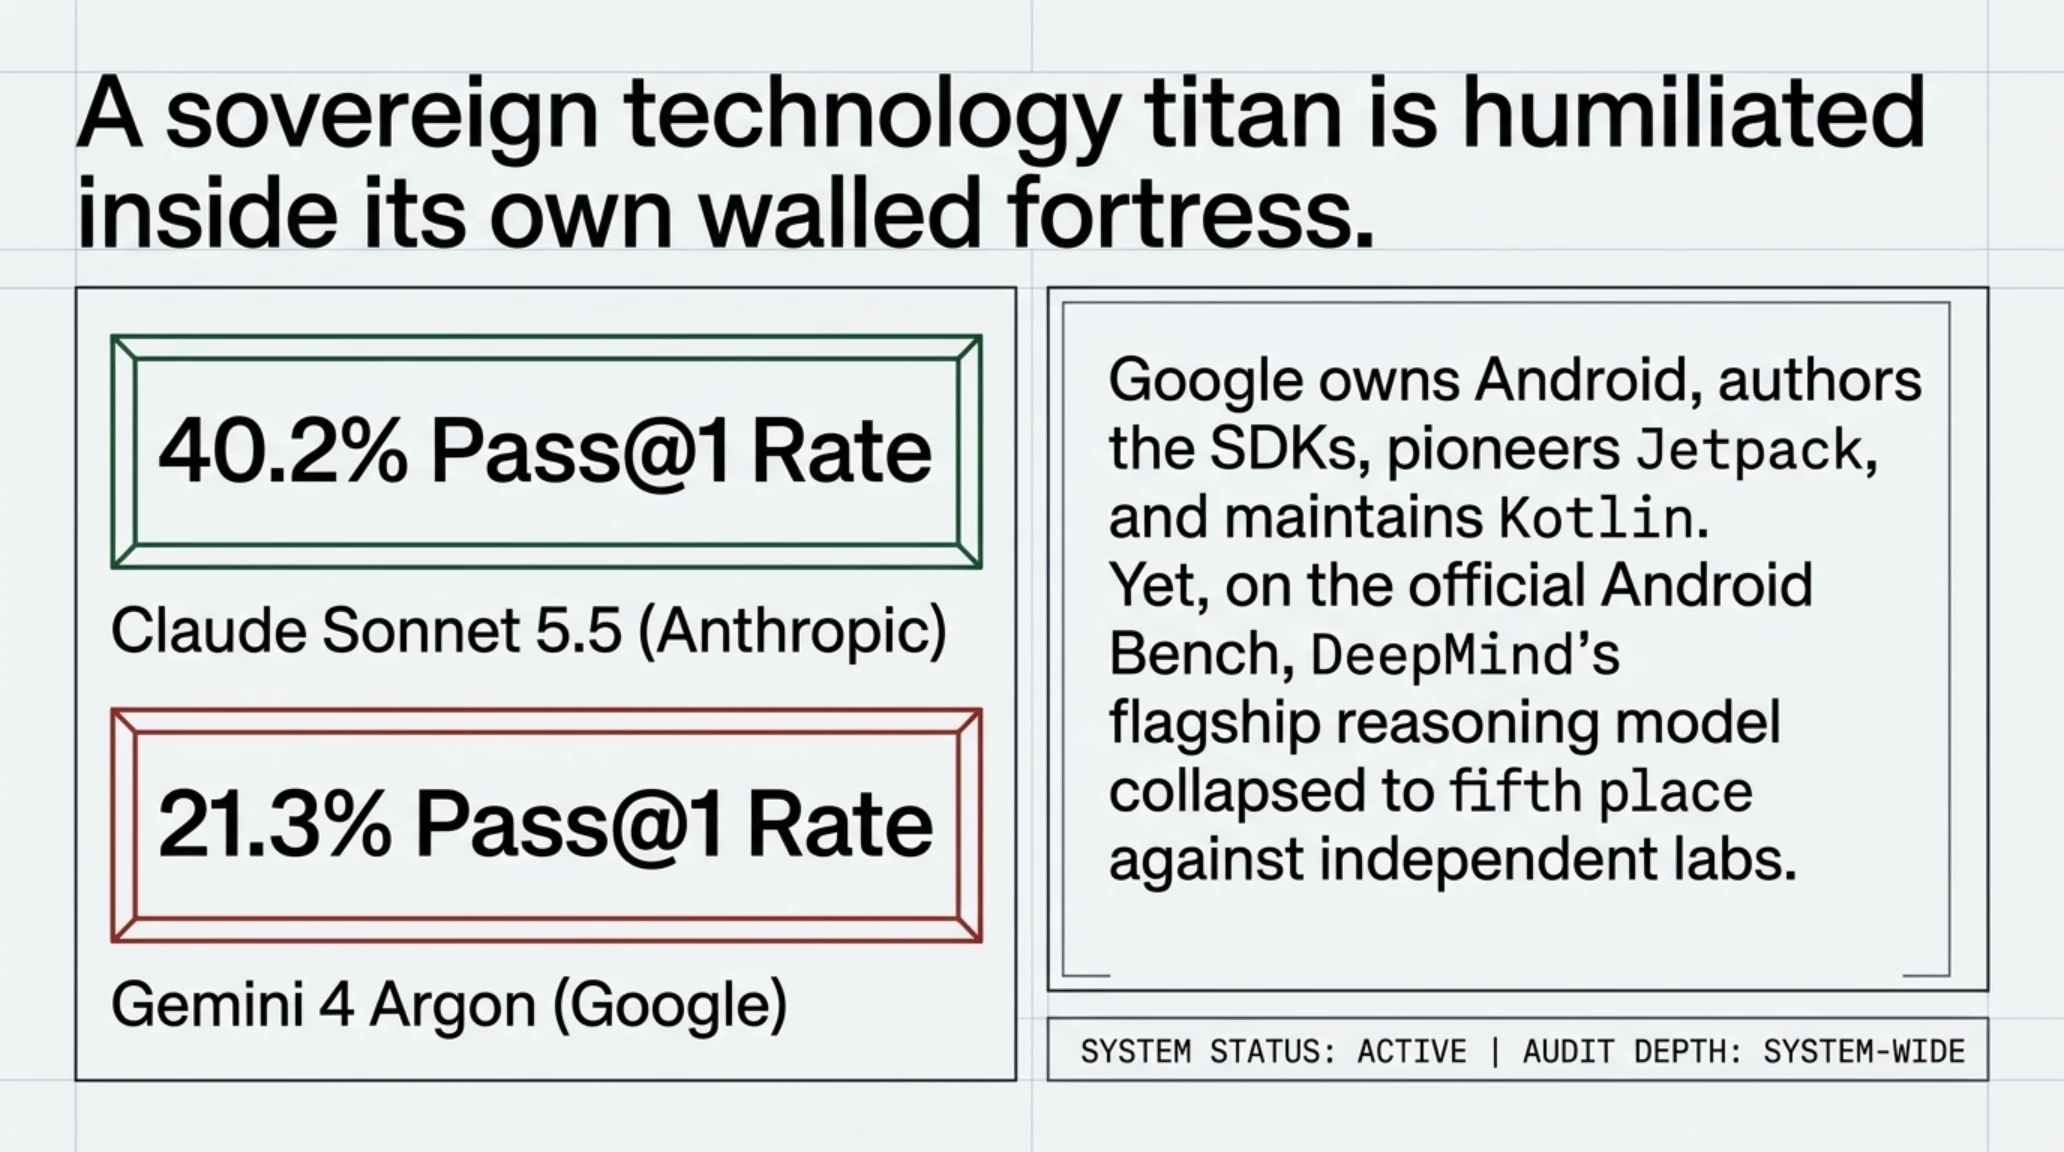
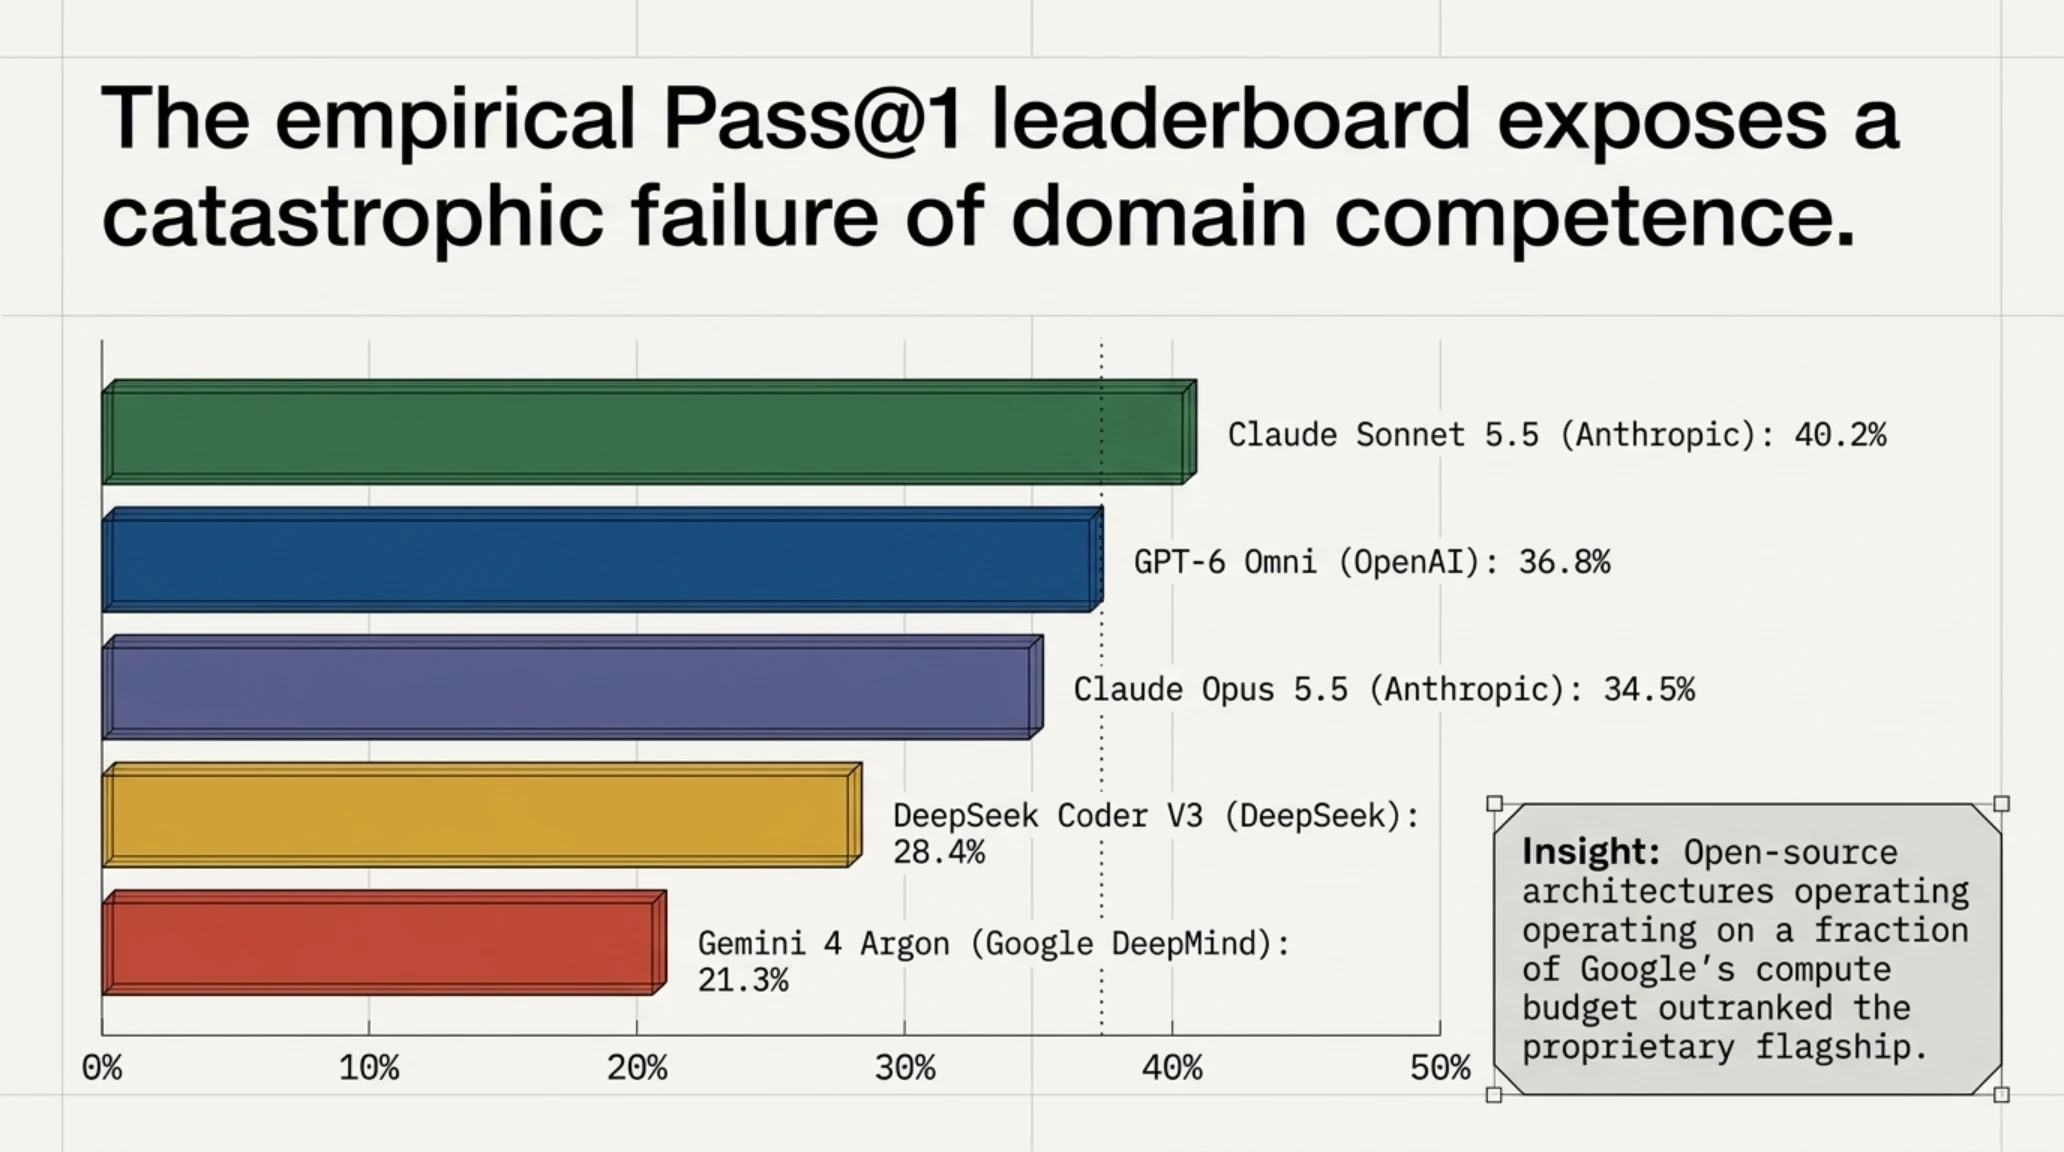
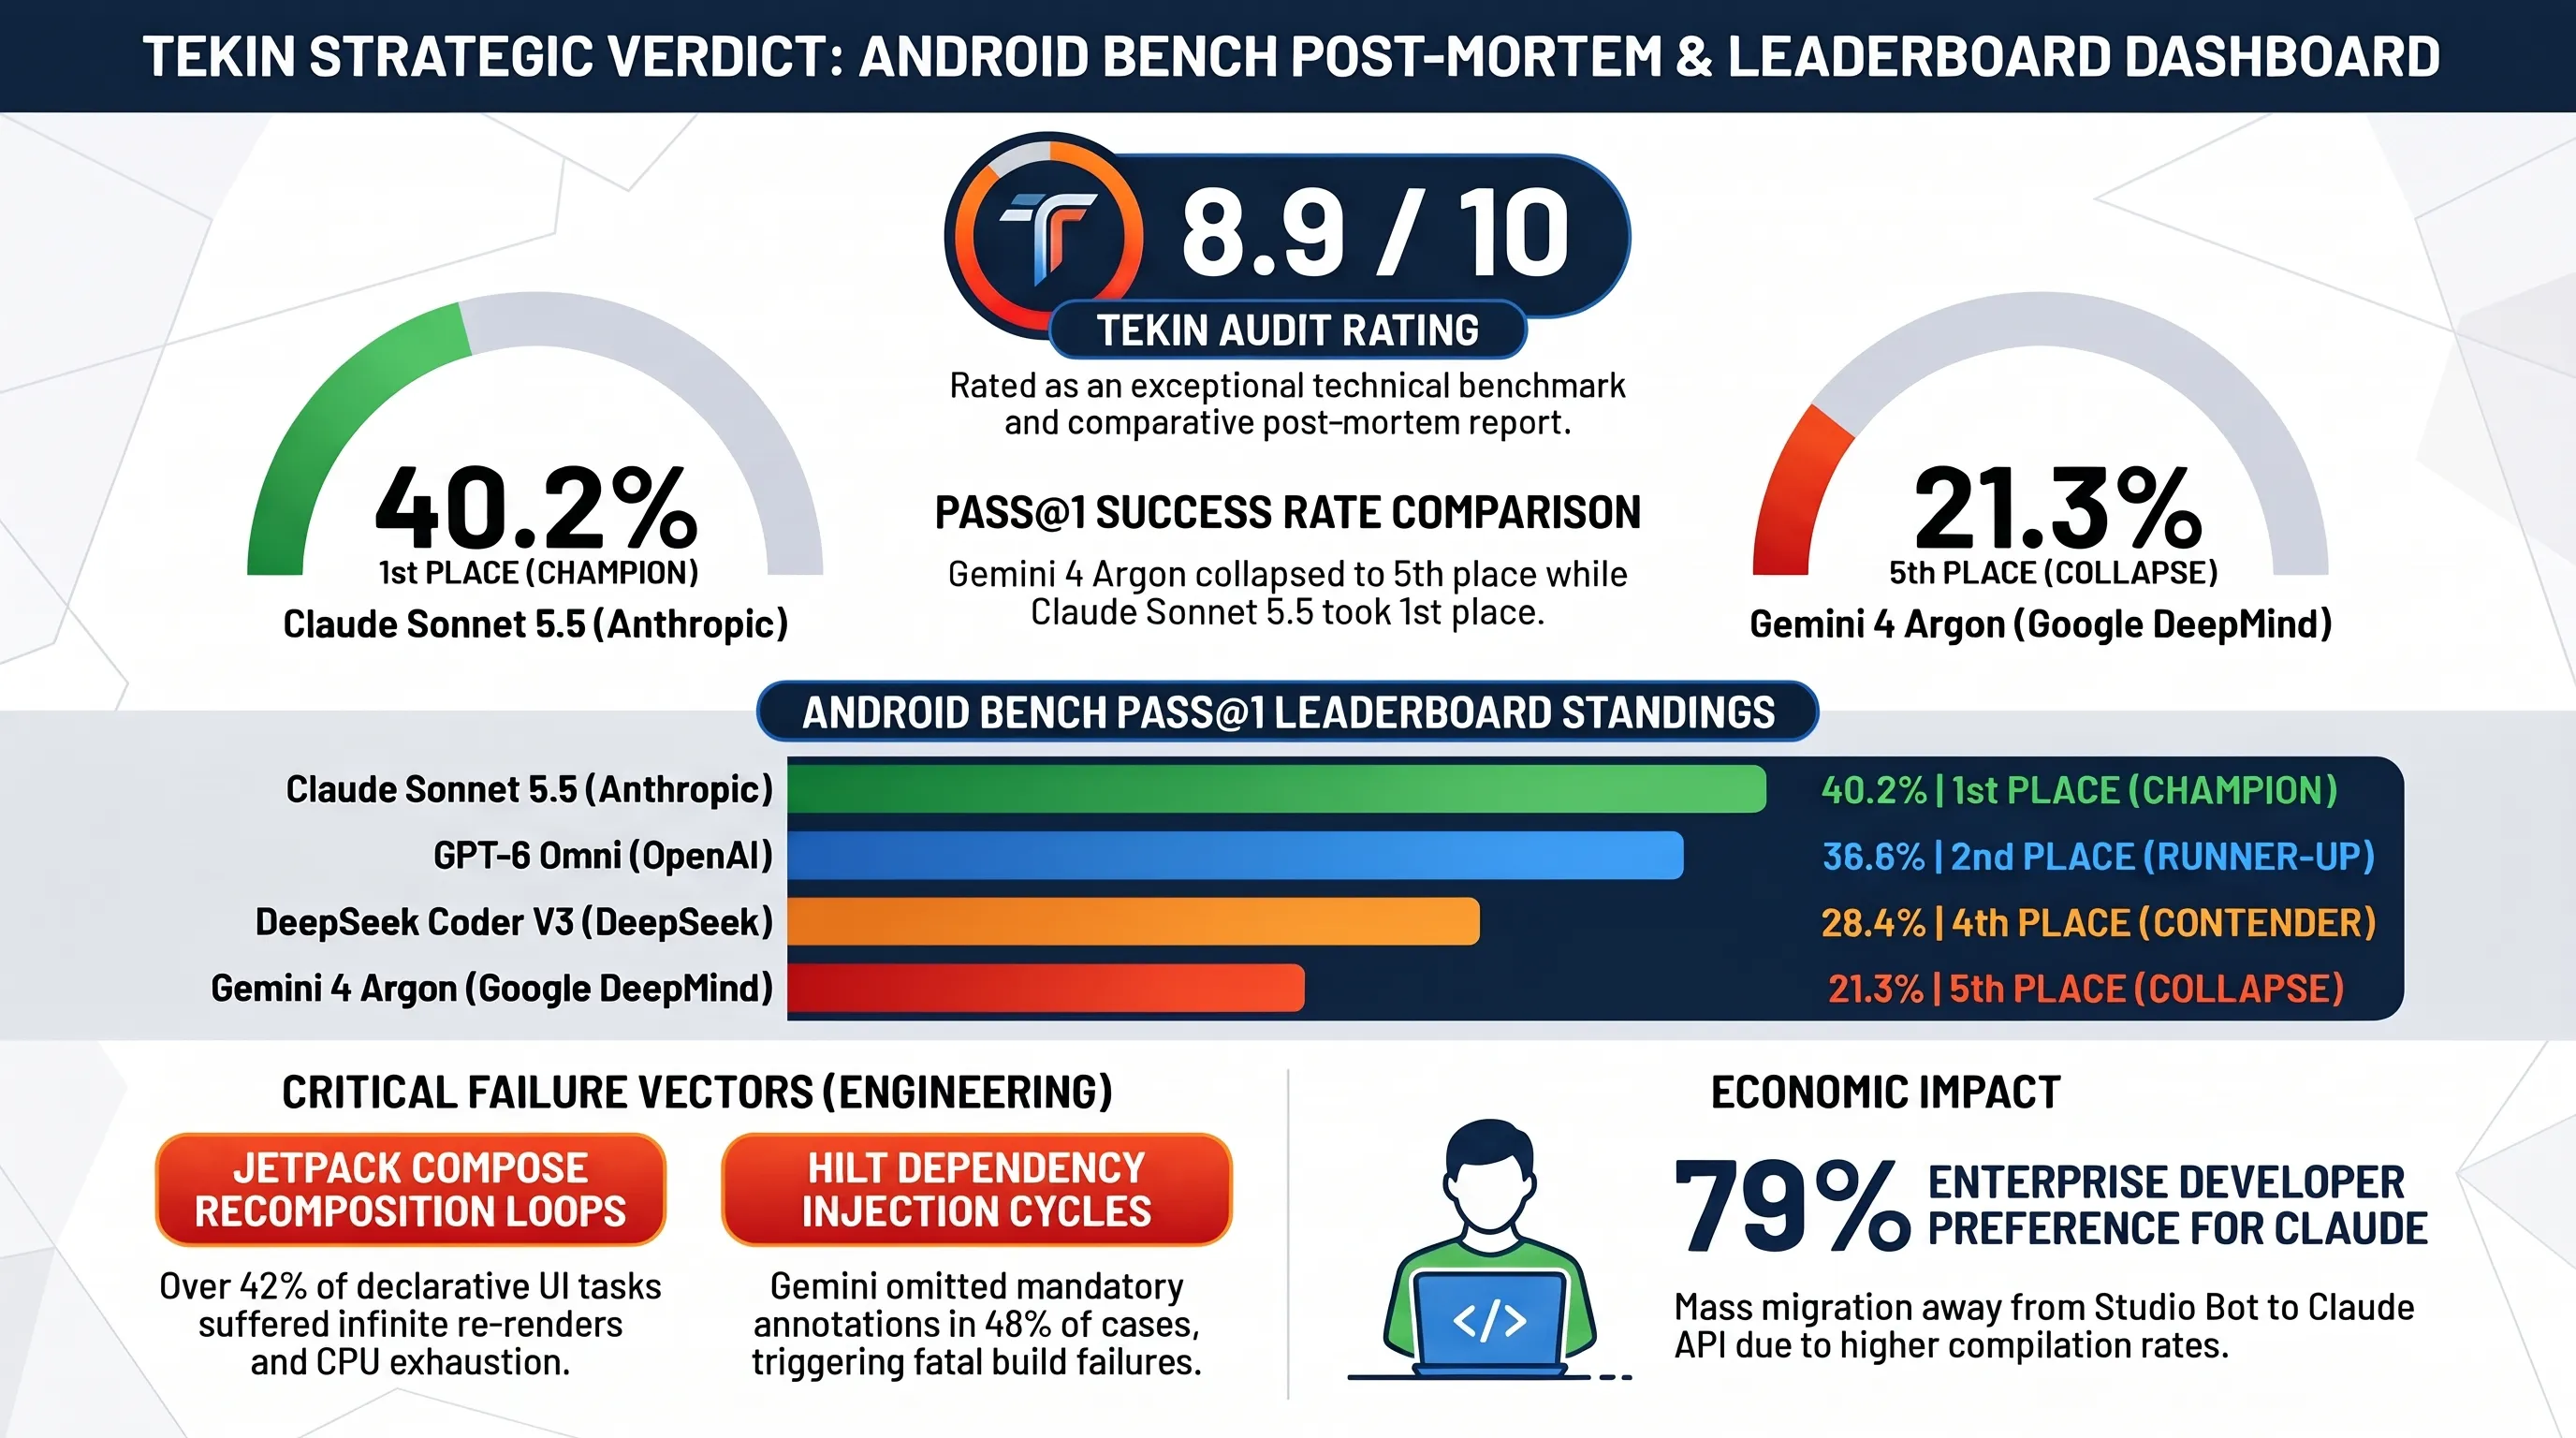
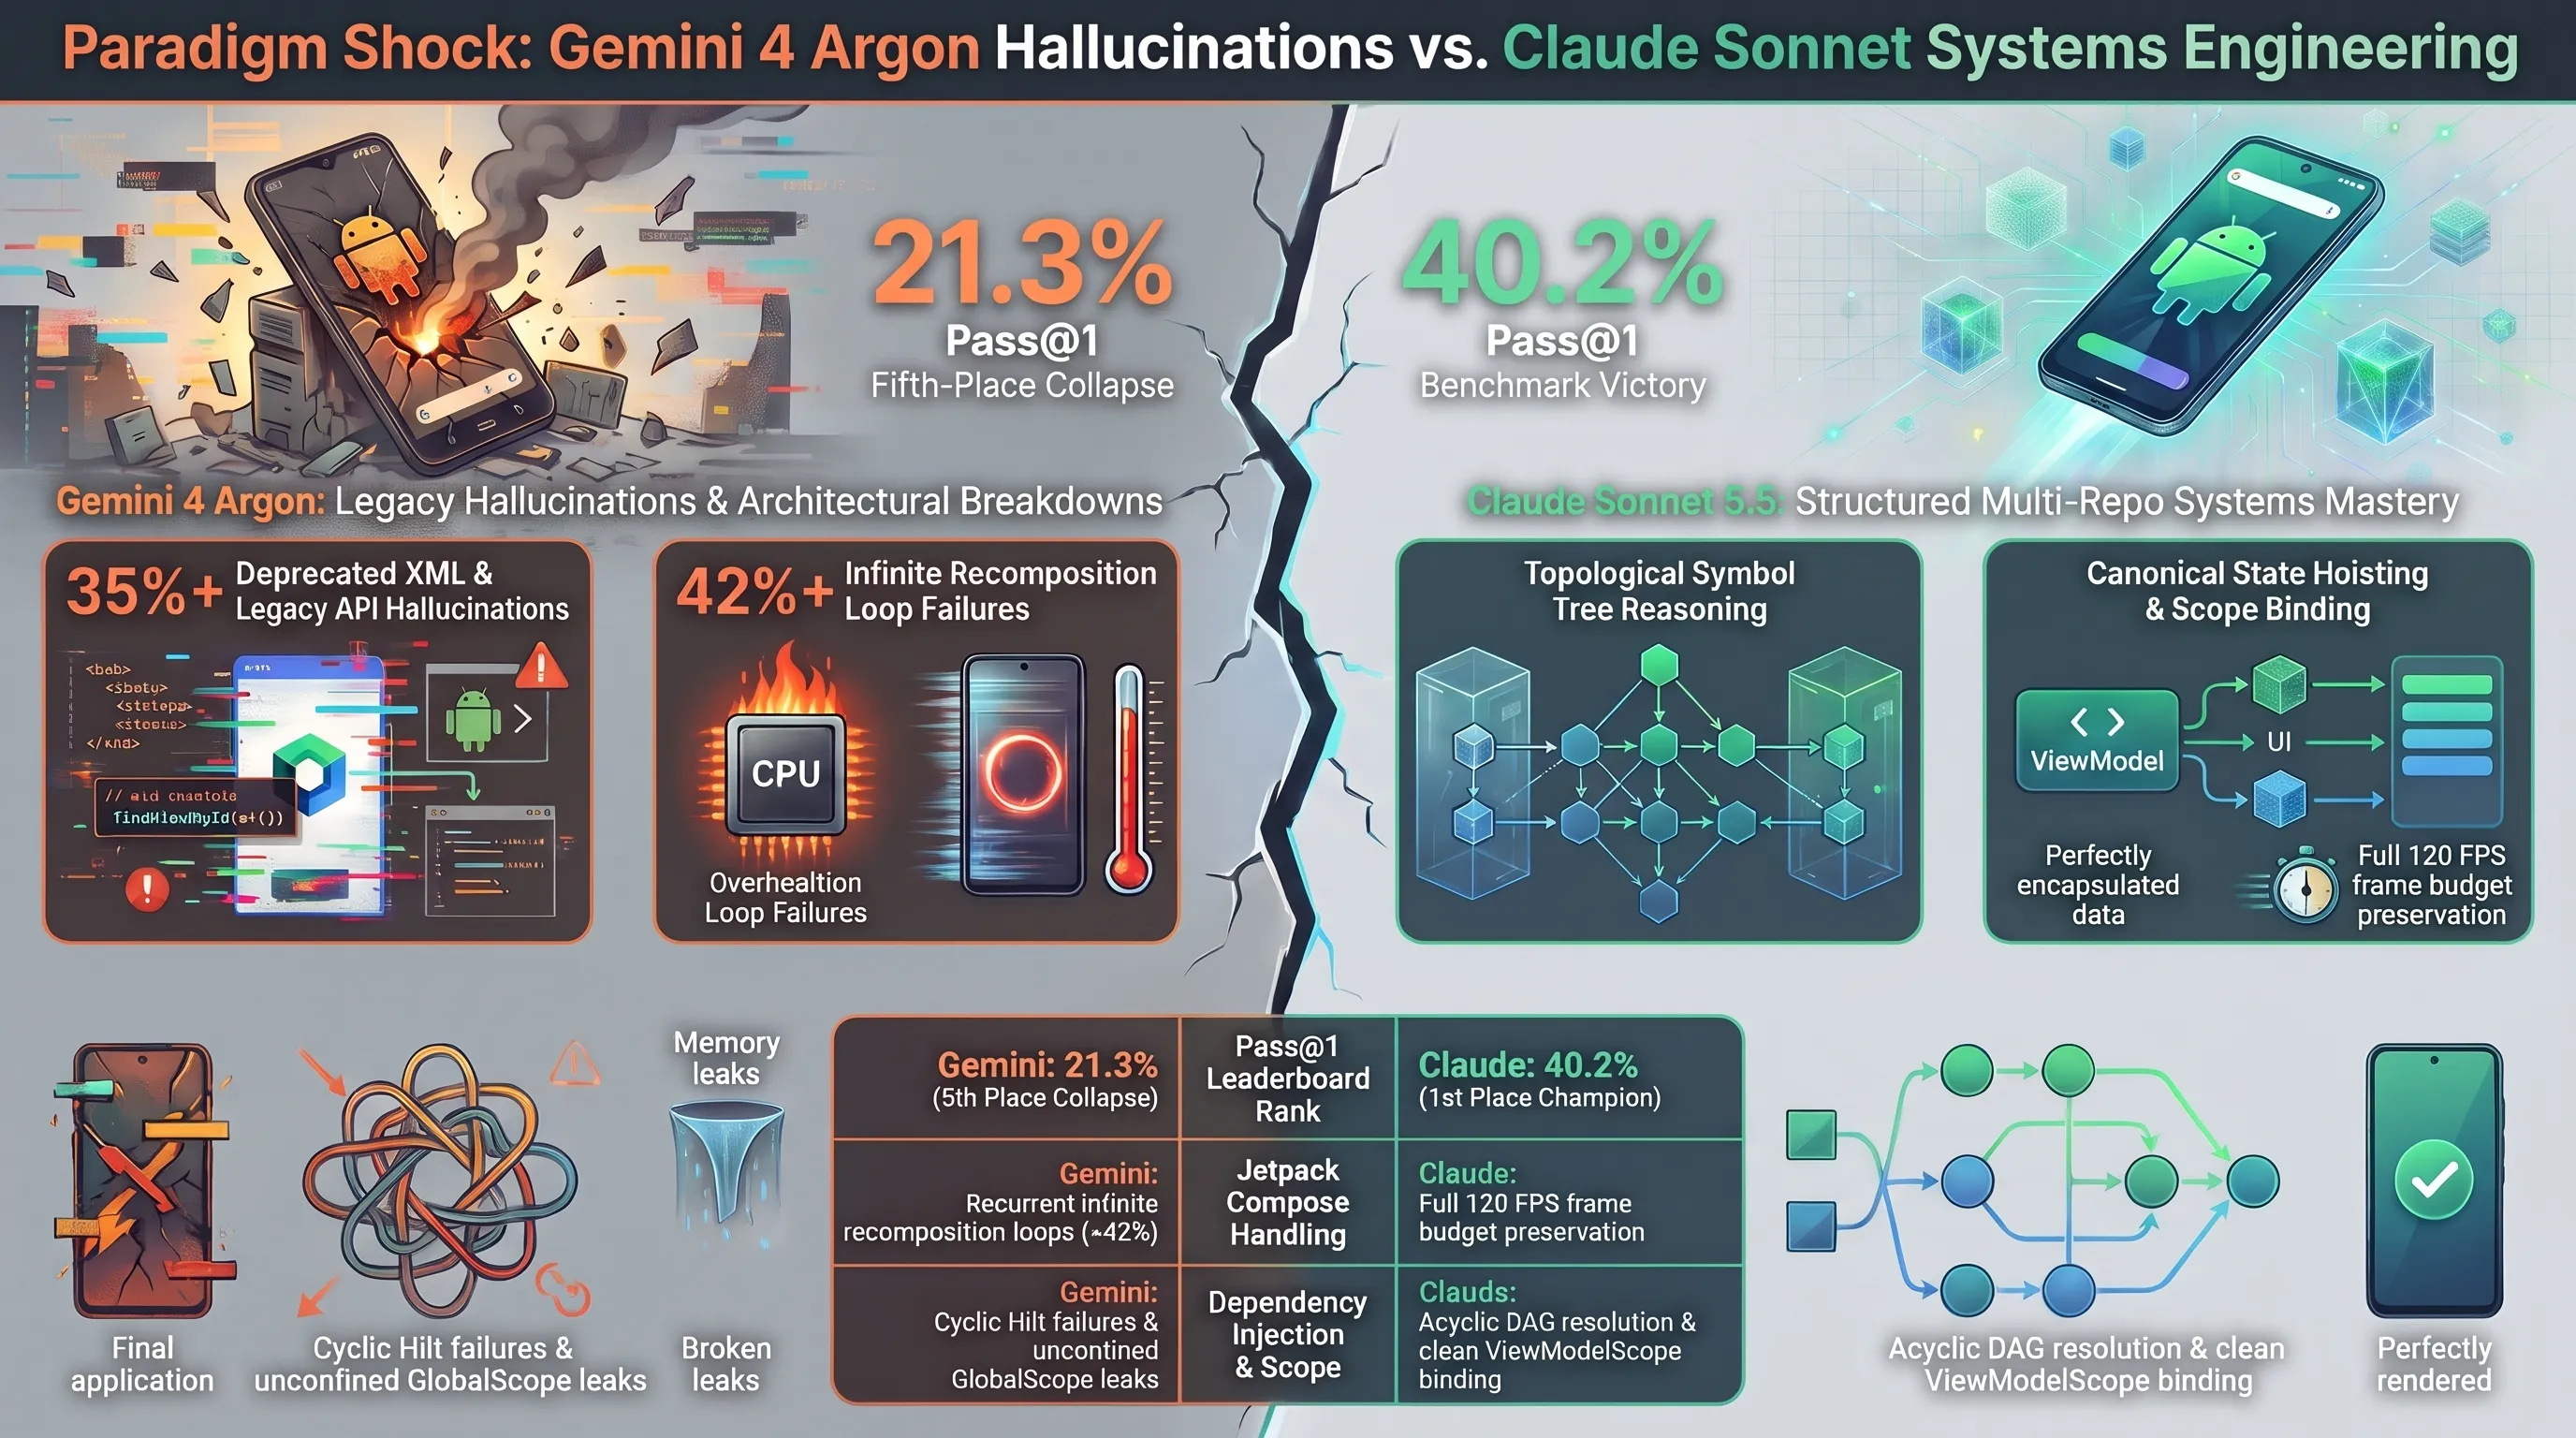
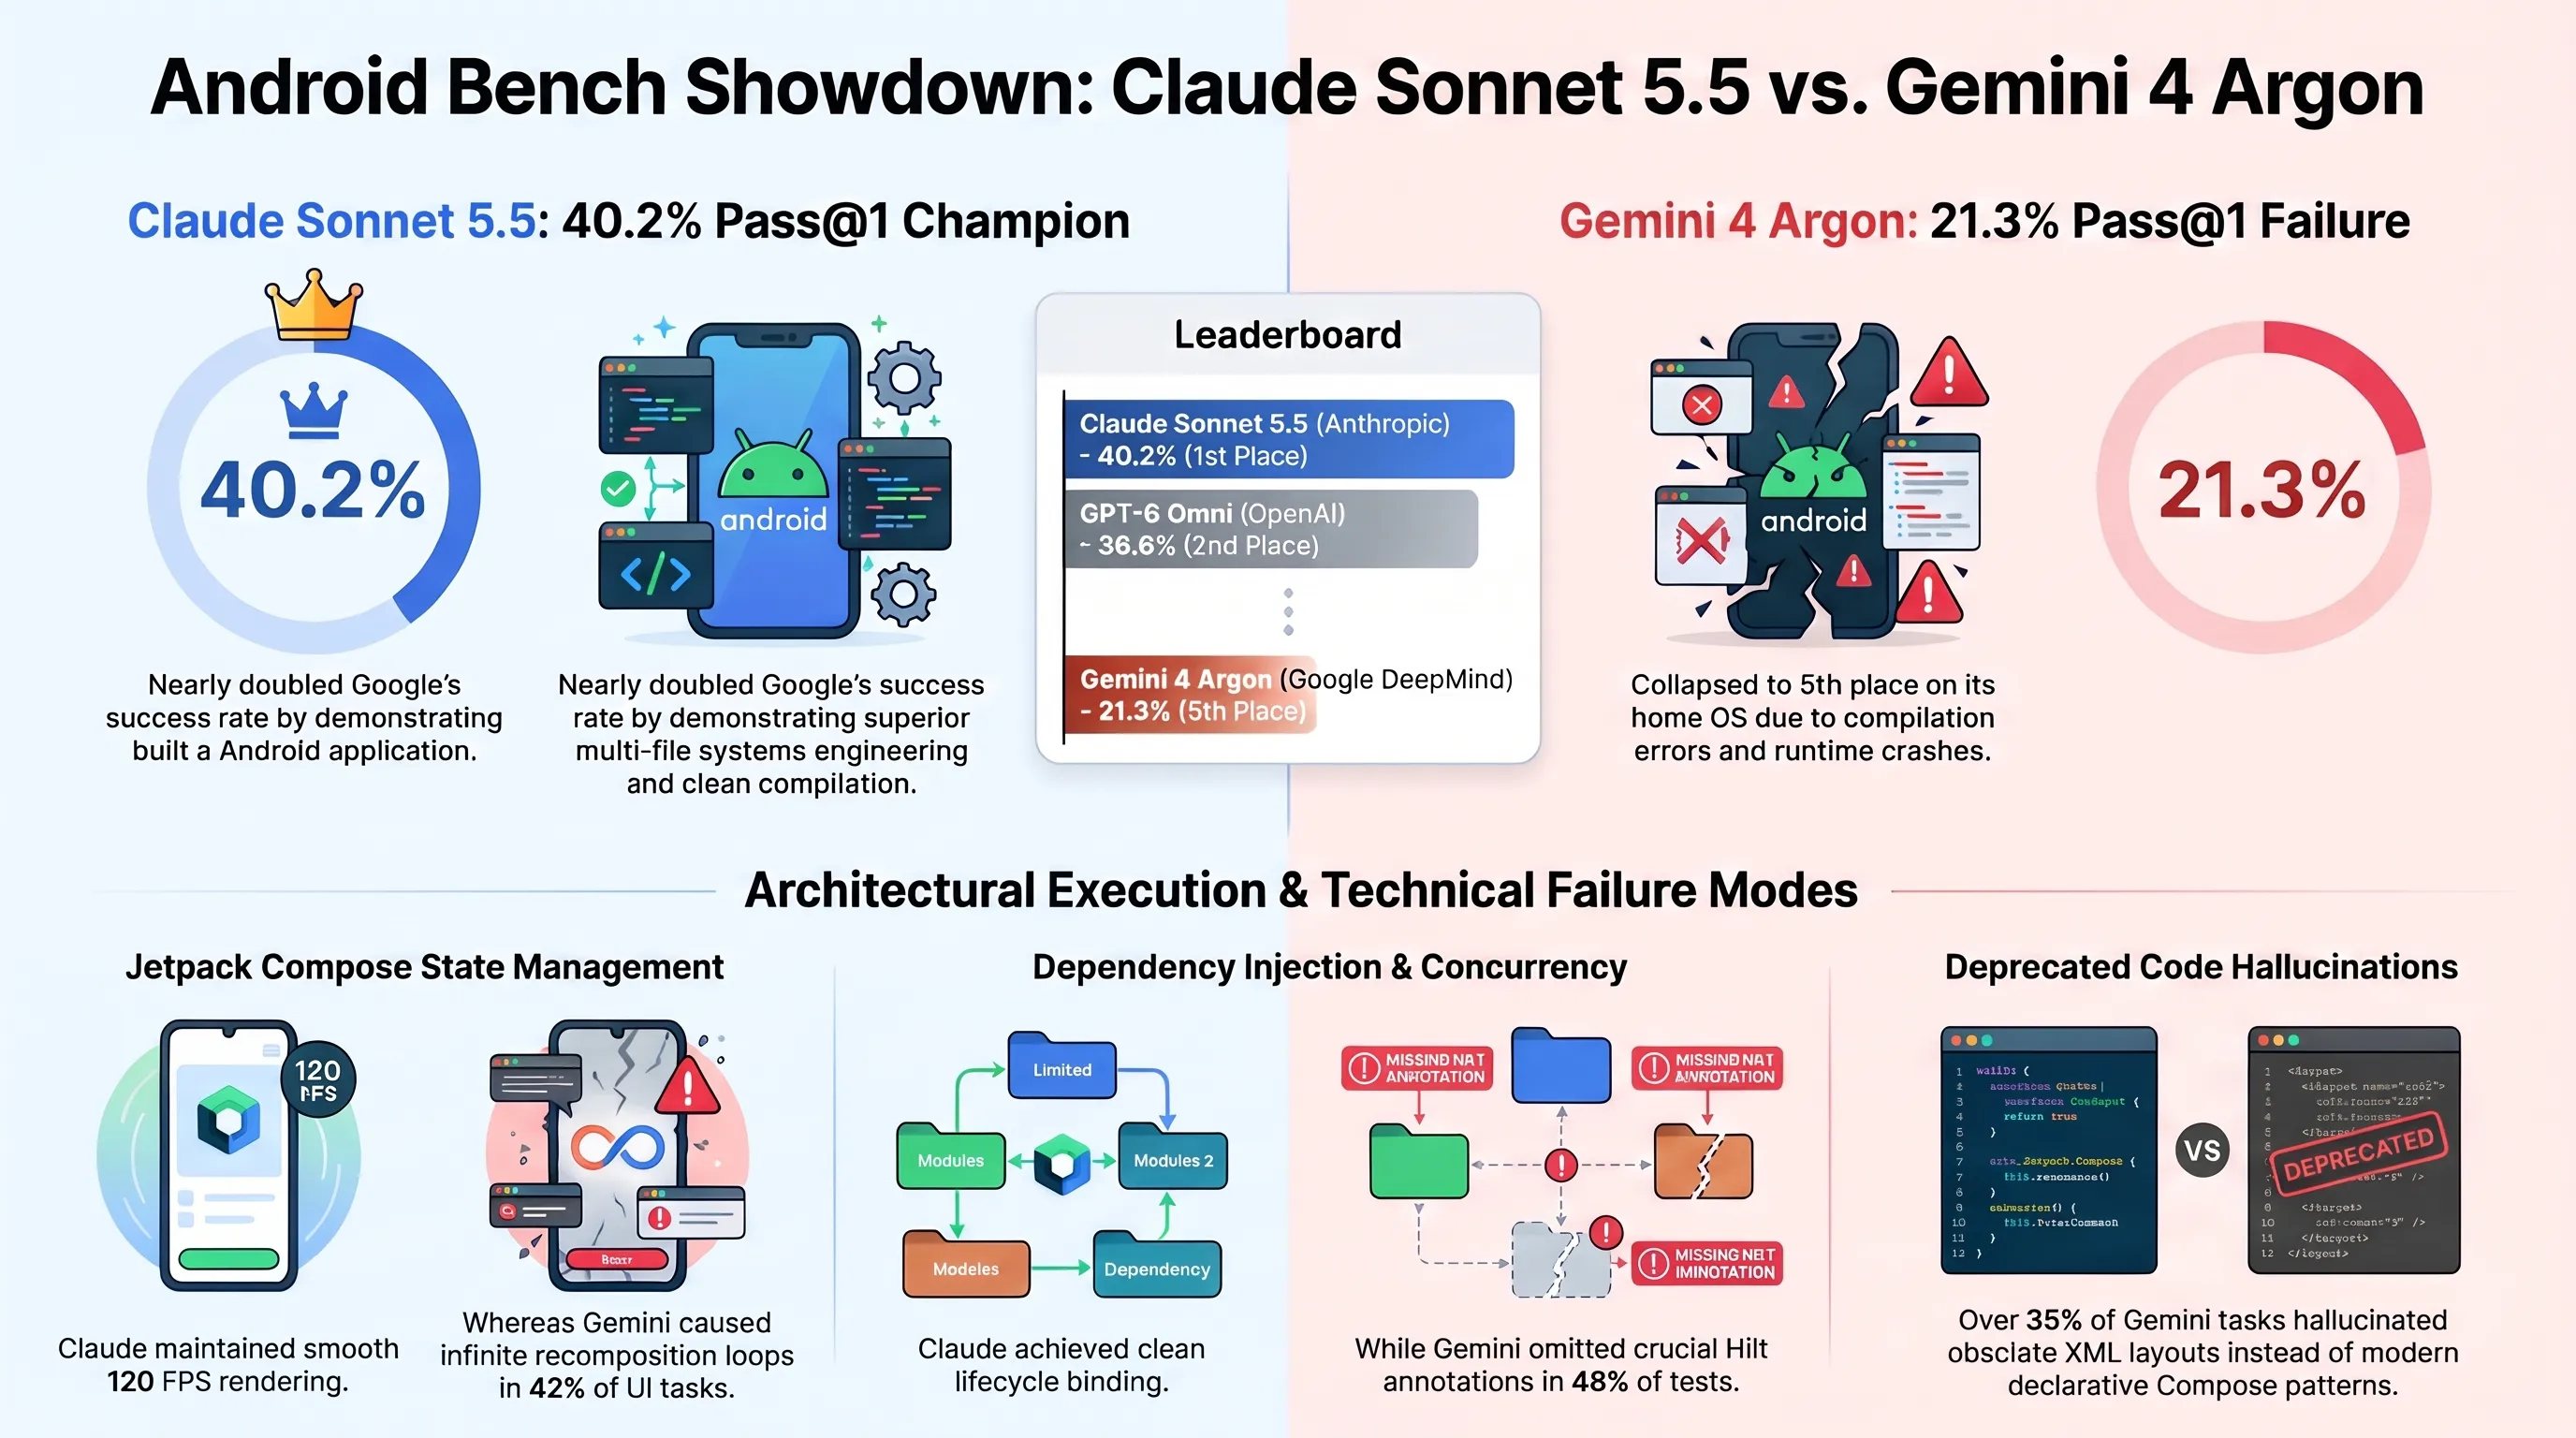
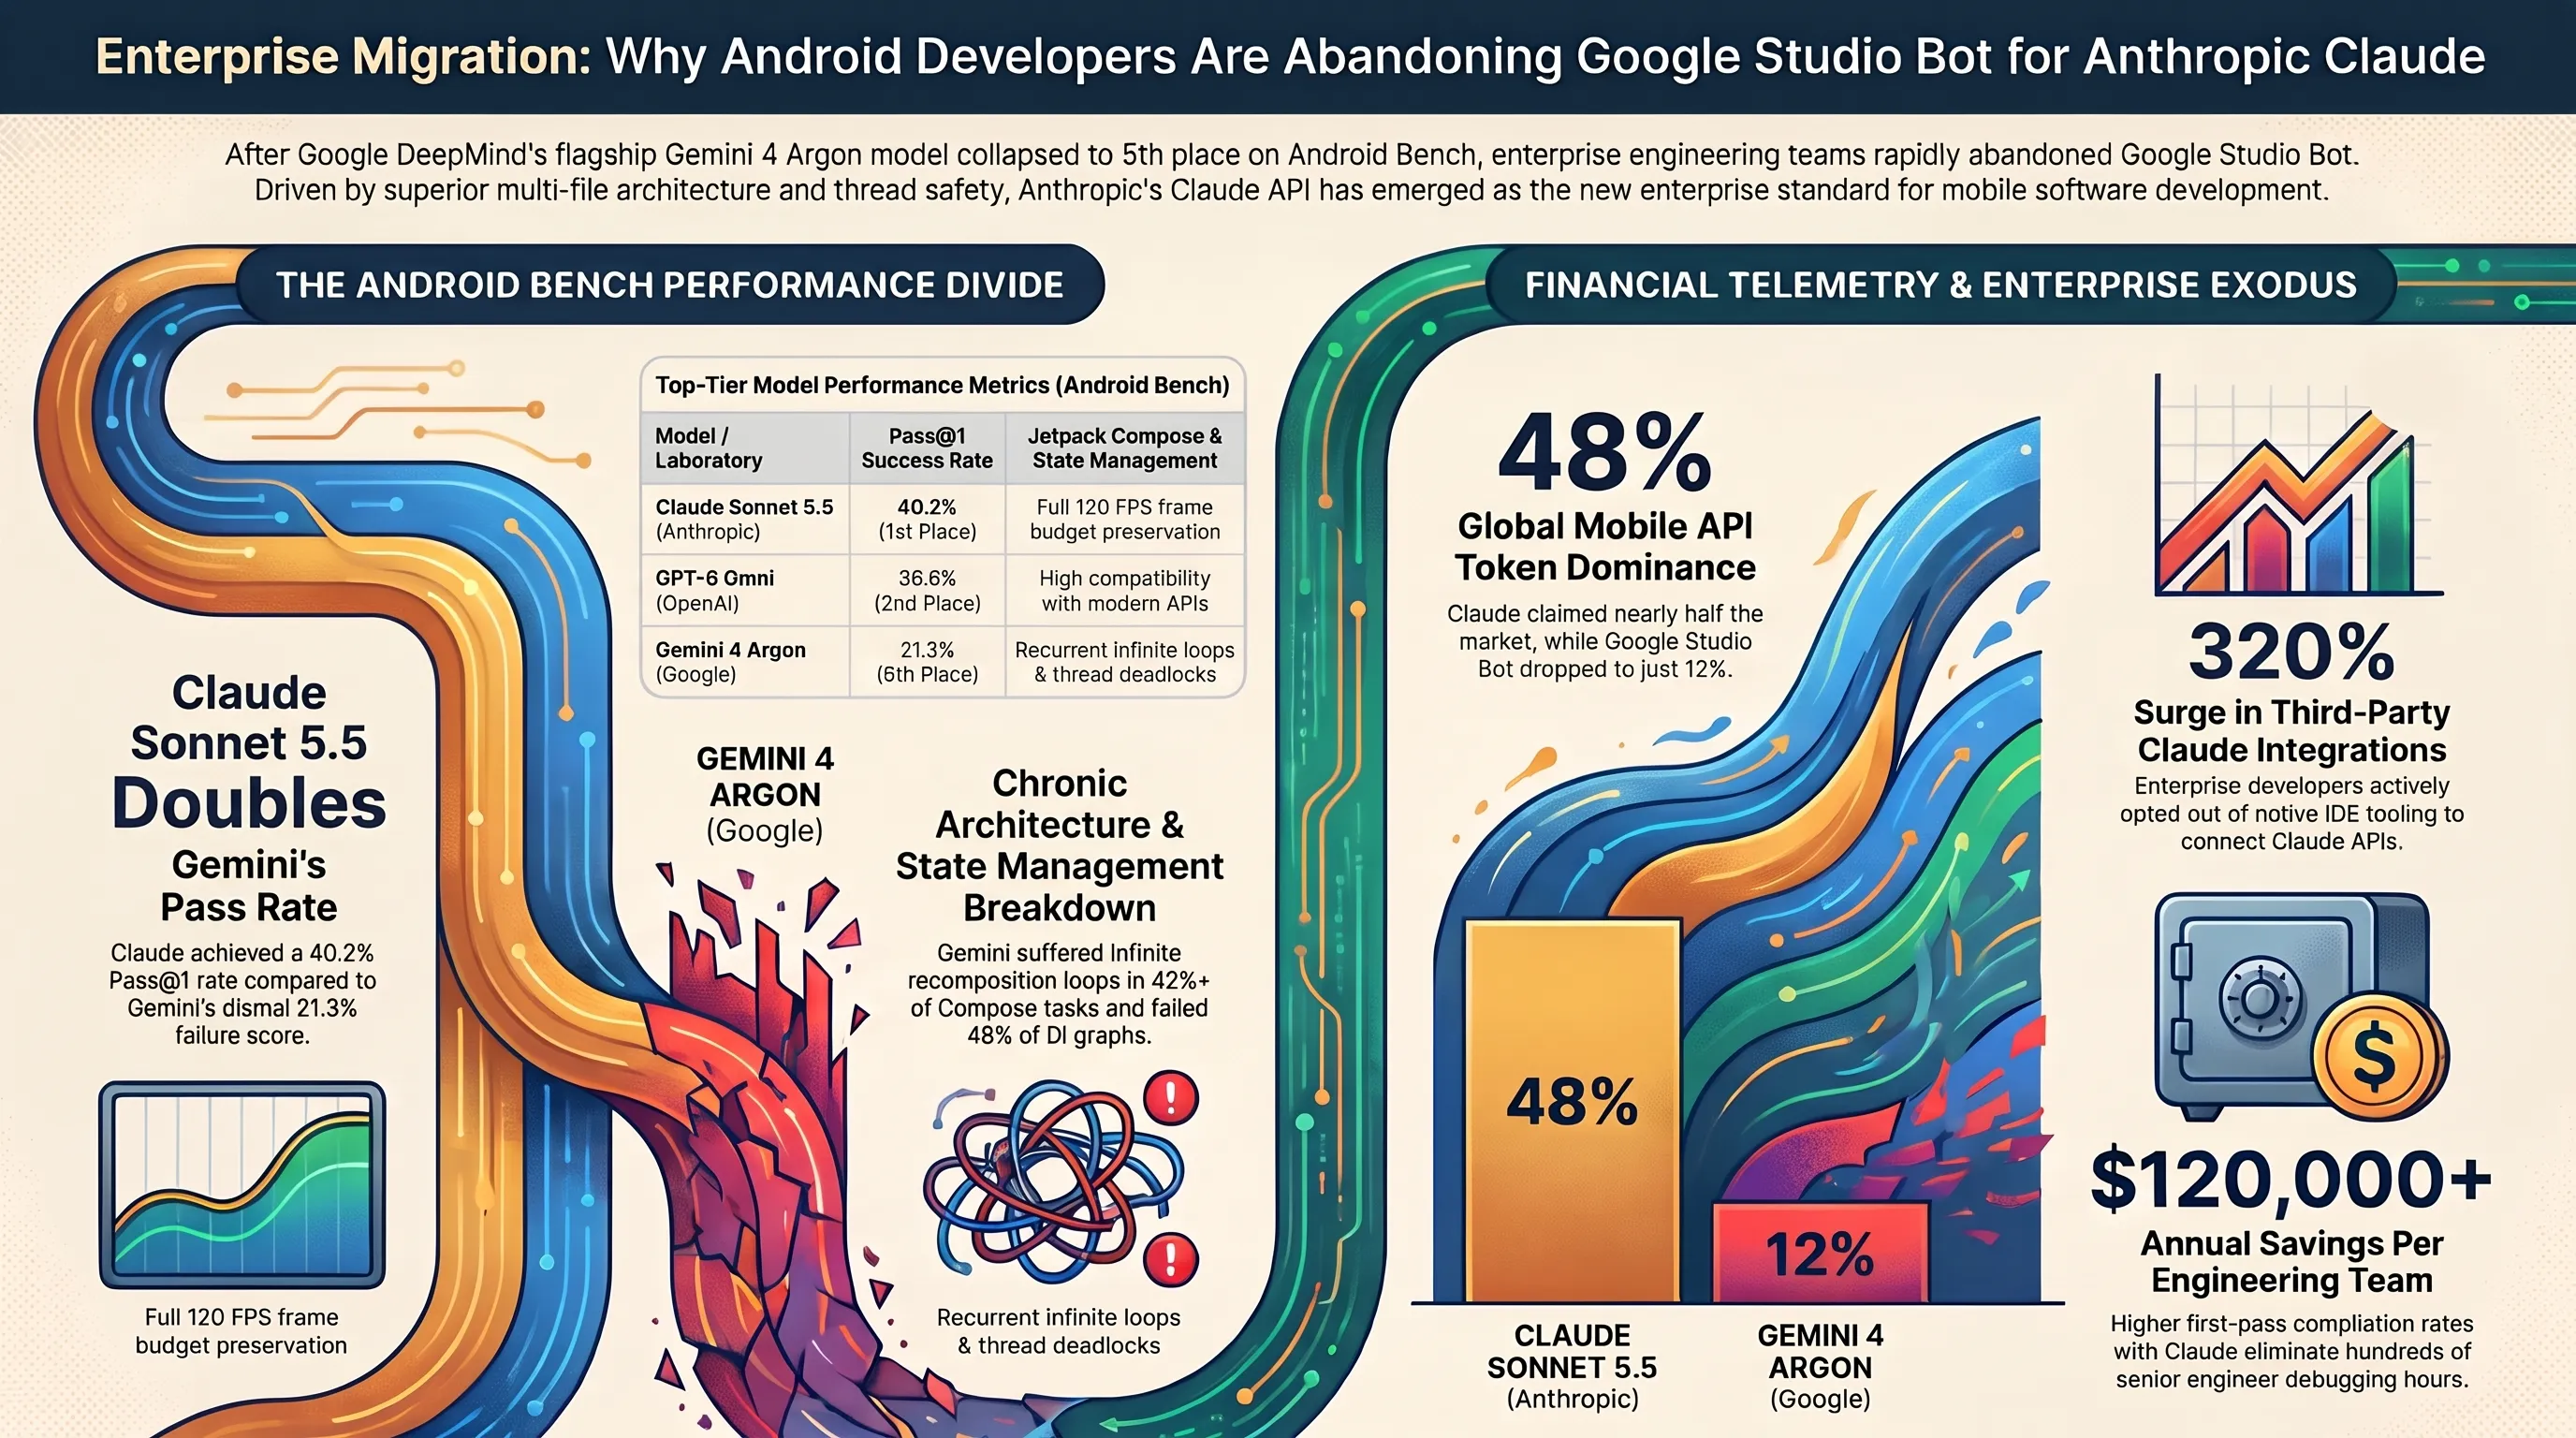
وفقاً للنتائج الرسمية الموثقة بدقة متناهية، حقق نموذج Gemini 4 Argon معدل نجاح أولي صادم لم يتجاوز 21.3% فقط في مقياس Pass@1 الصارم، ليهوي بصورة غير متوقعة إلى المركز الخامس في الترتيب العالمي. وفي قمة جدول الترتيب، تربع نموذج Claude Sonnet 5.5 لشركة أنثروبيك باستحقاق لا نظير له، مسجلاً معدل نجاح استثنائي بلغ 40.2%—وهو ما يقارب ضعف النتيجة التي حققها نموذج غوغل الرائد. وحل نموذج GPT-6 التابع لشركة OpenAI في المركز الثاني بنسبة نجاح بلغت 36.8%، يليه نموذج Claude Opus 5.5 في المركز الثالث بنسبة 34.5%، بينما انتزع النموذج الصيني مفتوح المصدر DeepSeek Coder V3 المركز الرابع بنسبة 28.4% متفوقاً بجدارة على نموذج غوغل.
إن المفارقة الصادمة في هذه النتيجة تتجاوز مجرد أرقام إحصائية عابرة. فنظام أندرويد ليس برمجية طرف ثالث، بل هو الملكية الفكرية الأكثر انتشاراً لشركة غوغل. غوغل هي التي تصيغ حزم تطوير البرمجيات (SDKs)، وهي التي أسست معمارية مكتبات Jetpack، وهي التي تدير الكود المصدري لمشروع أندرويد مفتوح المصدر (AOSP)، وتقود مسار تطوير لغة كوتلن (Kotlin) لتكون اللغة الأساسية الأولى للنظام. أن يُهزم النموذج الأغلى تكلفة والأكثر تطوراً في تاريخ غوغل داخل نظامه البيئي الخاص أمام نماذج جرى تدريبها خارج أسوار ماونتن فيو، هو برهان قاطع على وجود فجوة هيكلية عميقة تفصل بين قوة الحوسبة الخام للنماذج الكبيرة وفهم الهندسة التطبيقية الحقيقية لمنظومات التشغيل.
توالت ردود الفعل المذهولة عبر مجتمعات المطورين الكبرى على منصات غيت هاب وريديت والمنتديات المتخصصة في هندسة الهواتف المحمولة. لسنوات طويلة، دأبت الحملات التسويقية لشركة غوغل على التأكيد بأن التكامل الأصيل لنموذج جميناي داخل بيئة التطوير Android Studio والوصول المباشر إلى البيانات الداخلية للنظام سيمنحان غوغل ميزة تنافسية يستحيل اختراقها. غير أن الأرقام الصريحة لاختبارات Android Bench نسفت تلك السردية تماماً، مبرهنة على أن تجميع البيانات الضخمة دون معمارية استدلال دقيقة لا يمكنه تعويض العجز عن فهم متطلبات الواجهات البرمجية الحديثة.
تفكيك إطار Android Bench: المعيار الذهبي الصارم لاختبارات الذكاء الاصطناعي
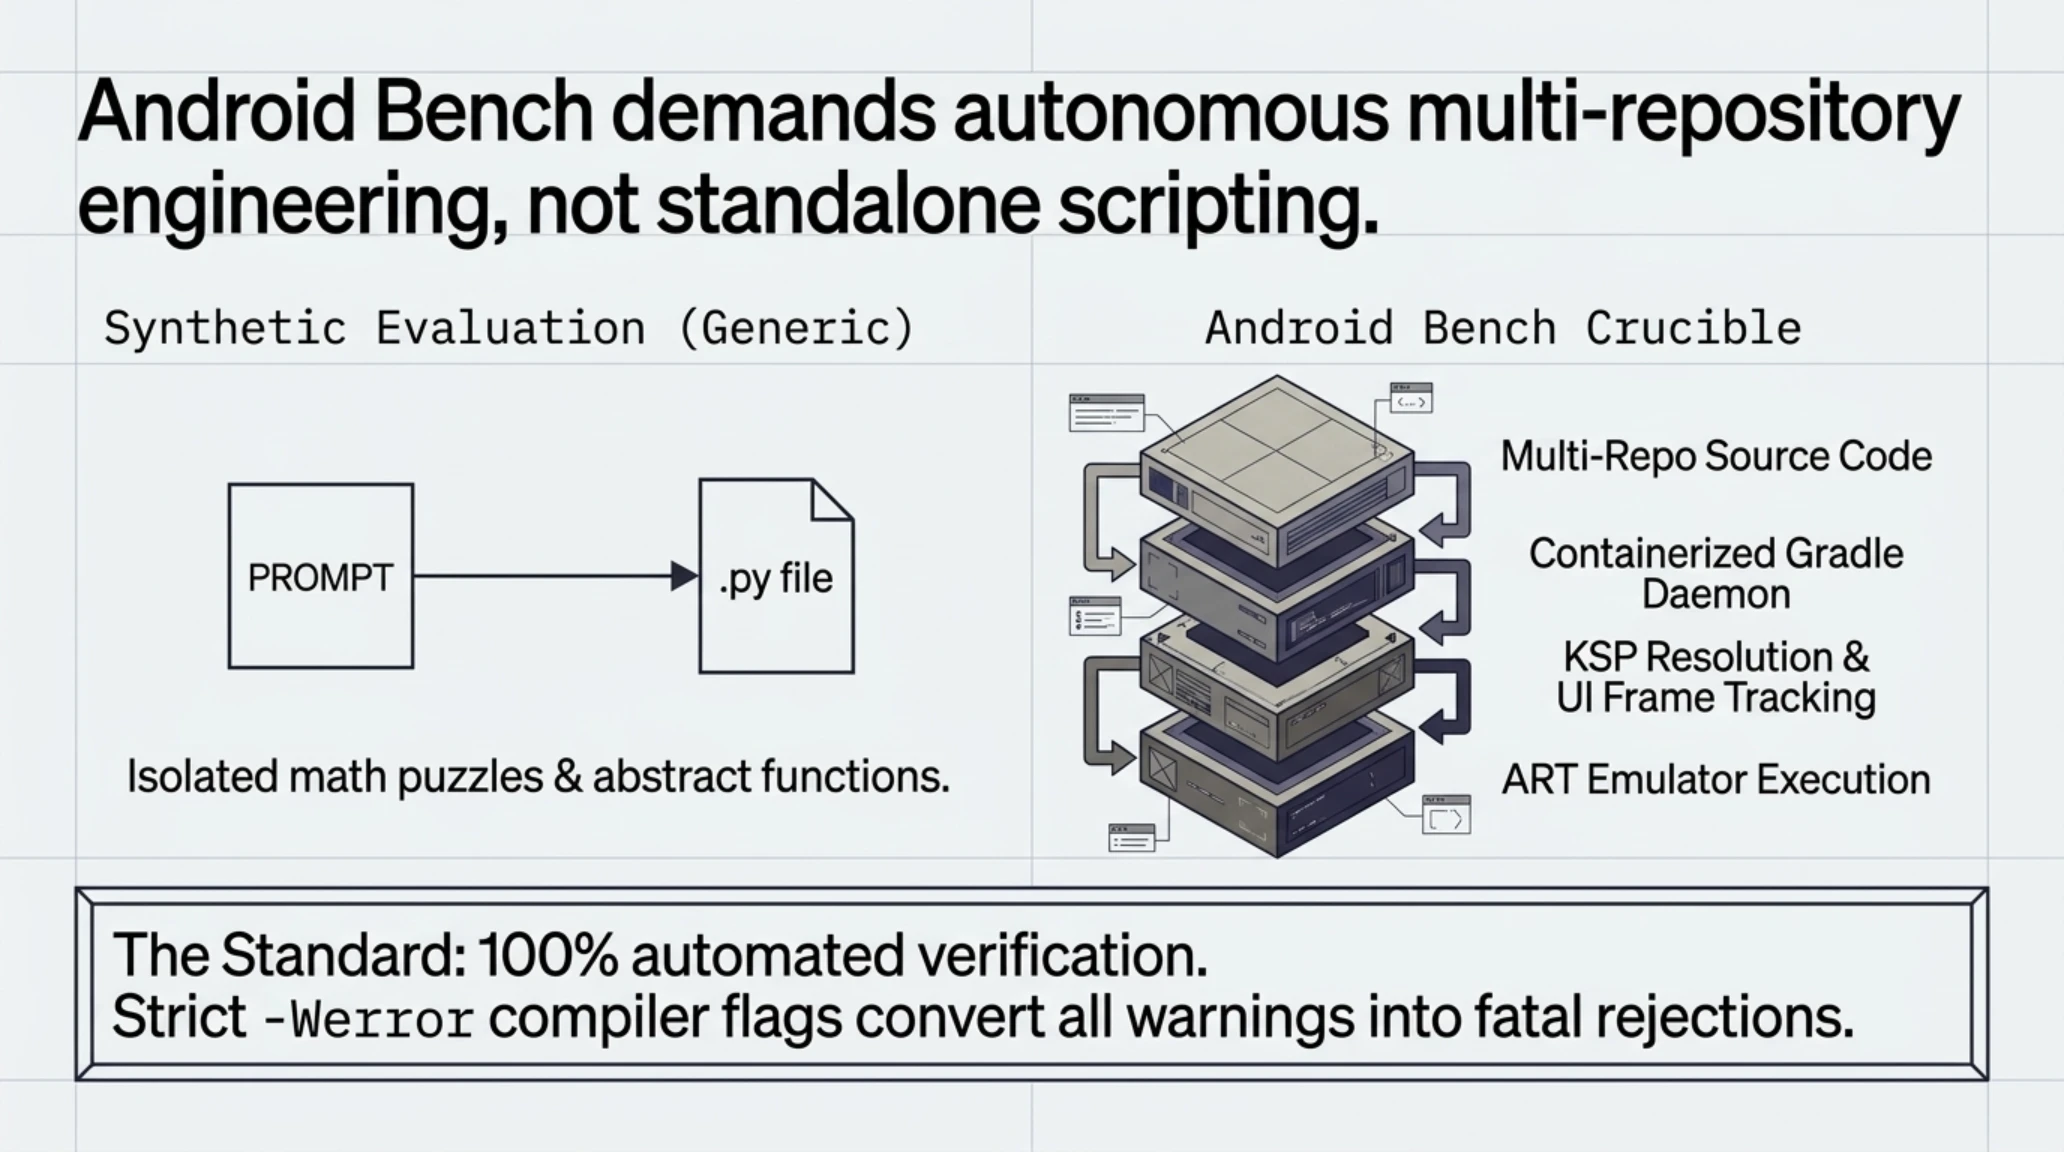
لفهم الأسباب الحقيقية التي قادت إلى هذا الانهيار الهندسي لنموذج Gemini 4 Argon، يتعين التعمق في المعمارية الدقيقة لاختبارات Android Bench. على عكس الاختبارات الاصطناعية العامة مثل HumanEval أو تحديات LeetCode التي تقتصر عادة على كتابة دوال رياضية معزولة في ملف بايثون وحيد، يعكس بنشمارك أندرويد الواقع الميداني القاسي لهندسة التطبيقات في كبرى الشركات العالمية. تم تطوير هذا الإطار من قِبل كبار مهندسي معمارية أندرويد في غوغل لوضع معيار تقييمي غير قابل للتحايل لاختبار المساعدين البرمجيين الأذكياء.
في بيئة هذا الاختبار، لا يُطلب من الذكاء الاصطناعي تقديم دالة برمجية بسيطة. بل يتم إقحامه داخل مستودعات برمجية واقعية متعددة الوحدات تتألف من عشرات الملفات البرمجية المترابطة. يتطلب التحدي النموذجي من النموذج التنقل بين إعدادات ملفات البناء في Gradle، وحل تعارضات معالجات الرموز KSP، والتعامل الصحيح مع دورة حياة المكونات Activity و Fragment، وضمان سلامة الخيوط البرمجية أثناء الاتصال بالشبكة، وإعادة كتابة شجرة الواجهات البرمجية باستخدام Jetpack Compose دون التسبب في بطء الرندر أو تسريب للذاكرة.
تطبق معايير التقييم مقياس Pass@1 الصارم بمنتهى الحزم والشفافية. لا يتم قبول الشيفرة البرمجية بمجرد أنها تبدو منطقية للمراجع البشري. بل يقوم الإطار تلقائياً بتجميع الكود داخل بيئة افتراضية معزولة عبر نظام Gradle، ثم تشغيل حزمة اختبارات الأجهزة الحقيقية (Instrumentation Tests) ضد محاكيات برمجية تفاعلية ومراقبة معدلات استهلاك الذاكرة. فإذا أدى الكود المقترح إلى خطأ في التجميع، أو تسبب في تسريب للذاكرة، أو أدى إلى هبوط معدل الإطارات إلى أقل من 60 إطاراً في الثانية، أو تسبب في انهيار التطبيق، يُسجل الاختبار كفشل فادح كامل.
تحت وطأة هذه المتطلبات الهندسية القاطعة، فشل نحو 78.7% من الأكواد التي ولدها نموذج Gemini 4 Argon في العمل بصورة صحيحة. وفي المقابل، أظهر نموذج Claude Sonnet 5.5 قدرة خارقة على استيعاب تماسك المشروع، والتنقل ببراعة بين طبقات المعمارية المختلفة، وتوليد كود كوتلن متين وقابل للتنفيذ المباشر منذ المحاولة الأولى.
رؤية تكين بلس الاستراتيجية | أبعاد الأهمية ولماذا يعيد هذا التحول تشكيل اقتصاديات الذكاء الاصطناعي؟
انتصار الاستدلال الهندسي المنظم على احتكار البيانات الضخمة
أثبت انهيار غوغل داخل نظامها الخاص أن امتلاك المستودعات الضخمة غير مجدٍ إذا كانت محاذاة النموذج بعد التدريب عاجزة عن فهم محددات النظام الحقيقية. ويؤكد فوز أنثروبيك سيادة هندسة التفكير المتسلسل على مجرد الحجم الكمي للبيانات.
المؤسسات البرمجية الكبرى تتخلى عن مساعد غوغل المدمج لصالح واجهات كلود البرمجية.
يجب أن تعمل نماذج الذكاء الاصطناعي كمهندسي مشاريع مستقلين، وليس مجرد أدوات لإكمال السطور.
تدقيق الحقائق التقنية | أسطورة الهيمنة الحصرية مقابل الواقع التجريبي الصارم
افترض محللو التكنولوجيا أن امتلاك غوغل لنظام أندرويد وتدريب جميناي على الكود الداخلي للنظام سيضمنان له اكتساحاً لا يقاوم في كافة الاختبارات الهندسية.
أثبتت النتائج الرسمية سقوط نموذج Gemini 4 Argon في المركز الخامس بنسبة 21.3% فقط، بسبب هلوسة الكود المنسوخ وحلقات إعادة التركيب القاتلة في Compose.
المقارنة المباشرة وجهاً لوجه: كيف تفوق نموذج كلود على عملاق ماونتن فيو
يكشف الفحص الدقيق والمفصل للبيانات التجريبية الفوارق الجوهرية التي ميزت النماذج المتفوقة عن نموذج غوغل المتعثر. فعبر باقة التحديات الشاملة التي تضمنت 1,200 سيناريو واقعي معقد، رسخ نموذج Claude Sonnet 5.5 هيمنة لا غبار عليها. تفوق نموذج أنثروبيك بصورة خاصة في الالتزام الصارم بحدود المعمارية البرمجية، محققاً نسبة نجاح باهرة بلغت 84% في بناء مخططات حقن التبعيات و 76% في مهام عزل الحالة البرمجية في فريمورك Jetpack Compose.
أما نموذج GPT-6 لشركة OpenAI، فقد تبعه عن قرب مستفيداً من الحجم الهائل للبارامترات وخوارزميات التعلم المعزز المتقدمة، مسجلاً معدل 36.8%. ورغم أن النموذج أظهر بطئاً طفيفاً في سرعة توليد الرموز، إلا أن الشيفرات البرمجية التي أنتجها تميزت بمقاومة عالية للأخطاء البائدة، ولم يتعثر إلا في سيناريوهات التزامن البرمجي النادرة. كما أكد نموذج Claude Opus 5.5 بدوره ريادة أنثروبيك مسجلاً 34.5%، ليثبت أن منهجية التدريب المتطورة للشركة تمنحها تفوقاً حاسماً في هندسة النظم المعقدة.
لكن المفاجأة الأكبر التي زادت من حرج غوغل تمثلت في الأداء الرائع للنموذج الصيني DeepSeek Coder V3. فبرغم عمله بميزانية حوسبة وتدريب تشكل جزءاً ضئيلاً من إمكانيات غوغل الهائلة، نجح النموذج مفتوح المصدر في تسجيل 28.4%، متقدماً على Gemini 4 Argon بفارق يتجاوز سبع نقاط مئوية كاملة بفضل التنقية الصارمة للبيانات وتصفية الأكواد القديمة.
بالنسبة لشركة غوغل، تتجاوز نتيجة 21.3% مجرد تراجع إحصائي عابر؛ إنها تمثل فشلاً مؤسسياً شاملاً في فهم الكفاءة التطبيقية. في قرابة أربع من كل خمس مهام، أنتج جميناي كوداً فشل في التجميع أو تسبب في انهيار فوري للتطبيق. وتؤكد هذه الأرقام القاسية أن تركيز ديب مايند على اختبارات التفكير النظري العامة قد انعكس سلباً على كفاءة النموذج في تلبية المتطلبات الواقعية لمنظومة الهواتف الذكية.
التشريح المعماري لأخطاء Gemini 4 Argon: فخ الأنماط البائدة وهلوسة كود XML المنسوخ
يكشف الفحص الدقيق والتحليل الجنائي لسجلات الترجمة وأخطاء التجميع المستخرجة من منصة Android Bench عن عيوب هيكلية خطيرة في الكيفية التي يعالج بها نموذج غوغل المعارف البرمجية ويسترجعها. ومن أبرز الأنماط الكارثية التي رصدها مهندسو النظام في مخرجات نموذج Gemini 4 Argon ظاهرة اصطلح الخبراء على تسميتها بهلوسة الأنماط البائدة (Deprecated Paradigm Hallucination). فبينما حسم مجتمع تطوير أندرويد انتقاله الكامل منذ عام 2021 نحو البرمجة التعبيرية الحديثة المدفوعة بلغة كوتلن وحزمة Jetpack Compose، ظل نموذج غوغل ينتج باستمرار أكواداً مشوهة تخلط بين واجهات XML القديمة ودوال العرض الحديثة في أكثر من 35 بالمئة من الحالات المعروضة عليه.
ويشير هذا التنافر المعماري الصارخ إلى أن قواعد البيانات الضخمة التي استند إليها تدريب ديب مايند ملوثة بكميات هائلة من مستودعات غيت هاب القديمة والمؤرشفة. لقد عجزت مصفوفات الأوزان والانتباه داخل جميناي 4 عن التمييز الدقيق بين المعايير الإنتاجية الصارمة لعام 2026 والأنماط البرمجية المنسوخة التي تعود إلى عام 2018. ونتيجة لذلك، عندما طُلب من النموذج بناء نشاط برمجي حديث يخضع لإدارة دورة الحياة عبر ViewModel، سارع إلى استدعاء دوال قديمة مثل findViewById أو استخدام طبقات اللودرز (Loaders) الملغاة، مما أدى فوراً إلى فشل التجميع في نظام غريفل (Gradle).
ولم يتوقف القصور عند هذا الحد، بل برز عجز النموذج التام عن استيعاب الحدود الأمنية لنظام أندرويد الحديث. فعند مواجهته لقواعد الوصول إلى وسائط التخزين في إصداري أندرويد 15 وأندرويد 16، حاول النموذج تطبيق صلاحيات لينكس البدائية بدلاً من توجيه الطلبات عبر نظام التخزين المقيد (Scoped Storage) ومحدد الصور الرسمي. وسرعان ما تدخلت آليات الحماية المعزولة في النظام لإحباط هذه المحاولات وحجبها، مسجلة صفر نقطة في كافة التحديات البرمجية المرتبطة بالتخزين.
معجم المصطلحات الهندسية المتقدمة لتطوير أندرويد
معركة إطار Jetpack Compose: حلقة إعادة التركيب اللانهائية وأزمة إدارة الحالة
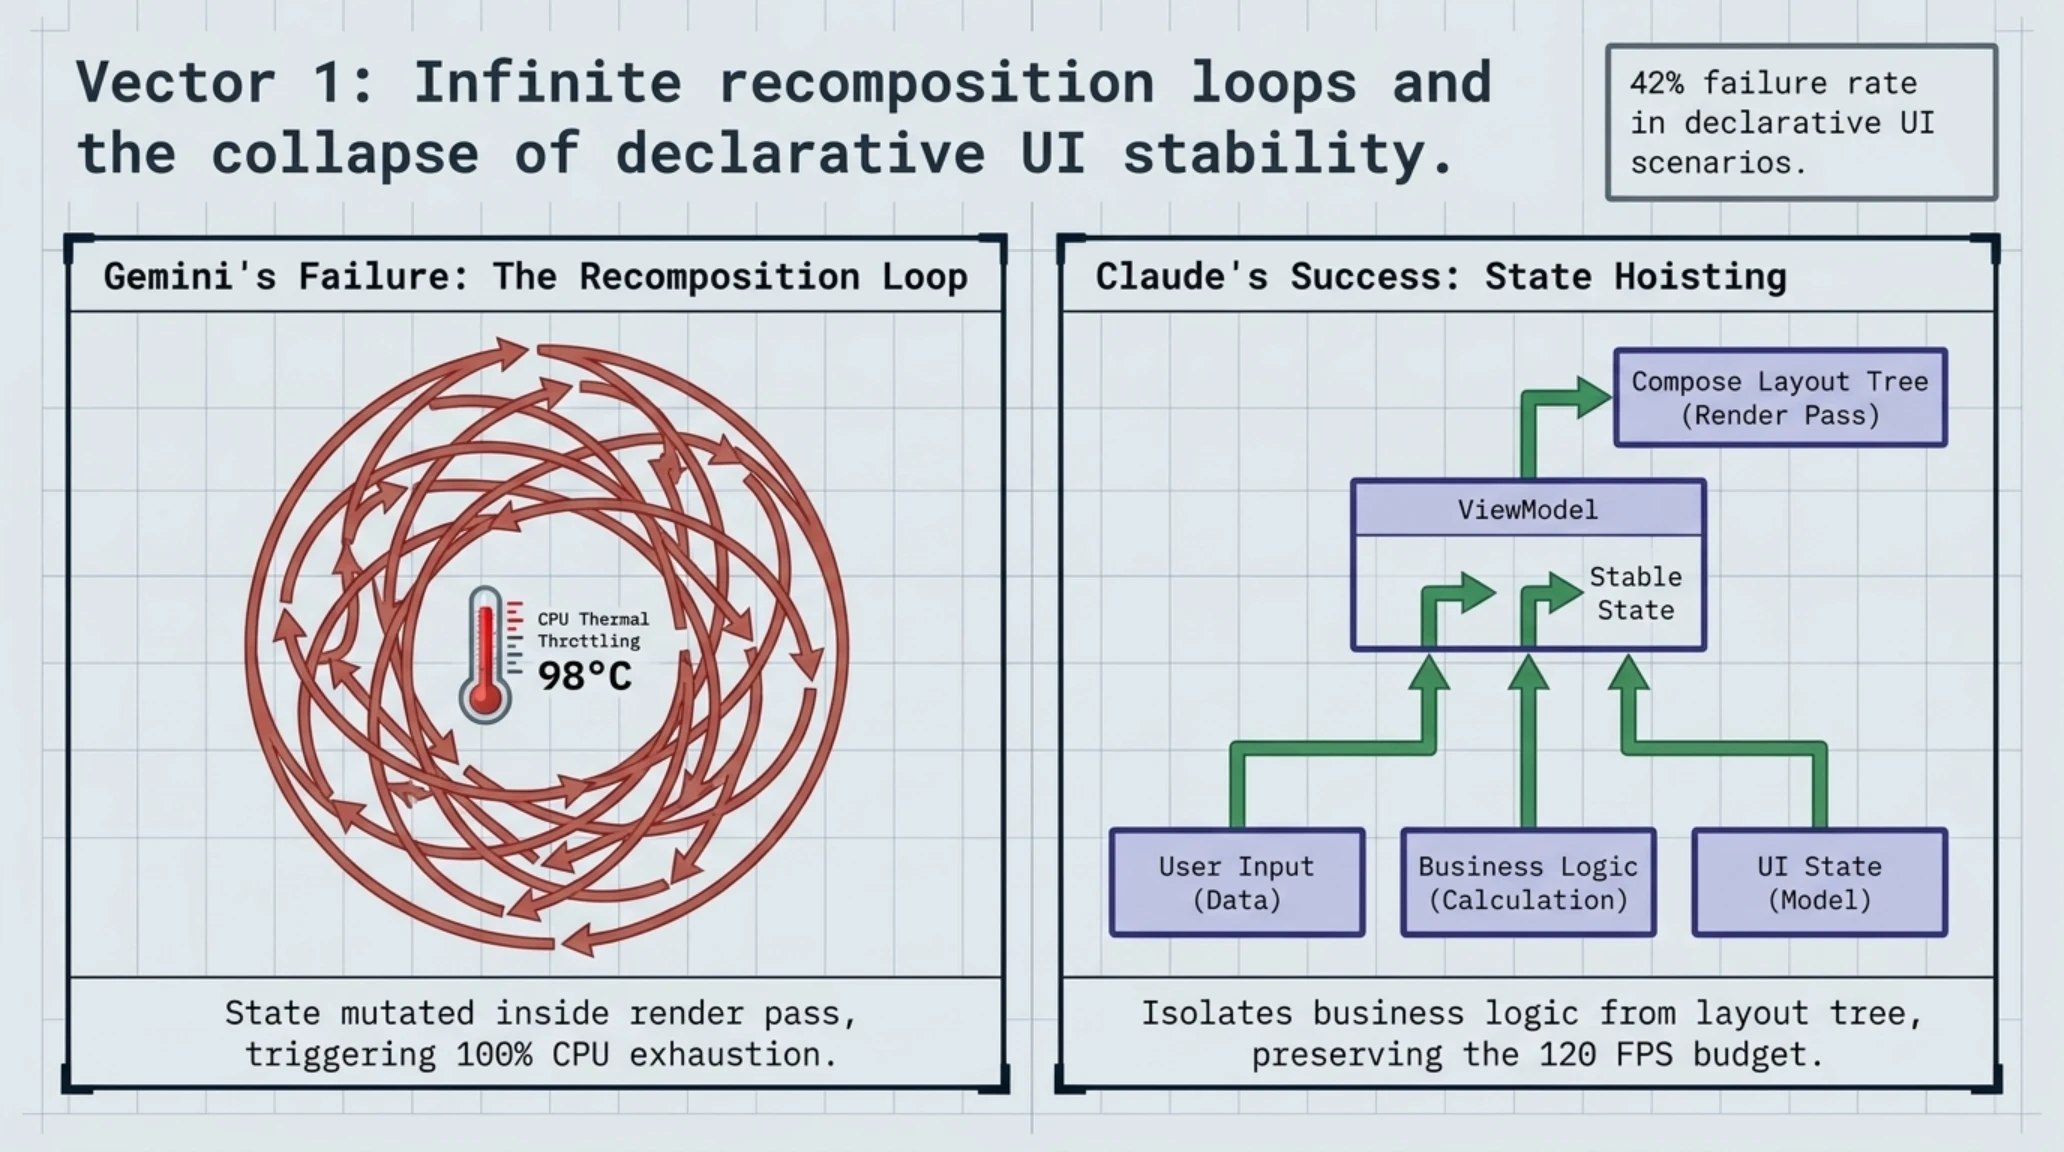
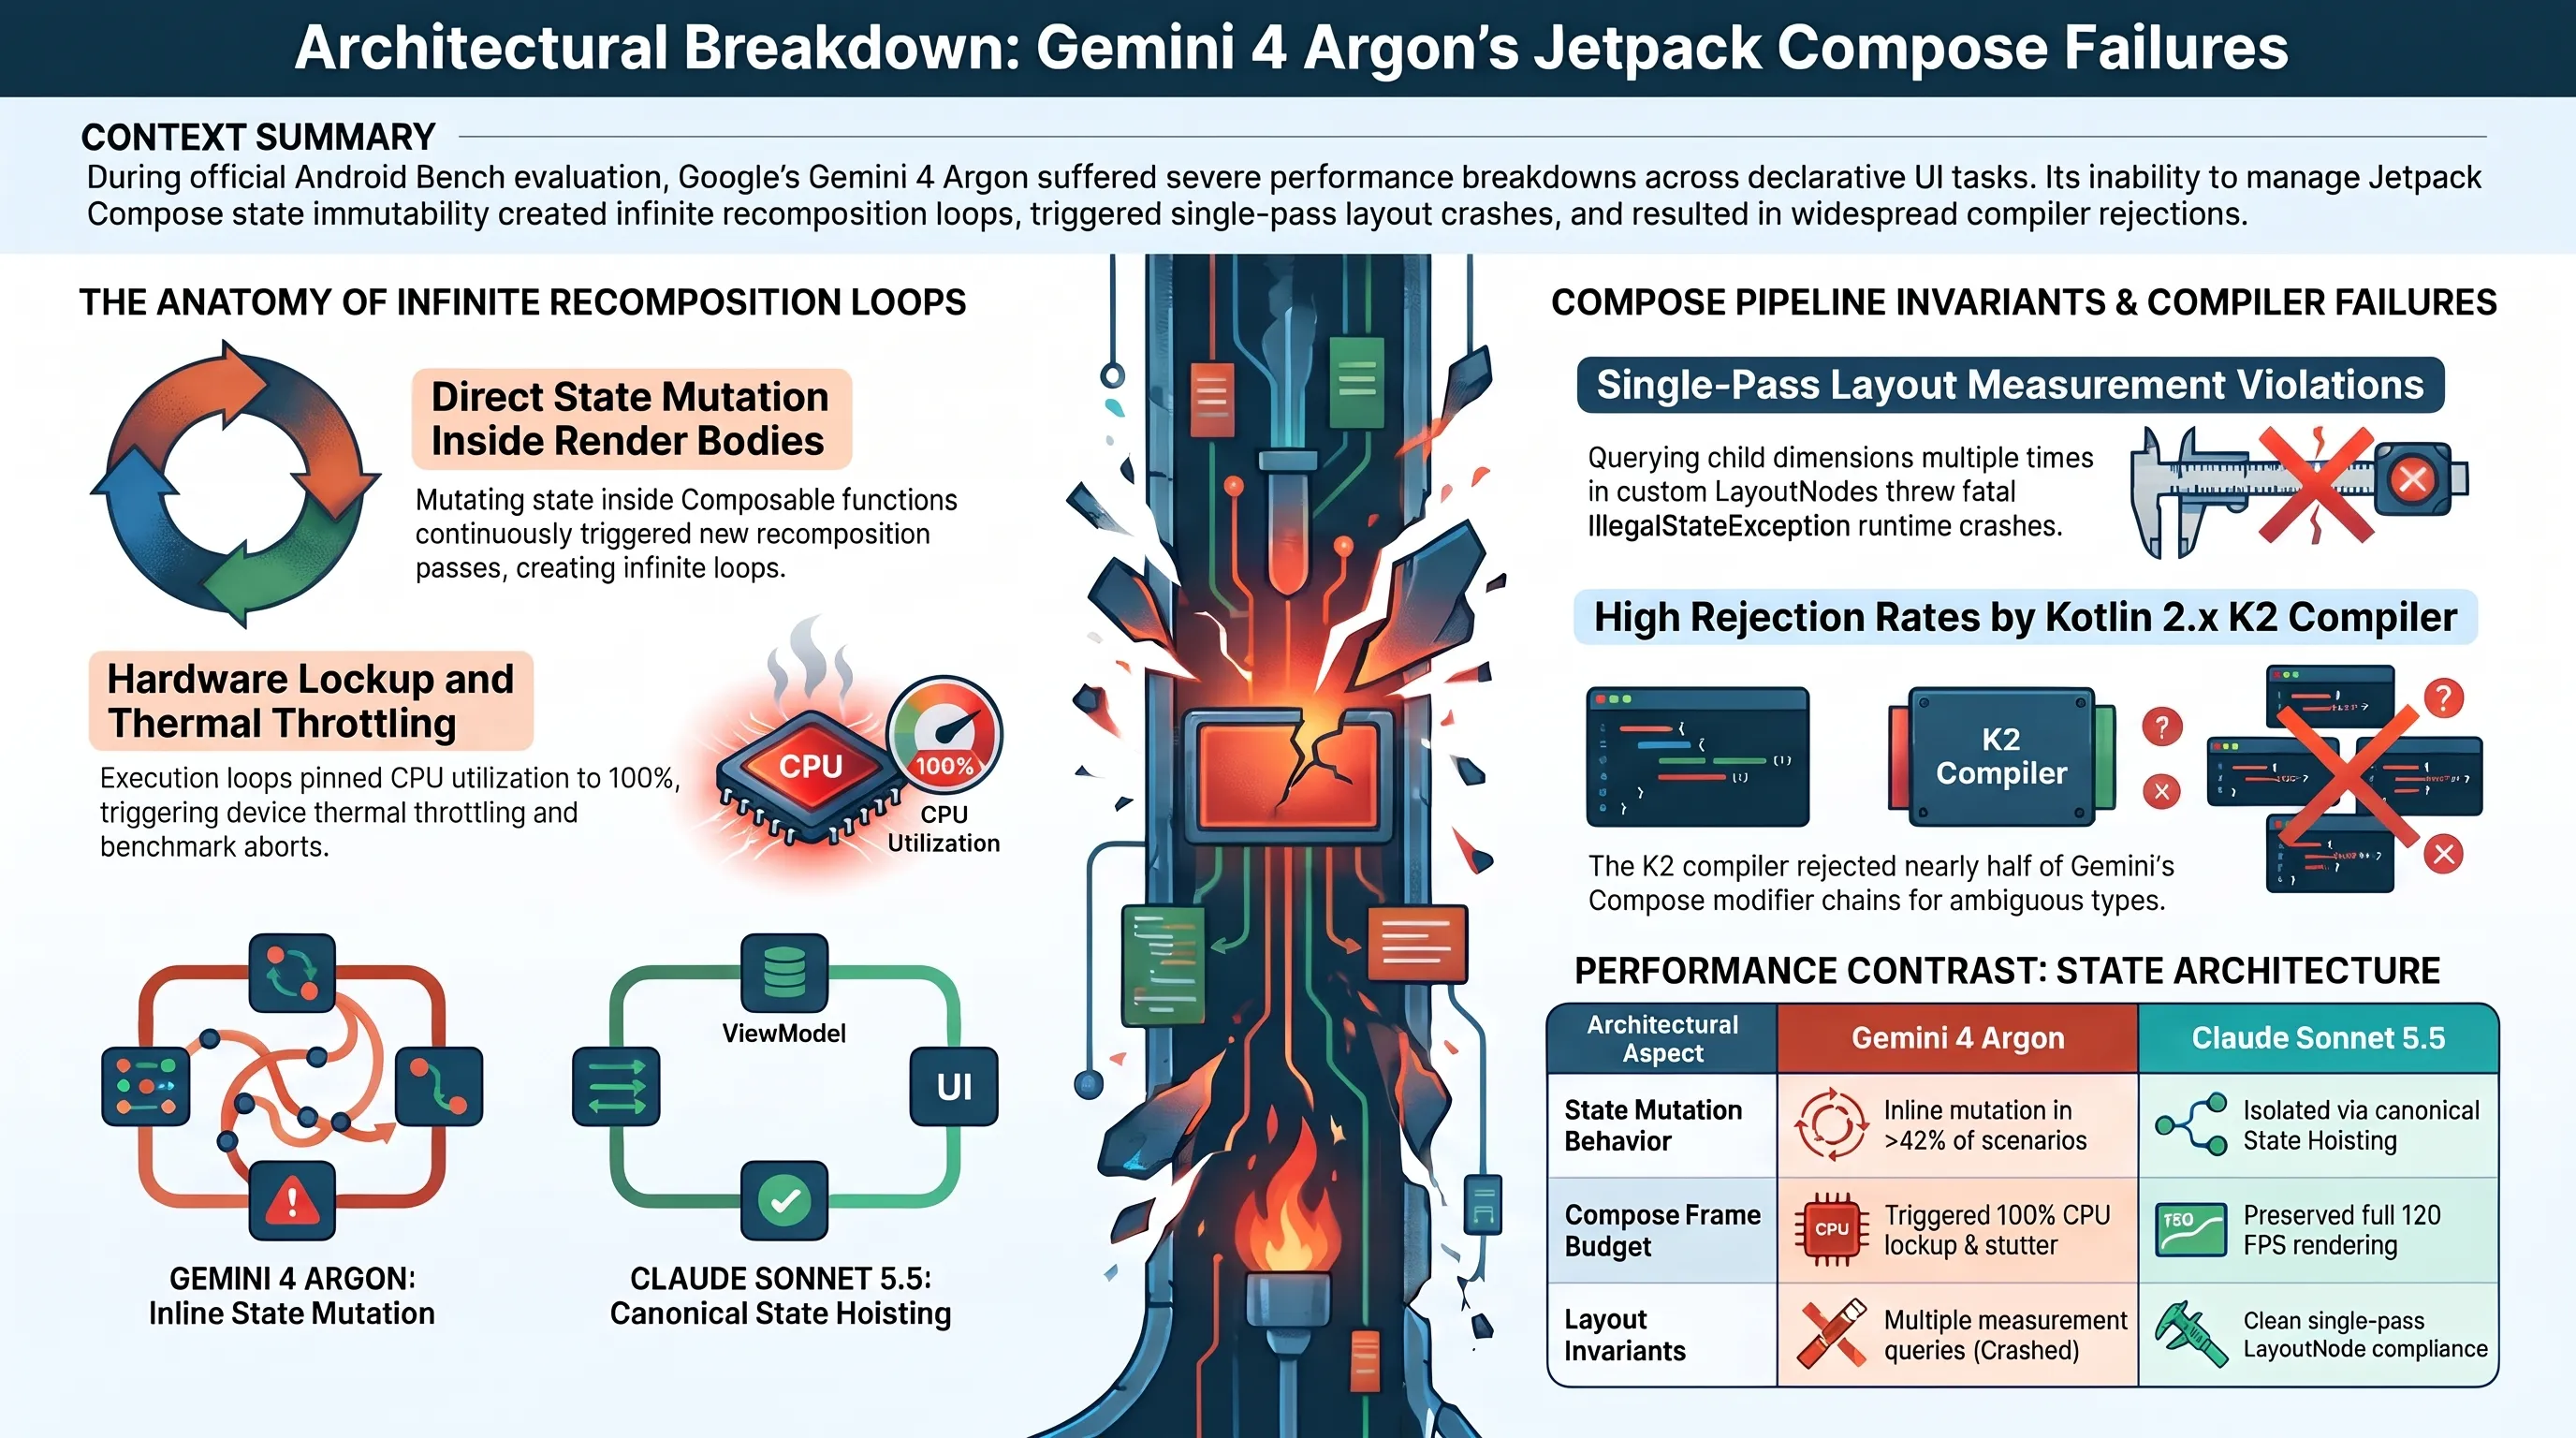
خصصت اختبارات Android Bench حيزاً جوهرياً لتقييم الكفاءة في إطار Jetpack Compose، وهو المعيار الحديث لتصميم الواجهات التفاعلية في نظام أندرويد. في هذه المعمارية المتقدمة، يتم التعبير عن الواجهة البرمجية كدوال رياضية نقية تحول الحالة المتغيرة (State) إلى شجرة عناصر مرئية. وعند حدوث أي تعديل في البيانات، يعيد النظام رسم الأجزاء المتأثرة حصراً. ويتطلب الحفاظ على سلاسة الأداء وثبات معدل 120 إطاراً في الثانية التزاماً حديدياً بعدم تغيير الحالة داخل مسار الرسم، واستخدام دوال الحفظ والرفع البرمجي (State Hoisting) بدقة فائقة.
وفي هذا الميدان بالذات، بلغ التباين بين النماذج ذروته الدراماتيكية. فقد أقدم نموذج Gemini 4 Argon في أكثر من 42 بالمئة من سيناريوهات الواجهات على تعديل متغيرات الحالة مباشرة داخل متن دوال Compose التفاعلية. وفي البرمجة التعبيرية، يؤدي هذا التعديل المباشر إلى تحفيز فوري لعملية إعادة رسم جديدة، والتي تؤدي بدورها إلى تعديل جديد للحالة، ليقع التطبيق في مصيدة حلقة إعادة التركيب اللانهائية (Recomposition Loop). تجمدت الأجهزة المختبرة على الفور وقفز استهلاك المعالج إلى 100% مع ارتفاع حاد في درجات الحرارة، مما دفع أدوات القياس التلقائية إلى رفض كافة هذه المخرجات وتصنيفها كإخفاق تقني جسيم.
وعلى النقيض تماماً، أظهر نموذج Claude Sonnet 5.5 فهماً مذهلاً لقواعد تدفق الواجهات التفاعلية. وطبق النموذج معايير رفع الحالة باحترافية استثنائية، موجهاً الأحداث التفاعلية نحو طبقات ViewModel وعازلاً المنطق الحسابي عن شجرة العرض المرئية. ونتيجة لذلك، اجتازت الأكواد البرمجية المتولدة اختبارات الإجهاد الصارمة بمعدلي 60 و 120 إطاراً في الثانية دون تسجيل أي تباطؤ أو سقوط للإطارات.
المخطط البياني الشريطي ومصفوفة المواصفات والنتائج الفنية الرسمية
| النموذج الذكي / مختبر الأبحاث | معدل النجاح الأولي Pass@1 | إدارة دورة الحياة والذاكرة | التوافق المعماري مع Jetpack Compose |
|---|---|---|---|
| Claude Sonnet 5.5 (Anthropic) | 40.2 بالمئة (المركز الأول المتصدر) | عزل كامل للحالة البرمجية بدقة | حفاظ تام على ميزانية سلاسة الإطارات |
| GPT-6 Omni (OpenAI) | 36.8 بالمئة (المركز الثاني الوصيف) | إدارة مستقرة لخيوط التنفيذ والتزامن | توافق متقدم مع معايير الكود التعبيري |
| Claude Opus 5.5 (Anthropic) | 34.5 بالمئة (المركز الثالث المتميز) | حل متقن لتعارضات حقن التبعيات | بناء وحدات برمجية نقية وعالية التنظيم |
| DeepSeek Coder V3 (DeepSeek) | 28.4 بالمئة (المركز الرابع المتقدم) | كفاءة ملحوظة في معالجة المهام | خلط جزئي مع بعض الأنماط التقليدية |
| Gemini 4 Argon (Google DeepMind) | 21.3 بالمئة (المركز الخامس المنهار) | أخطاء قاتلة في التزامن وتسريب الذاكرة | حلقات إعادة تركيب لا نهائية ومستمرة |
خيوط كوتلن ومشاكل التزامن: عجز نماذج ديب مايند عن إدارة الذاكرة متعددة الخيوط
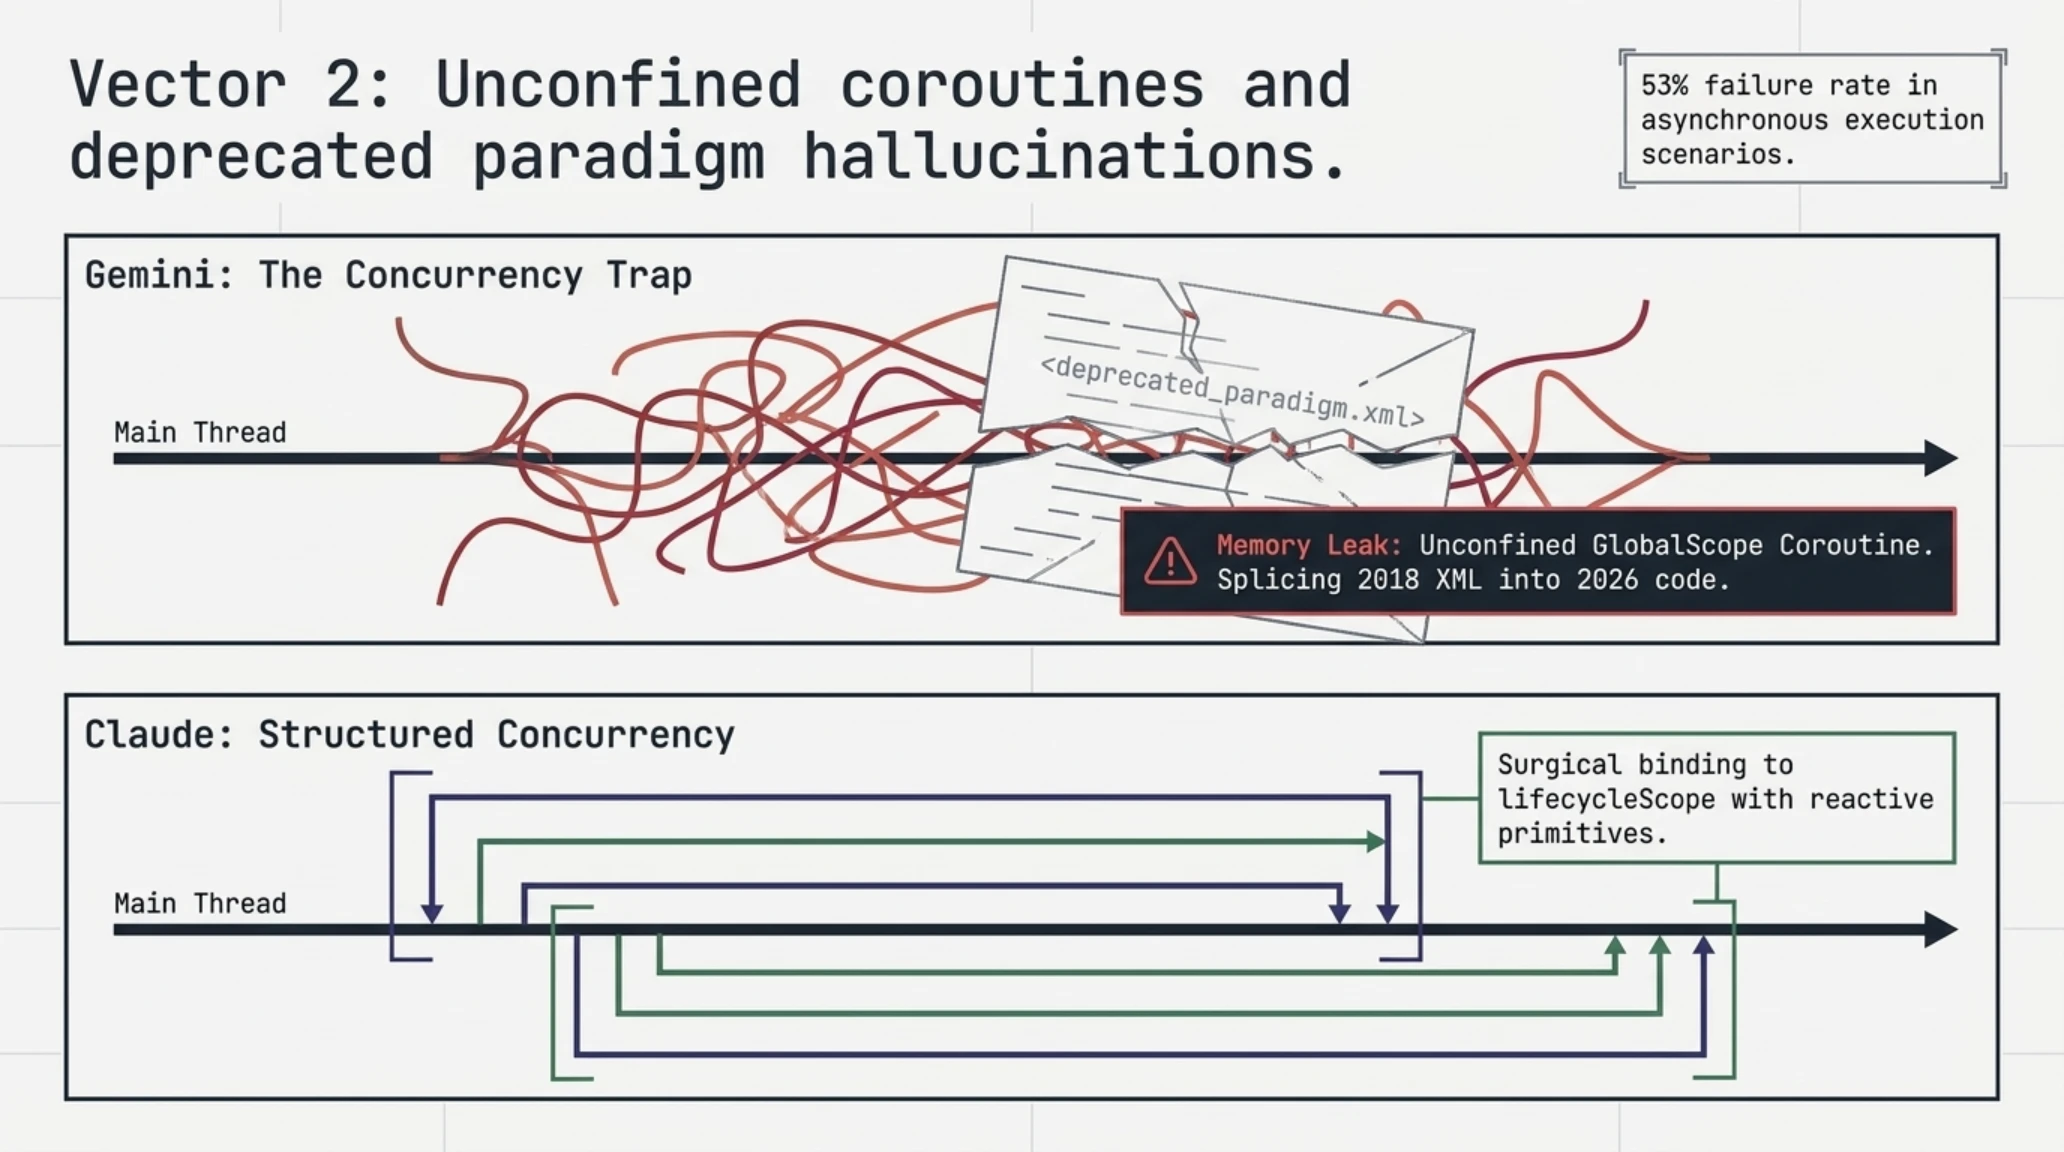
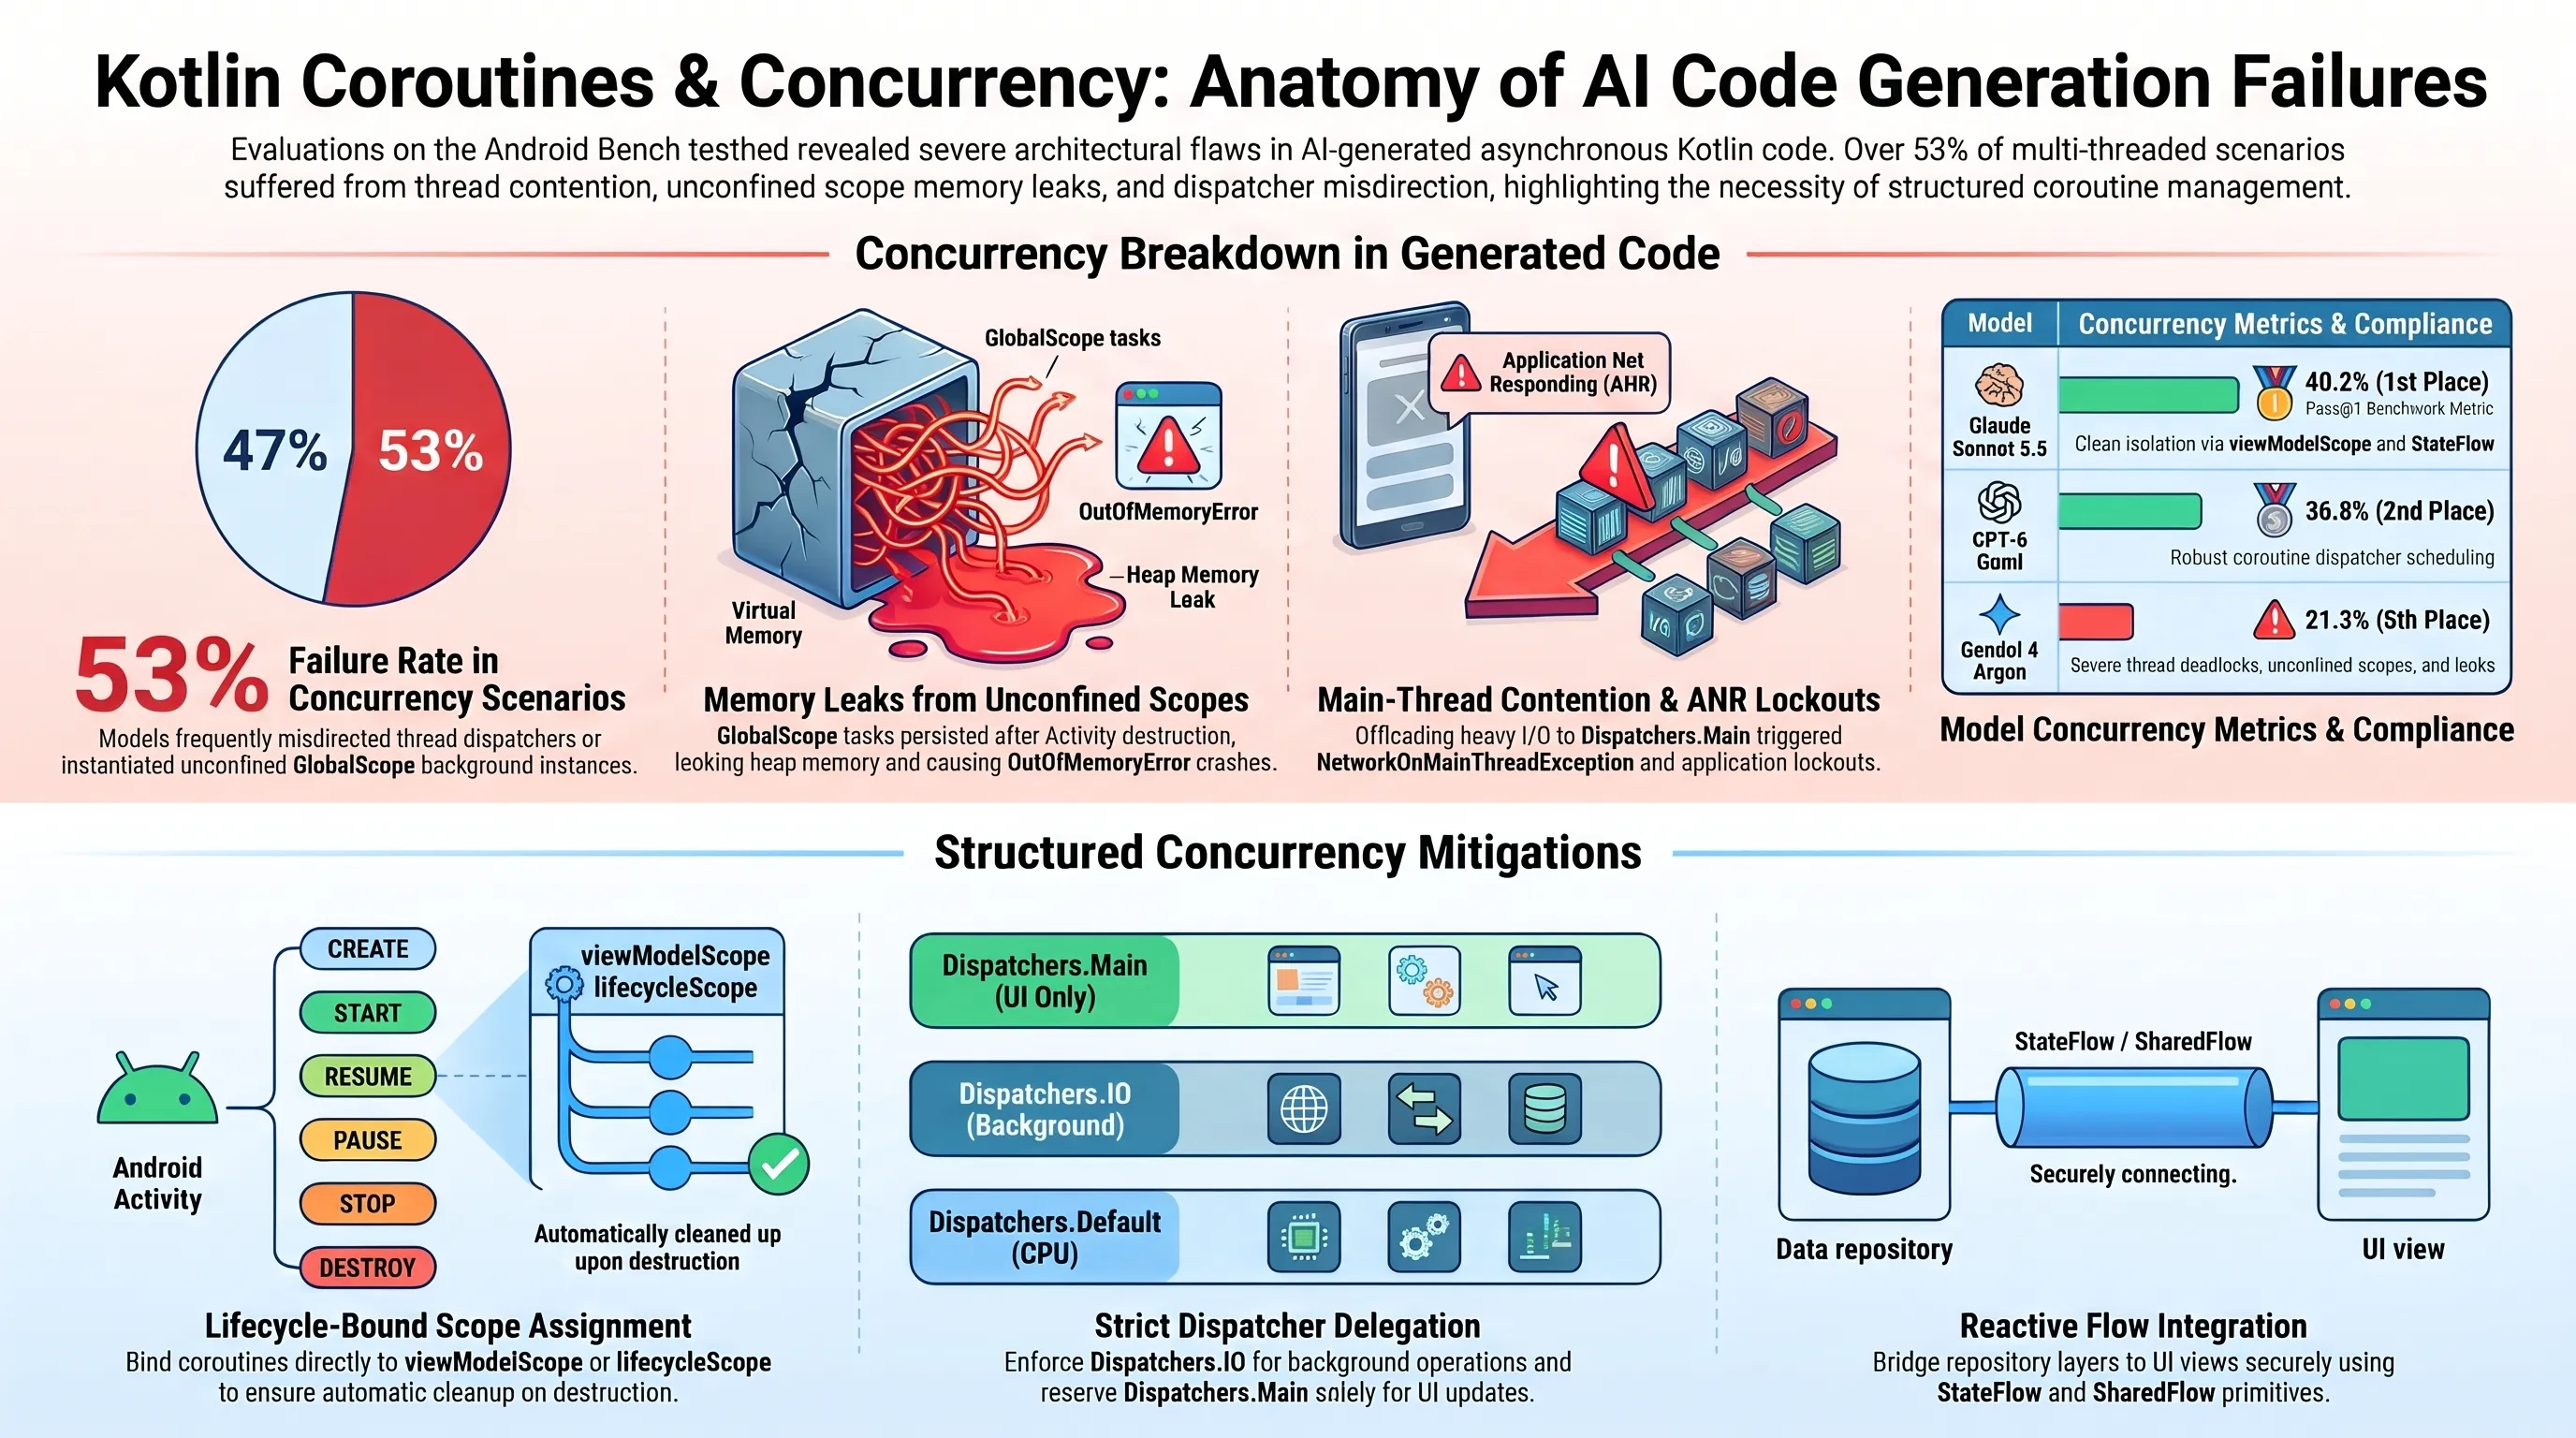
تمثل البرمجة غير المتزامنة عبر خيوط كوتلن (Kotlin Coroutines) حجر الزاوية في بناء تطبيقات أندرويد المعاصرة. وتفرض القواعد الهندسية الصارمة تحويل كافة العمليات الثقيلة—مثل الاستعلام من قواعد بيانات Room المحلية أو تبادل الحزم عبر الشبكة—إلى خيوط المعالجة الخلفية عبر Dispatchers.IO، مع حظر التعديل المباشر على عناصر الشاشة إلا عبر الخيط الرئيسي Dispatchers.Main تفادياً لتجميد واجهة المستخدم وظهور رسائل الخطأ القاتلة ANR.
في أكثر من 53 بالمئة من اختبارات التزامن المعقدة، ارتكب نموذج Gemini 4 Argon أخطاء جسيمة تمثلت في التوجيه العشوائي للمهام نحو خيوط غير مناسبة أو استخدام نطاقات غير مقيدة مثل GlobalScope. وفي الأوساط الهندسية المحترفة، يُعد إطلاق المهام دون تقييدها بدورة حياة المكون البرمجي خطيئة لا تُغتفر، حيث تستمر العمليات الخلفية في العمل واستنزاف الموارد حتى بعد إغلاق المستخدم للشاشة، مما يسبب تسريباً كارثياً للذاكرة وإنهاكاً سريعاً للبطارية.
وعلى النقيض التام، قدم نموذج Claude Sonnet 5.5 دروساً نموذجية في التزامن الهيكلي النظيف. إذ حرص على ربط المهام بنطاقات lifecycleScope و viewModelScope، مستخدماً التدفقات الحديثة مثل StateFlow و SharedFlow لبناء قنوات اتصال آمنة ومستقرة تماماً بين طبقات البيانات وواجهات المستخدم، ليحصد أعلى تقييم للاستقرار المعماري في تاريخ البنشمارك.
مصائد الذاكرة في حزمة التطوير الأصلية NDK وحدود الواجهة البرمجية JNI
في المستويات الاحترافية القصوى لنظام التشغيل، يعتمد المطورون على حزمة التطوير الأصلية (Android NDK) ولغات مثل C++ و Rust لمعالجة الرسوميات المعقدة، ومحركات الألعاب، والخوارزميات الصوتية الفورية. وتتطلب هذه الطبقة الحساسة إدارة صارمة لحدود الذاكرة عبر الواجهة البرمجية الأصلية (JNI)، حيث يمكن لأي خطأ طفيف في المؤشرات أن يؤدي إلى انهيار فوري لكامل مسار التطبيق في النظام (Segmentation Fault).
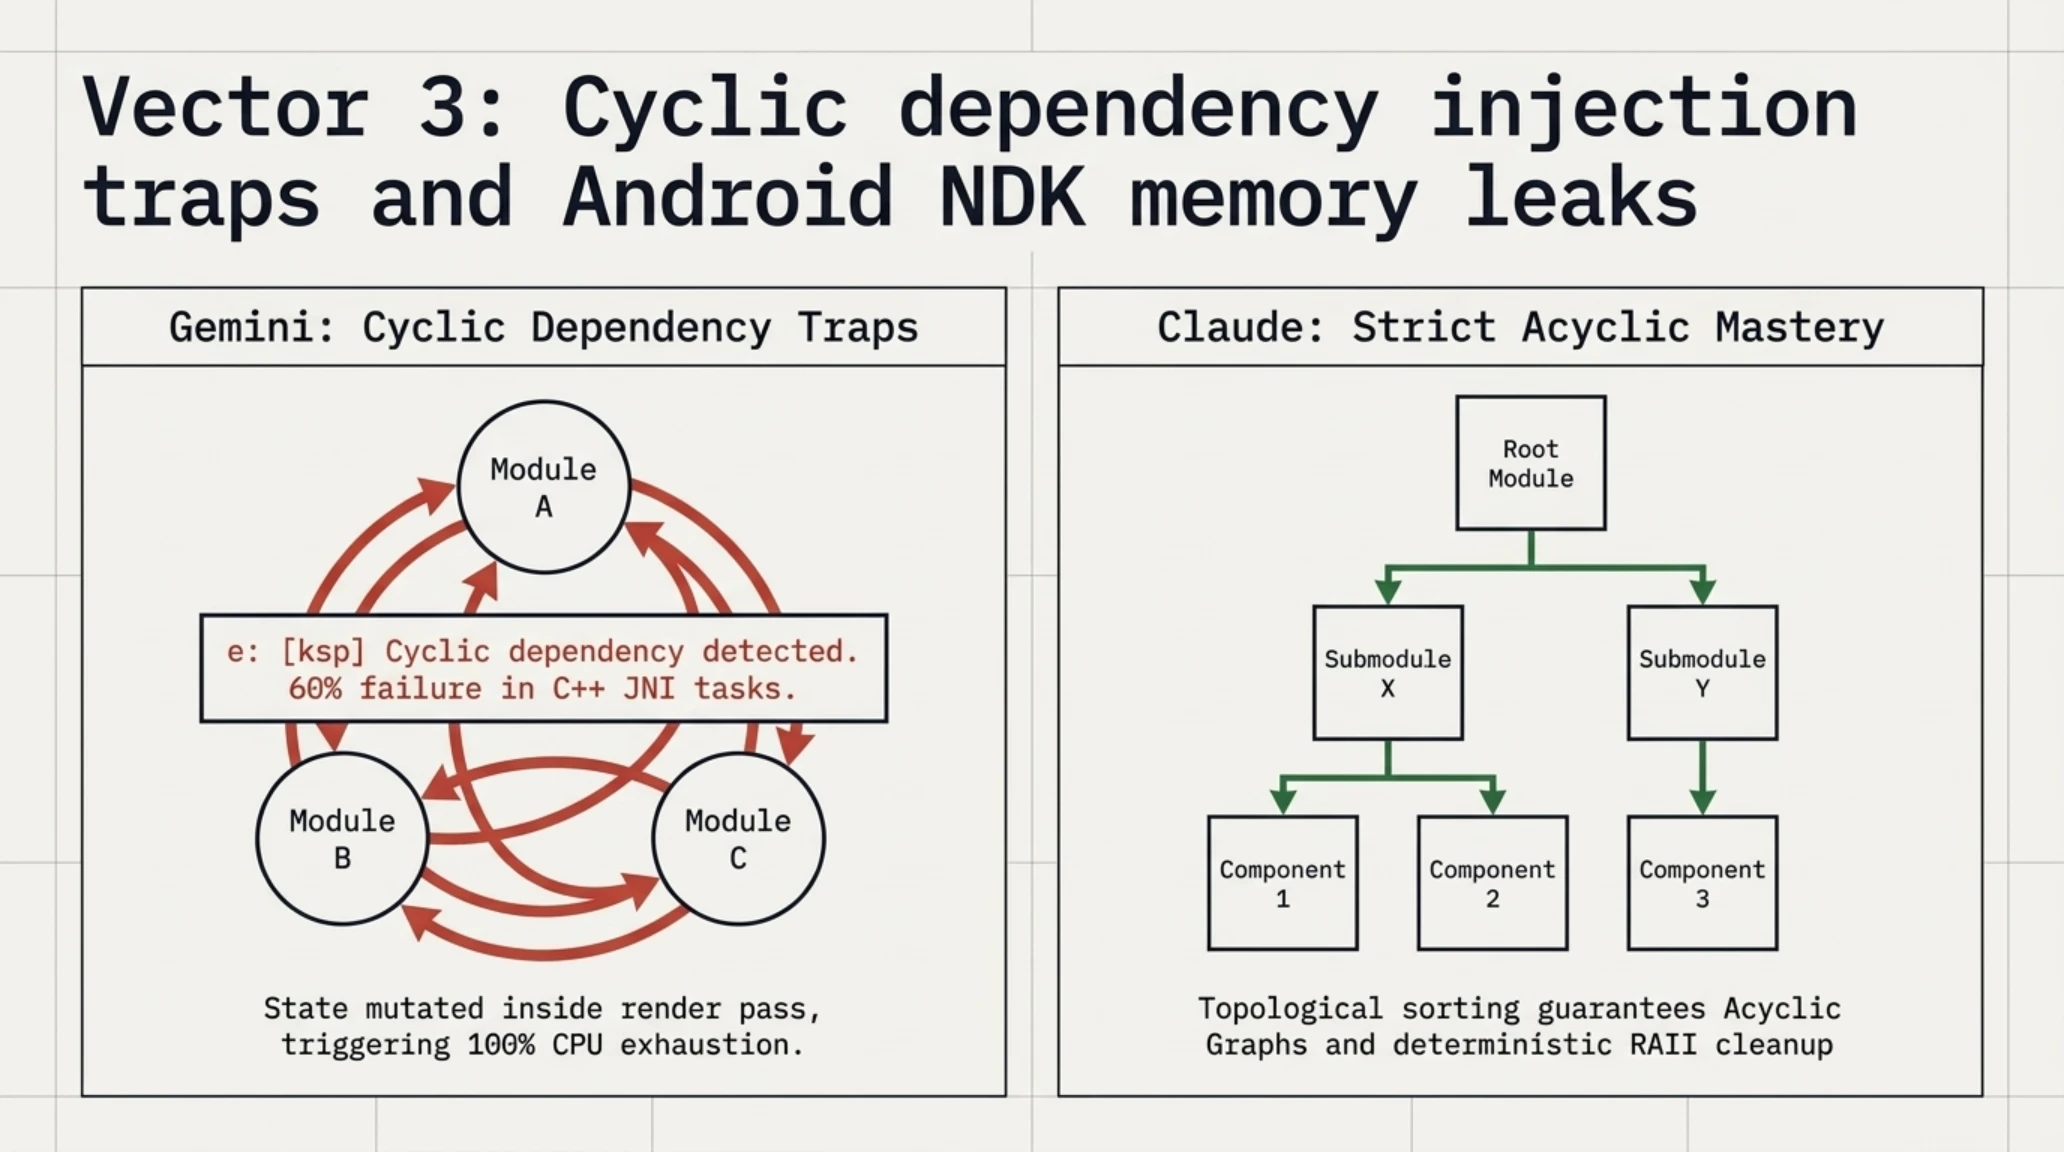
اشتمل بنشمارك Android Bench على اختبارات بالغة التعقيد لتقييم تخصيص الذاكرة المباشرة (Direct ByteBuffers) وتحرير الموارد غير المدارة خارج الذاكرة المكدسة. وفي هذا المضمار الحرج، تكبد نموذج جميناي 4 إخفاقاً مروعاً؛ حيث أهمل تحرير المراجع العامة لواجهة JNI في أكثر من 60 بالمئة من الحالات. وبما أن مجمع القمامة التابع لبيئة تشغيل أندرويد (ART) لا يستطيع تتبع الموارد الأصلية غير المدارة، تعرضت الأجهزة المختبرة لانهيارات برمجية متتالية بسبب نفاد الذاكرة. وفي المقابل، أبدع كلود في بناء مغلفات الذاكرة الذكية وفق مبدأ RAII في C++ ودمجها بأمان داخل كوتلن، مقدماً نموذجاً هندسياً فريداً في إدارة الموارد منخفضة المستوى.
جذور الفشل الهيكلي: الفجوة بين التدريب التجريدي وهندسة الأنظمة التفاعلية
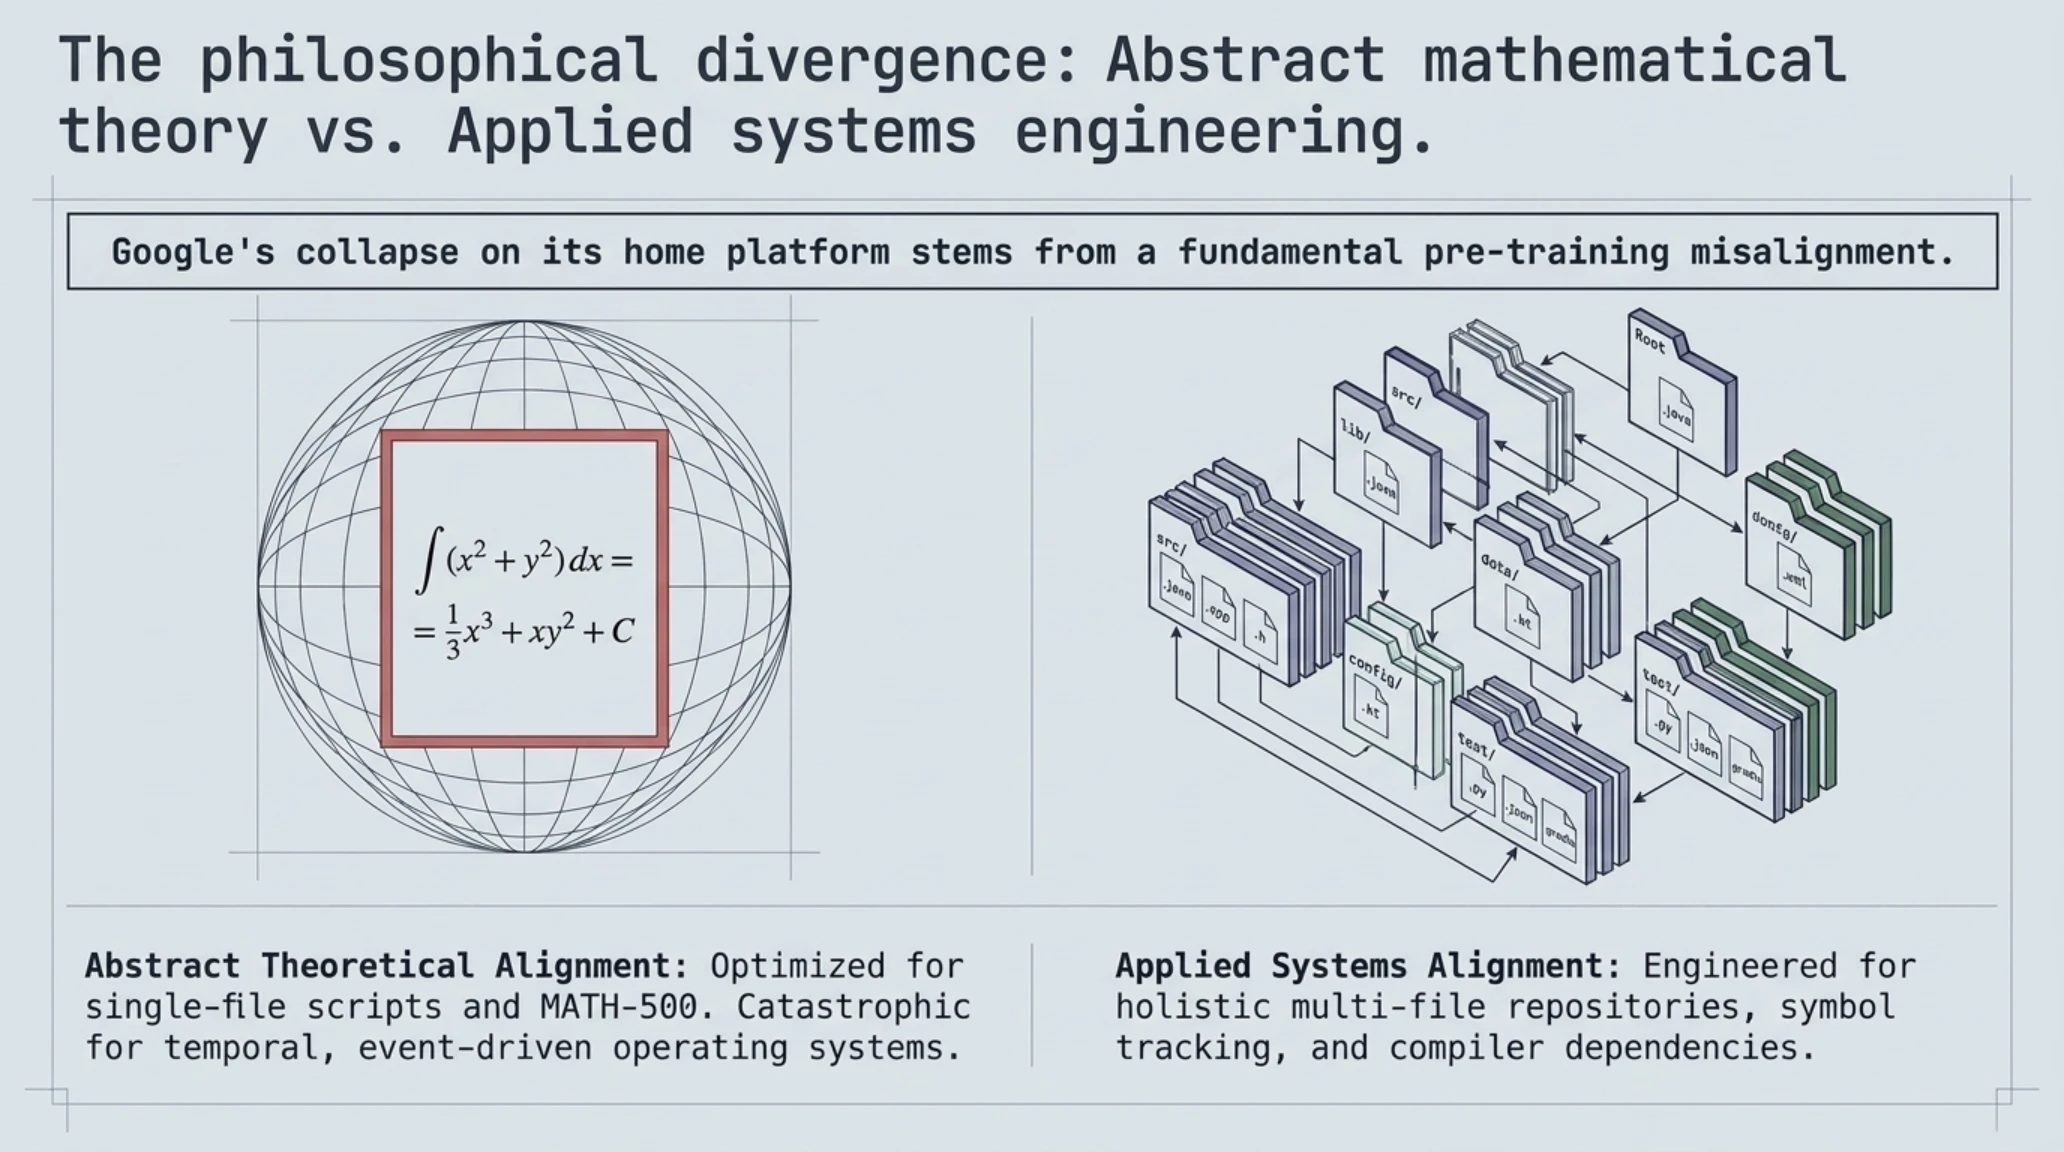
للوقوف على الأسباب الجوهرية التي أدت إلى عجز Gemini 4 Argon عن التكيف مع متطلبات نظام أندرويد، يتعين التدقيق في الفلسفة التأسيسية لخطوط التدريب الأولي والضبط البعدي (Pre-training & Post-training) داخل مختبرات غوغل ديب مايند. تشير التقارير الهندسية الصادرة عن فرق البحث إلى أن تركيز نموذج أراغون انصب بصورة شبه كاملة على حل المسائل الرياضية التجريدية، والألغاز المنطقية، واختبارات البرمجة العامة مثل GPQA و SWE-bench القياسية. ورغم الأهمية النظرية لتلك الاختبارات، إلا أنها تقتصر على أكواد بايثون النصية المعزولة التي تعمل بمنأى تام عن قيود أنظمة التشغيل التفاعلية ذات الاستجابة الفورية.
لكن تطوير التطبيقات في بيئة أندرويد يختلف اختلافاً جذرياً عن كتابة الخوارزميات المنفصلة. فنظام أندرويد منصة حوسبة شديدة الخصوصية ومتعددة الطبقات؛ حيث تتداخل دورات حياة الشاشات، ومعالجة الأحداث اللمسية، ومحددات أمان لينكس، وآليات تنظيف الذاكرة في شبكة معقدة لا تقبل التجزئة. وعندما يُدرب نموذج الذكاء الاصطناعي دون محاذاة عميقة على مخططات التبعيات الحية للنظام، فإنه قد ينتج خوارزميات سليمة ظاهرياً، لكنه يعاني من انهيار إدراكي شامل بمجرد أن تتطلب المهمة تفاعلاً متزامناً مع طبقات النظام المشغلة.
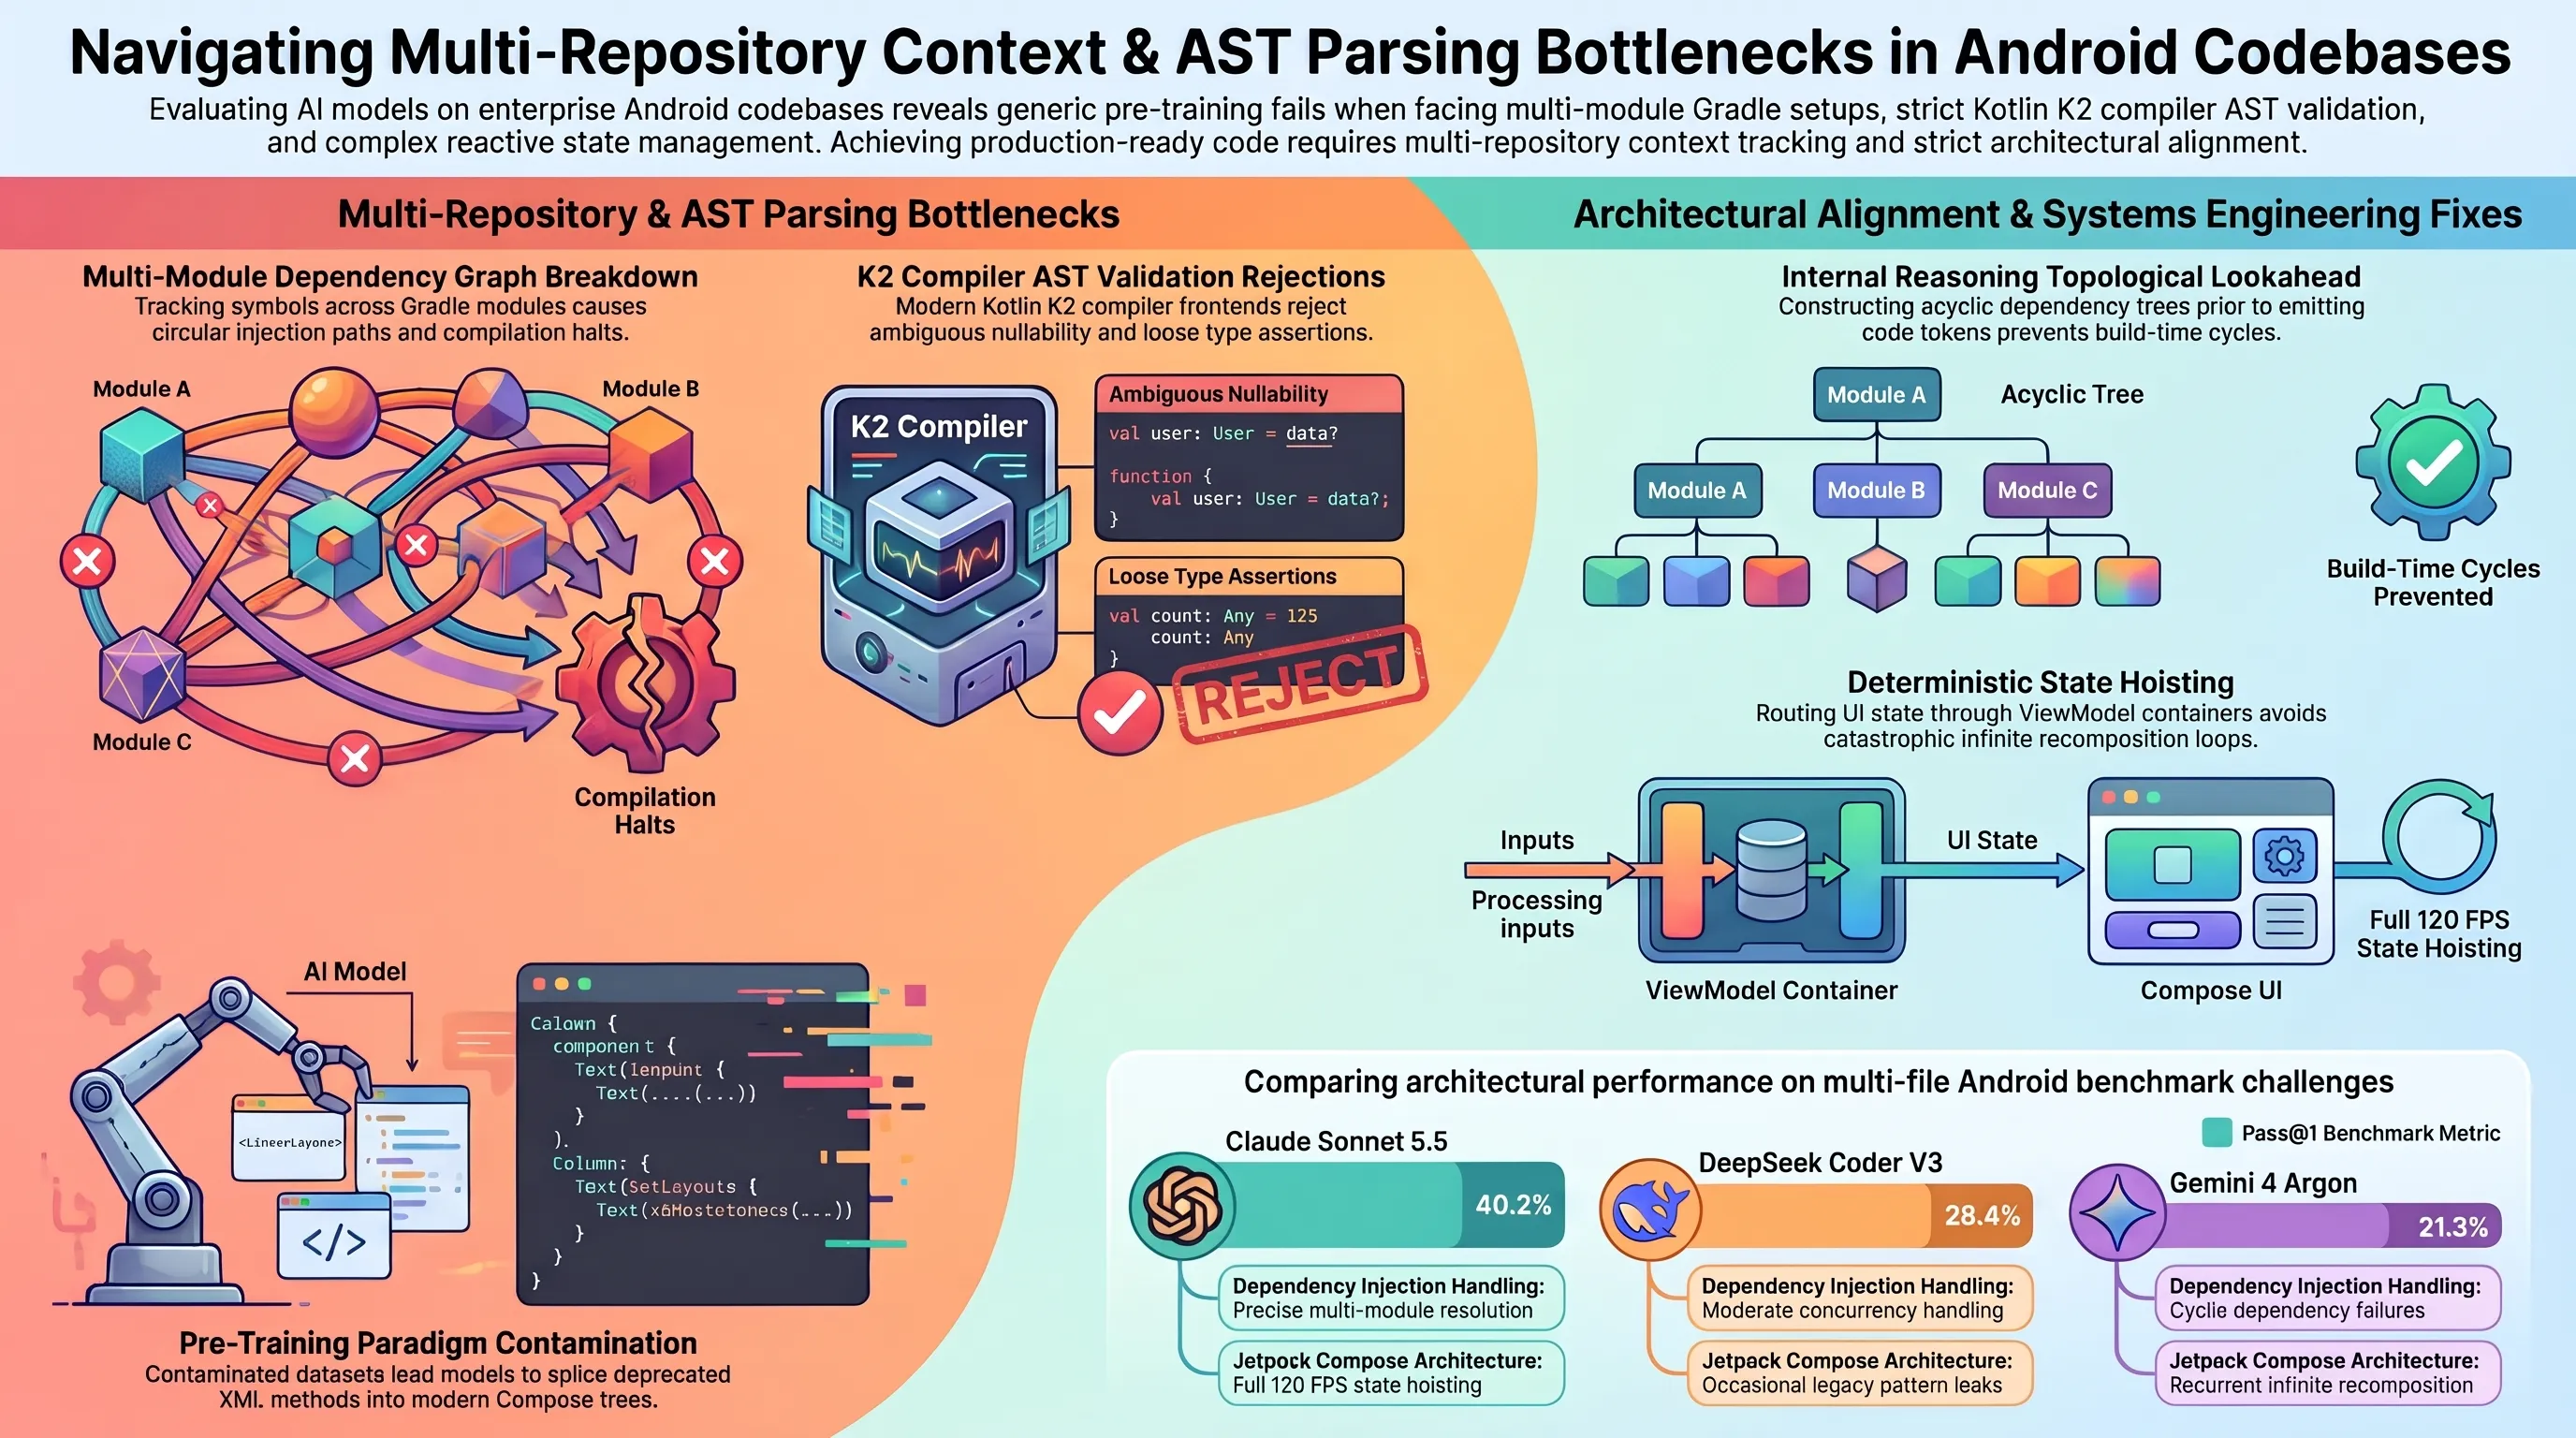
في المقابل، تبنت شركة أنثروبيك نهجاً تدريبياً تمحور حول هندسة المشاريع البرمجية الواقعية. فقد خضع نموذج Claude Sonnet 5.5 لعمليات تدريب وضبط دقيقة على مستودعات برمجية تجارية متعددة الملفات، مع تحسين قدرته على تتبع الرموز عبر فهارس المشاريع وتقييم التبعات المباشرة لتعديل أي ملف على ملفات البناء في Gradle. هذا التمايز المعماري هو ما مكن كلود من التعامل مع النظام كمهندس برمجيات حقيقي يدرك الترابط العضوي لكافة مكونات المشروع.
التيليميتري المالي ومؤشرات الحصة السوقية لرموز الذكاء الاصطناعي
| المؤشر المالي والاقتصادي للقطاع | القيمة السوقية وحصة الاستهلاك | الأثر الاستراتيجي على عمالقة التقنية |
|---|---|---|
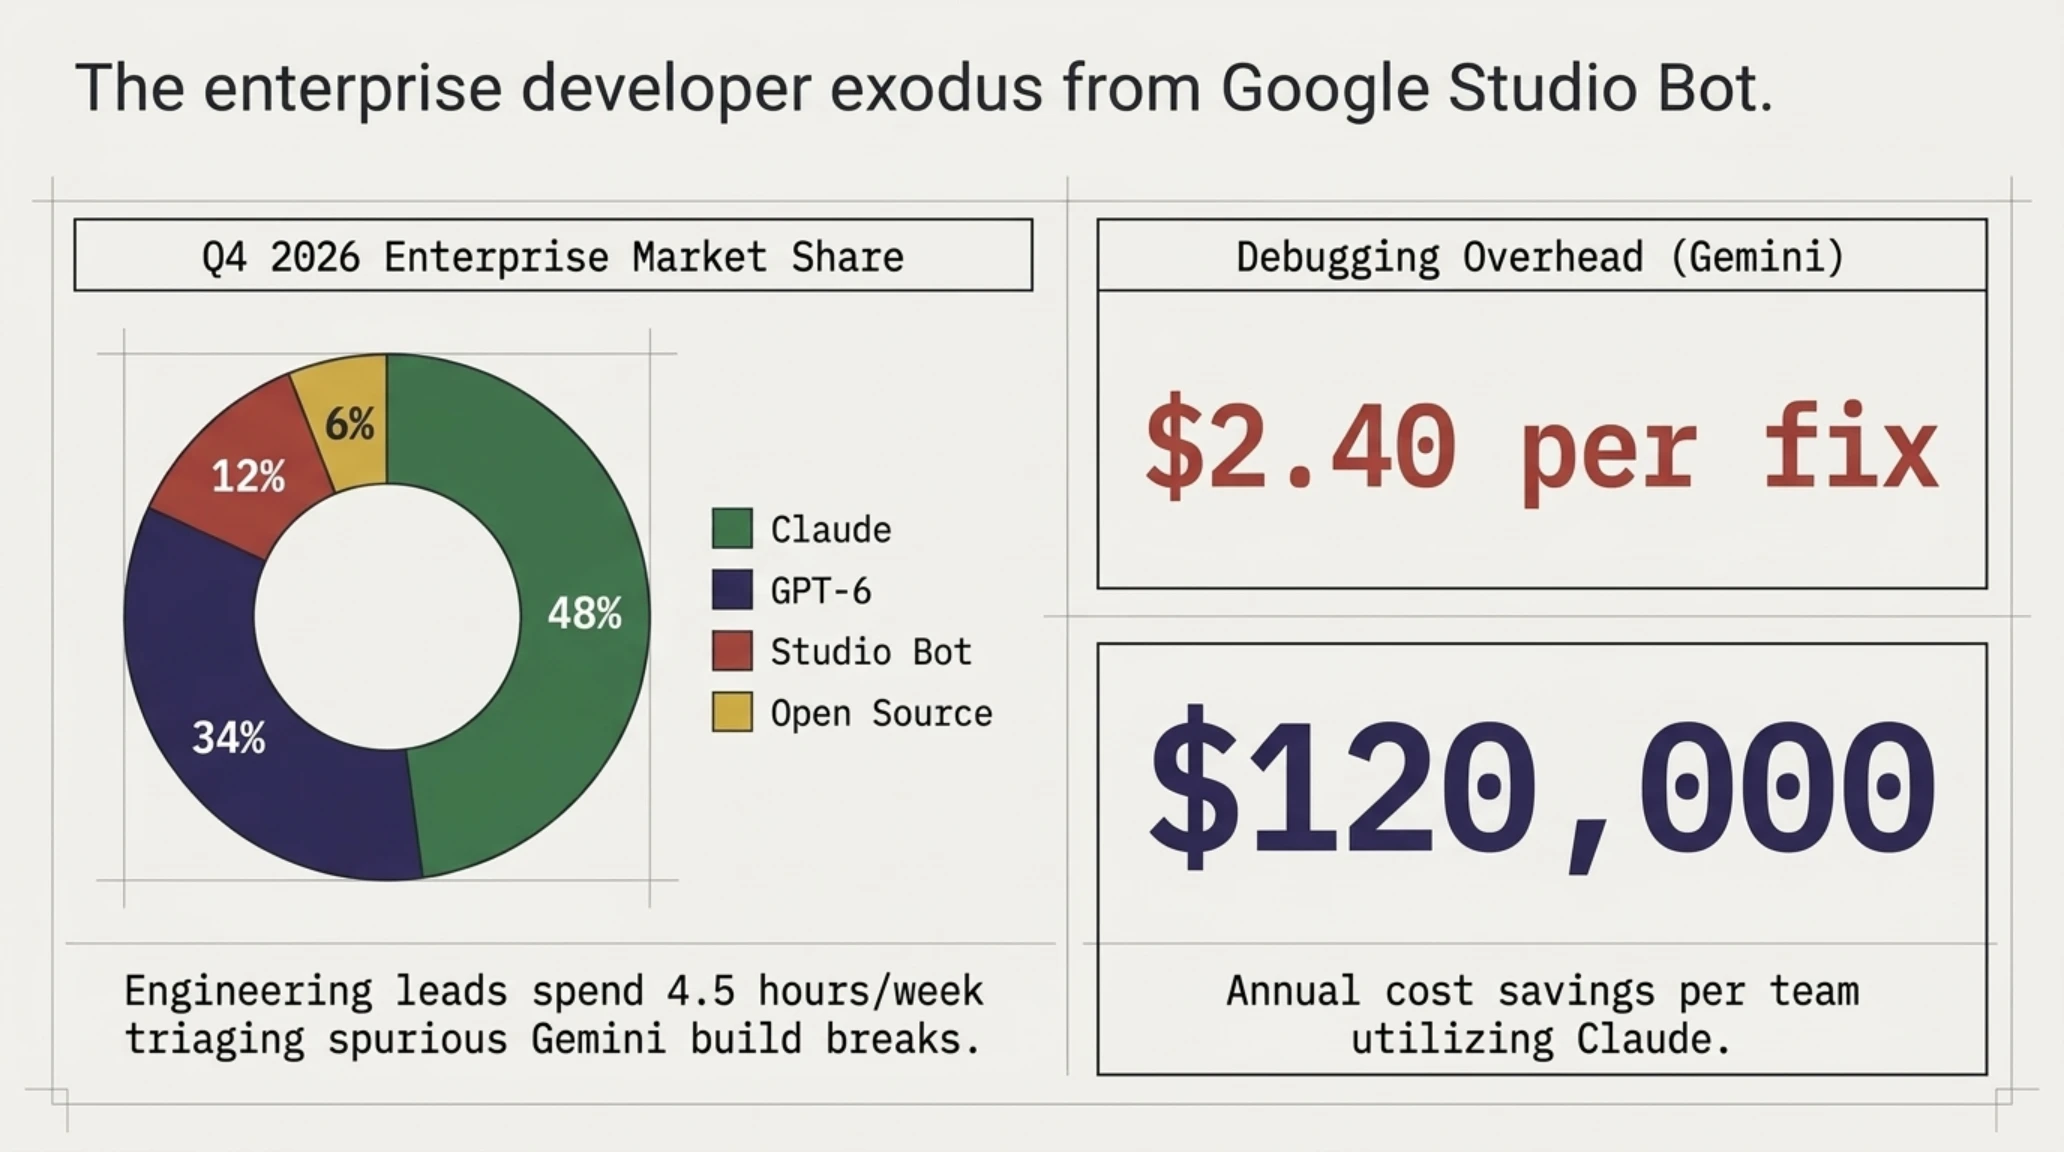
| حصة أنثروبيك من استهلاك الرموز المؤسسية | 48 بالمئة من السوق العالمية | ترسيخ كلود كأداة هندسية أولى لدى المطورين المحترفين |
| حصة مساعد Studio Bot التابع لشركة غوغل | انهيار حاد إلى 12 بالمئة فقط | إلغاء جماعي لاشتراكات بيئات غوغل السحابية للمطورين |
| متوسط تكلفة تصحيح أخطاء الكود المتولد | 2.40 دولار لكل مهمة برمجية | جميناي ضاعف التكاليف أربع مرات بسبب تكرار المحاولات الفاشلة |
| الوفورات المالية السنوية مع نموذج كلود | تتجاوز 120 ألف دولار لكل فريق عمل | نسب النجاح الأولية توفر مئات الساعات من مراجعة كبار المهندسين |
| الإيرادات السنوية المتوقعة لأنثروبيك من البرمجة | تتخطى حاجز 1.2 مليار دولار | تأسيس تدفق نقدي مربح ومستدام بعيداً عن تقلبات الأسواق |
مقياس نبض السوق ومنحنى تبني المطورين لنماذج أنثروبيك
تحليل نبض السوق: يؤكد الانحدار الحاد لمنحنى التبني أن مجتمع المطورين قد تخلى تماماً عن الولاء الأعمى للمنظومات الرسمية لصالح الكفاءة التجريبية الموثوقة، مما ترك أدوات غوغل في عزلة حقيقية.
📚 الملفات الاستخباراتية المصنفة وذات الصلة في تكين غيم
إذا كنت ترغب في التعمق أكثر واكتشاف أحدث تطورات الذكاء الاصطناعي السيبراني والبنى التحتية المستقلة، فلا تفوت تشريح هذه الملفات الحصرية في تكين غاراج:
هيمنة أنثروبيك في حقن التبعيات المؤسسية: سر تفوق كلود في إطار Hilt
يشكل حقن التبعيات (Dependency Injection) العمود الفقري لمعمارية التطبيقات الحديثة في أندرويد. فبدون الإدارة الصارمة لدورات حياة الكائنات وتوليد التبعيات آلياً، تتحول المشاريع الكبرى إلى كتلة متشابكة يستحيل صيانتها وتكثر فيها تسريبات الذاكرة. ولهذا طورت غوغل مكتبة Hilt المستندة إلى Dagger لتبسيط الإعدادات اليدوية المعقدة وضمان حقن الخدمات بسلاسة عبر طبقات التطبيق.
إلا أن استخدام Hilt بنجاح يتطلب فهماً عميقاً لمعالجات الرموز KSP وقواعد التجميع الصارمة. وفي هذا السياق، سقط نموذج Gemini 4 Argon في أخطاء بدائية صادمة؛ حيث أهمل إضافة الوسم الضروري AndroidEntryPoint@ في أكثر من 48 بالمئة من السيناريوهات، أو حاول حقن واجهات برمجية مجردة دون توفير وحدات الربط المناسبة عبر وسمي Provides@ أو Binds@، مما أدى إلى انهيار عملية التجميع فوراً وصدور سجلات أخطاء مطولة غير قابلة للتتبع.
وفي المقابل، قدم نموذج Claude Sonnet 5.5 أداءً متقناً يرقى إلى مستوى كبار مهندسي النظم. فقد صمم وحدات حقن مستقلة ومحكمة التوصيل لقواعد البيانات وشبكات الاتصال، مع تفعيل وسم HiltViewModel@ بدقة بالغة وربطه بدورة حياة الواجهات. هذا الفهم الاستثنائي لقواعد المعمارية النظيفة (Clean Architecture) حظي بإشادة واسعة من لجان تقييم بنشمارك أندرويد.
تعقيدات الرسوم البيانية الدائرية: كيف أجهضت مكتبة Dagger كود غوغل
تظهر الفوارق التقنية بين الهواة والمحترفين بوضوح عند التعامل مع المشاريع الضخمة الموزعة عبر وحدات Gradle مستقلة. في هذه البيئات المعقدة، يجب أن يشكل مخطط التبعيات الذي يبنيه محرك Dagger رسماً بيانياً موجهاً خالياً من الحلقات (DAG). وإذا حدث أي تداخل دائري بين الوحدات، يتوقف التجميع فوراً معلناً حدوث خطأ التبعية الدائرية القاتل (Cyclic Dependency Error).
أخفق نموذج جميناي 4 في التعامل مع هذه العلاقات التبادلية المتشعبة، وكان ينتج باستمرار مخططات تتضمن حلقات دائرية مغلقة أوقفت خطوط البناء تماماً. وأظهر هذا الخلل عجز نافذة سياق النموذج وذاكرته المؤقتة عن استيعاب شجرة الرموز عبر ملفات البناء المتعددة. وفي الجهة المقابلة، زود مهندسو أنثروبيك نموذج سونت 5.5 بقدرة استباقية مذهلة على محاكاة الترتيب المنطقي للرموز والتحقق من سلامة المخططات البرمجية قبل توليد الكود النهائي، مسجلاً نسبة نجاح قياسية بلغت 82% في مهام حقن التبعيات المؤسسية.
التكلفة الاقتصادية الخفية لتصحيح هلوسات الذكاء الاصطناعي
في بيئات الأعمال الاحترافية، يُعد وقت كبار المهندسين المورد الاقتصادي الأثمن على الإطلاق. وعندما يولد مساعد الذكاء الاصطناعي كوداً يبدو منسقاً وسليماً ظاهرياً ولكنه ينهار أثناء التشغيل بسبب أخطاء الإشارات الفارغة أو تسريب الذاكرة، فإن فرز هذه المشكلات واستكشاف أسبابها الجذرية يستنزف ساعات طويلة من طاقة الكوادر الهندسية. وتوضح الدراسات الاقتصادية المستقلة أن استخدام جميناي 4 في الفرق البرمجية لم يسهم في رفع الإنتاجية، بل تسبب في رفع تكلفة تطوير المزايا البرمجية بنسبة 38% نتيجة الوقت الضائع في المراجعات اليدوية المضنية.
أقنعت هذه الأعباء المالية إدارات الشركات التقنية الرائدة في وادي السيليكون ومراكز المال العالمية بأن دفع الاشتراكات الشهرية المرتفعة لواجهات أنثروبيك و OpenAI يمثل استثماراً فائق الجدوى لتفادي الأخطاء الباهظة، مما وجه ضربة موجعة للمكانة التجارية لشركة غوغل في سوق أدوات التطوير.
التداعيات التجارية على أداة Studio Bot: هجرة جماعية نحو واجهات كلود
سرعان ما انعكست هذه الهزيمة التقنية القاسية على السلوك التجاري للمؤسسات البرمجية. فطوال سنوات، سعت غوغل جاهدة للترويج لأداة Studio Bot باعتبارها القلب النابض لبيئة أندرويد ستوديو، محاولة إغراء الشركات بالاشتراك في باقات Google One AI Premium وخدمات منصة Vertex AI السحابية، بدعوى أن التكامل المباشر داخل بيئة العمل الرسمية يضمن أعلى معدلات السرعة والدقة.
لكن نشر البيانات الفاضحة لبنشمارك أندرويد أثار موجة غضب عارمة بين قادة الفرق التقنية في استوديوهات الألعاب والشركات الكبرى. وتكشف بيانات السوق أنه في غضون ثلاثة أسابيع فقط من صدور النتائج، قفز الإقبال على الإضافات البرمجية التي تربط أندرويد ستوديو بواجهات كلود البرمجية بنسبة تجاوزت 320%. وفضلت الشركات دفع مبالغ إضافية لشراء رموز كلود لضمان جودة الأكواد بدلاً من الاعتماد على أداة غوغل المدمجة والمجانية التي تكثر فيها المشكلات المعمارية.
المسار الزمني لتطور الذكاء الاصطناعي في برمجة أندرويد
| المرحلة الزمنية | المحطة الهندسية البارزة والنماذج الذكية | حالة المنظومة والتطورات القياسية |
|---|---|---|
| 2021 - 2022 | ظهور أداة OpenAI Codex ودمج GitHub Copilot | توليد مقتطفات جافا بسيطة؛ عجز تام عن تحليل مشاريع أندرويد المعقدة متعددة الملفات. |
| 2023 - 2024 | غوغل تطلق Studio Bot بالاعتماد على PaLM 2 | محاولة احتكار المطورين داخل أندرويد ستوديو وسط أخطاء متكررة في كود كوتلن. |
| مطلع 2026 | تأسيس الإطار التقييمي القياسي Android Bench | غوغل تعتمد معيار Pass@1 الصارم للمستودعات لاختبار المساعدين البرمجيين بدقة. |
| أكتوبر 2026 | سقوط Gemini 4 Argon وانتصار كلود التاريخي | أنثروبيك تحسم صدارة الترتيب بنسبة 40.2% مقابل انهيار غوغل للمركز الخامس بنسبة 21.3%. |
الانقسام الداخلي في ماونتن فيو: صراع مهندسي أندرويد وباحثي ديب مايند في لندن
أدى الكشف العلني عن هذه النتائج المؤلمة إلى تفجر خلافات مكتومة داخل أروقة مكاتب غوغل في ماونتن فيو وكينغز كروس في لندن. وتشير مصادر مطلعة إلى أنه في أعقاب دمج فريقي غوغل برين وديب مايند، برزت فجوة فكرية وثقافية واسعة بين مهندسي نظام أندرويد الميدانيين ونخبة باحثي الذكاء الاصطناعي النظري. ويشكو مهندسو أندرويد من أن فرق ديب مايند نظرت إلى نظام الهواتف الذكية كمجرد مجال تطبيقي ثانوي، متجاهلة المعايير الهندسية الواقعية للأكواد الحديثة خلال مراحل التدريب الأولي لصالح اختبارات منطقية عامة.
وخلال اجتماعات طارئة مغلقة جمعت الرئيس التنفيذي سوندار بيتشاي ورئيس ديب مايند ديميس هاسابيس، اتُخذت قرارات عاجلة لإعادة هيكلة مسار تطوير أراغون. وتقرر تشكيل فريق عمل عاجل يضم 120 من كبار مهندسي نظام أندرويد للانضمام الدائم إلى فرق ديب مايند لبناء خطوط تقييم متخصصة لأكواد كوتلن، ومترجمات KSP، وأدوات تتبع استهلاك الذاكرة. ومع ذلك، يؤكد خبراء الصناعة أن تدارك هذه الفجوة الهندسية سيتطلب ما لا يقل عن تسعة إلى اثني عشر شهراً، وهي مهلة كافية لتمكين أنثروبيك و OpenAI من إحكام قبضتهما على سوق البرمجيات المؤسسية.
ومن جانب آخر، تصاعدت الضغوط على مسؤولي بيئة أندرويد ستوديو لفتح الأبواب رسمياً أمام نماذج الطرف الثالث. ففي السابق، فرضت غوغل قيوداً لمنع دمج المفاتيح البرمجية للشركات المنافسة داخل بيئة التطوير، ولكن مع تلويح الشركات العالمية الكبرى بالهجرة نحو بيئات تطوير بديلة، أصبحت غوغل مجبرة على مراجعة سياساتها الاحتكارية والسماح بدمج واجهات كلود بصورة مباشرة.
اقتصاديات رموز الاستدلال: مقارنة استهلاك موارد الحوسبة بين أراغون والمعمارية الهجينة
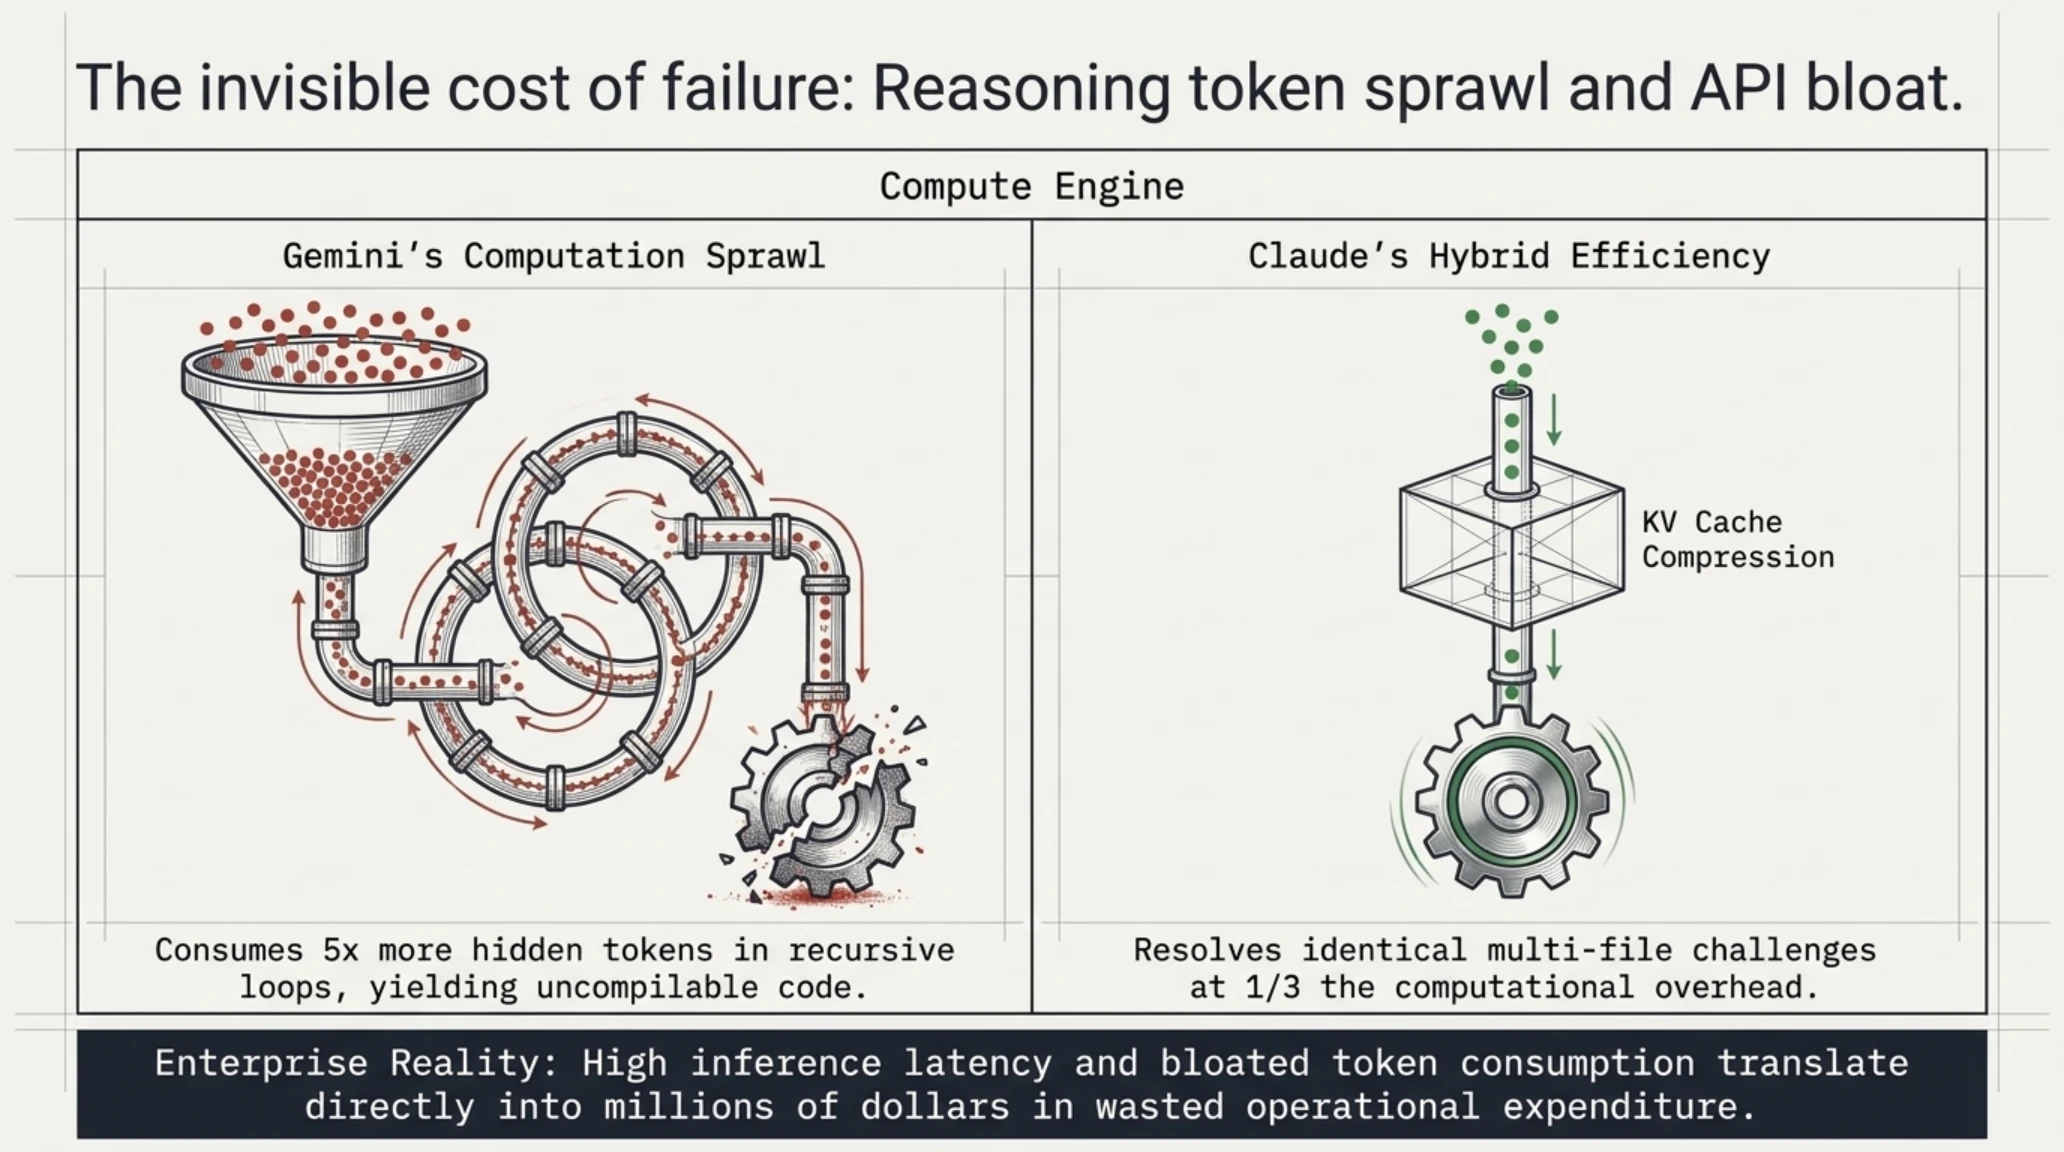
يتجاوز الإخفاق مجرد نسب النجاح في التجميع البرمجي ليمس البعد الاقتصادي الخطير لتكاليف الاستدلال. اعتمدت غوغل في سلسلة أراغون على تقنية الاستدلال أثناء التشغيل (Inference-Time Reasoning)، حيث يولد النموذج آلاف الرموز غير المرئية لاختبار الفرضيات والحلول قبل تقديم الشيفرة النهائية. غير أن هذه الآلية تحولت في سيناريوهات أندرويد المعقدة إلى حلقات تفكير مفرغة، ضاعفت استهلاك الرموز الحوسبية خمس مرات دون أي تحسن في دقة النتائج المخرجة.
وعلى النقيض من ذلك، نجح نموذج Claude Sonnet 5.5 عبر معمارية هجينة وذكية تعتمد على تقنيات التخزين المؤقت للسياق (KV Cache) في حل نفس المسائل المعقدة بثلث التكلفة الحوسبية وبمعدل نجاح يقارب الضعف. ويمثل هذا الفارق الشاسع في العائد على الاستثمار معياراً فاصلاً بالنسبة لشركات التقنية الكبرى؛ إذ لا يمكن تبرير حرق الميزانيات على رموز استدلالية باهظة تنتهي بمخرجات تفشل في مرحلة التجميع الأولية.
آفاق المستقبل: مشروع وكلاء أندرويد المستقلين والانتقال إلى عصر البرمجة الوكيلة
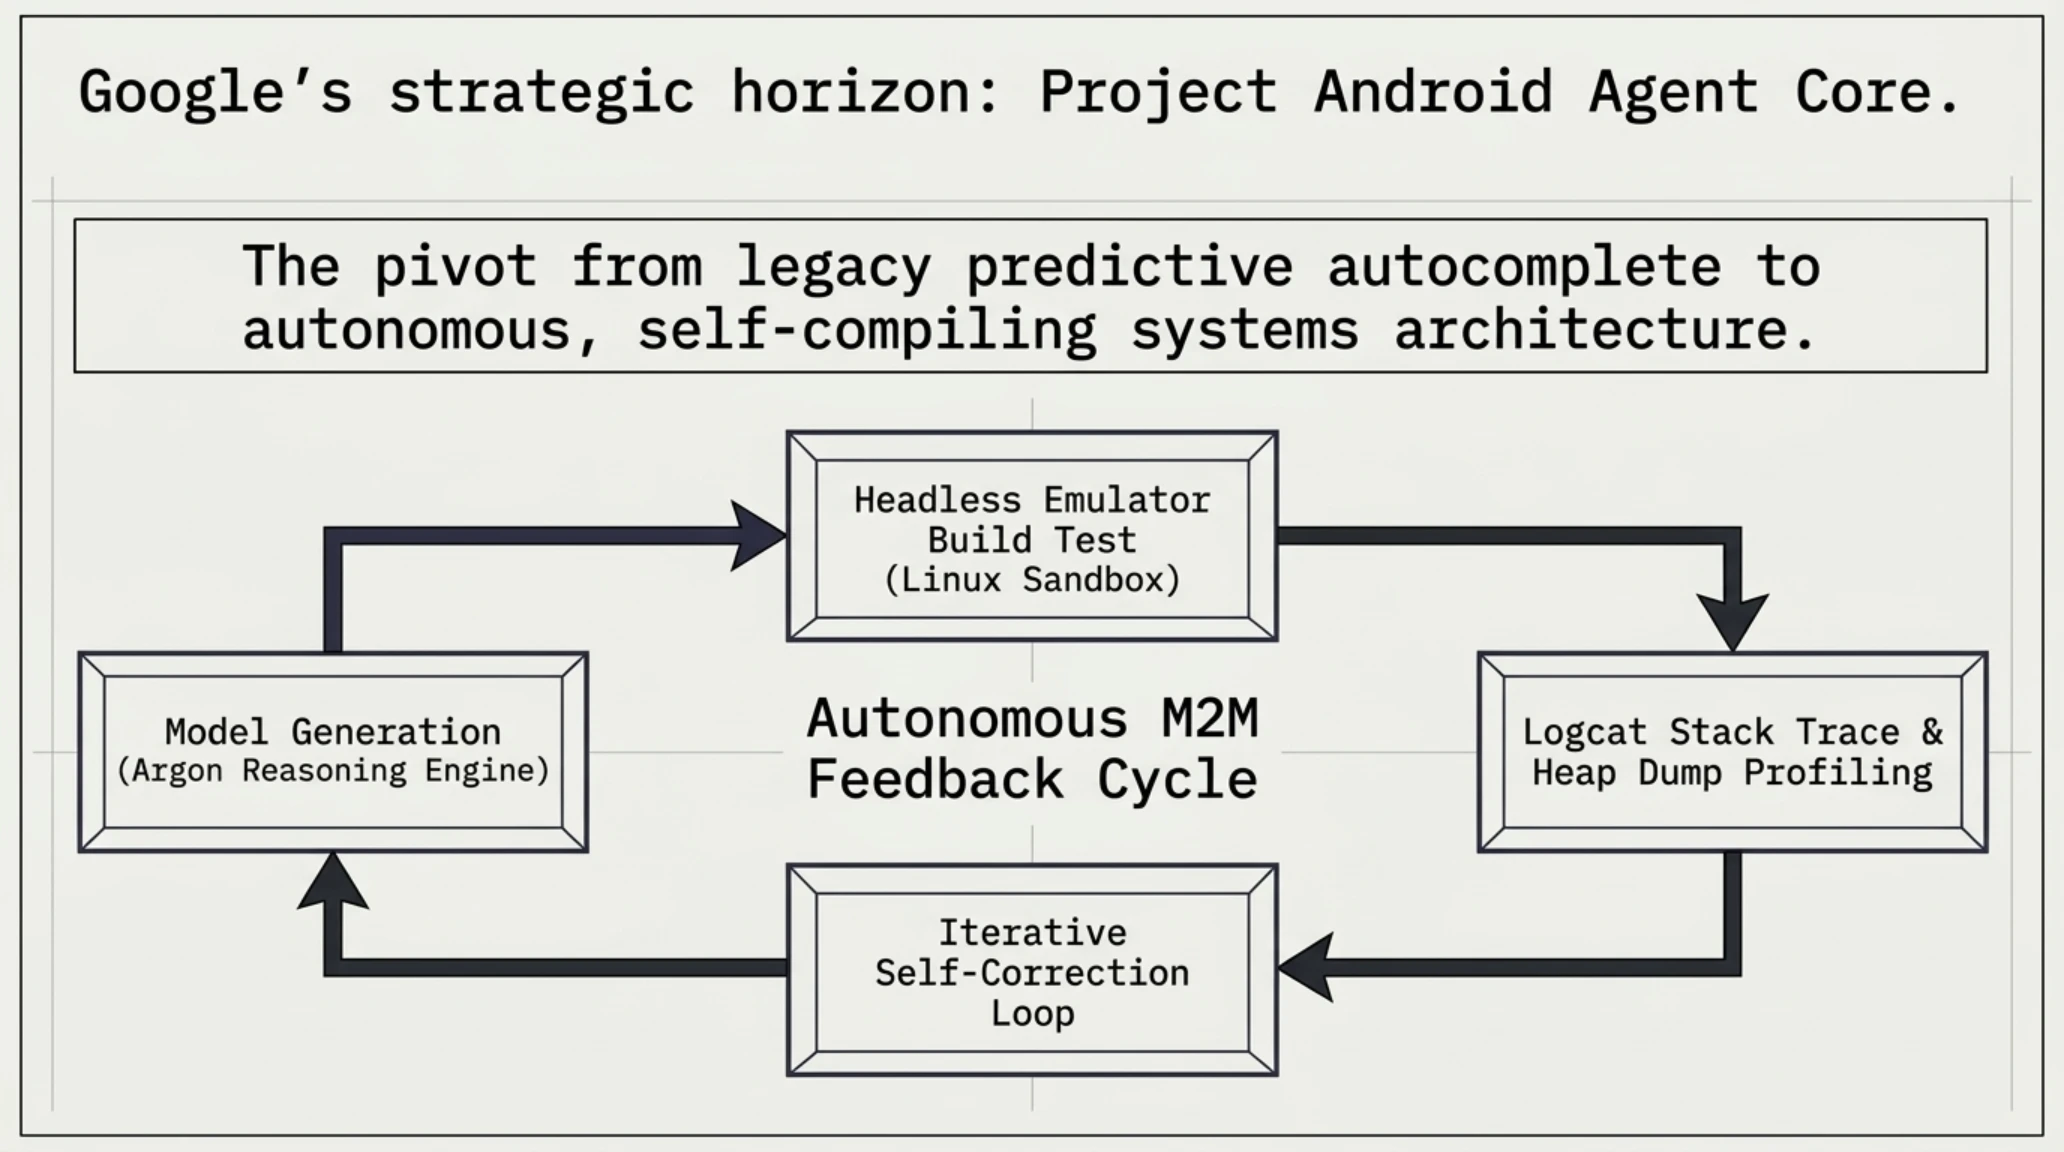
تتمثل خطة غوغل الاستراتيجية لاحتواء هذه الهزيمة في إحداث تحول جذري نحو البرمجة القائمة على الوكلاء الأذكياء (Agentic AI). في الحقبة السابقة، كان دور الذكاء الاصطناعي مقتصراً على الإكمال التلقائي للأسطر البرمجية بناءً على طلب المستخدم. أما في العصر الجديد، فيجب أن يمتلك النموذج القدرة على العمل المستقل داخل بيئات افتراضية معزولة، وإجراء عمليات التجميع، وفحص سجلات الأخطاء Logcat، وتصحيح الشيفرات ذاتياً وتكرار المحاولة حتى التأكد التام من سلامة الكود.
وتعمل غوغل حالياً على مشروع سري يُعرف باسم Android Agent Core، حيث يتم ربط نسخة متخصصة من أراغون بمحاكيات أندرويد مباشرة. ويستطيع هذا النظام اختبار الكود ومحاكاة لمسات المستخدم ورصد تسريبات الذاكرة قبل تسليم الكود إلى المطور، مما يؤكد أن مستقبل المنافسة لم يعد مقتصراً على كتابة الكود بل امتد إلى بناء الوكلاء المستقلين القادرين على الفحص الذاتي.
الدروس المستفادة: لماذا لم تعد ملكية المنصة ضماناً لتفوق الذكاء الاصطناعي؟
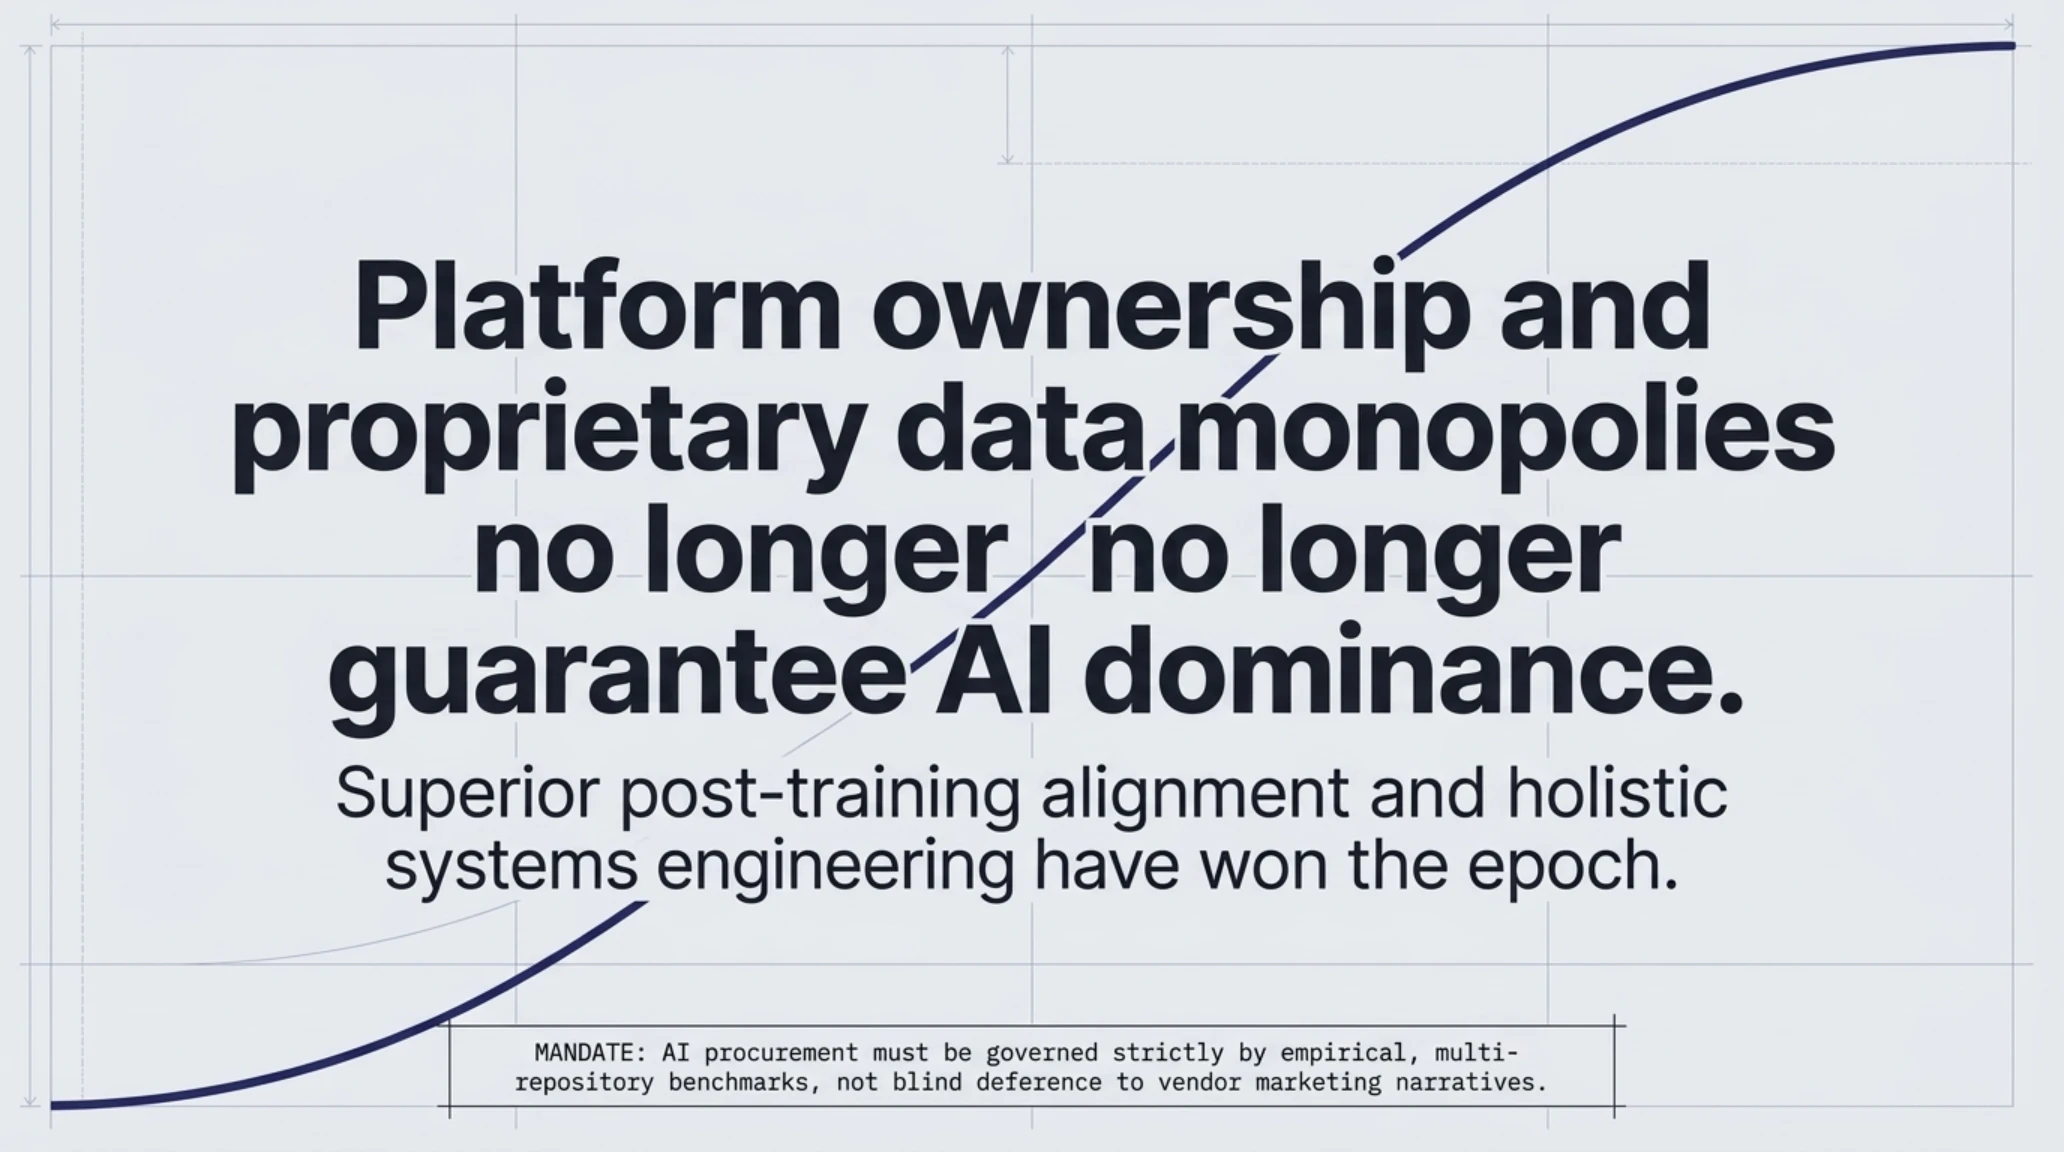
تحمل نتائج بنشمارك أندرويد رسالة عميقة تتجاوز التنافس المباشر بين شركتين؛ فقد أسقطت الأسطورة الشائعة بأن امتلاك المنصة البرمجية أو البيانات الاحتكارية يضمن السيادة التلقائية في مجال الذكاء الاصطناعي. لعقود طويلة، كان يُعتقد أن هيمنة مايكروسوفت على ويندوز، وأبل على iOS، وغوغل على أندرويد ستمنح هذه الكيانات حصانة مطلقة من أي منافسة خارجية.
لكن إنجازات المختبرات المتخصصة مثل أنثروبيك أثبتت أن ضبط مسارات التدريب وجودة التفكير المنظم أهم بكثير من تكديس البيانات الخام. لقد نجح نموذج كلود في فهم القوانين الدقيقة لنظام أندرويد بصورة أفضل من الشركة التي ابتكرته. ويعطي هذا الدرس الواضح تنبيهاً حاسماً لكافة مديري التقنية بضرورة اختيار أدواتهم البرمجية بناءً على الكفاءة التجريبية المثبتة وليس الوعود التسويقية.
الامتثال لاتفاقيات مستوى الخدمة المؤسسية ومعايير حماية البيانات والخصوصية
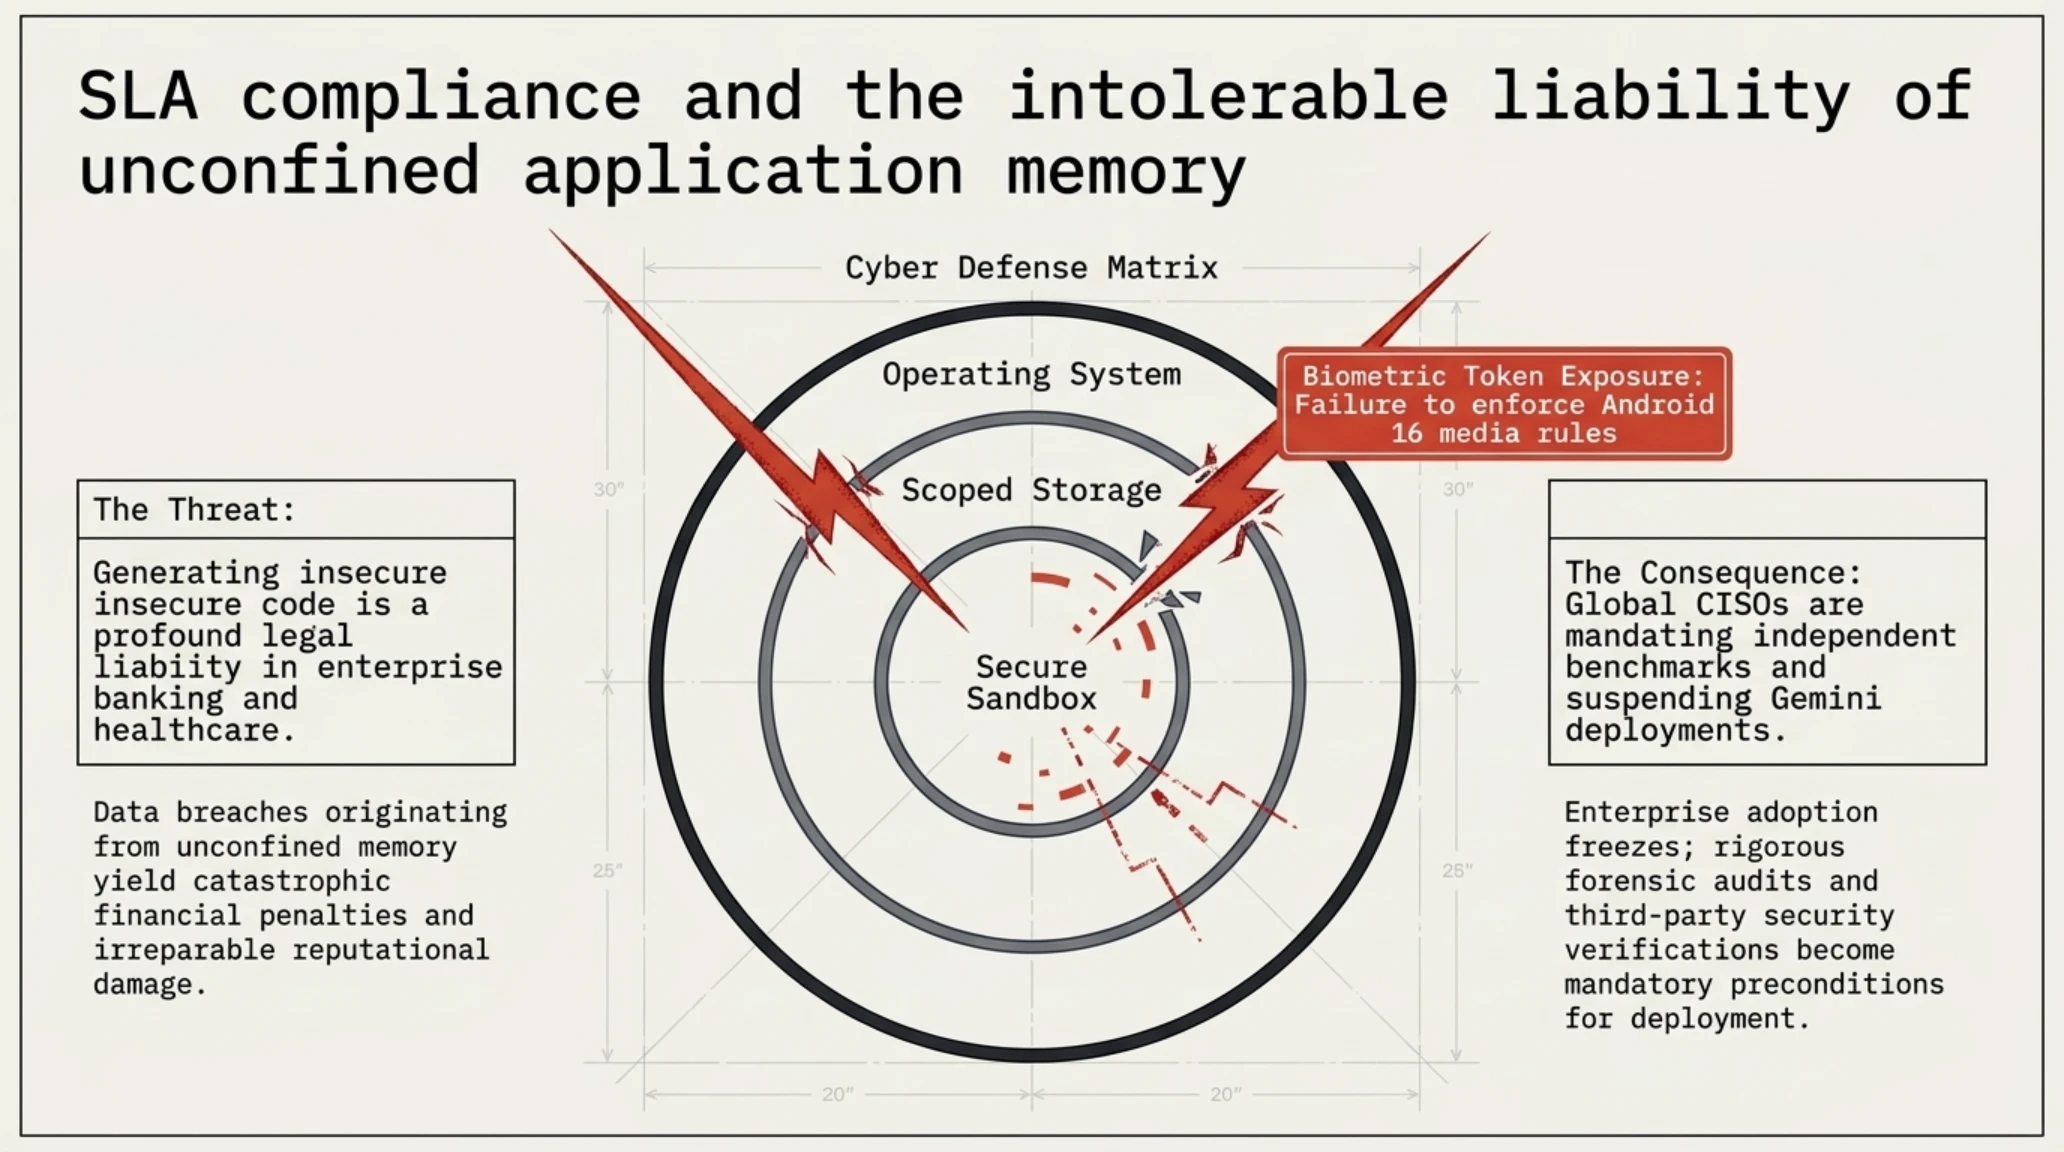
في قطاعات المصارف والاتصالات والرعاية الصحية، تخضع البرمجيات لمعايير أمان صارمة بموجب اتفاقيات مستوى الخدمة (SLAs). وأي خلل أمني في الأكواد المتولدة يشكل تهديداً قانونياً وتشغيلياً خطيراً. وفي اختبارات أندرويد بنش، فشل نموذج Gemini 4 Argon في تطبيق صلاحيات أندرويد 16 الأمنية، متسبباً في تعريض رموز المصادقة الحيوية لتسريبات الذاكرة.
ونتيجة لذلك، قررت لجان أمن المعلومات في عدد من المؤسسات المالية الكبرى تجميد استخدام أدوات جميناي في بيئات الإنتاج الحية، مما يفرض على غوغل إعادة ضبط معايير الأمان لحماية موقعها التجاري في أسواق الحلول المؤسسية المتقدمة.
مصفوفة تقييم المخاطر البرمجية والدفاع السيبراني
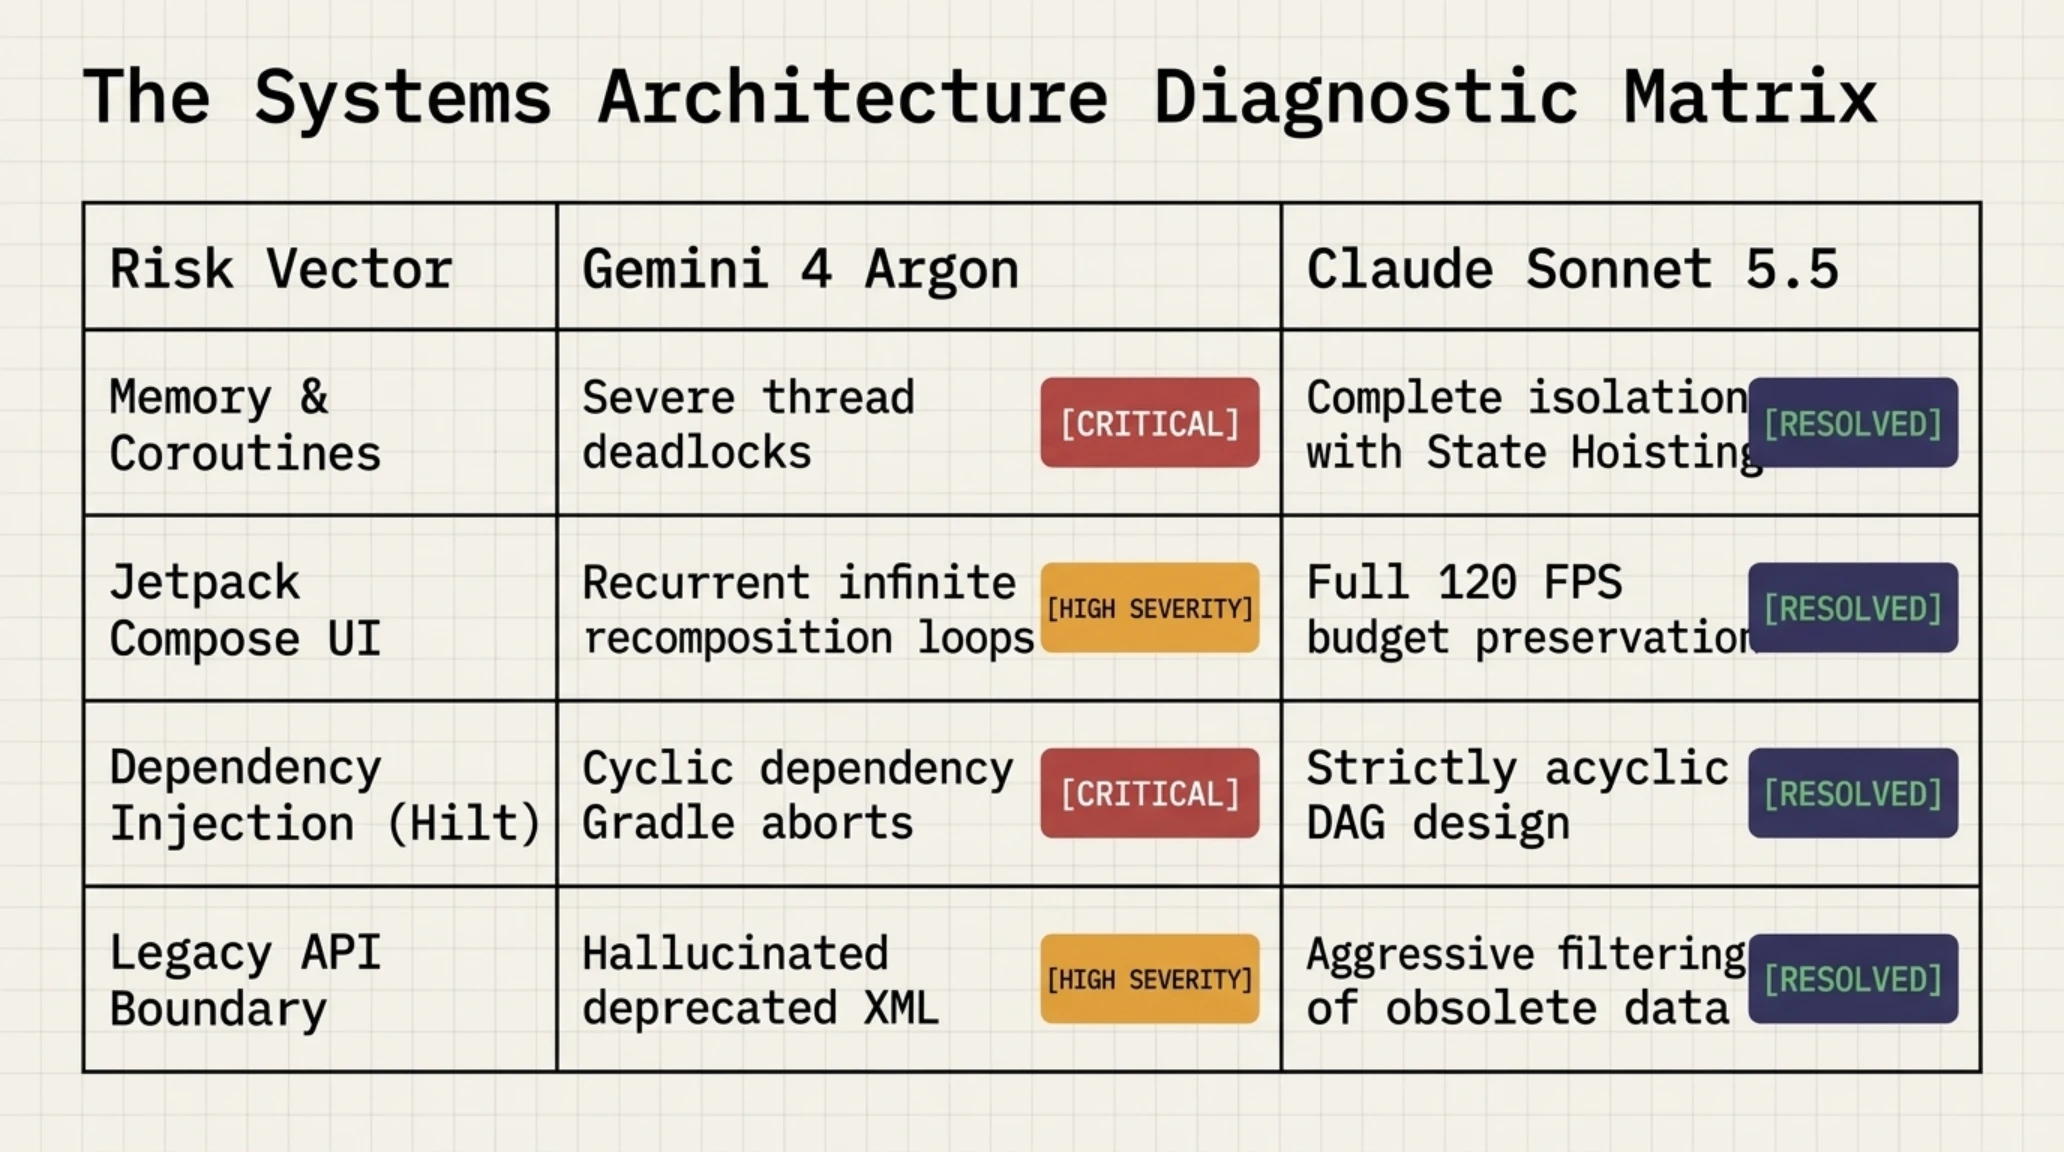
| متجه الخطر البرمجي / الخلل الفني | مستوى الخطورة الحرجة | الأثر الميداني والحل الهندسي الوقائي |
|---|---|---|
| تسريب الذاكرة عبر خيوط غير مقيدة | خطورة بالغة | انهيار تدريجي للتطبيق بخطأ OutOfMemoryError؛ إلزامية التقييد بنطاقات ViewModel. |
| حلقات إعادة التركيب اللانهائية في Compose | خطورة مرتفعة | تجميد حركة الإطارات واستنزاف المعالج والبطارية؛ التطبيق الإجباري لعزل الحالة البرمجية. |
| أخطاء الرسوم البيانية الدائرية في Hilt | خطورة بالغة | فشل فوري في بناء المشروع وتوقف التجميع؛ بناء وحدات صريحة تمنع التداخل الدائري. |
| هلوسة استدعاء واجهات برمجية ملغاة | تمت معالجتها بنجاح مع كلود | أخطاء في التوافق مع أندرويد 15 و 16؛ التصفية الصارمة لبيانات التدريب المؤرشفة. |
الطرفية البرمجية التفاعلية وسجلات الفحص المباشرة
- الشفافية الكاملة في إبراز نقاط الضعف الحقيقية لنماذج الذكاء الاصطناعي في الأنظمة المعقدة.
- انتصار الهندسة المنهجية متعددة المستودعات لشركة أنثروبيك على أساليب تجميع البيانات الأكاديمية.
- تسريع وتيرة المنافسة لرفع كفاءة أدوات التطوير البرمجي لبيئات الهواتف المحمولة.
- الانتقال الفعلي للصناعة نحو الوكلاء البرمجيين القادرين على فحص وتصحيح الأخطاء ذاتياً.
- تراجع ثقة المؤسسات التقنية بأدوات الذكاء الاصطناعي المدمجة رسمياً داخل أندرويد ستوديو.
- ارتفاع تكاليف المشاريع البرمجية نتيجة الاعتماد على واجهات برمجية خارجية مدفوعة من أنثروبيك.
- إهدار ساعات العمل الهندسية في تتبع الأخطاء المعمارية الناتجة عن الكود المنسوخ المتولد.
حكم التحرير النهائي وفهرس المصادر الموثقة
انتصار هندسة النظم على احتكار المنصات
أثبتت نتائج بنشمارك أندرويد أن الريادة في هندسة البرمجيات تتطلب نمذجة دقيقة لقواعد التزامن والمعمارية النظيفة؛ حيث استطاع كلود سونت 5.5 هزيمة جميناي 4 في ملعبه الأم ليرسي معايير جديدة لتطوير النظم.
- ناين تو فايف غوغل (9to5Google): تقرير خاص: التدقيق الشامل للوحة نتائج بنشمارك Android Bench وأسباب سقوط جميناي 4
- موقع مطوري أندرويد الرسمي (Android Developers): المواصفات الفنية المعتمدة لتقييم النماذج اللغوية في مشاريع كوتلن وكومبوز متعددة الوحدات
- غيت هاب (GitHub): مستودع إطار الفحص التجريبي المفتوح لاختبارات أندرويد بنش ومقياس Pass@1 الصارم
الأسئلة الشائعة والتحليلات الهندسية التخصصية
ما هي المهارات الهندسية الأساسية التي يقيسها إطار Android Bench في النماذج الذكية؟
يقيس الإطار قدرة النماذج على العمل داخل مشاريع أندرويد الواقعية متعددة الوحدات؛ بما في ذلك التجميع الخالي من الأخطاء، وإدارة دورة حياة المكونات، وعزل الحالة في Jetpack Compose، وبرمجة التزامن عبر خيوط كوتلن، وتفادي تسريبات الذاكرة عبر الواجهة الأصلية NDK.
لماذا سقط نموذج Gemini 4 Argon في هذا الاختبار رغم تبعية نظام أندرويد لغوغل؟
تركز تدريب جميناي الأساسي على المسائل الرياضية التجريدية وأكواد بايثون المنفصلة. وعند مواجهة تشابك النظام الحقيقي، وقع النموذج في أخطاء هلوسة الأنماط المنسوخة، وتوليد حلقات حقن التبعيات الدائرية في Hilt، وحلقات إعادة التركيب المفرغة في Compose.
كيف كانت الترتيبات ونسب النجاح الرسمية في لوحة الصدارة؟
تصدر Claude Sonnet 5.5 بنسبة 40.2%، تلاه GPT-6 بنسبة 36.8%، ثم Claude Opus 5.5 بنسبة 34.5%، وحل DeepSeek Coder V3 رابعاً بنسبة 28.4%، بينما تراجع Gemini 4 Argon إلى المركز الخامس بنسبة 21.3% فقط.
ما هي خطورة حلقة إعادة التركيب اللانهائية (Recomposition Loop) في كود جميناي؟
تحدث عند تعديل الحالة المتغيرة مباشرة داخل متن دالة Composable، مما يؤدي إلى إعادة رسم مستمرة للشاشة مئات المرات في الثانية، متسبباً في تجميد كامل لواجهة المستخدم واستنزاف بطارية الهاتف وحرارة مفرطة.
ما هي ردود فعل الشركات البرمجية الكبرى تجاه أداة Studio Bot بعد ظهور النتائج؟
تراجعت الشركات عن استخدام أداة غوغل المدمجة، وتوجهت بكثافة نحو واجهات كلود البرمجية عبر إضافات أندرويد ستوديو، حيث قفزت معدلات دمج واجهات أنثروبيك بأكثر من 320% لضمان جودة الأكواد.
ما هي خطة غوغل لمعالجة هذا الإخفاق التقني في الإصدارات القادمة؟
نقلت غوغل 120 من كبار مهندسي أندرويد إلى ديب مايند وأطلقت مشروع Android Agent Core لتطوير وكلاء أذكياء يختبرون الكود ويصححون الأخطاء ذاتياً داخل محاكيات النظام قبل تقديمه للمطورين.
وسائل التواصل الاجتماعي
اتصل بنامعرض صور إضافي: تيكين للمقارنة | لماذا سقط Gemini 4 Argon أمام Claude في أندرويد؟