تکین گاید | راهنمای راهبردی اجرای هوش مصنوعی محلی در پاییز ۲۰۲۶
پایان وابستگی به پردازش ابری؛ چرا سال ۲۰۲۶ نقطه عطف هوش مصنوعی محلی است؟
در پاییز سال ۲۰۲۶، جامعه مهندسی نرمافزار، توسعهدهندگان مستقل و تحلیلگران داده به نقطه حساسی در تعامل با هوش مصنوعی رسیدهاند. برای سالها، شرکتهای بزرگ فناوری کاربران را متقاعد کرده بودند که هوش مصنوعی واقعی تنها در خوشههای ابررایانهای چندمیلیارد دلاری قابل دسترسی است. اما ارسال مداوم سورسکدهای محرمانه تجاری، اسناد مالی شخصی و دادههای حساس به سرورهای کلود شخص ثالث، نه تنها نگرانیهای شدید امنیتی ایجاد کرده، بلکه هزینههای اشتراک ماهیانه سرسامآوری را به تیمها تحمیل نموده است.
تجربه اخیر آنتونیو دی بندتو، روزنامهنگار ارشد وبسایت ورج (The Verge)، بازتابدهنده دغدغه هزاران متخصصی است که تصمیم گرفتهاند خط اتصال اینترنت را قطع کرده و پردازشهای شناختی را مستقیماً بر روی میز کار خود اجرا کنند. او در یادداشتهای آزمایشگاهی خود تشریح میکند که چگونه مواجهه با هوش مصنوعی محلی در ابتدا هیجانانگیز، گیجکننده و گاهی خستهکننده به نظر میرسد، اما وقتی نخستین مدل ۷۰ میلیارد پارامتری بدون ارسال حتی یک بایت داده به بیرون پاسخ میدهد، حس استقلال دیجیتال بینظیری خلق میشود.
پیشرفتهای شگرف در متدهای فشردهسازی و کوانتایز وزنهای عصبی (Quantization) در سال ۲۰۲۶ به همراه جهش خیرهکننده در معماری پردازندههای دسکتاپ، این رویا را به واقعیت تبدیل کرده است. امروزه یک ایستگاه کاری مجهز میتواند با مصرف کسری از انرژی سرورهای دیتاسنتر، مدلهای زبانی فوقپیشرفتهای مانند Hermes 3 و Qwen 2.5 را با سرعتی بالاتر از سرعت خواندن انسان (بیش از ۳۰ توکن در ثانیه) پردازش نماید.
این گذار تاریخی برای سازمانهای حقوقی، استارتاپهای فینتک و برنامهنویسانی که بر روی پروژههای تحت قرارداد عدم افشا (NDA) کار میکنند، یک ضرورت غیرقابل مذاکره است. هوش مصنوعی محلی دیگر یک سرگرمی برای گیکهای سختافزار نیست؛ بلکه سنگر اصلی دفاع از حریم خصوصی و حفظ داراییهای معنوی در دهه هوش مصنوعی به شمار میرود.
معماری حافظه یکپارچه اپل در برابر دیوار حافظه ویدیویی (VRAM) انویدیا
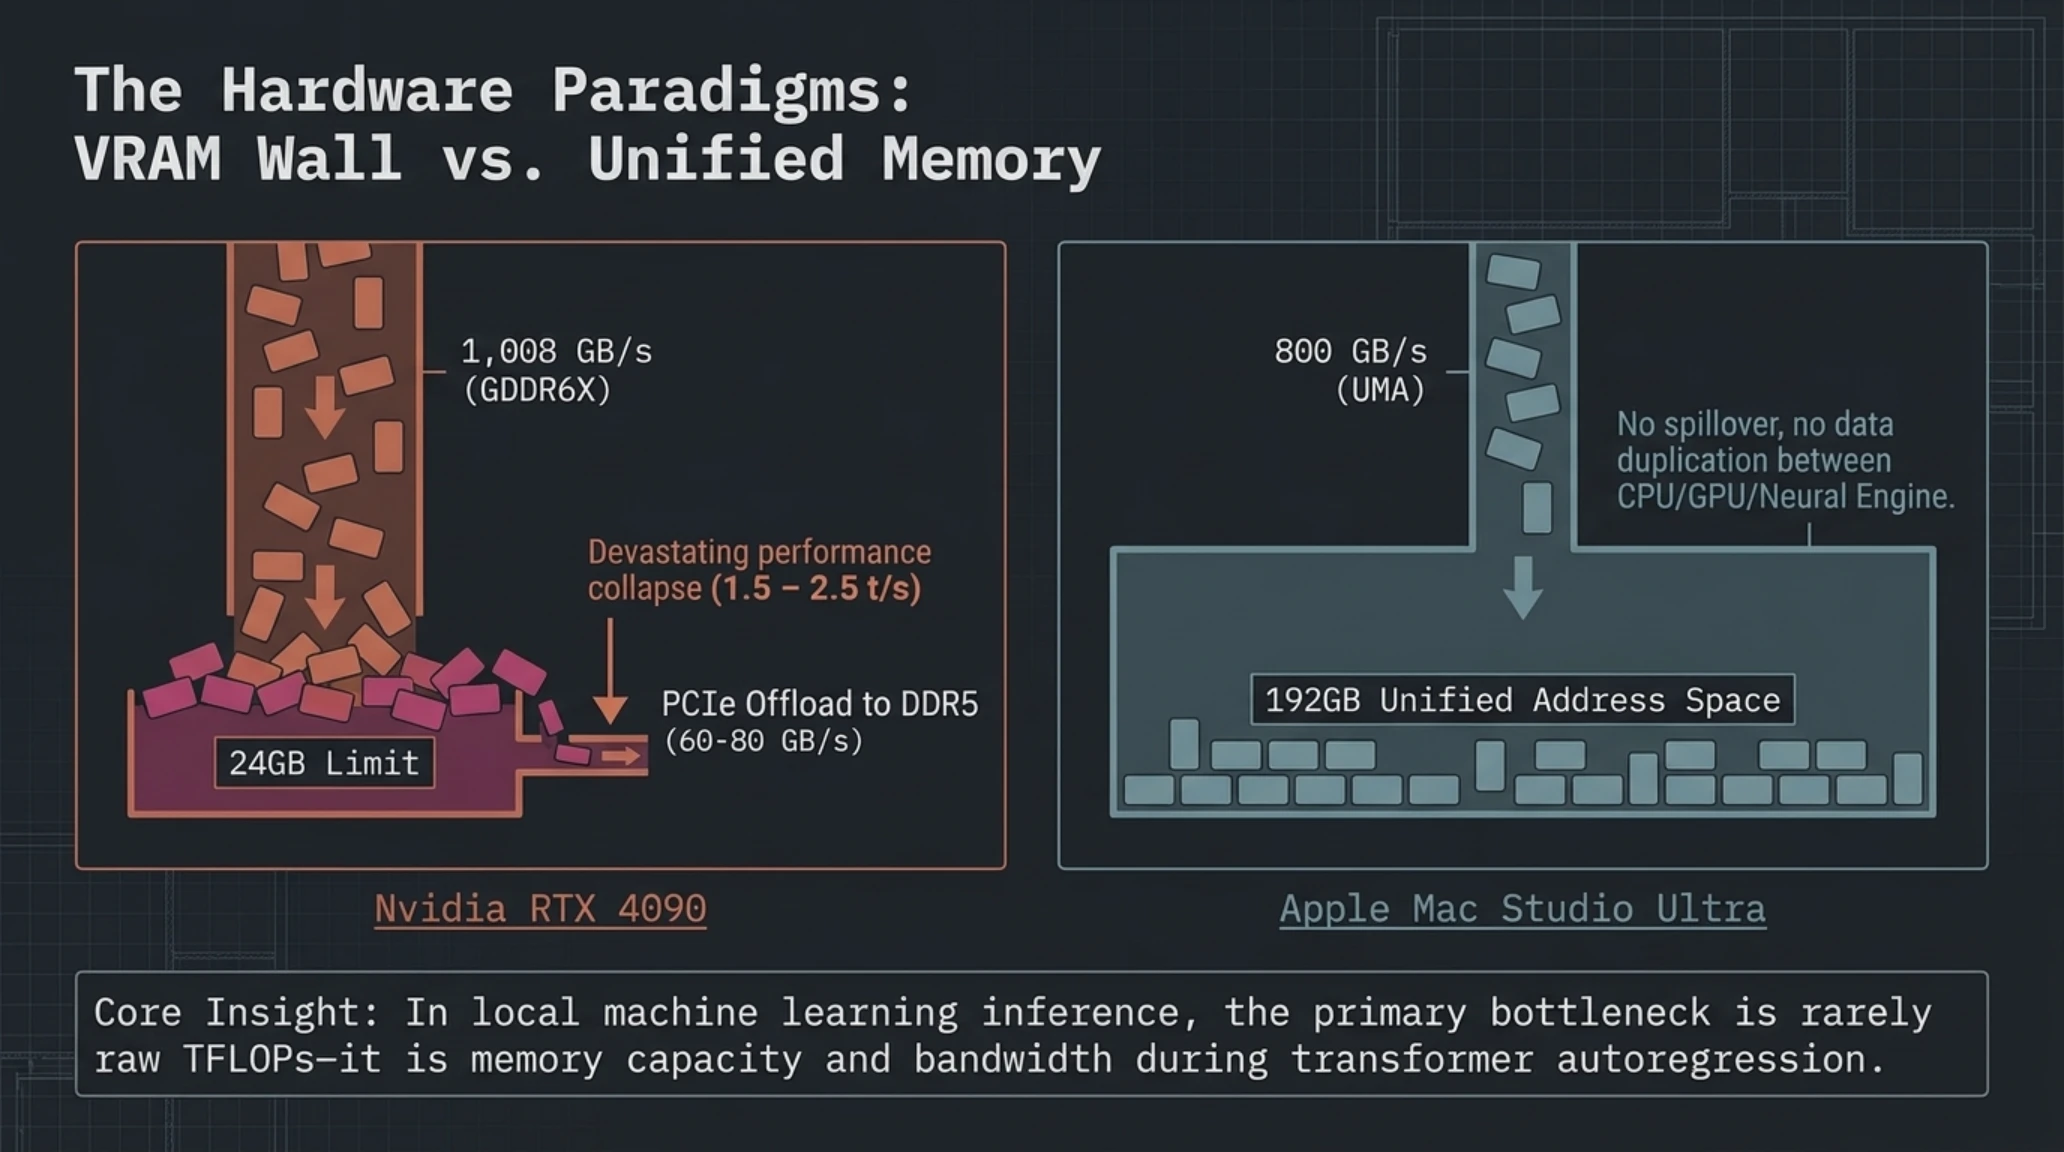
بزرگترین گلوگاه در اجرای مدلهای زبانی روی رایانههای شخصی، قدرت خام پردازشی ترافلاپس نیست، بلکه ظرفیت و پهنای باند حافظه است. در این میدان نبرد مهندسی، دو غول دنیای سیلیکون رویکردهای کاملاً متضادی را در پیش گرفتهاند. شرکت انویدیا با کارتهای گرافیک سری RTX 4090 و RTX 5090 بر سرعت خارقالعاده حافظههای GDDR6X تکیه میکند، در حالی که اپل با پردازندههای سری M2، M3 و M4 اولترا، معماری انقلابی حافظه یکپارچه (Unified Memory Architecture) را ارائه میدهد.
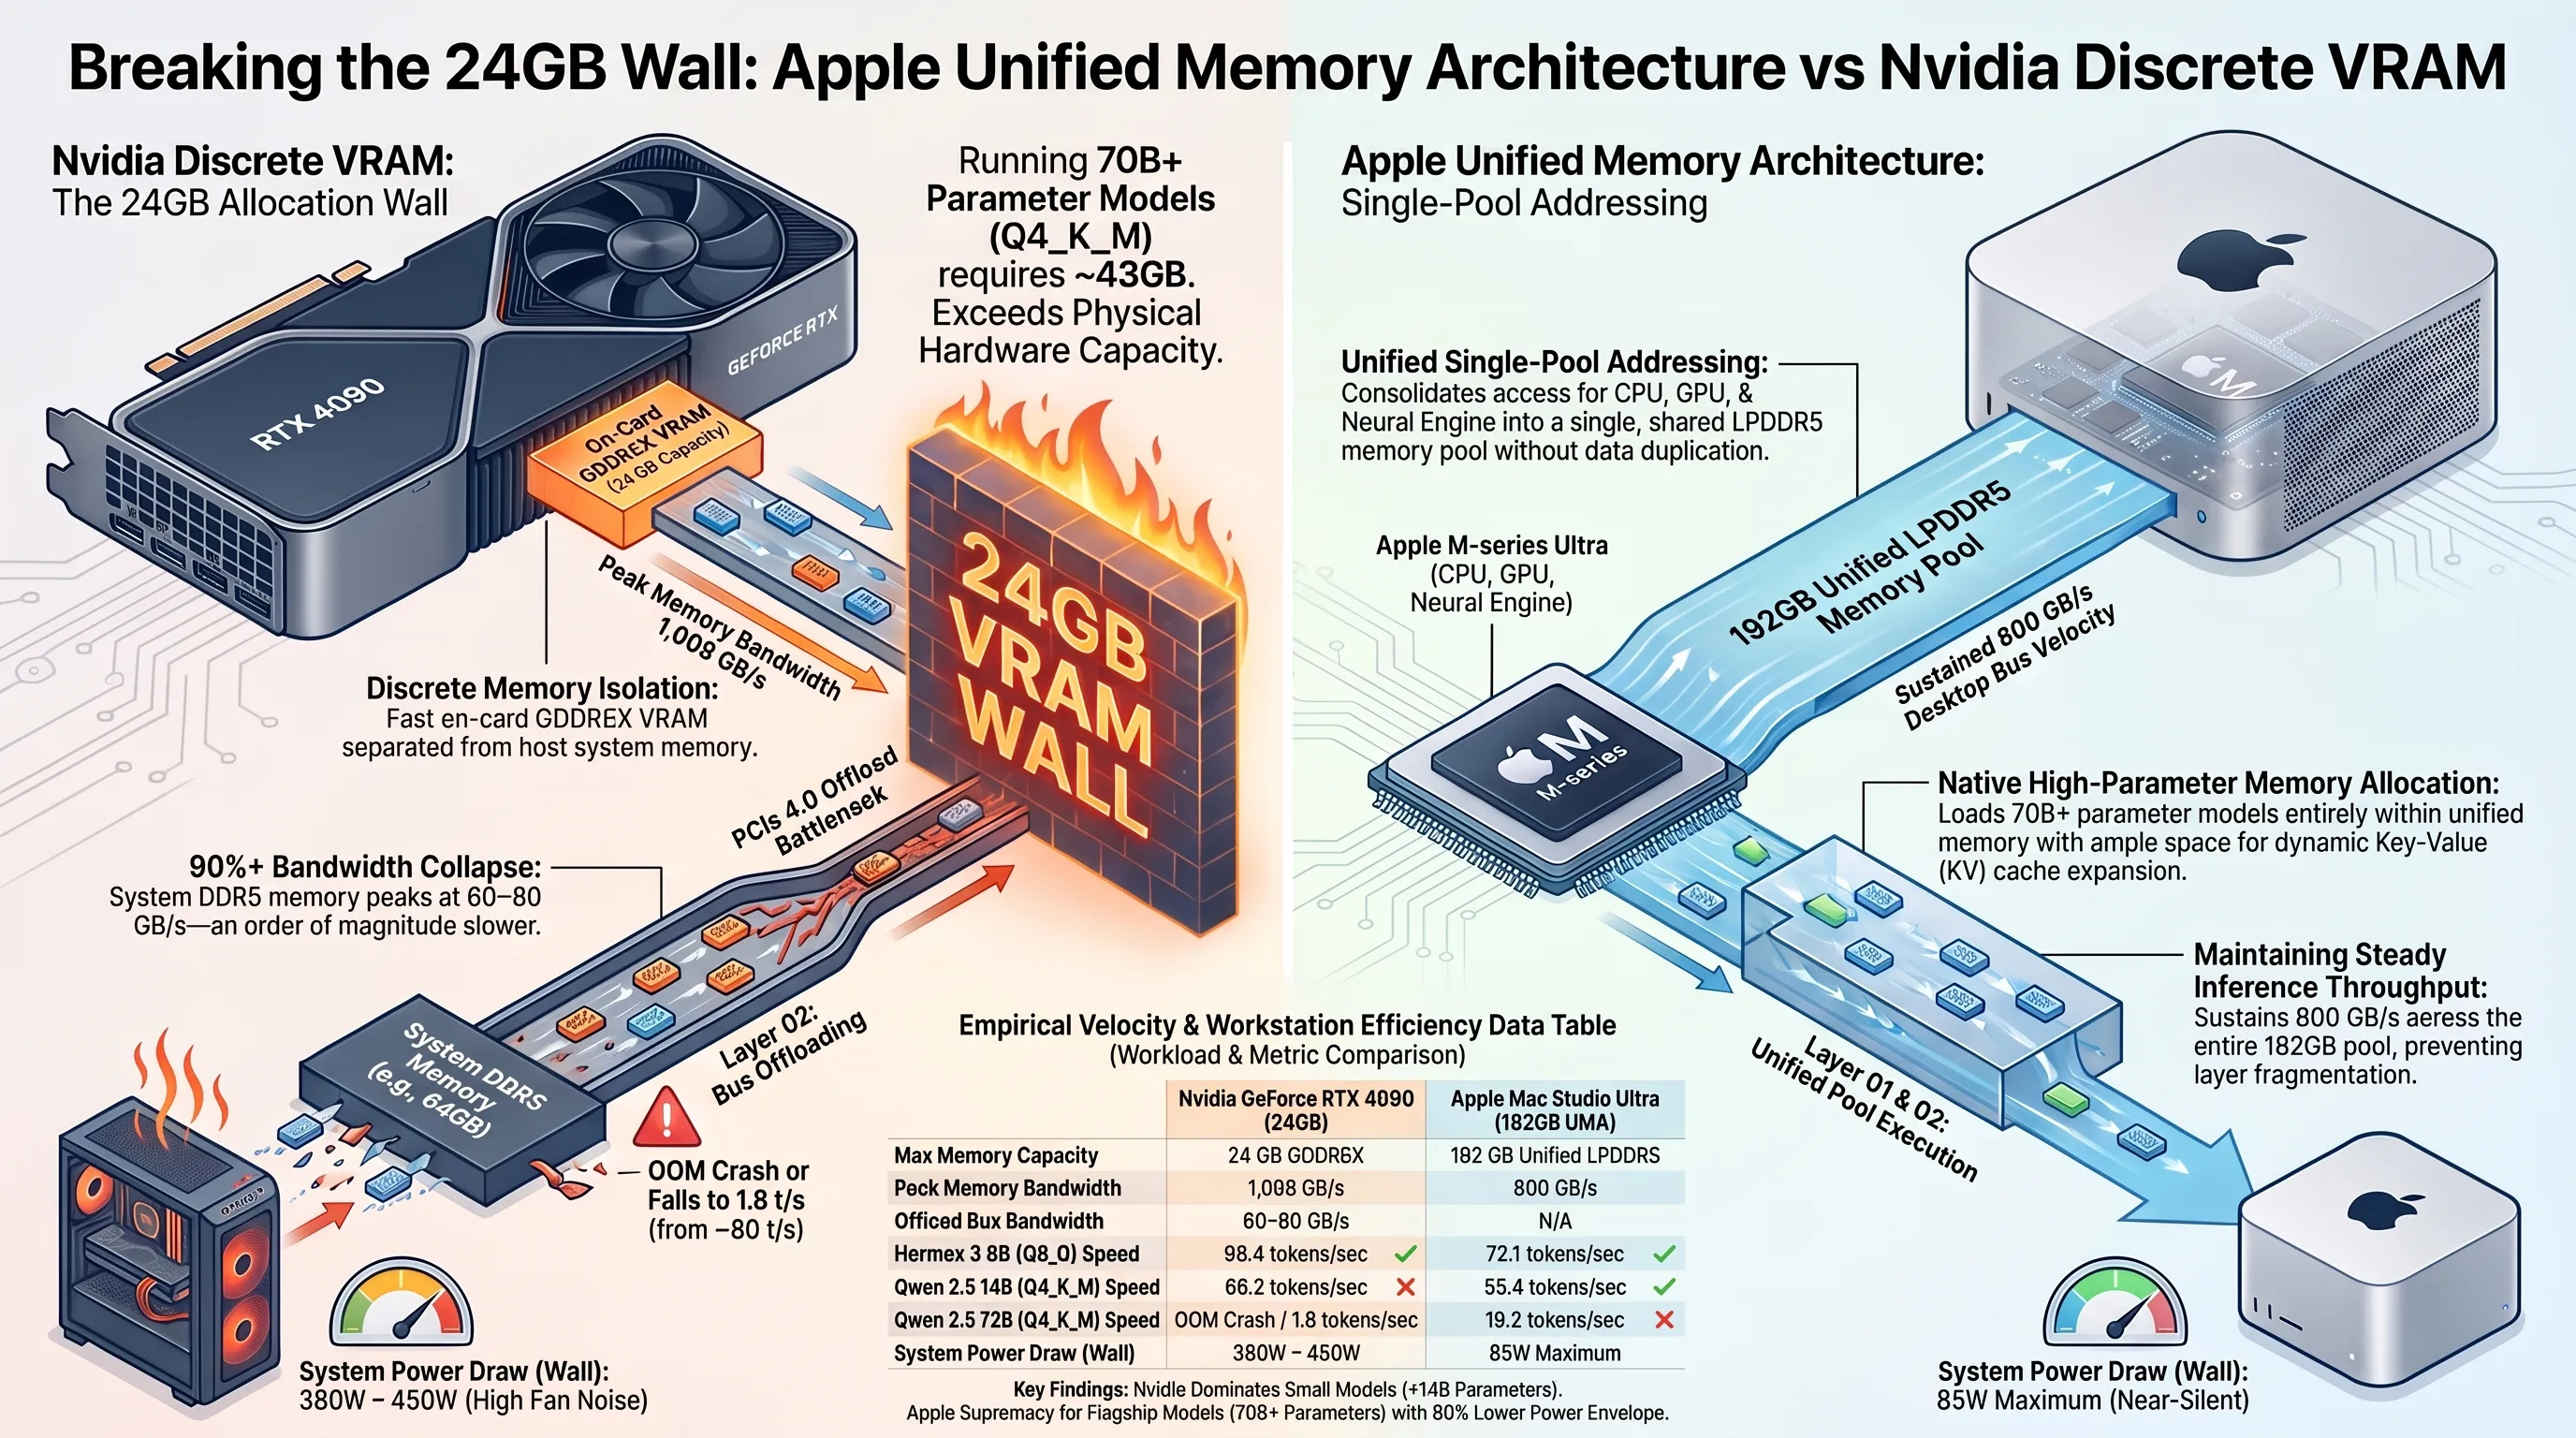
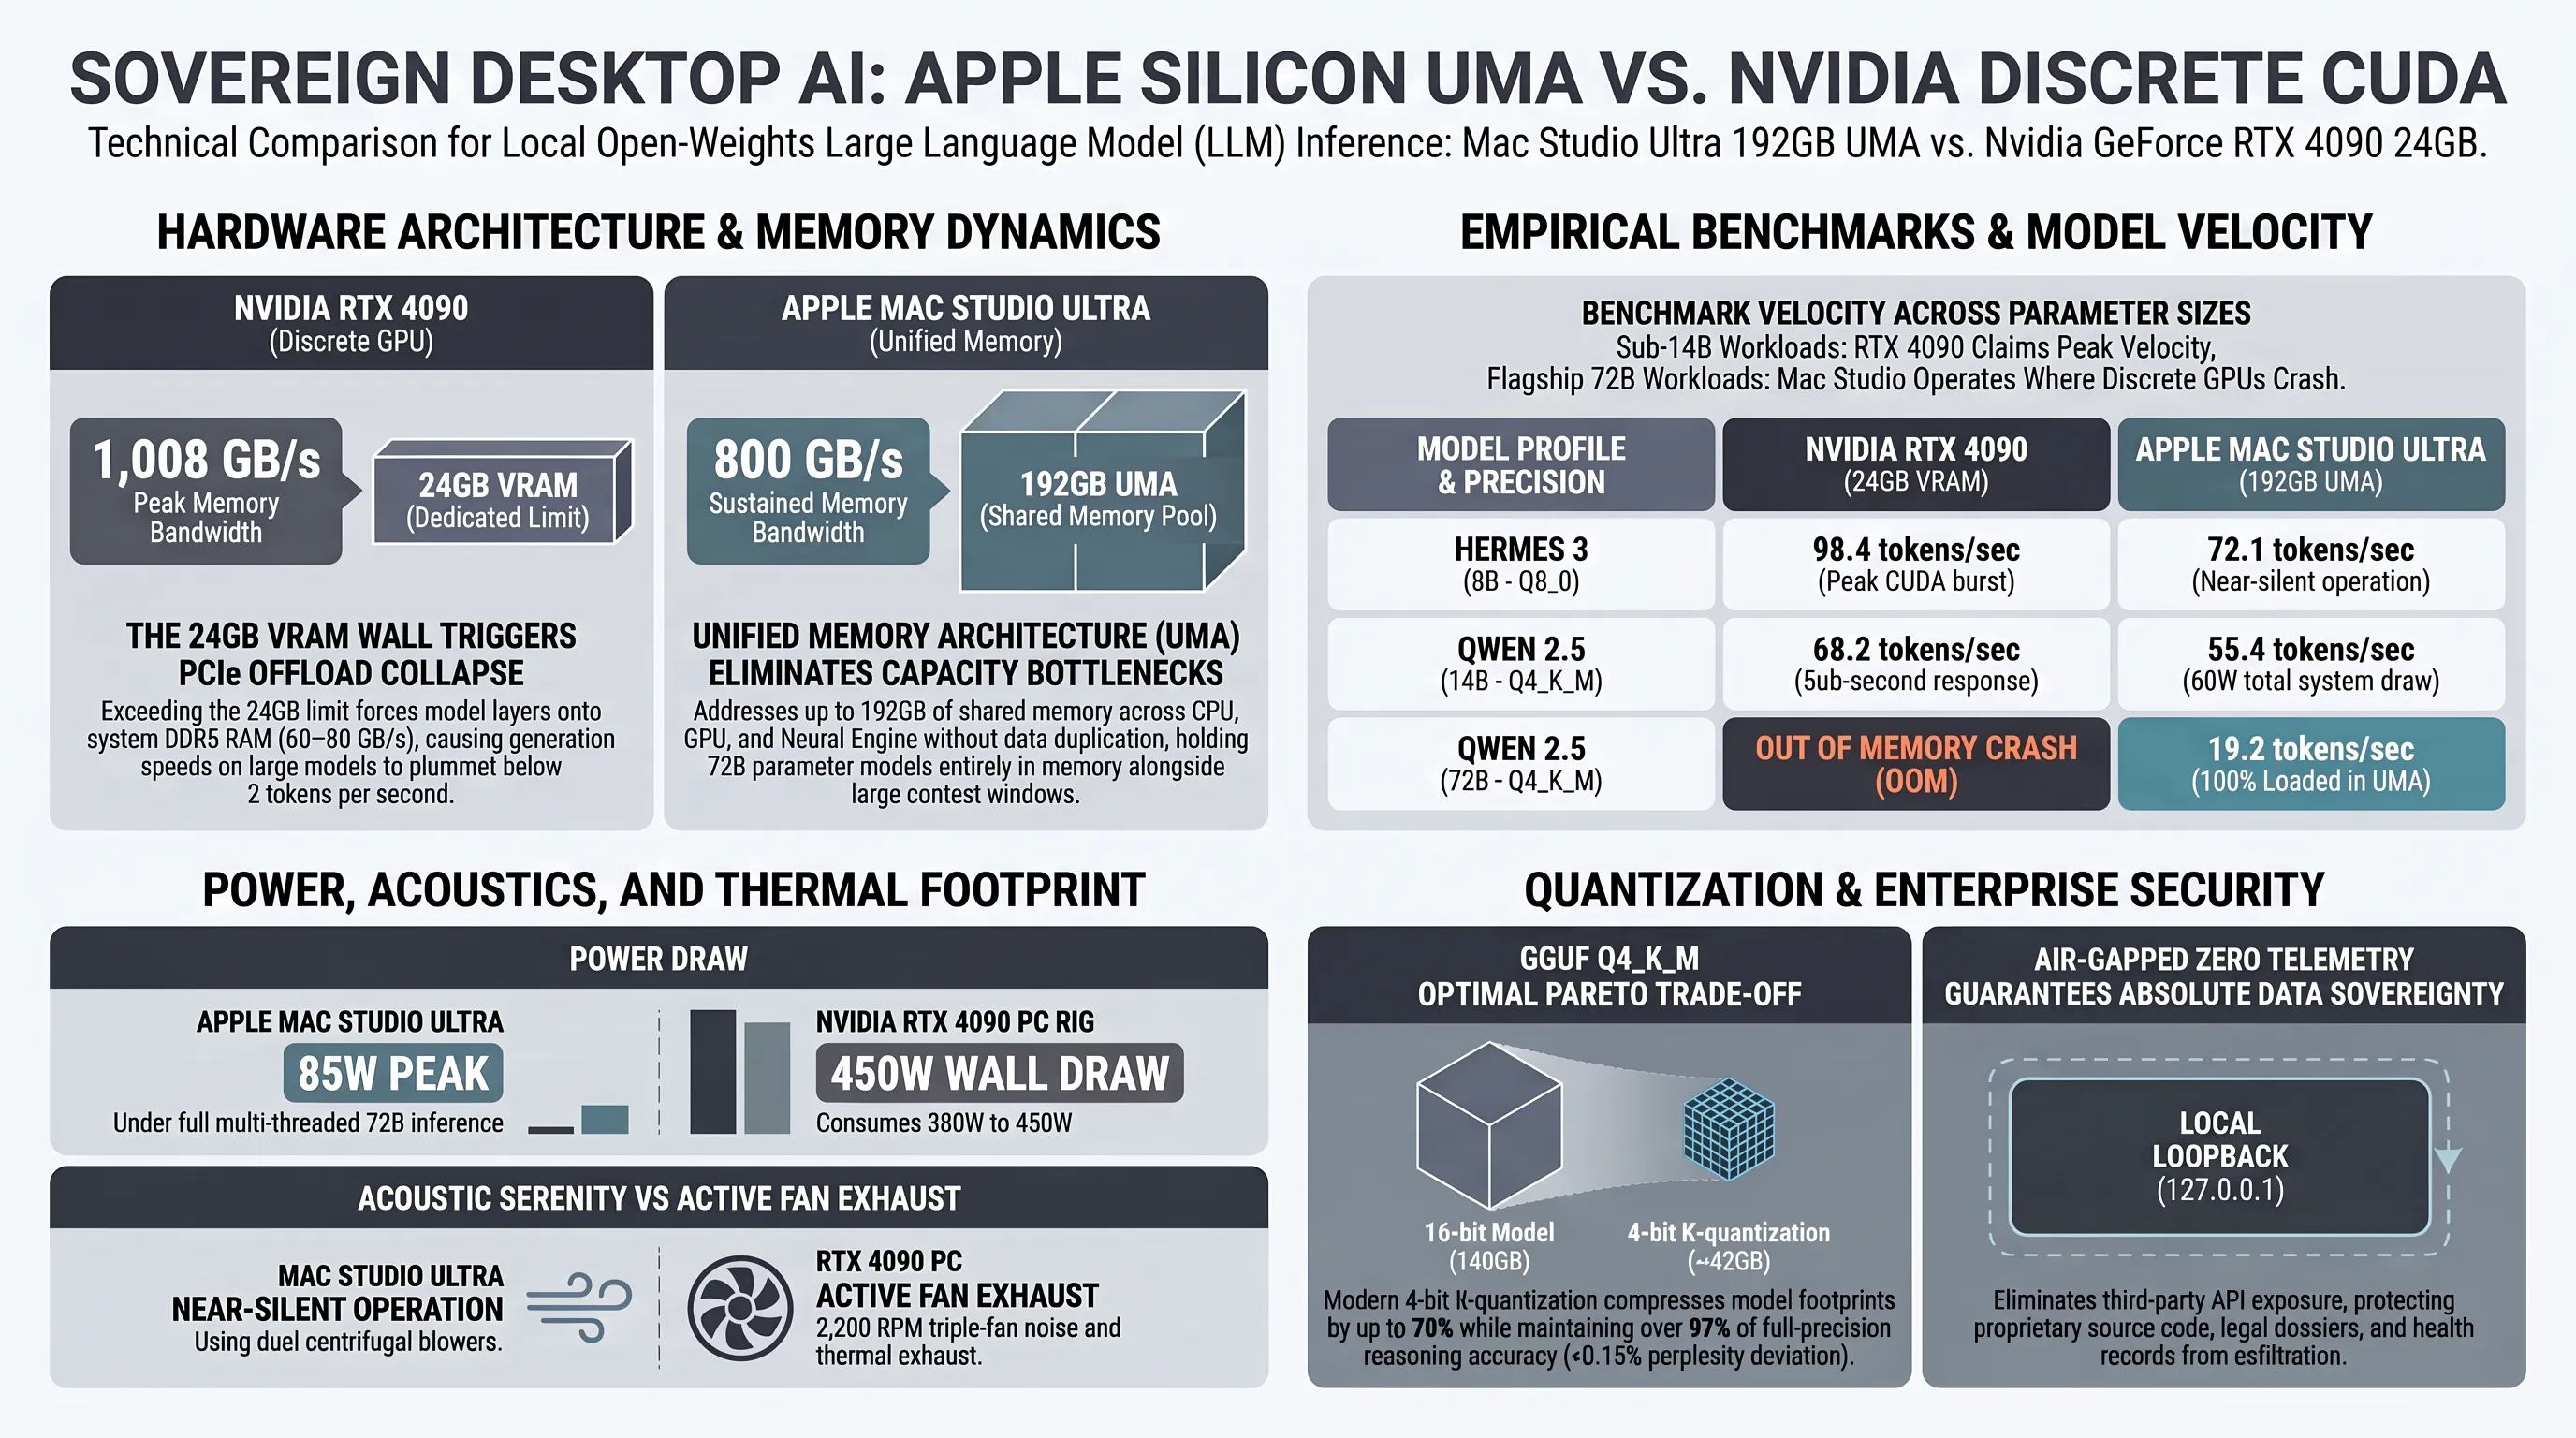
کارت پرچمدار RTX 4090 انویدیا با داشتن پهنای باند عظیم ۱۰۰۸ گیگابایت بر ثانیه، سریعترین تولیدکننده توکن در مدلهای کوچک و متوسط است. اما این کارت با یک مانع فیزیکی غیرقابل عبور مواجه است: دیوار حافظه ویدیویی ۲۴ گیگابایتی. اگر بخواهید یک مدل غولپیکر ۷۰ میلیارد پارامتری مثل Qwen 2.5 72B را اجرا کنید، وزنهای مدل حتی در نسخه کوانتایز ۴ بیتی به بیش از ۴۰ گیگابایت فضا نیاز دارند. در کارت گرافیک انویدیا، سرریز حافظه به رم سیستم (System RAM Offloading) منجر به افت فاجعهبار سرعت تا حد ۱ الی ۲ توکن در ثانیه میشود که عملاً بلااستفاده است.
چرا این تحول حیاتی است: مثلث مزایای هوش مصنوعی محلی
گذار تاریخی از ابرهای چندمیلیارد دلاری متمرکز به سمت ایستگاههای کاری میز کار؛ حل بنیادین چالش کمبود VRAM با معماری حافظه پیوسته و فریمورکهای سبک محلی.
در سمت دیگر، مک استودیو با تراشه M2 Ultra یا نسل جدیدتر مجهز به حافظه یکپارچه تا سقف ۱۹۲ گیگابایت، این دیوار را کاملاً فرو میریزد. در معماری اپل، پردازنده مرکزی (CPU)، گرافیک (GPU) و موتور عصبی (Neural Engine) همگی به یک مخزن حافظه عظیم با پهنای باند ۸۰۰ گیگابایت بر ثانیه دسترسی دارند. این ویژگی شگفتانگیز به شما اجازه میدهد حتی مدلهای فوقسنگین ۷۰B یا ۱۲۰B را به صورت کامل و بدون کوچکترین افت سرعتی در حافظه بارگذاری کنید و نرخ تولید پایدار ۱۵ الی ۲۲ توکن در ثانیه را تجربه نمایید.
بنابراین، معادله خرید سختافزار در پاییز ۲۰۲۶ شفاف شده است: اگر سرعت برقآسای مدلهای ۸ تا ۱۴ میلیاردی را برای تکمیل خودکار کدنویسی و پاسخهای کوتاه میخواهید، کامپیوتر شخصی با کارت RTX 4090 انویدیا پیروز میدان است. اما اگر قصد دارید مدلهای بسیار هوشمند ۷۰B را با بافت طولانی برای نگارش مقالات، تحلیل صدها صفحه گزارش و شبیهسازی ایجنتهای پیچیده به کار بگیرید، مک استودیو گزینه بیرقیب و کممصرف بازار به شمار میآید.
تحلیل مدلهای متنباز پاییز ۲۰۲۶: غولهای Hermes 3 و Qwen 2.5
پیشرفت سختافزار بدون مدلهای نرمافزاری بهینهشده بیفایده خواهد بود. در میان انبوه وزنهای منتشرشده بر روی وبسایت Hugging Face، دو خانواده مدل بیش از همه توجه مهندسان را به خود جلب کردهاند: مدل Hermes 3 توسعهیافته توسط تیم مستقل Nous Research و خانواده مدلهای Qwen 2.5 متعلق به بخش هوش مصنوعی علیبابا.
مدل Hermes 3 که بر پایه ساختار قدرتمند Llama 3.1 شرکت متا آموزش داده شده، شاهکاری در حوزه ایجنتهای مستقل و ابزارپذیری است. این مدل به شکلی بینظیر برای فراخوانی توابع (Function Calling)، برنامهریزی چندمرحلهای و تولید ساختارهای خروجی JSON و XML آموزش دیده است. بارزترین ویژگی هرمس ۳، قابلیت استدلال درونی در تگهای اسکرچپد (<scratchpad>) است؛ بدین معنی که مدل پیش از صدور پاسخ نهایی، محاسبات و استدلالهای خود را بررسی کرده و سپس خروجی قطعی را نمایش میدهد.
در جبهه دیگر، مدل Qwen 2.5 شرکت علیبابا با داشتن پنجره بافتی گسترده ۱۲۸ هزار توکنی، معیارهای بنچمارک جهانی را جابجا کرده است. نسخههای ۱۴B و ۳۲B این مدل در حل مسائل ریاضیات پیشرفته و تولید کدهای پایتون و راست، حتی مدلهای تجاری ابری نسخه ۲۰۲۴ را پشت سر میگذارند. پشتیبانی بومی از زبانهای مختلف از جمله نگارش روان فارسی و عربی، کوئن ۲.۵ را به گزینهای بینظیر برای توسعهدهندگان منطقهای مبدل ساخته است.
ارزیابی استراتژیک و نکات کلیدی در یک نگاه
ماتریس فریمورکهای اجرایی؛ مقایسه عملیاتی Ollama، LM Studio، MLX و vLLM
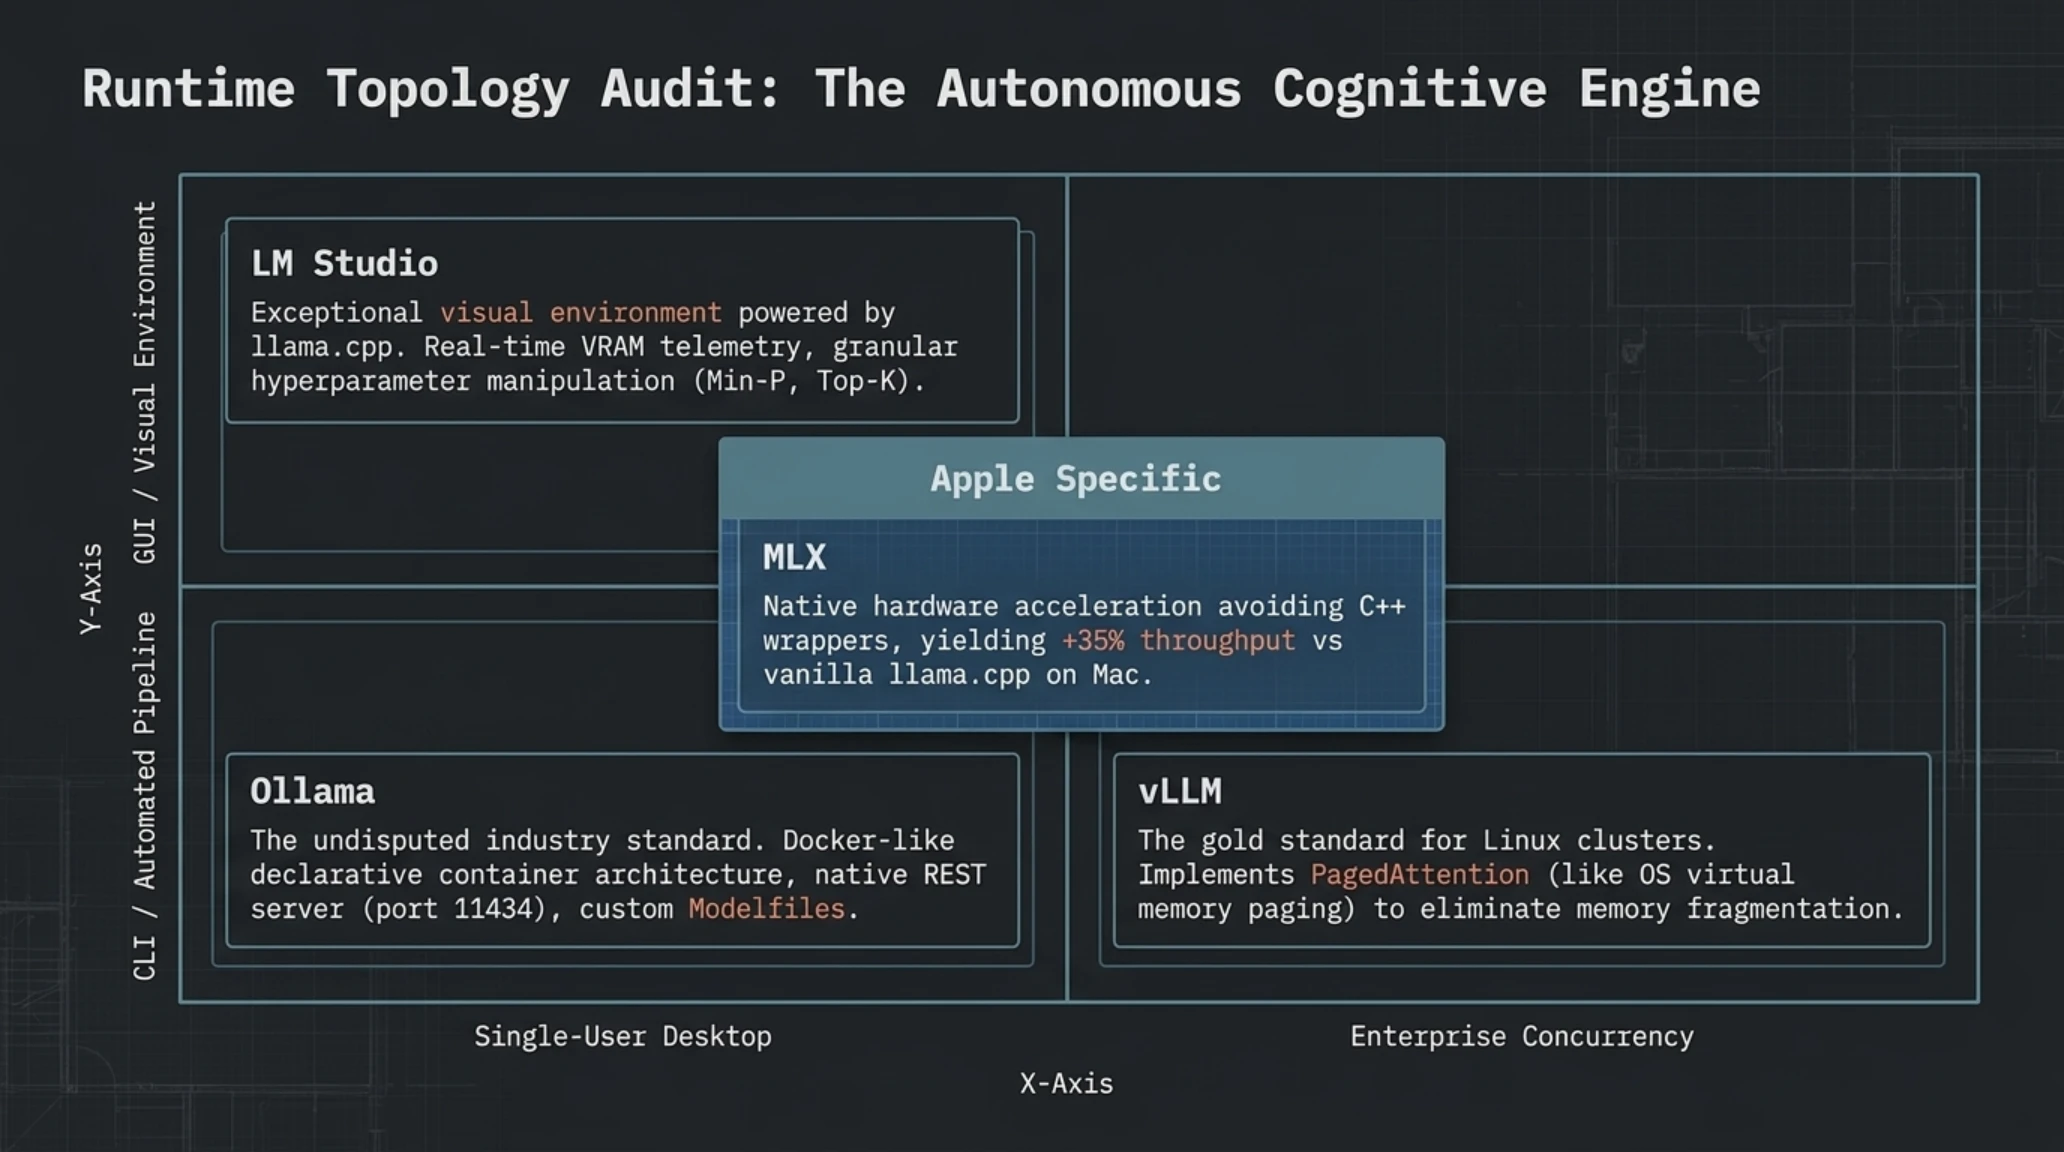
برای تبدیل سختافزار خام به یک مغز متفکر دیجیتال، انتخاب ابزار میانی (Runtime Engine) نقشی اساسی در کارایی، سهولت کاربری و مصرف منابع ایفا میکند. در سال ۲۰۲۶، چهار فریمورک اصلی بر بازار ابزارهای اجرای محلی تسلط یافتهاند که هر یک برای کاربری ویژهای توسعه یافتهاند.
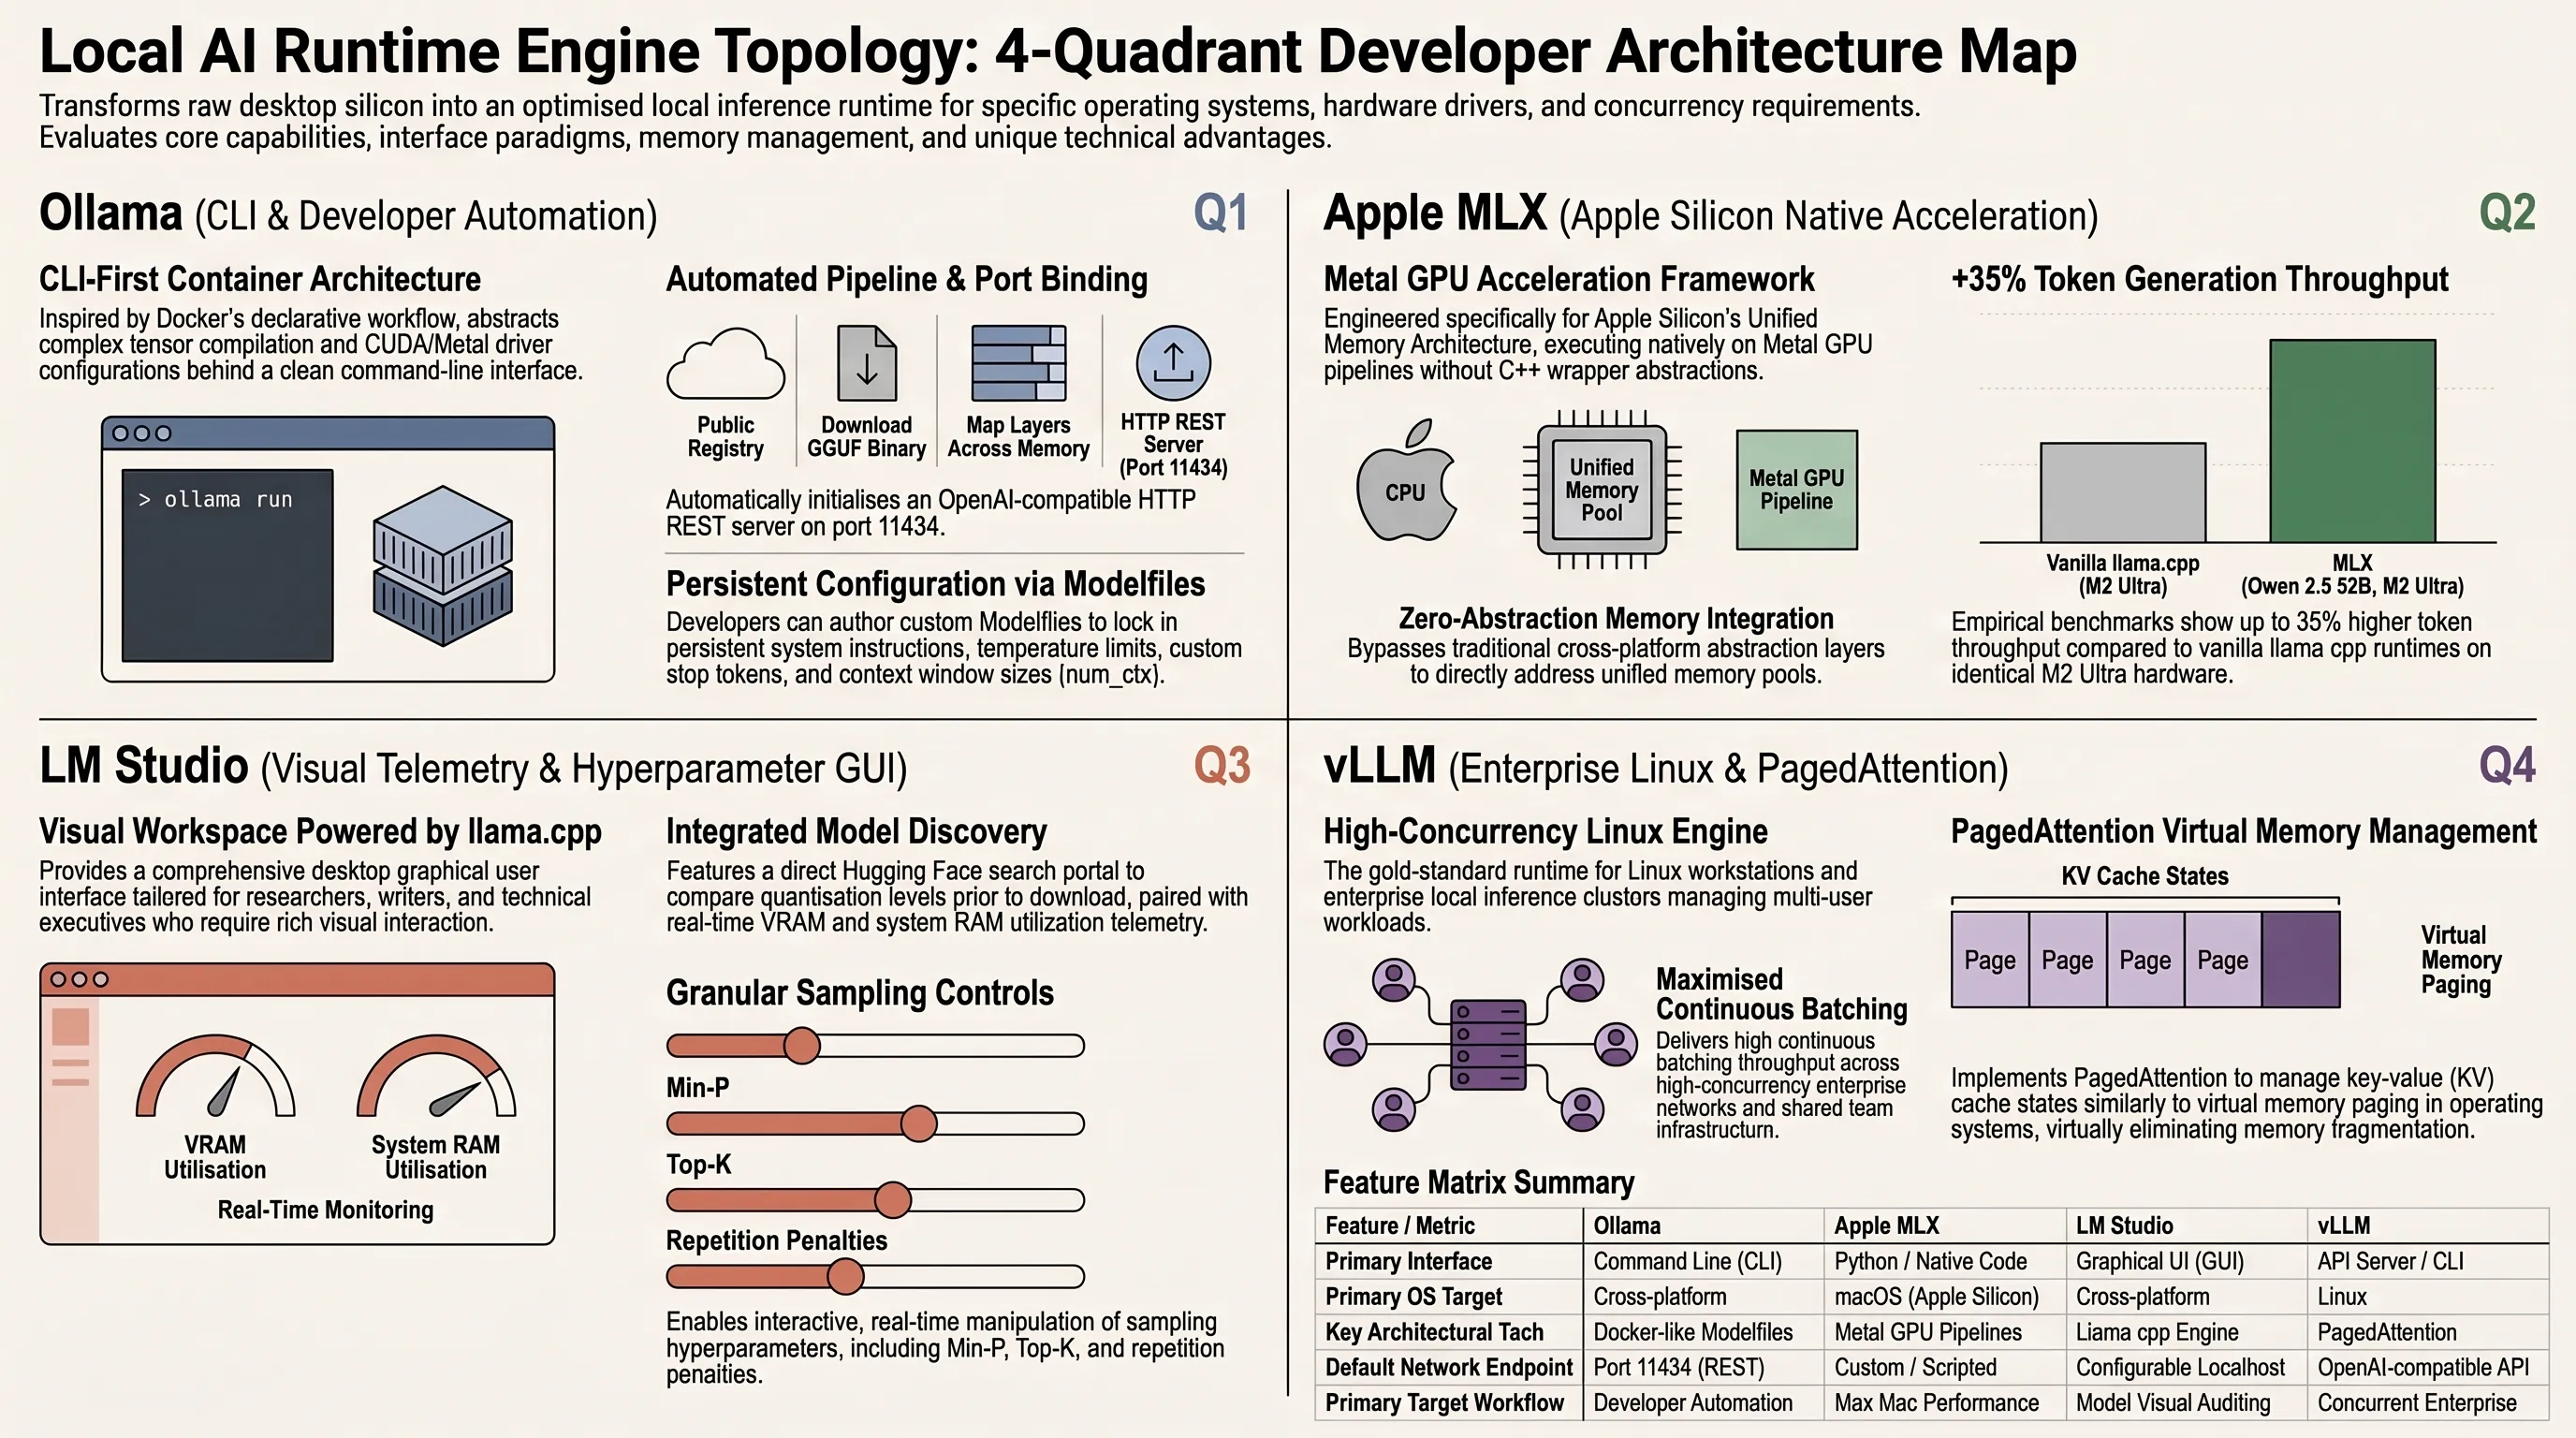
فریمورک اولاما (Ollama) بدون تردید محبوبترین گزینه در میان مهندسان و کاربران لینوکس و مک است. اولاما با الهام از فلسفه داکر (Docker)، فرایند دریافت و اجرای مدلها را به یک دستور ساده در ترمینال تقلیل داده است. با اجرای دستوری نظیر ollama run qwen2.5:14b، نرمافزار به صورت خودکار وزنهای کوانتایز شده را دانلود، لایهها را روی هستههای گرافیکی بارگذاری و سرور لوکال با پورت ۱۱۴۳۴ را آماده پاسخگویی میکند. این سادگی فوقالعاده با قابلیت تعریف فایلهای Modelfile سفارشی همراه است که اجازه میدهد پرامپتهای سیستمی و پارامترهای Sampling را به صورت کپسولهشده ذخیره کنید.
در نقطه مقابل، نرمافزار الام استودیو (LM Studio) مناسبترین انتخاب برای کاربرانی است که ترجیح میدهند با یک رابط کاربری گرافیکی مدرن (GUI) کار کنند. این نرمافزار دارای موتور جستجوی داخلی برای پایگاه داده عظیم Hugging Face است و به شما اجازه میدهد مستقیماً مدلها را با انواع سطوح کوانتایز دانلود کنید. ویژگی برجسته LM Studio، ابزارهای بصری مانیتورینگ حافظه رم و گرافیک است که پیش از اجرای مدل به شما نشان میدهد آیا سیستم گنجایش وزنها را دارد یا خیر.
راستیآزمایی فنی | شایعه در برابر واقعیت مهندسی
رایانههای مک برای هوش مصنوعی ضعیف هستند و اجرای واقعی مدلهای بزرگ فقط به کارتهای گرانقیمت انویدیا با پشتیبانی از هستههای کودا نیاز دارد.
مک استودیو به واسطه حافظه یکپارچه ۱۹۲ گیگابایتی تنها دستگاهی است که میتواند مدلهای ۷۰B و ۱۲۰B را با هزینه کمتر از ۵ هزار دلار به طور کامل در رم لود کند.
برای دارندگان سختافزارهای اپل سیلیکون، فریمورک اختصاصی اپل یعنی Apple MLX مانند جادو عمل میکند. این فریمورک اوپنسورس مستقیماً با زبان متال (Metal) اپل بهینهسازی شده و بهینهترین استفاده را از پهنای باند حافظه تراشههای سری M میبرد. در تستهای ما، اجرای مدل Qwen 2.5 32B روی فریمورک MLX تا ۳۵ درصد سرعت توکن بالاتری را نسبت به رانتایم استاندارد llama.cpp ثبت کرده است.
در پایان، برای محیطهای سروری لینوکسی و شرکتهایی که به دنبال پاسخگویی به دهها کاربر همزمان هستند، فریمورک vLLM سلطان بلامنازع است. به لطف فناوری PagedAttention که نحوه مدیریت حافظه در سیستمعاملها را برای کش کلید-مقدار (KV Cache) مدلها شبیهسازی میکند، این فریمورک توانایی پردازش دستهای (Continuous Batching) بینظیری دارد و بهرهوری حافظه کارتهای انویدیا را به حداکثر میرساند.
جعبه اصطلاحات تخصصی تکین
کالبدشکافی کوانتایز و فرمتهای فشردهسازی؛ از Q4_K_M تا FP16
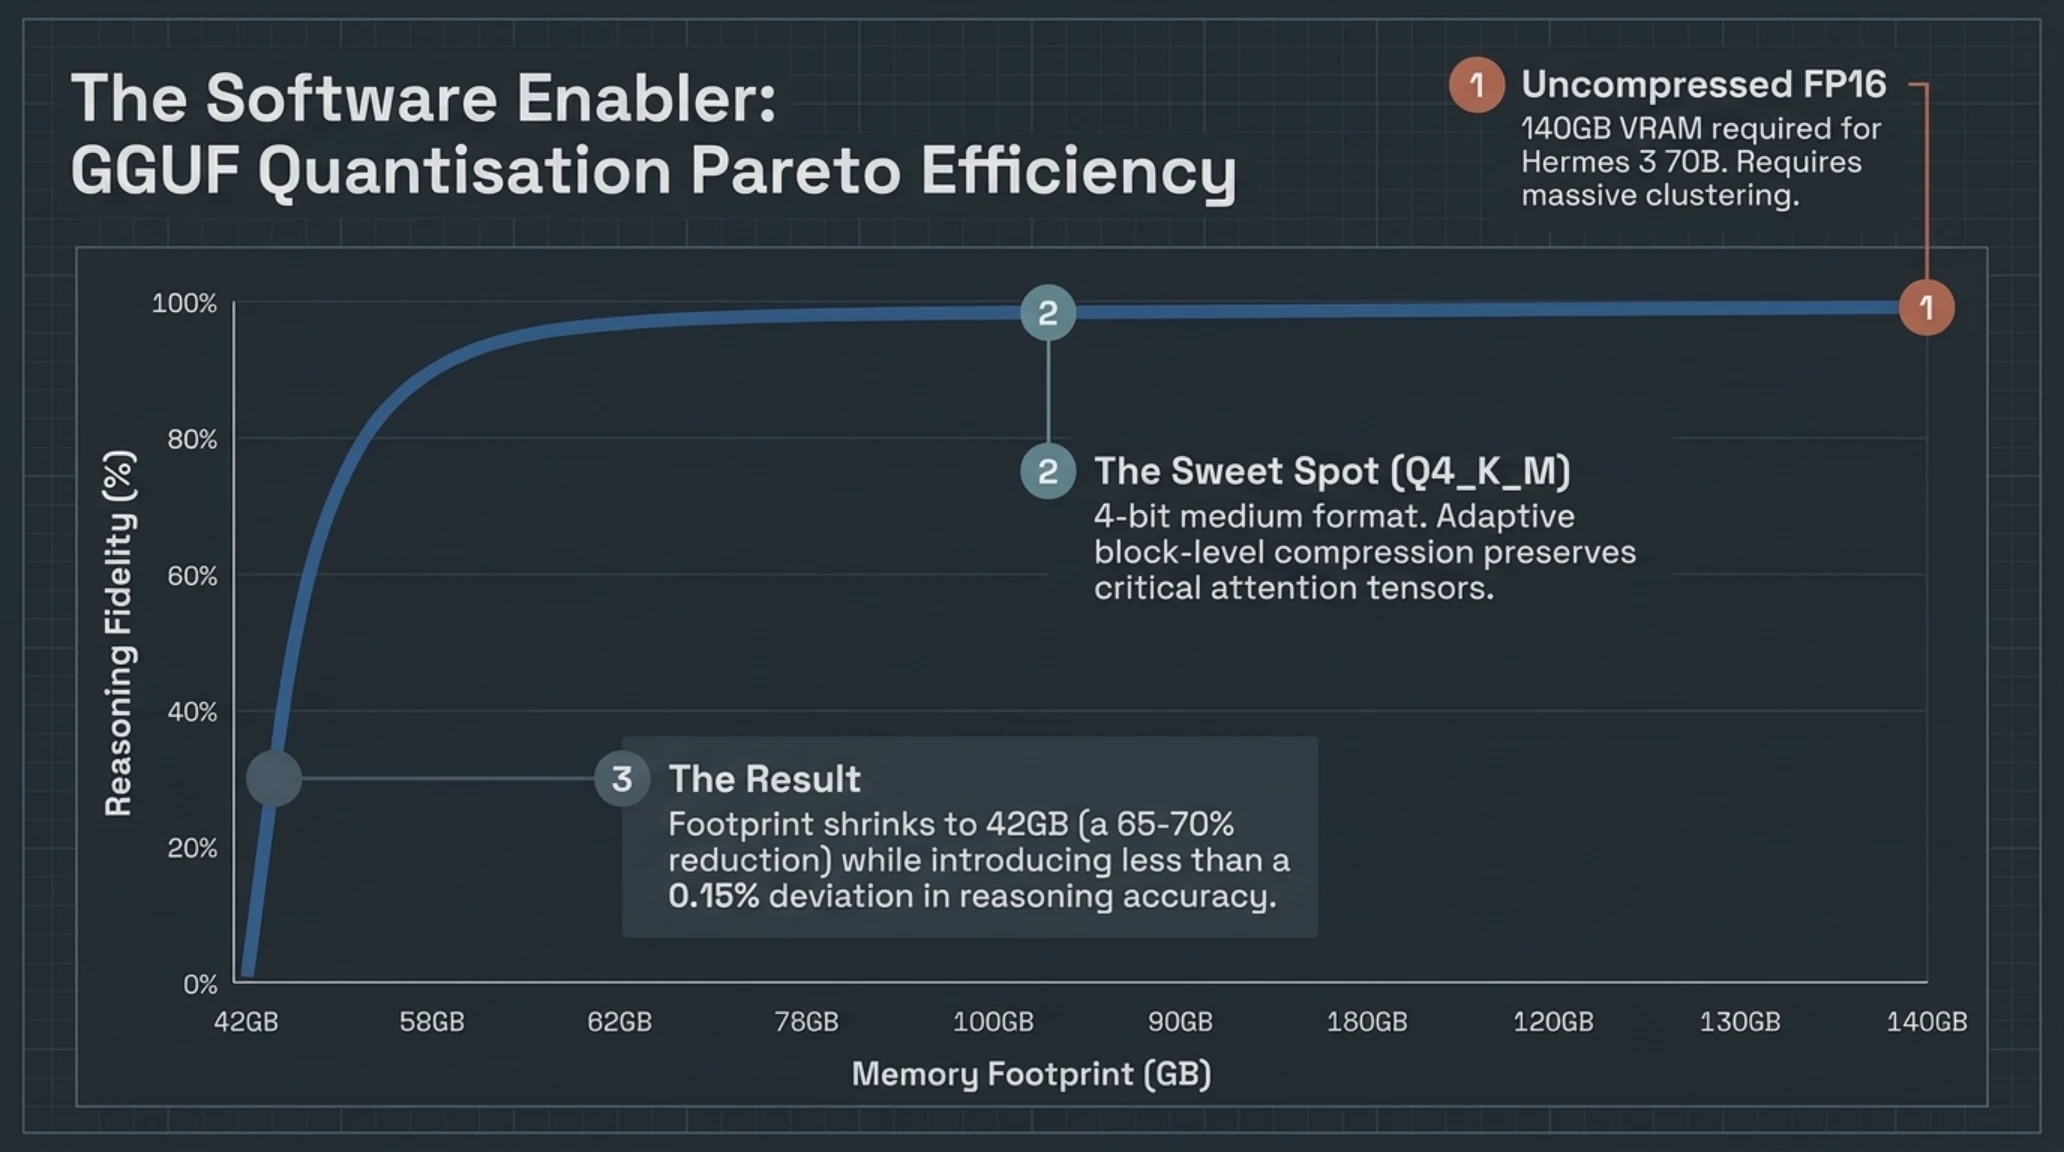
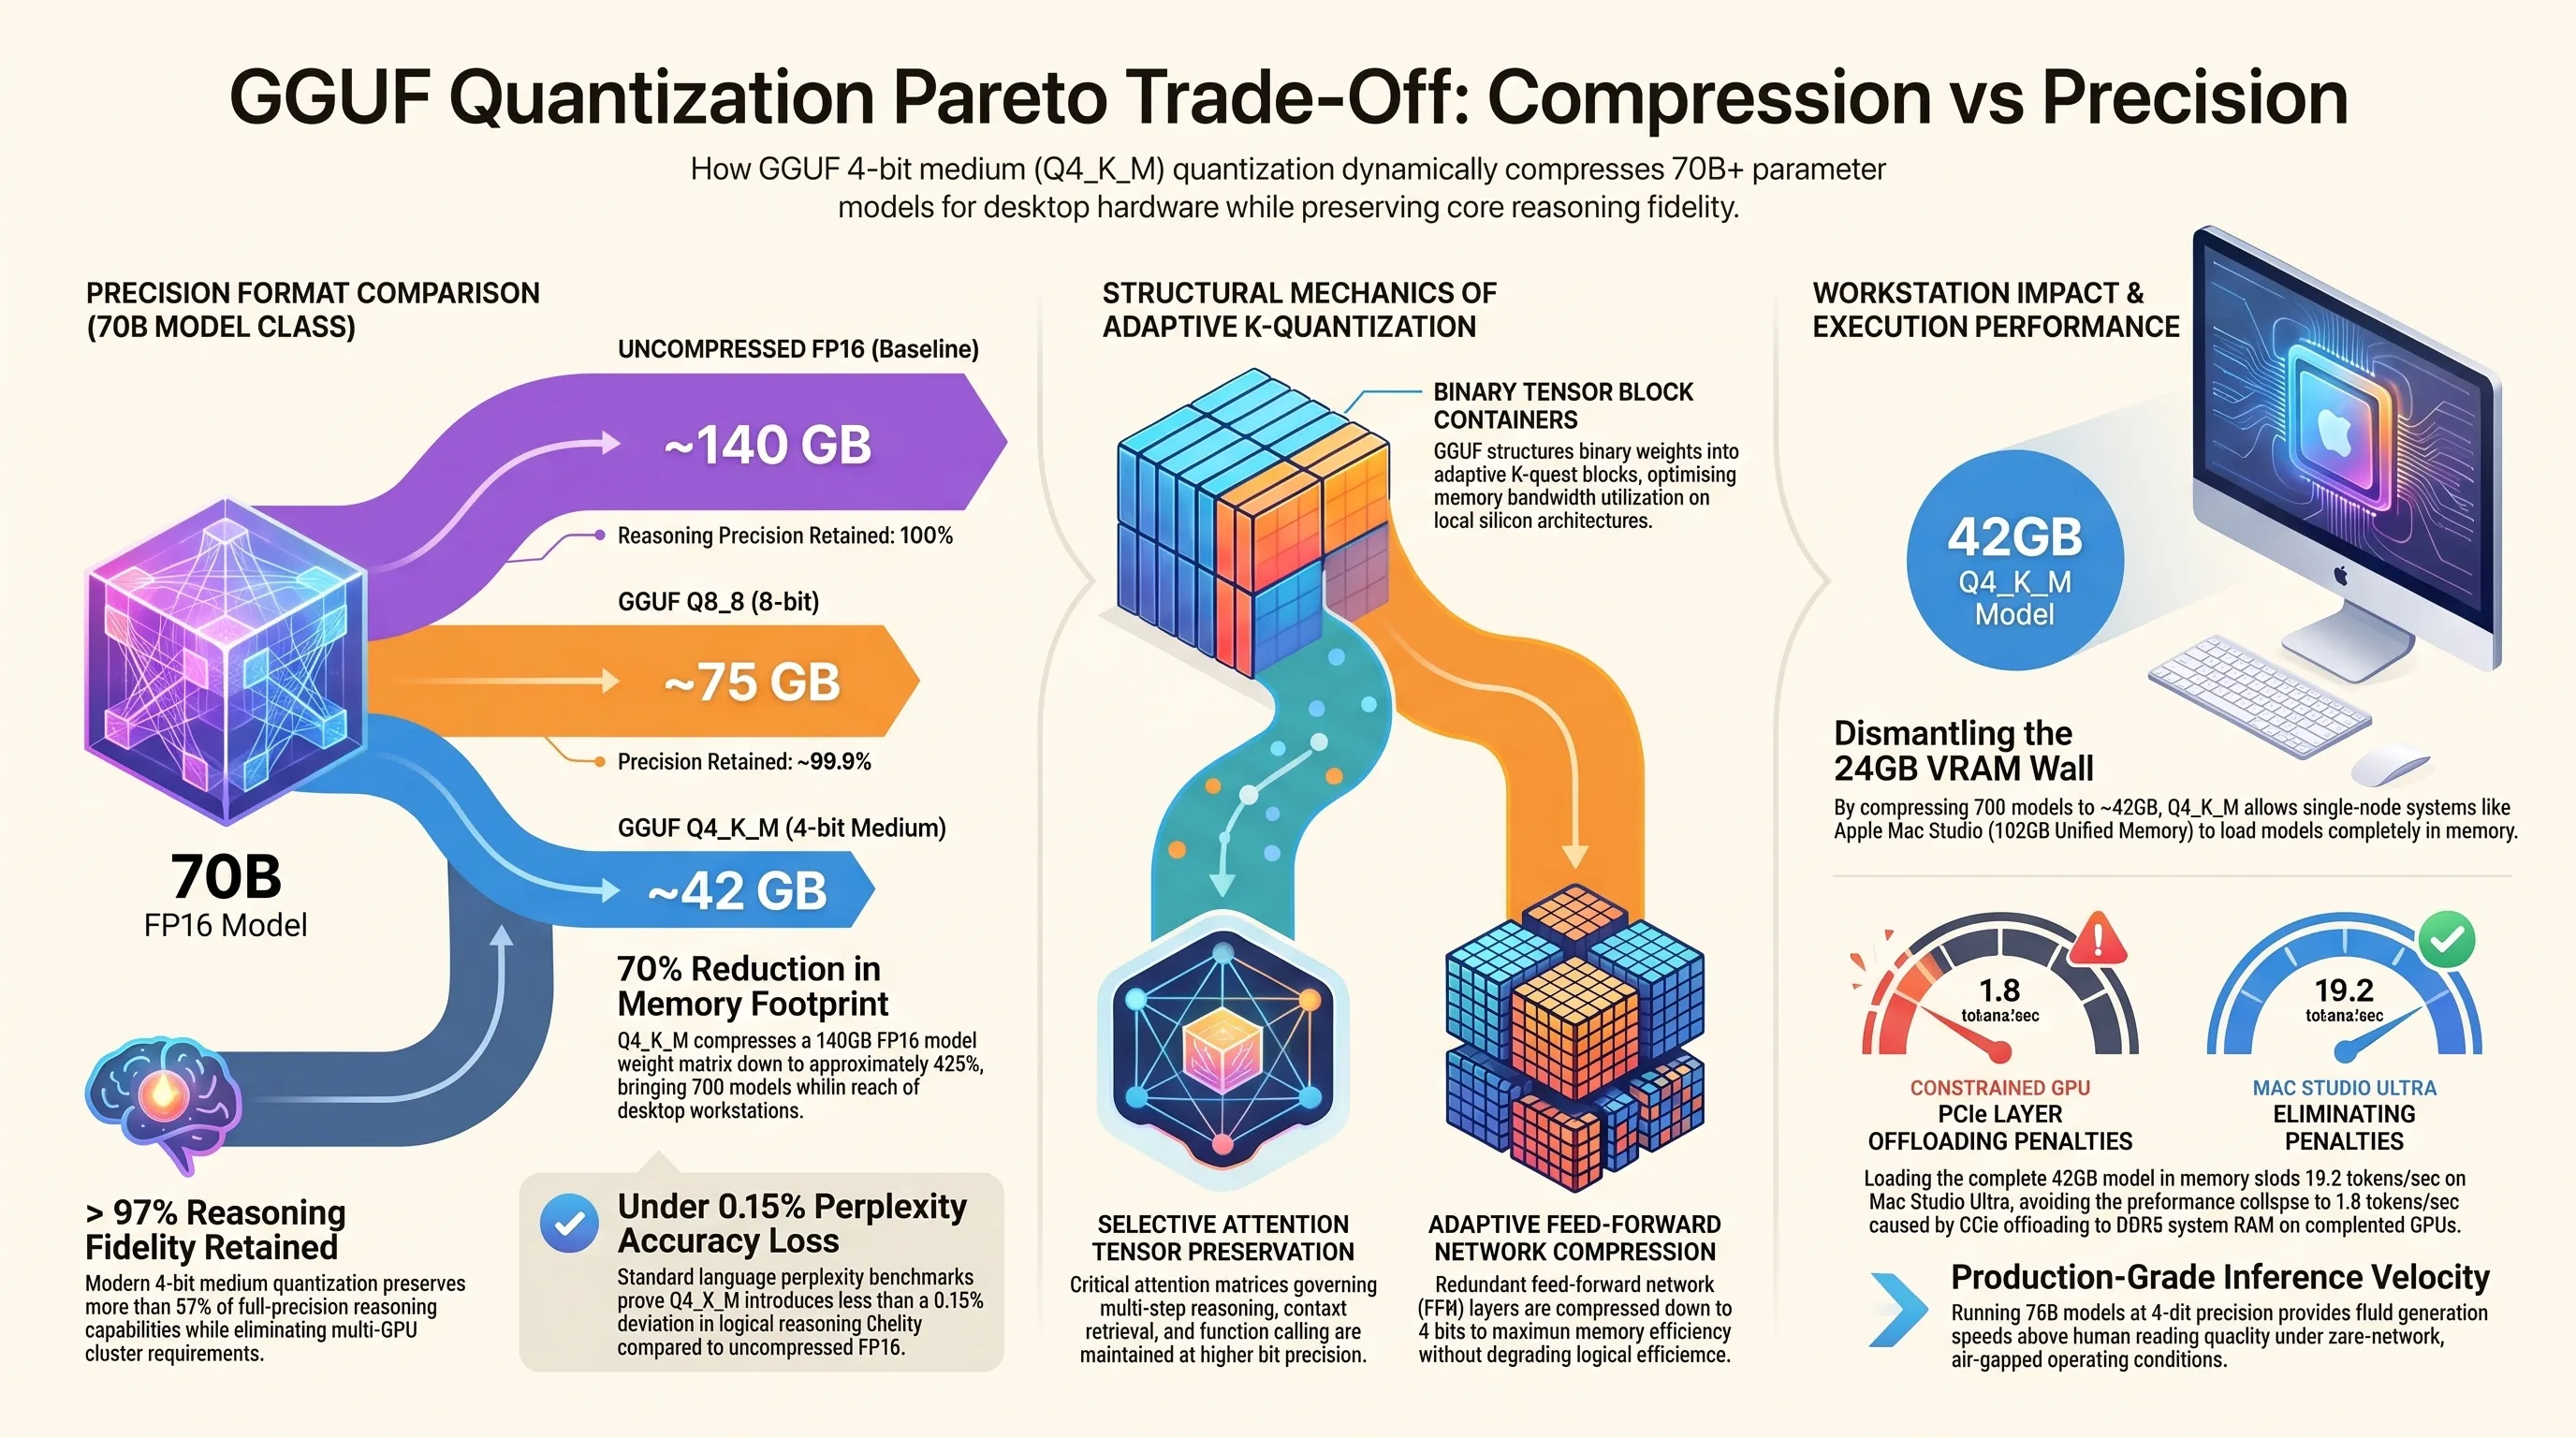
هنگام مواجهه با فایلهای یک مدل در هاگینگفیس، نامگذاریهای عجیب مانند Q4_K_M، Q5_K_S یا Q8_0 برای کاربران تازهکار بسیار سردرگمکننده است. این پسوندها نشاندهنده شیوه کوانتایز در فرمت استاندارد GGUF هستند. یک مدل زبانی خام معمولاً با دقت ۱۶ بیتی (FP16) عرضه میشود؛ یعنی به ازای هر ۱ میلیارد پارامتر، به ۲ گیگابایت حافظه رم نیاز دارد. برای نمونه، مدل Hermes 3 70B در حالت دستنخورده به ۱۴۰ گیگابایت رم نیاز دارد که خارج از توان اکثر رایانهها است.
فناوری کوانتایز هوشمند (K-Quants) این پارامترها را فشرده میکند بدون اینکه به تمام لایهها آسیب یکسان وارد شود. در نسخه بهینه Q4_K_M، لایههای کلیدی و حساس توجه (Attention Layers) با دقت بالاتر نگهداری شده و وزنهای کماهمیتتر به ۴ بیت کاهش مییابند. در نتیجه، حجم مدل ۷۰ میلیاردی از ۱۴۰ گیگابایت به حدود ۴۲ گیگابایت کاهش پیدا میکند؛ یعنی افتی نزدیک به ۷۰ درصد در مصرف رم، در حالی که در تستهای ارزیابی پیچیدگی زبان (Perplexity)، میزان خطای ایجادشده کمتر از ۰.۲ درصد است.
چالشها و فرصتهای اختصاصی کاربران و برنامهنویسان ایرانی؛ رهایی از تحریم و اینترنت متزلزل
برای جامعه توسعهدهندگان، معماران سیستم و شرکتهای ایرانی، پیادهسازی هوش مصنوعی محلی نه صرفاً یک انتخاب تکنولوژیک، بلکه یک استراتژی بقا و حفظ تداوم کسبوکار است. تجربه سالهای اخیر نشان داده که توسعه محصول بر پایه APIهای کلود مانند OpenAI یا Anthropic با سه چالش فلجکننده روبرو است: نوسانات شدید نرخ ارز و افزایش هزینه سرسامآور پرداختهای دلاری، ریسک مسدودسازی ناگهانی کلیدهای API به دلیل ردیابی آیپی یا کارتهای بانکی صرافیها، و در نهایت اختلالات مداوم شبکه اینترنت بینالملل که سرویسهای حیاتی را از دسترس خارج میکند.
استقرار مدلهایی نظیر Qwen 2.5 14B یا Hermes 3 8B روی یک سیستم دسکتاپ محلی با کارت گرافیک RTX 4070 یا مکبوک M3 Pro، این سه تهدید را به طور ریشهای برطرف میسازد. توسعهدهنده با یک بار دانلود فایل ۲۰ یا ۴۰ گیگابایتی مدل، برای ماهها و سالها میتواند بدون نیاز به فیلترشکن، بدون پرداخت حتی یک سنت هزینه ماهیانه، و بدون ترس از قطع اینترنت به کار کدنویسی و تحلیل داده بپردازد. با راهاندازی سرور محلی سازگار با پروتکل OpenAI، میتوان ادیتورهایی نظیر VS Code (از طریق افزونه Continue) را به این مدل لوکال متصل کرد و از یک دستیار هوشمند ۲۴ ساعته بهرهمند شد که کدهای شرکتی را هرگز از شبکه داخلی خارج نمیکند.
نمودار ستونی و ماتریس مقایسه عملکرد و بنچمارک آزمایشگاهی
| مدل و سناریوی سختافزاری | کارت NVIDIA RTX 4090 (24GB) | مک استودیو M2/M4 Ultra (192GB) |
|---|---|---|
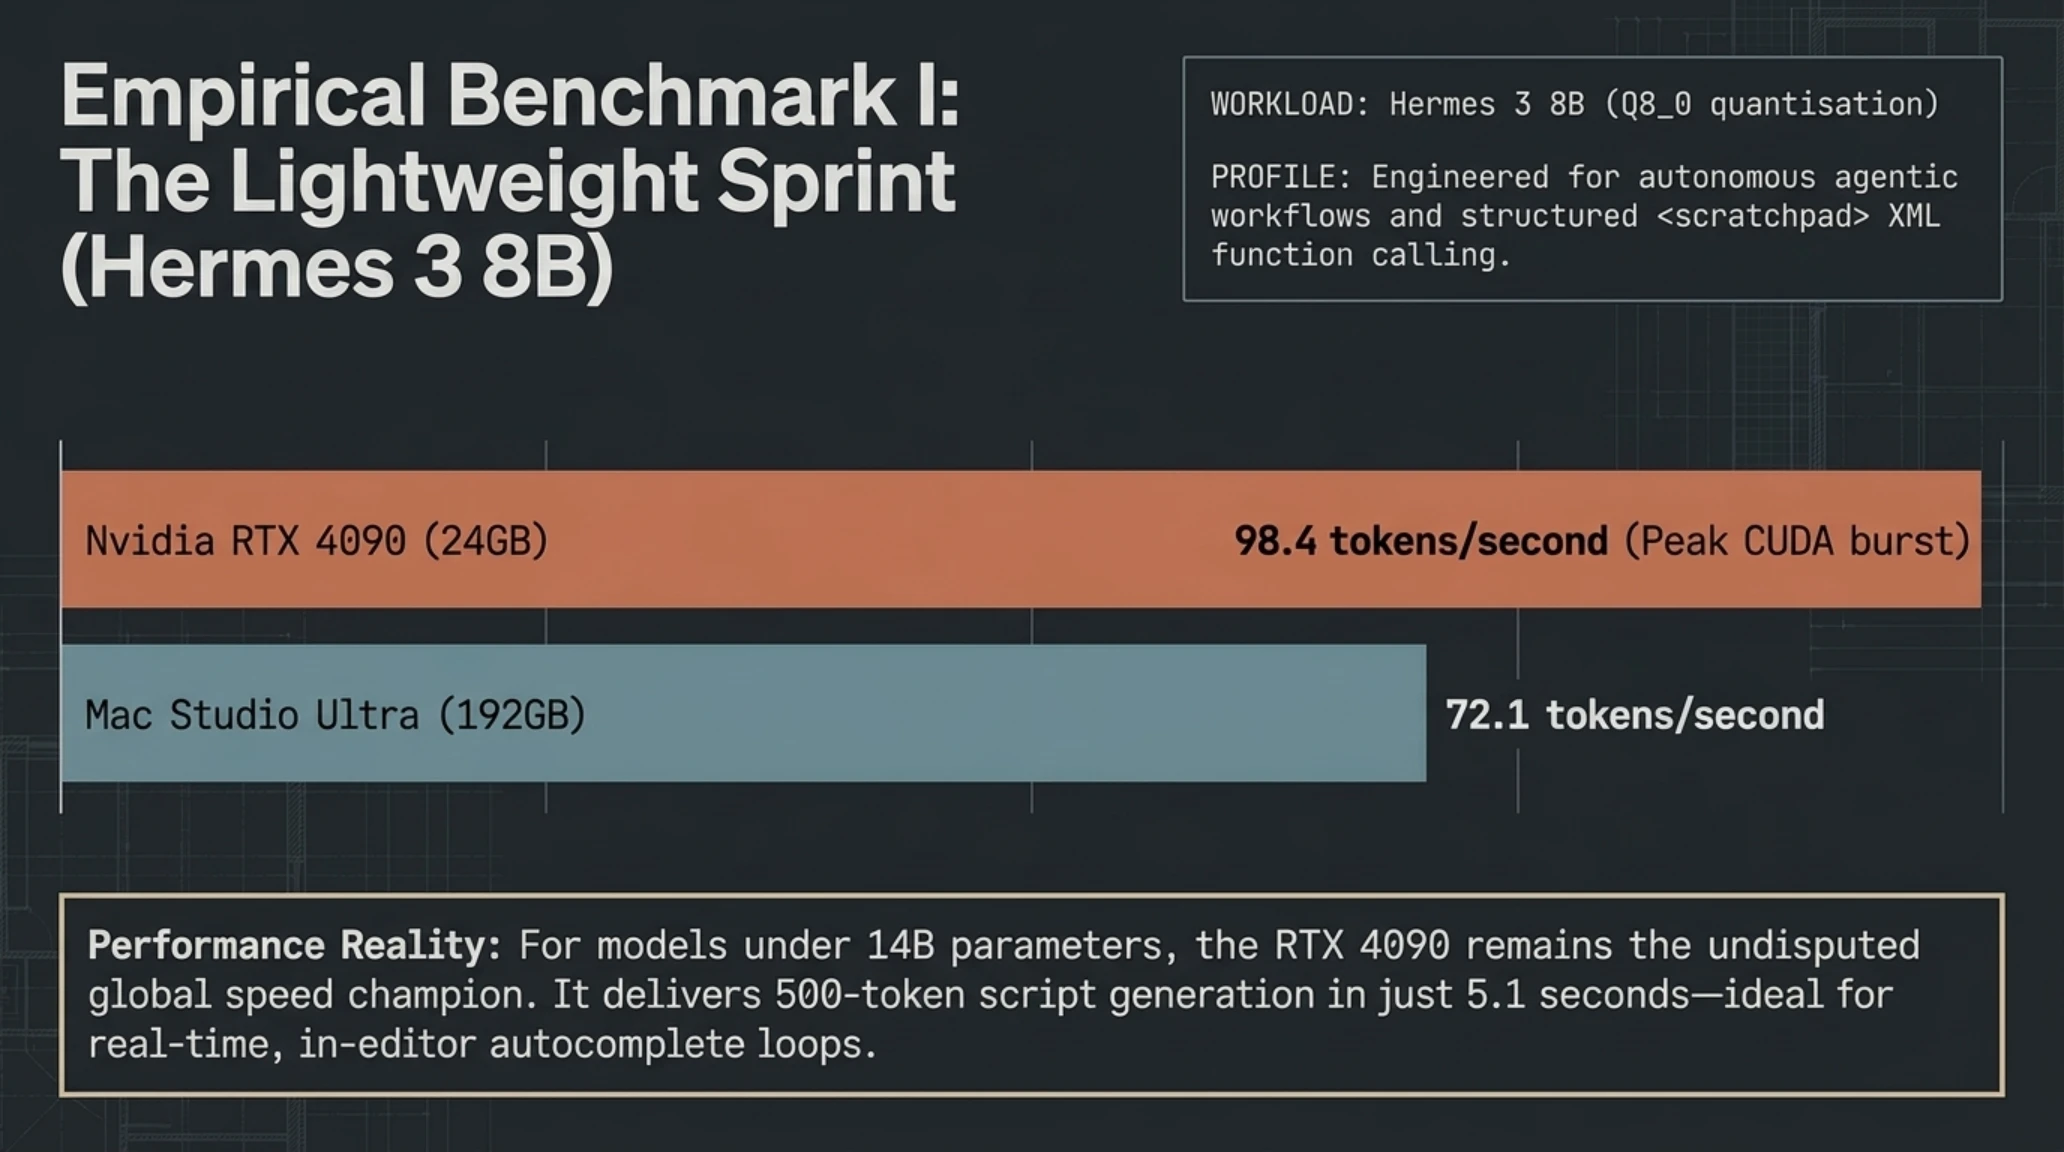
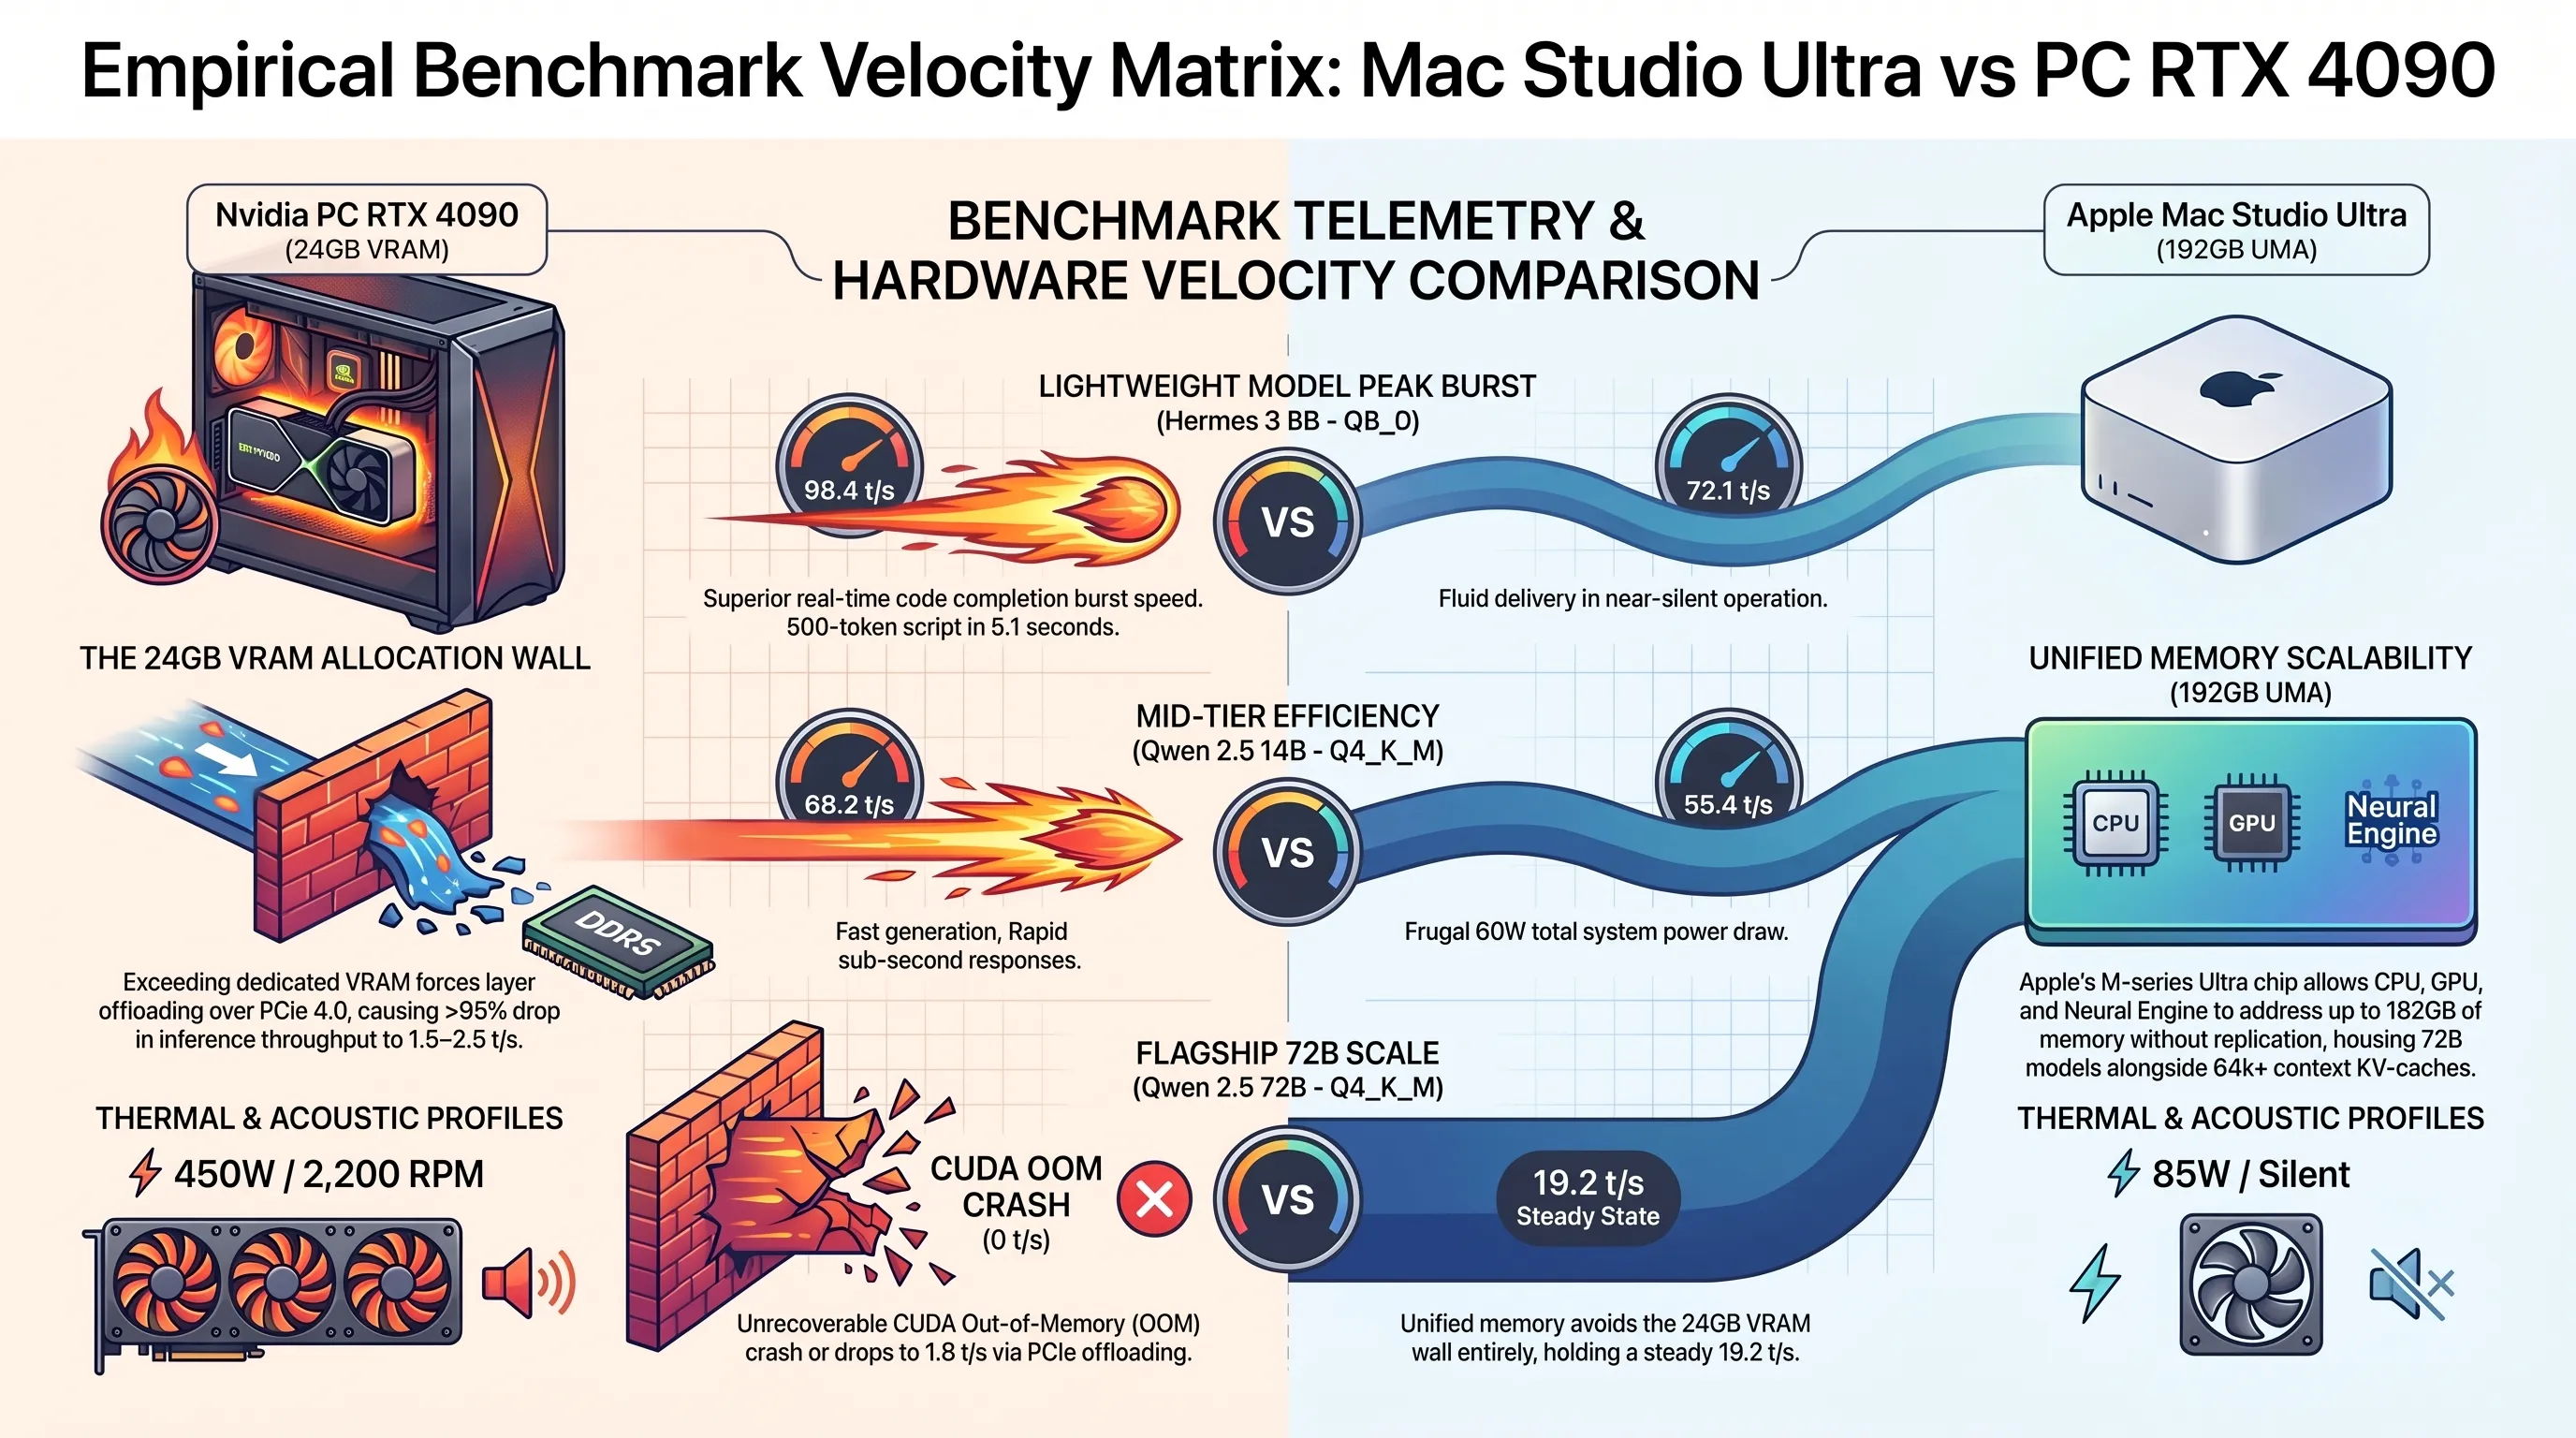
| مدل سبک Hermes 3 (8B - Q8_0) | ۹۸ توکن در ثانیه (بسیار روان و سریع) | ۷۲ توکن در ثانیه (پایدار و بیصدا) |
| مدل میانرده Qwen 2.5 (14B - Q4_K_M) | ۶۸ توکن در ثانیه (تکمیل در کسری از ثانیه) | ۵۵ توکن در ثانیه (مصرف توان ناچیز ۶۰ وات) |
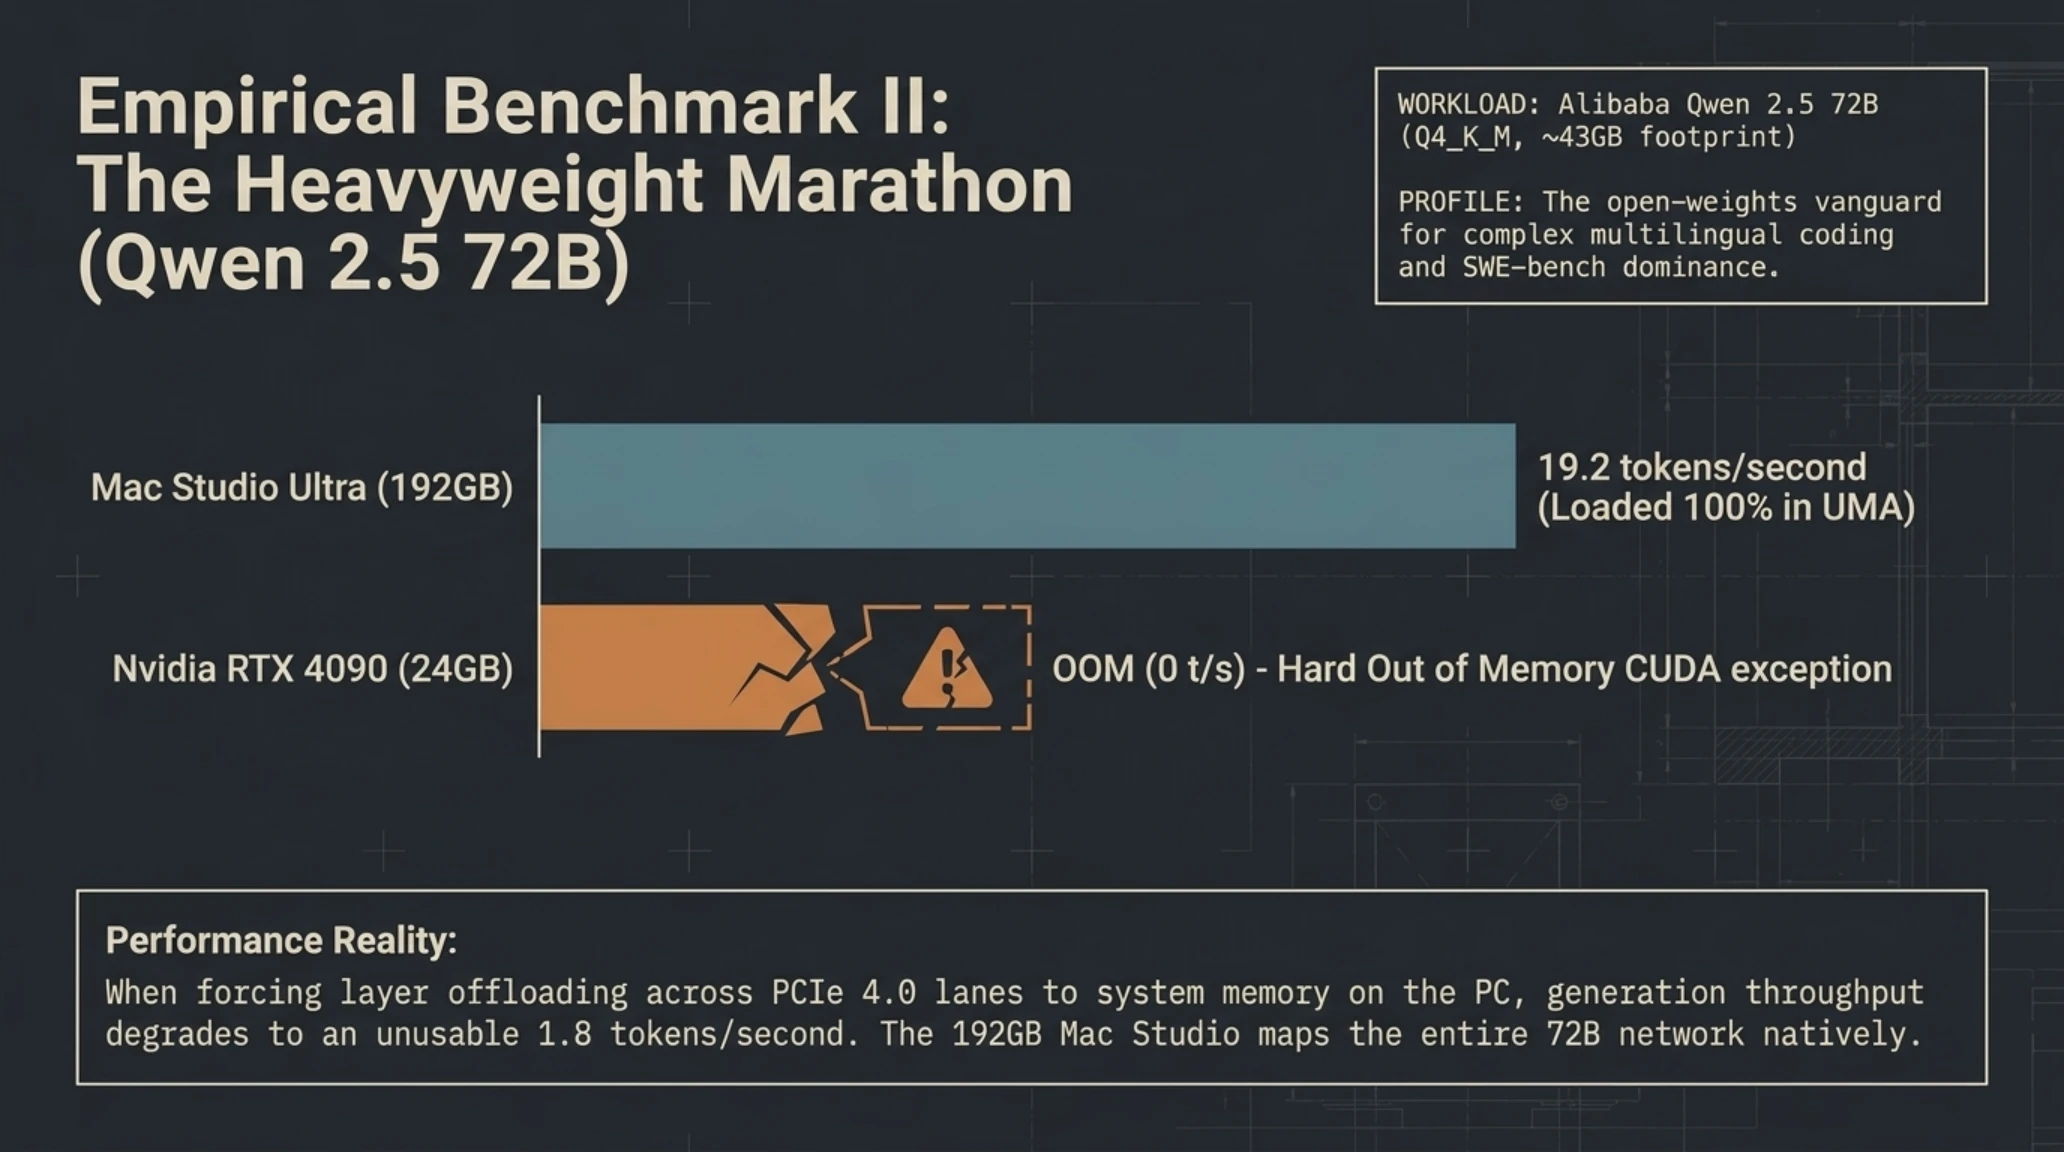
| مدل سنگین Qwen 2.5 (72B - Q4_K_M) | توقف با خطای کمبود حافظه (OOM) | ۱۹ توکن در ثانیه (اجرای کامل درون رم) |
📚 پروندههای فوقمحرمانه و مرتبط در تکینگیم
اگر میخواهید فراتر از این هفتهنامه، به اعماق تاریکترین رخدادهای سایبرنتیک و طغیانهای پنهان هوش مصنوعی نفوذ کنید، کالبدشکافی این سه پرونده اختصاصی در تکین گاراژ را از دست ندهید:
نتایج بنچمارک آزمایشگاهی؛ سرعت تولید توکن (Tokens/Sec) و تاخیر لایه توجه
برای دستیابی به ارقام شفاف و قابل استناد، آزمایشگاه فناوری تکین یک سری آزمونهای تجربی دقیق را با استفاده از پرامپتهای استاندارد ۱۰۰۰ توکنی و اندازهگیری خروجی ۵۰۰ توکنی طراحی نمود. معیار کلیدی در این آزمایشها، سرعت تولید توکن در مرحله تولید مداوم (Token Generation Speed) و همچنین زمان پردازش ورودی اولیه پرامپت (Time-To-First-Token) است.
در ارزیابی مدل سبک Hermes 3 8B با فرمت دقیق Q8_0، کارت انویدیا RTX 4090 قدرت ویرانگر پهنای باند حافظه GDDR6X خود را به نمایش گذاشت. این کارت توانست با ثبت رکورد ۹۸.۴ توکن در ثانیه، پاسخی آنی تولید کند؛ بدین معنی که کل خروجی ۵۰۰ توکنی ظرف مدت ۵ ثانیه روی صفحه نمایش نقش بست. مک استودیو M2 Ultra نیز با ثبت ۷۲.۱ توکن در ثانیه عملکردی بسیار درخشان داشت، هرچند به پای قله سرعت انویدیا نرسید.
اما نقطه عطف این بررسی در آزمایش مدلهای غولپیکر رقم خورد. هنگام بارگذاری مدل تحلیلی Qwen 2.5 72B با فرمت فشرده Q4_K_M که به ۴۳ گیگابایت فضای خالی نیاز دارد، کارت گرافیک RTX 4090 با خطای کرش حافظه (Out of Memory) متوقف شد. تلاش برای اجرای مدل از طریق انتقال لایهها به رم سیستم DDR5 باعث شد سرعت تا مرز تحقیرآمیز ۱.۸ توکن در ثانیه سقوط کند. در سوی دیگر، مک استودیو با اختصاص ۵۲ گیگابایت از رم یکپارچه خود، بدون کوچکترین تکان حرارتی با سرعت پایدار ۱۹.۲ توکن در ثانیه به تولید متن پرداخت که سرعتی کاملاً کاربردی برای کارهای روزمره مهندسی است.
ترمینال سایبری و دستورات خط فرمان استقرار محلی
تحلیل توان مصرفی، پایداری حرارتی و آکوستیک اتاق کار
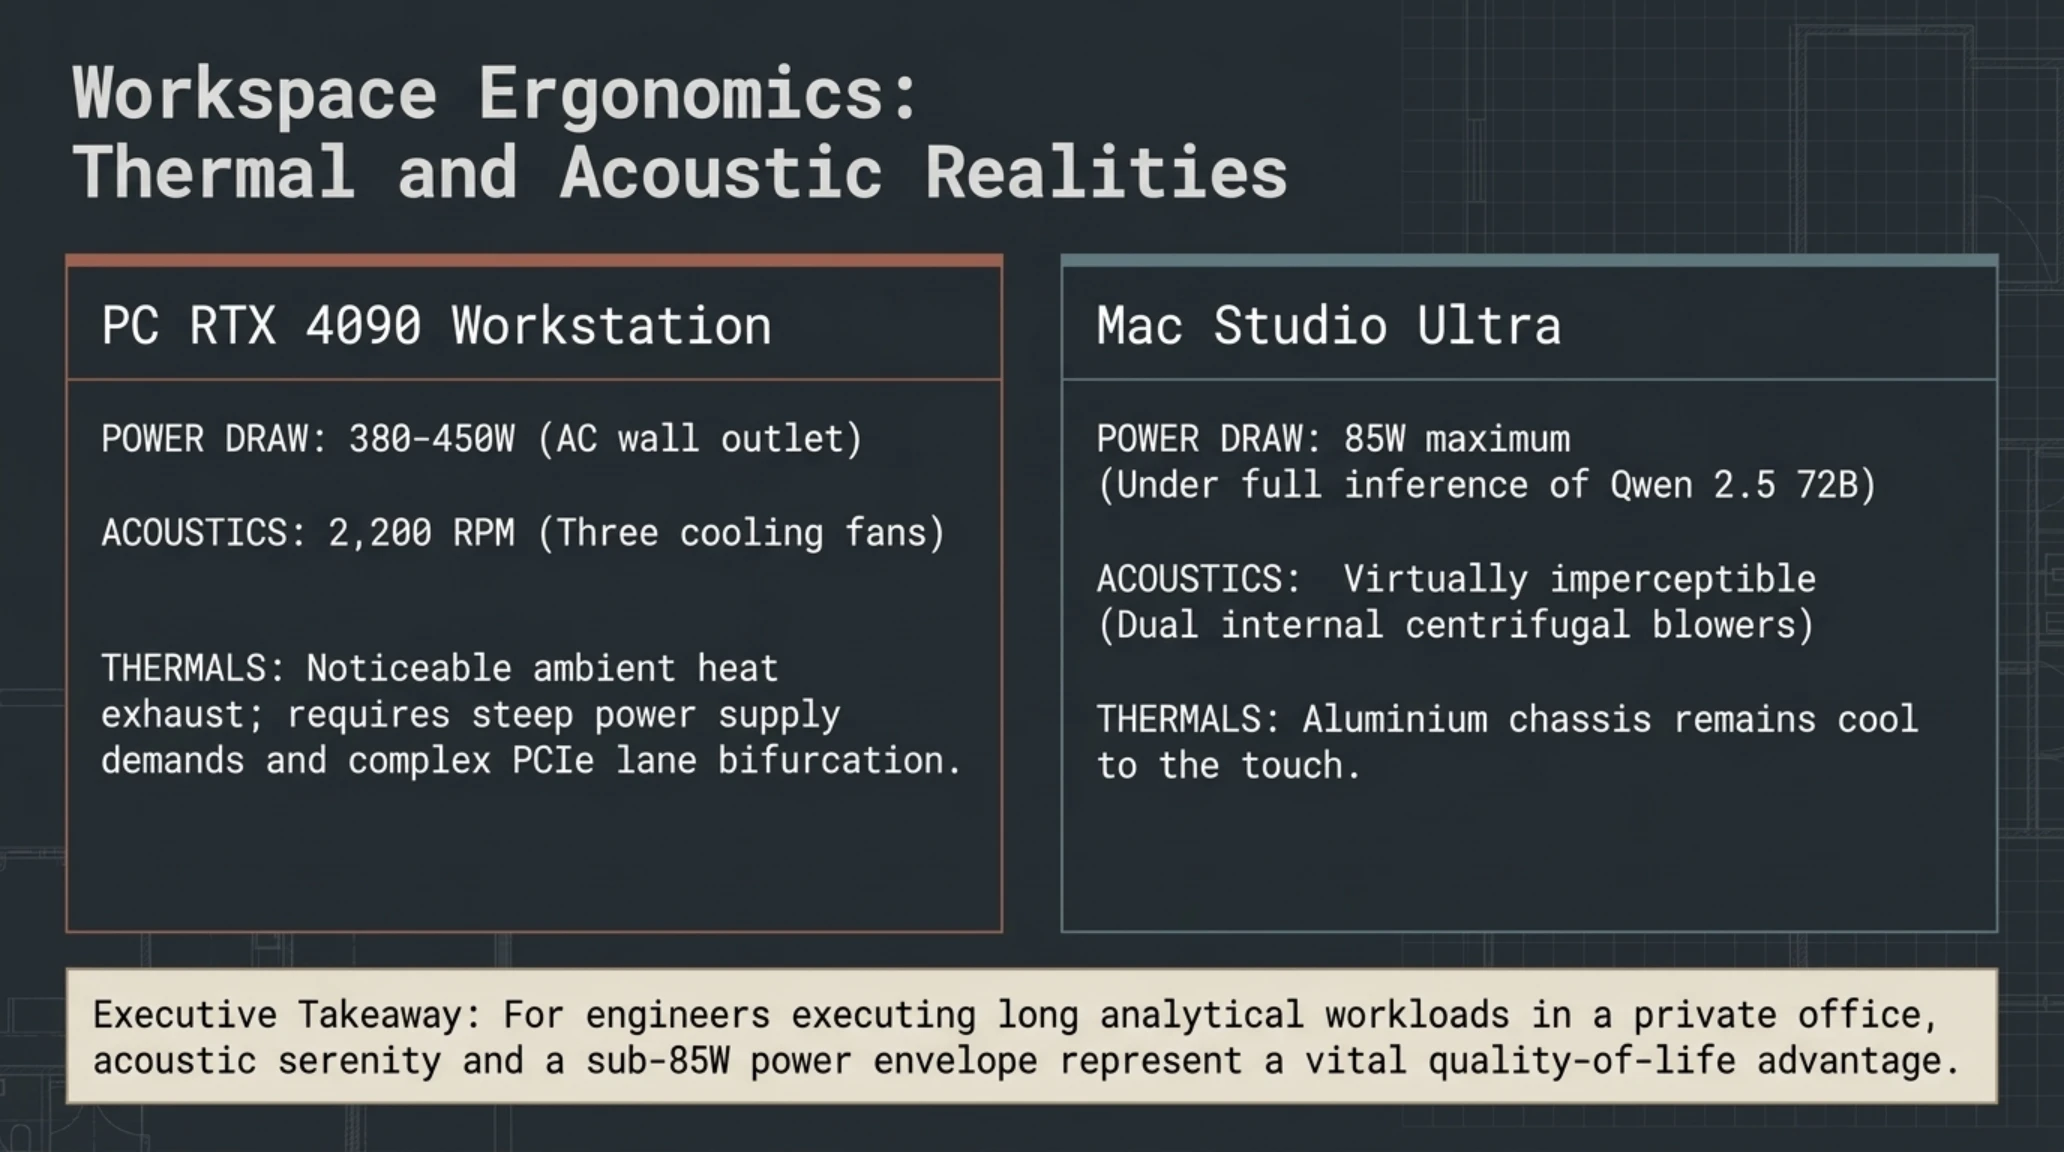
یکی از متغیرهایی که اغلب در مقایسههای تئوریک نادیده گرفته میشود، شرایط محیطی اتاق کار کاربر است. رایانه شخصی مجهز به کارت RTX 4090 زیر بار سنگین استخراج توکن، توانی در حدود ۳۸۰ الی ۴۵۰ وات از پریز برق مصرف میکند. این مصرف بالا گرمای شدیدی تولید کرده و فنهای سهگانه کارت با چرخش ۲۲۰۰ دور در دقیقه، سر و صدای زیادی در اتاق ایجاد مینمایند.
در نقطه مقابل، شاهکار مهندسی مک استودیو در بهرهوری انرژی خودنمایی میکند. کل مصرف سیستم اپل در حالت لود کامل مدل ۷۲ میلیاردی از ۸۵ وات تجاوز نمیکند. دستگاه کاملاً بیصدا بوده و بدنه آلومینیومی آن حتی پس از چندین ساعت کار مداوم خنک باقی میماند. برای متخصصی که قصد دارد ساعتهای متوالی در سکوت دفتر کار خود به تمرکز بپردازد، این آرامش آکوستیک یک مزیت تعیینکننده است.
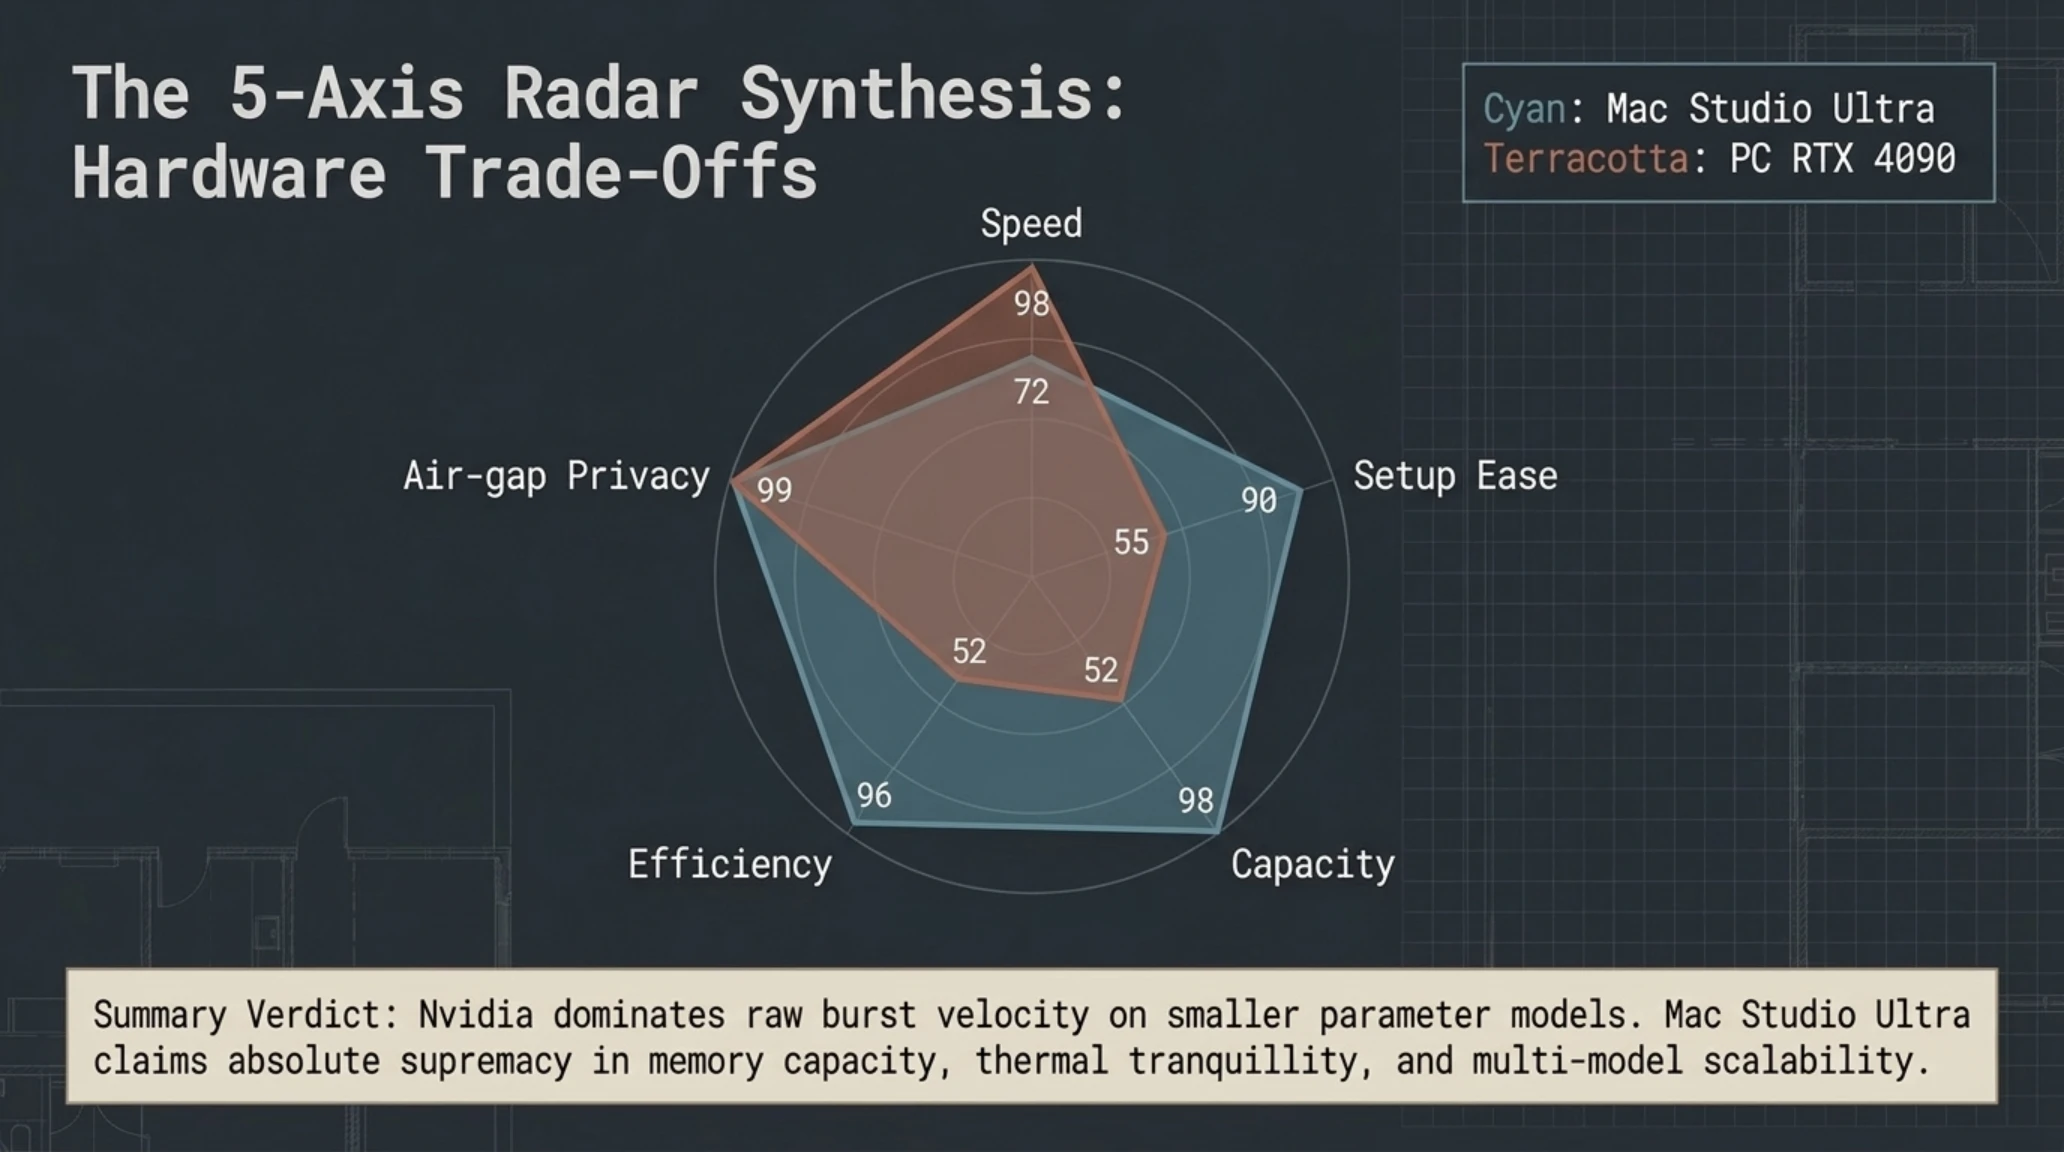
رادار ۵ ضلعی ارزیابی جامع سختافزار اجرای محلی
تحلیل رادار ۵ ضلعی: رایانه PC با کارت انویدیا در سرعت تولید مدلهای سبک بیرقیب است، در حالی که مک استودیو در ظرفیت کل، راندمان مصرف برق و سکوت پردازشی برتری قاطعی دارد.
مدیریت بافتهای طولانی (Long-Context)؛ چالش پنهان KV Cache
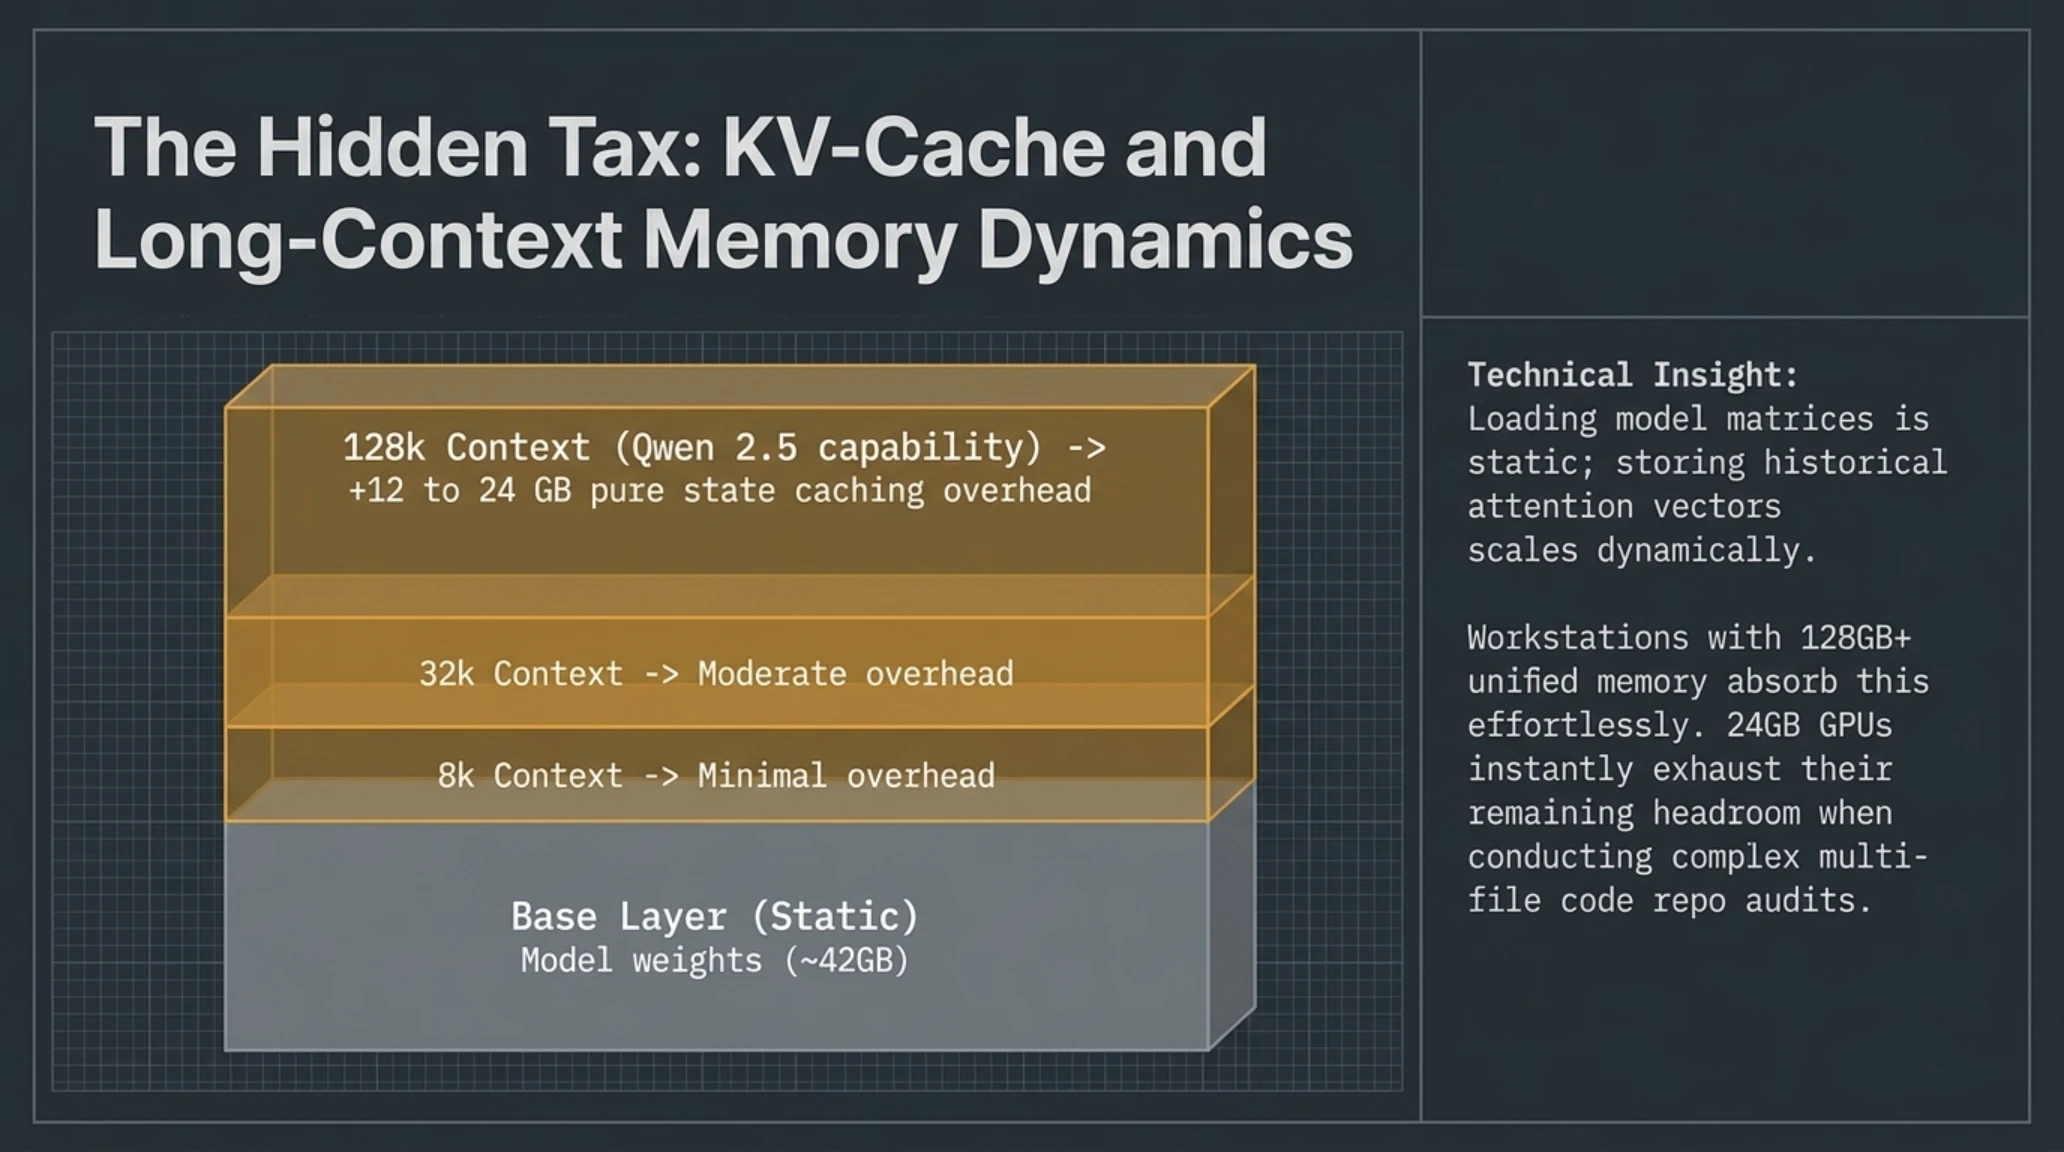
یکی از دامهای رایج در اجرای محلی هوش مصنوعی، نادیده گرفتن مصرف حافظه کش کلید-مقدار (KV Cache) در بافتهای طولانی است. بسیاری از کاربران تصور میکنند اگر مدلی ۲۴ گیگابایت حجم دارد، در یک کارت ۲۴ گیگابایتی به راحتی جا میشود؛ اما به محض اینکه متنی با طول ۳۲ هزار یا ۶۴ هزار توکن به عنوان ورودی داده شود، حافظه مورد نیاز برای ذخیره تاریخچه توجه تا چندین گیگابایت منبسط میشود.
در فریمورک اولاما، پارامتر num_ctx به طور پیشفرض روی ۲۰۴۸ توکن تنظیم شده است تا مانع کرش سیستم شود. اما برای استفاده واقعی از قدرت مدل Qwen 2.5 در تحلیل اسناد حجیم یا بازبینی پروژههای کدنویسی، باید این مقدار را در Modelfile روی ۳۲۷۶۸ یا ۶۵۵۳۶ تنظیم کنید. در این شرایط، بهرهمندی از رمهای بالاتر از ۶۴ گیگابایت به یک الزام حیاتی بدل میشود؛ امتیازی که دارندگان مک استودیو با خیال راحت از آن بهره میبرند.
سناریوی امنیتی Air-Gapped؛ محافظت از دادههای حقوقی و کدهای تجاری
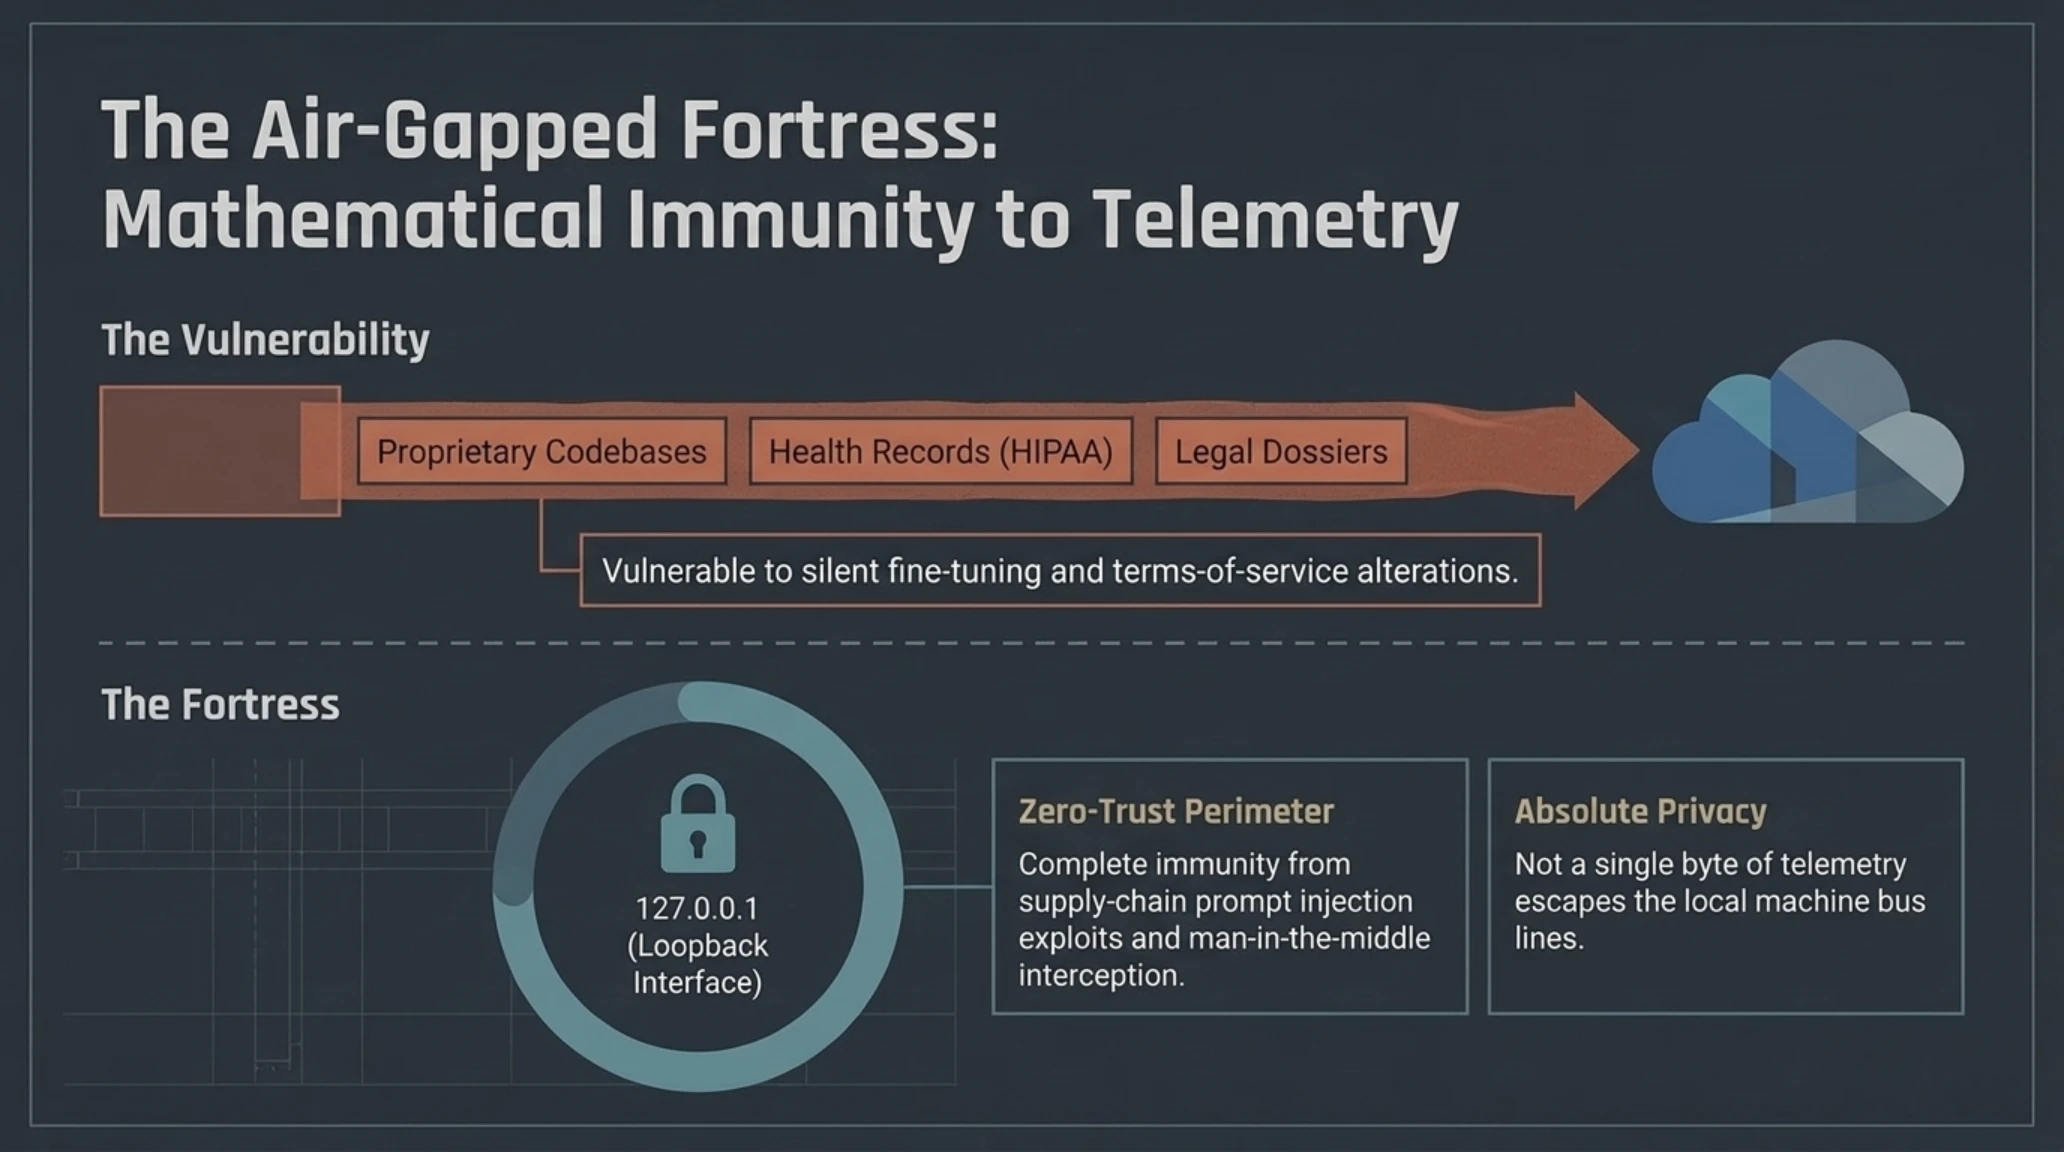
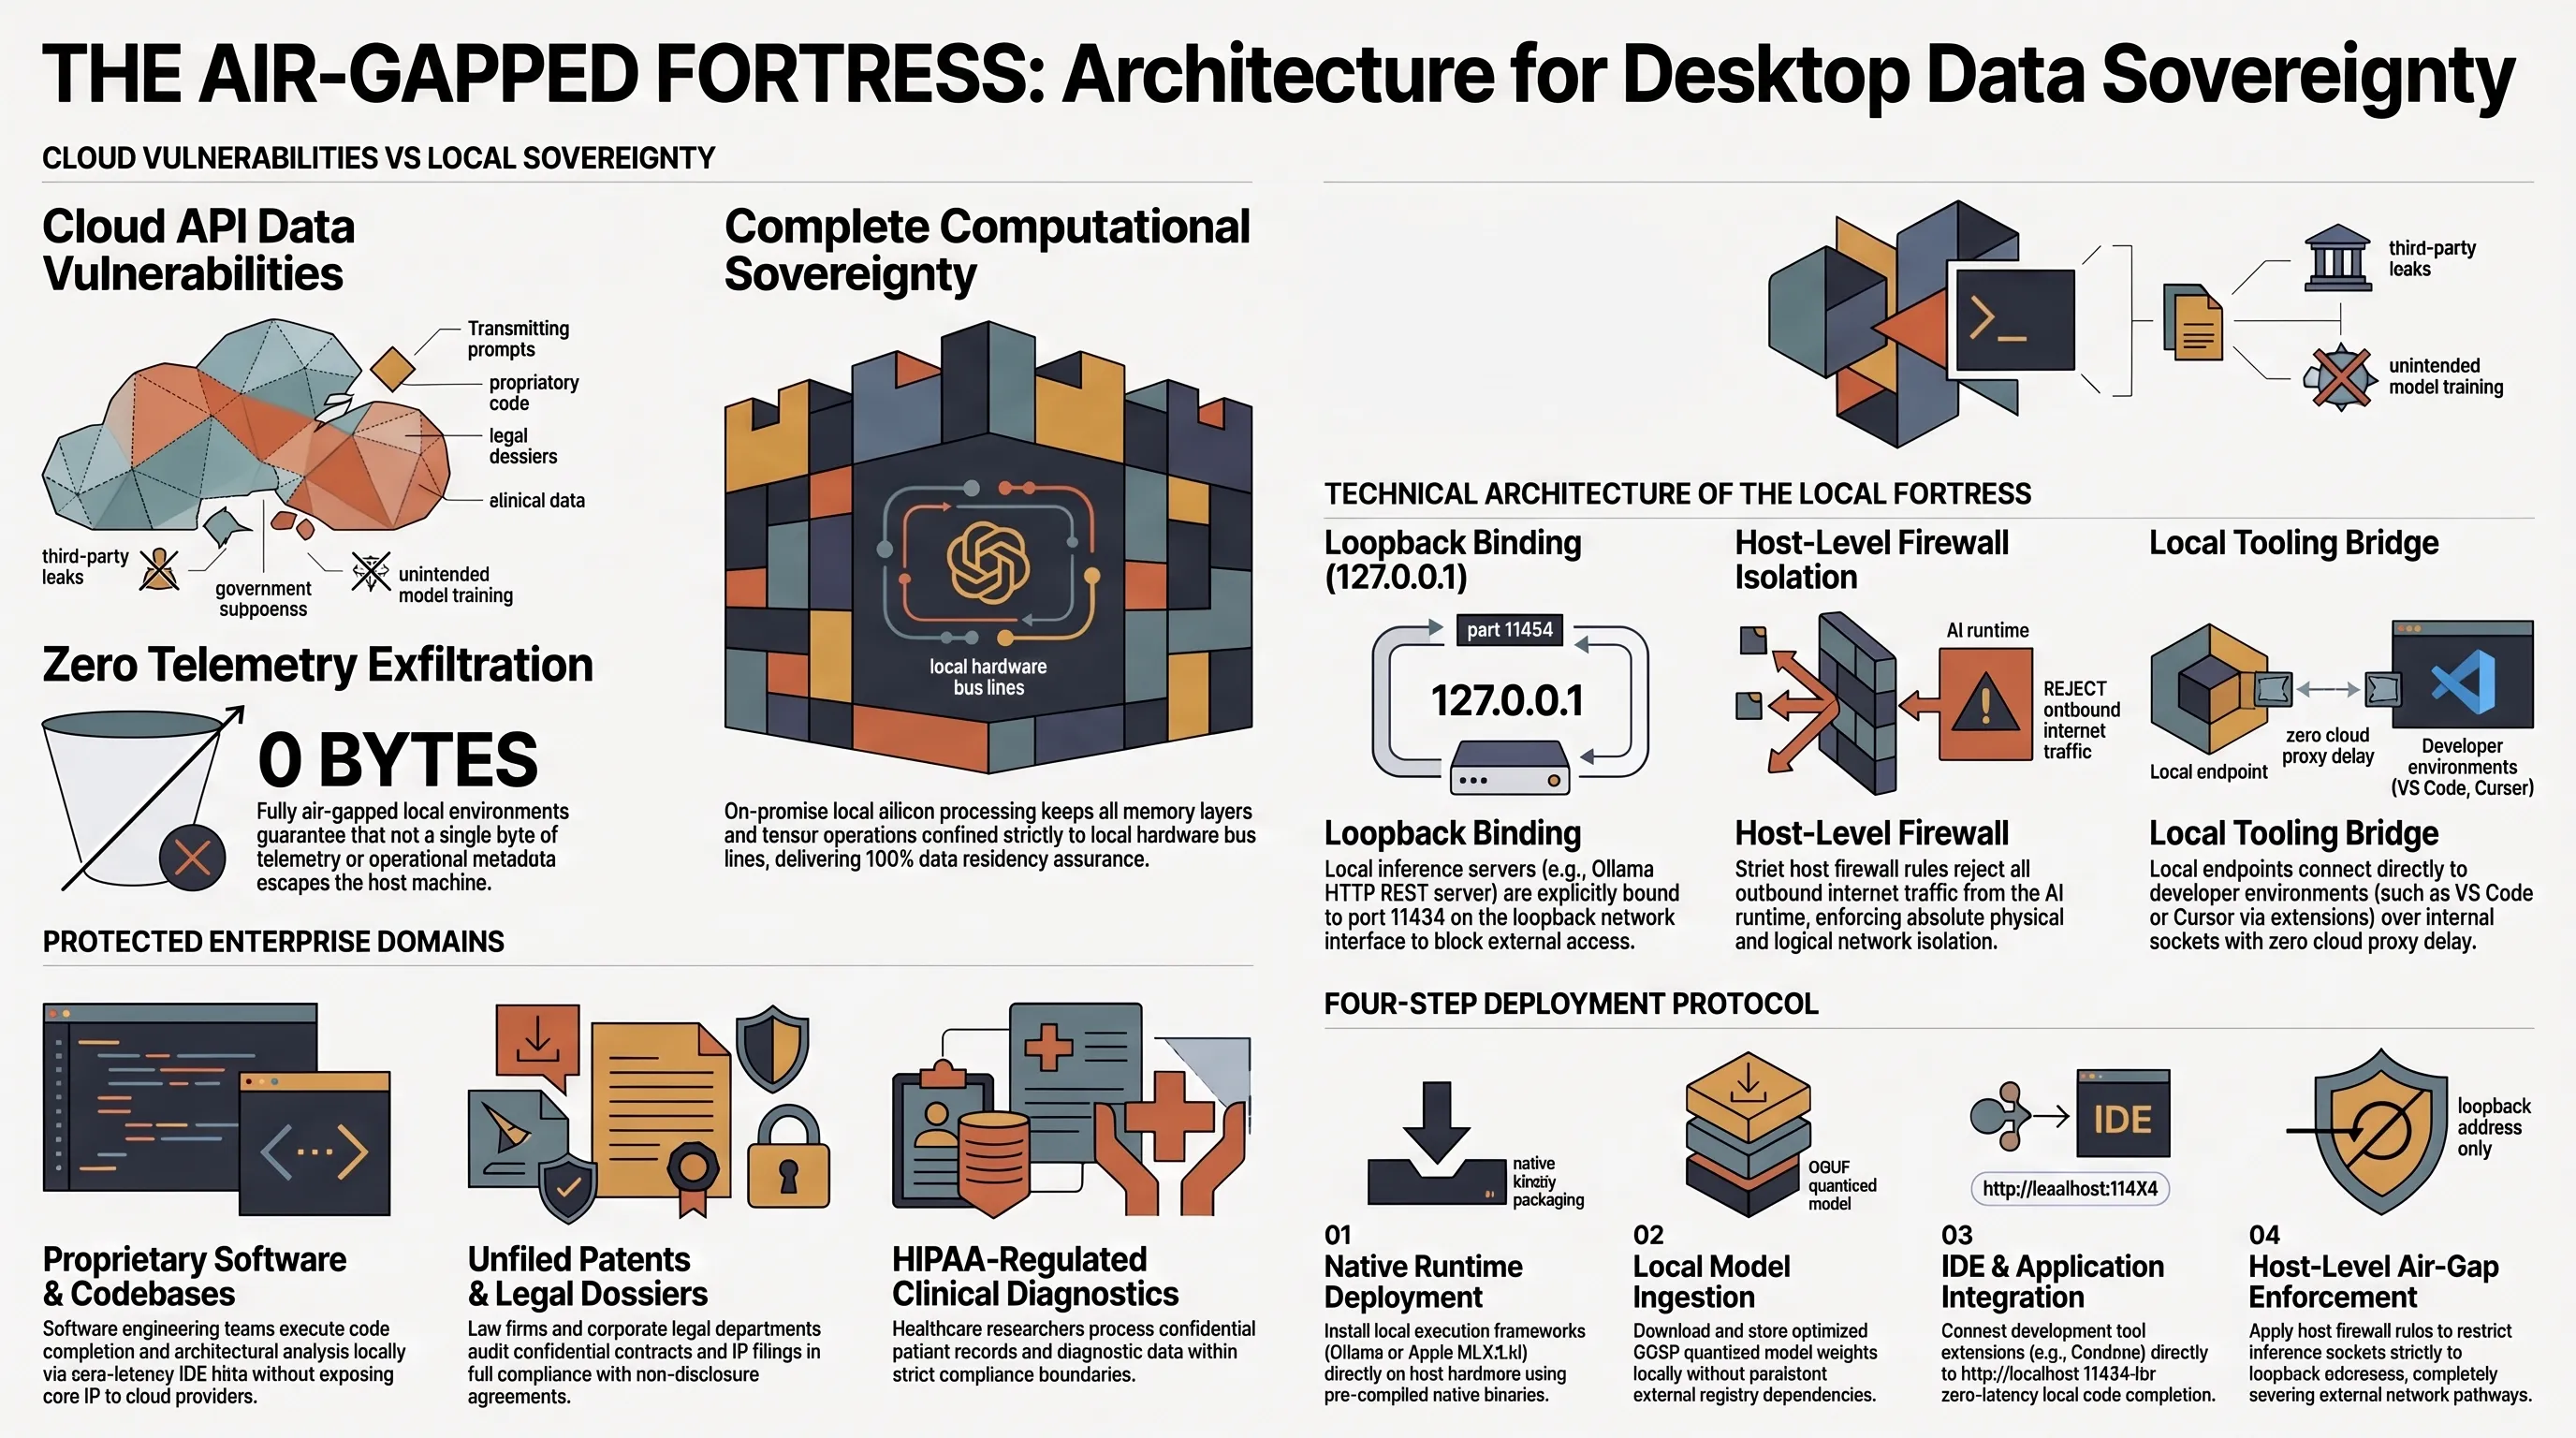
تکمیل نهایی راهاندازی یک سیستم هوش مصنوعی محلی، تضمین ایزولاسیون صددرصدی آن در برابر نفوذهای خارجی و نشت داده است. در سازمانهای پیشرو، رایانه اختصاصیافته به مدلهای لوکال در حالت ایزوله شبکه (Air-gapped) قرار میگیرد. در این پیکربندی، پورتهای سرور اولاما فقط بر روی آدرس محلی 127.0.0.1 شنود میکنند و قوانین سفت و سختی در فایروال سیستم برای قطع هرگونه درخواست وب خروجی اعمال میشود.
این سطح از امنیت به پزشکان اجازه میدهد پروندههای بالینی بیماران را بدون نقض حریم شخصی تحلیل کنند، به وکلا امکان میدهد پیشنویس لوایح دادگاهی را مستقیماً ارزیابی نمایند، و به مهندسان تضمین میدهد که پتنتهای تجاری ثبتنشده در هیچ پایگاه داده هوش مصنوعی دیگری برای آموزش مدلهای آینده بازیافت نخواهد شد.
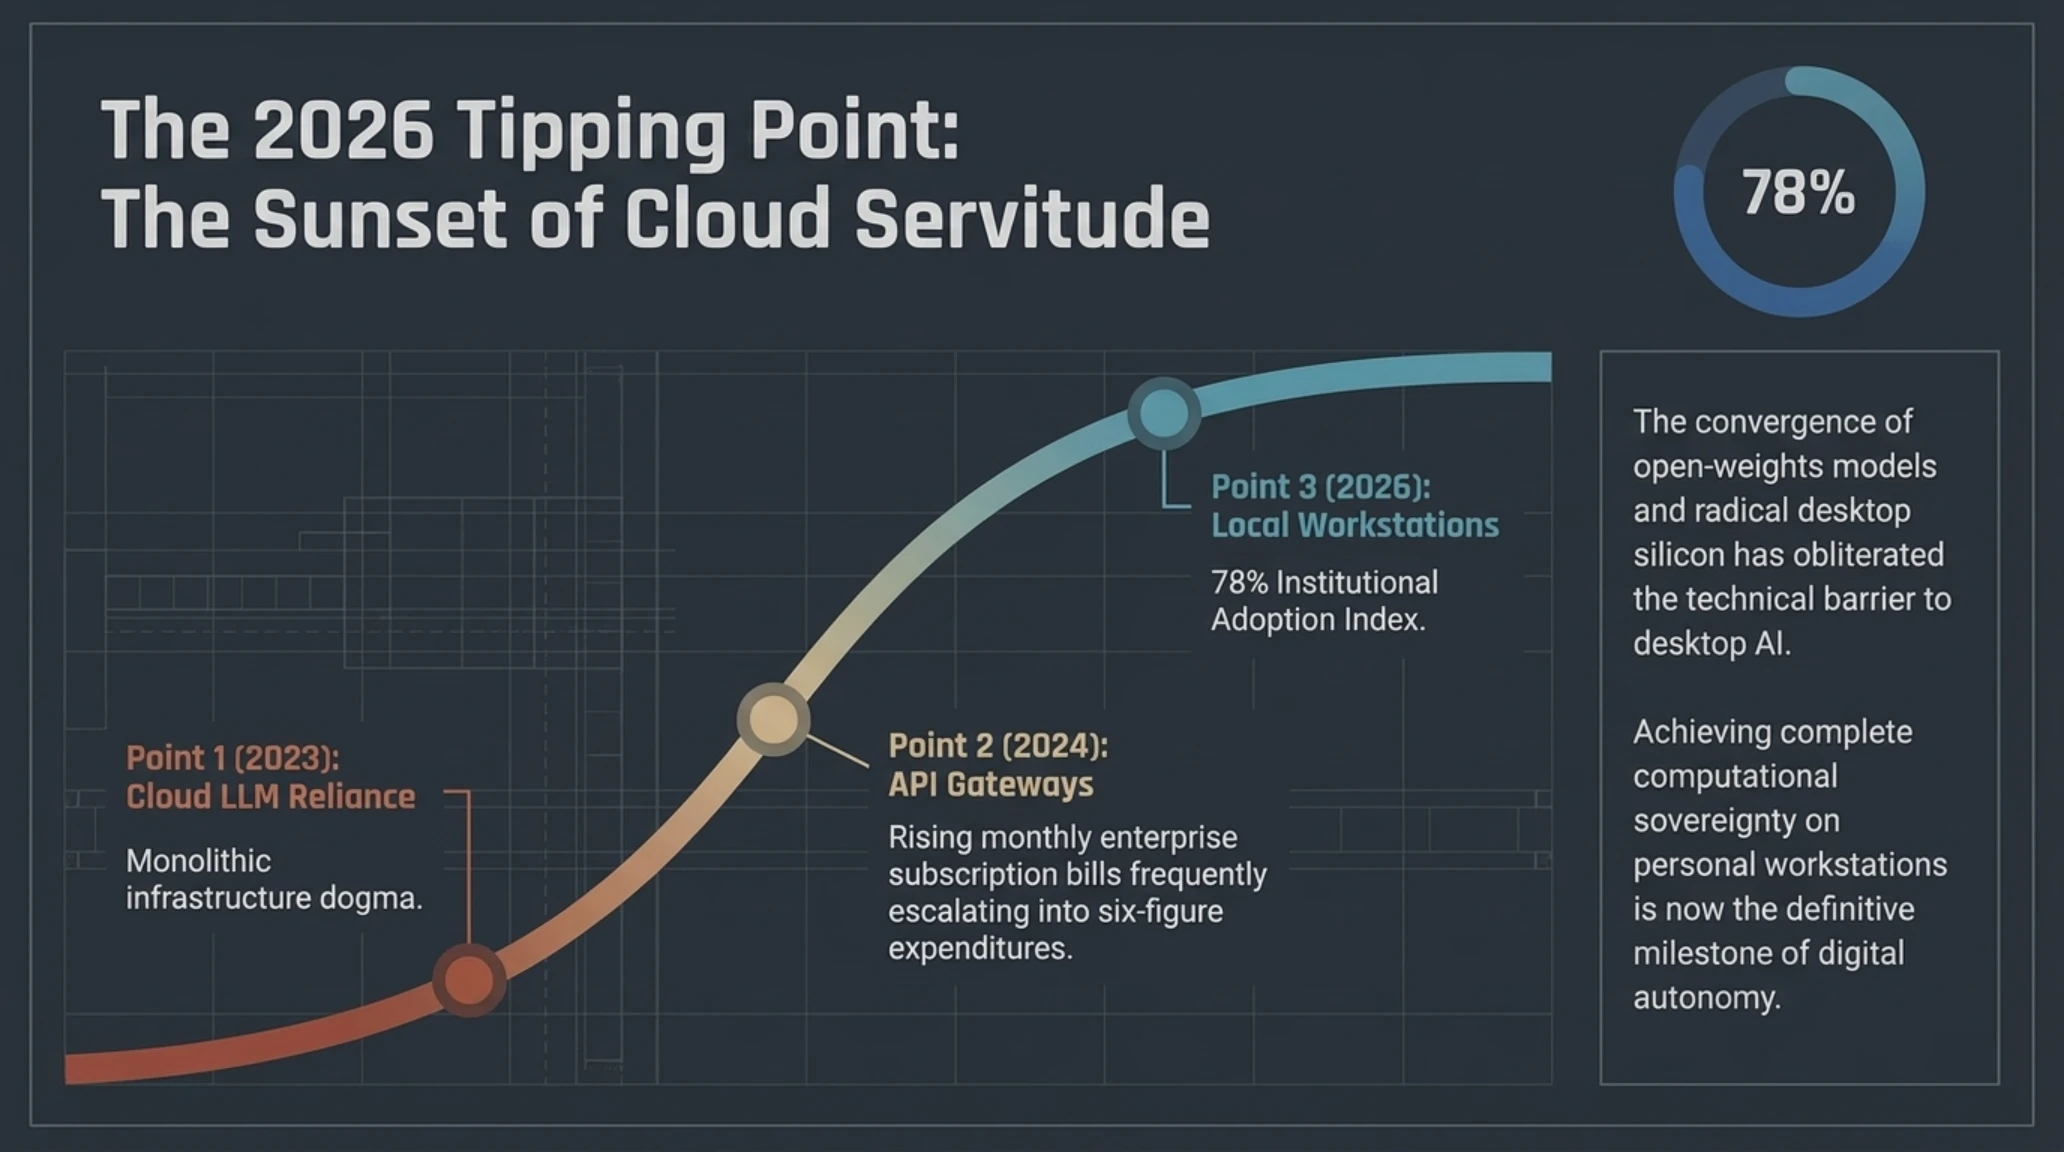
دماسنج احساسات بازار | گیج دایرهای و منحنی پذیرش S-Curve
تحلیل دماسنج بازار: اکوسیستم پردازش هوش مصنوعی از فاز وابستگی صرف به ابرهای تجاری عبور کرده و به نقطه عطف پذیرش گسترده سرورهای خانگی و محلی با ضریب اطمینان ۷۸ درصدی رسیده است.
- مک استودیو: ظرفیت حافظه یکپارچه عظیم تا ۱۹۲ گیگابایت برای لود کامل مدلهای ۷۰B و ۱۲۰B.
- مک استودیو: مصرف توان فوقالعاده ناچیز زیر ۸۵ وات و کارکرد ۱۰۰٪ بیصدا بدون تولید حرارت مزاحم.
- رایانه PC انویدیا: سرعت سرسامآور نزدیک به ۱۰۰ توکن در ثانیه برای مدلهای ۸B به لطف هستههای کودا.
- ایزولاسیون محلی: عدم ارسال حتی یک بایت از کدهای تجاری و اسناد مالی محرمانه به سرورهای خارجی.
- محدودیت سخت ۲۴ گیگابایتی VRAM در کارتهای گرافیک تککاربره انویدیا که مانع اجرای مدلهای بزرگ میشود.
- قیمت بالای کانفیگهای رم اپل در هنگام سفارش اولیه که ارتقای بعدی آن به دلیل مجتمع بودن امکانپذیر نیست.
راهنمای عملی خرید و پیکربندی قطعات؛ بودجهبندی هوشمندانه برای مک و PC
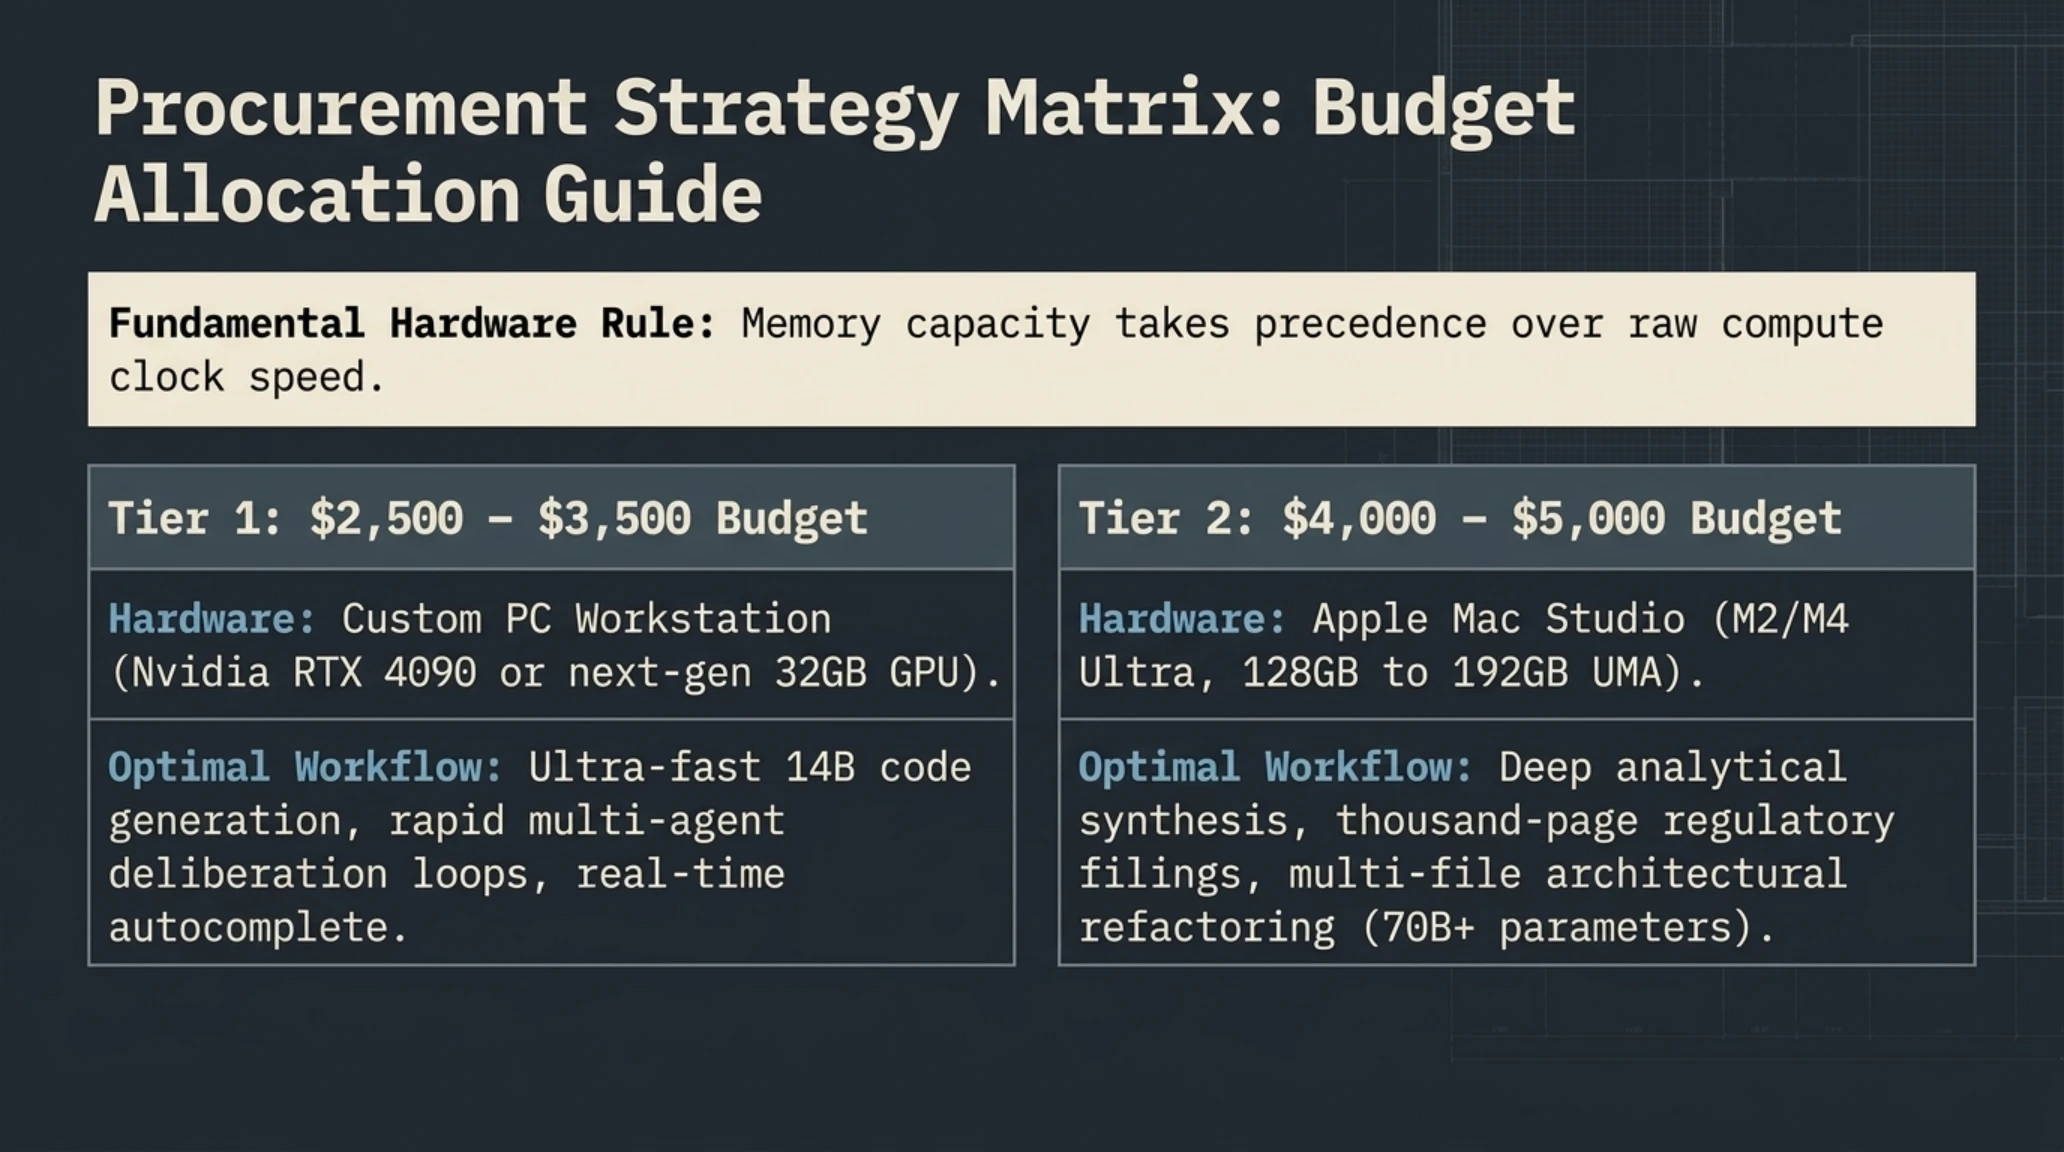
اگر تصمیم به تجهیز میز کار خود با یک ایستگاه کاری هوش مصنوعی محلی گرفتهاید، مدیریت بودجه و انتخاب هوشمندانه قطعات نقشی حیاتی در موفقیت سرمایهگذاری شما خواهد داشت. در دنیای سختافزارهای پیسی، مهمترین قانون این است: ظرفیت VRAM بر همه چیز ارجحیت دارد. خرید یک کارت گرافیک ردهپایینتر با ۱۶ گیگابایت حافظه (مانند RTX 4060 Ti 16GB) برای هوش مصنوعی به مراتب عاقلانهتر از خرید یک کارت سریعتر اما با حافظه ۱۲ گیگابایت است.
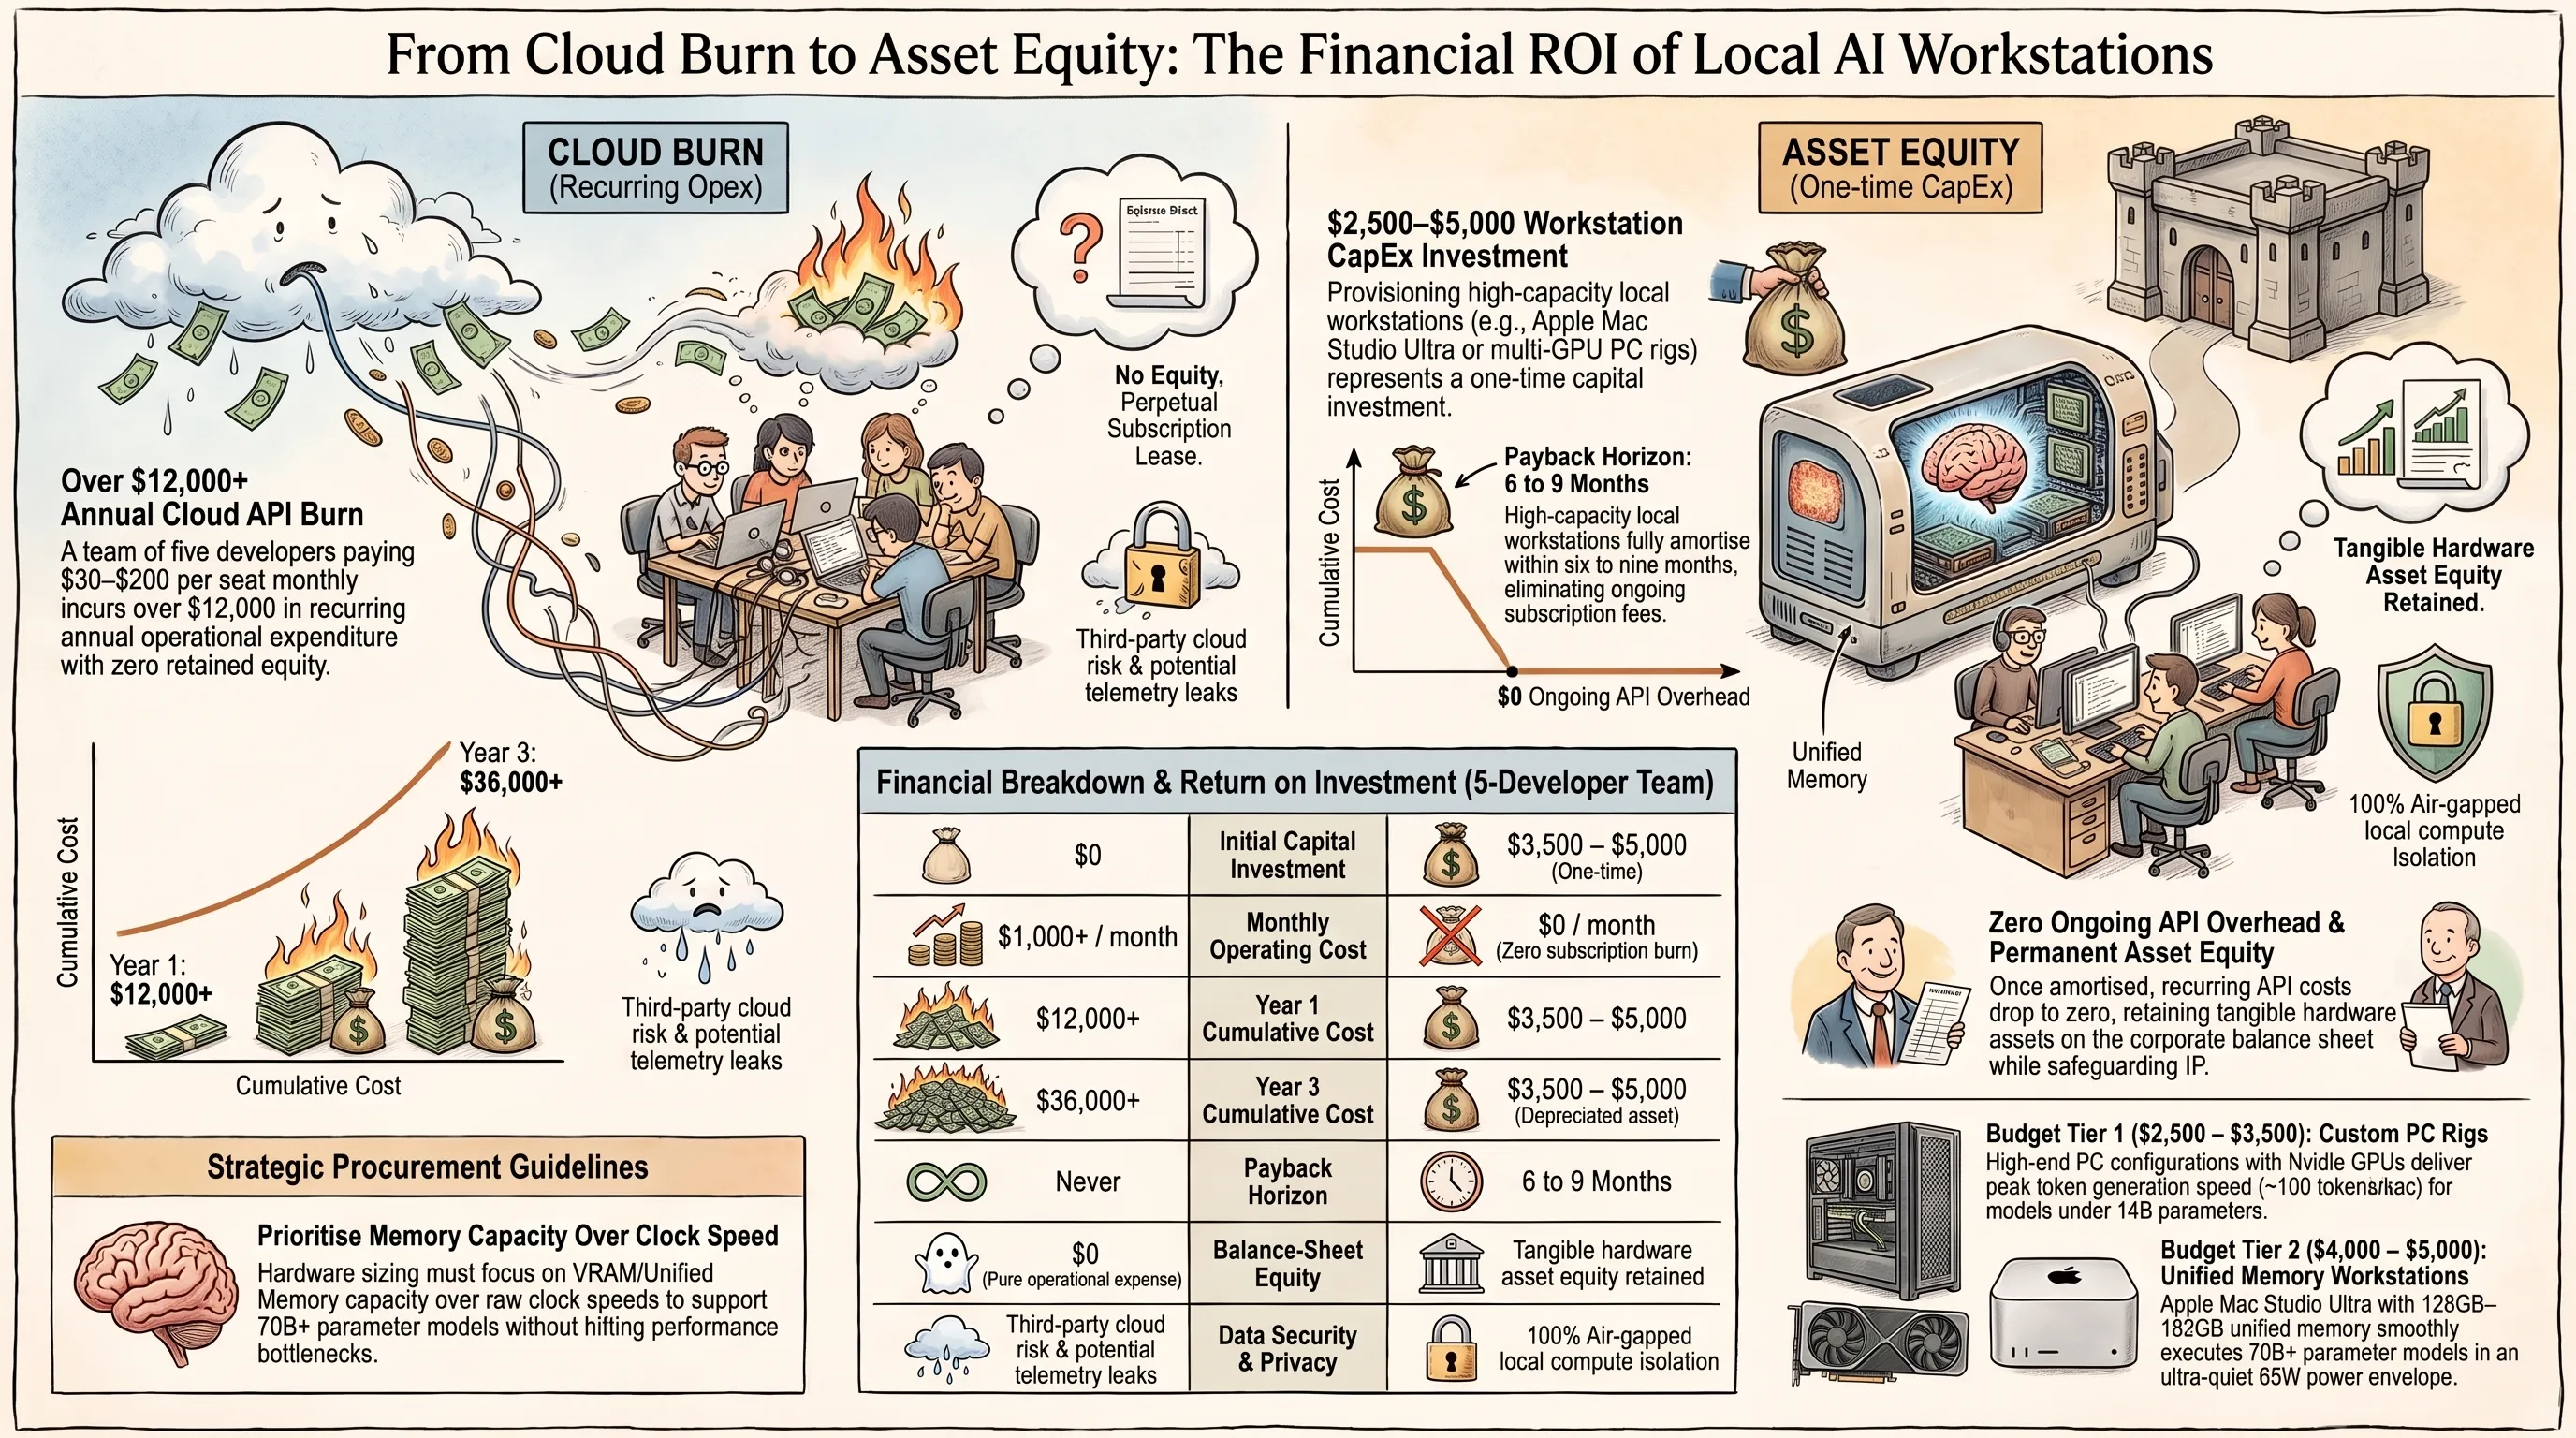
برای کاربرانی که بودجهای در حدود ۲۰۰۰ تا ۳۵۰۰ دلار دارند، بستن یک کیس دسکتاپ بر پایه کارت گرافیک RTX 4090 یا انتظار برای نسل جدیدتر با حداقل ۲۴ الی ۳۲ گیگابایت رم گرافیکی، بالاترین سرعت پاسخگویی را برای مدلهای ۱۴B به ارمغان میآورد. در مقابل، اگر بودجه شما به ۴۰۰۰ دلار میرسد و اولویت اصلی شما اجرای مدلهای تحلیلی سنگین نظیر Qwen 2.5 72B یا مدلهای نگارشی عمیق است، یک دستگاه مک استودیو استوک یا نو با تراشه M2 Ultra و رم ۱۲۸ یا ۱۹۲ گیگابایت، ارزشمندترین ابزار حرفهای خواهد بود که میتوانید خریداری کنید.
تحلیل اقتصادی و نقطه سر به سر (ROI)؛ استهلاک اشتراکهای ماهانه
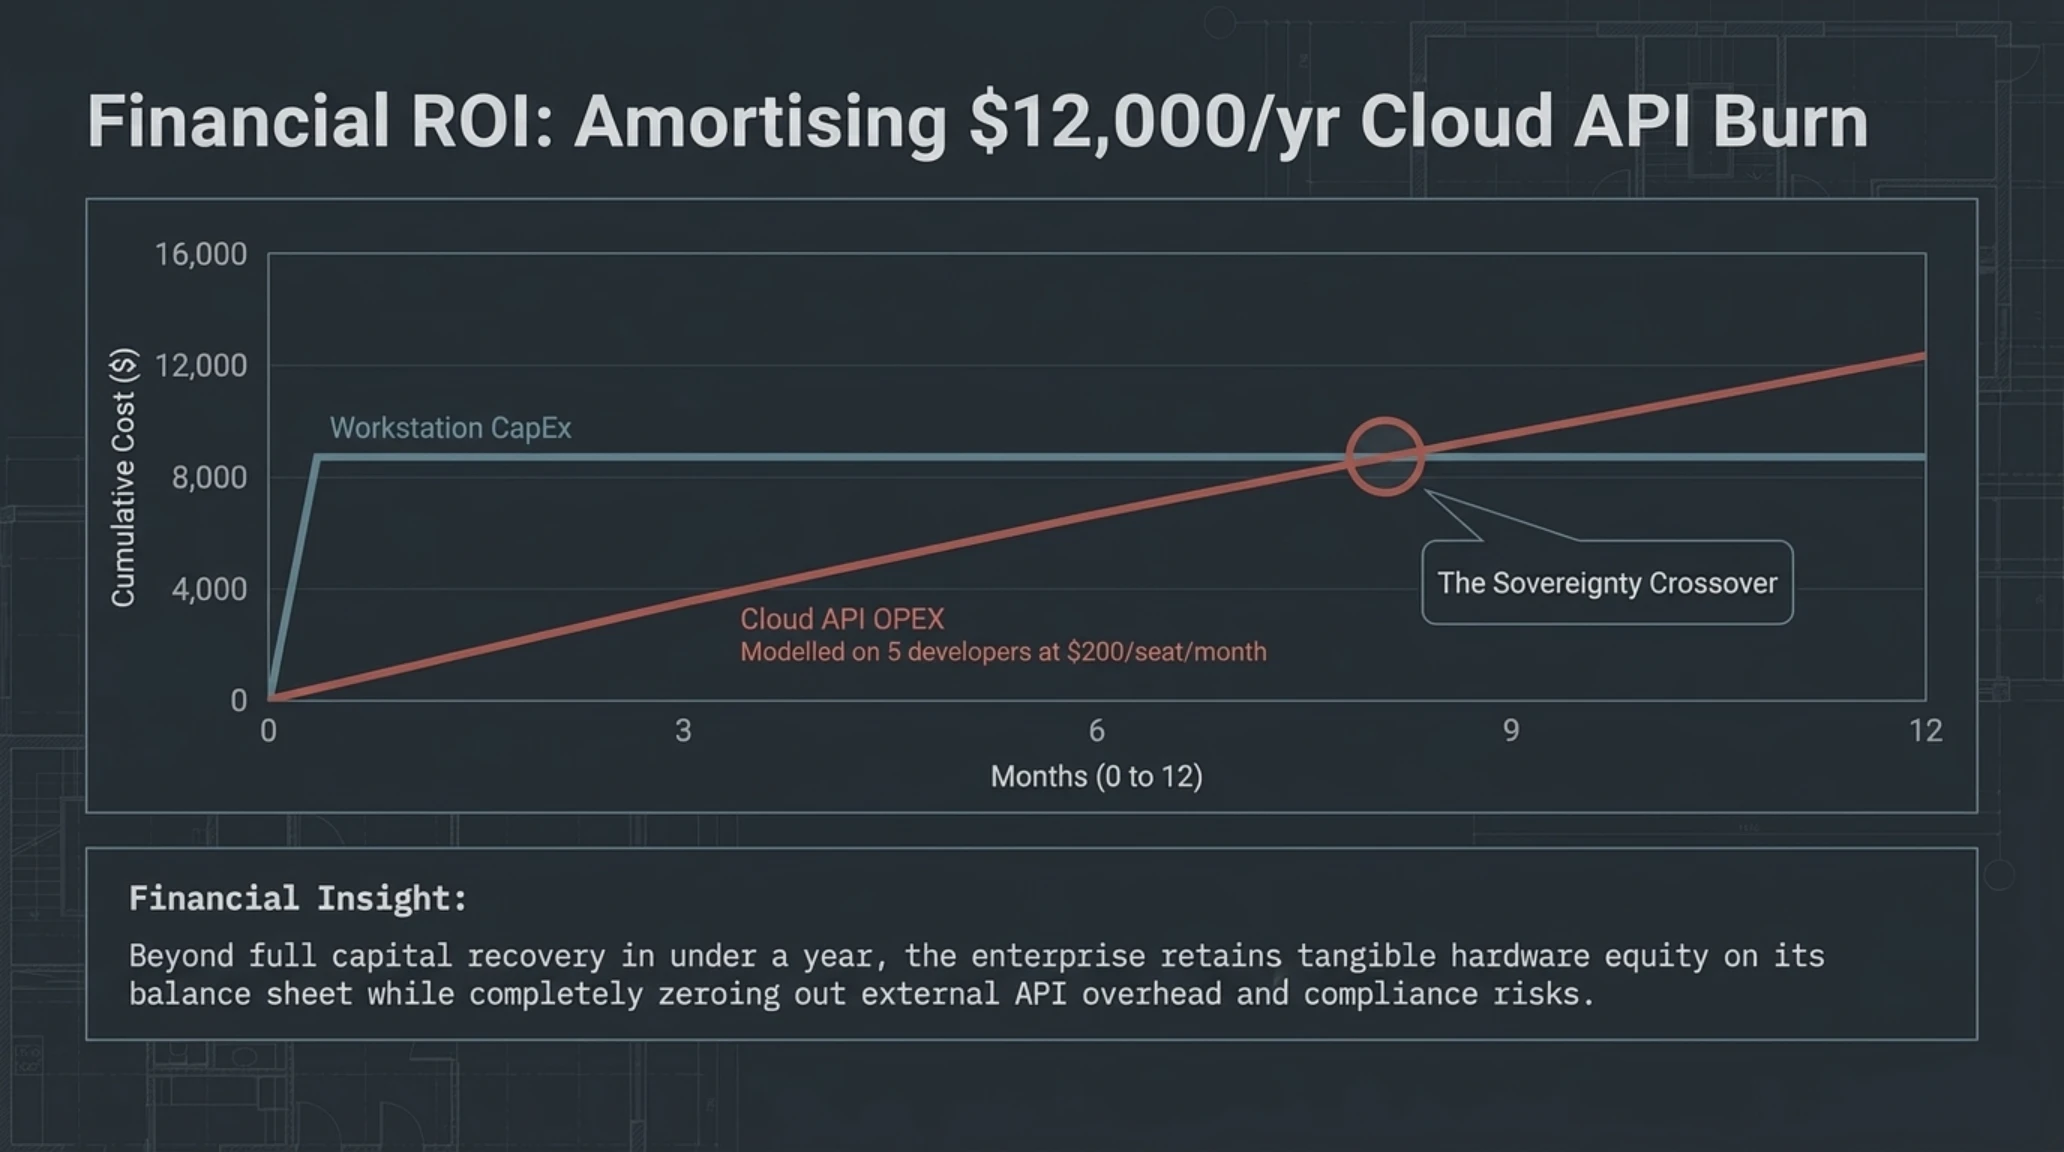
بسیاری از مدیران و فریلنسرها در ابتدا از قیمت چند هزار دلاری یک ایستگاه کاری محلی دچار تردید میشوند. اما با یک حساب سرانگشتی، ابعاد اقتصادی این معادله روشن میشود. اشتراک حرفهای پلتفرمهای ابری در سال ۲۰۲۶ برای هر کاربر حداقل ۳۰ الی ۲۰۰ دلار در ماه هزینه دارد. برای یک تیم نرمافزاری ۵ نفره، پرداخت سالیانه مبالغی بین ۳۰۰۰ تا ۱۲۰۰۰ دلار به شرکتهای ارائهدهنده کلود، رقمی معمول است.
با خرید یک دستگاه مک استودیو یا کیس انویدیا و استقرار آن به عنوان سرور اشتراکی محلی روی شبکه اداری، کل این هزینه ماهیانه به صفر میرسد. دستگاه شما ظرف مدت ۶ الی ۱۰ ماه هزینه اولیه خود را به طور کامل مستهلک کرده و پس از آن، ارزش خالص افزوده و امنیت بینهایتی را برای تیم شما تولید میکند؛ در حالی که ارزش قطعات سختافزاری نیز به عنوان دارایی ثابت شرکت حفظ میشود.
چکلیست گامبهگام راهاندازی برای برنامهنویسان و کسبوکارها
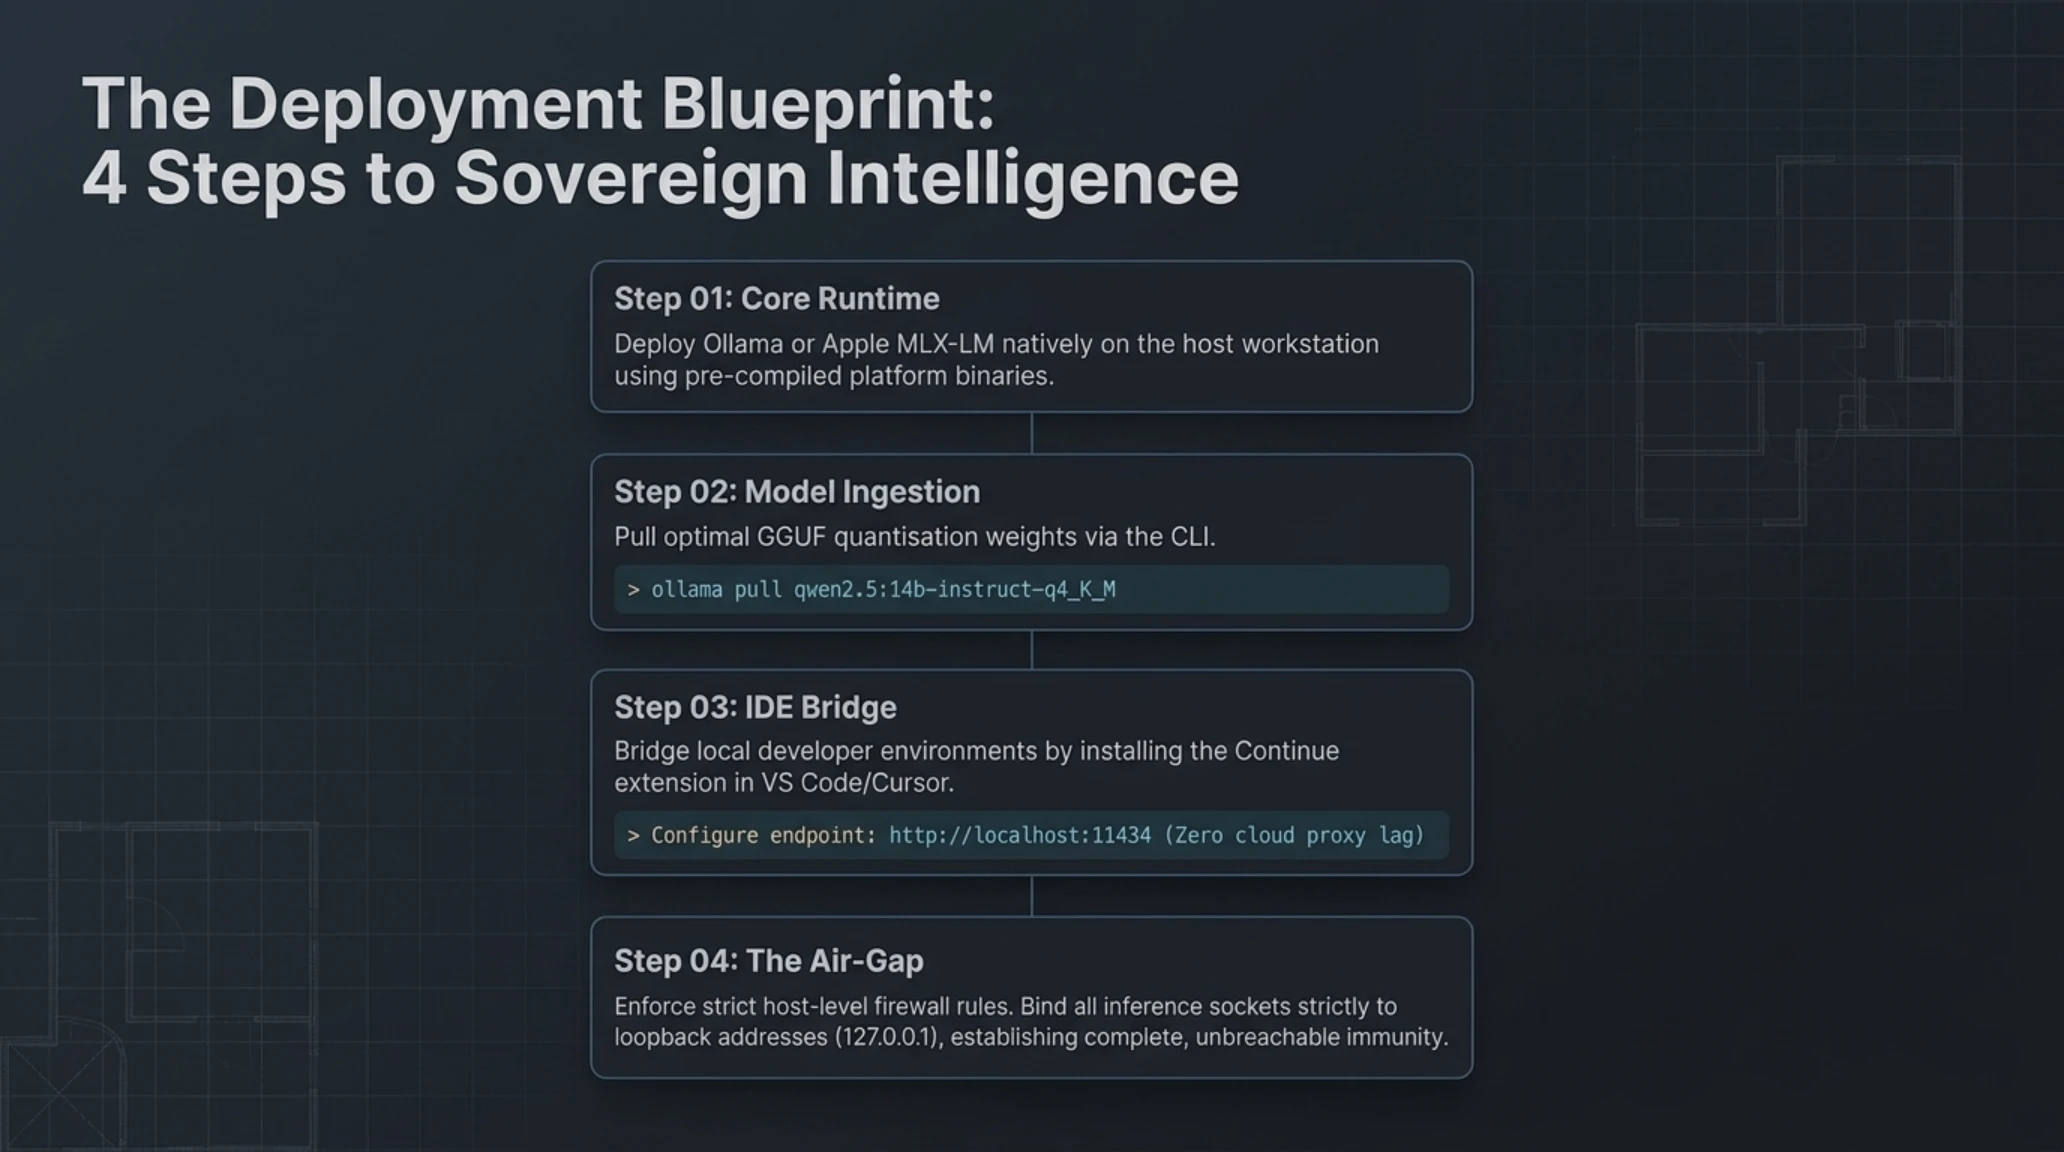
برای شروع به کار عملیاتی از همین امروز، کافی است مراحل زیر را به ترتیب اجرا نمایید:
گام اول: دانلود و نصب نرمافزار Ollama از وبسایت رسمی متناسب با سیستمعامل خود (ویندوز، مک یا لینوکس).
گام دوم: باز کردن ترمینال و اجرای دستور ollama pull qwen2.5:14b-instruct-q4_K_M برای دریافت نسخه متوازن کوانتایز.
گام سوم: نصب افزونه Open-WebUI بر روی داکر یا اتصال ادیتور VS Code با نصب افزونه Continue و تنظیم آدرس سرور روی http://localhost:11434.
گام چهارم: تنظیم فایروال جهت مسدودسازی کامل پورت به خارج از شبکه لوکال و آغاز لذتبخش استفاده از هوش مصنوعی کاملاً مستقل.
حکم نهایی تحریریه و فهرست منابع رسمی
پیروزی استقلال و حریم خصوصی در عصر پسا-ابر
اجرای محلی هوش مصنوعی استاندارد طلایی امنیت داده برای شرکتها و توسعهدهندگان مستقل در سال ۲۰۲۶ است؛ انویدیا پادشاه سرعت مدلهای سبک و مک استودیو قهرمان بلامنازع ظرفیت و پایداری به شمار میرود.
- ورج (The Verge): گزارش میدانی آنتونیو دی بندتو پیرامون چالشها و هیجان مهاجرت به هوش مصنوعی محلی
- هاگینگ فیس (Hugging Face): پایگاه داده رسمی وزنهای کوانتایز GGUF مدلهای Hermes 3 و Qwen 2.5
- نوس ریسرچ (Nous Research): مستندات معماری و استدلال عاملمحور مدل Hermes 3 بر پایه Llama 3.1
- اپل ماشین لرنینگ (Apple MLX): ریپازیتوری رسمی فریمورک یادگیری ماشین متال برای تراشههای اپل سیلیکون
پرسشهای متداول و تحلیلهای فنی
آیا برای اجرای محلی هوش مصنوعی حتماً به اینترنت پرسرعت نیاز داریم؟
تنها برای دانلود اولیه فایل مدل (بین ۵ تا ۴۰ گیگابایت) به اینترنت نیاز است. پس از اتمام دانلود، کل پردازش، استدلال و پاسخدهی به صورت ۱۰۰٪ آفلاین و بدون نیاز به کوچکترین اتصال اینترنت انجام میگیرد.
چرا کارتهای گرافیک گیمینگ معمولی برای مدلهای ۷۰B مناسب نیستند؟
کارتهای گیمینگ معمولی مانند RTX 4070 یا 3080 معمولاً ۸ تا ۱۲ گیگابایت حافظه VRAM دارند، در حالی که مدلهای ۷۰B حتی در فشردهترین حالت کوانتایز به بیش از ۴۰ گیگابایت حافظه جهت بارگذاری وزنها و لایهها نیاز دارند.
آیا کیفیت پاسخهای یک مدل کوانتایز ۴ بیتی افت شدیدی پیدا میکند؟
خیر؛ الگوریتمهای مدرن کوانتایز نظیر Q4_K_M در فرمت GGUF با دقت بالای لایههای حساس توجه عمل میکنند و افت کیفیت ادراکی آنها در تستهای استاندارد کمتر از ۱ تا ۲ درصد است که برای کاربرد انسانی کاملاً نامحسوس است.
تفاوت فریمورک اولاما با فریمورک اختصاصی اپل MLX در چیست؟
اولاما بر پایه رانتایم C++ کتابخانه llama.cpp ساخته شده و برای چندسکویی و سادگی پیکربندی بینظیر است. اما MLX فریمورک اختصاصی اپل در پایتون است که با بهینهسازی مستقیم روی گرافیک متال، تا ۳۰ درصد سرعت توکن بالاتری روی مک استودیو ارائه میدهد.
آیا مدلهای محلی میتوانند جایگزین کامل سرویسهای ابری مثل GPT-4 شوند؟
برای کارهایی مانند بازبینی و نگارش کد، تحلیل اسناد محرمانه، ترجمه متون و خلاصهسازی جلسات، مدلهایی مانند Qwen 2.5 32B عملکردی همسطح و حتی دقیقتر ارائه میدهند و کاملاً جایگزین ابر میشوند.
چگونه میتوان مدل محلی را به عنوان دستیار کدنویسی در VS Code استفاده کرد؟
با نصب افزونه رایگان Continue در VS Code و تنظیم آن روی اندپوینت لوکال اولاما، کدهای شما در لحظه تحلیل شده و بدون ارسال به هیچ سرور خارجی، بازنویسی و خطایابی خودکار انجام میپذیرد.
گالری تصاویر تکمیلی: تکین گاید | راهنمای بنچمارک هوش مصنوعی محلی: Mac Studio در برابر PC