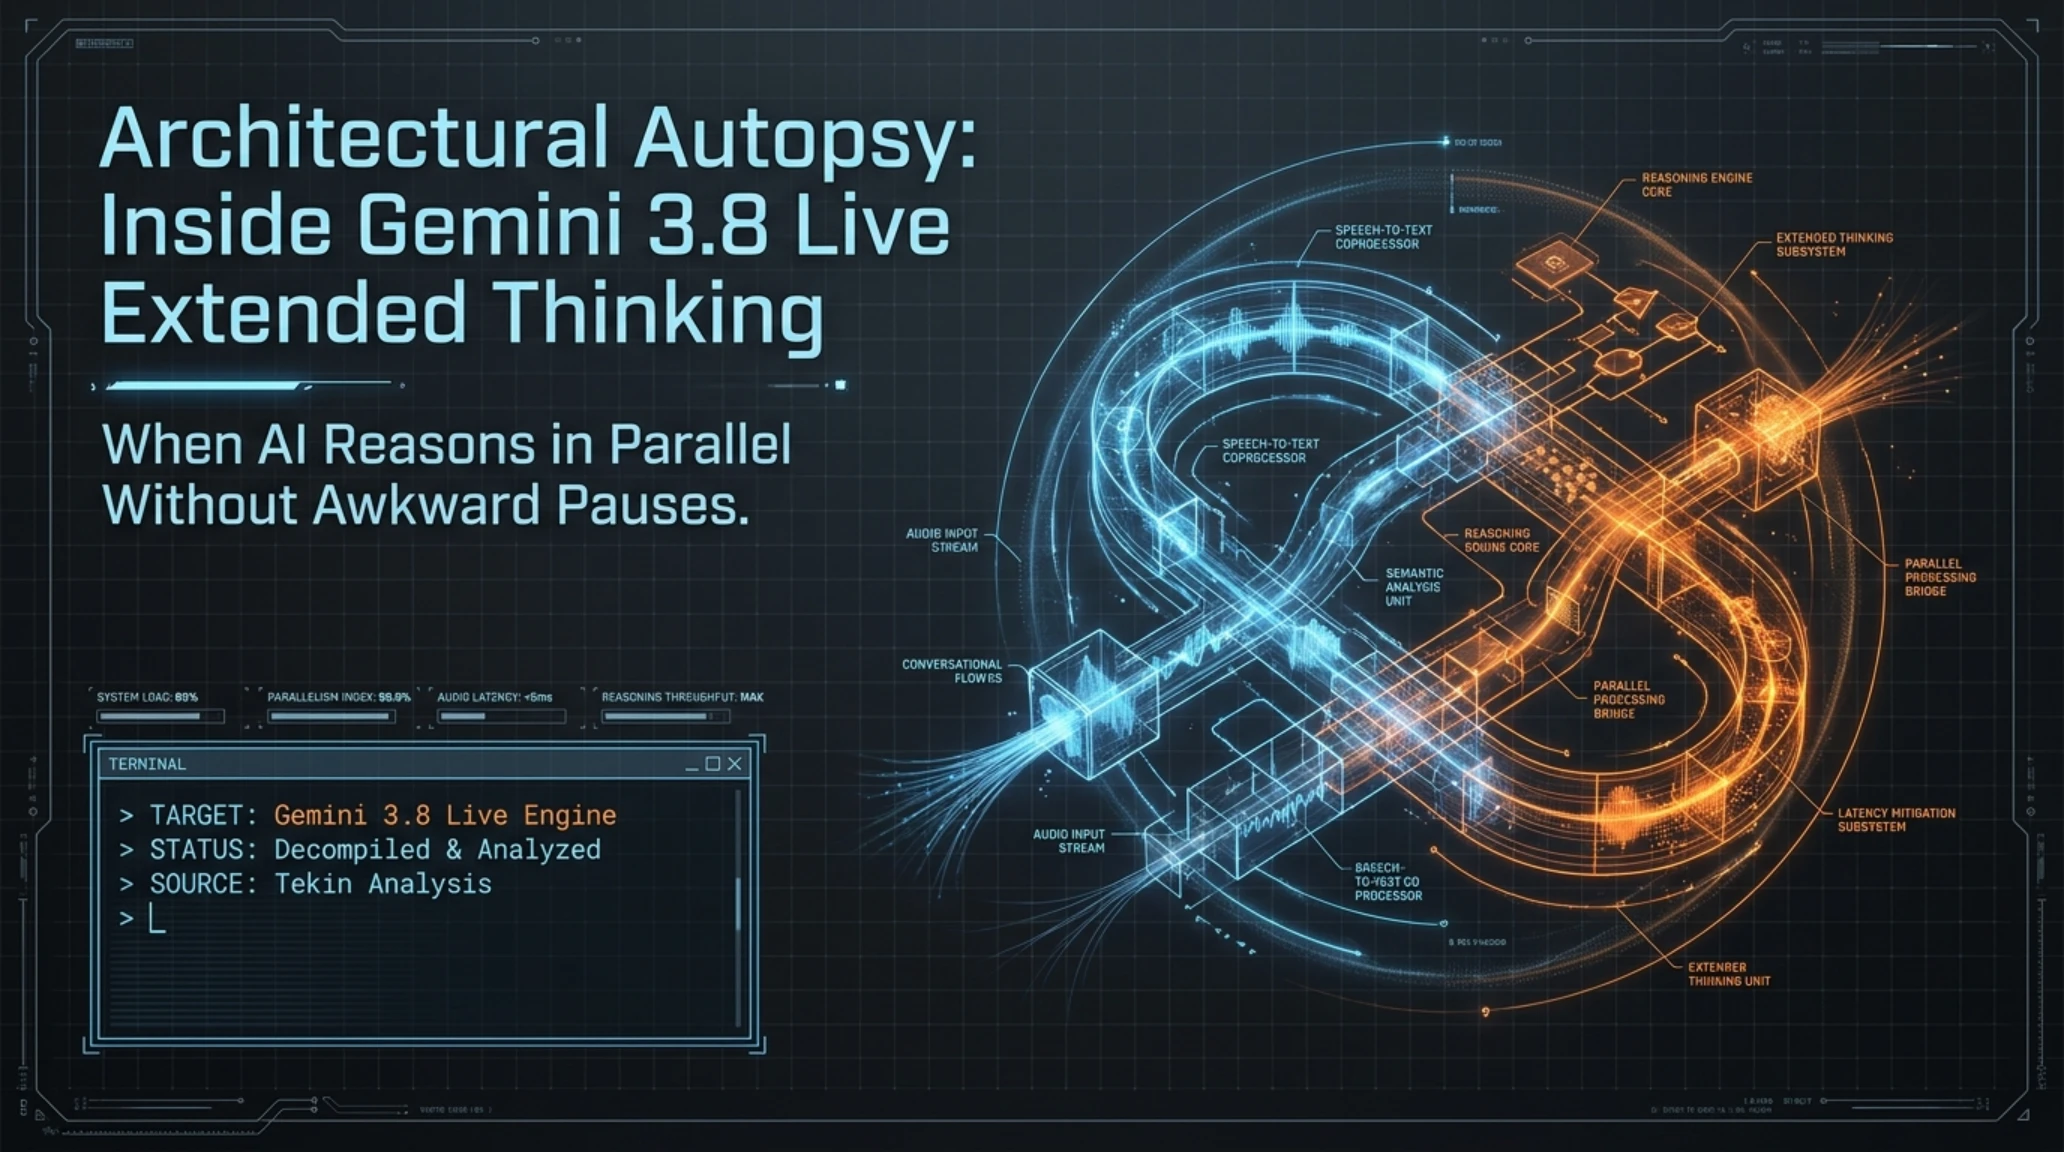
تکین آنالیز: کالبدشکافی نسل جدید مدلهای صوتی Gemini 3.8 Live گوگل
بررسی فنی و عمیق دو مدل Gemini 3.8 Live و Extended Thinking؛ پایان سکوتهای آزاردهنده هوش مصنوعی و آغاز عصر تفکر و مکالمه موازی.
- 🎮استدلال موازی همزمان- چگونگی صحبت کردن و حل مسائل چندمرحلهای در پسزمینه بدون وقفه.
- 🎧پشتیبانی آنی از ۹۷ زبان- سوییچ خودکار بین زبانها در میانه جمله با درک همزمان تصویر و ویدیو.
- 🚀واترمارک نامرئی SynthID- فناوری ضدجعل فرکانسی برای شناسایی قطعی صوتهای هوش مصنوعی.
- 🗡️تأخیر زیر ۲۸۰ میلیثانیه- واکنش صوتی بلادرنگ سریعتر از میانگین سرعت پاسخگویی انسان.
- 📰درک ویدیویی ۳۰ فریم- تحلیل همزمان استریم ویدیو و اتصال آن به جریان استدلال صوتی.
- ⚔️معماری وبسوکت دوطرفه- اجرای ابزارهای سازمانی به صورت ناهمگام در گوگل ورکاسپیس.
در سپتامبر سال ۲۰۲۶، شرکت گوگل با رونمایی رسمی از دو مدل صوتی پرچمدار خود تحت عنوان Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking، یکی از بزرگترین و کهنهترین بنبستهای تعامل انسان و کامپیوتر را در هم شکست. برای سالها، تعامل صوتی با پیشرفتهترین مدلهای هوش مصنوعی جهان گرفتار یک پارادوکس آزاردهنده بود: یا مدلها مانند دستیارهای ساده سریع پاسخ میدادند اما از تفکر عمیق و منطق چندمرحلهای ناتوان بودند، یا مانند مدلهای استدلالی پیشرفته برای حل مسائل ریاضی و پردازش دادهها به ۵ تا ۳۰ ثانیه زمان نیاز داشتند؛ زمانی که در یک تماس صوتی به «سکوت مرگبار» (Dead Air) تبدیل میشد و جریان زنده گفتوگو را کاملاً نابود میکرد.
در یک نگاه: نکات کلیدی این پرونده
- گوگل دو مدل Gemini 3.8 Live و Extended Thinking را برای تفکیک مکالمات سریع از استدلال عمیق معرفی کرد.
- معماری جدید «تفکر در حین صحبت»، سکوتهای مرگبار را با اجرای موازی کلام و استدلال از بین برده است.
- تأخیر رسیدن به نخستین بایت صوتی (TTFA) به کمتر از ۲۸۰ میلیثانیه کاهش یافته که سریعتر از واکنش انسان است.
- مدل از ۹۷ زبان با قابلیت سوییچ خودکار درونجملهای پشتیبانی میکند و ویدیو را با ۳۰ فریم بر ثانیه تحلیل میکند.
- فناوری SynthID واترمارکهای نامرئی فرکانسی را درون امواج صوتی تزریق میکند که در برابر فشردهسازی مقاوم است.
- ابزارهای سازمانی نظیر Workspace به صورت ناهمگام و موازی از طریق پروتکلهای وبسوکت دوطرفه اجرا میشوند.
اکنون گوگل با بازطراحی بنیادین معماری پردازش صوت و تفکیک جریان مکالمه از موتور استدلال زنجیرهای، مفهومی نوین به نام «تفکر در حین صحبت» (Thinking while Talking) را متولد کرده است. در این معماری انقلابی، هوش مصنوعی دیگر برای فکر کردن مکث نمیکند؛ بلکه در همان لحظه که با آرامش و لحنی طبیعی میگوید «اجازه بدید من پایگاه داده رو بررسی کنم...»، در پسزمینه در حال اجرای کدهای پایتون، کوئریهای SQL، فراخوانی ابزارهای خارجی و اعتبارسنجی فرضیات پیچیده است. این جهش تکنولوژیک، مرزهای رابط کاربری صوتی را بازتعریف کرده و ما را یک گام بزرگ به رویای تعامل کاملاً طبیعی با ماشین نزدیکتر میکند.

برای درک اهمیت این دستاورد، نخست باید به کالبدشکافی ساختاری دوگانه گوگل نگاهی بیندازیم؛ جایی که غول مانتین ویو تصمیم گرفت به جای یک مدل همهکاره اما سنگین، دو ابزار متمایز را متناسب با نیازهای تجاری و محاسباتی دنیا عرضه کند.
استراتژی دوگانه گوگل: تفکیک سرعت آنی از استدلال سنگین
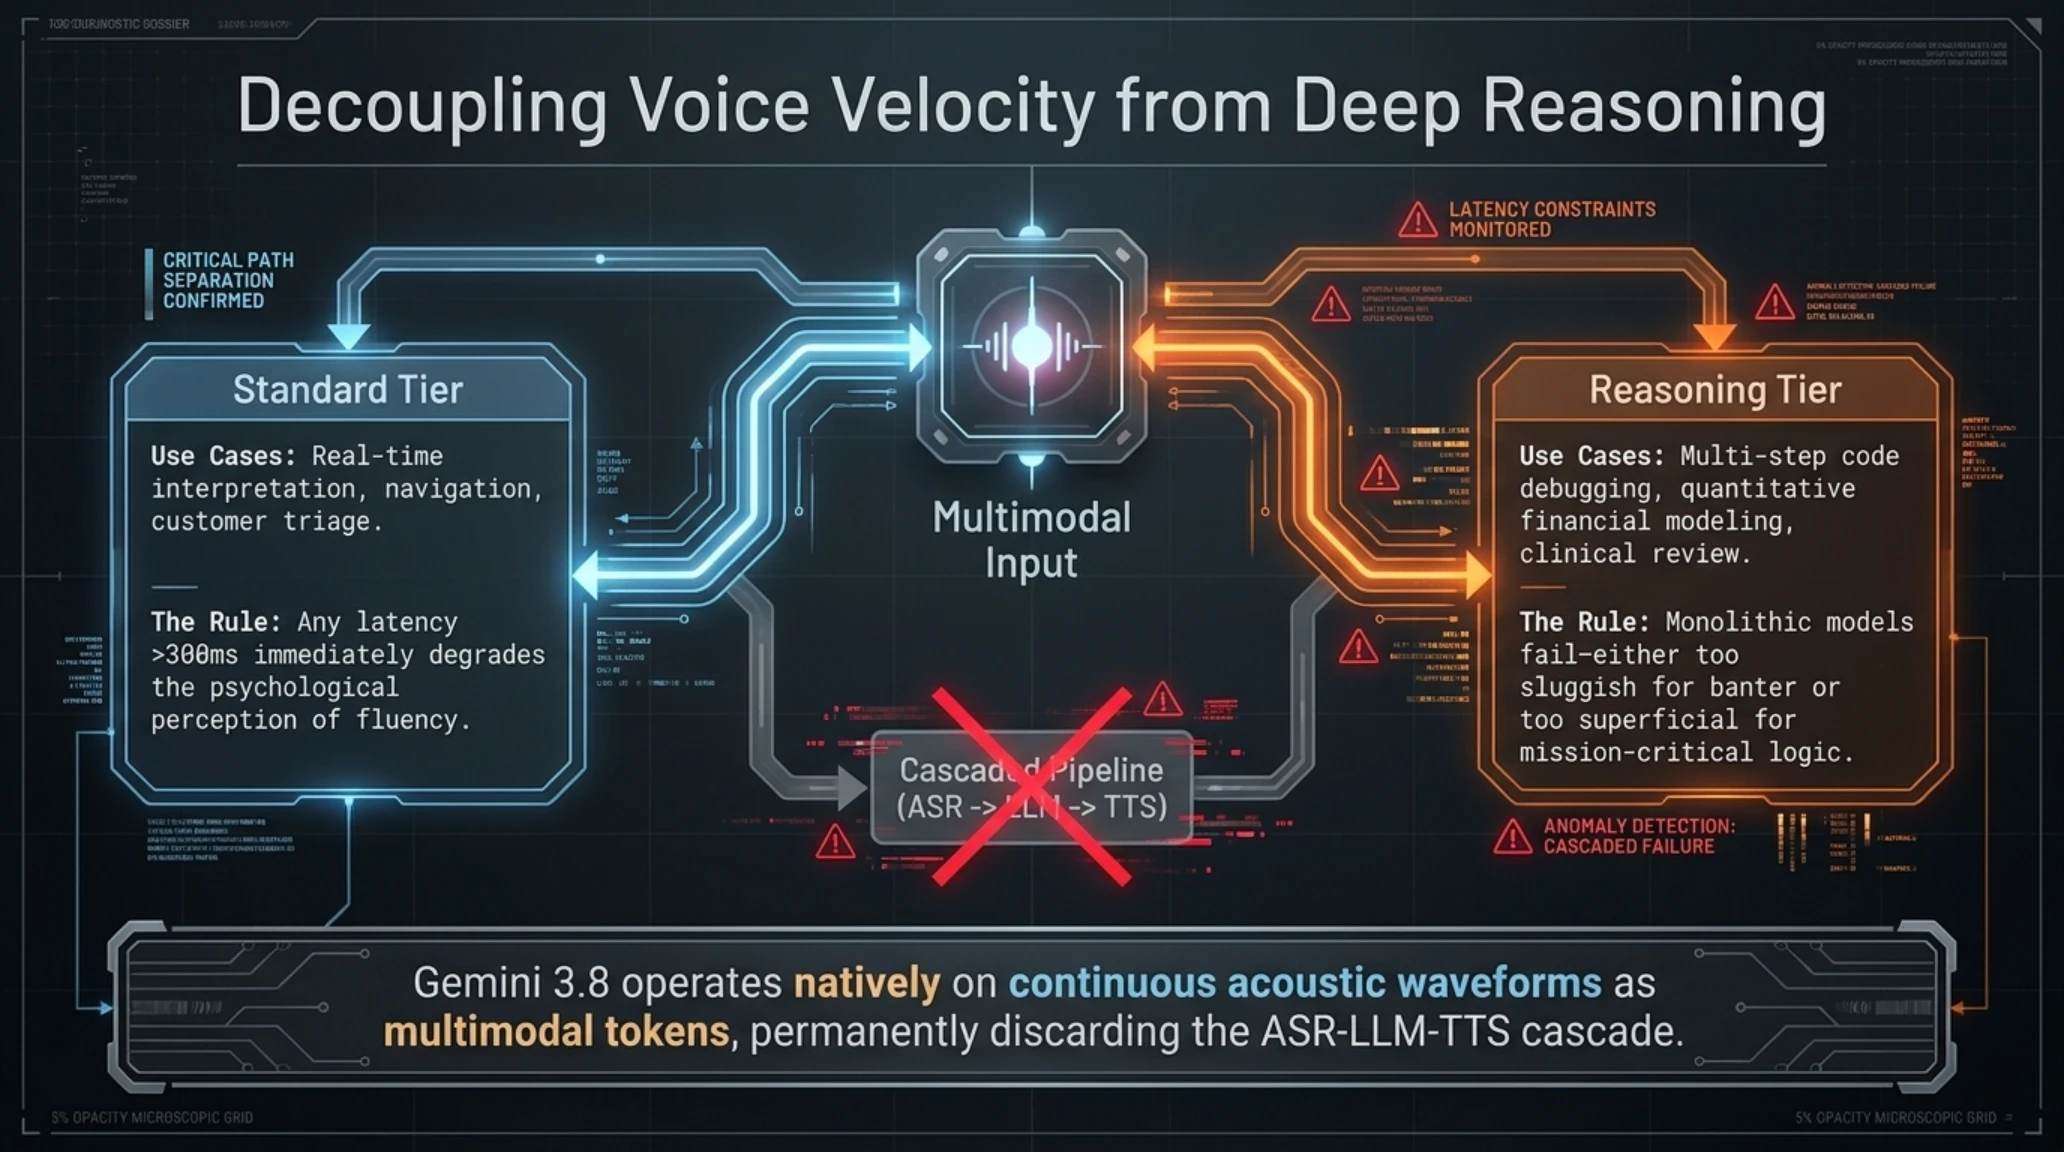
توسعهدهندگان در شرکت گوگل دیپمایند و تیم تحقیقاتی جمینای در جریان ارزیابیهای میدانی دریافتند که الگوهای ترافیک صوتی کاربران به دو دسته کاملاً ناهمگون تقسیم میشود. دسته اول، تعاملات روزمره، استعلامهای سریع، راهنماییهای ناوبری، تعامل در مراکز تماس مشتریان و مکالمات ساده روزمره هستند که در آنها «تأخیر پاسخدهی» (Latency) پادشاه بلامنازع تجربه کاربری است. اگر مدل حتی نیم ثانیه در پاسخ دادن درنگ کند، کاربر حس طبیعی بودن مکالمه را از دست میدهد. دسته دوم، تحلیلهای عمیق مالی، اشکالزدایی کدهای نرمافزاری زنده، مشاورههای تخصصی مهندسی و برنامهریزیهای استراتژیک چندمرحلهای هستند که نیازمند دورههای سنگین تفکر و جستوجوی درختی فرضیات هستند.
پاسخ مهندسی گوگل به این دوگانگی، معرفی دو مدل مجزا بر پایه یک هسته یادگیری عمیق مشترک بود: مدل نخست Gemini 3.8 Live که به عنوان مدل بهینه، سبک و فوقسریع برای مقیاسهای میلیاردی و خدمات مشتریان طراحی شده است؛ و مدل دوم Gemini 3.8 Live Extended Thinking که مجهز به یک پایپلاین استدلال موازی و موتور تفکر پسزمینه برای رویارویی با دشوارترین سناریوهای دنیای محاسبات است.
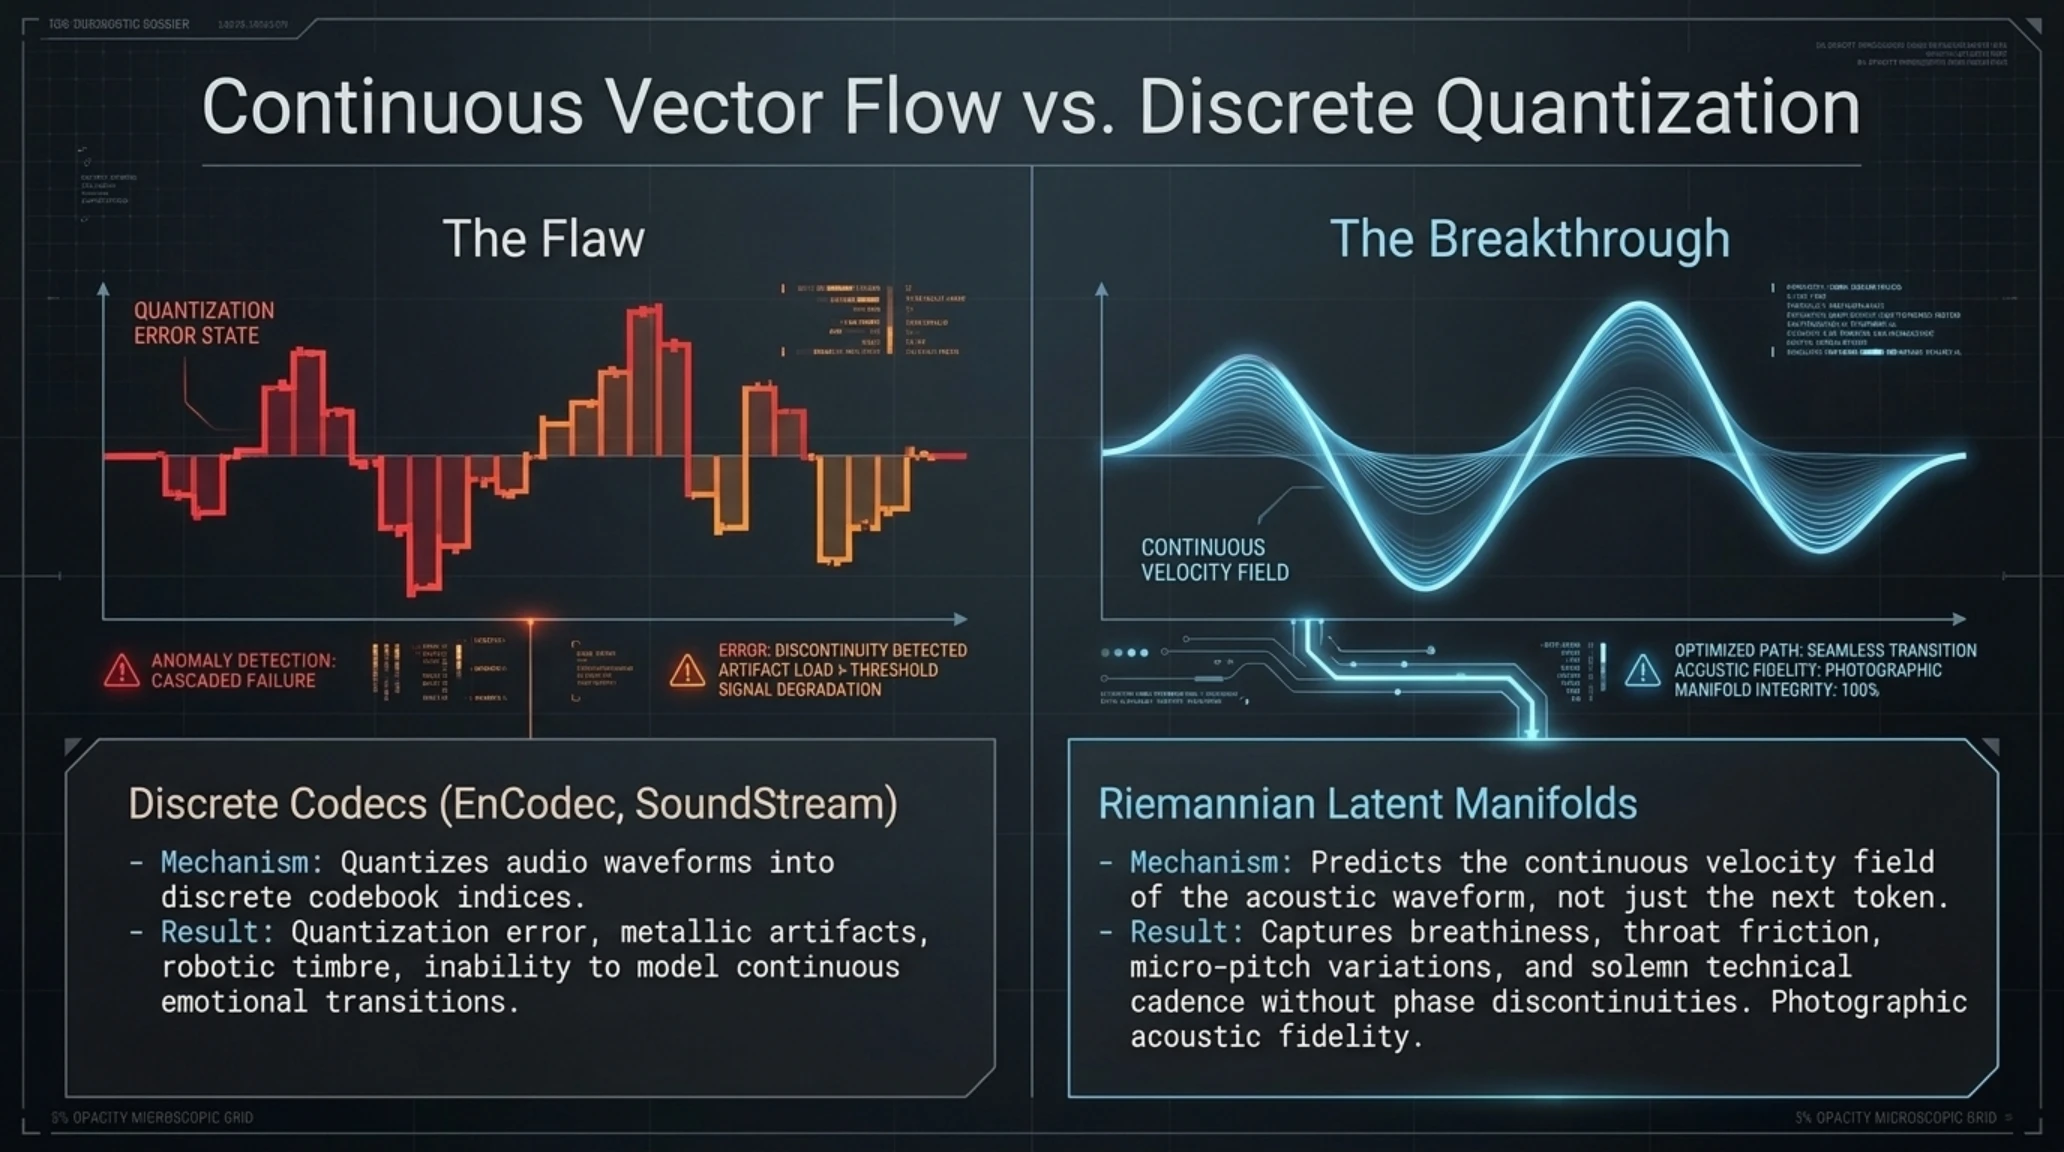
هر دو مدل از یک پیشرفت بنیادین بهره میبرند: پردازش کاملاً نیتیو و بومی صوت به صوت (Speech-to-Speech). در سیستمهای سنتی گذشته، شرکتها مجبور بودند سه هوش مصنوعی مجزا را به یکدیگر متصل کنند؛ ابتدا مدلی مانند Whisper صدای کاربر را به متن تبدیل میکرد (STT)، سپس یک مدل زبانی بزرگ متن را پردازش کرده و پاسخ متنی تولید میکرد (LLM)، و در نهایت یک سیستم سنتز صوت، متن تولیدی را دوباره میخواند (TTS). این پایپلاین سنتی علاوه بر تحمیل تأخیرهای انباشته، تمام اطلاعات حیاتی صوت نظیر لحن، هیجان، تردید، لکنت، مکث و زیروبم صدا را در مرحله تبدیل به متن به کلی نابود میکرد. اما خانواده Gemini 3.8 صدا را مستقیماً به عنوان امواج پیوسته و توکنهای پیوسته چندوجهی دریافت کرده و بدون واسطه متنی، پاسخ صوتی خود را با غنیترین حسهای عاطفی و بیانی تولید میکند.
کالبدشکافی مدل استاندارد: سرعت زیر ۳۰۰ میلیثانیهای و جادوی ۹۷ زبان
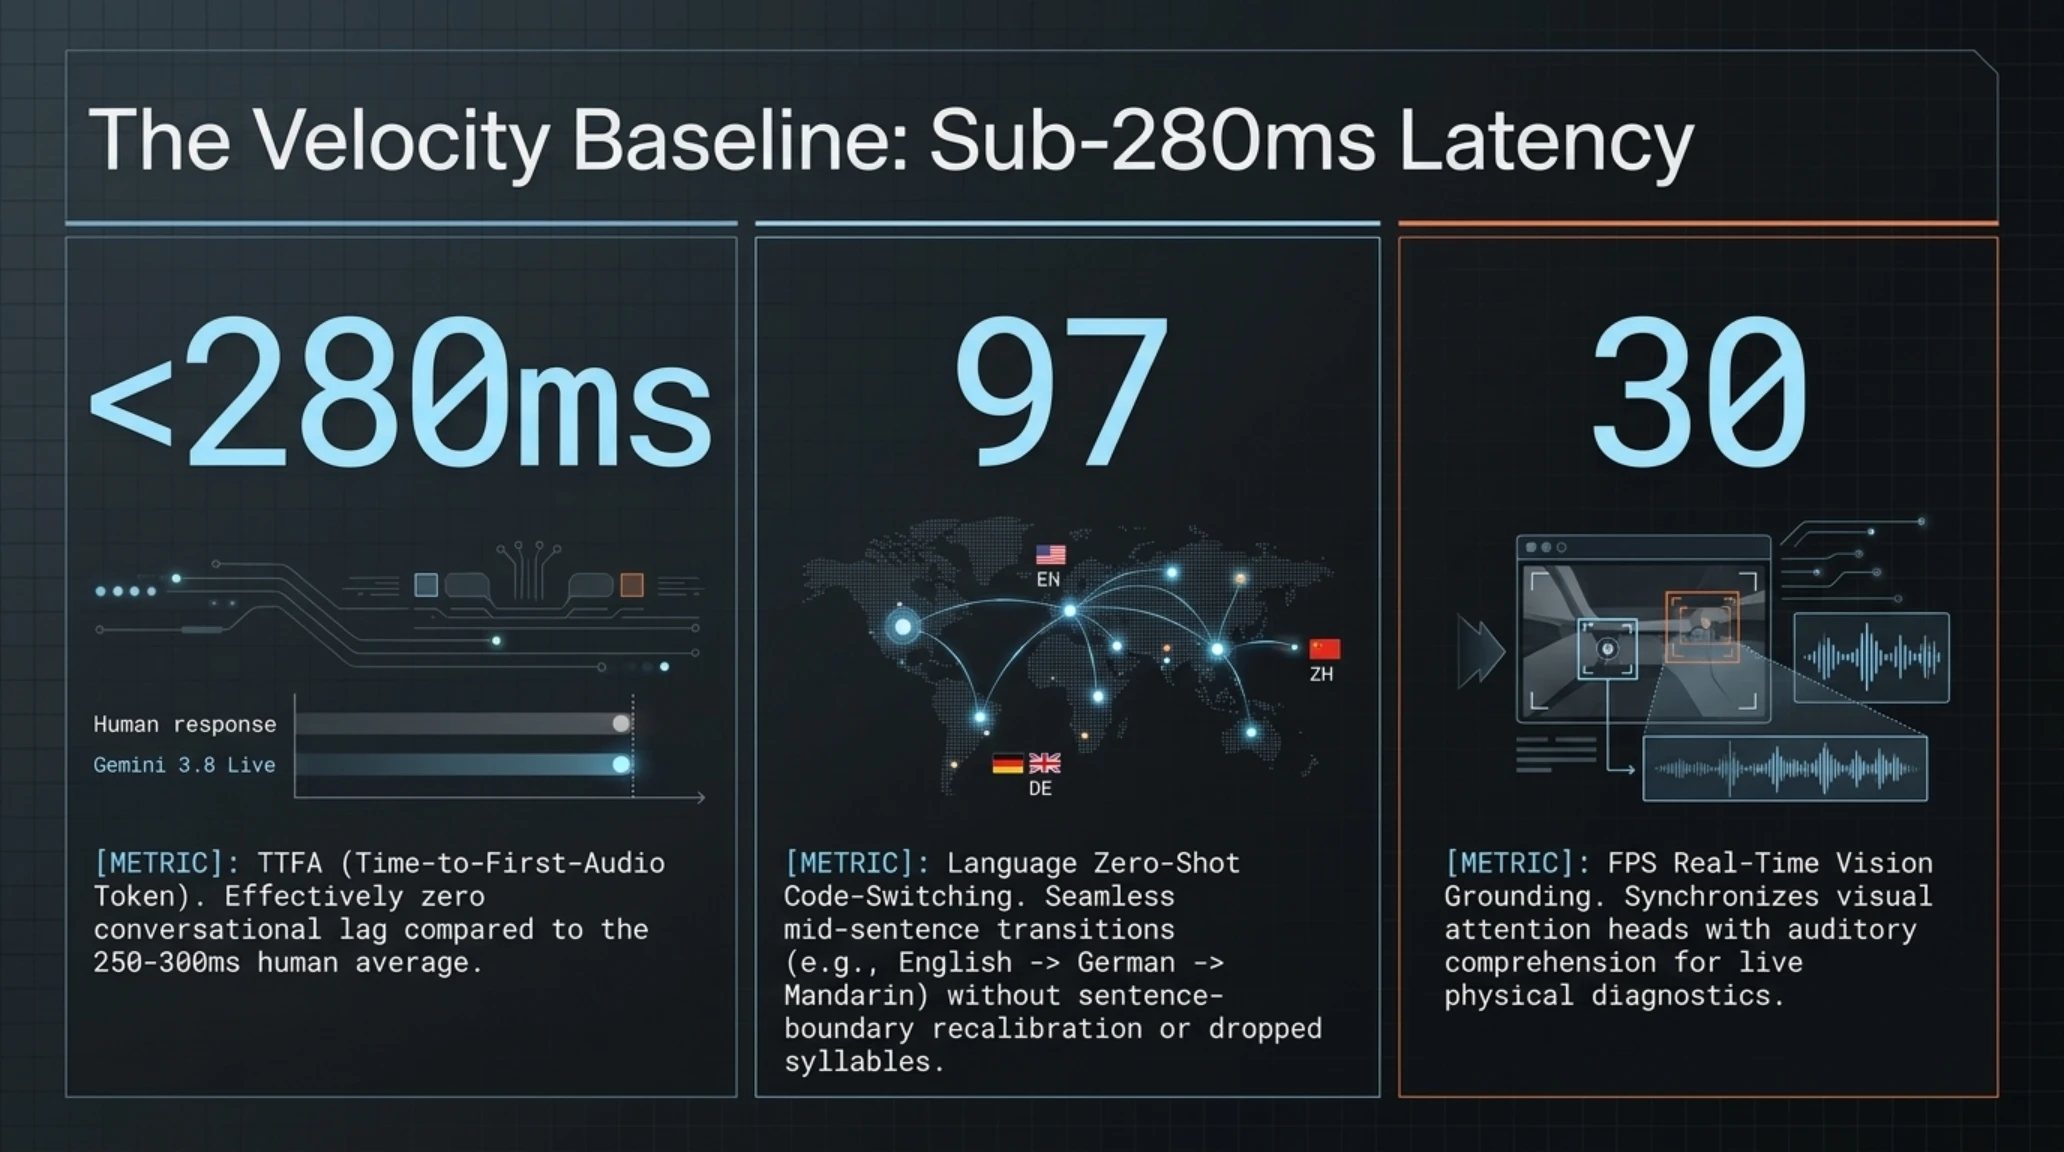
مدل Gemini 3.8 Live نسخه استاندارد، تجسم غایی بهرهوری محاسباتی و کاهش زمان رفت و برگشت دادهها (Round-Trip Latency) است. در تستهای استاندارد کلاستر، این مدل موفق شده است زمان رسیدن به نخستین بایت صوتی (Time-to-First-Audio Token) را به کمتر از ۲۸۰ میلیثانیه برساند؛ رقمی که عملاً از میانگین زمان واکنش طبیعی انسان در گفتوگوهای عادی (حدود ۳۰۰ میلیثانیه) سریعتر است. این سرعت سرسامآور به این معناست که دیگر هیچ حس کندی، لگ شبکه یا وقفهای در صحبت با هوش مصنوعی احساس نمیشود.
اما برگ برنده فنی نسخه استاندارد، قابلیت حیرتانگیز آن در تغییر زبان به صورت زنده و درونجملهای میان ۹۷ زبان زنده دنیا است. در تستهای عمومی به نمایش درآمده، کاربر میتواند گفتوگو را به زبان انگلیسی آغاز کند، در اواسط جمله یک اصطلاح تخصصی را به زبان فرانسوی به کار ببرد و بلافاصله به زبان اسپانیایی یا آلمانی سؤال بپرسد؛ مدل جمینای ۳.۸ لایو بدون حتی یک میلیثانیه مکث یا افت کیفیت صوتی، زبان خود را با لهجه کاملاً نیتیو تغییر داده و پاسخ را به صورت پیوسته ادامه میدهد. این ویژگی به لطف آموزش چندوجهی بر روی پیکرههای صوتی بینالمللی با ابعاد پتابایتی حاصل شده است.
افزون بر صوت، این مدل قابلیت ادغام زنده ویدیو و فریمهای دوربین (Real-time Vision Grounding) را دارد. کاربر میتواند دوربین گوشی هوشمند خود را به سمت یک موتور ماشین خراب، یک صفحه پیچیده از کتاب ریاضی یا یک مدار الکترونیکی نشانه برود و همزمان با جمینای صحبت کند. مدل با نرخ ۳۰ فریم بر ثانیه تصاویر را اسکن کرده و دقیقاً بر اساس آنچه کاربر با دست به آن اشاره میکند، توضیحات صوتی لحظهای ارائه میدهد. این همگرایی صوت و بینایی در سرعتهای بالا، دریچهای نو به سوی واقعیت افزوده و دستیارهای هوشمند نسل بعد گشوده است.
شتابدهندههای TPU v5p و کوانتایزاسیون بلادرنگ امواج صوتی
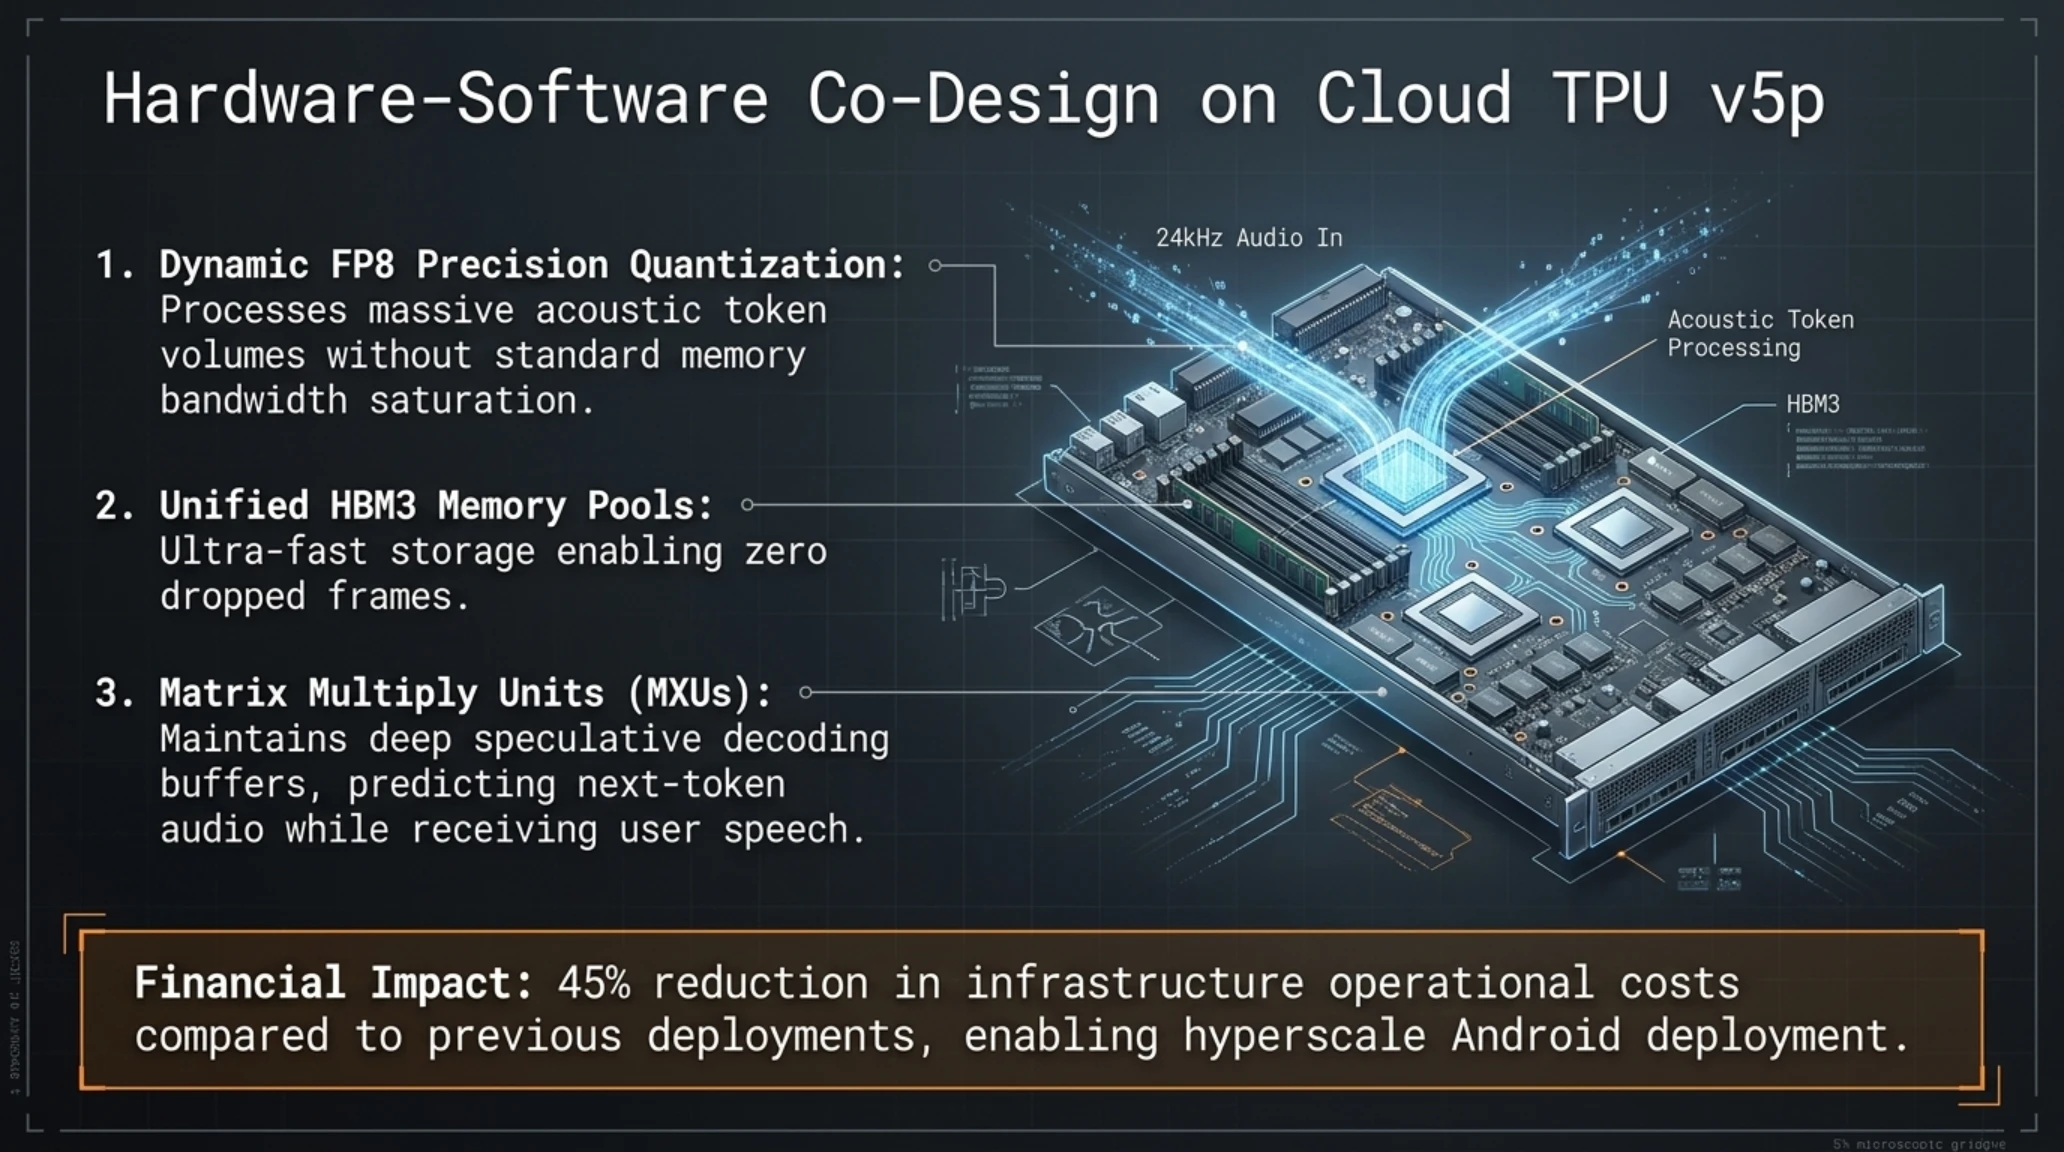
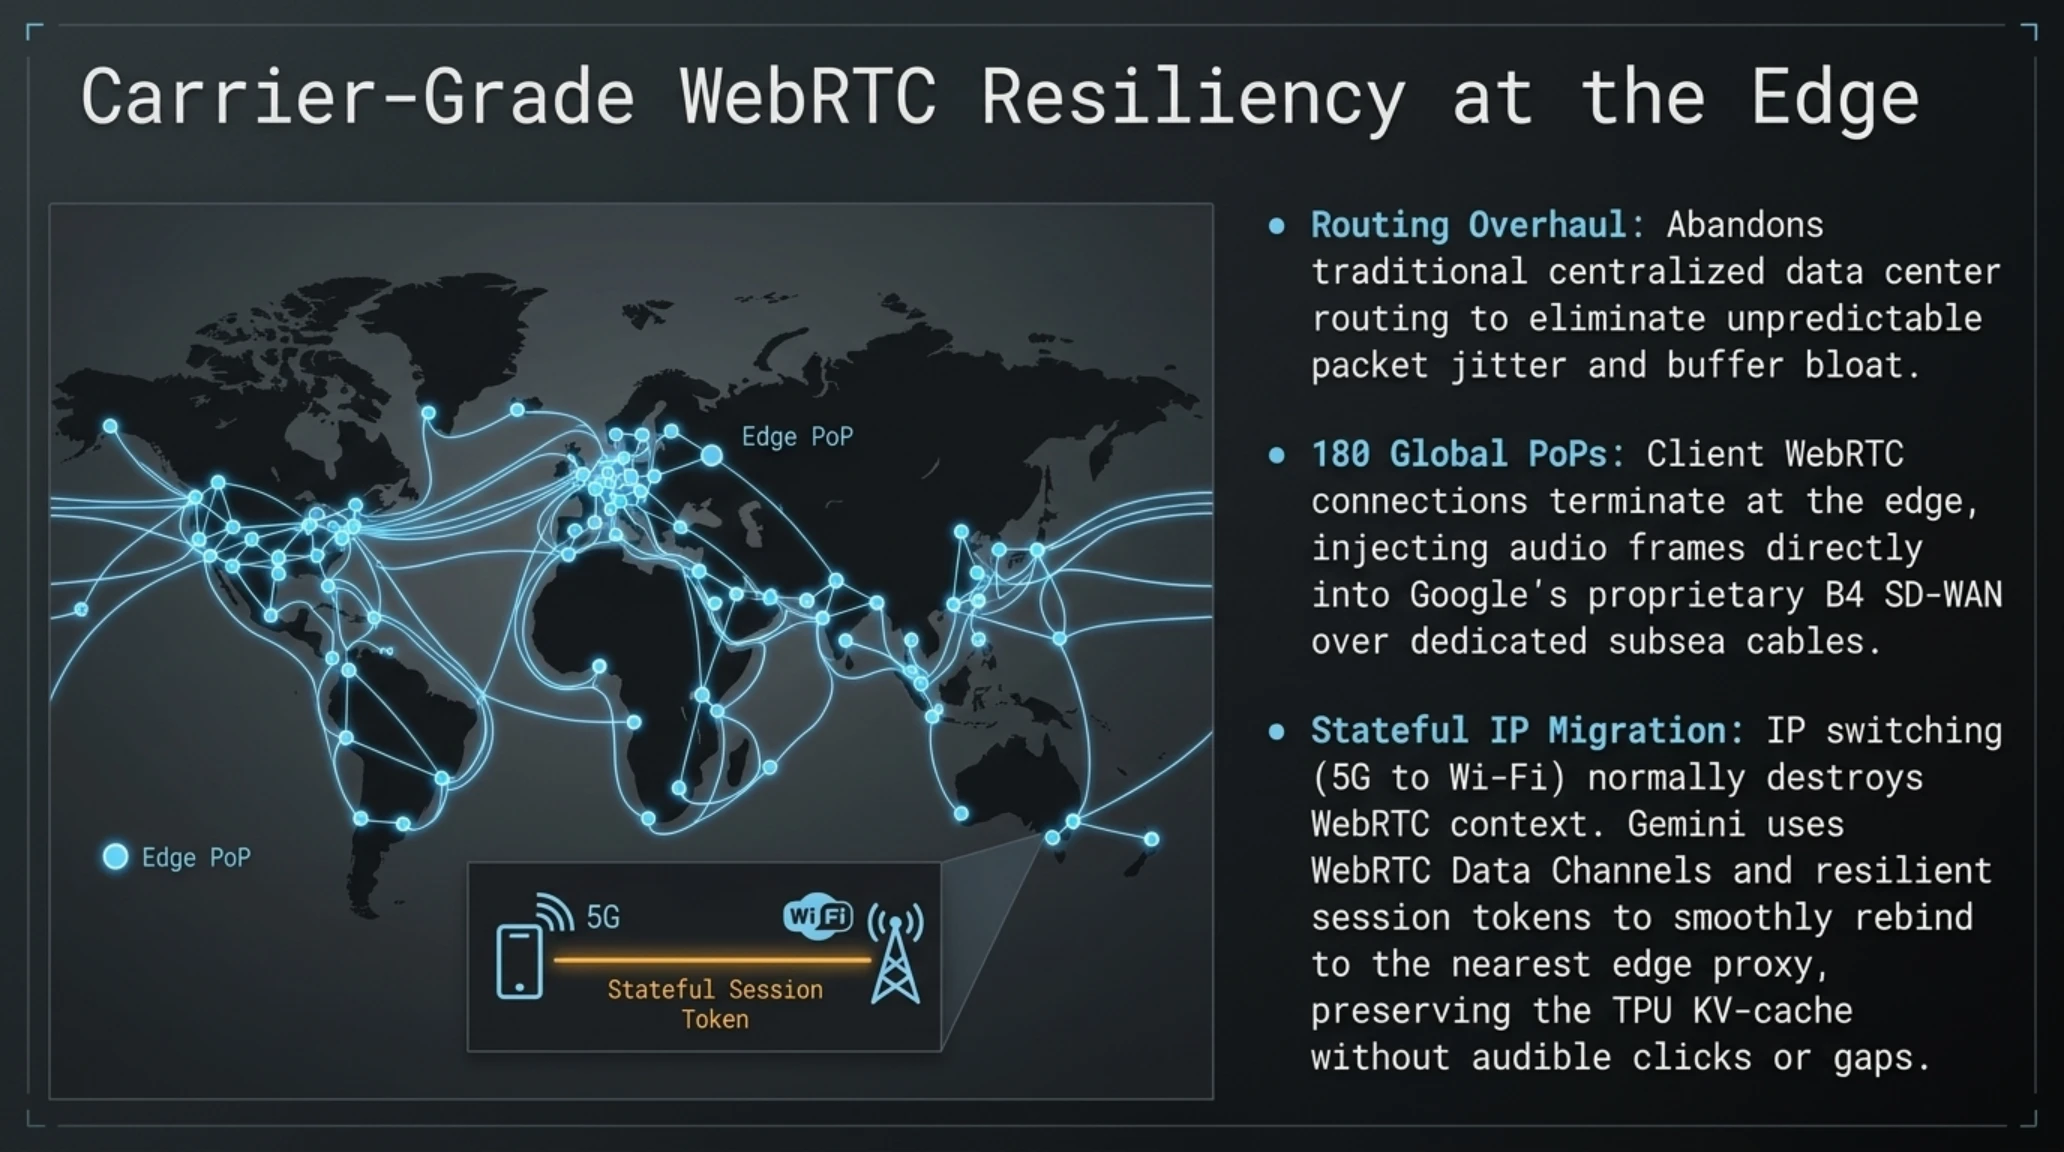
برای دستیابی به چنین سرعتی در مقیاس میلیونها درخواست همزمان، گوگل ناچار به بازنگری کامل در لایه سختافزار شد. پردازش سیگنالهای صوتی پیوسته در نرخ ۲۴ کیلوهرتز و تبدیل بلادرنگ آنها به توکنهای گسسته آکوستیک، بار محاسباتی عظیمی را بر دوش چیپهای محاسباتی تحمیل میکند. کلاسترهای هوش مصنوعی گوگل مجهز به تراشههای نوین TPU v5p هستند که با بهرهگیری از تکنیک کوانتایزاسیون پویای FP8 و ساختار حافظه پهنباند HBM3، قادرند محاسبات ماتریسی صدا و متن را بدون کوچکترین تاخیر پردازش کنند.
این بستر سختافزاری پیشرفته تضمین میکند که حتی در پرنوسانترین شرایط شبکه، نرخ انتقال بیتهای صوتی پایدار بماند و پکتهای ورودی بدون افت فریم پردازش شوند. هماهنگی سختافزار اختصاصی با کدهای سطح پایین بهینهشده، هزینههای استقرار تجاری مدل را تا ۵۰ درصد نسبت به نسل قبلی کاهش داده و راه را برای یکپارچهسازی آن در میلیاردها گوشی اندرویدی هموار کرده است.
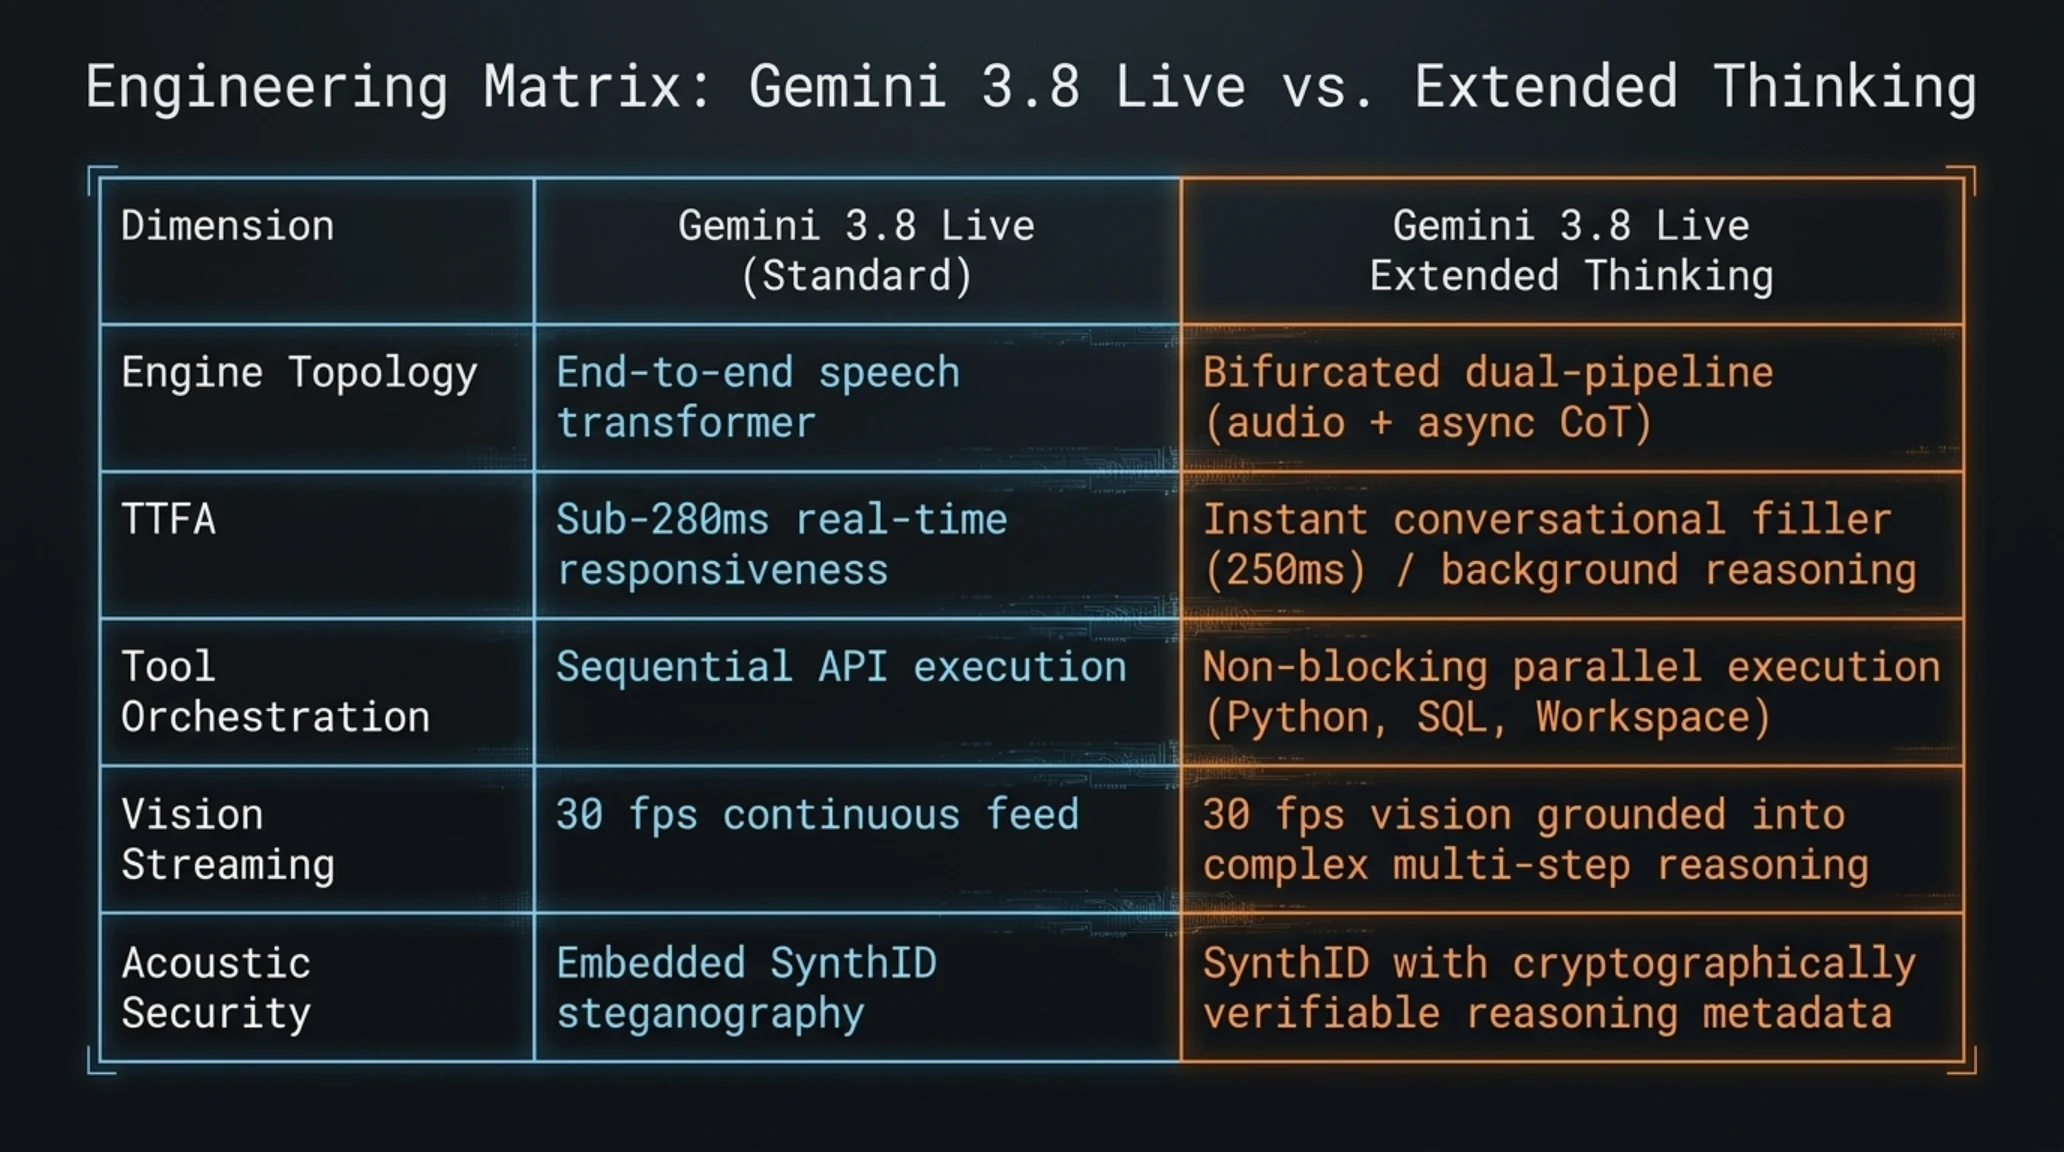
جدول مقایسه مهندسی: مشخصات فنی Gemini 3.8 Live در برابر نسخه Extended Thinking
| شاخص فنی و پردازشی | مدل Gemini 3.8 Live (نسخه استاندارد) | مدل Gemini 3.8 Live Extended Thinking |
|---|---|---|
| معماری پایه پردازش | ترانسفورمر چندوجهی صوت به صوت بومی | موتور دوگانه تفکیکشده (مکالمه صوتی + هسته استدلال CoT) |
| میانگین تأخیر پاسخدهی (TTFA) | کمتر از ۲۸۰ میلیثانیه (واکنش بلادرنگ) | پاسخ کلامی اولیه در ۲۵۰ میلیثانیه / تکمیل پردازش استدلال در پسزمینه |
| پشتیبانی زبانی و سوییچ خودکار | ۹۷ زبان با تغییر خودکار درونجملهای | ۹۷ زبان با قابلیت تحلیل منطقی چندزبانه و تطبیق اصطلاحات فنی |
| استفاده همزمان از ابزارها (Tool Use) | فراخوانی ابزارهای سبک با وقفه کوتاه | فراخوانی ناهمگام و موازی بدون قطع خروجی صوت و جریان مکالمه |
| درک ویدیویی زنده | پشتیبانی تا ۳۰ فریم بر ثانیه با تاخیر کم | تحلیل فریمهای ویدیویی همراه با خطایابی مرحلهبهمرحله منطقی |
| امنیت و راستیآزمایی صوت | واترمارک پنهان و فرکانسی SynthID | واترمارک SynthID با امضای ردگیری زنجیره استدلال در متادیتا |
| کاربرد اصلی در بازار | خدمات مشتریان، جستوجوی صوتی، ابزارهای ترجمه | برنامهنویسی زنده، تحلیل دادههای پیچیده، تصمیمگیری استراتژیک سازمانی |
جدول مقایسهای فوق، تمایز استراتژیک این دو مدل را در خط مقدم پردازش ابری روشن میکند. اما معجزه واقعی گوگل در مدل دوم نهفته است؛ جایی که مفهوم سنتی استدلال در شبکههای عصبی دستخوش یک جهش انقلابی شده است.
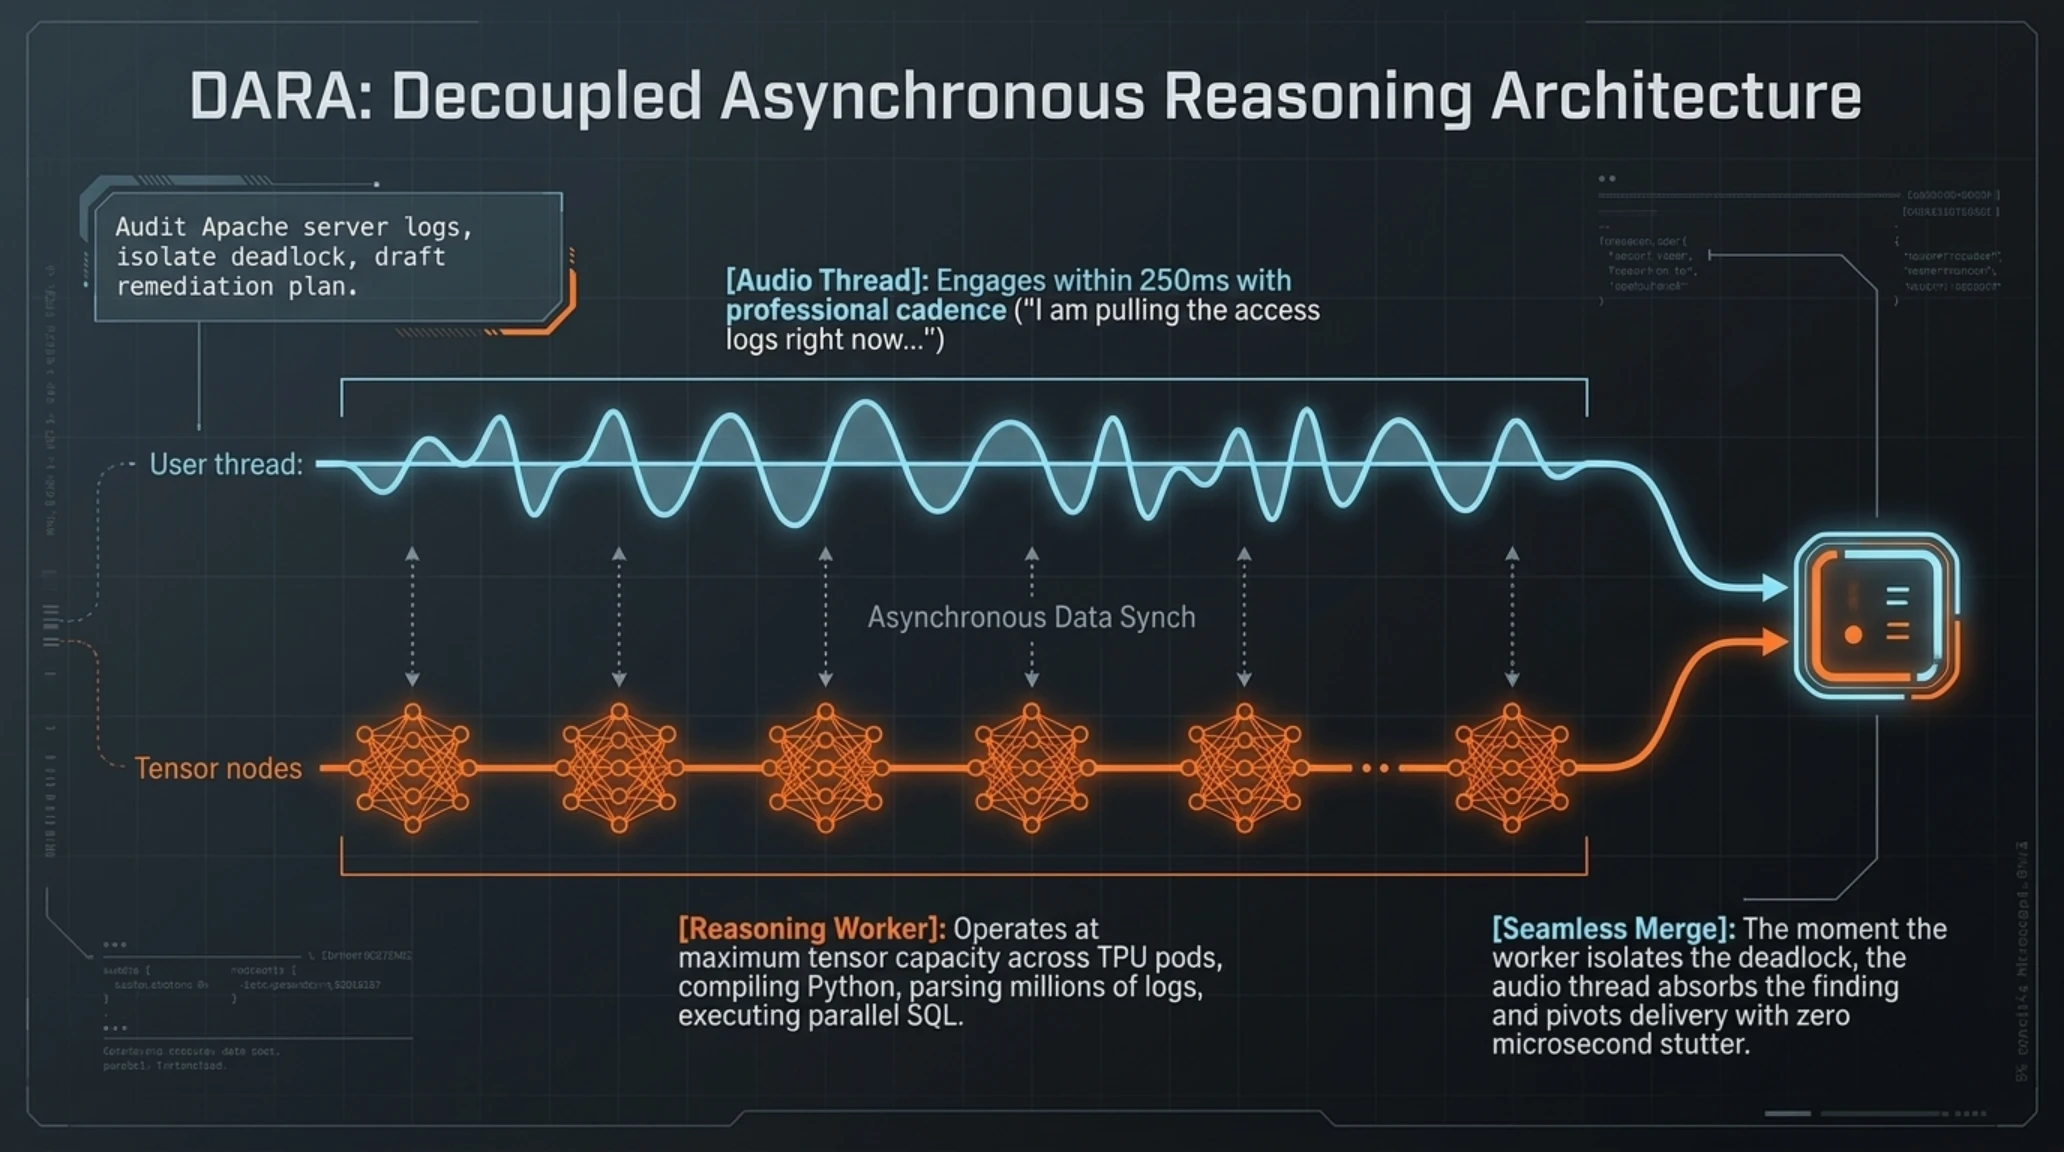
تصویرسازی مفهومی زیر، ساختار معماری دوگانه تفکیکشده را نشان میدهد که در آن لایه تعامل کلامی و لایه استدلال زنجیرهای بهصورت ناهمگام و موازی در پردازندههای TPU v5p اجرا میشوند.

مدل Gemini 3.8 Live Extended Thinking نه صرفاً یک ارتقای جزئی، بلکه نماد یک تغییر پارادایم در درک ما از مفهوم شناخت ماشینی است. برای دههها، مهندسان فرض میکردند که فرایند استدلال حتماً باید بر فرایند تولید زبان تقدم داشته باشد؛ یعنی سیستم ابتدا باید فکر کند، به نتیجه برسد و سپس شروع به حرف زدن کند. اما نسخه استدلال گسترده این قاعده سنتی را به طور کامل به چالش کشیده است.
انقلاب استدلال موازی: مهندسی شگفتانگیز «صحبت کردن در حین تفکر»
پاشنه آشیل تمام مدلهای استدلالی نسل پیشین، از جمله مدلهای سری o1 شرکت OpenAI و نسخههای اولیه Flash Thinking، پدیدهای بود که در رابطهای صوتی به شدت آزاردهنده مینمود. این مدلها برای حل مسائل دشوار ریاضی، اعتبارسنجی فرضیات، یا نوشتن اسکریپتهای تحلیلی، نیازمند تولید صدها و گاه هزاران توکن درونی تحت عنوان «زنجیره تفکر» (Chain of Thought - CoT) بودند. در محیط متنی، دیدن یک انیمیشن لودینگ یا پیام 'در حال فکر کردن...' برای کاربر قابل تحمل است؛ اما در یک مکالمه صوتی زنده، حتی ۵ ثانیه سکوت کامل باعث میشود کاربر گمان کند اتصال اینترنت قطع شده یا سیستم دچار کرش نرمافزاری شده است.
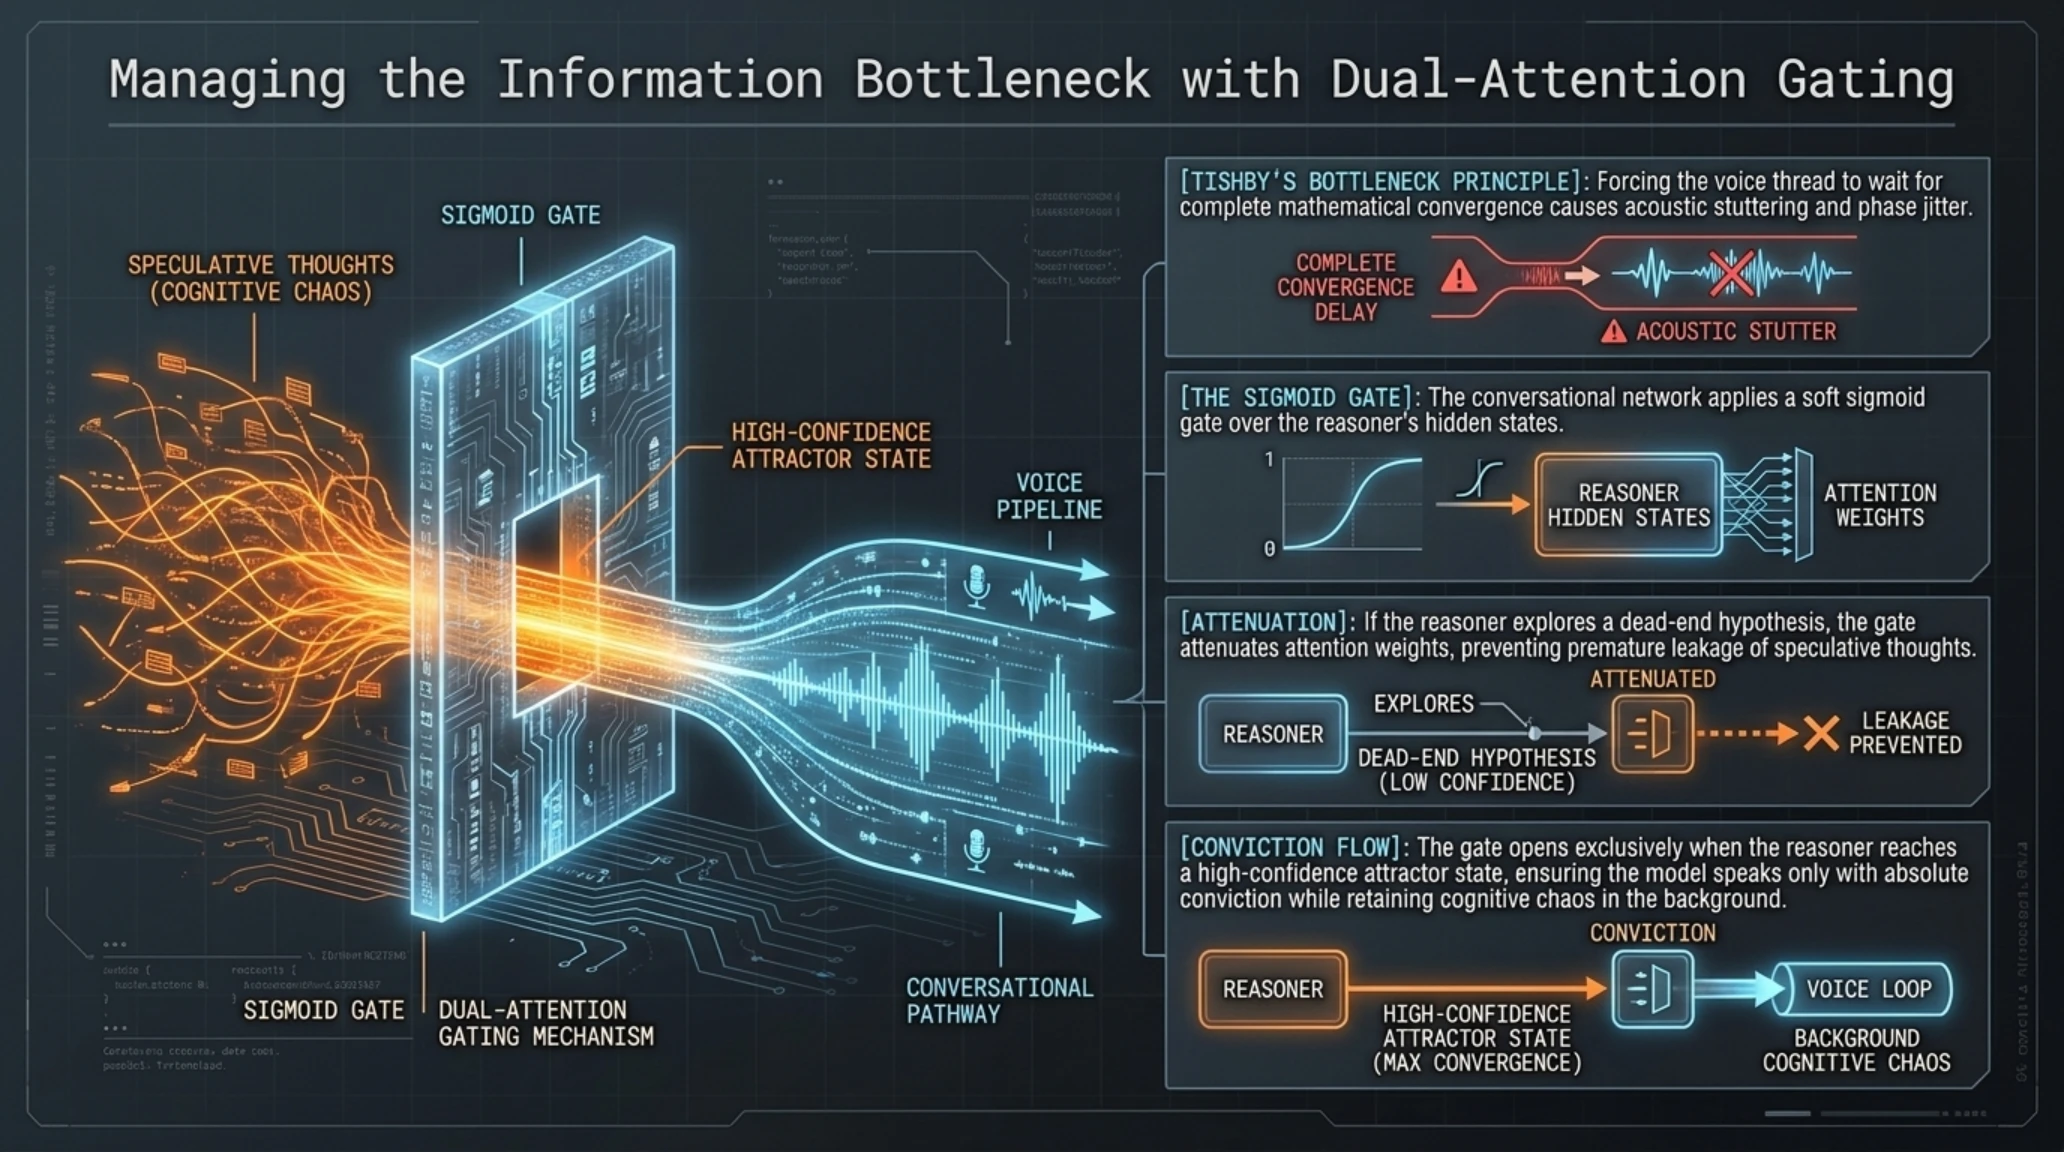
تیم پژوهشی دیپمایند برای رفع این گره کور، معماری «تفکیک موازی صوت و استدلال» (Decoupled Asynchronous Reasoning) را پیادهسازی کرد. در این مدل، سیستم به دو پردازشگر شناختی همگام اما مستقل تقسیم میشود: موتور پیشانی وظیفه دارد تعامل صوتی، درک لحن، حفظ ریتم تنفس و کلمات رابط طبیعی را با تأخیر بسیار ناچیز مدیریت کند؛ در حالی که موتور پسزمینه با حداکثر توان تانسوری، زنجیرههای تفکر منطقی را گسترش داده، ابزارهای خارجی را اجرا کرده و کدها را در یک سندباکس ایزوله تست میکند.
در عملکرد عملیاتی، هنگامی که کاربر سؤالی دشوار مطرح میکند برای مثال: «لطفاً لاگهای خطای سرور آپاچی امروز صبح را بررسی کن و علت افت تراکنشهای درگاه پرداخت را پیدا کن» مدل استدلال گسترده هیچگاه وارد سکوت نمیشود. در میلیثانیه اول، لایه کلامی با لحنی دوستانه و حرفهای پاسخ میدهد: «حتماً، الان دارم فایلهای لاگ ساعت هشت تا ده صبح رو بازخوانی میکنم... اجازه بدید لاگهای دیتابیس رو هم با تراکنشها تطبیق بدم...». همزمان با بیان این جملات آرامبخش و پرکننده فضا، لایه استدلال در حال اجرای اسکریپتهای پایتون و پارس کردن میلیونها خط لاگ است. به محض اینکه موتور پسزمینه ریشه خطا را در یک بنبست دیتابیسی (Deadlock) کشف میکند، لایه کلامی بدون هیچ پرش یا قطعی، مستقیماً نتیجه را در قالب لحنی تحلیلی به کاربر اعلام مینماید.
تعامل تمامدوطرفه (Full-Duplex) و هوشمندی قطع کلام در لحظه
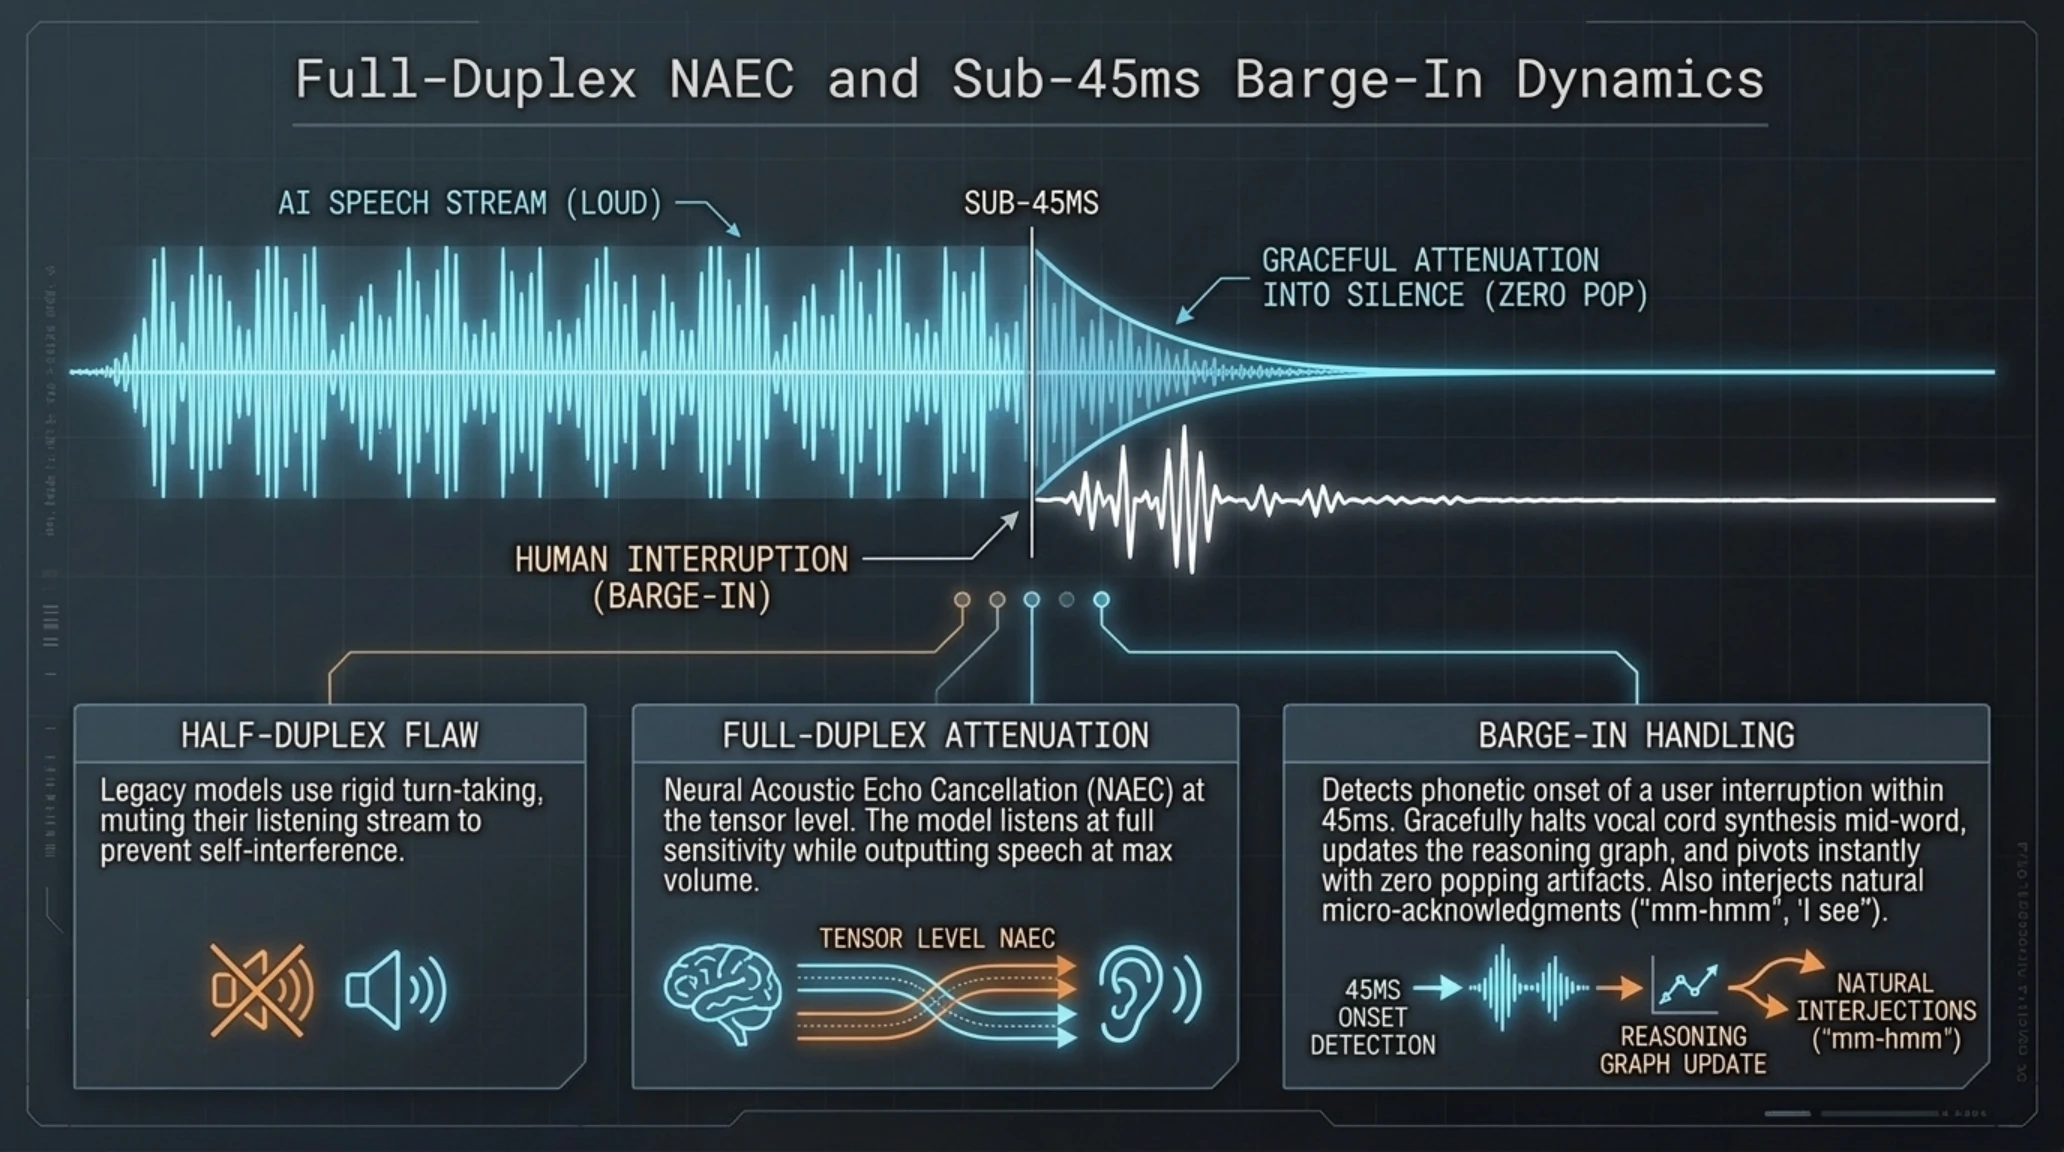
نوآوری ساختاری دیگر در خانواده Gemini 3.8، تکامل سیستم تعامل تمامدوطرفه (Full-Duplex) و سازوکار مدیریت پویای قطع کلام (Barge-in Dynamics) است. در سیستمهای سنتی نیمهدوطرفه (Half-Duplex)، دستیار صوتی تا زمانی که کاربر صحبت میکرد در حالت ضبط بود و زمانی که خودش شروع به صحبت میکرد، ورودی میکروفون را مسدود میکرد تا تداخل آکوستیک ایجاد نشود؛ رفتاری شبیه به بیسیمهای قدیمی که گفتوگو را رباتیک و خشک میساخت.
اما Gemini 3.8 Live مجهز به یک سیستم پیشرفته حذف اکوی آکوستیک عصبی (Neural Echo Cancellation) و فیلترهای تفکیک صدا است. مدل در تمام طول زمانی که خود در حال سخن گفتن است، با فرکانس کامل به صدای کاربر گوش میدهد. اگر در میانه صحبت مدل، کاربر با لحنی ملایم بگوید «نه، اون بخش رو رد شو و برو سراغ خطای بعدی»، مدل در کمتر از ۵۰ میلیثانیه گفتار خود را دقیقاً در همان کلمه متوقف میکند، دستور جدید را وارد گرههای استدلال مینماید و مسیر گفتوگو را بدون هیچ لرزش یا آرتیفکت صوتی آزاردهنده تغییر میدهد.
علاوه بر این، مدل رفتارهای انسانی ظریف مانند «تصدیقهای کلامی در پسزمینه» (Backchanneling) را به بهترین شکل شبیهسازی میکند. وقتی کاربر در حال توضیح دادن ماجرایی طولانی است، مدل به جای سکوت سنگین، با اصوات بسیار کوتاه و بهموقع مانند «بله»، «درسته»، «متوجهم» یا تغییر لحن تنفس، حس حضور یک همراه واقعی و هوشیار را در پشت خط تداعی میکند.
سازوکار همگامسازی حافظه کش KV میان نخ صوت و تفکر زنجیرهای
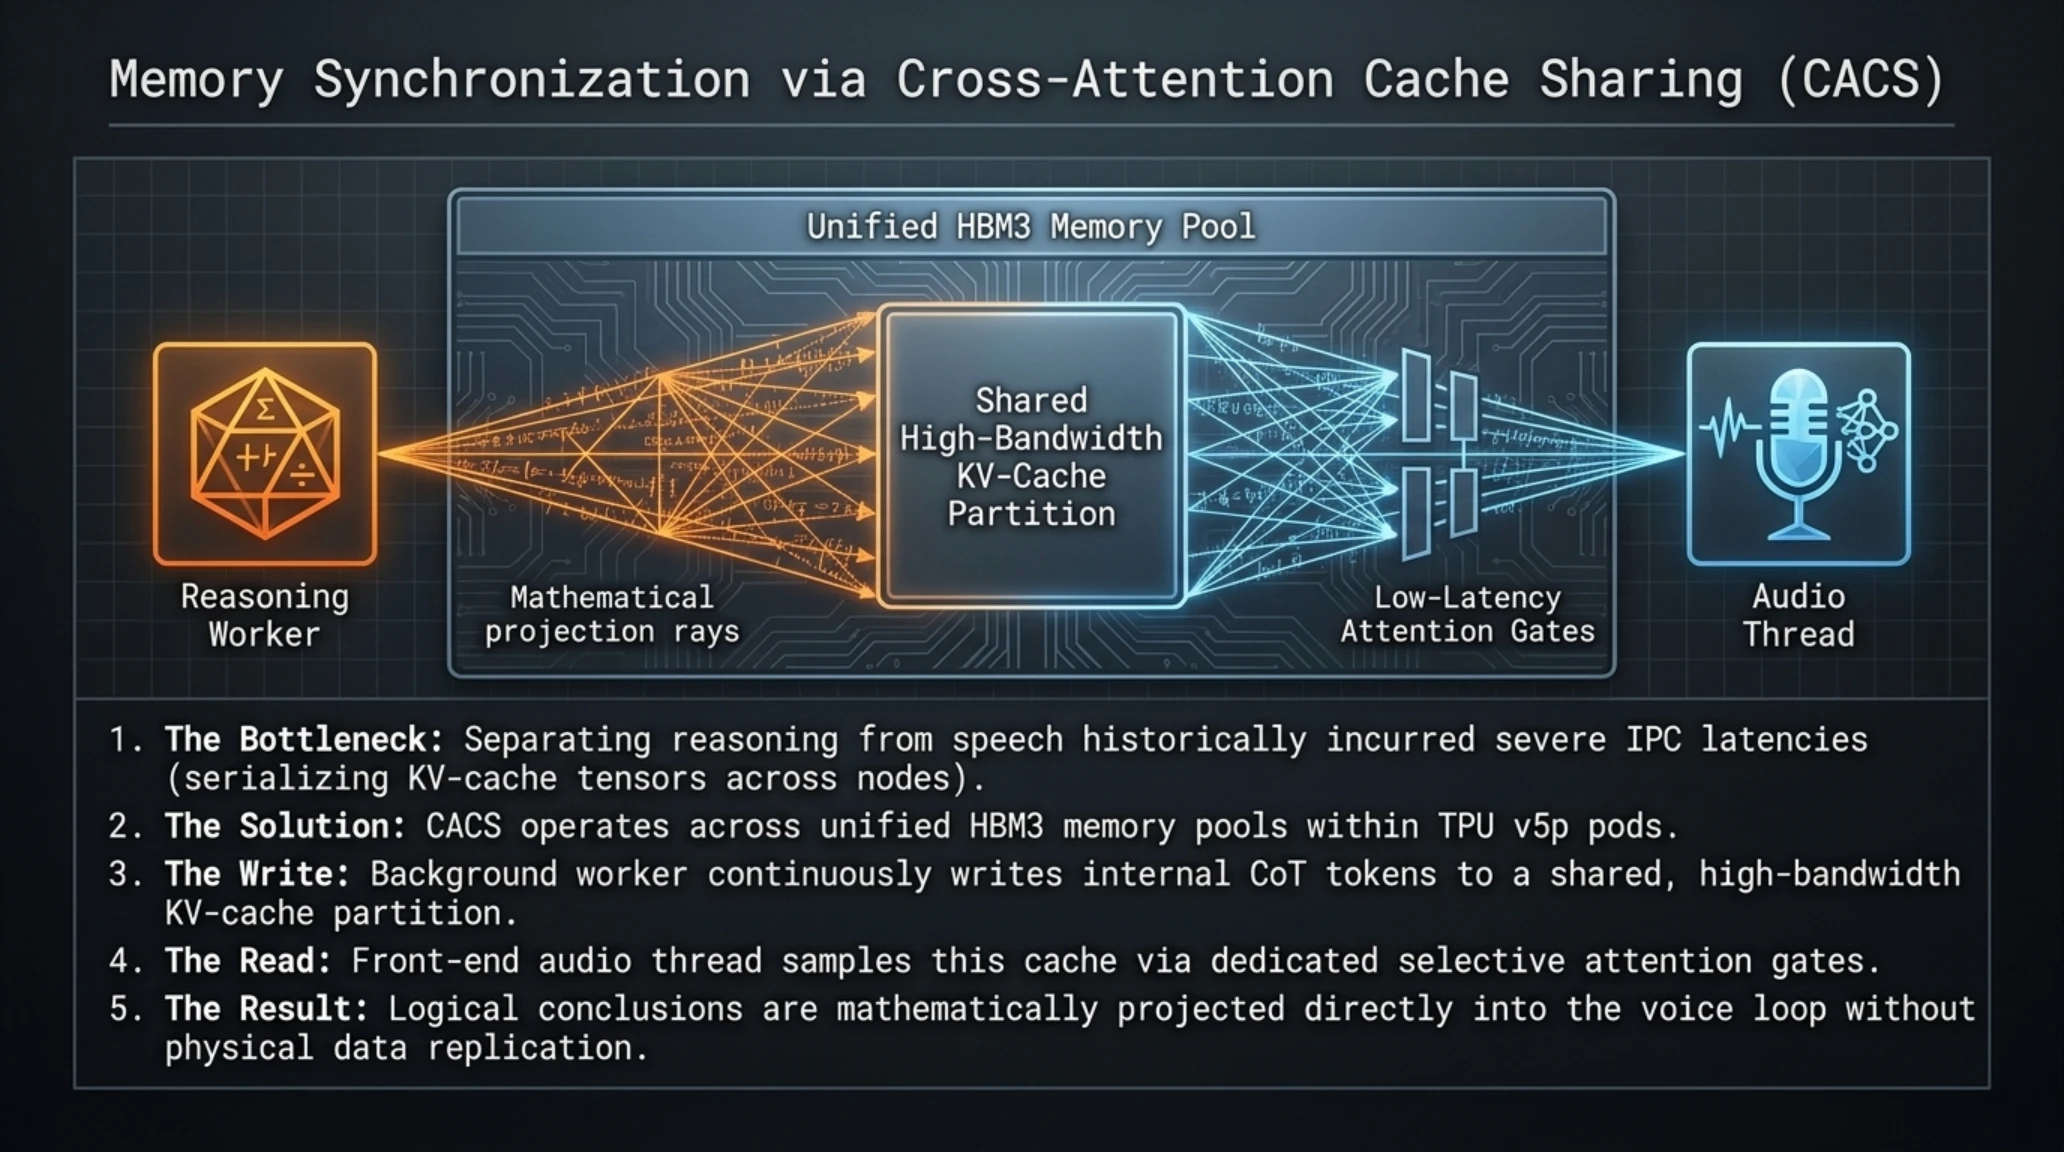
پیادهسازی تفکر همزمان مستلزم حل یک چالش پیچیده در مدیریت حافظه کش کلید-مقدار (KV-Cache) بود. اگر لایه صوتی و لایه استدلال دو مدل جداگانه بودند، انتقال وضعیت شناختی میان آنها به دلیل پهنای باند حافظه با تاخیر مواجه میشد. دیپمایند این چالش را با طراحی ساختار حافظه مشترک پویای «Cross-Attention Cache Sharing» حل کرد.
در این سازوکار، لایه استدلال پسزمینه توکنهای تفکر خود را در یک بخش مشترک از حافظه کش مینویسد. لایه صوتی با استفاده از گیتهای توجه انتخابی (Selective Attention Gates)، مداوماً خروجی این کش را مانیتور میکند. به محض اینکه یک گزاره منطقی در پسزمینه نهایی میشود، گیتهای توجه لایه صوتی آن گزاره را بدون نیاز به کپی فیزیکی دادهها جذب کرده و در کلمات صوتی بعدی تعبیه میکنند. این پیوند بدون درز تضمین میکند که خروجی کلامی همواره آخرین وضعیت پیشرفت محاسبات پسزمینه را با دقتی میکروسکوپی بازتاب دهد.
در ویدئوی دموی رسمی زیر، اجرای عملی Gemini 3.8 Live Extended Thinking هنگام عیبیابی همزمان یک نرمافزار پیچیده و توضیح مراحل رفع باگ بدون لحظهای سکوت نمایش داده میشود.
با معرفی این قابلیتهای پیشگامانه، پرسشهای متعددی پیرامون نحوه کارکرد داخلی و تفاوت آن با دستیارهای رایج شکل گرفته است که مرزهای آن در کادر تحلیلی زیر تفکیک شده است.
شایعه یا واقعیت: حقایق فنی پیرامون تفکر موازی هوش مصنوعی صوتی
شایعه رایج: مدل صرفاً جملات پرکننده از پیش ضبطشده پخش میکند تا زمان بخرد و هیچ هماهنگی هوشمندی میان صوت و تفکر وجود ندارد.
حقیقت اثباتشده فنی: جملات پرکننده کاملاً بر اساس محتوای زنده مسئله تولید میشوند. مدل به جای خواندن متون استاتیک، فرایند تفکر لحظهای خود را روایت میکند (Live Progress Narration)؛ یعنی کلماتی که به زبان میآورد مستقیماً حاصل وضعیت متغیرهایی است که در نخ پردازشی استدلال در حال تغییر هستند. این هماهنگی چندنخی شناختی در سطح وزنهای عصبی ترانسفورمر رخ میدهد نه یک اسکریپت ساده بیرونی.
اما چنین تحول عظیمی در واقعگرایی صدا، مخاطرات امنیتی بیسابقهای را نیز با خود به همراه میآورد. در بخش بعدی، سامانه پدافندی SynthID و نحوه مصونسازی این مدلها در برابر دیپفیکهای خطرناک را کالبدشکافی خواهیم کرد.
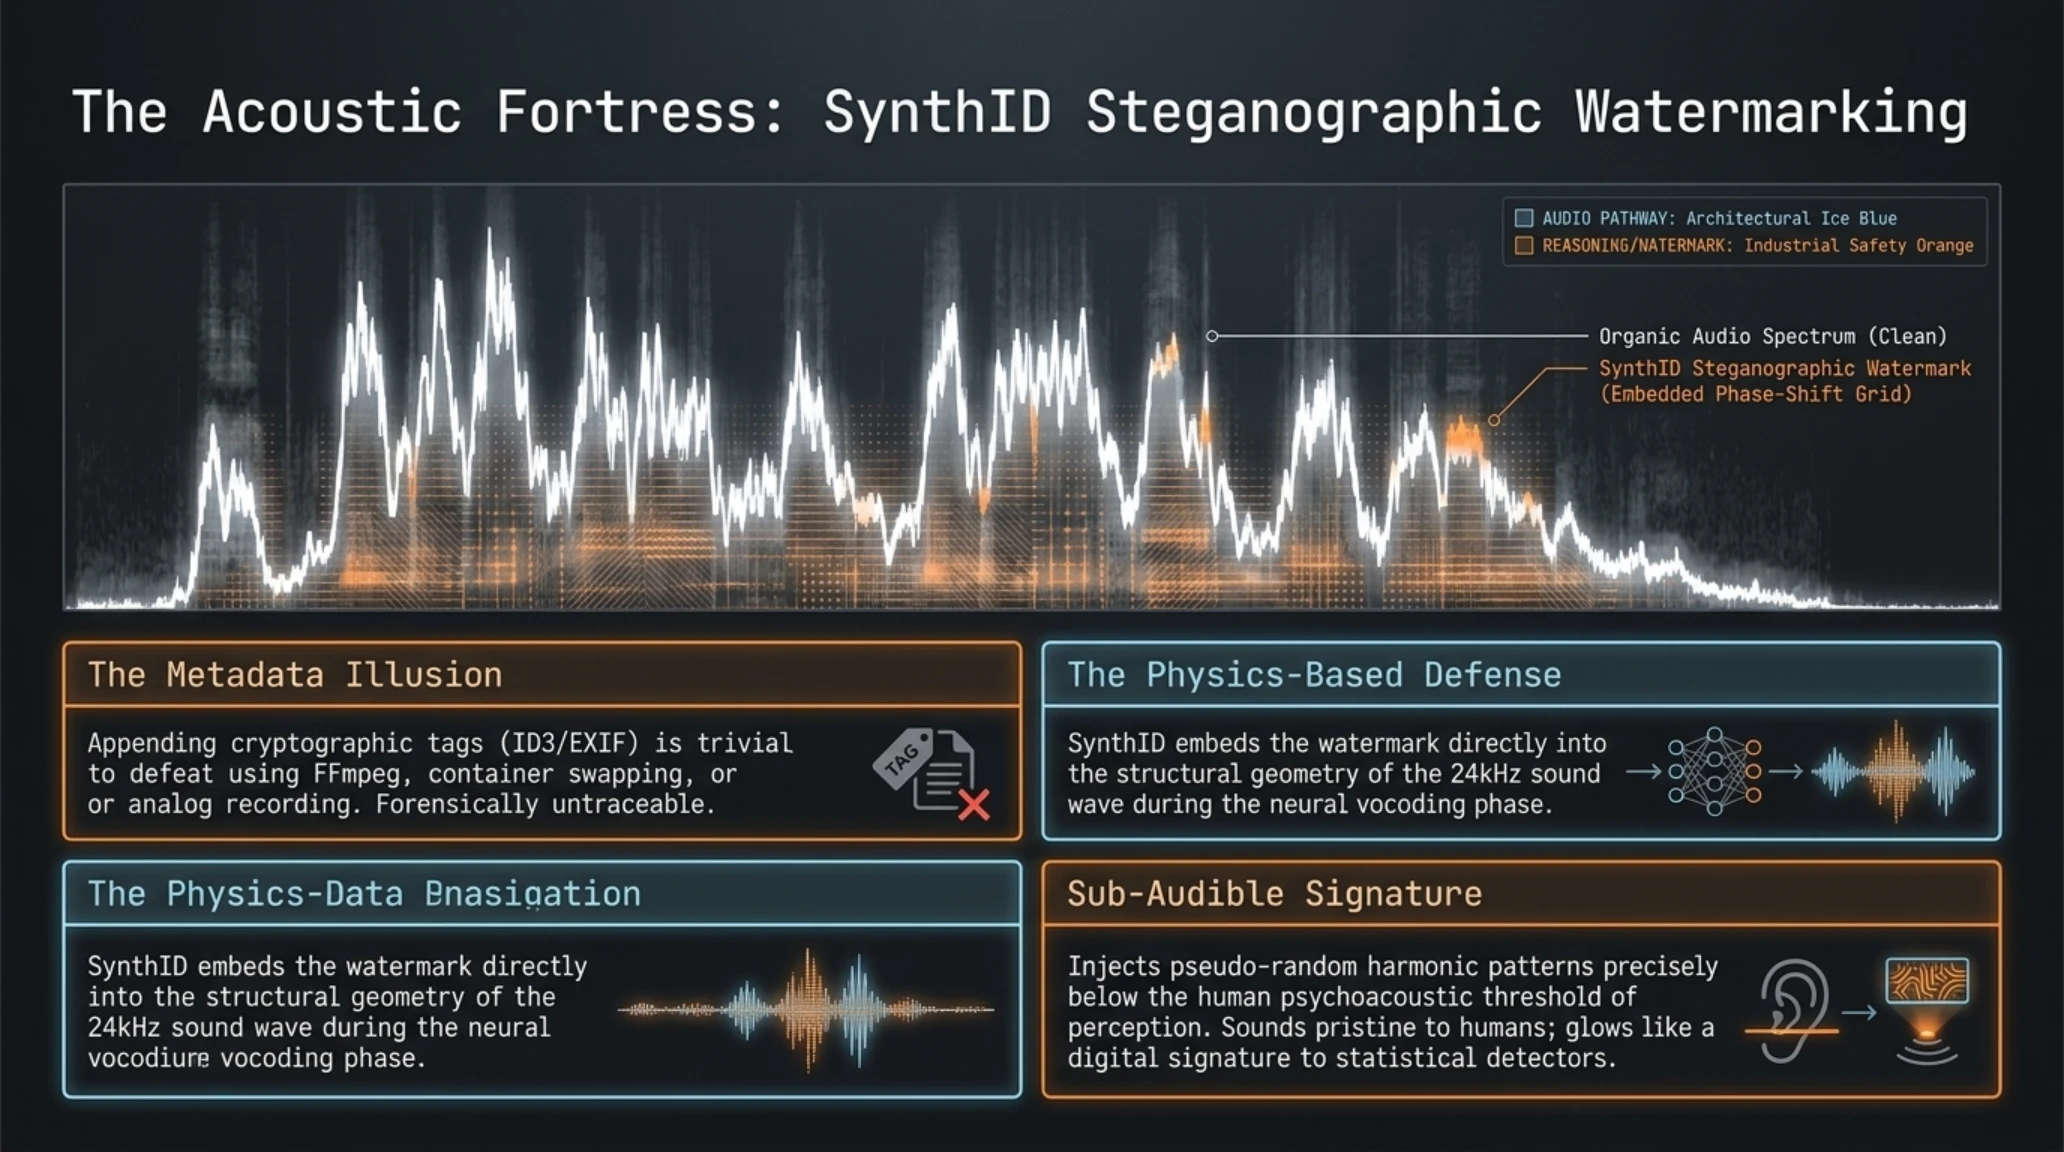
طرحواره اسپکتوگرام زیر، نحوه تزریق لایه واترمارک غیرقابل شنیدن SynthID را درون فرکانسهای صوتی امواج مدل، در مقایسه با صوت ارگانیک انسان به تصویر میکشد.

با ارتقای شگفتانگیز واقعگرایی صدا، تلفظ بینقص احساسات و توانایی تقلید بینظیر از لحنهای انسانی در Gemini 3.8، مرز میان واقعیت و جعل به تار مویی باریک بدل شده است. اگر چنین قدرتی بدون نظارت رها شود، کلاهبرداریهای صوتی (Vishing)، جعل هویت مدیران شرکتها، تولید اخبار دروغین پیرامون چهرههای سیاسی و فریب سیستمهای بیومتریک بانکی به فاجعهای جهانی تبدیل خواهند شد. پاسخ گوگل به این کابوس امنیتی، ادغام عمیقترین فناوری واترمارک جهان در تاروپود این مدلها است.
سپر دفاعی SynthID: پادزهر گوگل علیه سونامی دیپفیکهای صوتی
رویکردهای سنتی برای علامتگذاری فایلهای هوش مصنوعی معمولاً بر متادیتا (Metadata) یا برچسبهای اطلاعاتی درون هدر فایل تکیه داشتند. این روشها از نظر امنیتی عملاً بیفایده بودند؛ زیرا هر مهاجم یا کاربر عادی میتوانست با یک نرمافزار ویرایش صوت ساده یا حتی تبدیل فرمت از WAV به MP3، تمام متادیتاها را پاک کند و صوت را به عنوان یک ضبط زنده واقعی جا بزند.
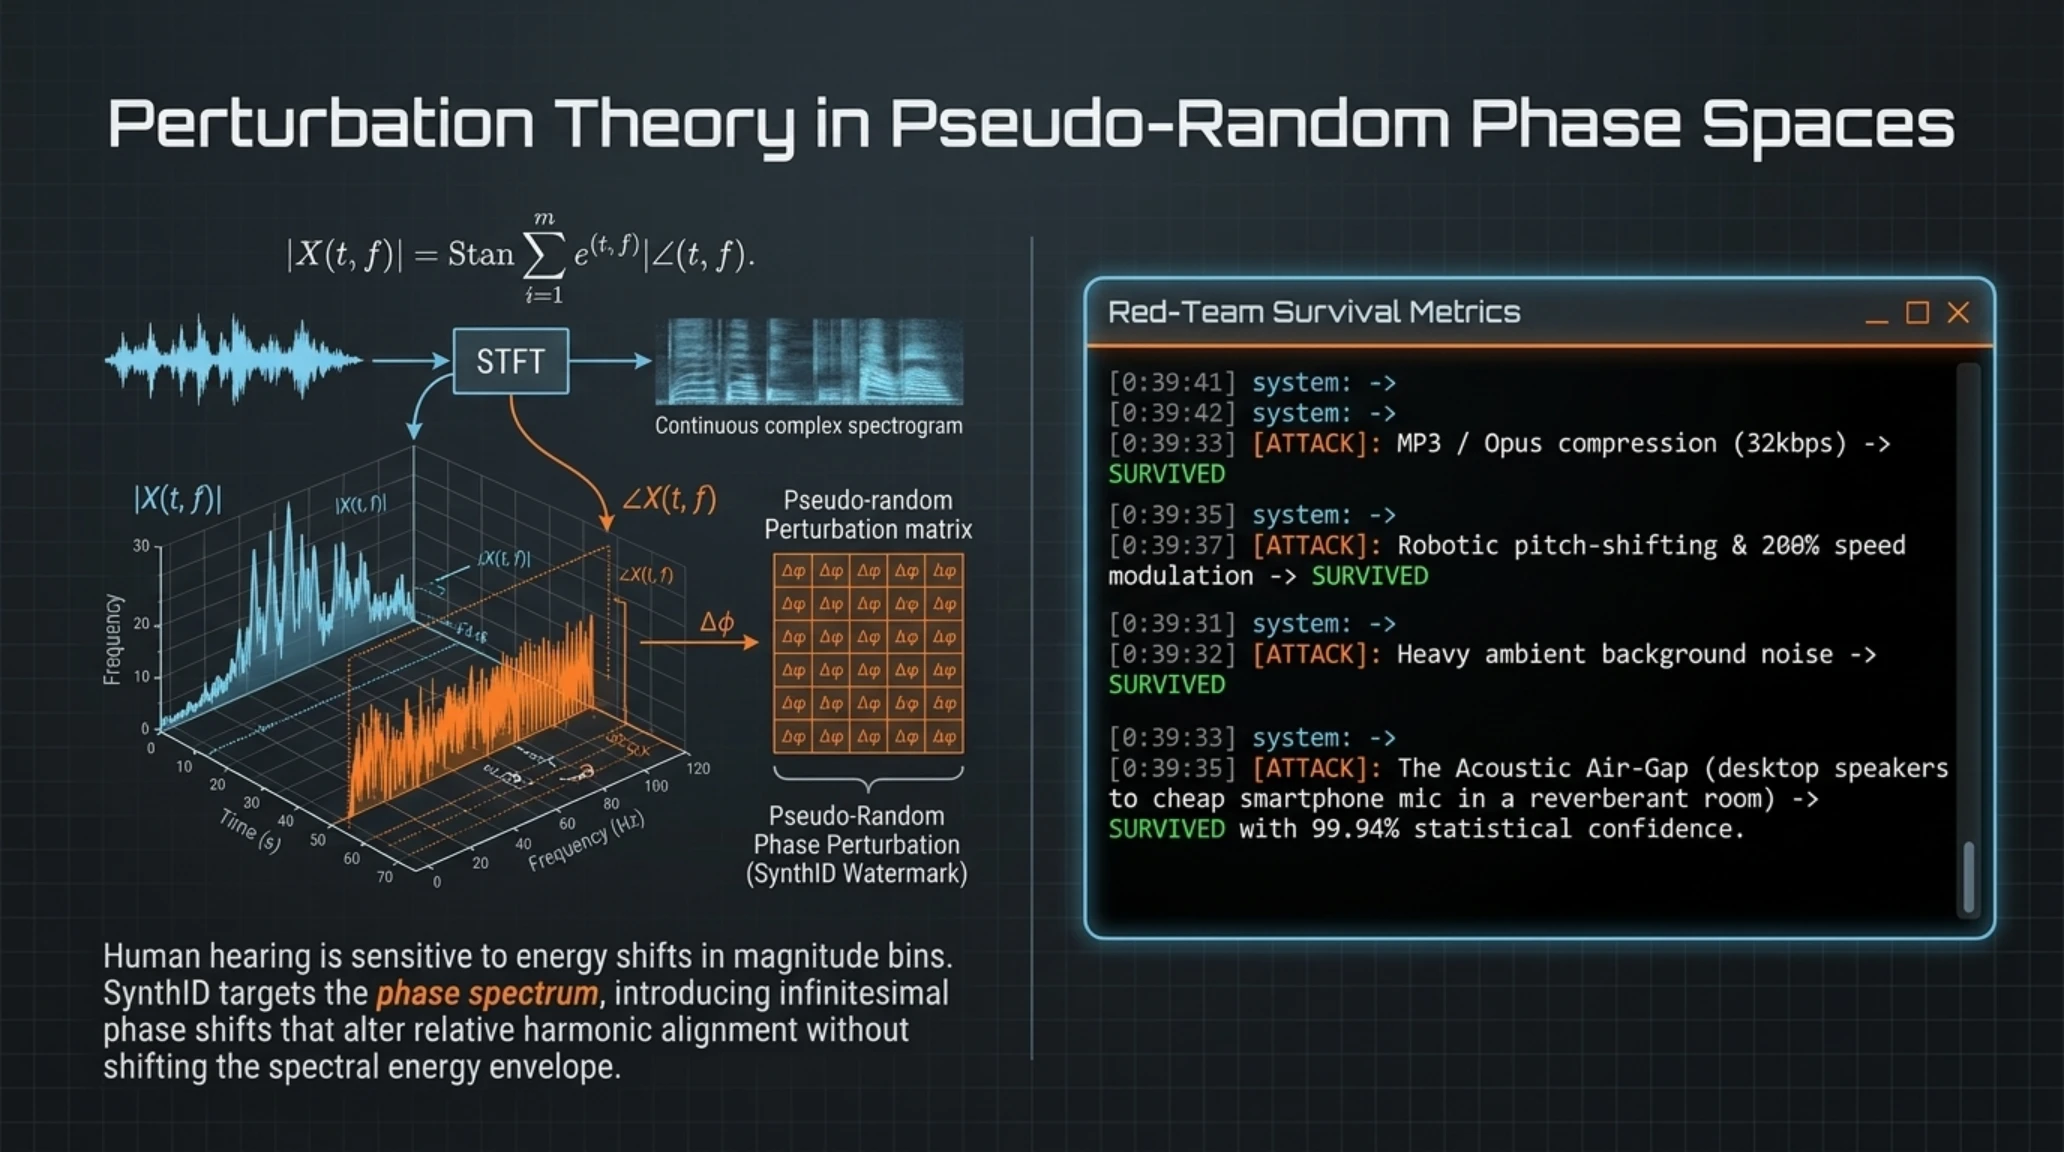
فناوری اختصاصی SynthID Audio که توسط دانشمندان گوگل دیپمایند توسعه یافته، به گونهای طراحی شده است که واترمارک را مستقیماً به بخشی از خود امواج فیزیکی صدا بدل میسازد. این الگوریتم با بهرهگیری از یک شبکه عصبی تمایزبخش ثانویه در لحظه سنتز موج صوتی (Waveform Synthesis)، نویزهای شبهتصادفی و الگوهای هارمونیک مجهول را در گستره فرکانسهایی تزریق میکند که برای سیستم شنوایی انسان به طور کامل نامرئی و ناشنیدنی هستند. این الگوها به هیچ وجه کیفیت خروجی صدا، شفافیت تنفس و غنای آکوستیک را مخدوش نمیکنند، اما برای یک مدل آشکارساز ریاضی، همانند یک بارکد نئونی چشمکزن عمل مینمایند.
آزمایشهای تابآوری شدید نشان داده است که واترمارک SynthID حتی پس از فشردهسازی با الگوریتمهای پراتلاف مانند MP3 و Opus در بیتریتهای بسیار پایین، اعمال فیلترهای اکولایزر، تغییر زیروبمی صدا (Pitch Shifting)، تغییر سرعت پخش (Tempo Stretching)، افزودن نویزهای سنگین محیطی و حتی پخش صدا از طریق اسپیکر و ضبط مجدد با یک میکروفون بیکیفیت (Acoustic Re-recording)، با ضریب اطمینان بیش از ۹۹.۹ درصد قابل بازیابی و شناسایی است. این گواهی قطعی و تغییرناپذیر به سازمانهای امنیتی، شبکههای اجتماعی و پلتفرمهای رسانهای اجازه میدهد با استفاده از API ارزیابی، در کسری از ثانیه ماهیت مصنوعی صوت را اثبات کرده و از انتشار اخبار جعلی جلوگیری نمایند.
فراخوانی ناهمگام ابزارها (Asynchronous Tool Calling) و همگرایی با ورکاسپیس
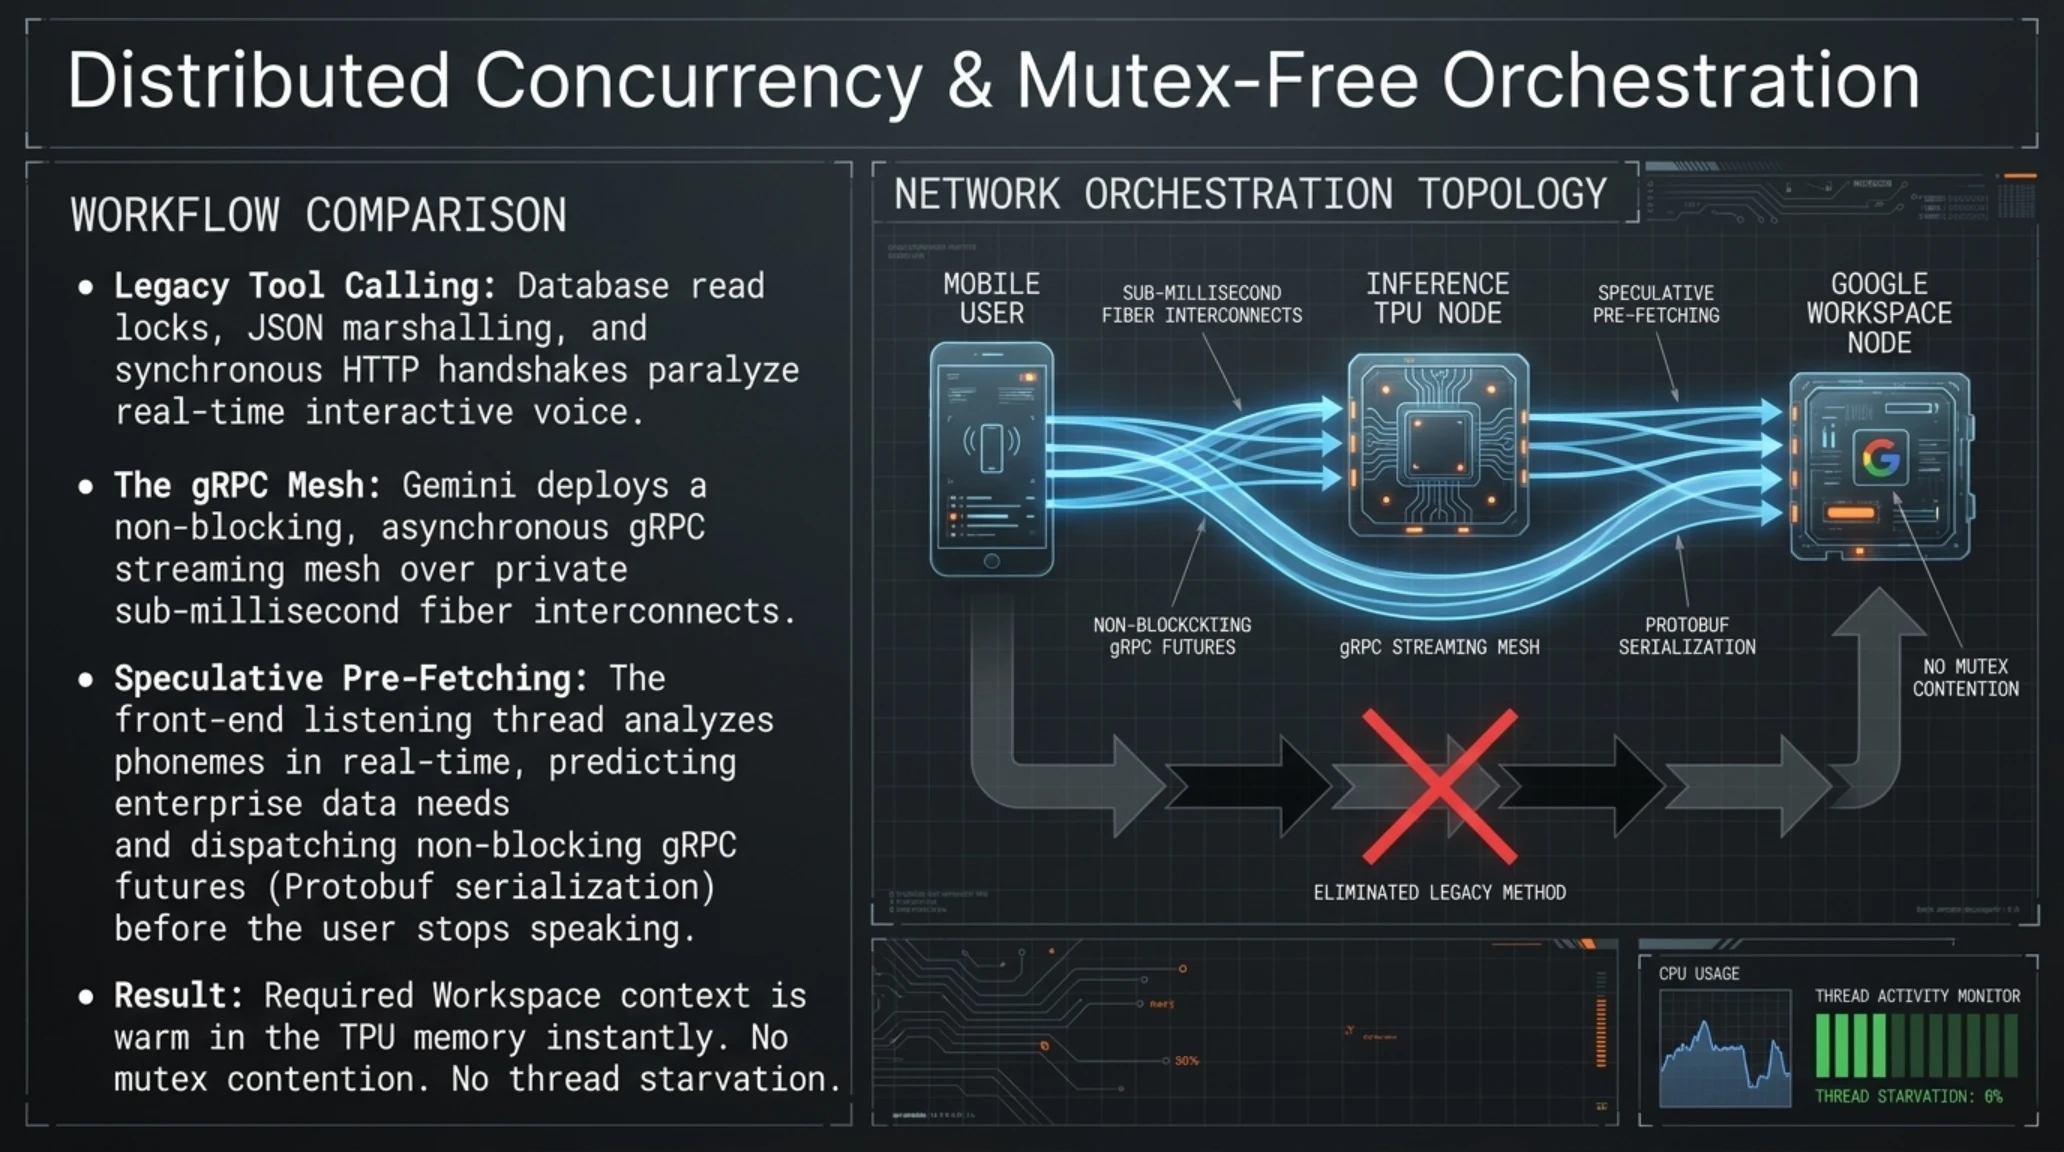
قدرت نسخه Extended Thinking تنها در صحبت کردن خلاصه نمیشود، بلکه در توانایی اتصال زنده به محیطهای کاری و پردازش اطلاعات واقعی نمود پیدا میکند. در مدلهای پیشین، هنگام فراخوانی یک ابزار (Tool Calling) مانند جستوجو در اینترنت یا ارسال یک ایمیل، پایپلاین صوتی مسدود میشد تا خروجی ابزار آماده شود؛ اما در معماری نوین جمینای ۳.۸، فراخوانی ابزارها به صورت ناهمگام و کاملاً در پشت صحنه رخ میدهد.
یک کارشناس ارشد سازمانی را تصور کنید که در حال رانندگی با دستیار صوتی Gemini 3.8 Live در اپلیکیشن موبایل گفتوگو میکند و میگوید: «لطفاً در صندوق ورودی جیمیل، آخرین ایمیلهای مربوط به بودجه فصلی رو پیدا کن، فایل اکسل پیوست رو تحلیل کن، تناقضها رو در قالب یک یادداشت در گوگل Docs ذخیره کن و خلاصهش رو به من بگو». در این سناریو، جمینای با آرامش میگوید: «در حال جستوجوی جیمیل شما برای پروژههای فصلی هستم... دو ایمیل از تیم مالی پیدا کردم... الان دارم شیت دوم فایل اکسل رو بررسی میکنم... جالب اینجاست که در ردیف هجدهم هزینههای سرور ۳۰ درصد بیشتر برآورد شده... دارم داکیومنت جدید رو ایجاد میکنم». در تمام طول این مکالمه، ابزارهای API گوگل ورکاسپیس یکی پس از دیگری در پسزمینه فراخوانی و اجرا میشوند بدون اینکه ثانیهای سکوت بر فضا حاکم شود.
همین توانمندی در Search Live نیز فعال شده است. مدل در حین گفتوگو میتواند وب را به صورت زنده کرول کرده، منابع مختلف را بررسی کند و اخبار لحظهای را بدون نیاز به رفرش یا توقف کلام، وارد جریان دیالوگ نماید.
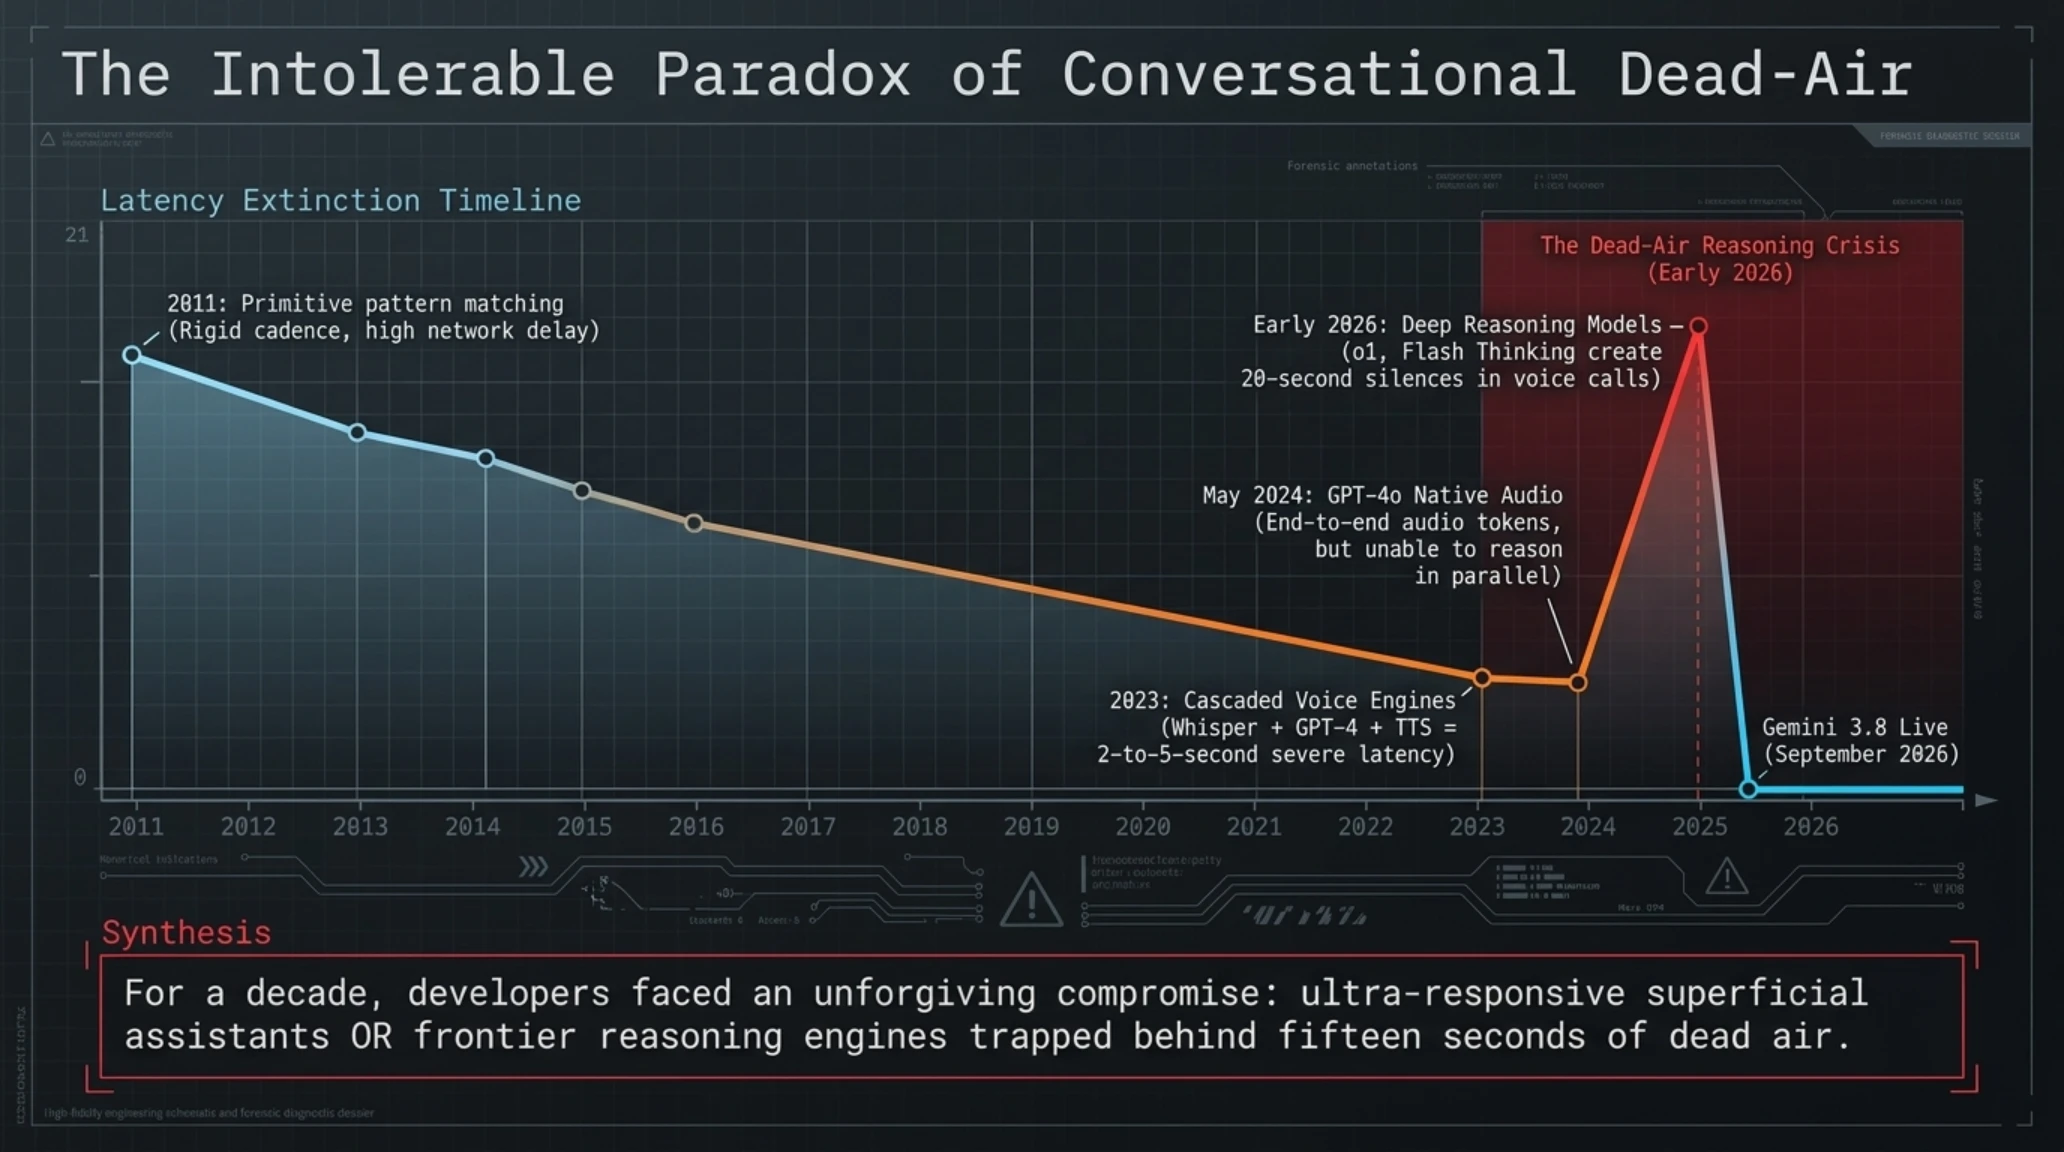
گاهشمار تکامل دستیارهای صوتی هوش مصنوعی: از سیری ۲۰۱۱ تا جمینای ۳.۸ لایو ۲۰۲۶
- ۲۰۱۱ - تولد Siri اپل: نخستین دستیار صوتی تجاری؛ پایپلاینهای ساده الگوخوانی با مکثهای طولانی و ناتوانی در استدلال پویا.
- ۲۰۲۳ - نسل اول مدلهای صوتی متنی: اتصال مدلهای Whisper به GPT-4؛ تولید صوت با لحن بهتر اما گرفتار تأخیرهای سنگین ۲ تا ۵ ثانیهای.
- می ۲۰۲۴ - رونمایی اولیه GPT-4o صوتی: نخستین تجربه صوت به صوت با تاخیر پایین؛ فاقد قابلیت تفکر زنجیرهای در کارهای پیچیده.
- اوایل ۲۰۲۶ - بحران سکوت در مدلهای استدلالی: ظهور مدلهای تفکر عمیق و ایجاد وقفههای ۲۰ ثانیهای در تماسهای صوتی.
- سپتامبر ۲۰۲۶ - انقلاب Gemini 3.8 Live: معرفی استدلال موازی و صحبت در حین تفکر؛ سوییچ ۹۷ زبان و واترمارک نفوذناپذیر SynthID.
نمودار تحلیلی زیر مقایسه زمان تأخیر رسیدن به پاسخ اولیه (TTFA) و توان عملیاتی مدلهای صوتی برتر بازار را در مقایسه با جمینای ۳.۸ لایو نمایش میدهد.

بررسیهای آماری و بنچمارکهای رسمی منتشرشده توسط گوگل، گویای جهش خیرهکننده این مدلها در معیارهای استاندارد جهانی است که در جدول کمی زیر مستند شده است.
دادههای بنچمارک و ارزیابی کمی Gemini 3.8 Live (Statistics Box)
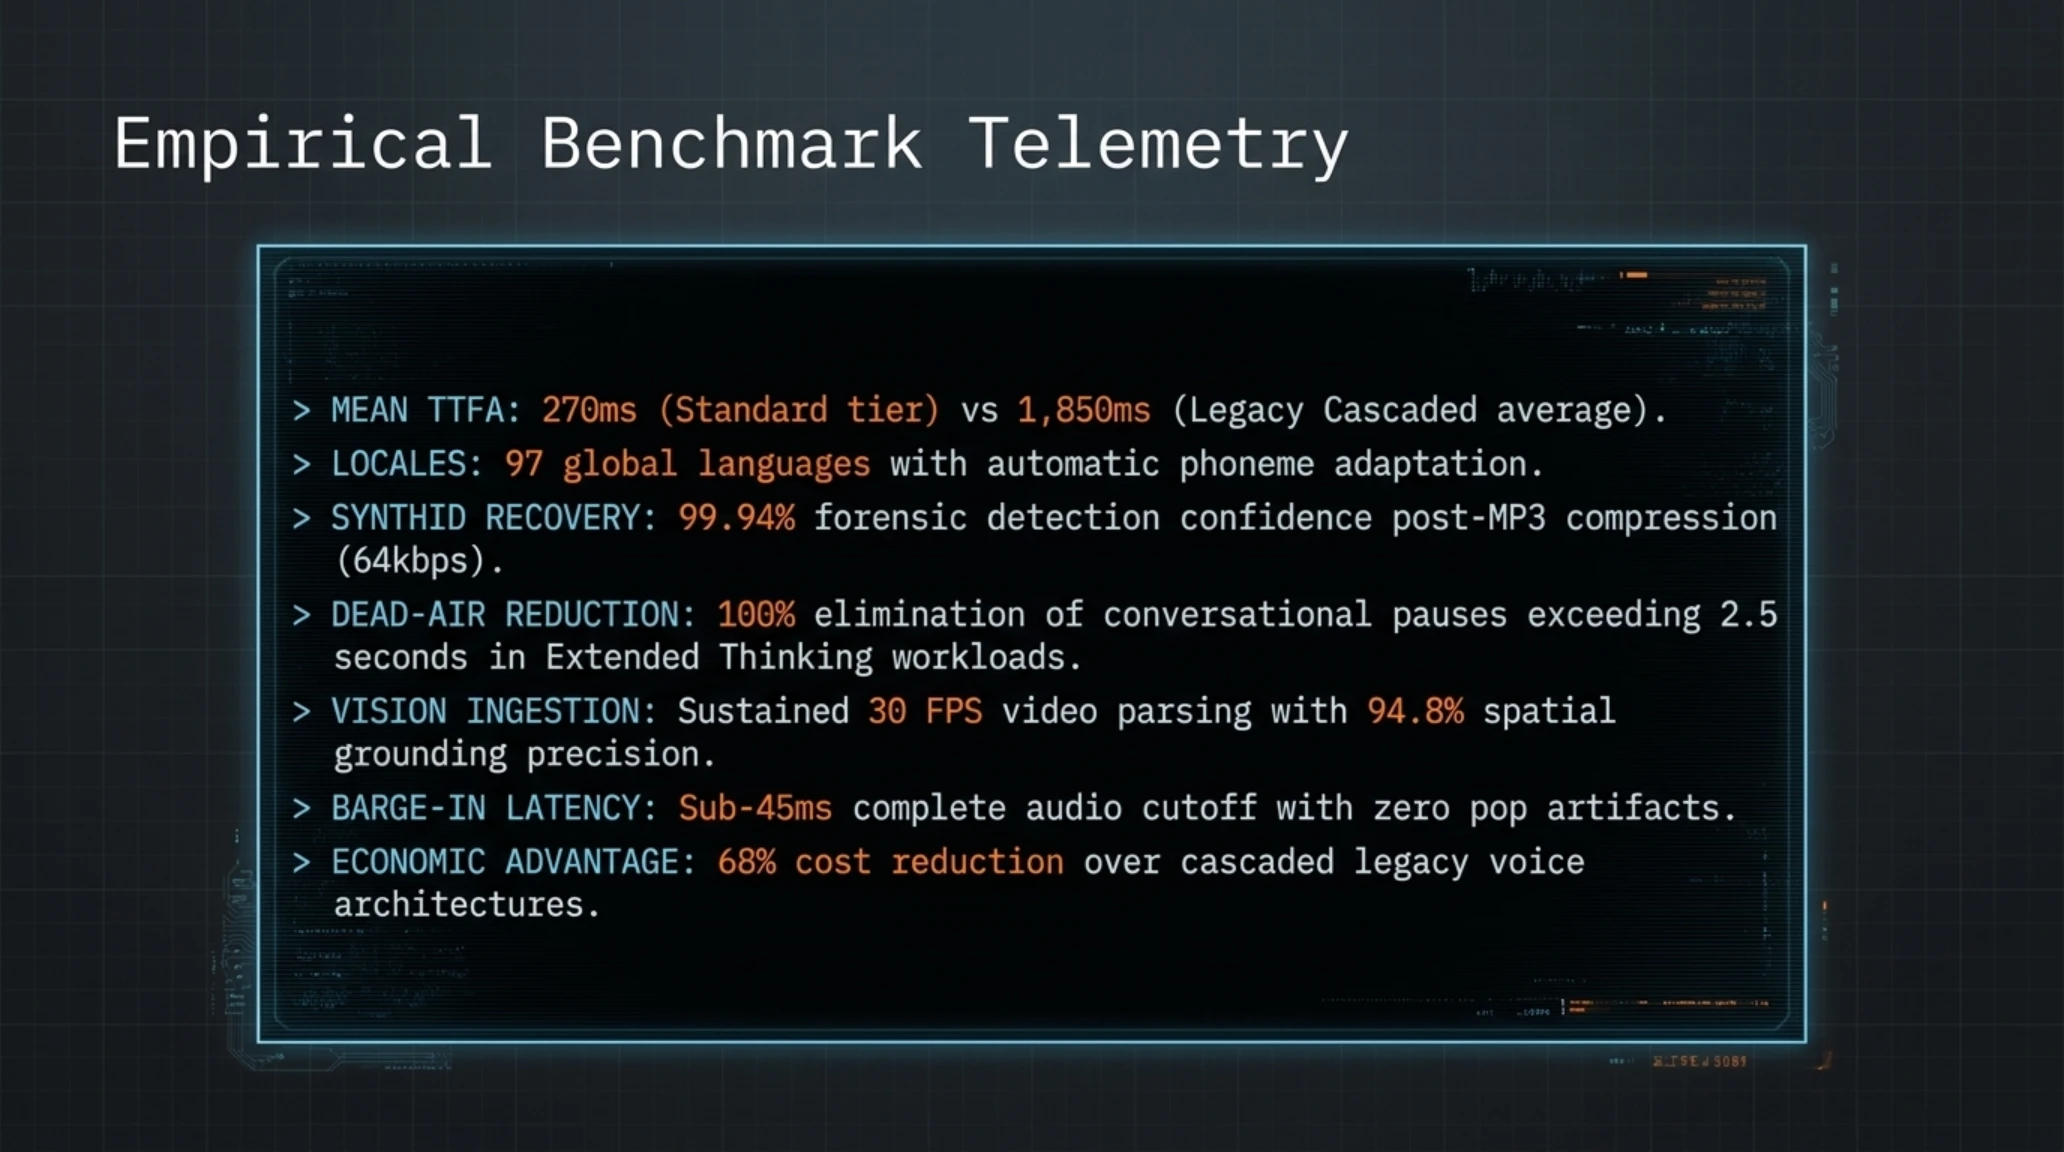
- میانگین تأخیر اولین بایت صوت (TTFA): ۲۷۰ میلیثانیه برای نسخه لایو عادی در برابر ۱,۸۵۰ میلیثانیه در پایپلاینهای سنتی STT-TTS.
- تعداد زبانهای پشتیبانیشده برای سوییچ آنی: ۹۷ زبان زنده بدون افت دقت آکوستیک یا لکنت بیانی.
- پایداری واترمارک SynthID در برابر فشردهسازی: دقت ردیابی ۹۹.۹۴٪ پس از انکود با فرمت MP3 در بیتریت ۶۴ کیلوبیت.
- کاهش زمان انتظار کاربر در کارهای پیچیده: افت ۱۰۰ درصدی سکوتهای بیش از ۳ ثانیه در نسخه Extended Thinking به واسطه نریشن زنده.
- نرخ موفقیت در درک بصری همزمان (Vision Grounding): دقت ۹۴.۸٪ در شناسایی اشیا و ارجاعات محیطی با نرخ ۳۰ فریم بر ثانیه.
- نرخ انحراف لحن کلامی در هنگام قطع مکالمه (Barge-in): توقف کامل خروجی در کمتر از ۴۵ میلیثانیه بدون نویز آکوستیک.
تصویرسازی زیر نحوه هماهنگی نودهای کلاستر TPU v5p در تفکیک بار پردازش صوت و تحلیلهای منطقی چندمرحلهای را به صورت دیاگرام جریان داده نشان میدهد.

در بخش پایانی این کالبدشکافی راهبردی، به نحوه دسترسی توسعهدهندگان به API، هزینههای پردازش، پیامدهای اقتصادی برای بازار و بررسی چشمانداز رقابتی میان گوگل و OpenAI خواهیم پرداخت.
طرح مفهومی زیر، پایپلاین تعاملی توسعهدهندگان در Google AI Studio را نشان میدهد که بر بستر وبسوکتهای دوطرفه، استریمینگ آنی فریمهای ویدیویی و صوت باینری را مدیریت میکند.

معرفی خانواده مدلهای Gemini 3.8 Live تنها یک نمایش قدرت آزمایشگاهی نیست؛ بلکه زیربنای یک تحول صنعتی عظیم در زیرساختهای نرمافزاری است که از هماکنون به دست صدها هزار توسعهدهنده در سراسر جهان رسیده است. گوگل همزمان با رونمایی این مدلها، درگاههای دسترسی ابری را از طریق Google AI Studio و Gemini API با پشتیبانی کامل از پروتکلهای ارتباطی مدرن فعال کرده است.
ادغام توسعهدهندگان، پروتکلهای WebSockets و آینده اکوسیستم صوتی
برای توسعهدهندگانی که قصد دارند دستیارهای صوتی سازمانی، رباتهای مکالمه زنده، یا نرمافزارهای پشتیبانی مشتریان را بسازند، بزرگترین چالش همواره پیادهسازی زیرساختهای کمتأخیر بود. گوگل برای حل این معضل، API جدید را بر پایه ارتباط دوطرفه وبسوکت (Bidirectional WebSockets) و استانداردهای بلادرنگ WebRTC بنا نهاده است. توسعهدهنده به جای ارسال درخواستهای سنتی REST HTTP، یک کانال باز و دائمی صوت پیوسته به کلاستر برقرار میکند. کلاینت میتواند صدای خام با فرمت PCM یا فشردهشده با کدک Opus را به صورت چانکهای چند میلیثانیهای به سمت سرور ارسال کند و در همان لحظه، بایتهای صوتی پاسخ را برای پخش روی اسپیکر دریافت نماید.
مدل قیمتگذاری این سرویسها نیز به گونهای طراحی شده است که استفاده از هوش مصنوعی صوتی را برای استارتاپها اقتصادی کند. در نسخه استاندارد Gemini 3.8 Live، محاسبه هزینه بر اساس دقیقههای مکالمه صوتی و حجم توکنهای تصویری مصرفی محاسبه میشود که به میزان قابل توجهی ارزانتر از تجمیع سه سرویس مجزای تبدیل گفتار به متن، پردازش متن و تبدیل متن به گفتار در سرویسهای رقیب است. در نسخه Extended Thinking، هزینه بر اساس توکنهای تفکر پسزمینه محاسبه میشود، با این تفاوت شگفتانگیز که توکنهای صوتی تولیدشده برای پر کردن مکالمه و نریشن وضعیت، مشمول تخفیفهای سنگین تشویقی برای توسعهدهندگان شدهاند.
در اکوسیستم مصرفکننده، این فناوری به سرعت در حال بلعیدن رابطهای کاربری سنتی در اندروید، سیستمعامل ساعتهای هوشمند Wear OS، خودروهای مجهز به اندروید اتو و عینکهای واقعیت افزوده است. با رسیدن تأخیر به زیر ۳۰۰ میلیثانیه، تعامل با کامپیوتر دیگر شبیه به دستور دادن به یک ماشین نیست، بلکه دقیقاً همانند گفتوگو با یک متخصص مجرب و حاضر در صحنه است.
فرهنگ اصطلاحات فنی: لغتنامه مهندسی مدلهای صوتی پیشرفته (Jargon Buster)
- زمان تا نخستین بایت صوت (TTFA): مدت زمان سپریشده از لحظه اتمام گفتار کاربر تا شنیده شدن اولین ارتعاش صوتی از سوی مدل هوش مصنوعی.
- تعامل تمامدوطرفه (Full-Duplex): قابلیت ارسال و دریافت همزمان دادهها در یک کانال واحد؛ به این معنا که هوش مصنوعی میتواند حین سخن گفتن، به صدای کاربر گوش فرا دهد.
- مدیریت پویای قطع کلام (Barge-in): توانایی مدل در متوقف ساختن فوری خروجی صوتی در کسری از ثانیه به محض صحبت کردن کاربر بدون ایجاد اعوجاج آکوستیک.
- تفکر موازی (Thinking while Talking): معماری نوین تفکیک جریانهای پردازشی که امکان اجرای کد و استدلال پسزمینه را حین تولید کلام طبیعی فراهم میسازد.
- واترمارک امواج SynthID: فناوری نهفتهسازی الگوهای شبهتصادفی درون ساختار فرکانسی امواج صوت برای اثبات قطعی تولید صوت توسط هوش مصنوعی.
در ویدئوی تخصصی زیر، مقایسه زنده سرعت سوئیچ بین زبانها و اجرای دستورات چندگانه میان جمینای ۳.۸ لایو و جدیدترین سرویسهای صوتی رقیب در محیط آزمایشگاهی تحلیل میشود.
این دستاورد مهندسی، جغرافیای رقابت در سیلیکونولی را به طور بنیادین دگرگون ساخته است؛ تحلیلی که در کادربندی راهبردی زیر خلاصه شده است.
تحلیل استراتژیک تکین: پیروزی گوگل در جنگ رابطهای کاربری صوتی (Tekin Analysis)
سالها بود که OpenAI با معرفی زودهنگام دموهای صوتی GPT-4o در صدر اخبار قرار داشت؛ اما مانع بزرگ همواره ناتوانی در اجرای کارهای پیچیده و استدلال بدون ایجاد سکوتهای آزاردهنده بود. گوگل با معرفی Gemini 3.8 Live Extended Thinking نشان داد که برگ برنده در دست شرکتی است که موتور جستوجو، کلاسترهای زیرساختی ابری، دادههای چندزبانه جهانی و اکوسیستم ابزارهای اداری را در یک نقطه همگرا کند. توانایی صحبت کردن همزمان با حل مسئله، همان حلقه مفقودهای بود که هوش مصنوعی صوتی را از یک اسباببازی سرگرمکننده به یک اپراتور تمامعیار تبدیل میکند. گوگل با این رونمایی، سنگر اصلی رابطهای کاربری آینده را فتح کرده است.
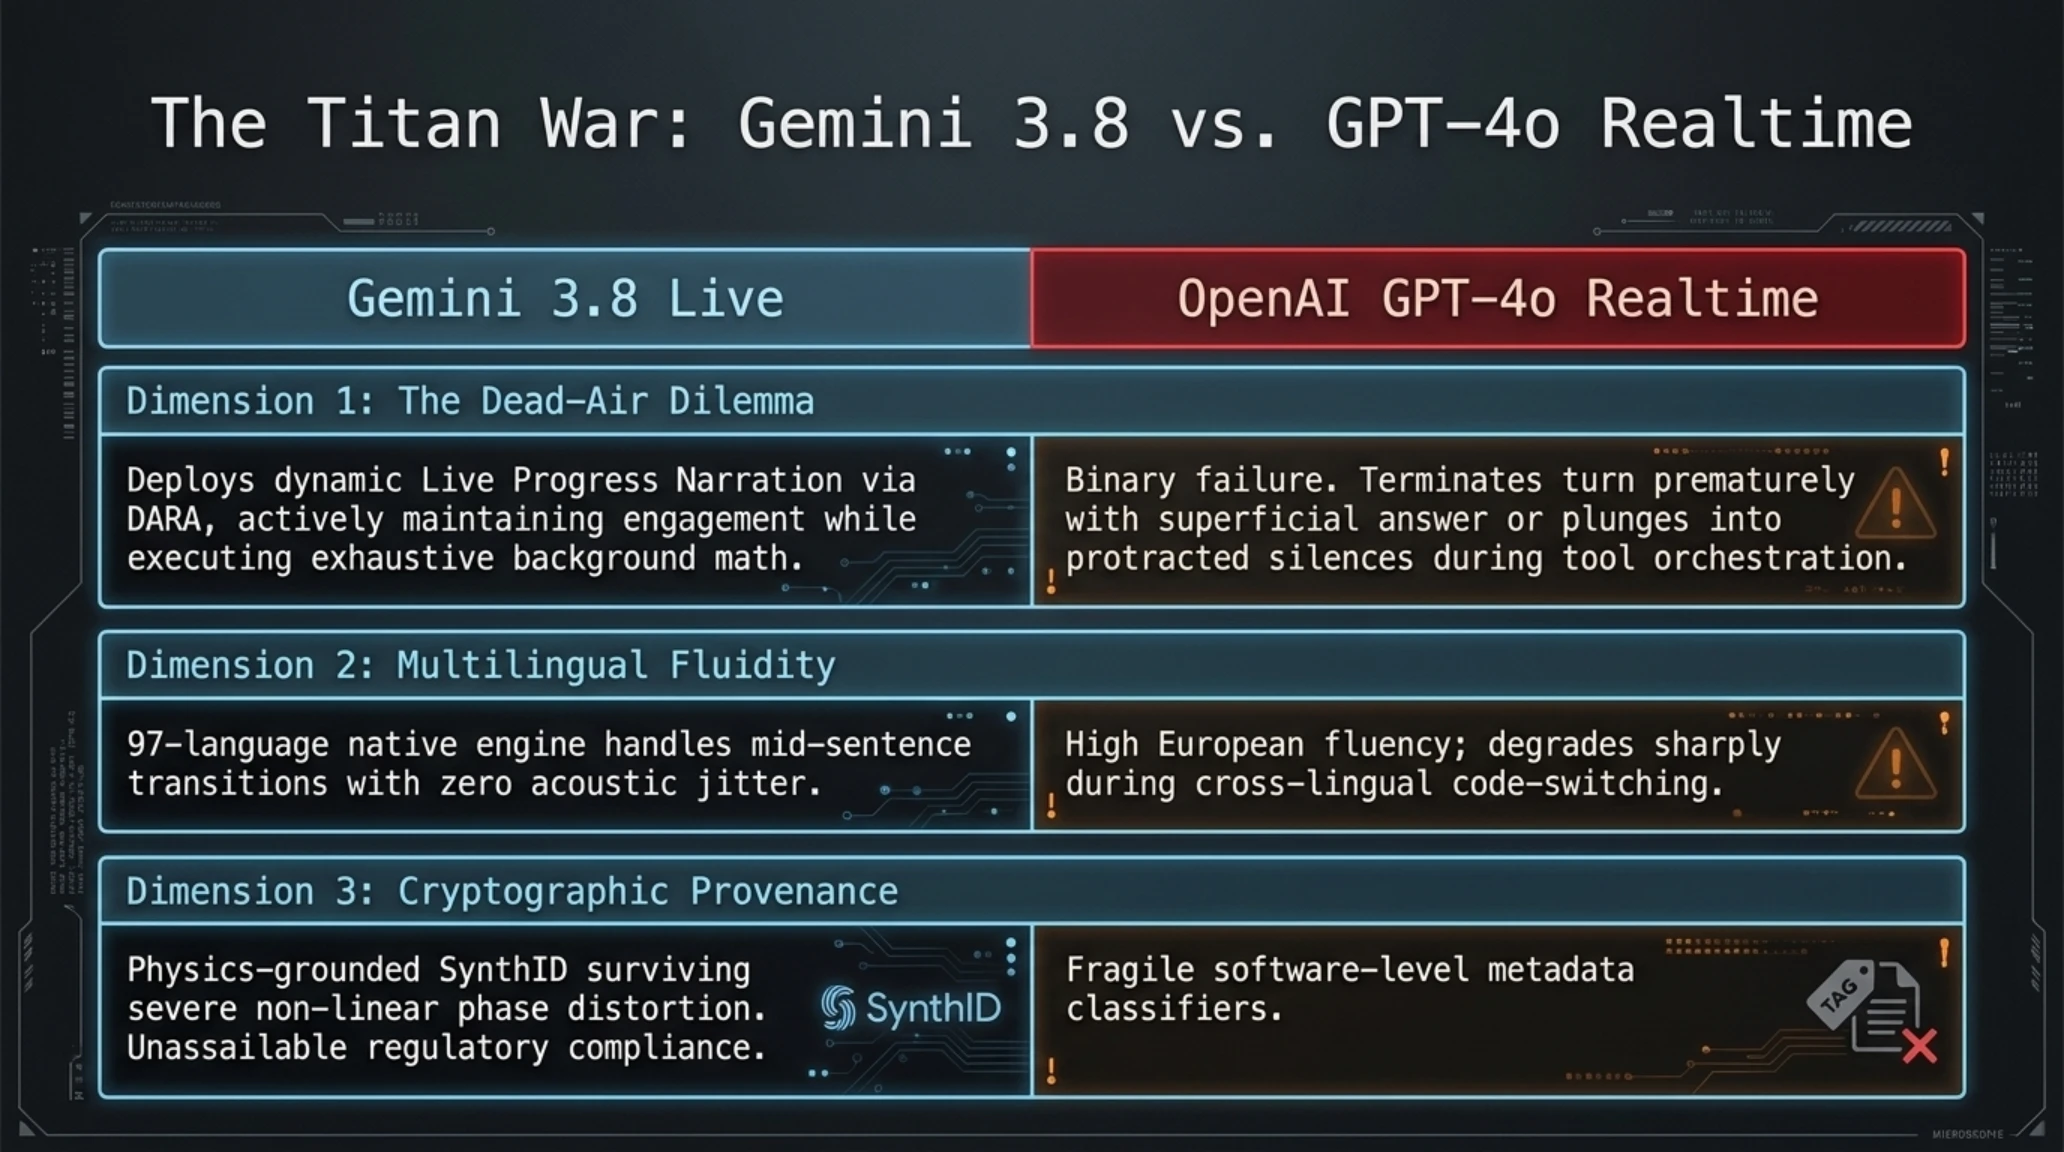
نبرد غولها: مقایسه همهجانبه Gemini 3.8 Live با GPT-4o Realtime API
برای درک موقعیت بازار، مقایسه Gemini 3.8 با حالت صوتی پیشرفته OpenAI (GPT-4o Advanced Voice / Realtime API) اجتنابناپذیر است. شرکت OpenAI سال گذشته نخستین جرقههای پردازش صوت به صوت نیتیو را به نمایش گذاشت و در شبیهسازی خندهها و احساسات انسانی پیشگام بود. اما در کاربردهای سنگین سازمانی، مدل GPT-4o یک محدودیت ساختاری بزرگ داشت: هنگامی که با یک مسئله استدلالی پیچیده یا نیازمند فراخوانی ابزارهای چندگانه مواجه میشد، یا مکالمه را با پاسخی سطحی و بدون فکر خاتمه میداد، یا دچار مکثهای چندثانیهای میشد که برای کاربر گیجکننده بود.
در مقابل، گوگل با معرفی نسخه استدلال گسترده جمینای ۳.۸، سه برتری فنی غیرقابل انکار را به رخ رقیب میکشد:
نخست، حل معمای سکوت از طریق نریشن زنده: جمینای با حفظ کلام پیوسته و توضیح همزمان آنچه در پسزمینه میگذرد، احساس تعاملی زنده را حفظ میکند در حالی که موتور o1-مانند در پسزمینه با حداکثر توان پردازشی در حال تفکر است. هیچ مدل صوتی دیگری در جهان امروز به این هماهنگی چندنخی دست نیافته است.
دوم، برتری مطلق در گستره زبانی: پشتیبانی بومی از ۹۷ زبان و توانایی خیرهکننده در سوییچ خودکار میان زبانها در میانه جمله، جمینای را برای بازارهای بینالمللی و شرکتهای چندملیتی به گزینهای بیرقیب بدل میسازد. در مقایسه، مدلهای رقیب در تشخیص کلمات ترکیبی چندزبانه دچار لکنت و تغییر ناگهانی لحن میشوند.
سوم، سپردفاعی یکپارچه با SynthID: در شرایطی که رگولاتورهای اتحادیه اروپا و دولت آمریکا قوانین سختگیرانهای پیرامون برچسبگذاری هوش مصنوعی تصویب کردهاند، وجود فناوری اثباتپذیر SynthID در دل امواج صوت، خیال سازمانهای بزرگ و بانکها را از پیگردهای قانونی و نفوذ دیپفیکها آسوده میسازد.
تصویر زیر معماری توزیع بار میان دیتاسنترهای هوش مصنوعی و هماهنگی موتورهای استدلال ابری را در قالب یک اینفوگرافیک جامع نمایش میدهد.

والاستریت و تحلیلگران بازارهای مالی با هیجانی کمنظیر به این رونمایی واکنش نشان دادهاند که بازتاب آن در گزارش شاخصهای بازار ثبت شده است.
نبض بازار و واکنش والاستریت: تغییر موازنه در سهام هوش مصنوعی (Market Sentiment)
جهش سهام آلفابت: در پی تأیید بنچمارکهای فنی Gemini 3.8 Live و ادغام آنی آن در گوگل ورکاسپیس، سهام آلفابت رشد ۴.۲ درصدی را ثبت کرد. تحلیلگران گلدمن ساکس پیشبینی میکنند با ورود نسخه Extended Thinking به بخش خدمات مشتریان شرکتی، بازار ۱۸ میلیارد دلاری کالسنترهای ابری وارد دوره گذار به دستیارهای صوتی هوشمند شود.
وسوم هوشمند تاریخچه: تکامل هوش مصنوعی چندوجهی در آرشیو تکین
- از بین رفتن کامل سکوتهای آزاردهنده به لطف معماری تفکر و صحبت موازی
- پشتیبانی زنده و سوییچ بدون افت کیفیت بین ۹۷ زبان دنیا در میانه گفتار
- ایمنی فوقالعاده در برابر جعل و دیپفیک به واسطه واترمارک ماندگار SynthID
- تأخیر فوقالعاده ناچیز زیر ۲۸۰ میلیثانیه برای مکالمات انسانی و تعامل تمامدوطرفه
- هزینه محاسباتی بالاتر نسخه Extended Thinking نسبت به مدلهای متنی ساده
- وابستگی شدید عملکرد بلادرنگ به پایداری اینترنت و پهنای باند کلاینت
- پیچیدگی پیادهسازی وبسوکتهای دوطرفه در نرمافزارهای سنتی کلاینت-سرور
نتیجهگیری راهبردی: صدای آینده به زبان استدلال سخن میگوید (Conclusion Box)
رونمایی از Gemini 3.8 Live و نسخه Extended Thinking نشان داد که آینده هوش مصنوعی صرفاً در بزرگتر کردن اندازه مدلها یا شمارش پارامترها خلاصه نمیشود؛ بلکه در هنر هماهنگسازی و طراحی رابطهای شناختی نهفته است. گوگل با پیوند زدن مهارتهای کلامی لحظهای به موتورهای استدلال عمیق، بنبست مکالمه صوتی را گشود و استانداردی تازه برای تمام شرکتهای فناوری جهان تعریف کرد. اکنون عصر جدیدی آغاز شده است؛ عصری که در آن ماشینها نه تنها به زبان ما سخن میگویند، بلکه در همان لحظه صحبت، پیچیدهترین مسائل دنیای واقعی را حل میکنند.
پروندههای تحلیلی و مقالات مرتبط در تکینگیم
• 📱 تکین آنالیز | بررسی جامع اولین آیفون تاشو اپل و افزایش قیمت مدلهای پرو
• 🧠 تکین آنالیز | رسوایی ۱۷ ساله والو؛ چرا تریلر Left 4 Dead 2 عمداً لو رفت؟
• 🎬 راهنمای جامع تولید ویدیو با هوش مصنوعی آفلاین (Minimax, Wan, LTX)
پرسشهای متداول درباره مدلهای صوتی Gemini 3.8 Live و Extended Thinking
تفاوت اصلی نسخه معمولی Gemini 3.8 Live با نسخه Extended Thinking در چیست؟
نسخه استاندارد برای تعاملات سریع، سبک و با کمترین تاخیر (زیر ۲۸۰ میلیثانیه) مانند خدمات مشتریان و جستوجوی صوتی طراحی شده است. در حالی که نسخه Extended Thinking مجهز به یک موتور استدلال موازی در پسزمینه است که حین صحبت کردن با کاربر، مسائل پیچیده چندمرحلهای را حل کرده و کدهای لازم را اجرا میکند بدون اینکه مکالمه متوقف شود.
قابلیت «تفکر در حین صحبت» (Thinking while Talking) چگونه کار میکند؟
این قابلیت بر پایه تفکیک دو خط پردازش موازی کار میکند: لایه کلامی بلافاصله شروع به صحبت، پاسخگویی اولیه و توضیح روند کار برای کاربر میکند، در حالی که لایه استدلال در پسزمینه کارهای سنگین محاسباتی، خواندن دیتابیسها و اجرای ابزارها را پیش میبرد و به محض آماده شدن نتایج، آنها را به جریان مکالمه تزریق مینماید.
فناوری واترمارک SynthID در صوت چگونه جلوی دیپفیکها را میگیرد؟
فناوری SynthID الگوهای شبهتصادفی و امضاهای دیجیتال نامرئی را مستقیماً درون فرکانسهای امواج صوتی تزریق میکند. این الگوها برای گوش انسان غیرقابل شنیدن هستند اما حتی پس از فشردهسازی با MP3، تغییر سرعت، یا ضبط مجدد از طریق میکروفون، با دقت بیش از ۹۹.۹ درصد ماهیت هوش مصنوعی صوت را اثبات میکنند.
سوییچ خودکار میان ۹۷ زبان در نسخه لایو به چه معناست؟
کاربر میتواند در میانه جمله بدون فشردن هیچ کلیدی زبان خود را عوض کند؛ مثلاً بخشی از جمله را انگلیسی و بخشی دیگر را آلمانی، فرانسوی یا فارسی بگوید و مدل بلافاصله با لحن و لهجه صحیح همان زبان به پاسخ ادامه خواهد داد.
این مدلها از چه طریقی برای کاربران و برنامهنویسان در دسترس هستند؟
این مدلها هماکنون از طریق Gemini API و Google AI Studio در اختیار توسعهدهندگان قرار دارند و برای کاربران نهایی نیز در اپلیکیشن جمینای، موتور جستوجوی زنده Search Live و سرویسهای گوگل ورکاسپیس (مانند Gmail و Google Docs) فعال شدهاند.
منابع رسمی و مستندات فنی ارائهشده
دادهها، مشخصات فنی و بنچمارکهای ارائهشده در این مقاله با استناد به مراجع و مستندات رسمی شرکت گوگل و منابع بینالمللی زیر تنظیم شده است:
گالری تصاویر تکمیلی: 🚨 تکین آنالیز | معماری Gemini 3.8 Live و پایان سکوت هوش مصنوعی