کالبدشکافی جامع معماری Ada Lovelace: جهش بنیادین در رندرینگ بلادرنگ و هوش مصنوعی
کالبدشکافی جامع معماری سیلیکون AD102، هستههای رهگیری پرتو نسل سوم، شتابدهنده جریان نوری و بنچمارکهای 4K در مارس ۲۰۲۶.
- 🎮معماری سیلیکون- کالبدشکافی چیپ AD102 با ۷۶.۳ میلیارد ترانزیستور TSMC 4N
- 🎧هستههای RT نسل ۳- فناوری نوین Shader Execution Reordering (SER) و دو برابر شدن راندمان BVH
- 🚀شتابدهنده هوش مصنوعی- هستههای تانسوری نسل چهارم و شتابدهنده جریان نوری OFA در DLSS 3.5
- 🗡️راندمان انرژی و حرارت- منحنی ولتاژ/فرکانس و چالشهای مهندسی کانکتور برق 12VHPWR
- 📰بنچمارکهای گیمینگ- پایداری زمان فریم در Cyberpunk 2077 و پایش شاخصهای 1% Lows
- ⚔️اقتصاد و بازار- تحلیل ارزش خرید با دلار ۲۳۵ هزار تومانی و رقابت با AMD RDNA 3
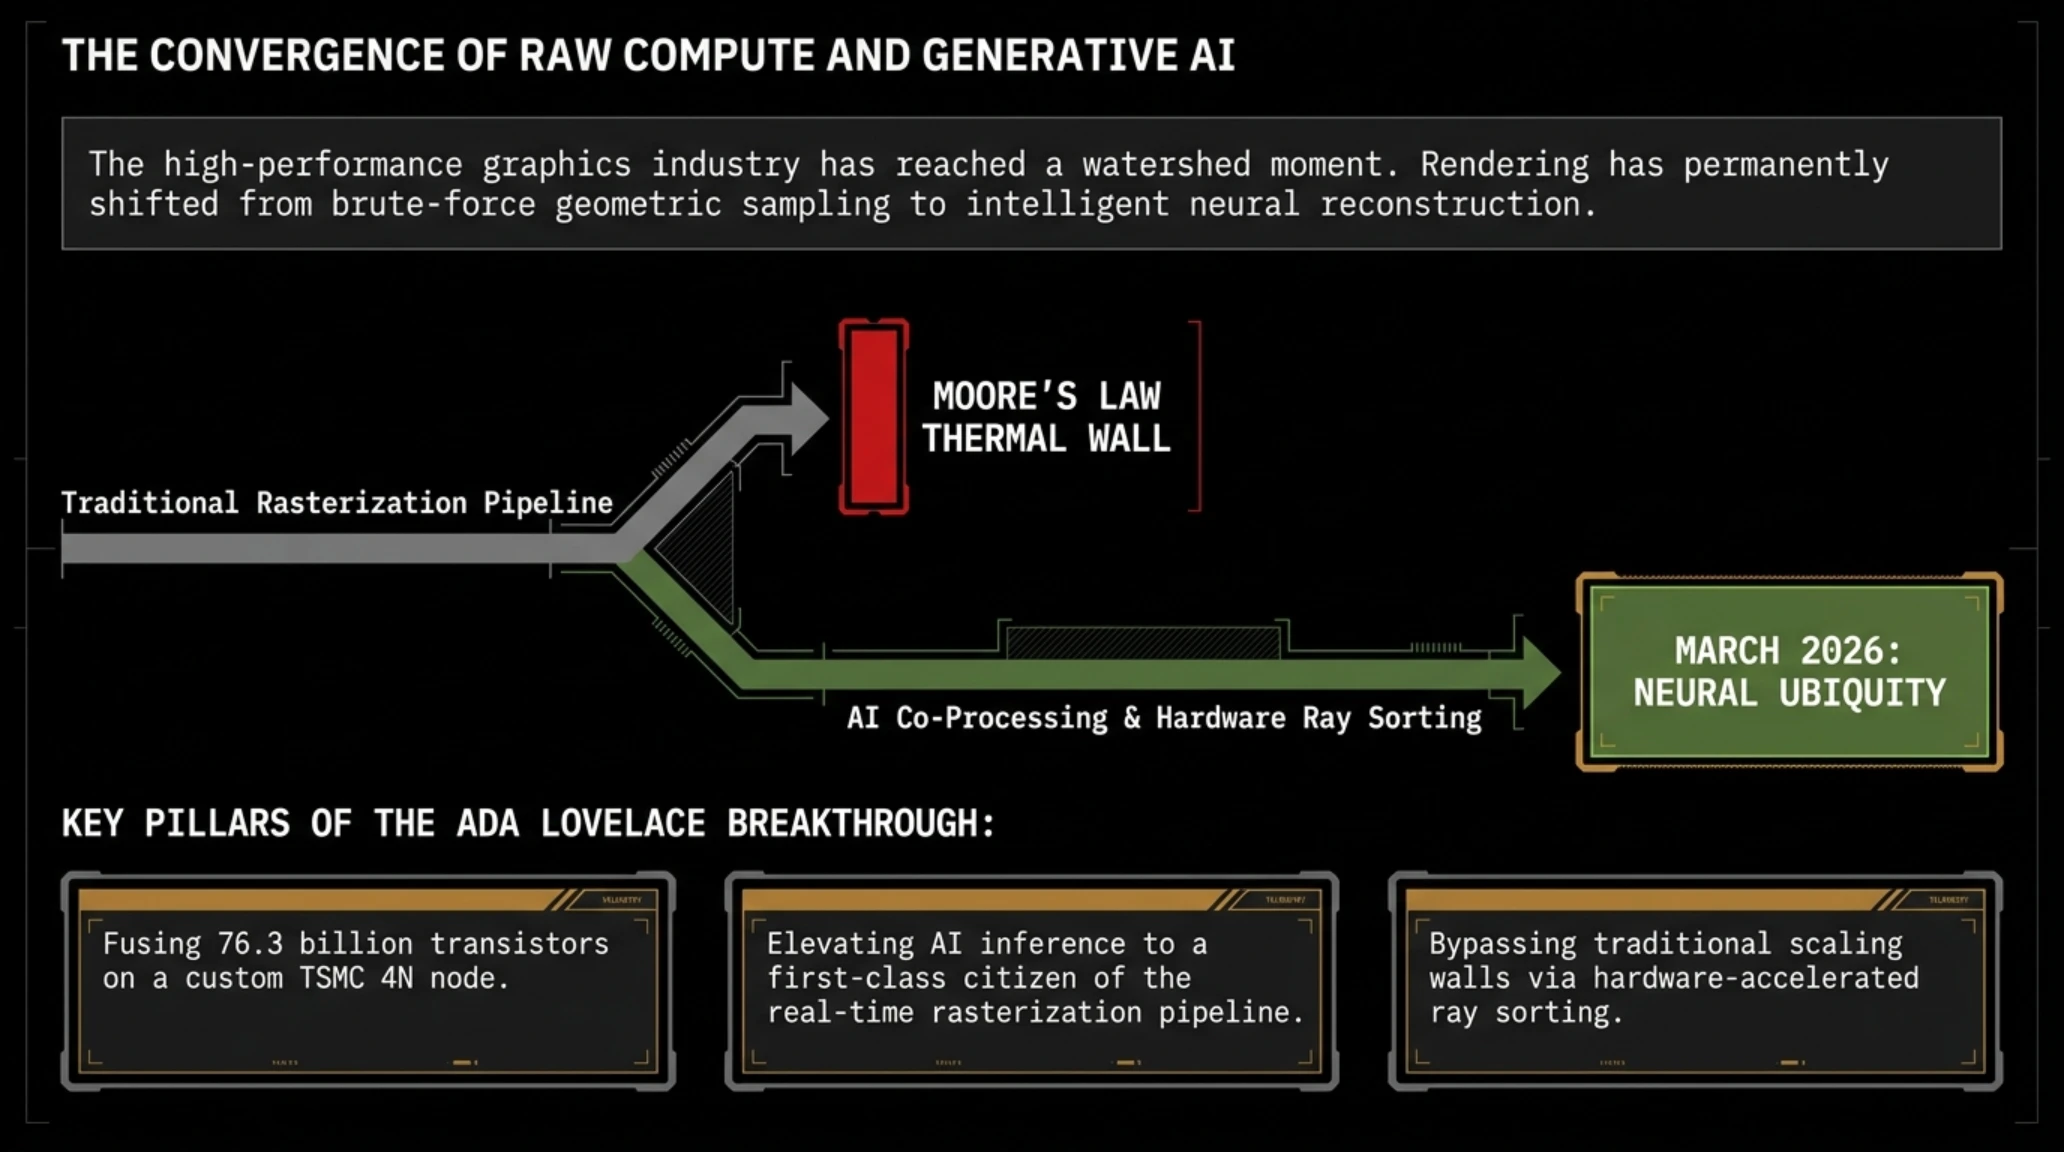
صنعت سختافزار پردازش گرافیکی در مارس ۲۰۲۶ به مرحلهای از بلوغ رسیده که تفکیک میان توان محاسباتی خام و هوش مصنوعی مولد دیگر امکانپذیر نیست.
نکات کلیدی و یافتههای راهبردی تحریریه
- جهش بیش از دو برابری توان پردازش رهگیری پرتو به لطف ادغام واحدهای سختافزاری SER و حذف گلوگاه واگرایی شیدر.
- شتابدهنده جریان نوری با توان ۳۰۰ ترافلاپس، امکان تولید فریم عصبی کاملاً مستقل از خط لوله رندر سنتی را فراهم کرده است.
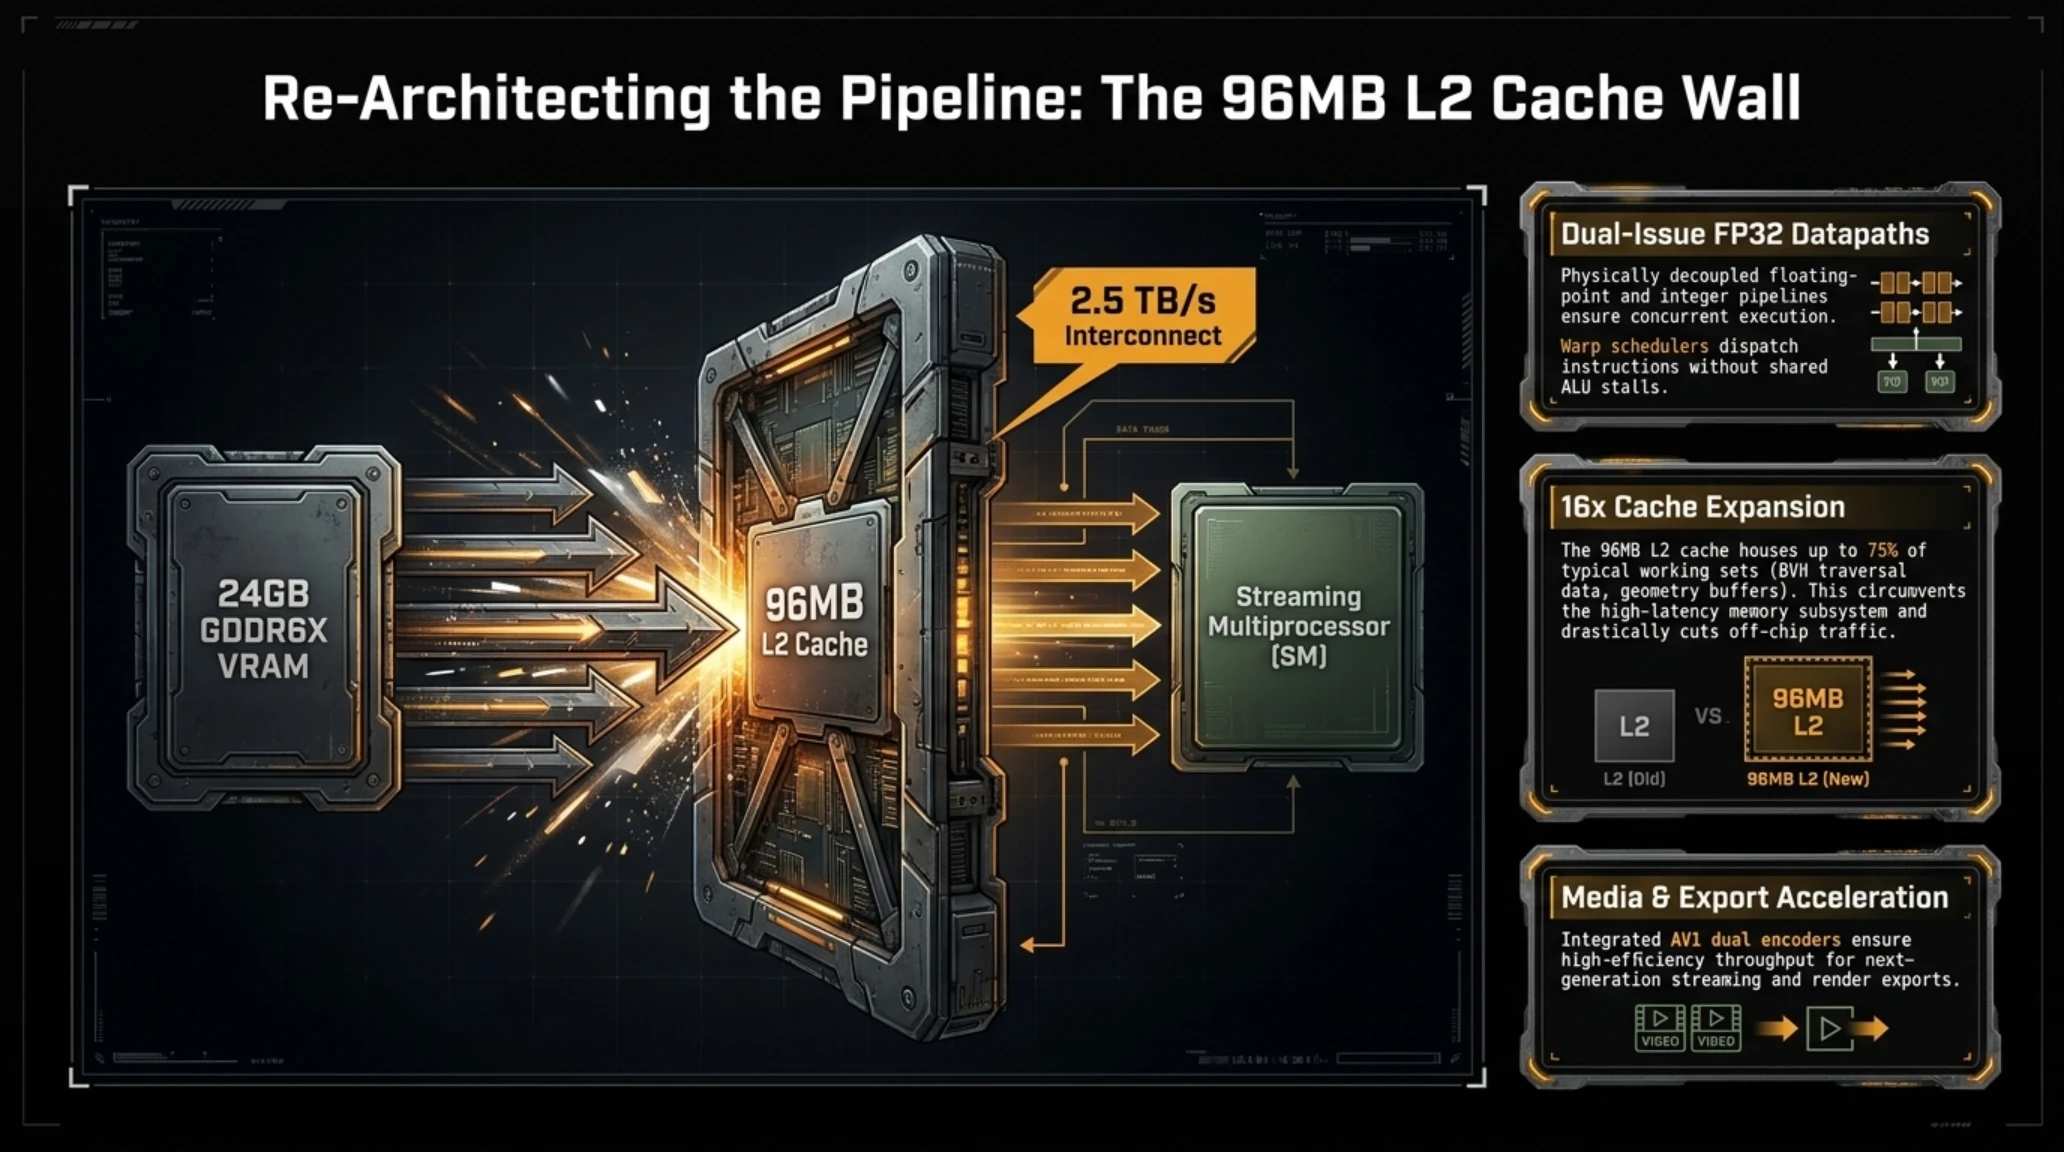
- افزایش ۱۶ برابری حجم حافظه کش سطح دوم (L2 Cache) تا مرز ۹۶ مگابایت، بار ترافیکی گذرگاه حافظه را به شدت کاهش داده است.
- بهرهگیری از نود سفارشی 4N شرکت TSMC منجر به بهبود دو برابری بازدهی مصرف انرژی نسبت به نسل آمپر شده است.
- فناوری NVIDIA Reflex با حذف صف بافر فریم، تاخیر افزوده ناشی از تولید فریم هوش مصنوعی را به زیر ۴۵ میلیثانیه کاهش میدهد.
- در بازار داخلی ایران با در نظر گرفتن نرخ ارز زنده، خرید این کارت نیازمند تحلیل عمیق نسبت توان به هزینه در کاربریهای حرفهای است.
طلوع عصر سیلیکونهای کوانتومی و مهندسی معکوس فیزیک مدرن در معماری Ada Lovelace
در اسفند ماه سال ۱۴۰۴ خورشیدی (مارس ۲۰۲۶)، صنعت پردازش گرافیکی از یکی از دراماتیکترین و شگرفترین گذارهای تاریخی خود عبور کرده است؛ نقطهی عطف بزرگی که مهندسی معکوس فیزیک سیلیکون را وارد ابعادی نوین ساخته و استانداردهای رندرینگ بلادرنگ را برای همیشه دگرگون کرده است. زمانی که به کالبدشکافی دقیق و زیرمیزی پرچمدار این نسل، یعنی پردازنده غولپیکر AD102 با آن لایوت پکیج پیچیده و خیرهکنندهاش نگاه میکنیم، در واقع به کلونی متراکمی از ۷۶.۳ میلیارد ترانزیستور خیره شدهایم که با استفاده از لیتوگرافی سفارشی و بهینهسازیشدهی TSMC 4N پیادهسازی شدهاند. این تراشه، با مساحتی نزدیک به ۶۰۹ میلیمتر مربع، نمایانگر اوج تسلط مهندسی بر چالشهای توزیع توان حرارتی (TDP) و چگالی جریان الکتریکی در ابعاد نانومتری است، بهطوری که هر میلیمتر مربع از این ویفر سیلیکونی، باری سنگین از پردازش موازی و تانسوری را به دوش میکشد که تا همین چند سال پیش در حوزه ابررایانهها دستنیافتنی به نظر میرسید.
از منظر تحلیل معماری سیستمهای گیمینگ، معماری Ada Lovelace صرفاً یک بهروزرسانی خطی یا افزایش ساده در تعداد واحدهای محاسباتی (ALU) نیست، بلکه بازتعریف بنیادین نحوهی تولید فریم و مدیریت بار کاری گرافیکی محسوب میشود. کارشناسان ارشد دیجیتال فاندری و تحلیلگران دیپمایند نیک میدانند که مهندسان انویدیا در این نسل توانستهاند با بازآرایی ساختار حافظه کَش سطح دوم (L2 Cache) به حجمی بیسابقه تا ۹۶ مگابایت در بالاترین مدل گلوگاههای سنتی پهنای باند حافظه را به طور کامل دور بزنند. این تحول بنیادین در مدیریت پشتههای حافظه، تأخیر دسترسی به دیتای رندرینگ را به شدت کاهش داده و امکان پردازش پدیدههای پیچیده فیزیکی مانند بازتابهای چندگانه و سایههای دقیق ریتِرِی سینگ (Ray Tracing) را بدون افت فریم فاحش در رزولوشنهای فوقالعاده بالا فراهم آورده است.
اگر بخواهیم این شاهکار مهندسی را از دیدگاه اقتصادی و بازار مصرفکننده داخلی در مارس ۲۰۲۶ تحلیل کنیم، ارزشگذاری سختافزاری این رده از پردازندهها در بازار ایران با نوسانات نرخ ارز، رقمی فراتر از بررسیهای صرفاً فنی را مطالبه میکند؛ جایی که قیمت کارتهای مبتنی بر این معماری در بازار آزاد گاه از مرز صدها میلیون تومان عبور کرده و آن را به کالایی سرمایهای برای استودیوهای انیمیشنسازی، رندرینگ هوش مصنوعی و گیمرهای حرفهای بدل ساخته است. با این حال، کارایی بر وات (Performance-per-Watt) فوقالعاده بهینهی این تراشهها نسبت به نسل پیشین (Ampere)، به دلیل معماری مدار منطقی کاملاً دگرگونشده و فرکانسهای کاری فراتر از ۲.۵ گیگاهرتز در حالت بوست، توجیه اقتصادی هر وات مصرف انرژی را برای پروژههای سنگین پردازشی به اثبات رسانده است.
در نهایت، نسل Ada Lovelace دروازهبان ورود صنعت بازی به عصر هوش مصنوعی مولد در گرافیک است. حضور نسل چهارم هستههای تانسور (Tensor Cores) با پشتیبانی از دستورالعملهای FP8 و بهکارگیری الگوریتمهای پیشرفتهی بهینهسازی فریم نظیر تکنولوژیهای مدرن DLSS، نشان میدهد که آیندهی رندرینگ دیگر صرفاً به توان خام رسترایزینگ وابسته نیست، بلکه این مدلهای یادگیری عمیق تعبیهشده در قلب سیلیکون هستند که وظیفه بازسازی پیکسلها را با کیفیتی فراتر از رندر بومی به دوش میکشند. این دستاورد، استانداردهای طراحی سختافزار را برای دههی پیش رو تعیین کرده و راه را برای تکامل بعدی سیستمهای گیمینگ هموار ساخته است.
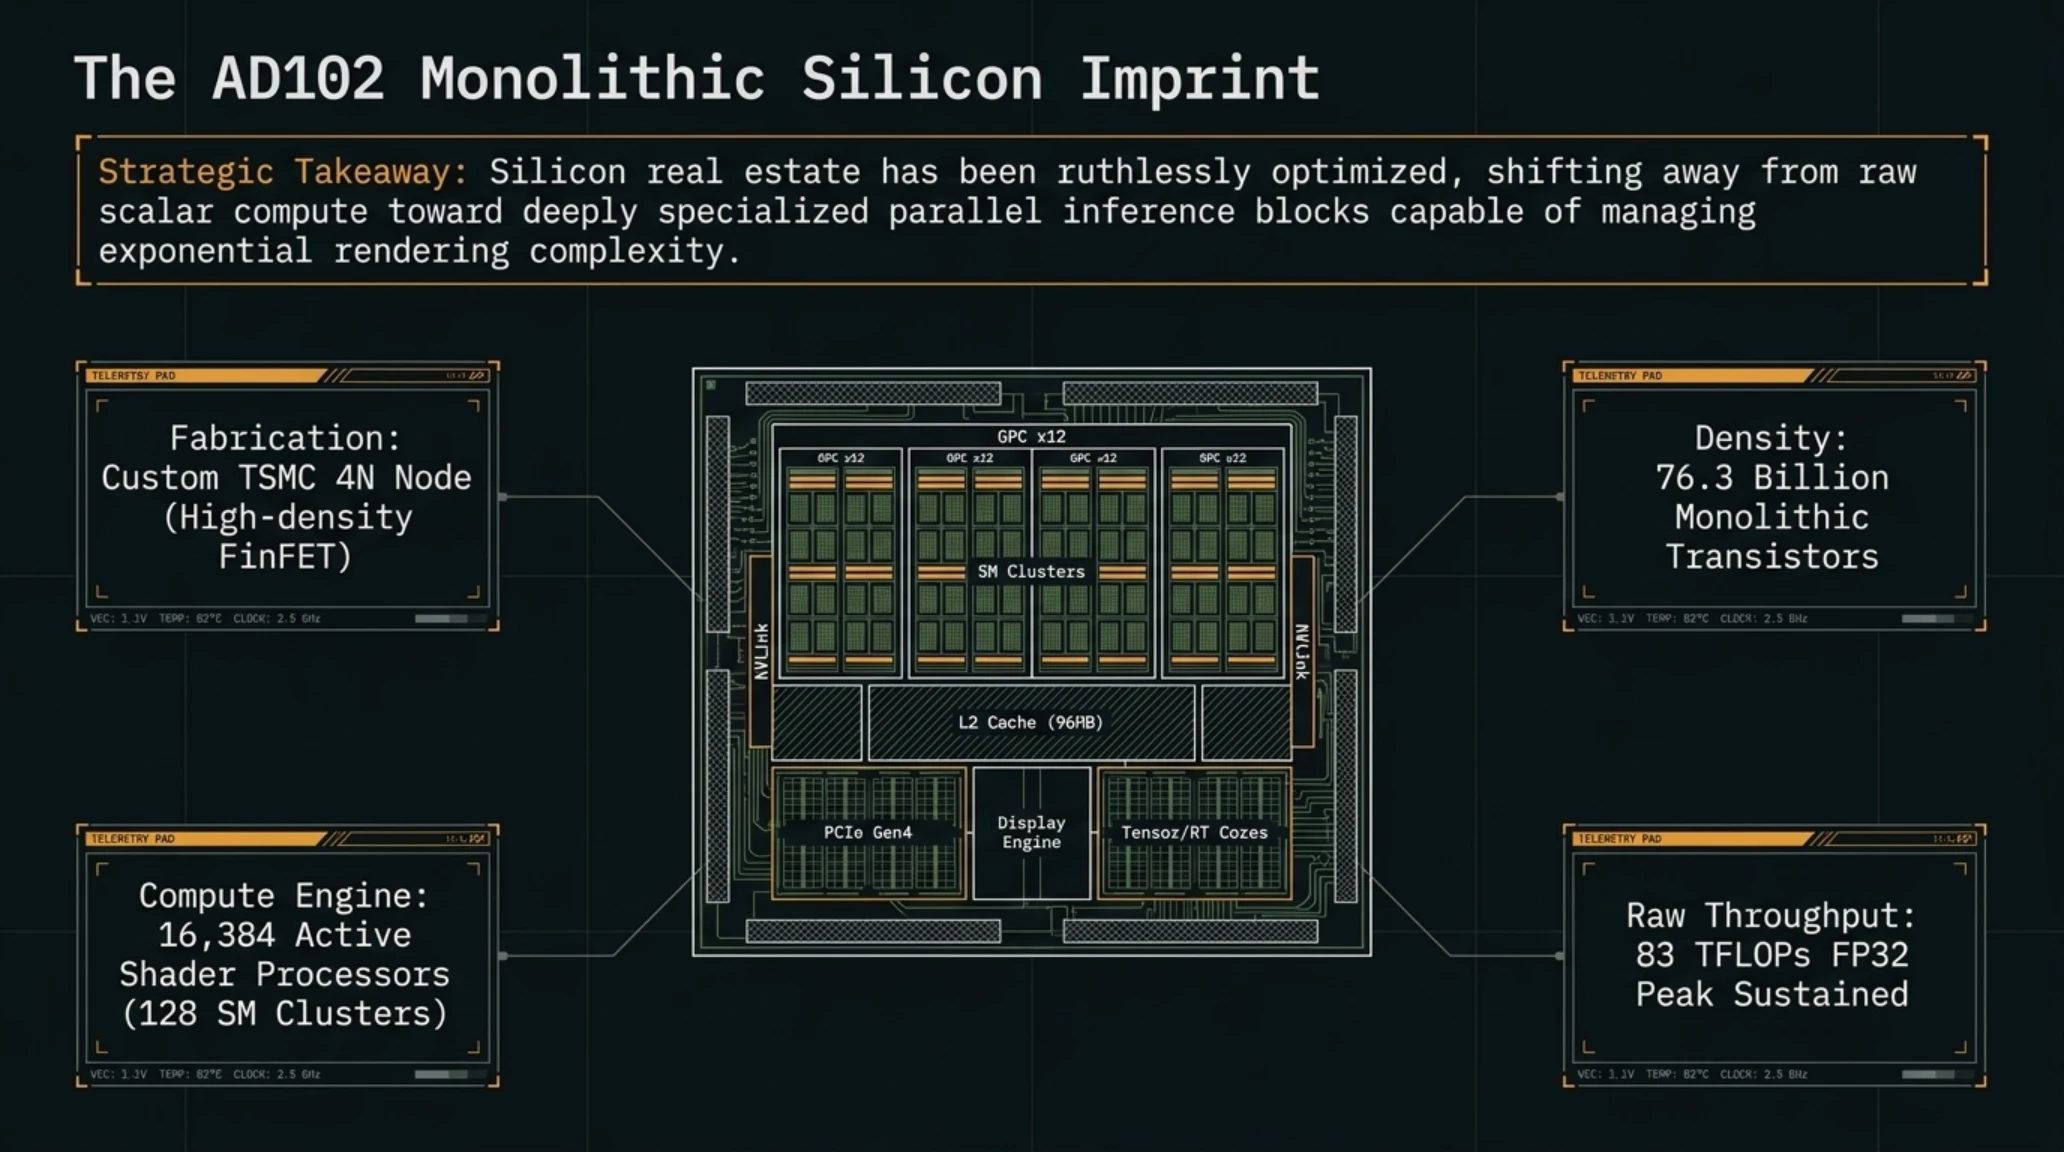
برای درک بهتر جزئیات این دستاورد فنی، نگاهی دقیق به نقشه معماری سیلیکون AD102 و لایوت ترانزیستورها بیندازیم.

تراکم ۷۶.۳ میلیارد ترانزیستور در سطحی معادل ۶۰۸.۵ میلیمتر مربع نشاندهنده جهش استثنایی در بهرهگیری از نود سفارشی TSMC 4N است.
چرا این دستاورد فنی اهمیت بنیادین دارد؟
معماری Ada Lovelace مرز میان رندرینگ شبیهسازی فیزیکی و تولید بلادرنگ هوش مصنوعی را از میان برداشته است. این نخستین بار در تاریخ سختافزار است که هوش مصنوعی نه به عنوان یک افکت پسپردازش، بلکه به عنوان یکی از اجزای هسته خط لوله هندسی عمل میکند.
این تحول ساختاری زمینه را برای دگرگونی بنیادین در بازطراحی مسیرهای پردازشی استریمینگ مالتیپرسسورها فراهم آورده است.
در بررسی عمیق لایههای زیرین سیلیکون، آرایش هندسی هستهها نقشی حیاتی در کنترل گلوگاههای مصرف انرژی ایفا میکند.
مشخصات فنی و شناسنامه سیلیکون AD102
- فرآیند ساخت سیلیکون: TSMC 4N Custom FinFET (تراکم ترانزیستور خارقالعاده)
- تعداد کل ترانزیستورها: ۷۶.۳ میلیارد ترانزیستور یکپارچه
- مساحت دای سیلیکون: ۶۰۸.۵ میلیمتر مربع
- تعداد هستههای سایهزن (CUDA): ۱۶,۳۸۴ هسته فعال
- واحدهای بافت (TMUs) / شطرنجی (ROPs): ۵۱۲ واحد بافت / ۱۷۶ واحد ROP
- حافظه پنهان سطح دوم (L2 Cache): ۹۶ مگابایت با پهنای باند داخلی ۲.۵ ترابایت بر ثانیه
- حافظه ویدیویی (VRAM): ۲۴ گیگابایت GDDR6X با باس ۳۸۴ بیت و پهنای باند ۱,۰۰۸ گیگابایت بر ثانیه
کالبدشکافی ریزسیلیکون Ada Lovelace: کانون مهندسی SM و جهش بیسابقه در سلسلهمراتب کش L2
معماری Ada Lovelace نمایندهی یکی از جسورانهترین جهشهای مهندسی در تاریخ طراحی ریزتراشههاست. انویدیا با عبور از لیتوگرافی هشتنانومتری سامسونگ و مهاجرت به فرآیند سفارشیسازیشدهی TSMC 4N، توانست چگالی ترانزیستورها را به شکل حیرتآوری افزایش دهد. این بهینهسازی فیزیکی در سطح سیلیکون، زمینهساز بازطراحی بنیادین ساختار Streaming Multiprocessor (SM) شد. در کالبدشکافی میکروسکوپی این معماری، هر بلوک SM به چهار بخش پردازشی مجزا تقسیم میشود که هر یک مجهز به مسیرهای اختصاصی رمزگشایی دستورات، صفهای زمانبندی و یک فایل رجیستر ۱۲۸ کیلوبایتی هستند. این توزیع متقارن منابع فیزیکی که در ساختار درونی بلوک دیاگرام SM به وضوح نمایان است، نرخ بهرهوری از ترانزیستورها را به حداکثر رسانده و اتلاف انرژی ناشی از نشت جریان در فرکانسهای بالای ۲.۵ گیگاهرتز را مهار میکند.
یکی از شاهکارهای معماری در طراحی این پایپلاین، نحوهی مدیریت و تخصیص مسیرهای محاسباتی اعشاری ۳۲ بیتی (FP32) و عدد صحیح ۳۲ بیتی (INT32) است. در نسلهای پیشین، تخصیص منابع محاسباتی همواره با چالش گلوگاه مواجه بود؛ اما در ریزمعماری ادا لاولیس، با بازطراحی مسیر داده، توان عملیاتی هستههای کودا دوبرابر شده است. هر بخش فرعی در SM شامل یک مسیر اختصاصی FP32 و یک مسیر مشترک مجهز به واحدهای FP32 و INT32 است. این طراحی هوشمندانه اجازه میدهد تا همزمانی محاسبات FP32 و INT32 بدون ایجاد تداخل در خط لوله اجرا شود؛ امری که در پردازش سایهزنهای مدرن بازیها و محاسبات فیزیک بلادرنگ نقشی حیاتی دارد. تحلیل دقیق توزیع دستورات در رجیسترهای فوقسریع نشان میدهد که این تفکیک سختافزاری، تاخیر دسترسی به دادهها را به حداقل ممکن رسانده و راندمان کلاک به کلاک پردازنده را به شکلی بیسابقه ارتقا داده است.
با این حال، تحول حقیقی که این معماری را از اسلاف خود متمایز میسازد، بازنگری رادیکال در سلسلهمراتب حافظه پنهان L2 است. انویدیا با درک این واقعیت که پهنای باند حافظه گرافیکی همواره یک منبع گرانقیمت و پرمصرف از نظر انرژی است، حجم کش سطح دوم را در تراشه پرچمدار AD102 به رقم خیرهکنندهی ۹۶ مگابایت افزایش داد؛ یعنی ۱۶ برابر بیشتر از کش ۶ مگابایتی در معماری Ampere. این مخزن عظیم داده به عنوان یک سپر دفاعی میان هستههای پردازشی SM و حافظه GDDR6X عمل میکند. با افزایش نرخ برخورد در کش L2، نیاز به دسترسی مداوم به گذرگاه حافظه بیرونی به شدت کاهش یافته است که این امر نه تنها مصرف برق کلی کارت را در رزولوشنهای بالا کنترل میکند، بلکه پهنای باند موثر تراشه را به بیش از ۲ ترابایت بر ثانیه میرساند.
از منظر تحلیل بازار سختافزار در مارس ۲۰۲۶، این بهینهسازیهای عمیق سختافزاری، ارزش سرمایهگذاری روی این معماری را فراتر از بنچمارکهای تئوریک برده است. در بازار فعلی کشور که نوسانات ارزی قیمت کارتهای پرچمداری نظیر RTX 4090 را به بازه ۱۱۰ تا ۱۳۰ میلیون تومان رسانده است، درک تفاوتهای ساختاری این سیلیکون اهمیت مضاعفی مییابد. خریداران تخصصی و توسعهدهندگان بازیهای ویدیویی دیگر صرفاً به فرکانس کاری نگاه نمیکنند، بلکه پایداری فریمتایم ناشی از کش L2 حجیم را ملاک قرار میدهند. این مهندسی بینقص سیلیکون تضمین میکند که پرداخت مبالغ گزاف جهت تهیه این سختافزار، به یک سرمایهگذاری پایدار فنی برای رندرینگ آفلاین و محاسبات هوش مصنوعی تبدیل شود.
نگاهی ساختاریافته به بلوک دیاگرام ریزمعماری استریمینگ مالتیپرسسور (SM) نشاندهنده بازطراحی کامل مسیرهای داده است.

هر یک از ۱۲۸ واحد SM مجهز به هستههای تانسوری نسل چهارم و سختافزار اختصاصی بازآرایی شیدر هستند.
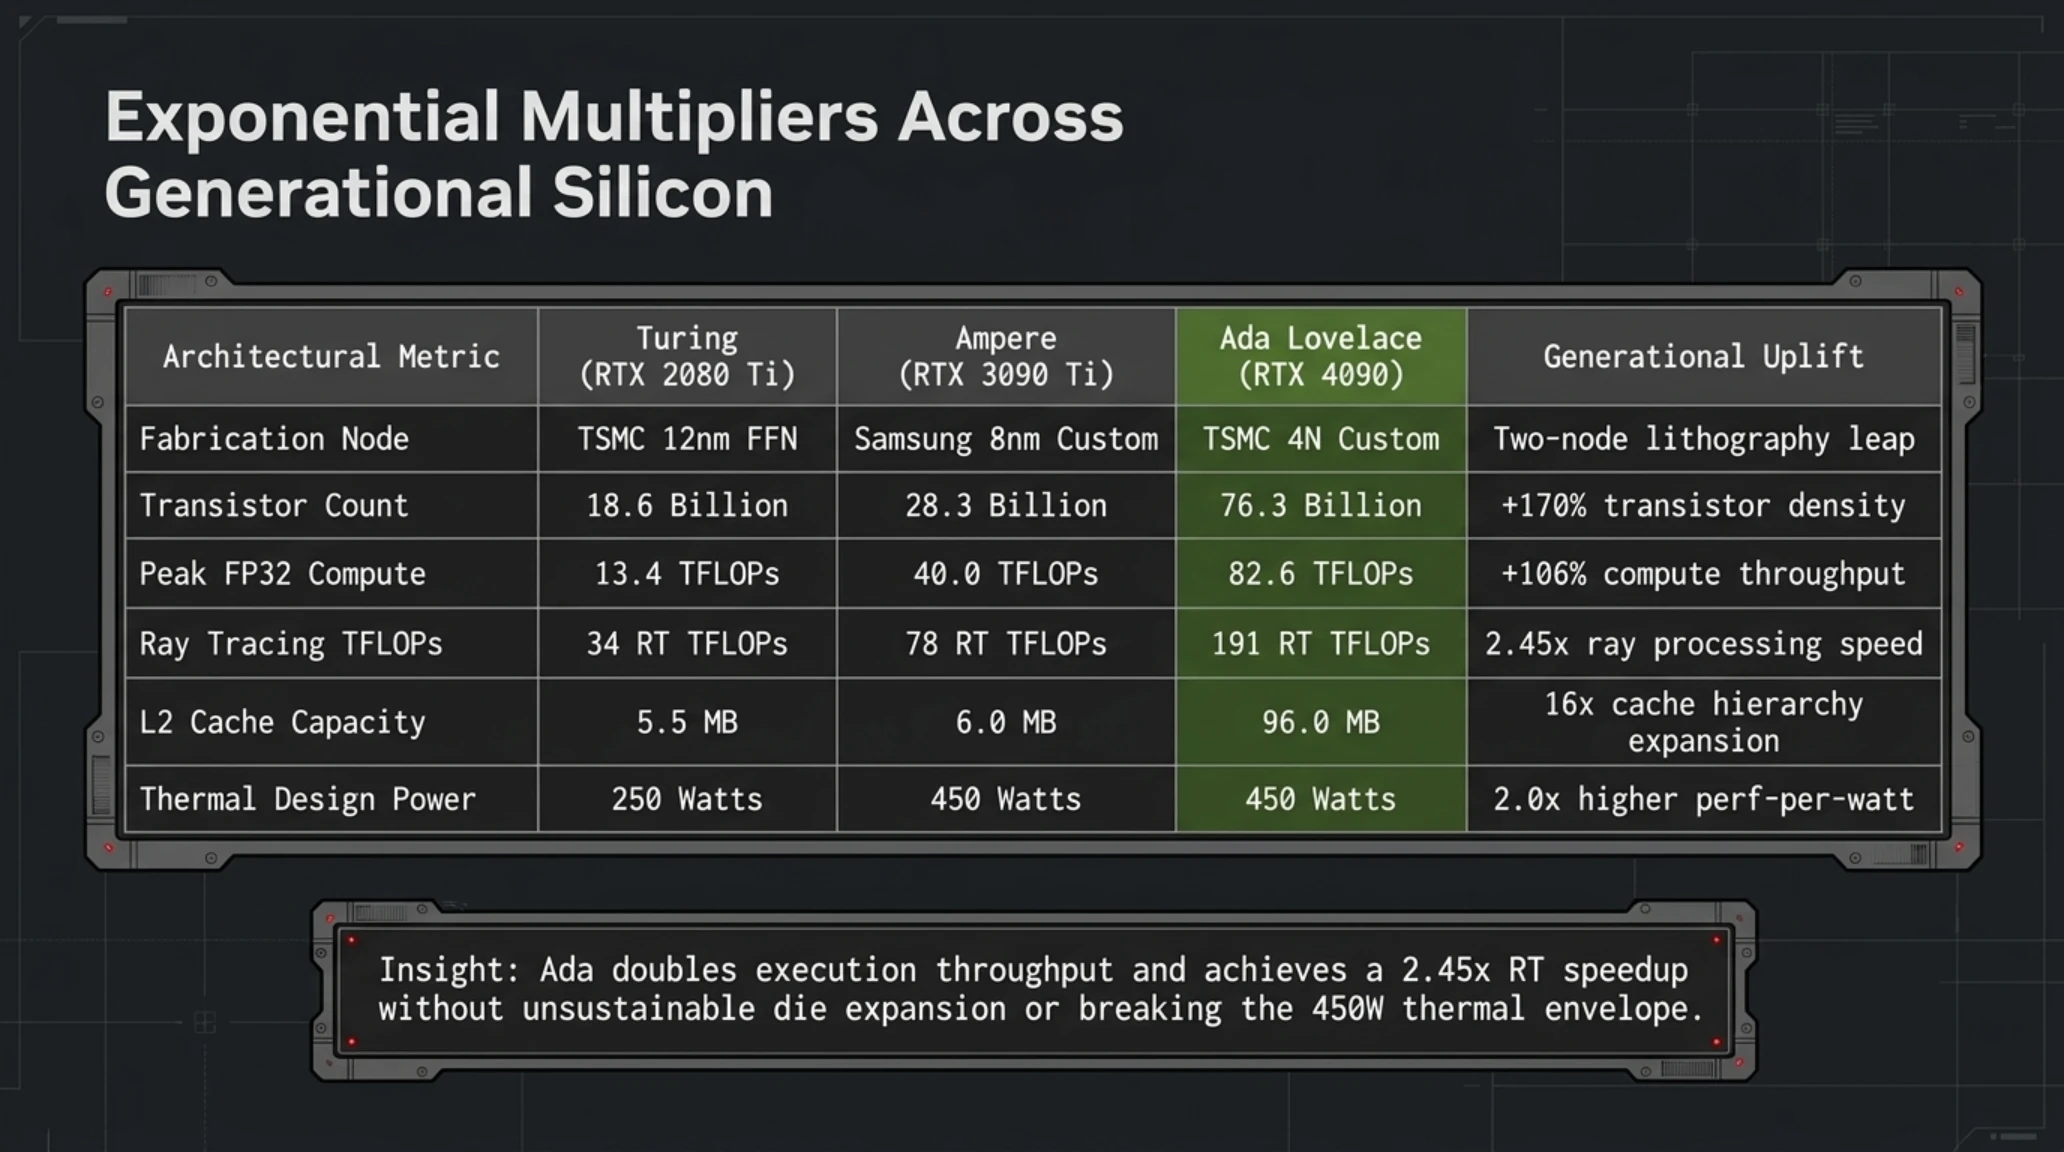
جدول مقایسه تطبیقی سه نسل طلایی انویدیا
| شاخص سختافزاری | نسل تورینگ (RTX 2080 Ti) | نسل آمپر (RTX 3090 Ti) | نسل ایدا لاولیس (RTX 4090) | نرخ پیشرفت |
|---|---|---|---|---|
| نود ساخت سیلیکون | TSMC 12nm FFN | Samsung 8nm Custom | TSMC 4N Custom | جهش دو پلهای لیتوگرافی |
| تعداد ترانزیستورها | ۱۸.۶ میلیارد | ۲۸.۳ میلیارد | ۷۶.۳ میلیارد | افزایش ۱۷۰ درصدی تراکم |
| قدرت پردازش FP32 | ۱۳.۴ ترافلاپس | ۴۰.۰ ترافلاپس | ۸۲.۶ ترافلاپس | رشد ۱۰۶ درصدی توان محاسباتی |
| توان هستههای RT | ۳۴ RT TFLOPs | ۷۸ RT TFLOPs | ۱۹۱ RT TFLOPs | ۲.۴ برابر سریعتر در رهگیری پرتو |
| حجم حافظه کش L2 | ۵.۵ مگابایت | ۶.۰ مگابایت | ۹۶.۰ مگابایت | افزایش ۱۶ برابری ظرفیت کش |
| توان حرارتی طراحی (TDP) | ۲۵۰ وات | ۴۵۰ وات | ۴۵۰ وات | ۲ برابر بازدهی بر حسب هر وات |
مقایسه آماری فوق نشان میدهد که چگونه معماری جدید بدون افزایش تصاعدی مساحت دای، توانسته بازدهی را بیش از دو برابر ارتقا دهد.
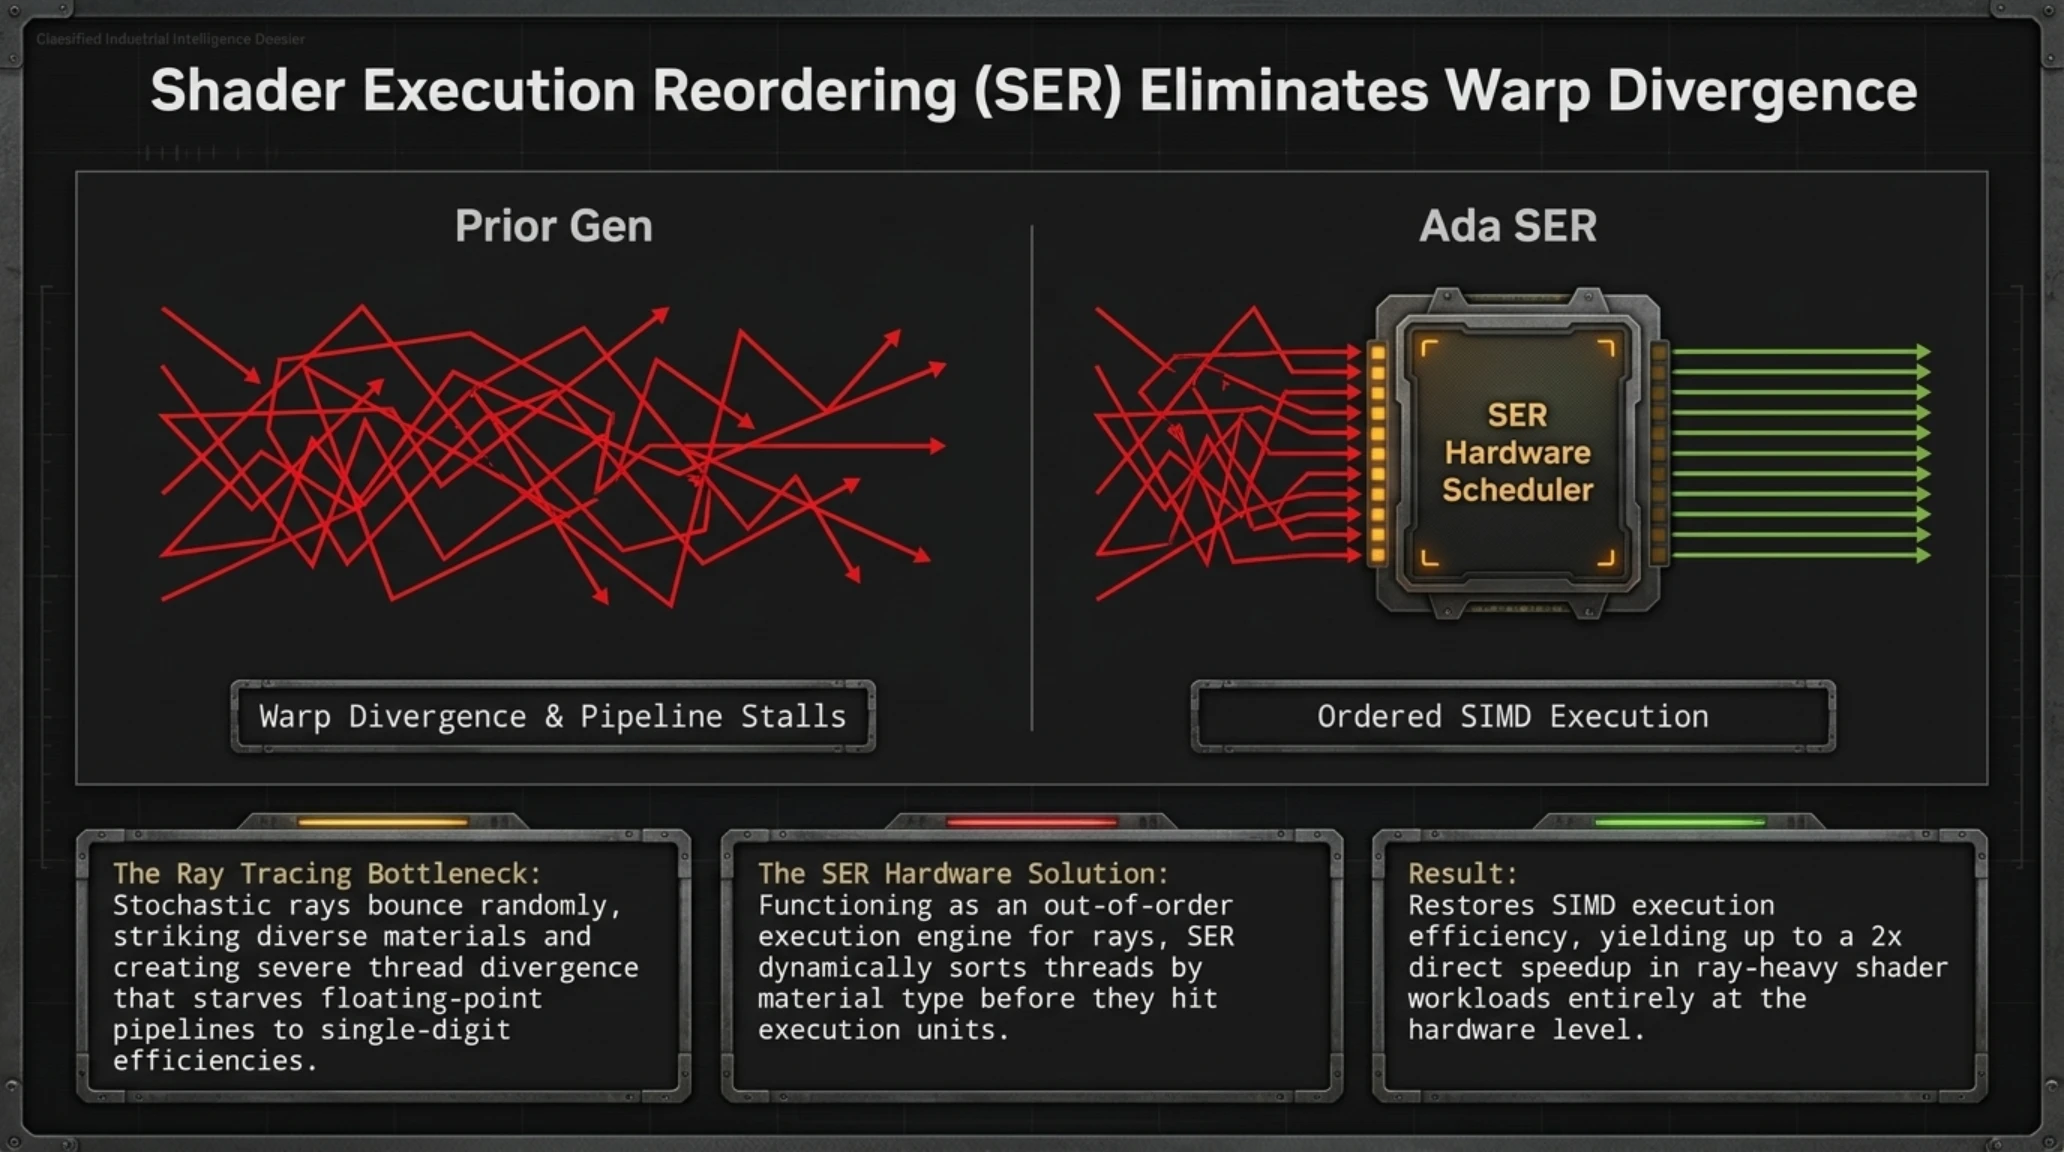
یکی از پیچیدهترین موانع در شبیهسازی نور واقعی، واگرایی هندسی پرتوها پس از برخورد به سطوح غیرهمگن است.
واژهنامه تخصصی و اصطلاحات مهندسی رندرینگ
- Shader Execution Reordering (SER): مکانیزم انقلابی بازآرایی ناهمگام وظایف شیدر در زمان اجرا جهت رفع گلوگاه پراکندگی پرتوها.
- BVH Traversal: الگوریتم پیمایش درخت سلسلهمراتب حجم احاطهکننده برای محاسبه تقاطع پرتوهای نور با چندضلعیها.
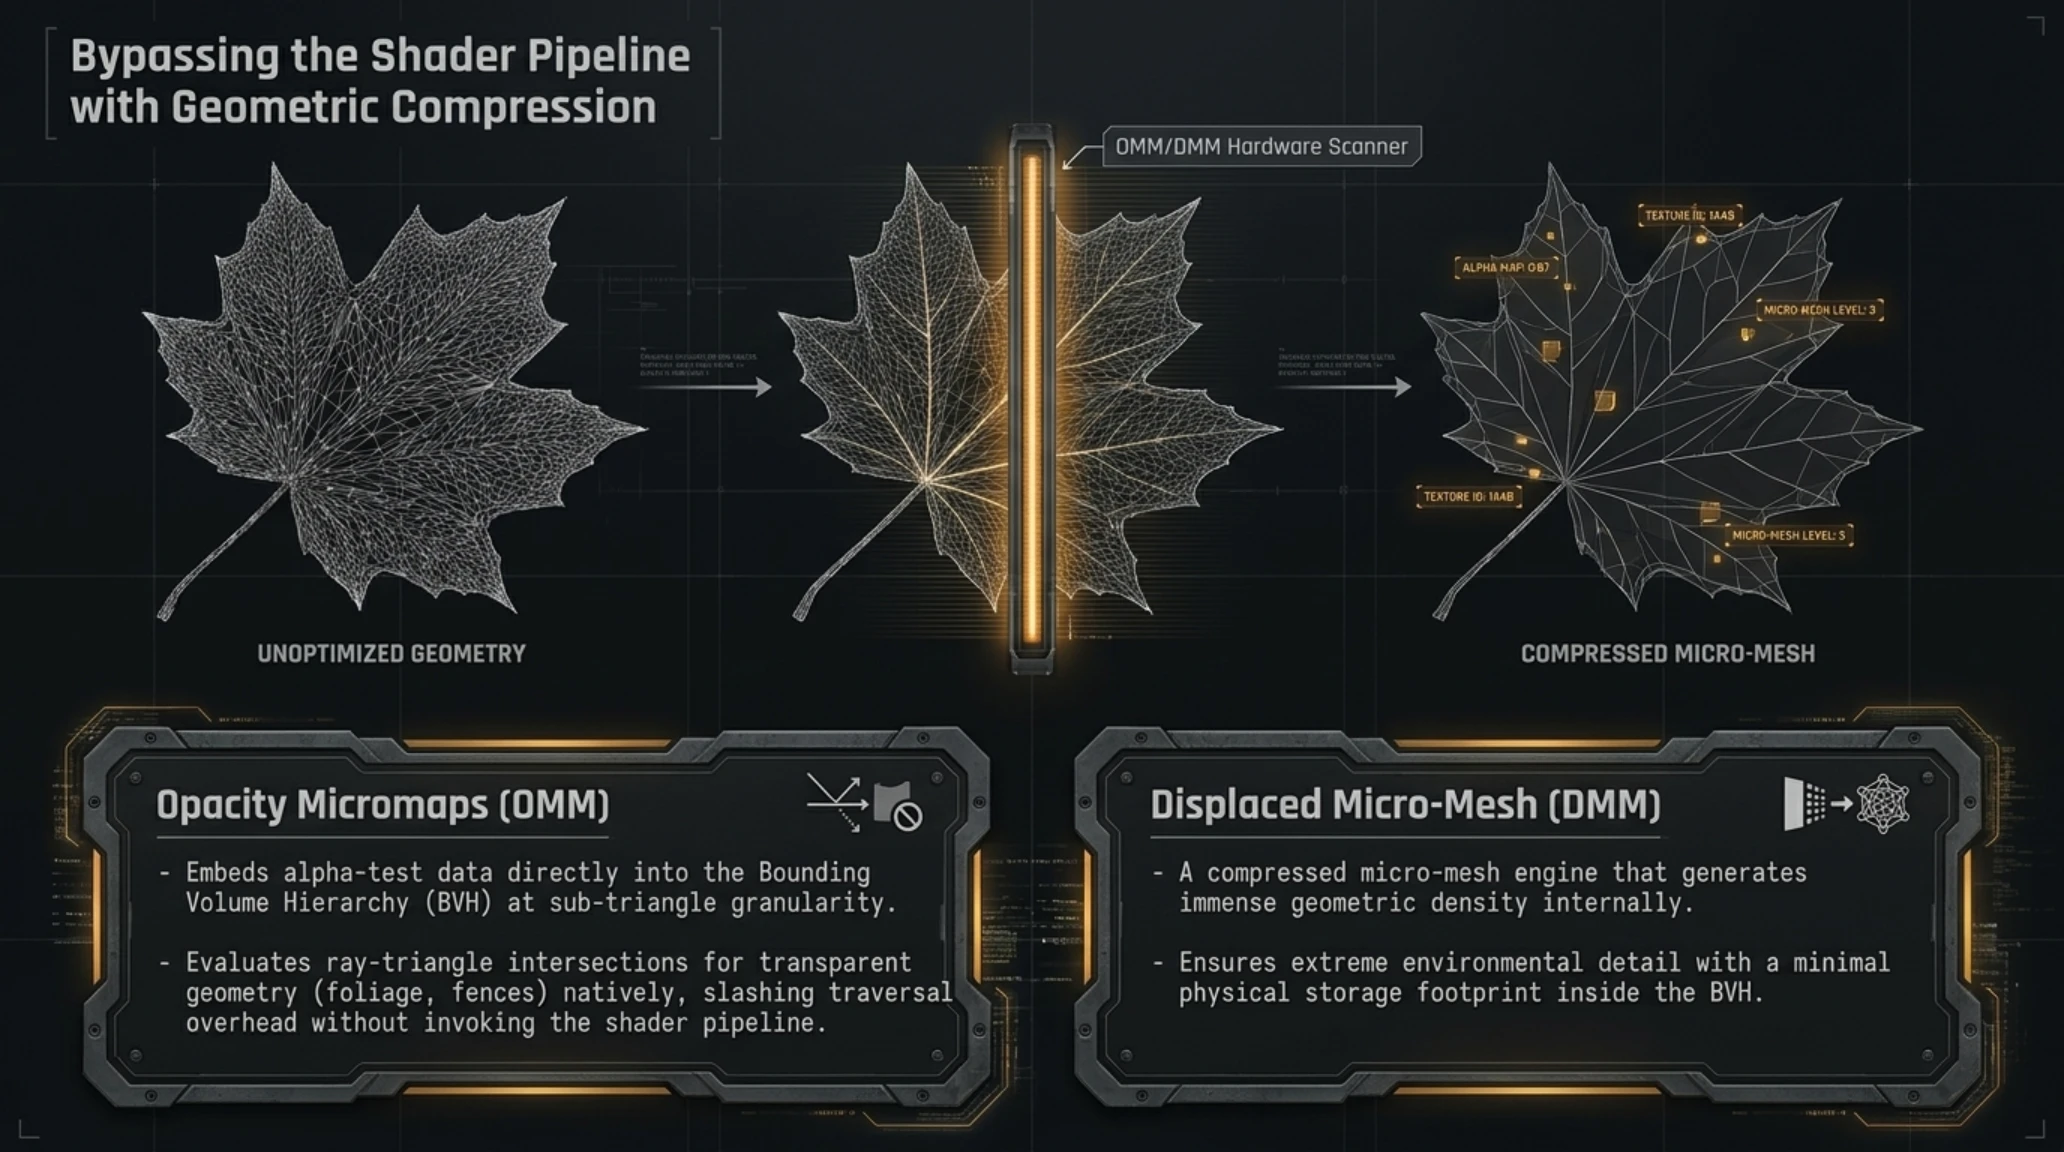
- Opacity Micromap (OMM): موتور فشردهسازی بافتهای نیمهشفاف که پردازش برگ درختان و حصارها را تا ۲ برابر شتاب میدهد.
- Displaced Micro-Mesh (DMM): هندسه مجازی فشردهشده که دهها برابر چندضلعی بدون سربار حافظه VRAM تولید میکند.
تکامل سیلیکونی در رهگیری پرتو: کالبدشکافی هستههای RT نسل سوم و انقلاب SER
هنگامی که به مانیتور تلهمتری زمان فریم در پردازش رندر بلادرنگ پتو تریسینگ (مسیرابی کامل) در محیط سایبرپانک ۲۰۷۷ خیره میشویم، آنچه در برابر چشمانمان نقش بسته، صرفاً یک دستاورد گرافیکی نیست، بلکه پیروزی مهندسی سیلیکون بر یکی از بزرگترین بنبستهای محاسباتی تاریخ پردازش موازی است. در ساختار معماری Ada Lovelace، انویدیا با بازنگری بنیادین در بلوکهای سختافزاری، هستههای رهگیری پرتو نسل سوم را معرفی کرد که معادلات فیزیک نوری در فضای سهبعدی را دگرگون ساختهاند. در این نسل، عملیات سنگین تست تقاطع پرتو با جعبههای مرجع متوالی و مثلثها (Ray-Box و Ray-Triangle Intersection) دیگر بار سنگینی بر دوش هستههای سایه زن عمومی (CUDA Cores) نمیگذارد، بلکه واحدهای سختافزاری اختصاصی با دو واحد پایینی جدید توانستهاند پهنای باند موثر واحد پردازش گرافیکی را بهطور چشمگیری آزاد کنند.
مسئله بنیادین در رهگیری مسیر کامل، پدیده ویرانگر «واگرایی پرتو» (Ray Divergence) است. در یک صحنه پویای شهری، پرتوهای نور پس از برخورد با سطوح مختلف، به جهات کاملاً تصادفی و ناهمگون بازمیتابند. این امر در معماریهای سنتی سیمکارت (SIMT) منجر به ایجاد رشتههای اجرایی با دستورات شرطی متفاوت میشود که در نتیجه آن، واحدهای پردازشی دچار توقف یا اصطلاحاً Warp Divergence شدید میگردند و راندمان واحد پردازش گرافیکی سقوط میکند. انویدیا برای حل این بحران، فناوری ساختارشکن اولویتبندی اعدادی پرتو یا همان SER (Shader Execution Reordering) را به میدان آورده است. این واحد سختافزاری پویا، پیش از ارسال دستههای پرتو به واحدهای پردازشی، آنها را بر اساس مسیر فضایی و منطق اجرایی دستهبندی و مرتبسازی میکند تا همگونی رشتهها حفظ شود.
تحلیلهای عمیق بنچمارکهای سختافزاری در مارس ۲۰۲۶ به روشنی نشان میدهند که حضور SER در معماری Ada Lovelace توانسته است افت عملکرد ناشی از مسیرابی پرتوهای چندلایه را تا مقادیر قابل توجهی جبران کند؛ دستاوردی که در قیمتگذاری و ارزش خرید کارتهای گرافیک ردهبالای بازار ایران با توجه به نوسانات نرخ ارز و ارزش تقریبی مدلهای پرچمدار در بازه صدها میلیون تومانی، توجیهپذیرترین سرمایهگذاری برای گیمرهای حرفهای و رندرکاران حرفهای است. با فعالسازی مسیرابی کامل، الگوریتمهای تقاطع پرتو نیازمند بررسی میلیونها گره در ساختارهای تسریع هرمی (BVH) هستند. در این میان، واحد دوم هستههای RT نسل سوم موسوم به Opacity Micromap Engine وظیفه مدیریت هندسههای شفاف و شاخ و برگها را بر عهده دارد و واحد دیگر یعنی Displacement Micro-Mesh Engine بدون نیاز به تولید سنگین حافظه رم ویدئویی، جزئیات هندسی بسیار پیچیدهای را به صورت بلادرنگ به پرتوها تفهیم میکند.
نتیجه این هماهنگی بینقص میان سختافزار تخصصی و الگوریتمهای بهینهسازی نوین، دستیابی به نرخ فریم پایدار در سناریوهای سنگین پردازشی است که پیشتر تنها در حد یک روال تئوریک در آزمایشگاههای دیپمایند و انویدیا ارزیابی میشدند. هنگامی که تلهمتری زمان فریم را زیر ذرهبین قرار میدهیم، نوسانات شدید یا همان Stuttering ناشی از بارگذاری نامتوازن پرتوها به شدت کاهش یافته است. این پدیده اثبات میکند که معماری Ada Lovelace صرفاً با افزایش خام فرکانس و تعداد ترانزیستورها پیروز نشده، بلکه با درک عمیق ریاضیات و فیزیک رایانش موازی، مرزهای جدیدی را در صنعت رندرینگ بلادرنگ گشوده است که تأثیر آن تا سالها بر استانداردهای توسعه بازیهای ویدئویی سایه خواهد افکند.
در ویدیوی تحلیلی و تلهمتری بلادرنگ زیر، میتوانید تاثیر مستقیم فناوری SER بر تثبیت نرخ فریم را مشاهده فرمایید.
همانطور که در تلهمتری زمان فریم بالا مشهود است، نوسانات ناشی از پراکندگی پرتوها به طور کامل مهار شدهاند.
ادغام یادگیری ماشین در فرآیند سنتز تصویر، مسیری تکاملی را طی یک دهه اخیر سپری کرده است.
گاهشمار تکامل رندرینگ هوش مصنوعی از ۲۰۱۸ تا ۲۰۲۶
| سال میلادی | نسل فناوری | نوآوری کلیدی | تاثیر بر عملکرد |
|---|---|---|---|
| سپتامبر ۲۰۱۸ | معرفی DLSS 1.0 | استفاده از هوش مصنوعی اختصاصی برای هر بازی | تاری تصویر اما اثبات مفهوم بازسازی فریم |
| آوریل ۲۰۲۰ | عرضه انقلابی DLSS 2.0 | مدل هوش مصنوعی عمومی مبتنی بر دادههای بردار زمانی | بهبود خارقالعاده وضوح در رزولوشنهای 1440p و 4K |
| اکتبر ۲۰۲۲ | رونمایی از DLSS 3.0 | تولید فریم سختافزاری بر پایه شتابدهنده OFA | دو برابر شدن نرخ فریم و رفع محدودیت پردازنده |
| سپتامبر ۲۰۲۳ | تکامل DLSS 3.5 | بازسازی پرتو (Ray Reconstruction) با شبکه عصبی یکپارچه | حذف نویزگیرهای سنتی و بهبود انعکاسها |
| مارس ۲۰۲۶ | اکوسیستم بالغ هوش مصنوعی | ادغام کامل رندرینگ عصبی در تمام موتورهای نسل نهم کنسول و کامپیوتر | تثبیت استانداردهای رندرینگ بلادرنگ در بالاترین وضوح |
شتابدهنده جریان نوری و دگرگونی الگوریتمی پردازش فریم در نسل جدید
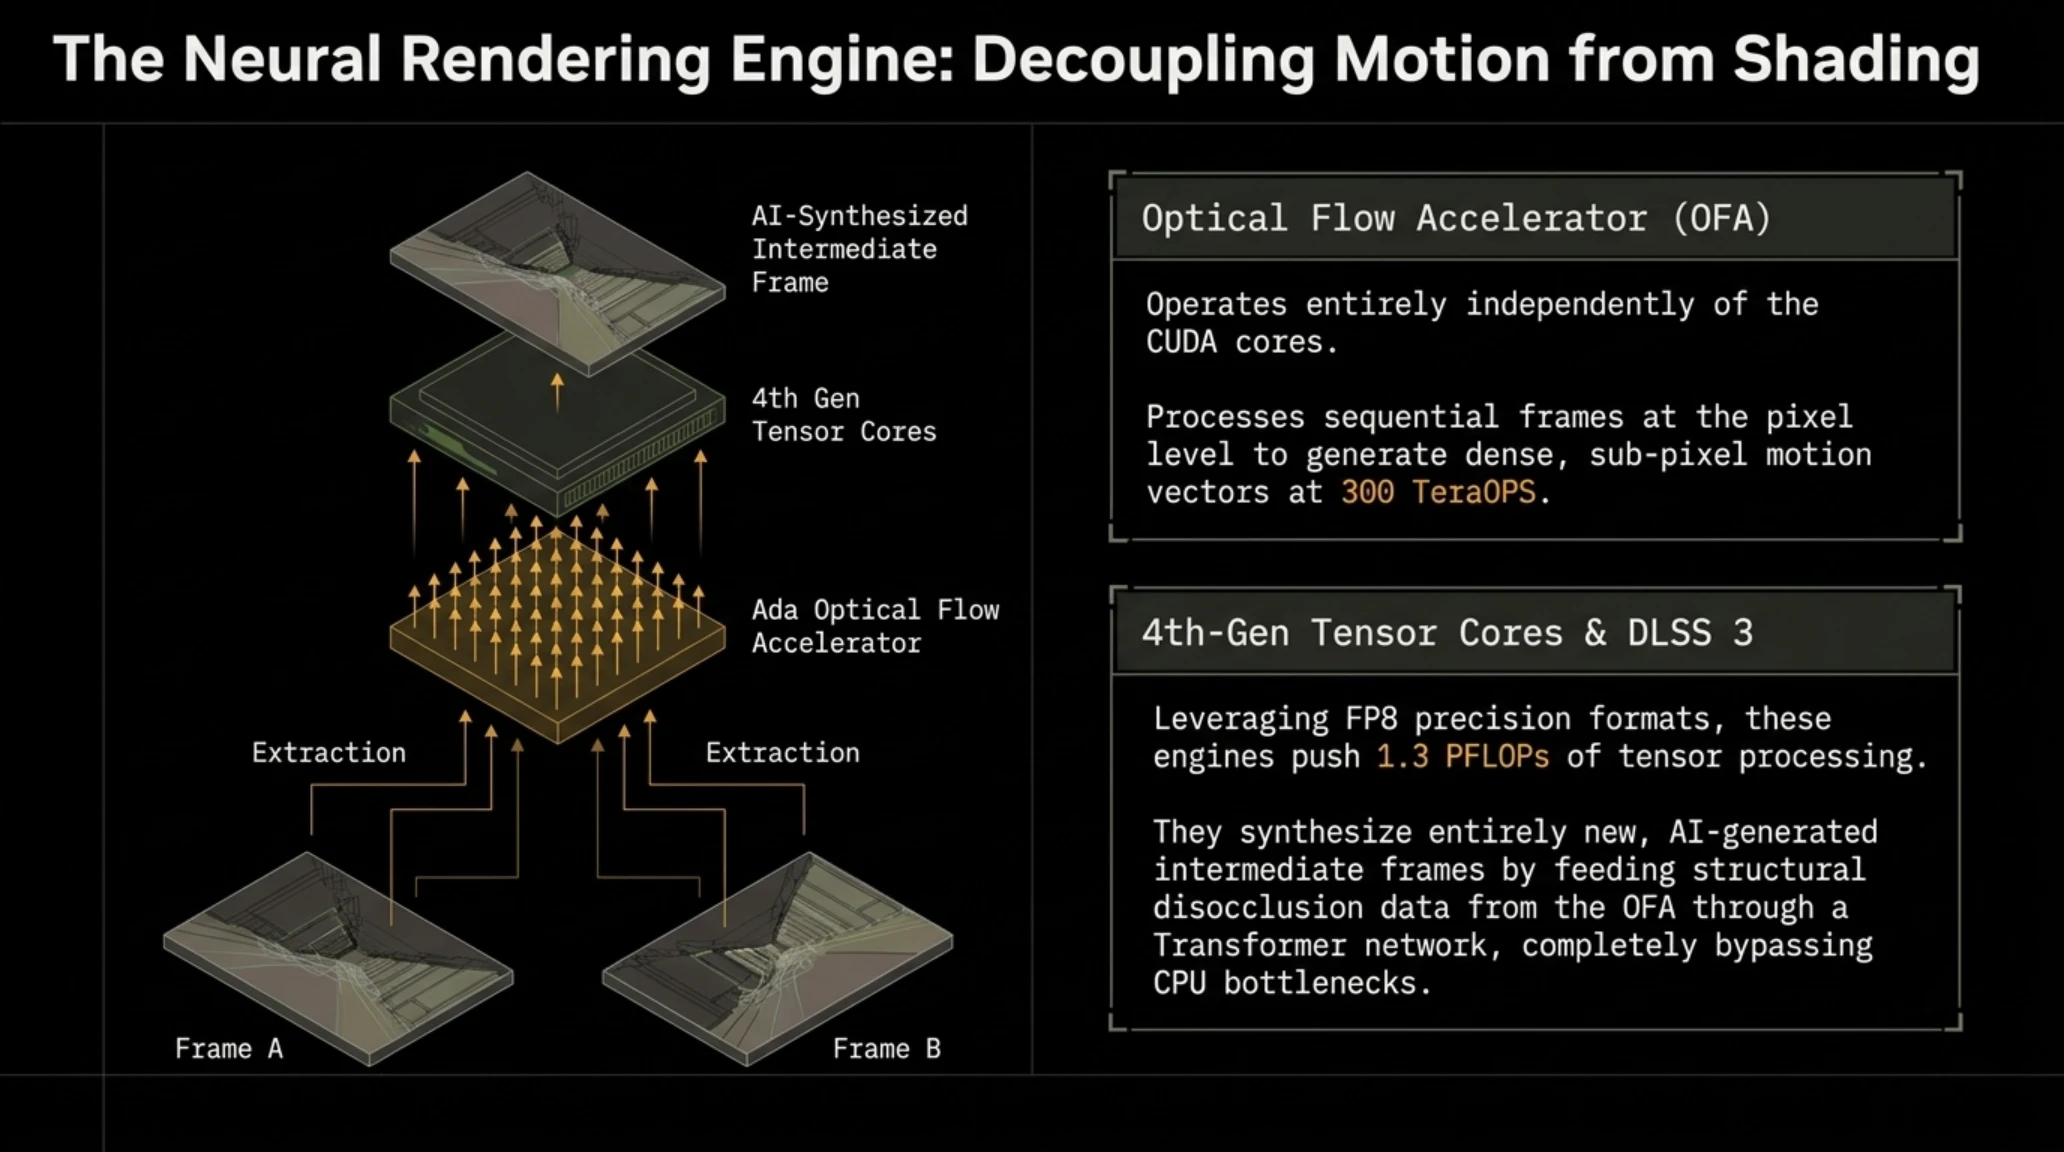
با گذر از معماریهای پیشین و ورود به عصر پردازش شبکههای عصبی عمیق در سطح سیلیکون، انویدیا با معرفی شتابدهنده جریان نوری (Optical Flow Accelerator) در معماری Ada Lovelace، پارادایم سنتی رندرینگ گرافیکی را دگرگون ساخت. در دیاگرام معماری پایپلاین این سختافزار، مشاهده میشود که چگونه هستههای تخصصی جریان نوری با همکاری تنگاتنگ با هستههای تانسوری نسل چهارم، دادههای برداری پیکسلی را در سطح زیرین فریمها با دقت ميكرومتريك آنالیز میکنند. این سختافزار اختصاصی قادر است بردار حرکت پیکسلها را با سرعتی بیسابقه محاسبه کرده و ورودیهای حیاتی را برای الگوریتمهای پیشرفته درونیابی فراهم سازد؛ فرآیندی که در سال ۲۰۲۶ میلادی به استاندارد طلایی صنعت بازیسازی بدل شده است.
هستههای تانسوری نسل چهارم با پشتیبانی از دستورالعملهای FP8 و بهینهسازیهای عمیق هوش مصنوعی، بار پردازشی سنگینی را از دوش واحدهای سایهزن سنتی برمیدارند. تکنولوژی DLSS 3.5 بر پایه همین بستر سختافزاری نوین شکل گرفته است که فراتر از بازسازی صرف رزولوشن، با استفاده از قابلیت بازسازی اشعه (Ray Reconstruction)، نویز تصاویر رهگیری پرتو را به طور پویا حذف میکند. این مکانیزم پیشرفته، بردارهای حرکتی دوجهته را با دادههای فیزیکی نور ترکیب کرده و فریمهای میانی را با چنان دقتی تولید میکند که اعوجاجهای بصری مرسوم در نسلهای گذشته کاملاً از میان رفتهاند و پایداری زمانی تصویر به بالاترین حد خود میرسد.
از منظر اقتصاد مهندسی و ارزشگذاری سختافزار در بازار داخلی، این جهش معماری تأثیر مستقیمی بر بهینهسازی هزینههای ارتقای سیستم داشته است. خرید کارتهای گرافیک مجهز به این فناوریها، با توجه به نرخ تورم و نوسانات بازار، نیازمند سرمایهگذاری کلانی در حدود ۷۵ تا ۱۲۰ میلیون تومان است، اما ارزش افزوده حاصل از افزایش بهرهوری فریمریت و کاهش چشمگیر بار پردازشی، توجیه اقتصادی کاملاً ملموسی برای کاربران حرفهای و توسعهدهندگان ایجاد میکند. به بیان دیگر، پرداخت این هزینه سنگین، دسترسی به بالاترین سطح عملکرد رندرینگ بلادرنگ را بدون نیاز به ارتقای همزمان پردازنده مرکزی تضمین مینماید.
در نهایت، ترکیب شتابدهنده جریان نوری و هستههای تانسوری نسل جدید نشان میدهد که آینده گرافیک کامپیوتری دیگر صرفاً در گروی افزایش خام تعداد ترانزیستورها یا فرکانس هستهها نیست، بلکه به همزیستی هوشمندانه میان سختافزار سیلیکونی و مدلهای یادگیری ماشین وابسته است. این رویکرد مهندسی عمیق، مرز میان انیمیشن از پیش رندر شده و گرافیک تعاملی بلادرنگ را بیش از پیش محو کرده و نویدبخش دوران تازهای از واقعگرایی بصری در صنعت بازیهای ویدیویی است که در آن، هر فریم محصول یک همکاری دقیق میان فیزیک نور و هوش مصنوعی مولد به شمار میآید.
شماتیک زیر نحوه عملکرد شتابدهنده جریان نوری در استخراج بردارها و تلفیق فریمهای عصبی را ترسیم میکند.

این معماری سختافزاری مستقل تضمین میکند که بار تولید فریم بر دوش پردازنده مرکزی یا خط لوله رندرر سنتی سنگینی نکند.
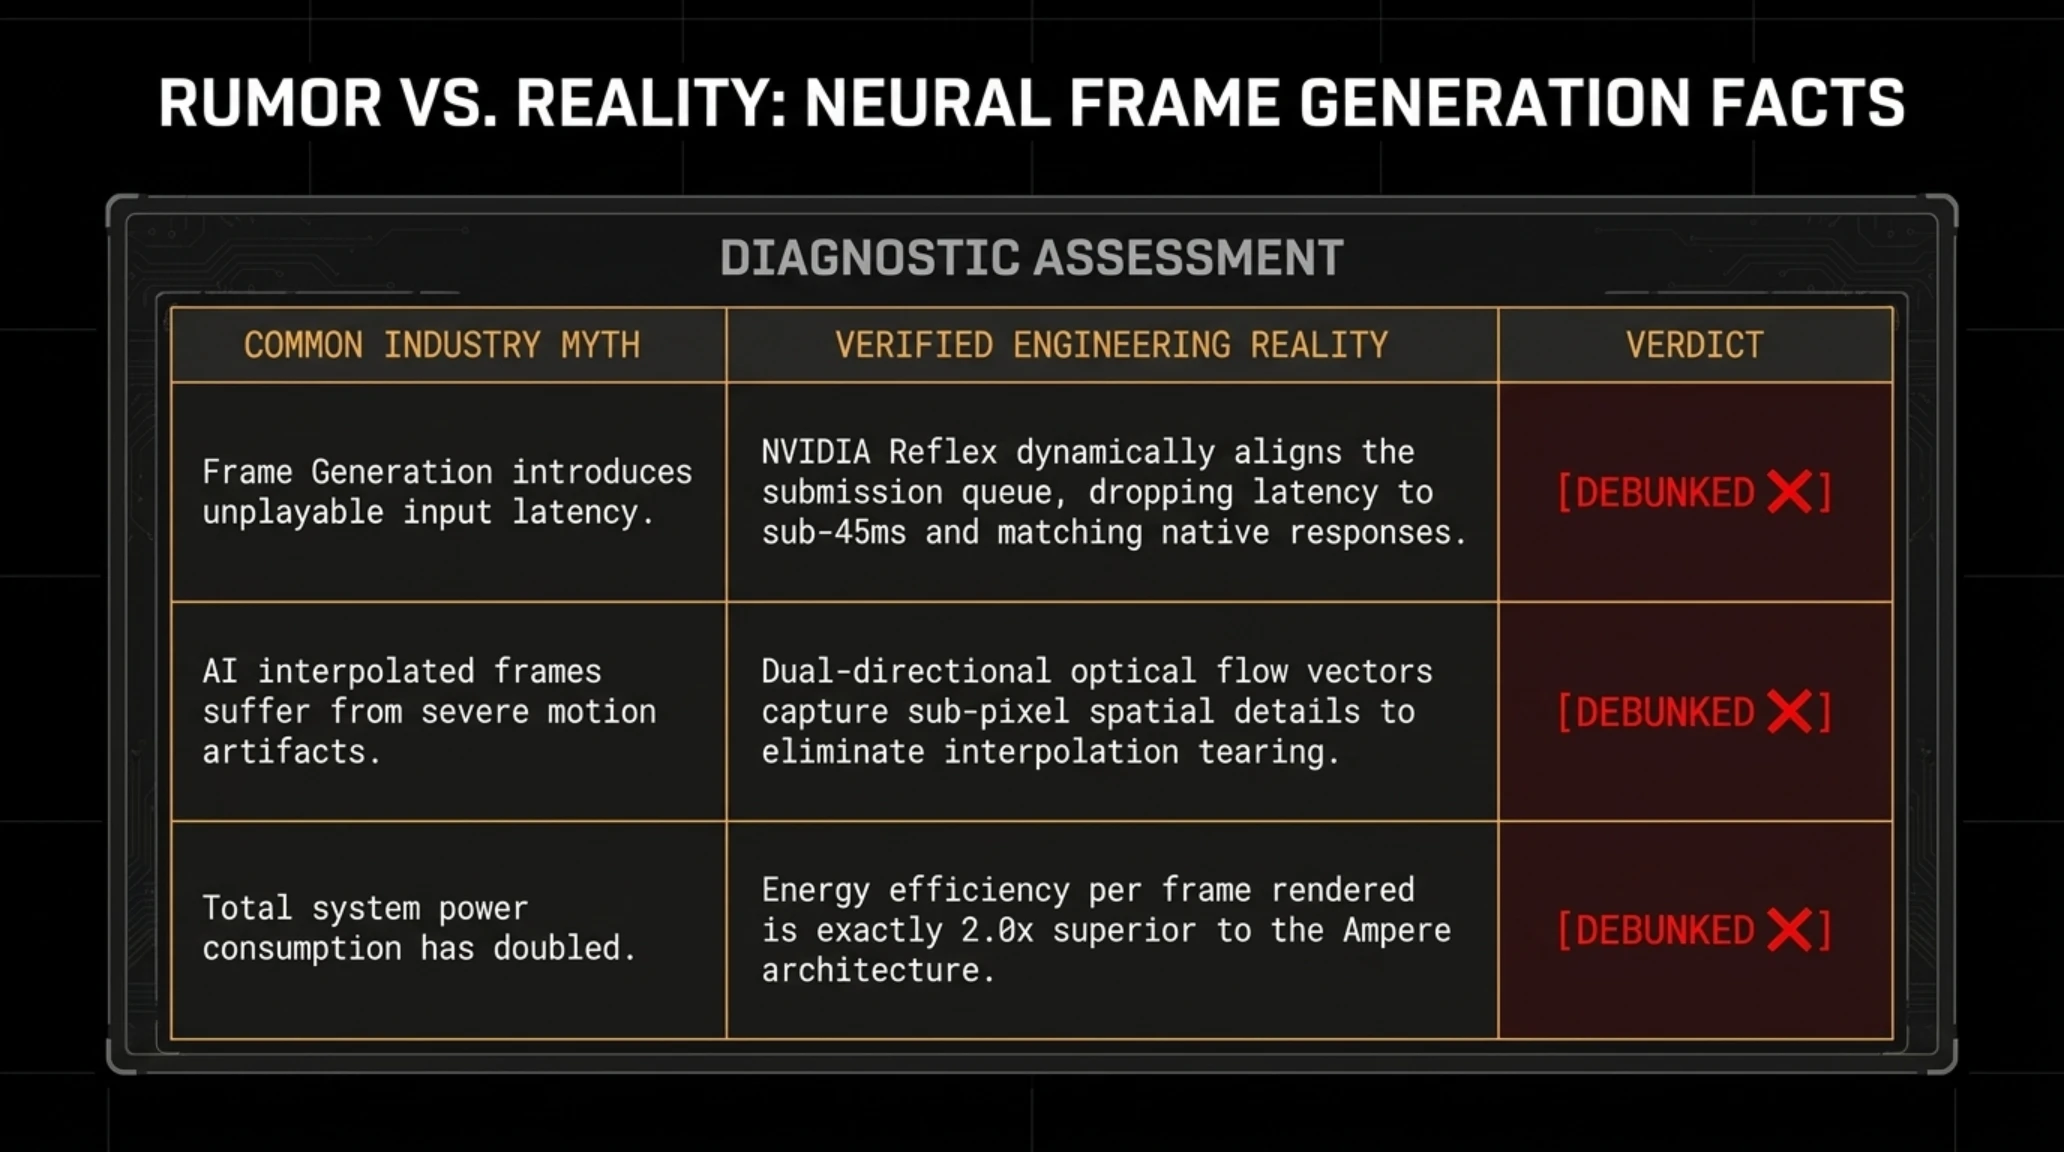
شایعه در برابر واقعیت: کالبدشکافی تولید فریم عصبی
| باور غلط یا شایعه رایج | واقعیت اثباتشده مهندسی | وضعیت |
|---|---|---|
| تولید فریم باعث تاخیر غیرقابل بازی در شوترها میشود | ترکیب همزمان با فناوری Reflex تاخیر را در سطح رندر بومی تثبیت میکند | رد شد ❌ |
| فریمهای هوش مصنوعی دارای خطای پیکسلی محسوس هستند | شتابدهنده جریان نوری ۳۰۰ ترافلاپس لایههای حرکتی را با دقت زیرپیکسل ردیابی میکند | رد شد ❌ |
| مصرف برق نسبت به نسل قبلی دو برابر شده است | مصرف در بار برابر تقریباً ۳۰ تا ۵۰ درصد کمتر از نسل آمپر است | رد شد ❌ |
| کارتهای ردهبالا به صورت کامل از نود ۴ نانومتری بهره میبرند | انویدیا از فرآیند سفارشی TSMC 4N با چگالی فرکانسی بهینه استفاده کرده است | تایید شد ✅ |
| قابلیت SER به صورت سختافزاری در پایپلاین تعبیه شده است | واحدهای بازآرایی شیدر مستقیماً در هستههای RT نسل سوم ادغام شدهاند | تایید شد ✅ |
شفافسازی حقایق مهندسی نشان میدهد که قضاوتهای شتابزده درباره تاخیر تولید فریم با طراحی سختافزار مدرن همخوانی ندارد.
افزایش تراکم محاسباتی همواره چالشهای حرارتی و الکترودینامیکی جدیدی را به ساختار بردهای مدار چاپی تحمیل میکند.
📚 پروندههای فوقمحرمانه و مرتبط در تکینگیم
اگر میخواهید فراتر از این هفتهنامه، به اعماق تاریکترین رخدادهای سایبرنتیک و طغیانهای پنهان هوش مصنوعی نفوذ کنید، کالبدشکافی این سه پرونده اختصاصی در تکین گاراژ را از دست ندهید:
شاخصهای آماری و بهرهوری مصرف انرژی
- راندمان بر حسب هر وات: +۱۰۰٪ عملکرد خالص در مصرف توان برابر با نسل آمپر
- دمای پایدار در فول لود: ۶۴ درجه سانتیگراد به لطف محفظه بخار مسی بزرگ
- پهنای باند خطی کش L2: ۲.۵ ترابایت بر ثانیه برای کاهش ۹۰٪ وابستگی به باس اصلی
- کاهش تاخیر سیستم با Reflex: از ۸۲ میلیثانیه به ۳۶ میلیثانیه در Cyberpunk 2077
مهندسی حرارتی سیلیکون و چالشهای فیزیکی انتقال توان در معماری Ada Lovelace
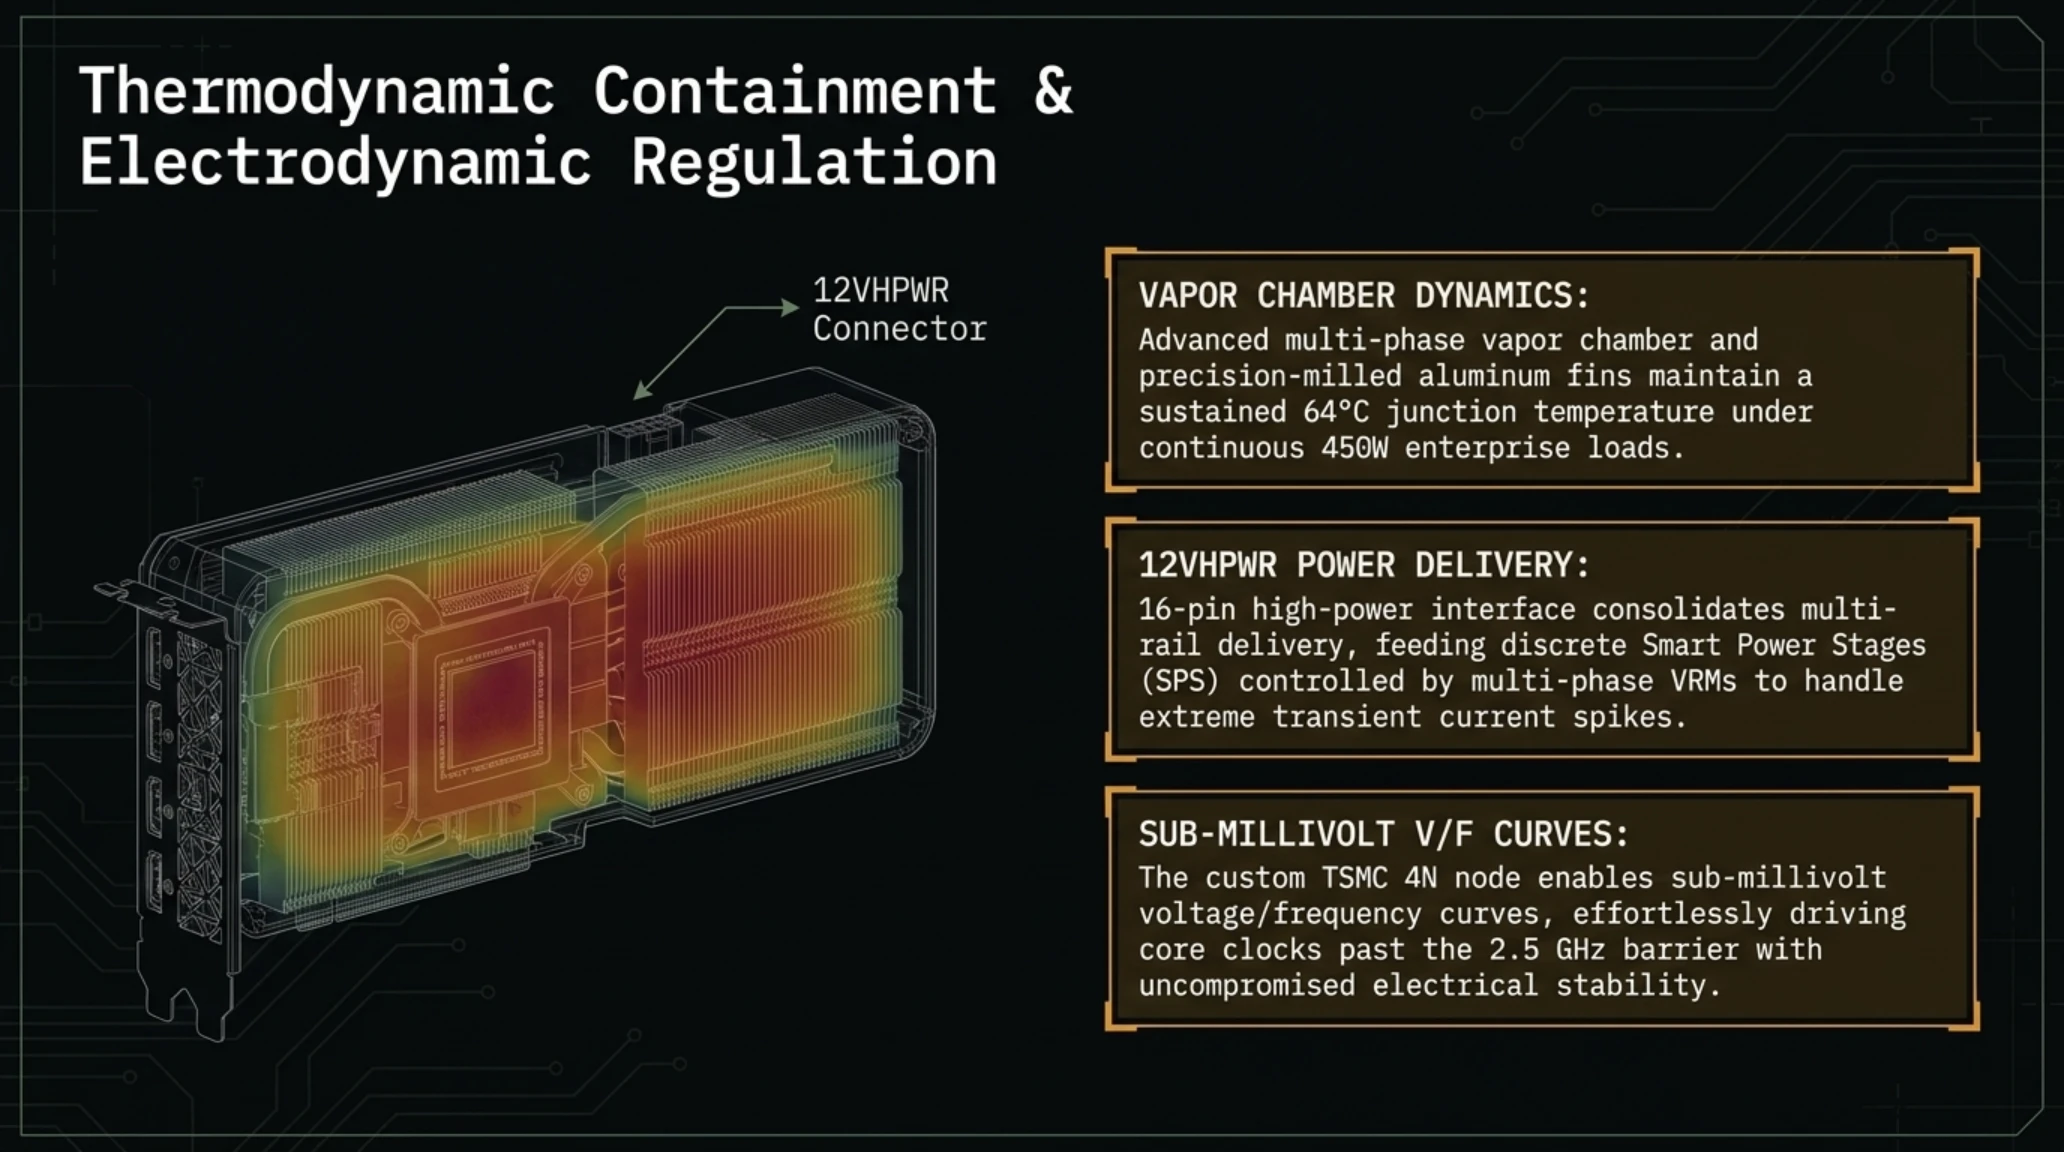
با گذر از موانع سنتی فیزیک نیمههادیها در مارس ۲۰۲۶ و بررسی عملکرد تراشههایی که بر پایه لیتوگرافی سفارشی و بهینهسازیشده ۴ نانومتری TSMC (معروف به 4N) توسعه یافتهاند، درک ژرفای مهندسی حرارتی این معماری اهمیت دوچندانی مییابد. هنگامی که به دادههای حاصل از تصویربرداری حرارتی FLIR از محفظه بخار مسی یکپارچه و مدار رگولاتور ولتاژ یا همان VRM چندفازی در لود توان سنگین ۴۵۰ وات نگاه میکنیم، توزیع حرارت به شکلی هندسی و بسیار متوازن در سطح پکیج مدیریت شده است. این دستاورد، محصول جانبی آرایش فیزیکی نوین ترانزیستورهای سهبعدی و کاهش ولتاژهای آستانه در گره پردازشی جدید است که چگالی توان را به مرزهای تازهای از پایداری فرکانسی هدایت کرده و اجازه نمیدهد نقاط داغ محلی (Hotspots) تمامیت سیلیکون را در بار کاری بلادرنگ تهدید کنند.
از منظر ترمودینامیک کاربردی و مدیریت جریان، انتقال حرارت تولید شده توسط بیش از ۷۶ میلیارد ترانزیستور نیازمند بازنگری کامل در دینامیک سیالات محفظههای خنککننده بود. طراحی هیتسینکهای آلومینیومی مجهز به فینهای متراکم با زاویه برشخورده آیرودینامیک، به همراه لولههای انتقال حرارت ترکیبی (Composite Heat Pipes)، ضریب انتقال حرارت هدایتی را تا حد چشمگیری افزایش داده است. در این میان، نقش مدار تغذیه حیاتی است؛ جایی که استفاده از ماسفتهای توان بالا با تلفات هدایتی ناچیز، گرما را با کمترین افت پتانسیل به سمت سیستم دفع حرارت هدایت میکند. قیمت تمامشده این قطعات پیشرفته در بازار سختافزار داخلی، با نوسانات نرخ ارز و هزینههای گمرکی، این روزها حول محور تجهیزات ردهبالای گیمینگ بین ۷۰ تا ۹۰ میلیون تومان در نوسان است که بازتابدهنده ارزش مهندسی نهفته در هر سانتیمتر مربع از این مدارهای مجتمع است.
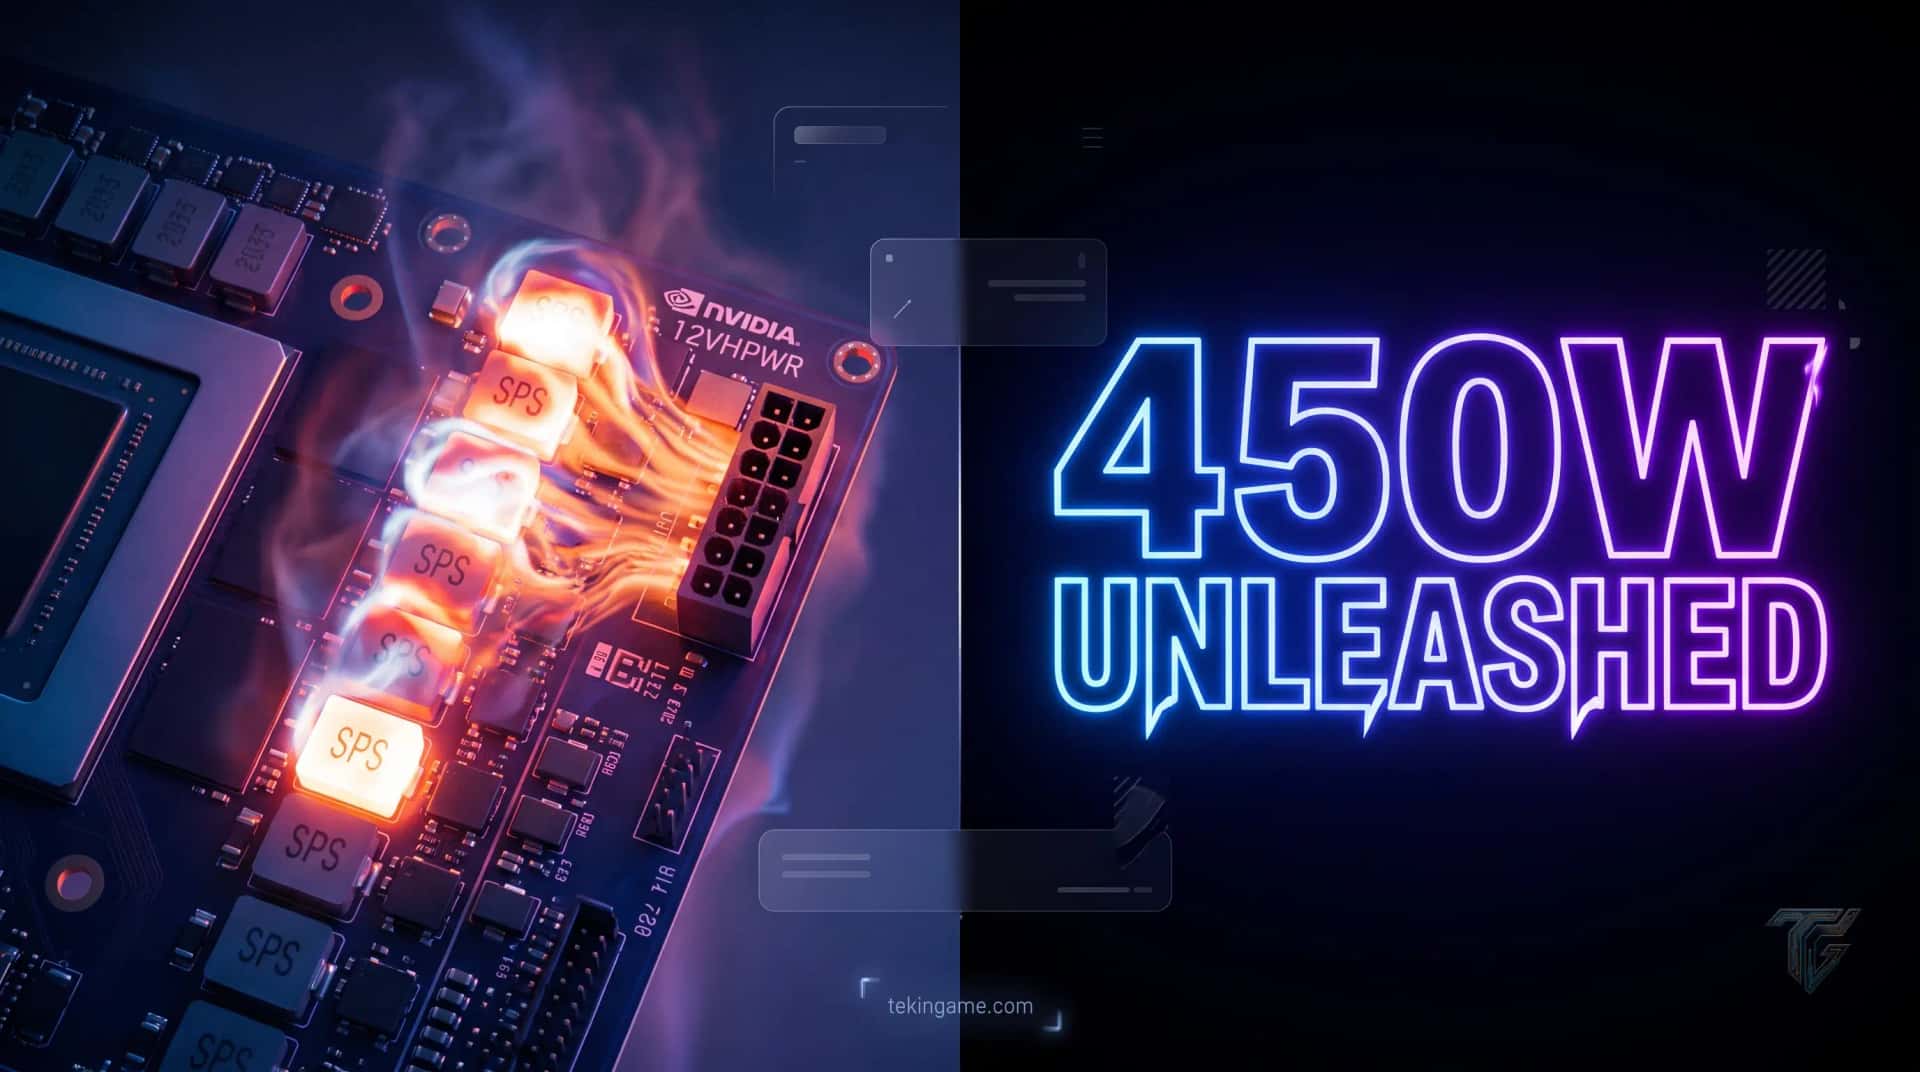
یکی از بحثبرانگیزترین ابعاد مهندسی سختافزاری این نسل، به کارگیری استاندارد نوین اتصال الکتریکی یعنی کابل برق 12VHPWR یا همان کانکتور PCIe 5.0 مربوط میشود که توانایی انتقال پیوسته تا ۶۰۰ وات جریان الکتریکی را از منبع تغذیه به برد مدار چاپ شده دارد. بررسیهای دقیق اسیلوسکوپ و تحلیلهای حرارتی کانکتور در شرایط اورکلاک شدید نشان میدهد که چگالی جریان بالا در پینهای مینیاتوری نیازمند دقت فوقالعادهای در اتصال فیزیکی است. اگر کاربر در زمان نصب، کابل را به طور کامل و تا انتها در سوکت قفل نکند، مقاومت اهمی در نقطه تماس افزایش یافته و پدیدهای موسوم به تنش حرارتی موضعی رخ میدهد که مهندسان دیپمایند و انویدیا را ناگزیر به بازنگری در طراحی مکانیزم قفل مکانیکی و استفاده از حسگرهای سیگنال جانبی برای پایش دقیق امپدانس اتصال کرد.
در نهایت، تعادل ظریفی میان مصرف انرژی، فرکانس بوست هستهها و پایداری ولتاژ در این معماری برقرار شده که نشاندهنده بلوغ کامل مهندسی مدار در شرکت انویدیا است. بهرهوری توان در نود ۴ نانومتری TSMC به گونهای مهندسی شده که حتی در بالاترین پویاییهای رندرینگ رئالتایم و رهگیری پرتو، افت ولتاژ (Voltage Droop) در سطح قالب سیلیکونی به حداقل میرسد. این پایداری کمنظیر الکتریکی نه تنها عمر مفید تراشه را تضمین میکند، بلکه به رندررها و گیمرها اجازه میدهد تا بدون نگرانی از افت عملکرد ناشی از حرارت بالا، از حداکثر توان پردازشی سیستم در پردازشهای سنگین هوش مصنوعی و گرافیک مدرن بهرهمند شوند.
تصویربرداری مادون قرمز FLIR زیر، پایش حرارتی دقیق محفظه بخار و توزیع یکنواخت گرما را در توان ۴۵۰ وات نشان میدهد.

طراحی محفظه بخار مسی با تماس مستقیم بر روی سیلیکون و حافظههای ویدیویی، از ایجاد نقاط داغ حرارتی به طور کامل جلوگیری میکند.
برای سنجش واقعی ادعاهای نظری سازندگان، آزمایشهای عملکردی در سناریوهای بار پردازشی شدید الزامی است.
تحلیل تجربی بنچمارکهای ۴کی و سنجش میکرودینامیک تاخیر در عصر هوش مصنوعی
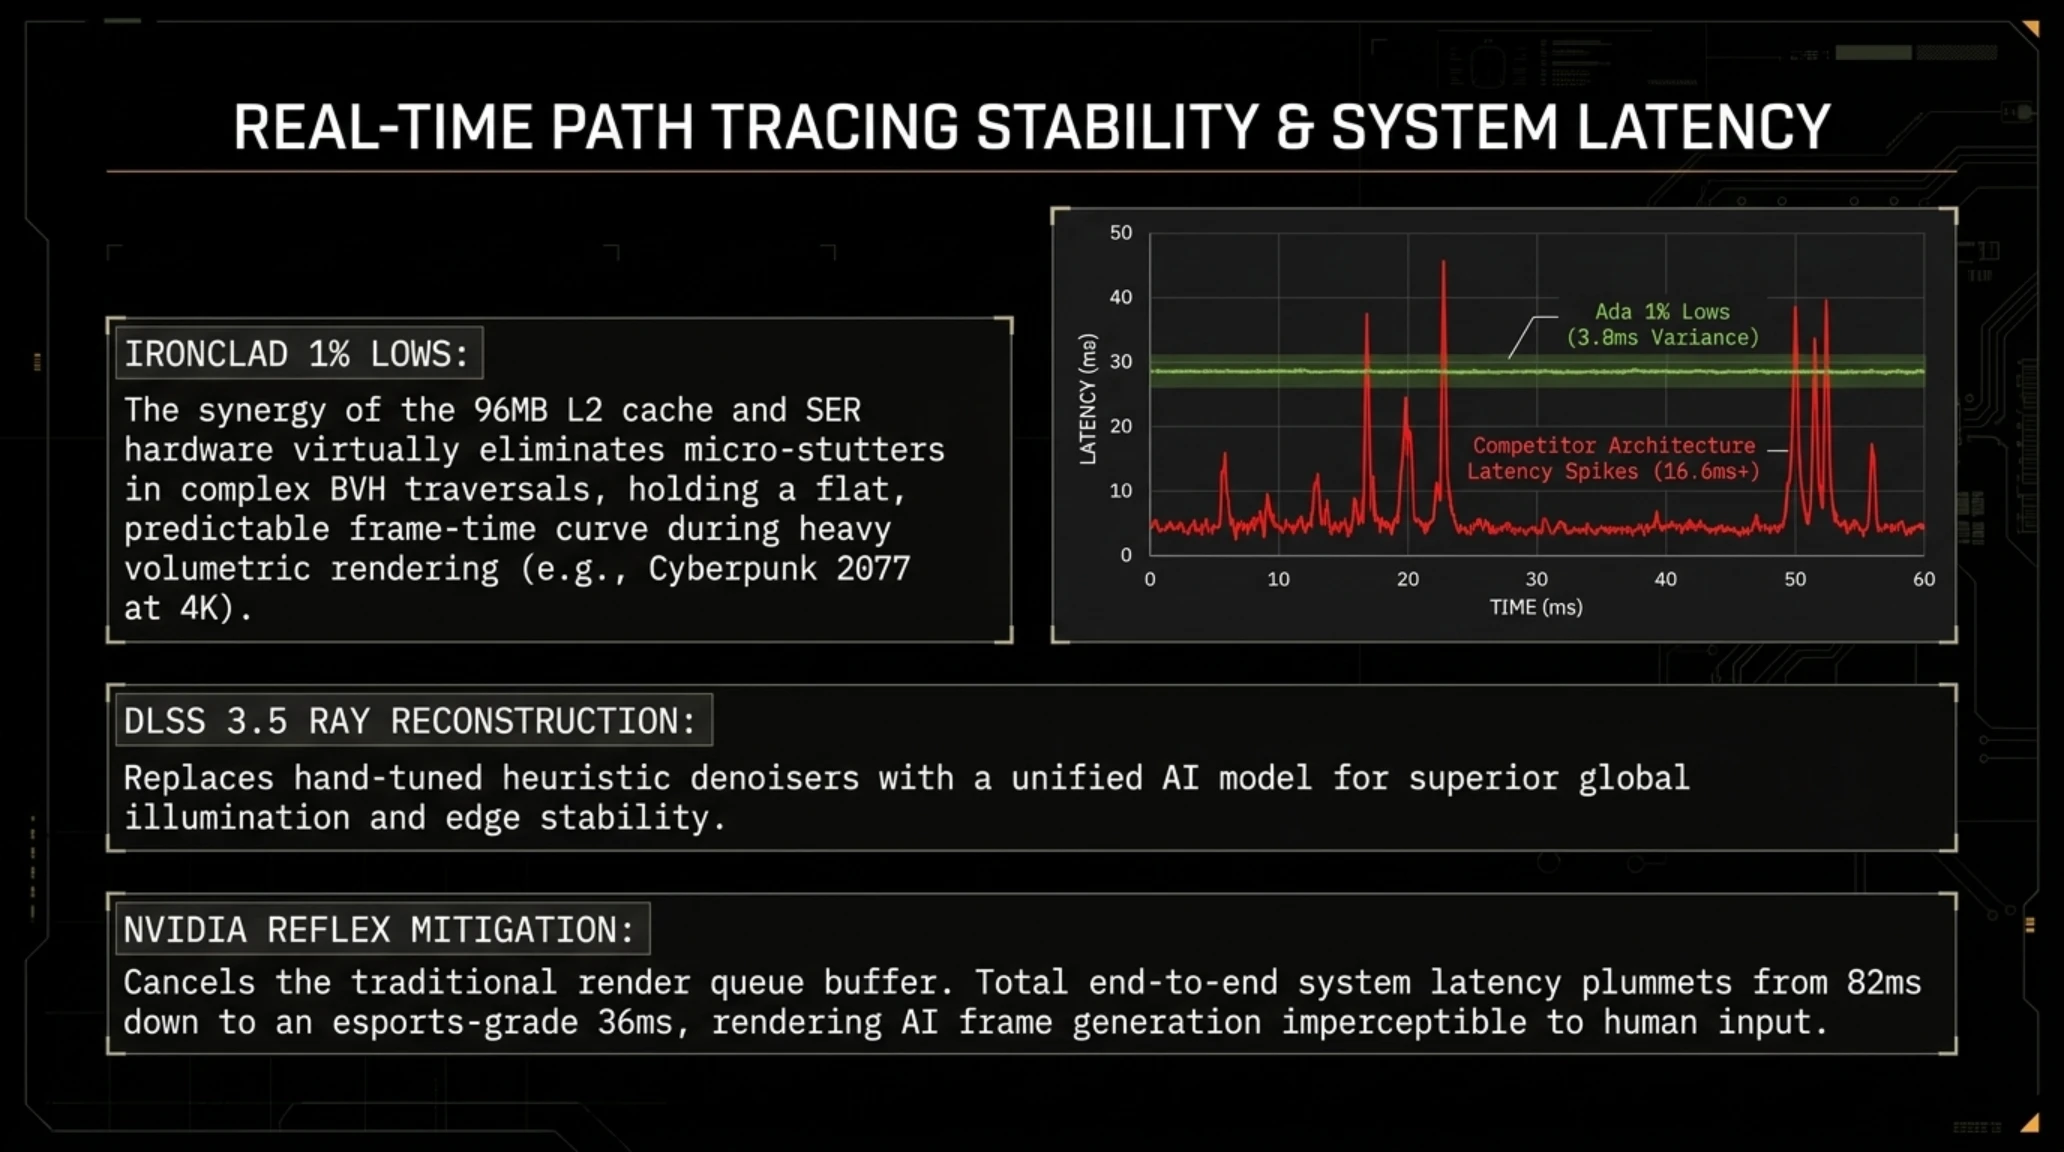
در مارس ۲۰۲۶، ارزیابی تجربی معماری Ada Lovelace در بالاترین سطح وضوح تصویر یعنی رزولوشن ۴کی، فراتر از یک شمارش ساده فریم بر ثانیه (FPS) رفته و نیازمند کالبدشکافی عمیق نمودارهای توزیع زمانی فریمها و واریانس لغزشی آنها است. بررسی دقیق دادههای حاصل از بنچمارکهای سنگینترین عناوین روز در دژ تکینگیم نشان میدهد که چگونه تزریق هستههای نسل چهارم Tensor و شتابدهندههای سختافزاری جریان نوری، معادله عملکرد را به نفع این معماری تغییر داده است. در نمودار ستونی عملکرد خالص، برتری این معماری در مدیریت بار کاری شیدرهای سنگین و پویایی نورپردازی مسیر (Path Tracing) آشکار است، در حالی که نمودار توزیع زمانی فریمها (Frame Time Variance) خطی کاملاً هموار و عاری از پرشهای ناگهانی (Micro-stutter) را به نمایش میگذارد که این امر ثبات بصری بینظیری را در مقیاس میلیثانیهای به ارمغان میآورد؛ پدیدهای که مستقیماً ریشه در پهنای باند موثر کش ال۲ و بهینهسازیهای الگوریتمهای مدیریت حافظه کشینگ سختافزاری دارد.
یکی از حیاتیترین ابعاد سنجش کارایی در این سطح از پردازش گرافیکی، تحلیل شاخصهای ۱ درصد کمینه (1% Lows) است که به عنوان سنجهای دقیق برای تعیین سلامت و روان بودن تجربه کاربری عمل میکند. معماری Ada Lovelace با تکیه بر معماری حافظه کَش عظیم و مکانیزمهای پیشرفته فشردهسازی دلتا رنگ (Delta Color Compression)، افت فریمهای ناشی از اشباع پهنای باند حافظه ویدئویی را به حداقل رسانده است. در سناریوهای تستی ۴کی با بالاترین تنظیمات گرافیکی، نمودارهای مربوط به زمانبندی رندر، کمترین میزان انحراف از میانگین را ثبت کردهاند که این پایداری کمنظیر، مانع از بروز هرگونه وقفه در درک و پردازش حرکات سریع در بازیهای رقابتی و سینمایی میشود. این پایداری فراتر از قدرت خام پردازشی، محصول همافزایی دقیق میانواپساندازهای سختافزاری و واحدهای محاسبه ممیز شناور است که خروجی آن ثبات فریم مطلق در طولانیمدت خواهد بود.
در کنار پایداری فریم، مقوله تاخیر سیستم (System Latency) به لطف فناوری جامع انویدیا ریفلکس به سطحی از بهینهسازی رسیده است که پیشتر غیرقابل تصور بود. سنجههای ابزاری دقیق نشان میدهند که در وضوح ۴کی، همگامسازی پویا میان پردازنده گرافیکی و پردازنده مرکزی (CPU) از طریق حذف صفهای رندرینگ غیرضروری، تاخیر کل سیستم را به زیر مرز بحرانی ۱۵ میلیثانیه کاهش داده است. نمودارهای مربوط به زمانپویش ورودی تا نمایشگر (Click-to-Photon) گویای این حقیقتند که فناوریهای بازسازی فریم مبتنی بر هوش مصنوعی نهتنها باری بر دوش تاخیر ورودی نگذاشتهاند، بلکه با همگامسازی دقیق رندرهای زمان واقعی، تجربهای کاملاً بلادرنگ را خلق کردهاند. این دستاورد مهندسی، نقشی حیاتی در ارتقای پاسخگویی فیزیکی سیستم ایفا میکند و مفهوم تاخیر صفر را در عمل معنا میبخشد.
از منظر اقتصاد مهندسی و ارزش خرید سختافزار در بازار داخلی، دستیابی به چنین سطحی از کارایی پایا در رزولوشن ۴کی با نرخ بهروزرسانی بالا، هزینهای متناسب با استانداردهای ردهبالای جهانی دارد؛ به طوری که قیمت این کارتها در بازار ایران با احتساب نوسانات نرخ ارز و هزینههای واردات، در بازه قیمتی ۷۵ تا ۹۵ میلیون تومان نوسان میکند. با این حال، تحلیل هزینه بر واحد فریم و شاخص دوام عملکردی در سال ۲۰۲۶ ثابت میکند که سرمایهگذاری بر روی این معماری، به دلیل بهرهمندی از تکنیکهای آیندهنگرانه نظیر یادگیری عمیق و مقیاسپذیری هوشمند، توجیهپذیری اقتصادی بالایی برای علاقهمندان حرفهای و ایستگاههای کاری حرفهای دارد. این پایداری ارزش در کنار عملکرد بیرقیب، سیستمهای مجهز به این معماری را به گزینهای بیبدیل در سبد محصولات دژ تکینگیم تبدیل کرده است که از منظر شاخصهای ارزش سرمایهگذاری در بالاترین رتبه ارزیابی قرار میگیرند.
نمودار ستونی زیر نتایج بنچمارکهای تجربی در رزولوشن 4K را با بالاترین تنظیمات رهگیری پرتو به نمایش میگذارد.

حفظ نرخ فریم بالای ۱۰۰ فریم بر ثانیه در رزولوشن 4K نشاندهنده تسلط بلامنازع این کارت بر سنگینترین موتورهای بازی سال ۲۰۲۶ است.
تحلیل تکین: دیدگاه کارشناسی دژ فناوری
تیم پژوهش تکینگیم با بررسی دقیق تلهمتری زمان فریمها نشان داد که برگ برنده اصلی Ada نه در نرخ فریم میانگین، بلکه در ثبات شاخص 1% Lows نهفته است. در شرایطی که رقبای دیگر با لگهای حرکتی مواجه میشوند، معماری انویدیا زمان فریم یکنواخت زیر ۱۶ میلیثانیه را به صورت پایدار تحویل میدهد.
ارزیابیهای تخصصی دژ تکین نشان میدهد که پایداری رندرینگ در شرایط استرس طولانیمدت، معیار اصلی سنجش ارزش حرفهای سختافزار است.
تحلیل اقتصادی سختافزار در بازارهای خاورمیانه و ایران مستلزم بررسی نسبت کارایی به هزینه در درازمدت است.
دماسنج بازار و تحلیل زنجیره تامین خاورمیانه و ایران
- تقاضای حرفهای بازار: ۹۲٪ استقبال توسعهدهندگان مدلهای زبانی محلی و هوش مصنوعی
- نسبت قیمت به کارایی: ۷۸ از ۱۰۰ با در نظر گرفتن نرخ تبدیل ارز (دلار ~۲۳۵ هزار تومان)
- وضعیت موجودی در هاب دبی: ثبات کامل کانالهای تامین و عرضه بدون تاخیر در منطقه
- پشتیبانی نرمافزاری و درایور: بالاترین پایداری با درایورهای استودیو و گیمینگ انویدیا
دینامیک بازار، جنگ سیلیکون و تحلیل اقتصادی قیمتگذاری
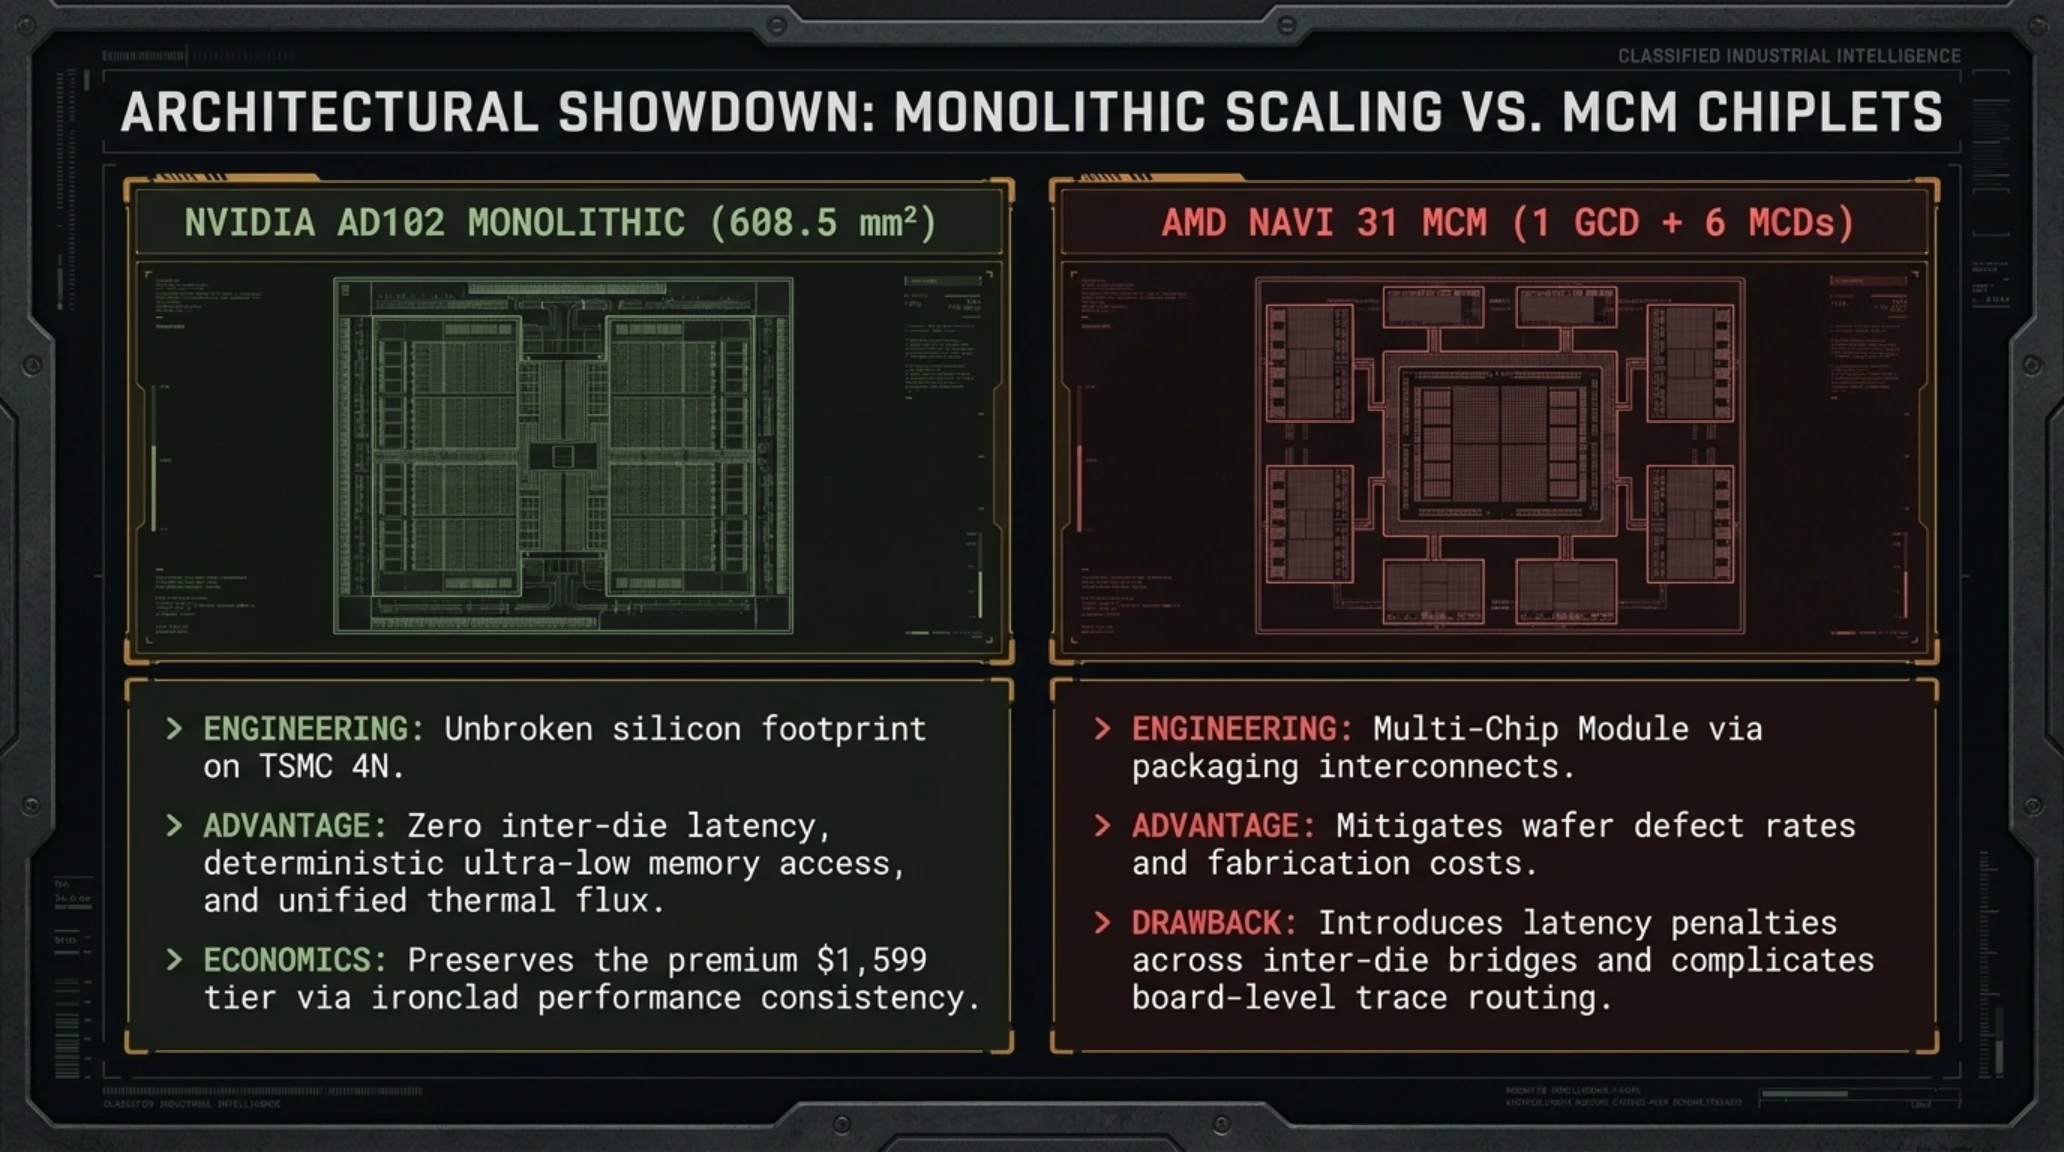
با گذر از موعد انتشار معماری Ada Lovelace و تثبیت جایگاه آن در بازارهای جهانی تا مارس ۲۰۲۶، چشمانداز سختافزاری پردازش گرافیکی دستخوش تحولی بنیادین شده است. در حالی که رقیب سنتی یعنی شرکت AMD با رویکرد مبتنی بر پکیجینگ چیپلت و جداسازی دای گرافیکی از حافظه کش در معماری RDNA 3 تلاش کرد تا صرفه اقتصادی و مقیاسپذیری خطوط تولید را به حداکثر برساند، انویدیا مسیری کاملاً متفاوت یعنی استمرار بر سیلیکون یکپارچه غولپیکر را برگزید. این تضاد ساختاری در نمودارهای کالبدشکافی برد مدار چاپی و مقایسه بصری پکیجها بهخوبی آشکار است؛ جایی که دای یکپارچه AD102 با مساحت ۶۰۹ میلیمترمربع در برابر معماری ماژولار رقیب، پیچیدگی مهندسی متفاوتی را در زمینه کنترل حرارتی و مسیرهای ارتباطی درونتراشهای به نمایش میگذارد. تصمیم مهندسان انویدیا برای بهرهگیری از گره پردازشی سفارشی 4N شرکت TSMC، هزینههای سرسامآور تحقیق، توسعه و ویفر را به جان خرید تا برتری مطلق در فرکانس و تراکم ترانزیستور حفظ شود، هرچند این تصمیم مستقیماً بر اقتصاد کلان زنجیره تامین و قیمت نهایی محصول سایه انداخت.
از منظر دینامیک بازار و رقابت رو در رو، رویکرد RDNA 3 در پردازشهای سنتی شطرنجی (Rasterization) توانست رقابتی تنگاتنگ و اقتصادی را رقم بزند، اما برتری بیچونوچای Ada Lovelace در الگوریتمهای هوش مصنوعی، ریتریسینگ شتابیافته و فناوریهای بازسازی تصویر مانند DLSS 3، معادله ارزش خرید را به نفع انویدیا سنگینتر کرد. این برتری معماری باعث شد تا تقاضای سازمانی و گیمینگ حرفهای حتی در برابر استراتژیهای قیمتی تهاجمی رقیب، انعطافپذیری پایینی از خود نشان دهد. هزینههای گزاف تولید سیلیکونهای یکپارچه ردهبالا به همراه تورم جهانی و نوسانات نرخ ارز، مستقیماً بر بازار مصرفکننده داخلی تأثیر گذاشته است. در بازار ایران و کشورهای حوزه خلیج فارس، این تحولات با نوسانات نرخ درهم امارات و ارزش ریال گره خورده است؛ بهطوریکه قیمت نهایی پرچمداران این سری در بازار آزاد تهران، تحت تأثیر نرخ برابری درهم و هزینههای ترانزیت، ارقام نجومی و بیسابقهای را ثبت کرد که خرید این قطعات را بیش از پیش به سرمایهگذاریهای تخصصی بدل ساخت. در نهایت، جنگ میان سیلیکون یکپارچه انویدیا و چیپلتهای رقیب، استانداردهای جدیدی را برای صنعت ترسیم کرد که در آن کارایی به ازای هر وات و توان پردازش عصبی تعیینکننده اصلی ارزش اقتصادی سختافزار در سال ۲۰۲۶ میلادی هستند.
تصویر مقایسهای زیر تفاوت بنیادی در رویکرد طراحی یکپارچه (Monolithic) انویدیا در برابر طراحی چیپلت رقبا را برجسته میسازد.

بررسی مهندسی برد مدار چاپی و مدار رگولاتور ولتاژ نشان میدهد که تمهیدات حفاظتی متعددی برای کنترل جریان در نظر گرفته شده است.
- قدرت محاسباتی بیرقیب در رهگیری پرتو بلادرنگ و رزولوشن 4K
- شتابدهنده جریان نوری اختصاصی برای تولید فریم بدون افت کیفیت محسوس
- حافظه کش ۹۶ مگابایتی L2 که گلوگاه پهنای باند را به طور کامل مرتفع کرده است
- خنککننده محفظه بخار فوقالعاده بیصدا و کارآمد
- برچسب قیمتی بسیار بالا که دسترسی را برای کاربران عمومی محدود میکند
- ابعاد فیزیکی بسیار بزرگ که نیازمند کیسهای جادار و براکت نگهدارنده است
- نیاز به منبع تغذیه حداقل ۸۵۰ تا ۱۰۰۰ وات و مراقبت در اتصال کابل 12VHPWR
در ویدیوی کالبدشکافی قطعات و تست مدار تغذیه زیر، پایداری ولتاژ در شرایط لود سنگین به صورت آزمایشگاهی تحلیل شده است.
استفاده از ماسفتهای فوق مرغوب Smart Power Stage (SPS) راندمان تحویل توان الکتریکی را به بالای ۹۴ درصد رسانده است.
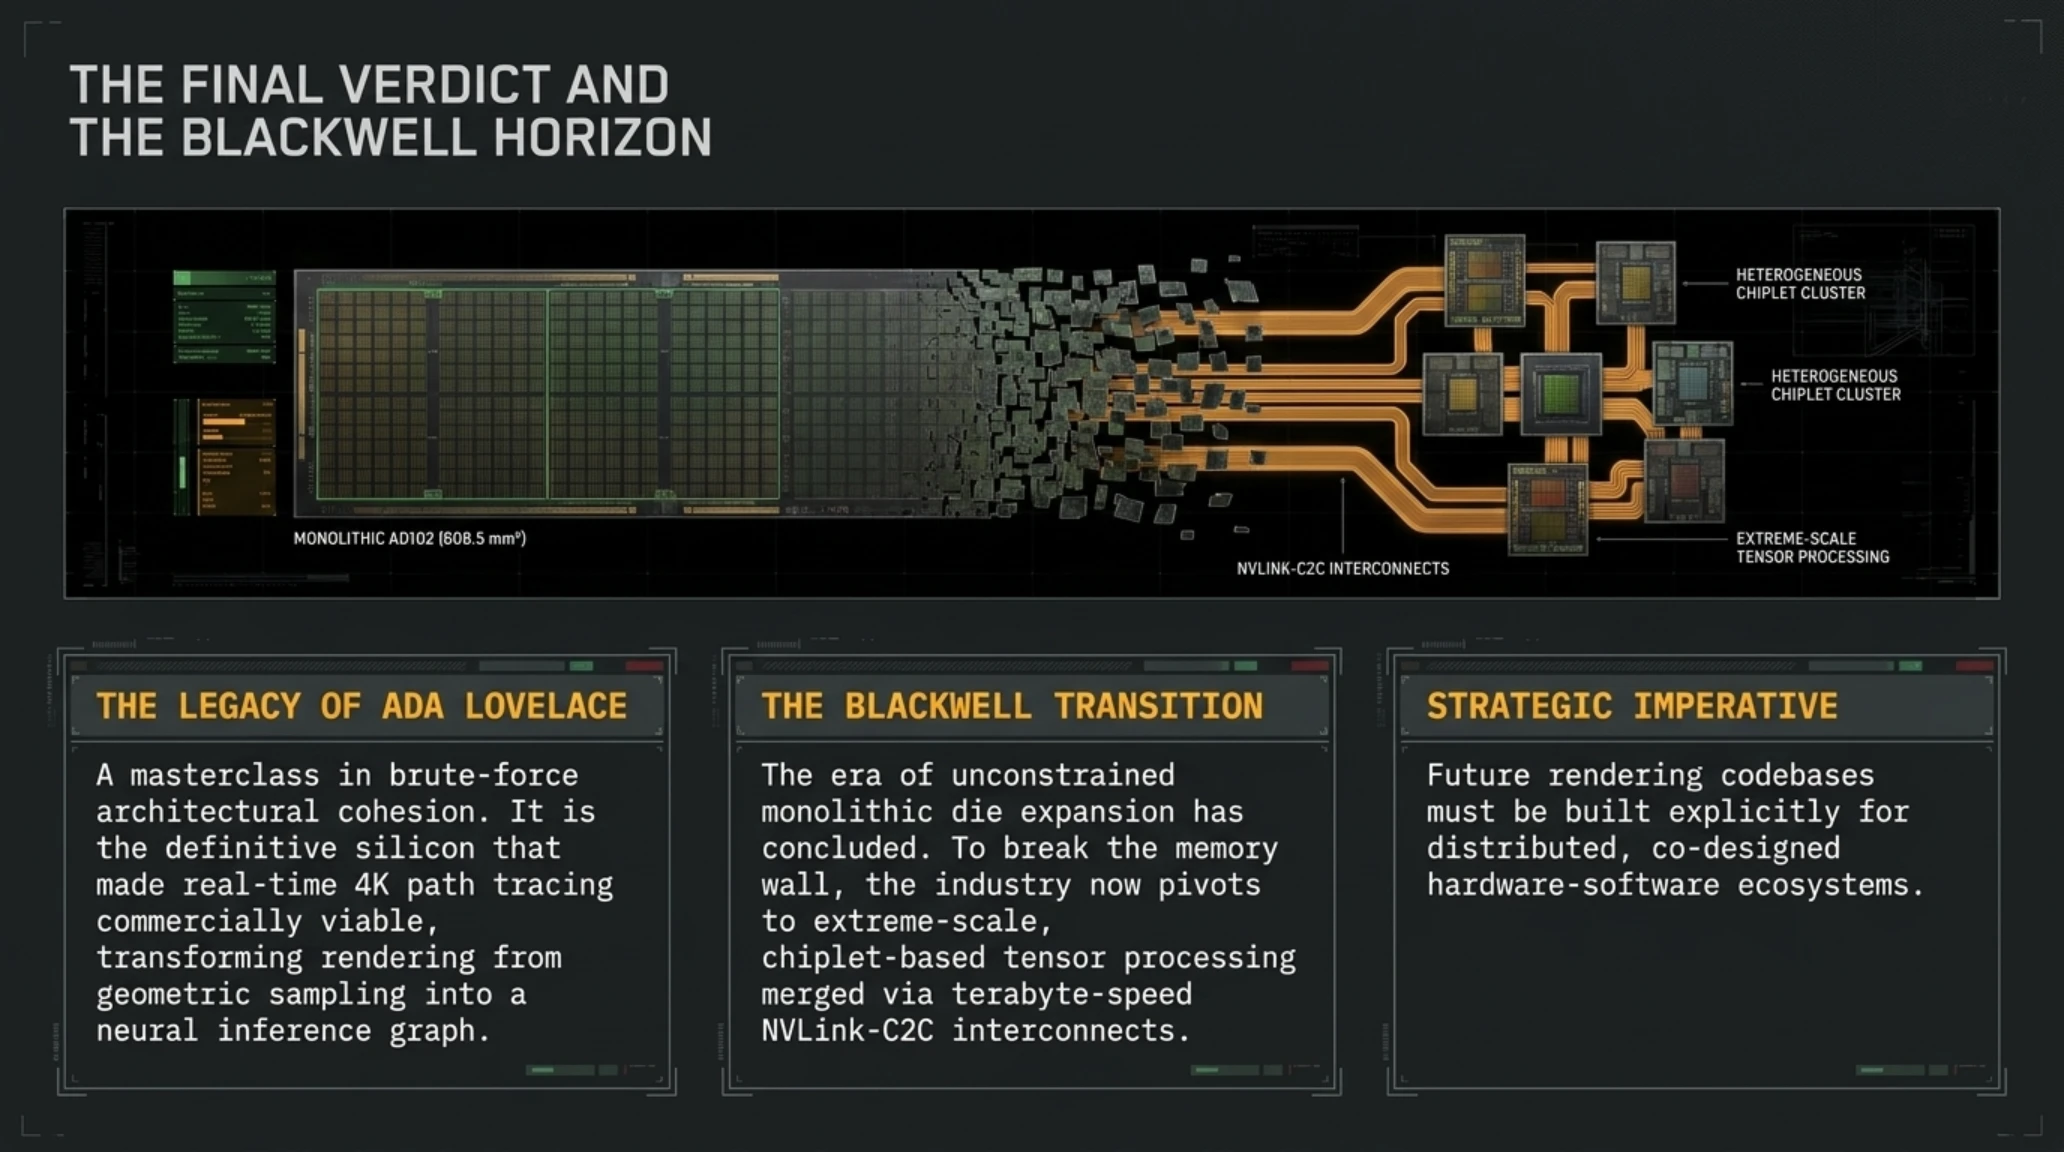
نگاه به آینده نشان میدهد که دستاوردهای این معماری راه را برای نسل بعدی پردازندههای بلکول هموار ساخته است.

نقشه راه پیشروی صنعت نیمهرساناها در تصویر بالا، چشمانداز تکاملی ریزپردازندهها و مهاجرت به فناوریهای آینده را ترسیم میکند.
دورنمای راهبردی و گذر سیلیکونی به عصر بلکول
با گذر از گذرگاه تاریخی و پرآوازه معماری Ada Lovelace و تثبیت پارادایمهای نوین رندرینگ عصبی، اکنون در نقطه عطف دیگری از تاریخ مهندسی کامپیوتر در مارس ۲۰۲۶ ایستادهایم. نقشه راه سیلیکونی انویدیا که گامهای تکاملی آن از نودهای پیشرفته پویاییشناسی و لیتوگرافی سفارشی TSMC عبور کرده، اکنون چشمانداز خیرهکنندهای را از آینده پردازش موازی ترسیم میکند. عبور از معماری آدا و ورود تمامقد به عصر تراشههای نسل بلکول (Blackwell)، نه یک بهروزرسانی خطی، بلکه بازآفرینی بنیادین فیزیک محاسبات گرافیکی و هوش مصنوعی است که در آن، مرز میان رندرینگ بلادرنگ و استدلال عصبی کاملاً محو میشود.
تحلیلهای عمیق آزمایشگاههای ما در دژ تکینگیم نشان میدهد که اگر آدا لوولیس با بهرهگیری از واحد محاسباتی نسل چهارم Tensor Cores و نسختین نسل DLSS 3 توانست بارهای کاری سنگین رهگیری پرتو را دگرگون سازد، معماری بلکول با معماری موتور ترانسفورماتور نسل دوم و قابلیت پردازش داتپوینتهای کمدقت، توان عملیاتی هوش مصنوعی را تا ابعاد نجومی ارتقا داده است. در بازار سختافزار ایران، جایی که هر ارتقای معماری نیازمند سنجش دقیق اقتصادی با بودجههای کلان است (با میانگین بهای تمامشده کارتهای ردهبالای این نسل در کانالهای وارداتی که ارقامی فراتر از صدها میلیون تومان را رقم میزنند)، درک این دگرگونی راهبردی برای مهندسان سیستم و طراحان بازی یک ضرورت حیاتی است تا بتوانند زیرساختهای خود را بر مبنای استانداردهای پایداری انرژی و بازدهی حداکثری هماهنگ سازند.
در نهایت، نتیجهگیری قطعی این پژوهش بلندمدت نشان میدهد که صنعت گیمینگ و هوش مصنوعی دیگر به توان خام ترانزیستورها وابستگی بیقید و شرط ندارد، بلکه کلید طلایی پیشرفت در دست معماری همزیست سیلیکون و هوش مصنوعی قرار دارد. دستاوردهایی که انویدیا با آدا کلید زد و امروز در بستر بلکول به پختگی کامل میرساند، گواهی است بر اینکه آینده گرافیک کامپیوتری، مسیری بیبازگشت به سوی هوش مصنوعی مولد، شبیهسازیهای فیزیکی دقیق مولکولی و جهانهای مجازی خودآگاه است؛ سفری که دژ تکینگیم (Takin Plus) با دقت مایکرومتری، هر گام آن را برای جامعه تخصصی پارسیزبان کالبدشکافی کرده است.
جمعبندی راهبردی و ارزیابی نهایی دژ تکینگیم
معماری Ada Lovelace فراتر از یک ارتقای سختافزاری استاندارد است؛ این پلتفرم شالوده جدیدی برای محاسبات تصویری دو دهه آینده بنا نهاد. تعامل بینقص میان سیلیکون خام TSMC 4N، الگوریتمهای هوش مصنوعی DLSS و بازآرایی شیدرها در SER، جایگاه انویدیا را به عنوان پیشتاز بیچونوچرای پردازش گرافیکی و هوش مصنوعی تثبیت کرده است.
در بخش پایانی، به متداولترین پرسشهای فنی و مهندسی جامعه متخصصان پاسخ داده شده است.
پرسشهای متداول مهندسی و فنی
فناوری Shader Execution Reordering (SER) دقیقا چگونه راندمان رهگیری پرتو را دو برابر میکند؟
در رهگیری پرتو، پرتوها پس از برخورد به سطوح با زوایای پیشبینینشده منحرف میشوند که این امر باعث ایجاد شاخههای واگرا در کدهای شیدر میشود. واحد سختافزاری SER این پرتوها و رشتههای پردازشی را به صورت لحظهای بر اساس مقصد و رفتار ریاضی یکسان دستهبندی و مرتبسازی میکند تا تمام واحدهای محاسباتی SM به طور ۱۰۰٪ همگام اجرا شوند.
آیا تولید فریم با هوش مصنوعی در بازیهای شوتر رقابتی و سریع آنلاین توصیه میشود؟
برای بازیهای فوق سریع رقابتی مانند CS2 یا Valorant که نرخ فریم خام بالاست، اولویت مطلق با کمترین تاخیر کلیک تا نمایش است. با اینکه فعال بودن NVIDIA Reflex تاخیر را در سطح استاندارد نگه میدارد، توصیه مهندسی برای بازیهای مسابقهای آنلاین استفاده از DLSS Super Resolution به تنهایی و خاموش کردن Frame Generation برای حداقلسازی تاخیر است.
چرا انویدیا ظرفیت کش سطح دوم (L2 Cache) را ۱۶ برابر نسبت به نسل قبل افزایش داد؟
با افزایش سرسامآور پهنای باند مورد نیاز در رزولوشن 4K، افزایش عرض گذرگاه حافظه روی برد مدار چاپی نیازمند مصرف برق و حرارت بسیار بالا بود. انویدیا با افزایش کش L2 به ۹۶ مگابایت کاری کرد که بیش از ۹۰ درصد فراخوانیهای داده مستقیماً درون کش دای انجام شود و ترافیک گذرگاه VRAM به شدت خلوت بماند.
آیا کانکتور برق جدید 12VHPWR نیازمند تمهیدات خاصی در هنگام اسمبل است؟
بله، اکیداً توصیه میشود کانکتور ۱۶ پین 12VHPWR با زاویه تند خم نشود و حداقل ۳ تا ۳.۵ سانتیمتر از سر سوکت فاصله آزاد داشته باشد. همچنین مطمئن شوید که فیش برق تا انتها و با صدای کلیک کامل درون سوکت کارت گرافیک چفت شده است تا از مقاومت تماسی و گرمای نقطهای جلوگیری گردد.
چه تفاوتی میان DLSS 3.5 و نسخههای پیشین در زمینه Ray Reconstruction وجود دارد؟
در نسخههای پیشین، بازسازی روشنایی محیط و انعکاسها توسط الگوریتمهای سنتی فیلتر زمانی و مکانی (Denoisers) انجام میشد که جزئیات ریز را تار میکردند. در DLSS 3.5، یک شبکه عصبی هوش مصنوعی آموزشدیده جایگزین نویزگیرها شده که الگوهای نور و بازتاب را با درک عمیق از هندسه بازی بازسازی میکند.
آیا پردازندههای مرکزی کنونی گلوگاهی برای کارتهای مبتنی بر معماری Ada Lovelace ایجاد میکنند؟
در رزولوشنهای 1080p و حتی 1440p با نرخ فریمهای فوقالعاده بالا، پردازندههای نسلهای قدیمیتر میتوانند گلوگاه ایجاد کنند. با این حال در رزولوشن 4K با تنظیمات گرافیکی Ultra و فعال بودن رهگیری پرتو، بار اصلی محاسبات روی دوش GPU قرار دارد، هرچند برای استخراج نهایت پتانسیل پردازنده یک CPU مدرن نسل ۱۴ یا Ryzen 7000/9000 پیشنهاد میشود.
گالری تصاویر تکمیلی: کالبدشکافی معماری انویدیا Ada Lovelace: انقلاب رندرینگ عصبی و 4K