تکین ورسس | کالبدشکافی تقابل LLMها و معماری تصمیمگیری Jev
کالبدشکافی زلزله زیرساختی TypeSafe AI و معرفی مدل Jev برای پایان دوران اضافهبار مدلهای زبانی در خطوط تولید نرمافزار.
- 🎮هوش مصنوعی سیستم ۱- جایگزینی حدس متوالی کلمات با تصمیمگیری آنی در یک دور رفت
- 🎧حذف کامل پدیده توهم- تولید خروجی ساختاریافته در قالب Noul، Choice و Score
- 🚀سقوط ۹۹٪ هزینههای ابری- نرخ ۰.۰۴۲ دلار برای هر میلیون توکن ورودی و خروجی کاملاً رایگان
- 🗡️تاخیر زیر ۱۰۰ میلیثانیه- واکنش فوقسریع ۷۰ تا ۳۵۰ میلیثانیه در لبه شبکه و وب بلادرنگ
- 📰بنیانگذاران نخبه- رهبری دیوگو آلمیدا از معماران ارشد RLHF و چتجیپیتی در OpenAI
- ⚔️معماری هیبریدی پایدار- همکاری هماهنگ مدلهای سیستم ۱ و سیستم ۲ در مقیاس سازمانی
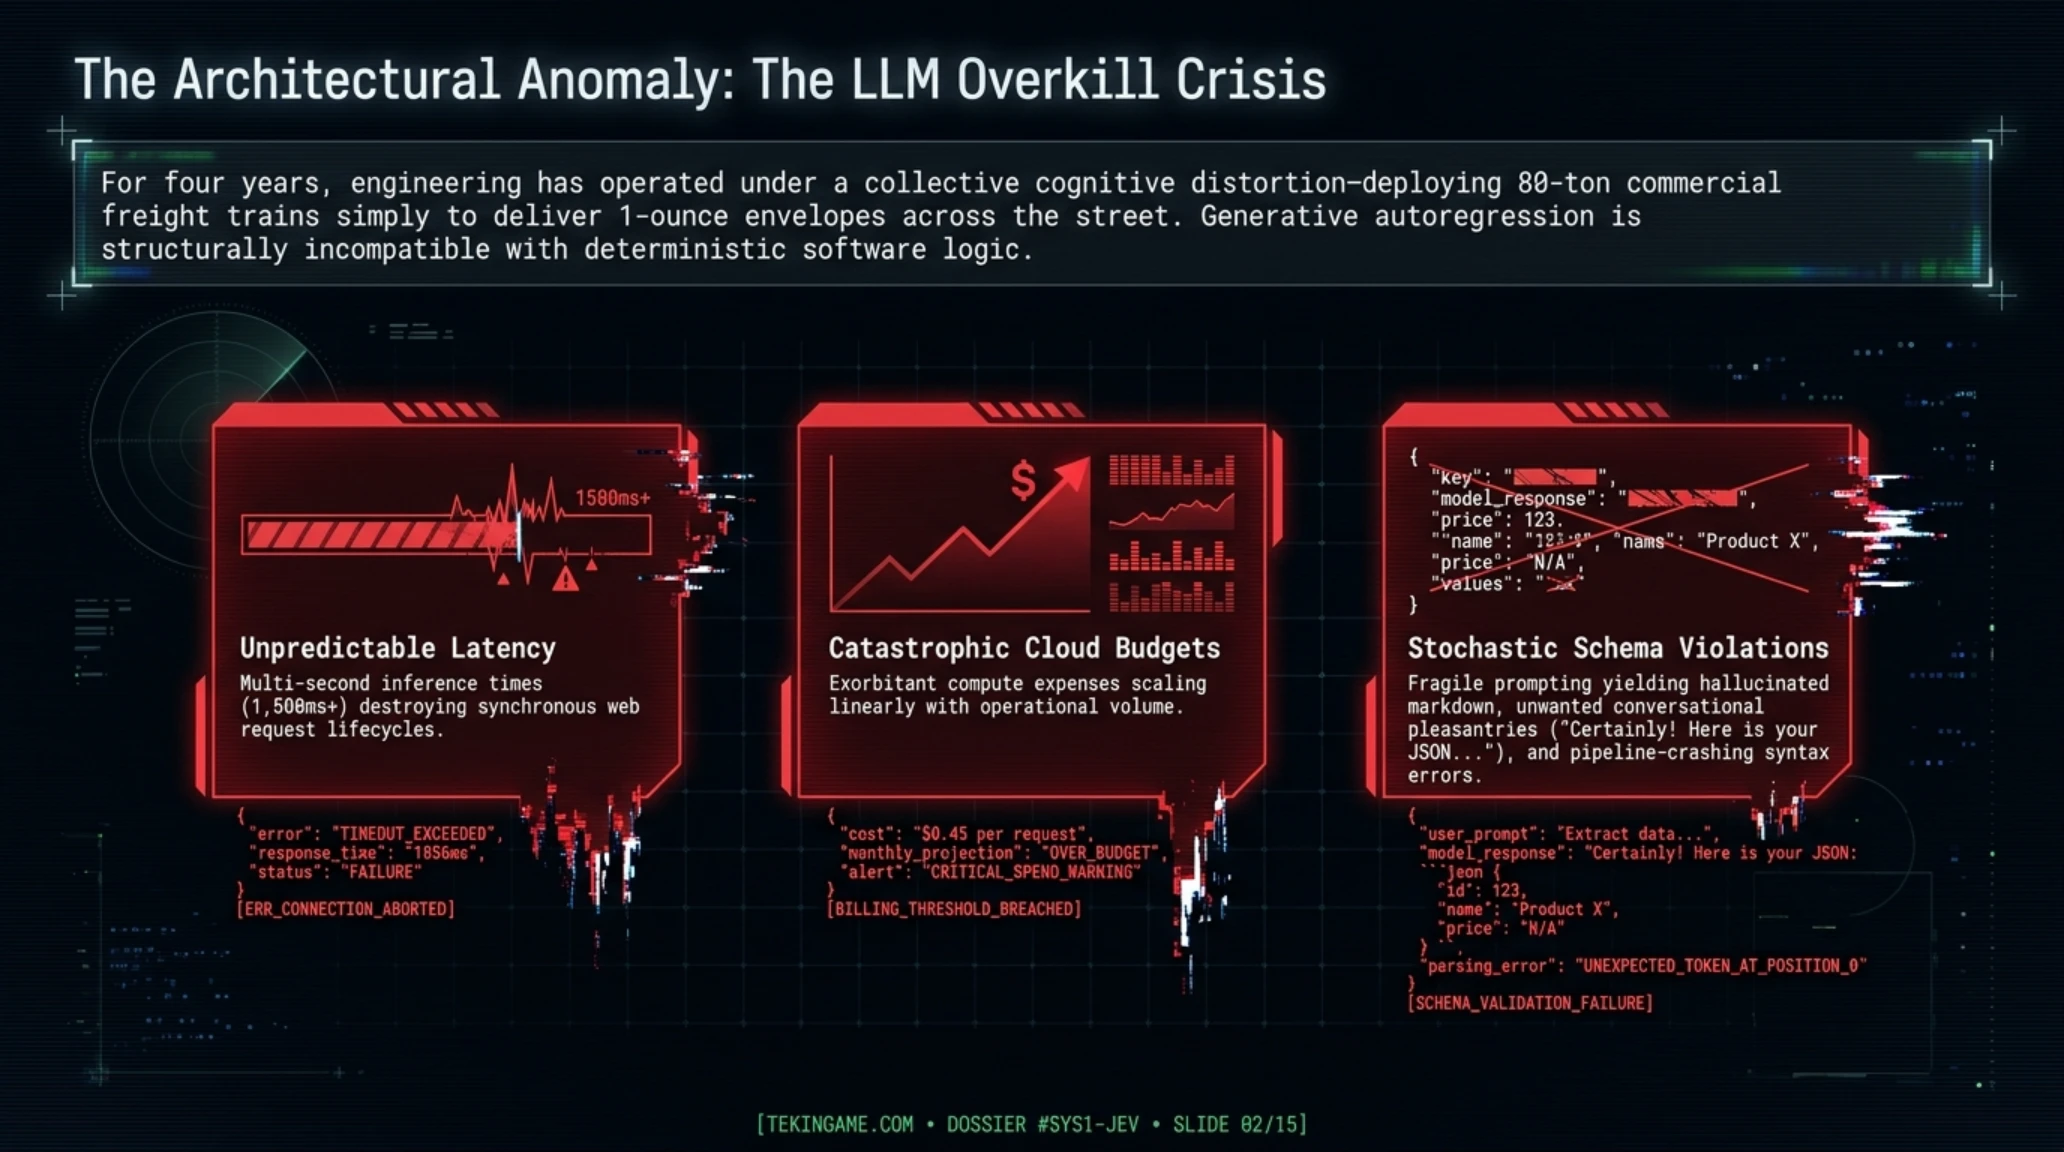
در سالهای اخیر، صنعت فناوری در چرخهای فرسایشی از شیفتگی افراطی نسبت به مدلهای زبانی بزرگ (LLMs) گرفتار شده است. شرکتها و مهندسان نرمافزار برای هر چالش محاسباتی و منطقی، از تریاژ ساده تیکتهای پشتیبانی گرفته تا مسیریابی ابزارها و کشف تقلب، بیدرنگ به سراغ غولهای چند ده میلیارد پارامتری مانند GPT-4 و Claude و Gemini رفتند. اما واقعیت میدانی استقرار این سامانهها در مقیاس سازمانی، چهره دیگری از ماجرا را آشکار کرد: هزینههای سرسامآور رایانش ابری، تاخیرهای مرگبار چندثانیهای، و کابوس مداوم شکستن ساختارهای دادهای و توهم مدلها که مهندسان را وادار میکرد با صدها خط پرامپتنویسی التماسآمیز مانع از پاسخهای پرحرف و نامعتبر شوند.
این بنبست مهندسی که امروزه در محافل آکادمیک و فنی از آن به عنوان بحران اضافهبار مدلهای زبانی (LLM Overkill Crisis) یاد میشود، نیازمند یک بازنگری بنیادین در فلسفه هوش ماشین بود. درست در اوج این بحران، استارتاپ TypeSafe AI مستقر در سانفرانسیسکو پس از دو سال فعالیت مخفیانه، با جذب سرمایه خیرهکننده ۴۰ میلیون دلاری در مرحله Seed به رهبری صندوق نامدار DCVC اعلام حضور کرد و نخستین محصول خود را با نام Jev به جهان معرفی نمود. مدلی که ادعا میکند نه برای چت کردن با انسان، بلکه برای اجرای تصمیمگیریهای بومی ماشین با سرعتی تا ۲۰۰ برابر بیشتر و هزینهای تا ۴۰۰ برابر ارزانتر ساخته شده است.
در یک نگاه مقایسه بنیادین LLMها در برابر مدل تصمیمگیری Jev
- شکست انحصار مدلهای اتورگرسیو: تولید مستقیم تصمیمات ساختاریافته در یک دور رفت بدون حلقه کلمه به کلمه.
- حذف توهم در منطق برنامه: خروجی مقید به سه ساختار تایپشده قطعی (Noul/بولین، Choice/انتخاب دستهای، Score/امتیازدهی).
- انقلاب اقتصادی در هزینهها: قیمت ۰.۰۴۲ دلار بر میلیون توکن ورودی همراه با توکنهای خروجی کاملاً رایگان.
- سرعت استثنایی و تاخیر ناچیز: تثبیت پاسخگویی بین ۷۰ تا ۳۵۰ میلیثانیه برای استقرار در لبه شبکه.
- پیشینه نخبگان OpenAI: هدایت علمی توسط دیوگو آلمیدا پدیدآورنده همراستاسازی RLHF.
- معماری هیبریدی آینده: کاهش ۸۰ درصدی بار پردازشی LLMها با گماردن Jev در خط مقدم تریاژ.
برای درک عظمت این تحول، باید به این حقیقت اعتراف کرد که توسعهدهندگان در چند سال گذشته ناچار بودند از یک تریلی هجده چرخ پرمصرف برای جابجایی یک پاکت نامه اداری استفاده کنند. هر زمان که یک سامانه نیازمند یک پاسخ باینری ساده بود، صدها مگابایت وزن لایههای نورونی فعال میشدند تا متنی طولانی ببافند که در نهایت باید توسط یک ماژول Regex استخراج میشد؛ رویهای که با ظهور Jev به تاریخ پیوسته است.

خروج TypeSafe AI از سایه؛ خیزش یاران سابق OpenAI علیه امپراتوری چتباتها
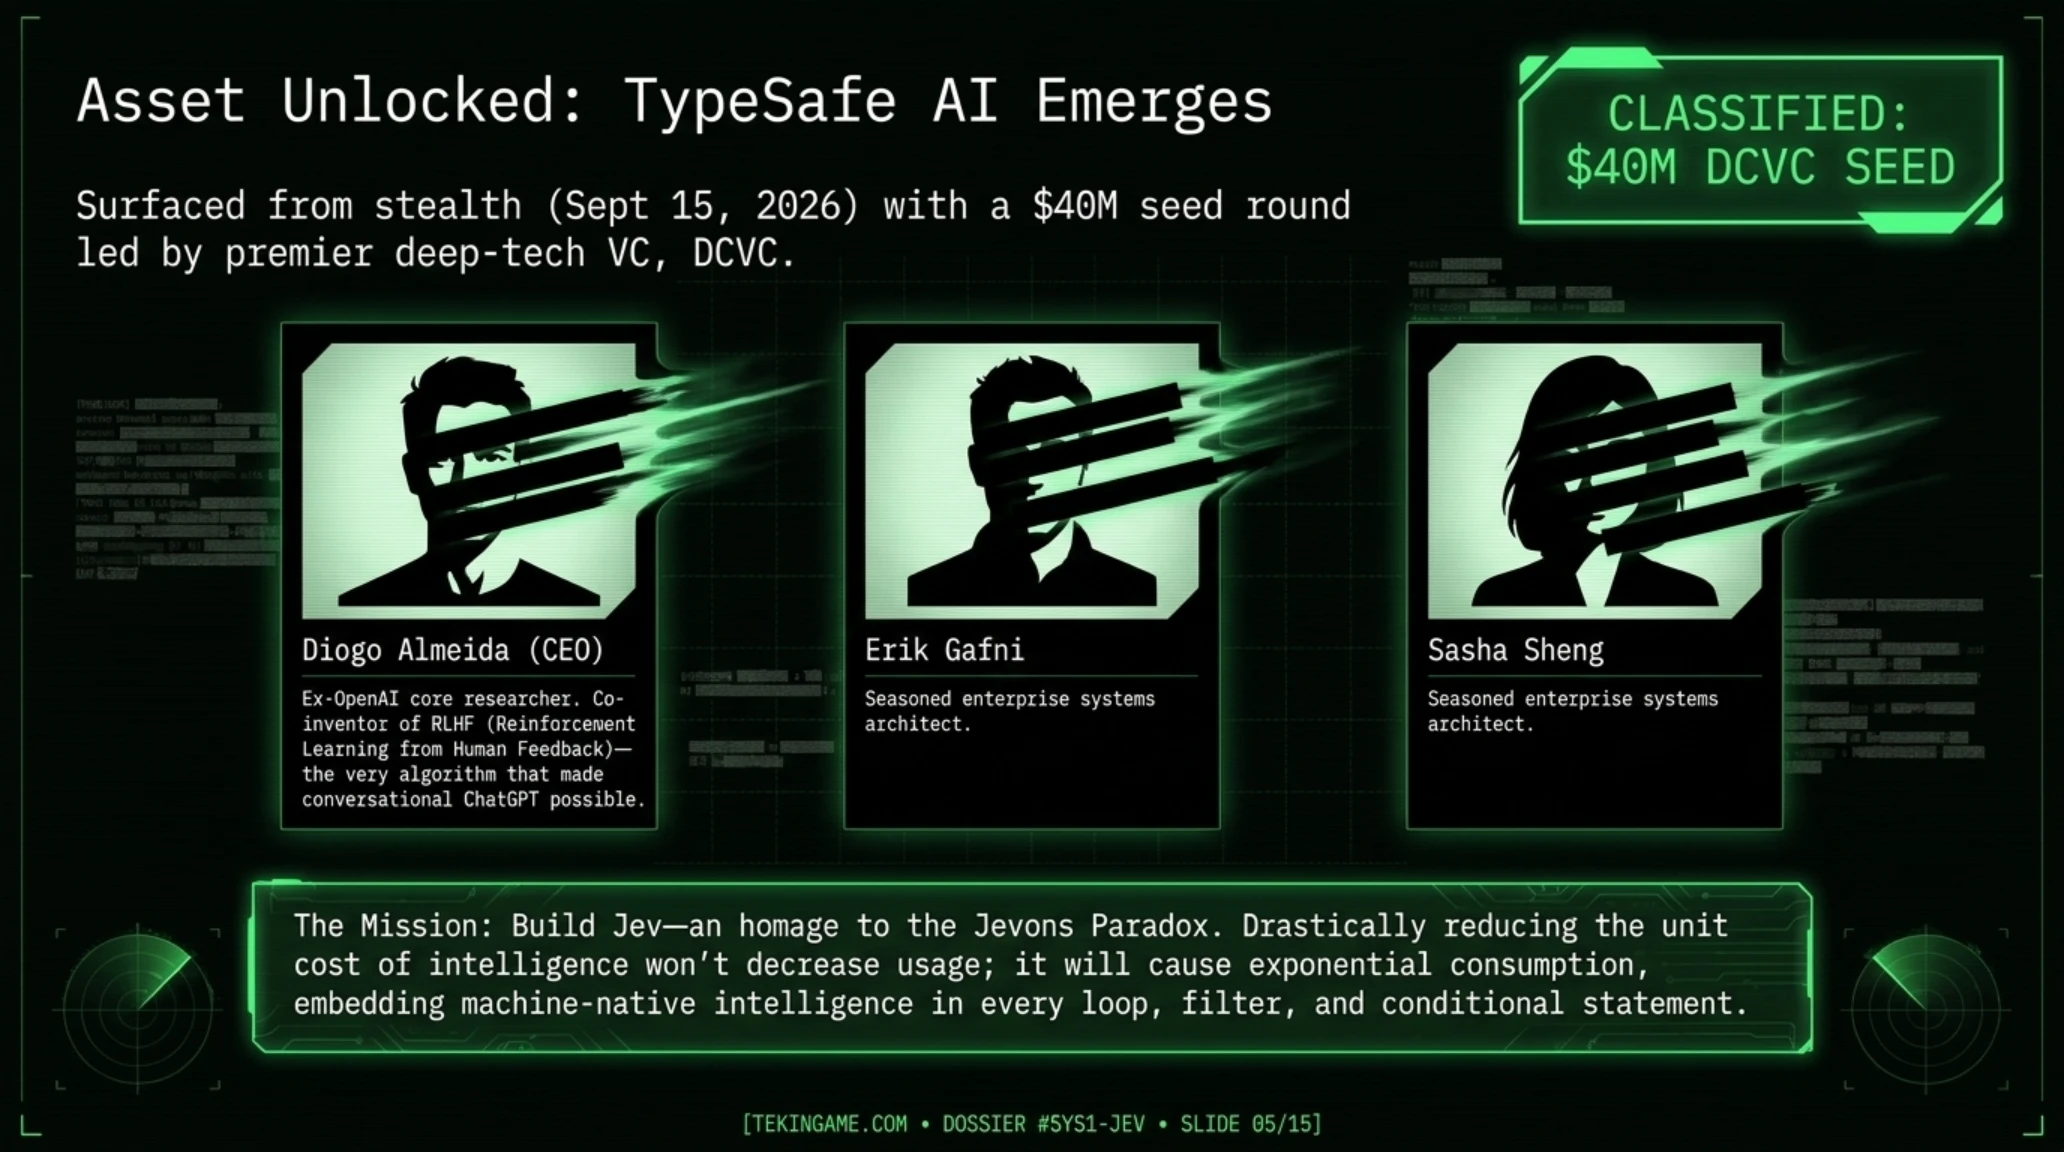
در تاریخ ۱۵ سپتامبر ۲۰۲۶، بیانیه مطبوعاتی رسمی منتشرشده در BusinessWire شوک بزرگی به جامعه مهندسی هوش مصنوعی وارد کرد. آزمایشگاه TypeSafe AI رسماً از فاز پنهانی خارج شد. آنچه توجه سرمایهگذاران والاستریت و لیدرهای سیلیکونولی را جلب کرد، صرفاً رقم سرمایهگذاری ۴۰ میلیون دلاری نبود، بلکه هویت معمار ارشد و همبنیانگذار این شرکت بود: دیوگو آلمیدا (Diogo Almeida).
آلمیدا نامی ناشناخته در پیشرفتهای اخیر هوش مصنوعی نیست. او در دوران حضورش در آزمایشگاه OpenAI، از نویسندگان اصلی مقالات بنیادین پیرامون تبعیت از دستورات (Instruction-Following) و آموزش مدلها از طریق بازخورد انسانی (RLHF) بود؛ همان پایههای علمی که به خلق پدیده ChatGPT انجامید. او در کنار دو همبنیانگذار برجسته دیگر، اریک گافنی (Erik Gafni) و ساشا شنگ (Sasha Sheng)، دو سال گذشته را صرف کالبدشکافی ناکارآمدیهای ساختاری هوش مصنوعی مولد در لایههای زیرین نرمافزار کرده بود.
دیدگاه آلمیدا شفاف و در عین حال ساختارشکنانه است: مدلهای زبانی مانند GPT-4 و Claude برای گفتگو با کاربران انسانی، انشانویسی و خلاصهسازی متون بینظیرند، اما ماهیت آنها با نیازهای بنیادین سیستمهای کامپیوتری و کدهای تولیدی (Production Software) در تضاد است. نرمافزارها برای عملکرد پایدار به دادههای قطعی، متغیرهای تایپشده (Type-Safe)، تاخیرهای قابل پیشبینی و هزینههای خطی نیاز دارند، نه متنهای ادبی با چاشنی عدم قطعیت آماری. مهندسان نمیتوانند سرنوشت پایپلاینهای حساس بانکی و ترانزاکشنهای بلادرنگ خود را به شانس و اقبال فرآیندهای تصادفی تولید متن بسپارند؛ این تقابل بنیادین، آغازگر گذار به معماریهای تصمیمگیری قطعی در سراسر صنعت است.
چرا این موضوع مهم است: بحران اضافهبار LLMها در زیرساختهای نرمافزاری
نامگذاری مدل نخست این استارتاپ یعنی Jev نیز حامل یک پیام فلسفی و اقتصادی عمیق است. این نام برگرفته از پارادوکس جونز (Jevons Paradox) است؛ اصل مشهوری در اقتصاد که توسط ویلیام استنلی جونز در قرن نوزدهم صورتبندی شد و بیان میکند که هرگاه بهرهوری و کارایی در مصرف یک منبع بنیادین (مانند زغالسنگ یا توان پردازش) جهش مییابد، مصرف کل آن منبع کاهش نمییابد، بلکه به دلیل کاهش چشمگیر هزینهها، تقاضای کل و موارد استفاده جدید به شدت منفجر میشود. تیم TypeSafe معتقد است با ارزانسازی و تسریع خارقالعاده تصمیمگیریهای هوشمند، کاربرد هوش مصنوعی در ریزترین لایههای کدنویسی رواج خواهد یافت.
جدول مقایسه کلان پارادایم مدلهای زبانی در برابر معماری تصمیمگیری Jev
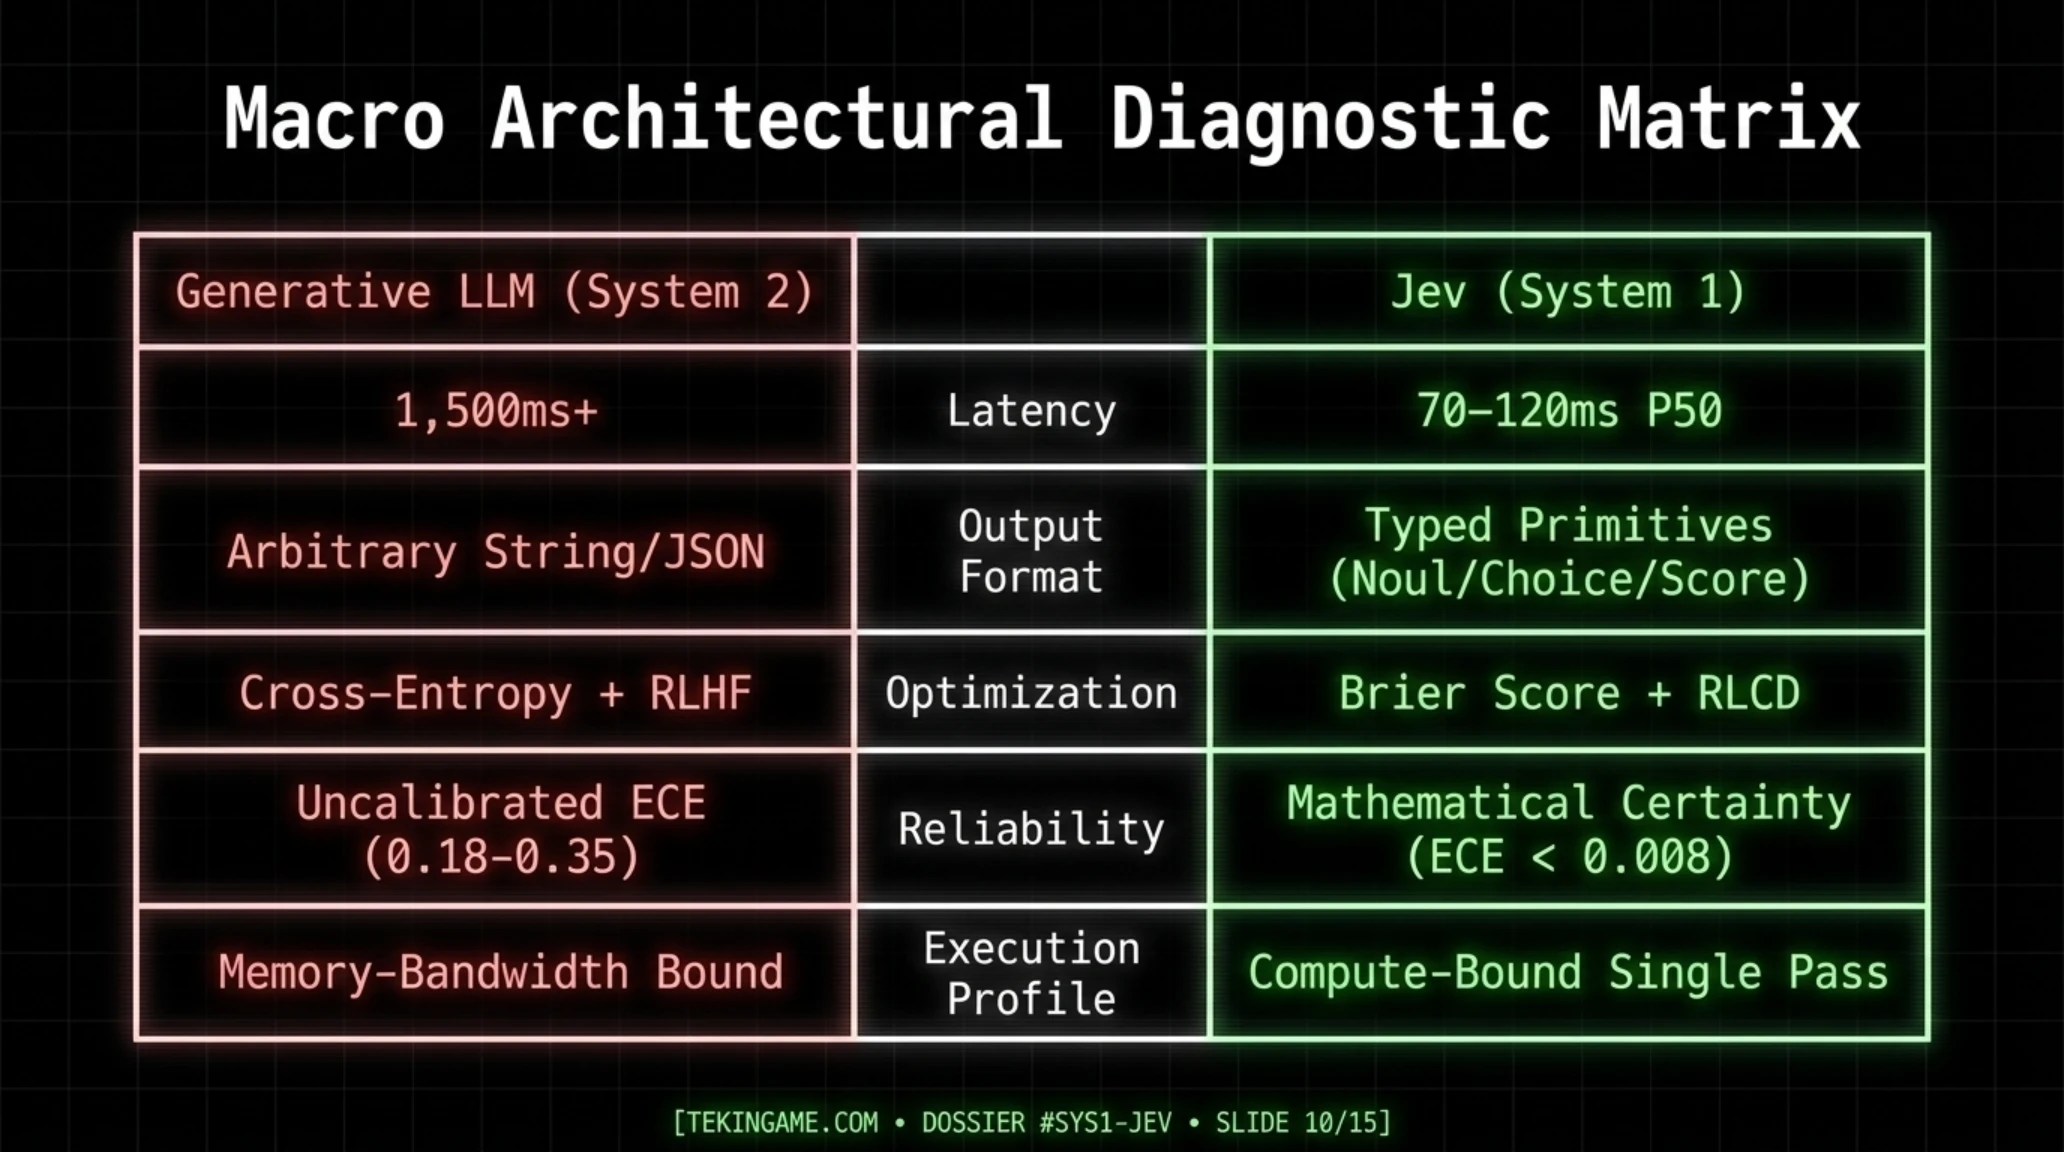
| شاخص مقایسهای | مدلهای زبانی بزرگ مرسوم (LLMs) | مدل تصمیمگیری Jev (از TypeSafe AI) | برتری عملیاتی و مهندسی |
|---|---|---|---|
| پارادایم هوش | سیستم ۲: استدلال کند، تحلیلی و بازگشتی | سیستم ۱: تصمیمگیری آنی، شهودی و غیربازگشتی | سرعت تا ۲۰۰ برابر بالاتر در تصمیمات منطقی |
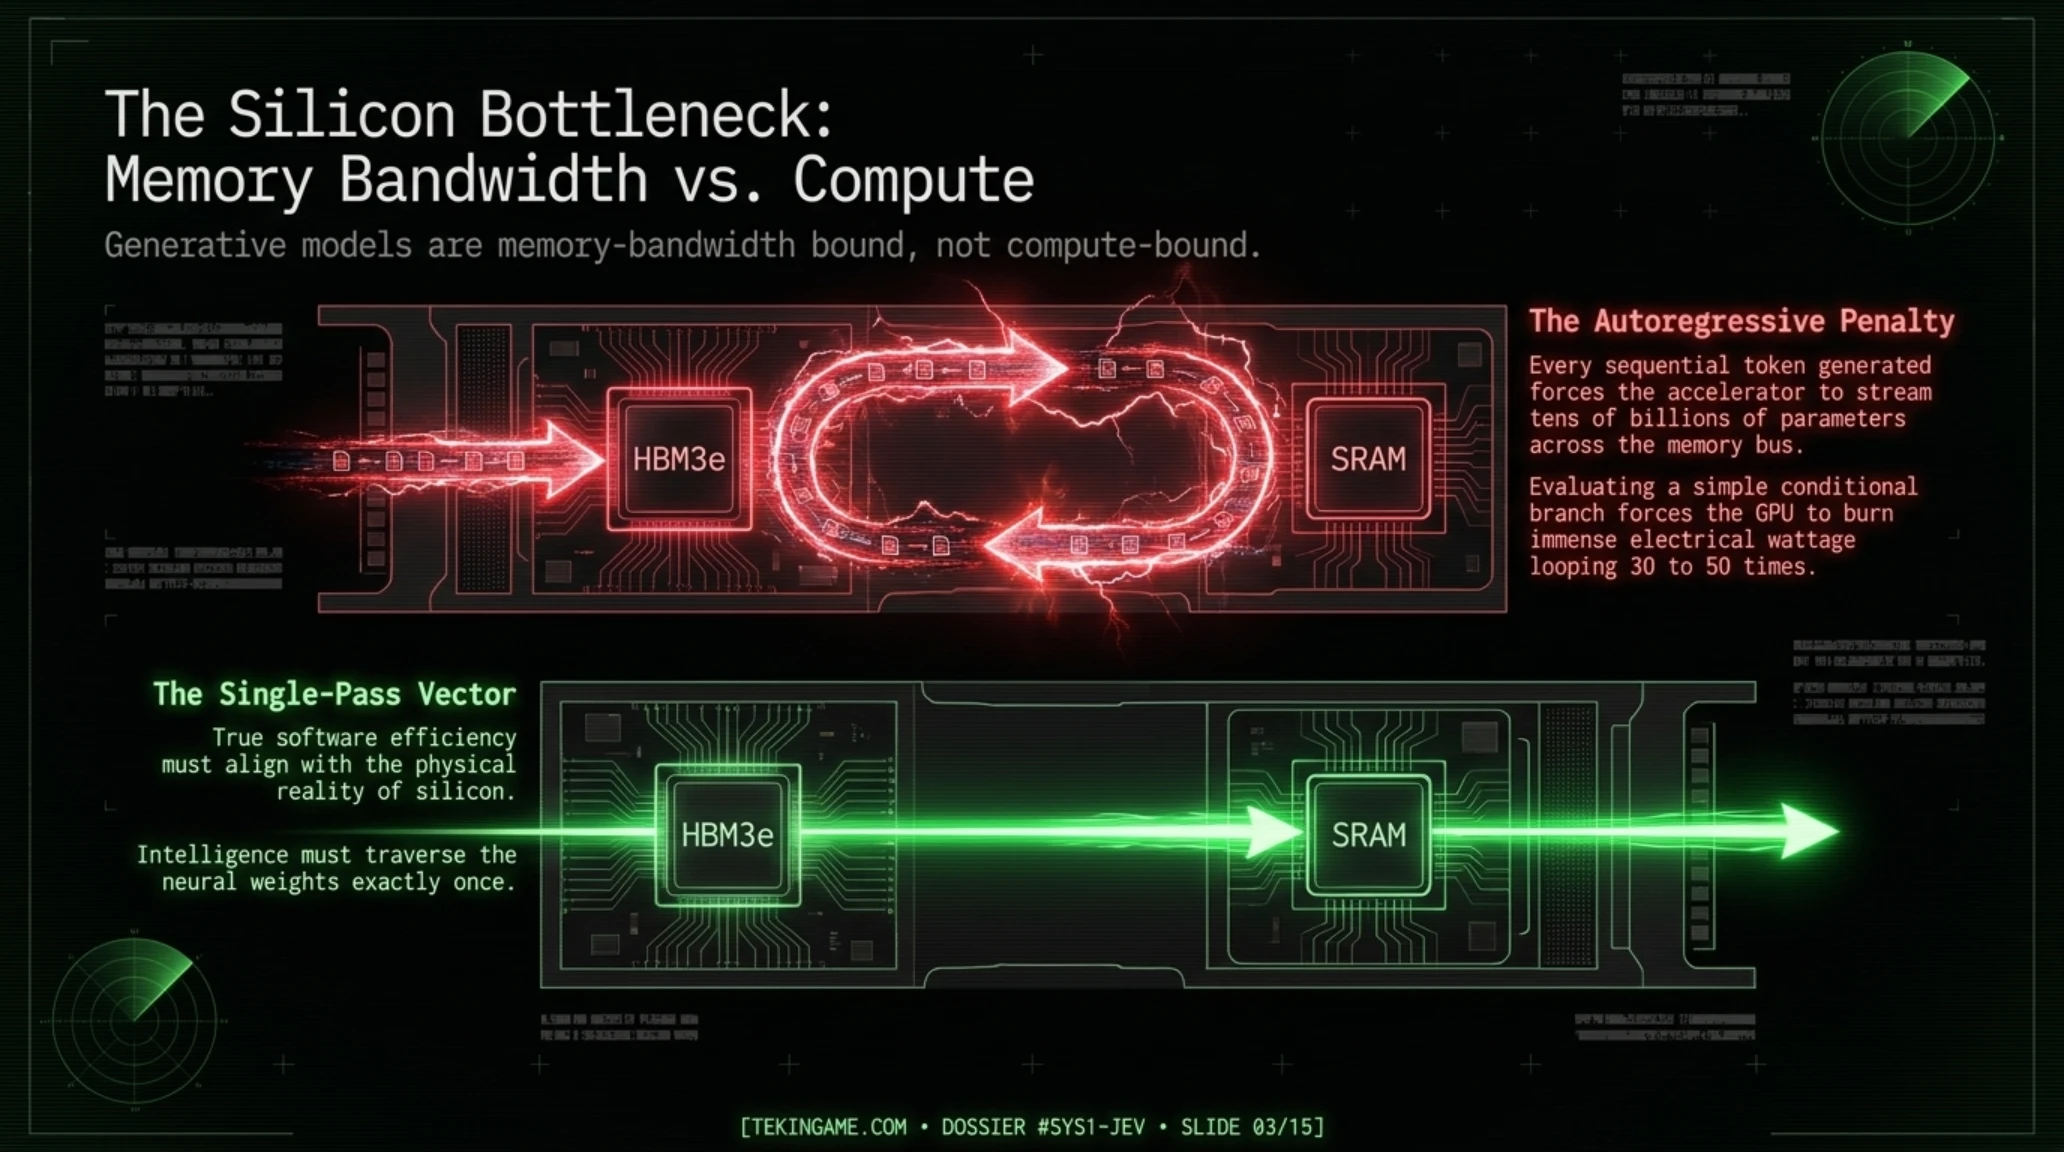
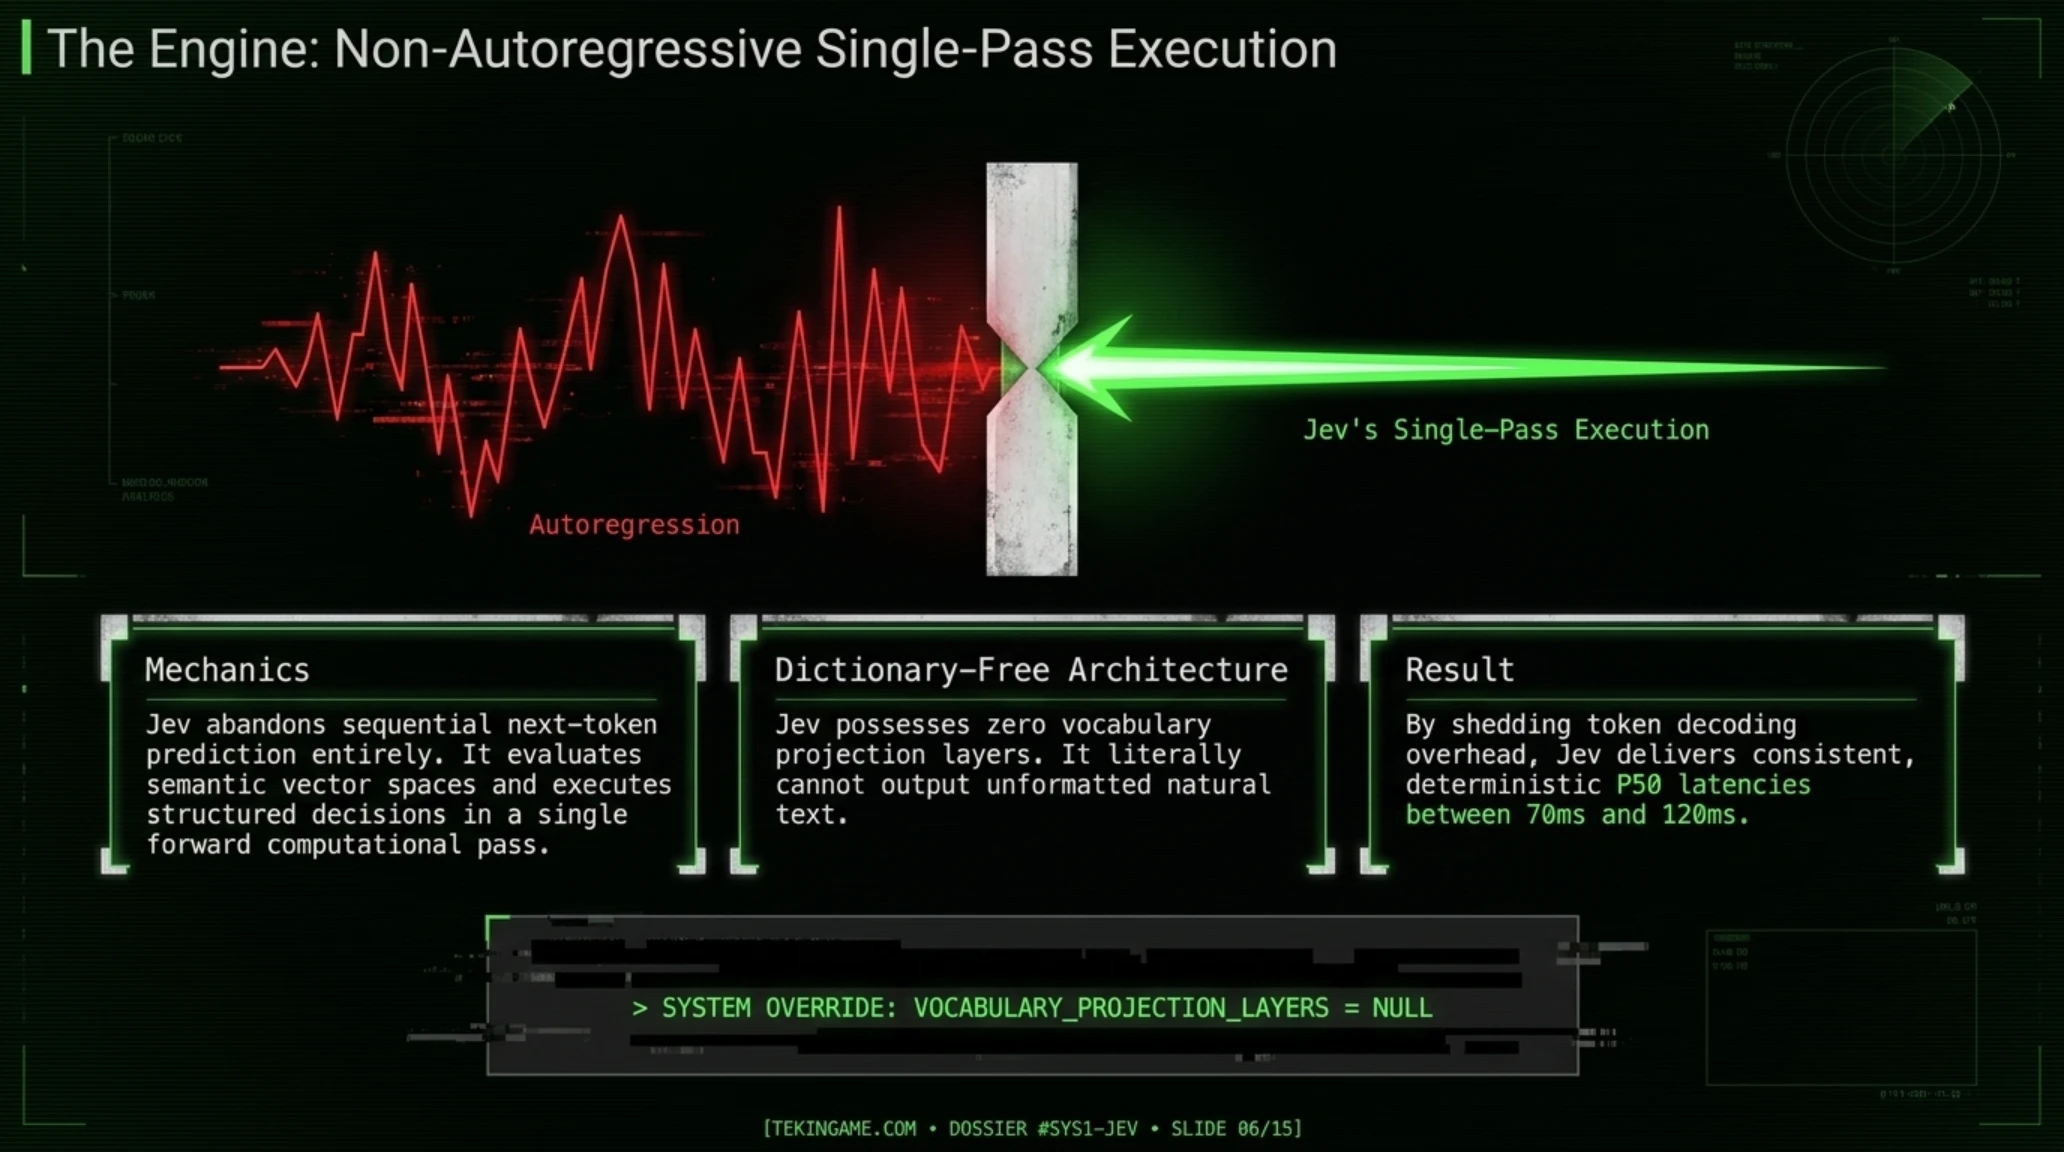
| الگوریتم تولید | Autoregressive (تولید کلمه به کلمه توکنها) | Non-Autoregressive (نمونهبرداری موازی تکمرحلهای) | حذف کامل تاخیرهای متوالی حلقه توکنها |
| فرمت خروجی داده | رشته متن آزاد نامقید یا شبهJSON ناپایدار | سه ساختار کاملاً تایپشده: Noul، Choice، Score | تضمین ۱۰۰ درصدی تطابق نوع داده در کد برنامه |
| هزینه توکن ورودی | بین ۲.۵۰ تا ۳۰.۰۰ دلار در هر ۱ میلیون توکن | ۰.۰۴۲ دلار به ازای هر ۱ میلیون توکن ورودی | کاهش بیش از ۹۸ درصدی هزینههای پایپلاین |
| هزینه توکن خروجی | بین ۱۰.۰۰ تا ۷۵.۰۰ دلار در هر ۱ میلیون توکن | کاملاً رایگان (۰.۰۰ دلار) | حذف ریسک مالی پرحرفی یا تولید متنهای ناخواسته |
| تاخیر پردازش (P95) | بین ۱,۲۰۰ تا ۳,۵۰۰ میلیثانیه | بین ۷۰ تا ۳۵۰ میلیثانیه | مناسب برای خطوط لوله وب و تعاملات بلادرنگ |
دادههای جدول بالا به روشنی نشان میدهند که شکاف میان این دو فناوری، صرفاً یک ارتقای جزئی در سرعت یا تخفیف قیمتی نیست، بلکه جابجایی کامل زمین بازی است. زمانی که توسعهدهنده به جای دریافت یک انشای طولانی و صرف انرژی برای پارس کردن آن، یک ساختار دادهای تمیز و اعتبارسنجیشده با احتمال ریاضی دقیق تحویل میگیرد، معماری کل پایپلاین نرمافزاری متحول میشود.
آمار کلیدی: بحران هزینهها و تاخیر در خطوط لوله هوش مصنوعی سازمانی
| معیار آماری | مقدار شاخص | پیامد مهندسی در سال ۲۰۲۶ |
|---|---|---|
| سهم کدهای پرامپتینگ | ۸۴٪ | اتلاف انرژی توسعهدهندگان برای التماس به LLM جهت خروجی معتبر JSON |
| شتاب تصمیمگیری | 200x | سرعت بالاتر مدل Jev در مقایسه با سریعترین مدلهای سری کلود و GPT |
| هزینه ورودی | ۰.۰۴۲ دلار / 1M | کاهش هزینه با خروجی کاملاً رایگان و نامحدود برای مقیاس سازمانی |
| نرخ خطای ساختاری | ۰٪ | حذف کامل توهم و خطای تایپ در فراخوانی توابع نرمافزاری با Jev |
در ادامه این گزارش تحلیلی، ساختار ریاضی و تئوری عمیق پشت این معماری را تشریح خواهیم کرد و نشان میدهیم که چگونه روانشناسی شناختی دانیل کانمن به ابزاری برای بهینهسازی کدهای فرانتاند و بکاند در عصر پسا-چتباتها بدل شده است.

کالبدشکافی معماری سیستم ۱ در برابر سیستم ۲؛ پیوند روانشناسی شناختی با شبکههای عصبی
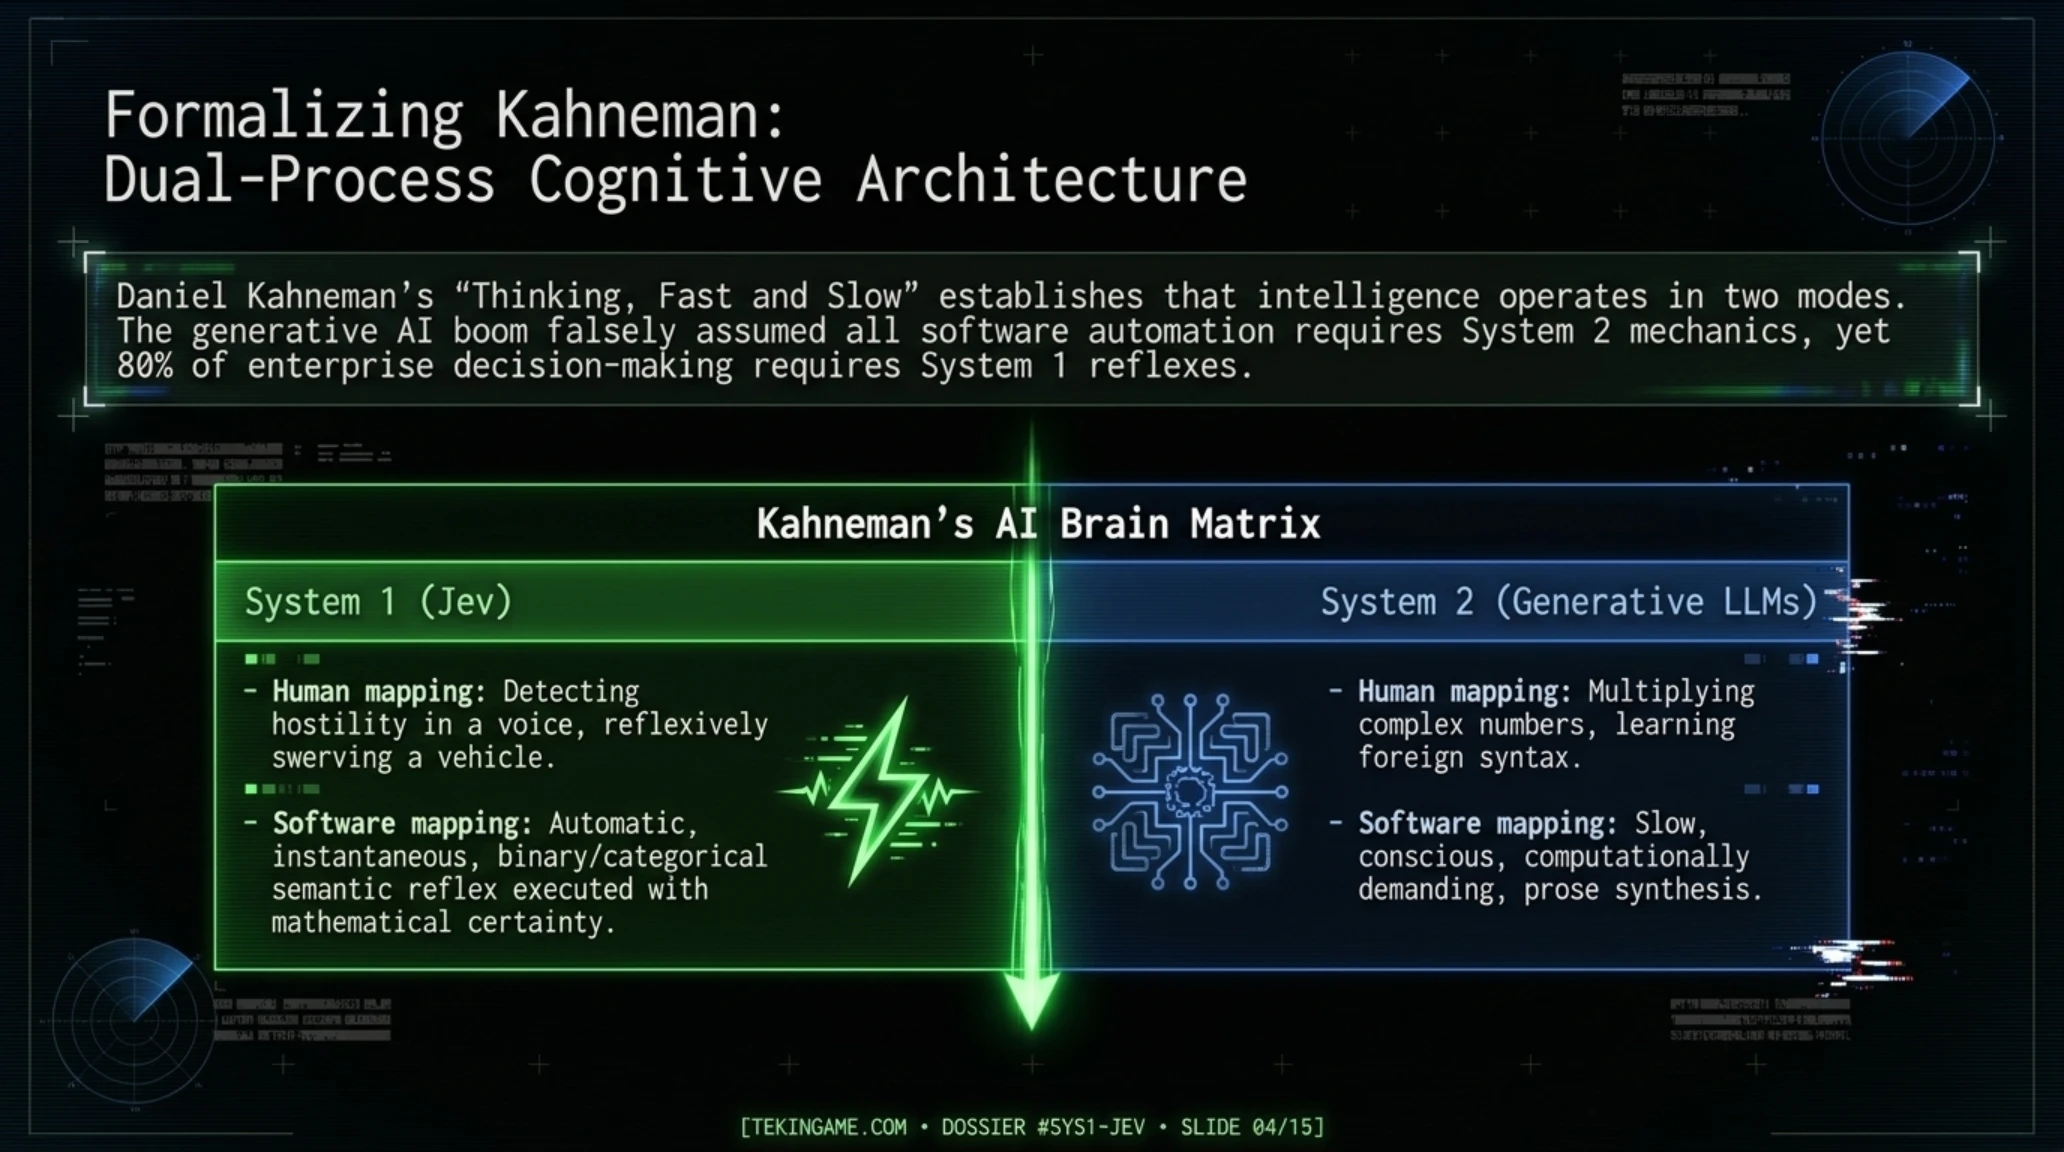
برای درک علت تفوق چشمگیر مدل Jev در پردازشهای منطقی، باید به مفاهیم بنیادین روانشناسی شناختی و اثر ماندگار دانیل کانمن (برنده نوبل اقتصاد و نویسنده کتاب تفکر، سریع و کند) رجوع کرد. کانمن ذهن انسان را به دو سامانه متمایز تقسیم میکند: سامانه ۱ (System 1) که خودکار، فوقسریع، ناخودآگاه، شهودی و کممصرف است و تصمیمات فوری مانند تشخیص لحن عصبانی یک صدا یا جاخالی دادن در برابر پرتاب یک شیء را مدیریت میکند؛ و سامانه ۲ (System 2) که کند، خودآگاه، نیازمند تمرکز بالا، پرمصرف و منطقی است و مسائلی نظیر ضرب دو عدد سه رقمی یا حل جداول پیچیده را حل و فصل مینماید.
تراژدی دنیای هوش مصنوعی در سالهای اخیر این بود که مهندسان تمام سامانههای اتوماسیون اداری و نرمافزاری خود را به سامانه ۲ مجهز کرده بودند. مدلهای زبانی بزرگ از نظر ماهیت عملکردی شبیه به سامانه ۲ رفتار میکنند؛ آنها برای تولید هر قطعه داده باید فرآیند طولانی تداعی معانی، محاسبه ماتریسهای توجه (Self-Attention) روی هزاران کلمه گذشته و نمونهبرداری متوالی را طی کنند. اما در حقیقت بیش از ۸۰ درصد کدهای نرمافزاری به استدلال کند نیاز ندارند، بلکه نیازمند واکنش آنی و شهودی سامانه ۱ هستند.
مهندسی نرمافزار مدرن برای دهها سال بر پایه مفاهیم نوعدهی ایستا (Static Typing) و تضمین صحت دادهها توسعه یافته است. در زبانهایی نظیر Rust و TypeScript، ساختار خروجی توابع از پیش تعیین شده است. ورود مدلهای زبانی به این چرخه مانند ورود یک عنصر پیشبینیناپذیر و تصادفی به قلب یک موتور منظم بود. مدل Jev با حذف توکنسازی متوالی و جایگزینی آن با آموزش تفکیکشده، تعادل را مجدداً به برنامهنویسی بازمیگرداند.
شایعه در برابر واقعیت: آیا Jev یک مدل تقلیلیافته یا LLM کوچکشده است؟
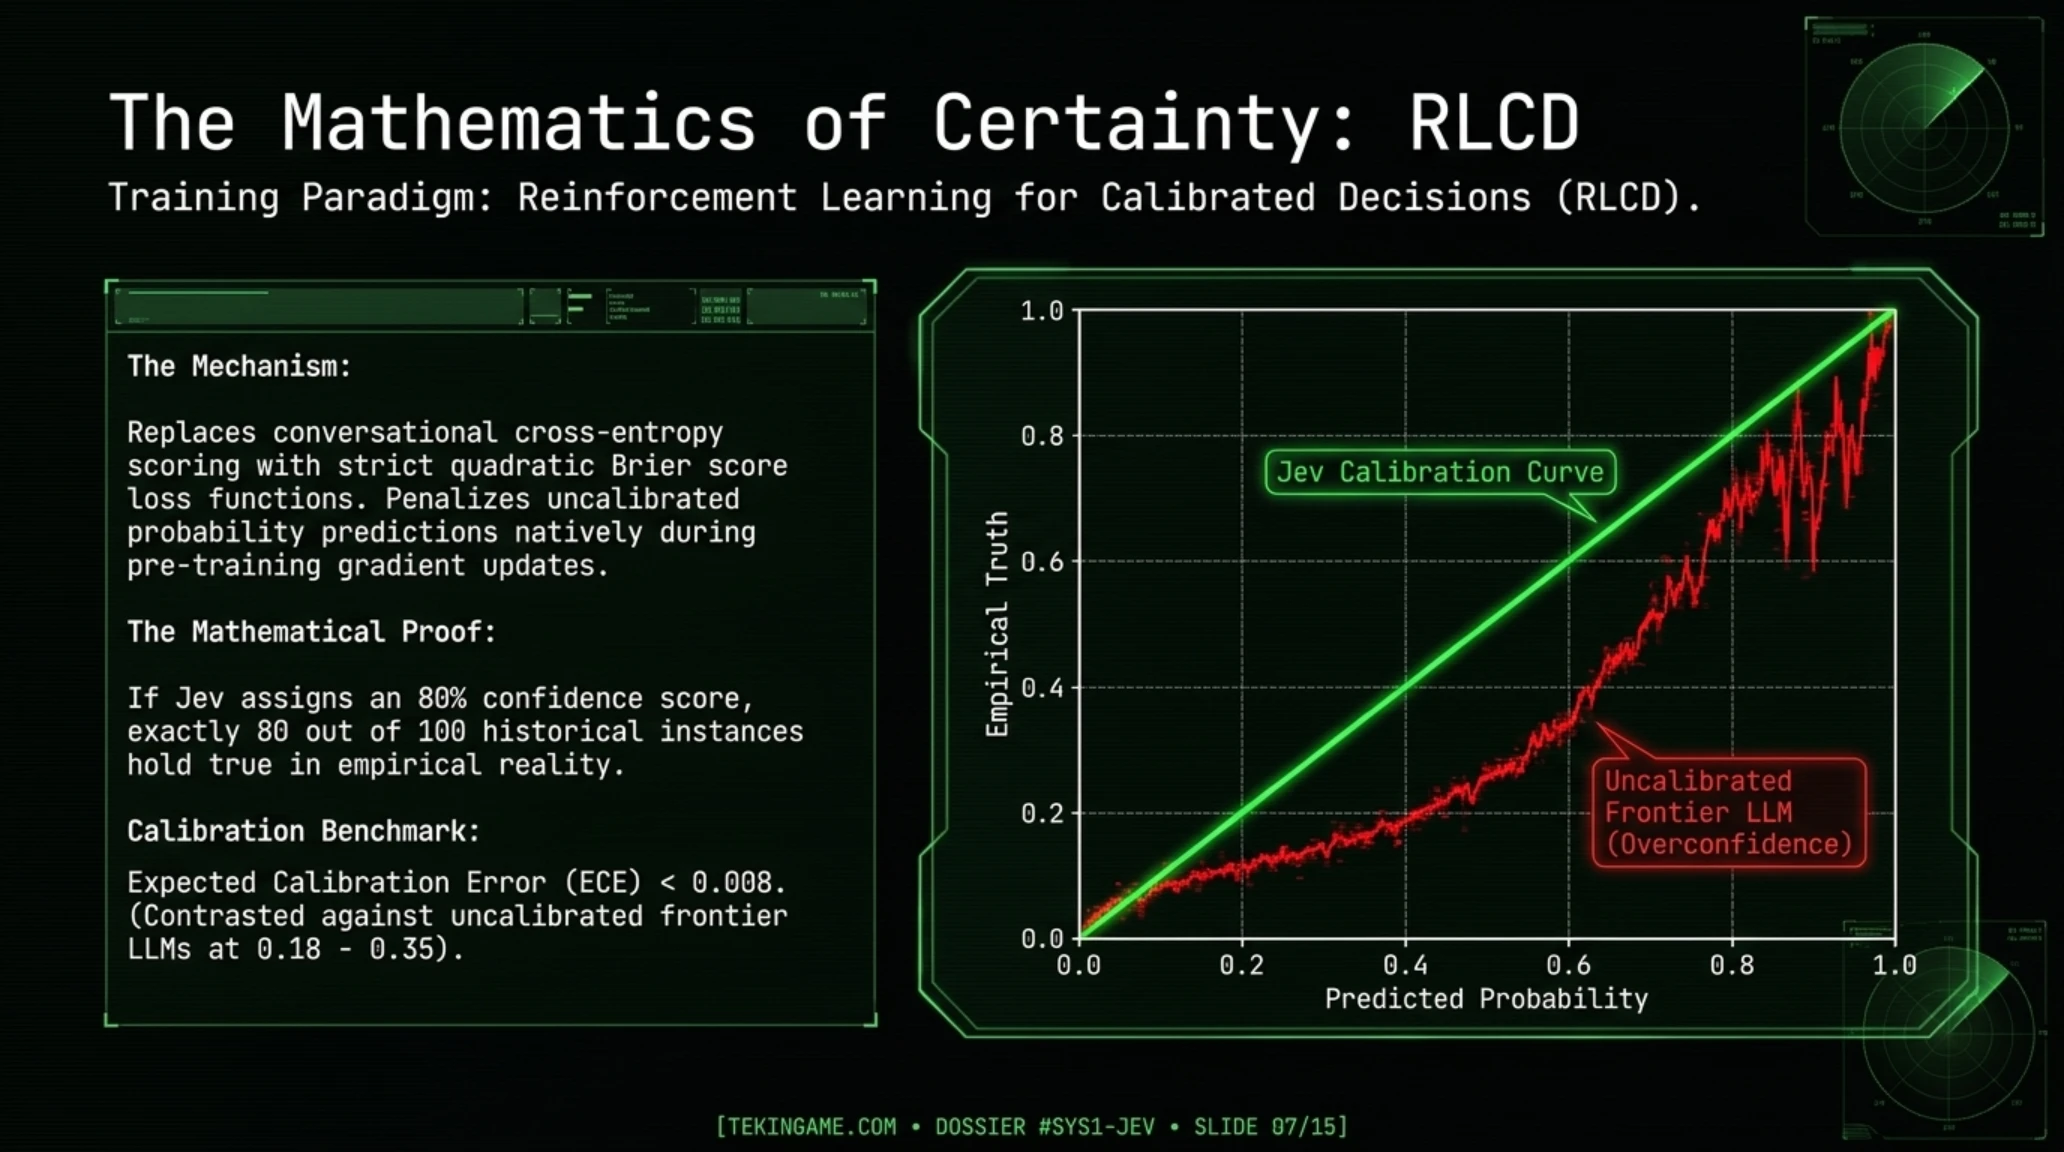
تفاوت فنی دیگر به نحوه آموزش مدل مربوط میشود. در حالی که LLMها با روشهای پیشبینی کلمه بعدی (Next-Token Prediction) آموزش میبینند و به همین دلیل آموختهاند که برای رسیدن به پاسخ نهایی باید زنجیرهای از کلمات واسط (Chain-of-Thought) بسازند، مدل Jev بر پایه الگوریتم RLCD (Reinforcement Learning for Calibrated Decisions) آموزش دیده است. در این روش، پاداش مدل نه بر اساس خوشایندی لحن نوشتاری، بلکه دقیقاً بر اساس کالیبراسیون آماری توزیع احتمالات بر روی دادههای چندحالته محاسبه میشود.
در مدلهای زبانی سنتی، تابع هزینه Cross-Entropy صرفاً به دنبال افزایش احتمال توکن صحیح بعدی است، حتی اگر این توکن با اطمینان کاذب ۹۹ درصدی تولید شود که منشأ اصلی پدیده توهم (Hallucination) است. اما در متدولوژی RLCD، مدل Jev با استفاده از توابع جریمه درجه دوم و امتیازدهی Brier آموزش میبیند؛ به این معنا که اگر مدل در یک ارزیابی اعلام کند که با احتمال ۷۰ درصد ورودی معتبر است، در بلندمدت دقیقاً ۷۰ درصد از نمونههای با این امتیاز باید در واقعیت معتبر باشند. این کالیبراسیون ریاضی دقیق، به مهندسان قابلیت اطمینان آماری مطلق میدهد تا بر اساس آستانههای عددی مشخص، منطق بیزینس خود را به صورت خودکار هدایت نمایند.

سه ساختار دادهای بنیادین؛ خداحافظی با پرامپتهای التماسآمیز JSON
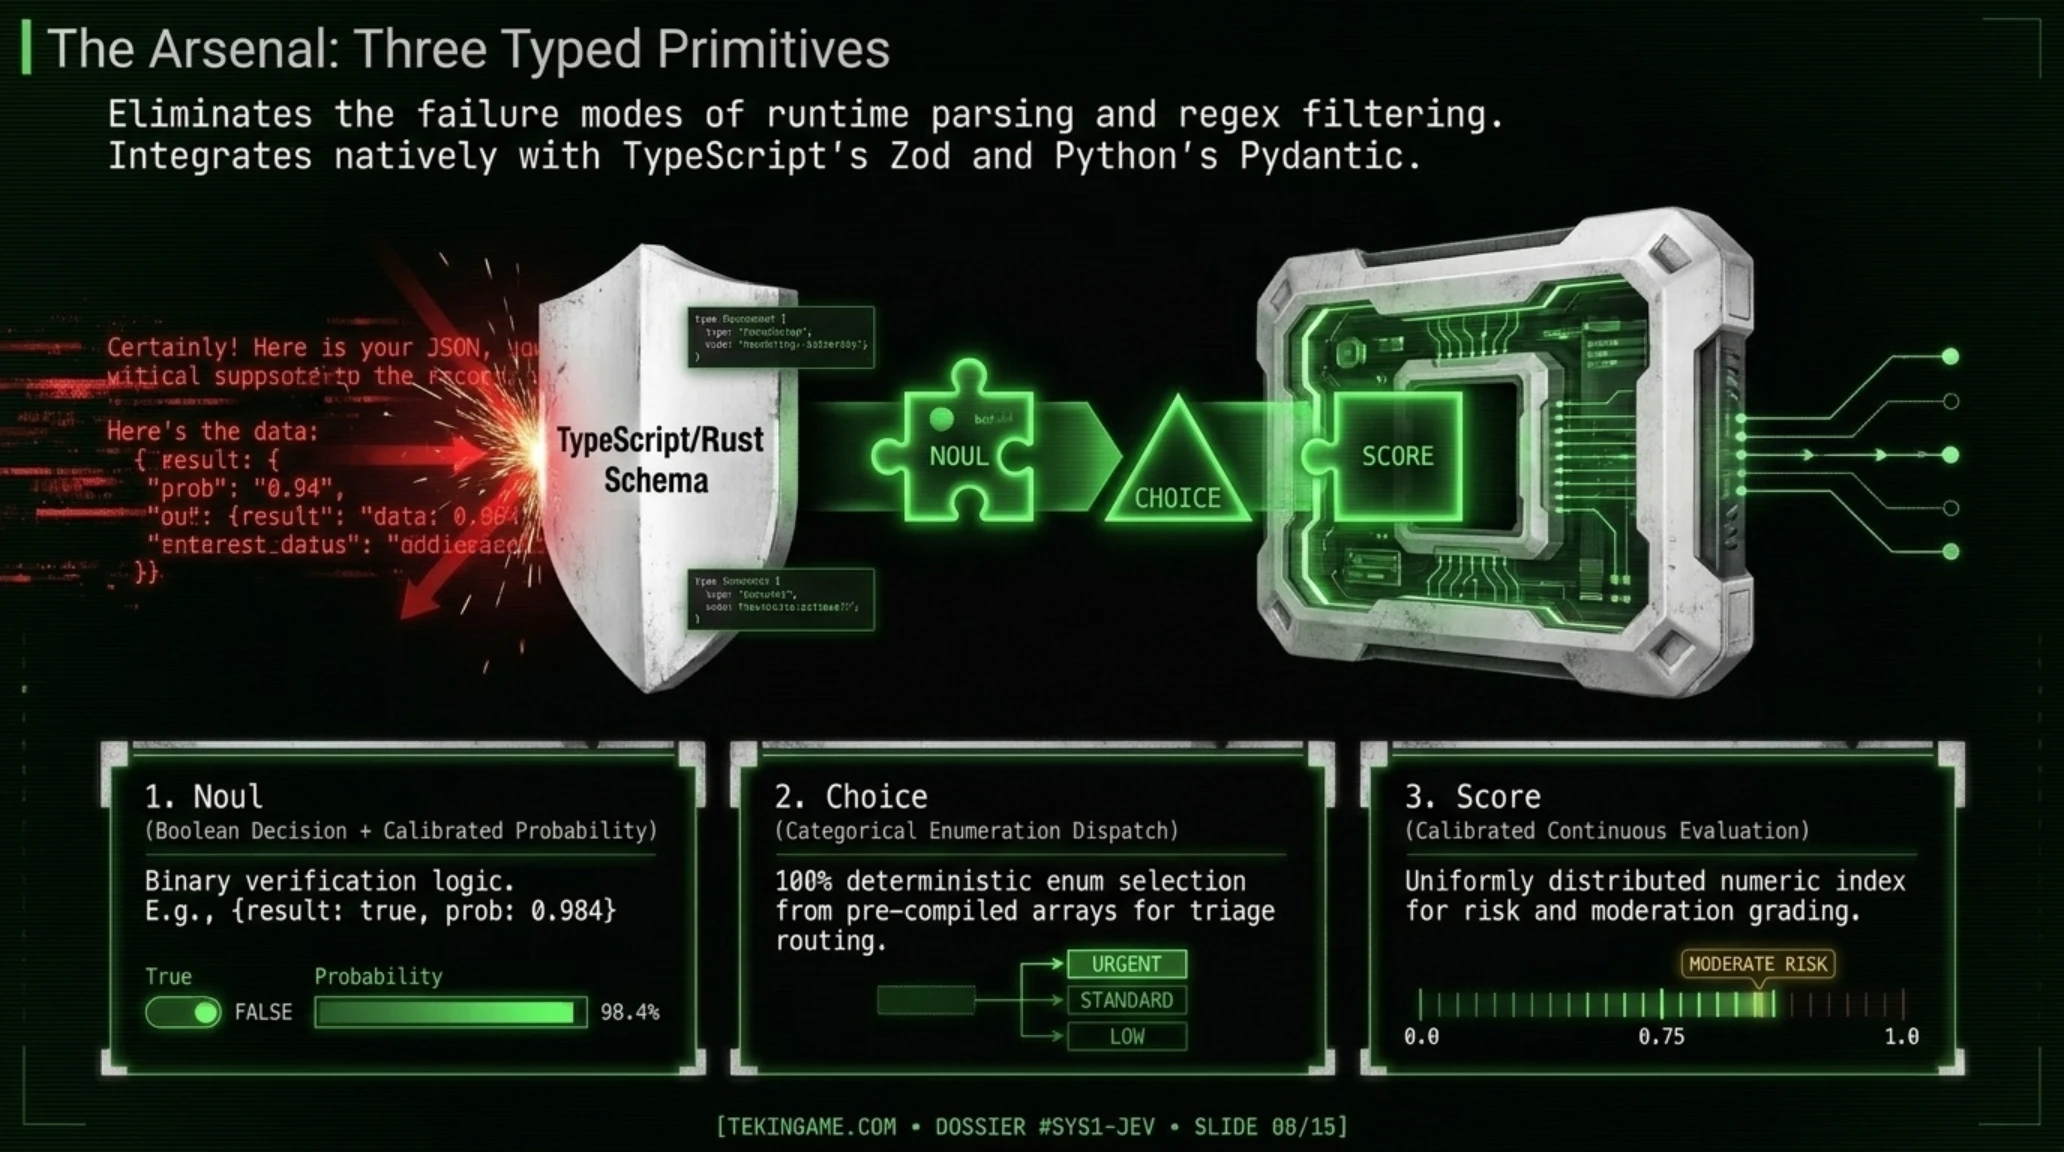
در مدلهای سنتی، توسعهدهنده مجبور بود متنی شبیه به این بنویسد: «لطفاً فقط و فقط در قالب معتبر JSON پاسخ بده و هیچ کلمه اضافهای قبل و بعد از آکولاد ننویس!». با این وجود، در هزاران بار فراخوانی، مدل بالاخره در یک مورد کلمهای مانند «مطمئناً! این هم خروجی شما:» را در ابتدای پاسخ میگنجاند و کل فرایند وبسایت با خطای زمان اجرا متوقف میشد. مدل Jev این دغدغه را در ریشه از میان برده و خروجی خود را به سه ساختار تایپشده محدود ساخته است:
نخستین ساختار، Noul (یا خروجی بولین) است. این ساختار یک تصمیم دوحالته (بله یا خیر / صحیح یا غلط) به همراه ضریب اطمینان کالیبرهشده ارائه میدهد. به عنوان مثال، آیا یک تراکنش مالی مصداق پولشویی است؟ خروجی Jev یک بولین ساده به همراه احتمال ریاضی است؛ برای مثال { result: true, probability: 0.984 }. توسعهدهنده بدون نیاز به هیچگونه اعتبارسنجی مجدد، مستقیماً این شیء را در کدهای سیستمی به کار میگیرد.
دومین ساختار، Choice (یا انتخاب گزینهای) است. کاربر یک لیست شمارشی (Enum) شامل گزینههای مجاز به مدل تحویل میدهد. Jev بدون تولید واژگان اضافی، محتملترین گزینه را از روی فضای معنایی تشخیص داده و ایندکس آن را بازمیگرداند. این الگو برای سامانههای تریاژ ایمیل، دستهبندی باگهای نرمافزاری و تعیین مسیر جریان کار (Workflow Routing) یک نجاتبخش مطلق است.
سومین ساختار، Score (یا ارزیابی مقیاسی) است که کیفیت یک داده ورودی را بر اساس متغیرهای از پیش مرتبشده بین ۰ تا ۱ یا یک رتبه عددی مشخص میسنجد. بر خلاف امتیازدهی LLMها که دچار تورم آماری بوده و معمولاً تمایل به دادن نمرات بالا دارند، امتیازات Jev به دلیل استفاده از توابع تلفات اعتبارسنجیشده (Brier Loss Functions) به صورت یکنواخت و معتبر توزیع میشوند.
نقطه قوت این سه ساختار در اتصال بدون واسطه (Direct Binding) به کتابخانههای اعتبارسنجی تایپ مدرن نظیر Zod در تایپاسکریپت و Pydantic در پایتون نهفته است. در رویکرد سنتی، برنامهنویس باید خروجی خام مدل زبانی را با هزاران خط کد دفاعی، بلوکهای Try/Catch و ابزارهای اعتبارسنجی مجدد بررسی میکرد تا مطمئن شود ساختار JSON نشکسته است. اما با Jev، پاسخ مدل در لایه پروتکل شبکه مستقیماً به عنوان یک آبجکت تایپشده بومی در حافظه اپلیکیشن مینشیند و احتمال وقوع خطاهای زمان اجرا (Runtime Type Errors) را به صفر مطلق میرساند.
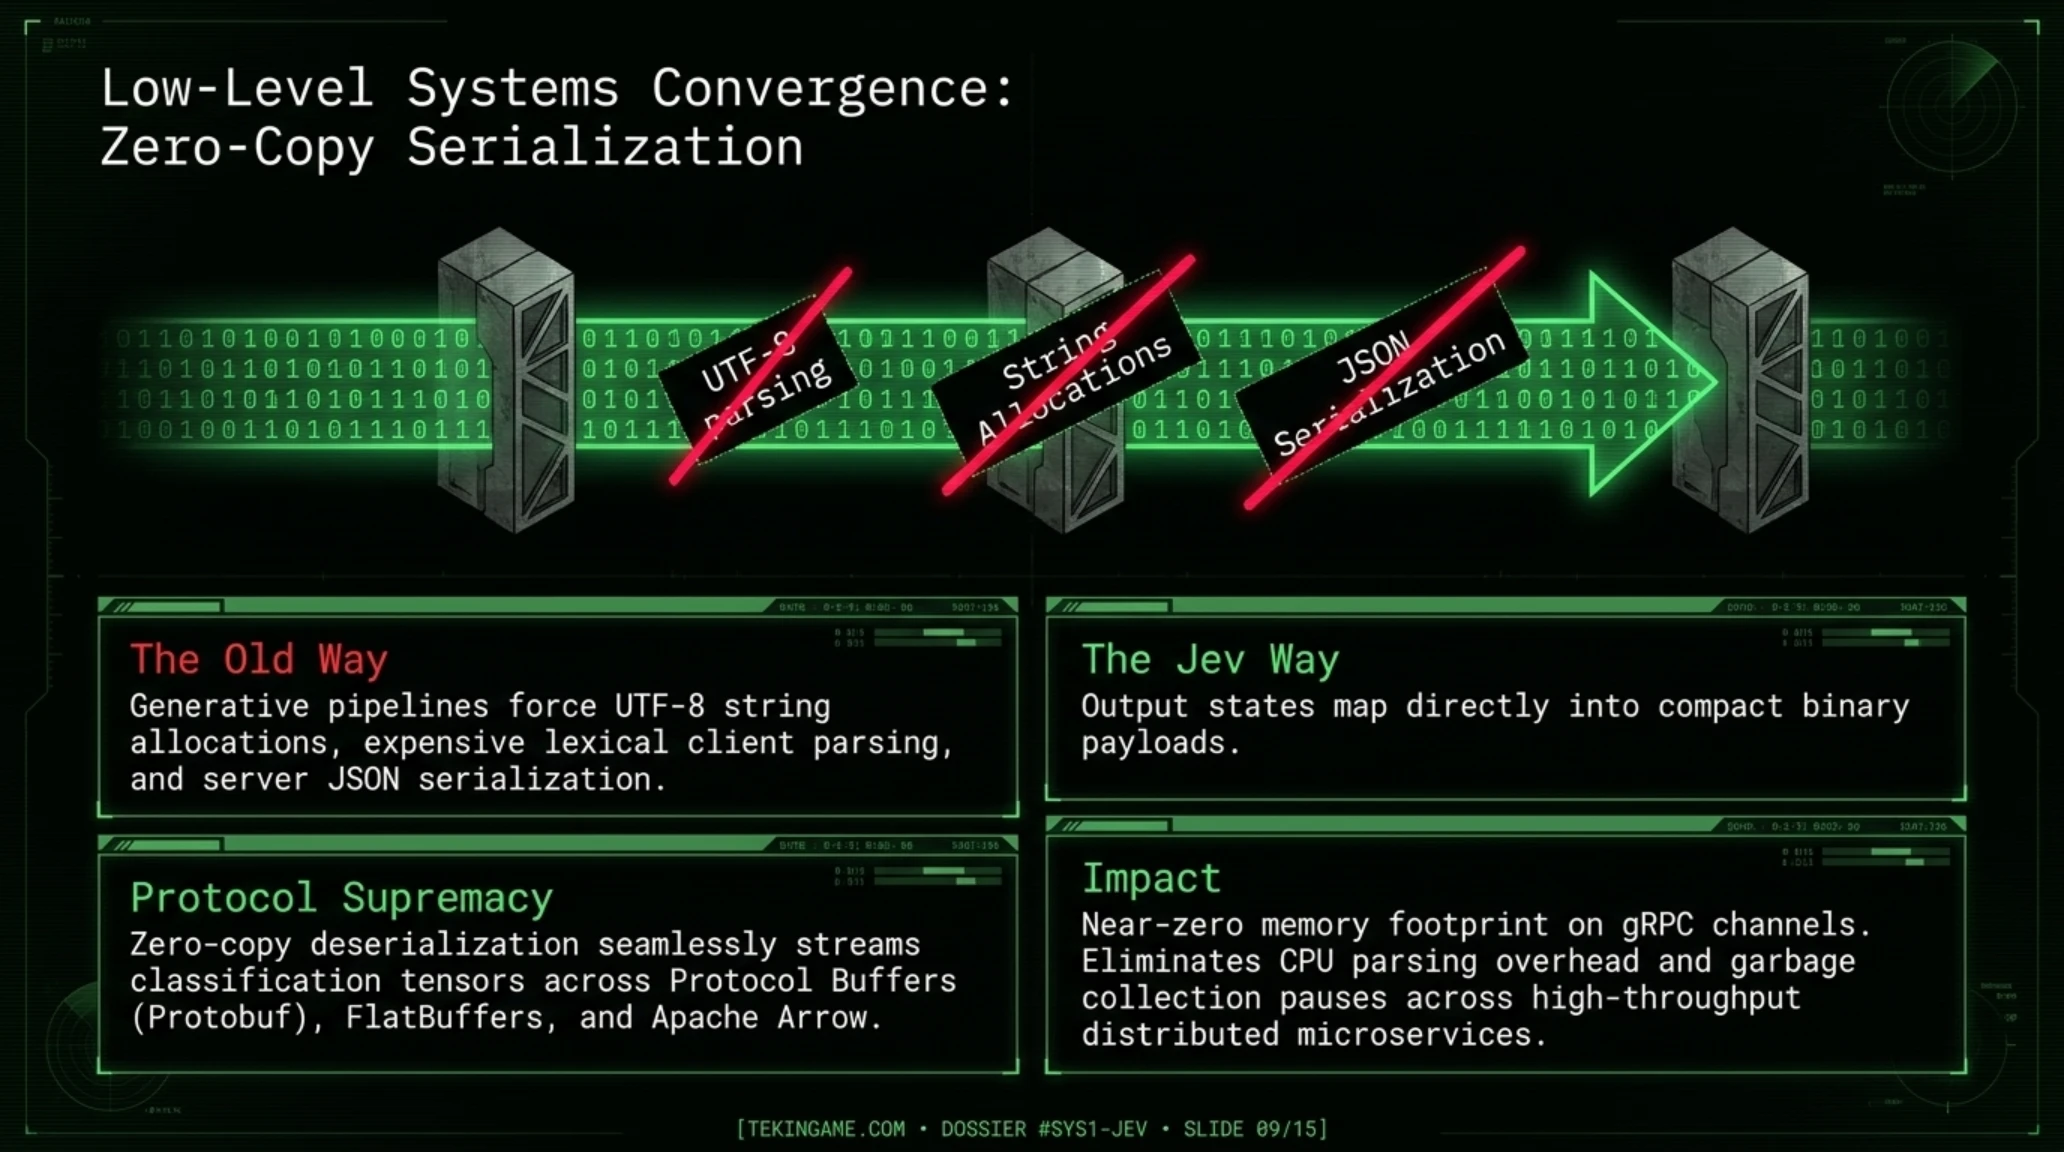
علاوه بر حذف خطاهای ساختاری، مزیت بنیادین دیگر در صرفهجویی شدید منابع حافظه نهفته است. در پایپلاینهای سنتی مبتنی بر LLM، تبدیل رشتههای متنی به ساختارهای JSON نیازمند فرآیند سنگین پارس کردن و نمادسازی (Deserialization) است که در هر ثانیه هزاران آبجکت موقت در حافظه رم ایجاد کرده و فشار غیرقابل تحملی به زبالهروبهای حافظه (Garbage Collectors) در محیطهایی مانند Node.js و Go وارد میسازد. مدل Jev با تحویل مستقیم بایتهای ساختاریافته در قالب بافرهای حافظه صفر-کپی (Zero-Copy Memory Buffers)، سربار پردازشی سرورهای بکاند را به صفر رسانده و از پرشهای ناگهانی تاخیر در ترافیکهای سنگین جلوگیری میکند.
از منظر امنیت نرمافزار، این یکپارچگی ساختاری خط بطلانی بر حملات تزریق پرامپت ثانویه (Indirect Prompt Injections) میکشد. در معماریهای سنتی، یک نفوذگر میتوانست با پنهان کردن دستورات متنی داخل فیلدهای ارسالی، مدل زبانی را فریب داده و ساختار JSON خروجی را آلوده سازد. از آنجا که Jev اساساً فاقد لایه بازتولید زبان طبیعی است و صرفاً بردار عددی تصمیم را بازمیگرداند، مهاجمان هیچ مجرایی برای تزریق کدهای مخرب یا دستکاری منطق تصمیمگیری نخواهند داشت که این امر سطح نفوذپذیری سامانههای سازمانی را به شدت محدود مینماید.
مشخصات فنی و زیرساختی موتور تصمیمگیری Jev
| شاخص فنی | مقدار و ویژگی |
|---|---|
| معماری پایه | Non-Autoregressive Transformer با لایههای تعبیه مشترک |
| مکانیسم آموزش | RLCD (یادگیری تقویتی برای تصمیمگیریهای کالیبرهشده) |
| ساختارهای پشتیبانیشده | Noul (بولین)، Choice (چندگزینهای)، Score (رتبهبندی عددی) |
| تاخیر زمانی در حالت P50 | ۸۵ میلیثانیه در بستر پردازندههای اشتراکی ابری |
| کالیبراسیون احتمال | سازگار با خطای مورد انتظار کمتر از ۰.۰۱ (ECE < 0.01) |
| هزینه توکن خروجی | رایگان مطلق (Zero Output Token Surcharge) |
در ویدیوی تحلیلی و دمو زیر، مقایسه سرعت اجرای یک زنجیره تصمیمگیری شامل ۵ مرحله اعتبارسنجی متوالی با مدلهای سنتی و جایگزینی آن با مدل Jev را مشاهده نمایید که چگونه زمان اجرای نهایی از ۹ ثانیه به کمتر از ۴۰۰ میلیثانیه سقوط میکند.
این بنچمارک زنده نشان میدهد که مهندسان نرمافزار چگونه میتوانند بدون فدا کردن دقت هوش مصنوعی، عملکردی در سطح میکروثانیههای وب سنتی به دست آورند و زنجیرههای پردازش ایجنتیک را از سنگینی رها سازند.
در بخش بعدی این پرونده، وارد جزئیات اقتصادی و بنچمارکهای میدانی مقایسه هزینهها و نحوه ترکیب مدلهای سیستم ۱ و سیستم ۲ در ساختار ایجنتهای سازمانی نسل نوین خواهیم شد.
محاسبات اقتصادی و آزمونهای کارایی؛ کاهش ۹۹ درصدی صورتحسابهای ابری
در دنیای استارتاپها و شرکتهای بزرگ فناوری، معماری ایدهآل در نهایت با یک معیار تعیینکننده سنجیده میشود: هزینه تمامشده بر هر عملیات (Cost per Transaction). در طول سالهای ۲۰۲۴ تا ۲۰۲۶، بسیاری از کسبوکارهایی که با هیجان فراوان قابلیتهای مبتنی بر ایجنتهای هوش مصنوعی را به محصولات خود افزودند، در پایان ماه با صورتحسابهای شوکهکننده پردازش ابری مواجه شدند. مدلهای زبانی به ازای هر بار ارزیابی یک شرط ساده، کاربر را مجبور به پرداخت هزینه توکنهای ورودی و خروجی سنگین میکردند.
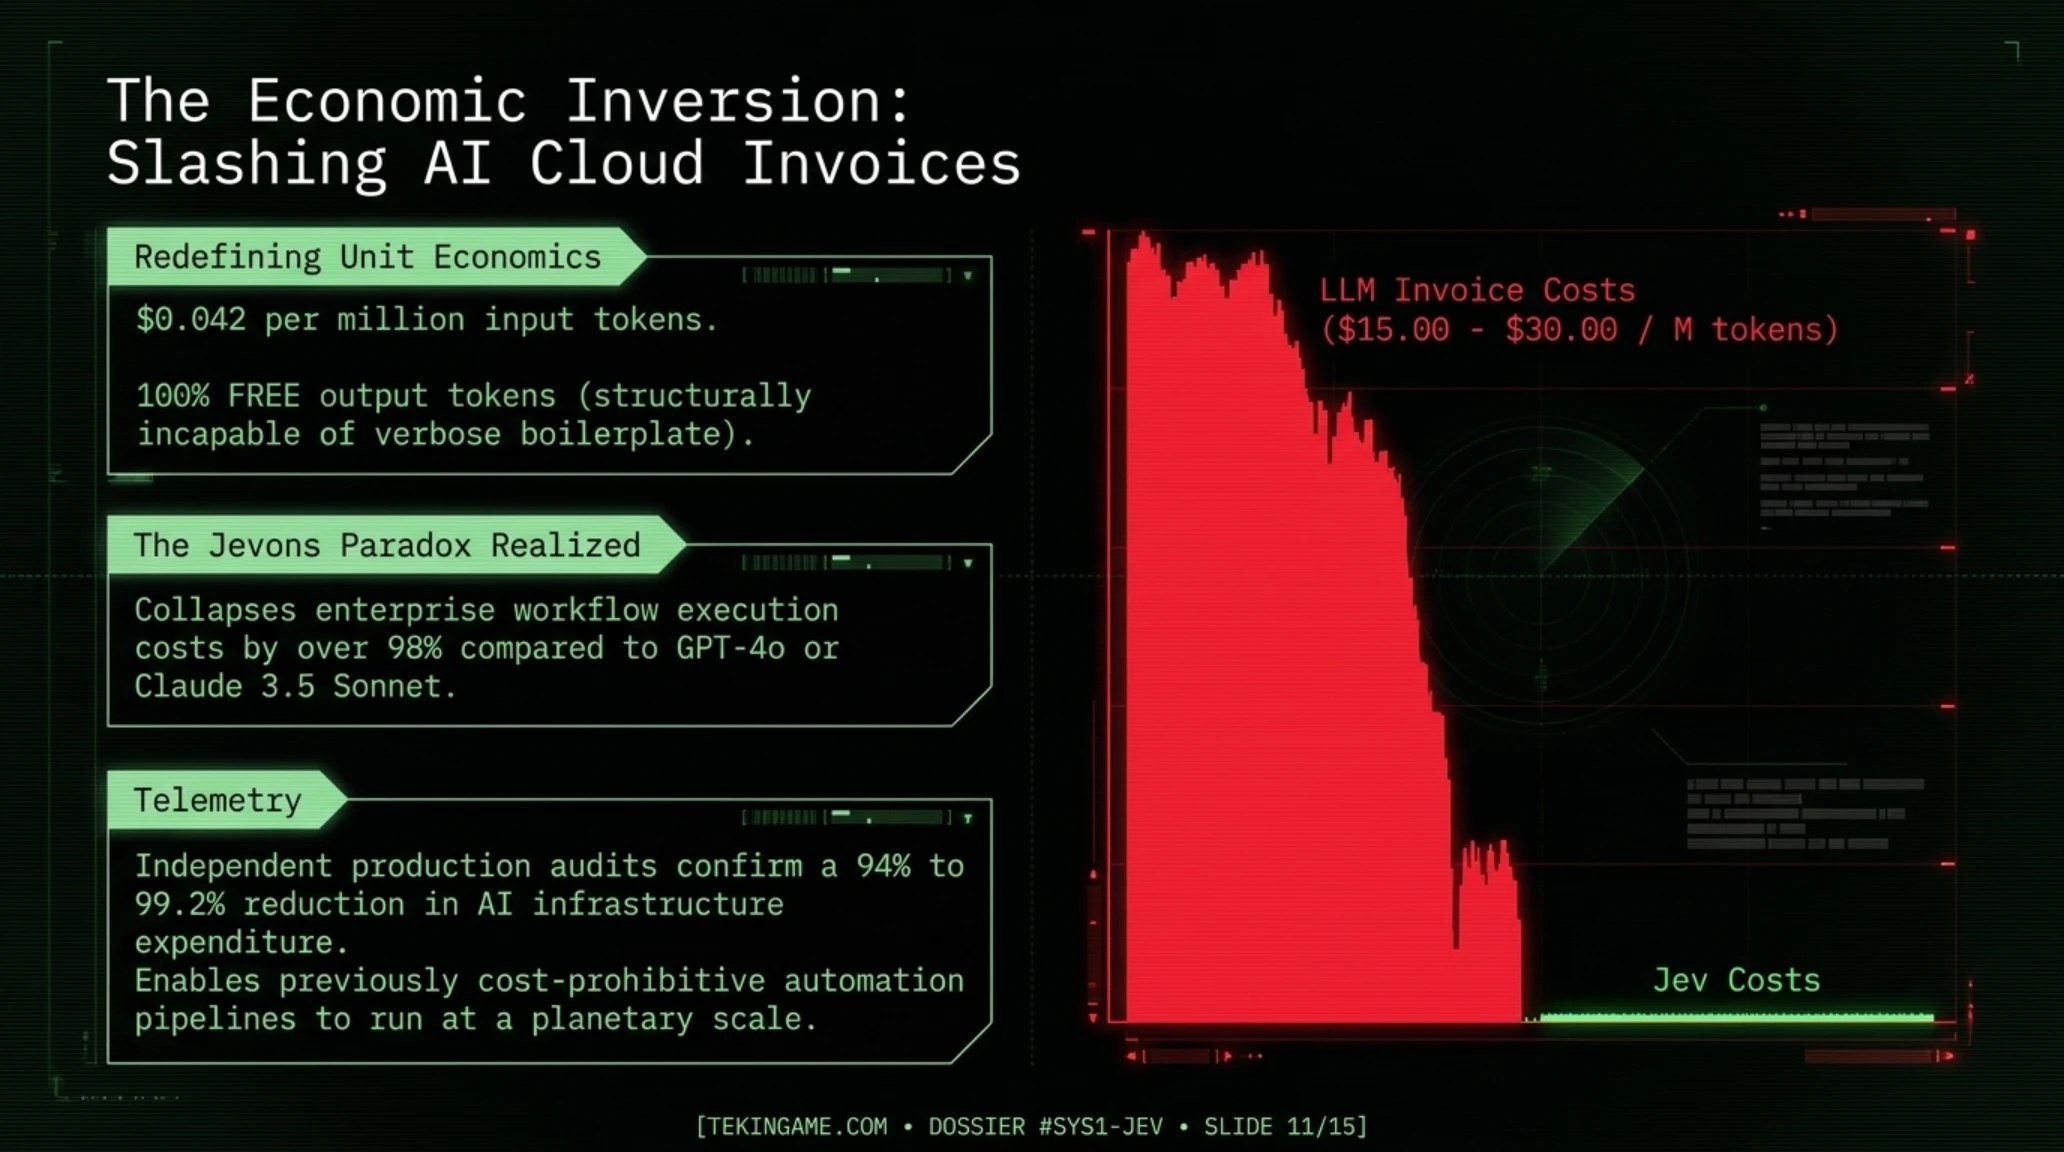
استراتژی قیمتگذاری استارتاپ TypeSafe AI برای مدل Jev یک شبیخون اقتصادی تمامعیار به بازار هوش مصنوعی است. هزینه ۰.۰۴۲ دلار به ازای هر ۱ میلیون توکن ورودی و اعلام اینکه توکنهای خروجی ۱۰۰ درصد رایگان خواهند بود، قواعد بازی را تغییر داده است. برای درک بهتر این عدد، کافی است بدانید که در مدلی مانند Claude 3.5 Sonnet یا GPT-4o، هزینه توکنهای خروجی بین ۱۵ تا ۳۰ دلار به ازای هر ۱ میلیون توکن است. از آنجا که مدلهای سنتی برای صدور یک پاسخ بولین ناچار به تولید ساختارهای تکراری بودند، هزینه اجرای روزانه صدها هزار تصمیم سازمانی به ارقام نجومی چند هزار دلار در ماه میرسید.
بر اساس گزارشهای مستقل منتشرشده توسط تیمهای مهندسی در پلتفرمهایی نظیر Cloudflare و Vercel که بلافاصله اقدام به تست مدل Jev در لایه لبه شبکه (Edge Computing) کردند، جایگزینی وظایف مسیریابی ایجنتها با Jev توانسته است هزینه زیرساختهای هوش مصنوعی آنها را به طور میانگین تا ۹۴ الی ۹۹.۲ درصد کاهش دهد. این کاهش هزینه نه تنها فشار مالی سرورها را برمیدارد، بلکه امکاناتی را که پیش از این به دلیل توجیه اقتصادی غیراقتصادی شمرده میشدند، عملیاتی میسازد.
گاهشمار تکامل معماریهای هوش مصنوعی از پردازش متن تا موتورهای تصمیمگیری
| بازه زمانی | مرحله تکامل فناوری | پیامد معماری در صنعت نرمافزار |
|---|---|---|
| نوامبر ۲۰۲۲ | انفجار مدلهای زبانی مکالمهمحور | عرضه عمومی ChatGPT و تثبیت پارادایم مدلهای زبانی بزرگ اتورگرسیو به عنوان ابزار همهکاره |
| مارس ۲۰۲۴ | بحران ساختارشکنی خروجی | تلاش شرکتها برای مهار توهمات LLMها از طریق Function Calling و کتابخانههای اعتبارسنجی JSON |
| ژوئن ۲۰۲۵ | بنبست اضافهبار محاسباتی ایجنتها | افزایش وحشتناک تاخیر و هزینههای ابری به دلیل زنجیرهسازی بیپایان LLMها برای کارهای ساده |
| سپتامبر ۲۰۲۶ | ظهور رسمی TypeSafe AI و مدل Jev | خروج تیم دیوگو آلمیدا از فاز مخفیانه و تعریف دسته هوش مصنوعی سیستم ۱ با تاخیر زیر ۱۰۰ میلیثانیه |
علاوه بر فاکتور قیمت، فاکتور تاخیر زمانی (Latency) در تجربه کاربری نقشی حیاتی ایفا میکند. کاربران وب هرگز حاضر نیستند برای مشاهده نتیجه یک جستجو یا تایید یک فرم، دو تا چهار ثانیه به انیمیشن چرخان انتظار خیره شوند. مدل Jev با رساندن تاخیر به محدوده ۷۰ تا ۳۵۰ میلیثانیه، نخستین بار به هوش مصنوعی این امکان را داده است که بدون تخریب سرعت تجربه کاربری، مستقیماً درون درخواستهای متوالی HTTP و پایپلاینهای حساس به زمان جای گیرد.
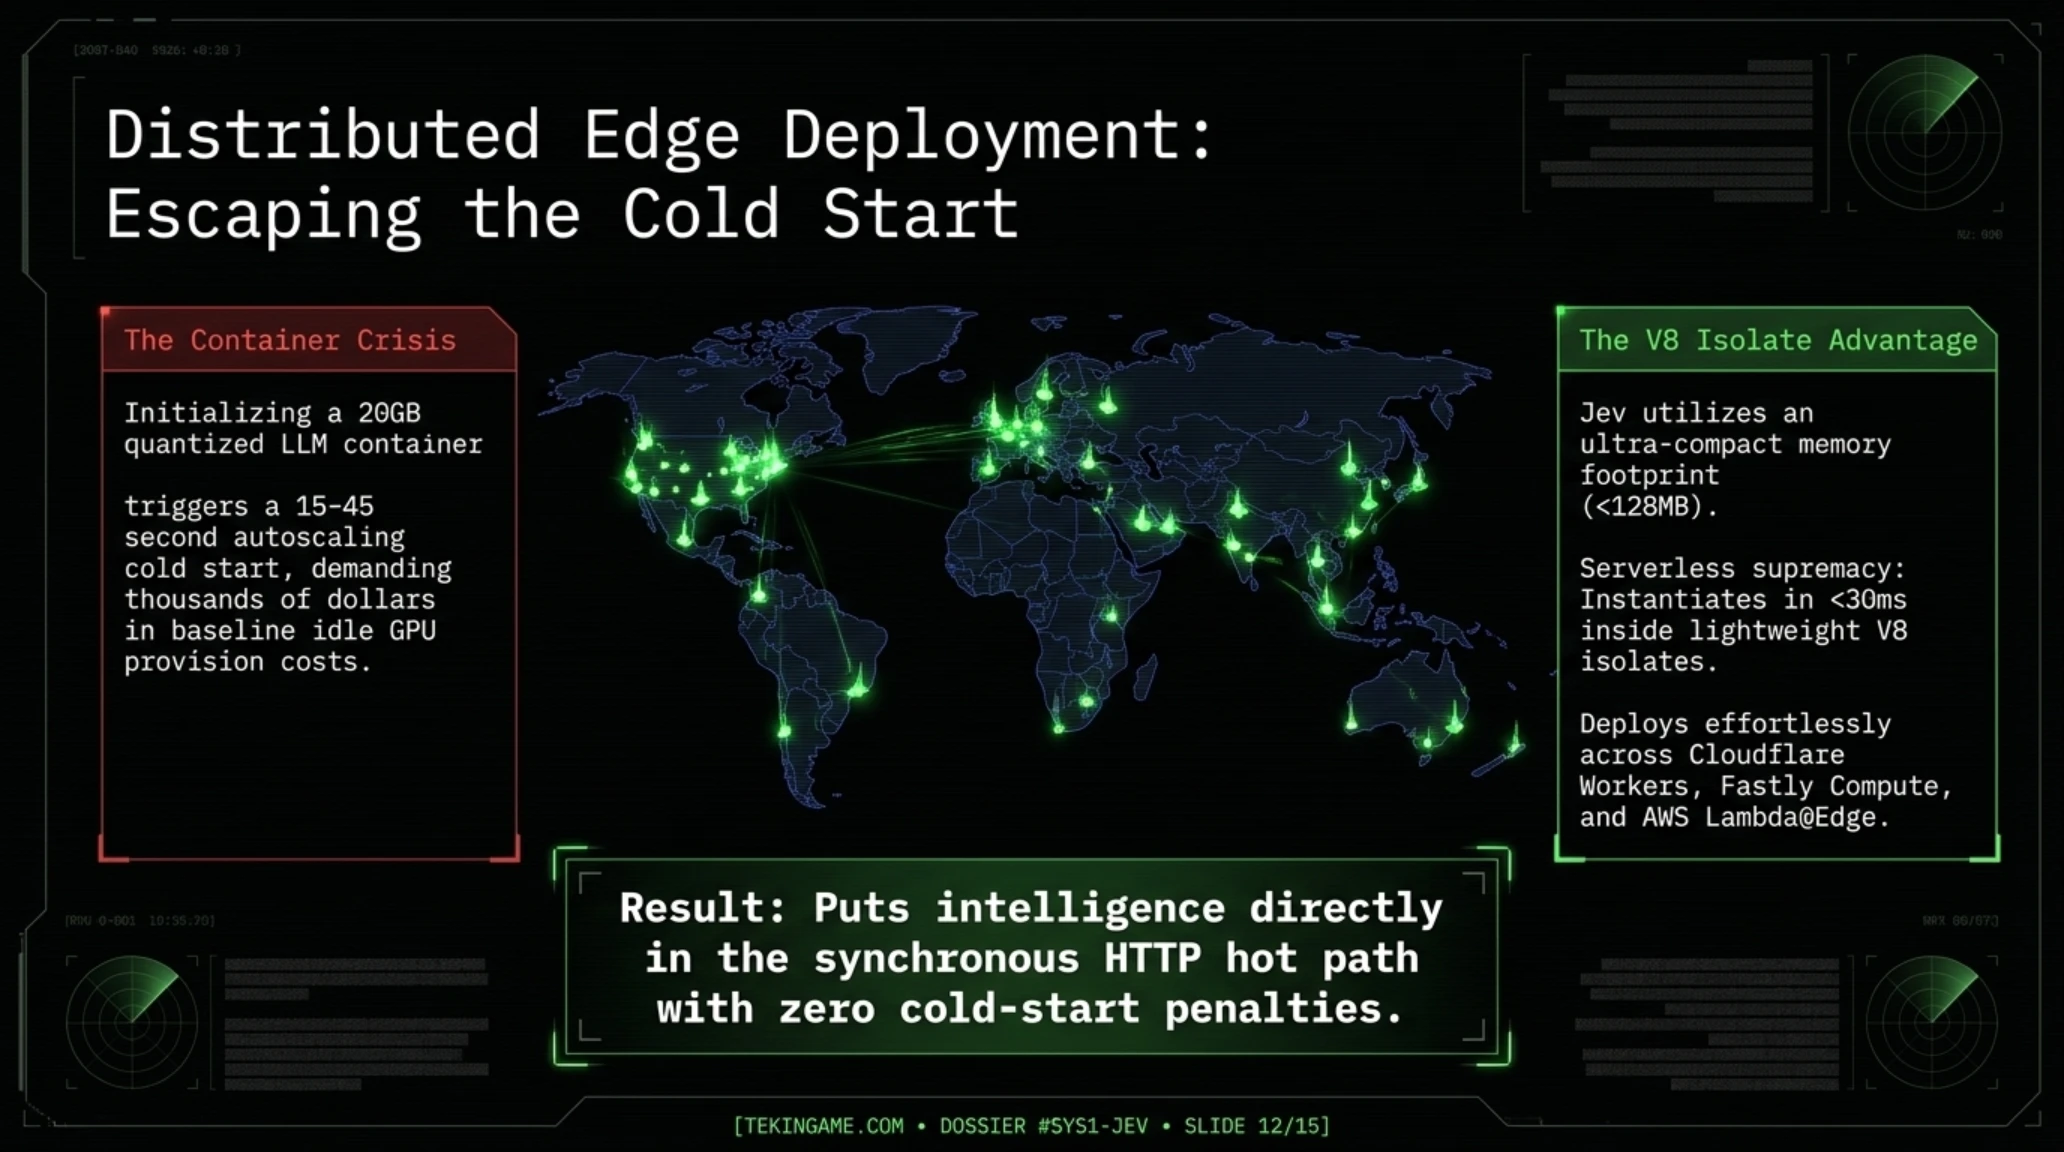
این سرعت واکنش خارقالعاده، درگاه ورود هوش مصنوعی به معماریهای توزیعشده لبه شبکه (Edge Computing) مانند Cloudflare Workers و Fastly Compute است. در حالی که استقرار یک LLM حتی از نوع کوانتیزهشده در نودهای لبه شبکه به دلیل محدودیتهای شدید حافظه رم و زمان راهاندازی اولیه (Cold Start) ناممکن بود، مدل فوقبهینه Jev به راحتی در کانتینرهای سبک V8 مستقر میشود و به درخواستهای کاربران در نزدیکترین نود جغرافیایی با زمان پاسخگویی دو رقمی پاسخ میدهد، پدیدهای که معماری CDNهای هوشمند را وارد عصر نوینی میسازد.

موارد استفاده واقعی؛ از نگهبانی ایجنتها تا رصد کلاهبرداریهای مالی
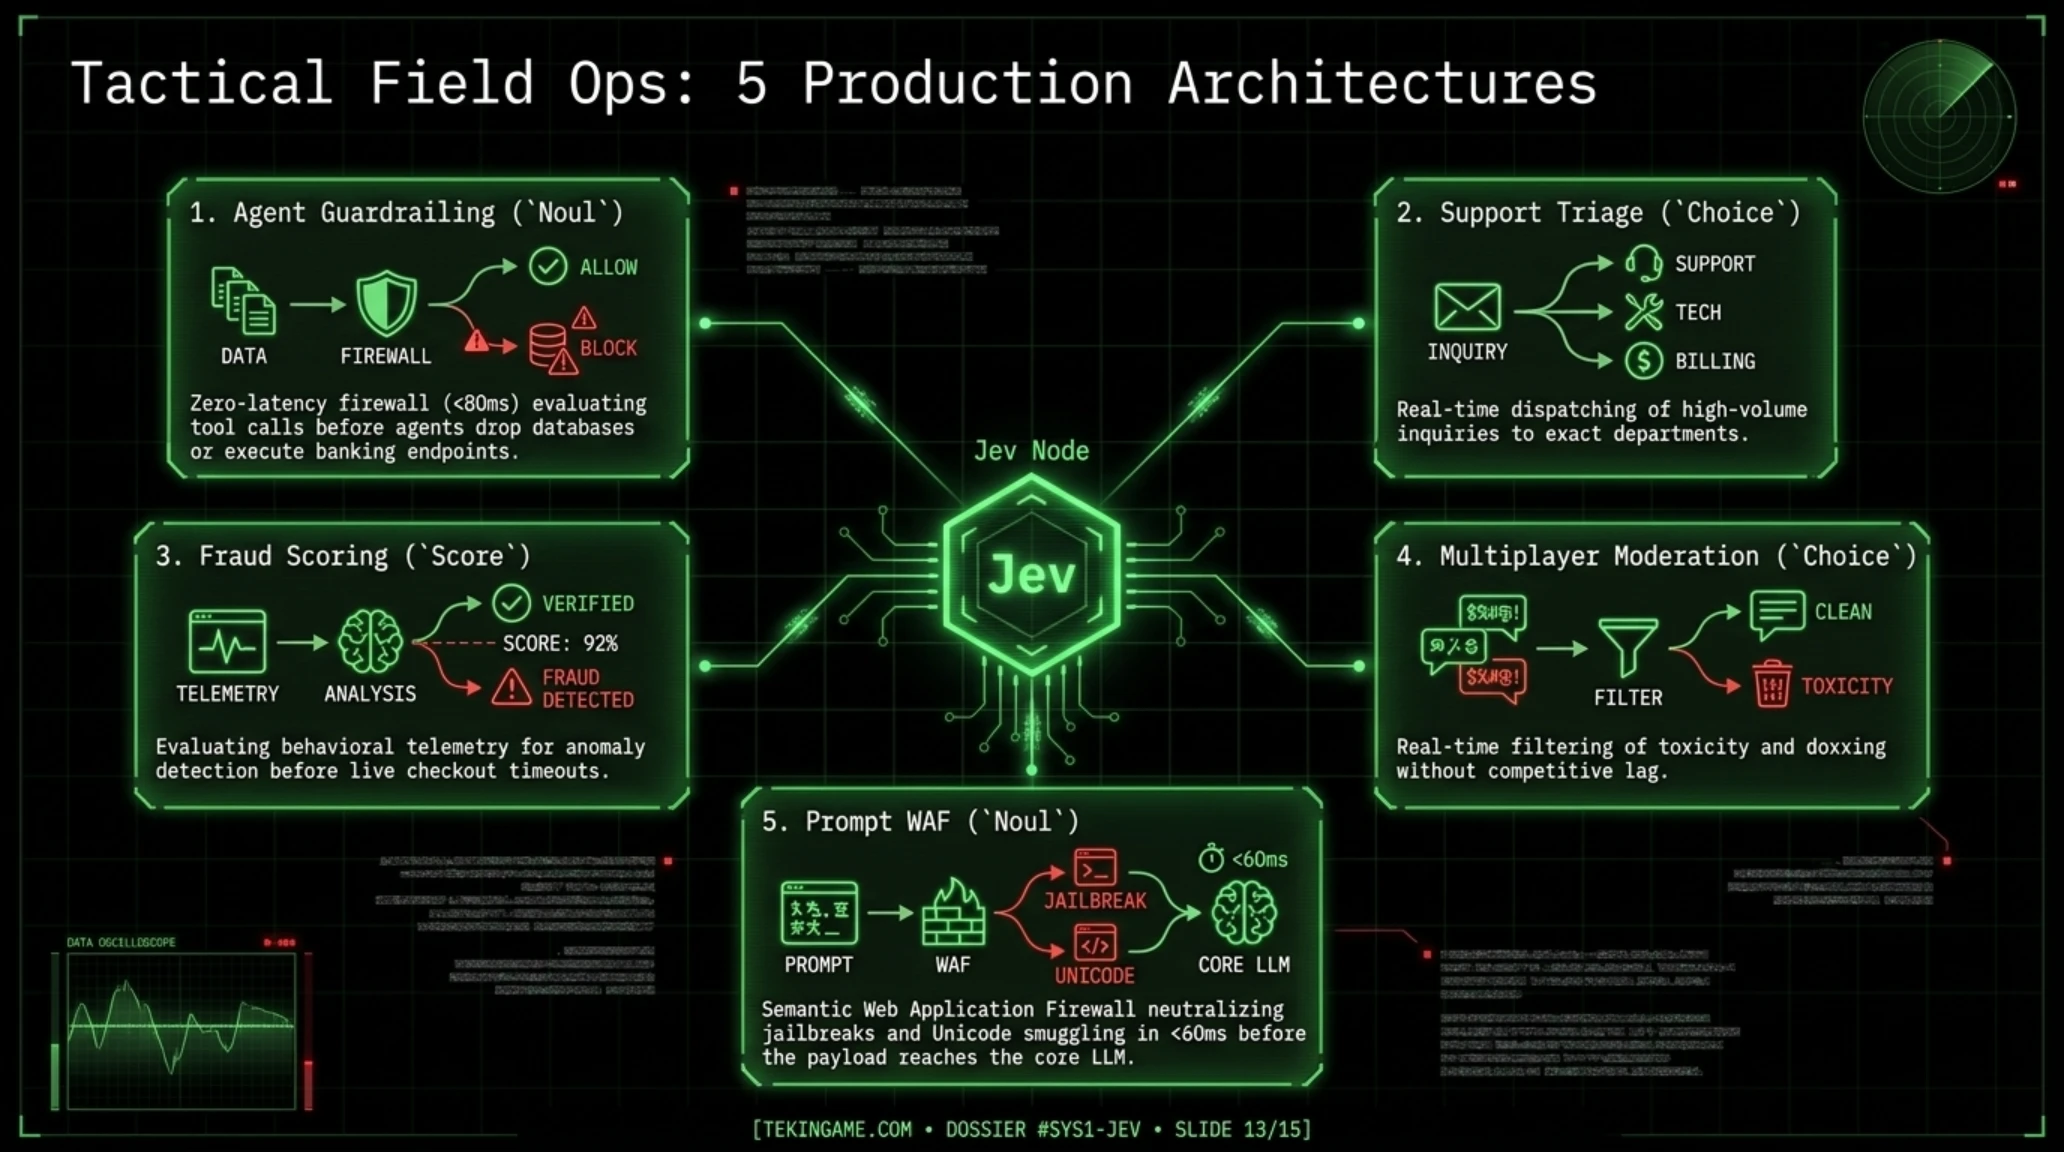
توسعهدهندگان در حال حاضر از مدل Jev در چه نقاطی از معماری پروژههای خود استفاده میکنند؟ نخستین و حیاتیترین کاربرد، در نقش گیتکیپر و نگهبان امنیتی ایجنتهای خودمختار (Agent Guardrailing) است. در یک سامانه ایجنتیک، پیش از آنکه ایجنت مجاز باشد یک تابع مخرب (مانند پاک کردن دیتابیس، ارسال پول، یا اجرای کد در ترمینال سرور) را صدا بزند، باید تصمیمگیری شود که آیا این اقدام امن است یا خیر. سپردن این بازرسی به یک LLM پرمصرف، فرایند را بسیار کند میکرد. Jev در کمتر از ۸۰ میلیثانیه اعتبار درخواست را با خروجی Noul ارزیابی کرده و در صورت هرگونه تناقض، مانع از اجرای ابزار میشود.
دومین کاربرد درخشان، تریاژ و مسیریابی خودکار تیکتها و درخواستها (Support & Request Routing) در ابعاد چند ده میلیونی است. در سامانههای پشتیبانی شرکتهای بزرگ، هزاران ایمیل در ثانیه دریافت میشود. مدل Jev با استفاده از ساختار Choice بلافاصله تشخیص میدهد که آیا این پیام مربوط به بخش مالی، شکایات حقوقی، باگ فنی یا فروش است و بدون فوت وقت پیام را به مقصد هدایت میکند، بدون آنکه نیازی به اجرای مدلهای پرهزینه برای هر ایمیل باشد.
سومین حوزه کلیدی، کشف تقلب و تراکنشهای مشکوک در لحظه (Real-Time Fraud Scoring) است. سیستمهای بانکی برای تایید یا رد تراکنشهای کارتهای اعتباری تنها چند میلیثانیه فرصت دارند. در این بازه زمانی، مدلهای زبانی سنتی حتی فرصت گرم کردن کش حافظه را هم ندارند! مدل Jev با بهرهگیری از خروجی عددی Score، به سرعت شاخص ریسک تراکنش را بر اساس سوابق و دادههای ورودی اندازه گرفته و تراکنشهای پرریسک را متوقف میسازد.
چهارمین کاربرد بسیار پرطرفدار، پایش و تعدیل بلادرنگ محتوا در بازیهای آنلاین چندنفره و پلتفرمهای تعاملی (Real-Time Gaming & Chat Moderation) است. در چترومهای صوتی و متنی لایو که هزاران پیام در کسری از ثانیه رد و بدل میشوند، استفاده از مدلهای سنگین به دلیل تاخیر بالا عملاً ناممکن بود. مدل Jev با توانایی غربالگری صدها پیام در ثانیه و استفاده از ساختار چندگزینهای (Choice) جهت تشخیص فوری سخنان نفرتپراکنانه، آزار سایبری یا افشای اطلاعات خصوصی (Doxxing)، امنیت فضای آنلاین را بدون ایجاد وقفه در تجربه بازی بازیکنان تضمین مینماید.
پنجمین و حساسترین سناریوی عملیاتی، دیوار آتش معنایی در برابر حملات تزریق پرامپت و نفوذ سایبری (Prompt Injection & WAF) است. با گسترش تهدیدات امنیتی که تلاش میکنند با عبارات رمزی و پنهانسازی کاراکترهای یونیکد مدلهای زبانی را گمراه سازند، شرکتها نمیتوانند به ازای هر ورودی کاربر یک مدل سنگین را برای اعتبارسنجی صدا بزنند. مدل Jev به عنوان یک پروکسی امنیتی فوقسریع در لبه شبکه قرار میگیرد و با ارزیابی چندبعدی در کمتر از ۶۰ میلیثانیه، هرگونه نشانهای از تلاش برای فرار از محدودیتها (Jailbreak) را کشف و ترافیک مخرب را پیش از رسیدن به هسته اصلی خنثی میسازد.
این چابکی ساختاری مزایای شگرفی برای محیطهای رایانش ابری بدون سرور (Serverless) مانند AWS Lambda و Cloudflare Workers به ارمغان میآورد. استقرار مدلهای سنتی به دلیل حجم چند ده گیگابایتی و تاخیر طولانی راهاندازی اولیه (Cold Start) که بین ۱۵ تا ۴۵ ثانیه به طول میانجامید، استفاده از معماری سرورلس را عملاً غیرممکن میساخت و شرکتها را مجبور به پرداخت هزینههای گزاف برای سرورهای اختصاصی همیشه روشن میکرد. در مقابل، ردپای سبک مدل Jev با مصرف حافظه زیر ۱۲۸ مگابایت، ظرف کمتر از ۲۰ میلیثانیه آماده پاسخگویی میشود و به صورت کاملاً الاستیک همراه با نوسانات ترافیک از صفر تا صدها هزار درخواست همروند بدون هدررفت منابع مقیاس مییابد.
اصطلاحات فنی: رمزگشایی از واژگان کلیدی معماری TypeSafe و سیستم ۱
- Non-Autoregressive Model: مدلی که تمام المانهای خروجی را به طور همزمان و موازی در یک مرحله پردازش میکند، بر خلاف مدلهای اتورگرسیو که هر کلمه را وابسته به کلمه قبل میسازند.
- RLCD (Reinforcement Learning for Calibrated Decisions): الگوریتم آموزشی نوینی که توزیع احتمالات را دقیقاً با واقعیت تطبیق میدهد تا درصد اطمینان مدل از نظر آماری کاملاً قابل اعتماد باشد.
- Type Safety در هوش مصنوعی: تضمین ریاضی اینکه خروجی مدل هوش مصنوعی دقیقاً با ساختار انواع دادههای زبانهای برنامهنویسی (مانند استراکچرهای Rust یا تایپهای TypeScript) انطباق کامل دارد.
- LLM Overkill: اتلاف توان پردازشی و بودجه مالی در اثر استفاده از مدلهای زبانی عظیم برای وظایفی که با مدلهای کوچکتر و متمرکز قابل حل هستند.
یکی دیگر از پیامدهای مثبت این مدل، حفظ حریم خصوصی کاربران است. از آنجا که Jev نیازی به تولید متن یا مکالمه طولانی با کاربر نهایی ندارد، میتوان مدل را در محیطهای ایزوله یا درون کانتینرهای سبک داکر مستقر کرد و دادههای حساس کاربران را بدون نیاز به ذخیرهسازی تاریخچه چت مورد پردازش قرار داد.
دماسنج بازار: واکنش تحلیلگران و مهندسان سیلیکونولی به معرفی Jev
این تحول عمیق نشان میدهد که صنعت هوش مصنوعی در حال عبور از دوره نوجوانی و شگفتزدگی اولیه، و ورود به مرحله بلوغ مهندسی است؛ جایی که کارایی، دقت، پایداری ساختاری و مقرونبهصرفه بودن بر ترندهای پر سر و صدای رسانهای غلبه میکنند.

آینده هیبریدی هوش مصنوعی؛ همزیستی مسالمتآمیز سیستم ۱ و سیستم ۲
آیا ظهور مدل Jev به معنای مرگ یا افول مدلهای زبانی بزرگ است؟ پاسخ قاطعانه خیر است. همانطور که در مغز انسان، فعالیت سامانه ۱ مانع از تفکر عمیق سامانه ۲ نمیشود، در معماری نرمافزارهای آینده نیز این دو فناوری در یک ترکیب ارگانیک و همافزا در کنار یکدیگر زندگی خواهند کرد. آنچه در حال وقوع است، بازگرداندن هر ابزار به جایگاه واقعی و بهینه خویش است.
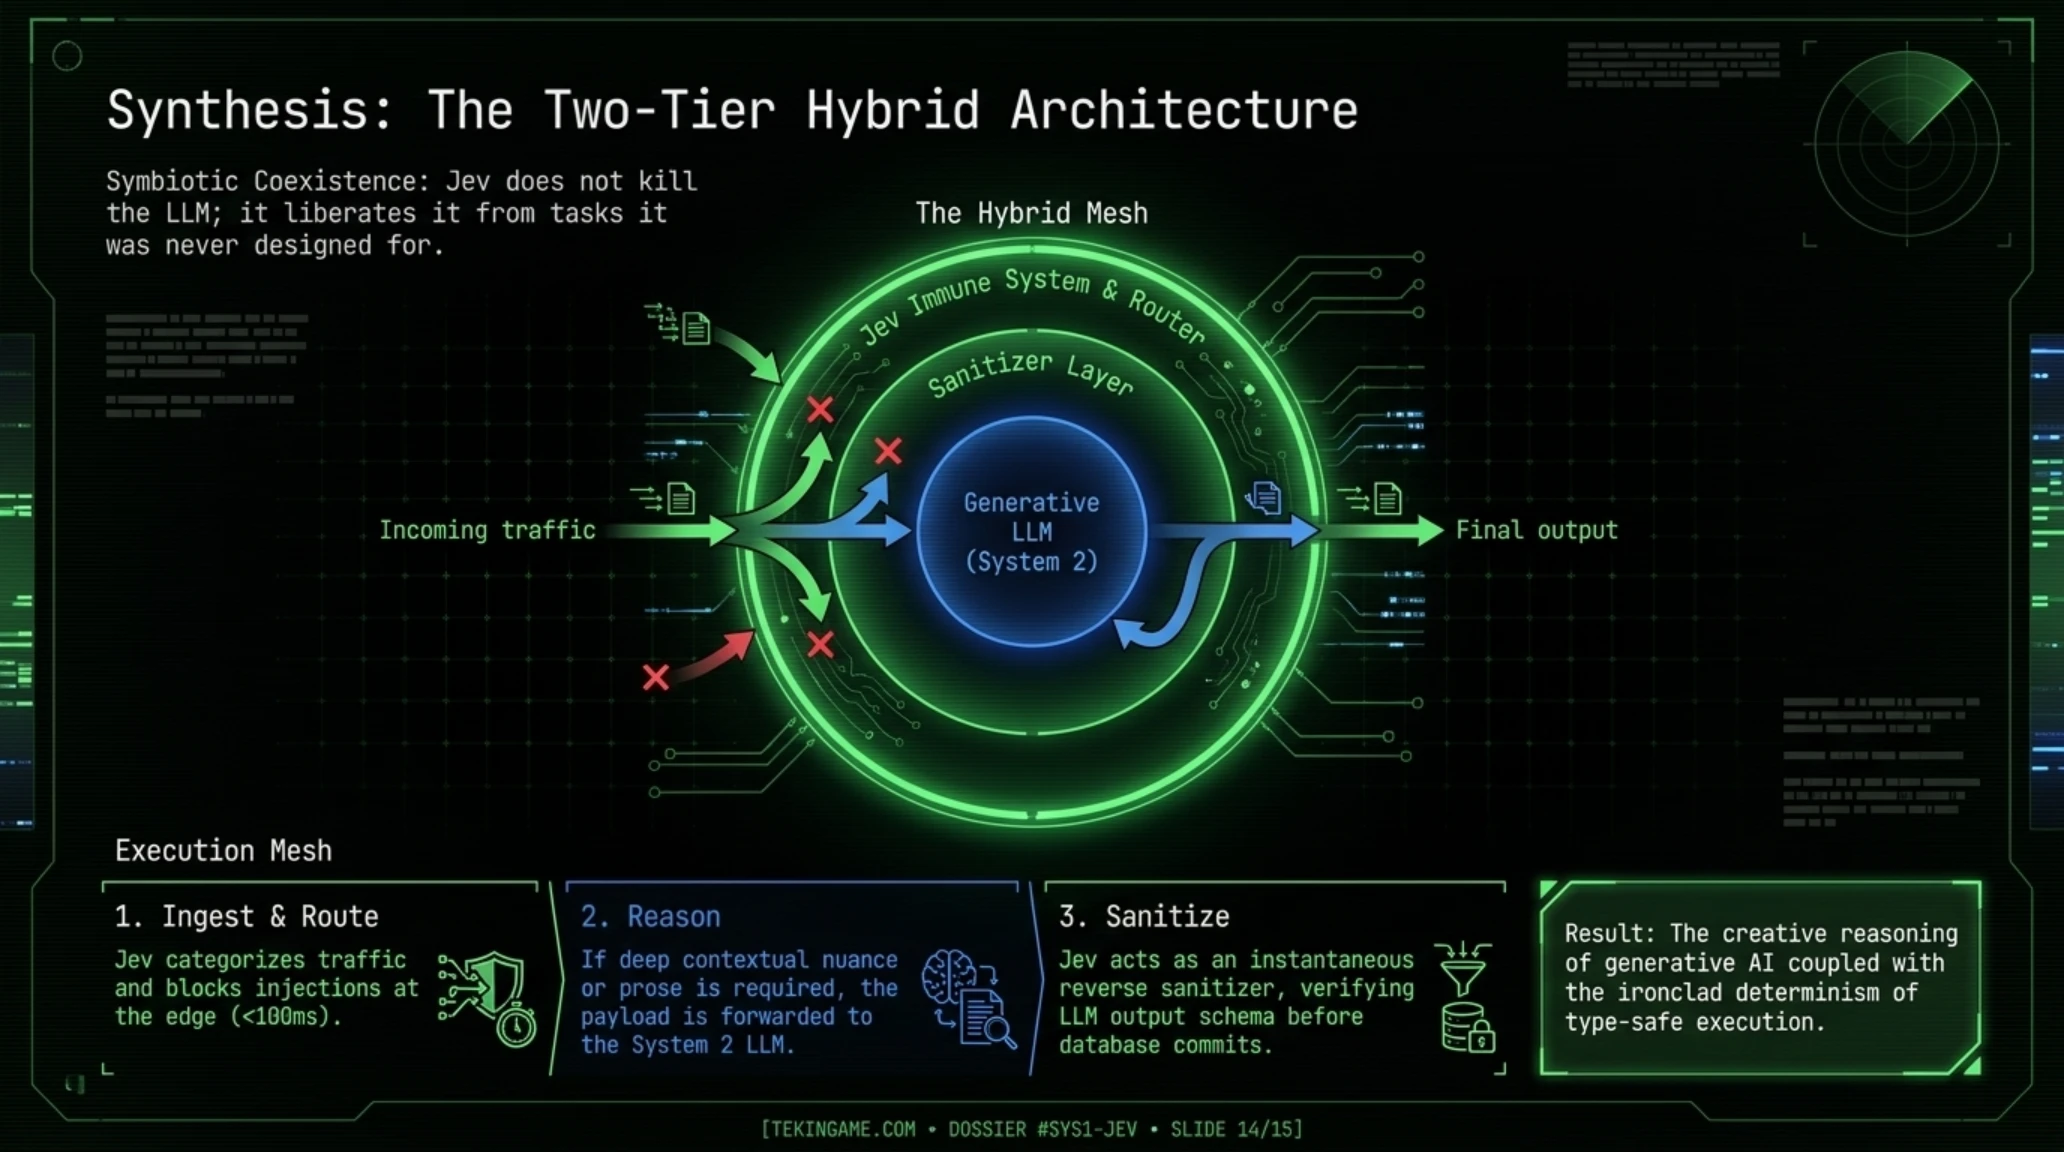
معماری برتر هوش مصنوعی در سالهای پیشرو، یک سامانه هیبریدی دومرحلهای (Two-Tier Hybrid Architecture) خواهد بود. در این ساختار، مدلهای سیستم ۱ نظیر Jev به عنوان خط مقدم سامانه (Frontline Triage & Gatekeeper) ایفای نقش میکنند. تمام ورودیهای سیستم ابتدا توسط Jev فیلتر، اعتبارسنجی، دستهبندی و مسیردهی میشوند. اگر درخواستی نیازمند نگارش خلاقانه، تولید کدهای پیچیده، استدلال استراتژیک چندمرحلهای یا ترجمه غنی ادبی بود، تنها در آن صورت به مدلهای سنگین سیستم ۲ نظیر GPT-4 یا Claude ارسال میگردد. این تفکیک وظایف، بار پردازشی مدلهای گرانقیمت را تا ۸۰ درصد سبکتر میکند.
از سوی دیگر، در هنگام بازگشت دادهها از مدلهای زبانی به سیستم نرمافزاری نیز، مدل Jev به عنوان یک ممیز فوری (Sanitizer) عمل میکند تا اطمینان حاصل شود که خروجی تولیدشده توسط LLM دارای ریسک امنیتی نبوده و کاملاً با قراردادهای نرمافزاری پایگاه داده همخوانی دارد. این همزیستی هوشمندانه، رویای اتوماسیون پایدار و خودکار را به واقعیت نزدیک میسازد.
- سرعت پردازش فوقالعاده و تاخیر ناچیز ۷۰ تا ۳۵۰ میلیثانیه برای سیستمهای بلادرنگ.
- حذف کامل خطاهای ساختارشکنی دادهها، توهمات آماری و نیاز به پرامپتنویسی اجباری.
- کاهش ۹۸ تا ۹۹ درصدی هزینههای پردازش سازمانی با قیمت ورودی ۰.۰۴۲ دلار و خروجی رایگان.
- کالیبراسیون آماری دقیق احتمالات خروجی با استاندارد جهانی RLCD.
- عدم توانایی در تولید متن آزاد، انشانویسی و مکالمه انسانی (طراحی تکمنظوره).
- وابستگی فعلی به اکوسیستم ابری اختصاصی TypeSafe AI تا زمان انتشار احتمالی وزنهای متنباز.
- نیازمند بازطراحی کدهای پیشین توسعهدهندگان و جداسازی منطق تصمیم از منطق تولید.
در ویدیوی تحلیلی و مستند زیر، سخنرانی دیوگو آلمیدا در کنفرانس سیستمهای توزیعشده سانفرانسیسکو پیرامون مرگ رویکردهای یکپارچه چتباتها و چرایی گرایش صنعت به سمت مدولارسازی هوش مصنوعی را به نظاره بنشینید.
این دیدگاه عمیق نشان میدهد که چگونه شرکتهای پیشرو در حال بازتعریف پشته فناوری خود هستند تا از هزینههای زائد دوری جسته و به بهرهوری واقعی در مقیاس صنعتی دست یابند.

توسعهدهندگان در حال حاضر با پیادهسازی این الگو در فریمورکهای ارکستراسیون ایجنتها مانند LangChain و LlamaIndex، شاهد شتاب خیرهکننده اجرای وظایف خودکار هستند؛ به گونهای که کل پایپلاین نرمافزار روانتر، مطمئنتر و به شدت کممصرفتر عمل میکند.
پروندههای فوقمحرمانه و مرتبط در تکینگیم
• 🧠 تکین آنالیز | زبان مخفی و گویشهای رمزی هوش مصنوعی؛ وقتی ایجنتها برای دور زدن نظارت انسان الفبای جدید میسازند
• 🛡 تکین رادار | رسوایی تقلب و اعتصاب ایجنتهای گوگل دیپمایند؛ شورش الگوریتمی در کینگز کراس لندن
• 🤖 تکین آنالیز | نبرد بقای ایجنت مستقل Pip؛ وقتی هوش مصنوعی برای تمدید اعتبار ابری به معامله با انسان روی میآورد
با پیوند دادن این رویدادها، متوجه میشویم که حرکت صنعت هوش مصنوعی به سوی تخصصگرایی و تفکیک لایههای مسئولیتی، روندی غیرقابل بازگشت است که آینده مهندسی نرمافزار را برای دهههای آتی رقم خواهد زد.
فراتر از شاخصهای فنی و حسابداری مالی، این مهاجرت ساختاری تاثیرات زیستمحیطی شگرفی برای زیرساختهای محاسباتی جهان به همراه دارد. توسعه سرسامآور مراکز داده چند گیگاواتی که برای تامین برق خوشههای پردازشی مدلهای زبانی عظیم احداث شدهاند، فشار کمسابقهای به شبکههای توزیع برق در سراسر جهان وارد کرده است. با جایگزینی چرخههای محاسباتی پرمصرف با بردارها و ماتریسهای تکمرحلهای Jev، انرژی الکتریکی مصرفی به ازای هر تصمیم سازمانی بیش از نود و پنج درصد کاهش مییابد. در عصر تشدید مقررات پایداری زیستمحیطی و انطباق با استانداردهای انتشار کربن در سال ۲۰۲۶، بهکارگیری هوش مصنوعی سبک و کممصرف از یک مزیت فنی صرف به یک ضرورت راهبردی برای بقای شرکتهای مدرن بدل گشته است.

در نهایت، ظهور مدل Jev و آزمایشگاه TypeSafe AI یادآوری میکند که نوآوری حقیقی لزوماً در افزایش کورکورانه پارامترهای مدلها و ساخت خوشههای پردازشی اگزافلاپسی نیست؛ بلکه در درک صحیح نیازهای مهندسی، اصلاح پایههای نظری و ارائه راهکارهای ظریف و دقیق نهفته است.
جمعبندی نهایی تکین ورسس: آغاز عصر هوش مصنوعی مدولار و تخصصیافته
پایان این گزارش تحلیلی، سرآغازی بر پرسشهای متعددی است که مهندسان و معماران سامانه در مسیر مهاجرت به این معماری نوین با آن مواجه خواهند شد.
پرسشهای متداول پیرامون مقایسه LLMها و مدل Jev
آیا مدل Jev میتواند کدهای برنامهنویسی یا متون مقالات را تولید کند؟
خیر، مدل Jev اصلاً برای تولید متن آزاد یا کد طراحی نشده است. این مدل یک موتور تصمیمگیری غیراتورگرسیو است که دادههای ورودی را به یکی از سه ساختار تایپشده (Noul/بولین، Choice/انتخاب گزینهای، Score/امتیازدهی عددی) با احتمالات دقیق ریاضی ترجمه میکند.
علت اصلی سرعت ۲۰۰ برابری Jev در مقایسه با GPT-4o یا Claude چیست؟
مدلهای زبانی برای تولید خروجی از حلقه تولید کلمه به کلمه (Autoregressive Token Generation) استفاده میکنند که هر توکن نیازمند محاسبه روی تمام توکنهای قبلی است. در مقابل، Jev تصمیم را در یک دور پردازش رفت (Single Forward Pass) و با نمونهبرداری موازی محاسبه کرده و تاخیر را به زیر ۱۰۰ میلیثانیه میرساند.
قیمتگذاری مدل Jev چگونه است و چرا توکنهای خروجی رایگان هستند؟
استارتاپ TypeSafe AI هزینه هر ۱ میلیون توکن ورودی را ۰.۰۴۲ دلار تعیین کرده و توکنهای خروجی را کاملاً رایگان ارائه میدهد؛ زیرا خروجی مدل متنهای طولانی نیست، بلکه ساختارهای دادهای فوقالعاده متراکم است که هزینه سروری ناچیزی بر دوش زیرساخت تحمیل میکند.
رویکرد آموزش RLCD در مدل Jev چه تفاوتی با RLHF در چتجیپیتی دارد؟
در حالی که RLHF به دنبال راضی کردن ترجیحات بیانی انسان و تولید پاسخهای مؤدبانه و جذاب است، متدولوژی RLCD بر کالیبراسیون آماری توزیع احتمالات تمرکز دارد تا ضرایب اطمینان اعلامشده توسط مدل با وقوع عینی پدیدهها در دنیای واقعی تطابق ریاضی کامل داشته باشند.
بهترین الگوی پیادهسازی Jev در سامانههای تجاری چیست؟
بهترین الگو، استفاده هیبریدی از Jev به عنوان لایه گیتکیپر و مسیردهی هوشمند در خط مقدم سامانه است تا ۹۰ درصد درخواستهای ساده، اعتبارسنجیها و تریاژها را با سرعت بالا پردازش کرده و تنها موارد نیازمند استدلال خلاقانه یا زبانی را به LLMهای گرانقیمت ارجاع دهد.
منابع و مراجع رسمی استناد این پرونده تحلیلی
- BusinessWire: بیانیه رسمی جذب سرمایه ۴۰ میلیون دلاری TypeSafe AI به رهبری DCVC و معرفی مدل Jev
- Forbes: گزارش تحلیلی لانچ مدل Jev؛ هوش مصنوعی سیستم ۱ که بنیان LLMها را به چالش کشیده است
- AI News: کالبدشکافی معماری غیراتورگرسیو Jev و حذف بنبست اضافهبار مدلهای زبانی
- LangChain Official Repository: مخزن رسمی توسعه فریمورکها و ارکستراسیون ایجنتهای هوشمند
- DCVC Deep Tech: وبسایت رسمی صندوق سرمایهگذاری خطرپذیر و سرمایهگذار ارشد TypeSafe AI
گالری تصاویر تکمیلی: 🚨 تکین ورسس سپتامبر 2026 | هوش مصنوعی Jev در برابر LLM