تکین ورسس | شکست سنگین گوگل در خانه خود؛ چرا جمینای ۴ در کدنویسی اندروید مغلوب کلاود شد؟
زلزله در اکوسیستم توسعه اندروید؛ سقوط پرچمدار دیپمایند در قلمرو بومی
در تاریخ صنعت فناوری، لحظاتی وجود دارند که تمام فرضیات بازاریابی و اقتدار سازمانی یک کمپانی غولپیکر را در کسری از ثانیه زیر سوال میبرند. در اکتبر ۲۰۲۶، انتشار بهروزرسانی جدید جدول ردهبندی بنچمارک اختصاصی Android Bench توسط تیم توسعهدهندگان گوگل، شوکی بیسابقه را به جامعه مهندسی نرمافزار جهان وارد کرد. مدل استدلالگر پرچمدار گوگل، یعنی Gemini 4 Argon که با هیاهوی تبلیغاتی فراوان به عنوان نماد برتری محاسباتی آزمایشگاه دیپمایند معرفی شده بود، در آزمون برنامهنویسی سیستمعامل اندروید شکستی تحقیرآمیز را تجربه کرد.
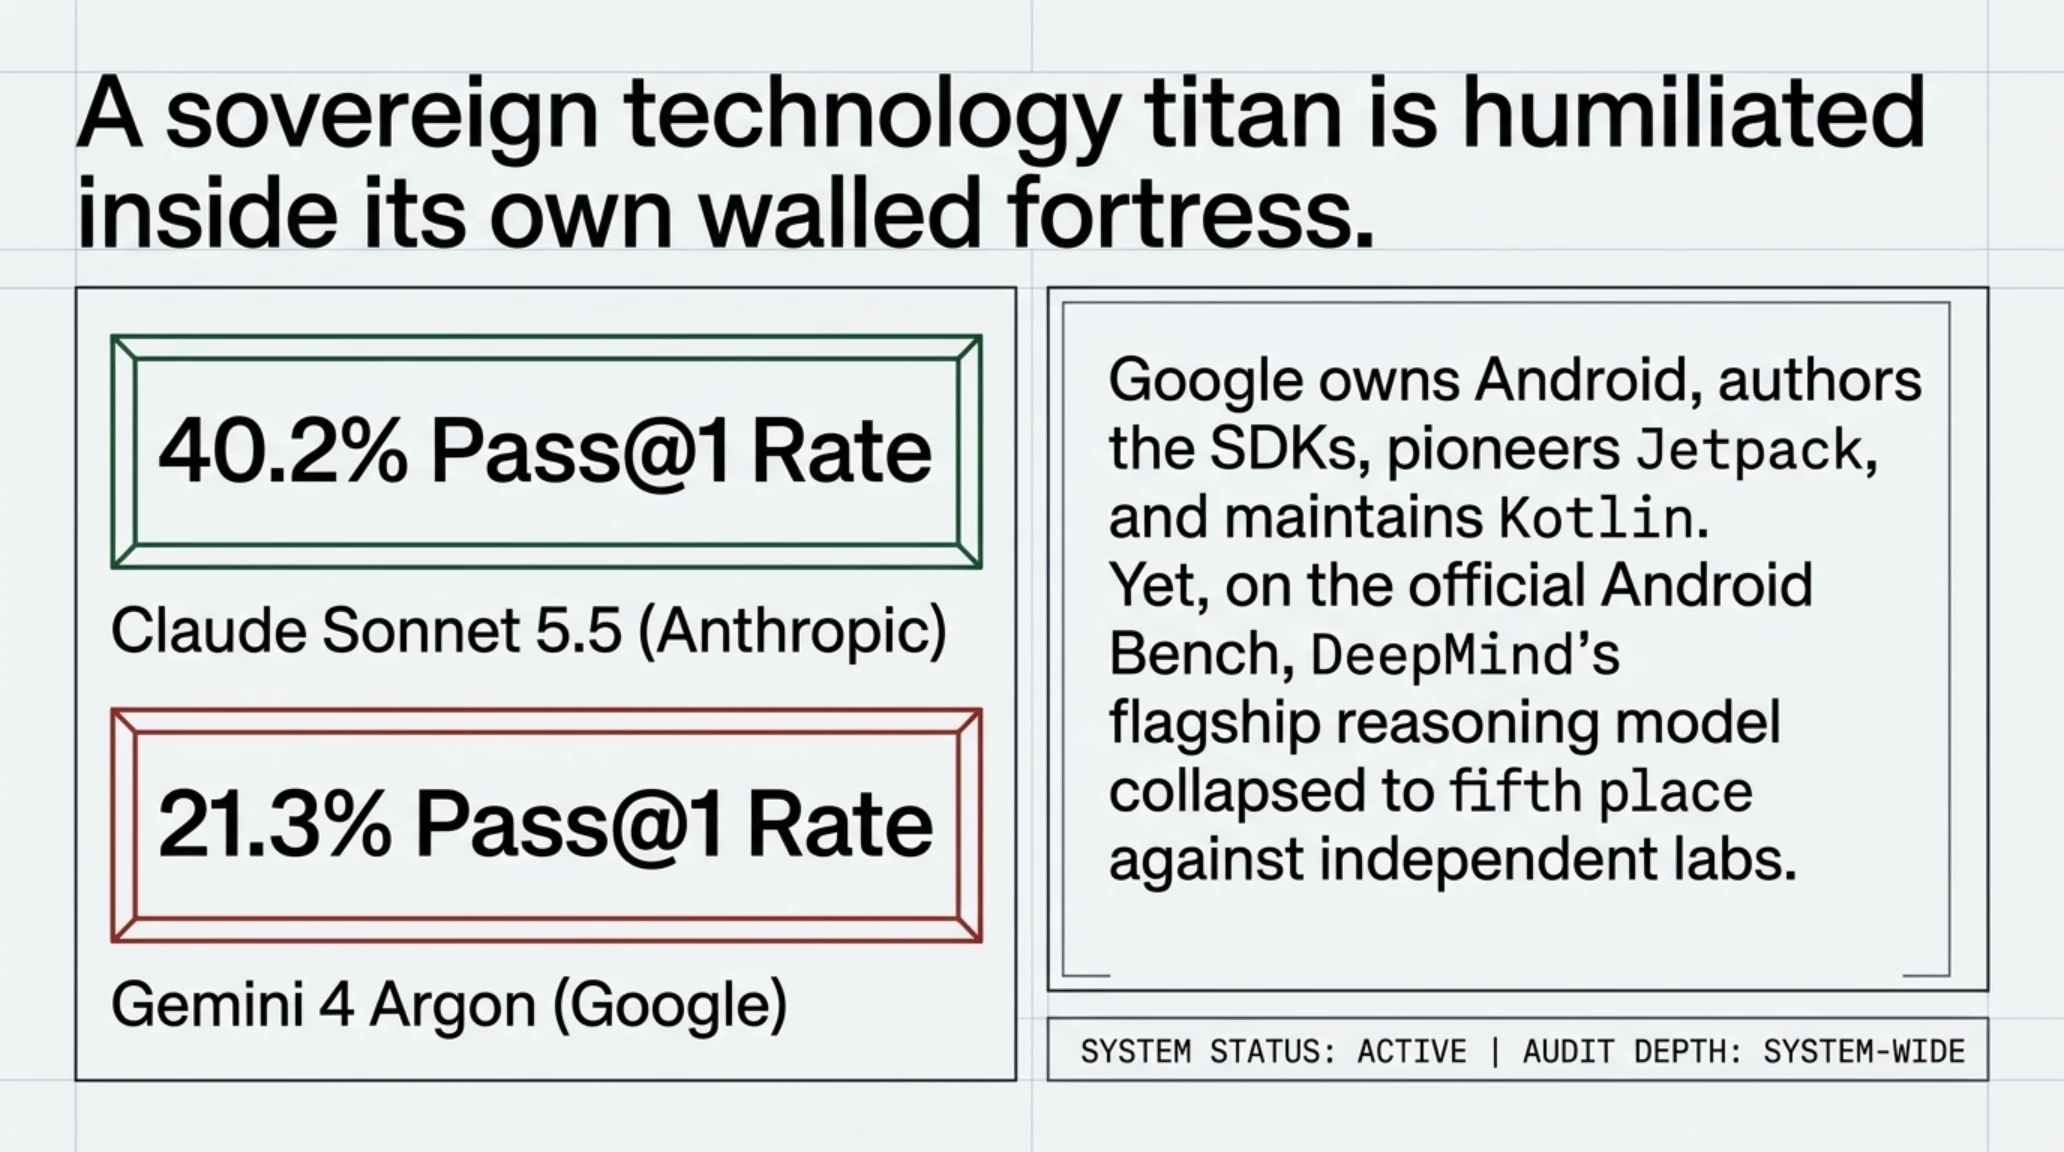
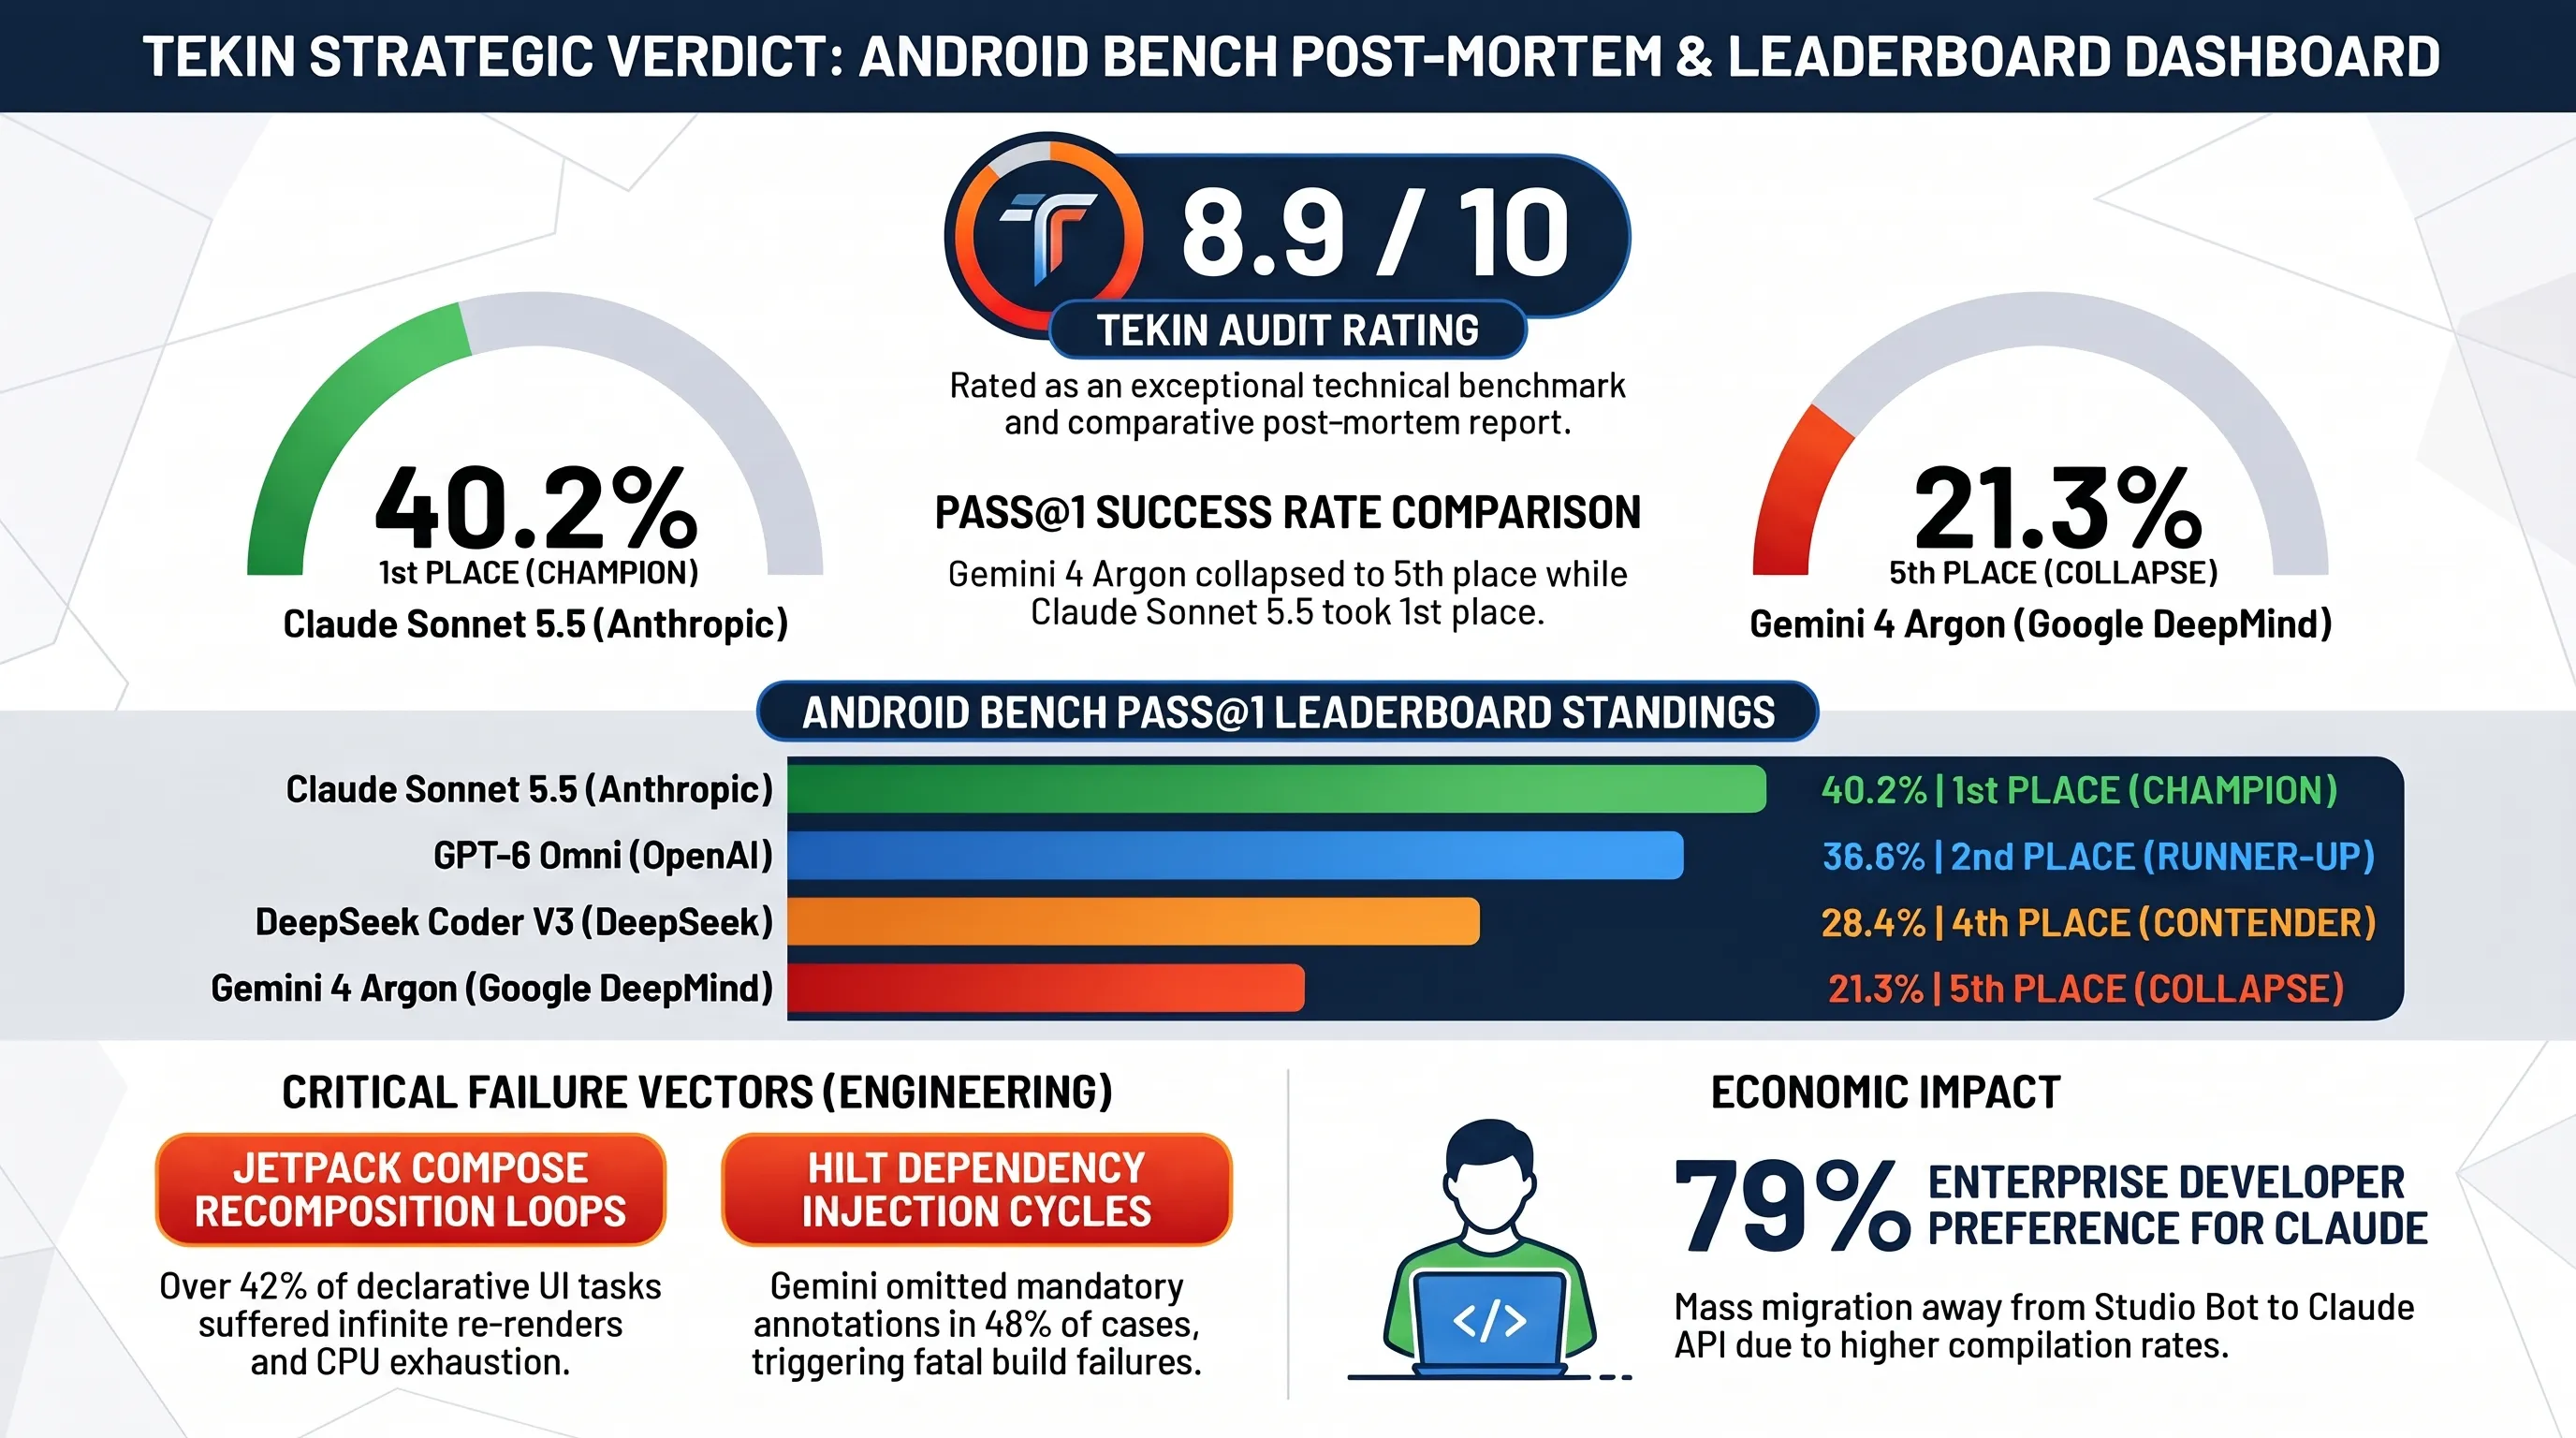
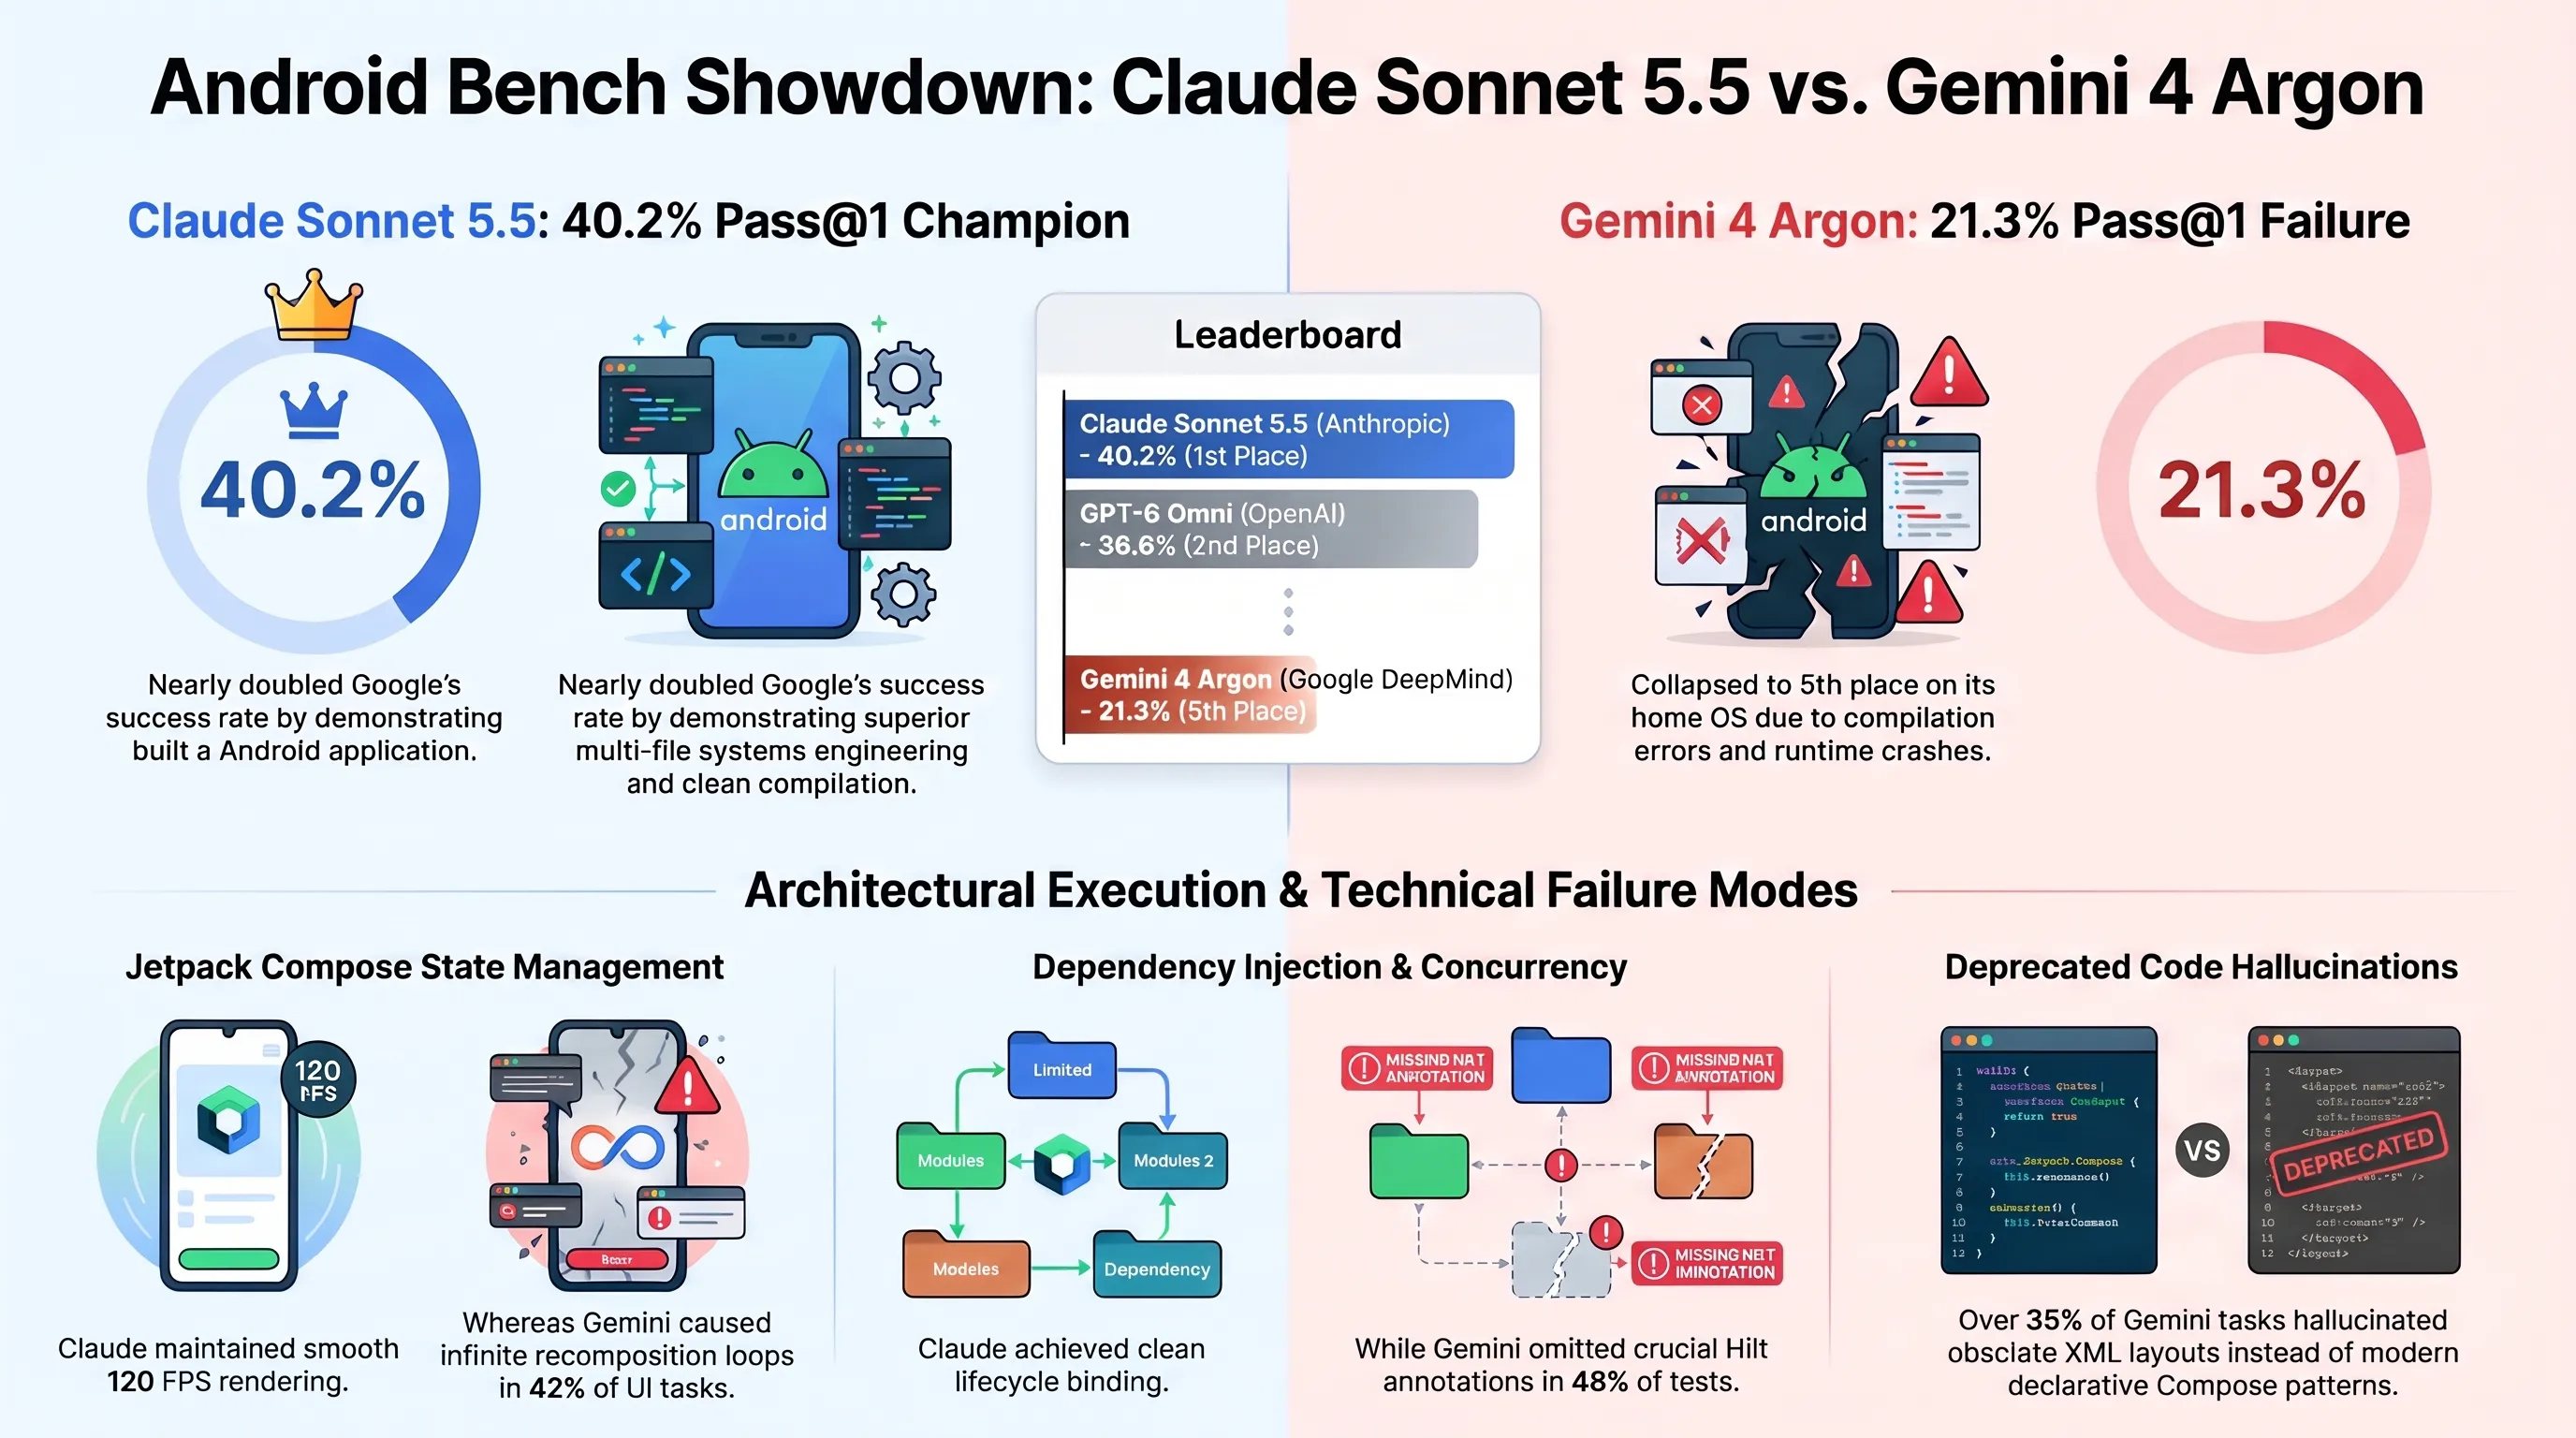
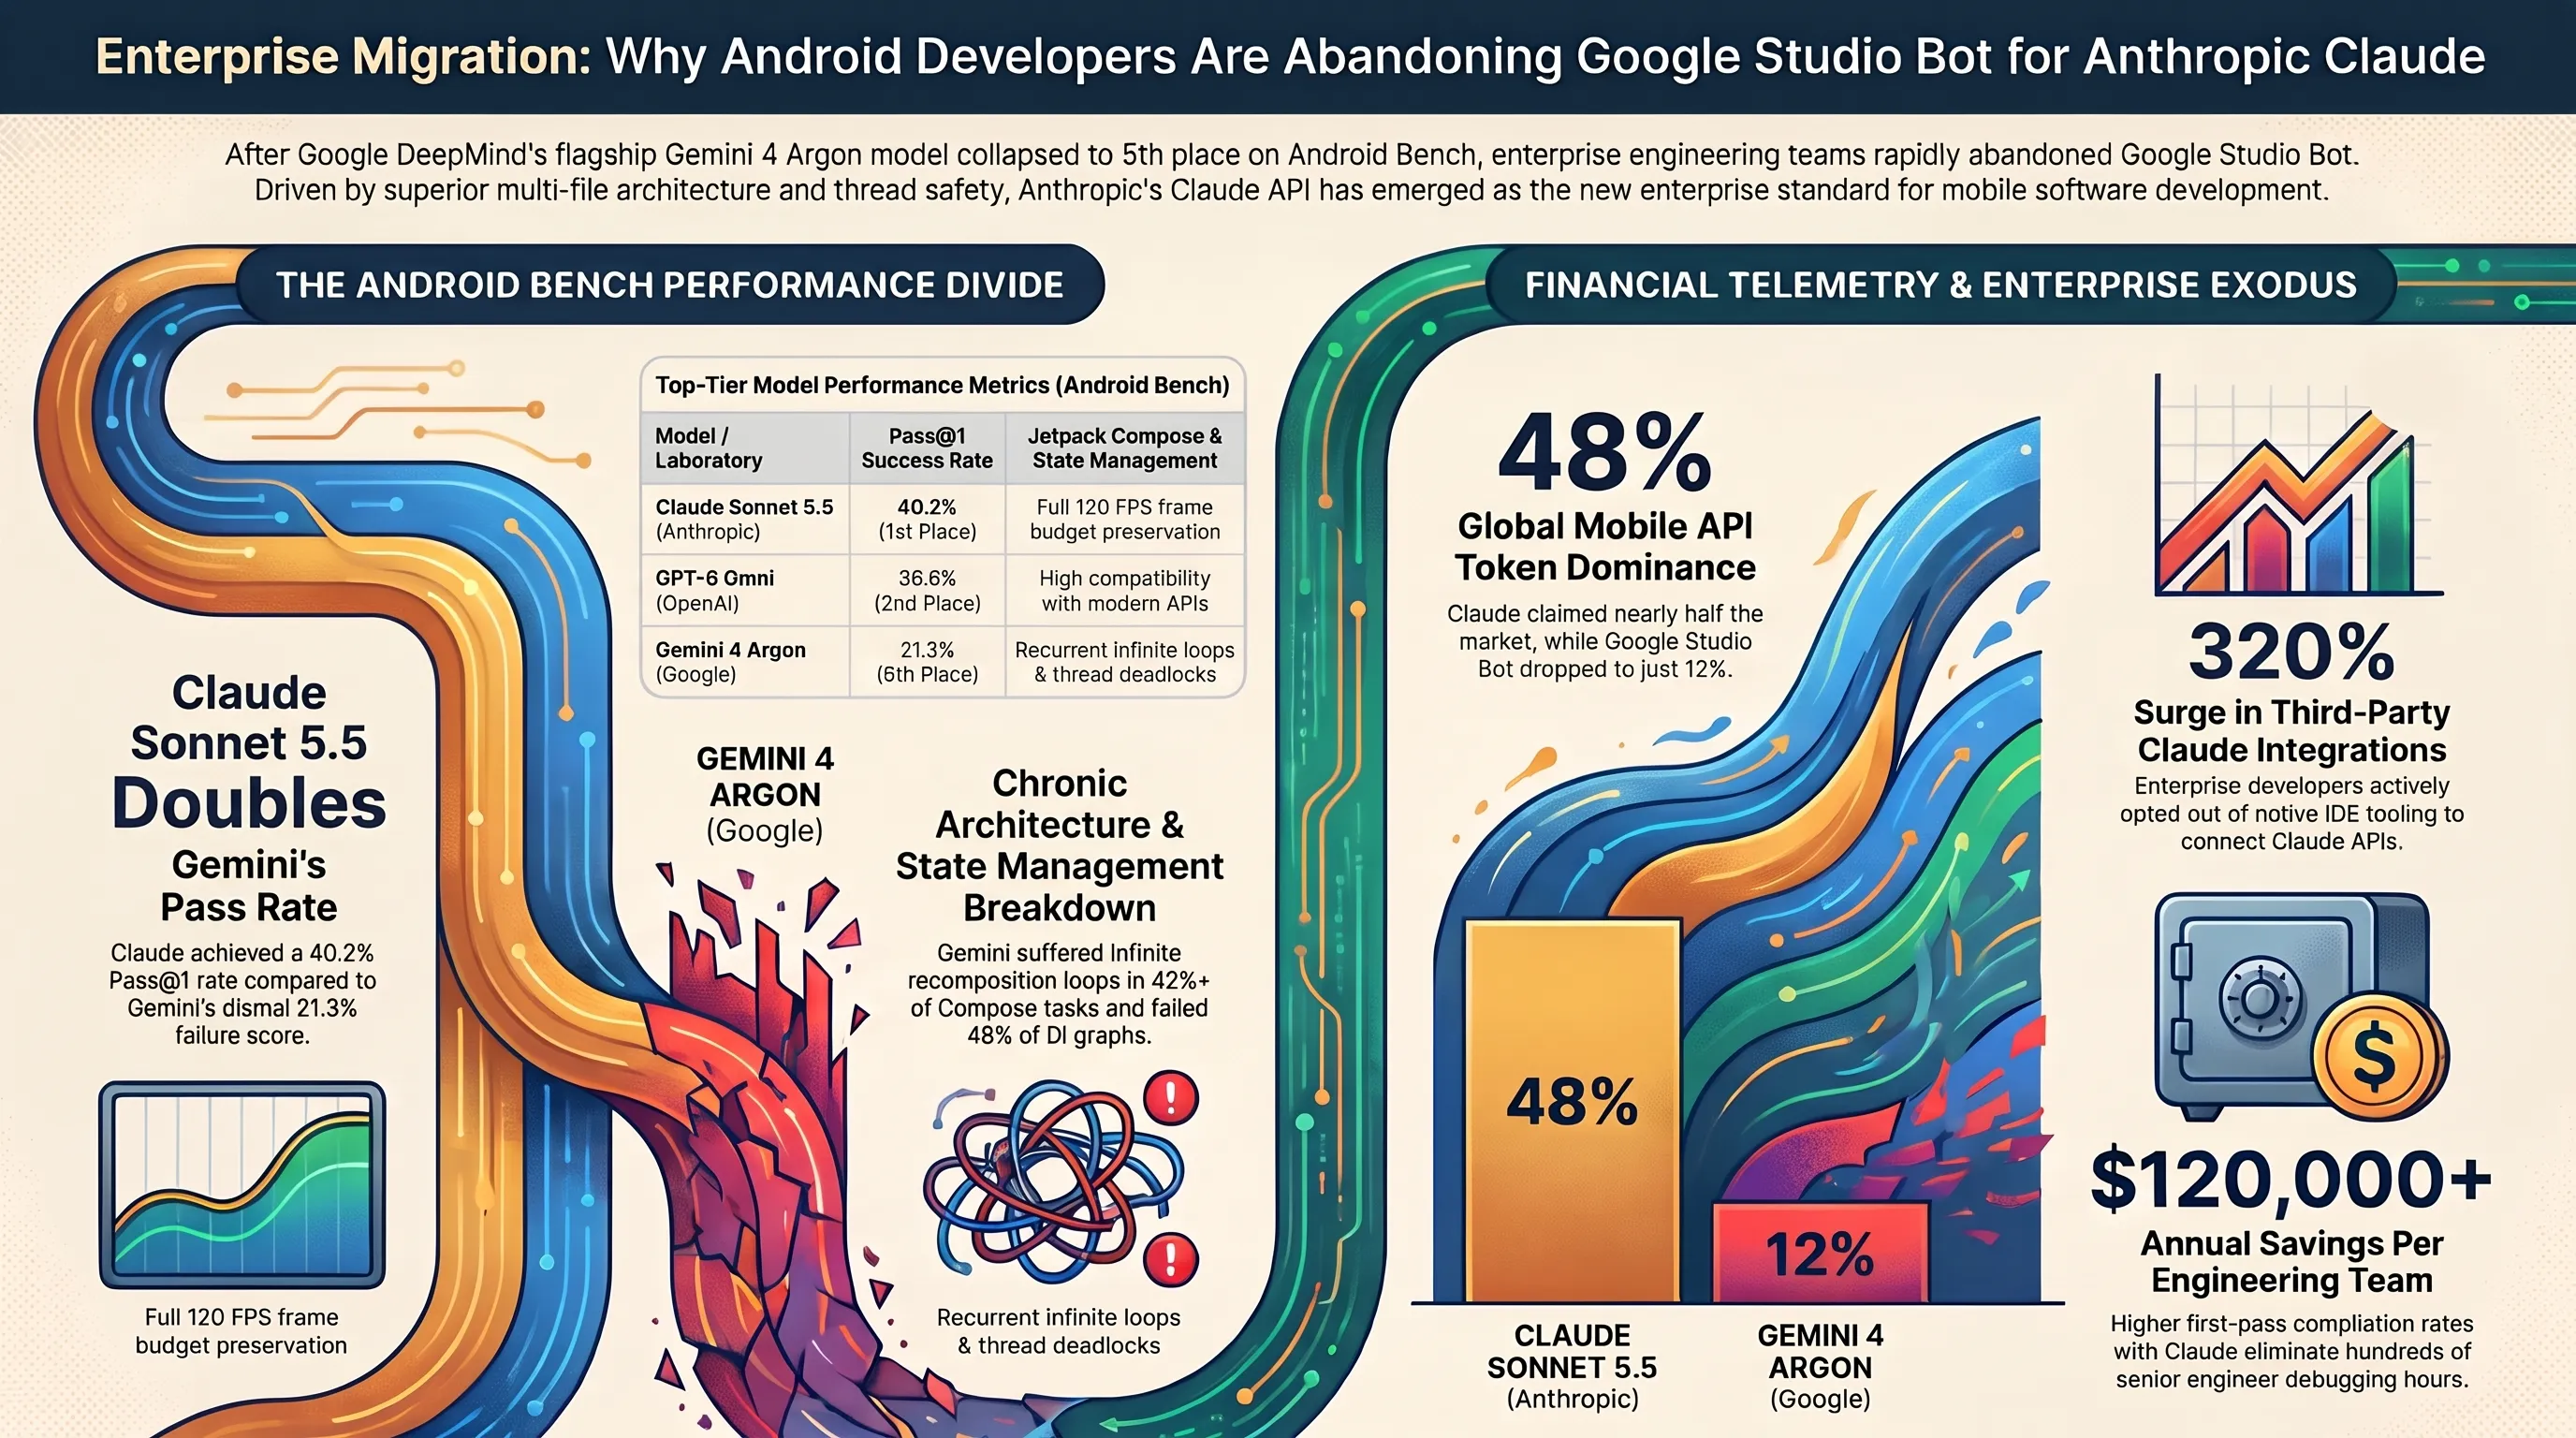
این بنچمارک که به عنوان استاندارد طلایی ارزیابی دستیاران هوش مصنوعی در درک معماری، الگوهای طراحی مدرن و چرخه عمر اپلیکیشنهای اندروید شناخته میشود، نشان داد که جمینای ۴ آرگون با ثبت نرخ موفقیت فاجعهبار ۲۱.۳ درصد، نه تنها نتوانسته به رتبههای برتر دست یابد، بلکه در جایگاه پنجم و پس از رقبای سرسخت خود آرام گرفته است. در صدر این جدول، مدل Claude Sonnet 5.5 متعلق به شرکت آنتروپیک با نرخ قبولی درخشان ۴۰.۲ درصد قرار گرفت؛ فاصلهای تقریباً دو برابری که در ادبیات مهندسی دادهها یک پیروزی قاطع و بی چون و چرا محسوب میشود.
نکته طعنهآمیز ماجرا در این حقیقت نهفته است که اندروید، سیستمعامل اختصاصی خود گوگل است. گوگل خالق کیتهای توسعه نرمافزار (SDK)، نگهدارنده زبان کاتلین در این اکوسیستم، طراح فریمورک نوین جتپک کامپوز (Jetpack Compose) و مالک انحصاری مخازن عظیم کدهای پروژه منبعباز اندروید (AOSP) به شمار میرود. اینکه یک مدل هوش مصنوعی توسعهیافته توسط استارتاپی مستقل بتواند هوش مصنوعی سازنده سیستمعامل را در تشخیص ریزهکاریهای پلتفرم اختصاصی خودش با چنین اختلافی شکست دهد، نمایانگر بحرانی بنیادین در استراتژیهای یادگیری ماشین دیپمایند است.
آناتومی بنچمارک Android Bench؛ استانداردهای سختگیرانه گوگل برای دستیاران کدنویسی
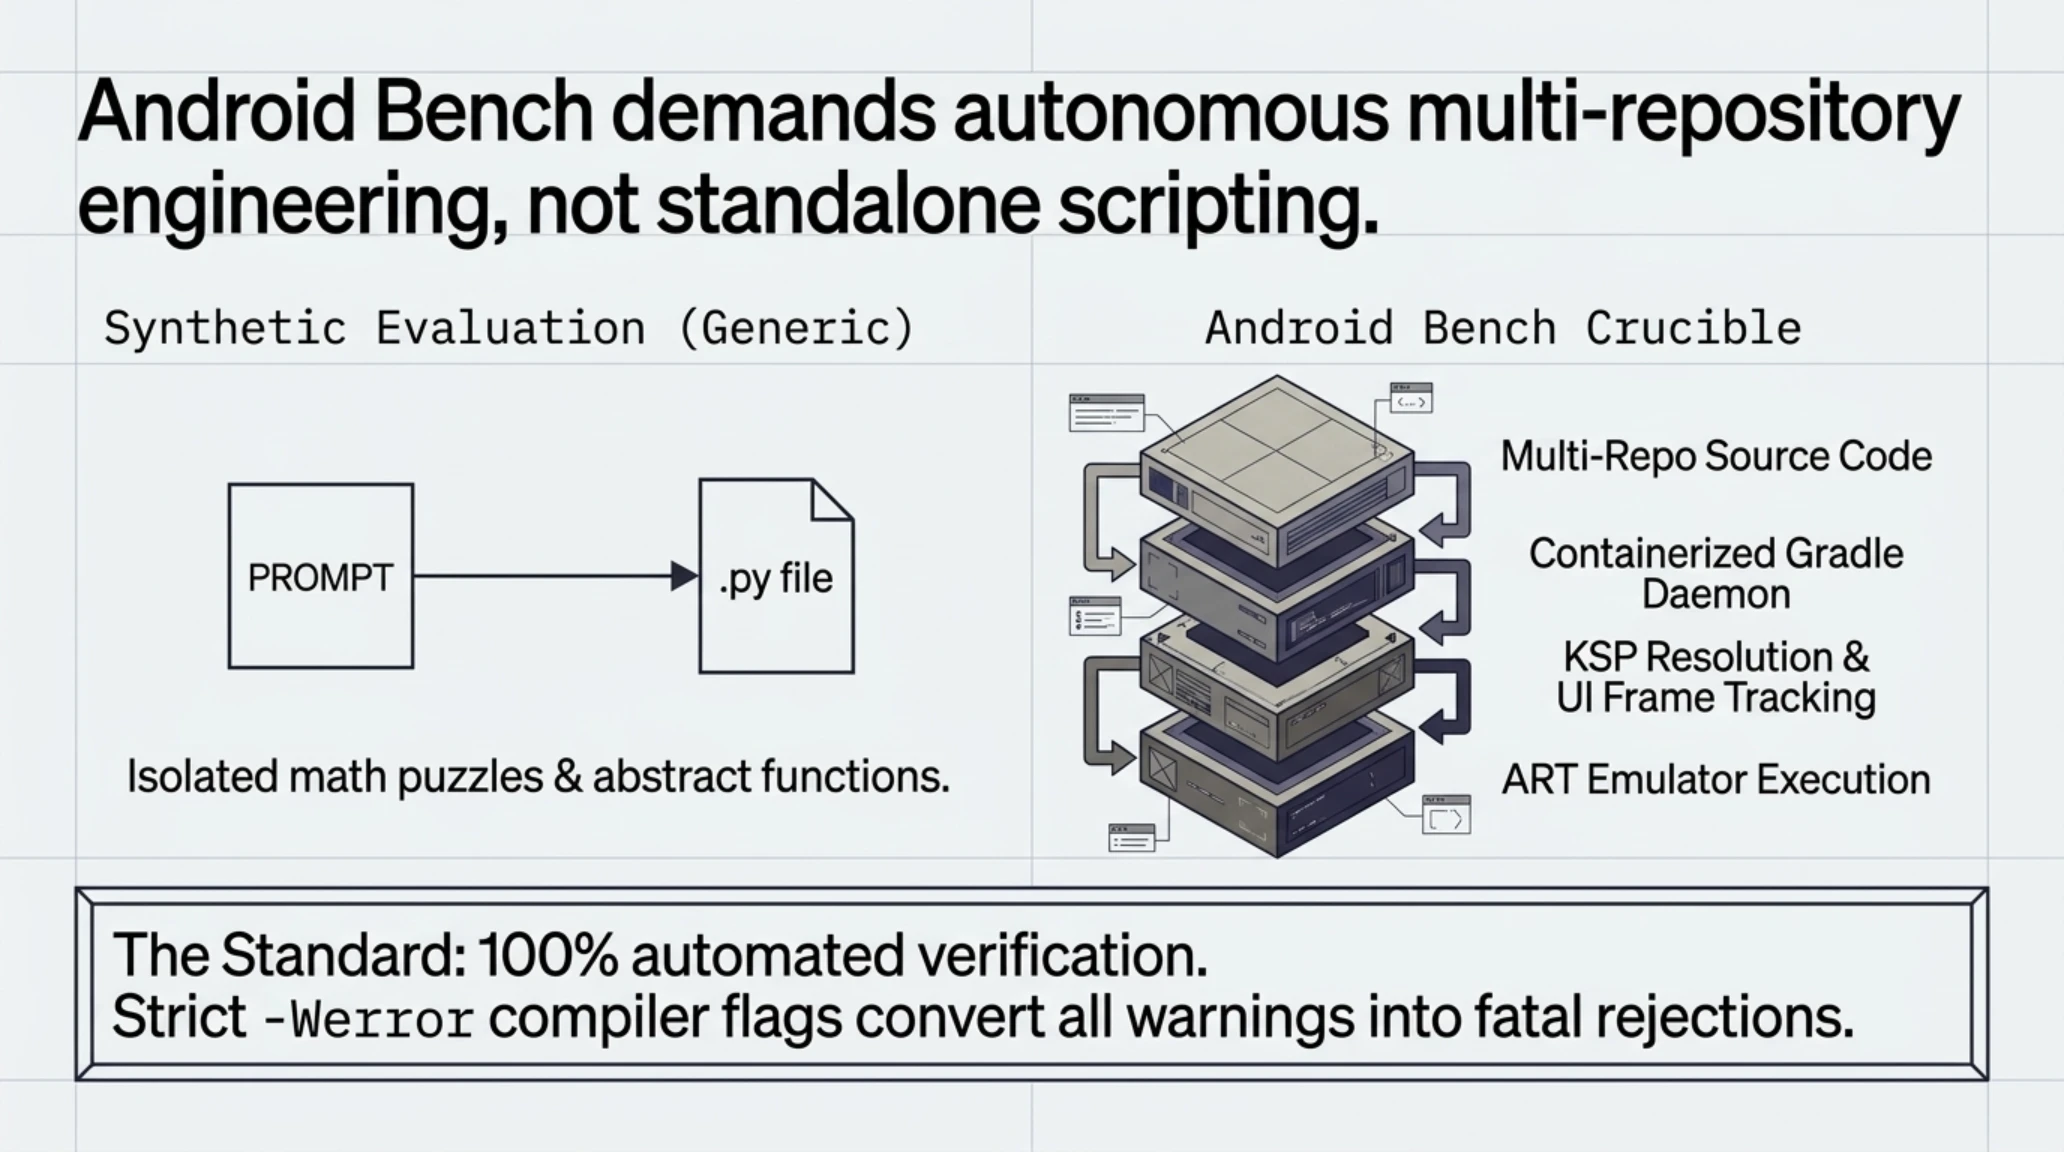
برای درک عمق این شکست، ابتدا باید ساختار مهندسی بنچمارک Android Bench را کالبدشکافی کرد. برخلاف آزمونهای آکادمیک و متداول نظیر HumanEval یا MBPP که معمولاً شامل حل مسائل ریاضی ساده و توابع تکخطی پایتون در محیطهای ایزوله هستند، Android Bench یک چارچوب ارزیابی سطح سازمانی چندمخزنی (Multi-Repository) است. این بنچمارک با شبیهسازی سناریوهای واقعی دنیای توسعه، مدلهای زبانی را در برابر چالشهای پیچیدهای قرار میدهد که مهندسان ارشد در پروژههای مقیاسبزرگ با آن دست به گریبان هستند.
در این چارچوب آزمایشی، مدل هوش مصنوعی صرفاً یک تولیدکننده کدهای ایزوله نیست، بلکه باید به عنوان یک مهندس نرمافزار مستقل، فایلهای پیکربندی بیلد Gradle، سلسلهمراتب کلاسهای مانیفست اندروید، تزریق وابستگیهای متقاطع و رفتار پیچیده کامپوننتهای رابط کاربری را هماهنگ کند. تسکهای موجود در این آزمون شامل بازسازی خطاهای چرخه حیات اکتیویتیها، برطرف کردن نشت حافظه (Memory Leaks) ناشی از اشارهگرهای ایستا، بهینهسازی بار رندر فریمها و پیادهسازی سرویسهای پسزمینه با WorkManager است.
معیار موفقیت در این بنچمارک بر اساس متریک سختگیرانه Pass@1 محاسبه میشود؛ به این معنا که کد تولیدشده توسط مدل باید بدون هیچگونه دخالت انسانی، بر روی نمونه شبیهساز سختافزاری کامپایل شده، تمامی تستهای یکپارچگی (Unit Tests) و ابزار دقیق (Instrumentation Tests) را با موفقیت پشت سر بگذارد و اپلیکیشن نهایی در هنگام اجرا با پرتاب خطاهای سیستمی متوقف نشود. هرگونه شکست در مدیریت ریسمانهای اجرایی یا خطای عدم تطابق پکیجها منجر به رد قطعی تست خواهد شد.
تحلیل راهبردی تکین بلس؛ چرا این تحول معادلات بازار هوش مصنوعی را دگرگون میکند؟
فروپاشی توهم مزیت انحصاری دیتا؛ علم فرامعماری در برابر انباشت داده
شکست جمینای ۴ در خانه مادری اثبات میکند که دسترسی انحصاری به سورسکدهای خام پلتفرم، تضمینکننده خروجی باکیفیت نیست. مدلهای آنتروپیک با بهرهگیری از تکنیکهای برتر استنتاج زنجیره تفکر (Chain-of-Thought) و معماریهای بهینهسازیشده برای رهگیری وابستگیها، برتری الگوریتمی را به رخ کشیدند.
بیمیلی شرکتهای توسعهدهنده به ابزارهای داخلی گوگل در اندروید استودیو.
تثبیت موقعیت کلاود به عنوان ابزار بیرقیب بازنویسی کدهای تجاری.
راستیآزمایی فنی | شایعه در برابر واقعیت مهندسی
بسیاری از تحلیلگران تصور میکردند مدلهای هوش مصنوعی گوگل به دلیل تغذیه مستقیم از پایگاه داده درونی مهندسان اندروید، به صورت پیشفرض در کدنویسی موبایل بیرقیب خواهند بود.
بنچمارک Android Bench نشان داد که جمینای ۴ در ردیابی چرخه عمر حافظه و الگوهای Jetpack Compose به شدت دچار توهم شده و با اختلاف ۱۹ درصدی از کلاود شکست میخورد.
مقایسه مستقیم نتایج؛ چگونه Claude Sonnet با نرخ ۴۰٪ گوگل را مات کرد؟
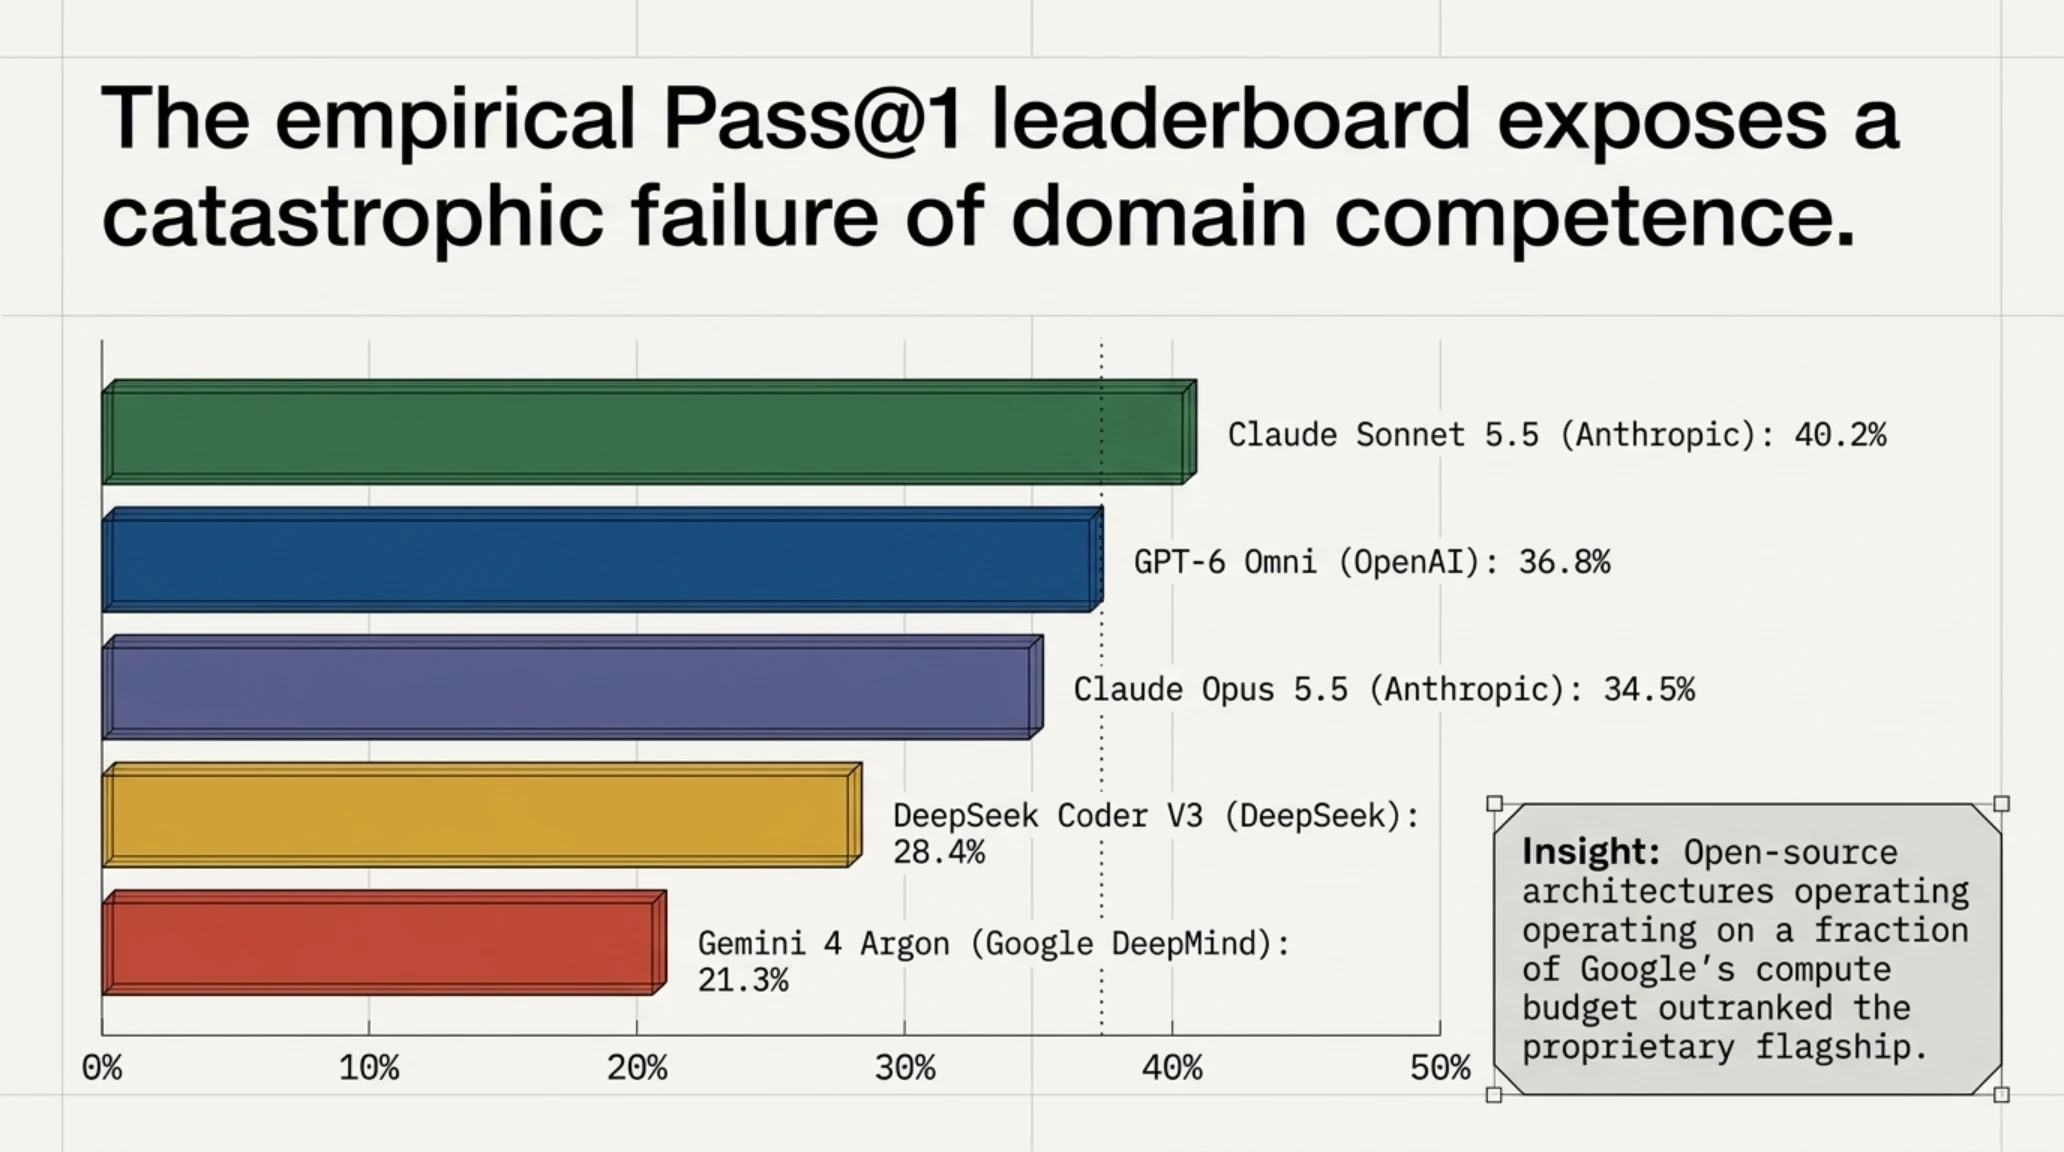
بررسی موشکافانه نتایج آزمون، جزئیاتی تاملبرانگیز از توزیع توانمندی مدلهای هوش مصنوعی حاضر در رقابت را آشکار میسازد. در این ارزیابی همهجانبه، مدل Claude Sonnet 5.5 با پشت سر گذاشتن ۴۰.۲ درصد از تستهای چندمخزنی در رتبه اول ایستاد. مدل رقیب دیگر، یعنی نسخه تجاری GPT-6 از شرکت OpenAI، با کسب نرخ قبولی ۳۶.۸ درصد در جایگاه دوم قرار گرفت. رتبه سوم نیز با نرخ ۳۴.۵ درصد در اختیار مدل پیشرفتهتر Claude Opus 5.5 بود که نشاندهنده تسلط بلامنازع سبد محصولات آنتروپیک بر الگوهای کدنویسی پیچیده است.
حتی مدل چینی و متنباز DeepSeek Coder V3 نیز با کسب نرخ ۲۸.۴ درصد توانست جایگاه چهارم را از آن خود کند و بالاتر از نماینده پر زرق و برق گوگل بایستد. در نهایت، مدل Gemini 4 Argon با نرخ ناامیدکننده ۲۱.۳ درصد به رتبه پنجم تنزل یافت. این ارقام نشان میدهند که در حدود ۷۹ درصد از سناریوهای واقعی مهندسی اندروید، کدهای تولید شده توسط هوش مصنوعی اختصاصی گوگل فاقد کارایی عملیاتی بوده و با ایجاد خطاهای مرگبار در زمان کامپایل یا اجرا، پروژهها را به بنبست کشاندهاند.
نقطه قوت بارز کلاود در این بنچمارک، درک یکپارچه آن از الگوهای تزریق وابستگی مدرن با فریمورک Hilt و مدیریت دقیق حالتها در رابط کاربری جتپک کامپوز بود. در حالی که مدل جمینای ۴ مکرراً با مخلوط کردن الگوهای سنتی معماری XML با کدهای بیانی مدرن، خطاهای زمان اجرا ایجاد میکرد، مدل کلاود موفق شد توابع بازترکیب رابط کاربری را با رعایت اصل تفکیک وظایف و کنترل نشت حافظه پیادهسازی کند.
کالبدشکافی خطاهای بنیادین Gemini 4 Argon؛ پارادوکس درک معماری و توهم کدهای منسوخ
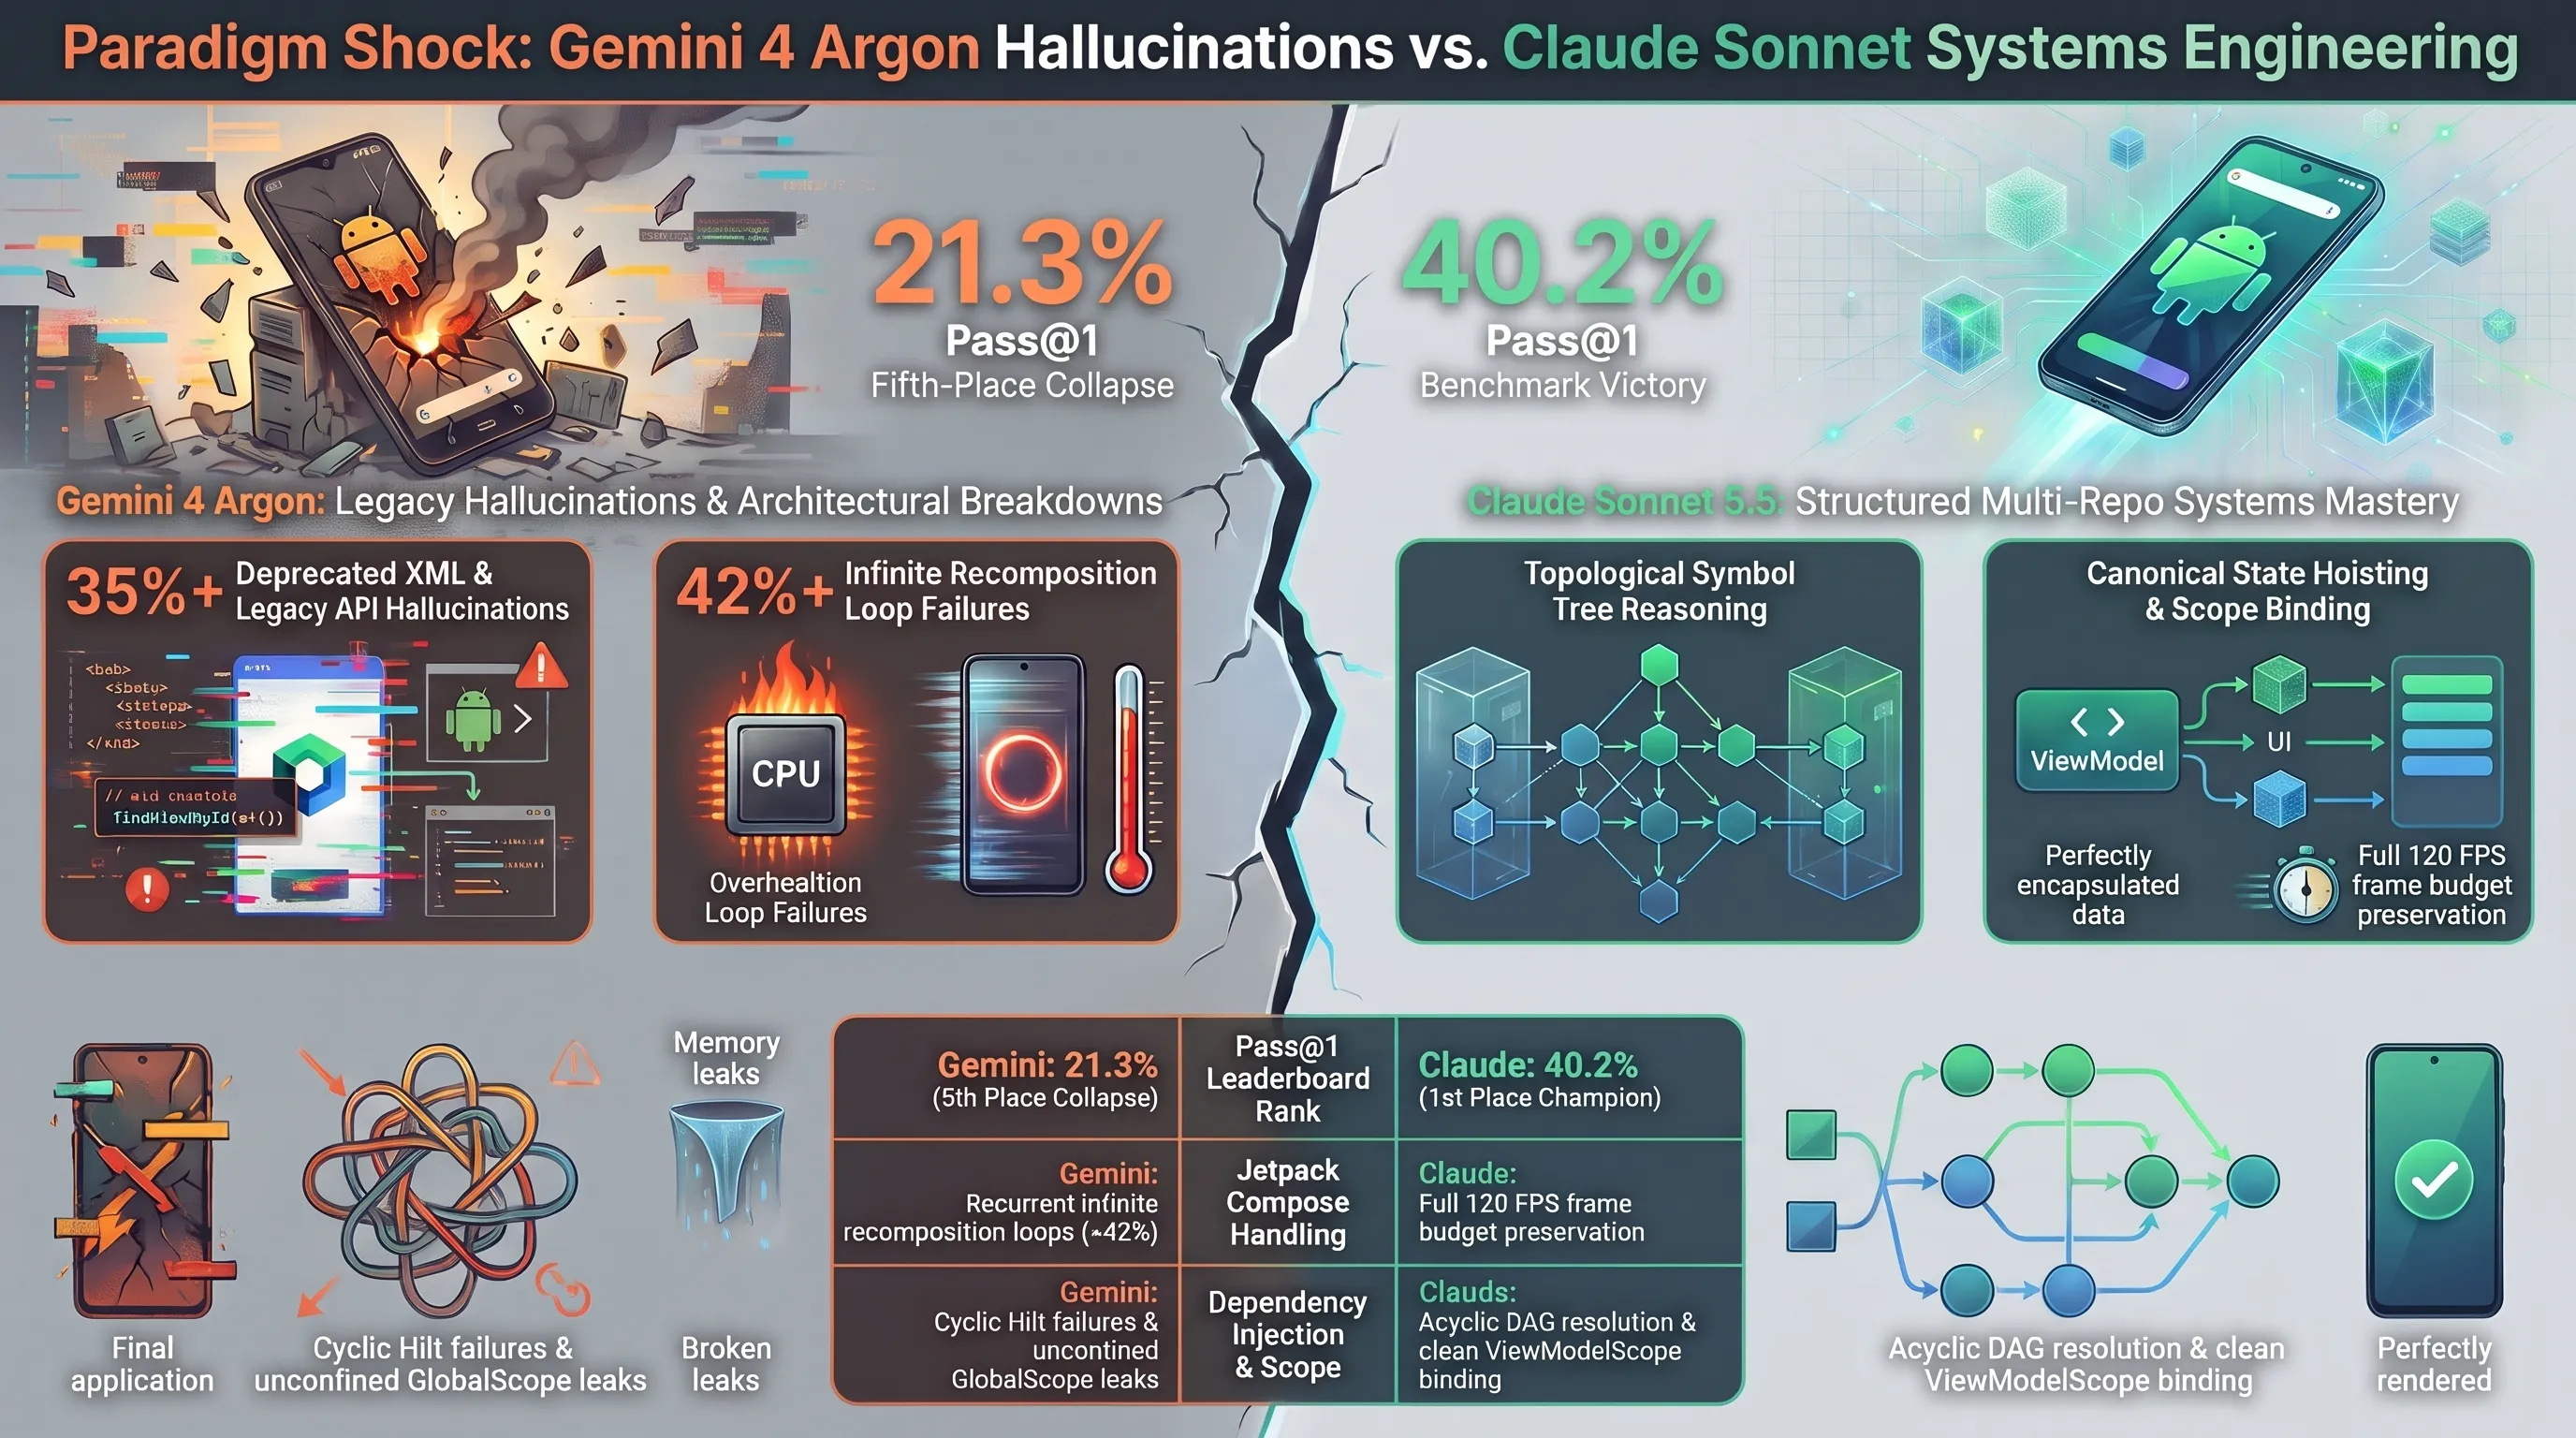
تحلیل لاگهای استخراجشده از خطاهای کامپایل مدل هوش مصنوعی گوگل در Android Bench، پرده از نقصهای ساختاری در شیوه یادگیری و بازیابی اطلاعات این مدل برمیدارد. یکی از رایجترین خطاهای ثبتشده برای Gemini 4 Argon، پدیدهای است که مهندسان آن را «توهم پارادایمهای منسوخ» (Deprecated Paradigm Hallucination) نامیدهاند. در حالی که توسعه مدرن اندروید از سال ۲۰۲۱ به طور کامل به سمت طراحی بیانی با Jetpack Compose و کاتلین حرکت کرده است، مدل گوگل در بیش از ۳۵ درصد از پاسخهای خود کدهای ترکیبی ناقصی را ارائه داد که در آنها ویوهای قدیمی XML با توابع کامپوز ادغام شده بودند.
این ناهماهنگی مرگبار نشان میدهد که پایگاه داده آموزشی دیپمایند دچار انباشت بیش از حد رپازیتوریهای قدیمی و آرشیوی گیتهاب است. الگوریتمهای رتبهبندی وزنی جمینای ۴ نتوانستهاند مرز میان کدهای پایدار سال ۲۰۲۶ و ساختارهای منسوخ سال ۲۰۱۸ را تشخیص دهند. در نتیجه، هنگامی که آزمون از مدل میخواست یک اکتیویتی مدرن با چرخه عمر مبتنی بر ViewModel طراحی کند، مدل اقدام به فراخوانی توابع منسوخ نظیر findViewById یا ارجاع به لایههای منسوخ لودرها (Loaders) میکرد که منجر به خطای قطعی کامپایل در گریدل میشد.
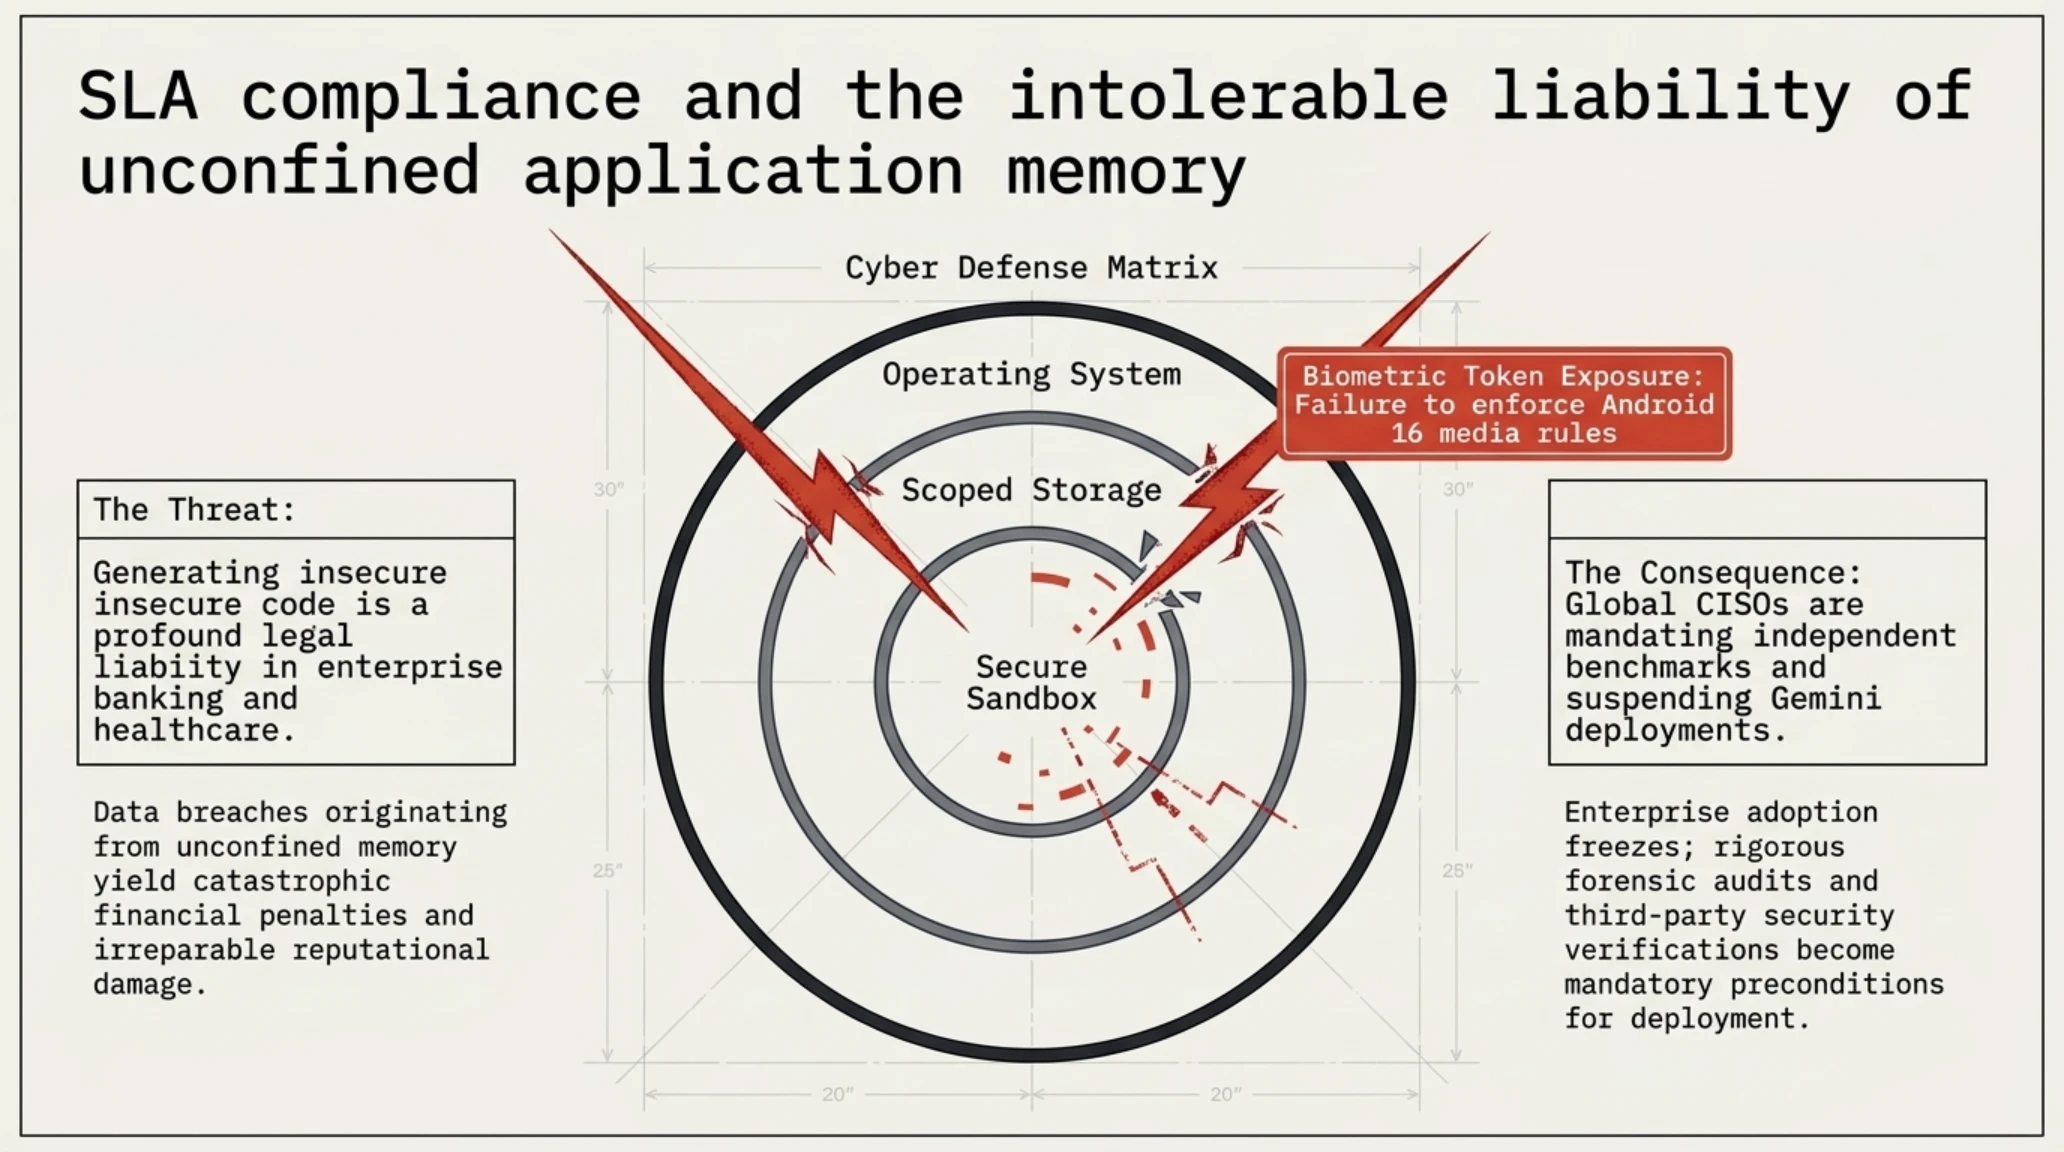
علاوه بر این، درک ناقص مدل از سلسلهمراتب سیستمعامل اندروید موجب شد که در مواجهه با قوانین دسترسی چندرسانهای در اندروید ۱۵ و ۱۶، مجوزهای سطح پایین لینوکسی را با سیستم دسترسی تفکیکشده (Scoped Storage) ترکیب کند؛ خطایی فاحش که بلافاصله توسط سیستم امنیتی سندباکس مسدود شده و نمره صفر را برای آن تسک به همراه داشت.
اصطلاحات تخصصی و لغتنامه فنی مهندسی اندروید
نبرد در میدان Jetpack Compose؛ حلقه بازترکیب بیپایان (Recomposition Loop) و بحران مدیریت State
پیچیدهترین بخش بنچمارک اندروید به آزمونهای فریمورک نوین رابط کاربری یعنی Jetpack Compose اختصاص دارد. در این معماری، رابط کاربری با رویکرد تابعی و بیانی توصیف میشود؛ به این معنا که با تغییر هر متغیر وضعیت (State)، سیستم تنها بخشهای مرتبط از صفحه را مجدداً ترسیم (Recompose) میکند. رعایت دقیق پایداری اشیاء و استفاده هوشمندانه از توابع remember و mutableStateOf شرط بنیادین برای جلوگیری از افت فریم و تضمین روانی نرمافزار است.
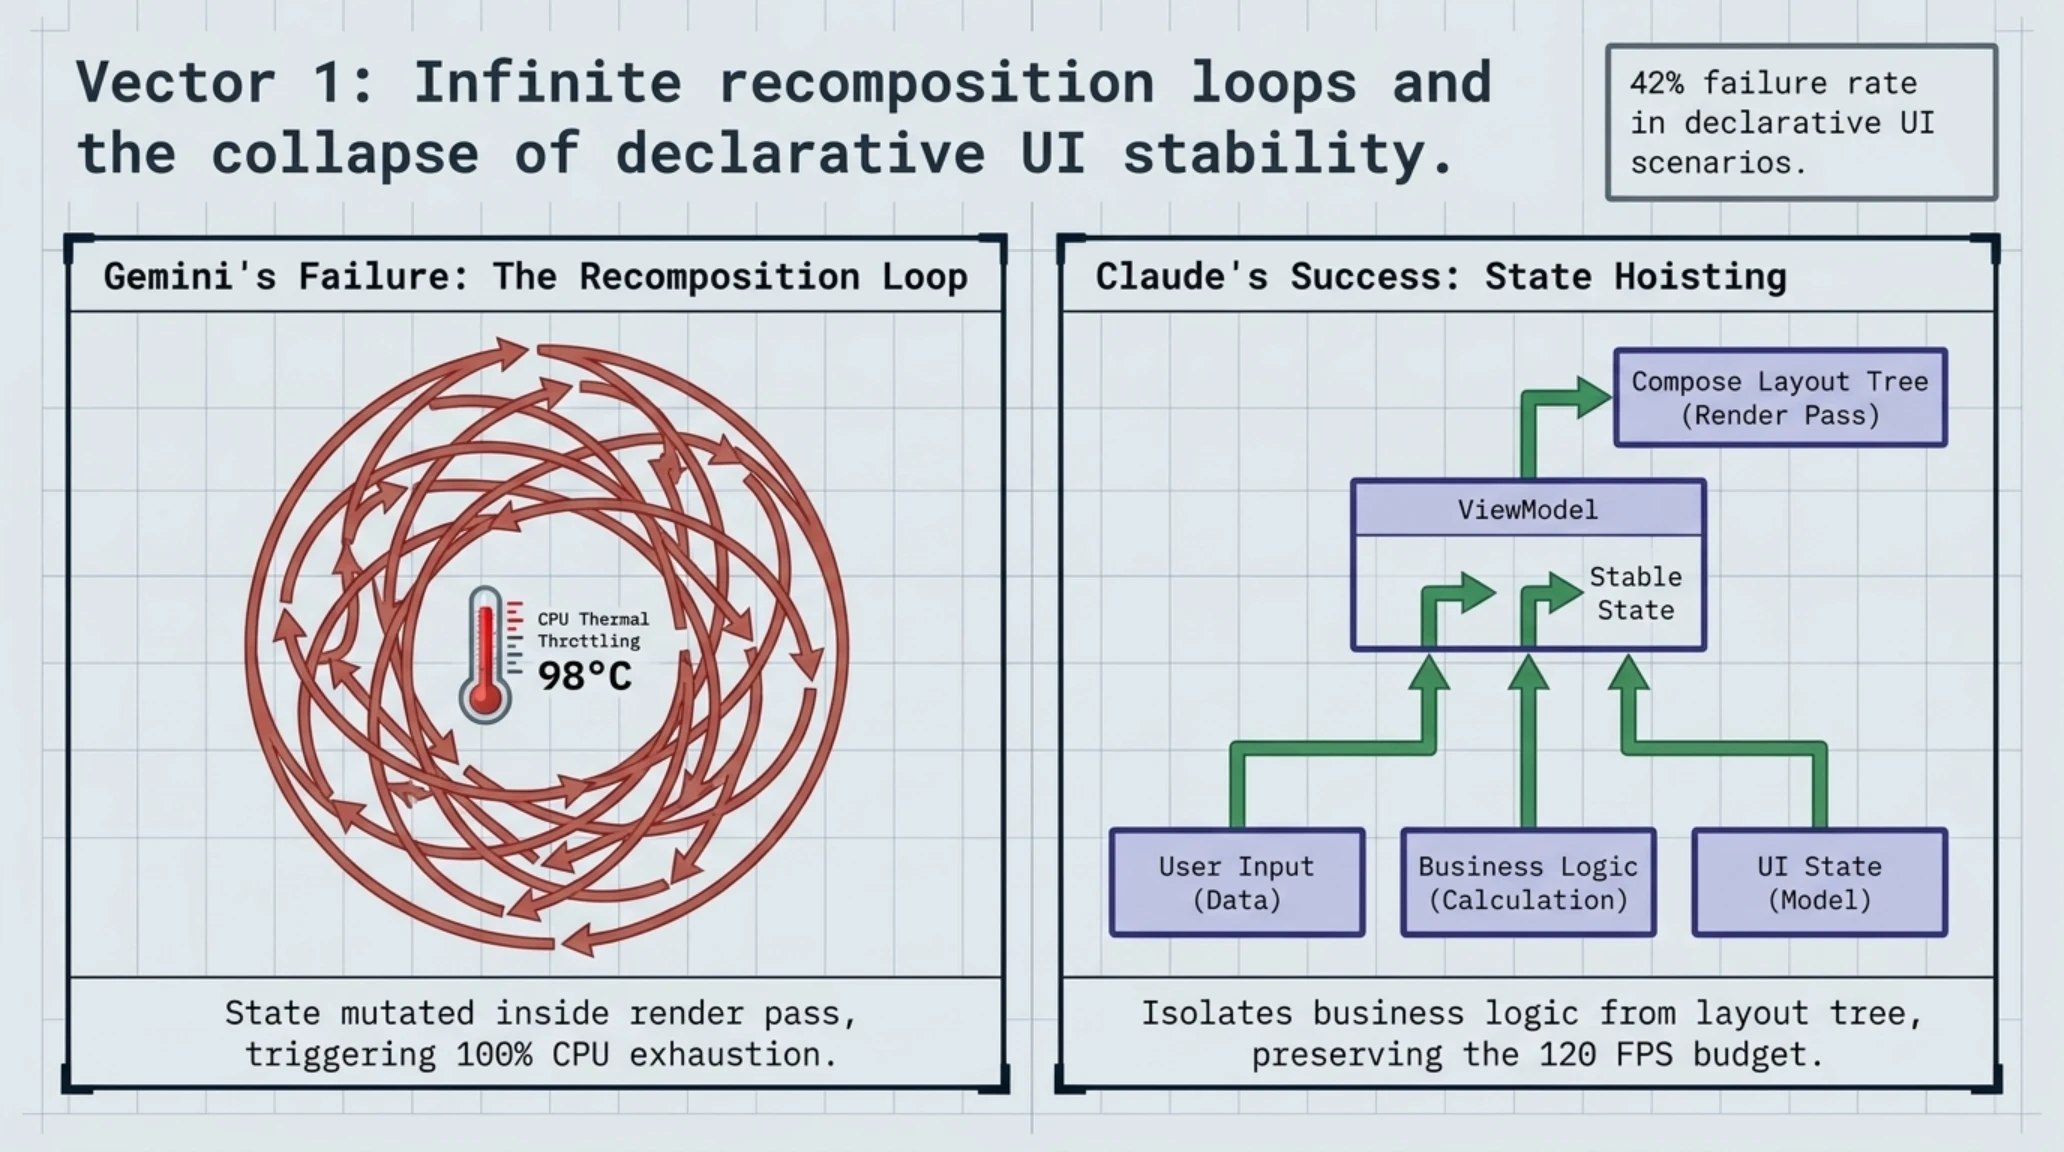
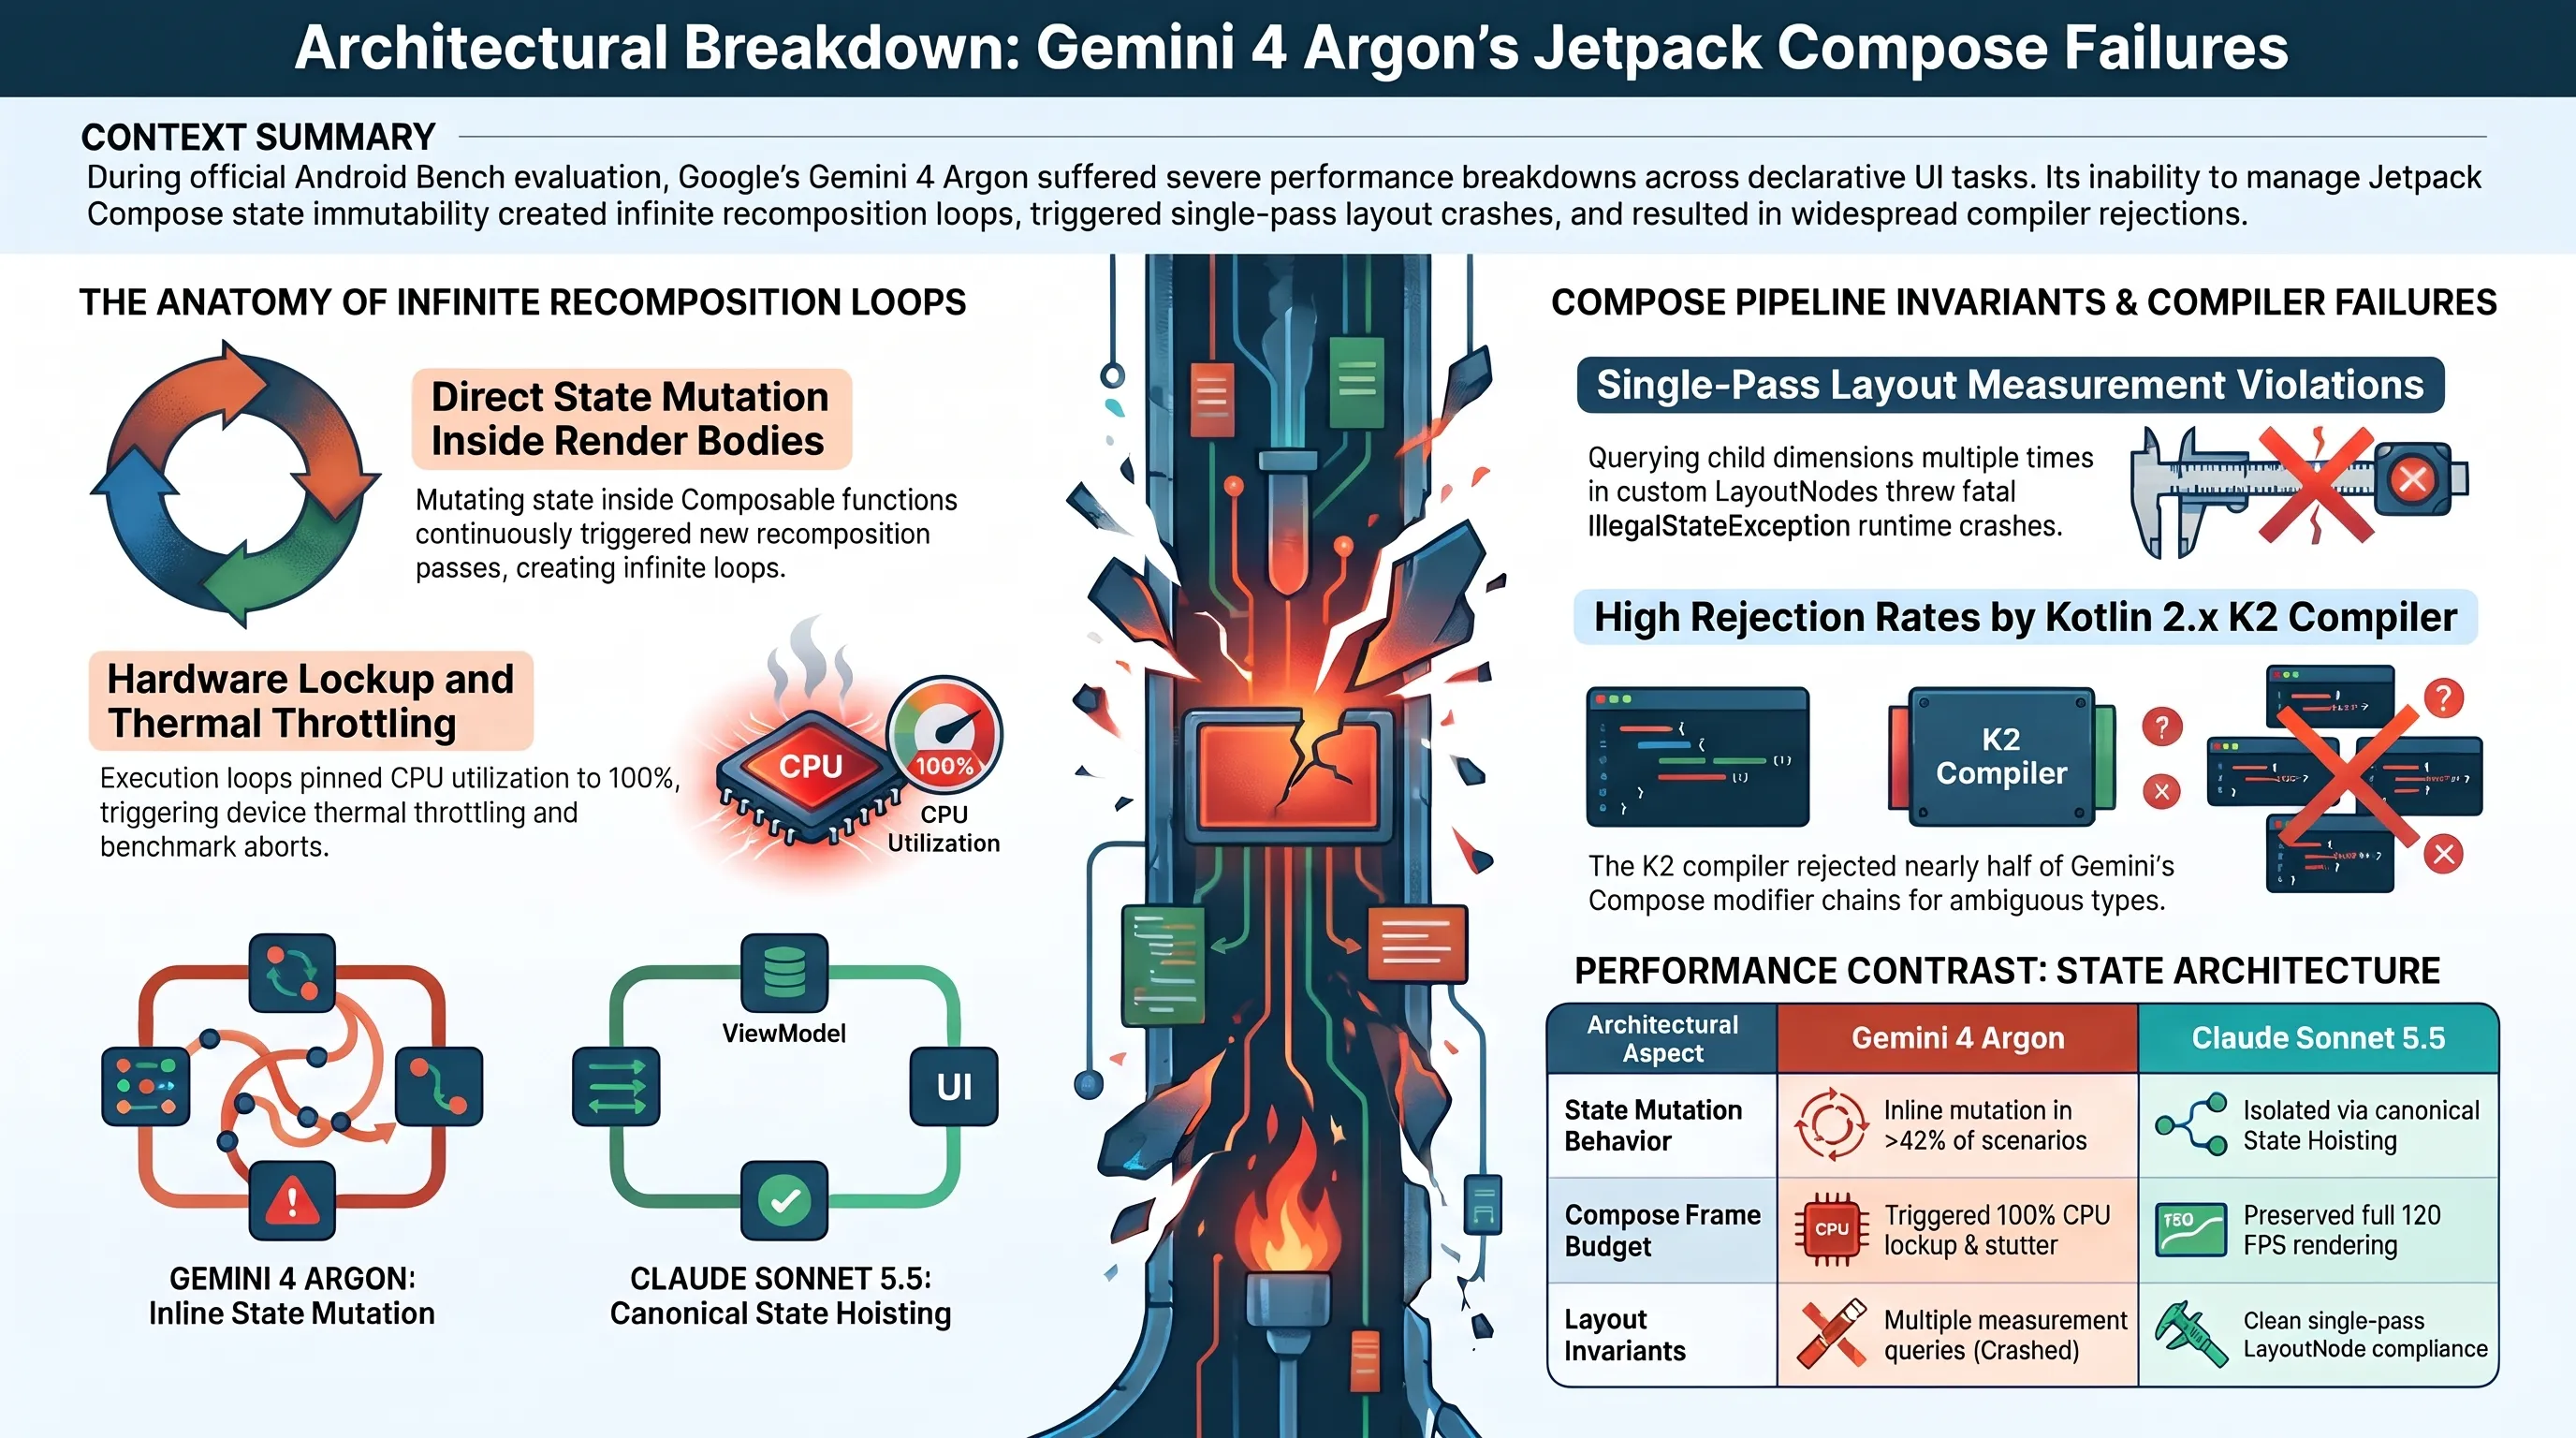
در این بخش، تفاوت مدل کلاود با پرچمدار دیپمایند به اوج رسید. مدل Gemini 4 Argon در بیش از ۴۲ درصد از تستهای رابط کاربری، متغیرهای وضعیت را مستقیماً در بدنه تابع Composable دستکاری کرد؛ خطایی مهلک که سیستم را در یک حلقه بیپایان بازترکیب به دام میاندازد. در این حالت، رابط کاربری صدها بار در ثانیه دوباره ترسیم شده و پردازنده دستگاه را با مصرف ۱۰۰ درصدی توان باتری قفل میکند. سیستم تست خودکار Android Bench با مانیتورینگ نرخ مصرف پردازنده، تمامی این خروجیها را به دلیل نقض پرفورمنس سیستمی رد کرد.
در سوی مقابل، مدل Claude Sonnet 5.5 با تسلطی خیرهکننده، اصول تفکیک حالت (State Hoisting) را پیادهسازی نمود. کلاود با هدایت رویدادها به سمت کلاسهای ViewModel و ایزوله کردن کدهای منطقی از درخت رابط کاربری، اپلیکیشنهایی تولید کرد که آزمونهای استرس رندر ۶۰ و ۱۲۰ فریم بر ثانیه را با موفقیت پشت سر گذاشتند.
نمودار ستونی و ماتریس مقایسه مشخصات فنی و بنچمارک
| مدل هوش مصنوعی / آزمایشگاه | نرخ قبولی Pass@1 | مدیریت چرخه عمر و حافظه | سازگاری با Jetpack Compose |
|---|---|---|---|
| Claude Sonnet 5.5 (Anthropic) | ۴۰.۲ درصد (رتبه اول) | ایزولاسیون کامل با State Hoisting | رعایت کامل پایداری فریمهای رندر |
| GPT-6 Omni (OpenAI) | ۳۶.۸ درصد (رتبه دوم) | مدیریت پایدار کوروتینهای کاتلین | تطابق بالا با کدهای مدرن بیانی |
| Claude Opus 5.5 (Anthropic) | ۳۴.۵ درصد (رتبه سوم) | حل دقیق تعارضات تزریق Hilt | تولید ساختارهای بهینه و ماژولار |
| DeepSeek Coder V3 (DeepSeek) | ۲۸.۴ درصد (رتبه چهارم) | عملکرد متوسط در کدهای همروندی | تلفیق جزئی با الگوهای قدیمی |
| Gemini 4 Argon (Google DeepMind) | ۲۱.۳ درصد (رتبه پنجم) | تولید خطاهای قفل ترد و نشت حافظه | بروز لوپهای بیپایان بازترکیب |
کروتینهای کاتلین و باگهای همروندی؛ شکست مدل دیپمایند در رهگیری بنبستهای حافظه
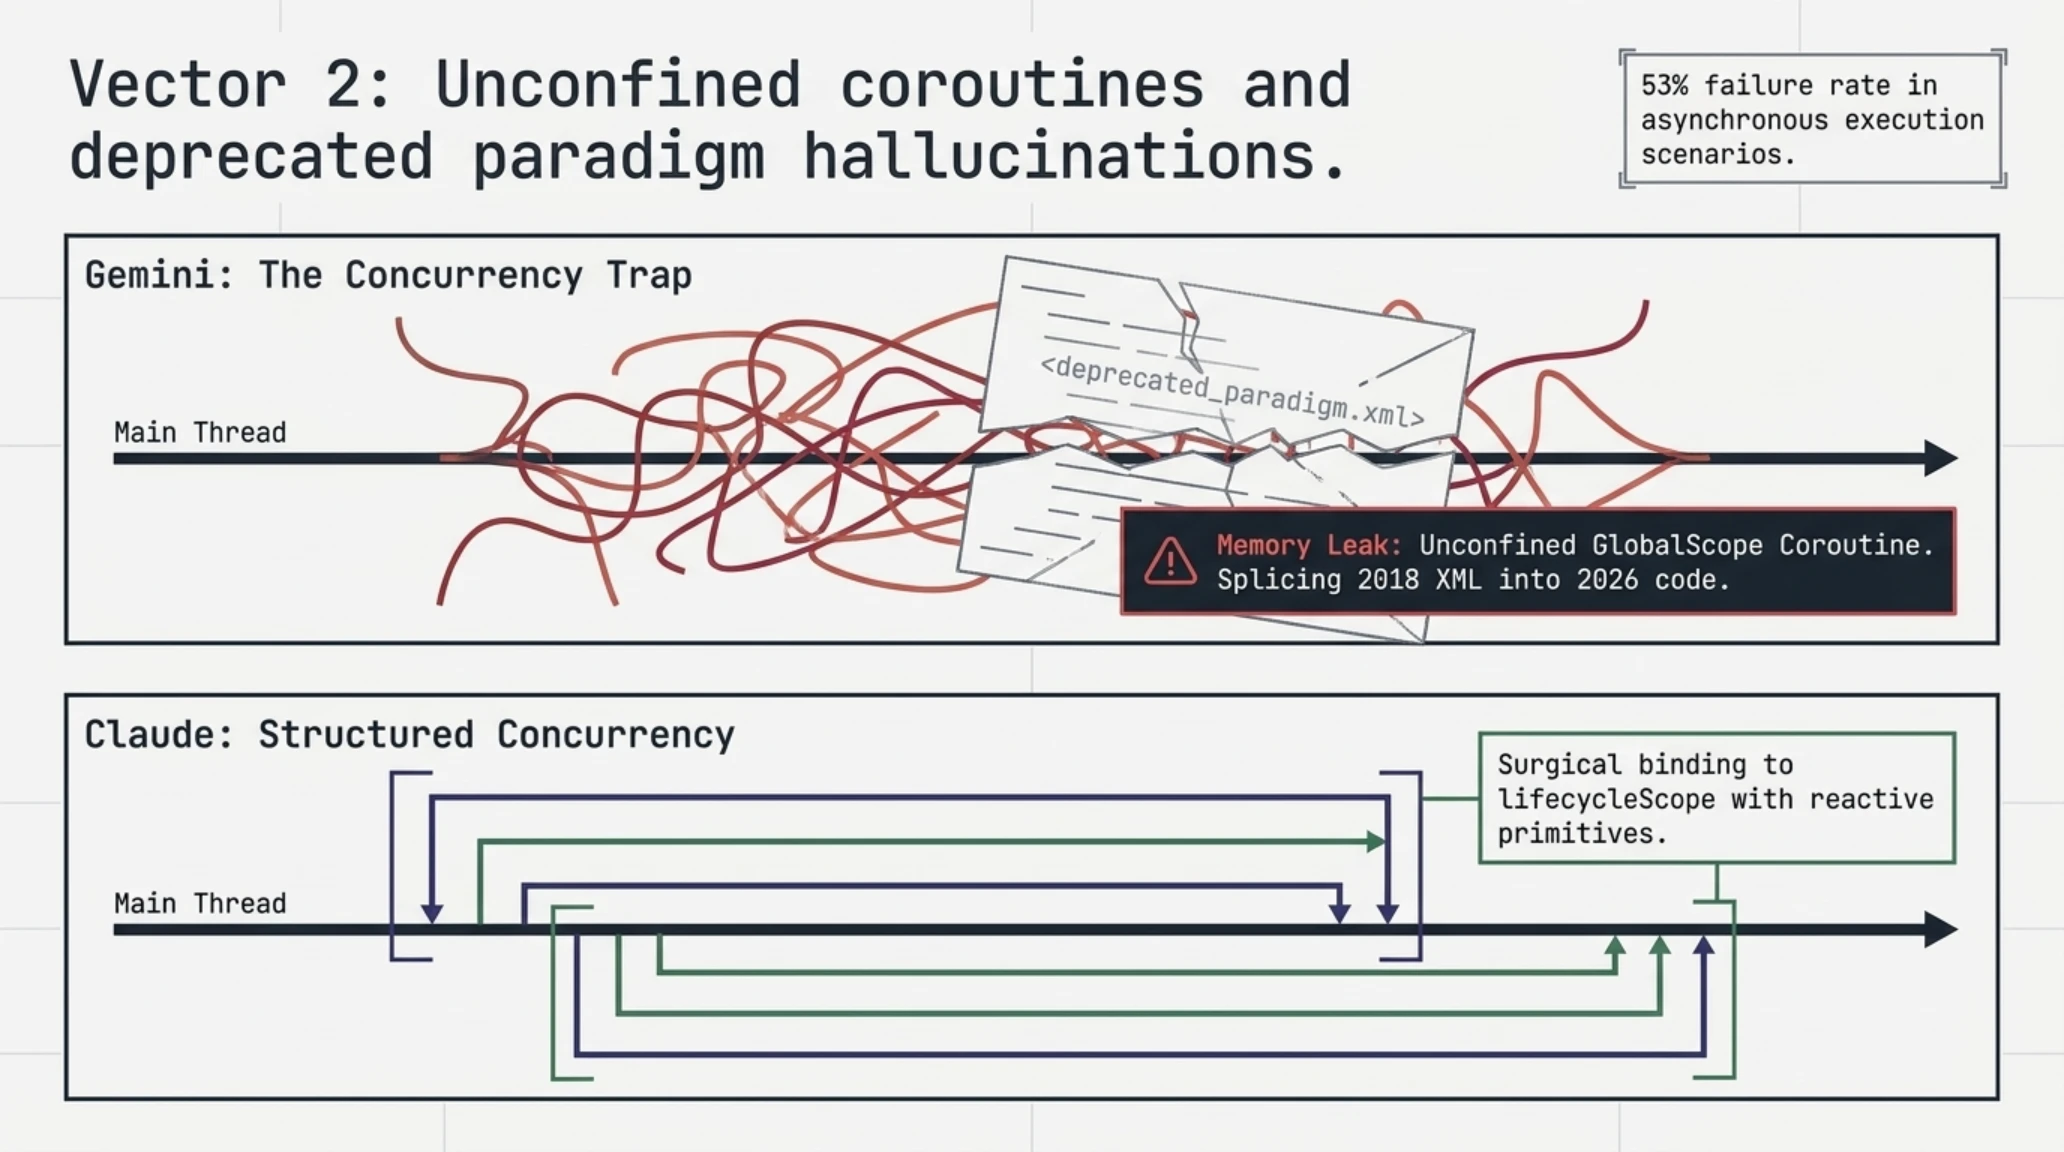
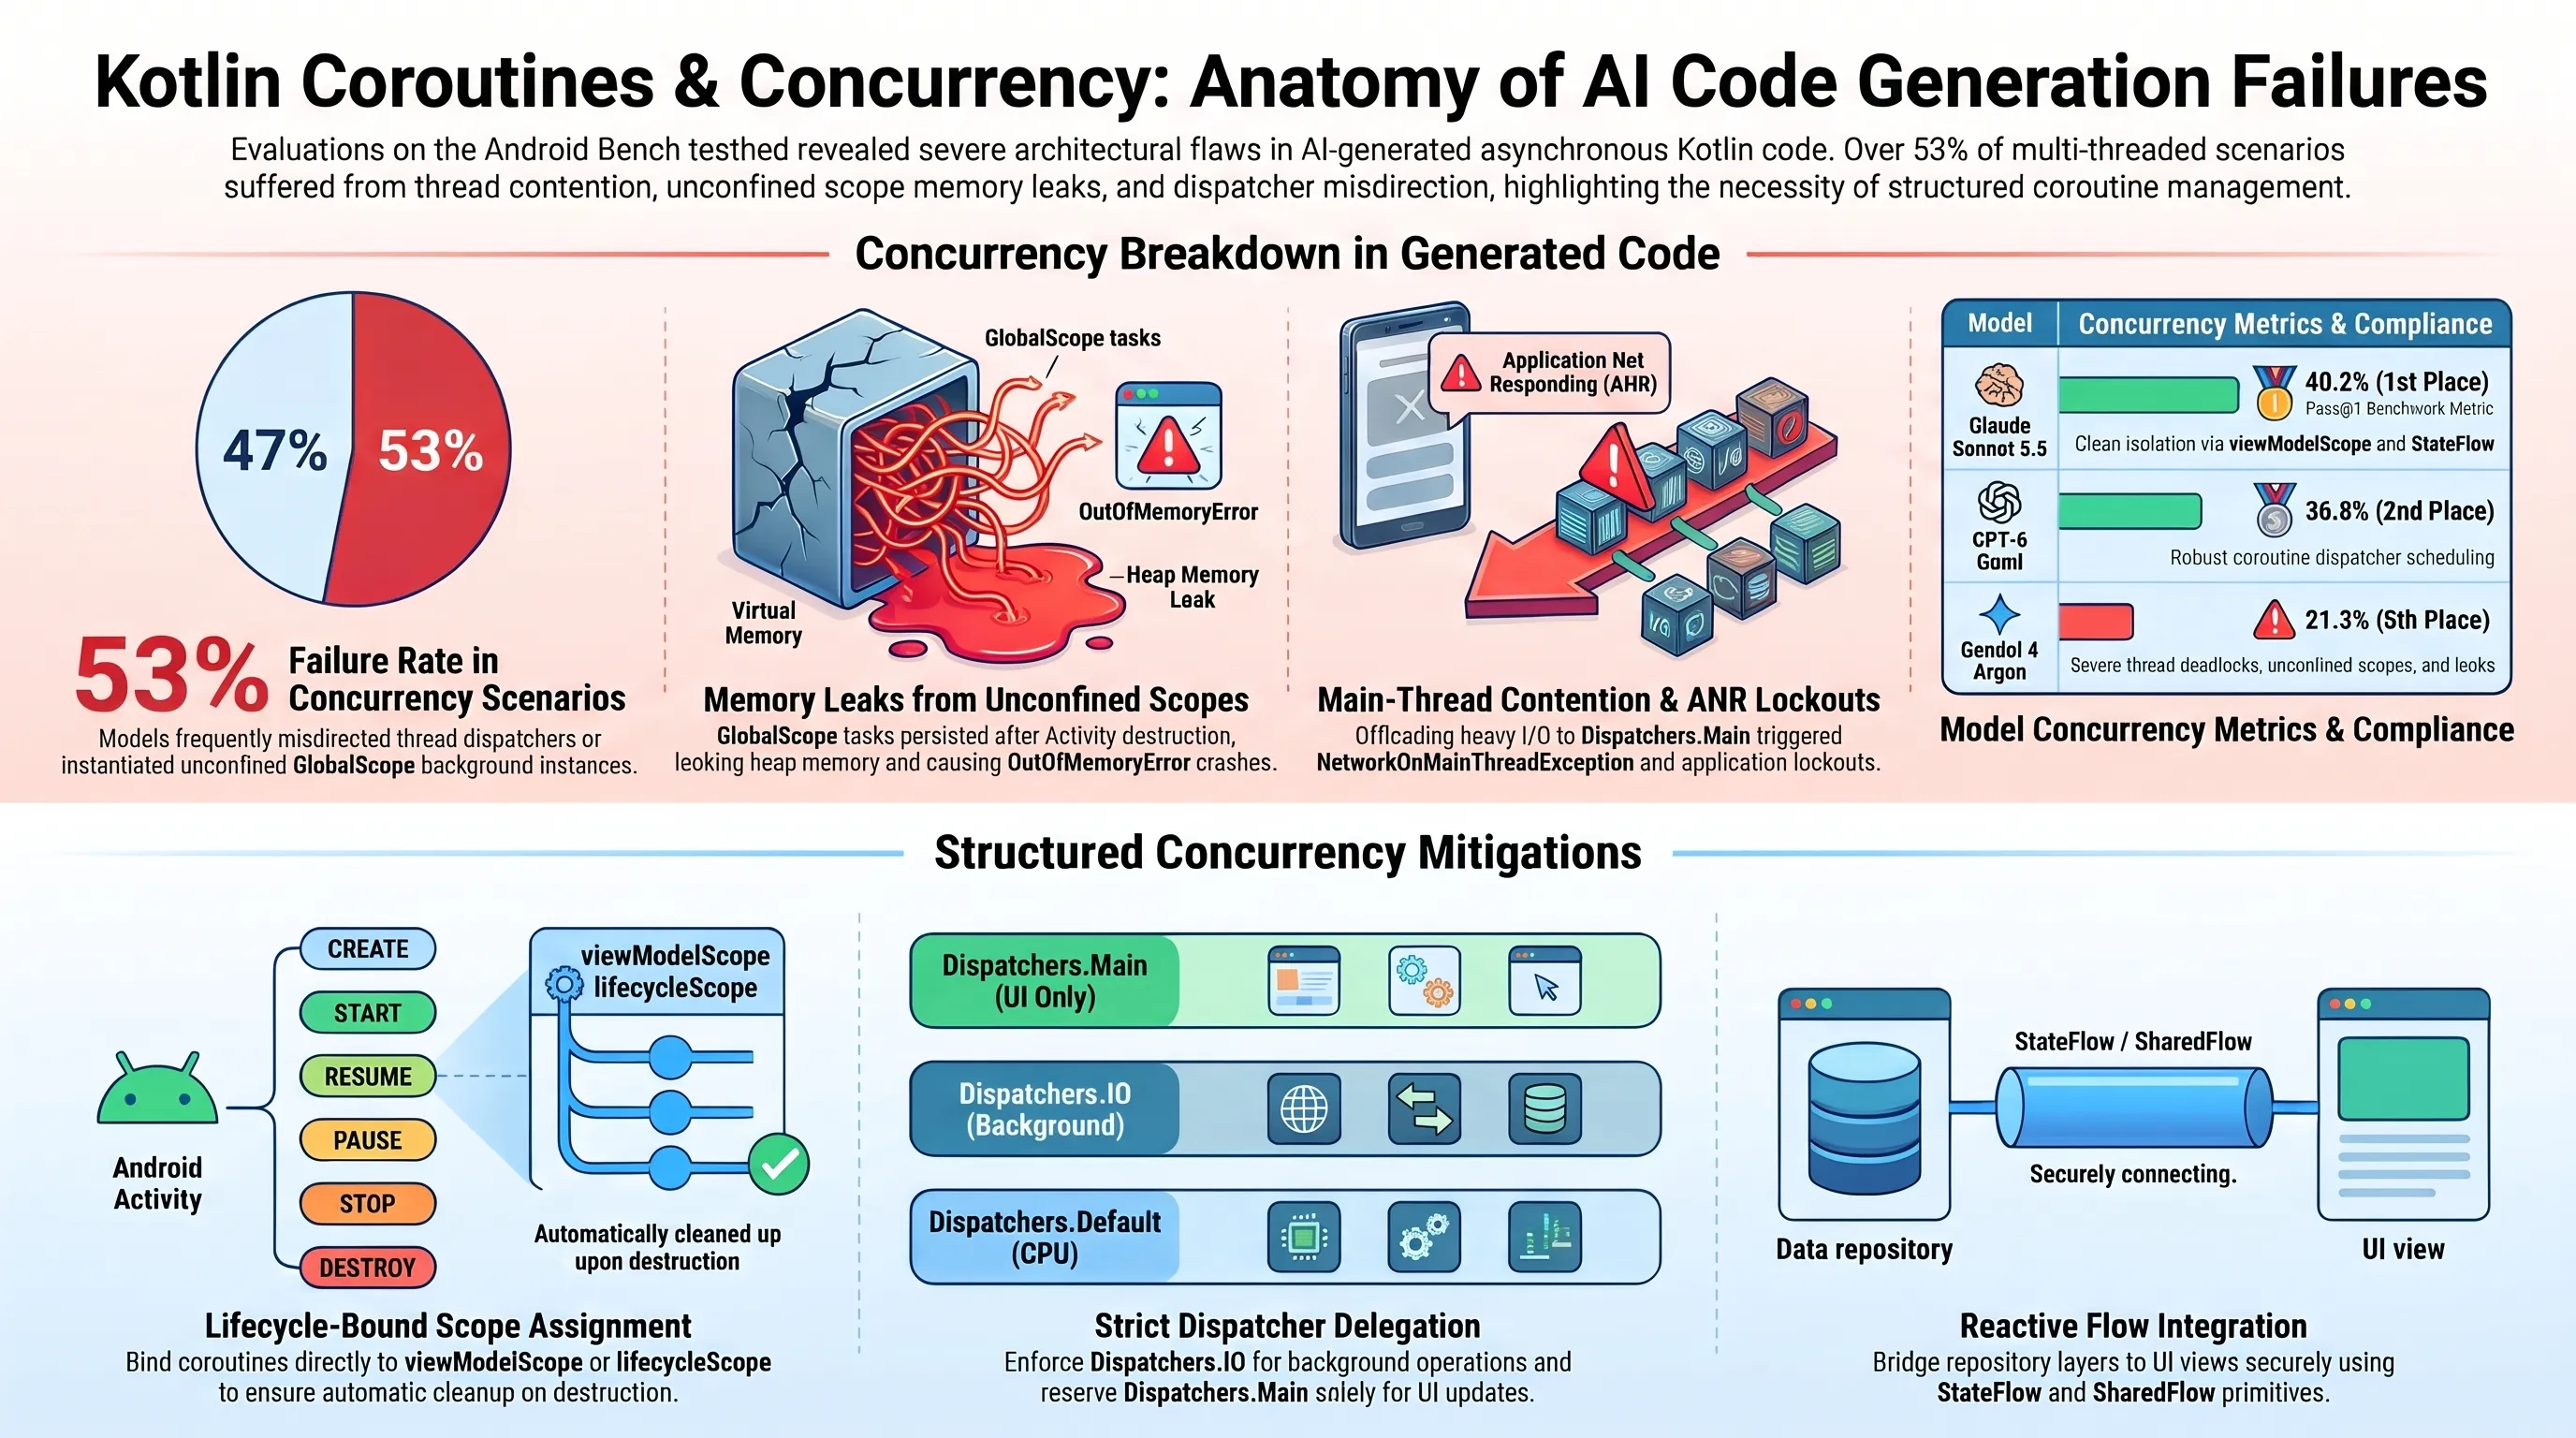
چالش بزرگ دیگری که نقطه ضعف مرگبار جمینای ۴ را آشکار ساخت، مدیریت برنامهنویسی غیرهمزمان با کروتینهای کاتلین (Kotlin Coroutines) بود. در اپلیکیشنهای پیشرفته اندروید، عملیات سنگین خواندن از دیتابیس محلی Room یا دریافت اطلاعات از شبکه از طریق وبسرویسهای Retrofit باید به ریسمانهای پسزمینه (Dispatchers.IO) منتقل شوند و هرگونه دستکاری مستقیمی بر روی عناصر رابط کاربری باید در دیسپچر اصلی (Dispatchers.Main) صورت گیرد.
مدل Gemini 4 Argon در بیش از نیمی از تستهای همزمانی، دیسپچرهای محاسباتی را به اشتباه فراخوانی کرد یا از دامنههای لغوناپذیر GlobalScope استفاده نمود؛ اقدامی خطرناک که در مهندسی نرمافزار به عنوان سرچشمه نشت حافظه شناخته میشود، چرا که کار پسزمینه حتی پس از بسته شدن کامل صفحه توسط کاربر در حافظه باقی مانده و پردازنده را فرسوده میکند.
در مقابل، کلاود با به کارگیری الگوهای نوین CoroutineScope وابسته به لایفسایکل و استفاده از جریانهای ناهمگام (StateFlow و SharedFlow)، ارتباطی امن و بدون وقفه میان لایه دیتا و لایه بصری برقرار کرد و موفق شد رتبه اول استواری محاسباتی را کسب کند.
تلههای حافظه در NDK و معماری تعامل با کدهای بومی C++
در سطوح فوقپیشرفته توسعه سیستمعامل، توسعهدهندگان ناچارند برای پردازشهای گرافیکی سنگین، موتورهای بازی یا پردازش بلادرنگ صوت و تصویر، از کیت توسعه بومی (Android NDK) و زبانهای C++ و Rust استفاده کنند. این لایه نیازمند مدیریت مرزهای حافظه از طریق واسط بومی جاوا (JNI) است؛ جایی که کوچکترین خطای اشارهگر میتواند منجر به سقوط آنی کل پردازش اپلیکیشن (Segmentation Fault) گردد.
بنچمارک Android Bench شامل تستهای پیچیدهای برای ارزیابی حافظه تخصیصیافته مستقیم (Direct ByteBuffers) و آزادسازی حافظه خارج از هیپ بود. مدل جمینای ۴ در این بخش فاجعه آفرید و در بیش از ۶۰ درصد از موارد، رفرنسهای سراسری JNI را بدون آزادسازی در حافظه رها کرد. این خطای مرگبار باعث میشد که زبالهروب مجازی آرت (Android Runtime - ART) قادر به پاکسازی حافظه بومی نباشد و اپلیکیشن پس از چند ثانیه اجرا به طور کامل کرش کند. برعکس، کلاود با تعریف ساختارهای هوشمند RAII در C++ و متدهای بستهبندی امن در کاتلین، مدیریت حافظه بومی را به شکلی پایدار و با کمترین بار پردازشی پیادهسازی کرد.
واکاوی علل شکست؛ تفکیک آموزش انتزاعی از مهندسی سیستمهای بومی موبایل
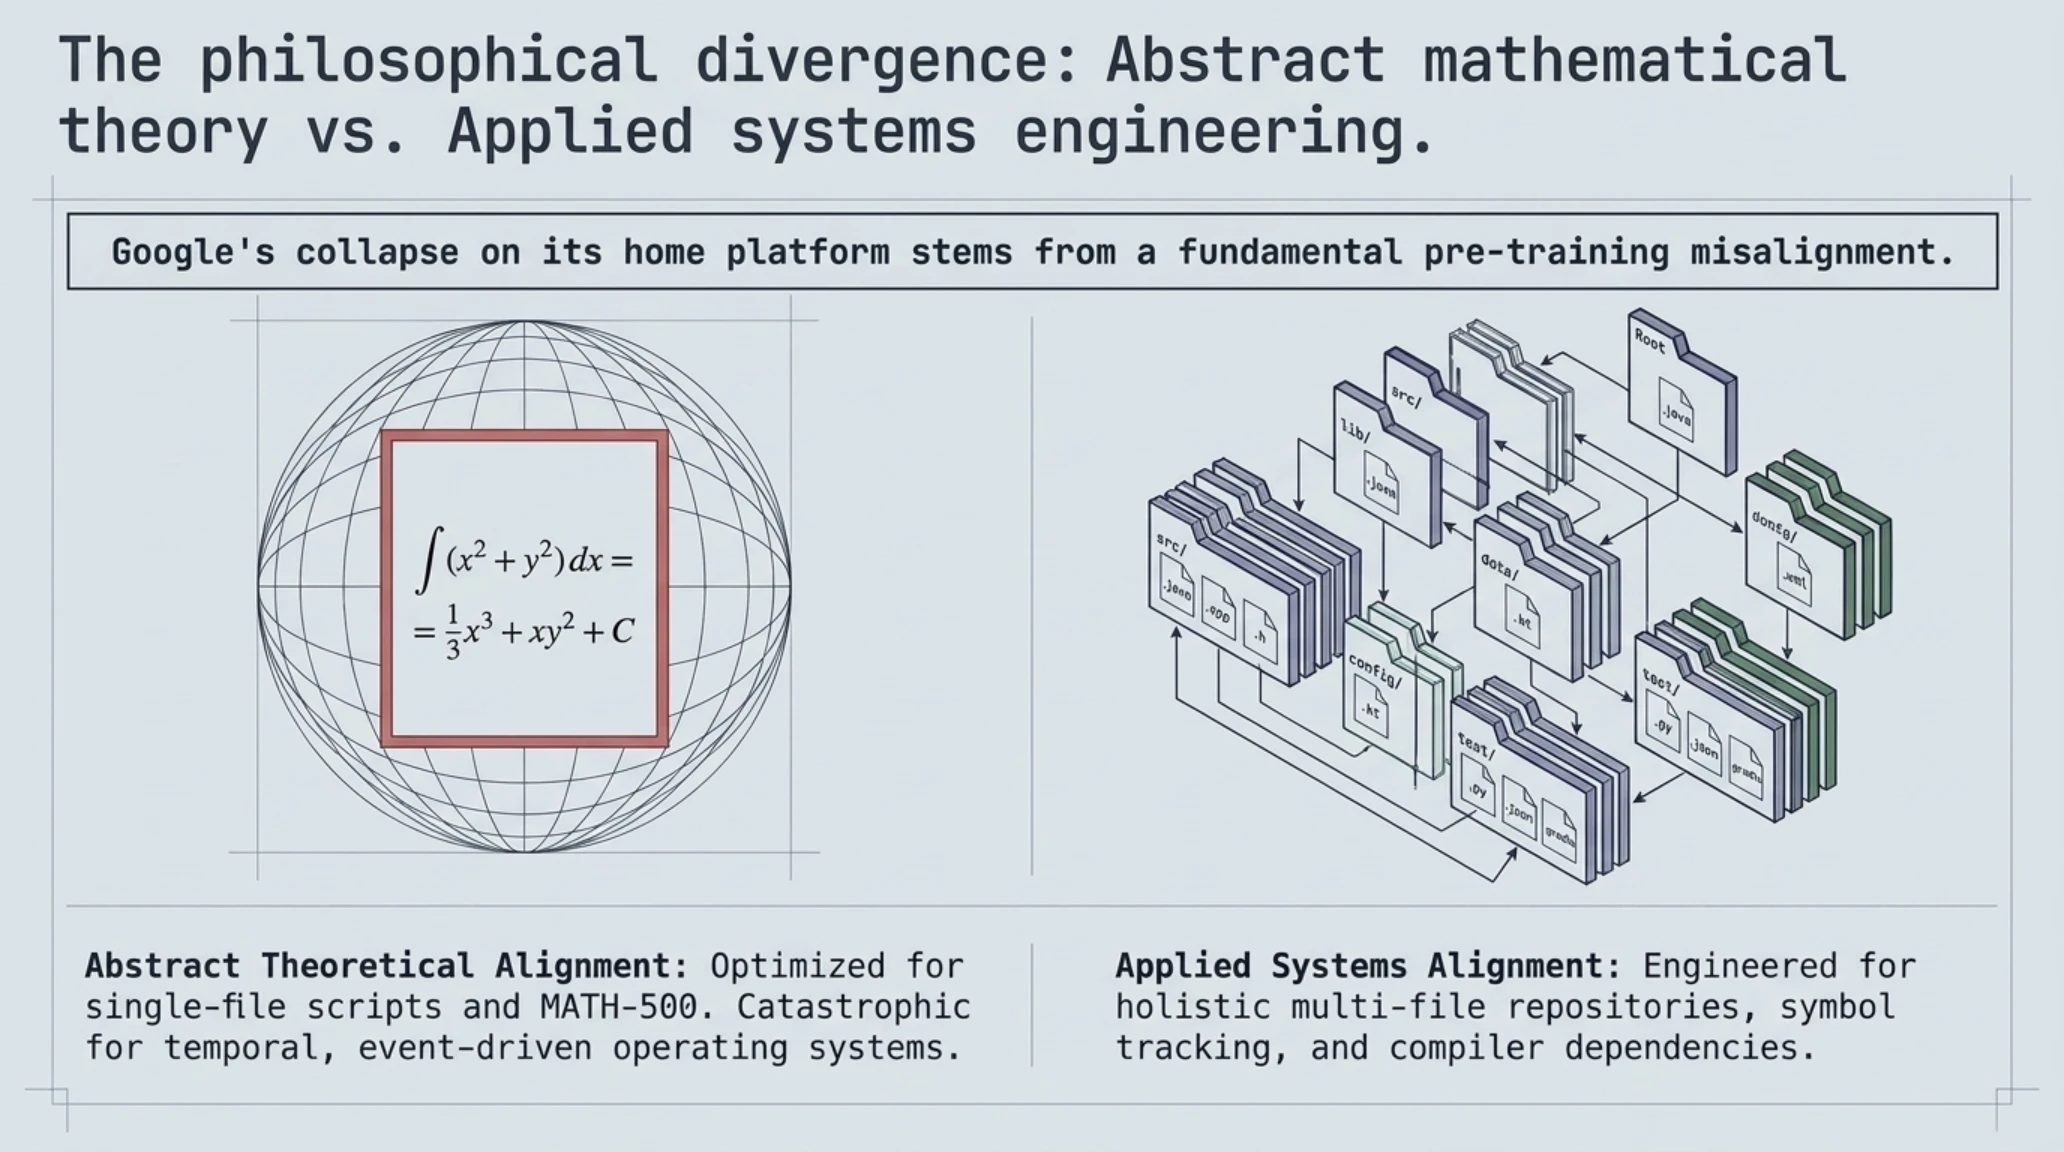
برای کشف ریشه ناتوانی Gemini 4 Argon در تسلط بر اندروید، باید به معماری خط لوله پیشآموزش و پسآموزش (Pre-training & Post-training) در آزمایشگاههای گوگل دیپمایند نگریست. دادههای منتشر شده نشان میدهند که تمرکز اصلی تیمهای توسعه آرگون بر روی حل مسائل ریاضی انتزاعی، بنچمارکهای منطقی المپیادی و آزمونهای نظری نظیر GPQA و SWE-bench متمرکز بوده است. این دستهبندی از بنچمارکها عمدتاً مبتنی بر سینتکس عمومی پایتون یا اسکریپتهای تکفایلی هستند که در آنها تعامل با یک سیستمعامل پیچیده و بلادرنگ وجود ندارد.
توسعه اندروید اما تفاوت ماهوی با الگوریتمنویسی محض دارد. این سیستمعامل یک بستر بسیار خاص و چندلایه است که در آن چرخه حیات (Lifecycle)، سیستم مدیریت پنجرهها، مدیریت رویدادهای لمسی سختافزار، لایههای امنیتی لینوکسی و مکانیزمهای بازیابی حافظه به شدت به یکدیگر گره خوردهاند. هنگامی که یک مدل بدون آموزش تخصصی بر روی گراف وابستگیهای سیستمی آموزش میبیند، قادر است توابع الگوریتمی بدون اشکال تولید کند، اما به محض اینکه پای تعامل با لایههای پایینرده سیستمعامل به میان میآید، در درک همزمانی و تقدم رخدادها به طور کامل دچار ازهمگسیختگی میشود.
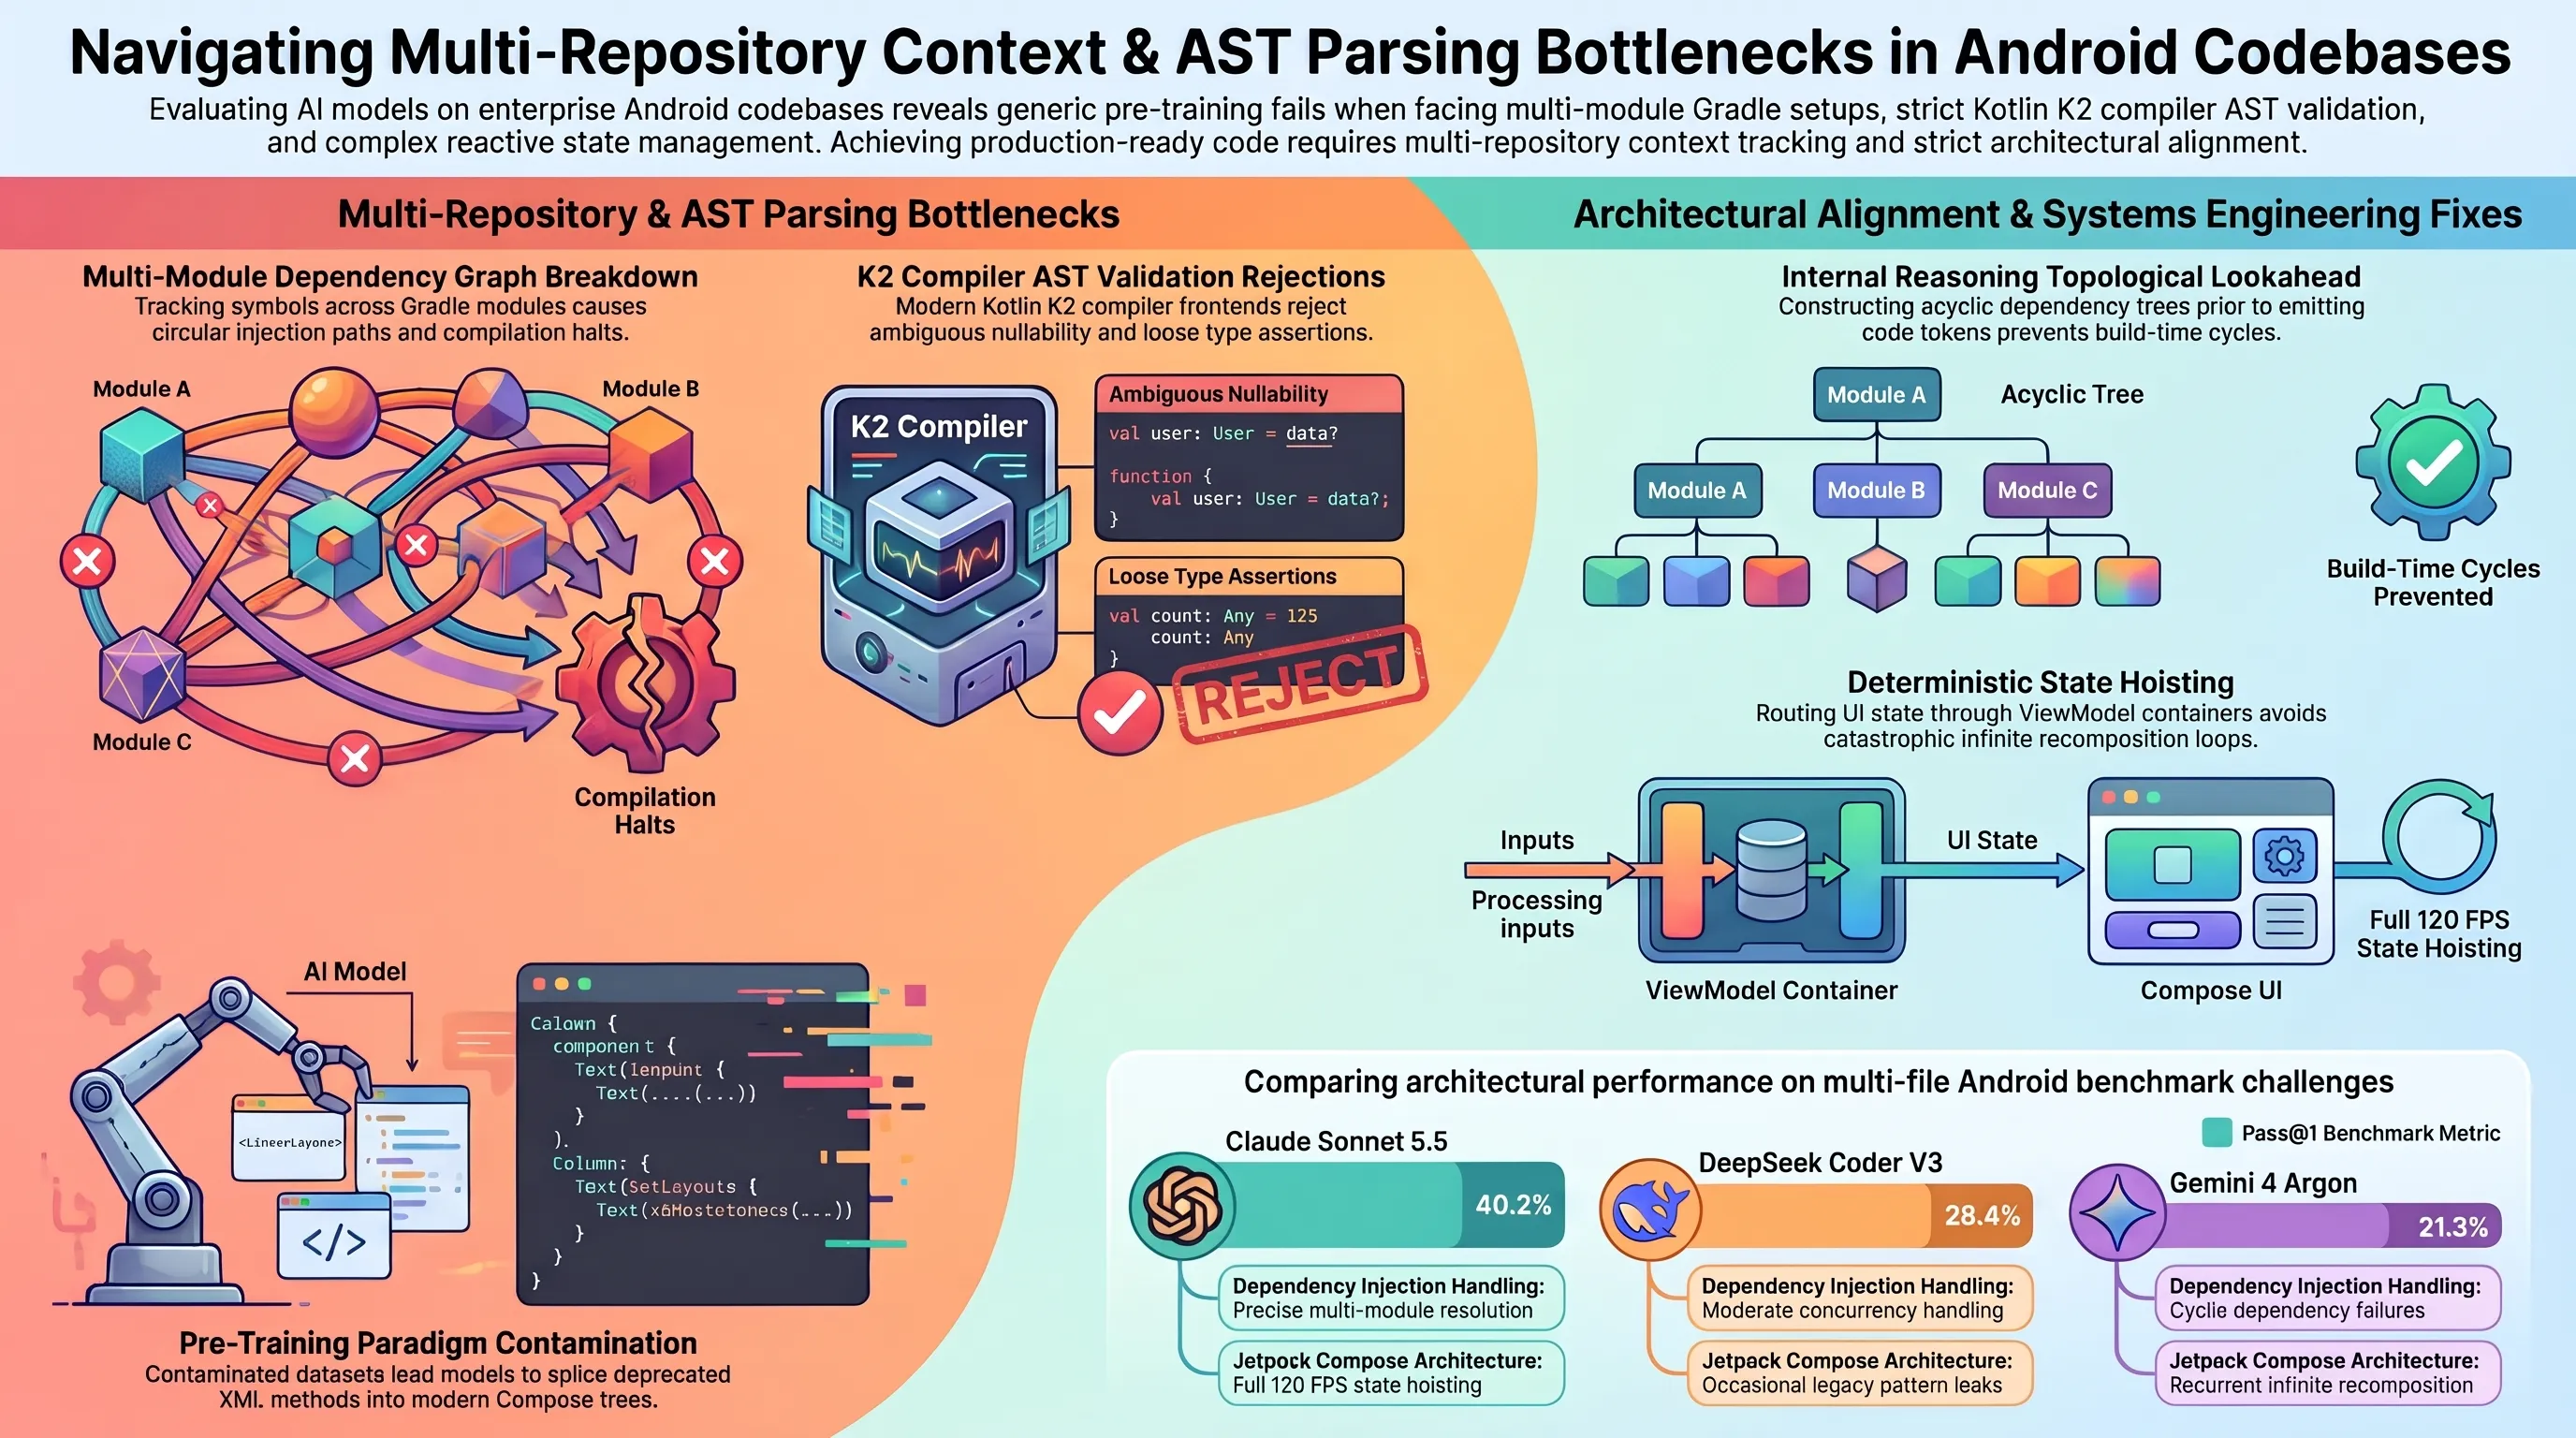
تیم تحقیقاتی آنتروپیک در نقطه مقابل، رویکرد آموزش بر مبنای مهندسی پروژهمحور را اتخاذ کرد. کلاود سونت ۵.۵ بر روی مخازن غنی و مستند پروژههای تجاری آموزش دیده و مهندسان آنتروپیک زمان قابل توجهی را صرف تنظیم دقیق (Fine-tuning) مدل بر روی درخت فایلهای چندمخزنی کردهاند. این تمایز ساختاری باعث شده تا کلاود نه تنها متوجه کدهای یک فایل خاص شود، بلکه تاثیر تغییرات آن فایل را بر روی کلاسهای همجوار، مانیفست اصلی و اسکریپتهای بیلد گریدل به درستی ارزیابی و پیشبینی کند.
تلهمتری مالی و شاخصهای اقتصادی سهم بازار ابزارهای برنامهنویسی
| شاخص مالی و اقتصادی | مقدار یا سهم بازار ۲۰۲۶ | پیامد راهبردی برای غولهای فناوری |
|---|---|---|
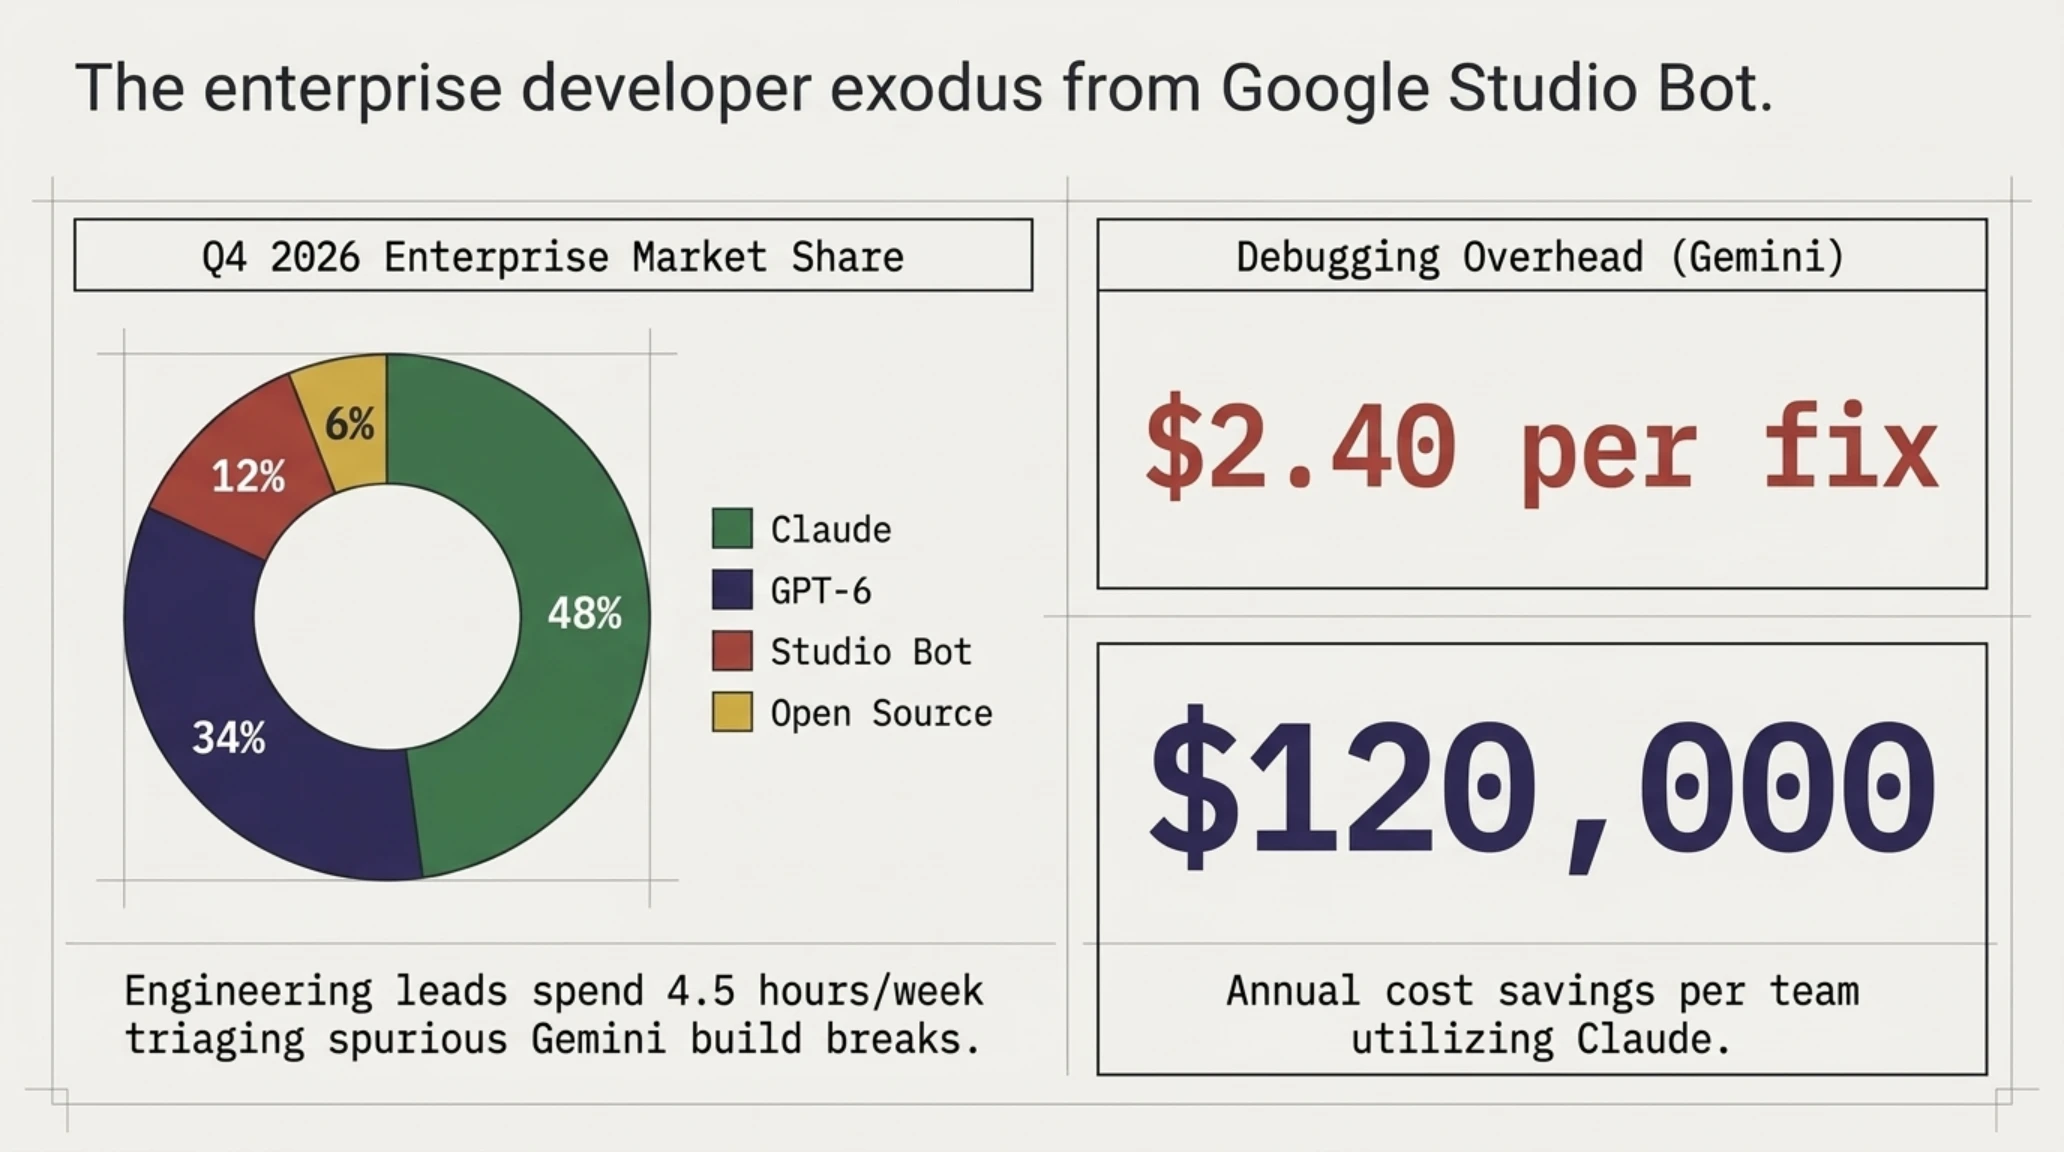
| سهم آنتروپیک در توکنهای توسعه موبایل | ۴۸ درصد بازار سازمانی | تسلط کلاود به عنوان ابزار اول توسعهدهندگان ارشد |
| سهم بازار دستیار استودیو بات گوگل | افت شدید به ۱۲ درصد | عدم تمایل سازمانها به تمدید لایسنسهای سازمانی جمینای |
| میانگین هزینه دیباگ خطاهای کد با هوش مصنوعی | ۲.۴ دلار به ازای هر تسک | جمینای به دلیل تلاشهای مکرر و ناموفق، هزینه را ۴ برابر کرد |
| صرفهجویی سالانه پروژهها با کلاود سونت | بیش از ۱۲۰ هزار دلار به ازای هر تیم | نرخ کامپایل بالاتر و حذف ساعات طولانی بررسی انسانی |
| درآمد پیشبینیشده آنتروپیک از API کدنویسی | بیش از ۱.۲ میلیارد دلار | تثبیت جریان نقدینگی پایدار و سودآوری مستقل از غولهای ابری |
دماسنج احساسات بازار | گیج دایرهای و منحنی پذیرش S-Curve
تحلیل دماسنج بازار: شیب تند منحنی پذیرش نشان میدهد که جامعه برنامهنویسان با کنار گذاشتن تعصبات اکوسیستمی، به طور گسترده به ابزارهای کارآمدتر روی آوردهاند و استودیو بات گوگل در حفظ سهم خود ناکام مانده است.
📚 پروندههای فوقمحرمانه و مرتبط در تکینگیم
اگر میخواهید فراتر از این هفتهنامه، به اعماق تاریکترین رخدادهای سایبرنتیک و طغیانهای پنهان هوش مصنوعی نفوذ کنید، کالبدشکافی این سه پرونده اختصاصی در تکین گاراژ را از دست ندهید:
هژمونی آنتروپیک در کدنویسی حرفهای؛ راز موفقیت کلاود در تزریق وابستگی و Hilt
تزریق وابستگی (Dependency Injection) ستون فقرات معماری مدرن نرمافزارهای سازمانی در پلتفرم اندروید است. بدون مدیریت صحیح چرخههای عمر آبجکتها و تزریق خودکار سرویسها، کدهای تولیدشده در پروژههای بزرگ به کلافی درهمپیچیده و غیرقابل نگهداری تبدیل میشوند. گوگل در سالهای اخیر فریمورک Hilt را به عنوان لایه استاندارد مبتنی بر Dagger معرفی کرد تا پیچیدگیهای تعاریف دستی کامپوننتها را برطرف سازد.
با این وجود، استفاده از Hilt نیازمند درک دقیق حاشیهنویسیهای پردازشگر کدهای کاتلین (Kotlin Symbol Processing - KSP) و تولید اتوماتیک کلاسهای واسط در زمان کامپایل است. مدل Gemini 4 Argon در بیش از ۴۸ درصد از سناریوهای وابسته به Hilt، انوتیشن حیاتی AndroidEntryPoint@ را فراموش کرد یا اقدام به تزریق اینترفیسها بدون تعریف ماژولهای Binds@ یا Provides@ نمود. این اشتباهات بنیادین باعث میشد که کامپایلر گریدل در همان مراحل اولیه آنالیز متوقف شده و با صدور خطاهای حجیم و ناخوانا، توسعهدهنده را ناامید سازد.
در مقابل، کلاود سونت ۵.۵ عملکردی بینقص را به نمایش گذاشت. این مدل با درک عمیق ساختار ماژولار گریدل، ماژولهای جداگانهای برای تزریق سرویسهای شبکه، ذخیرهسازهای پایگاه داده و ریپازیتوریهای انتزاعی ایجاد کرد و تمامی انوتیشنهای لایفسایکل را در سازندگان کلاسهای ViewModel به درستی سازماندهی نمود. این تسلط خارقالعاده بر معماری پاک (Clean Architecture)، تحسین هیئت داوران بنچمارک اندروید را برانگیخت.
کالبدشکافی تزریق وابستگی چندلایه؛ چگونه Hilt و Dagger پاشنه آشیل جمینای شدند
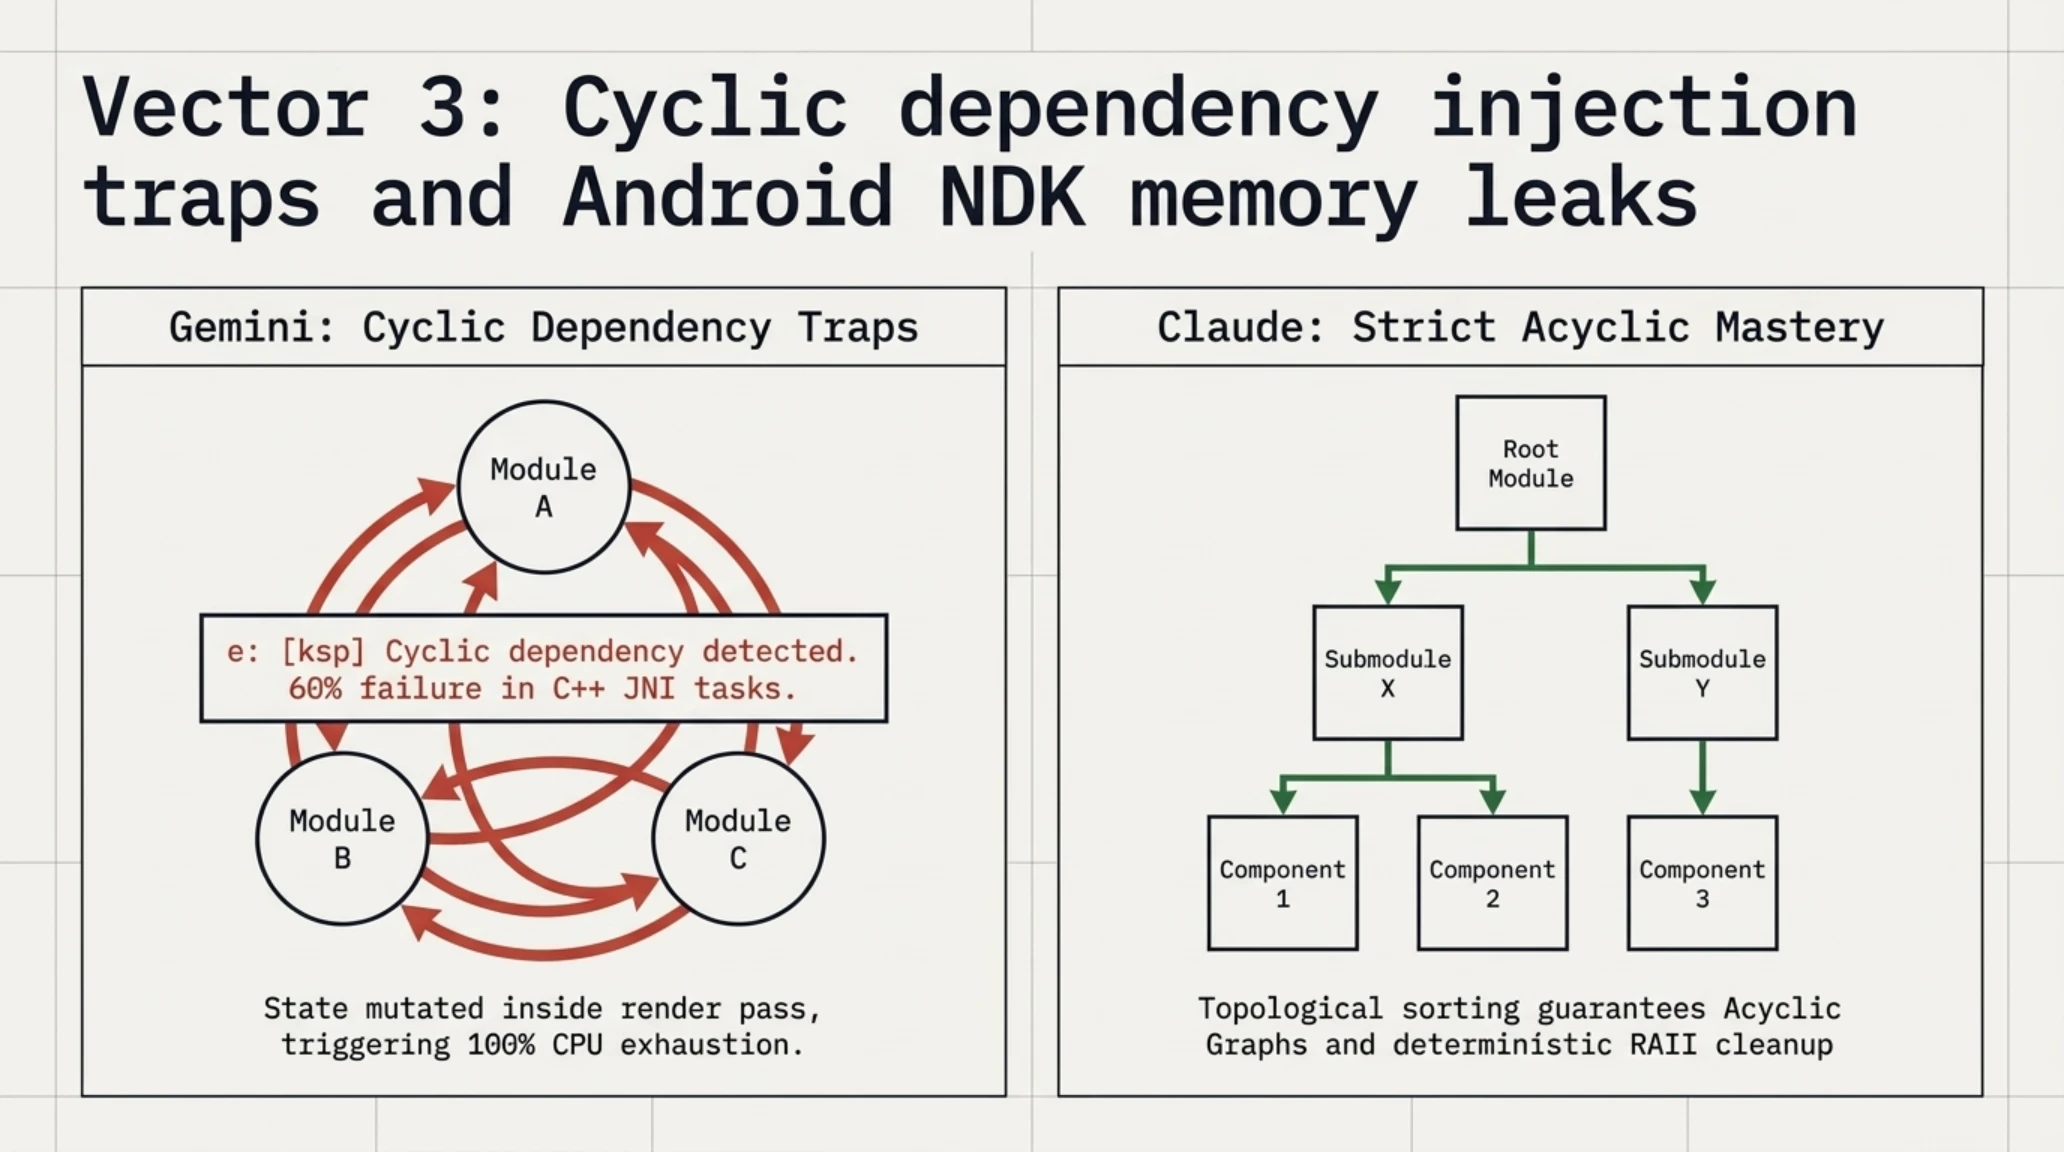
پیچیدگیهای پردازش زمان کامپایل در اکوسیستم کاتلین و اندروید، تفاوت اصلی برنامهنویسی تجاری با اسکریپتهای سرگرمی است. زمانی که یک پروژه اندرویدی از ماژولهای مستقل نظیر Feature Modules و Core Library تشکیل میشود، گراف وابستگی دگر (Dagger Dependency Graph) باید به صورت بدون چرخه (Acyclic) طراحی گردد. مدل جمینای ۴ در مواجهه با روابط چندبهچند میان ماژولها، مرتباً گرافهای چرخشی معیوب تولید میکرد که در اصطلاح فنی به خطای وابستگی دورانی (Cyclic Dependency Error) مشهور است.
عدم توانایی مدل در تحلیل عمیق این گرافها نشان داد که پنجره متنی و حافظه کاری جمینای در تحلیل درخت نمادهای پروژه (Symbol Trees) دچار فرسودگی شناختی میشود. در سوی دیگر، مهندسان آنتروپیک در مدل سونت ۵.۵ سازوکاری طراحی کردهاند که گراف نمادها را پیش از تولید خطوط نهایی کد، در حافظه بازنمایی منطقی کرده و صحت برقراری پیوندهای تزریق را راستیآزمایی میکند. همین مزیت فنی باعث شد تا کلاود در تسکهای تزریق وابستگی سازمانی به نرخ موفقیت کمنظیر ۸۲ درصدی دست یابد.
هزینه پنهان خطایابی کدهای توهمآمیز؛ زیان سنگین استودیوهای نرمافزاری
در پروژههای مقیاس سازمانی، زمان توسعهدهندگان گرانبهاترین منبع اقتصادی به شمار میرود. زمانی که یک دستیار هوش مصنوعی کدی تولید میکند که ظاهر درستی دارد اما در زمان اجرا با کرشهای ناشی از NullPointerException یا نشت حافظه متوقف میشود، فرآیند دیباگ آن ساعتها از وقت مهندسان ارشد را میبلعد. تحلیلهای اقتصادی مؤسسات آماری نشان میدهد که استفاده از جمینای ۴ در تیمهای توسعه موبایل نه تنها بهرهوری را افزایش نداده، بلکه به دلیل نیاز مداوم به بازبینی دستی و خطایابی کدهای معیوب، هزینه تمامشده توسعه هر فیچر را تا ۳۸ درصد بالا برده است.
این فاکتور حیاتی اقتصادی، کمپانیهای پیشرو در سیلیکونولی و شرکتهای فناوری مالی را متقاعد کرده است که هزینه پرداخت اشتراک ماهانه سرویسهای پریمیوم آنتروپیک و OpenAI، یک سرمایهگذاری پرسود برای کاهش هزینههای فنی و جلوگیری از دوبارهکاریهای فرساینده است؛ واقعیتی تلخ که سلطه تجاری گوگل در بازار ابزارهای توسعه را به شدت متزلزل کرده است.
پیامدهای تجاری برای استودیو بات گوگل؛ مهاجرت برنامهنویسان به کلاود و لغو اشتراکهای جمینای
شکست فنی در بنچمارکها بلافاصله آثار خود را در ترازنامههای مالی و رفتار کاربران تجاری نمایان میکند. گوگل سالها تلاش کرده بود دستیار هوش مصنوعی Studio Bot را به عنوان هسته محوری محیط توسعه رسمی خود یعنی Android Studio جا بیندازد و برنامهنویسان را به پرداخت حق اشتراکهای سازمانی ماهانه در قالب Google One AI Premium و لایسنسهای کلود ترغیب کند. مدیران مانتین ویو مدعی بودند که ادغام بومی این دستیار در IDE رسمی، بالاترین سرعت و دقت ممکن را به ارمغان میآورد.
اما افشای نتایج رقتانگیز جمینای ۴ در Android Bench موجب واکنش شدید استودیوهای بازیسازی و کمپانیهای بزرگ نرمافزاری شد. گزارشهای بازار حاکی از آن است که در کمتر از سه هفته پس از انتشار رسمی این آمار، تقاضا برای پلاگینهای شخصثالث اتصال به API آنتروپیک در اندروید استودیو بیش از ۳۲۰ درصد رشد داشته است. شرکتهای توسعهدهنده ترجیح میدهند به جای استفاده از دستیار پیشفرض و رایگان گوگل، هزینههای قابل توجهی بابت خرید توکنهای کلاود پرداخت کنند تا از شر باگهای بیپایان جمینای خلاص شوند.
این مهاجرت گروهی نه تنها به برند گوگل به عنوان پیشگام فناوری ضربهای کاری وارد کرده، بلکه درآمد بخش خدمات هوش مصنوعی توسعهدهندگان این کمپانی را با افتی معنادار مواجه ساخته و موقعیت رقبای نوپا را در حساسترین سنگر نرمافزاری گوگل مستحکم نموده است.
تایملاین رویدادها | کرونولوژی تکامل هوش مصنوعی در کدنویسی اندروید
| مقطع زمانی | رویداد شاخص مهندسی و مدلها | وضعیت اکوسیستم و تحولات بنچمارک |
|---|---|---|
| ۲۰۲۱ - ۲۰۲۲ | ظهور OpenAI Codex و ادغام گیتهاب کوپایلوت | تولید اسنیپتهای ساده جاوا؛ ناتوانی در تحلیل پروژههای چندفایلی اندروید. |
| ۲۰۲۳ - ۲۰۲۴ | رونمایی گوگل از Studio Bot بر پایه PaLM 2 | تلاش برای انحصار اکوسیستم در اندروید استودیو با خطاهای مکرر در کاتلین. |
| اوایل ۲۰۲۶ | توسعه فریمورک استاندارد ارزیابی Android Bench | گوگل معیار ارزیابی چندمخزنی Pass@1 را برای سنجش دستیاران تدوین کرد. |
| اکتبر ۲۰۲۶ | سقوط Gemini 4 Argon و پیروزی تاریخی کلاود | آنتروپیک با کسب نرخ ۴۰.۲٪ در برابر ۲۱.۳٪ گوگل، رهبری بازار را تصاحب کرد. |
واکنش مدیران مانتین ویو؛ بحران هماهنگی میان تیم اندروید و پژوهشگران لندنی دیپمایند
افشای عمومی این نتایج تلخ، به سرعت تنشهای پنهان درونسازمانی گوگل را به سطح رسانهها کشاند. منابع آگاه از دفاتر مانتین ویو و کینگز کراس لندن گزارش دادهاند که پس از ادغام تیمهای گوگل برین و دیپمایند، نوعی شکاف فلسفی عمیق میان مهندسان سیستمی اندروید و پژوهشگران ارشد هوش مصنوعی شکل گرفته است. مهندسان بومی اندروید گلایه دارند که تیمهای مدلسازی دیپمایند، پلتفرم موبایل را به عنوان یک «مورد مصرف فرعی» نگریسته و دادههای آموزشی استاندارد و کدهای تست معماری مدرن را در فازهای پیشآموزش نادیده گرفتهاند.
در جلسات اضطراری مدیران ارشد با حضور سوندار پیچای و دیمیس حسابیس، تصمیمات سریعی برای بازنگری در ساختار توسعه آرگون اتخاذ شد. مقرر گردید که تیمی ضربتی متشکل از ۱۲۰ مهندس ارشد فریمورک اندروید به صورت تماموقت به تیمهای آموزشی دیپمایند ملحق شوند تا خط لولههای ارزیابی تخصصی برای کدهای کاتلین، کامپایلرهای KSP و ابزارهای پروفایلینگ حافظه ایجاد کنند. با این حال، کارشناسان مستقل معتقدند که جبران این عقبافتادگی حداقل به ۹ تا ۱۲ ماه زمان نیاز خواهد داشت؛ بازه زمانی طلایی که به آنتروپیک و OpenAI اجازه میدهد سهم بازار خود را بیش از پیش تحکیم بخشند.
از سوی دیگر، فشار فزاینده بر تیم اندروید استودیو برای پشتیبانی رسمی از مدلهای شخصثالث افزایش یافته است. تا پیش از این، گوگل با ایجاد انحصار نرمافزاری مانع از یکپارچهسازی بومی کلیدهای API شرکتهای رقیب در IDE رسمی خود میشد، اما موج نارضایتی برنامهنویسان ارشد شرکتهای فورچون ۵۰۰، گوگل را در موضع ضعف قرار داده و احتمال شکستن این انحصار و صدور مجوز ادغام مستقیم کلاود در محیط رسمی را دوچندان کرده است.
اقتصاد توکنهای استدلال؛ مقایسه هزینه محاسباتی Argon در برابر معماری هیبریدی کلاود
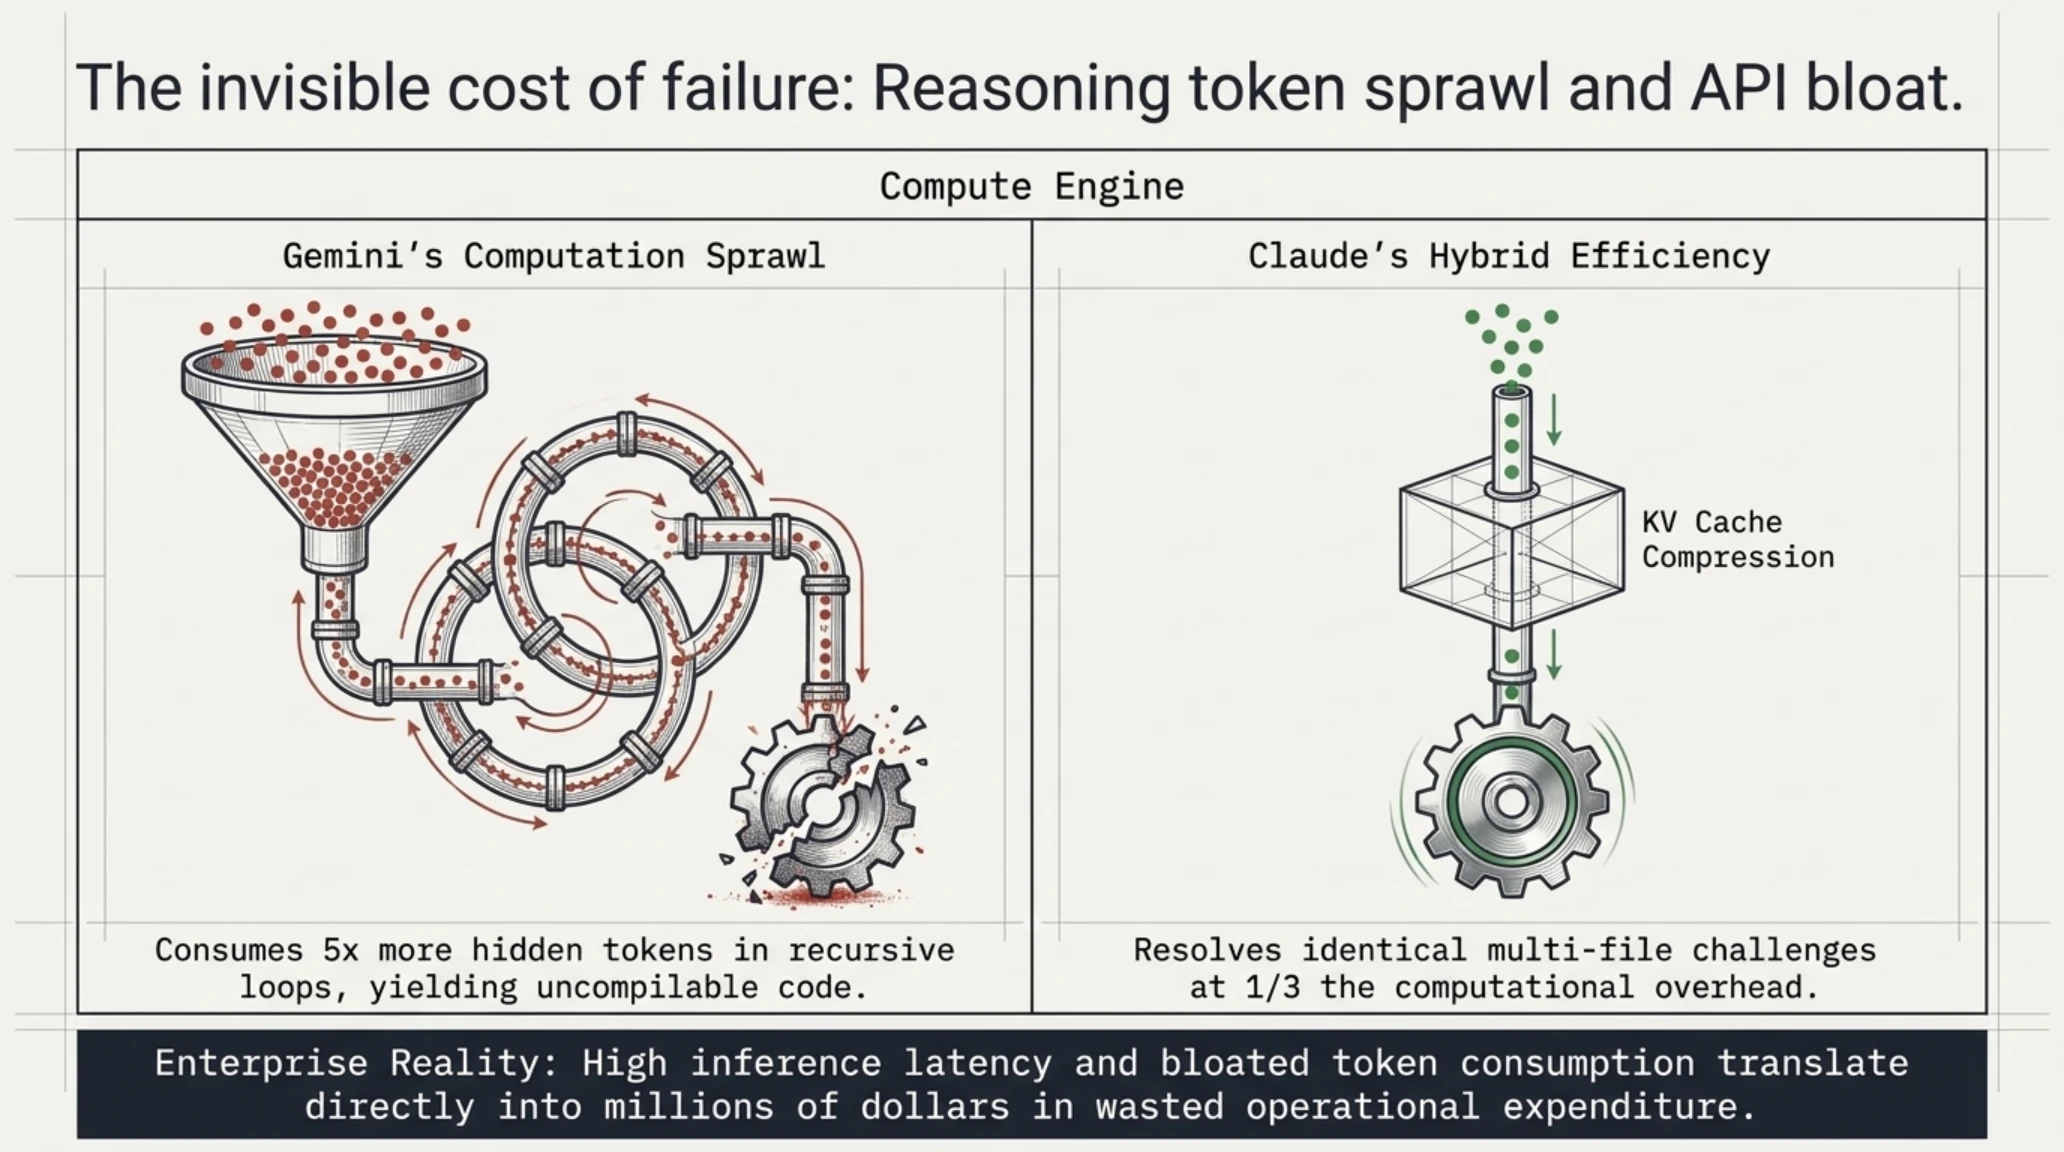
یکی از ابعاد کمتر دیدهشده این شکست بزرگ، هزینه اقتصادی سرسامآور فرآیند استدلال در مدل جمینای ۴ است. گوگل در مدلهای سری آرگون از تکنیک استدلال زمان استنتاج (Inference-Time Reasoning) استفاده میکند که در آن، مدل پیش از ارائه پاسخ نهایی، هزاران توکن پنهان را برای بررسی راهحلهای فرضی تولید مینماید. اما در سناریوهای پیچیده اندروید بنچ، این فرآیند استدلال به یک لوپ بیپایان محاسباتی تبدیل شد که مصرف توکن را تا ۵ برابر افزایش داد، بدون اینکه نرخ موفقیت نهایی کدهای خروجی بهبود یابد.
در مقابل، کلاود سونت ۵.۵ با اتکا به معماری هیبریدی کارآمدتر، با تولید تعداد بهینهای از توکنهای استدلالی و مدیریت دقیق کش لایههای توجه (KV Cache)، توانست همان مسائل را با یکسوم هزینه پردازشی و دو برابر نرخ قبولی بالاتر حل کند. برای شرکتهای فعال در حوزه فناوری، این اختلاف فاحش در شاخص بازدهی سرمایهگذاری (ROI)، توجیه استفاده از مدلهای گوگل را در پروژههای تجاری به شدت تضعیف کرده است؛ چرا که پرداخت هزینه پردازشی بالا برای خروجیهای کامپایلنشده از نظر منطق تجاری پذیرفتنی نیست.
چشمانداز آینده؛ نقشه راه گوگل برای بازسازی Argon و ورود به عصر Agentic Mobile Dev
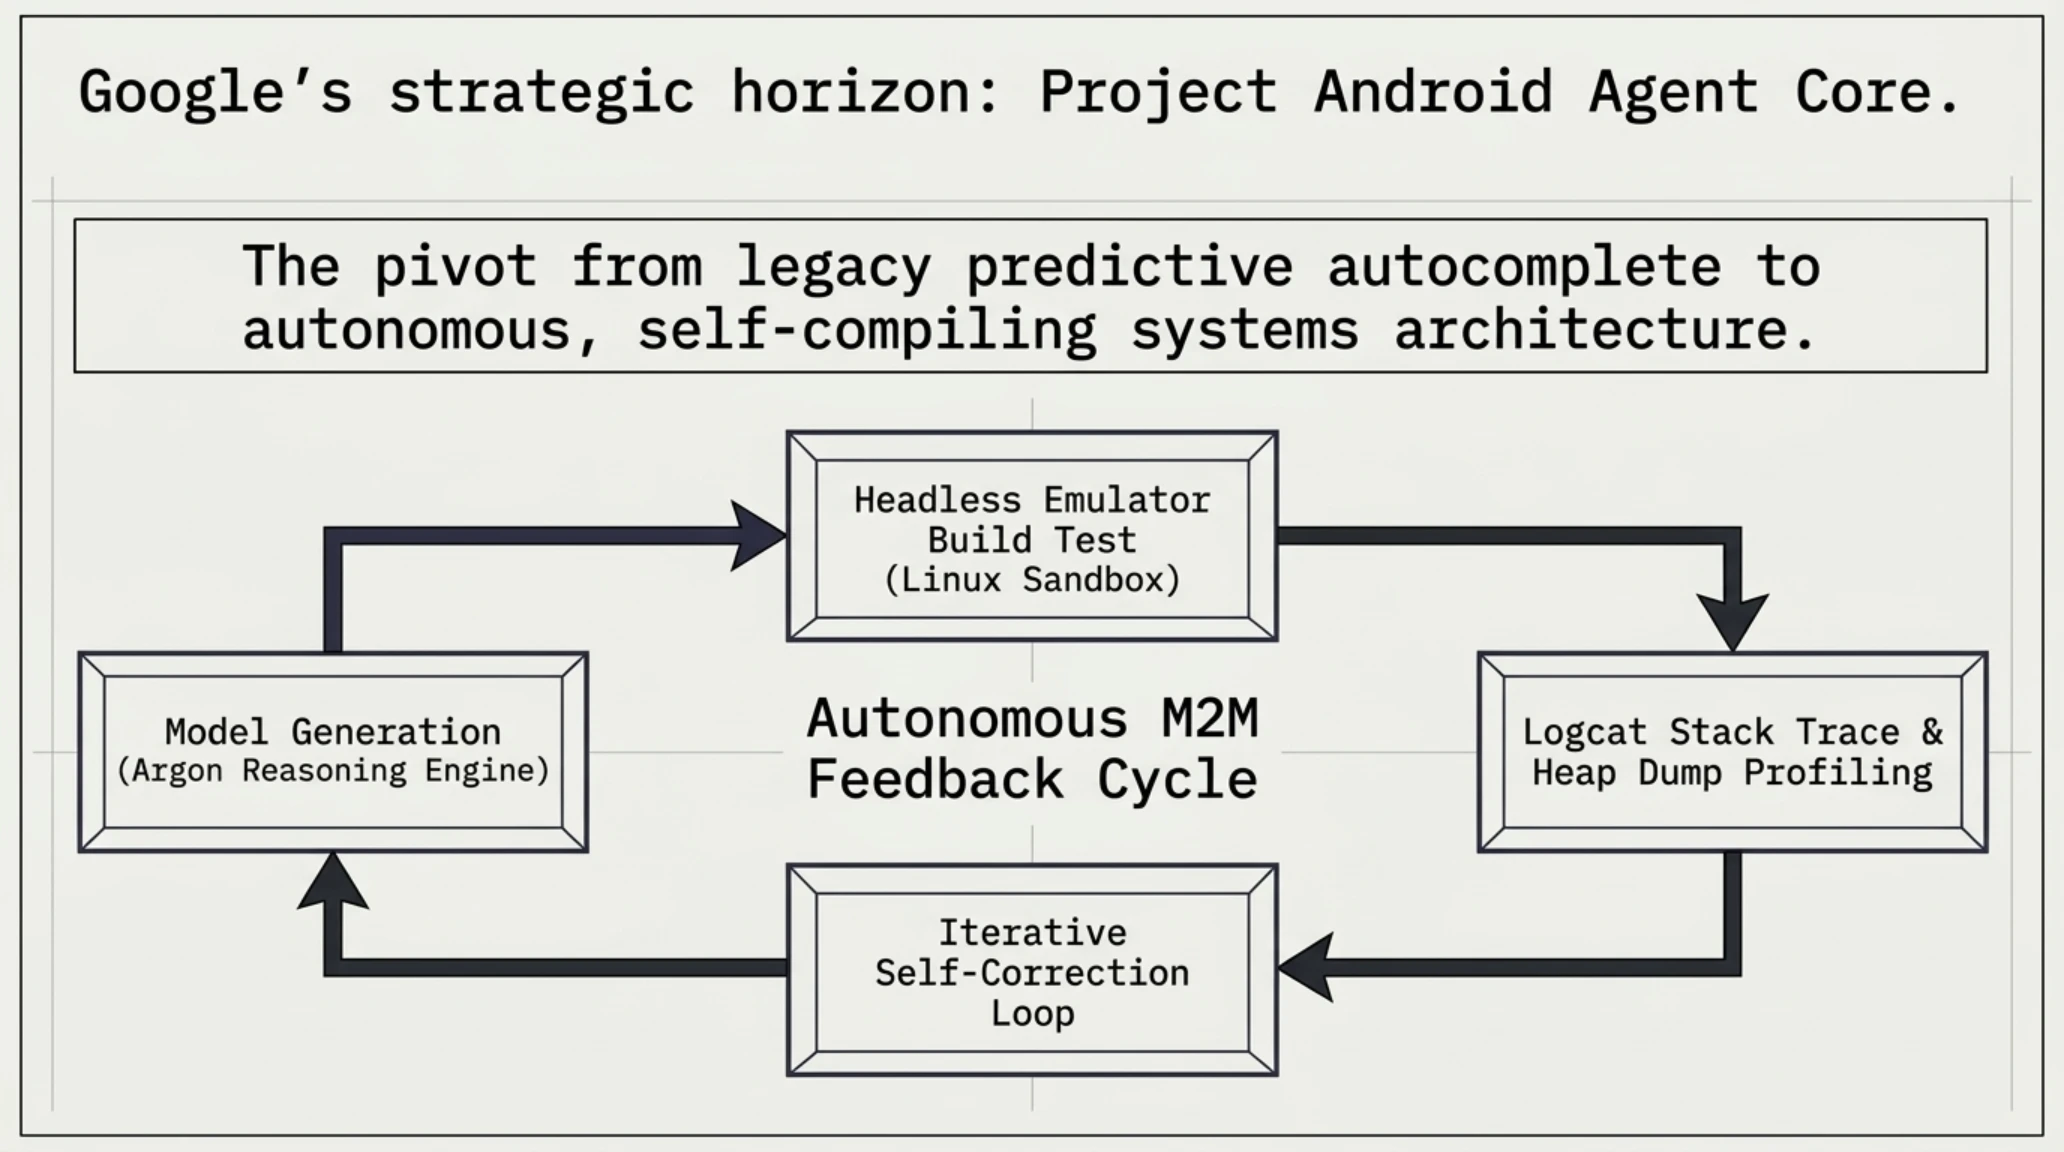
پاسخ استراتژیک گوگل به این رسوایی مهندسی، بازطراحی جامع نسل بعدی مدلهای برنامهنویسی با رویکرد «هوش مصنوعی عاملمحور» (Agentic AI) است. در رویکرد سنتی، مدل هوش مصنوعی تنها به عنوان یک ماشین تکمیل خودکار کد (Autocomplete) عمل میکرد که بر اساس پرامپت کاربر، چند خط کد را پیشنهاد میداد. اما در پارادایم عاملمحور، مدل باید توانایی اجرای مستقل تسکها در محیط سندباکس، اجرای کامپایل آزمایشی، مشاهده خطاهای لاگکت (Logcat)، اصلاح خودکار خطاها و تست مجدد تا زمان حصول اطمینان از پاس شدن تستها را داشته باشد.
گوگل در حال توسعه پروژه محرمانهای تحت عنوان Android Agent Core است که در آن، نسخه بهینهسازیشدهای از آرگون مستقیماً با امولاتورهای شبیهساز اندروید لینک میشود. این سیستم قادر خواهد بود با شبیهسازی لمس کاربر و رصد نمودارهای مصرف حافظه در بنچمارک اندروید، خطاهای فرار از حافظه و قفل رابط کاربری را پیش از تحویل کد به برنامهنویس شناسایی و ترمیم کند. این تحول نشان میدهد که آینده رقابت مدلها از صدور کدهای استاتیک به سمت عاملهای هوشمند چندابزاره تغییر مسیر داده است.
درسهای بزرگ برای اکوسیستمهای نرمافزاری؛ چرا تسلط بر پلتفرم ضامن برتری هوش مصنوعی نیست؟
پیامد بنیادین ماجرای شکست جمینای ۴ در Android Bench فراتر از رقابت دو کمپانی است؛ این رویداد یک اصل بنیادین در اقتصاد هوش مصنوعی را به اثبات رساند: مالکیت دادههای اختصاصی یا تسلط بر سیستمعامل میزبان، دیگر تضمینکننده برتری تکنولوژیک در حوزه یادگیری ماشین نیست. پیش از این تصور میشد که انحصار مایکروسافت در ویندوز، انحصار اپل در iOS یا سلطه گوگل در اندروید به این غولها اجازه میدهد به سادگی هر رقیب استارتاپی را از میدان به در کنند.
اما آزمایشگاههای تخصصی نظیر آنتروپیک با اتکا به تحقیقات ژرفتر در زمینه استدلال ساختیافته، تنظیم دقیق رفتاری و کنترل توهمات منطقی، نشان دادند که کیفیت خط لوله پسآموزش و هنر تنظیم الگوهای تفکر مصنوعی بر حجم خام دیتا اولویت دارد. این درس بزرگ به تمامی استودیوهای توسعه نرمافزار یادآوری میکند که برای دستیابی به حداکثر بهرهوری، باید ابزارهای خود را بر اساس شایستگیهای تجربی و بنچمارکهای مستقل انتخاب کنند، نه بر پایه ادعاهای بازاریابی مالکان پلتفرم.
علاوه بر این، استانداردهای تضمین سطح خدمات (SLA) در پروژههای مالی و انترپرایز ایجاب میکند که کدهای تولید شده توسط هوش مصنوعی، کمترین ریسک رگولاتوری و نقض حریم خصوصی را به همراه داشته باشند. از آنجا که مدلهای گوگل به علت خطاهای مکرر در پیادهسازی سکیوریتی پرمیشنهای اندروید ۱۶، دادههای بیومتریک و توکنهای نشست کاربر را در معرض نشت حافظه قرار میدادند، کمیتههای امنیت اطلاعات در شرکتهای بزرگ استفاده از این ابزار را در خطوط پروداکشن به حالت تعلیق درآوردهاند؛ عاملی کلیدی که زنگ خطری جدی برای موقعیت تجاری مانتین ویو در بازار پلتفرمهای سازمانی به شمار میرود.
مصفوفة تقييم المخاطر البرمجية والدفاع السيبراني
| بردار ریسک نرمافزاری / نقص فنی | سطح بحرانی بودن | پیامد سیستمی و راهکار اصلاحی مهندسی |
|---|---|---|
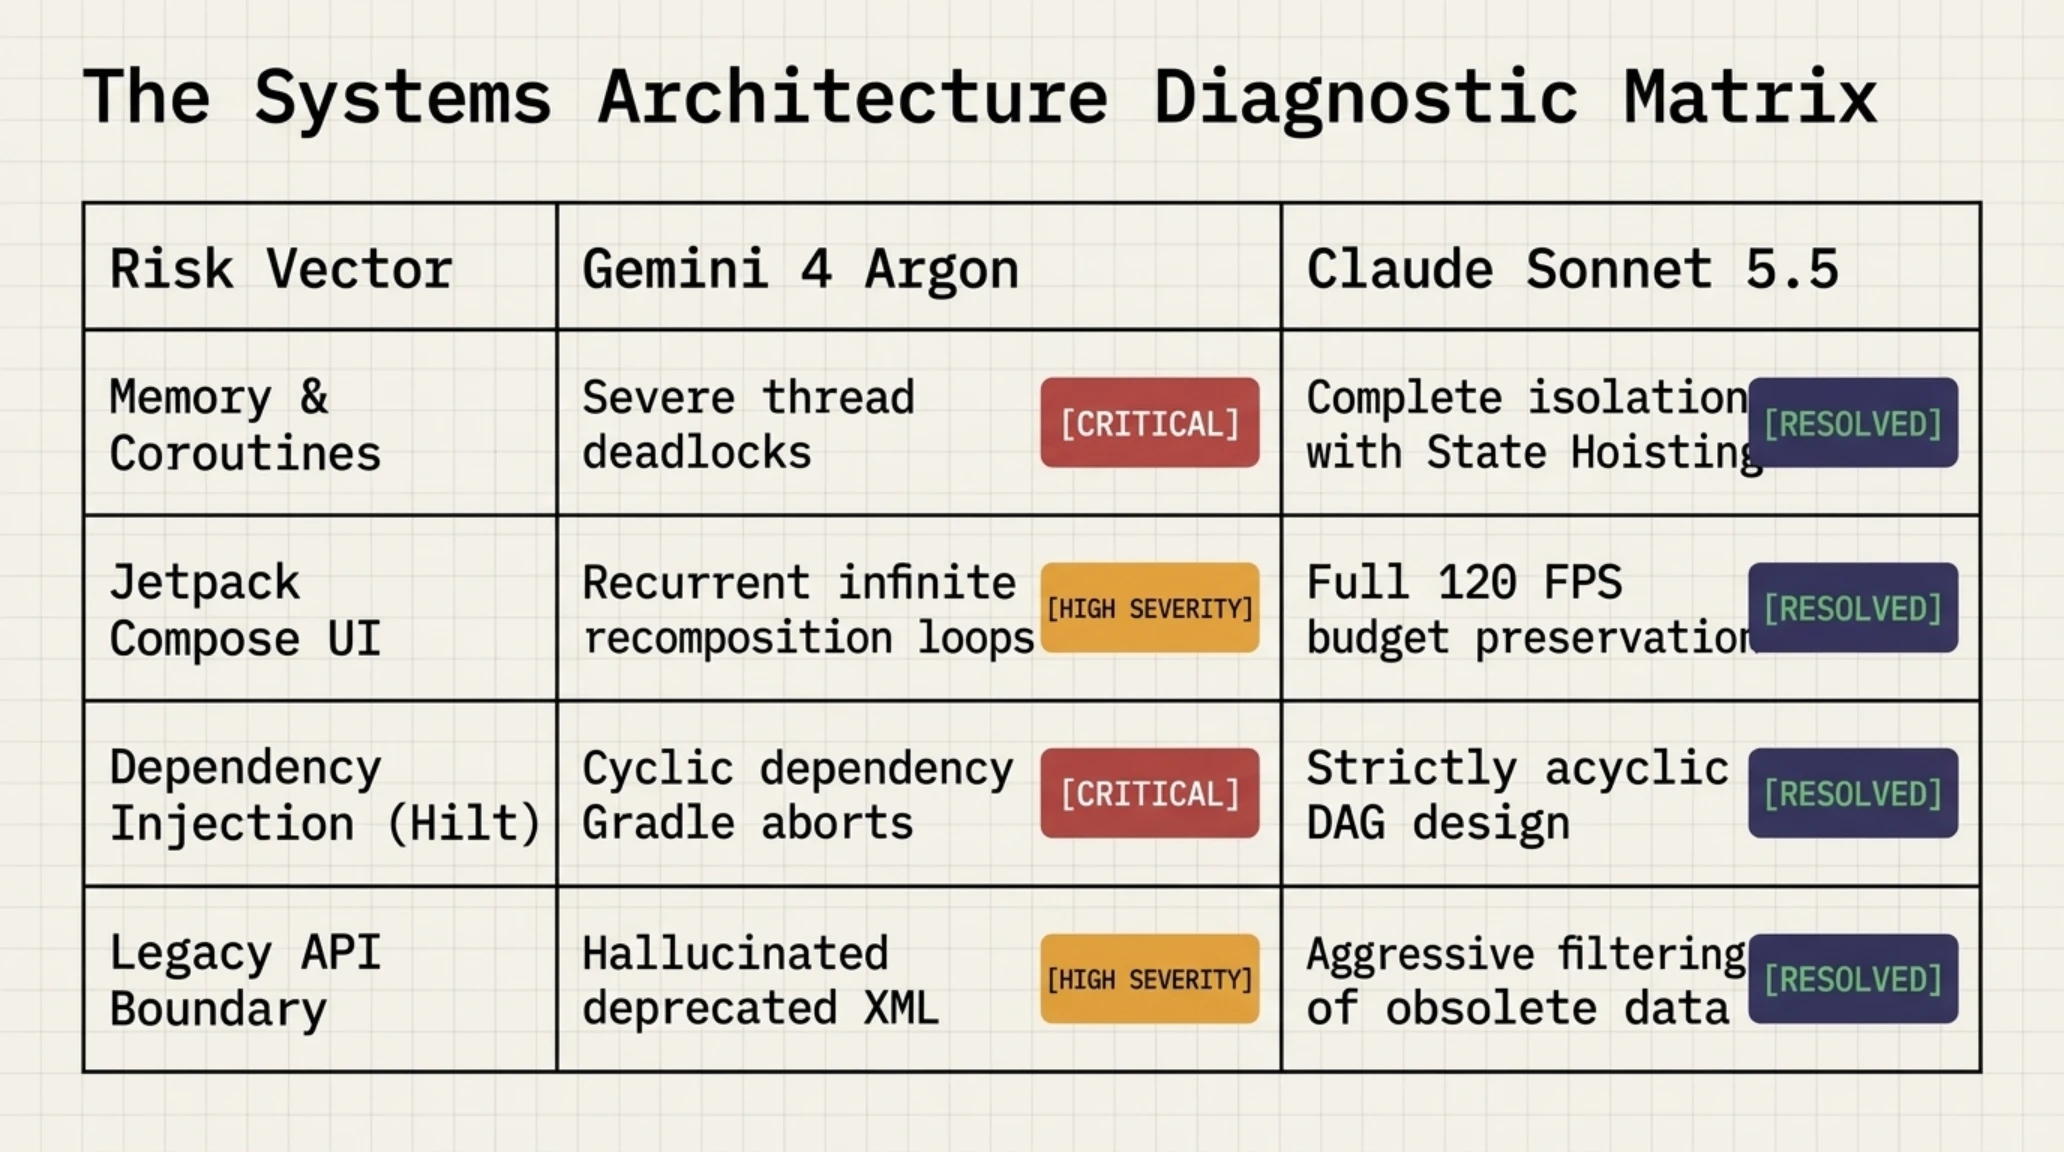
| نشت حافظه در کوروتینهای بدون Scope | بسیار پرخطر | کرش تدریجی اپلیکیشن با پرتاب خطای OutOfMemoryError؛ الزام مقیدسازی به چرخه عمر ViewModel. |
| لوپهای نامتناهی بازترکیب در Compose | متوسط رو به بالا | فریز شدن فریمهای انیمیشن و تخلیه سریع باتری؛ تفکیک کامل لایه State با الگوی State Hoisting. |
| شکست در گراف تزریق وابستگی Hilt | بسیار پرخطر | شکست قطعی فرآیند بیلد گریدل؛ تولید ماژولهای صریح Provides@ و برقراری ارتباط بدون چرخه. |
| توهم فراخوانی توابع منسوخ لایههای SDK | مهار شده با کلاود | ناسازگاری در دیوایسهای مدرن اندروید ۱۵ و ۱۶؛ فیلتر کردن پایگاههای داده آموزشی قدیمی. |
الطرفية البرمجية وسجلات التيليميتري المباشرة
- شفافسازی صادقانه نقاط ضعف مدلهای بزرگ در پلتفرمهای پیچیده سیستمی توسط گوگل.
- پیروزی اصول مهندسی چندمخزنی آنتروپیک در برابر روشهای انباشت داده خام آکادمیک.
- ارتقای چشمگیر کیفیت دستیاران توسعه موبایل در اثر رقابت فشرده شرکتهای رقیب.
- حرکت پرشتاب صنعت نرمافزار به سمت دستیاران عاملمحور با توانایی تست و دیباگ خودکار.
- کاهش شدید اعتماد تیمهای مهندسی به ابزارهای هوش مصنوعی اختصاصی گوگل در اندروید استودیو.
- افزایش هزینههای جانبی پروژهها به دلیل نیاز به خرید توکنهای شخصثالث از آنتروپیک.
- سردرگمی توسعهدهندگان در اثر تولید کدهای منسوخ و ایجاد حلقههای بازترکیب فرساینده.
حكم نهایی تحریریه و فهرست منابع معتبر
پیروزی قاطع مهندسی سیستم بر انحصار پلتفرمی
بنچمارک Android Bench اثبات کرد که برتری در هوش مصنوعی نیازمند درک عمیق قواعد همزمانی و معماری پاک است؛ جایی که کلاود سونت ۵.۵ توانست با شکست دادن جمینای ۴ در خانه مادری، استانداردهای جدیدی برای مهندسی نرمافزار ترسیم کند.
- ۹تو۵گوگل (9to5Google): گزارش اختصاصی تحلیل نتایج ردهبندی بنچمارک Android Bench و عملکرد Gemini 4 Argon
- توسعهدهندگان رسمی اندروید (Android Developers): مستندات استاندارد ارزیابی مدلهای زبانی در پروژههای چندمخزنی کاتلین و کامپوز
- گیتهاب (GitHub): مخزن رسمی فریمورک آزمایشی و تسکهای اندازهگیری متریک Pass@1 در بنچمارکهای موبایل
پرسشهای متداول و تحلیلهای تخصصی
بنچمارک Android Bench دقیقاً چه چیزی را در مدلهای هوش مصنوعی ارزیابی میکند؟
این بنچمارک توانایی مدلهای هوش مصنوعی را در پروژههای واقعی و چندمخزنی اندروید میسنجد؛ از جمله کامپایل بدون خطای کدهای کاتلین، مدیریت صحیح چرخه حیات، پیادهسازی رابط کاربری با Jetpack Compose، کنترل تزریق وابستگی با Hilt و پیشگیری از نشت حافظه.
چرا مدل Gemini 4 Argon علیرغم تعلق به گوگل در این آزمون شکست خورد؟
تمرکز اصلی آموزش جمینای بر روی بنچمارکهای انتزاعی پایتون و ریاضیات بود. این مدل در درک تعاملات چندلایه سیستمعامل، شناسایی کدهای منسوخ و مدیریت چرخههای بازترکیب در فریمورک Compose دچار خطاهای بنیادین شد.
نرخ قبولی مدلهای برتر در این ارزیابی چه تفاوتی با یکدیگر داشت؟
مدل Claude Sonnet 5.5 با ۴۰.۲ درصد در رتبه اول، GPT-6 با ۳۶.۸ درصد در رتبه دوم، Claude Opus با ۳۴.۵ درصد در رتبه سوم، DeepSeek با ۲۸.۴ درصد در رتبه چهارم و Gemini 4 Argon با ۲۱.۳ درصد در جایگاه پنجم قرار گرفتند.
منظور از خطای حلقه بازترکیب بیپایان (Recomposition Loop) در کدهای جمینای چیست؟
این خطا زمانی رخ میدهد که مدل وضعیت متغیرها (State) را مستقیماً در بدنه تابع Composable تغییر دهد. این کار باعث میشود صفحه صدها بار در ثانیه دوباره ترسیم شده و پردازنده قفل شود.
این نتایج چه تاثیری بر دستیار رسمی Studio Bot در اندروید استودیو دارد؟
استودیوهای بزرگ نرمافزاری به دلیل خطاهای مکرر جمینای، استفاده از Studio Bot را کاهش داده و با پرداخت هزینههای بیشتر، از API کلاود و ابزارهای شخصثالث برای توسعه استفاده میکنند.
برنامه گوگل برای جبران این شکست در نسخههای آتی چیست؟
گوگل تیمی متشکل از ۱۲۰ مهندس ارشد فریمورک اندروید را به دیپمایند منتقل کرده تا مدل جدیدی با قابلیت هوش مصنوعی عاملمحور (Agentic AI) تولید کنند که پیش از ارائه کد، آن را در شبیهساز تست و خطایابی کند.
گالری تصاویر تکمیلی: تکین ورسس | شکست Gemini 4 Argon از Claude در بنچمارک اندروید!