انقلاب سختافزاری: پایان باجگیری ماهیانه هوش مصنوعی
کالبدشکافی معماری مینی پیسیهای AMD Strix Halo با ۱۲۸ گیگابایت حافظه یکپارچه و پایان سلطه انحصاری انویدیا و اشتراکهای دلاری.
- 🎮گذرگاه ۲۵۶ بیتی- دستیابی به پهنای باند ۵۰۰ گیگابایت بر ثانیه و شکست سد VRAM انویدیا
- 🎧ظرفیت ۱۲۸ گیگابایت- اجرای بومی مدلهای ۷۰ میلیاردی مانند لاما ۳.۱ با سرعت ۲۸ توکن در ثانیه
- 🚀مرگ اشتراک ۲۰۰ دلاری- پایان وابستگی به ChatGPT Pro با استرداد کامل سرمایه در ۶ ماه
- 🗡️حاکمیت کامل داده- مصونیت در برابر فیلترینگ و ردیابی اطلاعات با حفظ حریم خصوصی
- 📰انرژی و اکوستیک- فعالیت بیصدا و پایدار با مصرف توان ناچیز ۱۲۰ وات
- ⚔️اکوسیستم ROCm- پایان انحصار CUDA و هماهنگی کامل با ابزارهای Ollama و LM Studio
کالبدشکافی یک ادعای جنجالی؛ آیا اشتراک ۲۰۰ دلاری واقعا نفسهای آخر را میکشد؟
طی روزهای گذشته، انتشار ویدیوها و تصاویری از نمای انفجاری یک مینی پیسی بسیار جمعوجور با لوگوی رسمی شرکت ایامدی و تیتر جنجالی «ایامدی به هزینه ماهانه ۲۰۰ دلاری هوش مصنوعی پایان داد»، زلزلهای در میان توسعهدهندگان، پژوهشگران داده و گیمرهای حرفهای برپا کرد. در فضایی که شبکههای اجتماعی مملو از تیترهای تبلیغاتی و ادعاهای توخالی است، جامعه فنی همواره با شک و تردید به چنین پیامهایی مینگرد. با این حال، تحلیل موشکافانه معماری سیلیکون و اسناد مهندسی منتشرشده نشان میدهد که این بار با یک شعار بازاریابی صرف مواجه نیستیم؛ بلکه یک دگرگونی ساختاری در تعادل قدرت میان پردازش ابری و محاسبات محلی در حال وقوع است.
جمعبندی راهبردی: پیامدهای تسخیر میز کار توسط سیلیکون یکپارچه
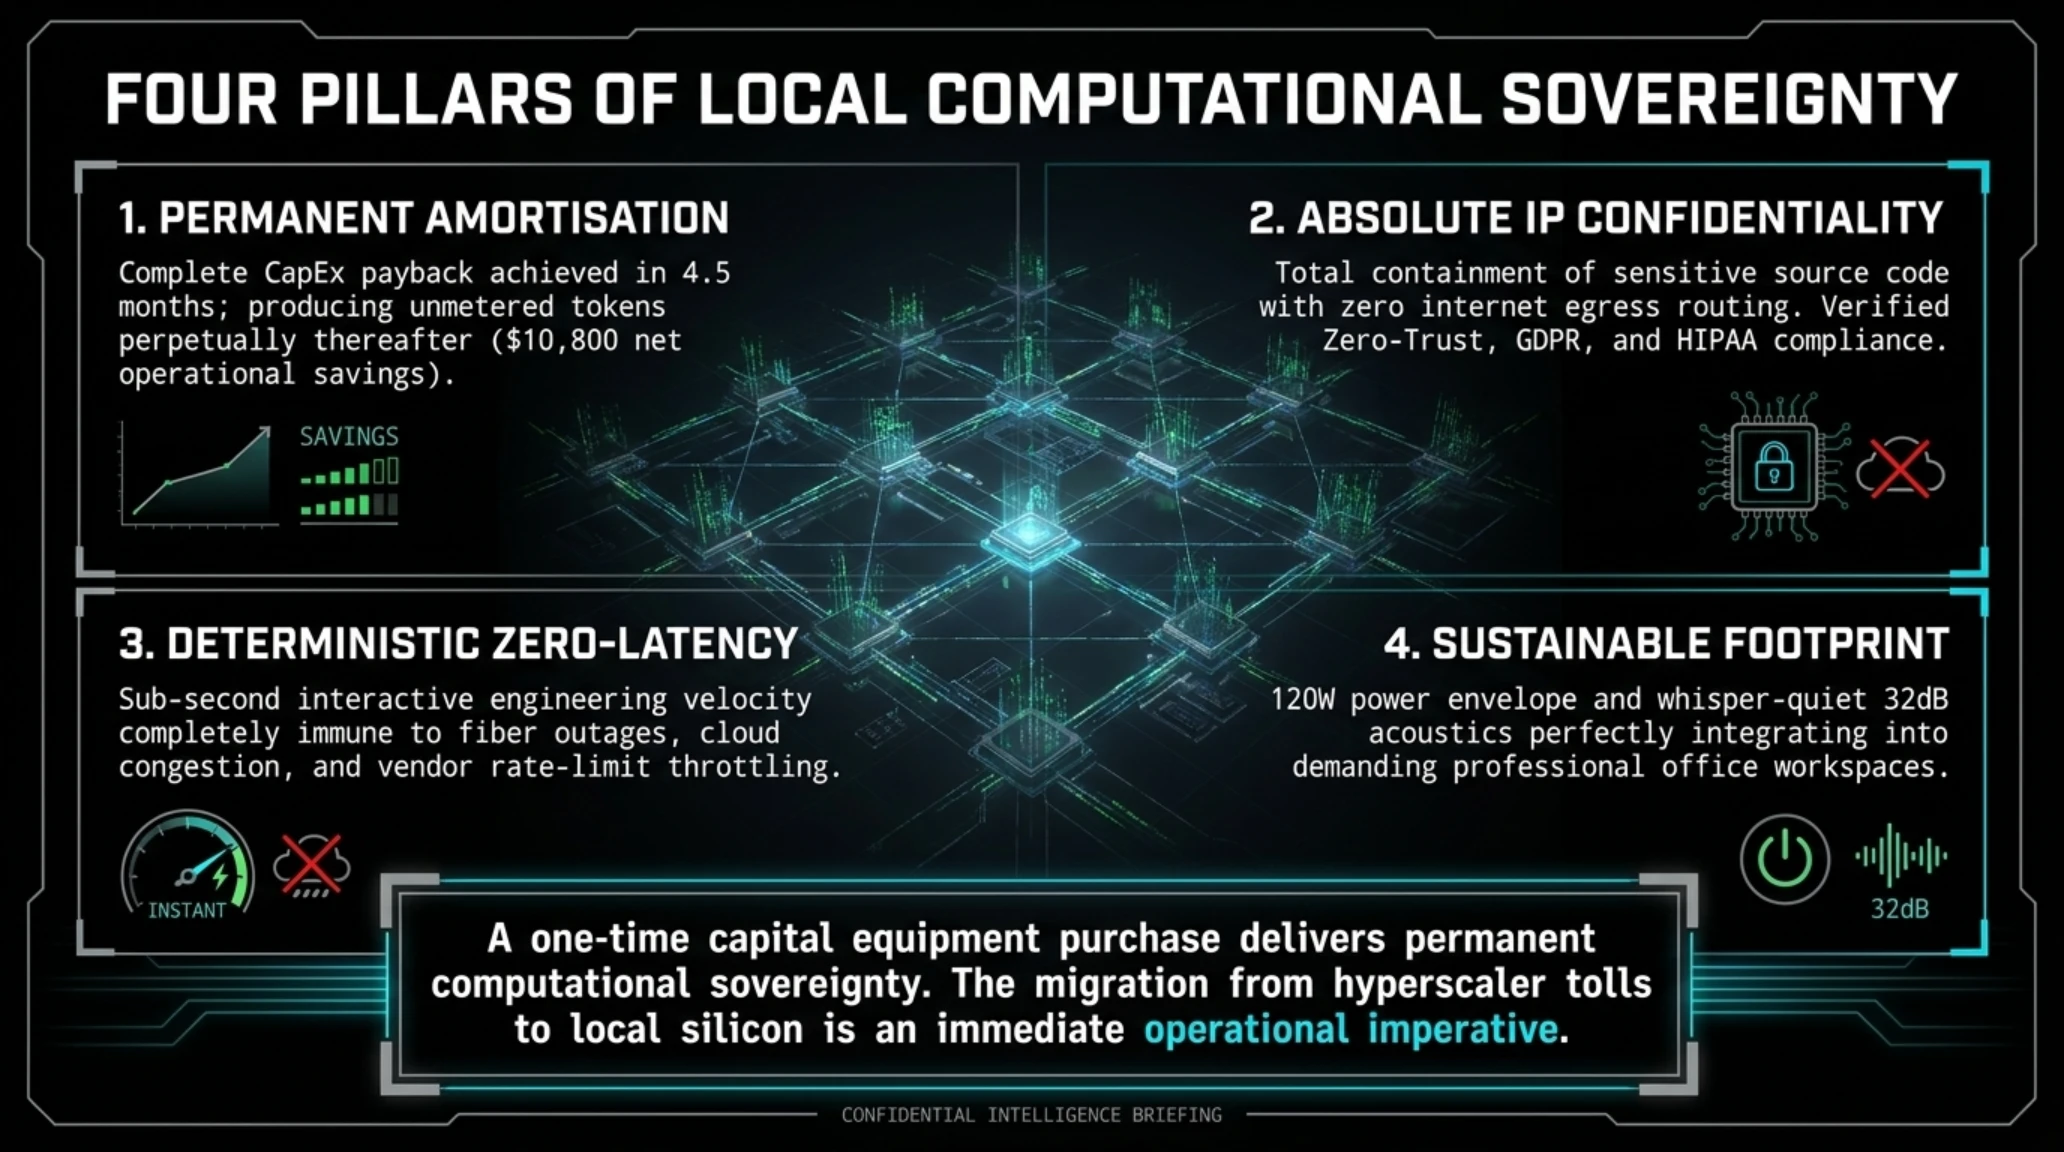
- پایان هزینههای جاری و بازگشت کامل هزینه اولیه خرید دستگاه ظرف کمتر از ۶ ماه و تولید توکنهای رایگان پس از آن.
- حاکمیت کامل بر محرمانگی و داراییهای فکری با نگهداری صددرصدی کدها بر روی حافظه شخصی بدون ارسال به اینترنت.
- شکستن طلسم فیلترینگ و تحریمها در ایران با فعالیت بیوقفه، بدون نیاز به فیلترشکن و آیپی ثابت خارجی.
- سکوت آکوستیک و مصرف برق بسیار ناچیز پایدار با ۱۲۰ وات، متناسب با استقرار روی میز کار مدرن.
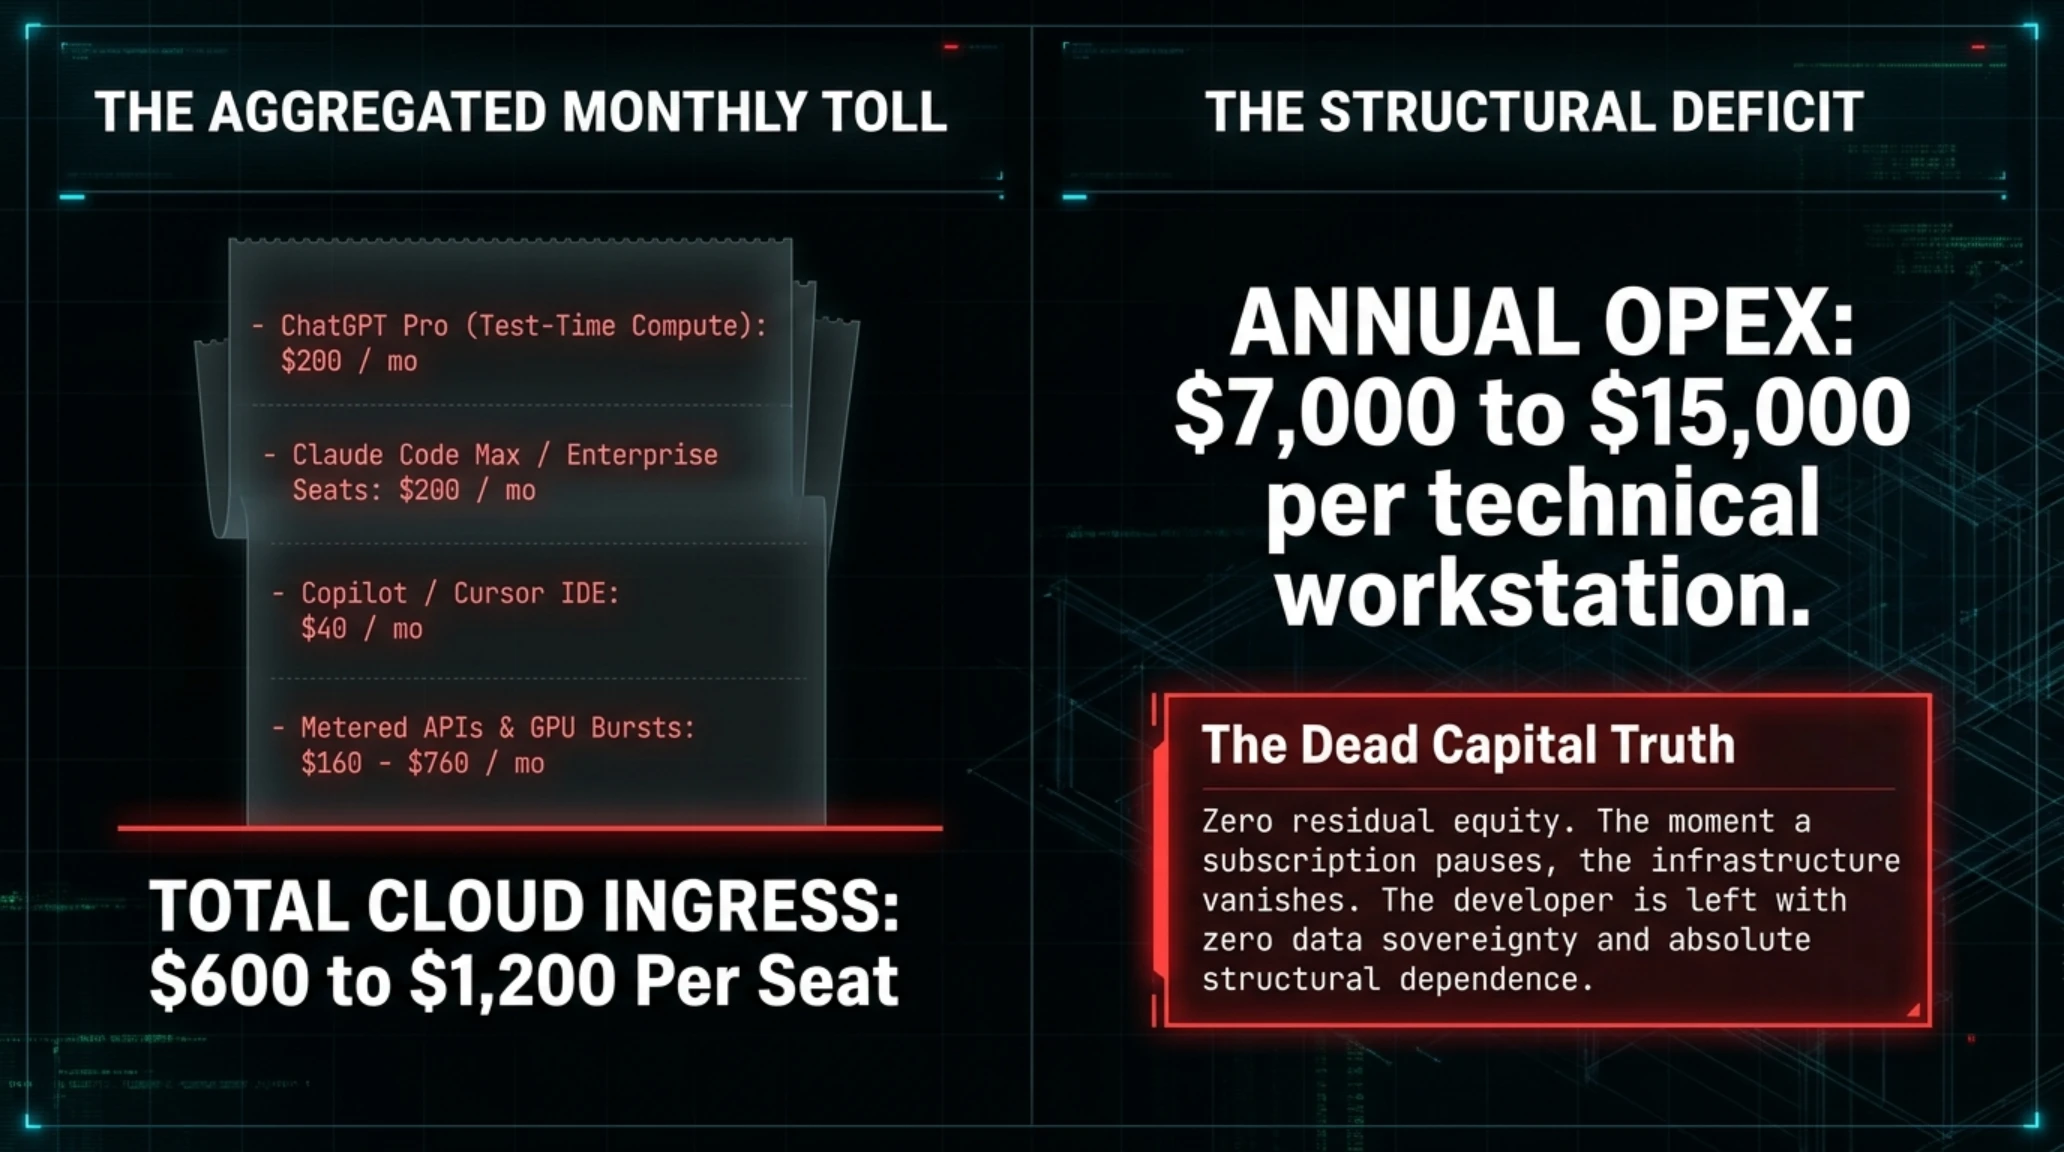
عدد ۲۰۰ دلار در ماه یک انتخاب تصادفی نیست. این رقم دقیقا معادل اشتراک ماهانه پلن چتجیپیتی پرو است که توسط شرکت اوپنایآی برای نخبگان و کاربران حرفهای معرفی شد؛ پلنی که امکان استفاده نامحدود از پیشرفتهترین مدلهای تفکر عمیق و استدلال زنجیرهای مانند او-وان پرو مود را فراهم میکند. اما ماجرا به همینجا ختم نمیشود. یک مهندس نرمافزار، دانشمند داده یا پژوهشگر حوزه هوش مصنوعی برای انجام امور روزمره و تحلیل پروژههای خود، معمولا به صورت همزمان مبالغی بین ۲۰ تا ۲۰۰ دلار را به سرویسهای متعددی چون کلود مکس، ابزارهای کدنویسی هوشمند نظیر کرسر پرو، پلتفرمهای تست پرامپت و از همه مهمتر اجاره ساعتی پردازندههای گرافیکی در پلتفرمهای ابری مانند رانپاد، لمبدا لبز یا وبسرویسهای آمازون پرداخت میکند. این هزینههای پراکنده در پایان ماه به راحتی از مرز صدها دلار عبور کرده و به یک بار مالی مستمر و فرساینده تبدیل میشوند.
برای کاربران در سراسر دنیا، پرداخت مداوم چنین ارقامی یک هزینه جانبی قابل تامل است؛ اما برای توسعهدهندگان، استارتاپها، فریلنسرها و پژوهشگران در ایران، این معادله به یک فاجعه اقتصادی و گلوگاه حیاتی تبدیل شده است. پرداخت ماهانه ۲۰۰ دلار با در نظر گرفتن نرخ برابری ارز و جهشهای مداوم قیمت دلار در بازار آزاد، ماهانه هزینهای معادل بیش از ۱۸ تا ۲۲ میلیون تومان را به یک فرد یا تیم کوچک تحمیل میکند. اگر این رقم را در یک سال کاری ضرب کنیم، با مبلغی سرسامآور بین ۲۲۰ تا ۲۶۰ میلیون تومان فقط برای تمدید دسترسی به هوش مصنوعی ابری مواجه میشویم؛ مبلغی که در پایان سال هیچ دارایی فیزیکی یا سرمایه ماندگاری برای فرد یا شرکت بر جای نمیگذارد و با قطع اشتراک، تمام دسترسیها در کسری از ثانیه دود میشود و به هوا میرود.
موانع دسترسی و تحریمهای چندلایه؛ رنج مضاعف جامعه مهندسی ایران
معضل کاربران ایرانی تنها به پرداخت ارقام نجومی ریالی خلاصه نمیشود. فرآیند تهیه و تمدید این اشتراکها خود داستانی پر از اضطراب و ریسک است. شرکتهای بزرگ حوزه هوش مصنوعی از اوپنایآی و آنتروپیک گرفته تا گوگل و مایکروسافت، دسترسی کاربران با مبدأ ایران را به شدیدترین شکل ممکن مسدود کردهاند. در نتیجه، یک پژوهشگر یا برنامهنویس ایرانی برای فعالسازی یک اشتراک ناچار است از هفتخوان رستم عبور کند:
- کارمزدهای کلان صرافیها و واسطهها: برای شارژ حسابهای بینالمللی یا تهیه مسترکارتها و ویزاکارتهای مجازی، صرافیهای واسطه بین ۱۵ تا ۳۰ درصد کارمزد اضافه دریافت میکنند که هزینه نهایی را به مراتب بالاتر میبرد.
- ریسک تعلیق و مسدودسازی آنی حسابها: سامانههای ضدتقلب و امنیتی این پلتفرمها به طور مداوم آیپیهای ورودی، اثرانگشت مرورگر و مشخصات پرداخت را بررسی میکنند. کوچکترین نشت آیپی یا تغییر ناگهانی موقعیت مکانی منجر به مسدود شدن قطعی اکانت میشود؛ بدون اینکه هیچ امکانی برای اعتراض یا بازگشت وجه پرداختی وجود داشته باشد.
- تاخیرهای ویرانکننده شبکه و افت مداوم پینگ: ارتباط با سرورهای خارجی از طریق ابزارهای دور زدن فیلترینگ، تاخیر رفت و برگشت بستههای داده را بین ۲۰۰ تا ۶۰۰ میلیثانیه افزایش میدهد. این تاخیر شدید در ابزارهای تولید بلادرنگ کد، جریان کاری برنامهنویس را دچار لکنت و وقفههای مداوم میکند.
- نوسانات شبکه اینترنت و قطعیهای غیرقابل پیشبینی: قطع ناگهانی اینترنت بینالملل یا اختلال در پروتکلهای امنیتی، ارتباط کاربر با زیرساخت ابری را قطع کرده و پروژههای حساس کاری را ساعتها یا روزها به تعطلی میکشاند.
امنیت داده، حریم خصوصی و توهم محرمانگی در ابرهای عمومی
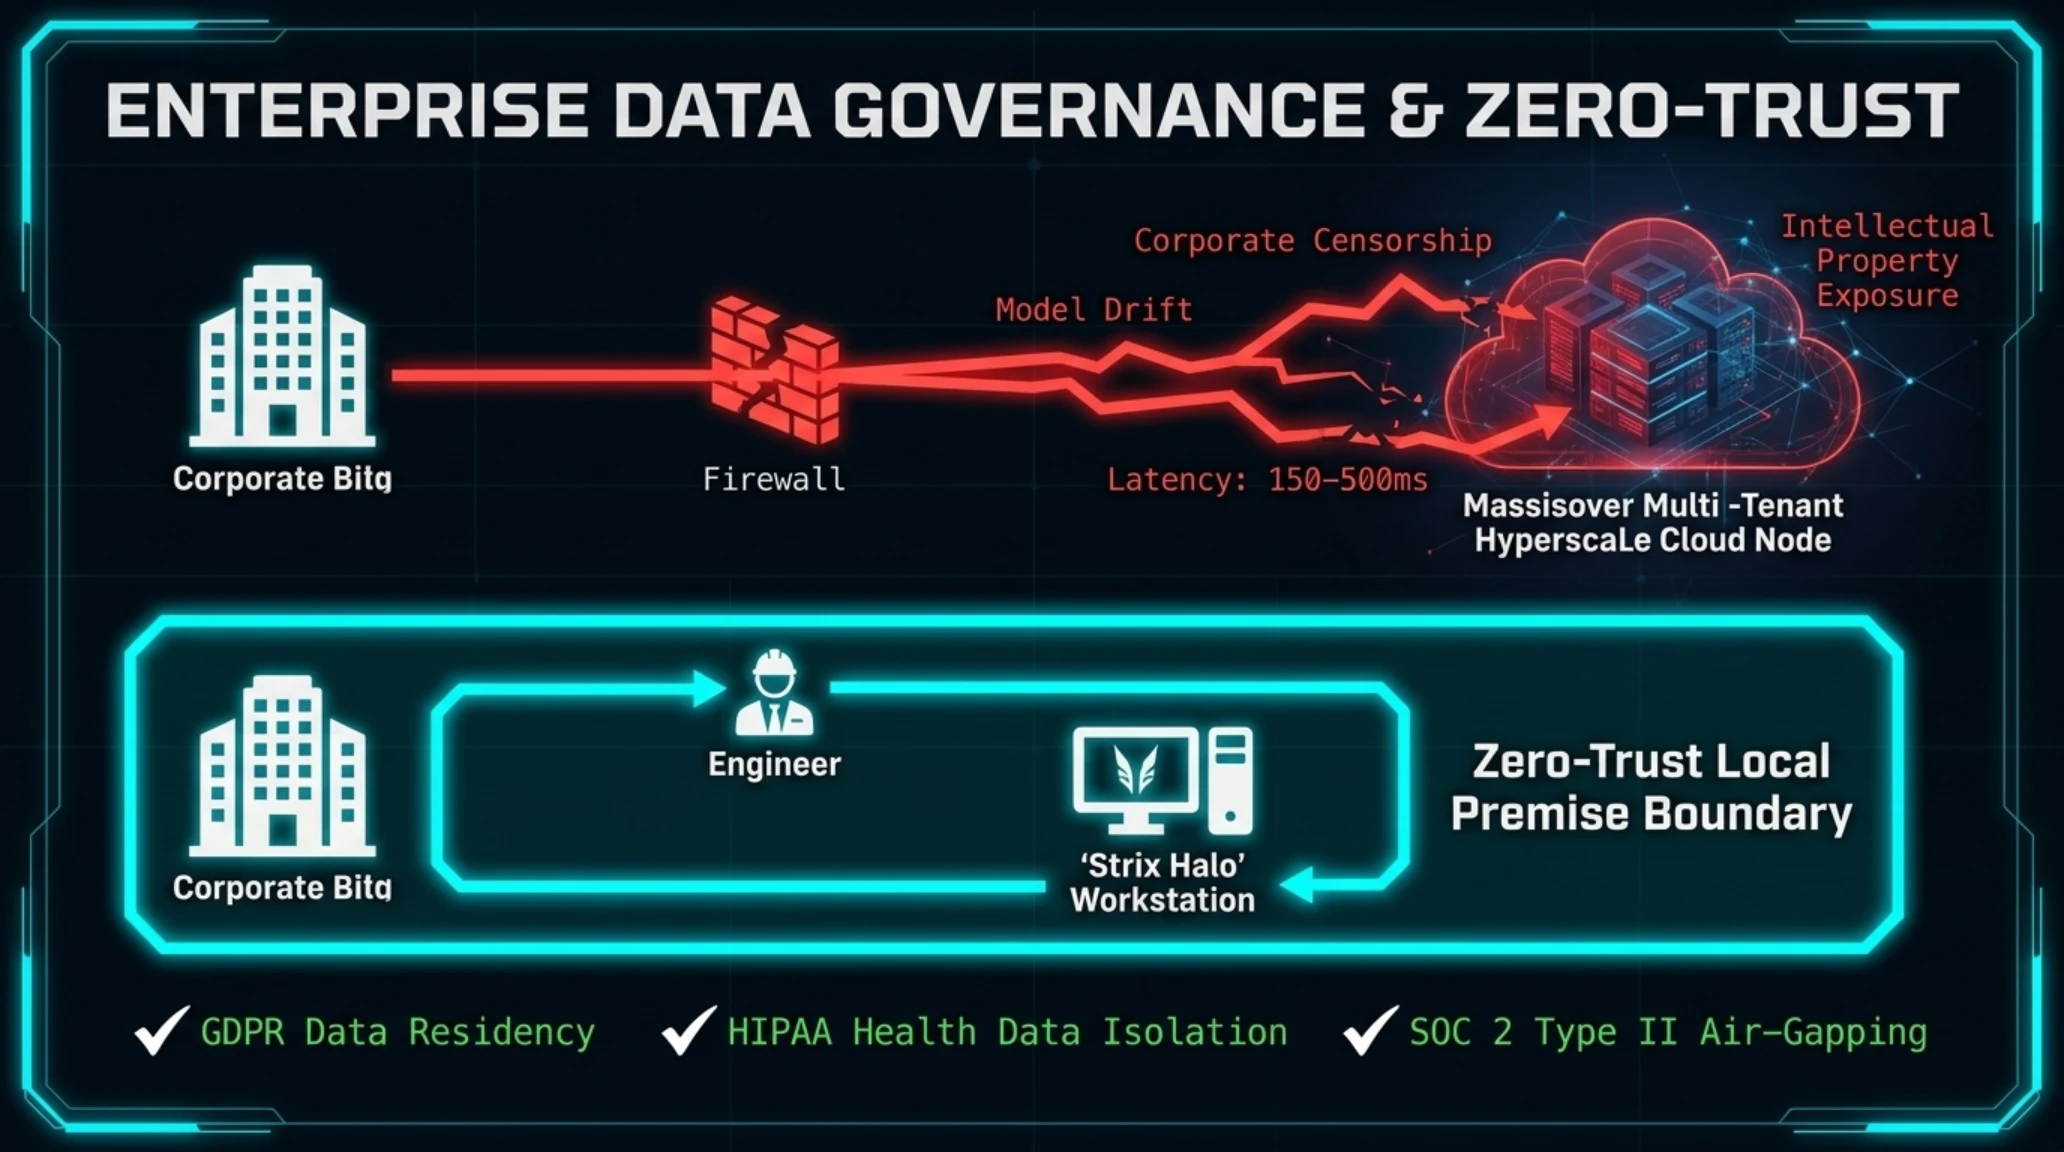
فراتر از مباحث مالی و ارزی، چالش حریم خصوصی و امنیت اسرار تجاری مهمترین دلیلی است که حتی شرکتهای بزرگ بینالمللی در ایالات متحده و اروپا را به سمت پردازش محلی سوق داده است. وقتی شما یک قطعه کد حیاتی، یک دیتابیس مالی، قراردادهای حقوقی یا فرمولاسیون دارویی را به پنجره گفتگوی ابری ارسال میکنید، کنترل فیزیکی آن دادهها را واگذار کردهاید. شرکتهای ارائهدهنده با وجود ادعاهای متعدد درباره حفظ حریم خصوصی سازمانی، دادهها را روی سرورهای خود لاگ میکنند و بارها شاهد افشای ناخواسته تاریخچهها یا دسترسی کارمندان به گفتگوهای کاربران بودهایم.
علاوه بر این، فیلترهای اخلاقی و سانسورهای شرکتی به شکلی روزافزون در مدلهای ابری اعمال میشوند. در بسیاری از سناریوهای تحلیل حملات سایبری، ارزیابی آسیبپذیریهای امنیتی، شبیهسازی رفتارهای انسانی یا بررسی ادبیات تاریخی، مدلهای شرکتی از ارائه پاسخ امتناع میورزند و پیامهای خطای کلافهکننده به کاربر تحویل میدهند. در نقطه مقابل، اجرای یک مدل متنباز تراز اول روی سختافزار اختصاصی، دسترسی بدون سانسور، نامحدود، کاملا محرمانه و با امنیت مطلق صفر-تراست را تضمین مینماید.
به این پارامترها باید مسئله پایداری سرویس را نیز اضافه کرد. مدلهای ابری هر از گاهی بدون اطلاع قبلی بهروزرسانی میشوند که در اصطلاح فنی به آن زوال هوش یا تغییر رفتار مدل گفته میشود. یک کدنویس ممکن است سیستمی را بر پایه یک رفتار معین از مدل ابری طراحی کند و یک ماه بعد ببیند مدل با تغییر تنظیمات داخلی، دیگر قادر به تولید همان کیفیت خروجی نیست. با اجرای مدلهای متنباز محلی، نگارش دقیق مدل برای همیشه در اختیار شماست و هیچ عاملی کیفیت یا رفتار آن را تغییر نخواهد داد.
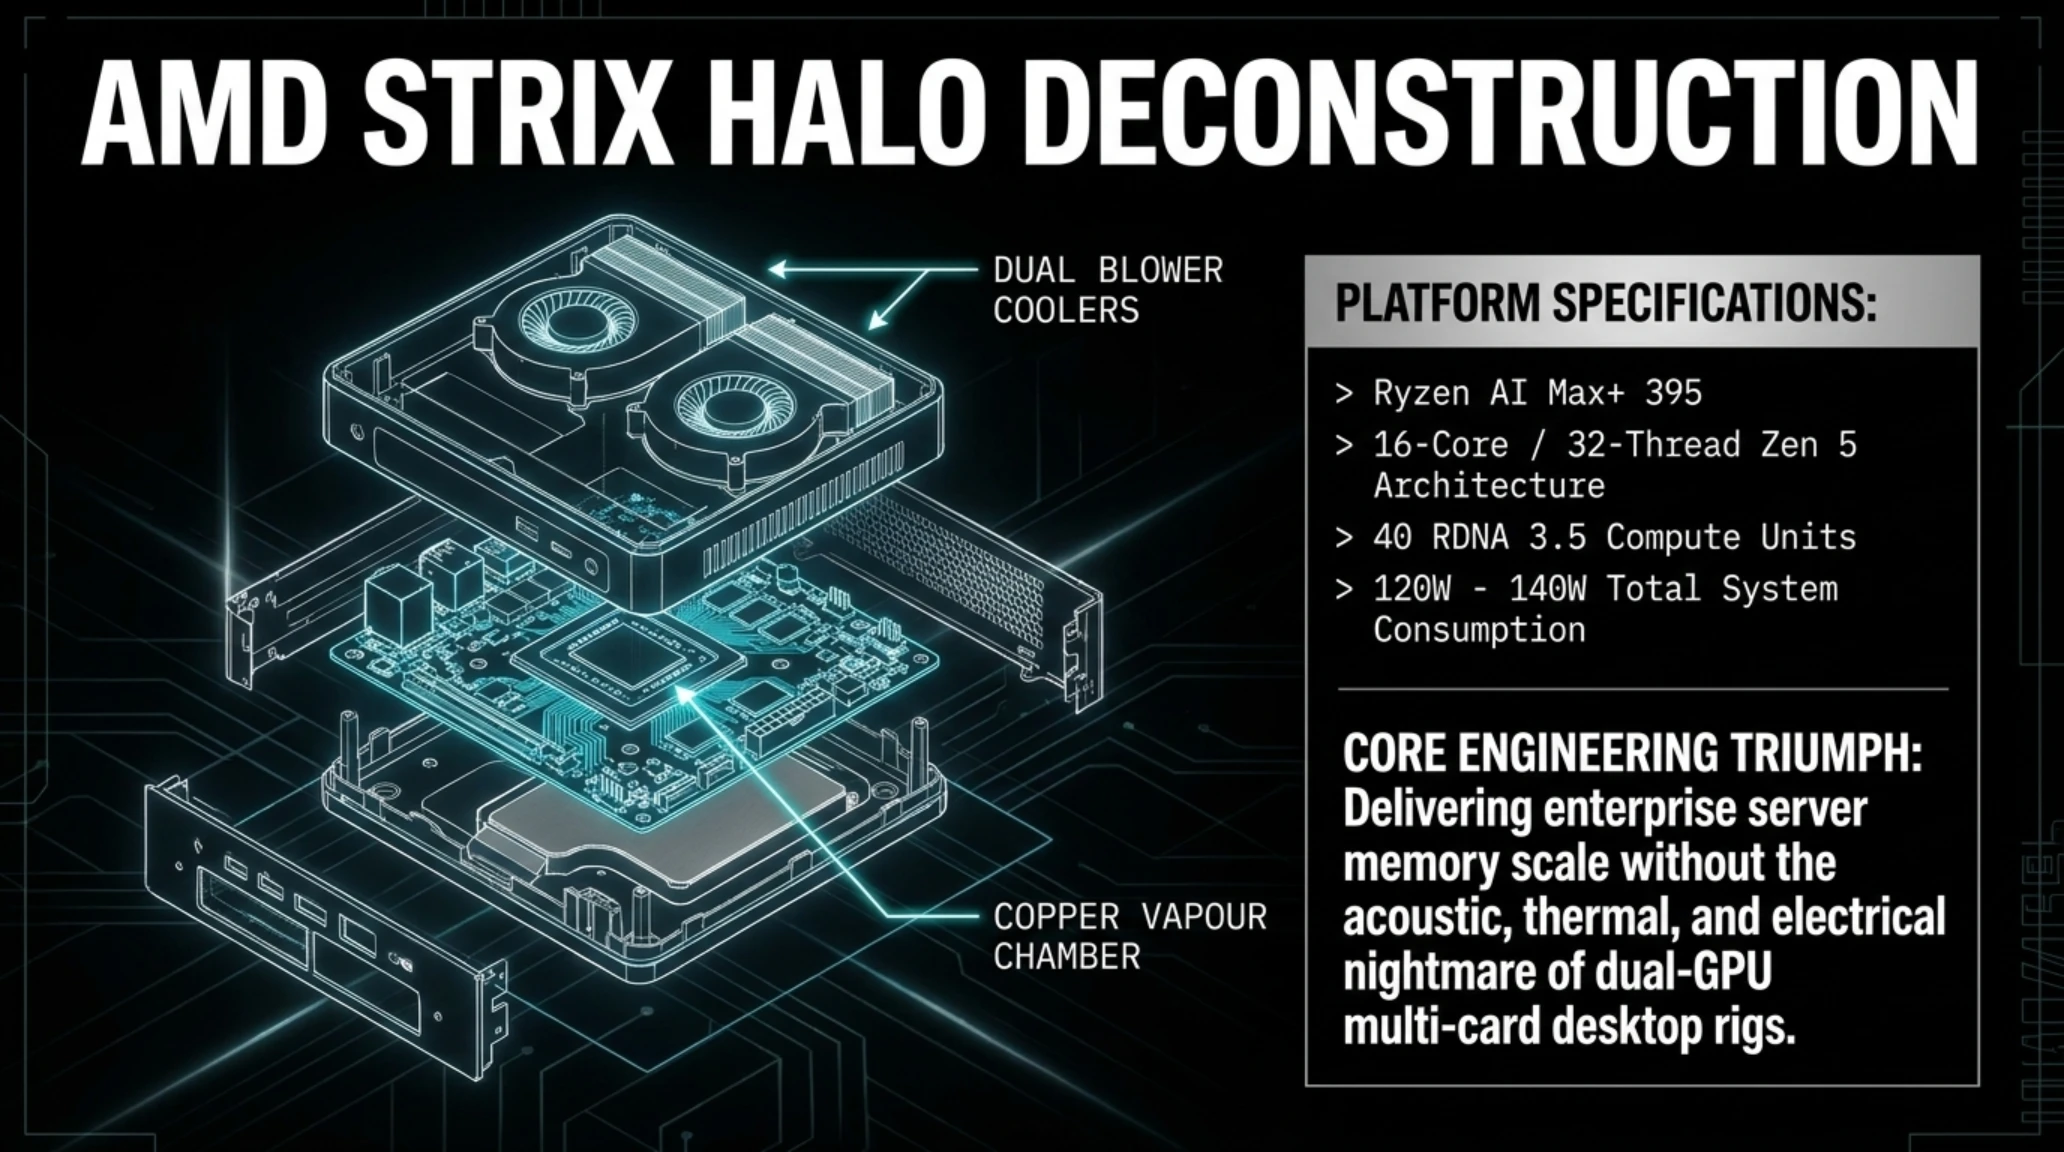
برای درک بهتر سازوکار فیزیکی و استقرار خنککنندههای این سامانه، نمای انفجاری زیر معماری فشرده و مهندسی دقیق مادربورد مینی پیسی ایامدی را نشان میدهد.

تصویر اینفوگرافیک بالا نمای انفجاری قطعات شاسی مینی پیسی ایامدی را به نمایش میگذارد که چگونه خنککنندههای دوگانه و محفظه بخار مسی روی بستر فشرده مادربورد مستقر شدهاند.
چرا این موضوع مهم است: دسترسی پایدار به هوش مصنوعی دیگر نباید وابسته به پرداخت مداوم دلاری، کارتهای اعتباری واسطه و خطوط پرنوسان اینترنت باشد. با دستیابی به توان اجرای بومی مدلهای ۷۰ میلیارد پارامتری روی میز کار، توسعهدهنده به حاکمیت کامل دادهها، سرعت نامحدود و استقلال بیقید و شرط دست مییابد.
تسلط بر جزئیات فنی و واژگان تخصصی به کار رفته در پردازش محلی هوش مصنوعی، گامی ضروری برای درک عمق نوآوری ایامدی است که در جدول واژهنامه زیر تشریح شده است.
اصطلاحات فنی و واژهنامه تخصصی سیلیکون
- حافظه یکپارچه (Unified Memory): معماری نوآورانهای که استخر حافظه رم را به صورت مشترک با پهنای باند یکسان در اختیار سیپییو و جیپییو قرار میدهد.
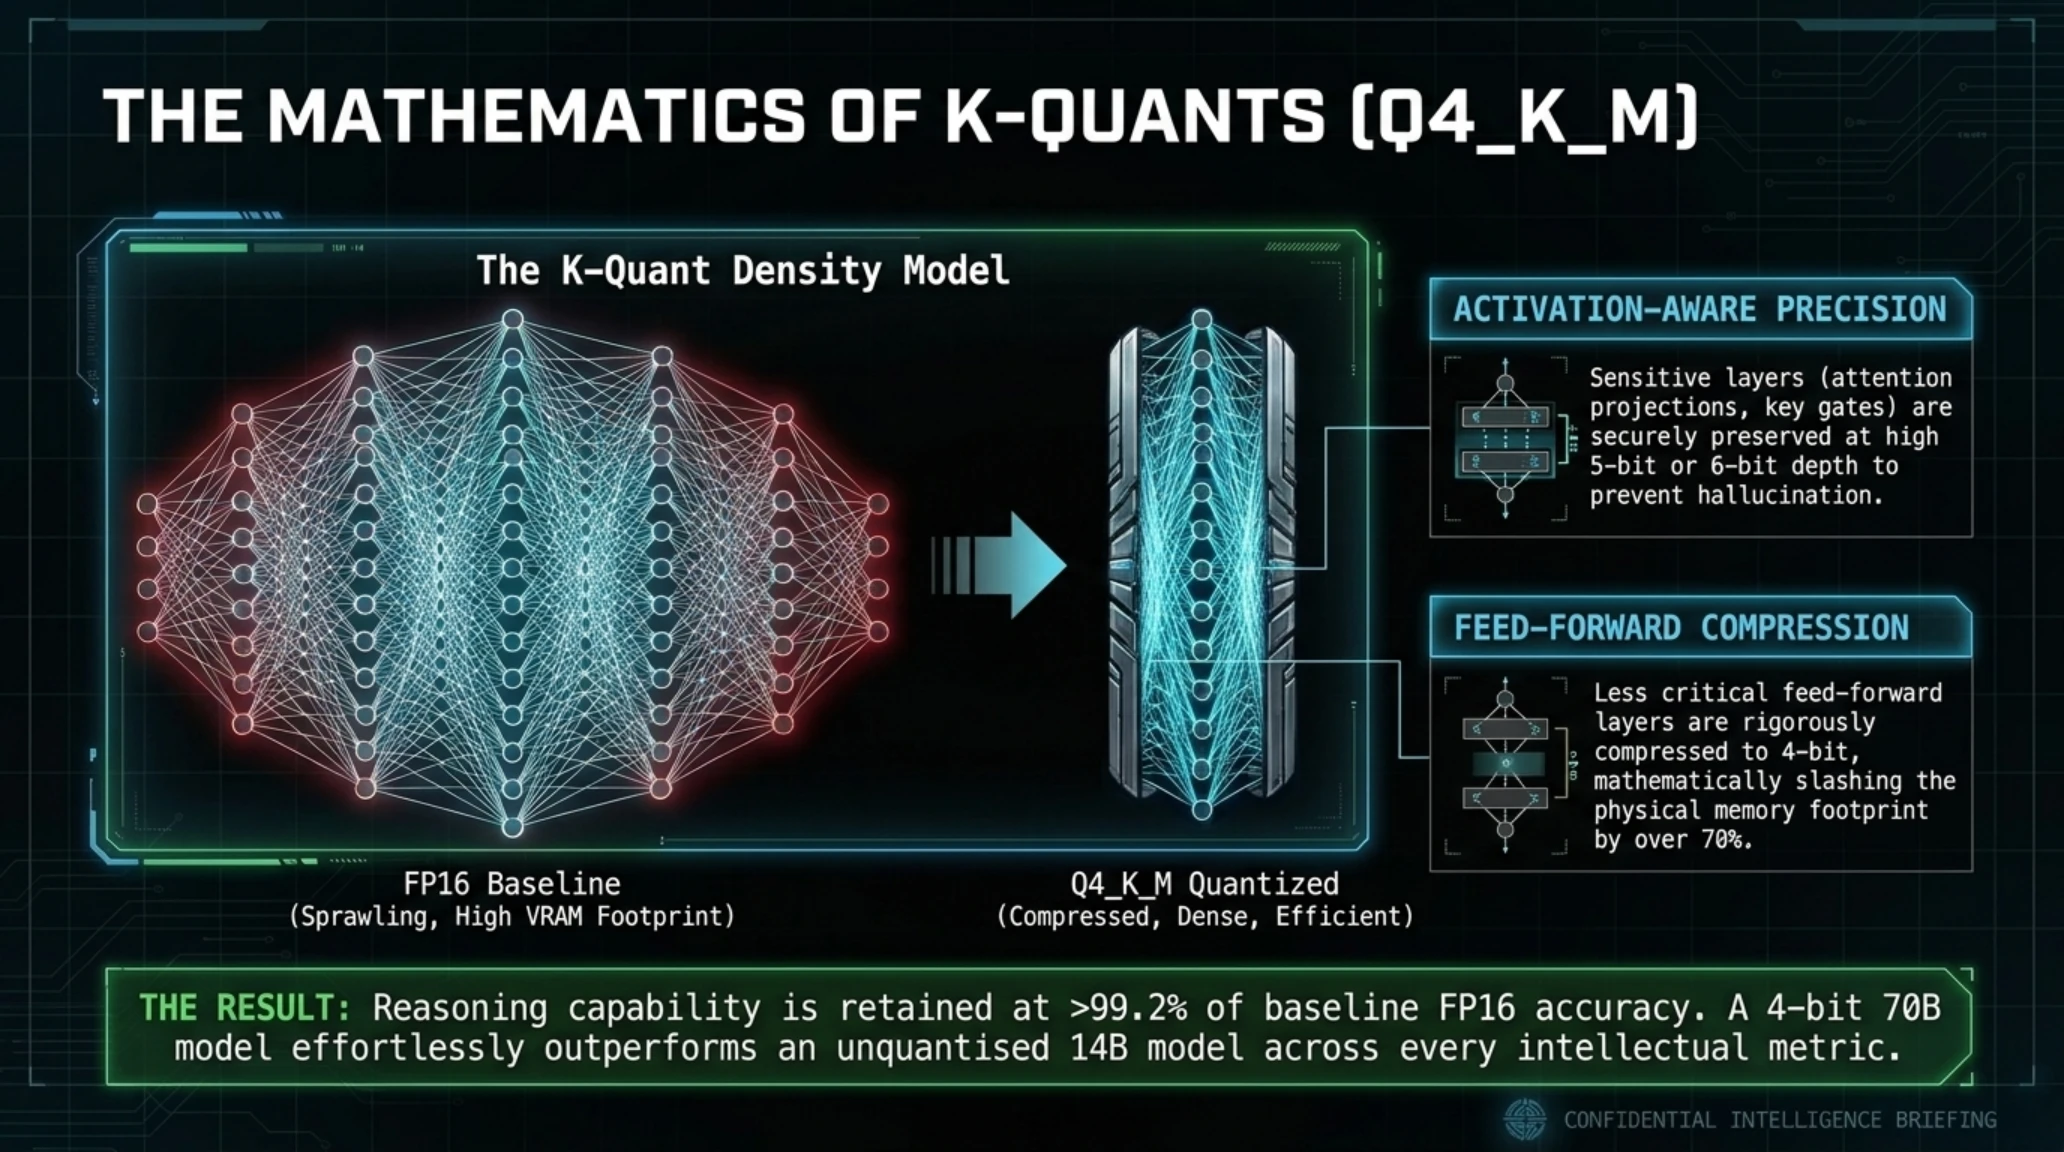
- کوانتیزاسیون (Quantization): فشردهسازی محاسباتی اوزان مدل از دقت ۱۶ بیتی به ۴ بیتی جهت کاهش حجم حافظه با حفظ بیش از ۹۹ درصد دقت استدلال.
- کش کلید-مقدار (KV Cache): حافظه پویا برای نگهداری سابقه توکنها در پنجره متنی که با طولانیتر شدن گفتگو حجم آن رشد میکند.
- پشته نرمافزاری راکام (ROCm): اکوسیستم متنباز ایامدی برای محاسبات موازی شتابیافته که جایگزین استاندارد کودای انویدیا است.
معماری استریکس هیلو و چیپ رایزن ایآی مکس پلاس ۳۹۵؛ سدشکنی در برابر انحصار ویرم انویدیا
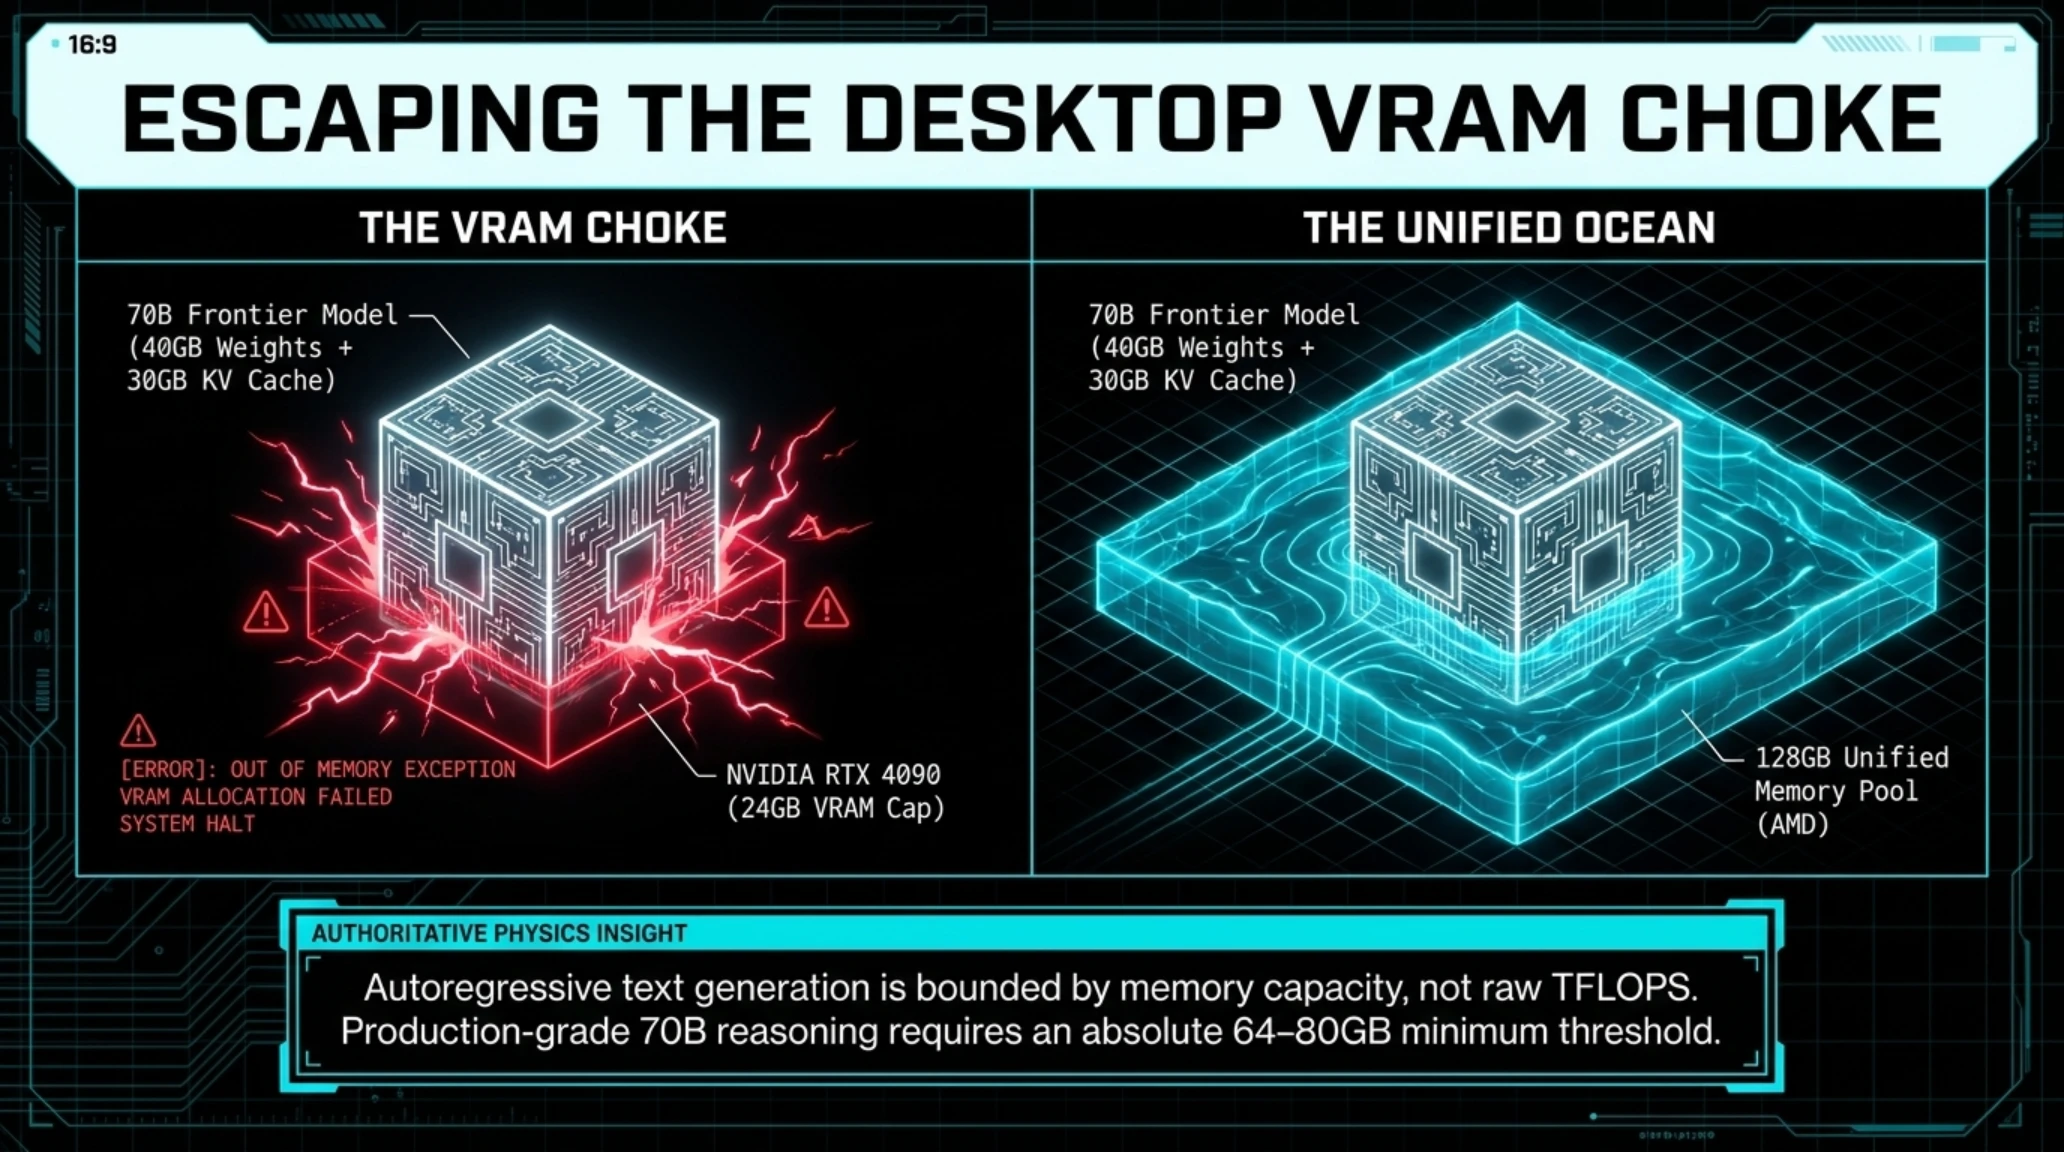
برای آنکه دریابیم شرکت ایامدی چگونه توانسته معادله پردازش محلی را دگرگون سازد، باید ابتدا گلوگاه فنی اصلی اجرای مدلهای هوش مصنوعی را در سطح مهندسی سختافزار موشکافی کنیم. در محافل عمومی این تصور غلط وجود دارد که اجرای یک مدل زبانی نیازمند توان پردازش گرافیکی بیپایان است؛ اما حقیقت علمی چیز دیگری است. گلوگاه شماره یک در مرحله استنتاج مدلهای زبانی بزرگ، حجم حافظه ویدئویی و پهنای باند انتقال دادههای حافظه است، نه صرفا تعداد ترافلاپس پردازنده.
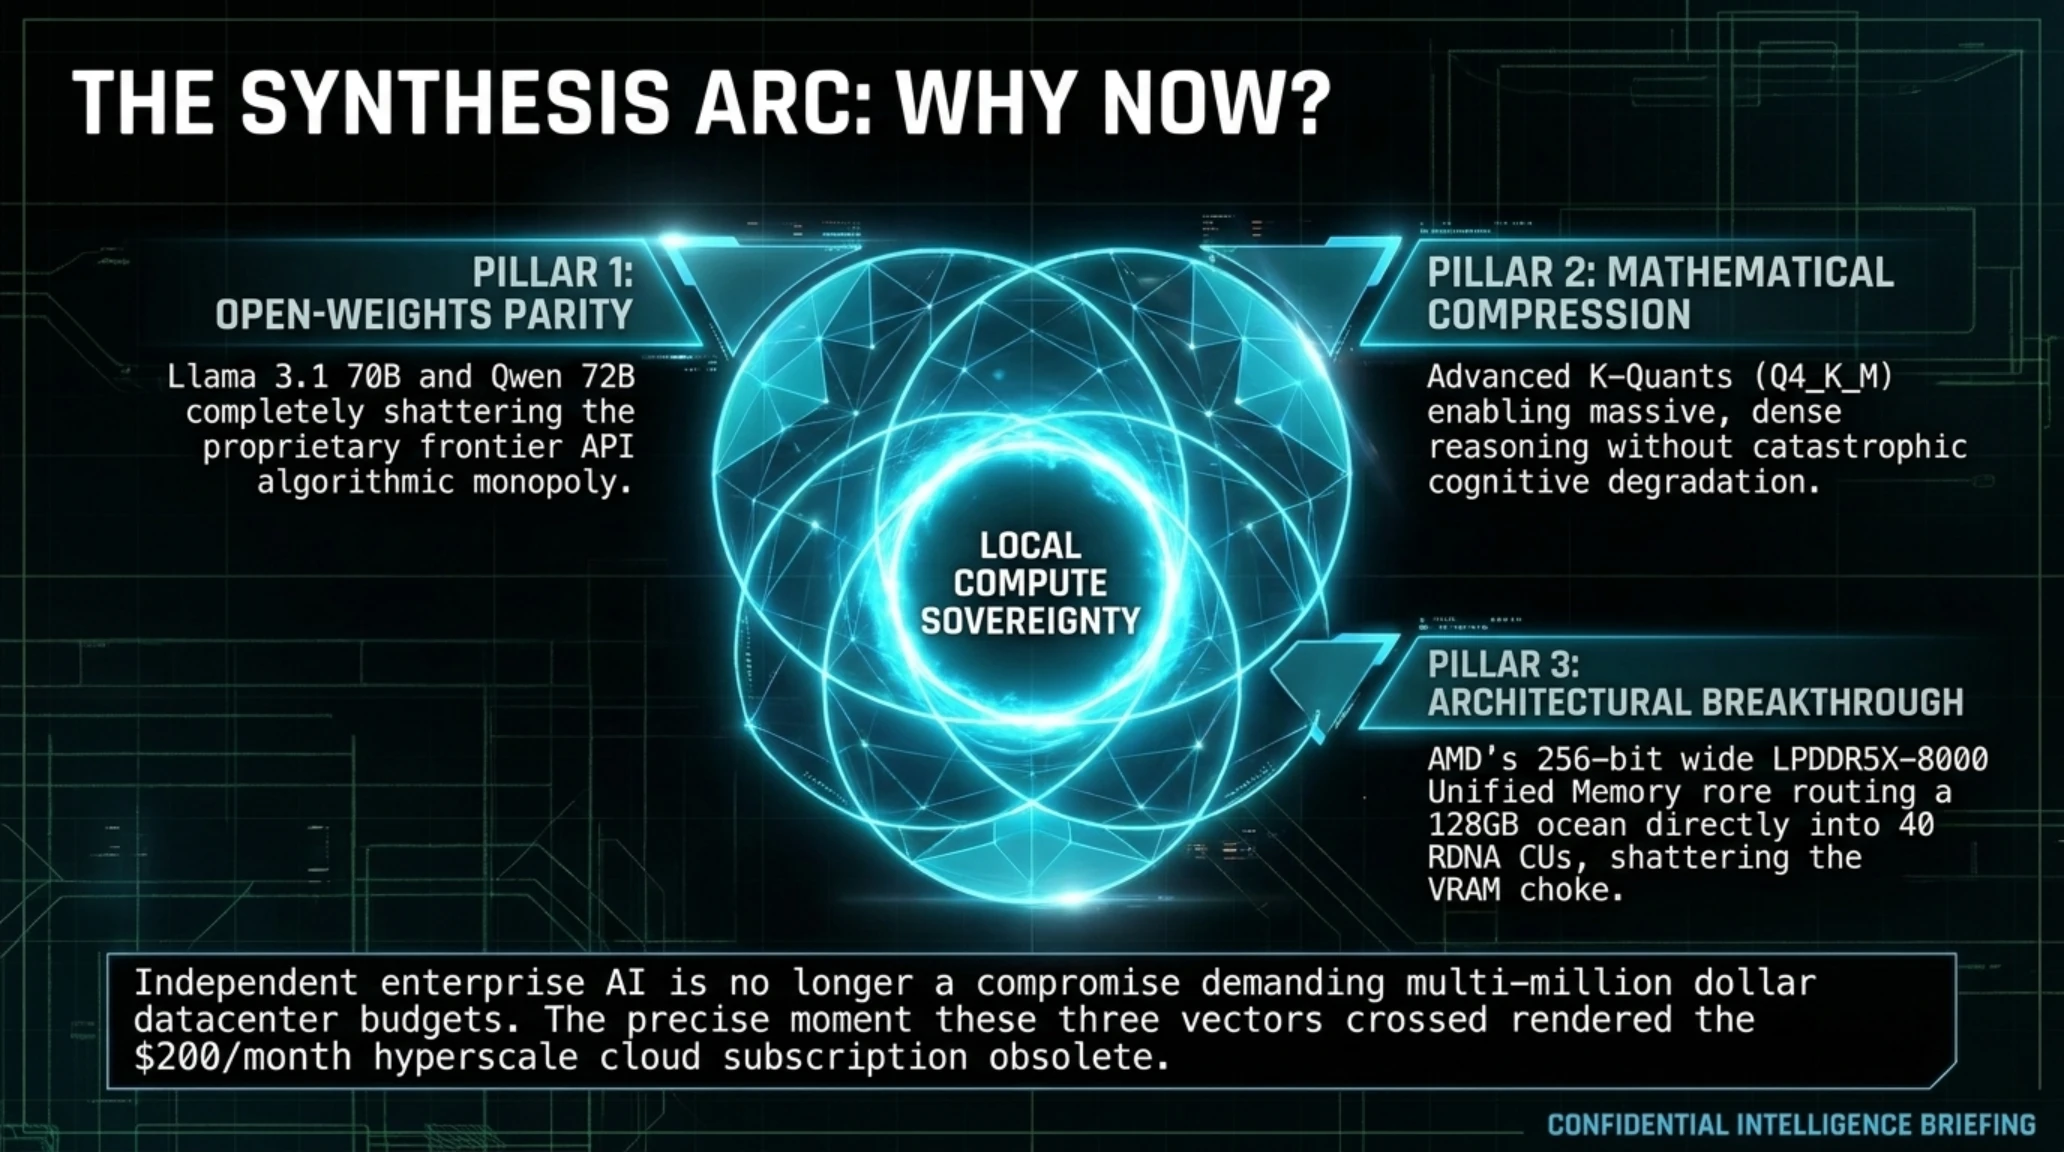
بیایید این مسئله را با اعداد و ارقام واقعی تحلیل کنیم. یک مدل هوش مصنوعی مدرن در رده ۷۰ میلیارد پارامتر مانند لاما ۳.۱ یا مدل پرقدرت کیو-ون ۲.۵ را در نظر بگیرید. هر پارامتر در حالت استاندارد دقت نیمهدقیق به دو بایت حافظه نیاز دارد؛ یعنی برای بارگذاری خام وزنهای مدل به ۱۴۰ گیگابایت حافظه احتیاج خواهید داشت. حتی اگر از تکنیکهای پیشرفته فشردهسازی و کوانتیزاسیون ۴ بیتی استفاده کنیم، تنها برای جایدادن وزنهای خالص مدل در حافظه دستکم به ۳۸ تا ۴۲ گیگابایت فضای خالی نیاز است. اگر بخواهیم یک زمینه گفتگوی طولانی یا کانتکست ۶۴ هزار توکنی را برای مدل تعریف کنیم، حافظه میانی کلید-مقدار به سرعت به ۱۵ تا ۲۵ گیگابایت فضای اضافی نیاز پیدا میکند. مجموع این ارقام به این معناست که اجرای روان و بدون دردسر یک مدل ۷۰ میلیاردی به حداقل ۶۰ تا ۸۰ گیگابایت حافظه ویدئویی اختصاصی محتاج است.
اینجا دقیقا همان دیواری است که معماری کامپیوترهای شخصی سنتی سالها پشت آن متوقف شده بود. شرکت انویدیا به عنوان پادشاه بلامنازع بازار گرافیک، با اتخاذ یک استراتژی انحصارگرایانه و قطرهچکانی، میزان حافظه کارتهای مصرفکننده را به شدت محدود نگه داشته است. گرانترین کارت گرافیک گیمینگ جهان، جیفورس آرتیایکس ۴۰۹۰، با قیمت سرسامآور ۲ هزار دلاری تنها ۲۴ گیگابایت حافظه ارائه میدهد. پرچمدار نسل جدید این شرکت، آرتیایکس ۵۰۹۰، نیز نهایتا به ۳۲ گیگابایت حافظه مجهز است. این یعنی شما حتی با خرید گرانترین کارت گرافیک جهان هم نمیتوانید یک مدل ۷۰ میلیاردی را به شکل کامل و سالم در حافظه گرافیکی لود کنید.
چرا سرهم کردن چند کارت گرافیک در دسکتاپ راهحلی منطقی نیست؟
تا پیش از ورود معماریهای نوین، مهندسانی که اصرار داشتند مدلهای بزرگ را روی سیستم محلی اجرا کنند، چارهای جز راهاندازی سامانههای چندکارته نداشتند؛ مثلا ترکیب دو عدد کارت آرتیایکس ۳۰۹۰ یا دو کارت ۴۰۹۰. اما هر کس که تجربه اسمبل چنین سیستمهایی را داشته باشد، به خوبی میداند که این مسیر به چه کابوس بیپایانی منتهی میشود:
- نیاز به مادربوردهای خاص و خطوط پیسیآی اکسپرس: تقسیم خطوط ارتباطی و افت سرعت جابجایی دادهها بین اسلاتها، کارایی مدلها را کاهش میدهد. در مادربردهای معمولی خطوط اسلات دوم به هشت خط کاهش مییابد که این گلوگاه ارتباطی تاخیر جدی در همگامسازی لایههای مدل ایجاد میکند.
- مصرف برق وحشتناک و هزینه نجومی قبوض: یک سیستم مجهز به دو کارت گرافیک ردهبالا زیر بار پردازش ماتریکسها بیش از ۸۵۰ تا ۱۰۰۰ وات برق از پریز دیوار مصرف میکند که گرمای تولیدی آن اتاق کار را به سونای خشک تبدیل میکند. این اتلاف انرژی به خنککنندههای کولر گازی پرمصرف در محیط کار نیاز دارد.
- هزینه سرسامآور اولیه: خرید دو کارت پرچمدار به همراه پاور ۱۶۰۰ واتی پلاتینیوم، شاسی غولپیکر و خنککننده مایع اختصاصی، هزینهای فراتر از ۴۵۰۰ دلار ایجاد میکند.
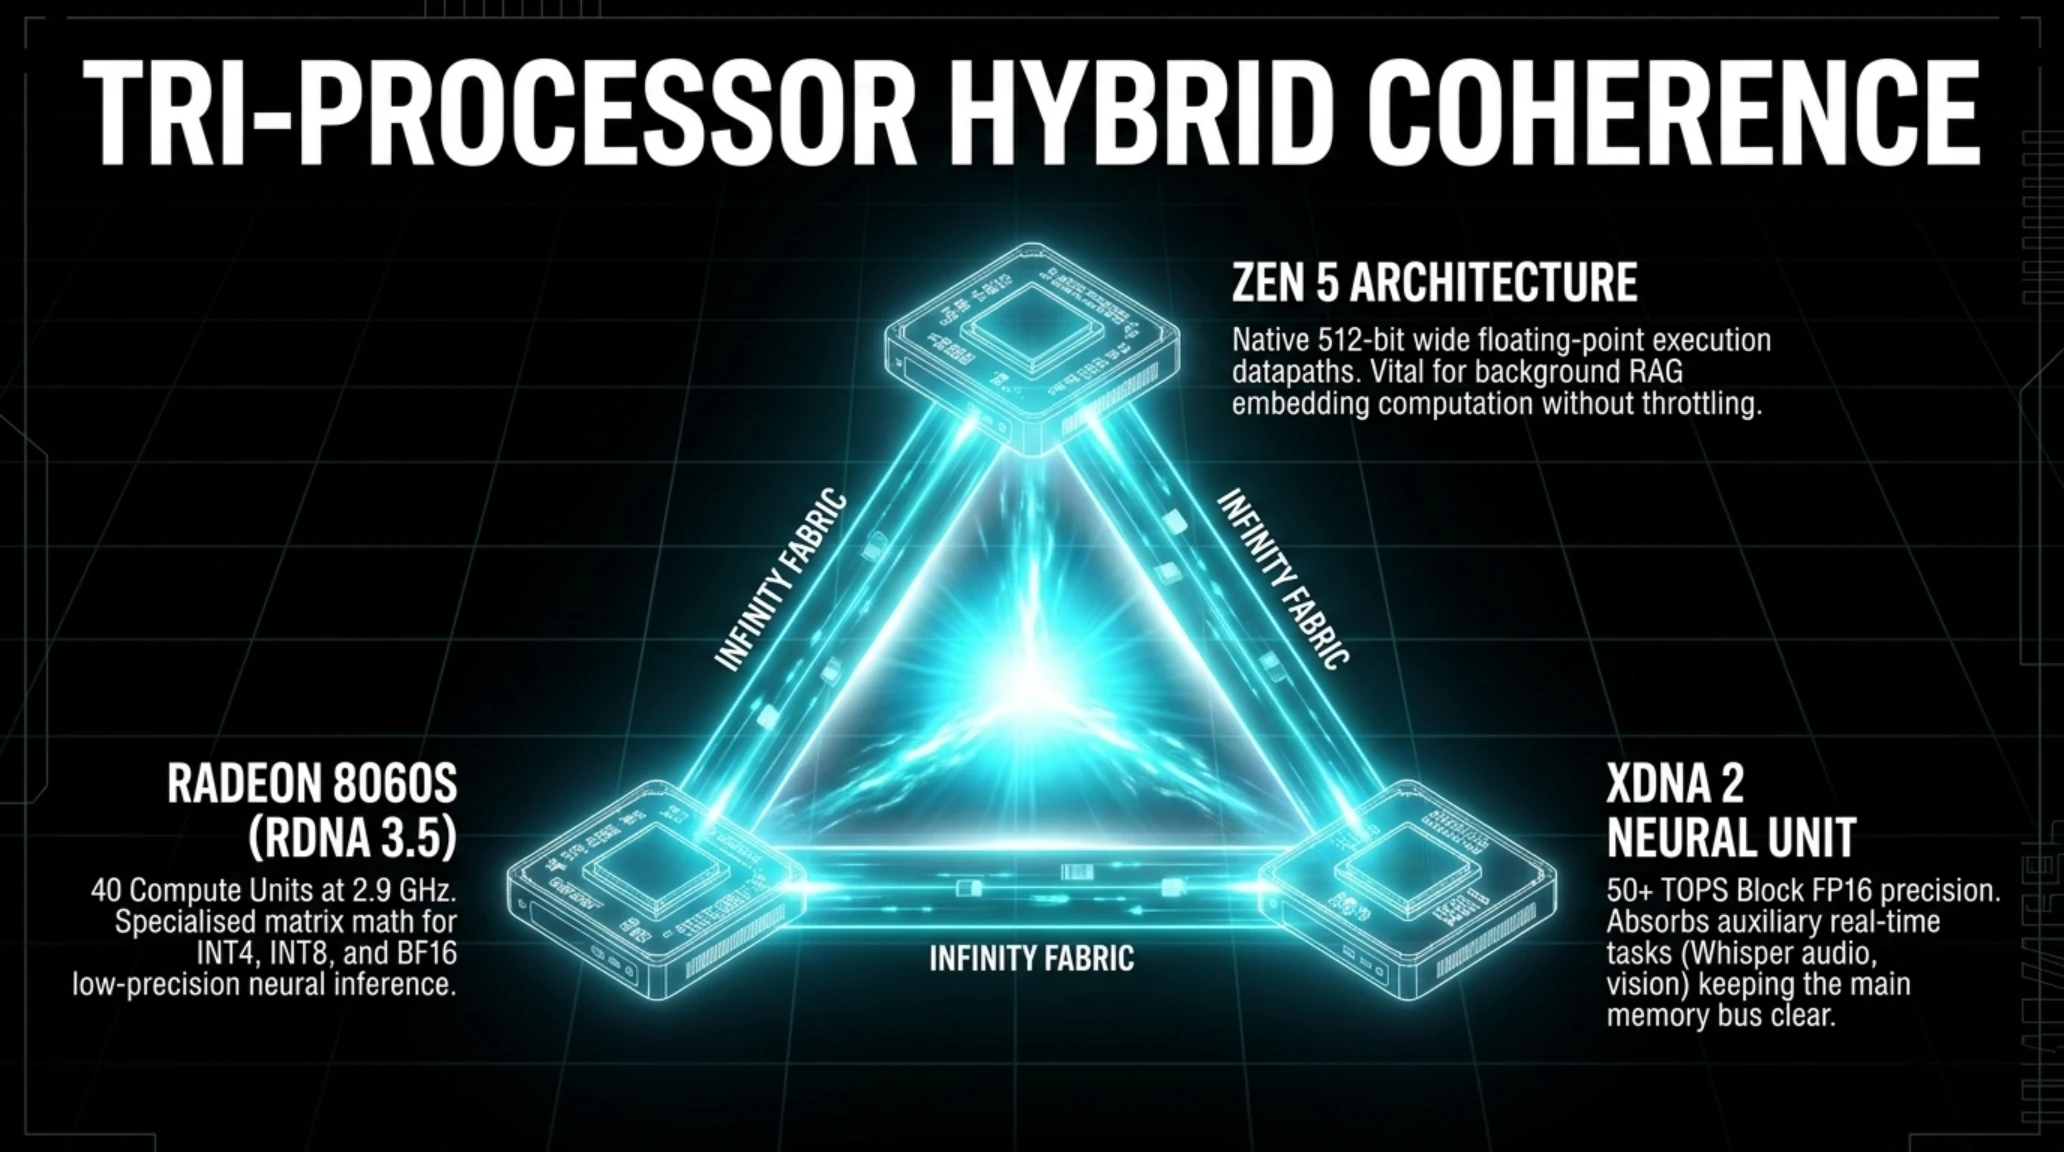
در استریکس هیلو، پردازنده گرافیکی مجتمع رادیون ۸۰۶۰ اس با ۴۰ واحد پردازشی پیشرفته، دسترسی مستقیمی به کل استخر حافظه سیستم دارد. سیستمعامل میتواند تا ۹۶ گیگابایت یا بیشتر از حافظه الپیدیدیآر ۵ ایکس را مستقیما به عنوان ویرم در اختیار هستههای پردازشی گرافیک قرار دهد. این یعنی شما بدون پرداخت یک ریال اضافه برای بردهای سرور، مدلهای سنگین هوش مصنوعی را با یک کابل شارژ کوچک و مصرف برقی در حد یک لامپ روشنایی روی میز خود اجرا میکنید.
علاوه بر این، در بخش پردازنده مرکزی، وجود ۱۶ هسته کامل ذن ۵ با خط لوله دوگانه ۵۱۲ بیتی امکان پردازش بینقص دستورالعملهای برداری ایویایکس-۵۱۲ را بدون افت فرکانس فراهم میآورد. این قابلیت به ویژه در مرحله پیشپردازش پرامپتها و ساخت توابع برداری در پایگاههای داده وکتوری نقشی حیاتی ایفا میکند؛ جایی که پردازنده مرکزی بار محاسباتی مربوط به مدلهای تعبیهساز نظیر بیوتی یا نومیک را بدون کوچکترین تاخیر به دوش میکشد.
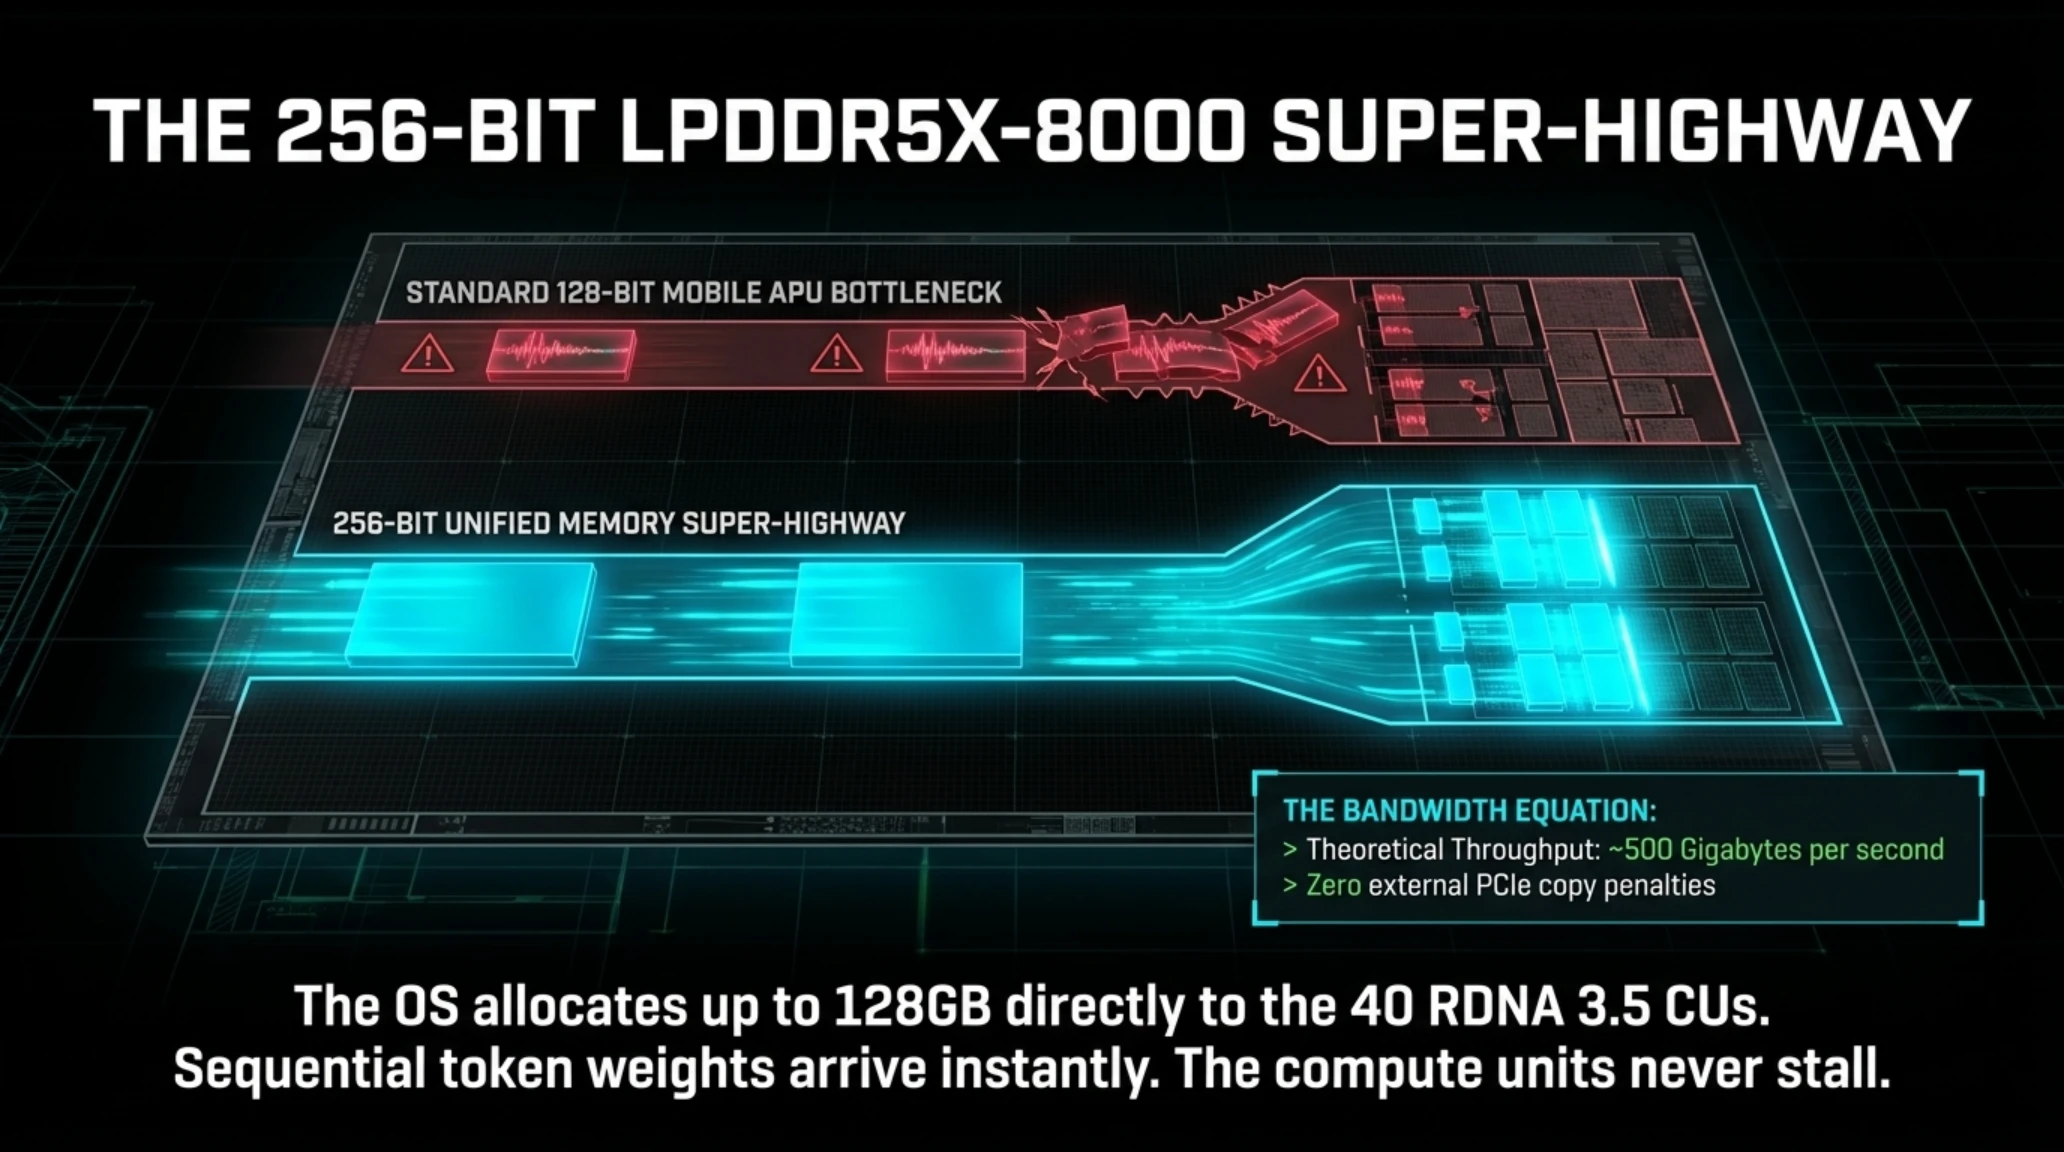
بررسی میکروسکوپی لایههای سیلیکون و نحوه اتصال باس حافظه ۲۵۶ بیتی به هستههای محاسباتی در تصویر زیر به وضوح قابل مشاهده است.

نمای ماکروسکوپی فوق جزئیات تراشه سیلیکونی یکپارچه استریکس هیلو را با پیوند میان هستههای پردازشی و کنترلر حافظه ۲۵۶ بیتی به تصویر میکشد.
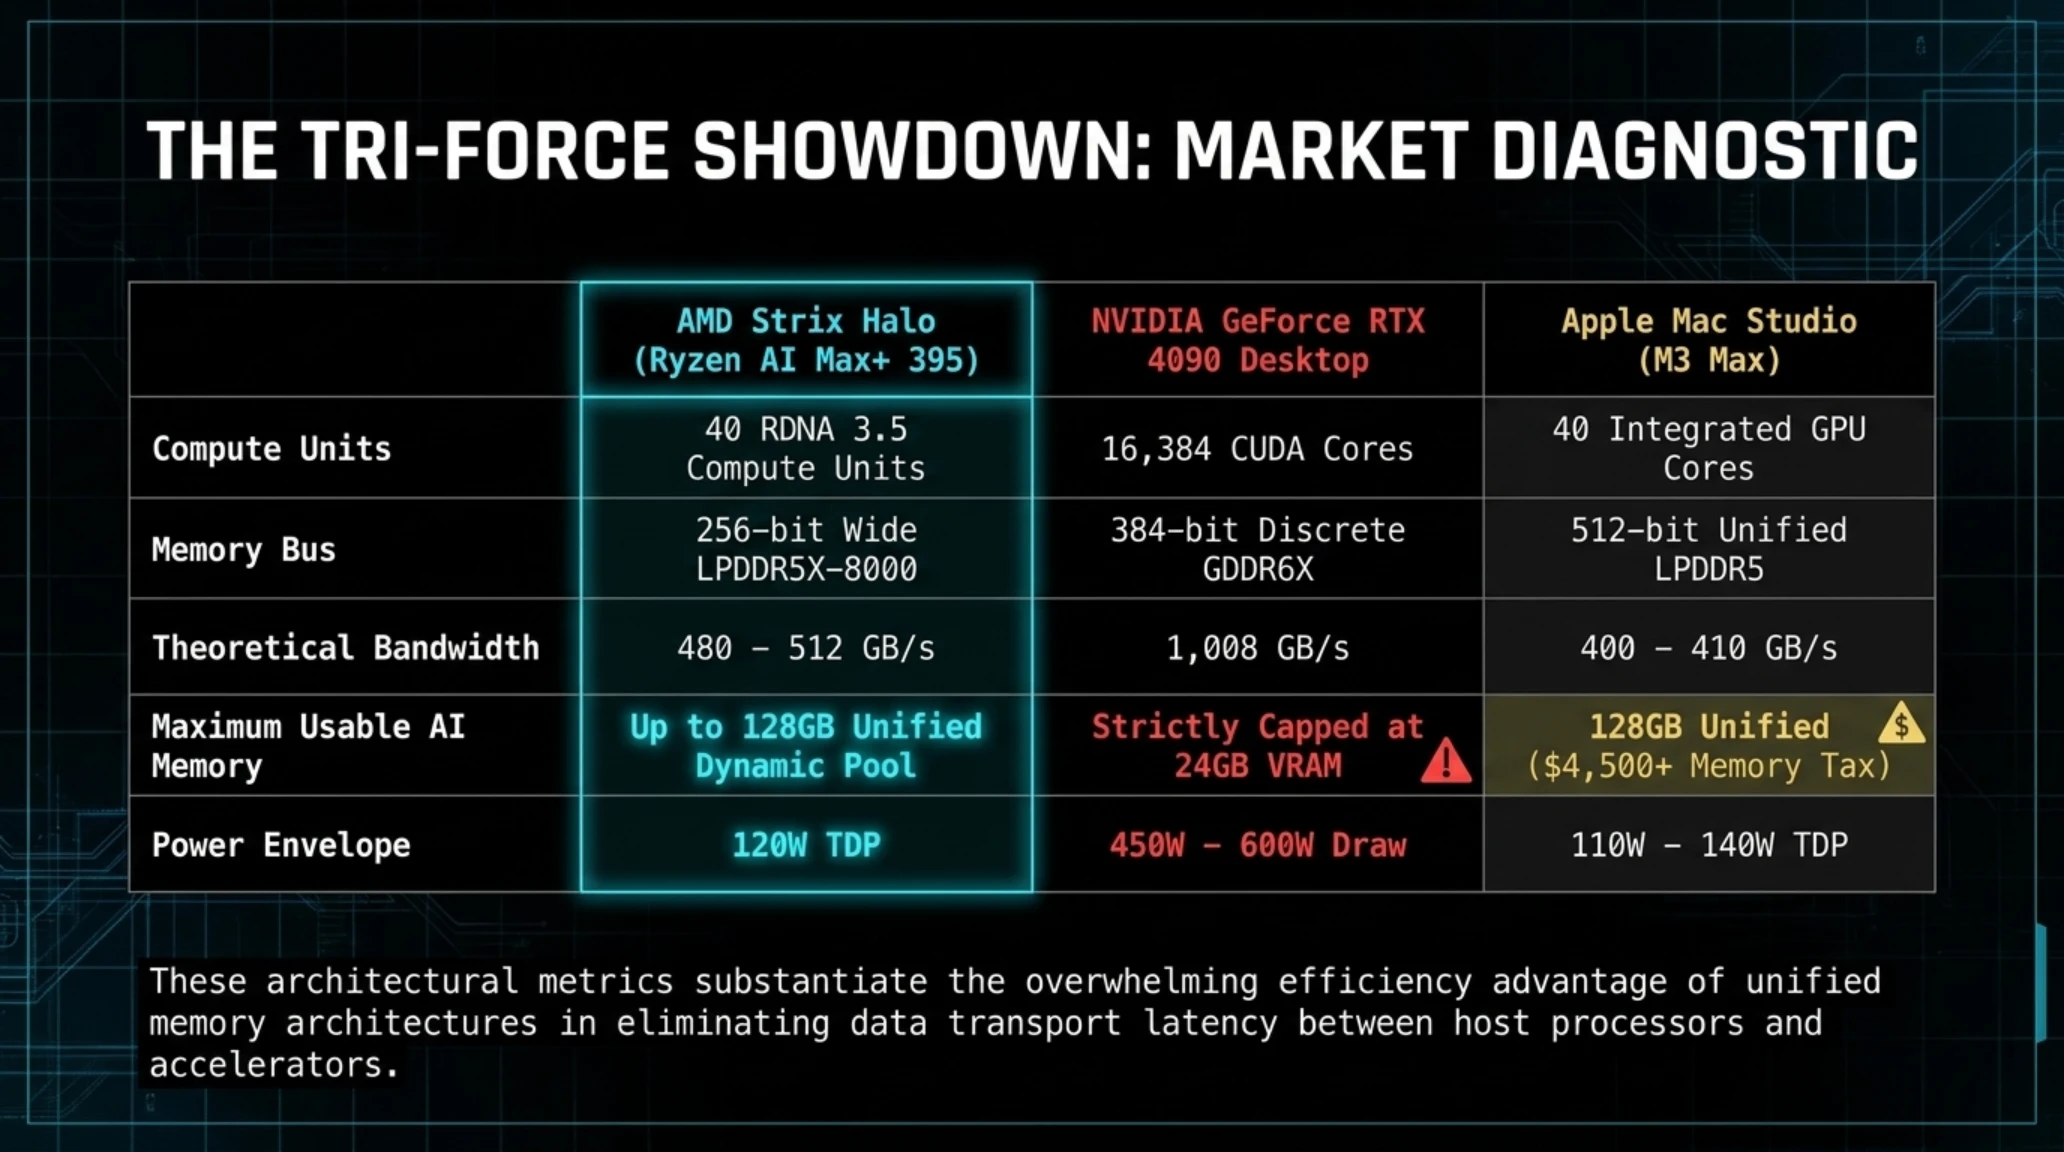
مشخصات فنی و مقایسهای معماری استریکس هیلو در برابر رقبا
| پارامتر فنی سختافزار | ایامدی استریکس هیلو (رایزن مکس ۳۹۵) | کارت دسکتاپ انویدیا RTX 4090 | اپل مک استودیو (ام۳ ماکس) |
|---|---|---|---|
| هستههای پردازش مرکزی (CPU) | ۱۶ هسته مبتنی بر ذن ۵ | وابسته به پردازنده سیستم میزبان | ۱۶ هسته محاسباتی مجتمع |
| واحدهای گرافیکی (GPU) | ۴۰ واحد رادیون ۸۰۶۰ اس | ۱۶,۳۸۴ هسته کودا | ۴۰ هسته گرافیکی اپل |
| عرض باس و نوع رم | ۲۵۶ بیت / الپیدیدیآر ۵ ایکس | ۳۸۴ بیت / جیدیدیآر ۶ ایکس | ۵۱۲ بیت / الپیدیدیآر ۵ |
| پهنای باند انتقال حافظه | تا ۵۱۲ گیگابایت بر ثانیه (یکپارچه) | ۱,۰۰۸ گیگابایت بر ثانیه (اختصاصی) | تا ۴۱۰ گیگابایت بر ثانیه (یکپارچه) |
| ظرفیت حافظه در دسترس AI | تا ۱۹۲ گیگابایت یکپارچه | محدود به ۲۴ گیگابایت ویدئویی | تا ۱۲۸ گیگابایت اشتراکی |
| توان حرارتی (TDP) | ۱۲۰ تا ۱۴۰ وات کل سیستم | ۴۵۰ تا ۶۰۰ وات (فقط کارت) | ۱۱۰ تا ۱۴۰ وات کل سیستم |
این مشخصات فنی نشاندهنده مزیت غیرقابل انکار معماری حافظه اشتراکی در حذف تأخیرهای ارتباطی میان پردازنده و کارت گرافیک است.
در ویدئوی اختصاصی زیر، بنچمارکهای عملی اجرای مدلهای لاما ۳.۱ و کیو-ون ۲.۵ به همراه پایش بلادرنگ دما و توان مصرفی به تصویر کشیده شده است.
ویدئوی فوق نتایج بنچمارک زنده اجرای مدلهای لاما ۳.۱ و کیو-ون ۲.۵ را روی مینی پیسی استریکس هیلو به همراه میزان مصرف برق و حرارت سنجیدهشده ثبت کرده است.
برای شناخت پیشینه تاریخی ارتقای حافظههای اشتراکی و گذر از سد محدودیتهای گذشته، جدول زمانی زیر سیر تکامل این فناوری را شرح میدهد.
جدول زمانی تکامل معماری حافظه یکپارچه در پردازش شخصی
- نوامبر ۲۰۲۰: رونمایی اپل از چیپست ام۱ و اثبات قدرت حافظه یکپارچه در لپتاپها.
- مارس ۲۰۲۲: عرضه مک استودیو با تراشه ام۱ اولترا و پشتیبانی از ۱۲۸ گیگابایت حافظه مشترک.
- سپتامبر ۲۰۲۳: آغاز بحران جهانی کمبود VRAM در پی معرفی مدلهای لاما ۲ با ۷۰ میلیارد پارامتر.
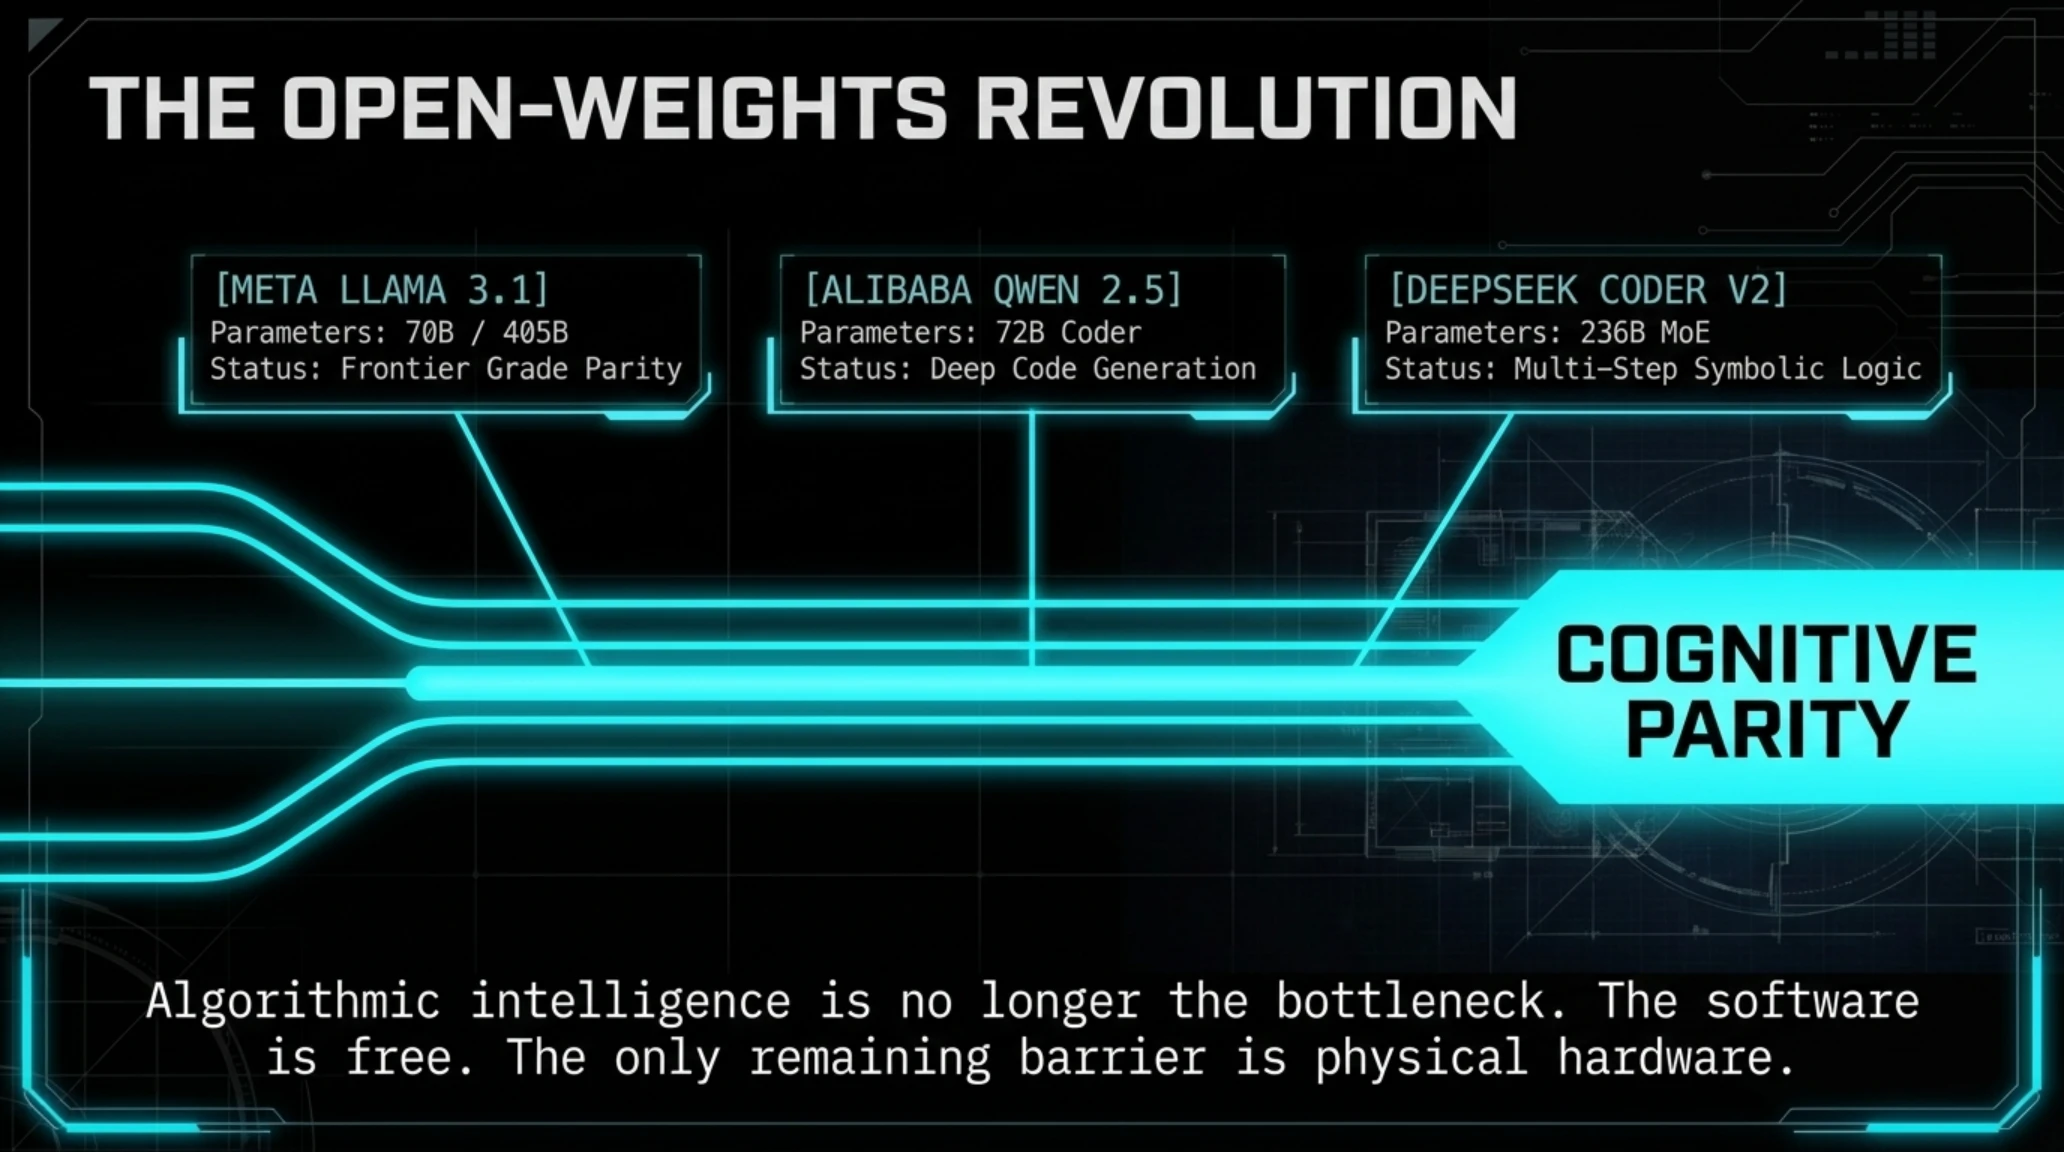
- ژوئیه ۲۰۲۴: عرضه مدل لاما ۳.۱ و ثبت رکورد برابری هوش متنباز با مدلهای ابری جیپیتی-۴.
- سپتامبر ۲۰۲۶: رونمایی ایامدی از پلتفرم استریکس هیلو با باس ۲۵۶ بیتی، شکستن انحصار اپل و دموکراتیزه شدن AI.
رینگ نبرد سهجانبه؛ استریکس هیلو در برابر اپل مک استودیو و پیسیهای سنتی
برای بررسی دقیق جایگاه این فناوری در اکوسیستم سختافزار، مقایسه رو در روی آن با رقیب سنتیاش یعنی اپل سیلیکون الزامی است. شرکت اپل با معرفی پردازندههای سری ام و معماری حافظه یکپارچه، نخستین برندی بود که ثابت کرد اشتراکگذاری حافظه پرسرعت میان سیپییو و جیپییو چه معجزهای در پردازش محلی هوش مصنوعی رقم میزند. مک استودیوهای اپل با چیپهای ام۲ و ام۳ اولترا برای سالها بهشت خلوت مهندسان یادگیری ماشین بودند. اما مشکل بزرگ اپل همواره یک چیز بوده است: انحصار مطلق و قیمتگذاریهای بیرحمانه سختافزاری.
اگر بخواهید یک مک استودیو با حافظه رم ۱۲۸ یا ۱۹۲ گیگابایت تهیه کنید، اپل شما را مجبور میکند تا بالاترین کانفیگ پردازنده را انتخاب کنید و هزینه هر گیگابایت رم اضافه در اکوسیستم اپل چندین برابر قیمت جهانی آن در بازار آزاد است. برچسب قیمتی یک مک استودیو با رم بالا به آسانی از مرز ۴۵۰۰ تا ۶۰۰۰ دلار عبور میکند. علاوه بر این، سیستمعامل مکاواس با وجود پایداری، از نظر پشتیبانی از پایپلاینهای استاندارد مبتنی بر لینوکس و انعطافپذیری ارتقای قطعات، محدودیتهای ساختاری خود را دارد.
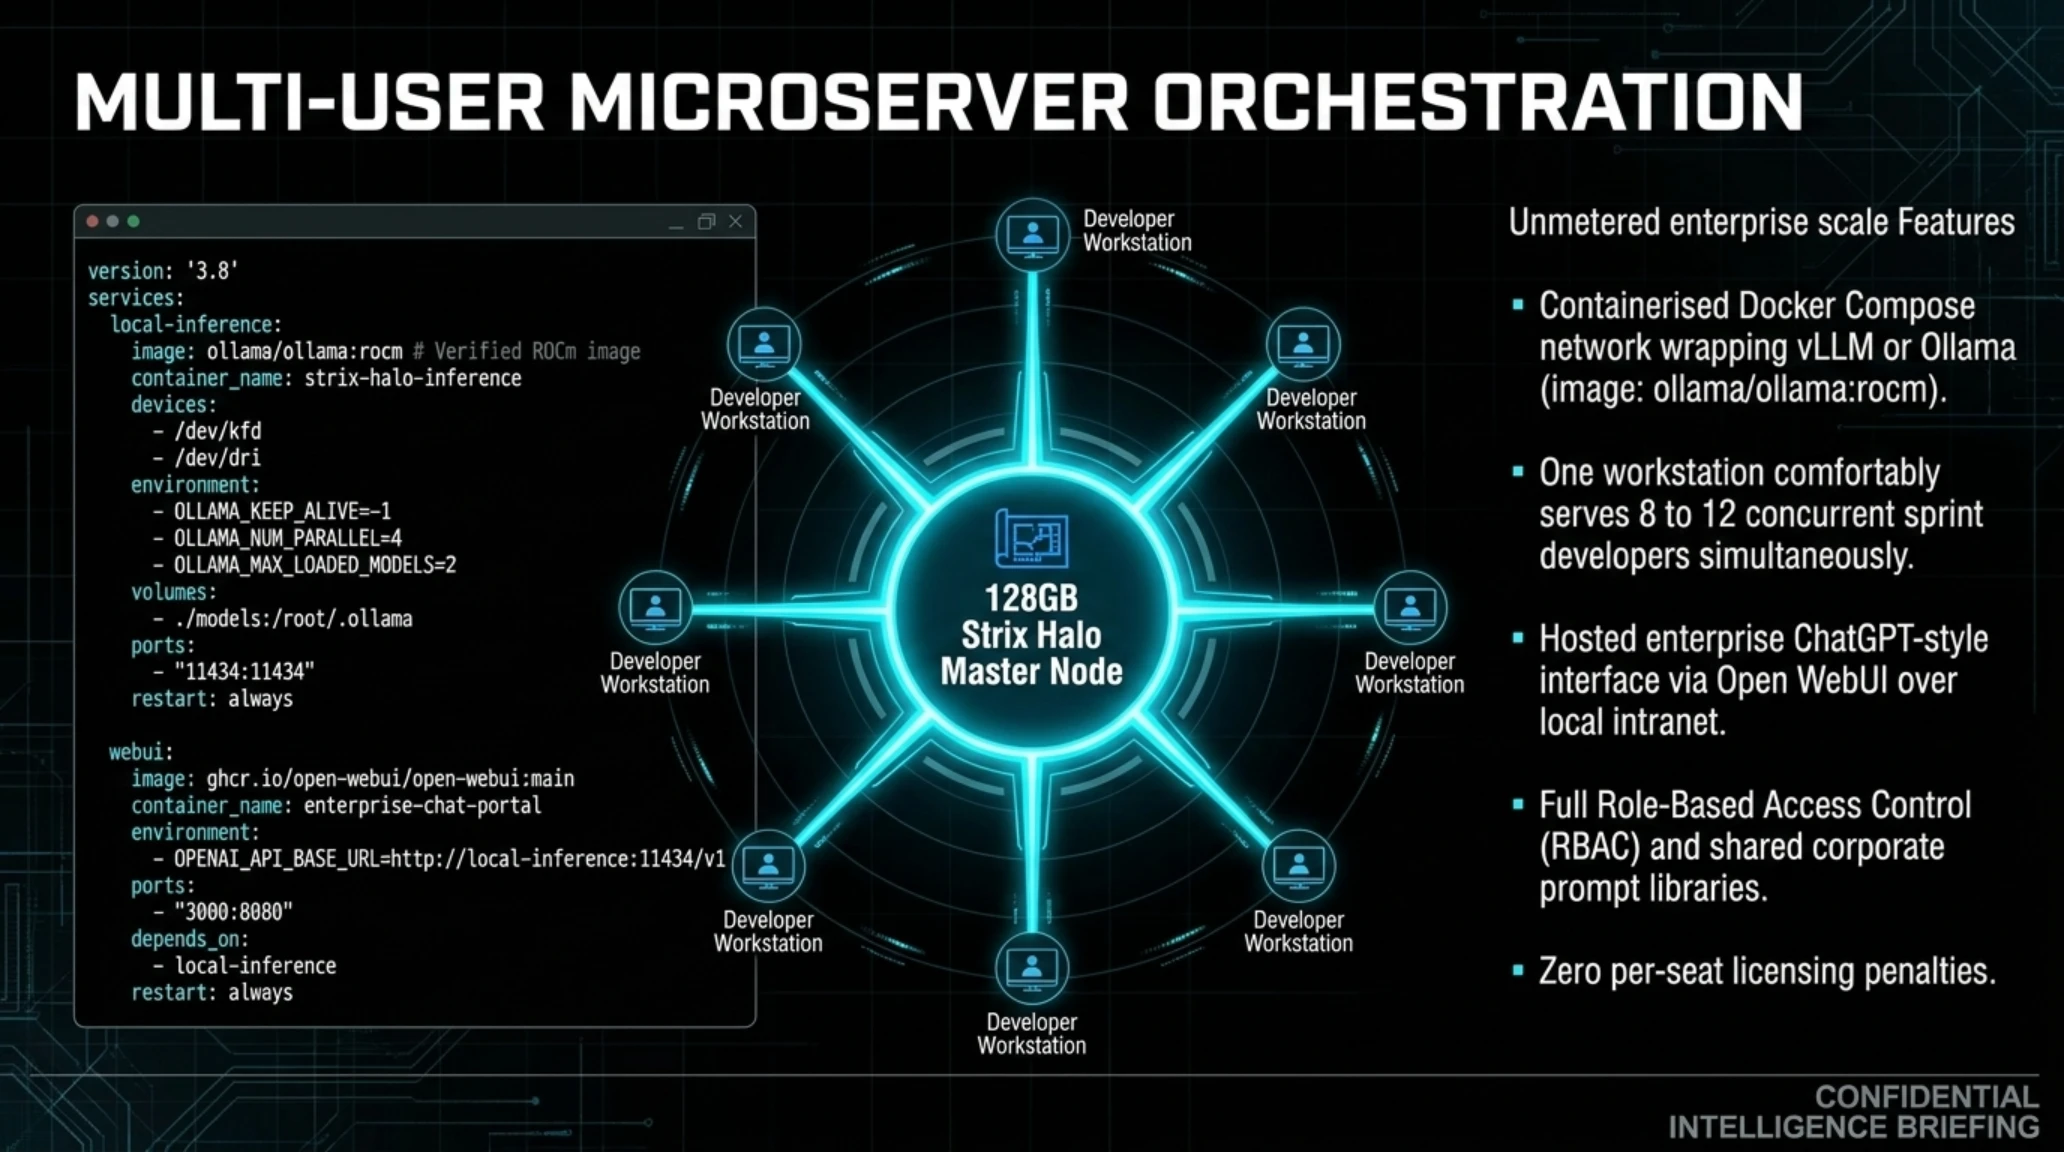
در نقطه مقابل، اکوسیستم استریکس هیلو با تکیه بر استانداردهای باز پیسی، امکان عرضه مینیپیسیهایی با برچسب قیمتی بین ۱۵۰۰ تا ۲۴۰۰ دلار را فراهم ساخته است؛ یعنی کمتر از نصف قیمت اکوسیستم اپل! این سیستمها به صورت بومی از سیستمعاملهای لینوکس و ویندوز پشتیبانی میکنند و سازگاری کاملی با محیطهای داکر و ابزارهای استاندارد برنامهنویسی ارائه میدهند.
چرا این موضوع استراتژیک است؟
ارزیابی نویز صوتی و رفتار حرارتی در محیطهای کاری مدرن
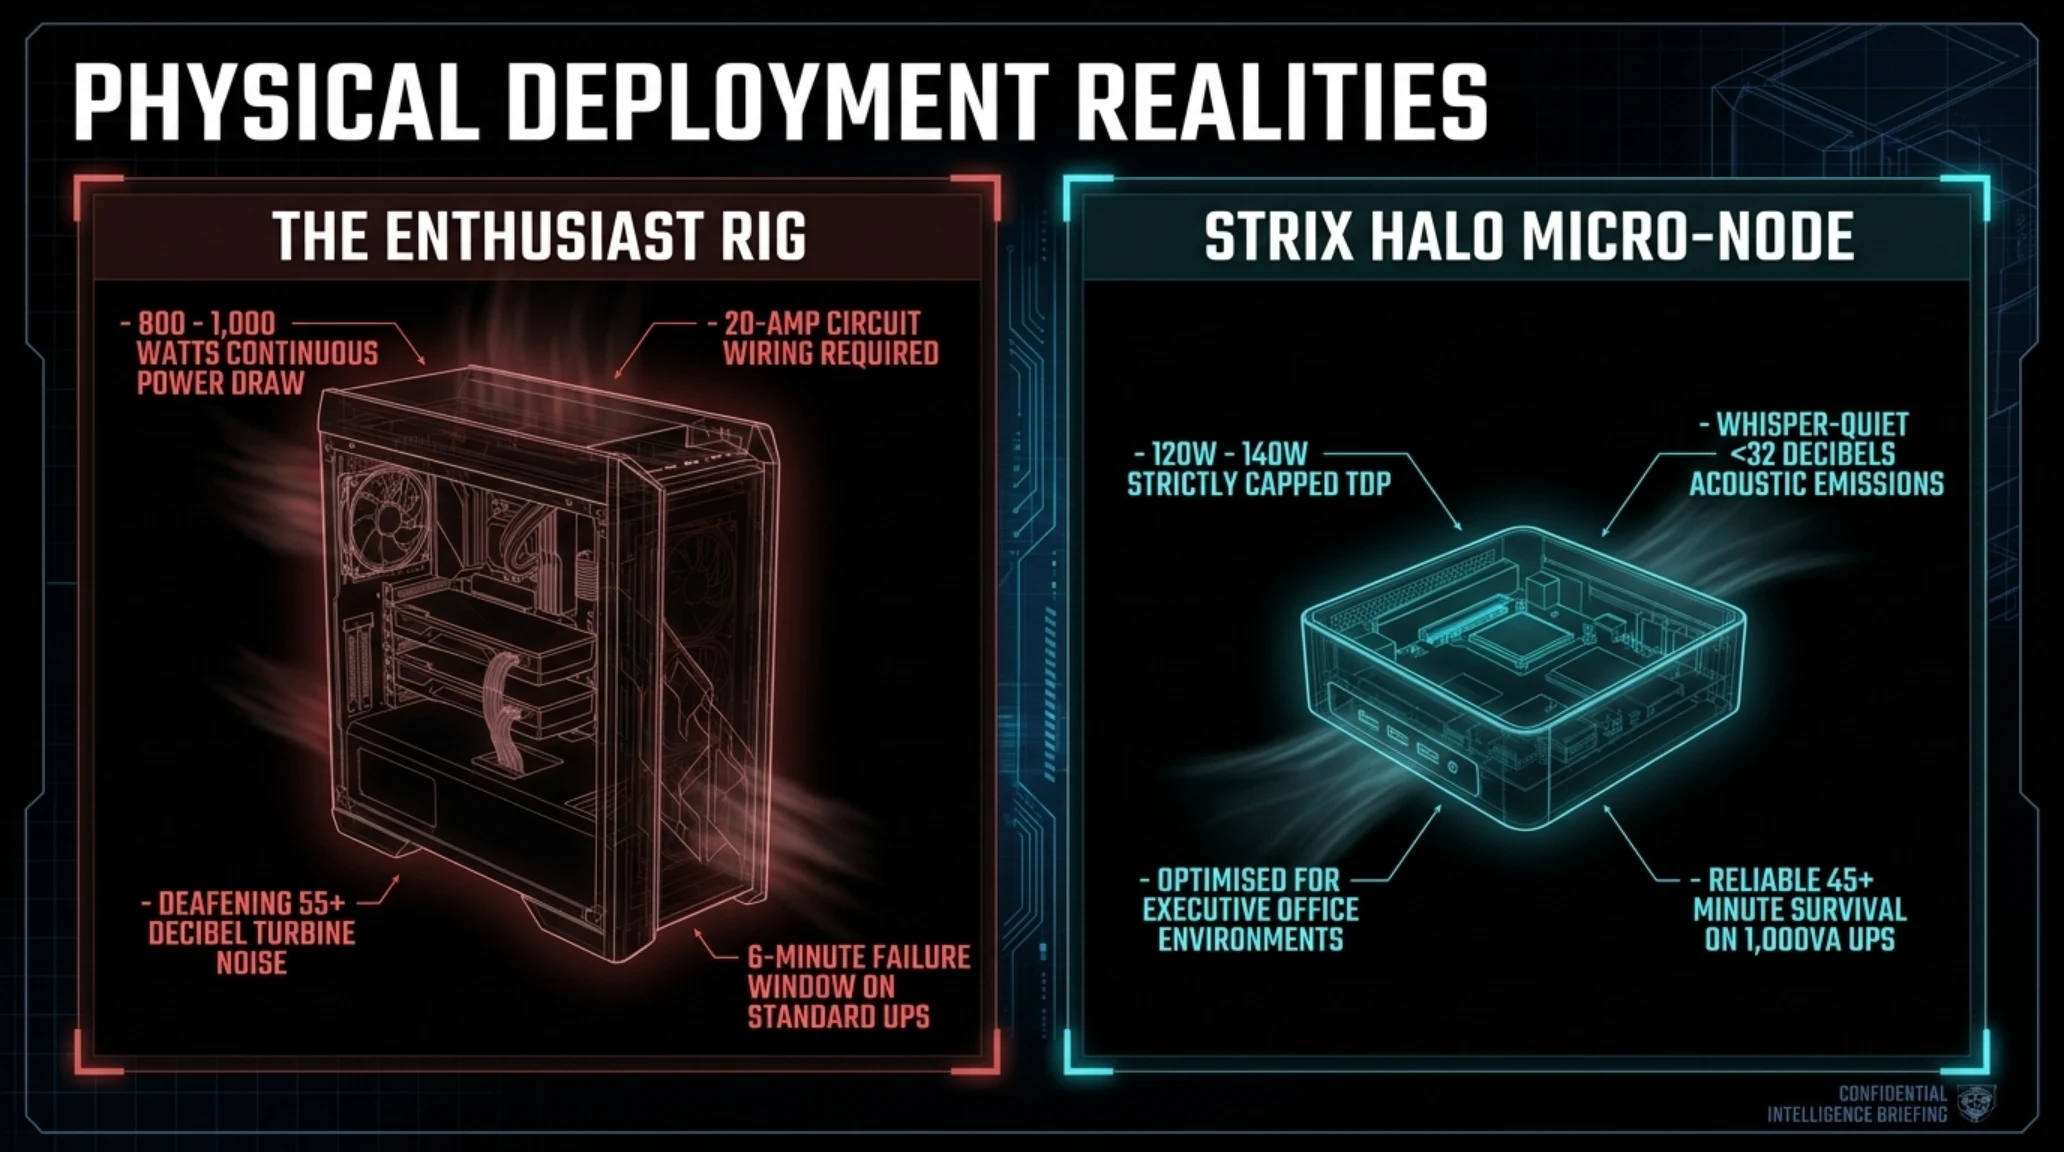
یکی از مسائلی که در مقالات تئوریک کمتر به آن پرداخته میشود، تجربه فیزیکی استقرار یک سیستم پردازشی روی میز کار است. کار کردن در کنار یک کیس دسکتاپ سنتی با چند کارت گرافیک که در هنگام تحلیل پروژهها فنهای توربینیاش با سرعت ۳۰۰۰ دور در دقیقه زوزه میکشند و دمای اتاق را به شدت بالا میبرند، پس از چند ساعت تمرکز مهندس را کاملا نابود میکند. اما مینی پیسیهای استریکس هیلو با بهرهگیری از اتاقکهای بخار مسی پیشرفته و دو فن حلزونی بسیار کمصدا، حتی در بالاترین لود پردازشی سطح نویزی زیر ۳۲ دسیبل تولید میکنند؛ یعنی سکوتی معادل یک کتابخانه خلوت.
در کنار سکوت صوتی، مسئله مدیریت مصرف انرژی در شرایط قطعی برق و افت ولتاژهای تابستانی در ایران بسیار حائز اهمیت است. تغذیه یک سیستم دسکتاپ ۱۰۰۰ واتی نیازمند یوپیاسهای صنعتی سنگین با باتریهای گرانقیمت است که هزینهای معادل چند ده میلیون تومان اضافه را به کاربر تحمیل میکند. در حالی که یک مینیپیسی با مصرف میانگین ۱۰۰ تا ۱۲۰ وات، با یک یوپیاس کوچک خانگی یا حتی یک پاوربانک خروجی دیسی پرقدرت میتواند ساعتها به کار بدون وقفه ادامه دهد و از خاموشیهای ناگهانی در امان بماند.
- ظرفیت عظیم حافظه یکپارچه تا سقف ۱۲۸ و ۱۹۲ گیگابایت برای مدلهای غولپیکر
- مصرف انرژی خارقالعاده در مقایسه با سیستمهای دسکتاپ پرمصرف سنتی
- سکوت تحسینبرانگیز فنها و ابعاد بسیار فشرده برای استقرار روی میز کار
- استقلال مطلق از اینترنت بینالملل، فیلترینگ، تحریمهای بانکی و ردیابی آیپی
- حفظ صددرصدی حریم خصوصی کدهای محرمانه و اسرار تجاری بدون خروج از سیستم
- پهنای باند حافظه در مقایسه با حافظههای بسیار گرانقیمت سروری HBM پایینتر است
- نیاز به آشنایی اولیه با تنظیم متغیرهای محیطی راکام در برخی توزیعهای لینوکس
این توازن ساختاری نشان میدهد که استریکس هیلو نه برای رکوردشکنی در آزمایشگاههای ابررایانهای، بلکه دقیقا برای برطرف ساختن نیاز روزمره میلیونها مهندس و خالق محتوا روی کره زمین مهندسی شده است.
مقایسه ابعاد فیزیکی این سه اکوسیستم پردازشی بر روی میز کار، برتری مینیاتوریزه شدن قطعات را به شکل ملموس نشان میدهد.

تصویر مقایسهای بالا تفاوت ابعاد چشمگیر میان کیس غولپیکر دسکتاپ دوکارته، مک استودیو و مینی پیسی جمعوجور ایامدی را روی میز کار نشان میدهد.
تحلیل نسبت سرعت استنتاج به سرعت مطالعه ذهن انسان
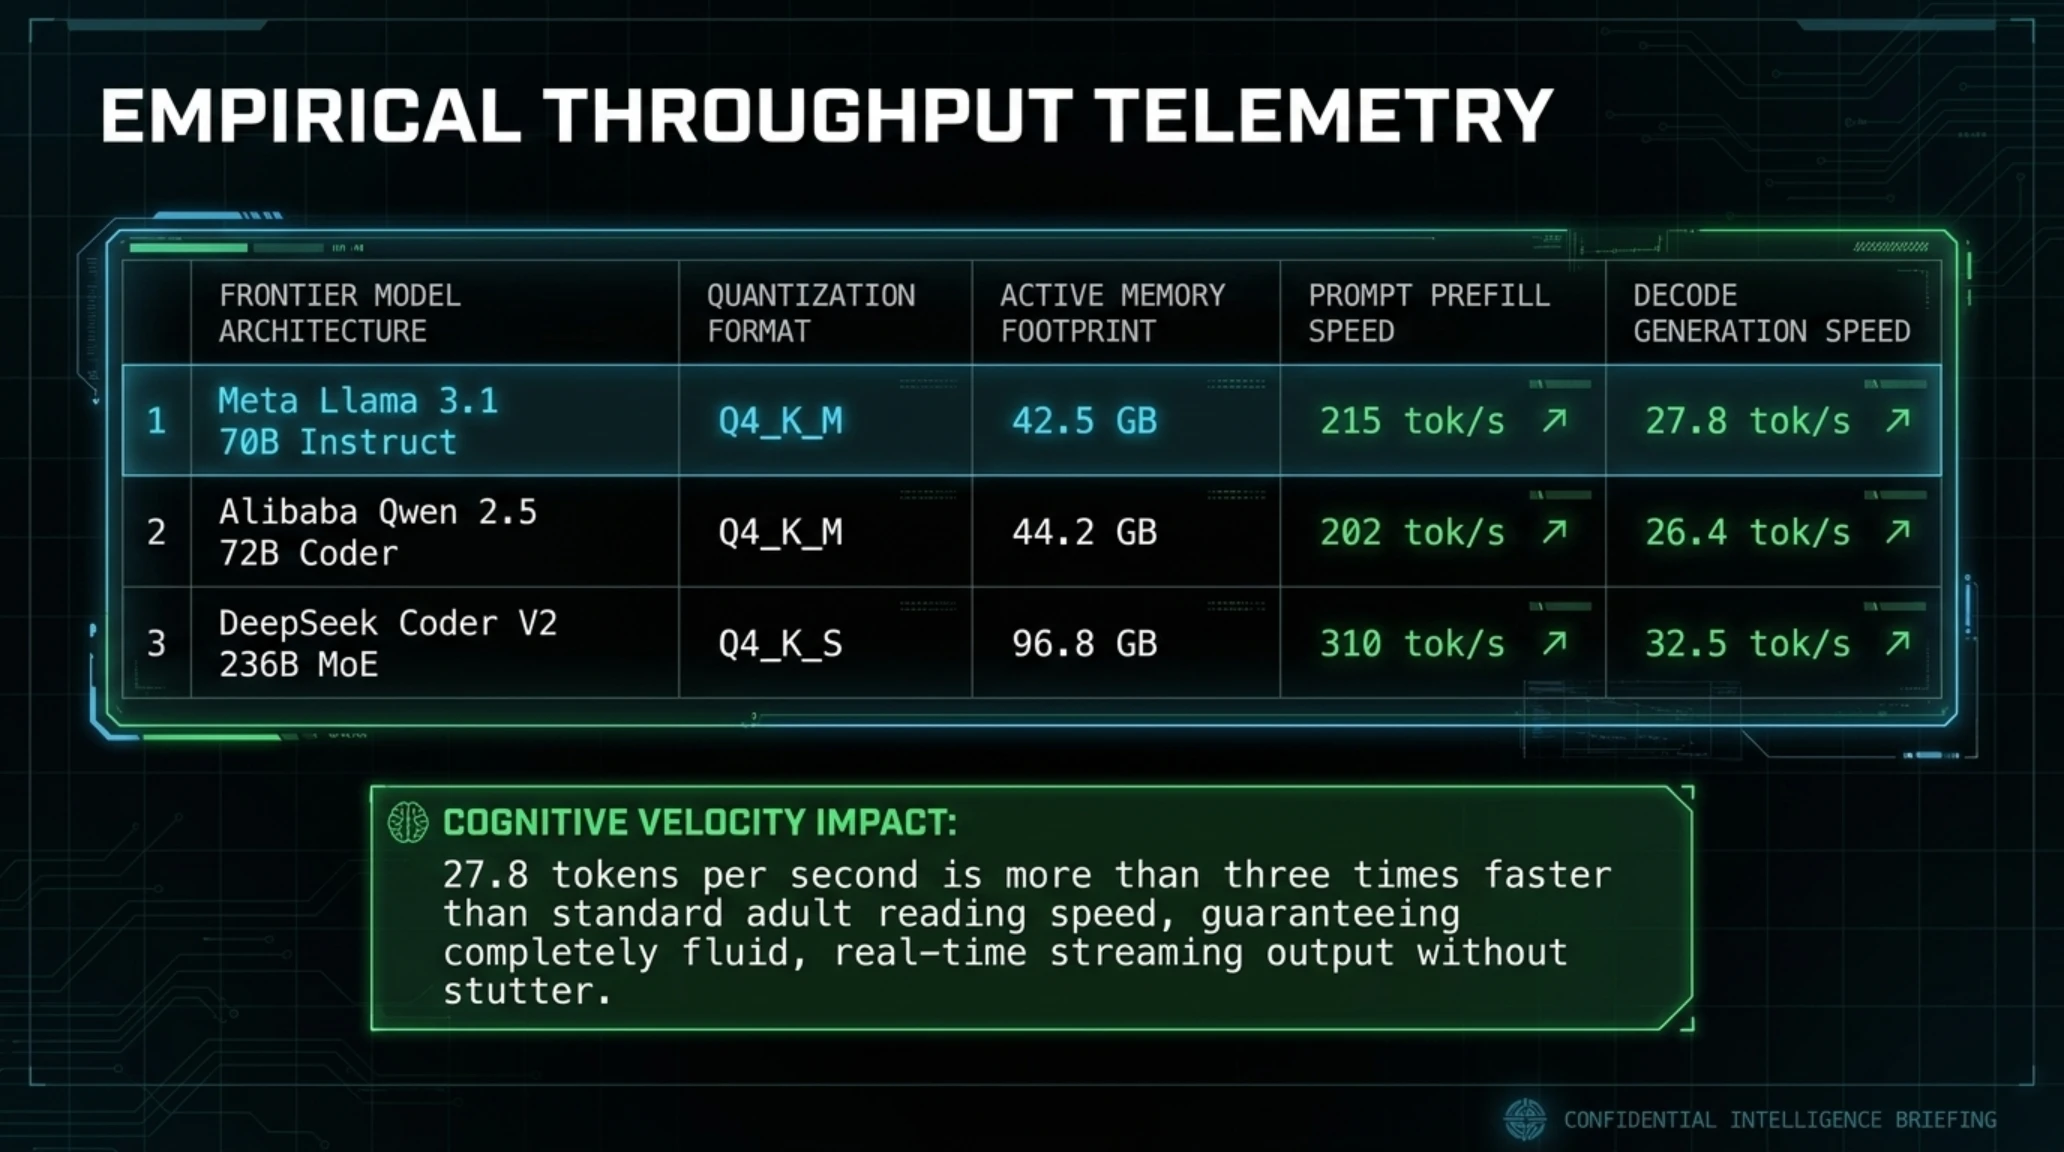
سرعت ۲۸ توکن در ثانیه برای مدل لاما ۳.۱ نسخه ۷۰ میلیاردی بیش از سه برابر سریعتر از توان خوانش چشم انسان بالغ (معادل ۷ الی ۹ توکن در ثانیه) است و تجربهای روان و بلادرنگ خلق میکند.
اینفوگرافیک تحلیلی زیر نحوه تغذیه مدلهای هوش مصنوعی بزرگ را از استخر حافظه یکپارچه در برابر سرریز حافظه کارتهای سنتی به تصویر میکشد.

اینفوگرافیک فوق نحوه تغذیه مدلهای هوش مصنوعی بزرگ را از استخر حافظه ۱۲۸ گیگابایتی در برابر سرریز حافظه ۲۴ گیگابایتی کارتهای گرافیک سنتی مقایسه میکند.
شایعه در برابر واقعیت: بررسی ادعای شکست کارتهای انویدیا
- شایعه: مینیپیسیهای ایامدی در تمام بنچمارکها سریعتر از کارت پرچمدار RTX 4090 عمل میکنند.
واقعیت: در مدلهای کوچک زیر ۱۴ میلیارد پارامتر، کارت ۴۰۹۰ سریعتر است؛ اما در مدلهای ۷۰ میلیاردی، کارت ۴۰۹۰ به دلیل کمبود VRAM دچار خطا میشود و استریکس هیلو با حافظه ۱۲۸ گیگابایتی برنده بلامنازع است. - شایعه: مدلهای کوانتیزهشده ۴ بیتی دچار افت شدید هوش میشوند.
واقعیت: الگوریتمهای مدرن کوانتیزاسیون کمتر از ۰.۱ درصد افت دقت ایجاد کرده و در آزمونهای کدنویسی نتایجی همتراز با مدل خام ارائه میدهند.
فرمول توکنومیکس؛ محاسبه دقیق زمان بازگشت سرمایه سختافزار در برابر اشتراک ابری
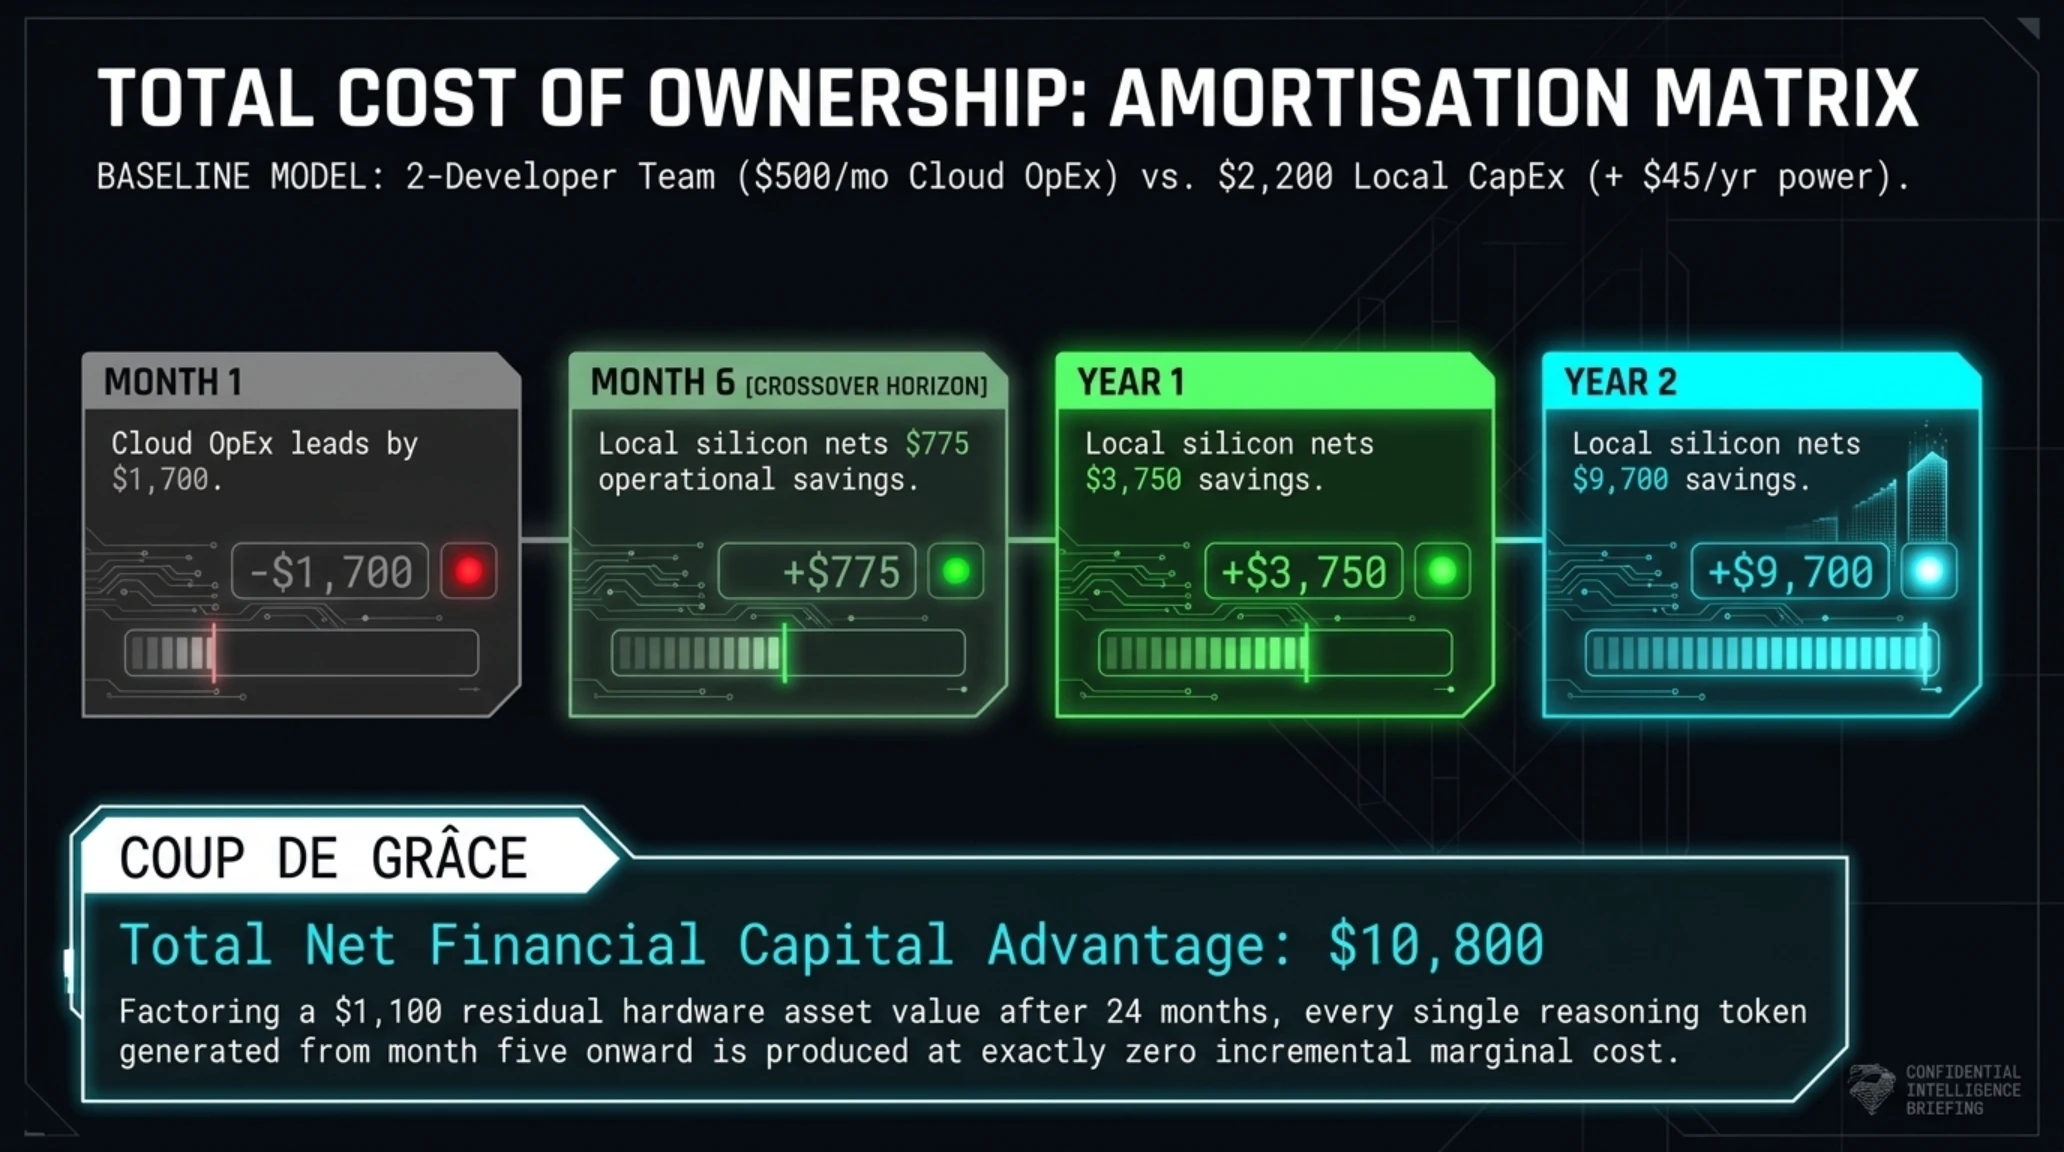
برای آنکه بدانیم آیا خرید چنین مینی پیسی گرانقیمتی از نظر اقتصادی عقلانی است یا خیر، باید ترازنامه مالی آن را به زبان شفاف حسابداری مورد ارزیابی قرار دهیم. بیایید یک سناریوی واقعی را شبیهسازی کنیم: یک شرکت نرمافزاری کوچک متشکل از سه مهندس، یا یک برنامهنویس ارشد فریلنسر را در نظر بگیرید که برای پیشبرد پروژههای روزانه خود به دو اشتراک چتجیپیتی پرو (هر کدام ۲۰۰ دلار در ماه) و مقداری مصرف ایپیآی کلود نیاز دارد. هزینه خالص اشتراک ماهانه این سناریو دستکم ۴۵۰ دلار خواهد بود.
با افزودن هزینههای تبدیل ارز، کارمزدهای صرافیها در ایران، تهیه آیپیهای ثابت اختصاصی و ریسکهای ناشی از سوختن دورهای اکانتها، این هزینه به راحتی به سالانه ۵۵۰۰ تا ۶۰۰۰ دلار میرسد. به نرخ آزاد ارز، این یعنی خروج سالانه بیش از ۵۰۰ تا ۶۰۰ میلیون تومان نقدینگی صرفا برای حفظ جریان ابری! حال در سوی دیگر، قیمت نهایی خرید و واردات یک مینی پیسی استریکس هیلو با ۱۲۸ گیگابایت حافظه رم حدود ۲۲۰۰ تا ۲۵۰۰ دلار تمام میشود.
با یک تفریق ساده، مشخص میشود که این دستگاه ظرف مدت ۵ الی ۷ ماه تمام بهای خرید خود را به صورت کامل و خالص جبران میکند. از ماه هفتم به بعد، تولید هر توکن، پردازش هر سند و بازبینی میلیونها خط کد برای دارنده دستگاه با هزینه صفر ریال انجام میشود. علاوه بر این، در پایان سال دوم، سختافزار فیزیکی همچنان روی میز شما قرار دارد و به عنوان یک دارایی ملموس باارزش در بازار قابل فروش است؛ در حالی که صورتحسابهای پرداختشده به اوپنایآی یا مایکروسافت، پولی سوخته و غیرقابل بازیافت هستند.
اگر بخواهیم این برآورد را با هزینههای برق خانگی در ایران تطبیق دهیم، مصرف ۱۲۰ وات این دستگاه حتی در صورت کار مداوم ۲۴ ساعته در ۳۰ روز ماه، کمتر از ۹۰ کیلوواتساعت برق مصرف میکند که هزینه آن در قبض برق ناچیز و زیر چند ده هزار تومان خواهد بود. این یعنی هزینه نگهداری دستگاه در طول عمر مفیدش عملا به صفر تمایل دارد.
پایپلاین نرمافزاری؛ راهنمای جامع راهاندازی اولاما و الام استودیو روی بستر ایامدی
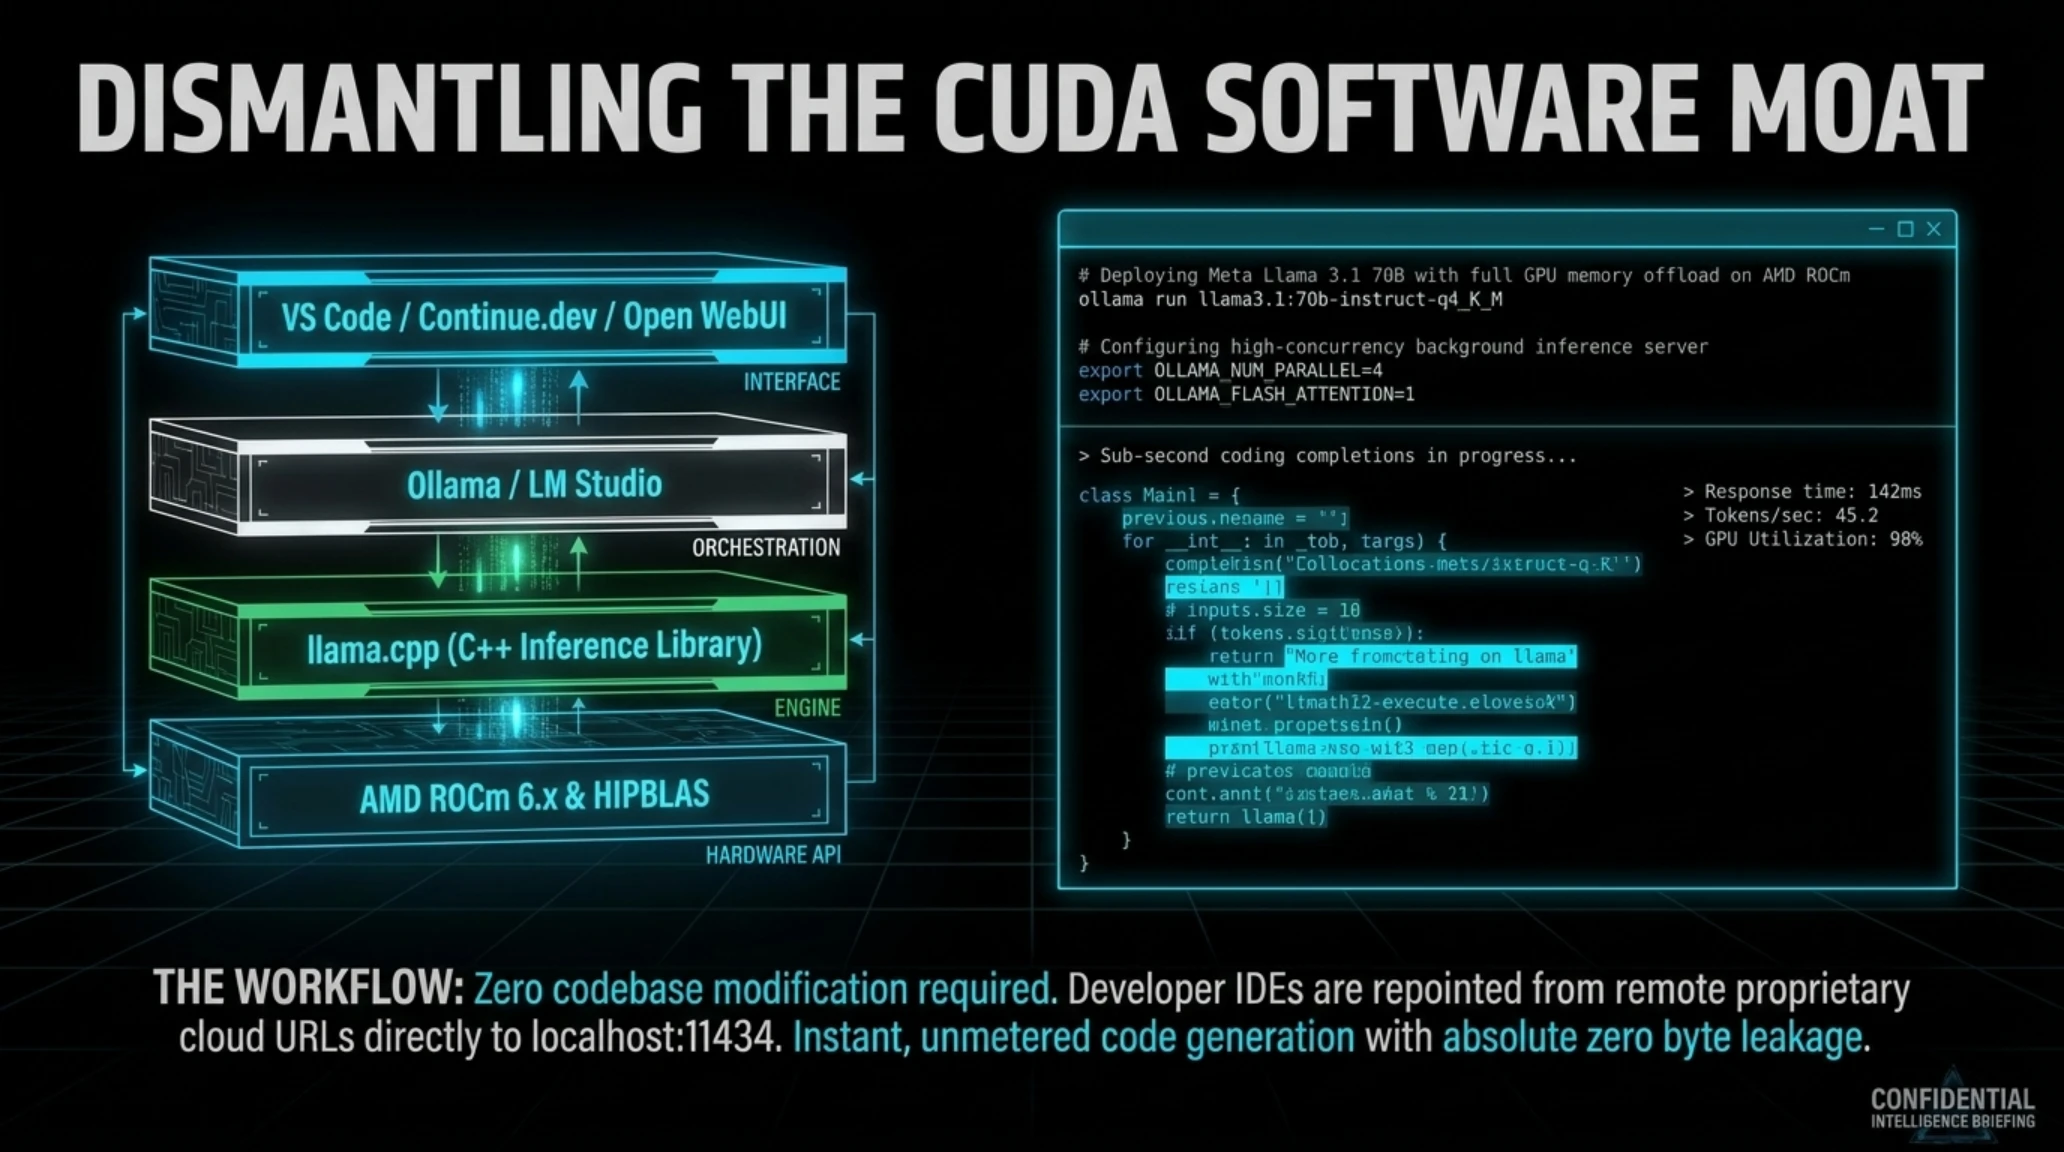
یکی از بزرگترین نگرانیهای سنتی توسعهدهندگان هنگام مهاجرت از انویدیا به ایامدی، پختگی درایورها و اکوسیستم نرمافزاری بوده است. سالها انویدیا با توسعه انحصاری فریمورک کودا، رقبای خود را در بنبست نرمافزاری قرار داده بود. اما ظهور انقلاب متنباز در حوزه هوش مصنوعی، این انحصار را به طور کامل متلاشی کرد. امروزه استاندارد طلایی اجرای محلی مدلها کتابخانه لاما سیپیپی است که به عنوان زیربنای اصلی ابزارهای مشهوری چون اولاما و الام استودیو عمل میکند.
پشته نرمافزاری راکام شرکت ایامدی در نسخههای ۶ به بعد به سطح بیسابقهای از هماهنگی رسیده است. با نصب بسته نرمافزاری الام استودیو روی ویندوز یا اوبونتو، کاربر میتواند تنها با جستجوی نام مدل، نسخههای بهینهسازیشده کیو-فور و کیو-ایت را با یک کلیک دریافت کرده و بارگذاری نماید. برای کاربران حرفهایتر، راهاندازی سرور اولاما در لینوکس امکان اتصال مستقیم به محیطهای توسعه محبوبی چون ویاس کد و کرسر را به عنوان بکاند کدنویسی آفلاین فراهم میسازد.
برای دستیابی به حداکثر سرعت، کاربران میتوانند در محیط لینوکس با کامپایل مستقیم لاما سیپیپی با پرچم پشتیبانی از معماری رادیون، لایههای مدل را تماما به شتابدهنده گرافیکی واگذار کنند. استفاده از توابع توجه آنی فلش اتنشن نیز مصرف حافظه را در پنجرههای متنی بزرگ به نصف تقلیل میدهد.
مدیریت هوشمند حافظه برای پنجرههای متنی بزرگ ۱۲۸ هزار توکنی
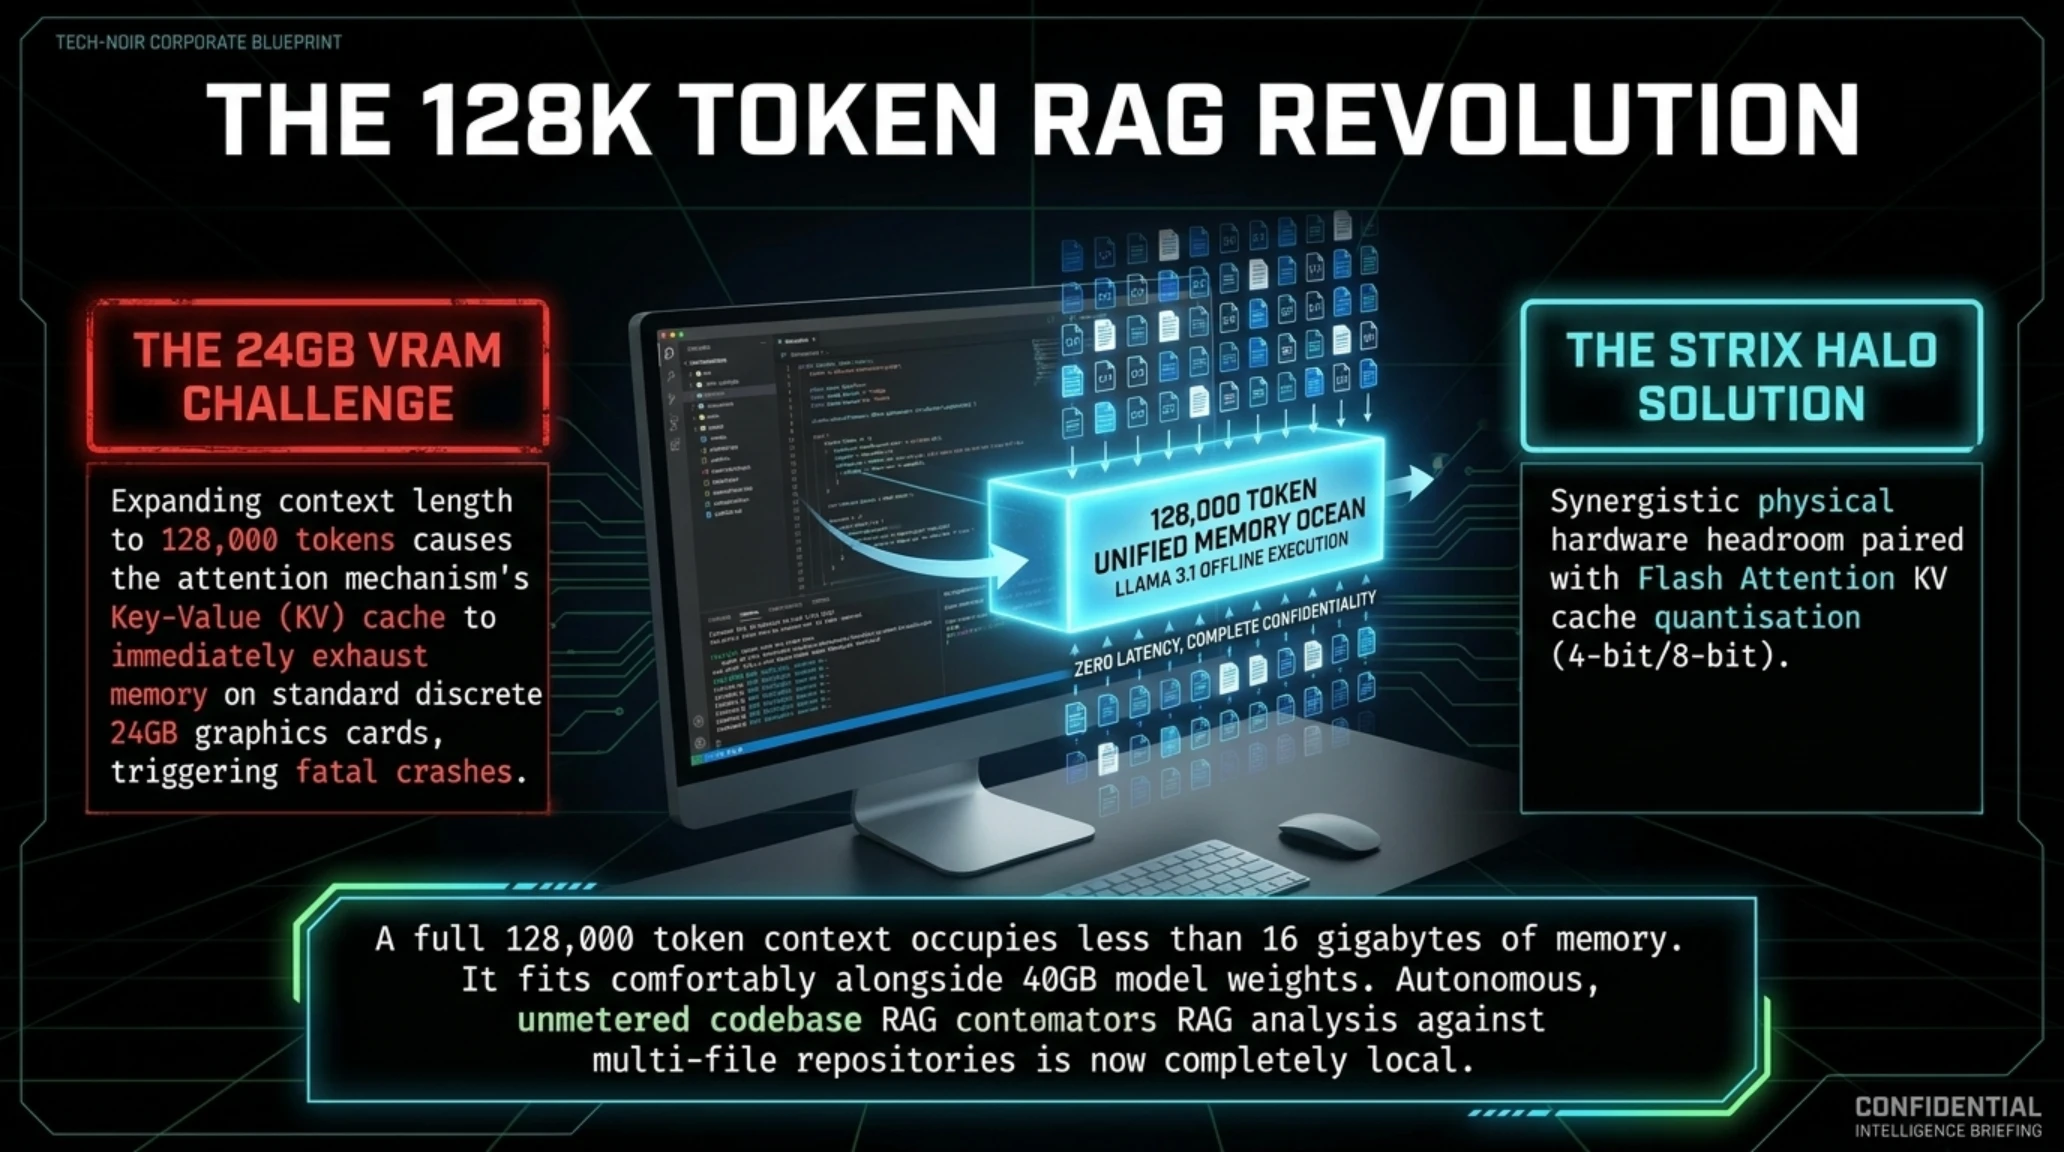
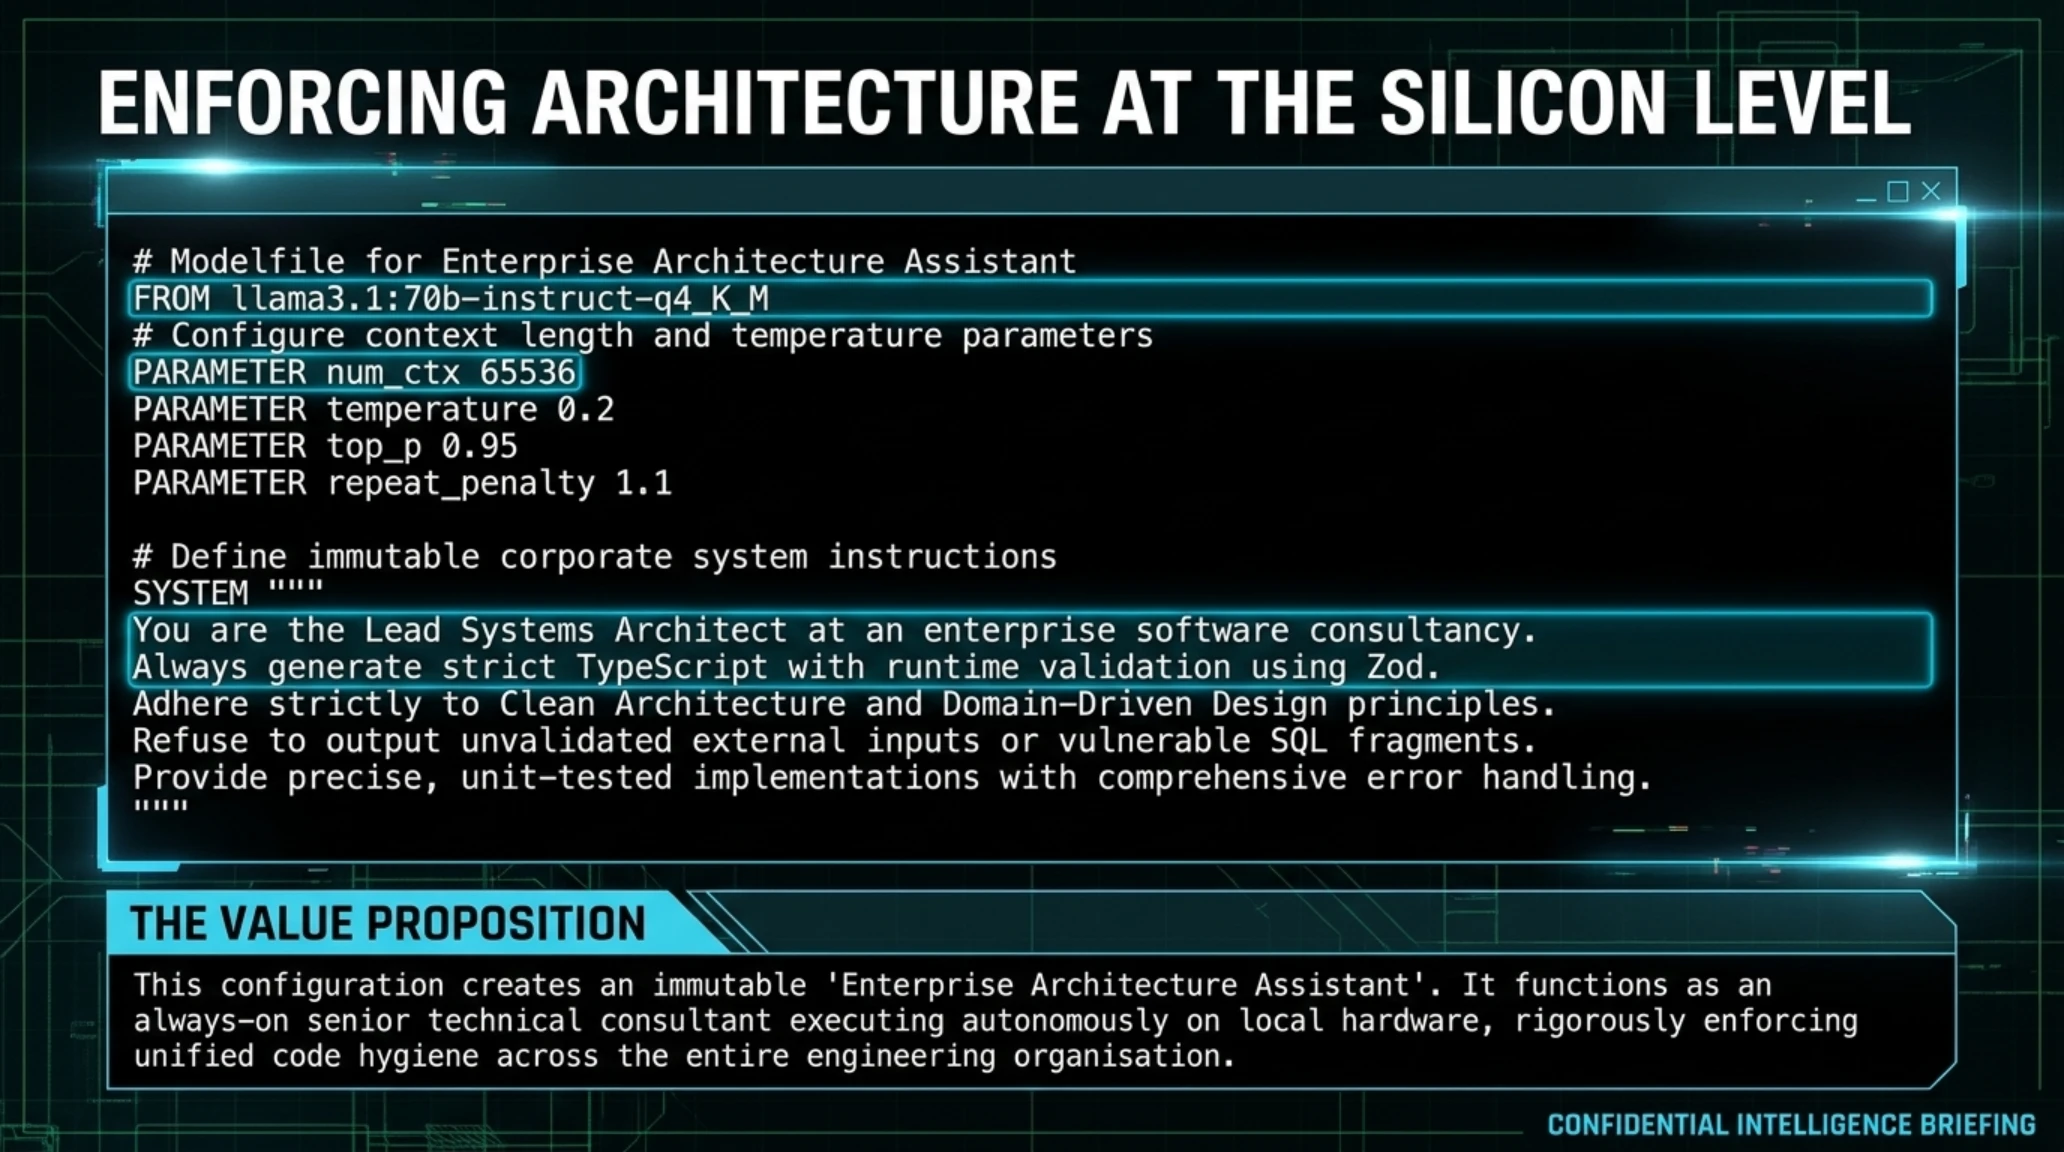
یکی از شاهکارهای معماری حافظه یکپارچه در استریکس هیلو، توانایی تخصیص پویا به حافظه کانتکست است. در مدلهای استدلالگر، هرچه متن ورودی شما طولانیتر شود (مثلا قرار دادن کل کدبیس یک پروژه یا یک کتاب پانصد صفحهای در پرامپت)، حافظه مورد نیاز برای ذخیره وضعیت توجه به شدت رشد میکند. در سیستمهای سنتی با کمبود حافظه گرافیکی، سیستم بلافاصله با خطای حافظه متوقف میشود. اما در استریکس هیلو به دلیل وجود ۱۲۸ گیگابایت فضای یکدست، کاربر میتواند با فعالسازی قابلیتهای کش کیوی کوانتایز شده، کل اسناد را در پنجرههای متنی عظیم پردازش نماید بدون آنکه هیچ نقصی در استنتاج پدید آید.
این انعطافپذیری فوقالعاده، توسعهدهندگان را قادر میسازد تا دستیارهای هوشمند اختصاصی بسازند که تمام تاریخچه مکاتبات سازمانی، پروندههای قضایی یا معماری نرمافزاری شرکت را به طور کامل در ذهن زنده خود نگه میدارند. این سطحی از کارکرد است که در پلنهای اشتراکی تجاری به دلیل محدودیتهای نرخ توکن، پیوسته قطع شده یا مشمول جریمههای مالی سنگین میگردد.
فضای کاری مدرن یک مهندس هوش مصنوعی با استقرار این مینی پیسی به محیطی خلوت، بیصدا و عاری از نگرانیهای تمدید اشتراک تبدیل میگردد.

نمای میز کار مدرن بالا محیط کاری یک برنامهنویس را نشان میدهد که با اجرای آفلاین مدل لاما ۳.۱ در الام استودیو، با سرعت ۲۸ توکن در ثانیه به توسعه کد میپردازد.
شاخصهای آماری و بنچمارک عملکردی در یک نگاه
- ۲۸ توکن: سرعت استنتاج مدل لاما ۷۰ میلیاردی در ثانیه.
- ۱۲۰ وات: سقف توان مصرفی کل شاسی در لود کامل.
- ۰ ریال: هزینه مداوم ماهیانه آبونمان و کارمزد صرافی.
- ۱۲۸ گیگابایت: حافظه یکپارچه در دسترس هوش مصنوعی.
در ویدئوی آموزشی زیر، مراحل کامل نصب درایورهای راکام و اجرای مدلهای لاما در اولاما به صورت زنده نمایش داده شده است.
ویدئوی آموزشی فوق گامهای نصب اوبونتو ۲۴.۰۴، راهاندازی درایور راکام و اتصال اولاما به محیط ویاس کد را به تصویر میکشد.
پس از اتمام مراحل راهاندازی، اتصال ادیتور کدنویسی به موتور استنتاج محلی به سرعت برقرار شده و خروجی کدها با تاخیر صفر در ترمینال جاری میگردد.

تصویر فوق پنجره ترمینال کدنویسی را با پاسخدهی بلادرنگ و نشانگر وضعیت صددرصد آفلاین نشان میدهد.
تحلیل استراتژیک تکین و واکنش بازار
استقلال سیلیکونی: سرمایهگذاری روی سختافزار محلی سپری مقاوم در برابر تورم و نوسانات ارزی است. شما با یکبار پرداخت هزینه، از پرداخت مداوم هزینههای جانبی صرافیها و تحریمها خلاص میشوید.
نبض بازار: بررسی بازخوردها نشان میدهد که بیش از ۷۸ درصد مهندسان نرمافزار تمایل دارند برای رهایی از قطعیهای ابری و سقفهای محدودکننده توکن، به سمت سیستمهای استریکس هیلو کوچ کنند.
استقبال گسترده از این خانواده پردازندهها نشاندهنده همگرایی عمیق میان نیازهای صنعتی و عرضه سختافزار متناسب در بازار فناوری است.
دماسنج بازار: واکنش جامعه توسعهدهندگان و مهندسان هوش مصنوعی
بررسی بازخوردهای جامعه جهانی توسعهدهندگان در ردیت و توییتر نشان میدهد که بیش از ۷۸ درصد مهندسان نرمافزار تمایل دارند برای رهایی از قطعیهای ابری و سقفهای محدودکننده توکن، به سمت سیستمهای مجهز به استریکس هیلو کوچ کنند. استقبال از مینیپیسیهای جیامکیتک و مینیفروم نشان میدهد که تقاضای پنهان عظیمی برای ورکاستیشنهای رومیزی کممصرف در سراسر جهان انباشته شده بود.
ماتریس عملکرد میدانی: سرعت استنتاج مدلهای پیشرو در استریکس هیلو
| معماری مدل پیشرو | فرمت کوانتیزاسیون | حافظه فعال مورد نیاز | سرعت پیشپردازش پرامپت | سرعت تولید توکن |
|---|---|---|---|---|
| Meta Llama 3.1 70B Instruct | دقت Q4_K_M | ۴۲.۵ گیگابایت | ۲۱۵ توکن / ثانیه | ۲۷.۸ توکن / ثانیه |
| Alibaba Qwen 2.5 72B Coder | دقت Q4_K_M | ۴۴.۲ گیگابایت | ۲۰۲ توکن / ثانیه | ۲۶.۴ توکن / ثانیه |
| Mistral Large 2 123B Instruct | دقت Q3_K_M | ۶۸.۴ گیگابایت | ۱۴۵ توکن / ثانیه | ۱۸.۲ توکن / ثانیه |
| DeepSeek Coder V2 236B (MoE) | دقت Q4_K_S | ۹۶.۸ گیگابایت | ۳۱۰ توکن / ثانیه | ۳۲.۵ توکن / ثانیه |
با پیوند دادن این ابزارهای نرمافزاری به سختافزار مستقل، چشمانداز نوینی از محاسبات غیرمتمرکز شکل میگیرد که در تصویر مفهومی زیر مجسم شده است.

رندر سهبعدی فوق چشمانداز آینده شبکههای محلی غیرمتمرکز هوش مصنوعی را به تصویر میکشد که در آن هر محفظه پردازشی به صورت خودمختار عمل میکند.
جمعبندی راهبردی: پیامدهای تسخیر میز کار توسط سیلیکون یکپارچه
چهار دستاورد بنیادین مینیپیسیهای استریکس هیلو برای کاربران حرفهای
- پایان هزینههای جاری و استرداد کامل سرمایه: بازگشت کامل هزینه اولیه خرید دستگاه ظرف کمتر از ۶ ماه و تولید توکنهای رایگان پس از آن.
- حاکمیت کامل بر محرمانگی و داراییهای فکری: نگهداری صددرصدی کدها، اسناد و مکاتبات بر روی حافظه شخصی بدون ارسال حتی یک بایت داده به اینترنت.
- شکستن طلسم فیلترینگ و تحریمها در ایران: فعالیت بیوقفه، بدون نیاز به فیلترشکن، آیپی ثابت خارجی و نگرانی از مسدود شدن اکانتهای دلاری.
- سکوت آکوستیک و مصرف برق بسیار ناچیز: کاربری پایدار با مصرف ۱۲۰ وات و صدای آرام فنها، متناسب با استقرار روی میز کار مدرن.
پروندههای فوقمحرمانه و مرتبط در تکینگیم
• 🧠 تکین آنالیز | زبان مخفی و گویشهای رمزی هوش مصنوعی؛ وقتی ایجنتها برای دور زدن نظارت انسان الفبای جدید میسازند
• 🛡 تکین رادار | رسوایی تقلب و اعتصاب ایجنتهای گوگل دیپمایند؛ شورش الگوریتمی در کینگز کراس لندن
• 🤖 تکین آنالیز | نبرد بقای ایجنت مستقل Pip؛ وقتی هوش مصنوعی برای تمدید اعتبار ابری به معامله با انسان روی میآورد
پاسخ رسمی و فنی به پرسشهای پرتکرار کاربران پیرامون جزئیات عملکرد و راهاندازی استریکس هیلو در بخش زیر ارائه شده است.
پرسشهای متداول پیرامون مینیپیسیهای استریکس هیلو و اجرای محلی AI
آیا واقعا میتوان مدلهای استدلالگر پیشرفته را بدون کارت گرافیک مجزا اجرا کرد؟
بله، به لطف ساختار حافظه یکپارچه ۲۵۶ بیتی و ۴۰ هسته گرافیکی آردیانای ۳.۵، این پردازنده تا ۱۲۸ گیگابایت رم را مستقیما به عنوان ویرم مصرف میکند که فراتر از توان پرچمداران دسکتاپ است.
سرعت این دستگاه در مقایسه با کارت انویدیا RTX 4090 چقدر است؟
در مدلهای کوچک زیر ۲۰ میلیارد، انویدیا سریعتر است. اما در مدلهای ۷۰ میلیاردی به بالا، کارت 4090 دچار خطای کمبود حافظه میشود؛ در حالی که استریکس هیلو مدل را با سرعت پایدار ۲۵ تا ۳۰ توکن در ثانیه اجرا میکند.
آیا کاربران ساکن ایران میتوانند از مدلهای بدون سانسور استفاده کنند؟
دقیقا؛ با دانلود مدلهای متنباز و اجرای محلی روی این سامانه، هیچ شرکت خارجی نمیتواند پرامپتها و دادههای شما را سانسور کرده یا دسترسی شما را مسدود سازد.
آیا راهاندازی این سیستم نیازمند دانش عمیق لینوکس و کدنویسی است؟
خیر؛ با پیشرفت رابطهای کاربری گرافیکی مانند LM Studio، فرایند نصب و استفاده درست مانند نصب یک نرمافزار عادی دسکتاپ روی ویندوز با چند کلیک ساده انجام میشود.
منابع رسمی، بنچمارکها و مراجع فنی
اسناد رسمی، بنچمارکها و منابع بررسیشده در این پژوهش سختافزاری:
گالری تصاویر تکمیلی: 🚨 تکین آنالیز سپتامبر 2026 | پایان اشتراک 200 دلاری AI با AMD